模型部署
一旦模型构建完成并经过充分测试,就可以进行部署了。部署(deploy)模型意味着让模型能够接受生产系统用户发来的查询。生产系统收到查询后,会将查询转换为特征向量(feature vector)。特征向量随后被发送给模型作为评分(scoring)的输入。评分结果再返回给用户。
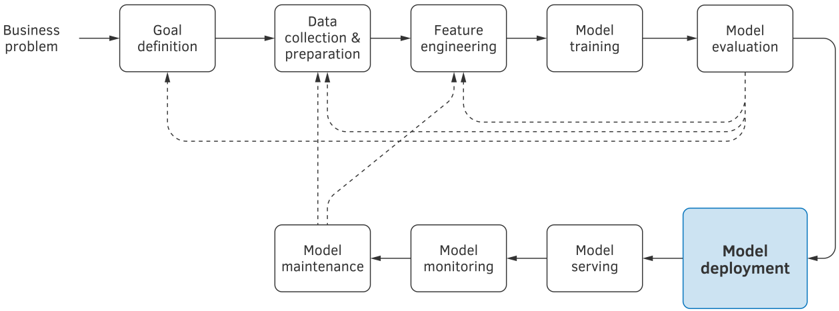
模型部署是机器学习项目生命周期中的第六个阶段:
图 1:机器学习项目生命周期。
训练好的模型可以通过多种方式进行部署。它可以部署在服务器上,也可以部署在用户的设备上。它可以一次性面向所有用户部署,也可以只面向一小部分用户部署。下面我们逐一考虑这些选项。
模型可以按照以下几种模式(pattern)进行部署:
- 静态部署(static deployment),作为可安装软件包的一部分;
- 在用户设备上动态部署(dynamic deployment);
- 在服务器上动态部署;或
- 通过模型流式部署(model streaming)。
8.1 静态部署
机器学习模型的静态部署与传统软件部署非常相似:你需要准备整个软件的可安装二进制文件。模型被打包为运行时可用的一种资源。根据操作系统和运行时环境的不同,模型对象和特征提取器(feature extractor)对象都可以打包成动态链接库(Windows 上的 DLL)、共享对象(Linux 上的 *.so 文件)的一部分,或者被序列化后保存在基于虚拟机(如 Java 和 .Net)系统的标准资源位置中。
静态部署有很多优点:
- 软件可以直接访问模型,因此对用户来说执行速度快;
- 预测时无需将用户数据上传到服务器;这既节省时间,又保护隐私;
- 用户离线时也可以调用模型;以及
- 软件供应商无需操心让模型保持可用;这变成了用户的责任。
然而,静态部署也有几个缺点。首先也是最重要的一点,机器学习代码与应用代码之间的关注点分离(separation of concerns)并不总是清晰的。这使得在不升级整个应用的情况下升级模型变得更加困难。其次,如果模型评分有特定的计算需求(例如需要访问加速器或 GPU),这可能会增加复杂性和困惑,让人难以判断静态部署在哪些场景可用、哪些场景不可用。
8.2 用户设备上的动态部署
设备上的动态部署与静态部署类似,都是用户在自己的设备上以软件应用的形式运行系统的一部分。区别在于,在动态部署中,模型不是应用二进制代码的一部分。因此它可以实现更好的关注点分离。推送模型更新时无需更新运行在用户设备上的整个应用。此外,动态部署还可以让同一段代码根据可用的计算资源选择合适的模型。
动态部署可以通过以下几种方式实现:
- 部署模型参数;
- 部署序列化对象(serialized object);以及
- 部署到浏览器。
8.2.1 模型参数的部署
在这种部署场景中,模型文件只包含学习到的参数,而用户的设备上安装了模型的运行时环境。一些机器学习软件包,如 TensorFlow,有可以在移动设备上运行的轻量级版本。
另外,像 Apple 的 Core ML 这样的框架允许在 Apple 设备上运行用流行软件包(包括 scikit-learn、Keras 和 XGBoost)创建的模型。
8.2.2 序列化对象的部署
在这种方式下,模型文件是一个序列化对象,应用会对其反序列化。这种方法的优点是你不需要在用户设备上为模型准备运行时环境。所有需要的依赖都会随着模型对象一起被反序列化。
一个明显的缺点是,更新可能会相当“沉重”,如果你的软件系统有数百万用户,这会是个问题。
8.2.3 部署到浏览器
大多数现代设备都可以访问浏览器,无论是桌面端还是移动端。一些机器学习框架,如 TensorFlow.js,提供了支持在浏览器中使用 JavaScript 作为运行时来训练和运行模型的版本。
甚至可以在 Python 中训练 TensorFlow 模型,然后将其部署到浏览器的 JavaScript 运行时环境中运行。此外,如果客户端设备上有 GPU(图形处理单元,graphics processing unit),TensorFlow.js 也可以利用它。
8.2.4 优点与缺点
向用户设备动态部署的主要优点是,对用户来说,调用模型会很快。它还减轻了组织服务器的负担,因为大部分计算都在用户设备上完成。此外,如果模型部署到浏览器,组织的基础设施只需要提供包含模型参数的网页。基于浏览器的部署的一个缺点是带宽成本和应用启动时间可能会增加。用户每次启动 Web 应用时都必须下载模型参数,而不是只在安装应用时下载一次。
另一个缺点出现在模型更新期间。回想一下,序列化对象可能非常庞大。一些用户在更新期间可能处于离线状态,甚至关闭所有未来的更新。在这种情况下,最终可能会出现不同用户使用非常不同的模型版本的情况。这时,升级应用的服务器端部分就变得困难了。
把模型部署在用户设备上,意味着模型很容易被第三方分析。他们可能会尝试对模型进行逆向工程以复现其行为。他们可能会通过提供各种输入并观察输出来寻找弱点。或者,他们可能会调整自己的数据,使模型按他们的意愿进行预测。
假设移动应用允许用户阅读与他们兴趣相关的新闻。某个内容提供商可能会试图对模型进行逆向工程,让模型更频繁地推荐来自该内容提供商的新闻。
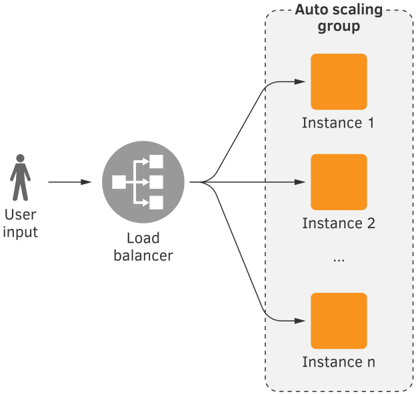
图 2:在虚拟机上将机器学习模型部署为 Web 服务。
与静态部署一样,部署到用户设备也使监控模型性能变得困难。
8.3 服务器上的动态部署
由于上述种种复杂性和性能监控方面的问题,最常见的部署模式是把模型放在一台(或多台)服务器上,并以 Web 服务形式的表述性状态转移应用程序接口(Representational State Transfer application programming interface,REST API)或 Google 远程过程调用(Google’s Remote Procedure Call,gRPC)服务的形式提供。
8.3.1 在虚拟机上部署
在云环境中部署的典型 Web 服务架构中,预测以对规范格式 HTTP 请求的响应形式提供。运行在虚拟机(virtual machine)上的 Web 服务接收包含输入数据的用户请求,调用机器学习系统处理这些输入数据,然后把机器学习系统的输出转换为 JavaScript 对象表示法(JavaScript Object Notation,JSON)或可扩展标记语言(Extensible Markup Language,XML)字符串输出。为了应对高负载,多台相同的虚拟机并行运行。
负载均衡器(load balancer)根据各虚拟机的可用性,把传入的请求分发到特定的虚拟机上。虚拟机可以手动添加和关闭,也可以作为自动伸缩组(autoscaling group)的一部分,根据使用情况自动启动或终止虚拟机。图 2 展示了这种部署模式。每个实例(用橙色方块表示)都包含运行特征提取器和模型所需的全部代码。该实例还包含一个可以访问这些代码的 Web 服务。
在 Python 中,REST API Web 服务通常使用 Flask 或 FastAPI 等 Web 应用框架实现。R 语言的对应物是 Plumber。
TensorFlow 是一个用于训练深度模型的流行框架,它自带 TensorFlow Serving,一个内置的 gRPC 服务。
在虚拟机上部署的优点是软件系统的架构在概念上很简单:它是一个典型的 Web 或 gRPC 服务。
缺点方面,需要维护(物理或虚拟)服务器。如果使用虚拟化,那么由于虚拟化和运行多个操作系统,会有额外的计算开销。另一个缺点是网络延迟,取决于你处理评分结果的速度要求,这可能是一个严重的问题。最后,与下面要讨论的容器部署或无服务器(serverless)部署相比,在虚拟机上部署的成本相对更高。
8.3.2 在容器中部署
虚拟机部署的一个更现代的替代方案是基于容器的部署。使用容器通常被认为比虚拟机更节省资源、更灵活。容器与虚拟机类似,它也是一个隔离的运行时环境,有自己的文件系统、CPU、内存和进程空间。然而,主要区别在于,所有容器都运行在同一台虚拟或物理机器上并共享操作系统,而每台虚拟机都运行自己的操作系统实例。
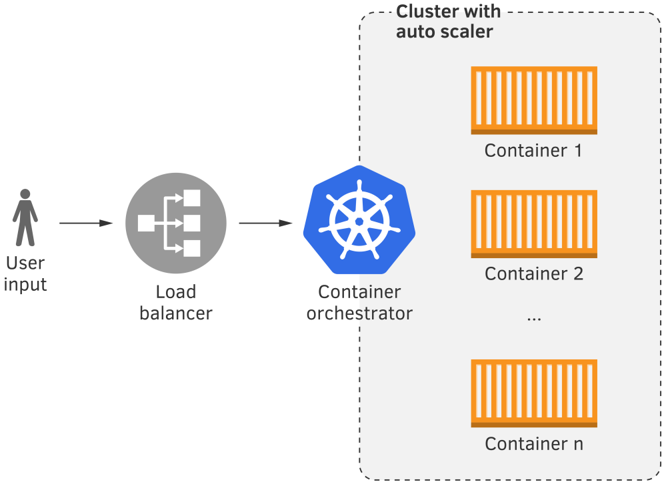
部署过程如下。机器学习系统和 Web 服务被安装在容器内部。通常,容器是 Docker 容器,但也有其他选择。然后使用容器编排系统(container-orchestration system)在物理或虚拟服务器集群上运行容器。在本地或云平台上运行容器编排系统的典型选择是 Kubernetes。一些云平台既提供自己的容器编排引擎(如 AWS Fargate 和 Google Kubernetes Engine),也原生支持 Kubernetes。
图 3 展示了这种部署模式。这里,虚拟或物理机器被组织成一个集群,集群资源由容器编排器管理。新的虚拟或物理机器可以手动添加到集群中,或关闭。如果你的软件部署在云环境中,集群自动伸缩器(cluster autoscaler)可以根据集群的使用情况启动(并添加到集群中)或终止虚拟机。
图 3:在集群中运行的容器内将模型部署为 Web 服务。
与在虚拟机上部署相比,容器部署的优势在于更节省资源。它可以随评分请求自动伸缩。它还允许我们缩容到零(scale-to-zero)。缩容到零的思想是:容器在空闲时可以缩减到零个副本,有请求需要服务时再启动。这样一来,与一直运行的服务相比,资源消耗很低。这导致更少的电力消耗,并节省云资源成本。
一个缺点是,容器化部署通常被认为更复杂,需要专业知识。
8.3.3 无服务器部署
包括 Amazon、Google 和 Microsoft 在内的多家云服务提供商提供所谓的无服务器计算(serverless computing)。它在 Amazon Web Services 上被称为 Lambda 函数(Lambda functions),在 Microsoft Azure 和 Google Cloud Platform 上被称为 Functions。
无服务器部署包括准备一个 zip 归档,其中包含运行机器学习系统(模型、特征提取器和评分代码)所需的全部代码。zip 归档必须包含一个具有特定名称的文件,该文件定义了一个具有特定签名的特定函数或类方法定义(入口点函数)。zip 归档被上传到云平台,并以唯一名称注册。
云平台提供一个 API,用于向无服务器函数提交输入。调用时指定函数名称、提供负载(payload),并获得输出。云平台负责把代码和模型部署到合适的计算资源上、执行代码,并把输出路由回客户端。
通常,函数的执行时间、zip 文件大小和运行时可用的 RAM 数量都受到云服务提供商的限制。
zip 文件大小限制可能是一个挑战。典型的机器学习模型需要多个重量级依赖。模型要正确执行,通常需要 Python 库,包括 Numpy、SciPy 和 scikit-learn。根据云平台的不同,其他受支持的编程语言可以包括 Java、Go、PowerShell、Node.js、C# 和 Ruby。
依赖无服务器部署有很多优点。最明显的优点是你不必配置服务器或虚拟机等资源。你不必安装依赖、维护或升级系统。无服务器系统具有很高的可伸缩性,可以轻松支持每秒数千个请求。无服务器函数支持同步和异步两种运行模式。
无服务器部署还具有成本效益:你只为计算时间付费。前两种部署模式也可以通过自动伸缩实现这一点,但自动伸缩有显著的延迟。当需求下降时,多余的虚拟机在被终止前可能仍在运行。
无服务器部署还简化了金丝雀部署(canary deployment,或 canarying)。在软件工程中,金丝雀发布是一种策略:把更新后的代码只推送给一小部分最终用户,通常用户并不知情。由于新版本只分发给少量用户,其影响相对较小,如果新代码包含 bug,可以快速回滚更改。在生产环境中很容易设置两个版本的无服务器函数,开始只向其中一个发送少量流量进行测试,而不会影响很多用户。我们将在 8.4 节进一步讨论金丝雀部署。
在无服务器部署中,回滚(rollback)也非常简单,因为只需替换一个 zip 归档就可以轻松切回函数的旧版本。
我们已经讨论了 zip 归档大小限制和运行时可用 RAM 的问题。这些是无服务器部署的重要缺点。同样,无法使用 GPU 1 可能是部署深度模型的一个显著限制。
当然,复杂的软件系统可以组合使用多种部署模式。适合一个模型的部署模式可能对另一个模型不是最优的。多种部署模式的组合被称为混合部署模式(hybrid deployment pattern)。像 Google Home 或 Amazon Echo 这样的个人助理,可能在客户端设备上部署一个识别唤醒词(如“OK, Google”或“Alexa”)的模型,而处理“把歌曲 X 放到设备 Y 上”这类请求的更复杂模型则在服务器上运行。或者,在用户移动设备上的部署可以为视频实时添加简单的智能效果,而服务器部署则用于应用更复杂的效果,如稳定化和超分辨率(super-resolution)。
1 截至 2020 年 7 月。
8.3.4 模型流式部署
模型流式部署(model streaming)是一种部署模式,可以看作是 REST API 的逆过程。在 REST API 中,客户端向服务器发送请求,然后等待响应(预测)。
在复杂系统中,可能有多个模型应用于同一个输入。或者,一个模型的输入可能是另一个模型的预测。例如,输入可以是一篇新闻文章。一个模型可以预测文章的主题,另一个模型可以提取命名实体(named entity),第三个模型可以生成文章的摘要,等等。
按照 REST API 部署模式,每个模型需要一个 REST API。客户端调用一个 API,在请求中发送新闻文章,得到主题作为响应。然后客户端调用另一个 API,发送新闻文章,得到命名实体作为响应;依此类推。
流式处理的工作方式不同。不是每个模型一个 REST API,而是所有模型以及运行它们所需的代码都注册在流处理引擎(stream-processing engine,SPE)内。例如 Apache Storm、Apache Spark 和 Apache Flink。或者,它们被打包为基于流处理库(stream-processing library,SPL)的应用,例如 Apache Samza、Apache Kafka Streams 和 Akka Streams。
这些 SPE 和 SPL 的描述超出了本书的范围,但它们都有一个共同的性质,使它们不同于基于 REST API 的应用。在每个流处理应用中,都有一个显式或隐式的数据处理拓扑(data processing topology)概念。输入数据以客户端发送的无限数据元素流的形式流入。按照预定义的拓扑,流中的每个数据元素在拓扑的节点中经历变换。变换后,数据流继续流向其他节点。
在流处理应用中,节点以某种方式变换它们的输入,然后:
- 把输出发送给其他节点,或
- 把输出发送给客户端,或
- 把输出持久化到数据库或文件系统。
一个节点可以接收新闻文章并预测其主题;另一个节点可以同时接收新闻文章和预测出的主题并生成摘要;依此类推。
基于 REST API 的应用与基于流处理的应用之间的区别如图 4 所示。图 4a 显示客户端使用 REST API,通过发送一系列请求来处理一个数据元素(如一篇新闻文章)。各种 REST API 逐个接收请求并同步生成响应。另一方面,使用流式处理的客户端(图 4b)打开一个到流处理应用的连接,发送一个请求,并在更新事件发生时接收它们。
图 4:REST API 与流式处理的区别:(a) 要处理一个数据元素,使用 REST API 的客户端发送一系列请求,一个接一个,并同步接收响应;(b) 要处理一个数据元素,使用流式处理的客户端打开一个连接,发送一个请求,并在事件发生时接收更新事件。
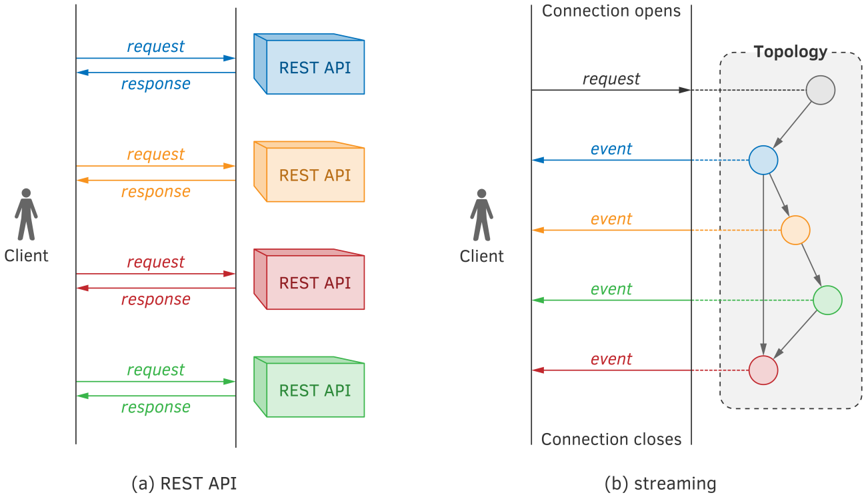
在图 4b 的流式处理应用的右侧,有一个定义应用中数据流的拓扑。客户端发送的每个输入元素都会经过拓扑图(topology graph)的所有节点。节点可以向客户端发送更新事件,和/或把数据持久化到数据库或文件系统。
基于 SPE 的流式处理应用运行在自己专用的虚拟或物理机器集群上,并负责在可用资源之间分配数据处理负载。基于 SPL 的流式处理应用不需要专用的数据处理集群。它可以与现有资源集成,如虚拟或物理机器,或容器编排器(如 Kubernetes)。
REST API 通常用于让客户端发送不遵循某种频繁重复模式的临时(ad-hoc)请求。当客户端希望自由决定如何处理 API 响应时,它是最佳选择。另一方面,如果客户端的每个请求:
- 是典型的,
- 经历某种固定的变换模式,尤其是多个中间变换,且
- 总是导致相同的动作,例如把特定数据元素持久化到文件系统或数据库,
那么基于流处理的应用能提供更好的资源效率、更低的延迟、安全性和容错性。
8.4 部署策略
典型的部署策略有:
- 单一部署(single deployment),
- 静默部署(silent deployment),
- 金丝雀部署(canary deployment),以及
- 多臂老虎机(multi-armed bandit)。
让我们逐一讨论。
8.4.1 单一部署
单一部署是最简单的。概念上,一旦你有了新模型,就把它序列化到一个文件中,然后用新文件替换旧文件。如果需要,也替换特征提取器。
要在云环境中部署到服务器,你要准备一台运行新版本模型的新虚拟机或容器。然后替换虚拟机镜像或容器镜像。最后,逐步关闭旧机器或容器,让自动伸缩器启动新的。
要在物理服务器上部署,你要把新的模型文件(以及需要的特征提取对象)上传到服务器。然后用新版本替换旧文件和旧代码,并重启 Web 服务。
要在用户设备上部署,你把新的模型文件连同任何需要的特征提取对象推送到用户设备,并重启软件。
如果你使用可解释的代码,可以通过用一个源代码文件替换另一个来部署特征提取器对象。为了避免重新部署整个软件应用(无论是在服务器上还是在用户设备上),可以把特征提取器对象序列化到一个文件中。然后,每次启动时,运行模型的软件都会反序列化特征提取器对象。
单一部署的优点是很简单;然而,它也是风险最大的策略。如果新模型或特征提取器包含 bug,所有用户都会受到影响。
8.4.2 静默部署
单一部署的对应物是静默部署。它部署新版本的模型和新的特征提取器,同时保留旧的。两个版本并行运行。然而,在切换完成之前,用户不会接触到新版本。新版本做出的预测只被记录下来。过一段时间后,对它们进行分析以检测可能的 bug。
静默部署的好处是提供了足够的时间来确保新模型按预期工作,而不会对任何用户产生不利影响。缺点是运行两倍的模型会消耗更多资源。此外,对许多应用来说,不把新模型的预测暴露给用户就无法评估它。
8.4.3 金丝雀部署
回想一下,金丝雀部署(canary deployment,或 canarying)把新版本的模型和代码推送给一小部分用户,同时让旧版本继续为大多数用户运行。与静默部署相反,金丝雀部署可以验证新模型的性能及其预测的效果。与单一部署相反,金丝雀部署在可能出现 bug 时不会影响大量用户。
选择金丝雀部署,你就接受了同时维护和运行多个模型版本带来的额外复杂性。
金丝雀部署的一个明显缺点是工程师不可能发现罕见错误。如果你把新版本部署给 5% 的用户,而某个 bug 影响 2% 的用户,那么你只有 0.1% 的机会发现这个 bug。
8.4.4 多臂老虎机
如第 7 章所述,多臂老虎机(multi-armed bandit,MAB)是一种在生产环境中比较模型的一个或多个版本、并选出表现最佳版本的方法。MAB 有一个有趣的性质:在最初的探索期之后(在此期间 MAB 算法收集足够的证据来评估每个模型(臂)的性能),最佳的臂最终会被一直使用。这意味着在 MAB 算法收敛之后,大多数时候所有用户都会被路由到运行最佳模型的软件版本。
因此,MAB 算法同时解决了两个问题——在线模型评估和模型部署。
8.5 自动化部署、版本管理与元数据
模型是重要的资产,但它从不单独交付。生产模型测试还有额外的资产,以确保模型没有被破坏。
8.5.1 模型的伴随资产
只有在模型附带以下资产时才将其部署到生产环境:
- 一个端到端测试集(end-to-end test set),它定义了必须始终有效的模型输入和输出;
- 一个置信测试集(confidence test set),它正确定义了模型输入和输出,并用于计算指标值;
- 一个性能指标(performance metric),其值通过在置信测试集上应用模型来计算;以及
- 性能指标可接受值的范围。
一旦使用该模型的系统首次在服务器或客户端设备实例上被调用,外部进程必须用端到端测试数据调用模型,并验证所有预测都是正确的。此外,同一个外部进程必须验证:把模型应用于置信测试集计算出的性能指标值在可接受值范围内。如果两项评估中任何一项失败,模型就不应该被提供给客户端。
8.5.2 版本同步
以下三个元素的版本必须始终同步:
- 训练数据(training data),
- 特征提取器(feature extractor),以及
- 模型(model)。
对数据的每次更新都必须在数据仓库(data repository)中产生一个新版本。使用特定版本的数据训练的模型,必须放入模型仓库(model repository),版本号与用于训练该模型的数据版本号相同。
如果特征提取器没有改变,它的版本仍然必须更新,以与数据和模型保持同步。如果特征提取器更新了,那么必须使用更新后的特征提取器构建新模型,并且特征提取器、模型和训练数据的版本都要递增(即使训练数据没有变化)。
新模型版本的部署必须由脚本以事务(transactional)方式自动化。给定要部署的模型版本,部署脚本会从相应的仓库中获取模型和特征提取对象,并把它们复制到生产环境。必须通过模拟来自外部的一次常规调用来对端到端和置信测试数据应用模型。如果端到端测试数据出现预测错误,或者指标值不在可接受值范围内,则必须回滚整个部署。
8.5.3 模型版本元数据
每个模型版本都必须附带以下代码和元数据:
- 用于训练模型的库或软件包的名称和版本;
- 如果使用 Python 构建模型,则提供用于构建模型的虚拟环境的 requirements.txt(或者,提供指向 Docker Hub 或你的 Docker 注册表中特定路径的 Docker 镜像名称);
- 学习算法的名称,以及超参数(hyperparameter)的名称和值;
- 模型所需的特征列表;
- 输出的列表、它们的类型,以及输出应该如何被消费;
- 用于训练模型的数据的版本和位置;
- 用于调整模型超参数的验证数据的版本和位置;以及
- 在新数据上运行模型并输出预测的模型评分代码。
元数据和评分代码可以保存到数据库或 JSON/XML 文本文件中。
出于审计目的,每次部署还必须附带以下信息:
- 谁构建了模型,以及何时构建;
- 谁在何时决定部署该模型,以及基于什么理由;
- 谁出于隐私和安全合规目的审查了模型。
8.6 模型部署最佳实践
在本节中,我们讨论在生产中部署机器学习系统的实际方面。我们还概述了几个有用且实用的模型部署技巧。
8.6.1 算法效率
大多数数据分析师使用 Python 或 R。虽然有允许用这两种语言构建 Web 服务的 Web 框架,但它们不被认为是最高效的语言。
事实上,当你在 Python 中使用科学软件包时,它们的许多代码是用高效的 C 或 C++ 编写的,然后针对你的特定操作系统编译。然而,你自己写的数据预处理、特征提取和评分代码可能没那么高效。
此外,并非所有算法都是实用的。有些算法可以快速解决问题,有些则太慢。对某些问题来说,不存在快速算法。
计算机科学中称为算法分析(analysis of algorithms)的子领域致力于确定和比较算法的复杂度。大 O 表示法(big O notation)用于根据算法的运行时间或空间需求随输入规模增长的方式对算法进行分类。
例如,假设我们有一个问题:在规模为 N 的示例集 S 中找出距离最远的两个一维示例。我们可以编写一个 Python 算法,看起来像这样:
def find_max_distance(S):
    result = None
    max_distance = 0
    for x1 in S:
        for x2 in S:
            if abs(x1 - x2) >= max_distance:
                max_distance = abs(x1 - x2)
                result = (x1, x2)
    return result
或者,用 R 这样写:
find_max_distance <- function(S) {
    result <- NULL
    max_distance <- 0
    for (x1 in S) {
        for (x2 in S) {
            if (abs(x1 - x2) >= max_distance) {
                max_distance <- abs(x1 - x2)
                result <- c(x1, x2)
            }
        }
    }
    result
}
在上述算法中,我们遍历 S 中的所有值,并且在第一个循环的每次迭代中,我们再次遍历 S 中的所有值。因此,上述算法进行 \(N^2\) 次数值比较。如果我们把比较、abs 和赋值操作所花的时间作为单位时间,那么这个算法的时间复杂度(或简称为复杂度)至多是 \(5N^2\)。在每次迭代中,我们有 1 次比较、2 次 abs 和 2 次赋值操作(1 + 2 + 2 = 5)。当算法复杂度按最坏情况衡量时,使用大 O 表示法。对上述算法,用大 O 表示法,我们说算法的复杂度是 \(O(N^2)\);像 5 这样的常数被忽略。
对于同一个问题,我们可以编写另一个 Python 算法,像这样:
def find_max_distance(S):
    result = None
    min_x = float("inf")
    max_x = float("-inf")
    for x in S:
        if x < min_x:
            min_x = x
        if x > max_x:
            max_x = x
    result = (max_x, min_x)
    return result
或者,用 R 这样写:
find_max_distance <- function(S) {
    result <- NULL
    min_x <- Inf
    max_x <- -Inf
    for (x in S) {
        if (x < min_x) {
            min_x <- x
        }
        if (x > max_x) {
            max_x <- x
        }
    }
    result <- c(max_x, min_x)
    result
}
在上述算法中,我们只遍历 S 中的所有值一次,因此算法的复杂度是 \(O(N)\)。在这种情况下,我们说后一个算法比前一个更高效。
当一个算法的复杂度是输入规模的多项式时,就称该算法是高效的。因此 \(O(N)\) 和 \(O(N^2)\) 都是高效的,因为 \(N\) 是 1 次多项式,而 \(N^2\) 是 2 次多项式。然而,对于非常大的输入,\(O(N^2)\) 算法仍然可能很慢。在大数据时代,科学家和工程师经常寻找 \(O(\log N)\) 的算法。
从实践的角度来看,在实现算法时,你应该尽可能避免使用循环,并使用 NumPy 或类似工具实现向量化(vectorization)。例如,你应该使用矩阵和向量运算,而不是循环。在 Python 中,要计算 \(w \cdot x\)(两个向量的点积),你应该输入:
import numpy
wx = numpy.dot(w, x)
而不是:
wx = 0
for i in range(N):
    wx += w[i]*x[i]
同样,在 R 中,你应该输入:
wx = w %*% x
而不是:
wx <- 0
for (i in seq(N)):
    wx <- wx + w[i]*x[i]
使用合适的数据结构。如果集合中元素的顺序无关紧要,使用 set 而不是 list。在 Python 中,当 S 是 set 时,验证特定示例是否属于 S 的操作很快,而当 S 是 list 时则很慢。
另一个让你的 Python 代码更高效的重要数据结构是 dict。在其他语言中它被称为字典(dictionary)或哈希表(hash table)。它允许你定义键值对集合,并且对键的查找非常快。
使用库通常更可靠——你应该只在做研究或确实需要时才编写自己的代码。NumPy、SciPy 和 scikit-learn 等科学 Python 软件包是由经验丰富的科学家和工程师以提高效率为出发点构建的。它们有许多方法是用 C 和 C++ 编译实现的,以获得最大性能。
如果你需要遍历一个庞大的元素集合,使用 Python 生成器(generator)(或 R 中 iterators 包的对应物),它创建一个一次只返回一个元素的函数,而不是一次返回所有元素。
使用 Python 中的 cProfile 包(或 R 中的对应物 lineprof)来发现代码中的低效之处。
最后,当你的代码从算法角度已无可改进时,你可以通过以下方式进一步提高速度:
- 使用 Python 中的 multiprocessing 包(或 R 中的对应物 parallel)并行运行计算;或使用分布式处理框架,如 Apache Spark;以及
- 使用 PyPy、Numba 或类似工具把你的 Python 代码编译成快速、优化的机器码(或使用 R 的 compiler 包)。
8.6.2 深度模型的部署
有时,要达到所需的速度,可能需要在图形处理单元(GPU)上进行评分。云环境中 GPU 实例的成本通常远高于“普通”实例。因此,只有模型可以部署在一个配备一个或多个 GPU、为快速评分而优化的环境中。应用的其余部分可以单独部署在 CPU 环境中。这种方法可以降低成本,但同时可能会增加应用两部分之间的通信开销。
8.6.3 缓存
缓存(caching)是软件工程中的标准做法。内存缓存用于存储函数调用的结果,这样下次以相同的参数值调用该函数时,可以直接从缓存读取结果。
当应用包含耗费资源、需要时间处理、或经常以相同参数值被调用的函数时,缓存有助于加速应用。在机器学习中,这种耗费资源的函数就是模型,尤其是当它们在 GPU 上运行时。
最简单的缓存可以在应用本身中实现。例如,在 Python 中,lru_cache 装饰器可以用一个记忆化(memoizing)可调用对象包装函数,该对象保存最近最多 maxsize 次调用:
from functools import lru_cache

# Read the model from file
model = pickle.load(open("model_file.pkl", "rb"))

@lru_cache(maxsize=500)
def run_model(input_example):
    return model.predict(input_example)

# Now you can call run_model
# on new data
第一次以某个输入调用函数 run_model 时,会调用 model.predict。之后以相同输入值再次调用 run_model 时,输出将从缓存中读取,该缓存记住了 model.predict 最近最多 maxsize 次调用的结果。
在 R 中,可以使用 memo 函数获得类似的结果:
library(memo)

model <- readRDS("./model_file.rds")

run_model <- function(input_example) {
    result <- predict(model, input_example)
    result
}

# Create a memoized version of run_model
run_model_memo <- memo(run_model, cache = lru_cache(500))

# Now you can use run_model_memo
# instead of run_model on new data
虽然使用 lru_cache 及类似方法对分析师来说非常方便,但在大规模生产系统中,工程师通常会使用 Redis 或 Memcached 等通用的、可伸缩、可配置的缓存解决方案。
8.6.4 模型与代码的交付格式
回想一下,序列化(serialization)是把模型和特征提取器代码交付到生产环境的最直接方式。
每种现代编程语言都有序列化工具。在 Python 中,它是 pickle:
import pickle
from sklearn import svm, datasets

classifier = svm.SVC()
X, y = datasets.load_iris(return_X_y=True)
classifier.fit(X, y)

# Save model to file
with open("model.pickle", "wb") as outfile:
    pickle.dump(classifier, outfile)

# Read model from file
classifier2 = None
with open("model.pickle", "rb") as infile:
    classifier2 = pickle.load(infile)
if classifier2:
    prediction = classifier2.predict(X[0:1])
而在 R 中,是 RDS:
library("e1071")

classifier <- svm(Species ~ ., data = iris, kernel = 'linear')

# Save model to file
saveRDS(classifier, "./model.rds")

# Read model from file
classifier2 <- readRDS("./model.rds")

prediction <- predict(classifier2, iris[1,])
在 scikit-learn 中,对于携带大型 NumPy 数组的对象,使用 joblib 可能更好(它是 pickle 的替代品,效率更高):
from joblib import dump, load

# Save model to file
dump(classifier, "model.joblib")

# Read model from file
classifier2 = load("model.joblib")
同样的方法也可以用来把特征提取器的序列化对象保存到文件中,复制到生产环境,然后从文件中读取。
对于某些应用来说,预测速度至关重要。在这种情况下,生产代码用编译语言编写,如 Java 或 C/C++。如果数据分析师用 Python 或 R 构建了模型,有三种生产部署选项:
- 用编译的、面向生产环境的编程语言重写代码;
- 使用模型表示标准,如 PMML 或 PFA;或
- 使用专门的执行引擎,如 MLeap。
预测模型标记语言(Predictive Model Markup Language,PMML)是一种基于 XML 的预测模型交换格式,它让数据分析师可以在符合 PMML 的应用之间保存和共享模型。PMML 允许分析师在一个供应商的应用中开发模型,然后在其他供应商的应用中使用它们,这样专有问题和兼容性问题不再成为应用之间模型交换的障碍。
例如,假设你用 Python 构建了一个 SVM 模型,然后把模型保存为 PMML 文件。假设生产运行时环境是 Java 虚拟机(Java Virtual Machine,JVM)。只要 JVM 的机器学习库支持 PMML,并且该库有 SVM 的实现,你的模型就可以直接在生产中使用。你不需要用 JVM 语言重写代码或重新训练模型。
可移植分析格式(Portable Format for Analytics,PFA)是一种更新的标准,用于表示统计模型和数据变换引擎。PFA 让我们可以轻松地在异构系统之间共享模型和机器学习流水线,并提供算法灵活性。模型、预处理和后处理变换都是函数,可以任意组合、链接或构建成复杂的工作流。PFA 采用 JavaScript 对象表示法(JSON)或 YAML(YAML Ain’t Markup Language,YAML 不是标记语言)配置文件的形式。
有一些开源的通用“求值器”(evaluator),用于求值保存为 PMML 或 PFA 格式文件的模型或流水线。JPMML(用于 Java 的 PMML)和 Hadrian 是采用最广泛的两个。求值器从文件中读取模型或流水线,通过把它应用于输入数据来执行它,并输出预测。
遗憾的是,PMML 和 PFA 并没有被流行的机器学习库和框架广泛支持 2。例如,scikit-learn 不支持这些标准,尽管 SkLearn2PMML 等辅助项目可以把 scikit-learn 对象转换为 PMML。
2 截至 2020 年 7 月。
另外,MLeap 等执行引擎可以在 JVM 环境中快速执行机器学习模型和流水线。在本书写作时,MLeap 可以执行在 Apache Spark 和 scikit-learn 中创建的模型和流水线。
现在,让我们简要概述几个有用且实用的模型部署技巧。
8.6.5 从简单模型开始
在生产中部署和应用模型可能比看起来更复杂。一旦服务简单模型的基础设施稳固了,就可以训练和部署更复杂的模型。
简单的可解释(interpretable)模型更容易调试,尤其是特征提取器和整个机器学习流水线。复杂的模型和流水线有很多依赖和大量需要调优的超参数,更容易出现实现和部署错误。
8.6.6 在外部人员身上测试
在把模型投入生产之前,要在外部人员身上测试模型,而不仅仅是在测试数据上。外部人员可以是其他团队成员或公司员工。或者,你可以使用众包(crowdsourcing),或同意参与新产品功能实验的一部分真实客户。
在外部人员身上测试有助于你避免个人偏见,因为作为模型的创建者,你情感上投入其中。它也会让模型接触到不同的用户(例如,当你的整个团队都是男性或白人时)。
8.7 小结
模型可以按照以下几种模式进行部署:静态部署,作为可安装软件的一部分;在用户设备上动态部署;在服务器上动态部署;或通过模型流式部署。
静态部署有很多优点,如执行时间快、保护用户隐私、用户离线时也能调用模型。也有缺点:在不升级整个应用的情况下升级模型更困难。
在用户设备上动态部署的主要优点是,对用户来说,调用模型会很快。它还减轻了组织服务器的负担。缺点包括难以向所有用户交付更新,以及模型容易被第三方分析。
与静态部署一样,把模型部署在用户设备上会使监控模型性能变得困难。
服务器上的动态部署可以有以下形式之一:在虚拟机上部署、在容器中部署、无服务器部署。
最流行的部署模式是把模型部署在服务器上,并以 Web 或 gRPC 服务形式的 REST API 提供。在这里,客户端向服务器发送一个请求,然后在发送另一个请求之前等待响应。
模型流式部署则不同。所有模型都注册在流处理引擎中,或打包为基于流处理库的应用。在这里,客户端发送一个请求,并在事件发生时接收更新。
典型的部署策略是单一部署、静默部署、金丝雀部署和多臂老虎机。
在单一部署中,你把新模型序列化到一个文件中,然后替换旧模型。
静默部署包括部署旧版本和新版本,并让它们并行运行。在切换完成之前,用户不会接触到新版本。新版本做出的预测只被记录和分析。因此,有足够的时间确保新模型按预期工作而不影响任何用户。缺点是运行更多的模型会消耗更多资源。
金丝雀部署包括把新版本推送给一小部分用户,同时让旧版本继续为大多数用户运行。金丝雀部署允许验证模型性能并评估用户体验。在可能出现 bug 时,它不会影响大量用户。
多臂老虎机允许我们在保留旧模型的同时部署新模型。只有当算法确信新模型表现更好时,它才会用新模型替换旧模型。
新模型版本的部署必须由脚本以事务方式自动化。给定要部署的模型版本,部署脚本会从相应的仓库中获取模型和特征提取对象,并把它们复制到生产环境。必须通过模拟来自外部的一次常规调用来对端到端和置信测试数据应用模型。如果端到端测试数据出现预测错误,或者指标值不在可接受值范围内,则必须回滚整个部署。
训练数据、特征提取器和模型的版本必须始终保持同步。
算法效率是模型部署中的一个重要考量。经验丰富的科学家和工程师构建的 NumPy、SciPy 和 scikit-learn 等 Python 软件包以提高效率为出发点。你自己的代码可能没那么可靠或高效。你应该只在绝对必要时才编写自己的代码。
如果你实现自己的算法代码,避免使用循环。使用 NumPy 或类似工具实现向量化。使用合适的数据结构。如果集合中元素的顺序无关紧要,使用 set 而不是 list。使用字典(或哈希表)可以让你定义键值对集合,对键的查找非常快。
当应用包含经常以相同参数值调用的耗费资源的函数时,缓存可以加速应用。在机器学习中,这种耗费资源的函数就是模型,尤其是当它们在 GPU 上运行时。