模型评估
统计模型在现代组织中扮演着越来越重要的角色。当应用于业务场景时,模型可能会影响组织的财务指标。然而,它也可能带来责任风险。因此,任何在生产环境中运行的模型都必须被仔细且持续地评估。
模型评估(model evaluation)是机器学习项目生命周期的第五个阶段:
图 1:机器学习项目生命周期。
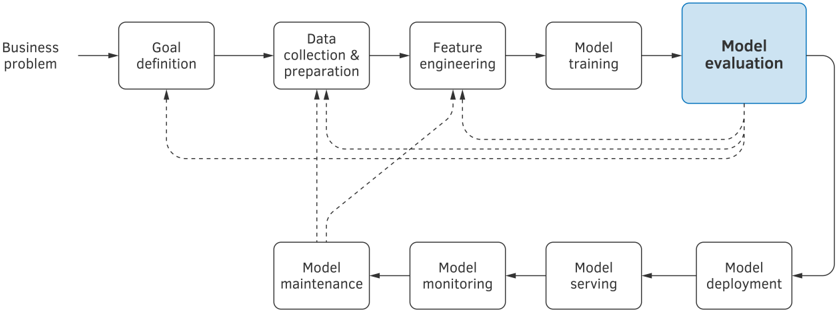
根据模型的应用领域以及组织的业务目标和约束,模型评估可能包括以下任务:
- 评估将模型投入生产可能带来的法律风险。例如,某些模型预测可能间接传达机密信息。网络攻击者或竞争对手可能试图对模型的训练数据进行逆向工程。此外,当用于预测时,某些特征(如年龄、性别或种族)可能导致组织被认为存在偏见甚至歧视。
- 研究训练数据与生产数据分布的主要性质。通过比较训练数据和生产数据中示例、特征和标签的统计分布,可以检测出分布偏移(distribution shift)。两者之间的显著差异表明需要更新训练数据并重新训练模型。
- 评估模型的性能。在模型部署到生产环境之前,必须在其外部数据(即未用于训练的数据)上评估其预测性能。外部数据必须同时包含来自生产环境的历史示例和在线示例。在实时在线数据上进行评估的上下文应尽可能接近生产环境。
- 监控已部署模型的性能。模型的性能可能随时间下降。能够检测到这一点,并通过添加新数据升级模型或训练一个完全不同的模型,这一点非常重要。模型监控必须是一个精心设计的自动化过程,并且可能包含人在回路(human in the loop)。我们将在第9章中更详细地讨论这一点。
在本章中,我们来看一些统计学家在模型评估阶段使用的技巧示例。机器学习工程是一门发展中的学科,有些问题仍然没有既成熟又易于应用的答案。特别是,本评估是从工程师的角度呈现的,而每个业务都有自己的成功标准,这些标准是独一无二的。在评估机器学习解决方案之前,非常重要的一点是确保合适的人已经完成了项目中最困难的工作:弄清楚成功是什么样的,以及以适合业务的形式(指标和目标)该问哪些正确的问题。
一个常见的失败原因是工程师用基本工具回答方便的问题,而不是用定制工具回答正确的问题——这可能需要在你项目的领导者和利益相关者完成他们在项目中的部分之后咨询专业统计学家。请注意,本章中强调的一些方法,特别是用于 A/B 测试(7.2 节)的方法,仅作为示例提供,可能不适用于你的特定业务问题。在重要的大型项目上,试图自己做所有事情是一个错误。及时与你的领导团队协作并咨询统计学家至关重要。
7.1 离线与在线评估
在第 ? 节中,我们概述了应用于所谓离线模型评估(offline model evaluation)的评估技术。离线模型评估发生在分析人员训练模型时。分析人员尝试不同的特征、模型、算法和超参数。诸如混淆矩阵(confusion matrix)和各种性能指标(如精确率(precision)、召回率(recall)和 AUC)之类的工具,允许比较候选模型,并引导模型训练朝着正确的方向进行。
首先,使用验证数据(validation data)来评估所选的性能指标并比较模型。一旦确定了最佳模型,就使用测试集(test set),也以离线模式,再次评估最佳模型的性能。这最终的离线评估保证了部署后的模型性能。在本章中,除其他主题外,我们将讨论为模型的离线测试性能建立统计界限(statistical bounds)。
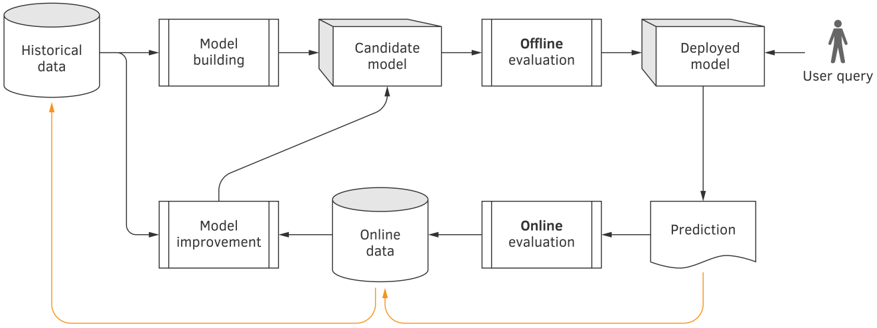
本章的很大一部分专门讨论在线模型评估(online model evaluation),即使用在线数据在生产环境中测试和比较模型。离线与在线模型评估之间的区别,以及每种评估类型在机器学习系统中的位置,如图 2 所示。
在图 2 中,历史数据首先用于训练一个部署候选(deployment candidate)。然后对其进行离线评估,如果结果令人满意,部署候选就成为已部署模型(deployed model),并开始接受用户查询。然后,用户查询和模型预测用于模型的在线评估。在线数据随后用于改进模型。为了闭合循环,在线数据会被永久复制到离线数据仓库中。
图 2:离线与在线模型评估在机器学习系统中的位置。
为什么我们要同时进行离线评估和在线评估?离线模型评估反映了分析人员在找到正确的特征、学习算法、模型和超参数值方面取得了多大成功。换句话说,离线模型评估反映了模型从工程角度来看有多好。
另一方面,在线评估侧重于衡量业务成果,例如客户满意度、平均在线时长、打开率和点击率。这些信息可能不会反映在历史数据中,但这是业务真正关心的。此外,离线评估不允许我们在某些只能在线上观察到的条件下测试模型,例如连接和数据丢失以及调用延迟。
只有在数据分布随时间保持不变的情况下,在历史数据上获得的性能结果在部署后才会保持有效。然而,在实践中,情况并非总是如此。分布偏移的典型示例包括移动或在线应用程序用户不断变化的兴趣、金融市场的不稳定性、气候变化,或者模型旨在预测其属性的机械系统的磨损。
因此,模型一旦部署到生产环境就必须持续监控。当发生分布偏移时,必须用新数据更新模型并重新部署。进行此类监控的一种方法是比较模型在在线数据和历史数据上的性能。如果在线数据上的性能与历史数据相比显著变差,就该重新训练模型了。
在线评估有不同形式,每种形式服务于不同的目的。例如,运行时监控(runtime monitoring)是检查正在运行的系统是否满足运行时要求。
另一个常见场景是监控用户对不同版本模型的响应行为。此场景中使用的一种流行技术是 A/B 测试(A/B testing)。我们将系统用户分成两组:A 和 B。两组分别被提供服务的是旧模型和新模型。然后我们应用统计显著性检验来决定新模型的性能是否优于旧模型。
多臂老虎机(multi-armed bandit,MAB)是另一种流行的在线模型评估技术。与 A/B 测试类似,它通过将模型候选暴露给一小部分用户来识别性能最佳的模型。然后,它逐渐将最佳模型暴露给更多用户,同时持续收集性能统计数据,直到其可靠为止。
7.2 A/B 测试
A/B 测试是最常用的统计技术之一。当应用于在线模型评估时,它使我们能够回答诸如「新模型 \(m_B\) 在生产环境中是否比现有模型 \(m_A\) 表现得更好?」或「两个模型候选中哪一个在生产环境中表现得更好?」之类的问题。
A/B 测试经常用于网站和移动应用程序,以测试设计或文案中的特定更改是否会对业务指标(如用户参与度、点击率或销售率)产生积极影响。
想象我们想要决定是否用新模型替换生产环境中现有的(旧)模型。包含模型输入数据的实时流量被分成两个不相交的组:A(对照组,control)和 B(实验组,experiment)。A 组流量被路由到旧模型,而 B 组流量被路由到新模型。
通过比较两个模型的性能,就新模型是否比旧模型表现更好做出决定。性能使用统计假设检验(statistical hypothesis testing)进行比较。
一般来说,统计假设检验维护一个零假设(null hypothesis)和一个备择假设(alternative hypothesis)。A/B 测试通常被构建为回答以下问题:「新模型是否导致该特定业务指标发生统计显著的变化?」零假设声明新模型不会改变业务指标的平均值。备择假设声明新模型会改变指标的平均值。
A/B 测试不是单一测试,而是一族测试。根据业务性能指标的不同,使用不同的统计工具集。然而,将用户分成两组并测量不同组之间指标值差异的统计显著性的原则保持不变。
描述 A/B 测试的所有形式超出了本书的范围。这里我们只考虑两种形式,但它们适用于广泛的实际场景。
7.2.1 G 检验
A/B 测试的第一种形式基于 G 检验(G-test)。它适用于统计「是」或「否」问题答案的指标。G 检验的一个优点是,只要只有两个可能的答案,你就可以问任何问题。问题示例:
- 用户是否购买了推荐的文章?
- 用户在一个月内是否花费超过 50 美元?
- 用户是否续订了订阅?
让我们看看如何应用它。我们想决定新模型是否比旧模型工作得更好。为此,我们构建一个定义我们指标的是/否问题。然后我们将用户随机分成 A 组和 B 组。A 组的用户被路由到运行旧模型的环境,而 B 组的流量被路由到新模型。观察每个用户的行为,并将答案记录为「是」或「否」。填写下表:
图 3:A 组和 B 组用户对是/否问题的答案计数。
| 是 | 否 | |
|---|---|---|
| A | ||
| B |
在上表中,\(\hat{a}_{\text{yes}}\) 是 A 组中问题答案为「是」的用户数,\(\hat{b}_{\text{yes}}\) 是 B 组中问题答案为「是」的用户数,\(\hat{a}_{\text{no}}\) 是 A 组中问题答案为「否」的用户数,以此类推。类似地,\(n_{\text{yes}} = \hat{a}_{\text{yes}} + \hat{b}_{\text{yes}}\),\(n_{\text{no}} = \hat{a}_{\text{no}} + \hat{b}_{\text{no}}\),\(n_a = \hat{a}_{\text{yes}} + \hat{a}_{\text{no}}\),\(n_b = \hat{b}_{\text{yes}} + \hat{b}_{\text{no}}\),最后 \(n_{\text{total}} = n_{\text{yes}} + n_{\text{no}} = n_a + n_b\)。
现在,求出 A 和 B 的「是」和「否」答案的期望数量,即如果版本 A 和 B 等价,我们会得到的「是」和「否」的数量。
\[ \hat{a}_{\text{yes}}' = \frac{n_a \cdot n_{\text{yes}}}{n_{\text{total}}}, \quad \hat{a}_{\text{no}}' = \frac{n_a \cdot n_{\text{no}}}{n_{\text{total}}}, \quad \hat{b}_{\text{yes}}' = \frac{n_b \cdot n_{\text{yes}}}{n_{\text{total}}}, \quad \hat{b}_{\text{no}}' = \frac{n_b \cdot n_{\text{no}}}{n_{\text{total}}} \]现在,如下求出 G 检验的值:¹
\[ G = 2 \left( \hat{a}_{\text{yes}} \ln \frac{\hat{a}_{\text{yes}}}{\hat{a}_{\text{yes}}'} + \hat{a}_{\text{no}} \ln \frac{\hat{a}_{\text{no}}}{\hat{a}_{\text{no}}'} + \hat{b}_{\text{yes}} \ln \frac{\hat{b}_{\text{yes}}}{\hat{b}_{\text{yes}}'} + \hat{b}_{\text{no}} \ln \frac{\hat{b}_{\text{no}}}{\hat{b}_{\text{no}}'} \right) \]G 是衡量 A 和 B 的样本有多不同的度量。从统计上讲,在零假设(A 和 B 相等)下,G 服从自由度为 1 的卡方分布(chi-square distribution):
\[ G \sim \chi^2_1 \]换句话说,如果 A 和 B 相等,我们预期 G 很小。G 的较大值会让我们怀疑其中一个模型比另一个表现更好。例如,假设你计算出 \(G = 3.84\)。如果 A 和 B 相等(即在零假设下),观察到 \(G \geq 3.84\) 的概率约为 5%。我们通常将这个概率称为 p 值(p-value)。
如果 p 值足够小(例如,低于 0.05),那么新旧模型的性能很可能不同(零假设被拒绝)。在这种情况下,如果 \(\hat{b}_{\text{yes}}\) 高于 \(\hat{a}_{\text{yes}}\),那么新模型很可能比旧模型工作得更好;否则,旧模型更好。
如果与 G 值对应的 p 值不够小,那么新旧模型之间观察到的性能差异不具有统计显著性,你可以继续在生产环境中保留旧模型。
使用你选择的编程语言来查找 G 检验的 p 值很方便。在 Python 中,可以这样做:
from scipy.stats import chi2

def get_p_value(G):
    p_value = 1 - chi2.cdf(G, 1)
    return p_value
以下代码适用于 R:
get_p_value <- function(G) {
    p_value <- pchisq(G, df=1, lower.tail=FALSE)
    return(p_value)
}
从统计上讲,如果每组中至少有 10 个「是」和「否」结果,G 检验的结果就是有效的,不过这个估计应该谨慎对待。如果测试成本不太高,那么每组中大约有 1000 个「是」和「否」结果,且每组中每种答案至少有 100 个,应该就足够了。请注意,两组中的答案总数可以不同。
¹ 上述公式的详细推导可参见统计学教科书或维基百科。
如果你无法以合理的成本在每个组中达到每种答案至少 100 个,你可以使用蒙特卡洛模拟(Monte-Carlo simulation)来近似一个非常相似测试的 p 值。
以下代码适用于 R:
p_value <- chisq.test(x, simulate.p.value = TRUE)$p.value
其中 x 是图 3 所示的 2 × 2 列联表(contingency table)。
请注意,可以测试两个以上的模型(例如模型 A、B 和 C),也可以测试定义我们指标的问题的两个以上可能答案(例如「是」、「否」、「也许」)。如果我们想测试 k 个不同模型和 l 个不同可能答案,G 统计量将服从自由度为 \((k-1) \times (l-1)\) 的卡方分布。这里的问题是,具有多个模型和答案的测试会告诉你你的模型之间是否存在某些差异,但它不会告诉你差异在哪里。在实践中,更容易的做法是只将当前模型与一个新模型进行比较,并构建一个具有二元答案的问题指标。更复杂的实验测试超出了本书的范围。
请注意,当我们有两个以上的模型时,使用为比较两个模型而设计的测试对模型对进行二元比较可能很有诱惑力。然而,不推荐这样做,因为这在科学上可能是错误的。最好咨询统计学家。
7.2.2 Z 检验
A/B 测试的第二种形式适用于对每个用户的问题是「多少?」或「多少量?」(与上一小节中考虑的是/否问题相反)的情况。问题示例包括:
- 用户在一次会话中在网站上花费了多少时间?
- 用户在一个月内花了多少钱?
- 用户在一周内阅读了多少篇新闻文章?
为了简化说明,让我们测量用户在我们部署模型的网站上花费的时间。像往常一样,用户被路由到网站的两个版本 A 和 B,其中版本 A 提供旧模型服务,版本 B 提供新模型服务。零假设是两个版本的用户平均花费相同的时间。备择假设是他们在网站 B 上花费的时间比在网站 A 上多。设 \(n_A\) 为路由到版本 A 的用户数,\(n_B\) 为路由到版本 B 的用户数。设 i 和 j 分别表示来自 A 组和 B 组的用户。
为了计算 Z 检验的值,我们首先计算 A 和 B 的样本均值(sample mean)和样本方差(sample variance)。样本均值由下式给出:
\[ \bar{a} = \frac{1}{n_A} \sum_{i=1}^{n_A} a_i, \quad \bar{b} = \frac{1}{n_B} \sum_{j=1}^{n_B} b_j \]其中 \(a_i\) 和 \(b_j\) 分别是用户 i 和 j 在网站上花费的时间。
A 和 B 的样本方差分别由下式给出:
\[ s^2_A = \frac{1}{n_A - 1} \sum_{i=1}^{n_A} (a_i - \bar{a})^2, \quad s^2_B = \frac{1}{n_B - 1} \sum_{j=1}^{n_B} (b_j - \bar{b})^2 \]然后 Z 检验的值由下式给出:
\[ Z = \frac{\bar{b} - \bar{a}}{\sqrt{\frac{s^2_A}{n_A} + \frac{s^2_B}{n_B}}} \]Z 越大,A 和 B 之间的差异显著的可能性就越大。在零假设下(即 A 和 B 等价),Z 近似服从标准化正态分布(standardized normal distribution):
\[ Z \sim \mathcal{N}(0, 1) \]这只有在样本量很大且 \(\sigma^2_A \approx \sigma^2_B\) 时才成立。如果不是这样,建议咨询统计学家。
与 G 检验一样,我们将使用 p 值来决定 Z 是否大到足以认为在 B 上花费的时间真的大于在 A 上花费的时间。为了计算 p 值,你需要检查从该分布中获得一个至少与你计算出的 Z 值一样极端(与零假设不一致)的 Z 值的概率。例如,让我们想象你的样本给出了 \(Z = 2.64\)。如果 A 和 B 相等,观察到 \(Z \geq 2.64\) 的概率约为 5%。
要查看测试结果,你将 p 值与所选择的显著性水平(significance level)进行比较。如果你的显著性水平是 5%,那么如果 p 值低于 0.05,我们拒绝零假设,该零假设声称两个模型之间的性能差异不具有统计显著性。因此,新模型比旧模型工作得更好。
如果 p 值大于或等于 0.05,那么我们就不拒绝零假设。请注意,这并不等同于接受零假设。这两个模型仍然可能不同,我们只是没有得到支持这一点的证据。在这种情况下,除非证据改变我们的想法,否则我们将坚持使用旧模型。没有证据意味着我们继续做我们正在做的事情。还要注意,我们不能简单地持续收集证据直到 p 值低于 0.05,因为这在科学上是不合理的。建议咨询统计学家并设计一个不同的测试。
至于显著性水平,对于哪个阈值最优没有普遍的共识。实践中常用 0.05 或 0.01 的值。它们是 20 世纪 20 年代引领潮流的统计学家罗纳德·费希尔(Ronald Fisher)的最爱。如果适合你的应用,你应该选择更高或更低的值。值越低,改变主意所需的证据就越多。
与 G 检验类似,使用编程语言查找 Z 检验的 p 值很方便。在 Python 中,可以这样做:
from scipy.stats import norm

def get_p_value(Z):
    p_value = norm.sf(Z)
    return p_value
以下代码适用于 R:
get_p_value <- function(Z) {
    p_value <- 1 - pnorm(Z)
    return(p_value)
}
为了获得最佳结果,建议将 \(n_A\) 和 \(n_B\) 设置为 1000 或更高的值。
7.2.3 结语与警告
正如本章开头提到的,本章中强调的一些方法仅作为示例提供,可能不适用于你的特定业务问题。特别是,上面介绍的两种统计检验在学校里被教授,并且确实在实践中经常使用,但不幸的是,并非所有这些用途都适用于你的业务问题。在指出这一点的同时,谷歌的首席决策科学家、本章的审阅者之一卡西·科济尔科夫(Cassie Kozyrkov)强调,上述两种检验在实践中很少是好的选择,因为它们只能表明两个模型不同,但不能表明差异是否「至少为 x」。如果用一个新模型替换旧模型成本高昂或带来风险,那么仅仅知道新模型「某种程度上」更好并不足以做出替换决定。在这种情况下,必须针对手头的问题专门设计调整后的检验,最好的方法是咨询统计学家。²
仔细测试你的 A/B 测试的编程代码。只有你把所有事情都实现正确,你才会得到有效的模型评估。否则,你不会知道有什么不对劲:你的测试不会揭示它坏了。
另外,确保在相同时间对 A 组和 B 组进行测量。请记住,网站流量在一天中的不同时间或一周中的不同日子表现不同。为了实验的纯粹性,避免比较来自不同时间的测量结果。同样的道理也适用于其他可能显著影响用户行为的可测量参数,例如居住国家、互联网连接速度或网络浏览器版本。
7.3 多臂老虎机
一种更先进、通常更可取的在线模型评估和选择方式是多臂老虎机(multi-armed bandit,MAB)。A/B 测试有一个主要缺点。计算 A/B 测试值所需的 A 组和 B 组的测试结果数量很大。被路由到次优模型的很大一部分用户将在很长一段时间内体验次优行为。
理想情况下,我们希望尽可能少地将用户暴露于次优模型。同时,我们需要将用户暴露给两个模型各足够多次,以获得两个模型性能的可靠估计。这就是所谓的探索-利用困境(exploration-exploitation dilemma):一方面,我们希望充分探索模型的性能,以便能够可靠地选择更好的一个。另一方面,我们希望尽可能多地利用更好模型的性能。
在概率论中,多臂老虎机问题是这样一个问题:一组固定且有限的资源必须在相互竞争的选项之间进行分配,以使期望奖励最大化。每个选项的性质在分配时只是部分已知,并且随着时间推移和我们向该选项分配资源而可能变得更清楚。
让我们看看多臂老虎机问题如何应用于两个模型的在线评估。(对于两个以上模型的方法是一样的。)
我们拥有的有限资源集是系统的用户。相互竞争的选项,也称为「臂」(arm),是我们的模型。我们可以通过将用户路由到运行特定模型的系统版本来将资源分配给一个选项(换句话说,我们可以「玩一个臂」)。我们希望最大化期望奖励,其中奖励由业务性能指标给出。示例可能包括会话期间在网站上花费的平均时间、一周内阅读的平均新闻文章数、购买推荐文章的用户百分比等。
² 遗憾的是,在一本紧凑的书中描述所有特殊情况和检验是不切实际的。请时常查阅本书的配套维基。更多统计检验会随着时间的推移而添加。
UCB1(代表上置信界,Upper Confidence Bound)是解决多臂老虎机问题的一种流行算法。该算法根据臂过去的性能以及算法对它的了解程度来动态选择臂。换句话说,当 UCB1 对模型性能的置信度很高时,它更频繁地将用户路由到性能最佳的模型。否则,UCB1 可能会将用户路由到次优模型,以便获得对该模型性能更自信的估计。一旦算法对每个模型的性能足够自信,它就几乎总是将用户路由到性能最佳的模型。
UCB1 的数学原理如下。设 \(c_a\) 表示从开始以来臂 a 被玩的次数,\(v_a\) 表示玩该臂获得的平均奖励。奖励对应于业务性能指标的值。为了说明,让指标是用户在一次会话中在系统中花费的平均时间。因此,玩一个臂的奖励是特定的会话持续时间。
一开始,所有臂 \(a = 1, \ldots, M\) 的 \(c_a\) 和 \(v_a\) 都为零。一旦玩了一个臂 a,就观察到奖励 r,\(c_a\) 增加 1;然后 \(v_a\) 如下更新:
\[ v_a \leftarrow \frac{c_a - 1}{c_a} v_a + \frac{r}{c_a} \]在每个时间步(即当新用户登录时),要玩的臂(即用户将被路由到的系统版本)按如下方式选择。如果某个臂 a 的 \(c_a = 0\),则玩这个臂;否则,玩 UCB 值最大的臂。臂 a 的 UCB 值(记为 \(u_a\))定义如下:
\[ u_a = v_a + \sqrt{\frac{2 \ln c}{c_a}} \]其中 c 是自开始以来所有臂被玩的总次数。
该算法被证明会收敛到最优解。也就是说,UCB1 最终会在大多数时候玩性能最佳的臂。
在 Python 中,实现 UCB1 的代码看起来如下:
class UCB1():
    def __init__(self, n_arms):
        self.c = [0]*n_arms
        self.v = [0.0]*n_arms
        self.M = n_arms
        return

    def select_arm(self):
        for a in range(self.M):
            if self.c[a] == 0:
                return a
        u = [0.0]*self.M
        c = sum(self.c)
        for a in range(self.M):
            bonus = math.sqrt((2 * math.log(c)) / float(self.c[a]))
            u[a] = self.v[a] + bonus
        return u.index(max(u))

    def update(self, a, r):
        self.c[a] += 1
        v_a = ((self.c[a] - 1) / float(self.c[a])) * self.v[a] \
            + (r / float(self.c[a]))
        self.v[a] = v_a
        return
相应的 R 代码如下所示:
setClass("UCB1", representation(count="numeric", value="numeric", M="numeric"))

setGeneric("select_arm", function(x) standardGeneric("select_arm"))
setMethod("select_arm", "UCB1", function(x) {
    for (a in seq(from = 1, to = x@M, by = 1)) {
        if (x@count[a] == 0) {
            return(a)
        }
    }
    u <- rep(0.0, x@M)
    count <- sum(x@count)
    for (a in seq(from = 1, to = x@M, by = 1)) {
        print(a)
        bonus <- sqrt((2 * log(count)) / x@count[a])
        u[a] <- x@value[a] + bonus
    }
    match(c(max(u)), u)
})

setGeneric("update", function(x, a, r) standardGeneric("update"))
setMethod("update", "UCB1", function(x, a, r) {
    x@count[a] <- x@count[a] + 1
    v_a <- ((x@count[a] - 1) / x@count[a]) * x@value[a] + (r / x@count[a])
    x@value[a] <- v_a
})

UCB1 <- function(M) {
    new("UCB1", count = rep(0, M), value = rep(0.0, M), M = M)
}
7.4 模型性能的统计界限
在报告模型性能时,有时除了指标的值之外,还需要提供统计界限(statistical bounds),也称为统计区间(statistical interval)。
熟悉其他机器学习书籍或一些流行在线博客的读者可能会疑惑,为什么我们使用术语「统计区间」而不是「置信区间」(confidence interval)。原因是,在某些机器学习文献中,作者所称的「置信区间」实际上是「可信区间」(credible interval)。两者之间的区别对统计学家来说是清晰且重要的,因为这两个术语在频率学派(frequentist)和贝叶斯学派(Bayesian)统计中具有不同的含义。在本书中,我决定不让读者背负这两个术语之间细微差别的负担。对于非统计学专家来说,将统计区间理解为以下内容是有益的:95% 的统计区间表明,你正在估计的参数有 95% 的机会位于区间边界之间。严格来说,这是可信区间的定义。置信区间的解释略有不同,大多数统计学新手在读完几本教科书之前不会开始理解这种差异。就我们的目的而言,上述对统计区间的解释就足够了。
有几种技术可以为模型建立统计界限。有些技术适用于分类模型,有些可以应用于回归模型。我们将在本节中考虑几种技术。
7.4.1 分类错误的统计区间
如果你为分类模型报告错误率(error ratio)’err’(其中 \(\text{err} \stackrel{\text{def}}{=} 1 - \text{accuracy}\)),那么可以使用以下技术来获得 ’err’ 的统计区间。
设 N 为测试集的大小。那么,以 99% 的概率,’err’ 位于以下区间内:
\[ \text{err} \in \left[ \text{err} - z_N \sqrt{\frac{\text{err}(1 - \text{err})}{N}},\ \text{err} + z_N \sqrt{\frac{\text{err}(1 - \text{err})}{N}} \right] \]\(z_N\) 的值取决于所需的置信水平(confidence level)。对于 99% 的置信水平,\(z_N = 2.58\)。对于其他置信水平值,\(z_N\) 的值可以在下表中找到:
| 置信水平 | 80% | 90% | 95% | 98% | 99% |
|---|---|---|---|---|---|
| z_N | 1.28 | 1.64 | 1.96 | 2.33 | 2.58 |
与 p 值一样,使用编程语言查找 \(z_N\) 的值很方便。在 Python 中,可以这样做:
from scipy.stats import norm

def get_z_N(confidence_level):  # a value in (0,100)
    z_N = norm.ppf(1-0.5*(1 - confidence_level/100.0))
    return z_N
以下代码适用于 R:
get_z_N <- function(confidence_level) {  # a value in (0,100)
    z_N <- qnorm(1-0.5*(1 - confidence_level/100.0))
    return(z_N)
}
理论上,上述技术甚至适用于 \(N \geq 30\) 的非常小的测试集。然而,获得测试集最小规模 N 的更准确的经验法则是:找到使 \(N \times \text{err}(1 - \text{err}) \geq 5\) 成立的 N 值。直观地说,测试集越大,我们对模型真实性能的不确定性就越低。
7.4.2 自助法统计区间
一种流行的、适用于分类和回归的任何指标的统计区间报告技术,基于自助法(bootstrapping)的思想。自助法是一种统计过程,包括构建数据集的 B 个样本,然后使用这些 B 个样本训练模型或计算某个统计量。特别是,随机森林(random forest)学习算法就是基于这个思想。
以下是自助法如何应用于为指标构建统计区间。给定测试集,我们创建 B 个随机样本 \(S_b\),每个对应 \(b = 1, \ldots, B\)。为了获得某个 b 的样本 \(S_b\),我们使用有放回抽样(sampling with replacement)。有放回抽样意味着我们从空集开始,然后从测试集中随机挑选一个示例,并将其精确副本放入 \(S_b\),同时将原始示例保留在测试集中。我们继续随机挑选示例并将它们放入 \(S_b\),直到 \(|S_b| = N\)。
一旦我们有了测试集的 B 个自助样本,我们就使用每个样本 \(S_b\) 作为测试集计算性能指标 \(m_b\) 的值。将这 B 个值按升序排序。然后求出指标的所有 B 个值之和 S:\(S \stackrel{\text{def}}{=} \sum_{b=1}^{B} m_b\)。为了获得指标 c% 的统计区间,选择最小 a 和最大 b 之间的最紧区间,使得位于该区间内的 \(m_b\) 值之和至少占 S 的 c%。我们的统计区间则由 [a, b] 给出。
上面这段听起来可能很模糊,所以让我们用一个例子来说明。设 \(B = 10\)。设通过将模型应用于 B 个自助样本计算的指标值为 [9.8, 7.5, 7.9, 10.1, 9.7, 8.4, 7.1, 9.9, 7.7, 8.5]。首先,我们将这些值按升序排序:[7.1, 7.5, 7.7, 7.9, 8.4, 8.5, 9.7, 9.8, 9.9, 10.1]。让我们的置信水平 c 为 80%。那么,统计区间的最小值 a 将是 7.46,最大值 b 将是 9.92。上述两个值是使用 Python 中的百分位数(percentile)函数找到的:
from numpy import percentile

def get_interval(values, confidence_level):
    # confidence_level is a value in (0,100)
    lower = percentile(values, (100.0-confidence_level)/2.0)
    upper = percentile(values, confidence_level+((100.0-confidence_level)/2.0))
    return (lower, upper)
使用 R 中的分位数(quantile)函数也可以完成同样的操作:
get_interval <- function(values, confidence_level) {
    # confidence_level is a value in (0,100)
    cl <- confidence_level/100.0
    quant <- quantile(values, probs = c((1.0-cl)/2.0, cl+((1.0-cl)/2.0)), names = FALSE)
    return(quant)
}
一旦你有了统计区间的边界 a = 7.46 和 b = 9.92,你就可以报告你的模型指标值以 80% 的置信度位于区间 [7.46, 9.92] 内。
在实践中,分析人员使用 95% 或 99% 的置信水平。置信度越高,区间越宽。自助样本的数量 B 通常设置为 100。
7.4.3 回归的自助法预测区间
到目前为止,我们考虑的是整个模型在给定性能指标下的统计区间。在本节中,我们将使用自助法为回归模型和该模型接收的给定特征向量 x 计算预测区间(prediction interval)。
我们想回答以下问题。给定一个回归模型 f 和一个输入特征向量 x,值区间 \([f_{\min}(x), f_{\max}(x)]\) 是多少,使得预测 f(x) 以 c% 的置信度位于该区间内?
这里的自助法过程类似。唯一的区别是,现在我们构建训练集(而不是测试集)的 B 个自助样本。通过将 B 个自助样本用作 B 个训练集,我们构建 B 个回归模型,每个自助样本一个。设输入特征向量为 x。固定置信水平 c。将 B 个模型应用于 x,获得 B 个预测。现在,使用与上述相同的技术,找到最小 a 和最大 b 之间的最紧区间,使得位于该区间内的预测值之和至少占 B 个预测之和的 c%。然后返回预测 f(x),并声明以 c% 的置信度,它位于区间 [a, b] 内。
与之前一样,置信水平通常是 95% 或 99%。自助样本的数量 B 设置为 100(或时间允许的尽可能多)。
7.5 测试集充分性评估
在传统软件工程中,测试用于识别软件中的缺陷。测试集合的构建方式使它们能够在软件进入生产环境之前发现代码中的错误。同样的方法适用于测试所有「围绕」统计模型开发的代码:从用户那里获取输入、将其转换为特征的代码,以及解释模型输出并将结果提供给用户的代码。
然而,还必须对模型本身进行额外的评估。用于评估模型的测试示例的设计方式也必须能够在模型进入生产环境之前发现模型的缺陷行为。
7.5.1 神经元覆盖率
当我们评估神经网络时,尤其是将用于关键任务场景(如自动驾驶汽车或太空火箭)的神经网络时,我们的测试集必须具有良好的覆盖率。神经网络模型测试集的神经元覆盖率(neuron coverage)定义为测试集中的示例激活的单元(神经元)数量与单元总数的比率。好的测试集具有接近 100% 的神经元覆盖率。
构建此类测试集的一种技术是从一组未标记的示例开始,此时模型的所有单元都未被覆盖。然后,我们迭代地:
- 随机挑选一个未标记的示例 i 并为其标记,
- 将特征向量 \(x_i\) 发送到模型的输入,
- 观察 \(x_i\) 激活了模型中的哪些单元,
- 如果预测正确,将这些单元标记为已覆盖,
- 返回步骤 1;继续迭代,直到神经元覆盖率接近 100%。
当单元的输出高于某个阈值时,该单元被视为被激活。对于 ReLU,通常为零;对于逻辑斯谛 S 形(logistic sigmoid),为 0.5。
7.5.2 变异测试
在软件工程中,可以使用称为变异测试(mutation testing)的方法来确定被测软件(software under test,SUT)的良好测试覆盖率。假设我们有一组为测试 SUT 而设计的测试。我们生成 SUT 的几个「变异体」(mutant)。变异体是 SUT 的一个版本,其中我们随机进行一些修改,例如在源代码中将「+」替换为「-」、将「<」替换为「>」、删除 if-else 语句中的 else 命令,等等。然后我们将测试集应用于每个变异体,看看是否至少有一个测试在该变异体上失败。我们说,如果有一个测试在其上失败,我们就杀死了该变异体。然后我们计算整个变异体集合中被杀死变异体的比率。好的测试集使该比率等于 100%。
在机器学习中,可以遵循类似的方法。然而,为了创建变异体统计模型,我们不修改代码,而是修改训练数据。如果模型很深,我们也可以随机删除或添加一层,或者删除或替换激活函数。训练数据可以通过以下方式修改:
- 添加重复示例,
- 伪造某些示例的标签,
- 删除一些示例,或
- 向某些特征的值添加随机噪声。
我们说,如果至少有一个测试示例被该变异体统计模型错误预测,我们就杀死了该变异体。
7.6 模型属性评估
当我们根据某个性能指标(如准确率或 AUC)衡量模型质量时,我们评估的是它的正确性属性。除了这个通常被评估的模型属性之外,评估模型的其他属性(如鲁棒性和公平性)也可能是合适的。
7.6.1 鲁棒性
机器学习模型的鲁棒性(robustness)是指向输入数据添加一些噪声后模型性能的稳定性。鲁棒模型会表现出以下行为。如果输入示例被添加随机噪声所扰动,模型的性能将按与噪声水平成比例的方式下降。
考虑一个输入特征向量 x。在对该输入示例应用模型 f 之前,让我们修改某些随机选择的特征的值,将它们替换为零,以获得修改后的输入 \(x'\)。继续随机选择并替换 x 中特征的值,只要 x 和 \(x'\) 之间的欧几里得距离保持低于某个 δ。然后将模型 f 应用于 x 和 \(x'\),以获得预测 f(x) 和 \(f(x')\)。固定 δ 和 ε 的值。如果对于任何满足 \(\|x - x'\| \leq \delta\) 的 x 和 \(x'\),我们都有 \(|f(x) - f(x')| \leq \epsilon\),则称模型 f 对输入的 δ-扰动是 ε-鲁棒的。
如果你有几个根据性能指标表现相似的模型,你会更倾向于部署一个在应用于测试数据时 ε 最小的 ε-鲁棒模型。然而,在实践中,如何设置合适的 δ 值并不总是很清楚。在几个候选模型中识别鲁棒模型的一种更实用的方法如下。
如果我们通过对某个原始测试集中的所有示例应用 δ-扰动而获得某个测试集,那么我们说该测试集是 δ-扰动的。选择你想要测试鲁棒性的模型 f。设置一个合理的 \(\hat{\epsilon}\) 值,使得如果模型在生产中的预测与正确预测的距离不超过 \(\hat{\epsilon}\),你就认为这是可接受的。从较小的 δ 值开始,构建一个 δ-扰动的数据集。找到最小的 ε,使得对于原始测试集中的每个示例 x 及其来自 δ-扰动测试集的对应示例 \(x'\),都有 \(|f(x) - f(x')| \leq \epsilon\)。
如果 \(\epsilon \geq \hat{\epsilon}\),你为 δ 选择的值太高了;设置一个更低的值并重新开始。
如果 \(\epsilon < \hat{\epsilon}\),则略微增加 δ,构建一个新的 δ-扰动测试集,为这个新的 δ-扰动测试集找到 ε,并继续增加 δ,只要 ε 保持小于 \(\hat{\epsilon}\)。一旦你找到 \(\epsilon \geq \hat{\epsilon}\) 的 \(\delta = \hat{\delta}\) 值,请注意你正在测试鲁棒性的模型 f 对输入的 \(\hat{\delta}\)-扰动是 \(\hat{\epsilon}\)-鲁棒的。现在挑选另一个你想测试鲁棒性的模型,并找到它的 \(\hat{\delta}\);继续这样直到所有模型都被测试。
一旦你有了每个模型的 \(\hat{\delta}\)-扰动值,就在生产环境中部署 \(\hat{\delta}\) 最大的模型。
7.6.2 公平性
机器学习算法倾向于学习人类教给它们的东西。教学以训练示例的形式进行。人类有偏见,这些偏见可能影响他们收集和标记数据的方式。有时,偏见存在于历史、文化或地理数据中。这反过来,正如我们在第3章第 ? 节中所见,可能导致有偏见的模型。
敏感且需要免受不公平影响的属性被称为受保护或敏感属性(protected or sensitive attributes)。法律认可和受保护的属性的示例包括种族、肤色、性别、宗教、国籍、公民身份、年龄、怀孕状况、家庭状况、残疾状况、退伍军人状况和遗传信息。
公平性(fairness)通常是特定于领域的,每个领域可能有自己的法规。受监管的领域包括信贷、教育、就业、住房和公共场所。
公平性的定义因领域而异,差异很大。在撰写本书时,科学和技术文献中对什么是公平性还没有坚定的共识。最常被引用的概念是人口统计均等(demographic parity)和机会均等(equal opportunity)。
人口统计均等(也称为统计均等(statistical parity)或独立性均等(independence parity))意味着受保护属性的每个细分群体以相同的比率获得模型的正预测。
设正预测表示「被大学录取」或「获得贷款」。在数学上,人口统计均等定义如下。设 \(G_1\) 和 \(G_2\) 是测试数据中按敏感属性 j(如性别)划分的两个不相交的群体。设 \(x^{(j)} = 1\) 如果 x 代表女性,否则 \(x^{(j)} = 0\)。如果 \(\Pr(f(x_i) = 1 \mid x_i \in G_1) = \Pr(f(x_k) = 1 \mid x_k \in G_2)\),则被测二元模型 f 满足人口统计均等。也就是说,在测试数据上衡量,模型 f 对女性预测 1 的机会与对男性预测 1 的机会相同。
从训练数据的特征向量中排除受保护属性并不能保证模型将具有人口统计均等,因为一些剩余特征可能与被排除的特征相关。
机会均等意味着每个群体以相同的比率获得模型的正预测,前提是该群体中的人符合条件。
在数学上,如果 \(\Pr(f(x_i) = 1 \mid x_i \in G_1 \text{ 且 } y_i = 1) = \Pr(f(x_k) = 1 \mid x_k \in G_2 \text{ 且 } y_k = 1)\),则被测二元模型 f 满足机会均等,其中 \(y_i\) 和 \(y_k\) 分别是特征向量 \(x_i\) 和 \(x_k\) 的实际标签。上述等式意味着,在测试数据上衡量,模型 f 对符合条件的女性预测 1 的机会与对也符合条件的男性预测 1 的机会相同。用混淆矩阵(confusion matrix)的术语来说,机会均等要求真正例率(true positive rate,TPR)在受保护属性的每个取值上都相等。
7.7 小结
所有在生产环境中运行的统计模型都必须被仔细且持续地评估。
根据模型的应用领域以及组织的目标和约束,模型评估将包括以下任务:
- 评估将模型投入生产的法律风险,
- 理解用于训练模型的数据分布的主要性质,
- 在部署前评估模型的性能,以及
- 监控已部署模型的性能。
离线模型评估发生在模型训练之后。它基于历史数据。在线模型评估包括使用在线数据在生产环境中测试和比较模型。
一种流行的在线模型评估技术是 A/B 测试。执行 A/B 测试时,我们将用户分成两组:A 和 B。两组分别被提供服务的是旧模型和新模型。然后我们应用统计显著性检验来决定新模型是否在统计上不同于旧模型。
多臂老虎机是另一种流行的在线模型评估技术。我们首先将所有模型随机暴露给用户。然后我们逐渐减少表现最差的模型的暴露,直到只有一个——表现最好的模型——在大多数时候被提供服务。
除了报告训练模型性能指标之外,可能还需要提供称为统计区间的统计界限。
对于分类和回归模型,可以使用一种称为自助法的流行技术计算任何指标的统计区间。这是一种统计过程,包括构建数据集的 B 个样本,然后使用这些 B 个样本中的每一个训练模型并计算某个统计量。
用于评估模型的测试示例必须能够在模型进入生产环境之前发现缺陷行为。诸如神经元覆盖率和变异测试之类的技术可用于评估测试集。
当模型用于关键任务系统或受监管领域(如信贷、教育、就业、住房和公共场所)时,可能必须评估准确率、鲁棒性和公平性。