监督式模型训练(第 2 部分)
在我们关于监督式模型训练(supervised model training)讨论的第二部分中,我们将考虑以下主题:训练深度模型(deep model)、模型堆叠(model stacking)、处理类别不平衡数据集、分布偏移(distribution shift)、模型校准(model calibration)、故障排查(troubleshooting)与误差分析(error analysis),以及其他最佳实践。
与浅层模型(shallow model)相比,深度神经网络(deep neural network)的模型训练策略涉及更多可变的环节。另一方面,它也更有章可循,更适合自动化。
6.1 深度模型训练策略
模型训练始于筛选出几种网络架构,也称为网络拓扑(network topology)。如果你处理的是图像数据,并且想从头构建模型,那么一个默认的拓扑选择可能是:一个卷积神经网络(convolutional neural network,CNN),它至少包含一个卷积层(convolutional layer)、一个紧随其后的最大池化层(max-pooling layer)和一个全连接层(fully connected layer)。
如果你处理的是文本或其他序列数据(如时间序列),你可以在 CNN、门控循环神经网络(gated recurrent neural network)(例如长短期记忆(Long Short Term Memory,LSTM)或门控循环单元(gated recurrent unit,GRU))或 Transformer 之间进行选择。
除了从头训练模型,你还可以从预训练模型(pre-trained model)开始。像 Google 和 Microsoft 这样的公司已经训练了非常深的神经网络,其架构针对图像或自然语言处理任务进行了优化。
在图像处理任务中使用最多的预训练模型包括:VGG16 和 VGG19(基于视觉几何组(Visual Geometry Group,VGG)架构)、InceptionV3(基于 GoogLeNet 架构)和 ResNet50(基于残差网络(residual network)架构)。
对于自然语言文本处理,与从头训练模型相比,诸如基于 Transformer 架构的 BERT(Bidirectional Encoder Representations from Transformer,来自 Transformer 的双向编码器表示)和基于双向 LSTM 架构的 ELMo(Embeddings from Language Models,来自语言模型的嵌入)等预训练模型往往能提高模型质量。
使用预训练模型的一个好处是,这些模型是在其创建者可以获得、但你很可能无法获得的海量数据上训练的。即使你的数据集更小,且与预训练模型所用的数据集不完全相似,预训练模型学到的参数仍然可能有用。
你可以通过两种方式使用预训练模型:
- 1)使用它学到的参数来初始化你自己的模型,或者
- 2)将预训练模型用作你模型的特征提取器(feature extractor)。
如果你以前一种方式使用预训练模型,它会给你更多的灵活性。缺点是最终你会在训练一个非常深的神经网络,这需要大量的计算资源。在后一种情况下,你「冻结」(freeze)预训练模型的参数,只训练新增层的参数。
6.1.1 神经网络训练策略
使用现有模型来创建新模型被称为迁移学习(transfer learning)。我们将在 6.1.10 节中更详细地讨论这个话题。现在,假设你正在基于你选择的架构从头构建一个模型。构建神经网络的常见策略如下:
- 定义性能指标(performance metric)P。
- 定义代价函数(cost function)C。
- 选择参数初始化策略(parameter-initialization strategy)W。
- 选择代价函数优化算法(cost-function optimization algorithm)A。
- 选择超参数调优策略(hyperparameter tuning strategy)T。
- 使用调优策略 T 选择一组超参数(hyperparameter)值组合 H。
- 使用算法 A、以超参数 H 参数化的模型 M 进行训练,以优化代价函数 C。
- 如果仍有未测试的超参数值,使用策略 T 选择另一组超参数值组合 H,并重复第 7 步。
- 返回使指标 P 得到最优化的模型。
现在让我们详细讨论上述策略中的一些步骤。
6.1.2 性能指标与代价函数
第 1 步与浅层模型训练策略(第 5 章的 ?? 节)的第 1 步类似:我们定义一个指标,用于比较两个模型在保留数据(holdout data)上的性能,并选出两者中更好的一个。性能指标的一个例子是 F 分数(F-score)或科恩卡帕系数(Cohen’s kappa)。
在第 2 步中,我们定义学习算法为了训练模型将优化什么。如果我们的神经网络是一个回归模型,那么在大多数情况下,代价函数是上一章中「??」等式定义的均方误差(mean squared error,MSE)。让我们在这里重复一遍:
\[ \text{MSE} = \frac{1}{N}\sum_{i=1}^{N} (y_i - \hat{y}_i)^2 \]对于分类问题,代价函数的典型选择是分类交叉熵(categorical cross-entropy)(用于多类分类)或二元交叉熵(binary cross-entropy)(用于二元分类和多标签分类)。
回忆一下,当我们训练神经网络进行多类分类(multiclass classification)时,我们应该使用独热编码(one-hot encoding)来表示标签。设 C 是我们分类问题中的类别数。设 \(y_i\) 是示例 i 的独热编码标签,其中 i 从 1 到 N。设 \(y_{i,j}\) 表示示例 i 中位置 j(j 从 1 到 C)的值。示例 i 分类的分类交叉熵损失定义为:
\[ L_i = -\sum_{j=1}^{C} y_{i,j} \log \hat{y}_{i,j} \]其中 \(\hat{y}_i\) 是神经网络针对输入 \(x_i\) 发出的 C 维预测向量。代价函数通常定义为各个示例损失之和:
\[ J = \sum_{i=1}^{N} L_i \]在二元分类(binary classification)中,神经网络针对输入特征向量 \(x_i\) 的输出是一个单一值 \(\hat{y}_i\),而示例的标签是一个单一值 \(y_i\),就像逻辑回归一样。示例 i 分类的二元交叉熵损失定义为:
\[ L_i = -(y_i \log \hat{y}_i + (1 - y_i) \log (1 - \hat{y}_i)) \]类似地,训练集分类的代价函数通常定义为各个示例损失之和:
\[ J = \sum_{i=1}^{N} L_i \]二元交叉熵也用于多标签分类(multi-label classification)。标签现在是 C 维词袋(bag-of-words)向量 \(y_i\),而预测是 C 维向量 \(\hat{y}_i\),其每个维度 j 上的值 \(\hat{y}_{i,j}\) 介于 0 和 1 之间。单个标签 \(\hat{y}_i\) 的预测损失定义为:
\[ L_i = -\sum_{j=1}^{C} \left( y_{i,j} \log \hat{y}_{i,j} + (1 - y_{i,j}) \log (1 - \hat{y}_{i,j}) \right) \]整个训练集分类的代价函数通常定义为各个示例损失之和:
\[ J = \sum_{i=1}^{N} L_i \]请注意,多类分类和多标签分类的输出层是不同的。在多类分类中,使用一个 softmax 单元。它生成一个 C 维向量,其值被限制在 (0, 1) 范围内,且总和等于 1。在多标签分类中,输出层包含 C 个逻辑单元(logistic unit),它们的值也位于 (0, 1) 范围内,但它们的总和位于 (0, C) 范围内。
神经网络输出
好奇的读者可能希望更好地理解选择特定损失函数背后的逻辑。本小节将从数学上描述神经网络的输出。
在回归中,输出层只包含一个单元。如果输出值可以是任何数,从负无穷到正无穷,那么输出单元将不包含非线性。另一方面,如果神经网络必须预测一个正数,那么可以使用 ReLU(修正线性单元,rectified linear unit)非线性。设输入示例 i 在非线性之前的输出单元值为 \(z_i\)。那么应用 ReLU 非线性后的输出为 \(\max(0, z_i)\)。
在二元分类中,输出层只包含一个逻辑单元。设输入示例 i 在非线性之前的输出单元值为 \(z_i\)。应用逻辑非线性后的输出 \(\hat{y}_i\) 由下式给出:
\[ \hat{y}_i = \frac{1}{1 + e^{-z_i}} \]其中 e 是自然对数的底数,也称为欧拉数(Euler’s number)。
二元分类和多标签分类模型的定义方式类似。唯一的区别是,在多标签分类中,输出层包含 C 个逻辑单元,每个类别一个。如果 \(\hat{y}_{i,j}\) 表示输入示例为 i 时、类别 j 的逻辑单元经过非线性后的输出,那么对所有 \(j = 1, \ldots, C\) 的 \(\hat{y}_{i,j}\) 求和,结果介于 0 和 C 之间。
在多类分类中,输出层也产生 C 个输出。然而,在这种情况下,输出层每个单元的输出由 softmax 函数控制。设输出单元 j 在非线性之前、输入示例为 i 时的输出为 \(z_{i,j}\)。那么非线性后的输出 \(\hat{y}_{i,j}\) 由下式给出:
\[ \hat{y}_{i,j} = \frac{e^{z_{i,j}}}{\sum_{k=1}^{C} e^{z_{i,k}}} \]对所有 \(j = 1, \ldots, C\) 的 \(\hat{y}_{i,j}\) 之和等于 1。
6.1.3 参数初始化策略
在第 3 步中,我们选择参数初始化策略。在训练开始之前,所有单元中的参数值都是未知的。我们必须用一些值来初始化它们。神经网络的训练算法,比如梯度下降及其随机变体(我们稍后就会考虑),本质上是迭代式的,需要分析师指定一个起始点来开始迭代。这种初始化可能会影响训练模型的性质。你可能会从以下策略中选择一种:
- 全一(ones)——所有参数都初始化为 1;
- 随机正态(random normal)——参数被初始化为从正态分布(normal distribution)中采样的值,通常均值为 0、标准差为 0.05;
- 全零(zeros)——所有参数都初始化为 0;
- 随机均匀(random uniform)——参数被初始化为从范围 [-0.05, 0.05] 的均匀分布(uniform distribution)中采样的值;
- Xavier 均匀(Xavier uniform)——参数被初始化为从 [-limit, limit] 范围内的均匀分布中采样的值,其中「limit」是 \(\sqrt{6 / (in + out)}\),「in」和「out」的定义与下面的 Xavier 正态相同;
- Xavier 正态(Xavier normal)——参数被初始化为从以 0 为中心、标准差为 \(\sqrt{2 / (in + out)}\) 的截断正态分布(truncated normal distribution)中采样的值,其中「in」是当前单元(即你要初始化其参数的单元)所连接的前一层中的单元数;「out」是当前单元所连接的后一层中的单元数;
还有其他初始化策略。如果你使用的是 TensorFlow、Keras 或 PyTorch 等神经网络训练模块,它们会提供一些参数初始化器,并推荐默认选择。
偏置项(bias term)通常用零初始化。
虽然我们知道参数初始化会影响模型的性质,但我们无法预测哪种策略会为你的问题提供最佳结果。随机初始化和 Xavier 初始化是最常见的。建议从这两种之一开始你的实验。
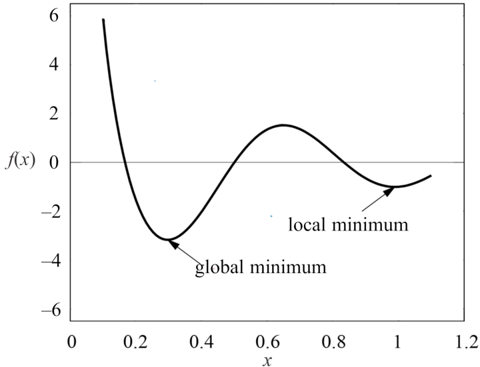
图 1:函数的局部极小值与全局极小值。
6.1.4 优化算法
在第 4 步中,我们选择代价函数优化算法。当代价函数是可微的(我们上面考虑的所有代价函数都是如此)时,梯度下降(gradient descent)和随机梯度下降(stochastic gradient descent)是两个最常用的优化算法。
梯度下降是一种迭代优化算法,用于寻找任何可微函数的局部极小值(local minimum)。我们说 \(f(x)\) 在 \(x = c\) 处有局部极小值,如果对 \(x = c\) 周围某个开区间(open interval)内的每个 \(x\),都有 \(f(x) \geq f(c)\)。区间是一组实数,具有这样的性质:集合中任意两个数之间的任何数也包含在该集合中。开区间不包括其端点,用圆括号表示。例如,(0, 1) 表示「所有大于 0 且小于 1 的数」。所有局部极小值中的最小值称为全局极小值(global minimum)。函数的局部极小值与全局极小值之间的区别如图 1 所示。
函数与优化
在本小节中,我们为好奇的读者解释数学函数和函数优化的基础知识。如果你只想知道训练神经网络的机制,可以放心跳过。
函数(function)是一种关系,它将集合 X(函数的定义域(domain))中的每个元素 x 与另一个集合 Y(函数的上域(codomain))中的单个元素 y 关联起来。函数通常有一个名字。如果函数叫 f,这种关系记为 \(y = f(x)\),读作「y 等于 f of x」。元素 x 是自变量(argument),或函数的输入(input),y 是函数的值(value),或输出(output)。用于表示输入的符号是函数的变量(variable)。我们常说 f 是变量 x 的函数。
函数 f 的导数(derivative)\(f'\) 是一个函数或一个值,描述 f 增加或减少的快慢。如果导数是一个常数值,比如 5 或 -3,那么函数在其定义域的任何点 x 上以恒定速率增加或减少。如果导数 \(f'\) 本身是一个函数,那么函数 f 在其定义域的不同区域可以以不同的速度增长。如果导数 \(f'\) 在某点 x 处为正,那么函数 f 在该点增加。如果 f 的导数在某点 x 处为负,那么函数在该点减少。导数在 x 处为零意味着函数在 x 处既不减少也不增加;函数在 x 处的斜率是水平的。
求导数的过程称为微分(differentiation)。
基本函数的导数是已知的。例如,如果 \(f(x) = x^2\),那么 \(f'(x) = 2x\);如果 \(f(x) = 2x\),那么 \(f'(x) = 2\);如果 \(f(x) = 2\),那么 \(f'(x) = 0\)。任何形如 \(f(x) = c\)(其中 c 是常数)的函数的导数都是零。
如果我们要微分的函数不是基本函数,我们可以用链式法则(chain rule)求它的导数。例如,如果 \(F(x) = f(g(x))\),其中 f 和 g 是某个函数,那么 \(F'(x) = f'(g(x))g'(x)\)。例如,如果 \(F(x) = (5x + 1)^2\),那么 \(g(x) = 5x + 1\),\(f(g(x)) = (g(x))^2\)。应用链式法则,我们得到 \(F'(x) = 2(5x + 1)g'(x) = 2(5x + 1) \cdot 5 = 50x + 10\)。
梯度(gradient)是导数对于接受多个输入、或接受向量或其他复杂结构形式的一个输入的函数的一般化。函数的梯度是一个偏导数(partial derivative)向量。求函数的偏导数,就是只关注函数的一个输入、而把所有其他输入视为常数值来求导数的过程。
例如,如果我们的函数定义为 \(f([x^{(1)}, x^{(2)}]) = ax^{(1)} + bx^{(2)} + c\),那么函数 f 关于 \(x^{(1)}\) 的偏导数,记为 \(\frac{\partial f}{\partial x^{(1)}}\),由下式给出:
\[ \frac{\partial f}{\partial x^{(1)}} = a \]其中 a 是函数 \(ax^{(1)}\) 的导数。两个零分别是 \(bx^{(2)}\) 和 c 的导数,因为当我们计算关于 \(x^{(1)}\) 的导数时,\(x^{(2)}\) 被视为常数,而任何常数的导数都是零。
类似地,函数 f 关于 \(x^{(2)}\) 的偏导数 \(\frac{\partial f}{\partial x^{(2)}}\) 由下式给出:
\[ \frac{\partial f}{\partial x^{(2)}} = b \]函数 f 的梯度,记为 \(\nabla f\),由向量 \(\left[ \frac{\partial f}{\partial x^{(1)}}, \frac{\partial f}{\partial x^{(2)}} \right]\) 给出。
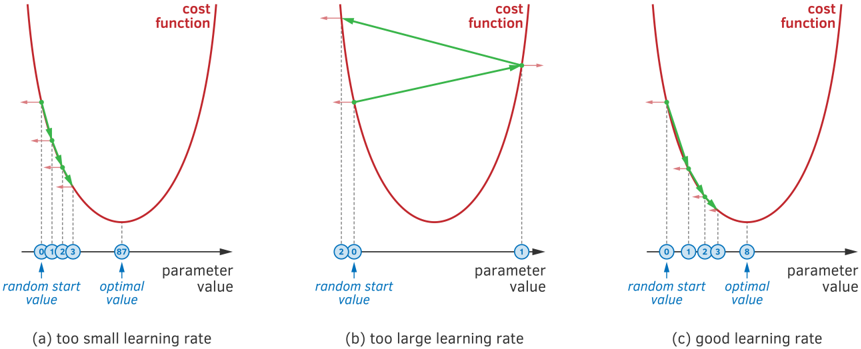
图 2:学习率对收敛的影响:(a) 过小,收敛会很慢;(b) 过大,无法收敛;(c) 学习率的正确取值。
链式法则也适用于偏导数。
为了使用梯度下降找到函数的局部极小值,我们从函数定义域中的某个随机点开始。然后,我们沿着当前点处函数的负梯度(或近似梯度)方向按比例移动。
机器学习中的梯度下降按轮次(epoch)进行。一个轮次包括完全使用训练集来更新每个参数。在第一个轮次中,我们使用上面讨论过的参数初始化策略之一来初始化神经网络的参数。反向传播(backpropagation)算法使用复杂函数导数的链式法则来计算每个参数的偏导数。1在每个轮次中,梯度下降使用偏导数更新所有参数。学习率(learning rate)控制一次更新的重要程度。这个过程一直持续到收敛(convergence),即每个轮次之后参数值变化不大的状态。然后算法停止。
梯度下降对学习率 \(\alpha\) 的选择很敏感。为你的问题选择合适的学习率并不容易。如果你选择的值太高,你可能根本无法收敛。另一方面,\(\alpha\) 值太小会使学习慢到看不到任何进展的程度。在图 2 中,你可以看到神经网络单个参数的梯度下降在三种学习率取值下的图示。每次迭代时参数的值用蓝色圆圈显示。圆圈内的数字表示轮次。红色箭头表示沿水平轴的梯度方向——即远离极小值的方向。绿色箭头显示每个轮次之后代价函数值的变化。
因此,在每个轮次中,梯度下降都会使参数值向极小值移动。如果学习率太小,向极小值的移动会非常慢(图 2a)。如果学习率太大,参数值会在极小值附近来回振荡,甚至远离极小值(图 2b)。
对于大型数据集,梯度下降相当慢,因为它使用整个数据集来计算每个轮次中每个参数的梯度。幸运的是,人们已经提出了该算法的几项重要改进。
小批量随机梯度下降(minibatch stochastic gradient descent,minibatch SGD)是梯度下降算法的一种变体。它使用训练数据的小子集(称为小批量(minibatch))来近似梯度。这有效地加快了计算速度。小批量的大小是一个超参数,你可以对它进行调优。推荐使用 32 到几百之间的 2 的幂:32、64、128、256 等等。
「原始」小批量 SGD 中仍然存在选择学习率 \(\alpha\) 值的问题。在后面的轮次中,学习仍然可能停滞不前。梯度下降可能无法到达局部极小值,而是因为更新幅度太大而在其附近持续振荡。有许多学习率衰减计划(learning rate decay schedule),可以在学习过程中、随着轮次数增加而降低学习率。使用学习率衰减计划的好处包括:梯度下降收敛更快(学习更快)和模型质量更高。下面,我们考虑几种流行的学习率衰减计划。
6.1.5 学习率衰减计划
学习率衰减(learning rate decay)就是在轮次推进过程中逐步降低学习率 \(\alpha\) 的值。相应地,参数更新变得更精细。有几种称为计划(schedule)的技术可以控制 \(\alpha\)。
基于时间的(time-based)学习率衰减计划根据上一轮的学习率来改变学习率。根据一种流行的基于时间的学习率衰减计划,学习率更新的数学公式为:
\[ \alpha_n = \frac{\alpha_0}{1 + d \cdot n} \]其中 \(\alpha_n\) 是学习率的新值,\(\alpha_0\) 是学习率的初始值,d 是衰减率(decay rate),一个超参数。例如,如果学习率的初始值 \(\alpha_0 = 0.3\),那么前五个轮次的学习率值如下表所示:
| 学习率 | 轮次 |
|---|---|
| 0.15 | 1 |
| 0.10 | 2 |
| 0.08 | 3 |
| 0.06 | 4 |
| 0.05 | 5 |
基于步进(step-based)的学习率衰减计划根据一些预定义的下降步(drop step)来改变学习率。根据一种流行的基于步进的学习率衰减计划,学习率更新的数学公式为:
\[ \alpha_n = \alpha_0 \cdot d^{\lfloor n / r \rfloor} \]其中 \(\alpha_n\) 是第 n 轮的学习率,\(\alpha_0\) 是学习率的初始值,d 是衰减率,反映在每个下降步中学习率应该改变多少(0.5 对应于减半),r 是所谓的下降率(drop rate),定义下降步的长度(10 对应于每 10 轮下降一次)。上式中的向下取整运算符(floor operator),当其参数值小于 1 时等于 0。
指数(exponential)学习率衰减计划与步进式类似。不过,它不是使用下降步,而是使用递减的指数函数。根据一种流行的指数学习率衰减计划,学习率更新的数学公式为:
\[ \alpha_n = \alpha_0 \cdot e^{-d \cdot n} \]其中 d 是衰减率,e 是欧拉数。
小批量 SGD 有几个流行的升级版,如动量(Momentum)、均方根传播(Root Mean Squared Propagation,RMSProp)和 Adam。这些算法根据学习过程的表现自动更新学习率。你不必担心选择初始学习率值、衰减计划和衰减率,或其他相关超参数。这些算法在实践中表现出良好的性能,从业者经常使用它们,而不是手动调优学习率。
动量通过使梯度下降朝向相关方向并减少振荡来加速小批量 SGD。它不是只使用当前轮次的梯度来引导搜索,而是累积过去轮次的梯度来确定前进方向。动量消除了手动调整学习率的需要。
神经网络代价函数优化算法方面较新的进展包括 RMSProp 和 Adam,后者是最新也最通用的。建议先用 Adam 开始训练模型。然后,如果模型质量没有达到可接受的水平,再尝试不同的代价函数优化算法。
6.1.6 正则化
在神经网络中,除了 L1 和 L2 正则化(regularization),你还可以使用神经网络特有的正则化方法:丢弃(dropout)、早停(early stopping)和批归一化(batch normalization)。后者严格来说并不是一种正则化技术,但它通常对模型有正则化效果。
丢弃的概念非常简单。每次你「运行」一个训练示例通过网络时,你都会随机地暂时将一些单元排除在计算之外。被排除的单元百分比越高,正则化效果越强。流行的神经网络库允许你在两个连续的层之间添加一个丢弃层,或者你可以为某个层指定丢弃超参数。丢弃超参数的值在 [0, 1] 范围内变化,表示要随机排除在计算之外的单元比例。该超参数的值必须通过实验来确定。虽然简单,但丢弃的灵活性和正则化效果是惊人的。
早停通过在每个轮次之后保存初步模型来训练神经网络。每个轮次之后保存的模型称为检查点(checkpoint)。然后它评估每个检查点在验证集(validation set)上的性能。你会在梯度下降过程中发现,代价随着轮次数的增加而减小。在某些轮次之后,模型可能开始过拟合,模型在验证数据上的性能可能恶化。还记得第 5 章「??」图中偏差-方差的说明吗?通过保留每个轮次之后的模型版本,一旦你开始观察到验证集上的性能下降,就可以停止训练。或者,你可以让训练过程持续固定数量的轮次,然后挑选最好的检查点。一些机器学习从业者依赖这种技术,另一些则尝试使用适当的技术对模型进行正确的正则化。
批归一化(更确切地说,应该叫批标准化(batch standardization))包括在下一层接收某一层的输出作为输入之前,对该层输出进行标准化。在实践中,批归一化带来更快、更稳定的训练,以及一定的正则化效果。所以,使用批归一化总是一个好主意。在流行的神经网络库中,你通常可以在两个连续的层之间插入一个批归一化层。
另一种可以应用于任何学习算法的正则化技术是数据增强(data augmentation)。这种技术经常用于对处理图像的模型进行正则化。在实践中,应用数据增强通常会带来模型性能的提升。
6.1.7 网络规模搜索与超参数调优
深度模型训练策略的第 5 步与浅层模型训练策略中的类似——选择一个超参数调优策略 T。
在第 6 步中,我们使用策略 T 选择一组超参数值。典型的参数包括小批量的大小、学习率的值(如果你使用原始小批量 SGD)或自动更新学习率的算法(如 Adam)。你还要决定初始的层数和每层的单元数。建议从一个合理的规模开始,这样我们可以足够快地构建第一个模型。例如,两个隐藏层、每层 128 个单元可能是一个不错的起点。
图 3:神经网络模型训练流程图。
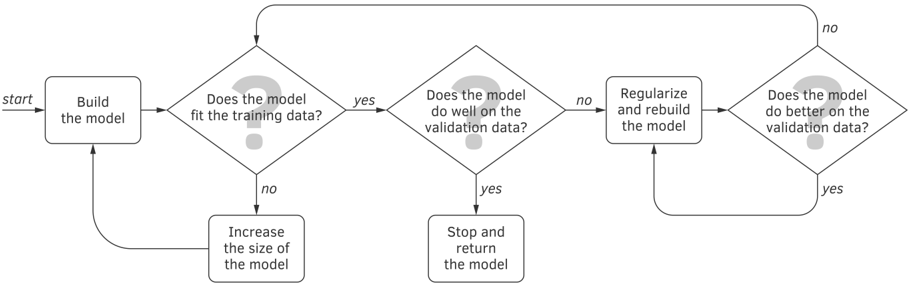
第 7 步是这样写的:「使用算法 A、以超参数 H 参数化的模型 M 进行训练,以优化代价函数 C。」这是与浅层学习的最大区别。当你使用浅层学习算法或模型时,你只能调整一些内置的超参数。你对模型架构和复杂度没有太多控制权。而对于神经网络,你拥有一切控制权,训练模型更像是一个过程,而不是单一动作。要构建一个深度模型,你从一个规模合理的模型开始,然后遵循图 3 所示的流程图。
请注意,你从一个模型开始,然后不断增加它的规模,直到它很好地拟合训练数据。然后你在验证数据上评估模型。如果根据性能指标它表现良好,你就停止并返回模型。否则,你进行正则化并重新训练模型。
正如我们所见,神经网络中的正则化通常可以通过几种方式实现。最有效的是丢弃,即你随机移除网络中的一些单元,使它更简单、「更笨」。更简单的模型在保留数据上会表现得更好,而这正是你的目标。
假设在几轮正则化和模型重新训练之后,你没有看到模型在验证数据上的性能有任何改善。检查它是否仍然拟合训练数据。如果没有,就增加模型的规模,可以通过增加单个层的规模,或者添加另一层。继续,直到模型再次拟合训练数据。然后再在验证数据上评估它。这个过程一直持续到无论你采取什么行动,更大的模型都不能带来更好的验证数据性能为止。然后,如果验证数据上的性能令人满意,你就停止并返回模型。
如果你对这一性能不满意,你可以在第 8 步选择不同的超参数组合,并构建不同的模型。你将持续测试不同的超参数值,直到没有更多可测试的值为止。然后,你在过程中训练的所有模型中保留最好的一个。如果最好模型的性能仍然不能令人满意,尝试不同的网络架构、添加更多带标签的数据,或尝试迁移学习。我们将在 6.1.10 节中更多地讨论迁移学习。
训练好的神经网络的性质在很大程度上取决于超参数值的选择。但在你选择具体的超参数值、训练模型并在验证数据上验证其性质之前,你必须决定哪些超参数重要到值得你花时间调优。
显然,如果你有无限的时间和计算资源,你会调优所有超参数。然而,在实践中,你的时间是有限的,而且资源往往相对有限。那么应该调优哪些超参数呢?
虽然这个问题没有确定的答案,但有几条观察结果可能有助于你在处理特定模型时选择要调优的超参数:
- 你的模型对某些超参数比其他超参数更敏感;而且
- 选择往往是在使用超参数的默认值还是更改它之间做出。
用于训练神经网络的库通常会为超参数提供默认值:随机梯度下降版本(通常是 Adam)、参数初始化策略(通常是随机正态或随机均匀)、小批量大小(通常是 32)等等。这些默认值是基于实践经验的观察选择的。开源库和模块往往是许多科学家和工程师合作的成果。这些才华横溢、经验丰富的人在处理各种数据集和实际问题时,为许多超参数确立了「良好」的默认值。
如果你决定调优一个超参数(而不是使用默认值),那么调优模型敏感的那些超参数更有意义。表 1 显示了2几个超参数以及神经网络对这些超参数的大致敏感度。
表 1:模型对某些超参数的大致敏感度。
| 超参数 | 敏感度 |
|---|---|
| 学习率 | 高 |
| 学习率衰减计划 | 高 |
| 损失函数 | 高 |
| 每层单元数 | 高 |
| 参数初始化策略 | 中 |
| 层数 | 中 |
| 层属性 | 中 |
| 正则化程度 | 中 |
| 优化器选择 | 低 |
| 优化器属性 | 低 |
| 小批量大小 | 低 |
| 非线性选择 | 低 |
6.1.8 处理多个输入
在实践中,机器学习工程师经常处理多模态数据(multimodal data)。例如,输入可能是一张图像和一段文本,而二元输出可能表示该文本是否描述了给定的图像。
浅层学习算法很难适应多模态数据。例如,你可以尝试通过应用相应的特征工程方法对每个输入进行向量化,然后拼接两个特征向量,形成一个更宽的特征向量。如果你的图像有特征 \([i^{(1)}, i^{(2)}, i^{(3)}]\),而你的文本有特征 \([t^{(1)}, t^{(2)}, t^{(3)}, t^{(4)}]\),那么你拼接后的特征向量将是 \([i^{(1)}, i^{(2)}, i^{(3)}, t^{(1)}, t^{(2)}, t^{(3)}, t^{(4)}]\)。
而使用神经网络,你拥有多得多的灵活性。你可以构建两个子网络(subnetwork),每种输入类型一个。例如,一个 CNN 子网络读取图像,而一个 RNN 子网络读取文本。两个子网络的最后一层都是一个嵌入(embedding)。CNN 有图像嵌入,RNN 有文本嵌入。然后你拼接两个嵌入,最后在拼接后的嵌入之上添加一个分类层,如 softmax 或逻辑 sigmoid。
神经网络库提供了易于使用的工具,允许拼接或平均来自多个子网络的层。
6.1.9 处理多个输出
有时,你想为一个输入预测多个输出。一些具有多个输出的问题可以有效地转换为多标签分类问题。标签性质相同的问题(如社交网络中的标签),或者可以创建假标签,作为原始标签组合的全枚举。
然而,在许多情况下,输出是多模态的,它们的组合无法有效枚举。考虑下面的例子:你想构建一个模型,检测图像上的物体并返回其坐标。此外,该模型还必须返回一个描述物体的标签,如「人」、「猫」或「仓鼠」。你的训练示例将是一个表示图像的特征向量和一个标签。标签可以表示为物体坐标的向量,以及另一个带独热编码标签的向量。
为此,你可以创建一个作为编码器(encoder)工作的子网络。它将使用(例如)一个或多个卷积层读取输入图像。编码器的最后一层是图像嵌入。然后你在嵌入层之上添加另外两个子网络:1)一个以嵌入向量为输入,预测物体的坐标;2)另一个以嵌入向量为输入,预测标签。
第一个子网络的最后一层可以是 ReLU,这很适合预测正的实数,如坐标。这个子网络可以使用均方误差代价 \(C_1\)。第二个子网络将接受相同的嵌入向量作为输入,并预测每个标签的概率。它的最后一层可以是 softmax,这适合多类分类,并使用平均负对数似然(negative log-likelihood)代价 \(C_2\)(也称为交叉熵代价)。或者,坐标可以位于 [0, 1] 范围内(在这种情况下,预测坐标的层将有四个逻辑 sigmoid 输出,并平均四个二元交叉熵代价函数),而预测标签的层可能解决一个多标签分类问题(在这种情况下,它也会有多个 sigmoid 输出,并平均多个二元交叉熵代价,每个标签一个)。
显然,你关心的是坐标和标签两者的准确预测。然而,不可能同时优化两个代价函数。试图改进其中一个,就有可能损害另一个,反之亦然。你能做的是添加另一个超参数 \(\gamma\),其值在 (0, 1) 范围内,并将组合代价函数定义为 \(\gamma \times C_1 + (1 - \gamma) \times C_2\)。然后你在验证数据上调优 \(\gamma\) 的值,就像任何其他超参数一样。
6.1.10 迁移学习
回忆一下,迁移学习包括使用预训练模型来构建新模型。预训练模型通常使用其创建者(通常是大型组织)可以获得的大数据创建,但这些数据不一定为你所用。预训练模型学到的参数可能对你的任务有用。
预训练模型可以通过两种方式使用:
- 1)它学到的参数可以用来初始化你自己的模型,或者
- 2)它可以用作你模型的特征提取器。
使用预训练模型作为初始化器
如前所述,参数初始化策略的选择会影响所学模型的性质。预训练模型,无论是互联网上可用的,还是你自己训练的,通常在解决原始学习问题上表现良好。
如果你当前的问题与预训练模型解决的问题相似,那么你当前问题的最优参数很可能与预训练参数相差不大,尤其是在神经网络的初始层(最接近输入的层)中。
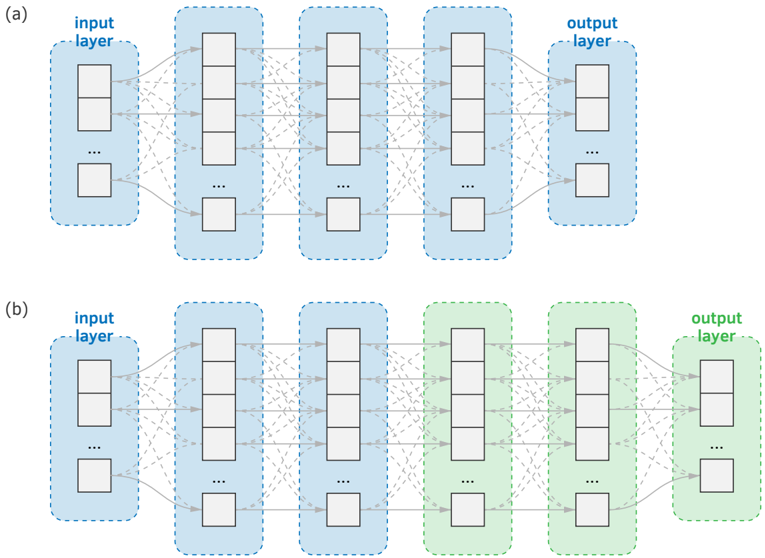
图 4:迁移学习示意图:(a) 预训练模型;(b) 你的模型,其中你使用了预训练模型的左侧部分,并添加了新层,包括针对你的问题定制的不同输出层。
你的问题学习起来可能会更快,因为梯度下降将在更小的潜在优良值区域中搜索最优参数值。
如果预训练模型是用比你的训练集大得多的训练集构建的,那么在潜在优良值区域中搜索也可能带来更好的泛化。确实,如果你想构建的模型的某些行为没有反映在你的训练示例中,这种行为仍然可以从预训练模型「继承」过来。
使用预训练模型作为特征提取器
如果你使用预训练模型作为你模型的初始化器,它会给你更多的灵活性。梯度下降将修改所有层中的参数,并可能为你的问题达到更好的性能。这样做的缺点是,你最终往往会训练一个非常深的神经网络。
一些预训练模型包含数百层和数百万个参数。训练这样的大型网络可能很有挑战性。它肯定需要大量的计算资源。此外,梯度消失(vanishing gradient)问题在深度神经网络中比在只有几个隐藏层的网络中更严重。
如果你的计算资源有限,你可能更愿意使用预训练模型的某些层作为你模型的特征提取器。在实践中,这意味着你只保留预训练模型的几个初始层,即最接近输入层并包括输入层的那些层。你保持它们的参数「冻结」,即不变也不可变。然后你在冻结层之上添加新层,包括适合你任务的输出层。在训练过程中,只有新层的参数会由梯度下降在你自己的数据上更新。
该过程的图示如图 4 所示。蓝色神经网络是预训练模型。蓝色层中的一部分在新模型中被复用,其参数被冻结;绿色层由分析师添加,并针对手头的问题定制。
分析师可以决定冻结新网络整个蓝色部分的参数,只训练绿色部分的参数。或者,也可以将最右侧的几个蓝色层设置为可训练的。
在新模型中使用预训练模型的多少层?冻结多少层?这取决于分析师:这是你将就最适合你问题的架构所做决定的一部分。
6.2 模型堆叠
集成学习(ensemble learning)是训练一个集成模型(ensemble model),它是多个基模型(base model)的组合,每个基模型单独的表现都比集成模型差。
6.2.1 集成学习的类型
有一些集成学习算法,如随机森林学习和梯度提升。它们训练一个由几百到几千个弱模型(weak model)组成的集成,并得到一个强模型,其性能显著优于每个弱模型。我们不会在这里讨论这些算法。如果你缺少这方面的知识,可以很容易地在专门的机器学习书籍中找到。3
组合多个模型能带来更好性能的原因是,当几个不相关的模型达成一致时,它们更有可能在正确的结果上达成一致。这里的关键词是「不相关」(uncorrelated)。理想情况下,基模型应该通过使用不同的特征获得,或者性质不同——例如,SVM 和随机森林。组合决策树学习算法的不同版本,或几个具有不同超参数的 SVM,可能不会带来显著的性能提升。
集成学习的目标是学会结合每个基模型的优势。有三种方法可以将弱相关的模型组合成集成模型:1)平均法(averaging),2)多数投票(majority vote),3)模型堆叠(model stacking)。
平均法适用于回归,以及那些返回分类分数的分类模型。它包括将你所有的基模型应用于输入 x,然后对预测取平均。要查看平均后的模型是否比每个单独算法表现更好,你可以使用你选择的指标在验证集上测试它。
多数投票适用于分类模型。它包括将你所有的基模型应用于输入 x,然后返回所有预测中的多数类别。在平局的情况下,你可以随机选择其中一个类别,或者如果错误分类会给业务带来重大损失,则返回一条错误消息。
模型堆叠是一种集成学习方法,它通过输入其他强模型的输出来训练一个强模型。让我们更详细地讨论模型堆叠。
6.2.2 模型堆叠算法
假设你想组合分类器 \(f_1\)、\(f_2\) 和 \(f_3\),它们都预测同一组类别。为了从原始训练示例 \((x_i, y_i)\) 为堆叠模型创建合成训练示例 \((\hat{x}_i, \hat{y}_i)\),设置 \(\hat{x}_i \leftarrow [f_1(x), f_2(x), f_3(x)]\),\(\hat{y}_i \leftarrow y_i\)。如图 5 所示。
图 5:三个弱相关的强模型进行堆叠。
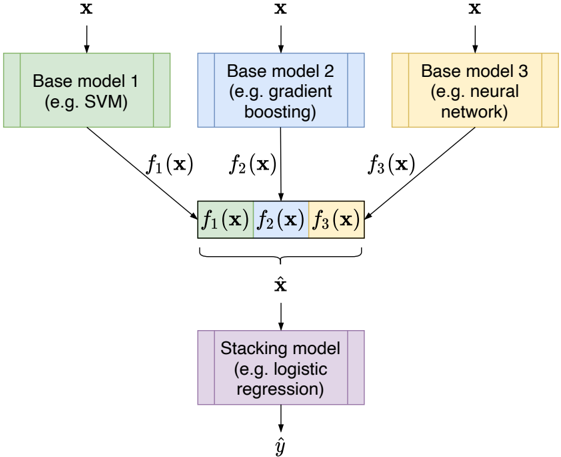
如果你的一些基模型返回一个类别加上一个类别分数,你可以使用这些分数作为堆叠模型的额外输入特征。
要训练堆叠模型,使用合成示例,并使用交叉验证来调优堆叠模型的超参数。确保你的堆叠模型在验证集上的表现优于每个被堆叠的基模型。
除了使用不同的机器学习算法和模型之外,为了让一些基模型弱相关,还可以通过随机采样原始训练集的示例和特征来训练它们。此外,使用差异很大的超参数值训练的同一学习算法,也能产生足够不相关的模型。
6.2.3 模型堆叠中的数据泄漏
为了避免数据泄漏(data leakage),训练堆叠模型时要小心。要为堆叠模型创建合成训练集,请遵循类似于交叉验证的过程。首先,将所有训练数据分成十个或更多块。块越多越好,但训练模型的过程会更慢。
暂时从训练数据中排除一个块,并在剩余块上训练基模型。然后将基模型应用于被排除块中的示例。获得预测,并使用基模型的预测为被排除块构建合成训练示例。
对其余每个块重复同样的过程,你最终会得到堆叠模型的训练集。新的合成训练集将与原始训练集大小相同。
6.3 处理分布偏移
回忆一下,保留数据必须类似于你在生产环境中观察到的数据。然而,有时无法获得足够大量的此类数据。与此同时,你可能可以获得与生产数据相似但不完全相同的带标签数据。例如,你可能从网络爬取(Web crawl)集合中获得大量带标签的图像,但你的目标是训练一个用于 Instagram 照片的分类器。你可能没有足够多的带标签 Instagram 照片用于训练,所以你希望使用网络爬取数据来训练模型,然后能够使用该模型对 Instagram 照片进行分类。
6.3.1 分布偏移的类型
当训练数据和测试数据的分布不相同时,我们称之为分布偏移(distribution shift)。处理分布偏移目前是一个开放的研究领域。研究人员区分三种类型的分布偏移:
- 协变量偏移(covariate shift)——特征值的变化;
- 概念漂移(concept drift)——特征与标签之间关系的变化;
- 先验概率偏移(prior probability shift)——目标值的变化。
你可能知道你的数据受到分布偏移的影响,但你通常不知道它是哪种类型的偏移。
如果测试集中的示例数量相对于训练集规模而言较高,你可以随机挑选一定比例的测试示例,将其中一些转移到训练集,一些转移到验证集。然后像往常一样训练模型。然而,通常情况下,你有非常多的训练示例,而相对较少的测试示例。在这种情况下,更有效的方法是使用对抗验证(adversarial validation)。
6.3.2 对抗验证
我们按如下方式为对抗验证做准备。我们假设训练示例和测试示例中的特征向量包含相同数量的特征,并且这些特征表示相同的信息。将你的原始训练集分成两个子集:训练集 1 和训练集 2。
通过如下转换训练集 1 中的示例来创建修改后的训练集 1:对于训练集 1 中的每个示例,将原始标签作为附加特征添加,然后为该示例分配新标签「训练」(Training)。
通过如下转换原始测试集中的示例来创建修改后的测试集:对于测试集中的每个示例,将原始标签作为附加特征添加,然后为该示例分配新标签「测试」(Test)。
合并修改后的训练集 1 和修改后的测试集,得到一个新的合成训练集。你将使用它来解决一个二元分类问题:区分「训练」示例和「测试」示例。使用该合成训练集,训练一个返回预测分数的二元分类器。
注意,我们训练的这个二元分类器将预测给定原始示例是训练示例还是测试示例。将该二元分类器应用于训练集 2 中的示例。识别被预测为「测试」的示例,即二元模型最有把握的那些。将这些示例用作你原始问题的验证数据。
从训练集 1 中移除二元模型以最高置信度预测为「训练」的示例。将训练集 1 中剩余的示例用作你原始问题的训练数据。
你必须通过实验找出将原始训练集划分为训练集 1 和训练集 2 的理想方式。你还必须弄清楚训练集 1 中要用多少示例进行训练,用多少进行验证。
6.4 处理类别不平衡数据集
在第 3 章的 ?? 节中,我们考虑了一些处理类别不平衡数据集(imbalanced dataset)的技术,如过采样和欠采样,以及生成合成数据。
在本节中,我们将考虑在学习过程中应用的额外技术,而不是在数据收集和准备阶段应用的技术。
6.4.1 类别加权
一些算法和模型,如支持向量机(support vector machine,SVM)、决策树(decision tree)和随机森林,允许数据分析师为每个类别提供权重。代价函数中的损失通常乘以该权重。例如,数据分析师可以为少数类提供更大的权重。这使得学习算法更难忽视少数类的示例,因为这样做会比没有类别加权时产生高得多的代价。
让我们看看它在支持向量机中是如何工作的。我们的问题是区分真实和欺诈性的电子商务交易。真实交易的示例要频繁得多。如果你使用带软间隔(soft margin)的 SVM,你可以为错误分类的示例定义代价。SVM 算法试图移动超平面以减少错误分类示例的数量。如果两个类别的错误分类代价相同,那么少数类的「欺诈」示例就有被错误分类的风险,以便正确分类更多多数类示例。这种情况如图 6a 所示。对于应用于不平衡数据集的大多数学习算法,都能观察到这个问题。
如果你把少数类错误分类的损失设得更高,那么模型将更加努力地避免错误分类这些示例。但这将以一些多数类示例被错误分类为代价,如图 6b 所示。
6.4.2 重采样数据集的集成
集成学习是缓解类别不平衡问题的另一种方式。分析师将多数类示例随机分成 H 个子集,然后创建 H 个训练集。在训练了 H 个模型之后,分析师通过对 H 个模型的输出取平均(或取多数)来进行预测。
图 6:不平衡问题示意图。(a) 两个类别具有相同的权重;(b) 少数类示例具有更高的权重。
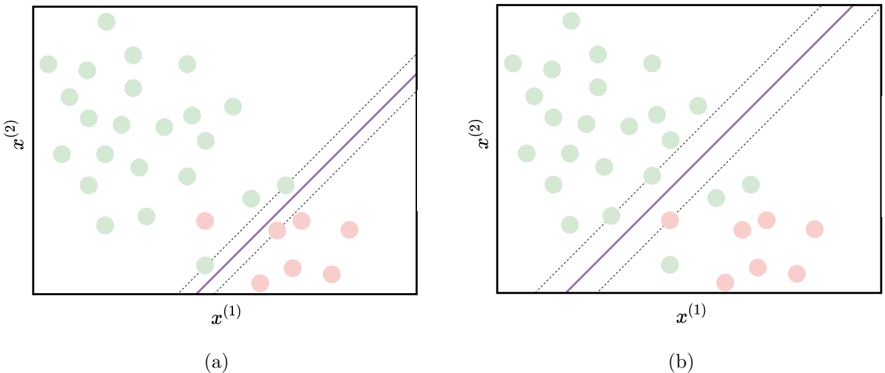
图 7:重采样数据集的集成。
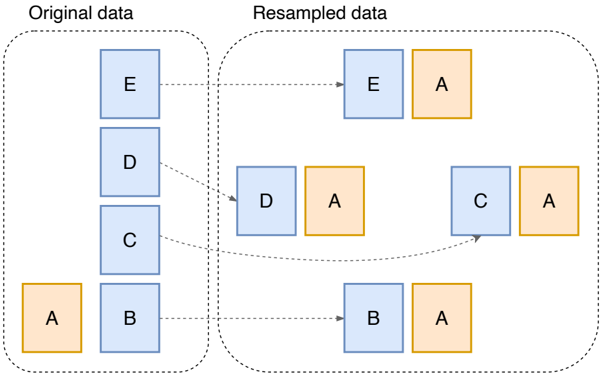
H = 4 的过程如图 7 所示。在这里,我们通过将多数类示例分成四个子集,将不平衡的二元学习问题转化为四个平衡问题。少数类示例被完整复制四次。
这种方法简单且可扩展:你可以在不同的 CPU 核心或集群节点上训练和运行你的模型。集成模型也往往比集成中的每个单独模型产生更好的预测。
6.4.3 其他技术
如果你使用随机梯度下降,可以通过几种方式解决类别不平衡问题。首先,你可以为不同的类别设置不同的学习率:多数类示例使用较低的值,其他示例使用较高的值。其次,每次遇到少数类示例时,你可以连续多次更新模型参数。
对于不平衡学习问题,模型性能使用调整过的性能指标来衡量,例如每类准确率(per-class accuracy)和我们在上一章 ?? 节中考虑过的科恩卡帕统计量。
6.5 模型校准
有时,分类模型不仅返回预测的类别,还返回预测类别正确的概率,这一点很重要。一些模型在返回预测类别的同时返回一个分数。即使它的值在 0 到 1 之间,它也未必是一个概率。
6.5.1 校准良好的模型
我们说模型是校准良好的(well-calibrated),当对于输入示例 x 和预测标签 \(\hat{y}\),它返回的分数可以被解释为 x 属于类别 \(\hat{y}\) 的真实概率。
例如,一个校准良好的二元分类器,对于大约 80% 实际属于正类的示例,会生成 0.8 的分数。
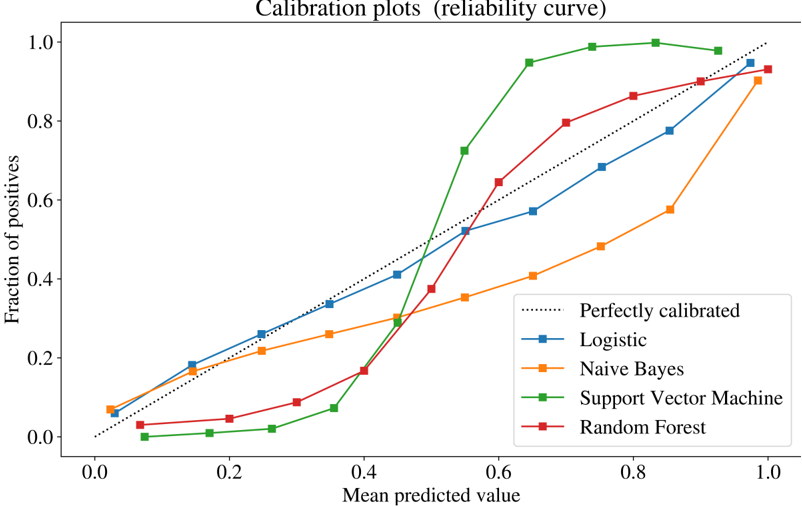
大多数机器学习算法训练的模型并不是校准良好的,如图 8 中的校准图(calibration plot)所示。4
二元模型的校准图可以让你看到模型的校准程度。X 轴上是按预测分数对示例进行分组的区间(bin)。例如,如果我们有 10 个区间,最左边的区间将所有预测分数在 [0, 0.1) 范围内的示例分组,而最右边的区间将所有预测分数在 [0.9, 1.0] 范围内的示例分组。Y 轴上是每个区间中正类示例的比例。
校准图(可靠性曲线)
图 8:将几种机器学习算法应用于随机二元数据集所训练模型的校准图。
对于多类分类,我们将以一对其余(one-versus-rest)的方式为每个类别绘制一个校准图。一对其余是将二元分类学习算法转换为解决多类分类问题的常见策略。其思想是将多类问题转化为 C 个二元分类问题,并构建 C 个二元分类器。例如,如果我们有三个类别,\(y \in \{1, 2, 3\}\),我们创建三个原始数据集的副本,并修改它们。在第一个副本中,我们将所有不等于 1 的标签替换为 0。在第二个副本中,我们将所有不等于 2 的标签替换为 0。在第三个副本中,我们将所有不等于 3 的标签替换为 0。现在我们有了三个二元分类问题,我们要学习区分标签 1 和 0、2 和 0、以及 3 和 0。正如你所看到的,在三个二元分类问题中的每一个里,标签 0 都表示「一对其余」中的「其余」。
当模型校准良好时,校准图围绕对角线振荡(如图 8 中的虚线所示)。校准图越接近对角线,模型校准得越好。因为逻辑回归模型返回正类的真实概率,所以它的校准图最接近对角线。当模型校准不佳时,校准图通常呈 sigmoid 形状,如支持向量机和随机森林模型所示。
6.5.2 校准技术
有两种常用于校准二元模型的技术:Platt 缩放(Platt scaling)和等渗回归(isotonic regression)。两者的原理相似。
假设我们有一个要校准的模型 f。首先,我们需要一个专门为校准留出的保留数据集。为了避免过拟合,我们不能使用训练或验证数据进行校准。设这个校准数据集的大小为 M。然后,我们将模型 f 应用于每个示例 \(i = 1, \ldots, M\),并为每个示例 i 获得预测 \(f_i\)。我们构建一个新数据集 Z,其中每个示例是一个对 \((f_i, y_i)\),\(y_i\) 是示例 i 的真实标签,标签取值为集合 {0, 1} 中的值。
Platt 缩放和等渗回归之间唯一的区别是:前者使用数据集 Z 构建逻辑回归模型,而后者构建 Z 的等渗回归,即一个尽可能接近示例的非递减函数。一旦我们有了校准模型 z(通过 Platt 缩放或等渗回归获得),我们就可以将输入 x 的校准概率预测为 \(z(f(x))\)。
请注意,校准后的模型可能会也可能不会为你的问题带来更好的预测质量。这取决于你选择的模型性能指标。
根据实验:5当预测概率中的失真呈 sigmoid 形状时,Platt 缩放最有效。等渗回归可以校正更广泛的失真类型。不幸的是,这种额外的能力是有代价的。分析表明,等渗回归更容易过拟合,因此在数据稀缺时,它的表现不如 Platt 缩放。
对八个分类问题的实验还表明,随机森林、神经网络和装袋决策树(bagged decision tree)是在校准之前预测良好校准概率的最佳学习方法,但在校准之后,最佳方法是提升树(boosted tree)、随机森林和 SVM。
6.6 故障排查与误差分析
对机器学习流水线进行故障排查是困难的。很难区分模型表现不佳是因为你的代码包含错误,还是你的训练数据、学习算法或流水线设计方式存在问题。此外,同样的性能下降可能由各种原因造成。学习结果可能对超参数或数据集构成的微小变化很敏感。
由于这些挑战,模型训练通常是一个迭代过程,分析师训练模型、观察其行为,并根据观察进行调整。
6.6.1 模型表现不佳的原因
如果你的模型在训练数据上表现不佳(欠拟合(underfit)),常见的原因是:
- 模型架构或学习算法的表达能力不足(尝试更先进的学习算法、集成方法(ensemble method)或更深的神经网络);
- 你为超参数选择了次优的值(调优超参数);
- 你正则化过度(减少正则化);
- 你工程化的特征没有足够的预测能力(添加更多信息性特征);
- 你的代码中有错误(调试定义和训练模型的代码);
- 你没有足够的数据让模型泛化(尝试获取更多数据、使用数据增强或迁移学习)。
如果你的模型在训练数据上表现良好,但在保留数据上表现不佳(过拟合(overfit)训练数据),常见的原因是:
- 你没有足够的数据用于泛化(添加更多数据或使用数据增强);
- 你的训练数据分布与保留数据分布不同(减少分布偏移);
- 你的模型正则化不足(添加正则化,或者对于神经网络,同时添加正则化和批归一化);
- 你为超参数选择了次优的值(调优超参数);或者
- 你的特征预测能力低(添加预测能力高的特征)。
6.6.2 迭代式模型改进
如果你能获得新的带标签数据(例如,你可以自己标注示例,或者很容易请标注者帮忙),那么你可以使用一个简单的迭代过程来改进模型:
- 使用迄今确定的最佳超参数值训练模型。
- 通过将模型应用于验证集的一个小子集(100–300 个示例)来测试模型。
- 找出那个小验证集上最频繁的错误模式。将这些示例从验证集中移除,因为你的模型现在会对它们过拟合。
- 生成新特征,或添加更多训练数据,以修复观察到的错误模式。
- 重复,直到不再观察到频繁的错误模式(大多数错误看起来各不相同)。
迭代式模型改进是误差分析(error analysis)的简化版本。下面描述一种更有原则的方法。
6.6.3 误差分析
误差可以是:
- 均匀的(uniform),在所有用例中以相同的频率出现,或者
- 集中的(focused),在特定类型的用例中更频繁地出现。
遵循特定模式的集中误差值得特别关注。通过修复一个错误模式,你可以一次性地为许多示例修复它。集中误差或误差趋势,通常发生在某些用例在训练数据中没有得到充分表示时。例如,一家大型网络摄像头供应商开发的人脸检测系统对白人用户的效果优于黑人用户。在另一个案例中,配备夜视系统的人体存在检测系统在白天比在夜晚效果更好,仅仅是因为训练数据中夜晚的训练示例较少。
均匀误差无法完全避免,但重要的集中误差应该在模型部署到生产环境之前被发现。这可以通过对测试示例进行聚类,并在来自不同聚类的示例上测试模型来实现。生产(在线)数据的分布可能与用于模型训练/部署前测试的离线数据分布显著不同。因此,在离线数据中包含少量示例的聚类,可能代表在线场景中更频繁的用例。
在第 4 章的 ?? 节中,我们讨论了几种降维技术。除了使用聚类来发现错误趋势之外,还可以使用统一流形逼近与投影(uniform manifold approximation and projection,UMAP)或自编码器(autoencoder)。使用这些技术将数据降维到 2D,然后目视检查误差在数据集中的分布。
更具体地说,你可以在 2D 散点图上可视化数据,为不同类别的示例使用不同的颜色。为了在散点图上识别误差趋势,根据模型的预测是否正确使用不同的标记。例如,用圆圈表示标签被正确预测的示例,用方块表示其他示例。这将让你看到模型性能不佳的区域。如果你处理的是感知性数据,如图像或文本,目视检查那些性能不佳区域中的一些示例也很有帮助。
无论你对模型在保留数据上的性能满意还是不满意,你总是可以通过分析单个误差来改进模型。如前所述,最好的方式是迭代工作,一次考虑 100–300 个示例。通过一次考虑少量示例,你可以在每次迭代后重新训练模型,从而快速迭代,但仍然考虑足够的示例以发现明显的模式。
你如何决定一个错误模式是否值得花时间修复?你可以基于错误模式频率(error pattern frequency)来做这个决定。让我们看看它是如何工作的。
假设你的模型准确率为 80%,这对应于 20% 的误差率。如果你修复所有错误模式,你最多可以将模型性能提高 20 个百分点。如果你的小型误差分析批次是 300 个示例,你的模型犯了 \(0.2 \times 300 = 60\) 个错误。
逐个观察这些误差,并尝试了解输入中的哪些特殊性导致了这 60 个示例的错误分类。为了更具体,假设我们的分类问题是检测街上的行人图像。假设在 300 张图像中有 60 张,模型未能检测到行人。经过仔细分析,你发现两种模式:1)40 个示例中图像模糊,2)5 个示例中照片是在夜间拍摄的。现在,你应该花时间解决这两个问题吗?
如果你解决模糊图像问题(例如,通过向训练数据添加更多带标签的模糊图像),你可以期望将误差降低 \((40 / 60) \times 20 = 13\) 个百分点。在最好的情况下,解决模糊图像错误分类问题后,你的误差变为 \(20 - 13 = 7\) 个百分点,相比初始 20% 的误差有显著下降。
另一方面,如果你解决夜间图像问题,你可以期望将误差降低 \(5 / 60 \times 20 = 1.7\) 个百分点。所以,在最好的情况下,你的模型将产生 \(20 - 1.7 = 18.3\) 个百分点的误差,这对某些问题可能意义重大,对其他问题则可能无关紧要。收集额外带标签的夜间图像的成本可能很高,可能不值得付出努力。
要修复一个错误模式,你可以使用以下一种或多种技术的组合:
- 预处理输入(例如,图像背景去除、文本拼写纠正);
- 标注更多训练示例;
- 数据增强(例如,图像的模糊或裁剪);
- 工程化新特征,使学习算法能够区分「困难」的案例。
6.6.4 复杂系统中的误差分析
假设你在一个复杂的文档分类系统上工作,该系统由三个串联的模型组成,如下所示:
图 9:一个复杂的文档分类系统。
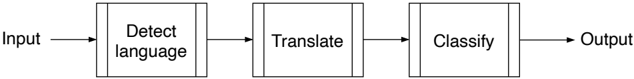
假设整个系统的准确率为 73%。如果分类是二元的,73% 的准确率似乎不高。另一方面,如果分类模型(图 9 中最右边的块)支持数千个类别,那么 73% 的准确率看起来就不那么低了。然而,对于某些业务场景,用户可能期望达到人类水平,甚至超人水平的表现。
想象一下你处于这样的位置:业务方期望你构建的文档分类系统达到高于 73% 的性能。为了从你额外的努力中获得最大收益,你必须决定首先需要改进系统的哪个部分。
当关于某事的决策是在几个串联的层级上做出的(如图 9 所示的问题),并且这些决策彼此独立时,准确率会相乘。
例如,如果语言预测器的准确率为 95%,机器翻译模型的准确率为690%,分类器的准确率为 85%,那么在三个模型相互独立的情况下,整个三阶段系统的总体准确率将是 \(0.95 \times 0.90 \times 0.85 = 0.73\),即 73%。乍一看,似乎很明显,整个系统准确率的最大提升来自最大化第三个模型——分类器——的准确率。然而,在实践中,给定模型犯的一些错误可能不会显著影响系统的整体性能。例如,如果语言预测器经常混淆西班牙语和葡萄牙语,机器翻译模型可能仍然能够为第三阶段的分类模型生成足够的翻译。
在处理第三阶段分类器时,你可能已经得出结论,你达到了它的最大性能,所以继续下去没有意义。现在,前两个模型——语言检测器和/或机器翻译器——中应该改进哪一个,以提高整个三阶段系统的质量?
确定整个系统潜力的上限的一种方法是进行分部误差分析(error analysis by parts)。你将一个模型的预测替换为完美标签,例如人工提供的标签。然后你计算整个系统的表现。例如,与其使用图 9 中第二阶段的机器翻译系统,你可以请专业的人类翻译员将文本从预测的语言翻译过来(如果语言预测正确的话),或者保留原文(如果语言预测错误的话)。
假设你请一位专业人士翻译了一百段文本。现在你可以衡量完美翻译对系统整体性能的影响。假设整个系统输出的准确率变为 74%。那么,改进翻译对系统整体性能的潜在收益只有一个百分点。为机器翻译模型达到人类水平的表现可能是一项艰巨的任务,不值得付出努力,尤其是当我们最终能获得的只是整个系统一个百分点的收益时。因此,如果第一阶段构建更好的语言预测器对系统整体性能预测质量的潜在收益更高,你可能更愿意花更多时间在那里。
6.6.5 使用切片指标
如果模型将应用于不同细分(segment)的用例,则应该为每个细分分别测试。例如,如果你想预测借款人的偿付能力,你会希望你的模型对男性和女性借款人都同样准确。为了实现这一点,你可以将验证数据分成几个子集,每个细分一个子集。然后通过将模型分别应用于每个子集来计算性能指标。
或者,你可以通过应用精确率(precision)和召回率(recall)指标来分别评估每个类别上的模型。请记住,这些指标只针对二元分类定义。通过在你的多类分类问题中隔离一个类别,并将其他类别标记为「其他」(Other),你可以单独计算每个类别的精确率和召回率。
如果你看到性能指标的值在细分或类别之间发生变化,你可以尝试通过向模型性能不令人满意的细分或类别添加更多带标签的数据,或工程化额外特征来修复问题。
6.6.6 修复错误标签
当人类为训练示例标注标签时,分配的标签可能是错误的。这可能导致模型在训练数据和保留数据上都表现不佳。确实,如果相似的示例具有相互冲突的标签——有些正确,有些不正确——学习算法可能会学习预测错误的标签。
这里有一个识别标签错误示例的简单方法。将模型应用于构建它的训练数据,并分析那些模型做出与人类提供的标签不同的预测的示例。如果你看到一些预测确实是正确的,就更改那些标签。
如果你有时间和资源,你也可以检查分数接近决策阈值(decision threshold)的预测。这些通常也是被错误标注的情况。
如果训练数据中的错误标签是一个严重问题,你可以通过让几个人为同一个训练示例提供标签来避免它。只有当所有人为该示例分配了相同的标签时才接受它。在要求不那么严格的情况下,如果大多数人分配了某个标签,你可以接受该标签。
6.6.7 寻找更多需要标注的示例
如上所述,误差分析可以揭示需要来自特征空间特定区域的更多带标签数据。你可能拥有大量未标注的示例。你应该如何决定标注哪些示例,以最大化对模型的积极影响?
如果你的模型返回预测分数,一种有效的方法是使用你最好的模型为未标注的示例打分。然后标注那些预测分数接近预测阈值的示例。
当误差分析通过可视化揭示了错误模式时,那么就选择那些被许多带有预测错误的示例包围的示例。
6.6.8 深度学习故障排查
为了避免训练深度模型时出现问题,请遵循下面所示的工作流:
图 10:深度学习故障排查工作流。
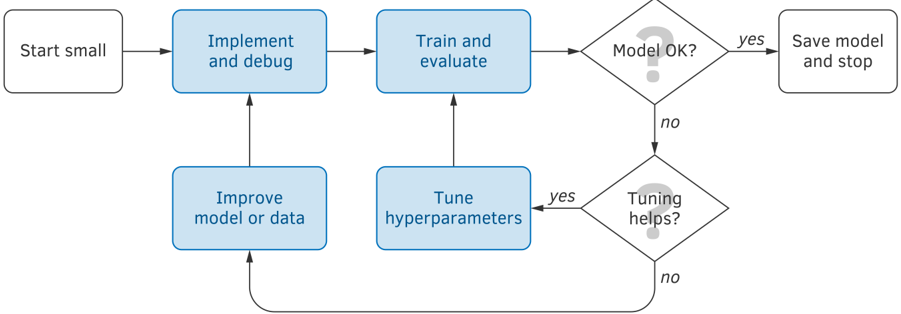
尽可能从小处开始,例如,使用 Keras 等高级库的简单模型。它应该非常容易进行目视验证,理想情况下最多适合两屏。
或者,复用已被证明有效的现有开源架构(注意代码许可证!)。从以下开始:
- 一个适合内存的小型、规范化数据集,
- 一个初始化策略(例如随机正态),
- 最容易使用的代价函数优化器(例如 Adam),
- 代价函数优化器和层两者的敏感超参数的默认值,以及
- 不使用正则化。
一旦你有了第一个简化模型架构和数据集,暂时将训练数据集进一步缩小到一个小批量的大小。然后开始训练。确保你的简化模型能够过拟合这个训练小批量。如果小批量的过拟合没有发生,这是一个可靠的迹象,表明你的代码或数据有问题。寻找以下迹象7及其可能的原因:
表 2:神经网络模型无法过拟合一个小批量时的常见迹象及最可能的原因。
| 迹象 | 可能的原因 |
|---|---|
| 误差上升 | 损失函数或梯度的符号被翻转;学习率过高;softmax 在错误的维度上计算 |
| 误差爆炸 | 数值问题;学习率过高 |
| 误差振荡 | 数据或标签损坏(例如被置零或错误地打乱);学习率过高 |
| 误差停滞 | 学习率过低;梯度未流过整个模型;正则化过强;输入到损失函数的内容不正确;数据或标签损坏 |
一旦你的模型过拟合了一个小批量,回到整个数据集,训练、评估,然后调优超参数,直到验证数据上不再有改进空间。
如果模型性能仍然不令人满意,更新模型(例如,通过增加其深度或宽度),或更新训练数据(例如,通过更改预处理或添加特征)。通过再次过拟合一个小批量来调试更改,然后训练、评估和调优新模型。持续迭代,直到你对模型的质量满意为止。
在搜索模型的最佳架构时,方便的做法不仅是使用更小的训练集,还可以通过以下方式简化问题:
- 创建简单的合成训练集,或者
- 减少类别数,或降低输入图像(或视频片段)的分辨率、文本的大小、声音频率的比特率等等。
在图 10 所示的深度学习故障排查工作流的评估步骤中,验证模型性能不佳是否可能是 6.6.1 节列出的原因之一造成的。根据性能是否可以通过调优超参数、更新模型、特征或训练数据来改进,选择下一步。
6.7 最佳实践
在本节中,我汇集了关于训练机器学习模型的实用建议。下面的最佳实践不是严格的规定。它们更像是经常能节省时间、精力的建议,并可能带来更高质量的结果。
6.7.1 交付一个好模型
什么是好模型?一个好模型有两个性质:
- 根据性能指标,它具有期望的质量;并且
- 它在生产环境中可以安全地提供服务。
模型可以安全提供服务意味着满足以下要求:
- 它在加载时,或在加载了糟糕或意外的输入时,不会崩溃或在服务系统中引起错误;
- 它不会使用不合理的资源量(如 CPU、GPU 或 RAM)。
6.7.2 信赖流行的开源实现
现代流行的编程语言和平台(如 Python、Java 和 .NET)中的机器学习开源库和模块,包含流行机器学习算法的高效、行业标准实现。它们通常具有宽松的许可证。此外,还有专门用于训练神经网络的开源库和模块。
只有在使用小众或非常新的编程语言时,创建你自己的机器学习算法才被认为是合理的。此外,如果模型要在资源极度受限的环境中执行,或者你需要以现有实现无法提供的速度运行你的模型,你才可能从零编程。
避免在同一项目中使用多种编程语言。使用不同的编程语言会增加测试、部署和维护的成本。这也使得在员工之间转移项目所有权变得困难。
6.7.3 优化业务特定的性能度量
学习算法试图减少训练数据误差。反过来,数据分析师希望最小化测试数据误差。然而,你的客户或雇主通常希望你优化业务特定的性能指标(business-specific performance metric)。
当你已经最小化验证误差率时,专注于调优优化业务特定指标的超参数,即使这会导致验证误差率上升。
6.7.4 从头升级
一旦部署到生产环境,一些模型必须定期用新数据更新,以适应不断变化的需求。这些新的训练数据必须使用脚本自动收集(正如我们在第 3 章中关于可复现性的 ?? 节所讨论的)。
每次数据更新时,超参数都必须从头调优。否则,新数据使用旧超参数可能会产生次优性能。
一些模型,如神经网络,可以迭代升级。然而,要避免热启动(warm-starting)的做法。它包括仅使用新的训练示例并运行额外的训练迭代来迭代升级现有模型。
此外,不从头重新训练而频繁升级模型可能导致灾难性遗忘(catastrophic forgetting)。这是一种曾经能做某事模型「忘记」了该能力的情况,因为它学习了新东西。
请注意,升级模型与迁移学习不是一回事。当用于构建预训练模型的数据或足够的计算资源不可用时,分析师会使用迁移学习。
6.7.5 避免校正级联
你可能有一个解决问题 A 的模型 \(m_A\),但你需要一个针对略有不同的问题 B 的解决方案 \(m_B\)。使用 \(m_A\) 的输出作为 \(m_B\) 的输入,并且只在少量「校正」\(m_A\) 输出以解决问题 B 的示例上训练 \(m_B\),这可能很有诱惑力。这种技术被称为校正级联(correction cascading),不建议使用。
模型级联使得不更新模型 \(m_B\)(以及级联的其余部分)就无法更新模型 \(m_A\)。\(m_A\) 的变化可能对 \(m_B\) 产生的影响是无法预测的,但很可能是负面的。此外,\(m_B\) 的开发者可能不知道 \(m_A\) 的变化,而 \(m_A\) 的开发者可能不知道 \(m_B\) 依赖它。\(m_A\) 的变化对 \(m_B\) 的负面影响可能在很长一段时间内不被注意到。
与其构建校正级联,建议更新模型 \(m_A\),使其包含解决问题 B 的用例。添加允许模型区分问题 B 示例的特征是明智的。也可以使用迁移学习,或者为解决问题 B 构建一个完全独立的模型。
6.7.6 谨慎使用模型级联
值得注意的是,模型级联并不总是不好的做法。使用一个模型的输出作为另一个模型的众多输入之一,是很常见的。它可以显著缩短上市时间。然而,必须谨慎使用级联,因为级联中一个模型的更新必须涉及级联中所有模型的更新,从长远来看,这最终可能是昂贵的。
为了减轻模型级联的负面影响,有两种策略是有益的:
分析软件系统中的信息流,并更新或重新训练整个链条。模型 \(m_A\) 更新后的输出必须反映在模型 \(m_B\) 的训练数据中。
控制谁可以、谁不可以调用模型 \(m_A\),以防止未声明的消费者造成这个问题。正如 Google 的工程师所说:8「在没有障碍的情况下,工程师们自然会使用手头最方便的信号,尤其是在时间压力下工作时。」
此外,模型输出的预测不应只是一个数字或字符串。它应该附带关于生产模型以及应如何使用它的信息。
6.7.7 编写高效代码、编译与并行化
通过编写快速高效的代码,与你在实验期间编写的低效的快速草稿脚本(只是为了「让它跑起来」)相比,你可以将训练速度提高一个数量级。现代数据集很大,所以你可能要等几个小时甚至几天进行数据预处理。训练也可能需要几天,有时甚至几周。
始终以效率为出发点编写代码,即使它看起来是一个你不会经常运行的函数、方法或脚本。一些本应只运行一次的代码可能会在循环中被调用数百万次。
避免使用循环。例如,如果你需要计算两个向量的点积,或将矩阵乘以向量,请使用科学库和模块中快速高效的点积或矩阵乘法方法。这类高效实现的例子是 Python 的 NumPy 和 SciPy 库。才华横溢、技艺精湛的软件工程师和科学家创建了这些库和模块。它们依赖 C 等低级编程语言以及硬件加速,运行速度快得惊人。
在可能的情况下,在执行前编译代码。诸如 Python 的 PyPy 和 Numba,或 R 的 pqR 等库会将代码编译成操作系统(operating system,OS)原生的二进制代码,这可以显著提高数据处理和模型训练的速度。
另一个重要方面是并行化(parallelization)。如果你使用现代库和模块,你可以找到利用多核 CPU 的学习算法。有些允许 GPU 加速神经网络和许多其他模型的训练。一些模型(如 SVM)的训练无法有效并行化。在这种情况下,你仍然可以通过并行运行多个实验来利用多核 CPU。为每个超参数值组合、地理区域或用户细分运行一个实验。此外,让每个交叉验证折与其他折并行计算。
在可能的情况下,使用固态硬盘(solid-state drive,SSD)存储数据。使用分布式计算;一些学习算法的实现被设计为在分布式计算环境中运行,如 Spark。尝试将所有需要的数据放入你的笔记本电脑或服务器的 RAM 中。如今,数据分析师在拥有 512 GB 甚至一个或多个 TB RAM 的服务器上工作并不罕见。
通过将训练模型所需的时间降到最低,你可以花更多时间调整模型、测试数据预处理想法、特征工程、神经网络架构和其他创造性活动。机器学习项目最大的收益在于人的参与和直觉。作为人,你能工作的时间越多(而不是等待),你的机器学习项目成功的几率就越高。
将胶水代码(glue code)降到最低。Google 工程师是这样说的。机器学习研究人员倾向于将通用解决方案开发为自包含的包。大量的这类包可以作为开源包、内部代码、专有包和基于云的平台获得。使用通用包通常会导致胶水代码系统设计模式,即编写大量支持代码来将数据送入和送出通用包。
胶水代码长期来看代价高昂。它倾向于将系统冻结在特定包的特性上。测试替代方案的成本可能高得令人望而却步。以这种方式使用通用包会阻碍改进。利用领域特定属性、调整目标函数和实现领域特定目标变得更加困难。一个成熟的系统可能变成(最多)5% 的机器学习代码和(至少)95% 的胶水代码。创建干净的本地解决方案可能比重用通用包成本更低。
对抗胶水代码的一个重要策略是将黑盒机器学习包包装成整个组织使用的通用 API。基础设施变得更具可重用性,并降低了更换包的成本。
建议学会在至少两种编程语言之间切换:一种用于快速原型设计(如 Python),一种用于快速实现(如 C++)。像 Go、Kotlin 和 Julia 这样的现代语言可能对这两种情况都很好,但在本书写作时,与更成熟的语言相比,这两种语言还没有发展出机器学习项目的生态系统。
6.7.8 在新旧数据上都进行测试
如果你使用了不久前的一个数据转储来创建训练集、验证集和测试集,请观察你的模型在使用该时间段之前和之后收集的数据上的行为。如果表现差得多,就有问题。
数据泄漏和分布偏移可能是最可能的原因。回忆一下,数据泄漏是指使用了未来或过去无法获得的信息来工程化特征。分布偏移是指数据的属性随时间变化。
6.7.9 更多数据胜过更聪明的算法
当模型性能不足时,为了改进模型性能,分析师经常倾向于设计更复杂的学习算法或流水线。
然而,在实践中,更好的结果往往来自获得更多数据,特别是更多带标签的示例。如果设计得当,数据标注过程可以让标注者每天产生几千个训练示例。与发明更先进的机器学习算法所需的专业知识相比,它也可能更便宜。
6.7.10 新数据胜过更巧妙的特征
如果尽管添加了更多训练示例并设计了巧妙的特征,你的模型性能仍然停滞不前,请考虑不同的信息来源。
例如,如果你想预测用户 U 是否会喜欢一篇新闻文章,尝试添加关于用户 U 的历史数据作为特征。或者对所有用户进行聚类,并使用与用户 U 最近的 k 个邻居的信息作为新特征。与编程非常复杂的特征或以复杂方式组合现有特征相比,这是一种更简单的方法。
6.7.11 拥抱微小的进步
对模型的许多微小改进可能比寻找一个革命性的想法更快地给出预期结果。
此外,通过尝试不同的想法,分析师能更好地了解数据,这可能确实有助于找到那个革命性的想法。
6.7.12 促进可复现性
大多数机器学习算法是随机的。例如,当我们训练神经网络时,我们随机初始化模型参数;小批量随机梯度下降随机生成小批量;随机森林中的决策树是随机构建的;当我们在将数据分成三个集合之前打乱示例时,我们是随机进行的;等等。这意味着当你两次在相同数据上训练模型时,你最终可能会得到两个不同的模型。为了促进可复现性(reproducibility),建议设置用于初始化伪随机数生成器(pseudorandom number generator)的随机种子(random seed)的值。如果你的随机种子保持不变,那么如果你的数据不变,你每次训练都会得到完全相同的模型。
随机种子可以设置为 np.random.seed(15)(在 NumPy 和 scikit-learn 中)、TensorFlow 中的 tf.random.set\_seed(15)、torch.manual\_seed(15)(在 PyTorch 中)和 set.seed(15)(在 R 中)。只要种子值保持不变,具体是多少并不重要。
即使机器学习框架允许我们设置随机种子的值,也无法保证框架中使用随机化的代码在框架版本之间不会改变。为了保证可复现性,每个项目的依赖项都应该被隔离。这可以通过多种方式完成:要么使用 Python 中的 virtualenv 和 R 中的 Packrat 等工具,要么在标准化的虚拟机或容器(container)中运行机器学习实验。我们将在第 8 章的 ?? 节中更多地讨论虚拟化。
交付模型时,确保它附带所有与可复现性相关的信息。除了数据集和特征的描述(如 ?? 节和 ?? 节中考虑的文档和元数据)之外,每个模型都应包含包含以下细节的文档:
- 所有超参数的规格说明,包括考虑过的范围和使用的默认值,
- 用于评估候选模型的特定度量或统计量的定义,以及它对于最佳模型的值,
- 用于选择最佳超参数配置的方法,
- 所用计算基础设施的描述,以及
- 每个训练模型的平均运行时间,以及训练的估计成本。
6.8 小结
与训练浅层模型相比,深度模型训练策略涉及更多可变的环节。同时,它也更有章可循,更适合自动化。
与其从头训练你的模型,从预训练模型开始可能更有用。能够访问大数据的组织已经训练并开源了非常深的神经网络,其架构针对图像或自然语言处理任务进行了优化。
预训练模型可以通过两种方式使用:1)它学到的参数可以用来初始化你自己的模型,或者 2)它可以用作你模型的特征提取器。
使用预训练模型来构建你自己的模型被称为迁移学习。深度模型允许迁移学习这一事实,是深度学习最重要的性质之一。
小批量随机梯度下降及其变体是深度模型最常用的代价函数优化算法。
反向传播算法使用复杂函数导数的链式法则计算每个深度模型参数的偏导数。在每个轮次中,梯度下降使用偏导数更新所有参数。学习率控制一次更新的重要程度。这个过程一直持续到收敛,即每个轮次之后参数值变化不大的状态。然后算法停止。
小批量随机梯度下降有几个流行的升级版,如动量、RMSProp 和 Adam。这些算法根据学习过程的表现自动更新学习率。你不需要选择学习率的初始值、衰减计划和衰减率,或其他相关超参数的值。这些算法在实践中表现出良好的性能,从业者经常使用它们,而不是试图手动调优学习率。
除了 L1 和 L2 正则化之外,神经网络还受益于神经网络特有的正则化方法:丢弃、早停和批归一化。丢弃是一种简单但非常有效的正则化方法。使用批归一化是一种最佳实践。
集成学习是训练一个集成模型,它是多个基模型的组合,每个基模型单独的表现都比集成模型差。有一些集成学习算法,如随机森林和梯度提升,构建由几百到几千个弱模型组成的集成,并得到一个强模型,其性能显著优于每个弱模型。
强模型可以通过对其输出取平均(用于回归)或进行多数投票(用于分类)来组合成集成模型。模型堆叠是集成方法中最有效的,它训练一个元模型(meta-model),以基模型的输出作为输入。
除了使用过采样和欠采样之外,不平衡学习问题还可以通过应用类别加权和重采样数据集的集成来解决。如果你使用随机梯度下降训练模型,还可以通过另外两种方式解决类别不平衡问题:1)为不同类别设置不同的学习率,2)每次遇到少数类示例时连续多次更新模型参数。
对于不平衡学习问题,模型性能使用调整过的性能指标来衡量,例如每类准确率和科恩卡帕统计量。
对机器学习流水线进行故障排查可能很困难。性能不佳可能由代码中的错误、训练数据错误、学习算法问题或流水线设计造成。此外,学习可能对超参数和数据集构成的微小变化很敏感。
机器学习模型犯的误差可以是均匀的,在所有用例中以相同频率出现,也可以是集中的,只在特定类型的用例中出现。
集中误差是那些值得特别关注的误差,因为通过修复一个错误模式,你可以一次性地为许多示例修复它。
模型的性能可以使用以下简单过程迭代改进:
- 使用迄今确定的最佳超参数值训练模型。
- 通过将模型应用于验证集的一个小子集(100–300 个示例)来测试模型。
- 找出那个小验证集上最频繁的错误模式。将这些示例从验证集中移除,因为你的模型现在会对它们过拟合。
- 生成新特征,或添加更多训练数据,以修复观察到的错误模式。
- 重复,直到不再观察到频繁的错误模式(大多数错误看起来各不相同)。
在复杂的机器学习系统中,误差分析是分部进行的。我们首先将一个模型的预测替换为完美标签(如人工提供的标签),看看整个系统的性能提高了多少。如果它显著提高,那么必须在该特定模型的改进上投入更多努力。
为了保证可复现性,设置随机种子,并确保模型附带所有相关信息。
反向传播的解释超出了本书的范围。你只需要知道,每个用于训练神经网络的现代软件库都包含该算法的实现。好奇的读者可以在《百页机器学习书》(The Hundred-Page Machine Learning Book)扩展版的配套维基上找到反向传播的解释。 ↩︎
摘自 Josh Tobin 等人于 2019 年 1 月发表的演讲「Troubleshooting Deep Neural Networks(深度神经网络故障排查)」。 ↩︎
你可以在《百页机器学习书》第 7 章中了解集成学习算法。 ↩︎
该图改编自 https://scikit-learn.org/stable/modules/calibration.html。 ↩︎
Alexandru Niculescu-Mizil 和 Rich Caruana,《Predicting Good Probabilities With Supervised Learning(用监督学习预测良好概率)》,发表于第 22 届国际机器学习大会论文集,德国波恩,2005 年。 ↩︎
在实践中,衡量机器翻译系统的误差很棘手,因为翻译很少是完全准确或不准确的。取而代之的是使用 BLEU(双语评估替补分数,Bilingual Evaluation Understudy Score)分数等度量。 ↩︎
改编自 Josh Tobin 等人于 2019 年 1 月发表的演讲「Troubleshooting Deep Neural Networks(深度神经网络故障排查)」。 ↩︎
Sculley 等人,《Hidden Technical Debt in Machine Learning Systems(机器学习系统中的隐藏技术债务)》(2015 年)。 ↩︎