监督式模型训练(第一部分)
模型训练(model training,又称建模,modeling)是机器学习项目生命周期的第四个阶段:
图 1:机器学习项目生命周期。
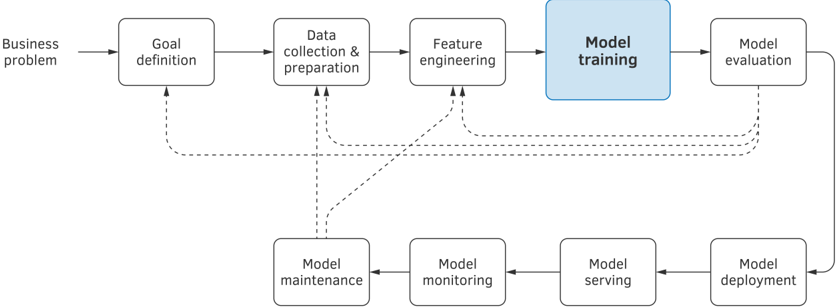
显然,没有训练,就不会构建出任何模型。然而,模型训练是机器学习中最被高估的活动之一。平均而言,机器学习工程师只把 5%–10% 的时间花在建模上,甚至可能更少。成功的数据收集、准备和特征工程(feature engineering)更为重要。通常,建模只是把 scikit-learn 或 R 中的某个算法应用到你的数据上,再随机尝试几组超参数(hyperparameter)组合而已。所以,如果你跳过了前面两章直接跳到建模,请回去读一读那些章节,它们很重要。
正如本章标题所示,我把监督式模型训练分成了两部分。在第一部分中,我们将讨论学习准备、选择学习算法、浅层学习策略、评估模型性能、偏差-方差权衡(bias-variance tradeoff)、正则化(regularization)、机器学习流水线(pipeline)的概念,以及超参数调优(hyperparameter tuning)。
5.1 开始建模之前
在着手模型之前,你应该验证数据与模式的一致性,定义可达到的性能水平,选择性能指标,并做出其他几项决策。
5.1.1 验证数据符合模式
首先,确保数据符合模式文件(schema file)所定义的模式。即使数据最初是由你准备的,原始数据和当前数据也很可能不一样。这种差异可以由多种因素解释,最可能的是:
- 用于将数据持久化到硬盘或数据库的方法包含错误;
- 其他人可能在未通知你的情况下更改了数据或模式;
- 你用来从持久化位置读取数据的方法包含错误。
这些模式错误必须像检测编程代码错误一样被检测、识别和纠正。如有必要,应从头重新运行整个数据收集和准备流水线,正如我们在第 3 章末尾讨论可复现性(reproducibility)时所说的那样。
5.1.2 定义可达到的性能水平
定义可达到的性能水平是至关重要的一步。它让你知道什么时候该停止尝试改进模型。以下是一些指导原则:
- 如果一个人不需要太多努力、数学或复杂的逻辑推导就能标注示例,那么你可以期望你的模型达到人类水平的性能;
- 如果输入特征向量包含大量信号(如图像中的像素或文档中的单词),你可以期望接近零误差;
- 如果做出标注决策所需的信息完全包含在特征中,你可以期望接近零误差;
- 如果你有一个能解决相同分类或回归问题的计算机程序,你可以期望你的模型至少表现得一样好。通常,随着更多带标签数据的到来,机器学习模型的性能还可以提高;以及
- 如果你观察到一个相似但不同的系统,你可以期望得到一个相似但不同的机器学习模型性能。
5.1.3 选择性能指标
我们稍后会讨论如何评估模型性能。目前,有几种指标(metrics)可以用来估计模型性能的水平(即其质量)。没有一个适用于所有项目的最佳指标。你将根据你的数据和问题来选择。
建议你在开始建模之前选择一个且仅一个性能指标。然后,使用这一个指标来比较不同的模型并跟踪整体进度。
在第 5.5 节中,你将读到最流行、最实用的模型性能指标,以及将多个指标组合成单一数值的方法。
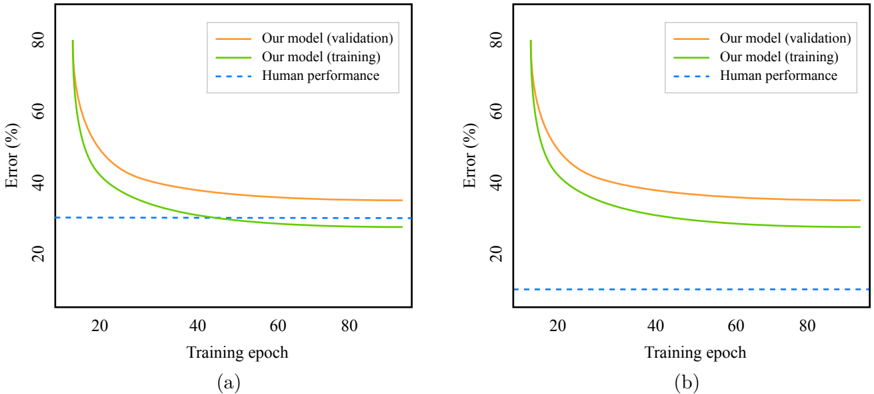
图 2:模型性能与人类性能基线的比较:(a) 模型看起来不错,因此我们可以决定对其进行正则化或添加更多训练示例;(b) 模型表现不佳,因此我们需要添加更多特征或增加模型复杂度。
5.1.4 选择合适的基线
在开始构建预测模型之前,为你的问题建立一个基线(baseline)性能很重要。基线是提供比较参考点的模型或算法。
拥有基线能让分析师确信基于机器学习的解决方案是有效的。如果机器学习模型的性能指标值优于使用基线获得的值,那么机器学习就提供了价值。
将当前模型的性能与基线进行比较,可以引导工作走向不同的方向。假设我们知道我们的问题可以达到人类水平的性能。那么我们就把人类性能作为基线,如图 2 所示。在图 2a 中,模型看起来不错,因此我们可以决定对其进行正则化或添加更多训练示例。另一方面,在图 2b 中,模型表现不佳,因此我们应该添加更多特征或增加模型复杂度(model complexity)。
基线是接收输入并输出预测的模型或算法。基线的预测输出必须与模型的预测具有相同的性质。否则,你无法比较它们。
基线不一定是任何学习算法的结果。它可以是一个基于规则或启发式的算法、应用于训练数据的简单统计量,或者其他什么东西。
两种最常用的基线算法是:
- 随机预测(random prediction),以及
- 零规则(zero rule)。
随机预测算法通过从分配给训练示例的标签集合中随机选择一个标签来做出预测。在分类问题中,它对应于从问题的所有类别中随机挑选一个类别。在回归问题中,它意味着从训练数据的所有唯一目标值中选择一个。
零规则算法产生的基线比随机预测算法更紧。这意味着与随机预测相比,它通常能改善指标的值。为了做出预测,零规则算法使用了更多关于问题的信息。
在分类中,零规则算法的策略是始终预测训练集中最常见的类别,与输入值无关。它看起来可能没什么用,但请考虑以下问题。假设你的分类问题的训练数据包含 800 个正类示例和 200 个负类示例。零规则算法将始终预测正类,基线的准确率(accuracy,我们将在第 5.5.2 节中讨论的流行性能指标之一)将是 800 / 1000 = 0.8,即 80%,对于如此简单的分类器来说这并不差。现在你知道,你的统计模型无论离最优有多近,其准确率至少必须达到 80%。
现在,让我们考虑用于回归的零规则算法。根据零规则算法,回归的策略是预测训练数据中观察到的目标值的样本平均值。与随机预测相比,该策略的错误率可能会更低。
如果你处理的是标准的、所谓的经典预测问题,你可以使用流行库(如 Python 的 scikit-learn)中的最先进算法。例如,对于文本分类,将文本表示为词袋(bag-of-words),然后训练一个带线性核(linear kernel)的支持向量机(support vector machine,SVM)模型。然后尝试用你自己更先进的方法击败该结果。这种方法也适用于图像分类、机器翻译和其他研究充分、所谓的基准(benchmark)问题。
对于一般的数值数据集,线性模型(如线性回归或逻辑回归),或 k 近邻(k-nearest neighbors,kNN)(k = 5)会是不错的基线。对于图像分类,一个简单的卷积神经网络(convolutional neural network,CNN)——包含三个卷积层(每层 32–64–32 个单元,每个卷积层后跟一个最大池化层(max pooling layer)和一个 dropout(随机失活)层)和末尾的两个全连接层(一个 128 个单元,另一个单元数与期望输出数对应)——会是一个不错的基线。
你还可以使用现有的基于规则的系统,或者构建你自己的简单基于规则的系统。例如,如果问题是要构建一个预测给定网站访问者是否会喜欢推荐文章的模型,一个简单的基于规则的系统可以这样工作:取用户喜欢的所有文章,根据它们的 TF-IDF 分数找出这些文章中的前十个词,然后如果推荐文章中有这十个词中的至少五个,就预测用户会喜欢这篇文章。此外,网上有多个专门的机器学习库和 API 可用。如果它们可以直接使用或改造来解决你的问题,你绝对应该考虑把它们作为基线。
找到好的人类基线并不总是那么简单。你可以使用亚马逊土耳其机器人(Amazon Mechanical Turk,MT)服务。MT 是一个人们为报酬完成简单任务的网络平台。MT 提供了一个 API,你可以调用它来获得人类预测。这类预测的质量可以从很低到相对较高,取决于任务和报酬。MT 相对便宜,所以你可以快速、大量地获得预测。
为了提高土耳其机器人用户(turkers,MT 对人类工作者的称呼)提供的预测质量,一些分析师使用土耳其机器人用户集成(ensemble)。你可以让三个或五个土耳其机器人用户标注同一个示例,然后在标签中取多数类(对于回归则取标签的平均值)。更昂贵的替代方案是请领域专家(或者为了更好的质量,请一个专家集成)来标注你的数据。
5.1.5 将数据划分为三个集合
回顾一下,通常需要三个集合来构建可靠的模型。第一个,训练集(training set),用于训练模型。它是机器学习算法「看到」的数据。第二个和第三个是留出集(holdout set)。验证集(validation set)不被机器学习算法看到。数据分析师用它来估计不同机器学习算法(或同一算法配置不同超参数值)或模型应用于新数据时的性能。剩余的测试集(test set)也不被学习算法看到,在项目结束时用于评估和报告在验证数据上表现最佳的模型的性能。
将整个数据集划分为三个集合的过程在第 3 章的 ?? 节中描述。这里我只重申该过程的两个最重要的性质:
- 验证集和测试集必须来自相同的统计分布。也就是说,它们的性质必须最大程度地相似,但属于两个集合的示例显然(而且理想情况下)必须不同,并且彼此独立地获得。
- 从与你在模型部署到生产环境后预期观察到的数据非常相似的分布中抽取验证和测试数据。它可以不同于训练数据的分布。
关于后一点说几句。大多数时候,分析师只是打乱整个数据集,然后从这个打乱的数据中随机填充三个集合。然而,在实践中,常常会有许多看起来不像生产数据的示例。有时,这些示例数量多且/或成本低。在项目中使用这些数据可能导致分布偏移(distribution shift),而分析师可能意识到也可能意识不到这一点。
如果你意识到了分布偏移,你会把所有那些容易获得的示例放入训练集,但避免在验证集和测试集中使用它们。这样,你就能根据与生产环境中相似的数据来评估模型。否则,可能会导致在模型测试期间获得过于乐观的性能指标值,并为生产环境选择次优模型。
分布偏移可能是一个难以处理的问题。因为数据的可用性,使用不同的数据分布进行训练可能是一个有意识的选择。然而,分析师可能没有意识到训练数据和发展(development)数据的统计性质是不同的。当模型在生产部署后频繁更新,并且新示例被添加到训练集时,这种情况经常发生。用于训练模型的数据的性质与用于验证和测试的数据的性质会随着时间的推移而出现分歧。下一章的 ?? 节为如何处理该问题提供了指导。
5.1.6 监督式学习的前提条件
在开始建模之前,请确保以下条件得到满足:
- 你有一个带标签的数据集。
- 你已将数据集划分为三个子集:训练集、验证集和测试集。
- 验证集和测试集中的示例在统计上相似。
- 你只使用训练数据进行了特征工程并填充了缺失值。
- 你已将所有示例转换为数值特征向量。1
- 你已选择一个返回单一数值的性能指标(参见第 5.5 节)。
- 你有一个基线。
5.2 为机器学习表示标签
在分类的经典表述中,标签看起来像类别型特征的值。例如,在图像分类中,标签可以是「猫」(cat)、「狗」(dog)、「汽车」(car)、「建筑物」(building)等等。
一些机器学习算法,比如你在 scikit-learn 中能找到的那些,接受其自然形式的标签:字符串。库会负责把字符串转换为特定学习算法所接受的数字。
然而,一些实现(如神经网络中的实现)要求分析师将标签转换为数字。
5.2.1 多类分类
在多类分类(multiclass classification)(即模型给定一个输入特征向量只预测一个标签)的情况下,通常使用独热编码(one-hot encoding)将标签转换为二元向量。例如,假设你的类别是 {狗,猫,其他},并且你有以下数据:
| 图片 | 标签 |
|---|---|
| image_1.jpg | dog |
| image_2.jpg | dog |
| image_3.jpg | cat |
| image_4.jpg | other |
| image_5.jpg | cat |
独热编码将为你的类别生成以下二元向量:
\[ \text{dog} \to [1, 0, 0], \quad \text{cat} \to [0, 1, 0], \quad \text{other} \to [0, 0, 1] \]将类别标签转换为二元向量后,你的数据变成:
| 图片 | 标签 |
|---|---|
| image_1.jpg | [1,0,0] |
| image_2.jpg | [1,0,0] |
| image_3.jpg | [0,1,0] |
| image_4.jpg | [0,0,1] |
| image_5.jpg | [0,1,0] |
5.2.2 多标签分类
在多标签分类(multi-label classification)中,模型可能同时为一个输入预测多个标签(例如,一张图片可以同时包含狗和猫)。在这种情况下,你可以使用词袋来表示分配给每个示例的标签。假设你的数据如下:
| 图片 | 标签 |
|---|---|
| image_1.jpg | dog, cat |
| image_2.jpg | dog |
| image_3.jpg | cat, other |
| image_4.jpg | other |
| image_5.jpg | cat, dog |
将标签转换为二元向量后,你的数据变成:
| 图片 | 标签 |
|---|---|
| image_1.jpg | [1,1,0] |
| image_2.jpg | [1,0,0] |
| image_3.jpg | [0,1,1] |
| image_4.jpg | [0,0,1] |
| image_5.jpg | [1,1,0] |
请阅读特定学习算法实现的文档,了解该学习算法期望的输入格式。
5.3 选择学习算法
选择机器学习算法可能是一项困难的任务。如果你有大量时间,你可以全部试一遍。然而,通常解决问题的可用时间是有限的。为了做出明智的选择,你可以在开始解决问题之前问自己几个问题。根据你的答案,你可以筛选出一些算法并在你的数据上尝试它们。
5.3.1 学习算法的主要属性
下面是一些可能指导你选择机器学习算法或模型的问题和答案。
可解释性
模型的预测是否需要向非技术受众解释?最准确的机器学习算法和模型是所谓的「黑盒」(black box)。它们产生的预测错误很少,但可能很难理解,甚至更难解释为什么一个模型或算法做出了特定的预测。这类模型的例子有深度神经网络和集成模型(ensemble model)。
相比之下,kNN、线性回归(linear regression)和决策树(decision tree)学习算法并不总是最准确的。然而,它们的预测很容易被非专家解释。
内存内与内存外
你的数据集能否完全加载到你笔记本电脑或服务器的内存(RAM)中?如果可以,你可以从各种各样的算法中选择。否则,你会更倾向于增量学习(incremental learning)算法,这些算法可以通过逐步读取数据来改进模型。这类算法的例子有朴素贝叶斯(Naïve Bayes)和训练神经网络的算法。
特征与示例的数量
你的数据集里有多少训练示例?每个示例有多少个特征?一些算法,包括用于训练神经网络和随机森林(random forest)的算法,可以处理海量的示例和数百万个特征。其他算法,如用于训练支持向量机(SVM)的算法,其容量可能相对有限。
数据的非线性
你的数据是线性可分的吗?它可以用线性模型建模吗?如果可以,带线性核的 SVM、线性回归和逻辑回归可能是不错的选择。否则,深度神经网络或集成模型可能效果更好。
训练速度
学习算法被允许用多少时间来构建模型?你需要多久在更新的数据上重新训练一次模型?如果训练需要两天,而你需要每 4 小时重新训练一次模型,那么你的模型永远不会是最新的。神经网络训练缓慢。像线性回归、逻辑回归或决策树这样的简单算法要快得多。
专门的库包含某些算法的高效实现。你可能更愿意在线研究来找到这样的库。一些算法(如随机森林学习)受益于多个 CPU 核心,因此在拥有数十个核心的机器上,它们的训练时间可以显著减少。一些机器学习库利用 GPU(图形处理单元,graphics processing unit)来加速训练。
预测速度
模型在生成预测时必须有多快?你的模型会用在需要非常高吞吐量的生产环境中吗?像 SVM、线性回归和逻辑回归模型,以及不太深的前馈神经网络,在预测时都非常快。其他模型,如 kNN、集成算法,以及非常深或循环的神经网络,则较慢。
如果你不想猜测最适合你数据的算法,一种流行的选择方式是把几个候选算法作为超参数在验证集上测试。我们将在第 5.6 节讨论超参数调优。
5.3.2 算法抽查
为给定问题筛选候选学习算法有时被称为算法抽查(algorithm spot-checking)。为了进行最有效的抽查,建议:
- 选择基于不同原则(有时称为正交,orthogonal)的算法,如基于实例的算法、基于核的算法、浅层学习、深度学习、集成;
- 用最敏感超参数的 3–5 个不同值尝试每个算法(如 k 近邻中的邻居数 k、支持向量机中的惩罚 C,或逻辑回归中的决策阈值);
- 所有实验使用相同的训练/验证划分;
- 项目结束后,记下哪些算法表现最好,并在未来处理类似问题时使用这些信息;
- 如果学习算法不是确定性的(如用于训练神经网络和随机森林的学习算法),运行几次实验,然后对结果取平均。
当你还不了解自己的问题时,试着用尽可能多的正交方法去解决它,而不是把大量时间花在最有可能成功的方法上。一般来说,花时间试验新的算法和库,比试图从你最有经验的那个算法中榨取最大收益要好。
如果你没有时间仔细抽查算法,一个简单的「技巧」是:找到大多数现代论文声称在与你类似的问题上能够击败的那个学习算法或模型的高效实现,并用它来解决你的问题。
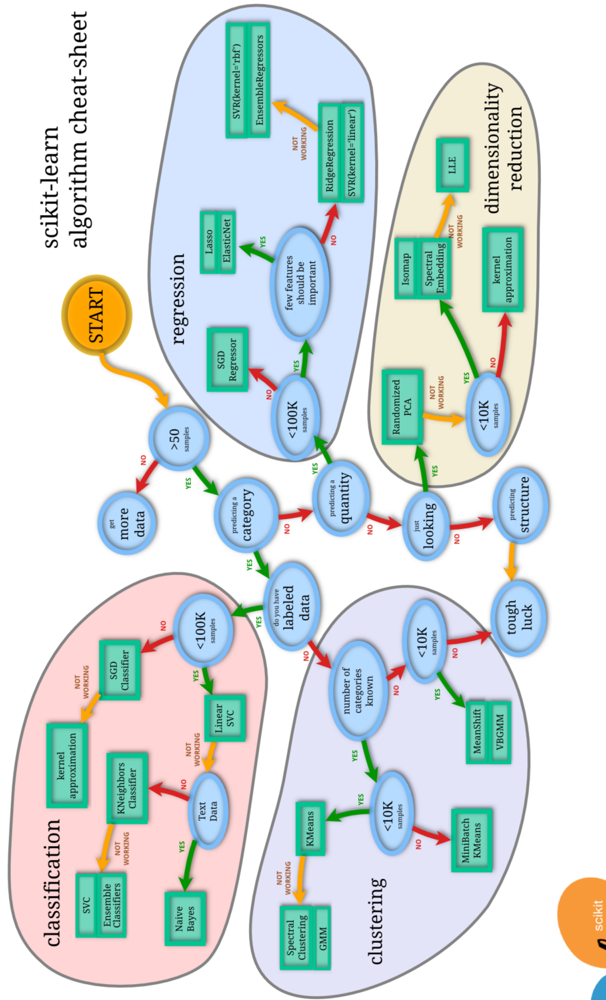
如果你使用 scikit-learn,你可以试试图 3 中所示的算法选择图。
图 3:scikit-learn 的机器学习算法选择图。来源:scikit-learn.org
5.4 构建流水线
许多现代机器学习包和框架支持流水线(pipeline)的概念。流水线是训练数据在成为模型之前所经历的一系列变换。下面展示了一个用于从带标签的文本文档集合中训练文档分类模型的流水线示例:
图 4:一个从原始数据开始生成模型的流水线。

流水线的每个阶段都接收前一阶段的输出,除了第一个阶段,它的输入是训练数据集。
下面是一个构建简单 scikit-learn 流水线的 Python 代码片段。它由两个步骤组成:1) 使用主成分分析(Principal Component Analysis,PCA)进行降维,以及 2) 训练一个支持向量机(SVM)分类器:
from sklearn.pipeline import Pipeline
from sklearn.svm import SVC
from sklearn.decomposition import PCA

# Define a pipeline
pipe = Pipeline([('dim_reduction', PCA()), ('model_training', SVC())])

# Train parameters of both PCA and SVC
pipe.fit(X, y)

# Make a prediction
pipe.predict(new_example)
当执行命令 pipe.predict(new_example) 时,输入示例首先使用 PCA 模型被变换成降维后的向量。该降维向量被用作 SVM 模型的输入。当执行命令 pipe.fit(X, y) 时,PCA 和 SVM 模型一个接一个地被训练。
不幸的是,在 R 中定义和训练流水线不像在 Python 中那样直接,所以我们不把代码放进书里。
流水线可以像保存模型一样保存到文件中。它将被部署到生产环境并用于生成预测。换句话说,在评分(scoring)过程中,输入示例经过整个流水线并「变成」一个输出。
正如你所看到的,流水线的概念是模型概念的推广。从现在开始,除非另有说明,当我提到模型训练、保存、部署、服务、监控或投产后的维护时,我指的是整个流水线。
在考虑训练模型的挑战之前,我们需要决定如何衡量模型质量。通常,我们会在几个相互竞争的模型(所谓的候选模型,model candidate)之间做出选择,但只有一个会被部署到生产环境。
5.5 评估模型性能
记住,留出数据由学习算法在训练期间没有看到的示例组成。如果我们的模型在留出集上表现良好,我们可以说我们的模型泛化(generalize)得很好、质量很好,或者简单地说,它很好。获得好模型的最常见方法是通过在留出数据上计算性能指标来比较不同的模型。
5.5.1 回归的性能指标
回归和分类模型使用不同的指标进行评估。让我们首先考虑回归的性能指标:均方误差(mean squared error,MSE)、中位数绝对误差(median absolute error,MdAE)和近似正确预测错误率(almost correct predictions error rate,ACPER)。
量化回归模型性能最常用的指标与代价函数(cost function)相同:均方误差(MSE),定义为:
\[ \text{MSE} = \frac{1}{N} \sum_{i=1}^{N} (f(x_i) - y_i)^2 \]其中 f 是接收特征向量 x 作为输入并输出预测的模型,i 从 1 到 N 变化,表示数据集中示例的索引。
拟合良好的回归模型预测的值接近观察到的数据值。均值模型(mean model)总是预测训练数据标签的平均值,如果没有信息性特征,通常会使用它。因此,回归模型的拟合应该比均值模型更好。这样,均值模型就充当了基线。如果回归模型的 MSE 大于基线 MSE,那么我们的回归模型就有问题。它可能是过拟合或欠拟合(我们将在第 5.8 节考虑这些)。也可能是问题定义有误,或者编程代码包含错误。
如果数据包含离群值(outlier),即远离「真实」回归线的示例,它们会显著影响 MSE 的值。根据定义,这类离群示例的平方误差会很高。在这种情况下,最好使用另一种指标——中位数绝对误差(MdAE):
\[ \text{MdAE} = \operatorname{median}\{|f(x_i) - y_i|\}_{i=1}^{N} \]其中 \(\{|f(x_i) - y_i|\}_{i=1}^{N}\) 表示执行模型评估的所有示例(从 i = 1 到 N)的绝对误差值集合。
近似正确预测错误率(ACPER)是预测值与真值偏差在 p% 以内的预测所占的百分比。要计算 ACPER,请按以下步骤进行:
- 定义一个你认为可接受的阈值百分比误差(比如 2%)。
- 对于目标 y_i 的每个真值,期望的预测应该在 y_i + 0.02·y_i 和 y_i − 0.02·y_i 之间。
- 使用所有示例 i = 1, …, N,计算满足上述规则的预测值的百分比。这将给出你的模型的 ACPER 指标值。
5.5.2 分类的性能指标
对于分类,事情要复杂一些。评估分类模型最广泛使用的指标是:
- 精确率-召回率(precision-recall),
- 成本敏感准确率(cost-sensitive accuracy),以及
- 准确率(accuracy),
- ROC 曲线下面积(area under the ROC curve,AUC)。
为了简化,我将用一个二分类问题来说明。在必要的地方,我会展示如何将该方法扩展到多类情况。
首先,我们需要理解混淆矩阵(confusion matrix)。
混淆矩阵是一个表格,总结了分类模型在预测属于各个类别的示例方面的成功程度。混淆矩阵的一个轴是模型预测的类别;另一个轴是实际标签。假设我们的模型预测类别「垃圾邮件」(spam)和「非垃圾邮件」(not_spam):
| spam(预测) | not_spam(预测) | |
|---|---|---|
| spam(实际) | 23(TP) | 1(FN) |
| not_spam(实际) | 12(FP) | 556(TN) |
上面的矩阵显示,在 24 个实际的垃圾邮件示例中,模型正确分类了 23 个。在这种情况下,我们说我们有 23 个真正例(true positive),即 TP = 23。模型错误地将 1 个垃圾邮件示例分类为 not_spam。在这种情况下,我们有 1 个假负例(false negative),即 FN = 1。类似地,在 568 个实际非垃圾邮件示例中,模型正确分类了 556 个,错误分类了 12 个(556 个真负例(true negative),TN = 556,以及 12 个假正例(false positive),FP = 12)。
多类分类的混淆矩阵有与不同类别数量相同的行和列。它可以帮助你确定错误模式。例如,混淆矩阵可以揭示,一个被训练来识别不同动物物种的模型倾向于错误地把「黑豹」预测为「猫」,或者把「老鼠」(rat)预测为「鼠」(mouse)。在这种情况下,你可以添加更多这些物种的带标签示例,帮助学习算法「看到」这些动物之间的差异。或者,你可以添加有助于学习算法更好地区分这些物种对的特征。
混淆矩阵用于计算三个性能指标:精确率、召回率和准确率。精确率和召回率最常用于评估二分类模型。
精确率(precision)是真正例预测与正类预测总数之比:
\[ \text{precision} = \frac{TP}{TP + FP} \]召回率(recall)是真正例预测与正类示例总数之比:
\[ \text{recall} = \frac{TP}{TP + FN} \]要理解精确率和召回率在模型评估中的含义和重要性,把预测问题想象成使用查询在数据库中检索文档的问题是有帮助的。精确率是所有返回文档列表中实际找到的相关文档的比例。召回率是搜索引擎返回的相关文档与应该返回的相关文档总数的比率。
在垃圾邮件检测中,我们希望有高精确率,以避免把合法消息错误地放进垃圾邮件文件夹。我们愿意容忍较低的召回率,因为我们可以处理收件箱里的一些垃圾邮件。
在实践中,我们在高精确率或高召回率之间做选择。要两者兼得几乎是不可能的。这被称为精确率-召回率权衡(precision-recall tradeoff)。我们可以通过各种方式实现其中之一:
- 为特定类别的示例分配更高的权重。例如,scikit-learn 中的 SVM 接受类别权重作为输入;
- 对返回预测分数的算法改变决策阈值。假设我们有一个逻辑回归模型或决策树。为了提高精确率(以降低召回率为代价),我们可以决定只有当模型返回的分数高于 0.9(而不是默认值 0.5)时预测才为正;
- 调整超参数,在验证集上最大化精确率或召回率。
即使精确率和召回率是为二分类定义的,你也可以用它们来评估多类分类模型。首先为你想要评估这些指标的类别选择一个类。然后把你所选类别的所有示例视为正例,把其余类别的所有示例视为负例。
在实践中,为了比较两个模型的性能,你更希望只有一个代表每个模型性能的数字。例如,你会希望避免这样的情况:第一个模型的精确率更高,而第二个模型的召回率更高:如果是这样,哪个模型更好?
一种基于单一数字比较模型的方法是对一个指标(比如召回率)设置可接受的最小值阈值,然后只根据另一个指标的值来比较模型。例如,假设你接受任何召回率高于 90% 的模型。然后你会优先选择精确率最高的模型(假设其召回率高于 90%)。这种技术被称为优化与满足技术(optimizing and satisficing technique)。
一些从业者使用精确率和召回率的组合,称为 F 度量(F-measure),也称为 F 分数(F-score)。传统的 F 度量,即 F1 分数,是精确率和召回率的调和平均(harmonic mean):
\[ F_1 = \frac{2 \cdot \text{precision} \cdot \text{recall}}{\text{precision} + \text{recall}} \]更一般地,F 度量用一个正实数 β 参数化,β 的选择使得召回率被认为与精确率同样重要 β 倍:
\[ F_\beta = (1 + \beta^2) \cdot \frac{\text{precision} \cdot \text{recall}}{(\beta^2 \cdot \text{precision}) + \text{recall}} \]β 的两个常用值是 2(召回率的权重是精确率的两倍)和 0.5(召回率的权重是精确率的一半)。
你应该找到一种最适合你的问题的组合两个指标的方法。除了 F 分数,还有其他方法通过组合多个指标得到单一数字:
- 指标的简单平均或加权平均;
- 发明你自己的特定领域「配方」;
- 对 n−1 个指标设置阈值并优化第 n 个(上述优化与满足技术的推广)。
准确率是正确分类的示例数除以被分类的示例总数。就混淆矩阵而言,它由下式给出:
\[ \text{accuracy} = \frac{TP + TN}{TP + TN + FP + FN} \]当预测所有类别的错误被认为同等重要时,准确率是一个有用的指标。例如,家用机器人的物体识别就是这种情况:椅子不比桌子更重要。在垃圾邮件/非垃圾邮件预测的情况下,可能就不是这样了。你可能更容忍假负例而不是假正例。记住,假正例是你的朋友给你发了一封邮件,但模型把它放进了垃圾邮件文件夹而你看不到。假负例(垃圾邮件进入收件箱)的问题则小一些。
为了处理不同类别具有不同重要性的情况,一个有用的指标是成本敏感准确率。首先,为两种类型的错误(FP 和 FN)都分配一个成本(一个正数)。然后照常计算 TP、TN、FP、FN 的数量,并在使用上面的公式 2 计算准确率之前,将 FP 和 FN 的数量乘以它们对应的成本。
准确率同时衡量模型在所有类别上的性能,并且方便地返回一个单一数字。然而,当数据不平衡时,准确率不是一个好的性能指标。在不平衡数据集(imbalanced dataset)中,属于某个或某几个类别的示例构成绝大多数,而其他类别只有很少的示例。不平衡的训练数据会显著且不利地影响模型。我们将在第 6 章的 ?? 节更多地讨论如何处理不平衡数据。
对于不平衡数据,更好的指标是逐类准确率(per-class accuracy)。首先,计算每个类别 {1, …, C} 的预测准确率,然后取 C 个单独准确率度量的平均值。对于上面垃圾邮件检测问题的混淆矩阵,「spam」类的准确率是 23 / (23 + 1) = 0.96,「not_spam」类的准确率是 556 / (12 + 556) = 0.98。逐类准确率就是 (0.96 + 0.98) / 2 = 0.97。
对于许多类别只有很少示例(大致每类不到十几个示例)的多类分类问题,逐类准确率不是一个合适的模型质量度量。在这种情况下,与这些少数类对应的二分类问题获得的准确率值在统计上不可靠。
科恩 kappa 系数(Cohen’s kappa)是一个既适用于多类又适用于不平衡学习问题的性能指标。与准确率相比,该指标的优势在于,Cohen’s kappa 告诉你你的分类模型与一个根据每个类别的频率随机猜测类别的分类器相比,表现好多少。
Cohen’s kappa 定义为:
\[ \kappa = \frac{p_o - p_e}{1 - p_e} \]其中 p_o 被称为观察一致性(observed agreement),p_e 是期望一致性(expected agreement)。
让我们再看一次混淆矩阵:
| class1(预测) | class2(预测) | |
|---|---|---|
| class1(实际) | a | b |
| class2(实际) | c | d |
观察一致性 p_o 从混淆矩阵中获得:
\[ p_o = \frac{a + d}{a + b + c + d} \]反过来,期望一致性 p_e 通过 \(p_e \overset{\text{def}}{=} p_{\text{class1}} + p_{\text{class2}}\) 获得,其中:
\[ p_{\text{class1}} = \frac{(a + b)(a + c)}{(a + b + c + d)^2} \]\[ p_{\text{class2}} = \frac{(c + d)(b + d)}{(a + b + c + d)^2} \]Cohen’s kappa 的值总是小于或等于 1。值为 0 或更小表明模型有问题。虽然没有普遍接受的解释 Cohen’s kappa 值的方法,但通常认为 0.61 到 0.80 之间的值表明模型良好,0.81 或更高的值表明模型非常好。
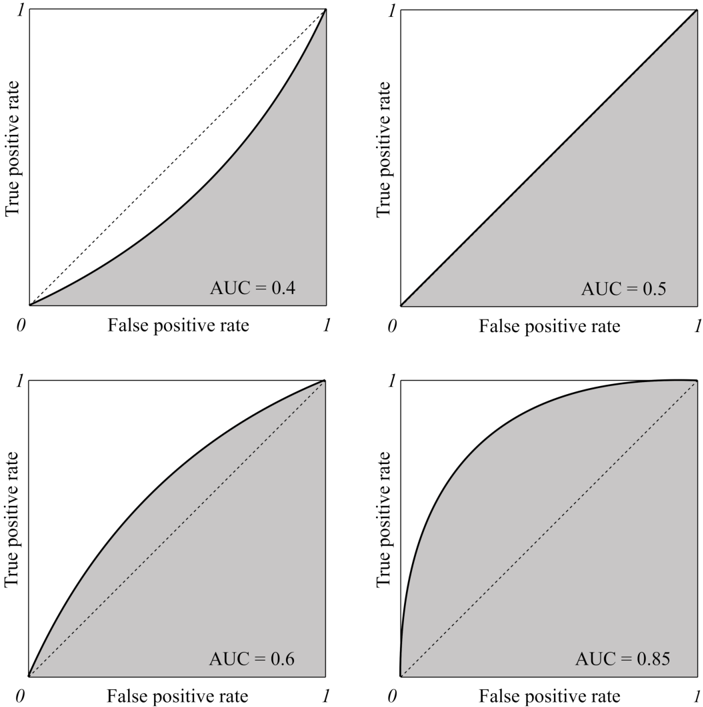
ROC 曲线(ROC 代表「接收者操作特征」,receiver operating characteristic;该术语来自雷达工程)是评估分类模型的常用方法。ROC 曲线使用真正例率(true positive rate,TPR,定义与召回率完全相同)和假正例率(false positive rate,FPR,被错误预测的负例比例)的组合来构建分类性能的总体图景。
真正例率(TPR)和假正例率(FPR)分别定义为:
\[ \text{TPR} = \frac{TP}{TP + FN}, \qquad \text{FPR} = \frac{FP}{FP + TN} \]ROC 曲线只能用于评估返回预测分数(或概率)的分类器。例如,逻辑回归、神经网络和决策树(以及基于决策树的集成模型)可以用 ROC 曲线评估。
要绘制 ROC 曲线,你首先对分数的范围进行离散化。例如,你可以像这样离散化范围 [0, 1]:[0, 0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9, 1]。然后,把每个离散值用作模型的预测阈值。例如,如果你想计算阈值为 0.7 时的 TPR 和 FPR,你对每个示例应用模型并获得分数。如果分数大于或等于 0.7,你预测正类。否则,你预测负类。
看图 5 中的插图。很容易看出,如果阈值等于 0,我们所有的预测都将是正类,所以 TPR 和 FPR 都将等于 1(右上角)。另一方面,如果阈值等于 1,那么不可能有正类预测。TPR 和 FPR 都将等于 0,这对应于左下角。
ROC 曲线下的面积(AUC)越大,分类器越好。AUC 大于 0.5 的分类器优于随机分类的模型。如果 AUC 低于 0.5,那么就有问题了,很可能是代码中的错误或数据中错误的标签。完美的分类器会有 1 的 AUC。在实践中,你通过选择一个阈值来获得好的分类器,该阈值使 TPR 接近 1,同时保持 FPR 接近 0。
ROC 曲线之所以流行,是因为它们相对容易理解。它们通过同时考虑假正例和假负例,捕捉了分类的多个方面。它们允许分析师轻松地、可视化地比较不同模型的性能。
图 5:ROC 曲线下的面积(灰色区域)。
5.5.3 排序的性能指标
精确率和召回率可以自然地应用于排序(ranking)问题。回想一下,把这两个指标看作衡量文档搜索结果的质量是很方便的。精确率是所有返回文档列表中实际找到的相关文档的比例。召回率是搜索引擎返回的相关文档与应该返回的相关文档总数的比率。
用精确率和召回率衡量排序模型质量的缺点是,这些指标平等地对待所有检索到的文档。列在位置 k 的相关文档与列表顶部的相关文档价值一样。这通常不是我们在文档检索中想要的。当人查看搜索结果时,最顶部的几个结果比列表底部显示的结果更重要。
折扣累积增益(discounted cumulative gain,DCG)是搜索引擎中衡量排序质量的流行度量。DCG 根据文档在结果列表中的位置来衡量文档的有用性(即增益)。增益从结果列表的顶部累积到底部,每个结果的增益在较低位置被折扣。
为了理解折扣累积增益,我们引入一个称为累积增益(cumulative gain)的度量。
累积增益(CG)是搜索结果列表中所有结果的分级相关性(graded relevance)值之和。在特定排名位置 p 的 CG 定义为:
\[ \text{CG}_p = \sum_{i=1}^{p} \text{rel}_i \]其中 rel_i 是位置 i 的结果的分级相关性。一般来说,分级相关性用数字、字母或描述(如「不相关」、「有点相关」、「相关」或「非常相关」)按某种尺度反映文档与查询的相关性。要在上面的公式中使用它,rel_i 必须是数字,例如从 0(位置 i 的文档与查询完全不相关)到 1(位置 i 的文档与查询最大程度相关)取值。或者,rel_i 可以是二值的:文档与查询不相关时为 0,相关时为 1。注意,CG_p 与每个文档在排名结果列表中的位置无关。它只刻画排名到位置 p 的文档与查询是相关还是不相关。
折扣累积增益基于两个假设:
- 高度相关的文档出现在结果列表中越靠前越有用。
- 高度相关的文档比勉强相关的文档更有用,而后者又比不相关的文档更有用。
对于给定的搜索结果,在特定排名位置 p 累积的 DCG 通常定义为:
\[ \text{DCG}_p = \sum_{i=1}^{p} \frac{\text{rel}_i}{\log_2(i + 1)} \]DCG 的另一种表述在工业和数据科学竞赛(如 Kaggle)中常用,它更强调检索相关文档:
\[ \text{DCG}_p = \sum_{i=1}^{p} \frac{2^{\text{rel}_i} - 1}{\log_2(i + 1)} \]对于一次查询,归一化折扣累积增益(normalized discounted cumulative gain,nDCG)定义为:
\[ \text{nDCG}_p = \frac{\text{DCG}_p}{\text{IDCG}_p} \]其中 IDCG 是理想折扣累积增益(ideal discounted cumulative gain):
\[ \text{IDCG}_p = \sum_{i=1}^{|\text{REL}_p|} \frac{2^{\text{rel}_i} - 1}{\log_2(i + 1)} \]而 REL_p 表示语料库中与查询相关的文档按相关性排序到位置 p 的列表。所以,REL_p 是搜索引擎排序算法(或模型)本应为该查询返回的理想排名(到位置 p 为止)。所有查询的 nDCG 值通常取平均,以获得搜索引擎排序算法或模型的性能度量。
让我们考虑下面的例子。假设一个搜索引擎响应搜索查询返回一个文档列表。我们请一个排序评估员(ranker,一个人)判断每个文档的相关性。评估员必须给出 0 到 3 的分数,其中 0 表示不相关,3 表示高度相关,而 1 和 2 表示「介于两者之间」。假设文档按以下顺序出现:
\[ D_1, D_2, D_3, D_4, D_5 \]我们的排序评估员给出以下相关性分数:
\[ \text{rel} = [3, 1, 0, 3, 2] \]这意味着文档 D_1 的相关性为 3,D_2 的相关性为 1,D_3 的相关性为 0,依此类推。这个搜索结果到位置 p = 5 的累积增益是:
\[ \text{CG}_5 = 3 + 1 + 0 + 3 + 2 = 9 \]你可以看到,改变任何文档的顺序都不会影响累积增益的值。现在我们将计算折扣累积增益,它通过对数折扣的设计,在高度相关的文档出现在结果列表早期时具有更高的值。要计算 DCG_5,让我们为每个 i 计算表达式 rel_i / log₂(i + 1) 的值:
| i | rel_i | log₂(i + 1) | rel_i / log₂(i + 1) |
|---|---|---|---|
| 1 | 3 | 1.00 | 3.00 |
| 2 | 1 | 1.58 | 0.63 |
| 3 | 0 | 2.00 | 0.00 |
| 4 | 3 | 2.32 | 1.29 |
| 5 | 2 | 2.58 | 0.77 |
所以这个排名的 DCG_5 由 3.00 + 0.63 + 0.00 + 1.29 + 0.77 = 5.70 给出。
现在,如果我们交换 D_1 和 D_2 的位置,DCG_5 的值会变低。这是因为一个不太相关的文档现在排在更靠前的位置,而一个更相关的文档因为排在较低的位置而被折扣得更多。
要计算归一化折扣累积增益 nDCG_5,我们首先需要找到理想排序的折扣累积增益值 IDCG_5。根据相关性分数,理想排序是 3, 3, 2, 1, 0。IDCG_5 的值等于 3.00 + 1.89 + 1.00 + 0.43 + 0.00 = 6.32。最后,nDCG_5 由下式给出:
\[ \text{nDCG}_5 = \frac{\text{DCG}_5}{\text{IDCG}_5} = \frac{5.70}{6.32} = 0.90 \]要为测试查询集合及对应的搜索结果列表获得 nDCG,我们对每个单独查询获得的 nDCG_p 值取平均。使用归一化折扣累积增益而不是其他度量的优势在于,为不同的 p 值获得的 nDCG_p 值是可比较的。当评估员提供的相关性分数数量 p 对不同查询不同时,这个性质很有用。
现在我们有了性能指标,就可以在称为超参数调优的过程中使用它来比较模型。
5.6 超参数调优
超参数在模型训练过程中起着重要作用。一些超参数影响训练速度,但最重要的超参数控制两个权衡:偏差-方差(bias-variance)和精确率-召回率(precision-recall)。
超参数不是由学习算法本身优化的。数据分析师通过试验值的组合来「调优」超参数,每个超参数一个值。每个机器学习模型和每个学习算法都有一组独特的超参数。此外,整个机器学习流水线中的每一步——数据预处理、特征提取、模型训练和做出预测——都可以有自己的超参数。
例如,在数据预处理中,超参数可以指定是否使用数据增强(data augmentation),或使用哪种技术填充缺失值。在特征工程中,超参数可以定义应用哪种特征选择技术。当使用返回分数的模型进行预测时,超参数可以指定每个类别的决策阈值。
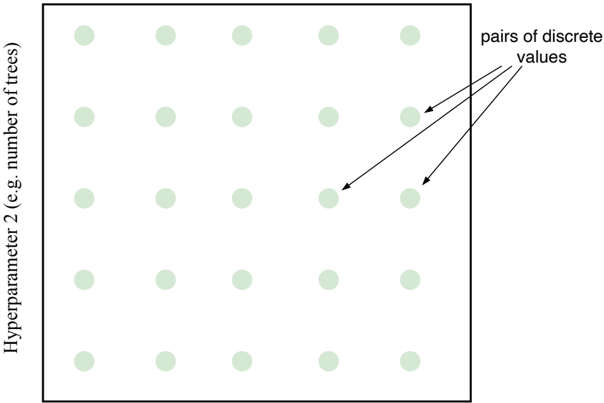
图 6:两个超参数的网格搜索:每个绿点代表一对超参数值。
下面,我们考虑几种流行的超参数调优技术(hyperparameter tuning technique)。
5.6.1 网格搜索
网格搜索(grid search)是最简单的超参数调优技术。当超参数的数量及其范围不太大时使用它。
我们以调优两个数值超参数的问题来解释它。该技术包括对两个超参数中的每一个进行离散化,然后评估每对离散值,如图 6 所示。
每次评估包括:
- 用一对超参数值配置一个流水线,
- 将流水线应用于训练数据并训练一个模型,以及
- 在验证数据上计算模型的性能指标。
然后选择产生最佳性能模型的那对超参数值来训练最终模型。
下面的 Python 代码使用带交叉验证(cross-validation)的网格搜索。2 它展示了如何优化上面考虑的简单两阶段 scikit-learn 流水线的超参数:
from sklearn.pipeline import Pipeline
from sklearn.svm import SVC
from sklearn.decomposition import PCA
from sklearn.model_selection import GridSearchCV

# Define a pipeline
pipe = Pipeline([('dim_reduction', PCA()), ('model_training', SVC())])

# Define hyperparameter values to try
param_grid = dict(dim_reduction__n_components=[2, 5, 10],
                  model_training__C=[0.1, 10, 100])

grid_search = GridSearchCV(pipe, param_grid=param_grid)

# Make a prediction
pipe.predict(new_example)
在上面的例子中,我们使用网格搜索来尝试 PCA 的超参数 n_components 的值 [2, 5, 10],以及 SVM 的超参数 C 的值 [0.1, 10, 100]。
对于大型数据集,尝试多种超参数组合可能非常耗时。有更高效的技术,如随机搜索、由粗到细搜索和贝叶斯超参数优化(Bayesian hyperparameter optimization)。
5.6.2 随机搜索
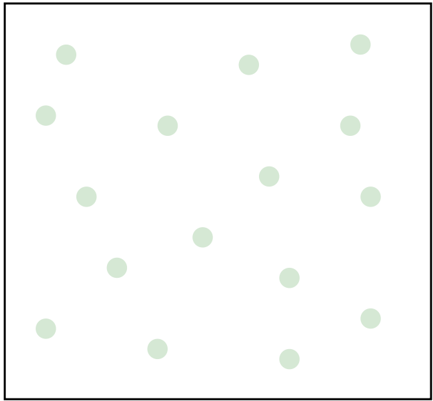
随机搜索(random search)与网格搜索的不同之处在于,你不需要为每个超参数提供一组要探索的离散值。相反,你为每个超参数提供一个统计分布,从中随机采样值。然后设置你想要评估的组合总数,如图 7 所示。
超参数 2
超参数 1
图 7:两个超参数的随机搜索,共 16 对待测试。
超参数 2
超参数 1
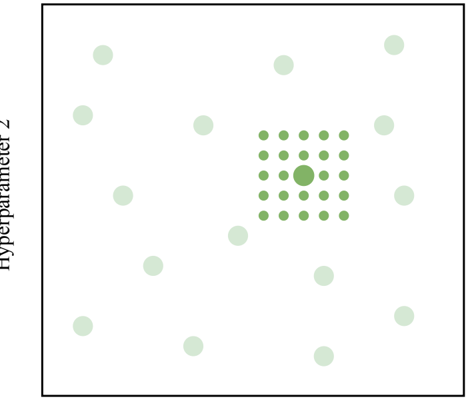
图 8:两个超参数的由粗到细搜索:16 对粗随机搜索组合待测试,以及一个在随机搜索发现的最高值区域内的网格搜索。
5.6.3 由粗到细搜索
在实践中,分析师经常使用网格搜索和随机搜索的组合,称为由粗到细搜索(coarse-to-fine search)。该技术使用粗随机搜索首先找到高潜力区域。然后,在这些区域中使用精细网格搜索,找到超参数的最佳值,如图 8 所示。
你可以决定只探索一个高潜力区域或几个这样的区域,这取决于可用的时间和计算资源。
5.6.4 其他技术
贝叶斯技术(Bayesian technique)与随机搜索和网格搜索的不同之处在于,它们使用过去的评估结果来选择下一个要评估的值。在实践中,这使得贝叶斯超参数优化技术能够在更短的时间内找到更好的超参数值。
还有基于梯度的技术、进化优化(evolutionary optimization)技术,以及其他算法性的超参数调优方法。大多数现代机器学习库实现了其中一种或多种技术。还有一些超参数调优库,可以用来调优几乎任何学习算法的超参数,包括你自己编程实现的算法。
5.6.5 交叉验证
当你有一个大小合适的验证集时,可以使用上面讨论的网格搜索和其他超参数调优技术。3 当没有时,一种常见的模型评估技术是交叉验证(cross-validation)。确实,当你只有很少的训练示例时,同时拥有验证集和测试集可能代价过高。你更愿意用更多的数据来训练模型。在这种情况下,你应该只把你的数据分成两部分:训练集和测试集。然后在训练集上使用交叉验证来模拟验证集。
交叉验证的工作原理如下。首先,你固定要评估的超参数值。然后你把训练集分成几个大小相同的子集。每个子集称为一折(fold)。通常使用五折交叉验证,你把训练数据随机分成五折:\(\{F_1, F_2, \ldots, F_5\}\)。每个 \(F_k\)(k = 1, …, 5)包含你 20% 的训练数据。然后你以一种特定的方式训练五个模型。为了训练第一个模型 \(f_1\),你把折 \(F_2\)、\(F_3\)、\(F_4\) 和 \(F_5\) 中的所有示例作为训练集,把 \(F_1\) 中的示例作为验证集。为了训练第二个模型 \(f_2\),你使用折 \(F_1\)、\(F_3\)、\(F_4\) 和 \(F_5\) 中的示例进行训练,用 \(F_2\) 中的示例进行验证。你继续迭代地训练模型 \(f_k\),4 处理所有剩余的折,并在每个验证集(从 \(F_1\) 到 \(F_5\))上计算感兴趣指标的值。然后你平均这五个指标值得到最终值。更一般地,在 n 折交叉验证中,你在除第 n 折 \(F_n\) 之外的所有折上训练模型 \(f_n\)。
你可以使用网格搜索、随机搜索或任何其他此类技术与交叉验证结合,找到最佳的超参数值。一旦你找到了这些值,你通常使用整个训练集,用通过交叉验证找到的最佳超参数值训练最终模型。最后,你用测试集评估最终模型。
虽然找到最佳的超参数值很诱人,但尝试所有的值可能不现实。记住,时间是宝贵的,完美往往是好的敌人。把一个「足够好」的模型部署到生产环境,然后继续搜索理想的超参数值(如果需要的话,搜索几周)。
现在,让我们考虑训练浅层模型的挑战。
5.7 浅层模型训练
浅层模型(shallow model)直接根据输入特征向量中的值做出预测。大多数流行的机器学习算法产生浅层模型。唯一常用的深度模型是深度神经网络。我们将在下一章的 ?? 节考虑训练它们的策略。
5.7.1 浅层模型训练策略
典型的浅层学习算法模型训练策略如下:
- 定义一个性能指标 P。
- 筛选出候选学习算法。
- 选择一个超参数调优策略 T。
- 挑选一个学习算法 A。
- 使用策略 T 为算法 A 挑选一组超参数值组合 H。
- 使用训练集,用超参数值为 H 的算法 A 训练一个模型 M。
- 使用验证集,为模型 M 计算指标 P 的值。 a. 如果仍有未测试的超参数值,使用策略 T 挑选另一组超参数值组合 H,并返回步骤 6。
- 决策: a. 如果对模型 M 的性能满意,则进入步骤 9; b. 否则,挑选一个不同的学习算法 A 并返回步骤 5,或者如果没有更多学习算法可尝试,则进入步骤 9。
- 返回指标 P 值最大的模型。
在上述策略的步骤 1 中,你为你的问题定义性能指标。正如我们在第 5.5 节看到的,它是一个数学函数或子程序,接收模型和数据集作为输入,并产生反映模型工作得有多好的数值。
在步骤 2 中,你选择候选算法,然后筛选出其中的一些(通常是两三个)。要做到这一点,你可以使用第 5.3 节中考虑的选择标准。
在步骤 3 中,你选择超参数调优策略。它是一系列生成要测试的超参数值组合的动作。我们在第 5.6 节中考虑了几种超参数调优策略。
5.7.2 保存和恢复模型
一旦你训练了一个模型或流水线,你必须把它保存到文件中,以便部署到生产环境并用于评分。模型和流水线都可以序列化。在 Python 中,Pickle 通常用于对象的序列化(serialization,保存)和反序列化(deserialization,恢复)。在 R 中,是 RDS。
以下是在 Python 中进行模型序列化/反序列化的方法:
import pickle
from sklearn.svm import SVC
from sklearn import datasets

# Prepare data
X, y = datasets.load_iris(return_X_y=True)

# Instantiate the model
model = SVC()

# Train the model
model.fit(X, y)

# Save the model to file
pickle.dump(model, open("model_file.pkl", "wb"))

# Restore the model from file
restored_model = pickle.load(open("model_file.pkl", "rb"))

# Make a prediction
prediction = restored_model.predict(new_example)
类似的 R 代码如下所示:
library("e1071")

# Prepare data
attach(iris)
X <- subset(iris, select = -Species)
y <- Species

# Train the model
model <- svm(X, y)

# Save the model to file
saveRDS(model, "./model_file.rds")

# Restore the model from file
restored_model <- readRDS("./model_file.rds")

# Make a prediction
prediction <- predict(restored_model, new_example)
现在,让我们谈谈分析师在实践中为了产生最优模型而必须注意的模型训练过程的特殊性。
5.8 偏差-方差权衡
开发模型既包括搜索最优算法,也包括找到性能最佳的超参数。调整超参数实际上控制着两个权衡。我们已经讨论了第一个:精确率-召回率权衡。第二个同样重要,是偏差-方差权衡(bias-variance tradeoff)。
5.8.1 欠拟合
如果模型能够很好地预测训练数据标签,我们就说它具有低偏差(low bias)。如果模型在训练数据上犯了太多错误,我们说它具有高偏差(high bias),或者说模型欠拟合(underfit)训练数据。欠拟合可能有几个原因:
- 模型对数据来说太简单(例如,线性模型经常欠拟合);
- 你正则化太多(我们将在下一节讨论正则化);
- 特征的信息量不够。
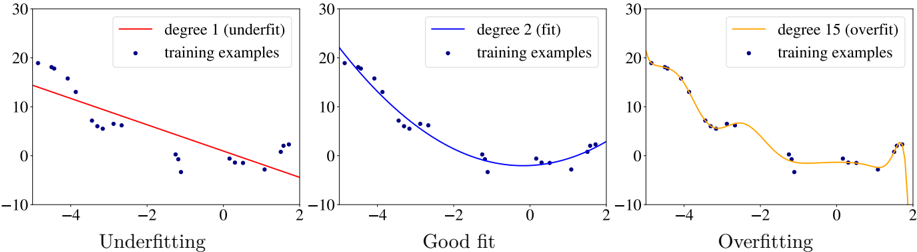
回归中欠拟合的一个例子如图 9(左)所示。回归线没有重现数据似乎所属的线的弯曲。模型过度简化了数据。欠拟合问题的可能解决方案包括:
- 尝试更复杂的模型,
- 在可能的情况下添加更多训练数据,以及
- 工程化预测能力(predictive power)更高的特征,
- 减少正则化。
图 9:欠拟合(线性模型)、良好拟合(二次模型)和过拟合(15 次多项式)的示例。
5.8.2 过拟合
过拟合(overfitting)是模型可能表现出的另一个问题。过拟合的模型通常能很好地预测训练数据标签,但在留出数据上表现不佳。
回归中过拟合的一个例子如图 9(右)所示。回归线几乎完美地预测了几乎所有训练示例的目标,但如果你决定用它来做预测,它很可能在新数据上犯重大错误。
你在文献中会找到过拟合的另一个名称:高方差(high variance)。模型对训练集中的微小波动过度敏感。如果你以不同的方式对训练数据采样,结果将是一个显著不同的模型。这些过拟合模型在留出数据上表现不佳,因为留出数据和训练数据是彼此独立地从数据集中采样的。所以,训练数据和留出数据中的微小波动很可能是不同的。
几个原因可能导致过拟合:
- 模型对数据来说太复杂。非常高的决策树或非常深的神经网络经常过拟合;
- 你正则化不够;
- 特征太多而训练示例太少;以及
过拟合有几种可能的解决方案:
- 使用更简单的模型。尝试线性而不是多项式回归,或者带线性核而不是径向基函数(radial basis function,RBF)核的 SVM,或者层数/单元数更少的神经网络;5
- 降低数据集中示例的维度;
- 对模型进行正则化;
- 如果可能的话,添加更多训练数据;以及
5.8.3 权衡
在实践中,当你试图减少方差时,你会增加偏差,反之亦然。换句话说,减少过拟合会导致欠拟合,反之亦然。这被称为偏差-方差权衡:你太过努力地构建一个在训练数据上表现完美的模型,结果却得到一个在留出数据上表现不佳的模型。
虽然许多因素决定模型在训练数据上是否表现良好,但最重要的因素是模型的复杂度。一个足够复杂的模型会学会记住所有训练示例及其标签,因此在应用于训练数据时不会产生预测错误。它将具有低偏差。然而,依赖记忆的模型将无法正确预测以前未见过的数据的标签。它将具有高方差。
随着模型复杂度的增长,模型应用于训练数据和留出数据时平均预测误差的典型演变如图 10 所示。
图 10:偏差-方差权衡。
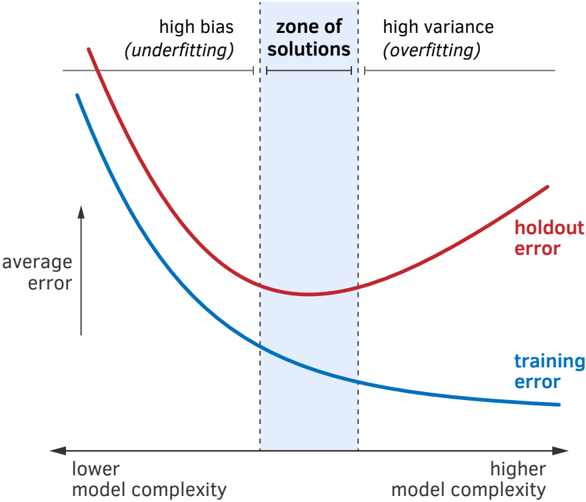
你希望处于的区域是「解区域」(zone of solutions),即偏差和方差都低的浅蓝色矩形。一旦进入这个区域,你可以微调超参数以达到所需的精确率-召回率比率,或者优化适合你问题的另一个模型性能指标。
要到达解区域,你可以:
- 通过增加模型复杂度向右移动,从而减少其偏差,或者
- 通过正则化模型使其更简单来向左移动以减少方差(我们将在下一节讨论正则化)。
如果你使用浅层模型(如线性回归),你可以通过切换到更高阶的多项式回归来增加复杂度。类似地,你可以增加决策树的深度,或者在支持向量机(SVM)中使用多项式或 RBF 核而不是线性核。基于提升(boosting)思想的集成学习算法通过组合几个(通常是数百个)高偏差「弱」模型来减少偏差。
如果你使用神经网络,你可以通过增加其规模来增加模型的复杂度:每层的单元数和层数。更长时间地训练神经网络模型(即更多轮次,epoch)通常也会带来更低的偏差。就偏差-方差权衡而言,使用神经网络的优势在于,你可以稍微增加网络的规模,并观察到偏差的轻微下降。大多数流行的浅层模型及相关学习算法无法为你提供这样的灵活性。
如果通过增加模型的复杂度,你发现自己处于图 10 中图形的右侧,你必须减少模型的方差。最常见的方法是应用正则化。
5.9 正则化
正则化(regularization)是迫使学习算法训练更简单模型的方法的总称。在实践中,它会导致更高的偏差,但显著减少方差。
两种最广泛使用的正则化类型是 L1 和 L2 正则化(L1 and L2 regularization)。这个想法相当简单。要创建一个正则化模型,我们修改目标函数(objective function)。这是学习算法在训练模型时优化的表达式。正则化添加一个惩罚项,当模型更复杂时其值更高。
为简单起见,我们将用线性回归来说明正则化,但同样的原理可以应用于各种各样的模型。
设 x 是一个二维特征向量 \([x^{(1)}, x^{(2)}]\)。回顾线性回归目标:
\[ \sum_{i=1}^{N} (f_i - y_i)^2 \]在上面的方程中,\(f_i \overset{\text{def}}{=} f(x_i)\),f 是回归线的方程。线性回归线 f 的方程具有形式 \(f = w^{(1)} x^{(1)} + w^{(2)} x^{(2)} + b\)。学习算法将通过最小化目标从训练数据中推导出参数 \(w^{(1)}\)、\(w^{(2)}\) 和 b 的值。如果一些参数 \(w^{(\cdot)}\) 接近或等于零,模型就被认为不太复杂。
5.9.1 L1 和 L2 正则化
对公式 3 中的目标进行 L1 正则化后,目标如下所示:
\[ \sum_{i=1}^{N} (f_i - y_i)^2 + C\left(|w^{(1)}| + |w^{(2)}|\right) \]其中 C 是控制正则化重要性的超参数。如果我们把 C 设为零,模型就变成标准的非正则化线性回归模型。另一方面,如果我们把 C 设为一个高值,学习算法将试图把大多数 \(w^{(\cdot)}\) 设置为接近或等于零的值以最小化目标。模型将变得非常简单,这可能导致欠拟合。数据分析师的角色是找到这样的超参数 C 值:它不会把偏差增加太多,但会把方差减少到对当前问题合理的水平。
在我们这个二维设定下,L2 正则化目标如下所示:
\[ \sum_{i=1}^{N} (f_i - y_i)^2 + C\left((w^{(1)})^2 + (w^{(2)})^2\right) \]在实践中,假设超参数 C 的值足够大,L1 正则化会产生一个稀疏模型(sparse model)。这是一个大多数参数恰好等于零的模型。所以,正如上一章所讨论的,L1 通过决定哪些特征对预测是必需的、哪些不是,隐式地执行特征选择。当我们想提高模型可解释性(explainability)时,L1 正则化的这一性质很有用。然而,如果我们的目标是在留出数据上最大化模型性能,那么 L2 通常给出更好的结果。
在文献中,你还会看到 L1 称为 lasso,L2 称为岭(ridge)正则化。
5.9.2 其他形式的正则化
L1 和 L2 正则化方法可以组合成所谓的弹性网络(elastic net)正则化。
除了广泛用于线性模型之外,L1 和 L2 也常用于神经网络和许多其他直接最小化目标函数的模型类型。
神经网络还可以受益于另外两种正则化技术:dropout(随机失活)和批归一化(batch normalization)。还有一些非数学方法具有正则化效果:数据增强(data augmentation)和早停(early stopping)。我们将在下一章考虑训练神经网络时更详细地讨论这些技术。
5.10 小结
在开始建模之前,你应该做几项检查和决策。首先,确保数据符合模式文件定义的模式。然后,定义一个可达到的性能水平,并选择一个性能指标。理想情况下,它应该用单一数字表示模型性能。此外,建立一个提供参考点来比较你的机器学习模型的基线也很重要。最后,把你的数据分成三个集合:训练集、验证集和测试集。
大多数现代分类学习算法实现要求训练示例具有数值标签,所以你通常必须把标签转换成数值向量。两种流行的做法是独热编码(用于二分类和多类问题)和词袋(用于多标签问题)。
为了选择最适合你问题的机器学习算法,问问自己以下问题:
模型的预测是否必须向非技术受众解释?如果是,你会更倾向于使用不太准确但更可解释的算法,如 kNN、线性回归和决策树学习。
你的数据集里有多少训练示例,每个示例有多少个特征?一些算法(包括用于训练神经网络和随机森林的算法)可以处理海量的示例和数百万个特征。其他算法的容量相对有限。
你的数据集能否完全加载到你笔记本电脑或服务器的内存中?如果不能,你会更倾向于增量学习算法。
你的数据是线性可分的,还是可以用线性模型建模?如果是,带线性核的 SVM、线性回归和逻辑回归可能是不错的选择。否则,深度神经网络或集成模型可能效果更好。
在生产环境中评分必须有多快?像 SVM、线性回归和逻辑回归这样的模型,以及不太深的前馈神经网络,在预测时都非常快。使用深度和循环神经网络以及梯度提升(gradient boosting)模型的评分则较慢。
学习算法被允许用多少时间来训练模型?神经网络以训练缓慢而闻名。像线性回归、逻辑回归或决策树这样的简单算法要快得多。
如果你不想猜测最适合你问题的最佳算法,推荐的方法是对几个算法进行抽查,然后把它们作为超参数在验证集上测试。
了解模型有多好的一种典型方法是在留出数据上计算性能指标的值。有为分类和回归模型定义的性能指标,也有为排序模型定义的性能指标。
调整超参数的值控制着两个权衡:精确率-召回率和偏差-方差。通过改变模型的复杂度,我们可以达到所谓的「解区域」,即模型的偏差和方差都相对较低的情况。优化性能指标的解决方案通常在该区域内找到。
正则化是迫使学习算法构建更简单模型的方法的总称。在实践中,这通常会导致偏差略高,但会显著减少方差。两种流行的正则化技术是 L1 和 L2。此外,神经网络还受益于另外两种正则化技术:dropout 和批归一化。
大多数现代机器学习包和框架支持流水线的概念。流水线是训练数据在成为模型之前所经历的一系列变换。在流水线中,每个阶段对其接收的输入应用某种变换。每个阶段接收前一阶段的输出,除了第一个阶段。第一个阶段接收训练数据集作为输入。流水线可以像保存模型一样保存到文件中。它可以被部署到生产环境并用于生成预测。
超参数不是由学习算法本身优化的。数据分析师必须通过试验不同的值组合来「调优」超参数。网格搜索是最简单、最广泛使用的超参数调优技术。它包括对超参数的值进行离散化,并通过以下方式尝试所有值组合:1) 为每个超参数组合训练一个模型,2) 把每个训练好的模型应用于验证集来计算性能指标。
一个像样的验证集至少包含一百个示例,并且集中的每个类别至少由二十几个示例表示。当你没有一个像样的验证集来调优超参数时,你可以使用交叉验证。
Machine Learning ENGINEERING
Andriy Burkov
「从理论上讲,理论与实践之间没有区别。但在实践中,是有区别的。」——本杰明·布鲁斯特(Benjamin Brewster)
「完美的项目计划是可能的,只要先把所有未知因素的清单记录下来。」——比尔·兰利(Bill Langley)
「当你筹款时,它是 AI。当你招聘时,它是机器学习(ML)。当你实施时,它是线性回归。当你调试时,它是 printf()。」——巴伦·施瓦茨(Baron Schwartz)
本书按「先读后买」原则发行。
如上一章所述,大多数现代机器学习库和包都期望数值特征向量。然而,一些算法(如决策树学习)可以自然地处理类别型特征。 ↩︎
我们将在第 5.6.5 小节讨论交叉验证。 ↩︎
一个像样的验证集至少包含一百个示例,并且集中的每个类别至少由二十几个示例表示。 ↩︎
交叉验证的过程更容易用迭代过程来说明;不过,你当然可以并行构建全部五个模型 \(f_1\) 到 \(f_5\)。 ↩︎
虽然通常建议减少模型参数的数量来减少过拟合并改善模型的泛化,但深度双重下降(deep double descent)现象有时证明情况恰恰相反。这种现象在各种架构中都被观察到,包括 CNN 和 Transformer:随着模型规模的增大,验证性能先是提高,然后变差,然后又提高。截至 2020 年 7 月,我们还不完全理解为什么会发生这种情况。 ↩︎