特征工程
在数据收集与准备之后,特征工程(feature engineering)是机器学习中第二重要的活动。它也是机器学习项目生命周期的第三个阶段:
图 1:机器学习项目生命周期。
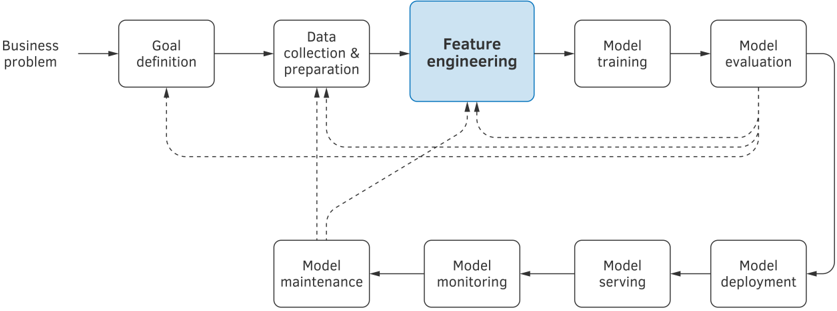
特征工程是一个过程:首先在概念上、然后在程序上,将一条原始示例(raw example)转换为特征向量(feature vector)。它包含构思一个特征,然后编写程序代码,将整条原始示例——可能借助一些间接数据——转换为该特征。
4.1 为什么要做特征工程
更具体地说,考虑在推文中识别电影标题的问题。假设你有一大堆电影标题;这是可以间接使用的数据。你还有一堆推文;这些数据将直接用于创建示例。首先,为电影标题构建一个索引,以便快速进行字符串匹配。1 然后在你的推文中找出所有电影标题的匹配项。现在规定你的示例就是这些匹配项,而你的机器学习问题是二分类(binary classification):一个匹配项是电影,还是不是电影。
考虑下面这条推文:
图 2:Kyle 的一条推文。
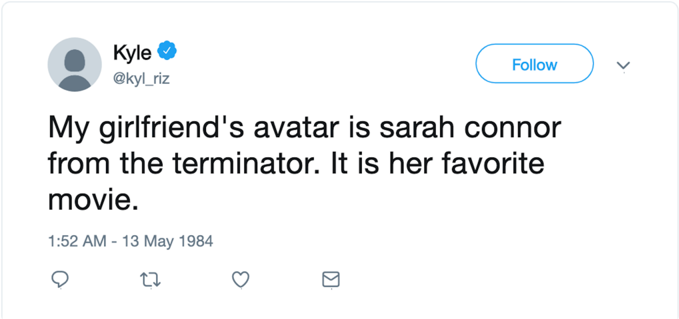
我们的电影标题匹配索引会帮助我们找到以下匹配项:「avatar」「the terminator」「It」和「her」。这就给了我们四个未标记的示例。你可以给这四个示例打上标签:{(avatar, False), (the terminator, True), (It, False), (her, False)}。然而,机器学习算法无法仅从电影标题本身学到任何东西(人类也不能):它需要上下文。你可能会决定,匹配项之前的五个词和之后的五个词构成一个信息量足够的上下文。用机器学习的行话来说,我们称这样的上下文为匹配项周围的「十字窗口」(ten-word window)。你可以把窗口的宽度作为超参数(hyperparameter)来调整。
现在,你的示例是带有上下文的已标记匹配项。然而,学习算法无法直接应用于这样的数据。机器学习算法只能应用于特征向量。这就是你求助于特征工程的原因。
4.2 如何做特征工程
特征工程是一个创造性的过程,分析师在此过程中运用他们的想象力、直觉和领域专长。在我们这个在推文中识别电影标题的示例问题中,我们凭直觉把匹配项周围的窗口宽度固定为十。现在,我们需要更有创造力,才能把字符串序列转换成数值向量。
4.2.1 文本的特征工程
说到文本,科学家和工程师经常使用简单的特征工程技巧。其中两个技巧是独热编码(one-hot encoding)和词袋(bag-of-words)。
一般来说,独热编码将一个类别属性(categorical attribute)转换成若干个二值属性。假设你的数据集有一个属性「颜色」(Color),可能的取值为「红」「黄」「绿」。我们把每个取值转换成一个三维二值向量,如下所示:
\[ \text{red} \to (1, 0, 0), \quad \text{yellow} \to (0, 1, 0), \quad \text{green} \to (0, 0, 1) \]在电子表格中,你将不再使用一个以「颜色」为表头的列,而是使用三个合成列,取值为 1 或 0。这样做的好处是,你现在可以使用大量的机器学习算法,因为只有少数学习算法支持类别属性。
词袋是独热编码技术应用于文本数据的一种推广。你不是用这种技术来表示一个属性,而是用它将整个文本文档表示为一个二值向量。让我们看看它是如何工作的。
想象你有一个包含六篇文本文档的集合,如下所示:
图 3:一个包含六篇文档的集合。
| 文档 1 | Love, love is a verb |
|---|---|
| 文档 2 | Love is a doing word |
| 文档 3 | Feathers on my breath |
| 文档 4 | Gentle impulsion |
| 文档 5 | Shakes me, makes me lighter |
| 文档 6 | Feathers on my breath |
假设你的问题是构建一个按主题分类的文本分类器。分类学习算法期望输入是带标签的特征向量,因此你必须将文本文档集合转换为特征向量集合。词袋就能让你做到这一点。
首先,对文本进行分词(tokenize)。分词(tokenization)是将文本拆分成称为「词元」(token)的小片段的过程。分词器(tokenizer)是一种软件,它接收一个字符串作为输入,并返回从该字符串中提取的词元序列。通常,词元就是单词,但这并不是严格必须的。它可以是一个标点符号、一个单词,或者在某些情况下是单词的组合,例如一个公司名(如 McDonald’s)或一个地名(如 Red Square)。让我们使用一个简单的分词器,它提取单词而忽略其他一切。我们得到如下集合:
图 4:分词后的文档集合。
| 文档 1 | [Love, love, is a verb] |
|---|---|
| 文档 2 | [Love, is, a, doing, word] |
| 文档 3 | [Feathers, on, my, breath] |
| 文档 4 | [Gentle, impulsion] |
| 文档 5 | [Shakes, me, makes, me lighter] |
| 文档 6 | [Feathers, on, my, breath] |
下一步是构建词表(vocabulary)。它包含 16 个词元:2
| a | breath | doing | feathers |
|---|---|---|---|
| gentle | impulsion | is | lighter |
| love | makes | me | my |
| on | shakes | verb | word |
现在以某种方式给你的词表排序,并为每个词元分配一个唯一索引。我按字母顺序对词元排序:
图 5:有序且有索引的词元。
| a | breath | doing | feathers | gentle | impulsion | is | lighter | love | makes | me | my | on | shakes | verb | word |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 |
词表中的每个词元都有一个唯一索引,从 1 到 16。我们把文档集合转换成二值特征向量集合,如下所示:
图 6:特征向量。
| a | breath | doing | feathers | gentle | impulsion | is | lighter | love | makes | me | my | on | shakes | verb | word | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 文档 1 | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 文档 2 | 1 | 0 | 1 | 0 | 0 | 0 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 1 |
| 文档 3 | 0 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 文档 4 | 0 | 0 | 0 | 0 | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 文档 5 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 1 | 1 | 0 | 0 | 1 | 0 | 0 |
| 文档 6 | 0 | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
如果对应的词元出现在文本中,则该特定位置为 1;否则,该位置的特征值为 0。
例如,文档 1「Love, love is a verb」由以下特征向量表示:
\[ x_1 = (1, 0, 0, 0, 0, 0, 1, 0, 1, 0, 0, 0, 0, 0, 1, 0) \]使用相应的带标签特征向量作为训练数据,任何分类学习算法都可以处理这些数据。
词袋有几种「变体」。上述二值模型通常效果不错。二值取值的替代方案包括:1)词元计数,2)词元频率,或 3)TF-IDF(词频-逆文档频率,term frequency-inverse document frequency)。如果你使用单词计数,那么文档 1「Love, love is a verb」中「love」的特征值将是 2,表示单词「love」在文档中出现的次数。如果应用词元频率,假设分词器从文档 1 中提取了两个「love」词元和总共五个词元,那么「love」的值将是 2/5 = 0.4。TF-IDF 值随单词在文档中的频率成比例增加,同时被语料库中包含该单词的文档数量所抵消。这可以调整某些词(如介词和代词)总体上出现更频繁的情况。我不再深入介绍 TF-IDF,但建议感兴趣的读者在线了解更多。
词袋技术的一个直接扩展是词袋 n-gram(bag-of-n-grams)。n-gram 是从语料库中取出的 n 个单词的序列。如果 n = 2,并且忽略标点,那么文本「No, I am your father.」中可以找到的所有二元组(two-grams,通常称为 bigrams)如下:[‘No I’, ‘I am’, ‘am your’, ‘your father’]。三元组(three-grams)是 [‘No I am’, ‘I am your’, ‘am your father’]。通过将直到某个 n 的所有 n-gram 与词元混合在一个字典中,我们得到一个 n-gram 词袋,可以像处理词袋模型一样对其进行分词。
由于单词序列通常比单个单词少见,使用 n-gram 会产生更稀疏的特征向量。同时,n-gram 使机器学习算法能够学习更细致的模型。例如,表达「this movie was not good and boring」和「this movie was good and not boring」含义相反,但如果仅基于单词,会产生相同的词袋向量。如果我们考虑单词的二元组,那么这两个表达的二元组词袋向量将不同。
4.2.2 词袋为什么有效
特征向量只有在遵循某些规则时才有效。一条规则是,特征向量中位置 j 的特征必须在数据集的所有示例中表示相同的属性。如果该特征表示数据集中某人的身高(以厘米为单位),其中每个示例代表不同的人,那么在所有其他示例中都必须如此。位置 j 的特征必须始终表示以厘米为单位的身高,而不是其他任何东西。
词袋技术也是如此。每个特征都表示文档的相同属性:特定词元在文档中存在还是不存在。
另一条规则是,相似的特征向量必须表示数据集中相似的实体。使用词袋技术时也遵循这一属性。两个相同的文档将具有相同的特征向量。同样,两个关于同一主题的文本更有可能具有相似的特征向量,因为它们比两个不同主题的文本共享更多的单词。
4.2.3 将类别特征转换为数字
独热编码并不是将类别特征转换为数字的唯一方法,而且它并不总是最好的方法。
均值编码(mean encoding),也称为分箱计数(bin counting)或特征校准(feature calibration),是另一种技术。首先,使用特征取值为 z 的所有示例计算标签的样本均值(sample mean)。然后,类别特征的每个取值 z 都被替换为该样本均值。这种技术的优点是数据维度不会增加,而且按照设计,数值本身就包含一些关于标签的信息。
如果你处理的是二分类问题,除了样本均值,你还可以使用其他有用的量:给定 z 值时正类(positive class)的原始计数、优势比(odds ratio)和对数优势比(log-odds ratio)。优势比(OR)通常定义在两个随机变量之间。从一般意义上讲,OR 是一种量化两个事件 A 和 B 之间关联强度的统计量。如果 OR 等于 1,则认为两个事件是独立的,也就是说,一个事件的发生概率在另一个事件存在或不存在时是相同的。
在量化类别特征的应用中,我们可以计算类别特征取值 z(事件 A)与正标签(事件 B)之间的优势比。让我们用一个例子来说明。假设我们的问题是预测一封电子邮件是垃圾邮件还是非垃圾邮件。假设我们有一个带标签的电子邮件数据集,并且我们设计了一个包含每封电子邮件中最常见单词的特征。让我们找出可以用什么数值来替换该特征中的类别取值「infected」。我们首先为「infected」和「spam」构建列联表(contingency table):
图 7:「infected」和「spam」的列联表。
| 垃圾邮件 | 非垃圾邮件 | 总计 | |
|---|---|---|---|
| 包含「infected」 | 145 | 8 | 153 |
| 不包含「infected」 | 346 | 2909 | 3255 |
| 总计 | 491 | 2917 | 3408 |
「infected」和「spam」的优势比由下式给出:
\[ OR = \frac{145 \times 2909}{8 \times 346} \]如你所见,优势比取决于列联表中的值,可能极低(接近零)或极高(任意高的正值)。为避免数值溢出问题,分析师经常使用对数优势比:
\[ \log\text{-odds} = \log \left( \frac{145 \times 2909}{8 \times 346} \right) = 2.2 \]现在你可以用值 2.2 替换上述类别特征中的「infected」取值。你可以用同样的方式处理该类别特征的其他取值,并将它们全部转换为对数优势比值。
有时,类别特征是有序的,但不是循环的。例子包括学校成绩(从「A」到「E」)和资历级别(「初级」「中级」「高级」)。与其使用独热编码,不如用有意义的数字来表示它们。使用 [0, 1] 范围内的均匀数字,比如「初级」用 1/3,「中级」用 2/3,「高级」用 1。如果某些取值应该相距更远,你可以用不同的比例来反映。如果「高级」应该比「中级」离「初级」更远,你可能会分别对「初级」「中级」「高级」使用 1/5、2/5、1。这就是领域知识重要的原因。
当类别特征是循环的时,整数编码效果不好。例如,尝试把周一到周日转换为整数 1 到 7。周日和周六之间的差是 1,而周一和周日之间的差是 -6。然而,我们的推理表明差值应该同样是 1,因为周一只是周日的后一天。
相反,使用正弦-余弦变换(sine-cosine transformation)。它把一个循环特征转换成两个合成特征。设 p 表示循环特征的整数值。用以下两个值替换循环特征的值 p:
\[ p_{\sin} = \sin \frac{2\pi p}{N}, \quad p_{\cos} = \cos \frac{2\pi p}{N} \]其中 N 是周期(即循环中的类别数,例如一周的 7 天)。
下表包含一周七天的 \(p_{\sin}\) 和 \(p_{\cos}\) 值:
| p | \(p_{\sin}\) | \(p_{\cos}\) |
|---|---|---|
| 1 | 0.78 | 0.62 |
| 2 | 0.97 | -0.22 |
| 3 | 0.43 | -0.9 |
| 4 | -0.43 | -0.9 |
| 5 | -0.97 | -0.22 |
| 6 | -0.78 | 0.62 |
| 7 | 0 | 1 |
图 8 包含使用上表绘制的散点图。你可以看到这两个新特征的循环性质。
现在,在你的整洁数据中,把「Monday」替换为两个值 [0.78, 0.62],把「Tuesday」替换为 [0.97, -0.22],依此类推。数据集增加了一个维度,但与整数编码相比,模型的预测质量显著提高。
4.2.4 特征哈希
特征哈希(feature hashing),或称哈希技巧(hashing trick),将文本数据或具有许多取值的类别属性转换为任意维度的特征向量。独热编码和词袋有一个缺点:许多唯一值会产生高维特征向量。例如,如果文本文档集合中有一百万个唯一词元,词袋将产生每个维度为一百万的特征向量。处理如此高维的数据可能在计算上非常昂贵。
图 8:表示一周各天的正弦-余弦变换特征。
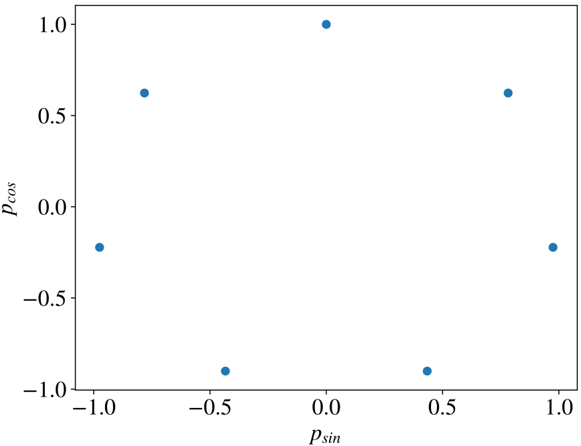
图 9:在属性原始基数(cardinality)为 K 的情况下,目标维度为 5 的哈希技巧示意图。
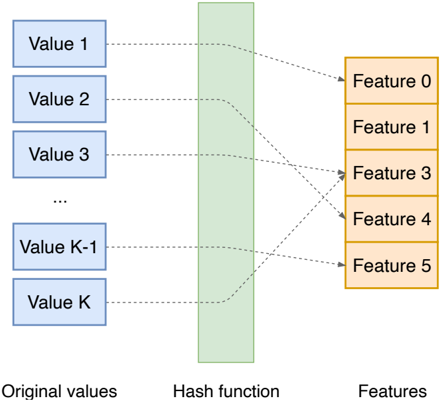
为了保持数据可管理,你可以使用哈希技巧,其工作方式如下。首先确定特征向量的目标维度。然后,使用哈希函数(hash function),先把类别属性的所有取值(或文档集合中的所有词元)转换为一个数字,再把这个数字转换为特征向量的一个索引。该过程如图 9 所示。
让我们说明如何将文本「Love is a doing word」转换为特征向量。假设我们有一个哈希函数 h,它以字符串为输入并输出非负整数,目标维度为 5。对每个单词应用哈希函数,并对结果取 5 的模(modulo)来获得单词的索引,我们得到:
h(love) mod 5 = 0
h(is) mod 5 = 3
h(a) mod 5 = 1
h(doing) mod 5 = 3
h(word) mod 5 = 4
然后我们构建特征向量:
\[ x = (1, 1, 0, 2, 1) \]确实,h(love) mod 5 = 0 意味着我们在特征向量的维度 0 中有一个单词;h(is) mod 5 = 3 和 h(doing) mod 5 = 3 意味着我们在特征向量的维度 3 中有两个单词,依此类推。如你所见,「is」和「doing」之间存在冲突:它们都由维度 3 表示。目标维度越低,冲突的概率就越高。这就是学习速度与质量之间的权衡。
常用的哈希函数有 MurmurHash3、Jenkins、CityHash 和 MD5。
4.2.5 主题建模
主题建模(topic modeling)是一族使用未标记数据的技术,通常采用自然语言文本文档的形式。模型学会将文档表示为话题向量(vector of topics)。例如,在一个新闻文章集合中,五个主要话题可能是「体育」「政治」「娱乐」「财经」和「科技」。那么,每篇文档都可以表示为一个五维特征向量,每个维度对应一个话题:
\[ x = (0.0, 0.5, 0.0, 0.3, 0.0) \]上述特征向量表示一篇混合了两个主要话题的文档:政治(权重 0.5)和财经(权重 0.3)。主题建模算法,如潜在语义分析(Latent Semantic Analysis,LSA)和潜在狄利克雷分配(Latent Dirichlet Allocation,LDA),通过分析未标记文档来学习。这两种算法产生相似的输出,但基于不同的数学模型。LSA 对词-文档矩阵(使用二值词袋或 TF-IDF 构建)进行奇异值分解(singular value decomposition,SVD)。LDA 使用分层贝叶斯模型(hierarchical Bayesian model),其中每篇文档是几个话题的混合,每个单词的出现都归因于其中一个话题。
让我们说明它在 Python 和 R 中是如何工作的。以下是 LSA 的 Python 代码:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.decomposition import TruncatedSVD

class LSA():
    def __init__(self, docs):
        # Convert documents to TF-IDF vectors
        self.TF_IDF = TfidfVectorizer()
        self.TF_IDF.fit(docs)
        vectors = self.TF_IDF.transform(docs)

        # Build the LSA topic model
        self.LSA_model = TruncatedSVD(n_components=50)
        self.LSA_model.fit(vectors)
        return

    def get_features(self, new_docs):
        # Get topic-based features for new documents
        new_vectors = self.TF_IDF.transform(new_docs)
        return self.LSA_model.transform(new_vectors)

# Later, in production, instantiate LSA model
docs = ["This is a text.", "This another one."]
LSA_featurizer = LSA(docs)

# Get topic-based features for new_docs
new_docs = ["This is a third text.", "This is a fourth one."]
LSA_features = LSA_featurizer.get_features(new_docs)
对应的 R 代码如下所示:3
library(tm)
library(lsa)

get_features <- function(LSA_model, new_docs){
    # new_docs can be passed as a tm::Corpus object or as a vector
    # holding character strings representing documents:
    if (!inherits(new_docs, "Corpus")) new_docs <- VCorpus(VectorSource(new_docs))
    tdm_test <- TermDocumentMatrix(
        new_docs,
        control = list(
            dictionary = rownames(LSA_model$tk),
            weighting = weightTfIdf
        )
    )
    txt_mat <- as.textmatrix(as.matrix(tdm_test))
    crossprod(t(crossprod(txt_mat, LSA_model$tk)), diag(1/LSA_model$sk))
}

# Train LSA model using docs
docs <- c("This is a text.", "This another one.")
corpus <- VCorpus(VectorSource(docs))
tdm_train <- TermDocumentMatrix(
    corpus, control = list(weighting = weightTfIdf))
txt_mat <- as.textmatrix(as.matrix(tdm_train))
LSA_fit <- lsa(txt_mat, dims = 2)

# Later, in production, get topic-based features for new_docs
new_docs <- c("This is a third text.", "This is a fourth one.")
LSA_features <- get_features(LSA_fit, new_docs)
以下是 LDA 的 Python 代码:
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.decomposition import LatentDirichletAllocation

class LDA():
    def __init__(self, docs):
        # Convert documents to TF-IDF vectors
        self.TF = CountVectorizer()
        self.TF.fit(docs)
        vectors = self.TF.transform(docs)

        # Build the LDA topic model
        self.LDA_model = LatentDirichletAllocation(n_components=50)
        self.LDA_model.fit(vectors)
        return

    def get_features(self, new_docs):
        # Get topic-based features for new documents
        new_vectors = self.TF.transform(new_docs)
        return self.LDA_model.transform(new_vectors)

# Later, in production, instantiate LDA model
docs = ["This is a text.", "This another one."]
LDA_featurizer = LDA(docs)

# Get topic-based features for new_docs
new_docs = ["This is a third text.", "This is a fourth one."]
LDA_features = LDA_featurizer.get_features(new_docs)
对应的 R 代码如下:
library(tm)
library(topicmodels)

# Generate feature for new_docs by using LDA_model
get_features <- function(LDA_mode, new_docs){
    # new_docs can be passed as tm::Corpus object or as a vector
    # holding character strings representing documents:
    if (!inherits(new_docs, "Corpus")) new_docs <- VCorpus(VectorSource(new_docs))
    new_dtm <- DocumentTermMatrix(new_docs, control = list(weighting = weightTf))
    posterior(LDA_mode, newdata = new_dtm)$topics
}

# train LDA model using docs
docs <- c("This is a text.", "This another one.")
corpus <- VCorpus(VectorSource(docs))
dtm <- DocumentTermMatrix(corpus, control = list(weighting = weightTf))
LDA_fit <- LDA(dtm, k = 5)

# later, in production, get topic-based features for new_docs
new_docs <- c("This is a third text.", "This is a fourth one.")
LDA_features <- get_features(LDA_fit, new_docs)
在上述代码清单中,docs 是一个文本文档集合。例如,它可以是一个字符串列表,其中每个字符串是一篇文档。
4.2.6 时间序列的特征
时间序列(time-series)数据不同于传统的监督学习数据,后者是无序的独立观测集合。时间序列是有序的观测序列,每个观测都带有与时间相关的属性,如时间戳、日期、月-年、年份等。时间序列数据的一个例子如图 10 所示。
图 10:事件流形式的时间序列数据示例。
| 日期 | 股票价格 | S&P 500 | 道琼斯 |
|---|---|---|---|
| 2020-01-11 | … | … | … |
| 2020-01-12 | 14.5 | 3,345 | 28,583 |
| 2020-01-12 | 14.7 | 3,352 | 28,611 |
| 2020-01-12 | 15.9 | 3,347 | 29,001 |
| 2020-01-13 | 17.9 | 3,298 | 28,312 |
| 2016-01-13 | 16.8 | 3,521 | 28,127 |
| 2020-01-14 | 17.9 | 3,687 | 28,564 |
| 2016-01-15 | 16.8 | 3,540 | 27,998 |
| 2016-01-16 | … | … | … |
图 11:对图 10 中的事件流进行聚合得到的经典时间序列。
| 日期 | 股票价格 | S&P 500 | 道琼斯 |
|---|---|---|---|
| 2020-01-11 | … | … | … |
| 2020-01-12 | 15.0 | 3,348 | 28,732 |
| 2020-01-13 | 17.4 | 3,410 | 28,220 |
| 2020-01-14 | 17.9 | 3,687 | 28,564 |
| 2016-01-15 | 16.8 | 3,540 | 27,998 |
| 2016-01-16 | … | … | … |
在图 10 中,每一行对应某只股票在某一时刻的价格,以及两个指数的值:S&P 500 和道琼斯。这些观测是不规则进行的:在 2020-01-12 进行了三次观测。在 2020-01-13 有两次观测。在经典时间序列数据中,观测在时间上均匀间隔,例如每秒、每分钟、每天一次观测等。如果观测是不规则的,这种时间序列数据称为点过程(point process)或事件流(event stream)。
通常可以通过聚合观测将事件流转换为经典时间序列数据。聚合算子(aggregation operator)的例子有 COUNT 和 AVERAGE。将 AVERAGE 算子应用于图 10 中的事件流数据,我们得到图 11 所示的经典时间序列数据。
虽然可以直接处理事件流,但将时间序列转换为经典形式可以更简单地应用进一步的聚合,并为机器学习生成特征。
分析师通常使用时间序列数据来解决两类预测问题。给定一个最近的观测序列:
- 预测关于下一个观测的某种信息(例如,给定过去七天某只股票的价格和股票指数的值,预测明天的股票价格),或者
- 预测关于产生该序列的现象的某种信息(例如,给定用户对软件系统的连接日志,预测他们是否可能在本季度取消订阅)。
在神经网络达到其现代学习能力之前,分析师使用浅层机器学习工具包处理时间序列数据。要将时间序列转换为特征向量形式的训练数据,必须做出两个决定:
- 需要多少个连续观测才能做出准确的预测(即所谓的预测窗口(prediction window)),以及
- 如何将观测序列转换为固定维度的特征向量。
这两个问题都没有简单的答案。通常基于领域专家的知识做出决定,或者使用超参数调优技术。然而,有些方法对许多时间序列数据都有效。下面就是这样一种方法:
- 1)将整个时间序列分块为长度为 w 的片段,
- 2)从每个片段 s 创建一个训练示例 e,
- 3)对每个 e,计算 s 中观测的各种统计量。
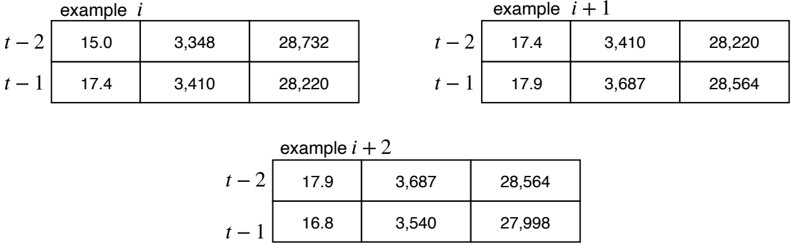
我们取图 11 的数据,并将其分块为长度 w = 2 的片段,其中 w 是预测窗口的长度。图 12 显示每个片段现在都是一个单独的示例。
图 12:分块为长度 w = 2 的片段的时间序列。
| 示例 i | 股票价格 | S&P 500 | 道琼斯 |
|---|---|---|---|
| 15.0 | 3,348 | 28,732 | |
| 17.4 | 3,410 | 28,220 |
| 示例 i+1 | 股票价格 | S&P 500 | 道琼斯 |
|---|---|---|---|
| 17.4 | 3,410 | 28,220 | |
| 17.9 | 3,687 | 28,564 |
| 示例 i+2 | 股票价格 | S&P 500 | 道琼斯 |
|---|---|---|---|
| 17.9 | 3,687 | 28,564 | |
| 16.8 | 3,540 | 27,998 |
在实践中,w 通常大于 2。假设我们的预测窗口长度为七。在上述方法的第(3)步计算的统计量可以是:
- 平均值(例如,过去七天股票价格的平均值或中位数),
- 离群值(例如,道琼斯指数值异常低的观测占比;例如,偏离均值超过两个标准差),
- 离散程度(例如,过去七天 S&P 500 指数值的标准差(standard deviation)、中位数绝对偏差(median absolute deviation)或四分位距(interquartile range)),
- 增长(例如,S&P 500 指数值是否在 t-6 与 t 天之间、t-3 与 t 天之间以及 t-1 与 t 之间增长),
- 视觉特征(例如,股票价格曲线与已知视觉图像——如帽子形、头肩形——的差异程度)。
现在你明白为什么建议将时间序列转换为经典形式了:上述统计量只有在可比数值上计算时才有意义。
应该指出,在现代神经网络时代,分析师通常更倾向于训练深度神经网络。长短期记忆(long short-term memory,LSTM)、卷积神经网络(convolutional neural network,CNN)和 Transformer 是时间序列模型的流行架构选择。它们可以读取任意长度的时间序列作为输入,并根据整个序列生成预测。同样,神经网络也经常应用于文本,逐词或逐字符地阅读文本。单词和字符通常表示为嵌入向量(embedding vector);后者是从大型文本文档语料库中学习得到的。我们将在 4.7.1 节讨论嵌入。
4.2.7 发挥你的创造力
正如我在本节开头提到的,特征工程是一个创造性的过程。作为分析师,你最有条件确定什么对你的预测模型是好特征。设身处地地站在学习算法的角度想一想:你会看数据中的什么来决定分配哪个标签?
假设你在把电子邮件分类为重要或不重要。你可能会注意到,相当多的重要邮件在每月第一个星期一来自政府税务机关。创建一个「政府月初周一」特征。当电子邮件在某个月的第一个星期一来自政府税务机关时,让它等于 1,否则为 0。或者,你可能会注意到,包含多个笑脸表情的电子邮件很少是重要的。创建一个「包含笑脸」特征。当一封电子邮件包含多个笑脸表情时,让它等于 1,否则为 0。
4.3 堆叠特征
回到我们的推文中电影标题分类问题。每个示例有三个部分:
- 1)位于提取出的潜在电影标题之前的五个词4(左侧上下文),
- 2)提取出的潜在电影标题(提取结果),
- 3)位于提取出的电影标题之后的五个词(右侧上下文)。
为了表示这种多部分示例,我们首先将每个部分转换为特征向量,然后将三个特征向量并排堆叠,得到整个示例的特征向量。
4.3.1 堆叠特征向量
在我们的电影标题分类问题中,我们首先收集所有左侧上下文。然后应用词袋将每个左侧上下文转换为二值特征向量。接下来,收集所有提取结果,并使用词袋将每个提取结果转换为二值特征向量。然后收集所有右侧上下文,并应用词袋将每个右侧上下文转换为二值特征向量。最后,拼接每个示例,将左侧上下文、提取结果和右侧上下文的特征向量连接起来。我们得到表示整个示例的最终特征向量,如图 13 所示。
图 13:创建并堆叠特征向量。
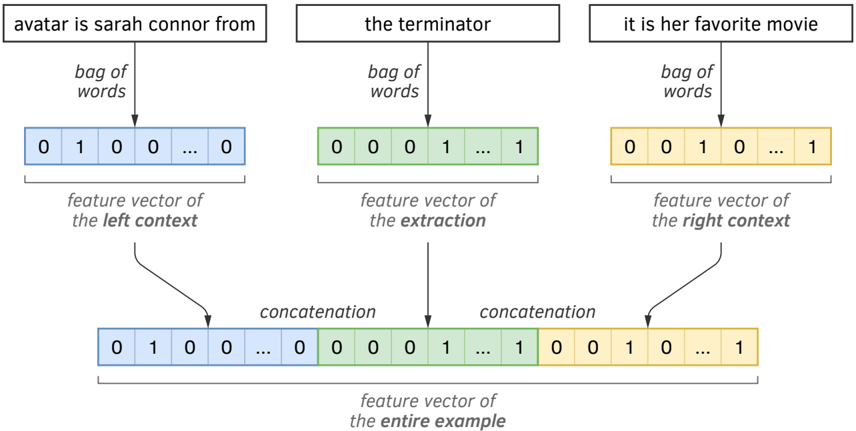
注意,三个特征向量(每个来自示例的一个部分)是彼此独立创建的。这意味着每个部分的词元词表是不同的,因此每个部分的特征向量维度也可能不同。
拼接特征向量的顺序无关紧要。左侧上下文特征可以放在最终特征向量的中间或右侧。但是,你必须在所有示例中保持相同的拼接顺序。这可以确保每个特征在示例之间表示相同的属性。
4.3.2 堆叠单个特征
到目前为止,我们是批量设计特征。独热编码和词袋通常生成数千个特征。这是一种非常省时的特征工程方式,但有些问题需要更多才能获得预测能力(predictive power)足够高的特征向量。我们将在下一节讨论特征的预测能力。
想象你已经有一个分类器 m_A,它以整条推文为输入并预测其主题。假设其中一个主题是电影。你可能想用分类器 m_A 提供的这一额外信息来丰富电影标题分类问题中的特征向量。在这种情况下,你将设计一个可以描述为「推文主题是否为电影」的特征,该特征也将是二值的:如果 m_A 对整条推文预测的主题是电影,则为 1,否则为 0。同样,我们拼接三个部分特征向量,如图 14 所示。
图 14:单个特征堆叠。
| B-o-w 1 | B-o-w 2 | B-o-w M-1 | B-o-w M | 是电影? | |||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 示例 1 | 0 | 1 | 0 | 0 | … | 0 | 0 | 0 | 0 | 1 | … | 1 | 0 | 0 | 1 | 0 | … | 1 | 1 |
| 示例 2 | 0 | 0 | 1 | 1 | … | 1 | 0 | 1 | 0 | 1 | … | 0 | 1 | 1 | 1 | 0 | … | 0 | 0 |
| … | … | … | … | … | … | … | … | … | … | … | … | … | … | … | … | … | … | … | … |
| 示例 N | 0 | 0 | 1 | 1 | … | 0 | 1 | 1 | 0 | 1 | … | 1 | 1 | 0 | 1 | 1 | … | 1 | 1 |
你可能想出更多对推文中标题分类有用的特征。这样的特征示例有:
- 电影在 IMDB 上的平均评分,
- 电影在 Rotten Tomato 上的评分,
- 电影在 IMDB 上的投票数,
- 电影是否是近期的(或表示上映年份的数字),
- 推文文本是否包含演员或导演的名字,
- 推文文本是否包含其他电影标题。
只要这些附加特征是数值型的,它们都可以被拼接(concatenate)到特征向量上。唯一的条件是它们在所有示例中以相同的顺序拼接。
4.4 好特征的性质
并非所有特征都是平等的。在本节中,我们考虑好特征的性质。
4.4.1 高预测能力
首先,好特征具有高预测能力。在第 3 章中,你读到预测能力是数据的一种属性。然而,特征也可以具有高或低的预测能力。假设你想预测患者是否患有癌症。在其他特征中,你知道这个人开的车的品牌以及这个人是否已婚。这两个特征不是癌症的良好预测因子,因此我们的机器学习算法不会学习到这些特征与标签之间的有意义关系。预测能力是特征相对于问题的一种属性。如果问题不同,这个人的汽车品牌和婚姻状况可能具有很高的预测能力。
4.4.2 可快速计算
好特征可以快速计算。假设你想预测一条推文的主题。推文很短,基于词袋的特征向量将是稀疏的。稀疏向量(sparse vector)是大多数维度上的值为零的向量。如果你的数据集很小且文本很短,学习算法将很难在稀疏向量中看到模式,因为与它们的大小相比,它们包含的信息很少。一个稀疏向量中的信息很少与另一个稀疏向量中的信息位于相同的维度上,即使它们表示相似的概念。
为了减少稀疏性,你可能想用额外的非零值来增强稀疏特征向量。为此,你可以将推文文本作为搜索查询发送到 Wikipedia,然后从搜索结果中提取其他单词。Wikipedia 的 API 不保证响应速度,因此可能需要几秒钟才能得到响应。对于实时系统,特征提取必须快:一个信息量较少但能在不到一毫秒内计算出来的特征,通常优于一个预测能力强但需要几秒钟计算的特征。如果你的应用程序必须快,从 Wikipedia 获得的特征可能不适合你的任务。
4.4.3 可靠性
好特征还必须是可靠的。同样,在我们的 Wikipedia 示例中,我们无法保证该网站一定会响应:它可能宕机、正在计划维护,或者 API 可能暂时被过度使用而拒绝请求。因此,我们不能相信基于 Wikipedia 的特征总是可用和完整的。因此,我们不能称这样的特征是可靠的。一个不可靠的特征会降低模型预测的质量。此外,如果一个重要特征的值缺失,某些预测可能变得完全错误。
4.4.4 不相关性
两个特征的相关性(correlation)意味着它们的值是相关的。如果一个特征的增长意味着另一个特征的增长,反之亦然,那么这两个特征是相关的。
一旦模型投入生产,其性能可能会改变,因为输入数据的属性可能随时间变化。当你的许多特征高度相关时,即使输入数据属性发生微小变化,也可能导致模型行为发生显著变化。
有时模型是在严格的时间限制下构建的,因此开发人员使用了所有可能的特征来源。随着时间的推移,维护这些来源可能变得昂贵。通常建议消除冗余或高度相关的特征。特征选择技术有助于减少此类特征。
4.4.5 其他性质
好特征的一个基本性质是,其特征值在训练集中的分布与在生产中接收到的分布相似。例如,推文的日期可能对关于它的一些预测是必要的。然而,如果你将在历史推文上构建的模型应用于预测当前推文的相关信息,你的生产示例的日期将始终超出训练分布,这可能导致显著误差。5
最后,你设计的特征应该是单一的(unitary)、易于理解和维护的。单一意味着特征表示一个易于理解和解释的量。例如,在根据汽车特征对汽车类型进行分类时,你可以使用重量、长度、宽度和颜色等单一特征。像「长度除以重量」这样的特征不是单一的,因为它由两个单一特征组成。
某些学习算法可能受益于组合特征。然而,最好在模型训练流程(pipeline)中的一个专门阶段进行。我们将在本章后面考虑特征组合和合成特征的生成。
4.5 特征选择
并非所有特征对你的问题都同等重要。例如,在推文中检测电影的问题中,电影的长度可能不是一个非常重要的特征。同时,当你使用词袋时,词表可能非常大,而大多数词元在文本集合中只出现一次。如果学习算法「看到」某个特征只在几个训练示例中具有非零值,那么该算法能否从该特征中学习到任何有用的模式是值得怀疑的。然而,如果特征向量非常宽(包含数千或数百万个特征),训练时间可能变得难以承受地长。此外,训练数据的总体大小可能变得太大,无法容纳在普通服务器的内存(RAM)中。
如果我们能估计特征的重要性,我们就会只保留最重要的特征。这将使我们能够节省时间,在内存中容纳更多示例,并提高模型质量。下面,我们考虑一些特征选择(feature selection)技术。
4.5.1 砍掉长尾
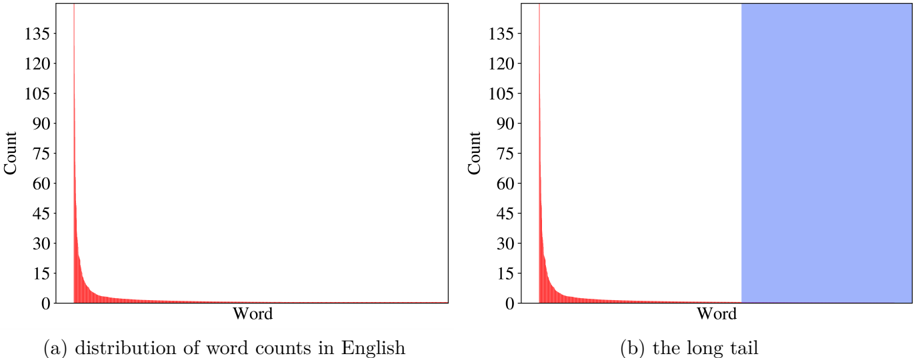
通常,如果一个特征只对少数示例包含信息(例如非零值),这样的特征可以从特征向量中移除。在词袋中,你可以构建一个词元计数分布的图,然后砍掉所谓的长尾(long tail),如图 15 所示。
分布的长尾是这样的部分:与计数最高的一小组元素相比,它包含的元素计数明显更低。这一小组称为分布的头部(head),它们的聚合计数至少占所有计数的一半。
定义长尾阈值的决定有些主观。你可以将它设置为问题的一个超参数,并通过实验发现最优值。另一方面,可以通过查看计数分布来做出决定,如图 15a 所示。如你所见,我在尾部元素的分布变得视觉上平坦的点上砍掉了长尾(图 15b)。
是否砍掉长尾,以及在哪里砍,是有争议的。在许多类别的分类问题中,某些类别之间的差异可能非常细微。即使是很少非零的特征也可能变得重要。然而,移除长尾特征通常会导致更快的学习和更好的模型。
图 15:英文文本集合中单词计数的分布(a)和长尾(b,蓝色区域)。最高计数对应「the」(计数 615);最低计数对应「zambia」(计数 1)。
4.5.2 Boruta
砍掉长尾并不是选择重要特征和移除次要特征的唯一方法。Kaggle 竞赛中使用的一种流行工具是 Boruta。Boruta 迭代地训练随机森林(random forest)模型并运行统计检验,以将特征识别为重要和不重要。该工具既有 R 包的形式,也有 Python 模块的形式。
Boruta 作为随机森林学习算法的包装器(wrapper)工作,因此得名 Boruta——斯拉夫神话中的森林之灵。为了理解 Boruta 算法,让我们先回顾随机森林学习算法是如何工作的。
随机森林基于装袋(bagging)的思想。它对训练集进行多次随机抽样,然后在每个样本上训练一个不同的统计模型。然后通过取所有模型的多数投票(用于分类)或平均值(用于回归)来做预测。随机森林与普通装袋算法的唯一实质区别是,前者训练的统计模型是决策树(decision tree)。在决策树的每个分裂处,都会考虑所有特征的一个随机子集。
随机森林的一个有用特性是它内置了估计每个特征重要性的能力。下面,我将解释这种估计在分类情况下是如何工作的。
该算法分两个阶段工作。首先,它对原始训练集中的所有训练示例进行分类。随机森林模型中的每棵决策树只对未用于构建该树的示例进行分类投票。在一棵树被测试后,记录该树的正确预测数。
在第二阶段,某个特征的值在示例之间被随机置换(permute),然后重复测试。再次为每棵树记录正确预测数。单个树的特征重要性计算为原始设置与置换设置之间正确分类数之差除以示例数。为了获得特征重要性分数,将各棵树的特征重要性度量取平均。虽然不是严格必须的,但使用 z 分数(z-score)而不是原始重要性分数更方便。
为了获得特征的 z 分数,我们首先找到各棵树单个特征分数的平均值和标准差。特征的 z 分数通过从分数中减去平均值,再除以标准差得到。
你可以就此打住,用每个特征的 z 分数作为保留它的标准(越高越好)。然而,在实践中,仅靠重要性分数往往不能反映特征与目标之间的有意义相关性。因此,我们需要一种不同的工具来区分真正重要的特征和不重要的特征,正如你可能猜到的,Boruta 提供了这种工具。
Boruta 的基本思想很简单:我们首先通过为每个原始特征添加一个随机化副本(randomized copy)来扩展特征列表,然后基于这个扩展数据集构建一个分类器。为了评估原始特征的重要性,我们将其与所有随机化特征进行比较。只有重要性高于随机化特征且统计显著的特征才被认为是真正重要的。
下面,我按照其作者描述的方式概述 Boruta 算法的主要步骤6,并做了适应性的调整以保证一致性和清晰度:
Boruta 算法
- 构建扩展的训练特征向量,其中每个原始特征都被复制。在训练示例之间随机置换复制特征的值,以消除复制变量与目标之间的任何相关性。
- 进行若干次随机森林学习运行。在每次运行之前,通过应用与上一步相同的随机特征值置换过程,对复制特征进行随机化。
- 对于每次运行,计算所有原始特征和复制特征的重要性(z 分数)。
- 如果某个特征的重要性高于所有复制特征中的最大重要性,则该特征在单次运行中被认为是重要的。
- 对所有原始特征执行统计检验。
- 零假设(null hypothesis)是特征的重要性等于复制特征的最大重要性(MIRA)。
- 统计检验是双侧相等性检验——当特征的重要性显著高于或显著低于 MIRA 时,该假设都可能被拒绝。
- 对每个原始特征,我们计数并记录命中次数(hit)。
- 特征命中次数是重要性高于 MIRA 的运行次数。
- 对于 R 次运行,期望命中数为 \(E(R) = 0.5R\),标准差为 \(S = \sqrt{0.25R}\)(二项分布,p = q = 0.5)。
- 当命中次数显著高于期望命中数时,原始特征被认为是重要的(接受);当命中次数显著低于期望时,被认为不重要(拒绝)。(对于任何运行次数和期望的置信水平,都可以计算接受和拒绝特征的界限。)
- 从特征向量(原始和复制的)中移除被认为不重要的特征。
- 对预定义的迭代次数执行相同的过程,或者直到所有特征都被拒绝或被确认为重要,以先到者为准。
Boruta 在许多 Kaggle 竞赛中表现良好;因此,你可以认为它是一种普遍适用的特征选择工具。不过,在将 Boruta 用于生产之前,有一点值得注意:Boruta 是一种启发式方法。它的性能没有理论保证。如果你想确保 Boruta 不会造成伤害,可以多次运行它,并确保特征选择是稳定的(即在多次应用于你的数据时结果一致)。如果特征选择不稳定,请确保随机森林中的树数量足够多,以产生稳定的结果。
虽然 Boruta 是一种有效的特征选择方法,但它并不是从业者使用的唯一方法。你可以在本书配套 wiki 的本章扩展版本中找到其他几种方法的描述。
4.5.3 L1 正则化
正则化(regularization)是改善模型泛化能力的一系列技术的总称。泛化(generalization)反过来是模型对未见示例正确预测标签的能力。
虽然正则化不能让你识别重要特征,但一些正则化技术,如 L1,允许机器学习算法学会忽略某些特征。
根据你训练的模型类型,L1 可能以不同的方式应用,但主要原则保持不变:L1 惩罚过于复杂的模型。
在实践中,L1 正则化会产生稀疏模型(sparse model),即大多数参数为零的模型。因此,L1 通过决定哪些特征对预测是必要的、哪些不是,隐式地执行特征选择。我们将在下一章更详细地讨论正则化。
4.5.4 特定任务的特征选择
特征选择也可以是特定于任务的。例如,我们可以从表示自然语言文本的词袋向量中移除一些特征,方法是排除对应于停用词(stop word)的维度。停用词是对于我们试图解决的问题来说过于通用或常见的词。停用词的常见例子是冠词、介词和代词。大多数语言的停用词词典都可以在线获得。
为了进一步降低从文本数据中获得的特征向量维度,有时将不常见的单词(例如,在语料库中计数低于三的单词)替换为相同的合成词元,例如 RARE_WORD,是一种实用的做法。
4.6 合成特征
最流行的 Python 机器学习包 scikit-learn 中实现的学习算法只适用于数值特征。但将数值特征转换为类别特征仍然可能有用。
4.6.1 特征离散化
将实值数值特征离散化(discretize)的原因可能很多。例如,某些特征选择技术只适用于类别特征。当训练数据集相对较小时,成功的离散化会为学习算法添加有用的信息。大量研究表明,离散化可以提高预测精度。如果模型的预测基于离散的值组(如年龄组或工资范围),人类也更容易解释。
分箱(binning),也称为分桶(bucketing),是一种流行的技术,通过将特定范围内的数值替换为恒定的类别值,将数值特征转换为类别特征。
分箱有三种典型方法:
- 均匀分箱(uniform binning),
- 基于 k-means 的分箱,以及
- 基于分位数(quantile)的分箱。
图 16:三种分箱方法:均匀、基于 k-means 和基于分位数。
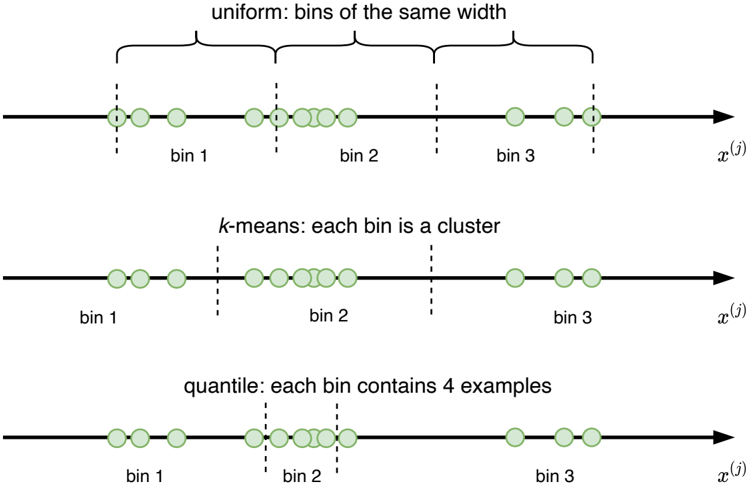
在所有三种情况下,你都应该决定要多少个箱。考虑图 16 中的插图。这里,我们有一个数值特征 j 和该特征的 12 个值,对应数据集中 12 个示例各一个值。假设我们决定要三个箱。在均匀分箱中,一个特征的所有箱具有相同的宽度,如图 16 顶部所示。
在基于 k-means 的分箱中,每个箱中的值属于最近的一维 k-means 簇,如图 16 中间所示。
在基于分位数的分箱中,所有箱具有相同数量的示例,如图 16 底部所示。
在均匀分箱中,一旦模型部署到生产环境,如果输入特征向量中特征的值低于或高于任何箱的范围,则分配最近的箱,即最左边或最右边的箱。
记住,大多数现代机器学习算法实现需要数值特征。必须使用独热编码等技术将箱转换回数值。
用户
图 17:用于流失分析的关系数据。
| 用户 ID | 性别 | 年龄 | … | 订阅日期 |
|---|---|---|---|---|
| 1 | M | 18 | … | 2016-01-12 |
| 2 | F | 25 | … | 2017-08-23 |
| 3 | F | 28 | … | 2019-12-19 |
| 4 | M | 19 | … | 2019-12-18 |
| 5 | F | 21 | … | 2016-11-30 |
| 订单 | ||||
|---|---|---|---|---|
| 订单 ID | 用户 ID | 金额 | … | 订单日期 |
| ——— | ——— | —— | —– | ———- |
| 1 | 2 | 23 | … | 2017-09-13 |
| 2 | 4 | 18 | … | 2018-11-23 |
| 3 | 2 | 7.5 | … | 2019-12-19 |
| 4 | 2 | 8.3 | … | 2016-11-30 |
| 通话 | ||||
|---|---|---|---|---|
| 通话 ID | 用户 ID | 通话时长 | … | 通话日期 |
| ——— | ——— | ———– | —– | ———- |
| 1 | 4 | 55 | … | 2016-01-12 |
| 2 | 2 | 235 | … | 2016-01-13 |
| 3 | 3 | 476 | … | 2016-12-17 |
| 4 | 4 | 334 | … | 2019-12-19 |
| 5 | 4 | 14 | … | 2016-11-30 |
用户特征
图 18:基于样本均值和标准差的合成特征。
| 用户 ID | 性别 | 年龄 | 平均订单金额 | 订单金额标准差 | 平均通话时长 | 通话时长标准差 |
|---|---|---|---|---|---|---|
| 2 | F | 25 | 12.9 | 7.1 | 235 | 0 |
| 4 | M | 19 | 18 | 0 | 134.3 | 142.7 |
4.6.2 从关系数据合成特征
数据分析师经常处理关系数据库(relational database)中的数据。例如,移动电话运营商想知道客户是否会很快放弃订阅。这个问题称为流失分析(churn analysis)。我们必须将每个客户表示为一个特征向量。
假设用户数据包含在三个关系表中:用户(User)、订单(Order)和通话(Call),如图 17 所示。
用户表已经包含两个潜在有用的特征:性别和年龄。我们还可以使用订单表和通话表中的数据创建合成特征。如你所见,用户 2 在订单表中有三行,而用户 4 在订单表中有一行,但在通话表中有三行。为了创建一个表示一个用户的特征,我们必须将这几条记录缩减为一个值。典型的方法是从多行数据计算各种统计量,并将每个统计量的值用作特征。最常用的统计量是样本均值和标准差。(标准差(standard deviation)是样本方差(sample variance)的平方根。)
举一个具体的例子,我为用户 2 和 4 计算了四个特征的值。你可以在图 18 中找到它们。
有时,关系数据库可以有更深的结构。例如,一个用户可以有订单,而每个订单可以有订购的商品。在这种情况下,我们可以计算统计量的统计量。例如,一个特征可以通过首先计算每个订单中商品价格的标准差,然后对特定用户取这些标准差的平均值来创建。你可以以任意方式组合统计量:均值的均值、均值的标准差、标准差的标准差,等等。同样的原则适用于表结构深于两层的数据库。
一旦你基于所有可能的统计量组合生成了特征,就可以使用特征选择方法之一选择最有用的特征。
如果你想提高特征向量的预测能力,或者当你的训练集相当小时,你可以合成有助于预测的附加特征。合成附加特征有两种典型方式:从数据中合成,或从其他特征中合成。
4.6.3 从数据合成特征
一种常用于合成一个或多个附加特征的技术是聚类(clustering)。让我们使用 k-means 聚类。为 k 选择一个值。如果你的最终目标是构建分类模型,为 k 赋值的一种常见方式是使用类别数 C。在回归中,使用你的直觉或应用任何能够确定数据中正确簇数的技术,如预测强度(prediction strength)或肘部法则(elbow method)。将 k-means 聚类应用于训练数据中的特征向量。然后向特征向量添加 k 个附加特征。附加特征 \(D + j\),其中 \(j = 1, \ldots, k\),将是二值的,如果相应的特征向量属于簇 j,则等于 1。
你可以通过应用不同的聚类算法,或从随机选择的起点多次重新启动 k-means 来合成更多特征。
4.6.4 从其他特征合成特征
神经网络以其以不寻常的方式组合简单特征来学习复杂特征的能力而闻名。它们通过让简单特征的值经过几层嵌套的非线性变换来组合它们。如果你有充足的数据,你可以训练一个深度多层感知机(multilayer perceptron)模型,它将学会聪明地组合它接收的基本单一特征。
如果你没有无限多的训练示例(在实践中经常如此),非常深的神经网络就失去了吸引力。7 在较小到中等规模的数据集(训练示例数在一千到十万之间)的情况下,你可能更愿意使用浅层学习算法,并通过提供更丰富的特征集来「帮助」你的学习算法学习。
在实践中,从现有特征获得新特征的最常见方式是对一个或一对现有特征应用简单的变换。适用于示例 i 中数值特征 j 的三种典型简单变换是:1)特征的离散化,2)特征平方,3)使用某种度量(如欧氏距离(Euclidean distance)或余弦相似度(cosine similarity))找到示例 i 的 k 近邻,并计算特征 j 的样本均值和标准差。
适用于一对数值特征的变换是简单的算术运算符:+、-、× 和 ÷(这种技术也称为特征交叉(feature-crossing))。例如,你可以通过以如下方式组合特征 2 和 6 的值,获得示例 i 中新特征 q(q > D)的值:\(x_i^{(q)} \overset{\text{def}}{=} x_i^{(2)} \div x_i^{(6)}\)。我任意选择了特征 2 和 6 以及变换 ÷。如果原始特征数 D 不是太大,你可以生成所有可能的变换(考虑所有特征对和所有算术运算符)。然后,使用特征选择方法之一,选择那些能提高模型质量的变换。
4.7 从数据中学习特征
有时,有用的特征可以从数据中学习。当我们能够获得大量相关的标记或未标记数据(如文本语料库或来自网络的图像集合)时,从数据中学习特征尤其有效。
4.7.1 词嵌入
在第 3 章中,我们使用词嵌入(word embedding)进行数据增强。词嵌入是表示单词的特征向量。相似的单词具有相似的特征向量,其中相似性由某种度量给出,如余弦相似度。词嵌入是从大型文本文档语料库中学习得到的。一个具有单个隐藏层(称为嵌入层(embedding layer))的浅层神经网络被训练来根据周围的单词预测一个单词,或根据中间的单词预测周围的单词。一旦神经网络训练完成,嵌入层的参数就被用作词嵌入。有许多算法可以从数据中学习词嵌入。应用最广泛的算法是 word2vec,它由 Google 发明,代码开源。许多语言的预训练 word2vec 嵌入都可以下载。
一旦你有了某种语言的词嵌入集合,你就可以用它们来表示用该语言书写的句子或文档中的单个单词,而不是使用独热编码。
让我们看看词嵌入是如何通过 word2vec 算法的一个版本——跳元(skip-gram)——来训练的。在词嵌入学习中,我们的目标是构建一个模型,用它可以把单词的独热编码转换为词嵌入。假设我们的字典包含 10,000 个单词。每个单词的独热向量是一个 10,000 维的向量,除一个维度包含 1 外,其余全为零。不同的单词在不同维度上有 1。
考虑一个句子:「I am attentively reading the book on machine learning engineering.」现在取同一个句子,但删掉一个单词,比如「book」。我们的句子变成:「I am attentively reading the · on machine learning engineering.」现在只保留 · 之前的三个单词和之后的三个单词:「attentively reading the · on machine learning.」看看这个围绕 · 的六词窗口,如果我让你猜 · 代表什么,你可能会说:「book」「article」或「paper」。这就是上下文单词如何让你预测它们包围的单词。这也是机器如何学会单词「book」「paper」和「article」具有相似含义的方式。它们在多个文本中共享相似的上下文。
事实证明,反过来也成立:一个单词可以预测它周围的上下文。「attentively reading the · on machine learning」这一片段称为跳元,窗口大小为 6(3 + 3)。通过使用网络上可用的文档,我们可以轻松创建数亿个跳元。
让我们用以下方式表示一个跳元:\([x_{-3}, x_{-2}, x_{-1}, x, x_{+1}, x_{+2}, x_{+3}]\)。在我们的句子中,\(x_{-3}\) 是「attentively」的独热向量,\(x_{-2}\) 对应「reading」,x 是被跳过的单词(·),\(x_{+1}\) 是「on」,依此类推。
窗口大小为 4 的跳元如下所示:\([x_{-2}, x_{-1}, x, x_{+1}, x_{+2}]\)。它也可以示意性地描绘,如图 19 所示。它是一个全连接网络(fully-connected network),就像多层感知机一样。输入单词在跳元中表示为 ·。神经网络必须学会在给定输入中心词的情况下预测跳元的上下文单词。
输出层中使用的激活函数是 softmax。代价函数是负对数似然(negative log-likelihood)。单词的嵌入由嵌入层的参数给出,当独热编码的单词作为模型输入时,这些参数被应用。
使用 word2vec 训练的词嵌入的一个问题是,词嵌入集合是固定的,你不能将模型用于词表外(out-of-vocabulary)的单词,即那些不在用于训练词嵌入的语料库中的单词。还有其他神经网络架构允许获得任何单词的嵌入,包括词表外的单词。实践中常用的一种这样的架构是 fastText。它由 Facebook 发明,代码开源。
word2vec 和 fastText 之间的关键区别在于,word2vec 将语料库中的每个单词视为一个单一实体,并为每个单词学习一个向量。相反,fastText 将每个单词视为组成该单词的字符 n-gram 嵌入向量的平均值。例如,单词「mouse」的嵌入是 n-gram「<mo」「mou」「<mou」「mous」「<mous」「mouse」「<mouse」「mouse>」「ous」「ouse」「ouse>」「use」「use>」「se>」的嵌入向量的平均值(假设最小和最大 n-gram 的大小分别为 3 和 6)。
词嵌入是一种有效的表示自然语言文本的方式,可用于循环神经网络(recurrent neural network,RNN)和卷积神经网络(CNN)等适用于序列处理的神经网络架构。然而,如果你想使用词嵌入来表示可变长度的文本给浅层学习算法(这些算法要求输入特征向量具有固定维度),你将不得不对词向量应用某种聚合操作,如加权和或平均值。将文本文档表示为其组成单词的平均值,在实践中并不是很有用。
4.7.2 文档嵌入
获得句子或整个文档嵌入的一种流行方式是使用 doc2vec 神经网络架构,它也由 Google 发明且开源。doc2vec 的架构与 word2vec 非常相似。唯一的主要区别是现在有两个嵌入向量:一个用于文档 ID,一个用于单词。对于输入单词的周围单词的预测,首先对两个嵌入向量(文档嵌入向量和词嵌入向量)取平均,然后从该平均值预测周围的单词。要对两个向量取平均,它们必须具有相同的维度。有趣的是,这使得不仅可以比较文档向量(通过计算余弦相似度),还可以比较文档和词向量。以这种方式训练的词向量与使用 word2vec 训练的非常相似。
图 19:窗口大小为 4、嵌入层为 300 个单元的跳元模型。
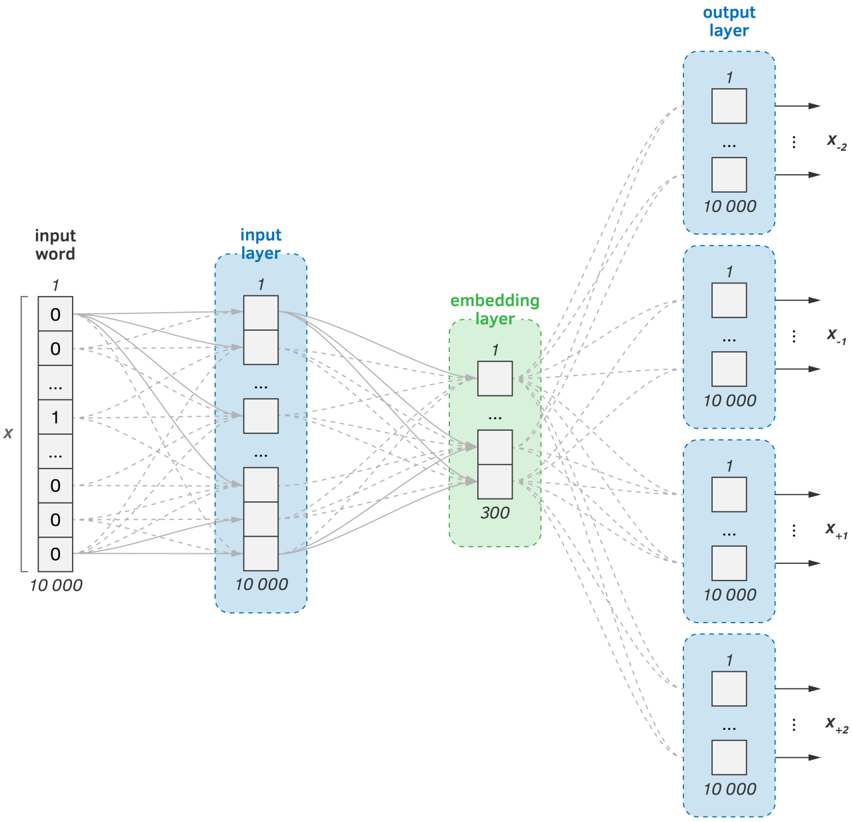
要为不属于用于训练文档嵌入的语料库的新文档获得嵌入,首先将该新文档添加到语料库中。它会获得一个新的文档 ID。然后对现有模型进行额外几个轮次(epoch)的训练,除对应新文档 ID 的新参数外,所有已训练参数都被冻结。输入文档 ID 以独热编码形式提供。
4.7.3 任意对象的嵌入
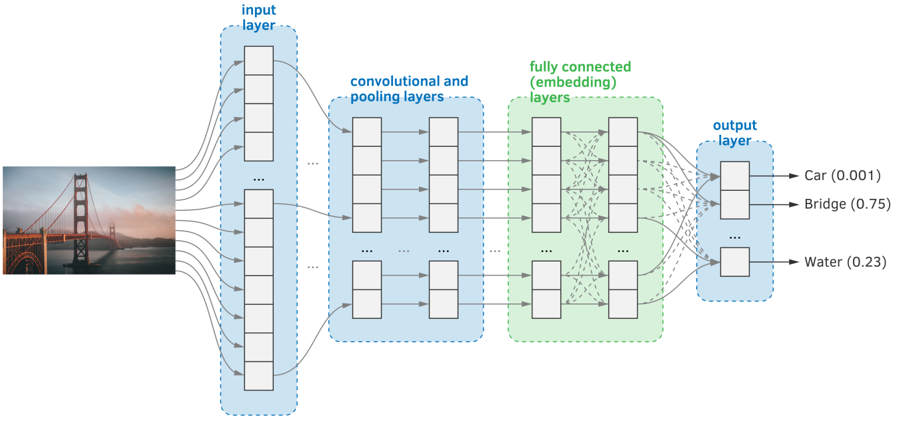
以下技术通常用于为任何对象(而不仅仅是单词或文档)获得嵌入向量。首先,我们制定一个有监督学习问题,以我们的对象为输入并输出一个预测。然后我们构建一个带标签的数据集,并训练一个解决我们的有监督学习问题的神经网络模型。然后我们使用神经网络模型中靠近输出层的一个全连接层的输出(在非线性之前)作为输入对象的嵌入。
例如,ImageNet 带标签的图像数据集和类似于 AlexNet 的深度卷积神经网络(CNN)架构经常被用来训练图像的嵌入。图像嵌入层的插图如图 20 所示。在这个插图中,我们有一个深度 CNN,在靠近输出处有两个全连接层。神经网络被训练来预测图像中描绘的对象。为了获得未用于训练模型的图像的嵌入,我们将该图像(通常表示为三个像素矩阵,每个通道 R、G 和 B 一个)发送到神经网络的输入,然后使用非线性之前的一个全连接层的输出。哪个全连接层更好取决于你想解决的任务,必须通过实验决定。
通过遵循上述方法,我们可以训练任何类型的嵌入。数据分析师只需要弄清楚三件事:
- 要解决什么有监督学习问题(对于图像,通常是对象分类),
- 全连接层之前的神经网络架构是什么(对于图像,通常是深度 CNN),
- 如何表示神经网络的输入(对于图像,像素矩阵,每个通道一个)。
4.7.4 选择嵌入维度
嵌入维度通常通过实验或经验确定。例如,Google 在其 TensorFlow 文档中推荐以下经验法则:
图 20:用于训练图像嵌入的神经网络架构。嵌入层以绿色显示。
其中 d 是嵌入维度,D 是「类别数」。词嵌入的类别数是语料库中唯一单词的数量。对于任意嵌入,它是原始输入的维度。例如,如果语料库中唯一单词的数量 D = 5,000,000,那么嵌入维度 \(d = \sqrt[4]{5{,}000{,}000} = 47\)。在实践中,经常使用 50 到 600 之间的值。
选择嵌入维度的一个更规范的方法是将它视为在下游任务上调优的超参数。例如,如果你有一个带标签的文档语料库,那么你可以通过最小化在该带标签数据上训练的分类器所做的预测错误数来优化嵌入维度,其中文档中的单词由嵌入表示。
4.8 降维
有时,可能需要降低示例的维度。这不同于特征选择问题。在后一种情况下,我们分析所有现有特征的属性,并移除那些我们认为对模型质量贡献不大的特征。当我们对数据集应用降维(dimensionality reduction)技术时,我们将原始特征向量中的所有特征替换为一个新的、维度更低且由合成特征组成的向量。
降维通常会导致学习速度提高和泛化能力更好。此外,它改善了数据集的可视化:人类只能看到三个维度。
有几种降低维度的方法。根据我们想要这样做的原因,有些方法比其他方法更流行。降维技术在机器学习理论书籍中有很好的描述,因此我将只讨论数据分析师何时应该优先选择一种技术而不是其他技术。
4.8.1 用 PCA 快速降维
主成分分析(Principal Component Analysis,PCA)是最古老的技术。它也远远是最快的选择。性能比较测试表明,PCA 算法的速度对数据集大小的依赖性非常弱。因此,你可以有效地将 PCA 用作模型训练之前的一个步骤,并在超参数调优过程中通过实验找到降维后的最优维度值。
PCA 最显著的缺点是,算法要工作,数据必须完全放入内存。有一个 PCA 的核外(out-of-core)版本,称为增量 PCA(Incremental PCA),它允许在数据集批次上运行算法,一次将一个批次加载到内存中。尽管如此,增量 PCA 比 PCA 慢一个数量级。与下面考虑的另外两种技术相比,PCA 在可视化方面也不太实用。
4.8.2 用于可视化的降维
如果可视化是你的目标,那么你会更喜欢统一流形逼近与投影(Uniform Manifold Approximation and Projection,UMAP)算法或自编码器(autoencoder)。两者都可以专门编程来产生 2D 或 3D 特征向量,而在 PCA 中,算法产生 D 个所谓的主成分(principal component)(其中 D 是你的数据的维度),分析师必须选择前两个或三个主成分作为可视化特征。UMAP 通常比自编码器快得多,但这两种技术产生的可视化效果看起来非常不同,因此你会根据特定数据集的属性优先选择一种。此外,与 PCA 一样,UMAP 要求所有数据都在内存中,而自编码器可以分批训练。
降维也可以是特定于任务的。例如,我们可以使用图像编辑器来降低图片的维度。同样,我们可以降低声音序列的比特率和通道数。
4.9 特征缩放
一旦你的所有特征都是数值型的,你几乎就可以开始研究你的模型了。唯一可能有所帮助的剩余步骤是缩放你的特征。
特征缩放(feature scaling)是将所有特征带到相同或非常相似的值范围或分布。多项实验表明,应用于缩放特征的学习算法可能会产生更好的模型。虽然不能保证缩放会对模型质量产生积极影响,但它被认为是一种最佳实践。缩放还可以提高深度神经网络的训练速度。它还确保没有单个特征占主导地位,尤其是在梯度下降(gradient descent)或其他迭代优化算法的初始迭代中。最后,缩放降低了数值溢出(numerical overflow)的风险,这是计算机在处理非常小或非常大的数字时遇到的问题。
4.9.1 归一化
归一化(normalization)是将数值特征可以取的实际值范围转换为预定义的人工值范围的过程,通常是在 [-1, 1] 或 [0, 1] 区间内。
例如,让一个特征的自然范围是 350 到 1450。从特征的每个值中减去 350,并将结果除以 1100,我们就将这些值归一化到 [0, 1] 范围。更一般地,归一化公式如下:
\[ x' = \frac{x - \min^{(j)}}{\max^{(j)} - \min^{(j)}} \]其中 \(x^{(j)}\) 是某个示例中特征 j 的原始值;\(\min^{(j)}\) 和 \(\max^{(j)}\) 分别是特征 j 在训练数据中的最小值和最大值。
如果你更喜欢 [-1, 1] 的范围,那么归一化公式如下:
\[ x' = 2 \cdot \frac{x - \min^{(j)}}{\max^{(j)} - \min^{(j)}} - 1 \]归一化的一个缺点是值 \(\max^{(j)}\) 和 \(\min^{(j)}\) 通常是离群值(outlier),因此归一化会将正常特征值「挤压」到一个非常小的范围内。这个问题的一个解决方案是应用截断(clipping),即为 \(\max^{(j)}\) 和 \(\min^{(j)}\) 选择「合理」的值,而不是使用训练数据中的极端值。让一个特征的一个合理范围被估计为 [a, b]。在使用上述两个公式之一计算缩放值之前,特征的值 \(x^{(j)}\) 被设置(「截断」)为:如果 \(x^{(j)}\) 低于 a 则为 a,如果高于 b 则为 b。估计 a 和 b 的值的一种常见方式是温莎化(winsorization)。该技术以工程师和生物统计学家查尔斯·温莎(Charles Winsor,1895-1951)的名字命名。温莎化包括将所有离群值设置为数据的指定百分位数;例如,90% 的温莎化会看到低于第 5 百分位的所有数据被设置为第 5 百分位,高于第 95 百分位的数据被设置为第 95 百分位。在 Python 中,温莎化可以按如下方式应用于数字列表:
from scipy.stats.mstats import winsorize
winsorize(list_of_numbers, limits=[0.05, 0.05])
winsorize 函数的输出将是一个与输入长度相同的数字列表,其中离群值的值被「截断」。对应的 R 代码如下所示:
library(DescTools)
DescTools::Winsorize(vector_of_numbers, probs = c(0.05, 0.95))
有时使用均值归一化(mean normalization):
\[ x' = \frac{x - \mu^{(j)}}{\max^{(j)} - \min^{(j)}} \]其中 \(\mu^{(j)}\) 是特征 j 值的样本均值。
4.9.2 标准化
标准化(standardization),或称 z 分数归一化(z-score normalization),是特征值被重新缩放的过程,使它们具有标准正态分布(standard normal distribution)的属性,其中 \(\mu = 0\) 和 \(\sigma = 1\),\(\mu\) 是样本均值(特征的平均值,对训练数据中的所有示例取平均),\(\sigma\) 是与样本均值的标准差。
特征的标准分数(standard score)或 z 分数计算如下:
\[ z = \frac{x - \mu^{(j)}}{\sigma^{(j)}} \]其中 \(\mu^{(j)}\) 是特征 j 值的样本均值,\(\sigma^{(j)}\) 是特征 j 值与样本均值的标准差。
此外,有时在应用上述缩放技术之前,对特征值应用简单的数学变换是有帮助的。这样的变换包括取特征的对数、平方或开平方根。其想法是获得尽可能接近正态分布的分布。
你可能想知道什么时候应该使用归一化,什么时候使用标准化。这个问题没有确定的答案。理论上,归一化对均匀分布的数据效果更好,而标准化往往对正态分布的数据效果最好。然而,在实践中,数据很少遵循完美的曲线分布。通常,如果你的数据集不是太大并且你有时间,你可以两者都尝试,看看哪一个对你的任务表现更好。特征缩放通常对大多数学习算法有益。
4.10 特征工程中的数据泄露
特征工程期间的数据泄露(data leakage)可能发生在几种情况下,包括特征离散化和缩放。
4.10.1 可能的问题
想象你使用整个数据集来计算每个箱的范围或特征缩放因子。然后你将数据集拆分为训练集、验证集和测试集。如果你这样做,训练数据中特征的值将部分地通过使用属于保留集(holdout set)的示例获得。当你的数据集足够小时,这可能导致模型在保留数据上的性能过于乐观。
现在想象你在处理文本,并使用词袋与整个数据集创建特征。构建词表后,你将数据拆分为三个集合。在这种情况下,学习算法将接触到基于仅存在于保留集中的词元的特征。同样,与在特征工程之前划分数据相比,模型将表现出人为的更好性能。
4.10.2 解决方案
解决方案,正如你可能已经猜到的,是首先将整个数据集拆分为训练集和保留集,并且只对训练数据进行特征工程。这也适用于使用均值编码将类别特征转换为数字时:先拆分数据,然后仅基于训练数据计算标签的样本均值。
4.11 特征的存储与文档化
即使你计划在完成特征工程后立即训练模型,也建议设计一个描述特征预期属性的模式文件(schema file)。
4.11.1 模式文件
模式文件是描述特征的一种文档。该文件是机器可读的、有版本的,并且每次有人对特征进行重大更新时都会更新。以下是可以在模式中编码的属性的几个示例:
- 特征的名称;
- 对于每个特征:
- 它的类型(类别型、数值型),
- 最小值和最大值,
- 预期具有该特征的示例占比,
- 样本均值和方差,
- 是否允许未定义的值,
- 是否允许零值。
一个四维数据集的模式文件示例如下所示:
feature {
  name: "height"
  type: float
  min: 50.0
  max: 300.0
  mean: 160.0
  variance: 17.0
  zeroes: false
  undefined: false
  popularity: 1.0
}

feature {
  name: "color_red"
  type: binary
  zeroes: true
  undefined: false
  popularity: 0.76
}

feature {
  name: "color_green"
  type: binary
  zeroes: true
  undefined: false
  popularity: 0.65
}

feature {
  name: "color_blue"
  type: binary
  zeroes: true
  undefined: false
  popularity: 0.81
}
4.11.2 特征存储
大型分布式组织可能会使用特征存储(feature store),它允许在多个数据科学团队和项目之间保存、文档化、复用和共享特征。特征在不同项目和团队之间的维护和服务方式可能差异很大。这带来了基础设施的复杂性,并常常导致重复工作。大型分布式组织面临其中一些挑战:
特征未被复用
表示同一实体同一属性的特征被不同的工程师和团队多次实现,而本可以复用其他团队的现有工作和现有的机器学习流水线。
特征定义不一致
不同团队对特征的定义不同,而且并不总是能够访问特征的文档。
计算密集的特征
一些实时机器学习模型并不基于信息丰富但计算密集的特征。在一个快速的存储中拥有这些特征,将允许在实时中使用此类特征,而不仅仅是在批处理模式中。
训练与服务之间的不一致
模型通常使用历史数据训练,但在服务时,它接触到的是实时在线数据。某些特征的值可能取决于在服务时不可用的整个历史数据集。为了使模型正确工作,每个特征对于相同的输入数据实体,在离线(开发)和在线(生产)模式下都必须具有相同的值。
特征过期时间未知
当一个新的输入示例进入生产环境时,没有办法确切知道哪些特征需要重新计算;相反,需要运行整个流水线来计算预测所需的所有特征的值。
特征存储是组织内部保存已文档化、已整理且受访问控制特征的中心库。每个特征由四个要素描述:1)名称,2)描述,3)元数据,4)定义。
特征名称是唯一标识特征的字符串,例如:「average_session_length」或「document_length」。
特征描述是对它所表示的对象属性的自然语言文本描述,例如:「用户会话的平均长度。」或「文档中的单词数。」
除了模式文件中的那些属性外,特征元数据还可以提供:为什么将该特征添加到模型中、它对泛化有何贡献、组织内负责维护特征数据源的人员姓名8、输入类型(例如数值、字符串、图像)、输出类型(例如数值标量、类别、数值向量)、特征存储是否必须缓存特征的值,以及如果需要,缓存多长时间。特征也可以被标记为可在线和离线使用,或仅用于离线处理。可用于在线处理的特征必须以这样的方式实现:它们的值可以:1)从缓存或值存储中快速读取,或 2)实时计算。可以实时计算的特征包括,例如,对输入数字求平方、确定单词的形状,或在组织的内联网中进行搜索。
特征的 definition(定义)是有版本的代码,如 Python 或 Java。它将在运行时环境中执行并应用于输入以计算特征值。
特征存储允许数据工程师插入特征。反过来,数据分析师和机器学习工程师使用 API 获取他们认为相关的特征值。特征存储可以为单个在线输入提供特征。或者,在离线研究模型的分析师可能希望将训练数据转换为特征向量集合,并将一批输入发送到特征存储。
为了可复现性(reproducibility),特征存储中的特征值是有版本的。有了特征值版本控制,数据分析师能够用与训练先前模型版本时相同的特征值重建模型。在给定输入的特征值更新后,先前的值不会被擦除。相反,它会与指示该值生成时间的时间戳一起保存。此外,模型 m_B 使用的特征 j 本身可以是某个模型 m_A 的输出。一旦模型 m_A 改变,保留其旧版本就很重要:模型 m_B 可能仍然期望输入由 m_A 的旧版本生成的输出。
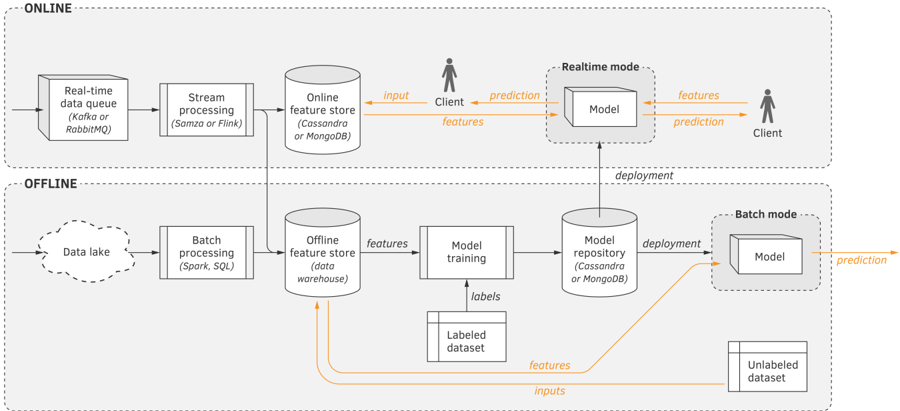
特征存储在整个机器学习流水线中的位置如图 21 所示。该架构的灵感来自 Uber 的 Michelangelo 机器学习平台。它包含两个特征存储:在线和离线,它们的数据是同步的。在 Uber,在线特征存储通过使用实时数据频繁更新,接近实时。相比之下,离线特征存储以批处理模式更新,使用在线计算的一些特征的值,以及来自日志和离线数据库的历史数据。在线计算的特征的一个例子是「餐厅过去一小时的平均餐食准备时间」。离线计算的特征的一个例子是「餐厅过去七天的平均餐食准备时间」。在 Uber,离线存储中的特征每天同步到在线存储一次或几次。
4.12 特征工程最佳实践
多年来,分析师和工程师发明、试验并验证了各种最佳实践。今天,几乎每个机器学习项目都推荐使用它们。使用这些最佳实践可能不会显著改善每个项目,但它们肯定不会造成伤害。本章已经考虑过的一个最佳实践是归一化或标准化特征。
图 21:特征存储在整个机器学习流水线中的位置。
4.12.1 生成大量简单特征
在建模过程开始时,尝试设计尽可能多的「简单」特征。当一个特征不需要大量编码时间时,它就是简单的。例如,文档分类中的词袋方法只需几行代码就能生成数千个特征。只要你的硬件有容量,就把任何可测量的东西用作特征。你无法提前知道某个量与其他量组合是否对预测有用。
4.12.2 复用遗留系统
当用统计模型替换旧的、非基于机器学习的算法时,将旧算法的输出用作新模型的特征。确保旧算法不再改变;否则,你的模型性能可能会随时间受到负面影响。如果旧算法作为特征来说太慢,请使用旧算法的输入作为新模型的特征。
只有当你控制外部系统的行为时,才将外部系统用作特征源。否则,外部系统有可能在你不知情的情况下随时间演变。此外,外部系统的所有者可能决定使用你的模型的输出作为他们模型的输入。这就创造了隐藏反馈回路(hidden feedback loop),一种你影响你从中学习的现象的情况。
4.12.3 必要时使用 ID 作为特征……
必要时使用 ID 作为特征。这看起来可能违反直觉,因为唯一 ID 对泛化没有贡献。然而,使用 ID 允许创建一个模型,它在一般情况下有一种行为,在其他情况下有不同的行为。
例如,你想对某个地点(城市或村庄)做出预测,并且你有一些地点的属性作为特征。通过使用地点 ID 作为特征,你可以为一个一般地点添加训练示例,并训练模型在其他特定地点有不同的行为。
然而,避免使用示例 ID 作为特征。
4.12.4 ……但在可能时降低基数
只有当你希望模型具有依赖于该类别特征的不同「模式」行为时,才使用具有许多值(超过十几个)的类别特征。典型的例子是邮政编码(postal code)或国家。如果你希望模型对俄罗斯与美国,在输入相似的情况下表现出不同的行为,你可能会考虑使用「国家」类别特征。9
如果你有一个具有许多值的类别特征,但不需要一个依赖于该特征的多种模式的模型,请尝试降低该特征的基数(cardinality,即不同值的数量)。有几种方法可以做到这一点。我们已经在 4.2.4 节中考虑了其中之一:特征哈希。其他技术简要讨论如下:
对相似的值分组
尝试将一些值分组到同一类别中。例如,如果你认为在一个区域内,不同地点不太可能需要不同的预测,那么将同一州的所有邮政编码分组为一个州代码。将州分组为地区。
对长尾分组
同样,尝试将不频繁值的长尾分组到「其他」(Other)名称下,或将它们与相似的频繁值合并。
删除该特征
如果一个类别特征的所有或几乎所有值都是唯一的,或者一个值支配所有其他值,请考虑完全删除该特征。
降低特征的粒度应该谨慎进行。类别特征通常与其他类别特征具有函数依赖关系,它们的预测能力通常来自它们的组合。以州和城市为例。如果我们决定对州特征中的一些值进行分组或删除,我们可能会无意中破坏允许模型区分一个「Springfield」与另一个「Springfield」的信息。
4.12.5 谨慎使用计数
谨慎使用基于计数的特征。有些计数随时间保持大致相同的范围。例如,在词袋中,如果你使用每个词元的计数而不是二值值,那么只要输入文档的长度不随时间增长或缩小,这就不是问题。但是,如果你有一个像「自订阅以来的通话次数」这样的特征,对于一家不断发展的移动电话提供商的客户来说,与较新的客户群相比,一些老客户可能有非常高的通话次数。另一方面,训练数据可能是在公司还很年轻、还没有老客户时构建的。
当你根据特征值在数据集中的常见程度将特征值分组到箱中时,也必须应用同样的谨慎。今天不常见的值可能会随着更多数据的添加而随着时间的推移变得更加常见。定期重新评估模型和特征被认为是一种最佳实践。
4.12.6 必要时进行特征选择
在必要时进行特征选择。原因可能是:
- 需要有一个可解释的模型(所以你保留最重要的预测因子),
- 可用于实验和/或在生产中重建模型的时间很短,
- 严格的硬件要求,如内存(RAM)、硬盘空间,或
- 你预计两次模型训练之间存在显著的分布偏移(distribution shift)。
如果你决定进行特征选择,请从 Boruta 开始。
4.12.7 仔细测试代码
特征工程代码必须仔细测试。单元测试应该覆盖每个特征提取器。检查每个特征是否使用尽可能多的输入正确生成。对于每个布尔特征,检查它在应该为真时为真,在应该为假时为假。检查数值特征的值范围是否合理。检查 NaN(非数值,Not-a-Number)、空值、零值和空值。一个特征的一个损坏的提取器可能导致模型性能任意差。如果模型行为异常,特征提取器是第一个需要查找问题的地方。
每个特征都必须测试速度、内存消耗以及与生产环境的兼容性。在你的本地环境中运行良好的东西,在部署到生产环境时可能表现不佳。
一旦模型部署到生产环境,并且每次加载模型时,都必须重新运行特征提取器测试。如果特征消耗了一些外部资源,如数据库或 API,这些资源在特定的生产运行时实例上可能不可用。如果在特征提取过程中任何资源不可用,特征提取器必须抛出异常并终止。避免静默失败,这可能在很长一段时间内不被注意到,而模型性能会下降或变得完全错误。
还建议定期在固定的测试数据上运行特征提取器,以确保特征值分布保持不变。
4.12.8 保持代码、模型和数据同步
特征提取代码的版本必须与模型的版本以及用于构建模型的数据同步。这三者必须同时部署或回滚。每次模型在生产中加载时,检查这三个要素是否同步(即它们的版本是否相同)是有用的。
4.12.9 隔离特征提取代码
特征提取代码必须独立于支持模型的其余代码。应该可以在不影响其他特征、数据处理流水线或模型调用方式的情况下更新负责每个特征的代码。唯一的例外是当许多特征是批量生成时,如独热编码和词袋。
4.12.10 将模型与特征提取器一起序列化
在可能的情况下,将构建模型时使用的模型和特征提取器对象一起序列化(Python 中的 pickle,R 中的 RDS)。在生产环境中,反序列化两者并使用它们。在可能的情况下,避免拥有多个版本的特征提取代码。
如果你的生产环境不允许你同时反序列化模型和特征提取代码,请在训练模型和服务模型时使用相同的特征提取代码。数据科学家用来训练模型的代码与 IT 团队可能为生产环境编写的优化代码之间即使是微小的差异,也可能导致显著的预测错误。
一旦生产特征提取代码准备就绪,就用它重新训练模型。在特征提取代码发生任何更改后,始终完全重新训练模型。
4.12.11 记录特征值日志
为在线示例的随机样本记录生产环境中提取的特征值。当你研究新版本的模型时,这些值将有助于控制训练数据的质量。它们将允许你比较并确保生产环境中记录的特征值与你在训练数据中观察到的相同。
4.13 小结
特征是模型设计用来处理的数据实体中提取的值。每个特征表示数据实体的一个特定属性。特征被组织在特征向量中,模型学会对这些特征向量执行数学运算以生成期望的输出。
对于文本,可以使用词袋等技术批量生成特征。词袋特征向量中的数字表示特定词表单词在文本文档中的存在或不存在。这些数字可以是二值的,也可以包含更多信息,例如每个单词在文档中的频率,或 TF-IDF 值。
大多数机器学习算法和库要求所有特征都是数值型的。为了将类别特征转换为数字,使用独热编码和均值编码等技术。如果类别特征的值是循环的,如一周中的几天或一天中的几小时,更好的替代方案是使用正弦-余弦变换将该循环特征转换为两个特征。
特征哈希是一种将文本数据或具有许多值的类别属性转换为任意维度特征向量的方法。当独热编码或词袋生成维度不切实际的特征向量时,这可能很有用。
主题建模是一族算法技术,如 LDA 和 LSA,它们允许我们学习一个模型,将任何文档转换为所需维度的话题向量。
时间序列是有序的观测序列。每个观测都带有与时间相关的属性,如时间戳、日期、年份等。在神经网络达到其现代学习能力之前,分析师使用浅层机器学习工具包处理时间序列数据。时间序列必须转换为「扁平」特征向量。如今,分析师使用适用于序列处理的神经网络架构,如 LSTM、CNN 和 Transformer。
好特征具有高预测能力,可以快速计算,可靠且不相关。
训练集中特征值的分布与生产模型将接收的值分布相似是很重要的。此外,好特征是单一的,易于理解和维护。单一性意味着特征表示一个易于理解和解释的量。
为了提高数据的预测能力,可以通过离散化现有的数值特征、对训练示例进行聚类,或对现有特征应用简单变换或组合成对特征来合成附加特征。
对于文本,可以从未标记数据中以词嵌入和文档嵌入的形式学习特征。更一般地,如果我们能够制定适当的预测问题并训练深度模型,就可以为任何类型的数据训练嵌入。然后从最右侧(即最接近输出)的若干全连接层提取嵌入向量。
明智地使用特征选择技术可以移除对模型质量没有贡献的特征。两种常见技术是砍掉长尾和 Boruta。L1 正则化也可以作为一种特征选择技术。
降维可以改善高维数据集的可视化。它还可以提高模型的预测质量。目前,PCA、UMAP 和自编码器等技术被用于降维。PCA 非常快,但 UMAP 和自编码器产生更好的可视化效果。
在训练模型之前缩放特征、在模式文件或特征存储中存储和文档化特征,以及保持代码、模型和训练数据同步,都被认为是最佳实践。
特征提取代码是机器学习系统最重要的部分之一。它必须被广泛而系统地测试。
《机器学习工程》(Machine Learning Engineering)
Andriy Burkov(安德烈·布尔科夫)
「理论上,理论与实践没有区别;但在实践中,有区别。」——本杰明·布鲁斯特(Benjamin Brewster)
「完美的项目计划是可能的,只要你先把所有未知项列成一份清单。」——比尔·兰利(Bill Langley)
「融资时它是 AI,招聘时它是 ML,实现时它是线性回归,调试时它是 printf()。」——巴伦·施瓦茨(Baron Schwartz)
本书按「先读后买」(read first, buy later)的原则发行。
要构建快速字符串匹配的索引,你可以使用 Aho-Corasick 算法。 ↩︎
我决定忽略大小写,但作为分析师,你可能会选择把「Love」和「love」这两个词元当作两个独立的词表实体。 ↩︎
LSA 和 LDA 的 R 代码由 Julian Amon 提供。 ↩︎
在实践中,对于某些示例,潜在电影标题左侧或右侧的上下文可能少于五个词,因为它要么是推文的开头,要么是推文的结尾。 ↩︎
日期信息通常与机器学习相关,仍然可以包含在训练数据中。例如,你可以考虑设计「一天中的小时」「一周中的星期几」「一年中的月份」等循环特征。对于时间季节性具有预测能力的预测问题,拥有这样的特征可能是有用的。 ↩︎
Miron B. Kursa, Aleksander Jankowski, Witold R. Rudnicki,《Boruta - A System for Feature Selection》,发表于 Fundamenta Informaticae 101,2010 年,第 271-285 页。 ↩︎
除非你在迁移学习(transfer learning)中使用深度预训练模型,我们将在下一章讨论。 ↩︎
如果负责该特征的人员离开公司,必须自动通知产品负责人。 ↩︎
通常,你希望你的模型做什么和数据要求什么是非常不同的两件事。即使你认为模型必须独立于国家做出类似的预测,实际上你可能会因为不同国家的训练数据中标签分布不同而获得较差的模型性能。 ↩︎