数据收集与准备
在任何机器学习(machine learning)活动开始之前,分析师必须收集并准备数据。分析师可获得的数据并不总是「正确」的,也不总是机器学习算法可以直接使用的形式。本章聚焦于机器学习项目生命周期的第二个阶段,如下图所示:
图 1:机器学习项目生命周期。
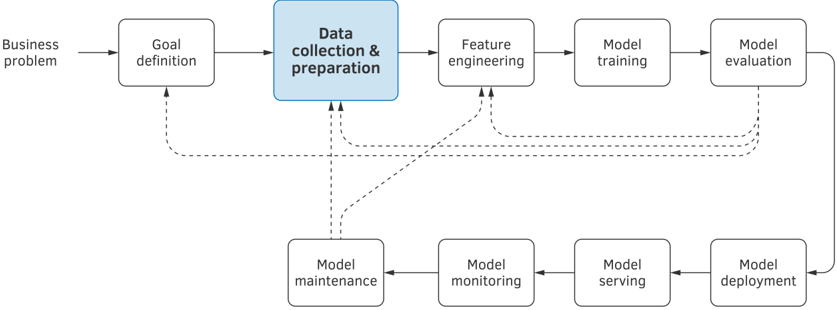
具体来说,我们将讨论优质数据的属性、数据集可能存在的典型问题,以及为机器学习准备和存储数据的方法。
3.1 关于数据的问题
既然你已经有了一个机器学习目标,并且明确定义了模型的输入、输出和成功标准,你就可以开始收集训练模型(model)所需的数据了。然而,在开始收集数据之前,有一些问题需要回答。
3.1.1 数据是否可获取?
你所需的数据是否已经存在?如果存在,它是否可获取(从物理、合同、伦理或成本角度)?如果你要购买或复用他人的数据源,你是否考虑过这些数据可能被如何使用或共享?你是否需要与原始供应商重新谈判许可协议?
如果数据可获取,它是否受版权或其他法律规范保护?如果是,你是否已确定你的数据版权归谁所有?是否存在共同版权?
数据是否敏感(例如,涉及你所在组织的项目、客户或合作伙伴,或者被政府列为机密)?是否存在潜在的隐私问题?如果是,你是否已与数据采集的受访者讨论过数据共享?你是否能长期保存个人信息,以便将来使用?
你是否需要将数据与模型一起共享?如果是,你是否需要获得数据所有者或受访者的书面同意?
你是否需要在分析过程中或为共享做准备时对数据进行匿名化处理1,例如去除个人身份信息(personally identifiable information,PII)?
即使从物理上获取所需数据是可能的,在上述所有问题解决之前,也不要使用这些数据。
3.1.2 数据是否足够大?
你希望得到明确答案的问题是:数据是否足够。然而,正如我们已经发现的,通常并不知道需要多少数据才能达成目标,尤其是当最低模型质量要求很严格时。
如果你对短期内是否有足够数据存疑,那么请弄清楚新数据的生成频率。对于某些项目,你可以先使用最初可用的数据开始,当你进行特征工程(feature engineering)、建模并解决其他相关技术问题的同时,新数据可能会逐渐到来。这些数据可以自然产生(作为某个可观测或可测量过程的结果),也可以由你的数据标注专家或第三方数据提供商逐步提供。
考虑完成项目所需的预计时间。在这段时间内能否收集到足够大的数据集2?请基于类似项目的经验或文献中报告的结果来回答这个问题。
判断你是否收集了足够数据的一个实用方法是绘制学习曲线(learning curves)。更具体地说,绘制你的学习算法在不同训练样本数量下的训练得分和验证得分,如图 2 所示。
通过观察学习曲线,你会发现当训练样本达到一定数量后,模型性能将趋于平稳。达到该训练样本数量后,继续增加样本带来的收益将开始递减。
图 2:朴素贝叶斯(Naïve Bayes)学习算法应用于 scikit-learn 标准「digits(手写数字)」数据集的学习曲线。
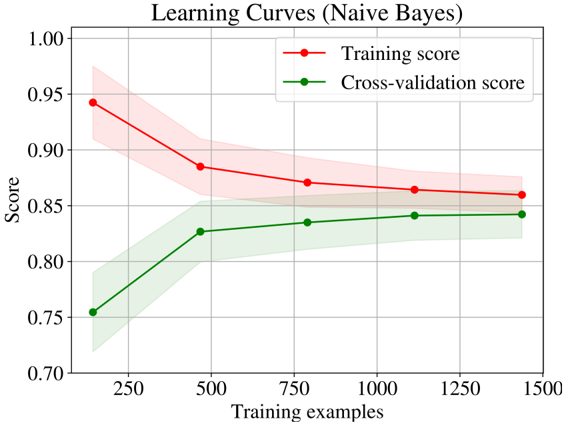
如果你观察到学习算法的性能趋于平稳,这可能表明收集更多数据对训练更好的模型没有帮助。我使用了「可能」这个表述,因为还有另外两种可能的解释:
- 你没有足够的信息性特征(informative features),供学习算法利用以构建性能更强的模型;或者
- 你使用的学习算法无法利用现有数据训练出足够复杂的模型。
在前一种情况下,你可以考虑通过以巧妙的方式组合现有特征,或利用间接数据源(如查找表(lookup tables)和地名录(gazetteers))的信息来工程化更多特征。我们将在第 4 章的 ?? 节讨论合成特征的技术。
在后一种情况下,一种可行的方法是使用集成学习(ensemble learning)方法或训练深度神经网络。然而,深度神经网络通常比浅层学习算法需要更多的训练数据。
一些从业者使用经验法则来估计一个问题所需的训练样本数。通常,他们会使用应用于以下对象的缩放因子:
- 特征数量,或
- 类别数量,或
- 模型中可训练参数的数量。
这类经验法则通常有效,但它们因问题领域而异。每位分析师都会根据自己的经验调整数字。虽然你需要通过经验来发现适合自己的那些「神奇」缩放因子,但各种网络来源中最常被引用的数字是:
- 特征数量的 10 倍(这往往会夸大训练集的大小,但作为上界效果很好),
- 类别数量的 100 或 1000 倍(这往往会低估大小),或
- 可训练参数数量的 10 倍(通常应用于神经网络)。
请记住,仅仅因为你有大数据,并不意味着你应该全部使用。大数据中较小的样本在实践中也能给出良好的结果,并加速寻找更好模型的过程。不过,重要的是要确保样本能代表整个大数据集。分层抽样(stratified sampling)和系统抽样(systematic sampling)等抽样策略可以带来更好的结果。我们将在 3.10 节讨论数据抽样策略。
3.1.3 数据是否可用?
数据质量是影响模型性能的主要因素之一。想象一下,你想训练一个根据人名预测性别的模型。你可能会获得一个包含性别信息的人员数据集。然而,如果你盲目使用这个数据集,你可能会发现,无论你多么努力地提高模型质量,模型在新数据上的表现都很差。这种糟糕表现的原因是什么?
答案可能是性别信息并非事实性的,而是由一个质量较低的统计分类器获得的。在这种情况下,你的模型能达到的最佳性能就是这个低质量分类器的性能。
如果数据集以电子表格的形式出现,首先要检查的是电子表格中的数据是否整洁(tidy)。正如引言中讨论的,用于机器学习的数据集必须是整洁的。如果你的数据并非如此,你必须使用(如前所述)特征工程将其转换为整洁数据。
整洁的数据集也可能有缺失值(missing values)。考虑使用数据插补(data imputation)技术来填充缺失值。我们将在 3.7 节讨论几种此类技术。
人工整理的数据集的一个常见问题是,人们可能决定用某个神奇数字(如 9999 或 -1)来表示缺失值。这种情况必须在数据的可视化分析中发现,并且必须使用合适的数据插补技术替换这些神奇数字。
另一个需要验证的属性是数据集是否包含重复项(duplicates)。通常,重复项会被删除,除非你是故意添加它们以平衡类别不平衡(imbalanced)问题。我们将在 3.9 节讨论这个问题及其缓解方法。
数据可能已过期或严重过时。例如,假设你的目标是训练一个识别复杂电子设备(如打印机)行为异常的模型。你有打印机在正常和异常运行期间采集的测量数据。然而,这些测量数据是针对上一代打印机记录的,而新一代打印机自那以后经历了多次重大升级。使用这种来自旧一代打印机的过期数据训练的模型,在部署到新一代打印机上时可能表现更差。
最后,数据可能不完整或不能代表所研究的现象。例如,一个动物照片数据集可能只包含在夏季或特定地理区域拍摄的照片。自动驾驶系统的行人数据集可能是由工程师假扮行人创建的;在这种数据集中,大多数场景只包含年轻男性,而儿童、女性和老年人则代表性不足或完全缺失。
一家从事面部表情识别(facial expression recognition)的公司可能将研发办公室设在以白人为主的地区,因此数据集只会展示白人的面孔,而黑人或亚洲人则代表性不足。为摄像头开发姿态识别(posture recognition)模型的工程师可能通过在室内拍摄人物来构建训练数据集,而客户通常会在室外使用该摄像头。
在实践中,数据只有在预处理之后才能用于建模;因此,在开始建模之前对数据集进行可视化分析非常重要。假设你从事新闻文章主题预测问题。你很可能会从新闻网站抓取数据。下载日期也很可能保存在与新闻文章文本相同的文档中。再想象一下,数据工程师决定遍历网站上提到的新闻主题,一次抓取一个主题。于是,周一抓取艺术类文章,周二抓取体育类,周三抓取科技类,依此类推。
如果你不通过移除日期来预处理这些数据,模型就可能学习到日期与主题之间的相关性,而这样的模型将毫无实际用途。
3.1.4 数据是否可理解?
正如性别预测示例所展示的,理解数据集中每个属性的来源至关重要。理解每个属性确切代表什么同样重要。实践中常见的一个问题是:分析师试图预测的变量出现在特征向量(feature vector)的特征中。这怎么可能发生?
想象一下,你在研究根据房屋属性(如卧室数量、面积、位置、建造年份等)预测房价的问题。每栋房屋的属性由你的客户——一个大型在线房地产销售平台——提供给你。数据以 Excel 电子表格的形式呈现。在没有花太多时间分析每一列的情况下,你只从属性中移除了成交价(transaction price),并将该值作为你想要学习预测的目标。很快你发现模型几乎完美:它以接近 100% 的准确率预测成交价。你把模型交付给客户,他们将其部署到生产中,而测试显示模型大多数时候是错误的。发生了什么?
发生的情况被称为数据泄漏(data leakage),也称为目标泄漏(target leakage)。经过对数据集的更仔细检查,你发现电子表格中的某一列包含房地产经纪人的佣金。当然,模型很容易学会将该属性完美地转换为房价。然而,在房屋售出之前,生产环境中并没有这些信息,因为佣金取决于售价。在 3.2.8 节中,我们将更详细地讨论数据泄漏问题。
3.1.5 数据是否可靠?
数据集的可靠性因收集该数据集所用的程序而异。你能信任标签(labels)吗?如果数据是由 Mechanical Turk 上的工人(所谓的「turkers」)生产的,那么此类数据的可靠性可能非常低。在某些情况下,分配给特征向量的标签可能是多个 turkers 的多数投票(或平均值)的结果。如果是这样,数据可以被认为更可靠。然而,最好还是对数据集的少量随机样本进行额外的质量验证。
另一方面,如果数据代表某些测量设备所做的测量,你可以在相应测量设备的技术文档中找到每次测量精度的详细信息。
标签的可靠性也可能受到标签的延迟性或间接性的影响。当被分配标签的特征向量所代表的事物发生的时间显著早于标签观测时间时,该标签被认为是延迟的。
更具体地说,以流失预测(churn prediction)问题为例。这里,我们有一个描述客户的特征向量,我们想预测该客户是否会在未来某个时间点(通常是从现在起六个月到一年)离开。特征向量代表我们现在对客户的了解,但标签(「离开」或「留下」)将在未来被分配。这是一个重要的性质,因为从现在到未来之间,可能发生许多未反映在我们特征向量中的事件,这些事件会影响客户留下或离开的决定。因此,延迟标签使我们的数据可靠性降低。
标签是直接的还是间接的也会影响可靠性,当然这取决于我们试图预测什么。例如,假设我们的目标是预测网站访问者是否会对某个网页感兴趣。我们可能会获得一个数据集,其中包含用户、网页的信息,以及反映特定用户是否对特定网页感兴趣的「感兴趣」/「不感兴趣」标签。直接标签确实能表明兴趣,而间接标签可能暗示某种兴趣。例如,如果用户按下了「点赞」(Like)按钮,我们就有了兴趣的直接指标。然而,如果用户只是点击了链接,这可能是某种兴趣的指标,但这是一个间接指标。用户可能是误点,或者因为链接文本是标题党(clickbait),我们无法确定。如果标签是间接的,这也使此类数据的可靠性降低。当然,对于预测兴趣来说它的可靠性较低,但对于预测点击来说它可能完全可靠。
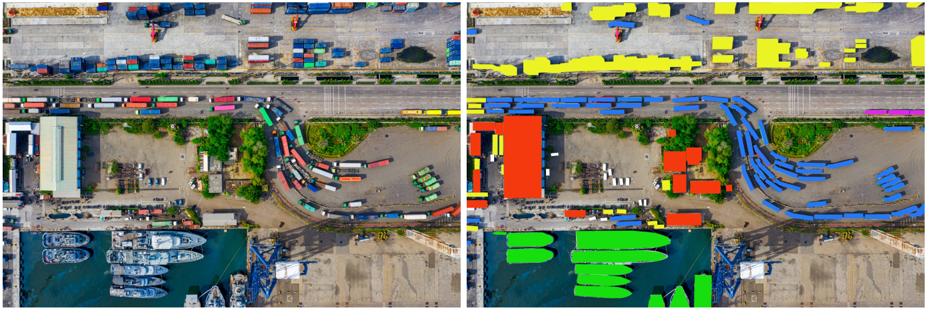
图 3:未标注和已标注的航拍照片。照片来源:Tom Fisk。
数据中不可靠性的另一个来源是反馈循环(feedback loops)。反馈循环是系统设计中的一种性质:用于训练模型的数据是通过模型本身获得的。再想象一下,你在研究预测某个网站用户是否会喜欢内容的问题,而你只有间接标签——点击。如果模型已经部署在网站上,用户会点击模型推荐的链接,这意味着新数据不仅间接反映了用户对内容的兴趣,还反映了模型推荐该内容的强度。如果模型判定某个特定链接足够重要,值得推荐给许多用户,那么更多用户可能会点击该链接,尤其是当该推荐在几天或几周内被重复做出时。
3.2 数据的常见问题
正如我们刚刚看到的,你要处理的数据可能存在问题。在本节中,我们列举其中最重要的问题以及你可以采取的缓解措施。
3.2.1 高成本
获取未标注数据可能很昂贵;然而,标注数据是最昂贵的工作,尤其是当这项工作由人工完成时。
当未标注数据必须专门为你的问题而收集时,获取它就会变得昂贵。假设你的目标是了解一个城市中不同类型商业的分布位置。最好的解决方案是从政府机构购买这些数据。然而,由于各种原因,这可能很复杂甚至不可能:政府数据库可能不完整或过时。为了获得最新数据,你可能决定派遣装有摄像头的汽车行驶在城市的街道上,拍摄街道上所有建筑物的照片。
正如你可能想象的那样,这样的项目并不便宜。拍摄建筑物的照片还不够,我们还需要知道每栋建筑中的商业类型。现在我们需要标注数据:「咖啡馆」、「银行」、「杂货店」、「药店」、「加油站」等。这些必须人工标注,而付费请人做这项工作是很昂贵的。顺便说一句,Google 有一个巧妙的技术,通过其免费的 reCAPTCHA 服务将标注外包给随机人群。reCAPTCHA 因此解决了两个问题:减少网络垃圾邮件,以及为 Google 提供廉价的标注数据。
在图 3 中,你可以看到标注一张图片所需的工作。这里的目标是通过为每个像素分配以下标签之一来分割图片:「重型卡车」、「轿车或轻型卡车」、「船」、「建筑」、「集装箱」、「其他」。标注图 3 中的图片花了我大约 30 分钟。如果有更多类型,例如「摩托车」、「树」、「道路」,则需要更长时间,标注成本也会更高。
设计良好的标注工具将最大限度地减少鼠标使用(包括由鼠标点击激活的菜单),最大限度地增加热键使用,并通过提高数据标注速度来降低成本。
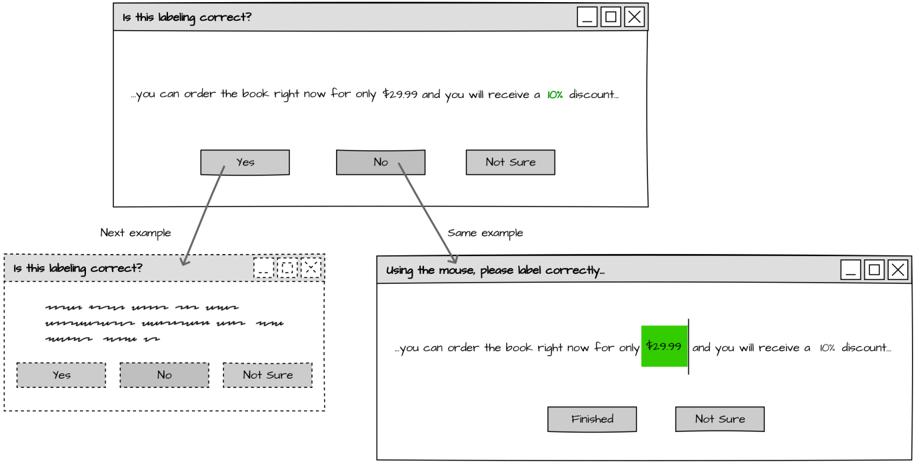
只要有可能,就把决策简化为是/否答案。与其问「找出这段文本中的所有价格」,不如从文本中提取所有数字,然后逐一显示每个数字,问「这个数字是价格吗?」,如图 4 所示。如果标注者点击「不确定」(Not Sure),你可以保存此示例以便稍后分析,或者干脆不用这些示例来训练模型。
另一个加速标注的技巧是噪声预标注(noisy pre-labeling),即使用当前最佳模型对示例进行预标注。在这种方案中,你首先「从头开始」标注一定数量的示例(即不使用任何辅助)。然后,使用这组初始标注示例构建第一个表现合理的模型。接下来,使用当前模型代替人工标注者为每个新示例标注标签3。询问自动分配的标签是否正确。如果标注者点击「是」,照常保存此示例。如果他们点击「否」,则要求手动标注此示例。参见图 5 中说明此过程的工作流程图。良好的标注流程设计的目标是使标注尽可能流畅。保持标注者的参与度也至关重要。显示已添加标签数量的进度,以及当前最佳模型的质量。这能让标注者参与进来,并为标注任务增添意义。
图 4:简单标注界面的示例。
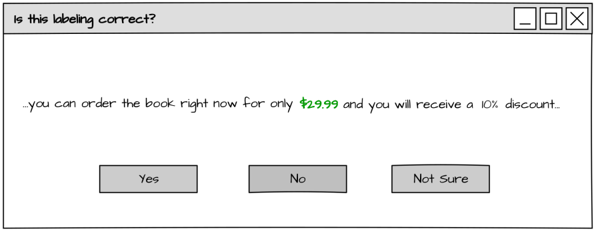
图 5:噪声预标注工作流的示例。
3.2.2 质量差
请记住,数据质量是影响模型性能的主要因素之一。这一点我再怎么强调也不为过。
数据质量有两个组成部分:原始数据质量和标注质量。
原始数据的一些常见问题是噪声(noise)、偏差(bias)、预测能力低(low predictive power)、示例过时(outdated examples)、离群值(outliers)和泄漏(leakage)。
3.2.3 噪声
数据中的噪声是对示例的破坏。图像可能模糊或不完整。文本可能丢失格式,导致某些单词被拼接或拆分。音频数据可能有背景噪声。民意调查答案可能不完整或缺少某些属性,如受访者的年龄或性别。噪声通常是一个随机过程,它独立于集合中的其他示例破坏每个示例。
如果整洁数据缺少属性,数据插补技术可以帮助猜测这些属性的值。我们将在 3.7.1 节讨论数据插补技术。
模糊的图像可以使用特定的图像去模糊算法来去模糊,不过深度机器学习模型(如神经网络)可以在需要时学习去模糊。音频数据中的噪声也是如此:可以通过算法抑制。
当数据集相对较小时(数千个示例或更少),噪声更成问题,因为噪声的存在可能导致过拟合(overfitting):算法可能学习对训练数据中包含的噪声进行建模,这是不可取的。另一方面,在大数据背景下,如果噪声是独立于数据集中其他示例随机施加到每个示例上的,那么它通常会随着多个示例被「平均掉」。在后一种背景下,噪声可以带来正则化(regularization)效果,因为它防止学习算法过于依赖一小部分输入特征4。
3.2.4 偏差
数据中的偏差是与数据所代表的现象的不一致。这种不一致可能由多种原因引起(这些原因并不互斥)。
偏差的类型
选择偏差(selection bias)是倾向于将你的数据源选择偏向那些容易获得、方便和/或成本效益高的数据源。例如,你可能想知道读者对你新书的看法。你决定把前几章发给上一本书读者的邮件列表。这个被选中的群体很可能喜欢你的新书。然而,这个信息并不能告诉你太多关于普通读者的看法。
选择偏差的一个现实例子是由 PULSE(Photo Upsampling via Latent Space Exploration,通过潜在空间探索进行照片上采样)算法生成的图像,该算法使用神经网络模型对图像进行上采样(提高分辨率)。当互联网用户测试它时,他们发现一张黑人的上采样图像在某些情况下可能呈现为白人,如图 6 中巴拉克·奥巴马(Barack Obama)的上采样照片所示。
图 6:选择偏差对训练后模型影响的示例。图片来源:Twitter / @Chicken3gg。
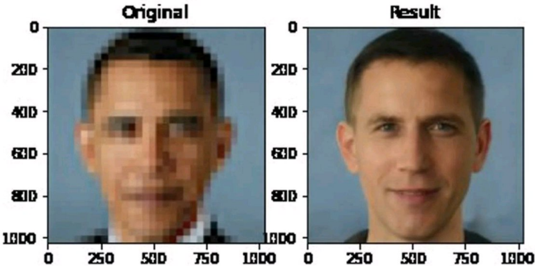
上面的例子表明,不能仅仅因为机器学习算法是公正的、训练出的模型是基于数据的,就假定机器学习模型是正确的。如果数据有偏差,它很可能会反映在模型中。
自选择偏差(self-selection bias)是选择偏差的一种形式,即你从「自愿」提供数据的来源获取数据。大多数民意调查数据都有这种偏差。例如,你想训练一个预测成功企业家行为的模型。你决定先询问企业家他们是否成功。然后只保留那些自称成功的人的数据。这里的问题在于,真正成功的企业家很可能没有时间回答你的问题,而那些自称成功的人在这方面可能是错误的。
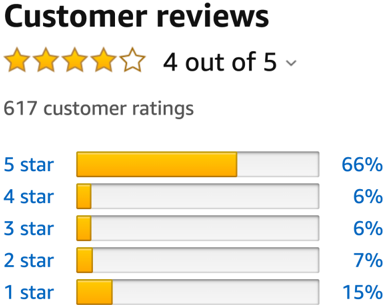
再举一个例子。假设你想训练一个预测读者是否会喜欢某本书的模型。你可以使用用户过去对类似书籍的评分。然而,不满意的用户往往给出不成比例的低评分。与中等评分数量相比,数据将偏向于过多的极低评分,如图 7 所示。这种偏差还因以下事实而加剧:我们往往只在体验非常好或非常差时才评分。
图 7:读者在亚马逊上对一本流行 AI 书籍给出的评分分布。
遗漏变量偏差(omitted variable bias)发生在你的特征化数据缺少准确预测所必需的特征时。例如,假设你在做一个流失预测模型,想预测客户是否会在六个月内取消订阅。你训练了一个模型,它足够准确;然而,部署几周后,你看到许多意外的假阴性(false negatives)。你调查模型性能下降的原因,发现一个新竞争对手现在以更低的价格提供非常相似的服务。这个特征最初对你的模型不可用,因此准确预测所需的重要信息缺失了。
赞助或资助偏差(sponsorship or funding bias)影响由受赞助机构产生的数据。例如,让一家著名的视频游戏公司赞助一家新闻机构,提供关于视频游戏行业的新闻。如果你想对视频游戏行业做出预测,你可能会把这家受赞助机构制作的故事纳入数据。
然而,受赞助的新闻机构倾向于压制关于其赞助商的坏消息,并夸大其成就。结果,模型的性能将是次优的。
抽样偏差(sampling bias),也称为分布偏移(distribution shift),发生在用于训练的示例分布不能反映模型在生产中将要接收的输入分布时。这种偏差在实践中经常观察到。例如,你在研究一个根据数百个主题的分类法对文档进行分类的系统。你可能决定创建一个文档集合,其中每个主题的文档数量相等。完成模型工作后,你观察到 5% 的错误率。部署后不久,你看到约 30% 的文档被错误分配。为什么会发生这种情况?
可能的原因之一是抽样偏差:生产数据中一两个频繁出现的主题可能占所有输入的 80%。如果你的模型对这些频繁主题表现不佳,那么你的系统在生产中犯的错误将比你最初预期的更多。
偏见或刻板印象偏差(prejudice or stereotype bias)经常在从历史来源(如书籍或照片档案)或在线活动(如社交媒体、在线论坛和在线出版物评论)获得的数据中观察到。
使用照片档案训练一个区分男性和女性的模型,可能会显示,例如,男性更常出现在工作或户外环境中,而女性更常出现在家中室内。如果我们使用这种有偏差的数据,我们的模型将更难识别户外的女性或家中的男性。
这类偏差的一个著名例子是使用 word2vec 等算法训练的词嵌入(word embeddings)来寻找单词的关联。该模型预测 king - man + woman ≈ queen,但同时预测 programmer - man + woman ≈ homemaker。
系统性价值扭曲(systematic value distortion)是通常发生在进行测量或观测的设备上的偏差。这会导致机器学习模型部署到生产环境时做出次优预测。
例如,训练数据是使用白平衡使白色看起来发黄的相机收集的。然而在生产中,工程师决定使用更高质量的相机,「看到」白色就是白色。因为你的模型是在低质量图片上训练的,使用更高质量输入的预测将是次优的。
这不应与噪声数据混淆。噪声是扭曲数据的随机过程的结果。当你有足够大的数据集时,噪声就不那么成问题了,因为它可能会被平均掉。另一方面,如果测量结果持续向一个方向偏移,那么它会损害训练数据,并最终导致低质量的模型。
实验者偏差(experimenter bias)是倾向于以确认自己先前信念或假设的方式搜索、解释、偏袒或回忆信息的倾向。应用于机器学习时,实验者偏差通常发生在数据集中的每个示例都来自某个人对调查问卷的回答时,每人一个示例。
通常,每份调查都包含多个问题。这些问题的形式会显著影响回答。问题影响回答的最简单方式是提供有限的回答选项:「你喜欢哪种披萨:意大利辣香肠、全肉还是素食?」这没有留下给出不同答案或「其他」选项的空间。
或者,调查问题可能带有内置的倾向。与其问「你回收垃圾吗?」,一个有实验者偏差的分析师可能会问「你会逃避回收垃圾吗?」在前一种情况下,受访者更有可能给出诚实的回答,而在后一种情况下则不然。
此外,当分析师事先被告知要支持某个特定结论(例如支持「一切照旧」的结论)时,也可能发生实验者偏差。在这种情况下,他们可以将特定变量排除在分析之外,称其不可靠或噪声大。
标注偏差(labeling bias)发生在标签由有偏差的过程或人分配给未标注示例时。例如,如果你让几位标注者通过阅读文档来为文档分配主题,一些标注者可能确实通读了整个文档并给出深思熟虑的标签。相比之下,其他人可能只是快速「扫描」文本,找出一些关键词组,然后选择与所选关键词组最匹配的主题。由于每个人的大脑都更关注来自某个或某些特定领域的关键词组,而不太关注其他领域,因此通过扫描而非阅读来标注文本的标注者所分配的标签将是有偏差的。
或者,一些标注者可能对阅读某些主题的文档更感兴趣(他们个人偏好这些主题)。如果是这样,标注者可能会跳过无趣的文档,而这些文档在你的数据中代表性将不足。
避免偏差的方法
通常不可能确切知道数据集中存在哪些偏差。此外,即使知道存在偏差,避免它们也是一项具有挑战性的任务。首先,要做好准备。
一个好习惯是质疑一切:谁创建了数据,他们的动机和质量标准是什么,更重要的是,数据是如何以及为什么被创建的。如果数据是某项研究的结果,请质疑研究方法,并确保它不会导致上述任何一种偏差。
可以通过系统地质疑选择特定数据源的原因来避免选择偏差。如果原因是简单或低成本,那么要格外小心。回想一下预测特定客户是否会订阅你新产品的问题。仅使用现有客户的数据来训练模型可能是个坏主意,因为你的现有客户比随机的潜在客户对你的品牌更忠诚。你对模型质量的估计将过于乐观。
自选择偏差无法完全消除。它通常出现在调查中;受访者仅仅同意回答问题就代表了自选择偏差。调查越长,受访者越不可能高度专注地回答。因此,请保持调查简短,并为高质量的回答提供激励。
预先筛选受访者以减少自选择。不要问企业家是否认为自己成功。相反,基于专家或出版物的推荐建立一个名单,只联系那些人。
完全避免遗漏变量偏差很困难,因为正如人们所说,「我们不知道自己不知道什么」。一种方法是使用所有可用的信息,即尽可能多地在特征向量中包含特征,即使你认为它们是不必要的。这可能会使你的特征向量非常宽(即维度很多)且稀疏(即大多数维度的值为零)。不过,如果你使用调优良好的正则化,你的模型将「决定」哪些特征重要,哪些不重要。
或者,让我们怀疑某个特定变量对准确预测很重要,而将其排除在模型之外可能导致遗漏变量偏差。假设获取该数据很困难。尝试使用代理变量(proxy variable)来代替被遗漏的变量。例如,如果我们想训练一个预测二手车价格的模型,而我们无法获得车龄,那么可以使用当前车主拥有的时长。当前车主拥有汽车的时间可以被视为车辆车龄的代理。
赞助偏差可以通过仔细调查数据源来减少,特别是数据源所有者提供数据的动机。例如,众所周知,关于烟草和药品的出版物非常常由烟草和制药公司或其反对者赞助。新闻公司也是如此,尤其是那些依赖广告收入或有不公开商业模式的新闻公司。
抽样偏差可以通过研究生产中将观察到的数据中各种属性的真实比例,然后以保持相似比例的方式对训练数据进行抽样来避免。
偏见或刻板印象偏差是可以控制的。在开发区分女性和男性照片的训练模型时,数据分析师可以选择对室内女性照片进行欠采样(under-sample),或对家中男性照片进行过采样(oversample)。换句话说,偏见或刻板印象偏差通过让学习算法接触更均衡的示例分布来减少。
系统性价值扭曲偏差可以通过使用多个测量设备,或雇佣经过训练的人员来比较测量或观测设备的输出来缓解。
实验者偏差可以通过让多个人验证调查中提出的问题来避免。问问自己:「回答这个问题时,我会感到不舒服或受限制吗?」
此外,尽管分析起来更困难,但优先选择开放式问题而不是是/否或多项选择题。如果你仍然更愿意给受访者提供答案选择,请包括「其他」选项和一个写下不同答案的地方。
标注偏差可以通过让多位标注者标注同一个示例来避免。询问标注者为什么决定为产生不同结果的示例分配特定标签。如果你看到一些标注者提到某些关键词组,而不是试图复述整个文档,你就可以识别出那些快速扫描而不是阅读的人。
你还可以比较不同标注者跳过文档的频率。如果你看到某个标注者跳过文档的频率高于平均水平,请询问他们是否遇到技术问题,或者只是对某些主题不感兴趣。
你无法完全避免数据中的偏差。没有灵丹妙药。作为一般规则,保持人在回路中(keep a human in the loop),尤其是当你的模型影响人们的生活时。
回想一下,数据分析师中有一种诱惑,即认为机器学习模型天生公平,因为它们基于证据和数学做出决策,而不是基于通常混乱或不理性的人类判断。不幸的是,情况并非总是如此:在偏差数据上训练的模型必然会产生有偏差的结果。
确保输出公平是训练模型的人的责任。但你可能会问,什么是公平?不幸的是,再次强调,没有能够始终检测不公平的灵丹妙药式度量。选择适当的模型公平性定义总是特定于问题的,需要人的判断。我们将在第 7 章的 ?? 节考虑机器学习中公平性的几种定义。
在数据收集和准备的各个阶段都有人类参与,是确保机器学习可能造成的损害最小化的最佳方法。
3.2.5 预测能力低
预测能力低是一个你往往在徒劳地花精力试图训练一个好模型之后才会考虑的问题。模型表现不佳是因为它不够有表现力吗?还是数据没有包含足够的信息可供学习?你不知道。
假设目标是预测听众是否会喜欢音乐流媒体服务上的新歌。你的数据是艺术家姓名、歌曲标题、歌词,以及这首歌是否在他们的播放列表中。你用这些数据训练的模型将远非完美。
不在听众播放列表中的艺术家不太可能从模型获得高分。此外,许多用户只会将特定艺术家的部分歌曲添加到他们的播放列表中。他们的音乐偏好显著受歌曲编排、乐器选择、音效、音色以及调性、节奏和节拍的细微变化影响。这些是歌曲的属性,无法在歌词、标题或艺术家姓名中找到;它们必须从声音文件中提取。
另一方面,从音频文件中提取这些相关特征很有挑战性。即使是现代神经网络,根据歌曲听感推荐歌曲也被认为是人工智能的难题。通常,歌曲推荐是通过比较不同听众的播放列表并找到构成相似的播放列表来开发的。
考虑另一个预测能力低的例子。假设我们要训练一个模型来预测望远镜应该指向哪里以观测有趣的事物。我们的数据是过去捕获到不寻常事物的天空各区域的照片。仅基于这些照片,我们不太可能训练出准确预测此类事件的模型。然而,如果我们在这些数据中加入各种传感器的测量数据,例如测量不同区域射频信号的传感器或粒子爆发,我们更有可能做出更好的预测。
第一次处理某个数据集时,你的工作可能特别具有挑战性。如果你无法获得可接受的结果,无论模型变得多么复杂,都可能是时候考虑预测能力低的问题了。尽可能工程化更多特征(发挥你的创造力!)。考虑使用间接数据源来丰富特征向量。
3.2.6 示例过时
一旦你构建模型并将其部署到生产中,模型通常会在一定时间内表现良好。这段时间完全取决于你所建模的现象。
通常,正如我们将在第 9 章的 ?? 节讨论的,生产环境中会部署某种模型质量监控流程。一旦检测到异常行为,就会添加新的训练数据来调整模型;然后重新训练并重新部署模型。
通常,错误的原因可以用训练集的有限性来解释。在这种情况下,额外的训练示例将使模型更加稳固。然而,在许多实际场景中,模型开始出错是因为概念漂移(concept drift)。概念漂移是特征与标签之间统计关系的根本性变化。
想象一下,你的模型预测用户是否会喜欢网站上的某些内容。随着时间的推移,一些用户的偏好可能开始改变,也许是因为年龄增长,或者因为用户发现了新事物(三年前我不听爵士乐,现在听了!)。过去添加到训练数据中的示例不再反映某些用户的偏好,并开始损害模型性能,而不是有所贡献。这就是概念漂移。如果你看到模型在新数据上的性能呈下降趋势,请考虑这一点。
通过从训练数据中移除过时的示例来纠正模型。将你的训练示例排序,最近的在前。定义一个额外的超参数——使用最近多少百分比的示例来重新训练模型——并使用网格搜索(grid search)或其他超参数调优技术来调整它。
概念漂移是更广泛问题——分布偏移——的一个例子。我们将在 ?? 节和 ?? 节讨论超参数调优和其他类型的分布偏移。
3.2.7 离群值
离群值(outliers)是看起来与数据集中大多数示例不相似的示例。「不相似」的定义取决于数据分析师。通常,不相似性由某种距离度量来衡量,例如欧氏距离(Euclidean distance)。
然而在实践中,在原始特征向量空间中看似离群值的示例,在使用核函数(kernel function)等工具变换后的特征向量空间中可能是典型示例。特征空间变换通常由基于核的模型显式完成,例如支持向量机(support vector machine,SVM),或者由深度神经网络隐式完成。
浅层算法,如线性回归或逻辑回归,以及一些集成方法,如 AdaBoost,对离群值特别敏感。SVM 有一个对离群值不那么敏感的定义:一个特殊的惩罚超参数调节错分类示例(通常恰好是离群值)对决策边界(decision boundary)的影响。如果这个惩罚值很低,SVM 算法在绘制决策边界(一个分隔正例和负例的假想超平面)时可能会完全忽略离群值。如果太低,甚至一些常规示例也可能最终落在决策边界的错误一侧。该超参数的最佳值应由分析师使用超参数调优技术找到。
一个足够复杂的神经网络可以学习对数据集中每个离群值采取不同的行为,同时仍然对常规示例表现良好。这不是期望的结果,因为模型对任务来说变得不必要地复杂。更多的复杂性导致更长的训练和预测时间,以及生产部署后更差的泛化能力。
是否从训练数据中排除离群值,或者使用对离群值鲁棒的机器学习算法和模型,是有争议的。从数据集中删除示例在科学上或方法论上不被认为是合理的,尤其是在小数据集中。另一方面,在大数据背景下,离群值通常不会对模型产生显著影响。
从实践的角度来看,如果排除某些训练示例能提高模型在保留数据上的性能,那么排除可能是合理的。可以考虑排除哪些示例可以基于某种相似性度量来决定。获得这种度量的现代方法是构建一个自编码器(autoencoder),并使用重构误差(reconstruction error)5作为(不)相似性的度量:给定示例的重构误差越高,它与数据集的相似性越低。
3.2.8 数据泄漏
数据泄漏(data leakage),也称为目标泄漏(target leakage),是影响机器学习生命周期多个阶段(从数据收集到模型评估)的问题。在本节中,我将只描述这个问题如何在数据收集和准备阶段表现出来。在后续章节中,我将描述它的其他形式。
图 8:数据泄漏简图。
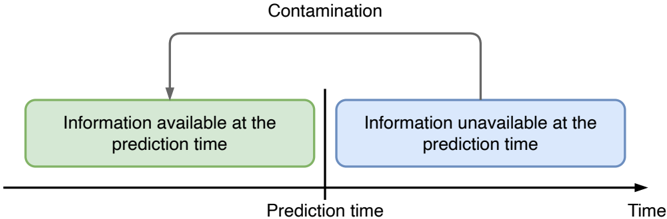
监督学习中的数据泄漏是指无意中引入了不应提供有关目标的信息。我们称之为「污染」(contamination)(图 8)。在受污染的数据上训练会导致对模型性能的过于乐观的期望。
3.3 什么是好数据
我们已经考虑了开始收集数据之前需要回答的问题,以及分析师可能遇到的数据常见问题。但什么构成机器学习项目的好数据?下面我们来看看好数据的几个属性。
3.3.1 好数据具有信息性
好数据包含足够多的可用于建模的信息。例如,如果你想训练一个预测客户是否会购买特定产品的模型,你将需要同时拥有该产品的属性和客户过去购买过的产品的属性。如果你只有产品属性以及客户的位置和姓名,那么来自同一位置的所有用户的预测都将相同。
如果你有足够的训练示例,那么模型有可能从姓名中推导出性别和种族,并为男性、女性、不同位置和种族做出不同的预测,但无法为每个客户单独做出预测。
3.3.2 好数据具有良好覆盖
好数据对你想要用模型做什么具有良好的覆盖。例如,如果你将使用模型按主题对网页进行分类,并且你有一千个感兴趣的主题,那么你的数据必须包含这一千个主题中每个主题的足够数量的文档示例,以便算法能够学习主题之间的差异。
想象另一种情况。假设对于某个特定主题,你只有一两篇文档。让每篇文档在文本中包含一个唯一 ID。在这种情况下,学习算法将不确定它必须在每篇文档中看什么才能理解它属于哪个主题。也许是 ID?它们看起来是不错的区分器。如果算法决定使用 ID 将这两个示例与数据集的其余部分分开,那么学习到的模型将无法泛化:它将永远不会再看到这些 ID。
3.3.3 好数据反映真实输入
好数据反映模型在生产中将要看到的真实输入。例如,如果你构建一个识别道路上汽车的系统,而你所有的图片都是在工作时间拍摄的,那么你不太可能有很多夜间图片的示例。一旦你将模型部署到生产中,图片将开始来自一天中的各个时间段,你的模型将更频繁地在夜间图片上出错。另外,还记得猫、狗和浣熊的问题:如果你的模型对浣熊一无所知,它会将它们的图片预测为狗或猫。
3.3.4 好数据无偏差
好数据尽可能无偏差。这个属性看起来与上一个相似。尽管如此,偏差可能同时存在于你用于训练的数据和模型在生产环境中应用的数据中。
我们在 3.2 节讨论了数据中偏差的几个来源以及如何处理。用户界面也可以是偏差的来源。例如,你想预测一篇新闻文章的热度,并使用点击率作为特征。如果某篇新闻文章显示在页面顶部,它获得的点击次数通常会比显示在底部的另一篇新闻文章高,即使后者更有吸引力。
3.3.5 好数据不是反馈循环的结果
好数据不是模型本身的结果。这与上面讨论的反馈循环问题相呼应。例如,你不能训练一个根据姓名预测人性别的模型,然后用预测结果来标注新的训练示例。
或者,如果你使用模型来决定哪些电子邮件对用户重要并突出显示这些重要邮件,你不应直接将那些电子邮件的点击作为该邮件重要的信号。用户可能是因为模型突出了它们才点击的。
3.3.6 好数据具有一致的标签
好数据具有一致的标签。标注的不一致可能来自几个来源:
- 不同的人按照不同的标准进行标注。即使人们认为他们使用相同的标准,不同的人也经常对相同的标准做出不同的解释。6
- 某些类别的定义随着时间推移而演变。这导致两个非常相似的特征向量收到两个不同标签的情况。
- 对用户动机的误解。例如,假设用户忽略了一篇推荐的新闻文章。结果,这篇新闻文章收到了负面标签。然而,用户忽略这个推荐的原因可能是他们已经知道这个故事,而不是他们对故事的主题不感兴趣。
3.3.7 好数据足够大
好数据足够大,可以允许泛化。有时,任何方法都无法提高模型的准确性。无论你向学习算法投入多少数据:数据中包含的信息对你问题的预测能力都很低。然而,更常见的是,如果你从数千个示例增加到数百万或数亿个,你可以获得非常准确的模型。在开始处理问题并看到进展之前,你无法知道你需要多少数据。
3.3.8 好数据总结
为了方便将来参考,让我再次重复好数据的属性:
- 它包含足够多的可用于建模的信息,
- 它对你想要用模型做什么具有良好的覆盖,
- 它反映模型在生产中将要看到的真实输入,
- 它尽可能无偏差,
- 它不是模型本身的结果,
- 它有一致的标签,并且
- 它足够大,可以允许泛化。
3.4 处理交互数据
交互数据(interaction data)是你可以从用户与你模型所支持系统的交互中收集的数据。如果你能从用户与系统的交互中收集到好数据,那你就算幸运了。
好的交互数据包含三个方面的信息:
- 交互的上下文(context of interaction),
- 用户在该上下文中的行为(action of the user),以及
- 交互的结果(outcome)。
例如,假设你构建了一个搜索引擎,你的模型为每个用户单独重新排序搜索结果。重排序(reranking)模型将搜索引擎根据用户提供的关键词返回的链接列表作为输入,并输出另一个改变条目顺序的列表。通常,重排序模型「知道」一些关于用户及其偏好的信息,并可以根据该用户学到的偏好为每个用户单独重新排序通用搜索结果。这里的上下文是搜索查询和以特定顺序呈现给用户的一百篇文档。行为是用户点击某个特定文档链接。结果是用户花多少时间阅读文档,以及用户是否点击了「返回」。另一个行为是点击「下一页」链接。
直觉是,如果用户点击了某个链接并花了大量时间阅读页面,那么排名是好的。如果用户点击了某个结果的链接然后迅速「返回」,排名就不那么好。如果用户点击了「下一页」链接,排名就是差的。这些数据可以用来改进排名算法并使其更加个性化。
图 9:目标(GDP)是人口和人均 GDP 这两个特征的简单函数的示例。
| 国家 | 人口 | 地区 | … | 人均GDP | GDP |
|---|---|---|---|---|---|
| 法国 | 67M | 欧洲 | … | 38,800 | 2.6T |
| 德国 | 83M | 欧洲 | … | 44,578 | 3.7T |
| … | … | … | … | … | … |
| 中国 | 1386M | 亚洲 | … | 8,802 | 12.2T |
3.5 数据泄漏的原因
让我们讨论在数据收集和准备阶段可能发生的数据泄漏的三个最常见原因:1)目标是某个特征的函数,2)特征隐藏了目标,3)特征来自未来。
3.5.1 目标是某个特征的函数
国内生产总值(Gross Domestic Product,GDP)被定义为一个国家在特定时期内所有成品和服务的货币度量。假设我们的目标是根据各种属性预测一个国家的 GDP:面积、人口、地理区域等等。此类数据的示例如图 9 所示。如果你不仔细分析每个属性及其与 GDP 的关系,你可能就会让泄漏发生:在图 9 的数据中,人口和人均 GDP 两列相乘等于 GDP。你训练的模型将仅通过查看这两列就完美预测 GDP。你让 GDP 成为特征之一(尽管是以稍微修改过的形式——除以人口得出的)这一事实构成了污染,因此导致了数据泄漏。
一个更简单的例子是特征中包含目标的副本,只是格式不同。想象你训练一个模型,根据雇员的属性预测年薪。训练数据是一个包含月薪和年薪以及其他许多属性的表格。如果你忘记从特征列表中移除月薪,仅该属性就能完美预测年薪,让你相信你的模型是完美的。一旦模型投入生产,它很可能不再接收关于个人月薪的信息:否则,建模就没有必要了。
图 10:目标隐藏在某个特征中的示例。
| 客户ID | 分组 | 年消费额 | 年页面浏览量 | … | 性别 |
|---|---|---|---|---|---|
| 1 | M18-25 | 1350 | 11,987 | … | M |
| 2 | F25-35 | 2365 | 8,543 | … | F |
| … | … | … | … | … | … |
| 18879 | F65+ | 3653 | 6,775 | … | F |
3.5.2 特征隐藏目标
有时目标不是一个或多个特征的函数,而是「隐藏」在某个特征中。考虑图 10 中的数据集。
在这种情况下,你使用客户数据来预测他们的性别。看「分组」(Group)列。如果你仔细调查「分组」列中的数据,你会发现它表示过去每个现有客户被归入的人口统计值。如果关于客户性别和年龄的数据是事实性的(而不是由生产环境中可能可用的另一个模型猜测的),那么「分组」列构成了一种数据泄漏,即你想要预测的值「隐藏」在某个特征的值中。
另一方面,如果「分组」值是由另一个可能不太准确的模型提供的预测,那么你可以使用这个属性来构建一个可能更强的模型。这被称为模型堆叠(model stacking),我们将在第 6 章的 ?? 节讨论这个主题。
3.5.3 特征来自未来
特征来自未来(feature from the future)是一种数据泄漏,如果你对业务目标没有清晰的理解,就很难发现。想象一下,客户要求你训练一个模型,根据年龄、性别、教育程度、薪水、婚姻状况等属性预测借款人是否会偿还贷款。此类数据的示例如图 11 所示。
如果你不努力理解你的模型将被使用的业务背景,你可能决定使用所有可用属性来预测「是否会还款」(Will Pay Loan)列的值,包括「逾期还款提醒」(Late Payment Reminders)列的数据。你的模型在测试时看起来很准确,你把它发给客户,客户后来报告说模型在生产环境中表现不佳。
经过调查,你发现生产环境中「逾期还款提醒」的值始终为零。这是有道理的,因为客户在借款人获得信贷之前就使用你的模型,所以还没有发出任何提醒!然而,你的模型很可能学会了在「逾期还款提醒」为 1 或更多时做出「否」的预测,而较少关注其他特征。
图 11:预测时不可用的特征:逾期还款提醒。
| 借款人ID | 人口统计分组 | 教育程度 | … | 逾期还款提醒 | 是否会还款 |
|---|---|---|---|---|---|
| 1 | M35-50 | High school | … | 0 | Y |
| 2 | F25-35 | Master’s | … | 1 | N |
| … | … | … | … | … | … |
| 65723 | M25-35 | Master’s | … | 3 | N |
再举一个例子。假设你有一个新闻网站,你想预测你提供给用户的新闻排名,以便最大化故事点击次数。如果在你的训练数据中,你有过去提供的每条新闻项的位置特征(例如,标题和网页上摘要块的 x-y 位置),这些信息在提供服务时将不可用,因为你在排名之前不知道文章在页面上的位置。
因此,理解模型将被使用的业务背景对于避免数据泄漏至关重要。
3.6 数据划分
如第一章的 ?? 节所讨论的,在实际机器学习中,我们通常使用三个不相交的示例集合:训练集(training set)、验证集(validation set)和测试集(test set)。
图 12:整个数据集被划分为训练集、验证集和测试集。
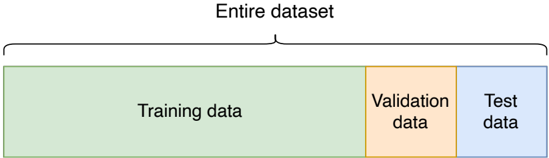
训练集由机器学习算法用来训练模型。
验证集用于找到机器学习流水线(pipeline)超参数的最佳值。分析师逐个尝试不同的超参数值组合,使用每个组合训练一个模型,并记录模型在验证集上的性能。然后使用使模型性能最大化的超参数来训练用于生产的模型。我们将在第 5 章的 ?? 节更详细地讨论超参数调优技术。
测试集用于报告:一旦你有了最佳模型,你在测试集上测试其性能并报告结果。
验证集和测试集通常被称为保留集(holdout sets):它们包含学习算法不允许看到的示例。
为了获得将整个数据集划分为这三个不相交集合的良好划分(如图 12 示意所示),划分必须满足几个条件。
条件 1:划分应用于原始数据。
一旦你可以访问原始示例,在做其他事情之前,先进行划分。这将有助于避免数据泄漏,我们稍后会看到。
条件 2:划分前数据已随机化。
首先随机打乱你的示例,然后进行划分。
条件 3:验证集和测试集遵循相同的分布。
当你使用验证集选择最佳超参数值时,你希望这个选择能产生在生产中表现良好的模型。测试集中的示例是你对生产数据的最佳代表。因此需要验证集和测试集遵循相同的分布。
条件 4:划分期间避免了泄漏。
数据泄漏甚至可能发生在数据划分期间。下面,我们将看到在该阶段可能发生什么形式的泄漏。
没有理想的划分比例。在较老的文献(大数据之前)中,你可能会发现推荐的划分是 70% / 15% / 15% 或 80% / 10% / 10%(分别用于训练集、验证集和测试集,相对于整个数据集的比例)。
今天,在互联网和廉价劳动力(如 Mechanical Turk 或众包)的时代,组织、科学家,甚至家里的爱好者都可以获得数百万的训练示例。这使得只使用 70% 或 80% 的可用数据进行训练变得浪费。
验证集和测试数据只用于计算反映模型性能的统计数据。这两个集合只需要足够大以提供可靠的统计数据。多大是有争议的。根据经验法则,每类十几个示例是理想的最低限度。如果你能在两个保留集中的每一个中每类有一百个示例,你就有了可靠的设置,基于这些集合计算的统计数据是可靠的。
划分的百分比也可能取决于所选的机器学习算法或模型。深度学习模型在接触更多训练数据时往往显著改善。浅层算法和模型则不那么明显。
你的比例可能取决于数据集的大小。一个少于一千个示例的小数据集最适合使用 90% 的数据进行训练。在这种情况下,你可能决定不设独立的验证集,而是使用交叉验证(cross-validation)技术来模拟。我们将在第 5 章的 ?? 节更多地讨论这一点。
值得一提的是,当你将时间序列(time-series)数据划分为三个数据集时,你必须执行划分,以便在打乱过程中保持每个示例中观测值的顺序。否则,对于大多数预测问题,你的数据将被破坏,无法进行任何学习。我们将在第 4 章的 ?? 节更多地讨论时间序列。
3.6.1 划分期间的泄漏
如你所知,数据泄漏可能发生在任何阶段,从数据收集到模型评估。数据划分阶段也不例外。
划分期间可能发生分组泄漏(group leakage)。想象你有多个患者的脑部磁共振图像。每张图像被标注为某种脑部疾病,同一患者可能由不同时间拍摄的多张图像表示。如果你应用上面讨论的划分技术(打乱,然后划分),同一患者的图像可能同时出现在训练数据和保留数据中。
模型可能从患者的特殊性而不是疾病中学习。模型会记住患者 A 的大脑有特定的脑回结构,如果训练数据中他们有特定疾病,模型会通过仅从脑回结构识别出患者 A 而在验证数据中成功预测这种疾病。
分组泄漏的解决方案是分组划分(group partitioning)。它包括将所有患者的示例保持在一个集合中:要么训练集,要么保留集。再次,你可以看到数据分析师尽可能多地了解数据是多么重要。
3.7 处理缺失属性
有时,数据以整洁的形式到达分析师手中,例如 Excel 电子表格7,但你可能会发现某些属性缺失。这通常发生在数据集是手工制作的时候,制作人忘记填写某些值或没有测量它们。
处理某个属性缺失值的典型方法列表包括:
- 从数据集中移除具有缺失属性的示例(如果你的数据集足够大,可以安全地牺牲一些数据,则可以这样做);
- 使用可以处理缺失属性值的学习算法(如决策树(decision tree)学习算法);
- 使用数据插补技术。
3.7.1 数据插补技术
要插补缺失的数值属性的值,一种技术是用该属性在数据集其余部分中的平均值替换缺失值。数学上如下所示。设 \(j\) 是原始数据集中某些示例缺失的属性,设 \(S^{(j)}\) 是大小为 \(N^{(j)}\) 的集合,只包含原始数据集中属性 \(j\) 的值存在的那些示例。那么属性 \(j\) 的缺失值 \(\hat{x}^{(j)}\) 由下式给出:
\[ \hat{x}^{(j)} = \frac{1}{N^{(j)}} \sum_{i \in S^{(j)}} x_i^{(j)}, \]其中 \(N^{(j)} < N\),求和仅针对属性 \(j\) 的值存在的那些示例。这种技术的说明如图 13 所示,其中两个示例(第 1 行和第 3 行)的「身高」(Height)属性缺失。平均值 177 将被插补到空白单元格中。
图 13:用该属性在数据集中的平均值替换缺失值。
| 行 | 年龄 | 体重 | 身高 | 薪水 |
|---|---|---|---|---|
| 1 | 18 | 70 | 35,000 | |
| 2 | 43 | 65 | 175 | 26,900 |
| 3 | 34 | 87 | 76,500 | |
| 4 | 21 | 66 | 187 | 94,800 |
| 5 | 65 | 60 | 169 | 19,000 |
另一种技术是用正常范围之外的值替换缺失值。例如,如果常规范围是 [0, 1],你可以将缺失值设置为 2 或 -1;如果属性是分类的,例如星期几,那么缺失值可以替换为「未知」(Unknown)值。在这里,学习算法学习当属性的值不同于常规值时该怎么做。如果属性是数值型的,另一种技术是用范围中间的值替换缺失值。例如,如果属性的范围是 [-1, 1],你可以将缺失值设置为 0。这里的思想是,范围中间的值不会显著影响预测。
一种更高级的技术是将缺失值用作回归问题的目标变量。(在这种情况下,我们假设所有属性都是数值型的。)你可以使用其余属性 \([x_i^{(1)}, x_i^{(2)}, \ldots, x_i^{(j-1)}, x_i^{(j+1)}, \ldots, x_i^{(D)}]\) 构成特征向量 \(\hat{x}_i\),设置 \(\hat{y}_i \leftarrow x_i^{(j)}\),其中 \(j\) 是具有缺失值的属性。然后你构建一个回归模型来从 \(\hat{x}\) 预测 \(\hat{y}\)。当然,要构建训练示例 \((\hat{x}, \hat{y})\),你只使用原始数据集中属性 \(j\) 的值存在的那些示例。
最后,如果你有一个非常大的数据集,而只有少数属性有缺失值,你可以为每个有缺失值的原始属性添加一个合成的二元指示属性。假设你数据集中的示例是 \(D\) 维的,位置 \(j = 12\) 的属性有缺失值。对于每个示例 \(x\),你然后在位置 \(j = D + 1\) 添加一个属性,如果位置 12 的属性的值在 \(x\) 中存在,则该属性等于 1,否则为 0。然后缺失值可以替换为 0 或你选择的任何值。
在预测时,如果你的示例不完整,你应该使用与你完成训练数据时相同的数据插补技术来填充缺失值。
在你开始处理学习问题之前,你无法知道哪种数据插补技术效果最好。尝试几种技术,构建几个模型,并选择效果最好的那个(使用验证集来比较模型)。
3.7.2 插补期间的泄漏
如果你使用计算某个属性(如平均值)或几个属性(通过求解回归问题)的统计量的插补技术,那么如果你使用整个数据集来计算该统计量,就会发生泄漏。使用所有可用示例,你会用从验证集和测试示例中获得的信息污染训练数据。
这种类型的泄漏没有前面讨论的其他类型那么严重。然而,你仍然必须意识到它并通过先划分、然后仅在训练集上计算插补统计量来避免它。
3.8 数据增强
对于某些类型的数据,无需额外标注就可以很容易地获得更多带标签的示例。这种策略称为数据增强(data augmentation),它应用于图像时最有效。它包括对原始图像应用简单的操作,如裁剪或翻转,以获得新图像。
3.8.1 图像数据增强
在图 14 中,你可以看到可以轻松应用于给定图像以获得一个或多个新图像的操作示例:翻转、旋转、裁剪、颜色偏移、添加噪声、透视变化、对比度变化和信息丢失。
图 14:数据增强技术示例。照片来源:Alfonso Escalante。
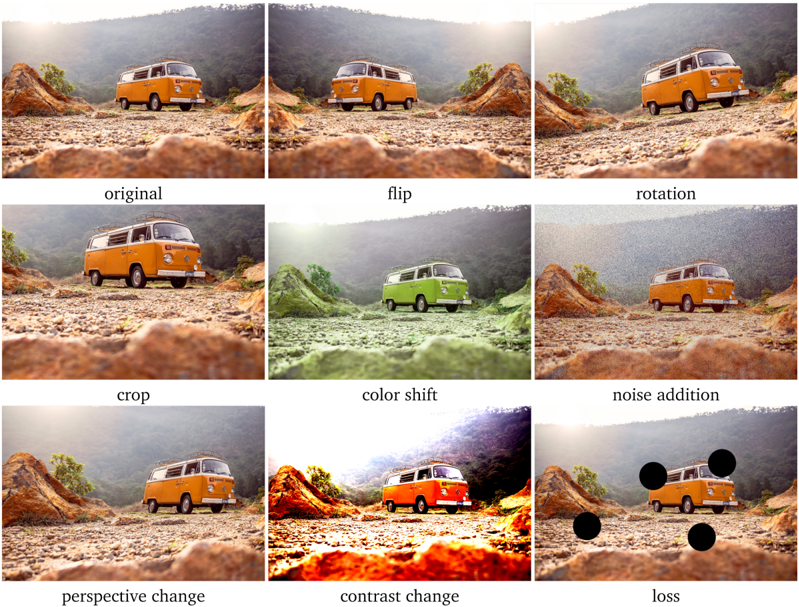
当然,翻转只能相对于图像含义得以保留的轴进行。如果是足球,你可以相对于两个轴翻转8,但如果是汽车或行人,那么你应该只相对于垂直轴翻转。
旋转应以微小的角度应用,以模拟不正确的地平线校准。你可以朝两个方向旋转图像。
裁剪可以多次随机应用于同一图像,同时在裁剪图像中保留感兴趣对象的显著部分。
在颜色偏移中,红绿蓝(red-green-blue,RGB)的细微差别会略微改变,以模拟不同的光照条件。对比度变化(降低和增加)以及不同强度的高斯噪声也可以多次应用于同一图像。
通过随机移除图像的部分内容,我们可以模拟对象可识别但因障碍物而无法完全可见的情况。
另一种看起来很反直觉但在实践中效果很好的流行数据增强技术是 mixup。顾名思义,该技术包括在训练集中图像的混合上训练模型。更准确地说,不是在原始图像上训练模型,而是取两张图像(可以是同一类别,也可以不是),并使用它们的线性组合进行训练:
mixup_image = t × image 1 +(1 -t ) × image 2 ,
其中 \(t\) 是 0 到 1 之间的实数。该 mixup 图像的目标是使用相同 \(t\) 值获得的原始目标的组合:
mixup_target = t × target 1 +(1 -t ) × target 2 .
在 ImageNet-2012、CIFAR-10 和其他几个数据集上的实验9表明,mixup 改善了神经网络模型的泛化。mixup 的作者还发现,它提高了对对抗样本(adversarial examples)的鲁棒性,并稳定了生成对抗网络(generative adversarial networks,GANs)的训练。
除了图 14 中显示的技术之外,如果你预计生产系统中的输入图像会过度压缩,你可以通过使用一些常用的有损压缩方法和文件格式(如 JPEG 或 GIF)来模拟过度压缩。
只有训练数据会进行增强。当然,预先生成所有这些额外的示例并存储它们是不切实际的。在实践中,数据增强技术在训练期间即时应用于原始数据。
3.8.2 文本数据增强
说到文本数据增强,它就不那么直接了。我们需要使用适当的变换技术来保留自然语言文本的上下文和语法结构。
一种技术涉及将句子中的随机单词替换为其近义词(close synonyms)。对于句子「The car stopped near a shopping mall.」一些等效的句子是:
「The automobile stopped near a shopping mall.」
「The car stopped near a shopping center.」
「The auto stopped near a mall.」
类似的技术使用上位词(hypernyms)而不是同义词。上位词是含义更一般的词。例如,「哺乳动物」是「鲸鱼」和「猫」的上位词;「车辆」是「汽车」和「公共汽车」的上位词。从我们上面的例子中,我们可以创建以下句子:
「The vehicle stopped near a shopping mall.」
「The car stopped near a building.」
如果你使用词嵌入或文档嵌入(document embeddings)来表示数据集中的单词或文档,你可以对随机选择的嵌入特征施加轻微的高斯噪声,以生成同一单词或文档的变体。你可以通过优化验证数据上的性能,将要修改的特征数量和噪声强度作为超参数进行调整。
或者,要替换句子中的给定单词 \(w\),你可以在词嵌入空间中找到单词 \(w\) 的 \(k\) 个最近邻,并通过将单词 \(w\) 替换为其相应的邻居来生成 \(k\) 个新句子。可以使用余弦相似度(cosine similarity)或欧氏距离等度量来找到最近邻。度量的选择和 \(k\) 的值可以作为超参数进行调整。
上述 \(k\) 近邻方法的现代替代方案是使用深度预训练模型,如来自 Transformer 的双向编码器表示(Bidirectional Encoder Representations from Transformers,BERT)。像 BERT 这样的模型被训练为根据句子中的其他单词预测被掩蔽的单词。可以使用 BERT 为被掩蔽的单词生成 \(k\) 个最可能的预测,然后将它们用作数据增强的同义词。
类似地,如果你的问题是文档分类,并且你有大量未标注文档的语料库,但只有少量已标注文档的语料库,你可以这样做。首先,为你的大型语料库中的所有文档构建文档嵌入。使用 doc2vec 或任何其他文档嵌入技术。然后,对于数据集中的每个已标注文档 \(d\),在文档嵌入空间中找到 \(k\) 个最近的未标注文档,并用与 \(d\) 相同的标签标注它们。同样,在验证数据上调整 \(k\)。
另一种有用的文本数据增强技术是反向翻译(back translation)。要从英文文本(可以是一个句子或一篇文档)创建新示例,首先使用机器翻译系统将其翻译成另一种语言 \(l\)。然后将其从 \(l\) 翻译回英文。如果通过反向翻译获得的文本与原始文本不同,你将其添加到数据集中,并分配与原始文本相同的标签。
还有其他数据类型的数据增强技术,如音频和视频:添加噪声、在时间上平移音频或视频片段、减慢或加速、改变音频的音高和视频的色彩平衡,仅举几例。详细描述这些技术超出了本书的范围。你只需要知道数据增强可以应用于任何媒体数据,而不仅仅是图像和文本。
3.9 处理不平衡数据
类别不平衡(class imbalance)是数据中的一种状况,无论选择哪种学习算法,它都会显著影响模型的性能。问题在于训练数据中标签的分布非常不均匀。
例如,当你的分类器必须区分真实电子商务交易和欺诈交易时,就是这种情况:真实交易的示例要频繁得多。通常,机器学习算法试图正确分类大多数训练示例。算法之所以这样做,是因为它需要最小化一个成本函数,该函数通常为每个错误分类的示例分配一个正的损失值。如果少数类示例的错误分类损失与多数类示例的错误分类损失相同,那么学习算法很可能会决定「放弃」许多少数类示例,以便在多数类中少犯错误。
虽然没有不平衡数据的正式定义,但请考虑以下经验法则。如果有两个类别,那么平衡的数据意味着数据集中一半代表每个类别。轻微的类别不平衡通常不是问题。因此,如果 60% 的示例属于一个类别,40% 属于另一个类别,并且你使用其标准形式的热门机器学习算法,它不应该造成任何显著的性能下降。然而,当类别不平衡严重时,例如 90% 的示例属于一个类别,10% 属于另一个类别,使用通常同等加权两个类别错误的算法标准形式可能不会那么有效,需要修改。
3.9.1 过采样
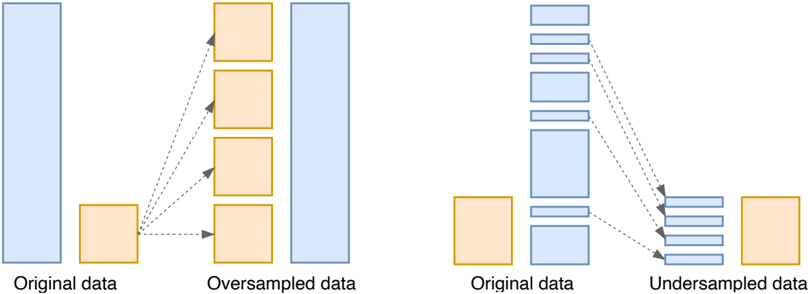
经常用于缓解类别不平衡的技术是过采样(oversampling)。通过制作少数类示例的多个副本,它增加了它们的权重,如图 15a 所示。你还可以通过采样少数类的几个示例的特征值并组合它们来获得该类的新示例,从而创建合成示例。两种通过对少数类创建合成示例来过采样的流行算法:合成少数类过采样技术(Synthetic Minority Oversampling Technique,SMOTE)和自适应合成抽样方法(Adaptive Synthetic Sampling Method,ADASYN)。
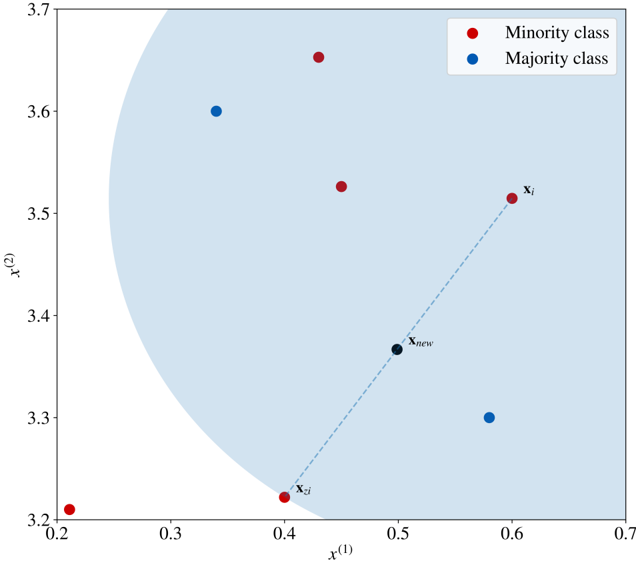
SMOTE 和 ADASYN 在许多方面的工作方式相似。对于少数类的给定示例 \(x_i\),它们选择 \(k\) 个最近邻。让我们将这 \(k\) 个示例的集合记为 \(S_k\)。合成示例 \(x_{new}\) 定义为 \(x_i + \lambda (x_{z_i} - x_i)\),其中 \(x_{z_i}\) 是从 \(S_k\) 中随机选择的少数类示例。插值超参数 \(\lambda\) 是 [0, 1] 范围内的任意数字。(参见图 16 中 \(\lambda = 0.5\) 的图示。)
SMOTE 和 ADASYN 都会在数据集中所有可能的 \(x_i\) 中随机选择。在 ADASYN 中,为每个 \(x_i\) 生成的合成示例数量与 \(S_k\) 中不属于少数类的示例数量成正比。因此,在少数类示例稀少的区域会生成更多的合成示例。
图 15:欠采样(左)和过采样(右)。
3.9.2 欠采样
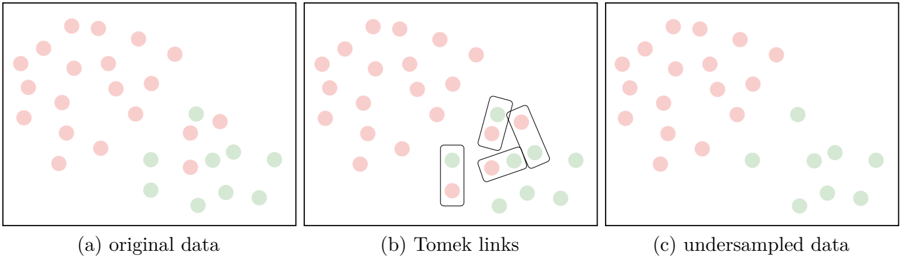
相反的方法,欠采样(undersampling),是从训练集中移除一些多数类示例(图 15b)。
欠采样可以随机进行;也就是说,要从多数类中移除的示例可以随机选择。或者,要从多数类中撤出的示例可以根据某个属性来选择。其中一个属性是 Tomek 链接(Tomek links)。如果数据集中没有其他示例 \(x_k\) 比 \(x_i\) 和 \(x_j\) 彼此更接近其中任何一个,那么属于两个不同类别的两个示例 \(x_i\) 和 \(x_j\) 之间存在 Tomek 链接。可以使用余弦相似度或欧氏距离等度量来定义接近程度。
在图 17 中,你可以看到基于 Tomek 链接从多数类中移除示例如何有助于在两个类别的示例之间建立清晰的边界。
基于聚类的欠采样(cluster-based undersampling)工作原理如下。决定欠采样后你希望在多数类中拥有的示例数量。让该数量为 \(k\)。仅在多数类示例上运行基于质心的聚类算法,\(k\) 是所需的聚类数量。然后将多数类中的所有示例替换为 \(k\) 个质心。基于质心的聚类算法的一个例子是 \(k\) 近邻(k-nearest neighbors)。
3.9.3 混合策略
你可以开发自己的混合策略(通过组合过采样和欠采样),并可能获得更好的结果。一种这样的策略包括使用 ADASYN 进行过采样,然后使用 Tomek 链接进行欠采样。
另一种可能的策略包括将基于聚类的欠采样与 SMOTE 相结合。
图 16:SMOTE 和 ADASYN 合成示例生成的图示。(使用改编自 Guillaume Lemaitre 的脚本构建。)
3.10 数据抽样策略
当你拥有大型数据资产(所谓的大数据)时,处理整个数据资产并不总是实际或必要的。相反,你可以抽取一个包含足够学习信息的较小数据样本。
同样,当你对多数类进行欠采样以调整数据不平衡时,较小的数据样本应能代表整个多数类。在本节中,我们讨论几种抽样策略、它们的属性、优点和缺点。
有两种主要策略:概率抽样(probability sampling)和非概率抽样(nonprobability sampling)。在概率抽样中,所有示例都有机会被选中。这些技术涉及随机性。
非概率抽样不是随机的。为了构建样本,它遵循固定的确定性启发式动作序列。这意味着无论你构建多少样本,一些示例都没有机会被选中。
图 17:使用 Tomek 链接进行欠采样。
从历史上看,非概率方法对人工手动执行来说更易于管理。如今,这一优势已不显著。数据分析师使用计算机和软件,极大地简化了抽样,即使是从大数据中抽样也是如此。非概率抽样方法的主要缺点是它们包含非代表性样本,并且可能系统地排除重要示例。这些缺点超过了非概率抽样方法的可能优势。因此,在本书中我将只介绍概率抽样方法。
3.10.1 简单随机抽样
简单随机抽样(simple random sampling)是最直接的方法,也是我说「随机抽样」时所指的方法。在这里,整个数据集中的每个示例都是纯粹凭机会选择的;每个示例都有相等的机会被选中。
获得简单随机样本的一种方法是为每个示例分配一个数字,然后使用随机数生成器决定选择哪些示例。例如,如果你的整个数据集包含 1000 个示例,编号从 0 到 999,请使用随机数生成器的三位数字组来选择示例。因此,如果随机数生成器的前三个数字是 0、5 和 7,选择编号为 57 的示例,依此类推。
简单性是这种抽样方法的一大优势,它很容易实现,因为任何编程语言都可以充当随机数生成器。简单随机抽样的一个缺点是,你可能无法选择足够多具有特定感兴趣属性的示例。考虑从大型不平衡数据集中抽取样本的情况。这样做时,你可能会意外地无法捕获足够多的少数类示例——或者根本无法捕获。
3.10.2 系统抽样
要实现系统抽样(systematic sampling,也称为间隔抽样,interval sampling),你创建一个包含所有示例的列表。从该列表中,你从列表的前 \(k\) 个元素中随机选择第一个示例 \(x_{start}\)。然后,从 \(x_{start}\) 开始,你选择列表中每第 \(k\) 个项目。你选择这样的 \(k\) 值,使你能获得所需大小的样本。
系统抽样相对于简单随机抽样的一个优势是,它从整个值范围中抽取示例。然而,如果示例列表具有周期性或重复模式,系统抽样就不合适。在后一种情况下,获得的样本可能表现出偏差。然而,如果示例列表是随机化的,那么系统抽样通常会产生比简单随机抽样更好的样本。
3.10.3 分层抽样
如果你知道数据中存在几个组(例如,性别、位置或年龄),你的样本中应该有来自每个组的示例。在分层抽样(stratified sampling)中,你首先将数据集划分为组(称为层,strata),然后像简单随机抽样一样从每个层中随机选择示例。从每个层中选择的示例数量与该层的大小成比例。
分层抽样通常通过减少偏差来提高样本的代表性;在最坏的情况下,所得样本的质量不低于简单随机抽样的结果。然而,要定义层,分析师必须理解数据集的属性。此外,可能很难决定哪些属性将定义层。
如果你不知道如何最好地定义层,你可以使用聚类(clustering)。你唯一需要做的决定是需要多少个聚类。这种技术对于选择发送给人工标注者进行标注的未标注示例也很有用。通常,我们有数百万个未标注示例,而可用于标注的资源很少。仔细选择示例,以便每个层或聚类都在我们的标注数据中得到代表。
由于处理多个独立层的额外开销,分层抽样是三种方法中最慢的。然而,它产生偏差较小样本的潜在好处通常超过其缺点。
3.11 存储数据
保证数据安全是组织业务的保险:如果你因任何原因(如灾难或人为错误——包含模型的文件被意外删除或覆盖)丢失了业务关键模型,拥有数据将允许你轻松重建该模型。
当敏感数据或个人身份信息(PII)由客户或业务合作伙伴提供时,它必须存储在一个不仅安全而且可靠的位置。与 DBA 或 DevOps 工程师一起,敏感数据的访问可以通过用户名(如果需要,还可以通过 IP 地址)来限制。对关系数据库的访问也可以按行和按列进行限制。
还建议将访问限制为只读和只追加操作,将写入和擦除操作限制给特定用户。
如果数据是在移动设备上收集的,可能有必要将数据存储在移动设备上,直到所有者连接到 wifi。这些数据可能需要加密,以便其他应用程序无法访问。一旦用户连接到 wifi,数据必须使用加密协议(如传输层安全(Transport Layer Security,TLS))与安全服务器同步。移动设备上的每个数据元素都必须标记时间戳,以便与服务器上的数据正确同步。
3.11.1 数据格式
用于机器学习的数据可以以各种格式存储。间接使用的数据,如字典或地名录,可以存储在关系数据库的表中、键值存储的集合中或结构化文本文件中。
整洁数据通常存储为逗号分隔值(comma-separated values,CSV)或制表符分隔值(tab-separated values,TSV)文件。在这种情况下,所有示例都存储在一个文件中。或者,XML(可扩展标记语言,Extensible Markup Language)文件或 JSON(JavaScript 对象表示法,JavaScript Object Notation)文件的集合可以每文件包含一个示例。
除了通用格式之外,某些流行的机器学习包使用专有数据格式来存储整洁数据。其他机器学习包通常提供一个或多个此类专有数据格式的应用程序编程接口(application programming interfaces,APIs)。最常支持的格式是 ARFF(属性关系文件格式,Attribute-Relation File Format,用于 Weka 机器学习包)和 LIBSVM(支持向量机库,Library for Support Vector Machines)格式,这是 LIBSVM 和 LIBLINEAR(大规模线性分类库,Library for Large Linear Classification)机器学习库使用的默认格式。
LIBSVM 格式的数据由一个包含所有示例的文件组成。该文件的每一行使用以下格式表示一个带标签的特征向量:
label index1:value1 index2:value2 ...
其中 index X:value Y 指定位置(维度)X 处特征的值为 Y。如果某个位置的值是零,可以省略。这种数据格式对于由大多数特征值为零的示例组成的稀疏数据特别方便。
此外,不同的编程语言带有数据序列化(serialization)功能。特定机器学习包的数据可以使用编程语言或库提供的序列化对象或函数持久化到硬盘上。需要时,数据可以反序列化为其原始形式。例如,在 Python 中,一个流行的通用序列化模块是 Pickle;R 有内置的 saveRDS 和 readRDS 函数。不同的数据分析包也可以提供自己的序列化/反序列化工具。
在 Java 中,任何实现 java.io.Serializable 接口的对象都可以被序列化到文件中,并在需要时反序列化。
3.11.2 数据存储层级
在决定如何以及在哪里存储数据之前,选择适当的存储层级(storage level)至关重要。存储可以组织在不同的抽象层级:从最低层级的文件系统,到最高层级(如数据湖)。
文件系统(filesystem)是存储的基础层级。该层级数据的基本单位是文件(file)。文件可以是文本或二进制,没有版本管理,并且很容易被擦除或覆盖。
文件系统可以是本地的或网络的。网络文件系统可以简单,也可以分布式。
本地文件系统可以简单到是一个包含机器学习项目所需所有文件的本地挂载磁盘。
分布式文件系统(distributed filesystem),如 NFS(网络文件系统,Network File System)、CephFS(Ceph 文件系统,Ceph File System)或 HDFS,可以由多台物理或虚拟机通过网络访问。分布式文件系统中的文件存储在多台机器上,并通过网络访问。
尽管它很简单,但文件系统级存储适用于许多用例,包括:
文件共享
文件系统级存储的简单性和对标准协议的支持,使你可以以最小的努力与一小群同事存储和共享数据。
本地归档
得益于横向扩展 NAS 解决方案的可用性和可访问性,文件系统级存储是数据归档的经济高效的选择。
数据保护
得益于内置的冗余和复制,文件系统级存储是一个可行的数据保护解决方案。
在文件系统级别对数据的并行访问,检索访问很快,但存储较慢,因此它适用于较小的团队和数据。
对象存储(object storage)是定义在文件系统之上的应用程序编程接口(API)。使用 API,你可以以编程方式对文件执行 GET、PUT 或 DELETE 等操作,而无需担心文件实际存储在哪里。该 API 通常由网络上可用的 API 服务提供,可通过 HTTP 或更一般地通过 TCP/IP 或其他通信协议套件访问。
对象存储层级数据的基本单位是对象(object)。对象通常是二进制的:图像、声音或视频文件,以及具有特定格式的其他数据元素。
版本管理和冗余等功能可以内置到 API 服务中。对存储在对象存储层级的数据的访问通常可以并行进行,但访问不如文件系统层级快。
对象存储的典型例子是 Amazon S3 和 Google Cloud Storage(GCS)。另外,Ceph 是一个存储平台,在单个分布式计算机集群上实现对象存储,并为对象存储和文件系统级存储提供接口。它通常被用作本地(on-premises)计算系统中 S3 和 GCS 的替代品。
数据库(database)层级的数据存储允许对结构化数据进行持久、快速和可扩展的存储,并支持存储和检索的快速并行访问。
现代数据库管理系统(database management system,DBMS)将数据存储在随机存取存储器(random-access memory,RAM)中,但软件确保数据被持久化(并且对数据的操作被记录日志)到磁盘并且永远不会丢失。
该层级数据的基本单位是行(row)。一行有唯一的 ID,并在列中包含值。在关系数据库中,行被组织在表(tables)中。行可以引用同一表或不同表中的其他行。
数据库并不特别适合存储二进制数据,尽管相当小的二进制对象有时可以以 blob(二进制大对象,Binary Large OBject)的形式存储在列中。Blob 是作为单个实体存储的二进制数据集合。然而,更常见的是,行存储对其他位置(文件系统或对象存储中)的二进制对象的引用。
行业中最常用的四种 DBMS 是 Oracle、MySQL、Microsoft SQL Server 和 PostgresSQL。它们都支持 SQL(结构化查询语言,Structured Query Language),这是一种用于访问和修改存储在数据库中的数据以及创建、修改和擦除数据库的接口。10
数据湖(data lake)是以其自然或原始格式存储的数据存储库,通常以对象 blob 或文件的形式。数据湖通常是从多个来源(包括数据库、日志或因原始数据的昂贵转换而获得的中间数据)进行非结构化聚合的结果。
数据以原始格式保存在数据湖中,包括结构化数据。要从数据湖读取数据,分析师需要编写读取和解析存储在文件或 blob 中的数据的编程代码。编写脚本来解析数据文件或 blob 是一种称为读时模式(schema on read)的方法,与 DBMS 中的写时模式(schema on write)相反。在 DBMS 中,数据的模式是预先定义的,每次写入时,DBMS 都会确保数据与模式一致。
3.11.3 数据版本管理
如果数据在多个地方保存和更新,你可能需要跟踪版本。当你通过收集更多数据(尤其是以自动化方式)频繁更新模型时,也需要对数据进行版本管理。例如,当你在做自动驾驶、垃圾邮件检测或个性化推荐时,就会发生这种情况。新数据来自驾驶汽车的人、清理电子邮件的用户或最近的视频流。有时,在数据更新之后,新模型的表现更差,你希望通过在数据的一个版本和另一个版本之间切换来调查原因。
当标注由多个标注者完成时,数据版本管理在监督学习中也至关重要。一些标注者可能为相似的示例分配非常不同的标签,这通常会损害模型的性能。你会希望将不同标注者标注的示例分开保存,并且只在构建模型时才合并它们。对模型性能的仔细分析可能会表明,标注者没有提供高质量或一致的标签。将此类数据从训练数据中排除,或重新标注,数据版本管理将使这以最小的努力实现。
数据版本管理可以在几个复杂层级实现,从最基本的到最精细的。
第 0 级:数据无版本管理。
在此级别,数据可以驻留在本地文件系统、对象存储或数据库中。拥有无版本管理数据的好处是处理数据的速度和简单性。尽管如此,这个好处被你在模型工作时可能遇到的潜在问题所抵消。很可能,你的第一个问题将是无法进行版本化的部署。正如我们将在第 8 章讨论的,模型部署必须是版本化的。部署的机器学习模型是代码和数据的混合体。如果代码有版本管理,数据也必须如此。否则,部署将是无版本管理的。
如果你不对部署进行版本管理,那么在模型出现任何问题时,你将无法回到之前的性能水平。因此,不建议使用无版本管理的数据。
第 1 级:数据在训练时作为快照进行版本管理。
在此级别,通过在训练时存储训练模型所需的一切的快照来对数据进行版本管理。这种方法允许你对部署的模型进行版本管理,并回到过去的性能。你应该在某个文档(通常是 Excel 电子表格)中跟踪每个版本。该文档应描述代码和数据快照的位置、超参数值以及必要时重现实验所需的其他元数据。如果你没有很多模型并且不频繁更新它们,这个版本的版本管理可能是一个可行的策略。否则,不建议这样做。
第 2 级:数据和代码作为一个资产进行版本管理。
在此版本管理级别,小型数据资产,如字典、地名录和小型数据集,与代码一起存储在版本控制系统(如 Git 或 Mercurial)中。大文件存储在对象存储(如 S3 或 GCS)中,并带有唯一 ID。训练数据存储为 JSON、XML 或其他标准格式,并包括相关元数据,如标签、标注者身份、标注时间、用于标注数据的工具等等。
像 Git 大文件存储(Large File Storage,LFS)这样的工具会自动用文本指针替换大文件(如音频样本、视频、大型数据集和图形),同时将文件内容存储在远程服务器上。
数据集的版本由代码和数据文件的 git 签名定义。添加时间戳以轻松识别所需版本也可能有所帮助。
- 第 3 级:使用或构建专门的数据版本管理解决方案。
像 DVC 和 Pachyderm 这样的数据版本管理软件为数据版本管理提供了额外的工具。它们通常与 Git 等代码版本管理软件互操作。
对于大多数项目,第 2 级版本管理是推荐的实现版本管理的方式。如果你觉得第 2 级不足以满足你的需求,请探索第 3 级解决方案,或考虑构建自己的解决方案。否则,不建议采用这种方法,因为它会给本已复杂的工程项目增加复杂性。
3.11.4 文档和元数据
当你在积极从事机器学习项目时,你通常能够记住有关数据的重要细节。然而,一旦项目投入生产,你转向另一个项目,这些信息最终会变得不那么详细。
在转向另一个项目之前,你应该确保其他人能够理解你的数据并正确使用它。
如果数据是不言自明的,那么你可以不为其编写文档。然而,没有创建数据集的人仅通过查看它就能轻松理解它并知道如何使用它,这种情况相当罕见。
文档必须伴随任何用于训练模型的数据资产。该文档必须包含以下细节:
- 数据意味着什么,
- 它是如何收集的,或创建它所使用的方法(给标注者的说明和质量控制方法),
- 训练-验证-测试划分的细节,
- 所有预处理步骤的细节,
- 对任何被排除数据的解释,
- 用于存储数据的格式,
- 属性或特征的类型(每个属性或特征允许哪些值),
- 示例数量,
- 标签的可能值或数值目标的允许范围。
3.11.5 数据生命周期
一些数据可以无限期存储。然而,在某些业务环境中,你可能只允许将某些数据存储特定时间,然后可能必须擦除它。如果此类限制适用于你处理的数据,你必须确保有可靠的警报系统。该警报系统必须联系负责数据擦除的人,并且有一个备份计划,以防那个人不可用。别忘了,不擦除数据的后果有时对组织来说可能非常严重。
对于每个敏感数据资产,数据生命周期文档必须描述该资产、在项目开发期间和之后有权访问该数据资产的人员圈子。该文档必须描述数据资产将被存储多长时间,以及是否必须被明确销毁。
3.12 数据操作最佳实践
为结束本章,我们考虑两个剩余的最佳实践:可复现性(reproducibility)和「数据优先,算法其次」(data first, algorithm second)。
3.12.1 可复现性
可复现性应该是你所做的一切中的重要关注点,包括数据收集和准备。你应该避免手动转换数据,或使用文本编辑器或命令行 shell 中包含的强大工具,如正则表达式、「快速而粗糙」的临时 awk 或 sed 命令,以及管道表达式。
通常,数据收集和转换活动由多个阶段组成。这些包括从 Web API 或数据库下载数据、用唯一标记替换多词表达、移除停用词(stop-words)和噪声、裁剪和去模糊图像、插补缺失值等等。这个多阶段过程中的每一步都必须实现为软件脚本,如 Python 或 R 脚本,并带有其输入和输出。如果你以这种方式组织工作,它将允许你跟踪数据中的所有变化。如果在任何阶段数据发生了错误,你总是可以修复脚本并从零开始运行整个数据处理流水线。
另一方面,手动干预很难复现。它们难以应用于更新的数据,或难以扩展到更多的数据(一旦你有能力获得更多数据或不同的数据集)。
3.12.2 数据优先,算法其次
请记住,在工业界,与学术界相反,「数据优先,算法其次」,所以把你的大部分精力和时间集中在获得更多种类多样、质量高的数据上,而不是试图从学习算法中榨取最大值。
数据增强,如果实现得好,很可能比寻找最佳超参数值或模型架构对模型质量的贡献更大。
3.13 总结
在开始收集数据之前,有五个问题需要回答:你将处理的数据是否可获取、足够大、可用、可理解且可靠。
数据的常见问题是高成本、偏差、预测能力低、示例过时、离群值和泄漏。
好数据包含足够多的可用于建模的信息,对你想要用模型做什么具有良好的覆盖,并反映模型在生产中将要看到的真实输入。它尽可能无偏差,不是模型本身的结果,有一致的标签,并且足够大以允许泛化。
好的交互数据包含三个方面的信息:交互的上下文、用户在该上下文中的行为,以及交互的结果。
要获得将整个数据集划分为训练集、验证集和测试集的良好划分,划分过程必须满足几个条件:1)划分前数据已随机化,2)划分应用于原始数据,3)验证集和测试集遵循相同的分布,4)避免了泄漏。
数据插补技术可以用来处理数据中的缺失属性。
数据增强技术通常用于在没有额外人工标注的情况下获得更多带标签的示例。这些技术通常适用于图像数据,但也可以应用于文本和其他类型的感知数据。
类别不平衡可以显著影响模型的性能。当训练数据遭受类别不平衡时,学习算法的表现是次优的。过采样和欠采样等技术可以帮助克服类别不平衡问题。
当你处理大数据时,处理整个数据资产并不总是实际和必要的。相反,抽取一个包含足够学习信息的较小数据样本。不同的数据抽样策略可以用于此目的,特别是简单随机抽样、系统抽样、分层抽样和整群抽样(cluster sampling)。
数据可以以不同的数据格式存储在几个数据存储层级上。当标注由多个标注者完成时,数据版本管理是监督学习中的关键元素。不同的标注者可能提供不同质量的标签,因此跟踪谁创建了哪个带标签的示例很重要。数据版本管理可以在几个复杂层级实现,从最基本的到最精细的:无版本管理(第 0 级)、在训练时作为快照进行版本管理(第 1 级)、作为包含数据和代码的一个资产进行版本管理(第 2 级),以及通过使用或构建专门的数据版本管理解决方案进行版本管理(第 3 级)。
大多数项目推荐使用第 2 级。
文档必须伴随任何用于训练模型的数据资产。该文档必须包含以下细节:数据意味着什么、它是如何收集的或创建它所使用的方法(给标注者的说明和质量控制方法)、训练-验证-测试划分的细节以及所有预处理步骤。它还必须包含对任何被排除数据的解释、用于存储数据的格式、属性或特征的类型、示例数量,以及标签的可能值或数值目标的允许范围。
对于每个敏感数据资产,数据生命周期文档必须描述该资产、在项目开发期间和之后有权访问该数据资产的人员圈子。
一个说明性的例子是 Twitter 的内容再分发政策。该政策限制分享除推文 ID 和用户 ID 之外的推文信息。Twitter 希望分析师始终通过 Twitter API 拉取最新数据。对这种限制的一种可能解释是:有些用户可能因为改变了主意或觉得推文过于有争议而想删除某条推文。如果该推文已被拉取并在公共领域分享,则可能使用户处于易受攻击的境地。 ↩︎
别忘了,在你的估计中,你不仅需要训练数据,还需要保留数据(holdout data)来验证模型在未训练过的样本上的性能。该保留数据也必须足够大,才能在统计意义上提供可靠的模型质量估计。 ↩︎
这就是为什么它被称为「噪声」预标注:使用次优模型为示例分配的标签并非全部准确,需要人工验证。 ↩︎
顺便说一句,这正是深度学习中 dropout 正则化技术带来性能提升的原因。 ↩︎
自编码器模型被训练为从嵌入向量重构其输入。自编码器的超参数被调优以最小化保留数据上的重构误差。 ↩︎
回想我们在 3.1 节中考虑的 Mechanical Turk 示例。为了提高不同人分配的标签的可靠性,可以使用多个标注者的多数投票(或平均值)。 ↩︎
你的原始数据集包含在 Excel 电子表格中这一事实并不能保证数据是整洁的。整洁性的一个属性是每行代表一个示例。 ↩︎
除非上下文(如草地)使水平轴翻转变得无关紧要。 ↩︎
关于 mixup 技术的更多细节可以在 Zhang、Hongyi、Moustapha Cisse、Yann N. Dauphin 和 David Lopez-Paz 的《mixup: Beyond empirical risk minimization》中找到。arXiv 预印本 arXiv:1710.09412(2017)。 ↩︎
SQL Server 使用其专有的 Transact SQL(T-SQL),而 Oracle 使用过程化语言 SQL(Procedural Language SQL,PL/SQL)。 ↩︎