机器学习的人性化一面
在整本书中,我们涵盖了设计 ML 系统的许多技术层面。然而,ML 系统不仅仅是技术性的。它们涉及业务决策者、用户,当然还有系统的开发者。我们在第 1 章和第 2 章中讨论了利益相关者及其目标。在本章中,我们将讨论 ML 系统的用户和开发者如何与这些系统互动。
我们首先探讨 ML 模型固有的概率特性会如何改变和影响用户体验。接着,我们将讨论什么样的组织结构能让同一个 ML 系统的不同开发者高效地协同工作。在本章结尾,我们将在「责任 AI(Responsible AI)」一节(第 339 页)中讨论 ML 系统会如何影响整个社会。
用户体验
我们已经详细讨论过 ML 系统与传统软件系统的行为差异。首先,ML 系统是概率性的(probabilistic)而不是确定性的(deterministic)。通常,如果你在不同时间对相同的输入运行两次相同的软件,你会得到相同的结果。然而,如果你在不同时间对完全相同的输入运行两次相同的 ML 系统,你可能会得到不同的结果。¹ 其次,由于这种概率特性,ML 系统的预测大多是正确的,而难点在于我们通常不知道系统会对哪些输入给出正确结果!第三,ML 系统可能规模很大,生成预测所需的时间可能出人意料地长。
这些差异意味着 ML 系统会以不同的方式影响用户体验,尤其是对一直习惯于传统软件的用户。由于 ML 在现实世界中的应用还相对较新,ML 系统如何影响用户体验仍缺乏充分的研究。在本节中,我们将讨论 ML 系统对良好用户体验构成的三个挑战,以及如何应对这些挑战。
¹ 有时,即使你在完全相同的时间对相同输入运行两次相同的模型,也可能得到不同的结果。
确保用户体验的一致性
在使用应用程序或网站时,用户期望一定程度的连贯性。例如,我已经习惯了 Chrome 在 MacBook 上把「最小化」按钮放在左上角。如果 Chrome 把这个按钮移到右边,我会感到困惑,甚至沮丧。
ML 预测是概率性的、不连贯的,这意味着今天为某个用户生成的预测,可能会与第二天为同一用户生成的预测不同,具体取决于预测所处的上下文。对于想借助 ML 改善用户体验的任务来说,ML 预测的不一致性可能成为障碍。
为了把问题说得更具体,我们来看 Booking.com 在 2020 年发布的一个案例研究。当你在 Booking.com 预订住宿时,大约有 200 个筛选条件可供你指定偏好,例如「含早餐」「允许携带宠物」「无烟房」等。筛选条件如此之多,用户需要花时间才能找到自己想要的筛选条件。Booking.com 的应用 ML 团队希望用 ML 根据用户在某个浏览会话中使用过的筛选条件,自动推荐用户可能想要的筛选条件。
他们遇到的挑战是:如果 ML 模型每次都推荐不同的筛选条件,用户可能会感到困惑,尤其是当他们找不到以前已经应用过的筛选条件时。该团队通过制定规则解决了这一挑战:规则规定了系统在哪些条件下必须返回相同的筛选条件推荐(例如,当用户已经应用了一个筛选条件时),以及在哪些条件下系统可以返回新的推荐(例如,当用户更改目的地时)。这被称为一致性-准确率权衡(consistency-accuracy trade-off),因为系统认为最准确的推荐,未必是能给用户带来一致体验的推荐。
应对「大部分正确」的预测
在上一节中,我们讨论了确保模型预测一致性的重要性。在本节中,我们将讨论在某些情况下,我们反而希望模型的预测少一些一致性、多一些多样性。
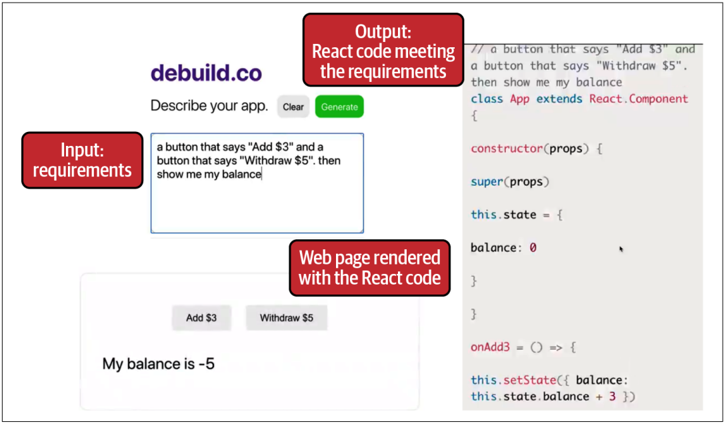
自 2018 年以来,大语言模型(large language model)GPT 及其后继者 GPT-2 和 GPT-3 风靡全球。这些大语言模型的一个优势是:它们能够为广泛的任务生成预测,而几乎不需要特定任务的训练数据。例如,你可以把网页的需求描述作为模型输入,它会输出创建该网页所需的 React 代码,如图 11-1 所示。
图 11-1. GPT-3 可以帮助你为网站编写代码。来源:改编自 Sharif Shameem 的一段视频截图
然而,这些模型的一个缺点是预测并不总是正确的,而且在特定任务数据上微调(fine-tune)它们以改进预测非常昂贵。对于能够轻松纠正这些预测的用户来说,「大部分正确」的预测很有用。例如,在客户支持场景中,对于每个客户请求,ML 系统可以生成大体正确的回复,人工客服可以快速修改这些回复。与从头撰写回复相比,这可以加快响应速度。
然而,如果用户不知道如何纠正或无法纠正这些回复,「大部分正确」的预测就不会有多大用处。以使用语言模型为网页生成 React 代码这一任务为例。生成的代码可能无法运行;即使能运行,渲染出的网页也可能不满足指定的需求。React 工程师也许能快速修复这段代码,但这个应用的许多用户可能并不懂 React。而且这个应用吸引的可能正是大量不懂 React 的用户——他们当初需要这个应用,正是因为自己不会写 React!
为了克服这一点,一种做法是向用户展示同一输入的多个预测结果,以增加其中至少一个正确的概率。这些预测应该以即使非专业用户也能评估的方式呈现。在这个例子中,给定用户输入的一组需求,你可以让模型生成多段 React 代码,并将这些代码片段渲染成可视化的网页,让非工程背景的用户能够评估哪一版最适合自己。
这种方法非常常见,有时被称为「人在回路」(human-in-the-loop)AI,因为它需要人来挑选最佳预测或改进机器生成的预测。对人在回路 AI 感兴趣的读者,我强烈推荐 Jessy Lin 的《Rethinking Human-AI Interaction》(重新思考人机交互)。
平滑降级
在第 15 页的「计算优先级(Computational priorities)」一节中,我们已经详细讨论了 ML 模型的推理延迟(inference latency)对用户体验的影响。在第 206 页的「模型压缩(Model Compression)」一节中,我们也讨论了如何压缩模型并针对更快的推理速度进行优化。然而,平时很快的模型在处理某些查询时仍可能很慢。这在处理序列数据的模型中尤为常见,例如语言模型或时间序列模型——比如,模型处理长序列比处理短序列耗时更长。对于模型响应过慢的查询,我们应该怎么办?
与我合作过的一些公司使用备用系统:它不如主系统那样最优,但保证能快速生成预测。这些系统可以是启发式规则(heuristics)或简单模型,甚至可以是缓存的预计算结果。这意味着你可以制定一条规则:如果主模型生成预测的时间超过 X 毫秒,就改用备用模型。有些公司不用这种简单规则,而是训练另一个模型来预测主模型对给定查询生成预测所需的时间,然后据此把查询路由到主模型或备用模型。当然,这个额外增加的模型也可能给系统带来额外的推理延迟。
这与速度-准确率权衡(speed-accuracy trade-off)有关:一个模型的性能可能不如另一个模型,但推理速度快得多。这个次优但快速的模型可能会给用户更差的预测,但在延迟至关重要的场景中仍可能更受青睐。许多公司不得不在多个模型之间二选一,而有了备用系统,你可以两者兼得。
团队结构
一个 ML 项目不仅涉及数据科学家(data scientist)和 ML 工程师,还涉及其他类型的工程师,如 DevOps 工程师和平台工程师,以及领域专家(subject matter expert,SME)等非开发者的利益相关者。面对如此多样的利益相关者,问题是如何组织 ML 团队才能达到最优结构。我们将聚焦两个方面:跨职能团队协作,以及备受争议的端到端数据科学家角色。
跨职能团队协作
领域专家(医生、律师、银行家、农民、造型师等)在 ML 系统设计中常常被忽视,但许多 ML 系统如果没有领域专业知识就无法正常工作。他们不仅是 ML 系统的用户,也是 ML 系统的开发者。
大多数人只在数据标注阶段才会想到领域专业知识——例如,你需要受过训练的专业人士来标注肺部 CT 扫描是否显示癌症迹象。然而,随着在线上环境中训练 ML 模型成为持续进行的过程,标注和重新标注也可能成为贯穿整个项目生命周期的持续过程。如果领域专家能参与生命周期的其余环节,ML 系统将受益匪浅,这些环节包括问题定义、特征工程、错误分析、模型评估、预测重排序,以及用户界面:如何最好地向用户和/或系统的其他部分呈现结果。
当多种不同背景的人共同参与一个项目时,会产生许多挑战。例如,你如何向可能没有工程或统计背景的领域专家解释 ML 算法的局限性和能力?要构建 ML 系统,我们希望一切都进行版本管理(versioning),但你如何把领域专业知识(例如「如果 X 和 Y 之间的这个区域有一个小圆点,那可能是癌症的迹象」)转化为代码并进行版本管理?
想让你的医生去用 Git,祝你好运。
在项目规划阶段尽早让领域专家参与进来很重要,并且要让他们能够自主做出贡献,而无需工程师费心为他们开通访问权限。例如,为了帮助领域专家更多地参与 ML 系统的开发,许多公司正在构建无代码/低代码(no-code/low-code)平台,让人们无需编写代码就能做出修改。目前,面向领域专家的无代码 ML 解决方案大多集中在标注、质量保证和反馈阶段,但更多平台正在开发中,以支持其他关键环节,例如数据集创建,以及调查需要领域专家输入的问题的视图。
端到端数据科学家
读完这本书,我希望我已经让你相信:ML 生产不仅仅是一个 ML 问题,也是一个基础设施(infrastructure)问题。要做好 MLOps,我们不仅需要 ML 专业知识,还需要运维(Ops,即运营操作)专业知识,尤其是在部署、容器化、任务编排和工作流管理方面。
为了把所有这些领域的专业知识引入 ML 项目,公司通常采用以下两种方法之一:设立一个独立团队来管理所有运维方面,或者让数据科学家加入团队并全流程负责。
让我们仔细看看这两种方法在实践中是如何运作的。
方法 1:由独立团队负责生产管理
在这种方法中,数据科学/ML 团队在开发环境中开发模型,然后由另一个独立团队(通常是运维/平台/ML 工程团队)将模型生产化(productionize)到生产环境。这种方法让招聘变得更容易,因为招聘只具备单一技能组合的人比招聘具备多种技能组合的人更容易。它也可能让每个参与者的工作更轻松,因为他们只需专注于一个关注点(例如开发模型或部署模型)。然而,这种方法有许多缺点:
沟通与协调开销
一个团队可能成为其他团队的阻碍者。正如 Frederick P. Brooks 所言:「一个程序员一个月能完成的工作,两个程序员需要两个月才能完成。」
调试难题
当出现故障时,你不知道是你们团队的代码还是其他团队的代码导致的。问题甚至可能根本不是你们公司的代码造成的。你需要多个团队协作才能查明问题所在。
相互推诿
即使你查明了问题出在哪里,每个团队可能都认为修复它是其他团队的责任。
视野狭窄
没有人能纵览整个流程来优化/改进它。例如,平台团队有改进基础设施的想法,但他们只能响应数据科学家的请求来行动;而数据科学家不需要处理基础设施,因此他们主动改进基础设施的动力不足。
方法 2:数据科学家全流程负责
在这种方法中,数据科学团队还得操心模型的线上化生产。数据科学家变成了「脾气暴躁的独角兽」(grumpy unicorns),被期望了解流程中的一切,最终他们写的样板代码(boilerplate code)可能比数据科学工作本身还多。
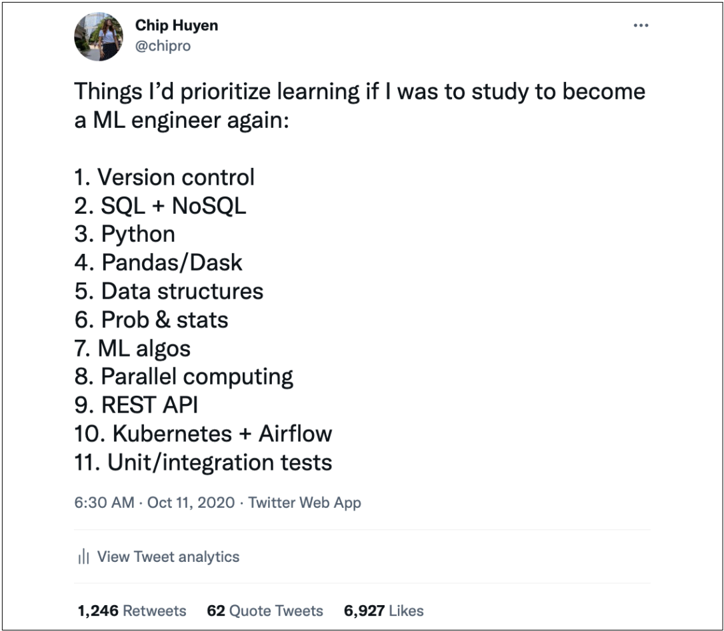
大约一年前,我在推特上发了一组我认为成为 ML 工程师或数据科学家所需的重要技能,如图 11-2 所示。这份清单几乎涵盖了工作流的每个部分:查询数据、建模、分布式训练和搭建端点(endpoint)。它甚至包括了 Kubernetes 和 Airflow 这样的工具。
图 11-2. 我曾经以为数据科学家需要掌握所有这些技能
这条推文似乎引起了读者的共鸣。Eugene Yan 也撰文论述「数据科学家应该更端到端」²。Stitch Fix 的首席算法官 Eric Colson(此前曾任 Netflix 数据科学与工程副总裁)写了一篇文章,讨论「全栈数据科学通才的力量,以及按职能分工的危险」³。
² Eugene Yan,《Unpopular Opinion—Data Scientists Should be More End-to-End》(少数派观点——数据科学家应该更端到端),EugeneYan.com,2020 年 8 月 9 日,https://oreil.ly/A6oPi。
³ Eric Colson,《Beware the Data Science Pin Factory: The Power of the Full-Stack Data Science Generalist and the Perils of Division of Labor Through Function》(警惕数据科学针厂:全栈数据科学通才的力量与按职能分工的危险),MultiThreaded,2019 年 3 月 11 日,https://oreil.ly/m6WWu。
当我写下那条推文时,我认为 Kubernetes 是 ML 工作流中必不可少的。这种想法源于我自己工作中的挫败感——如果我更精通 K8s,我作为 ML 工程师的日子会好过得多。
然而,随着我对底层基础设施了解得更多,我意识到期望数据科学家掌握这些是多么不合理。基础设施所需的技能与数据科学截然不同。理论上,你可以同时学会两套技能;实际上,你在一个上面花的时间越多,在另一个上面花的时间就越少。我很喜欢 Erik Bernhardsson 的类比:期望数据科学家了解基础设施,就像期望应用开发者了解 Linux 内核是如何工作的一样⁴。我加入 ML 公司是因为我想花更多时间与数据打交道,而不是花在启动 AWS 实例、编写 Dockerfile、调度/扩缩集群或调试 YAML 配置文件上。
要让数据科学家全流程负责,我们需要好工具。换句话说,我们需要好的基础设施。
如果我们提供一种抽象,让数据科学家能够端到端地负责整个流程而无需操心基础设施,会怎样?
如果我可以直接告诉这个工具:「这是我的数据存储位置(S3),这是我运行代码的步骤(特征化、建模),这是我的代码应该运行的地方(EC2 实例、AWS Batch、Function 等无服务器服务),这是每一步运行代码所需的东西(依赖)」,然后这个工具就替我管理所有基础设施事务,会怎样?
根据 Stitch Fix 和 Netflix 两家的经验,全栈数据科学家的成功依赖于他们拥有的工具。他们需要这样的工具:「让数据科学家不必面对容器化、分布式处理、自动故障转移以及其他高级计算机科学概念的复杂性」⁵。
⁴ Erik Bernhardsson 的推特(@bernhardsson),2021 年 7 月 20 日,https://oreil.ly/7X4J9。
⁵ Colson,《Beware the Data Science Pin Factory》(警惕数据科学针厂)。
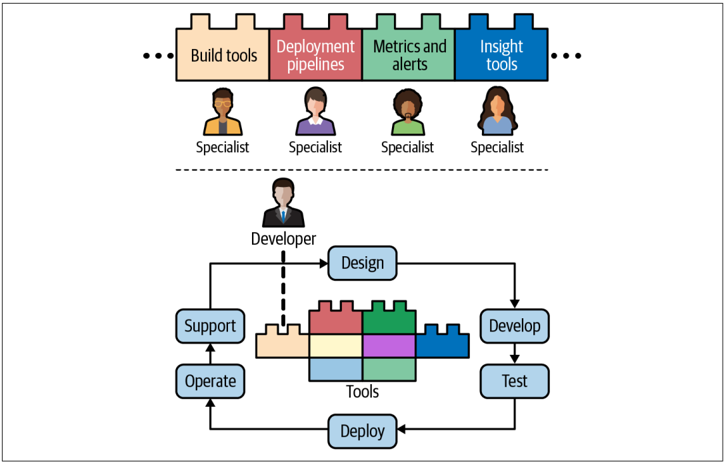
在 Netflix 的模式中,专家——即最初负责项目某一部分的人——首先创建工具来自动化他们负责的部分,如图 11-3 所示。数据科学家可以利用这些工具端到端地负责自己的项目。
图 11-3. Netflix 的全周期开发者(full-cycle developer)。来源:改编自 Netflix 的一张图片⁶
我们已经讨论了 ML 系统如何影响用户体验,以及组织结构如何影响 ML 项目的生产力。在本章的后半部分,我们将聚焦一个更为关键的考量:ML 系统会如何影响社会,以及 ML 系统开发者应该做些什么,以确保他们开发的系统利大于弊。
责任 AI
本节由蒙特利尔 AI 伦理研究所(Montreal AI Ethics Institute)创始人兼首席研究员 Abhishek Gupta 慷慨供稿。他的工作聚焦于构建合乎伦理、安全、包容的 AI 系统的应用技术与政策措施。
如何让智能系统负起责任(responsible)这个问题,不仅与 ML 系统相关,也与广义的人工智能(artificial intelligence,AI)系统相关。AI 是一个更宽泛的术语,包含 ML。因此,在本节中,我们使用 AI 而不是 ML。
⁶ 《Full Cycle Developers at Netflix—Operate What You Build》(Netflix 的全周期开发者——运维你构建的东西),Netflix Technology Blog,2018 年 5 月 17 日,https://oreil.ly/iYgQs。
责任 AI(Responsible AI)是这样一种实践:以良好的意图和充分的意识来设计、开发和部署 AI 系统,以赋能用户、赢得信任,并确保对社会产生公平和积极的影响。它涵盖公平性(fairness)、隐私(privacy)、透明性(transparency)和问责制(accountability)等领域。
这些术语不再只是哲学上的思辨,而是政策制定者和日常从业者都必须认真对待的问题。鉴于 ML 正被部署到我们生活的几乎方方面面,如果我们未能让 ML 系统公平、合乎伦理,就可能导致灾难性后果,正如《Weapons of Math Destruction》(数学毁灭武器,Cathy O’Neil 著,Crown Books,2016 年)一书以及本书中提到的其他案例研究所阐述的那样。
作为 ML 系统的开发者,你不仅有责任思考你的系统会如何影响用户和整个社会,还有责任通过在 ML 系统中具体落实伦理、安全和包容性,帮助所有利益相关者更好地认识到他们对用户的责任。本节将简要介绍:如果我们在让 ML 系统负起责任方面投入不足,会发生什么。我们将从两个相当不幸且广为人知的 ML 失败案例开始,然后为数据科学家和 ML 工程师提出一个初步框架,用于选择最有助于让 ML 系统负起责任的工具和指南。
免责声明:责任 AI 是一个复杂的主题,相关文献日益增多,值得单独成书论述,甚至可以轻松写满好几本书。本节远非一份详尽的指南,我们只想让 ML 开发者对这个领域的发展有一个有效的概览。有兴趣进一步阅读的读者,强烈推荐以下资源:
- NIST Special Publication 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence(NIST 特别出版物 1270:《迈向识别和管理人工智能偏见的标准》)
- ACM Conference on Fairness, Accountability, and Transparency (ACM FAccT) publications(ACM 公平性、问责制与透明度会议(ACM FAccT)的出版物)
- Trustworthy ML’s list of recommended resources and fundamental papers(Trustworthy ML 为想要深入了解可信 ML 的研究者和从业者整理推荐的资源与基础论文清单)
- Sara Hooker’s awesome slide deck on fairness, security, and governance in machine learning (2022)(Sara Hooker 关于机器学习中公平性、安全与治理的精美幻灯片,2022)
- Timnit Gebru and Emily Denton’s tutorials on fairness, accountability, transparency, and ethics (2020)(Timnit Gebru 和 Emily Denton 关于公平性、问责制、透明性与伦理的教程,2020)
不负责任的 AI:案例研究
本节开始时,我们先看两个 AI 系统的失败案例,它们不仅给系统用户带来了严重伤害,也给开发这些系统的组织带来了严重伤害。我们将追溯这些组织出错的一些环节,以及从业者原本可以采取哪些措施来预见这些失败点。这些要点将作为背景,帮助我们深入探讨责任 AI 的工程框架。
AI 事故数据库(AI Incident Database)中还记录了许多其他有趣的「AI 事故」案例。请记住,虽然下面两个例子以及 AI 事故数据库中记录的那些案例引起了关注,但还有更多不负责任的 AI 在悄无声息地发生。
案例研究一:自动评分系统的偏见
2020 年夏天,由于 COVID-19 疫情,英国取消了决定大学录取的高风险考试 A 水平考试(A levels)。英国教育及考试监管机构 Ofqual 批准使用一个自动化系统,在学生未参加考试的情况下为他们分配最终的 A 水平成绩。据 Ada Lovelace 研究所的 Jones 和 Safak 所述:「根据教师评估来授予学生成绩的做法最初被 Ofqual 否决,理由是学校之间不公平、代际之间不可比,以及分数通胀会贬低成绩的价值。Ofqual 推测,更公平的选择是结合学生既往学业数据和教师评估,使用一个特定的统计模型——即一个『算法』——来分配成绩。」⁷
⁷ Elliot Jones 和 Cansu Safak,《Can Algorithms Ever Make the Grade?》(算法能给出合格成绩吗?),Ada Lovelace Institute Blog,2020 年,https://oreil.ly/ztTxR。
然而,这个算法公布的结果被证明是不公正、不可信的。公众迅速强烈呼吁废除该算法,数百名学生齐声抗议⁸。
⁸ Tom Simonite,《Skewed Grading Algorithms Fuel Backlash Beyond the Classroom》(偏斜的评分算法引发课堂之外的强烈反弹),Wired,2020 年 8 月 19 日,https://oreil.ly/GFRet。
是什么引发了公众的强烈抗议?乍一看,似乎是算法糟糕的表现。Ofqual 表示,他们的模型在 2019 年数据上测试,各 A 水平科目的平均准确率约为 60%⁹。这意味着他们预计该模型分配的 40% 的成绩会与学生的实际成绩不同。
⁹ Ofqual,《Awarding GCSE, AS & A Levels in Summer 2020: Interim Report》(2020 年夏季 GCSE、AS 与 A 水平考试成绩授予:中期报告),Gov.uk,2020 年 8 月 13 日,https://oreil.ly/r22iz。
虽然模型的准确率看起来很低,但 Ofqual 为其算法辩护称,这与人类阅卷者的准确率大体相当。比较一名阅卷员与一名高级阅卷员给出的成绩时,一致性也在 60% 左右¹⁰。无论是人类阅卷员还是算法的准确率,都暴露了在单一时间点评估学生所固有的不确定性¹¹,这进一步加剧了公众的沮丧情绪。
¹⁰ Ofqual,《Awarding GCSE, AS & A levels》(GCSE、AS 与 A 水平考试成绩授予)。
¹¹ Jones 和 Safak,《Can Algorithms Ever Make the Grade?》(算法能给出合格成绩吗?)。
如果你已经读到这里,你就会知道,仅凭粗粒度的准确率远不足以评估一个模型的性能,尤其是当一个模型的性能可能影响如此多学生的未来时。仔细审视这个算法,可以发现这个自动评分系统在设计和开发过程中至少存在三个重大失败:
- 未能设定正确的目标
- 未能进行细粒度评估以发现潜在偏见
- 未能让模型保持透明
我们将逐一详细讨论这些失败。请记住,即使这些问题得到解决,公众可能仍然对这个自动评分系统感到不满。
失败 1:设定了错误的目标。 我们在第 2 章讨论了 ML 项目的目标会如何影响最终 ML 系统的性能。在开发自动化学生评分系统时,你可能会认为这个系统的目标是「对学生评分的准确率」。
然而,Ofqual 似乎选择优化的目标是在各学校之间「维持标准」——让模型预测的成绩拟合每所学校的历史成绩分布。例如,如果学校 A 在历史上一直比学校 B 表现更好,Ofqual 就希望算法平均而言也给学校 A 的学生打出比学校 B 学生更高的成绩。Ofqual 将学校之间的公平性置于学生之间的公平性之上——他们宁愿选择在学校层面结果正确的模型,也不愿选择让每个学生个人成绩都正确的模型。
由于这一目标,模型不成比例地压低了来自历史上表现不佳学校的高分群体的成绩。来自学生历史上一直得 D 的班级的 A 等学生,被降级为 B 等和 C 等¹²。
¹² Jones 和 Safak,《Can Algorithms Ever Make the Grade?》(算法能给出合格成绩吗?)。
Ofqual 没有考虑到一个事实:资源更充足的学校往往比资源较少的学校表现更好。由于优先考虑学校的历史表现而不是学生的当前表现,这个自动评分系统惩罚了资源匮乏学校的学生,而这类学校往往有更多来自弱势背景的学生。
失败 2:细粒度模型评估不足,未能发现偏见。 对来自历史上表现不佳学校学生的偏见,只是结果公布后人们发现这个模型众多偏见中的一种。自动评分系统将教师的评估作为输入,却没有处理教师在不同人口群体之间评分不一致的问题。它「也没有考虑 [2010 年《平等法》(2010 Equalities Act)下] 某些受保护群体因多重不利因素而受到的影响,这些群体将因教师期望过低而遭受双重/三重不利,还会受到一些学校中普遍存在的种族歧视的影响」¹³。
¹³ Ofqual,《Awarding GCSE, AS & A Levels》(GCSE、AS 与 A 水平考试成绩授予)。
由于模型考虑了每所学校的历史表现,Ofqual 承认他们的模型对小型学校没有足够的数据。对这些学校,他们没有用这个算法分配最终成绩,而只使用了教师评估的成绩。在实践中,这导致「私立学校学生获得了更好的成绩,因为私立学校的班级规模往往更小」¹⁴。
¹⁴ Jones 和 Safak,《Can Algorithms Ever Make the Grade?》(算法能给出合格成绩吗?)。
如果公开发布模型预测成绩时进行了细粒度评估,以了解模型在不同数据切片(slice)上的表现——例如评估模型对不同规模学校、不同背景学生的准确率——或许就有可能发现这些偏见。
失败 3:缺乏透明性。 透明性是建立系统信任的第一步,然而 Ofqual 未能在为时已晚之前公布其自动评分系统的重要方面。例如,他们直到成绩公布那天才让公众知道系统的目标是在学校之间维持公平。因此,公众在模型开发过程中无法对这一目标表达关切。
此外,Ofqual 直到教师提交评估和学生排名之后,才让教师知道他们的评估将被自动评分系统如何使用。Ofqual 的理由是避免教师试图篡改评估以影响模型的预测。Ofqual 选择在放榜日之前不公布所用的具体模型,以确保所有人同时获知自己的成绩。
¹³ Ofqual,《Awarding GCSE, AS & A Levels》(GCSE、AS 与 A 水平考试成绩授予)。
¹⁴ Jones 和 Safak,《Can Algorithms Ever Make the Grade?》(算法能给出合格成绩吗?)。
这些考虑都出自良好的意图;然而,Ofqual 将模型开发过程保密,意味着他们的系统没有得到充分的独立外部审查。任何依赖公众信任运行的系统,都应该接受公众信任的独立专家的审查。英国皇家统计学会(Royal Statistical Society,RSS)在调查这个自动评分系统的开发过程时,对 Ofqual 为评估模型而组建的「技术咨询小组」的构成表示担忧。RSS 指出:「如果没有更坚实的程序基础来确保统计严谨性,没有对 Ofqual 正在审查的问题有更大的透明度」¹⁵,Ofqual 统计模型的合法性就值得怀疑。
¹⁵ 《Royal Statistical Society Response to the House of Commons Education Select Committee Call for Evidence: The Impact of COVID-19 on Education and Children’s Services Inquiry》(皇家统计学会对下议院教育特别委员会证据征集的回应:COVID-19 对教育与儿童服务影响调查),Royal Statistical Society,2020 年 6 月 8 日,https://oreil.ly/ernho。
这个案例研究说明了在构建一个能直接影响如此多人生计的模型时透明性的重要性,以及未能在正确时机披露模型重要方面可能带来的后果。它也说明了选择正确优化目标的重要性,因为错误的目标(例如优先考虑学校之间的公平性)不仅会让你选出一个在正确目标下表现不佳的模型,还会让偏见持续存在。
它还例证了当前「什么应该由算法自动化、什么不应该」之间模糊的界限。英国政府中一定有人认为用算法自动化 A 水平评分是可以的;但也有理由认为,鉴于 A 水平评分可能带来灾难性后果,它从一开始就不应该被自动化。在界限更清晰之前,还会有更多滥用 AI 算法的案例。而更清晰的界限,只有通过投入更多时间和资源,以及 AI 开发者、公众和当局的认真思考才能实现。
案例研究二:「匿名化」数据的危险
这个案例研究让我很感兴趣,因为在这里,算法并不是明确的罪魁祸首,而是界面和数据收集方式的设计导致了敏感数据的泄露。由于 ML 系统的开发高度依赖数据质量,收集用户数据非常重要。研究界需要获取高质量的数据集来开发新技术。从业者和公司需要访问数据来发现新的用例、开发新的 AI 产品。
¹⁵ 《Royal Statistical Society Response to the House of Commons Education Select Committee Call for Evidence: The Impact of COVID-19 on Education and Children’s Services Inquiry》(皇家统计学会对下议院教育特别委员会证据征集的回应:COVID-19 对教育与儿童服务影响调查),Royal Statistical Society,2020 年 6 月 8 日,https://oreil.ly/ernho。
然而,收集和共享数据集可能会侵犯数据所属用户的隐私和安全。为了保护用户,人们一直呼吁对个人身份信息(personally identifiable information,PII)进行匿名化(anonymization)。根据美国劳工部的定义,PII 是「任何允许通过直接或间接方式合理推断出信息所属个人身份的信息表示」,例如姓名、地址或电话号码¹⁶。
¹⁶ 《Guidance on the Protection of Personal Identifiable Information》(个人身份信息保护指南),美国劳工部,https://oreil.ly/FokAV。
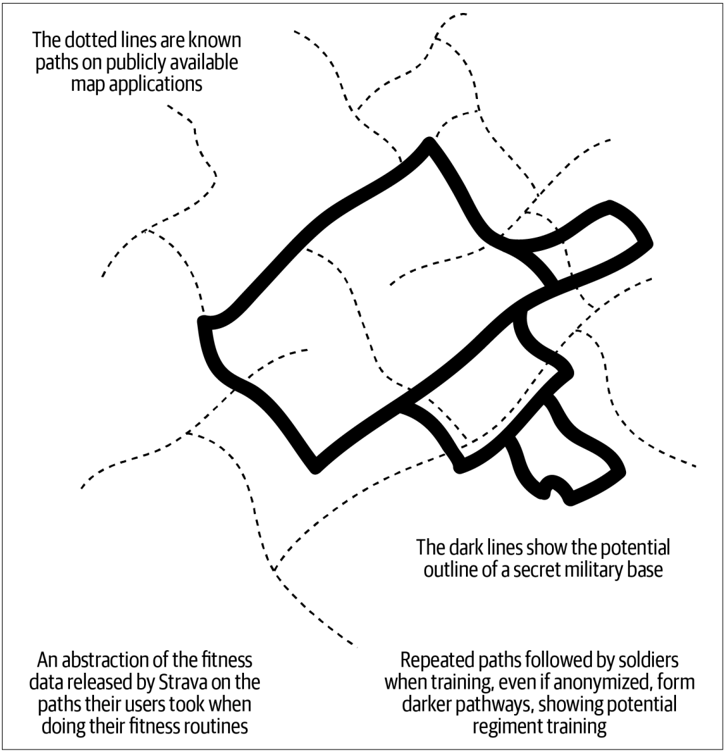
然而,匿名化可能并不足以保证防止数据滥用和隐私预期的侵蚀。2018 年,在线健身追踪应用 Strava 发布了一张热力图(heatmap),展示其记录的用户在世界各地锻炼时的路径,例如跑步、慢跑或游泳。这张热力图聚合了 2015 年至 2017 年 9 月间记录的 10 亿次活动,总距离达 270 亿公里。Strava 表示,所使用的数据已经过匿名化处理,并且「排除了被标记为私密的活动以及用户自定义的隐私区域」¹⁷。
¹⁷ Sasha Lekach,《Strava’s Fitness Heatmap Has a Major Security Problem for the Military》(Strava 的健身热力图对军方构成重大安全隐患),Mashable,2018 年 1 月 28 日,https://oreil.ly/9ogYx。
由于军人也在使用 Strava,他们的公开数据尽管经过匿名化,仍让人们发现了暴露美国海外军事基地活动的模式,包括「阿富汗的前沿作战基地、土耳其军队在叙利亚的巡逻,以及俄罗斯在叙利亚行动区域内可能存在的警卫巡逻」¹⁸。图 11-4 展示了这类可辨识模式的一个例子。一些分析人士甚至提出,这些数据可能泄露个别 Strava 用户的姓名和心率¹⁹。
¹⁸ Jeremy Hsu,《The Strava Heat Map and the End of Secrets》(Strava 热力图与秘密的终结),Wired,2018 年 1 月 29 日,https://oreil.ly/mB0GD。
¹⁹ Matt Burgess,《Strava’s Heatmap Data Lets Anyone See the Names of People Exercising on Military Bases》(Strava 的热力图数据让任何人都能看到在军事基地锻炼者的姓名),Wired,2018 年 1 月 30 日,https://oreil.ly/eJPdj。
那么匿名化在哪里出了问题?首先,Strava 的默认隐私设置是「选择退出」(opt-out),这意味着如果用户不希望自己的数据被收集,必须手动选择退出。然而,用户指出这些隐私设置并不总是清晰明了,可能会给用户带来意外²⁰。有些隐私设置只能通过 Strava 网站修改,而不是在移动应用中修改。这说明向用户普及你的隐私设置有多么重要。更好的做法是,默认应该是数据选择加入(opt-in,即默认不收集数据),而不是选择退出。
²⁰ Matt Burgess,《Strava’s Heatmap Data Lets Anyone See》(Strava 的热力图数据让任何人都能看到);Rosie Spinks,《Using a Fitness App Taught Me the Scary Truth About Why Privacy Settings Are a Feminist Issue》(使用健身应用让我了解到为什么隐私设置是一个女权主义问题的可怕真相),Quartz,2017 年 8 月 1 日,https://oreil.ly/DO3WR。
图 11-4. 基于 BBC 新闻的分析创建的图片²¹
²¹ 《Fitness App Strava Lights Up Staff at Military Bases》(健身应用 Strava 照亮军事基地人员行踪),BBC News,2018 年 1 月 29 日,https://oreil.ly/hXwpN。
当 Strava 热力图的问题公之于众时,部分责任被推给了用户:例如,军人不应该使用带 GPS 追踪功能的非军用设备,以及应该关闭定位服务²²。
²² Matt Burgess,《Strava’s Heatmap Data Lets Anyone See》(Strava 的热力图数据让任何人都能看到)。
然而,隐私设置和用户的选择只是在表面层面解决了问题。根本问题在于,我们今天使用的设备在不断地收集和上报关于我们的数据。这些数据必须被传输和存储在某个地方,这就为数据被截获和滥用创造了机会。与 Amazon、Facebook、Google 等使用范围广得多的应用相比,Strava 拥有的数据量很小。Strava 的失误可能暴露了军事基地的活动,但其他隐私失败可能造成更大的危险,不仅对个人,也对整个社会。
收集和共享数据对于 AI 这类数据驱动技术的发展至关重要。然而,这个案例研究揭示了收集和共享数据的潜在危险,即使数据据称已经匿名化、且发布意图是良善的。收集用户数据的应用开发者必须明白:用户可能没有足够的技术知识和隐私意识来为自己选择正确的隐私设置,因此开发者必须主动努力,让正确的设置成为默认选项,即使代价是收集更少的数据。
责任 AI 框架
在本节中,我们将为你——作为 ML 从业者——奠定基础,帮助你审计模型行为,并制定最有助于满足项目需求的指南。这个框架并不适用于所有用例。有些应用场景下,无论你遵循什么框架,使用 AI 本身就可能不恰当或不道德(例如刑事量刑决策、预测性警务)。
发现模型偏见的来源
作为一个一直关注 ML 系统设计讨论的人,你知道偏见可能通过整个工作流悄然渗入系统。第一步就是发现这些偏见是如何渗入的。下面是一些数据偏见的来源示例,但请记住,这份清单远非详尽。偏见如此难以对抗的原因之一,正是偏见可能来自项目生命周期的任何一步。
训练数据
用于开发模型的数据,是否代表模型在现实世界中将要处理的数据?如果不是,你的模型可能会对在训练数据中代表性不足的用户群体产生偏见。
标注
如果你使用人工标注员来标注数据,你如何衡量这些标签的质量?你如何确保标注员遵循标准指南,而不是依赖主观经验来标注数据?标注员越需要依赖主观经验,人为偏见的空间就越大。
特征工程
你的模型是否使用了包含敏感信息的特征?你的模型是否对某一人群子群体造成差异性影响(disparate impact)?差异性影响发生在「一个选择过程对不同群体产生截然不同的结果,即使它看起来是中立的」²³。当模型的决策依赖于与法律保护类别(例如族裔、性别、宗教信仰)相关的信息时,就可能发生这种情况,即使这些信息没有直接用于训练模型。例如,如果招聘流程利用与种族相关的变量(如邮政编码、高中文凭),就可能按种族造成差异性影响。为了缓解这种潜在的差异性影响,你可以使用 Feldman 等人在《Certifying and Removing Disparate Impact》(认证与消除差异性影响)中提出的差异性影响消除(disparate impact remover)技术,或者使用 AI Fairness 360(AIF360)实现的 DisparateImpactRemover 函数。你还可以使用 H2O 中实现的 Infogram 方法识别变量中隐藏的偏见(然后将其从训练集中移除)。
²³ Michael Feldman、Sorelle Friedler、John Moeller、Carlos Scheidegger 和 Suresh Venkatasubramanian,《Certifying and Removing Disparate Impact》(认证与消除差异性影响),arXiv,2015 年 7 月 16 日,https://oreil.ly/FjSve。
模型的目标
你优化模型所用的目标是否能让所有用户都得到公平对待?例如,你是否优先考虑模型在所有用户上的性能,这会让模型偏向大多数用户群体?
评估
你是否进行了充分、细粒度的评估,以了解模型在不同用户群体上的表现?这一点在第 185 页的「基于切片(Slice-based evaluation)的评估」一节中有所介绍。公平、充分的评估取决于是否存在公平、充分的评估数据。
理解数据驱动方法的局限性
ML 是一种解决问题的数据驱动(data-driven)方法。然而,重要的是要理解:仅有数据是不够的。数据关乎现实世界中的人,需要考虑社会经济和文化层面的因素。我们需要更好地理解过度依赖数据所造成的盲点。这往往意味着跨越学科和职能的边界——无论是在组织内部还是外部——以便我们能够考虑到那些将被我们所构建系统影响的人的真实生活经验。
例如,要构建一个公平的自动评分系统,就必须与领域专家合作,了解学生群体的人口统计学分布,以及社会经济因素如何反映在历史成绩数据中。
理解不同期望属性之间的权衡
构建 ML 系统时,你可能希望系统具备不同的属性。例如,你可能希望系统推理延迟低,这可以通过剪枝(pruning)等模型压缩技术实现;你可能希望模型预测准确率高,这可以通过增加更多数据实现;你可能还希望模型公平且透明,这可能需要让模型及其开发所用数据能够接受公众的审查。
通常,ML 文献会做出一个不切实际的假设:优化某一属性(如模型准确率)时,其他所有属性保持不变。人们在讨论改进模型公平性的技术时,可能会假设模型的准确率或延迟保持不变。然而,在现实中,改进一个属性可能导致其他属性退化。以下是这类权衡的两个例子:
隐私与准确率的权衡
根据维基百科的定义,差分隐私(differential privacy)是「一种公开共享数据集信息的系统,它描述数据集中群体的模式,同时保留数据集中个体的信息。差分隐私背后的思想是:如果在数据库中任意替换单个个体所产生的影响足够小,查询结果就无法被用来推断出关于任何单个个体的太多信息,因此就提供了隐私保护」²⁴。
²⁴ 维基百科,「Differential privacy」(差分隐私)词条,https://oreil.ly/UcxzZ。
差分隐私是 ML 模型训练数据上常用的一种技术。这里的权衡在于:差分隐私能提供的隐私保护水平越高,模型的准确率就越低。然而,这种准确率下降对样本并不是均匀的。正如 Bagdasaryan 和 Shmatikov(2019)所指出的,「差分隐私模型的准确率在代表性不足的类别和子群体上下降得更多」²⁵。
²⁵ Eugene Bagdasaryan 和 Vitaly Shmatikov,《Differential Privacy Has Disparate Impact on Model Accuracy》(差分隐私对模型准确率具有差异性影响),arXiv,2019 年 5 月 28 日,https://oreil.ly/nrJGK。
紧凑性与公平性的权衡
在第 7 章中,我们详细讨论了各种模型压缩技术,如剪枝和量化(quantization)。我们了解到,可以用极小的准确率代价显著减小模型规模,例如将模型参数量减少 90% 而准确率代价极小。
如果准确率代价在所有类别上均匀分布,那么它确实很小;但如果代价集中在少数几个类别上呢?在 2019 年的论文《What Do Compressed Deep Neural Networks Forget?》(压缩后的深度神经网络会遗忘什么?)中,Hooker 等人发现:「权重数量截然不同的模型,顶层性能指标不相上下,但在数据集的一个狭窄子集上的行为却大相径庭」²⁶。例如,他们发现当受保护特征(如性别、种族、残疾)处于分布的长尾时,压缩技术会放大算法伤害。这意味着压缩对代表性不足的特征产生了不成比例的影响²⁷。
²⁶ Sarah Hooker、Aaron Courville、Gregory Clark、Yann Dauphin 和 Andrea Frome,《What Do Compressed Deep Neural Networks Forget?》(压缩后的深度神经网络会遗忘什么?),arXiv,2019 年 11 月 13 日,https://oreil.ly/bgfFX。
²⁷ Sara Hooker、Nyalleng Moorosi、Gregory Clark、Samy Bengio 和 Emily Denton,《Characterising Bias in Compressed Models》(刻画压缩模型中的偏见),arXiv,2020 年 10 月 6 日,https://oreil.ly/ZTI72。
他们工作的另一个重要发现是:虽然他们评估的所有压缩技术都产生了不均匀的影响,但并非所有技术的差异性影响程度都相同。剪枝造成的差异性影响远高于他们评估的量化技术²⁸。
²⁸ Hooker 等人,《Characterising Bias in Compressed Models》(刻画压缩模型中的偏见)。
类似的权衡还在不断被发现。了解这些权衡很重要,这样我们才能为 ML 系统做出明智的设计决策。如果你在开发一个经过压缩或采用差分隐私的系统,建议分配更多资源来审计模型行为,以避免无意中造成伤害。
尽早行动
设想市中心正在建造一栋新楼。承包商受雇建造一座未来 75 年都要屹立不倒的建筑。为了节省成本,承包商使用了劣质水泥。业主不愿在监理上投入,因为他们想避免开销、加快进度。承包商继续在糟糕的地基上施工,并按时完工。
²⁵ Eugene Bagdasaryan 和 Vitaly Shmatikov,《Differential Privacy Has Disparate Impact on Model Accuracy》(差分隐私对模型准确率具有差异性影响),arXiv,2019 年 5 月 28 日,https://oreil.ly/nrJGK。
²⁶ Sarah Hooker、Aaron Courville、Gregory Clark、Yann Dauphin 和 Andrea Frome,《What Do Compressed Deep Neural Networks Forget?》(压缩后的深度神经网络会遗忘什么?),arXiv,2019 年 11 月 13 日,https://oreil.ly/bgfFX。
²⁷ Sara Hooker、Nyalleng Moorosi、Gregory Clark、Samy Bengio 和 Emily Denton,《Characterising Bias in Compressed Models》(刻画压缩模型中的偏见),arXiv,2020 年 10 月 6 日,https://oreil.ly/ZTI72。
²⁸ Hooker 等人,《Characterising Bias in Compressed Models》(刻画压缩模型中的偏见)。
不到一年,裂缝开始出现,大楼似乎有倒塌的危险。市政府认定这栋楼构成安全隐患,要求拆除。承包商当初节省成本的决定和业主当初节省时间的决定,最终让业主付出了多得多的金钱和时间代价。
这种叙事在 ML 系统中你可能会经常遇到。公司可能为了节省成本和时间而绕过 ML 模型中的伦理问题,结果在未来才发现风险,届时代价要大得多,比如前面 Ofqual 和 Strava 的案例。
在 ML 系统的开发周期中,你越早开始思考这个系统将如何影响用户的生活、系统可能有哪些偏见,解决这些偏见的成本就越低。NASA 的一项研究表明,在软件开发中,错误的成本在项目生命周期的每个阶段都会上升一个数量级²⁹。
²⁹ Jonette M. Stecklein、Jim Dabney、Brandon Dick、Bill Haskins、Randy Lovell 和 Gregory Moroney,《Error Cost Escalation Through the Project Life Cycle》(项目生命周期中错误成本的升级),NASA 技术报告服务器(NTRS),https://oreil.ly/edzaB。
创建模型卡
模型卡(model card)是随训练好的 ML 模型一起提供的简短文档,说明这些模型是如何训练和评估的。模型卡还披露模型预期使用的场景及其局限性³⁰。根据模型卡论文作者的说法:「模型卡的目标是标准化伦理实践和报告流程,让利益相关者不仅能够跨传统评估指标比较候选部署模型,还能沿着伦理、包容和公平考量的维度进行比较。」
³⁰ Margaret Mitchell、Simone Wu、Andrew Zaldivar、Parker Barnes、Lucy Vasserman、Ben Hutchinson、Elena Spitzer、Inioluwa Deborah Raji 和 Timnit Gebru,《Model Cards for Model Reporting》(用于模型报告的模型卡),arXiv,2018 年 10 月 5 日,https://oreil.ly/COpah。
以下清单改编自《Model Cards for Model Reporting》(用于模型报告的模型卡)论文的内容,展示了你可能希望为模型报告的信息³¹:
- 模型详情(Model details):模型的基本信息。
- 开发模型的个人或组织
- 模型日期
- 模型版本
- 模型类型
- 关于训练算法、参数、公平性约束或其他应用方法以及特征的信息
- 提供更多信息的论文或其他资源
- 引用信息
- 许可证
- 向何处发送关于模型的问题或评论
- 预期用途(Intended use):开发过程中设想的用例。
- 主要预期用途
- 主要预期用户
- 范围外用例
- 因素(Factors):因素可以包括人口统计学或表型群体、环境条件、技术属性等。
- 相关因素
- 评估因素
- 指标(Metrics):指标的选择应能反映模型的潜在现实影响。
- 模型性能度量
- 决策阈值
- 变异性方法
- 评估数据(Evaluation data):模型中定量分析所用数据集的详细信息。
- 数据集
- 动机
- 预处理
- 训练数据(Training data):在实践中可能无法提供。如果可能,本节应参照评估数据。如果无法提供如此详细的信息,则应在此提供允许的最小信息量,例如训练数据集中各因素分布的情况。
- 定量分析(Quantitative analyses)
- 单一维度结果
- 交叉维度结果
- 伦理考量(Ethical considerations)
- 注意事项与建议(Caveats and recommendations)
³¹ Mitchell 等人,《Model Cards for Model Reporting》(用于模型报告的模型卡)。
模型卡是提高 ML 模型开发透明度的一步。当模型的使用者与开发者不是同一批人时,模型卡尤其重要。
请注意,每当模型更新时,模型卡也需要更新。对于频繁更新的模型,如果手动创建模型卡,会给数据科学家带来相当大的负担。因此,拥有自动生成模型卡的工具很重要,无论是利用 TensorFlow、Metaflow 和 scikit-learn 等工具的模型卡生成功能,还是内部自建这一功能。由于模型卡中应该跟踪的信息与模型存储(model store)中应该跟踪的信息有重叠,如果不久的将来模型存储演进为自动生成模型卡,我一点也不会感到惊讶。
建立缓解偏见的流程
构建责任 AI 是一个复杂的过程,过程越临时随意,出错的空间就越大。企业建立系统化的流程来让 ML 系统负起责任,这一点非常重要。
你可能希望创建一套便于不同利益相关者访问的内部工具组合。大公司有一些可供参考的工具集。例如,Google 发布了责任 AI 的推荐最佳实践,IBM 开源了 AI Fairness 360,其中包含一组用于缓解数据集和模型中偏见的指标、解释和算法。你也可以考虑使用第三方审计。
持续跟进责任 AI 的最新进展
AI 是一个快速发展的领域。AI 中新的偏见来源不断被发现,责任 AI 的新挑战也不断涌现,对抗这些偏见和挑战的新技术正在被积极开发。紧跟责任 AI 的最新研究非常重要。你可以关注 ACM FAccT 会议、人工智能伙伴关系组织(Partnership on AI)、艾伦·图灵研究所(Alan Turing Institute)的公平性、透明性、隐私研究组,以及 AI Now 研究所(AI Now Institute)。
小结
尽管 ML 解决方案具有技术性,但设计 ML 系统不能局限于技术领域。它们由人开发、被人使用,并在社会中留下印记。在本章中,我们偏离了前八章的技术主题,聚焦于 ML 中人的因素。
我们首先聚焦 ML 系统的概率性、「大部分正确」和高延迟特性会如何以各种方式影响用户体验。概率性会导致用户体验的不一致,从而引发沮丧情绪——「嘿,我刚才还在这里看到这个选项,现在却找不到了。」如果用户无法轻松地把「大部分正确」的预测修正为正确,ML 系统的这一特性可能会让它变得毫无用处。为了应对这一点,你可以向用户展示同一输入的多个「最正确」预测,希望至少有一个是正确的。
构建 ML 系统通常需要多种技能组合,组织可能会思考如何分配这些所需技能:是让拥有不同技能的不同团队参与,还是期望同一个团队(例如数据科学家)拥有全部技能。我们探讨了两种方法的利弊。第一种方法的主要缺点是沟通开销;第二种方法的主要缺点是很难招聘到能够端到端负责 ML 系统开发流程的数据科学家,即使他们能做到,他们可能也不乐意这么做。然而,如果为这些端到端数据科学家提供足够的工具和基础设施——这正是第 10 章的重点——第二种方法或许是可行的。
在本章结尾,我们讨论了本书中我认为最重要的主题:责任 AI。责任 AI 不再只是一个抽象概念,而是当今 ML 行业中亟需行动的基本实践。将伦理原则融入你的建模和组织实践,不仅有助于你成为出类拔萃、紧跟前沿的数据科学家和 ML 工程师,还有助于你的组织赢得客户和用户的信任。随着越来越多的客户和用户强调他们对责任 AI 产品和服务的需求,这还将帮助你的组织获得市场竞争优势。
重要的是,不要把责任 AI 仅仅当作一项为满足组织合规要求而进行的打勾(checkbox)活动。诚然,本章提出的框架会帮助你满足组织的合规要求,但它不能替代你的批判性思考——即某个产品或服务从一开始是否就应该被构建。
后记
哇,你做到了!你刚刚读完了一本相当技术性的书,全书十万词、插图超过一百幅,作者是一位把英语作为第二语言的人。在许多同事和导师的帮助下,我为这本书付出了很多努力,我很感激你在茫茫书海中选择了阅读它。我希望你能从这本书中获得的收获,能让你的工作轻松一点点。
凭借我们现在拥有的最佳实践和工具,已经有无数令人惊叹的 ML 用例在影响着我们的日常生活。我毫不怀疑,随着工具日趋成熟,有影响力的用例数量会与日俱增,而你或许就是推动这一切发生的人之一。我期待看到你构建的作品!
ML 系统面临很多挑战。并非所有挑战都令人愉快,但所有挑战都是成长和产生影响的机会。如果你想聊聊这些挑战和机遇,请不要犹豫,随时联系我。你可以在 Twitter 上找到我(@chipro),或通过电子邮件 chip@claypot.ai 联系我。
索引
| 符号(Symbols) | 自动重训练(automated retraining),275-277 |
|---|---|
| 1NF(第一范式,first normal form),59 | AutoML |
| 2NF(第二范式,second normal form),59 | 架构搜索(architecture search),174-178 |
| A A/B 测试(A/B testing),283-284,288 准确率相关指标(accuracy-related metrics),252 | 硬 AutoML(hard AutoML),174-178 超参数调优(hyperparameter tuning),173-174 学习型优化器(learned optimizer),174-178 软 AutoML(soft AutoML),173-174 |
| ACID(原子性、一致性、隔离性、持久性),68 | 自动扩缩容(autoscaling),30 |
| 主动学习(active learning),101-102 临时分析(ad hoc analytics),162 适应性(adaptability),31 | B |
| 装袋(bagging),158-159 集成(ensembles) 赌博机算法(bandit algorithms),287-291 | |
| 对抗攻击(adversarial attacks),272 对抗性增强(adversarial augmentation),116 | BASE(基本可用、软状态、最终一致),68 |
| AI(人工智能),伦理,339,347-348 | 基学习器(base learners),156 |
| 数据驱动方法的局限性,349 不负责任的,案例研究,341-347 | 基础模型(base model),微调,100 基线(baselines),离线模型评估,179 |
| 缓解偏见,353 模型卡,351-353 权衡,349 | 现有解决方案(existing solutions),181 人工(human),180 随机(random),180 180 |
| Airflow,315-316 | 简单启发式(simple heuristic), |
| 零规则(zero rule),180 | |
| 告警疲劳(alert fatigue),255,259 | 批量管道(batch pipeline),203-205 |
| 告警策略(alert policies),259 | 批量预测(batch prediction), |
| 算法(algorithms) | 197-201 |
| 赌博机算法,287-291 | 迁移到在线预测(moving to online prediction),201-203 |
| 持续学习与,273-274 | 批处理(batch processing),78-79 |
| 特征重要性,142 处理,67 | 批次(batches),过拟合,167 37 |
| 分析型(analytical) Apache Iceberg,69 | 二分类(binary classification),37 二进制数据(binary data),57 |
| 二进制文件大小(binary file size),57 | |
| 架构搜索(architectural search),174 | 提升(boosting),159-161 集成(ensembles) |
| Argo,316-318 | 159-161 |
| 产物(artifacts),162 | Borg,314 |
| 人工智能(见 AI) | 品牌监测(brand monitoring),12 |
| 异步预测(asynchronous prediction),198 | 浏览器,ML(机器学习)与,222 |
| 自建还是购买(building versus buying),327-329 | 特征复用(feature reuse),277 |
| 业务分析(business analysis),35 | 新鲜数据访问(fresh data access),270-272 |
| 业务目标(business objectives),26-28 | 有状态训练(stateful training),265-268 自动化的,277-278 |
| C | 无状态重训练(stateless retraining),265-268 手动的,275 |
| 校准(calibration),183-184 | |
| 金丝雀发布(canary release),285 | 训练,自动化重训练,275-277 |
| 基数(cardinality),分类任务与,37 | 与在线学习对比(versus online learning),268 |
| 灾难性遗忘(catastrophic forgetting),264 | 便利抽样(convenience sampling),83 |
| 类别型特征(categorical features),129-132 | 代价敏感学习(cost-sensitive learning),111 |
| 冠军模型(champion model),264 | 协变量数据分布偏移(covariate data distribution shift),238-240 |
| 流失预测(churn prediction),104 | cron,调度器,313-314 |
| 类别不平衡(class imbalance),102 | 跨职能协作(cross-functional collaboration),团队,335 |
| 算法级方法,110 类别平衡损失(class-balanced loss),112 | CSV(逗号分隔值),行主序,54 |
| 代价敏感学习,111 焦点损失(focal loss),112 | mat, |
| 挑战,103-105 | D |
| 评估指标,106-108 | DAG(有向无环图),312 |
| 重采样,109-110 | 仪表盘(dashboards),监控与,258 |
| 类别平衡损失,112 | 数据,5,18 |
| 分类(classification) | 思维与数据(mind versus data),43-46 |
| 作为回归问题,107 | 训练(见训练数据) |
| 二分类,37 | 未见数据(unseen data),6 |
| 层级分类,38 | 数据增强(data augmentation),113 |
| 高基数,37,38 | 对抗性增强,116 |
| 多分类,37, | 数据合成(data synthesis),116-117 |
| 多标签,38 | 扰动(perturbation),114-116 |
| 情感分析,120 | 简单标签保持变换(simple label-preserving transformations),114 |
| 分类模型(classification models),36 | 数据分布偏移(data distribution shifts) |
| 云计算(cloud computing),212,300-302 | 应对,248-250 |
| 弹性(elasticity),300 | 检测(detection) |
| 多云策略(multicloud strategy),302 | 统计方法,243-244 |
| 代码版本管理(code versioning),164 | 时间尺度窗口(time scale windows),245-247 |
| 列删除(column deletion),125 | ML 系统故障,237 |
| 列主序格式(column-major formats),54-56 | 概念漂移(concept drift),238,241 |
| pandas,56 | 协变量偏移(covariate shift),238-240 |
| Parquet,54 | 特征变化(feature change),241 |
| Commuter,305 | 标签模式变化(label schema change),241 |
| 紧凑卷积滤波器(compact convolutional filters),206 | 标签偏移(label shift),238,240 |
| 计算优先级(computational priorities),15 | 数据重复(data duplication),数据泄露与,139 |
| 计算密集型问题(compute-intensive problems),6 | 数据工程(data engineering),34 |
| 概念漂移,238,241 | 数据格式(data formats),53 |
| 置信度测量(confidence measurement),185 | 二进制,57 |
| 容器(containers),308-310 上下文赌博机(contextual bandits),289 | 列主序,54-56 JSON,54 |
| 持续学习(continual learning),35,264,268-270 | 多模态数据,53 关系模型,NoSQL,63-66 |
| 算法与,273-274 | 行主序,54-56 |
| 评估与,272-273 | |
| 文本,57 | 依赖(dependencies),312 |
| 数据新鲜度(data freshness),模型更新与,279-280 | ML 模型,模型存储,322 |
| 数据生成(data generation),数据泄露与,140 | 依赖故障(dependency failure),227 |
| 数据迭代(data iteration),267 | 部署(deployment),34,192 |
| 模型更新与,281 | 端点(endpoints),暴露,192 |
| 数据泄露(data leakage),135 | 故障,227 |
| 分割前数据重复 | ML 模型,320 |
| 分割,数据生成过程与,140 | 迷思(myths) |
| 检测,140 | 一次有限模型,194-195 |
| 组泄露(group leakage),139 | 模型更新,196 |
| Kaggle 竞赛,136 | 性能,195 |
| 分割前缩放,138 | 规模,196 |
| 测试分割统计,缺失数据与,138 | 职责分离,193 |
| 时间相关数据,137 | 影子部署(shadow deployment),282 |
| 数据模型(data models) | 开发环境(development environment),基础设施,296,302 |
| 关系型,59-62 | 容器,308-310 |
| 结构化数据,66-67 | 搭建,303 |
| 非结构化数据,66-67 | IDE,303-306 |
| 数据归一化(data normalization),59 | 标准化(standardization),306-308 |
| 数据并行(data parallelism),分布式训练与,168-170 | 有向无环图(DAG),312 |
| 数据科学家,团队,336-339 | 方向性期望测试(directional expectation tests),183 |
| 数据来源(data sources),50 | 离散化(discretization),特征工程与,128-129 |
| 内部数据库,52 | 分布式训练(distributed training),168 |
| 日志,51 | 数据并行与,168 |
| 智能手机与,52 | 模型并行与,170-172 |
| 系统生成数据,50 | Docker Compose,310 |
| 第三方数据,52 | Docker 镜像,308-310 |
| 用户输入,50 | Dockerfile,308-310 |
| 数据合成,116-117 | 文档模型(document model),63 |
| 数据驱动方法,AI 伦理与,349 | 模式(schemas),64 |
| 数据库与数据流,72 | 停机(downtime),228 |
| 数据流(dataflow),72 | 司机管理服务(driver management service),73 |
| 消息队列模型,77 通过数据库传递,72 | 动态采样(dynamic sampling),110 |
| 通过实时传输传递,74-77 | E |
| 通过服务传递,73-74 | 边界情况(edge cases) |
| 请求驱动,75 | |
| DataFrame,pandas 与,56 | 故障与,231 异常值与,232 |
| 调试(debugging),165 | 计算(computing), |
| 决策树(decision trees),剪枝,208-209 | 边缘(edge)213 |
| 声明式 ML 系统(declarative ML systems),62 | 模型优化,214-221 EKS(弹性 Kubernetes 服务),314 |
| 深度学习(deep learning) | 嵌入(embedding) |
| ML(机器学习)与,1 ML 算法与,150 | 位置嵌入(positional embedding),133-135 |
| 退化反馈循环(degenerate feedback loops),ML 系统故障, | 词嵌入(word embeddings),133 |
| 端点,暴露,192 | |
| 233 | 集成(ensembles) 装袋,158-159 |
| 纠正,235-236 | 基学习器,156 |
| 提升(boosting),159-161 | 管理,326 |
| 垃圾邮件分类器(spam classifiers),157 | 监控(monitoring),253-255 |
| 堆叠(stacking),161 | 在线(online),199 |
| AI 中的伦理(ethics in AI),339-347 | 复用,277 |
| ETL(抽取、转换、加载),70-72 | 流式(streaming),199 |
| 评估,离线(evaluation, offline) | 反馈循环(feedback loops),288 |
| 置信度测量,185 | ML 系统故障,234 |
| 方向性期望测试,183 | 反馈,用户,93 |
| 不变性测试(invariation tests),182 | 固定位置嵌入,135 |
| 模型校准(model calibration),183-184 | 定点推理(fixed-point inference),210 |
| 扰动测试(perturbation tests),181-182 | FLOPS(每秒浮点运算次数),298 |
| 基于切片,185-188 | 客户需求预测(forecasting customer demand),11 |
| 现有数据(existing data),5 | 傅里叶特征(Fourier features),135 |
| 实验产物(experiment artifacts),开发与,323 | 欺诈检测(fraud detection),11,104 |
| 实验跟踪(experiment tracking),162-163 | |
| 第三方工具,163 | G |
| 导出模型(exporting models),193 | GDPR(通用数据保护条例),164 |
| F | 泛化(generalization),特征,144-146 |
| F1 指标(F1 metrics),107 | GKE(Google Kubernetes 引擎),314 |
| 分解,低秩(factorization, low-rank),206-208 | Google 翻译,1 |
| 公平性(fairness),19 | 65 |
| 特征变化(feature change),241 | 图模型(graph model), |
| 特征工程(feature engineering),120-122 类别型特征,129-132 | H |
| 离散化,128-129 | H2O AutoML,62 |
| 特征交叉(feature crossing),132 | 人工标签(hand labels),88 |
| 特征泛化(feature generalization),144-146 | 谱系(lineage),90 |
| 特征重要性(feature importance),142 | 多重性(multiplicity),89-90 |
| 缺失值与,123 | 硬 AutoML,174-178 |
| 删除,125 | 硬件故障(hardware failure),228 |
| 插补(imputation),125-126 | 哈希函数(hashed functions),130 |
| MAR(随机缺失),124 | 启发式,LFs(标注函数),95 |
| MCAR(完全随机缺失),124 | 基于启发式的切片,188 |
| MNAR(非随机缺失),124 | 层级分类,38 |
| NLP(自然语言处理)与,122 | 人工基线(human baselines),180 |
| 位置嵌入,133-135 特征,140 | 超参数(hyperparameters) |
| 缩放的预测能力,126-128 | 失败与,166 |
| 调优,173-174 | |
| 无用特征,141 | 值随时间变化,163 |
| 特征缩放(feature scaling),126-128 | I |
| 特征存储(feature store),325-327 特征(features) | IDE(集成开发环境),303 |
| 计算,326 一致性,326 | 云开发环境,307 笔记本与,304 |
| 提取,255 失败与,166 | 重要性采样(importance sampling),87 |
| 学习型,120-122 | 基础设施(infrastructure),293,295 |
| 自建还是购买,327-329 | 类别不平衡与,102 |
| 云计算与,300-302 | 错误,类别不平衡与,105 |
| 开发环境层,296,302 | 人工标签,88 |
| 搭建,303-306 | 谱系,90 |
| 基础性设施(fundamental facilities),295 | 多重性,89-90 |
| ML 平台层,296 | 缺乏标签,94 |
| 需求,295 | 主动学习,101-102 |
| 资源管理层,295 | 半监督,98-99 |
| 存储与计算层,295,296,297 | 迁移学习,99-101 |
| 计算资源,297 | 弱监督,95-98 |
| FLOPS,298 | ML 算法,151 91 |
| 私有数据中心,300-302 | 自然标签(natural labels), |
| 公有云,300-302 | 反馈循环长度,92 91 |
| 单元,297 | 推荐系统, |
| 输入,监控,255 | 扰动,114-116 |
| 按需实例,300 | 简单标签保持变换,114 |
| 集成开发环境(见 IDE) | 语言建模,采样与,83 |
| 交错实验,285-287 | 延迟(latency),16 |
| 内部数据库,52 | 延迟与吞吐量(latency versus throughput),16-18 |
| 可解释性(interpretability),20 | 学习,3 |
| 不变性测试,182 | LFs(标注函数),95 |
| IR(中间表示),215 | 启发式,95 |
| 迭代过程(iterative processes) | 日志(logs),51,51 |
| 模型开发与,34 | 实验跟踪,162 256-257 |
| 性能检查,149 | 监控与, |
| 模型更新与,281 | 存储,51 |
| 训练模型与,32-33 | 循环分块(loop tiling),模型优化,218 |
| 数据工程,34 | 损失曲线(loss curve),162 |
| 项目范围界定,34 | 损失函数(loss functions),40 |
| J | (另见目标函数 objective functions)206-208 |
| JSON(JavaScript 对象表示法),54 | 低秩分解(low-rank factorization), |
| 判断抽样(judgment sampling),83 | M |
| K | 可维护性(maintainability),31 |
| k-means 聚类模型,150 | Manning,Christopher,44 |
| Kaggle,数据泄露,136 | MAR(随机缺失)值,124 |
| 208 | MCAR(完全随机缺失)值,124 |
| 知识蒸馏(knowledge distillation), | 合并冲突(merge conflicts),164 |
| Kubeflow,318 Kubernetes(K8s),310,314 | 消息队列,数据流与,77 |
| EKS(弹性 Kubernetes 服务),314 | Metaflow,318 |
| GKE(Google Kubernetes 引擎),314 | 指标(metrics) |
| L | 监控与,250 |
| 标签计算(label computation),271 | 准确率相关指标,252 特征,253-255 |
| 标签模式变化,241 | 预测,252-253 |
| 标签偏移,238,240 | 原始输入,255 |
| 88 | 162 |
| 标注(labeling), | 性能指标(performance metrics), |
| 系统性能,163 思维与数据,43-46 随机缺失(MAR),124 完全随机缺失(MCAR),124 缺失数据,测试分割统计与,138 非随机缺失(MNAR),124 ML(机器学习):浏览器与,222,223 云计算,212-223 复杂模式,4 深度学习与,1 边缘计算,212-223 现有数据与,5 学习,3 模型优化,220-221 预测与,6 生产与,12-21 重复,7 研究与,12-21 规模,7 智能手机与,9 未见数据,6 用例,9-12 何时使用,3-12 ML 算法,2,149 深度学习与,150 标签,151 与神经网络对比,150 ML 模型逻辑,191 ML 模型:持续学习,35 数据迭代,267 调试,165 部署,320 边缘计算,优化,214-221 集成,156,157 装袋,158-159 基学习器,156 提升,159-161 堆叠,161 评估,150 线上测试,281-291 实验跟踪,162-163 导出,193 失败:批次,过拟合,167 组件,167 数据问题,166 特征选择,166 | |
| 超参数与,166 糟糕的模型实现,166 随机种子,167 理论约束,166 迭代,267 监控,35 离线评估,178 基线,179-181 方法,181-188 优化,220-221 参数,模型存储,322 性能指标,162 选择标准,151 其中的人类偏见,153 模型,155 当前与未来的性能,153 简单模型,152 最先进陷阱,152 权衡,154 速度,163 训练,32-33 数据工程,34 分布式,168-172 更新频率,279 数据新鲜度与,279-280 数据迭代与,281 模型迭代与,281 更新,267 版本管理,163-165 ML 平台,319 模型部署,320 模型存储,321-325 ML 平台层,基础设施,296 ML 系统故障:数据分布偏移,237 应对,248-250 概念漂移,238,241 协变量,238-240 检测,242-247 特征变化,241 标签模式变化,241 标签偏移,238,240 ML 系统特有:退化反馈循环,233-236 边界情况,231 生产数据与训练数据不同,229-231 运维预期违例,227 软件 | |
| 崩溃,228 | 推荐系统,91 |
| 依赖故障,227 | 自然语言处理(NLP)(见 NLP) |
| 部署故障,227 | 神经架构搜索(NAS),174 |
| 停机,228 | 神经网络,150 |
| 硬件故障,228 | 位置嵌入,133 |
| ML 系统 | 信息流(newsfeeds) |
| 声明式,62 | 帖子排序,41 |
| 故障,226 | 用户参与度与,41 |
| 迭代过程,32-35 | NLP(自然语言处理),114 |
| 需求 | 数据增强与,113 |
| 适应性,31 | 特征工程,122 |
| 可维护性,31 | 非概率抽样,83 |
| 可靠性,29 | 偏见,83 |
| 可扩展性,30-31 | Norvig,Peter,44 |
| 与传统软件对比,22-23 | NoSQL,63 |
| MLOps,ML 系统设计与,2-3 | 文档模型,63 |
| MNAR(非随机缺失)值,124 模型偏见,AI 伦理,347-348 | 图模型,65 |
| 笔记本(notebooks),IDE 与,304 | |
| 模型校准,183-184 | NSFW(不宜在工作场合浏览)内容过滤,56 |
| 模型卡,AI 伦理,351-353 | NumPy, |
| 206 | |
| 模型压缩(model compression), | O |
| 知识蒸馏,208 | 目标函数(objective functions),40-43 |
| 低秩分解,206-208 | 可观测性(observability),250,259-261 |
| 剪枝,208-209 | 模型的离线(offline)评估,178 |
| 量化,209-211 | 评估 |
| 开发,34 | 基线,179 |
| 模型实现(model implementation), | 现有解决方案,181 |
| 失败与,166 模型并行(model parallelism),分布式训练与,170-172 | 人工,180 随机,180 |
| 模型性能,业务分析,35 | 简单启发式,180 |
| 监控(monitoring),250,263 | 零规则,180 |
| (另见线上测试) | OLAP(联机分析处理),69 |
| 告警与,259 | OLTP(联机事务处理)系统,69 |
| 仪表盘与,258 | 按需实例,300 |
| 日志与,256-257 | 按需预测(on-demand prediction),198 |
| 指标与,250 | 十亿词语言建模基准(One Billion Word Benchmark for Language Modeling),45 |
| 准确率相关指标,252 | 在线特征(online features),199 |
| 特征,253-255 | 在线学习(online learning),268 |
| 预测,252-253 | 在线预测(online prediction),197-201,288 从批量预测迁移到,201-203 |
| 原始输入,255 | 流式管道(streaming pipeline),203-205 |
| 多分类,37,38 多标签分类,38 | 运维预期违例(operation expectation violations),227 |
| 多模态数据,53 | 算子融合(operator fusion),模型优化与,218 |
| N | 编排器(orchestrators) |
| n-gram,120 | HashiCorp Nomad,314 Kubernetes(K8s),314 |
| NAS(神经架构搜索),174 | 边界情况与,232 |
| 自然标签,91 | 异常值(outliers), |
| 反馈循环长度,92 | |
| 过采样(oversampling) | 剪枝,208-209 |
| 过拟合,110 | 公有云与私有数据中心对比,300-302 |
| SMOTE,110 | |
| P | Q |
| pandas,56 | 量化(quantization),209-211 |
| Papermill,305 | 查询语言(query languages),60 |
| 并行化(parallelization),模型优化与,217 | 配额抽样(quota sampling),83 |
| 参数值随时间变化(parameter values over time),163 Pareto 优化(Pareto optimization),42 | |
| Parquet,54,57 | R |
| 二进制文件,57 | 随机基线(random baselines),180 |
| 模式(patterns) | 实时传输(real-time transport) |
| 变化的,8 | 数据流与,74-77 |
| 复杂的,4 | 流式数据与,78 |
| Pearl,Judea,43 | 合理规模(reasonable scale),294 |
| 性能指标,162 系统性能,163 | 召回率指标(recall metrics),107 |
| 114-116 | 推荐系统,标签,91 |
| 扰动(perturbation), | 回归(regression) |
| 半监督的扰动方法,99 | 类别不平衡与,102 |
| 扰动测试,181-182 | 任务,39 |
| 位置嵌入,133-135 | 回归模型(regression models),36 |
| 固定的,135 | 关系数据库(relational databases),60 |
| 精确率指标(precision metrics),107 | 关系模型(relational models),59-62 |
| 预测(prediction),6,39 | 数据归一化,59 |
| 异步,198 | NoSQL,63 |
| 批量预测,197-201 | 文档模型,63 图模型,65 |
| 迁移到在线预测,201-203 | 表(tables),59 |
| 「大部分正确」,用户体验,332-334 按需预测,198 | 可靠性(reliability),29 |
| 在线,197-201 | 重复(repetition),7 |
| 重复性任务(repetitive jobs), | |
| 流式管道,203-205 | 调度,311 请求驱动的数据传递,75 |
| 同步,198 | 重采样(resampling),109 |
| 预测,监控,252-253 | 动态采样,110 |
| 特征的预测能力(predictive power of features),140 | 过采样(oversampling) |
| 过拟合与,110 | |
| 价格优化服务(price optimization service),73 | SMOTE,110 |
| 问题框架(problem framing),35-43 | 两阶段学习(two-phase learning),110 |
| 处理(processing) | 欠采样(undersampling),109 |
| 分析型,67 | 水库采样(reservoir sampling),86-87 |
| 批处理,78-79 ETL(抽取、转换、加载),70-72 流处理,78-79 | 资源管理(resource management),311 |
| 事务型,67 | 资源管理层,基础设施,295 |
| REST(表述性状态转移),74,73 | |
| ACID 与,68 环境, | 出行管理服务(ride management service), |
| 生产环境(production),192 生产,ML 与,12-21 | ROC(受试者工作特征)曲线,108 |
| 项目目标(project objectives),26-28 | Rogati,Monica,44 |
| 项目范围界定(project scoping),34 | ROI(投资回报率),成熟采用阶段,28 |
| 原型开发(prototyping),批量预测与,201 | 行删除(row deletion),125 |
| 行主序格式(row-major format),54-56 CSV(逗号分隔值),54 NumPy,56 RPC(远程过程调用),74 S 采样(sampling),82 重要性采样,87 非概率,83 偏见,83 水库采样,86-87 简单随机抽样,84 分层抽样,84 加权抽样,85 可扩展性(scalability),30-31 自动扩缩容,30 规模(scale),7 部署迷思,196 调度器(schedulers),313-314 Borg,314 Slurm,314 模式(schemas),文档模型,64 界定项目范围(scoping a project),34 自训练(self-training),98 半监督(semi-supervision),98-99 情感分析分类器(sentiment analysis classifier),120 序列化(serialization),193 服务(services):数据流与,73-74 司机管理,73 价格优化,73 出行管理,73 SGD(随机梯度下降),169 影子部署(shadow deployment),282 SHAP(沙普利加性解释),142 简单启发式,离线评估,180 简单标签保持变换,114 简单随机抽样,84 辛普森悖论(Simpson’s paradox),186 偏态分布(skewed distribution),特征缩放与,127 基于切片的评估,185-188 切片(slicing):错误分析,188 基于启发式,188 切片查找器(slice finders),188 Slurm,314 智能手机:数据来源与,52 ML(机器学习)与,9 | |
| 平滑降级(smooth failing),用户体验,334 SMOTE(合成少数类过采样技术),110 Snorkel,95 滚雪球抽样(snowball sampling),83 软 AutoML,173-174 软件系统故障(software system failure):崩溃,228 依赖,227 部署,227 硬件,228 垃圾邮件过滤(spam filtering),41 分割(splitting):数据重复,139 数据泄露与,138 SQL,60 SQL 数据库,61 SSD(固态硬盘),297 堆叠(stacking),集成,161 利益相关者(stakeholders),研究项目,13-15 最先进模型(state-of-the-art models),152 有状态训练(stateful training),265-268 自动化的,277-278 无状态重训练(stateless retraining),265-268 手动的,275 随机梯度下降(SGD),169 存储与计算层,基础设施,295,296,297 计算资源,297 FLOPS(每秒浮点运算次数),298 私有数据中心,300-302 公有云,300-302 单元,297 存储引擎(storage engines),67 分层抽样(stratified sampling),84 流处理(stream processing),78-79 流式数据,实时传输,78 流式特征(streaming features),199 流式管道(streaming pipeline),203-205 结构化数据,66-67 Sutton,Richard,44 同步预测(synchronous prediction),198 合成少数类过采样技术(SMOTE),110 系统性能指标(system performance metrics),163 系统生成数据(system-generated data),50 | |
| T | 缺乏标签,94-102 |
| 标签(tags),模型存储,323 | 自然标签,91-94 93 |
| 任务(tasks) | 用户反馈(user feedback), |
| 分类,36 | n-gram,121 |
| 二分类,37 | 噪声样本(noisy samples),116 |
| 高基数,37 | 采样,82 |
| 多分类,37,38 | 重要性采样,87 |
| 多标签,38 | 非概率,83-84 |
| 标签,91 | 水库采样,86-87 |
| 回归,36,39 | 简单随机抽样,84 |
| 团队(teams) | 分层抽样,84 |
| 跨职能协作,335 | 加权抽样,85 |
| 数据科学家,336-339 | 训练模型,迭代与,32-33 34 |
| 生产管理,336 | 数据工程,34 |
| 遥测(telemetry),260 | 项目范围界定, |
| 线上测试(test in production),263,281 | 事务型处理(transactional processing),67 |
| A/B 测试,283-284 | ACID 与,68 |
| 赌博机(bandits),287-291 | 迁移学习(transfer learning),99-101 |
| 金丝雀发布,285 | 两阶段学习,110 |
| 交错实验,285-287 | |
| 影子部署与,282 | U |
| 文本数据(text data),57 | 欠采样(undersampling),109 |
| 文本文件大小(text file size),57 | 未见数据(unseen data),6 |
| 理论约束(theoretical constraints),失败与,166 | 非结构化数据(unstructured data),66-67 |
| 第三方数据(third-party data),52 | 更新(updates),部署迷思,196 |
| 时间相关数据(time-correlated data),数据泄露与,137 | 用例(use cases),9-12 |
| 训练 | 用户体验,331 |
| 自动再训练,275-277 | 一致性,332 |
| 分布式,168 | 预测,大多正确,332-334 |
| 数据并行与,168-170 | 平滑失败,334 |
| 模型并行与,170-172 | 用户反馈,93 |
| 有状态,265-268 | 用户输入数据,50 |
| 自动,277-278 无状态再训练,265-268 | V |
| 手动,275 | vCPU(虚拟 CPU),299 |
| 训练数据,81 | 向量化,模型优化,217 |
| 类别不平衡,102 | 版本管理,163-165 |
| 算法层面的方法,110-113 | |
| 代码版本管理,164 | |
| 挑战,103-105 | |
| 评估指标,106-108 重采样,109-110 | W |
| 数据增强,113 | WASM(WebAssembly),223、95-98 |
| 扰动,114-116 | 弱监督, |
| 简单的标签保持变换,114 | Snorkel,95 |
| 数据分布,229 数据泄漏,135 | 加权采样,85 词嵌入,133 |
| 工作流管理,314 | |
| 标注,88 | |
| 人工标签,88-90 | Airflow,315-316 |
| DAG(有向无环图),312 Kubeflow,318 Metaflow,318 X XGBoost,142 | |
| Z 零规则基线,180 零样本学习,100 |
关于作者
Chip Huyen(https://huyenchip.com)是 Claypot AI 的联合创始人兼首席执行官,该公司致力于为实时机器学习开发基础设施。此前,她曾在 NVIDIA、Snorkel AI 和 Netflix 工作,帮助全球一些规模最大的组织开发和部署机器学习系统。
在斯坦福大学就读期间,她创建并讲授了「TensorFlow for Deep Learning Research(面向深度学习研究的 TensorFlow)」课程。她目前正在斯坦福大学教授 CS 329S:机器学习系统设计(Machine Learning Systems Design)。本书基于该课程的讲义编写而成。
她还是四本越南语畅销书的作者,其中包括「Xách ba lô lên và Đi(背上背包出发)」系列(Quảng Văn 出版社,2012、2013 年)。该系列入选 FAHASA 2014 年读者票选十大好书(Top 10 Readers Choice Books)。
Chip 的专业领域处于软件工程与机器学习的交叉地带。2019 年,LinkedIn 将她列为软件开发领域十大杰出声音(10 Top Voices in Software Development)之一;2020 年又将其评为数据科学与 AI 领域杰出声音(Top Voices in Data Science & AI)。
Colophon(版权信息)
《机器学习系统设计》(Designing Machine Learning Systems)封面上的动物是红腿石鸡(Alectoris rufa),又名法国石鸡(French partridge)。
红腿石鸡作为猎禽(gamebird)被饲养了几个世纪,这种具有重要经济价值、基本不迁徙的雉科(pheasant family)鸟类原产于欧洲大陆西部,不过其他地区也已引入其种群,包括英格兰、爱尔兰和新西兰。
红腿石鸡体型相对较小但身体粗壮,拥有华丽的羽色和羽毛图案:背部为浅棕色至灰色的羽毛,腹部呈浅粉色,喉部为奶油色,喙呈鲜红色,体侧有红褐色或黑色的横纹。
红腿石鸡主要以种子、叶片、草本植物和根为食,也吃昆虫,每年在干旱的低地地区(如农田)繁殖,在地面巢穴中产卵。尽管它们仍被大量人工饲养,但由于种群数量急剧下降(部分归因于过度捕猎和栖息地消失),这些鸟类如今已被视为近危(near threatened)物种。与 O’Reilly 封面上的所有动物一样,它们对我们的世界至关重要。
封面插画由 Karen Montgomery 绘制,基于《河畔自然史》(The Riverside Natural History)中的一幅古老线刻版画。封面字体为 Gilroy Semibold 和 Guardian Sans;正文使用 Adobe Minion Pro;标题字体为 Adobe Myriad Condensed;代码字体为 Dalton Maag 的 Ubuntu Mono。