MLOps 的基础设施与工具
在第 4 章到第 6 章中,我们讨论了开发 ML 系统的逻辑。在第 7 章到第 9 章中,我们讨论了部署、监控和持续更新 ML 系统时需要考虑的事项。到目前为止,我们一直假设 ML 从业者可以访问实现这些逻辑、落实这些考虑所需的所有工具和基础设施。然而,这一假设远非事实。许多数据科学家告诉我,他们知道自己的 ML 系统应该怎么做才是对的,但他们做不到,因为他们的基础设施没有以能让他们做到的方式搭建起来。
ML 系统是复杂的。系统越复杂,就越能从良好的基础设施中受益。搭建得当的基础设施可以帮助自动化流程,减少对专业知识和工程时间的需求。这反过来又可以加快 ML 应用的开发和交付,减少 bug 的暴露面(surface area),并催生新的用例。然而,如果搭建不当,基础设施用起来痛苦,替换起来昂贵。在本章中,我们将讨论如何为 ML 系统搭建正确的基础设施。
在深入之前,重要的是要指出:每家公司的基础设施需求各不相同。你需要什么样的基础设施,取决于你开发的应用数量以及这些应用的专业化程度。在光谱的一端,有些公司把 ML 用于临时性的业务分析,例如预测明年会有多少新用户,以便在季度规划会议上展示。这些公司可能不需要投资任何基础设施——Jupyter Notebooks、Python 和 Pandas 就是它们最好的朋友。如果你只有一个简单的 ML 用例,比如一个用于向朋友展示的目标检测(object detection)Android 应用,你可能也不需要任何基础设施——你只需要一个兼容 Android 的 ML 框架,比如 TensorFlow Lite。
在光谱的另一端,有些公司开发的应用有独特的需求。例如,自动驾驶汽车对准确率和延迟有独特的要求——算法必须在毫秒内做出响应,而且准确率必须近乎完美,因为一个错误的预测就可能导致严重的事故。同样,Google 搜索对规模有独特的要求,因为大多数公司不会像 Google 那样每秒处理 63,000 次搜索查询,也就是每小时 2.34 亿次搜索查询。1 这些公司很可能需要开发自己的高度专业化的基础设施。Google 为其搜索业务开发了内部基础设施的很大一部分;特斯拉(Tesla)和 Waymo 等自动驾驶汽车公司也是如此。2 专业基础设施的一部分后来被公开并被其他公司采用,这是很常见的。例如,Google 将其内部云基础设施扩展为公有云,成就了 Google Cloud Platform。
在光谱中间是大多数公司,它们将 ML 用于多个常见应用——欺诈检测(fraud detection)模型、价格优化模型、流失预测(churn prediction)模型、推荐系统(recommender system)等——并且规模"合理"。“合理规模"指的是公司每天处理的数据量级是 GB 和 TB,而不是 PB。它们的数据科学团队规模可能在 10 到数百名工程师之间。3 这一类别可能包括从 20 人的初创公司到 Zillow 规模的任何公司,但不包括 FAAAM 规模的公司。4 例如,早在 2018 年,Uber 每天就向其数据湖(data lake)添加数十 TB 的数据,而 Zillow 最大的数据集每天带来 2 TB 的未压缩数据。5 相比之下,即使在 2014 年,Facebook 每天就产生 4 PB 的数据。6
1 Kunal Shah,“This Is What Makes SEO Important for Every Business”,Entrepreneur India,2020 年 5 月 11 日,https://oreil.ly/teQlX。
2 想一窥特斯拉用于 ML 的计算基础设施,我非常推荐在 YouTube 上观看特斯拉 AI Day 2021 的录像。
3 “合理规模"的定义受 Jacopo Tagliabue 的论文启发:“You Do Not Need a Bigger Boat: Recommendations at Reasonable Scale in a (Mostly) Serverless and Open Stack”,arXiv,2021 年 7 月 15 日,https://oreil.ly/YNRZQ。关于合理规模的更多讨论,见 Ciro Greco 的"ML and MLOps at a Reasonable Scale”(2021 年 10 月)。
4 FAAAM 是 Facebook、Apple、Amazon、Alphabet、Microsoft 的首字母缩写。
5 Reza Shiftehfar,“Uber’s Big Data Platform: 100+ Petabytes with Minute Latency”,Uber Engineering,2018 年 10 月 17 日,https://oreil.ly/6Ykd3;Kaushik Krishnamurthi,“Building a Big Data Pipeline to Process Clickstream Data”,Zillow,2018 年 4 月 6 日,https://oreil.ly/SGmNe。
6 Nathan Bronson and Janet Wiener,“Facebook’s Top Open Data Problems”,Meta,2014 年 10 月 21 日,https://oreil.ly/p6QjX。
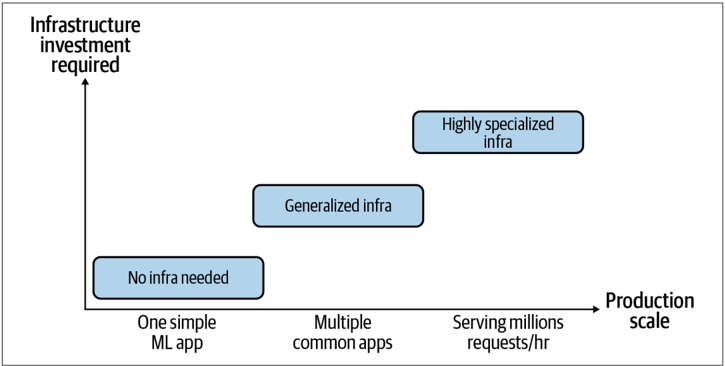
处于光谱中间的公司很可能会受益于日益标准化的通用 ML 基础设施(见图 10-1)。在本书中,我们将聚焦于合理规模下绝大多数 ML 应用所需的基础设施。
图 10-1. 不同生产规模公司的基础设施需求
为了搭建适合你需求的基础设施,理解基础设施的确切含义及其构成非常重要。根据维基百科的说法,在物理世界中,“基础设施是支持家庭和企业可持续运转的基本设施和系统的集合。“7 在 ML 世界中,基础设施是支持 ML 系统开发和维护的基本设施的集合。什么应被视为"基本设施"因公司而异,本章前面已经讨论过这一点。在本节中,我们将考察以下四个层次:
存储与计算
存储层(storage layer)是数据被收集和存储的地方。计算层(compute layer)提供运行 ML 工作负载所需的计算,例如训练模型、计算特征、生成特征等。
资源管理
资源管理(resource management)包括用于调度和编排工作负载的工具,以充分利用你可用的计算资源。这一类工具的例子包括 Airflow、Kubeflow 和 Metaflow。
7 维基百科,“Infrastructure"条目,https://oreil.ly/YaIk8。
ML 平台
这提供了帮助开发 ML 应用的工具,例如模型存储(model store)、特征存储(feature store)和监控工具。这一类工具的例子包括 SageMaker 和 MLflow。
开发环境
这通常被称为开发环境(development environment),简称 dev 环境;它是编写代码和运行实验的地方。代码需要做版本管理和测试。实验需要被跟踪。
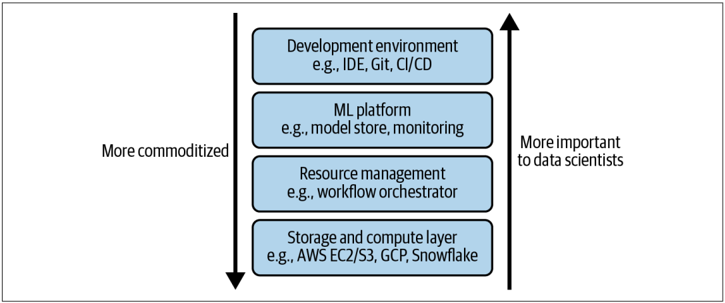
这四个不同的层次如图 10-2 所示。数据和计算是任何 ML 项目所需的基本资源,因此存储与计算层构成了任何想应用 ML 的公司的基础设施基础。这一层对数据科学家来说也是最抽象的。我们先讨论这一层,因为这些资源最容易解释。
图 10-2. ML 基础设施的不同层次
dev 环境是数据科学家每天都要与之交互的环境,因此对他们来说最不抽象。我们接下来讨论这一类别,然后讨论资源管理——这是数据科学家中间一个有争议的话题:人们仍在争论数据科学家是否需要了解这一层。因为"ML 平台"是一个相对较新的概念,其不同组成部分仍在成熟中,我们把它放在最后讨论,等我们熟悉了其他所有类别之后再说。ML 平台需要公司进行前期投入,但如果做得好,它能让该公司各个业务用例的数据科学家的生活轻松得多。
即使两家公司的基础设施需求完全相同,它们最终的基础设施也可能看起来不同,这取决于它们对自建(build)与购买(buy)决策的不同态度——即哪些想自建、哪些想外包给其他公司。我们将在本章最后一部分讨论自建与购买决策,届时我们还会讨论对标准化、统一化 ML 基础设施抽象的希望。
让我们开始吧!
存储与计算
ML 系统要处理大量数据,这些数据需要存储在某个地方。存储层就是数据被收集和存储的地方。最简单的形式,存储层可以是一块机械硬盘(HDD,hard drive disk)或固态硬盘(SSD,solid state disk)。存储层可以集中在一个地方,例如你可能把所有的数据放在 Amazon S3 或 Snowflake 中,也可以分散在多个位置。8 你的存储层可以位于私有数据中心的本地(on-prem),也可以位于云端。过去,公司可能会尝试自己管理存储层。然而,在过去十年里,存储层基本上已经被商品化并转移到云端。数据存储变得如此便宜,以至于大多数公司干脆把所有数据都存下来,几乎不用考虑成本。9 我们在第 3 章中深入讨论过数据层,因此本章将聚焦于计算层。
计算层指的是公司可以访问的所有计算资源,以及决定如何使用这些资源的机制。可用计算资源的数量决定了你的工作负载的可扩展性。你可以把计算层想象成执行你的任务的引擎。最简单的形式,计算层可以只是一个完成所有计算的 CPU 核心或 GPU 核心。最常见的形式是由云提供商(如 AWS Elastic Compute Cloud(EC2)或 GCP)管理的云计算。
计算层通常可以被切分成更小的计算单元(compute unit)以并发使用。例如,一个 CPU 核心可能支持两个并发线程;每个线程被用作一个计算单元来执行各自的任务。或者多个 CPU 核心可以组合在一起,形成一个更大的计算单元来执行更大的任务。计算单元可以为了某个特定的短期任务而创建,例如 AWS Step Function 或 GCP Cloud Run——任务完成后该单元就会被销毁。计算单元也可以被创建得更加"永久”,即不与某个任务绑定,比如虚拟机(virtual machine)。更持久的计算单元有时被称为"实例(instance)"。
8 我见过一家公司的数据分散在 Amazon Redshift 和 GCP BigQuery 上,他们的工程师对此相当不满。
9 我们在这里只讨论数据存储,因为数据系统我们已在第 2 章讨论过。
然而,计算层并不总是用线程或核心作为计算单元。有些计算层抽象掉了核心的概念,使用其他的计算单位。例如,像 Spark 和 Ray 这样的计算引擎用"任务(job)“作为单位,而 Kubernetes 用"pod”——容器(container)的包装——作为其最小可部署单元。虽然一个 pod 里可以有多个容器,但你不能独立启动或停止同一个 pod 中的不同容器。
要执行一个任务,你首先需要把所需的数据加载到计算单元的内存中,然后对这些数据执行所需的操作——加法、乘法、除法、卷积(convolution)等。例如,要把两个数组相加,你首先需要把这两个数组加载到内存中,然后对它们执行加法。如果计算单元没有足够的内存来加载这两个数组,那么在没有处理内存不足(out-of-memory)计算的算法的情况下,这个操作就不可能完成。因此,计算单元主要由两个指标来刻画:它有多少内存,以及它运行操作的速度有多快。
内存指标可以用 GB 等单位来指定,评估起来通常很直接:一个 8 GB 内存的计算单元能比只有 2 GB 内存的计算单元在内存中处理更多数据,而且通常也更贵。10 一些公司不仅关心计算单元有多少内存,还关心数据进出内存有多快,因此一些云提供商宣传其实例具有"高带宽内存”,或指明其实例的 I/O 带宽。
操作速度则更有争议。最常见的指标是 FLOPS——每秒浮点运算次数(floating point operations per second)。顾名思义,这个指标表示一个计算单元每秒能运行的浮点运算次数。你可能会看到硬件厂商宣传他们的 GPU、TPU 或 IPU(智能处理单元,intelligence processing unit)具有 teraFLOPS(一万亿 FLOPS)或其他数量庞大的 FLOPS 数字。
然而,这个指标之所以有争议,首先是因为测量这个指标的公司可能对什么算作一次运算有不同的看法。例如,如果一台机器把两个运算融合成一个并执行这个融合后的运算,11 这算一次运算还是两次?其次,仅仅因为一个计算单元有能力每秒执行一万亿次浮点运算,并不意味着你能以每秒一万亿次浮点运算的速度执行你的任务。一个任务能运行的 FLOPS 数量与计算单元能处理的 FLOPS 数量之比称为利用率(utilization)。12 如果一个实例每秒能处理一百万次浮点运算,而你的任务以每秒 30 万次浮点运算运行,那就是 30% 的利用率。当然,你希望利用率尽可能高。然而,要达到 100% 的利用率几乎是不可能的。取决于硬件后端和应用,50% 的利用率可能被认为好,也可能被认为差。利用率还取决于你能多快把数据加载到内存中以执行下一个操作——这就是 I/O 带宽重要性的原因。13
10 截至本书写作时,一个 ML 工作负载通常需要 4 GB 到 8 GB 的内存;16 GB 的内存足以处理大多数 ML 工作负载。
11 参见第 216 页"模型优化"一节中的运算融合(operation fusion)。
12 “What Is FLOP/s and Is It a Good Measure of Performance?",Stack Overflow,最后更新于 2020 年 10 月 7 日,https://oreil.ly/M8jPP。
在评估一个新的计算单元时,重要的是评估这个计算单元完成常见工作负载需要多长时间。例如,MLPerf 是一个流行的基准(benchmark),硬件厂商用它来展示硬件性能,方法是在 ImageNet 数据集上训练 ResNet-50 模型需要多长时间,或使用 BERT-large 模型为 SQuAD 数据集生成预测需要多长时间。
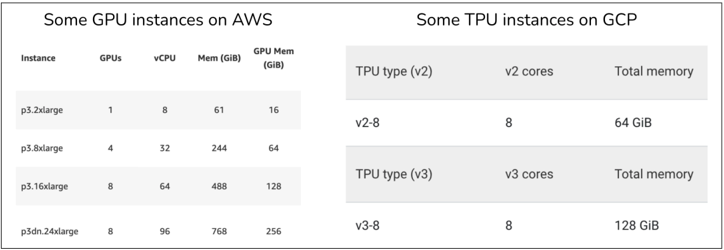
因为思考 FLOPS 并不是很有用,为了简化,许多人在评估计算性能时只看一个计算单元有多少个核心。所以你可以用一个 4 个 CPU 核心、8 GB 内存的实例。请记住,AWS 使用 vCPU 的概念,vCPU 代表虚拟 CPU(virtual CPU),在实际使用中可以认为相当于半个物理核心。14 你可以在图 10-3 中看到一些 AWS EC2 和 GCP 实例提供的核心数和内存。
图 10-3. 截至 2022 年 2 月,AWS 和 GCP 上可用的 GPU 和 TPU 实例示例。来源:AWS 和 GCP 网站截图
13 对 FLOPS 和带宽以及如何为深度学习模型优化它们感兴趣的读者,我推荐"Making Deep Learning Go Brrrr From First Principles"这篇文章(He 2022)。
14 根据 Amazon 的说法,“EC2 实例支持多线程(multithreading),这使得多个线程可以在单个 CPU 核心上并发运行。每个线程在实例上表示为一个虚拟 CPU(vCPU)。实例有默认的 CPU 核心数,因实例类型而异。例如,m5.xlarge 实例类型默认有两个 CPU 核心,每个核心两个线程——总共四个 vCPU”(“Optimize CPU Options”,Amazon Web Services,最后访问于 2020 年 4 月,https://oreil.ly/eeOtd)。
公有云与私有数据中心
与数据存储一样,计算层在很大程度上已经商品化。这意味着公司不必自建数据中心来存储和计算,而是可以按实际使用的计算量向 AWS 和 Azure 等云提供商付费。云计算让公司可以极其容易地开始构建,而无需操心计算层。它尤其吸引那些工作负载规模波动的公司。想象一下,如果你的工作负载在一年中的某一天需要 1,000 个 CPU 核心,而在其余时间只需要 10 个 CPU 核心。如果你自建数据中心,你需要为 1,000 个 CPU 核心提前付费。使用云计算,你只需要在那一天为 1,000 个 CPU 核心付费,其余时间为 10 个 CPU 核心付费。能够按需添加更多计算或关闭实例是很方便的——大多数云提供商甚至会自动为你做这些——从而减少工程运维开销。这在 ML 中尤其有用,因为数据科学工作负载是突发性的。数据科学家在开发阶段的几周内往往会大量运行实验,这需要计算能力的激增。而到了生产阶段,工作负载则更加稳定。
请记住,云计算是弹性的,但并非魔法。它实际上并没有无限的计算能力。大多数云提供商会对你同时使用的计算资源设置上限。这些上限中有一部分(但不是全部)可以通过申请提高。例如,截至本书写作时,AWS EC2 最大的实例是 X1e,有 128 个 vCPU 和近 4 TB 的内存。15 拥有大量计算资源并不意味着它们总是容易使用,尤其是当你为了省钱而不得不用竞价实例(spot instance)时。16
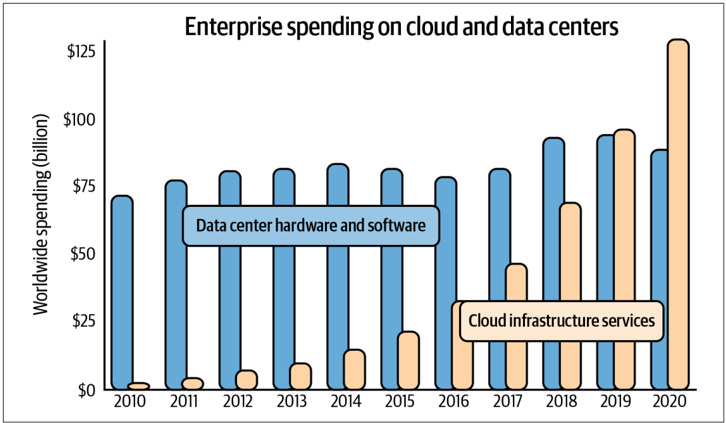
由于云的弹性和易用性,越来越多的公司选择为云付费,而不是自建和维护自己的存储与计算层。Synergy Research Group 的研究显示,2020 年,“企业在云基础设施服务上的支出(增长了)35%,达到近 1,300 亿美元”,而"企业在数据中心(支出)下降了 6%,降至不到 900 亿美元”,17 如图 10-4 所示。
15 价格为 26.688 美元/小时。
16 按需实例(on-demand instance)是你在请求时就可用的实例。竞价实例(spot instance)是当没有其他人使用时才可用的实例。与按需实例相比,云提供商倾向于以折扣价提供竞价实例。
17 Synergy Research Group,“2020—The Year That Cloud Service Revenues Finally Dwarfed Enterprise Spending on Data Centers”,2021 年 3 月 18 日,https://oreil.ly/uPx94。
图 10-4. 2020 年,企业在云基础设施服务上的支出增长了 35%,而在数据中心上的支出下降了 6%。来源:改编自 Synergy Research Group 的一张图
虽然利用云在早期往往比自建存储与计算层给公司带来更高的回报,但随着公司的发展,这一点就不那么站得住脚了。根据上市软件公司披露的云基础设施支出,风投公司 a16z 显示,云支出约占这些公司收入成本的 50%。18
云的高成本促使公司开始把工作负载迁回自己的数据中心,这一过程被称为"云遣返(cloud repatriation)"。Dropbox 在 2018 年的 S-1 文件中显示,由于基础设施优化大改造——其中很大一部分是把工作负载从公有云迁回自己的数据中心——该公司在 IPO 前两年节省了 7,500 万美元。云的高成本是否因为 Dropbox 从事数据存储业务而独有?不完全是。在上述分析中,a16z 估计,“在目前使用云基础设施的前 50 家上市软件公司中,云对利润率的影响导致它们合计损失了约 1,000 亿美元的市场价值——相比它们自己运行这些基础设施而言”。19
虽然开始使用云很容易,但离开云很难。云遣返需要在硬件和工程投入上进行不菲的前期投资。越来越多的公司正在采取混合方案:把大部分工作负载留在云上,同时慢慢增加对数据中心的投资。
18 Sarah Wang and Martin Casado,“The Cost of Cloud, a Trillion Dollar Paradox”,a16z,https://oreil.ly/3nWU3。
19 同上:Wang and Casado,“The Cost of Cloud”。
多云策略
另一种减少公司对任何单一云提供商依赖的方式是采用多云(multicloud)策略:把工作负载分散到多个云提供商上。20 这使公司能够架构其系统,使其兼容多个云,从而利用最好、最具成本效益的技术,而不是被困在单一云提供商提供的服务中——这种情况被称为厂商锁定(vendor lock-in)。Gartner 2019 年的一项研究显示,81% 的组织正在与两个或更多的公有云提供商合作。21 我见过的 ML 工作负载的常见模式是在 GCP 或 Azure 上训练,在 AWS 上部署。
多云策略通常不是出于选择。正如我们的早期审稿人之一 Josh Wills 所说:“没有哪个神志正常的人打算使用多云。“跨云移动数据和编排工作负载极其困难。
通常,多云之所以发生,只是因为组织的不同部分独立运作,每个部分自己做云决策。它也可能发生在收购之后——被收购的团队已经使用了与母公司不同的云,而迁移尚未进行。
在我的工作中,我看到多云因战略投资而发生。微软和 Google 是初创生态系统的重大投资者,与我合作的几家公司此前在 AWS 上,在微软/Google 投资他们之后迁移到了 Azure/GCP。
开发环境
dev 环境是 ML 工程师编写代码、运行实验,并与部署了冠军模型(champion model)、评估挑战者模型(challenger model)的生产环境交互的地方。dev 环境由以下组件组成:IDE(集成开发环境,integrated development environment)、版本管理(versioning)和 CI/CD。
如果你是一位每天写代码的数据科学家或 ML 工程师,你可能对这些工具非常熟悉,并想知道它们有什么好说的。根据我的经验,除了少数科技公司之外,大多数公司的 dev 环境都被严重低估和投入不足。Ville Tuulos 在他的书《Effective Data Science Infrastructure》中写道:“你会惊讶地发现,有多少公司拥有调优良好的、可扩展的生产基础设施,但代码最初是如何开发、调试和测试的这个最基本的问题,却是以临时拼凑(ad hoc)的方式解决的。“22
20 Laurence Goasduff,“Why Organizations Choose a Multicloud Strategy”,Gartner,2019 年 5 月 7 日,https://oreil.ly/ZiqzQ。
21 Goasduff,“Why Organizations Choose a Multicloud Strategy”。
他建议:“如果你只有时间把一块基础设施搭好,那就把数据科学家的开发环境搭好。“因为 dev 环境是工程师工作的地方,dev 环境的改进直接转化为工程生产力的改进。
在本节中,我们首先介绍 dev 环境的不同组件,然后讨论 dev 环境的标准化,最后讨论如何用容器把你的改动从 dev 环境带到生产环境。
开发环境搭建
dev 环境应该搭建得包含所有能让工程师更轻松完成工作的工具。它也应该包含版本管理的工具。截至本书写作时,公司使用一套临时拼凑的工具来对 ML 工作流做版本管理,例如用 Git 对代码做版本控制,用 DVC 对数据做版本控制,用 Weights & Biases 或 Comet.ml 在开发期间跟踪实验,用 MLflow 在部署模型时跟踪模型的产物(artifact)。Claypot AI 正在开发一个平台,可以帮助你在一个地方对所有的 ML 工作流进行版本管理和跟踪。版本管理对任何软件工程项目都很重要,对 ML 项目更是如此,因为既可更改的东西数量庞大(代码、参数、数据本身等),又需要跟踪以前的运行以便日后复现。我们已在第 162 页的"实验跟踪与版本管理"一节中讨论过这一点。
dev 环境还应该配置 CI/CD 测试套件,以便在把代码推送到预发布(staging)或生产环境之前进行测试。编排 CI/CD 测试套件的工具示例包括 GitHub Actions 和 CircleCI。因为 CI/CD 是软件工程领域的问题,超出了本书的范围。
在本节中,我们聚焦于工程师编写代码的地方:IDE。
IDE
IDE 是你编写代码的编辑器。IDE 往往支持多种编程语言。IDE 可以是原生应用,如 VS Code 或 Vim。IDE 也可以是基于浏览器的,即它们在浏览器中运行,如 AWS Cloud9。
22 Ville Tuulos,Effective Data Science Infrastructure(Manning,2022)。
许多数据科学家不仅在 IDE 中写代码,还在 Jupyter Notebooks 和 Google Colab 等笔记本(notebook)中写代码。23 笔记本不仅仅是写代码的地方。你可以加入任意的内容,如图片、图表、格式美观的表格数据等,这使得笔记本对探索性数据分析和分析模型训练结果非常有用。
笔记本有一个很好的特性:它们是有状态的(stateful)——它们在运行后可以保留状态。如果你的程序中途失败,你可以从失败的步骤重新运行,而不必从头运行整个程序。当你必须处理加载耗时很长的大型数据集时,这一点尤其有用。使用笔记本,你只需要加载一次数据——笔记本可以在内存中保留这些数据——而不必每次运行代码时都重新加载。如图 10-5 所示,如果你的代码在笔记本的第 4 步失败,你只需要重新运行第 4 步,而不是从头运行你的程序。
图 10-5. 在 Jupyter Notebook 中,如果第 4 步失败,你只需要重新运行第 4 步,而不必重新运行第 1 到第 4 步
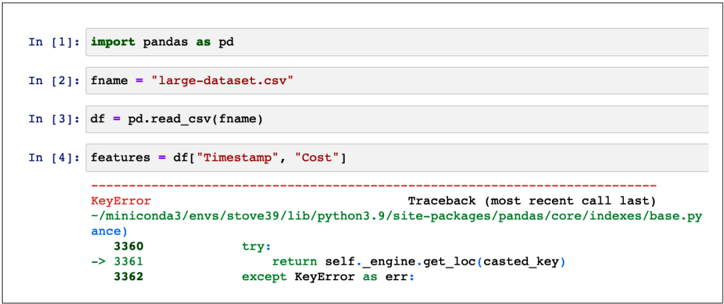
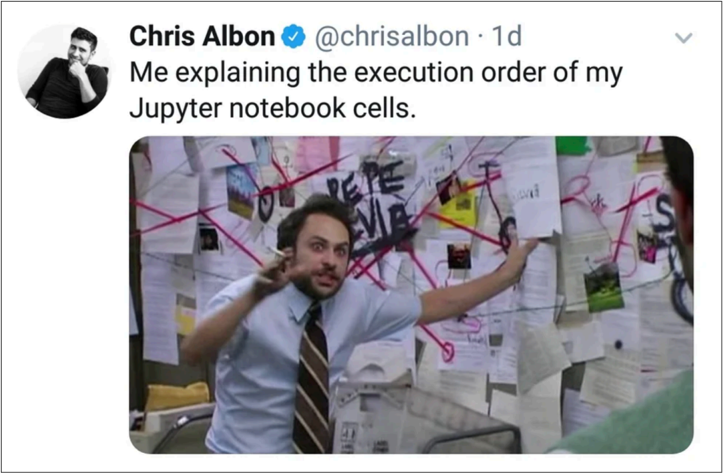
请注意,这种有状态性是一把双刃剑,因为它允许你不按顺序执行单元格。例如,在普通脚本中,单元格 4 必须在单元格 3 之后运行,单元格 3 必须在单元格 2 之后运行。然而,在笔记本中,你可以先运行单元格 2、3,再运行 4,或者先运行 4、3,再运行 2。这使得笔记本更难复现,除非你的笔记本附带运行单元格顺序的说明。这个难题被 Chris Albon 的一个笑话捕捉到了(见图 10-6)。
23 截至本书写作时,Google Colab 甚至为其用户提供免费的 GPU。
图 10-6. 笔记本的有状态性允许你不按顺序执行单元格,使笔记本难以复现
因为笔记本对数据探索和实验如此有用,笔记本已成为数据科学家和 ML 不可或缺的工具。一些公司把笔记本作为其数据科学基础设施的中心。Netflix 在其开创性文章"Beyond Interactive: Notebook Innovation at Netflix"中,列出了一份可以用来让笔记本更强大的基础设施工具清单。24 这份清单包括:
用于以不同的参数集生成多个笔记本——例如,当你想用不同的参数集运行不同的实验并并发执行它们时。它还可以帮助汇总一组笔记本的指标。
一个笔记本中心(notebook hub),用于在组织内查看、查找和共享笔记本。
24 Michelle Ufford, M. Pacer, Matthew Seal, and Kyle Kelley,“Beyond Interactive: Notebook Innovation at Netflix”,Netflix Technology Blog,2018 年 8 月 16 日,https://oreil.ly/EHvAe。
另一个旨在改善笔记本体验的有趣项目是 nbdev,它是 Jupyter Notebooks 之上的一个库,鼓励你在同一个地方编写文档和测试。
标准化开发环境
关于 dev 环境,首先要说的是它应该被标准化,如果不能全公司统一,至少团队内要统一。我们来看一个故事,理解 dev 环境标准化意味着什么,以及为什么需要它。
在我们初创公司的早期,我们各自用自己的电脑工作。我们有一个 bash 文件,新团队成员可以运行它来创建一个新的虚拟环境——我们使用 conda 管理虚拟环境——并安装运行我们的代码所需的包。所需包的清单就是我们一直在维护的 requirements.txt,每当我们开始使用一个新包,就往里加。有时,我们中的某个人偷懒,只添加了包名(例如 torch),而没有指定包的版本(例如 torch==1.10.0+cpu)。偶尔,一个新的 pull request 在我的电脑上运行得很好,但在另一个同事的电脑上却不行,25 我们通常很快就会发现这是因为我们用了同一个包的不同版本。我们下定决心,在向 requirements.txt 添加新包时总是同时指定包名和包版本,这消除了很多不必要的麻烦。
有一天,我们遇到一个奇怪的 bug,只在某些运行中出现,其他运行没有。我请同事看看,但他无法复现这个 bug。我告诉他这个 bug 只是偶尔出现,所以他可能需要运行代码大约 20 次才能确定。他运行了 20 次代码,仍然一无所获。我们对比了彼此的包,一切都匹配。经过几个小时抓狂的折腾,我们发现这是一个并发问题,只有 Python 3.8 或更早版本才会出现。我的是 Python 3.8,同事的是 Python 3.9,所以他没有看到这个 bug。我们下定决心让所有人使用相同的 Python 版本,这又消除了一些头疼问题。
然后有一天,我的同事换了一台新笔记本电脑。那是一台搭载当时新款 M1 芯片的 MacBook。他试图在这台新笔记本上按照我们的搭建步骤操作,但遇到了困难。这是因为 M1 芯片是新的,我们使用的一些工具,包括 Docker,当时还不能很好地与 M1 芯片配合。看到他折腾了一整天来搭建环境之后,我们决定迁移到云开发环境。这意味着我们仍然对虚拟环境、工具和包进行标准化,但现在每个人都在同一类型的机器上使用这些虚拟环境、工具和包,这台机器由云提供商提供。
25 对不了解的人来说,可以把新的 pull request 理解为要添加到代码库中的一段新代码。
使用云开发环境时,你可以使用自带云 IDE 的云开发环境,如 AWS Cloud9(没有内置笔记本)和 Amazon SageMaker Studio(自带托管的 JupyterLab)。截至本书写作时,Amazon SageMaker Studio 似乎比 Cloud9 使用得更广泛。然而,我认识的大多数使用云 IDE 的工程师,都是在他们的云实例上安装自己选择的 IDE(如 Vim)。
一个更受欢迎的选择是使用云开发环境搭配本地 IDE。例如,你可以使用安装在电脑上的 VS Code,用安全外壳协议(SSH,Secure Shell)等安全协议把本地 IDE 连接到云环境。
虽然大家普遍同意工具和包应该标准化,但一些公司对标准化 IDE 犹豫不决。工程师们会对 IDE 产生情感依恋,有些人为了捍卫自己选择的 IDE 不遗余力,26 所以强迫所有人使用同一个 IDE 会很困难。然而,多年过去,一些 IDE 已经脱颖而出成为最受欢迎的。其中,VS Code 是一个不错的选择,因为它可以轻松与云开发实例集成。
在我们的初创公司,我们选择了 GitHub Codespaces 作为云开发环境,但可以 SSH 进入的 AWS EC2 或 GCP 实例也是不错的选择。在迁移到云环境之前,和许多其他公司一样,我们担心成本——如果我们在不使用时忘记关闭实例,它们会不会一直向我们收费?然而,这种担心已经消失了,原因有二。第一,像 GitHub Codespaces 这样的工具会在 30 分钟无活动后自动关闭你的实例。第二,有些实例相当便宜。例如,一个 4 个 vCPU、8 GB 内存的 AWS 实例每小时花费约 0.1 美元,如果你从不关闭它,一个月大约 73 美元。因为工程时间很贵,如果云开发环境能帮你每月节省几个小时的工程时间,对许多公司来说就是值得的。
从本地开发环境迁移到云开发环境还有很多其他好处。第一,它让 IT 支持容易得多——想象一下要支持 1,000 台不同的本地机器,而不是只支持一种类型的云实例。第二,它对远程工作很方便——无论你走到哪里,都可以从任何电脑 SSH 到你的开发环境。第三,云开发环境有助于安全。例如,如果员工的笔记本电脑被偷了,你只需撤销那台笔记本对云实例的访问权限,就能防止窃贼访问你的代码库和专有信息。当然,一些公司也可能因为安全顾虑而无法迁移到云开发环境。例如,他们不被允许把代码或数据放到云端。
26 参见编辑器大战(editor war),一场持续十年之久的关于 Vim 与 Emacs 的激烈辩论。
第四个好处——我认为对于在生产中使用云的公司来说这是最大的好处——是把你的 dev 环境放在云端缩小了 dev 环境与生产环境之间的差距。如果你的生产环境在云端,那么把 dev 环境也搬到云端是很自然的事。
偶尔,公司不得不把 dev 环境搬到云端,不仅是因为这些好处,也是出于必要。对于无法下载或存储在本地机器上的数据用例,访问它的唯一方式是通过云端的一个笔记本(SageMaker Studio),只要它有正确的权限,就可以从 S3 读取数据。
当然,云开发环境可能并不适合每家公司,因为成本、安全或其他顾虑。搭建云开发环境也需要一些前期投入,你可能还需要对数据科学家进行云卫生(cloud hygiene)教育,包括建立到云的安全连接、安全合规,或避免浪费的云使用。然而,dev 环境的标准化可能会让你的数据科学家的生活更轻松,从长远来看为你省钱。
从开发到生产:容器
在开发期间,你通常使用固定数量的机器或实例(通常一台)工作,因为你的工作负载波动不大——你的模型不会突然从每小时只服务 1,000 个请求变成每小时服务 100 万个请求。
另一方面,生产服务可能分布在多个实例上。实例的数量会不时变化,取决于传入的工作负载,而工作负载有时是不可预测的。例如,一位名人发推提到了你刚起步的应用,突然你的流量飙升 10 倍。你将不得不按需开启新实例,而这些实例需要配置好执行工作负载所需的工具和包。
过去,你需要自己启动和关闭实例,但大多数公有云提供商已经解决了自动伸缩(autoscaling)部分。然而,你仍然需要操心新实例的配置。
当你始终使用同一个实例时,你可以安装一次依赖,之后每次使用这个实例时都可以用。在生产中,如果你按需动态分配实例,你的环境本质上是无状态的(stateless)。当一个新的实例被分配给你的工作负载时,你需要按照一组预定义的指令来安装依赖。
问题来了:你如何在任何新实例上重建一个环境?容器技术——其中 Docker 最流行——就是为回答这个问题而设计的。使用 Docker,你创建一个 Dockerfile,其中包含如何在某个环境中逐步重建你的模型可以运行的环境的指令:安装这个包、下载这个预训练模型、设置环境变量、进入某个文件夹等。这些指令让任何地方的硬件都能运行你的代码。
Docker 中的两个关键概念是镜像(image)和容器(container)。运行 Dockerfile 中的所有指令,你就得到了一个 Docker 镜像。如果你运行这个 Docker 镜像,你就得到一个 Docker 容器。你可以把 Dockerfile 想成构造模具的配方,模具就是 Docker 镜像。从这个模具,你可以创建多个运行实例;每一个都是一个 Docker 容器。
你可以从头构建 Docker 镜像,也可以基于另一个 Docker 镜像构建。例如,NVIDIA 可能提供一个包含 TensorFlow 和为 GPU 优化 TensorFlow 所需的所有库的 Docker 镜像。如果你想构建一个在 GPU 上运行 TensorFlow 的应用,用这个 Docker 镜像作为基础镜像,然后在这个基础镜像之上安装你的应用特有的依赖,并不是一个坏主意。
容器注册表(container registry)是你可以分享 Docker 镜像或找到其他人创建的镜像的地方,这些镜像可以公开发布,也可以只对组织内部人员开放。常见的容器注册表包括 Docker Hub 和 AWS ECR(Elastic Container Registry,弹性容器注册表)。
下面是一个简单的 Dockerfile 示例,它执行以下指令。这个示例是为了展示 Dockerfile 一般是如何工作的,可能无法直接执行。
- 下载最新的 PyTorch 基础镜像。
- 克隆 NVIDIA 在 GitHub 上的 apex 仓库,进入新建的 apex 文件夹,并安装 apex。
- 把 fancy-nlp-project 设置为工作目录。
- 克隆 Hugging Face 在 GitHub 上的 transformers 仓库,进入新建的 transformers 文件夹,并安装 transformers。
FROM pytorch/pytorch:latest RUN git clone https://github.com/NVIDIA/apex RUN cd apex && \ python3 setup.py install && \ pip install -v --no-cache-dir --global-option="--cpp_ext" \ --global-option="--cuda_ext" ./ WORKDIR /fancy-nlp-project RUN git clone https://github.com/huggingface/transformers.git && \ cd transformers && \ python3 -m pip install --no-cache-dir.
如果你的应用做了任何有趣的事情,你可能需要不止一个容器。考虑这样一个项目:特征化(featurizing)代码运行快但需要大量内存,模型训练代码运行慢但需要的内存较少。如果你在同一批 GPU 实例上运行这两部分代码,你需要高内存的 GPU 实例,这可能非常昂贵。相反,你可以在 CPU 实例上运行特征化代码,在 GPU 实例上运行模型训练代码。这意味着你需要一个用于特征化的容器和另一个用于训练的容器。
当你的流水线中的不同步骤有相互冲突的依赖时,也可能需要不同的容器,例如你的特征化代码需要 NumPy 0.8,而你的模型需要 NumPy 1.0。
如果你有 100 个微服务,每个微服务都需要自己的容器,你可能会同时运行 100 个容器。手动构建、运行、分配资源和停止 100 个容器可能是一件痛苦的差事。帮助你管理多个容器的工具称为容器编排(container orchestration)。Docker Compose 是一个轻量级的容器编排器,可以在单个主机上管理容器。
然而,你的每个容器可能运行在各自的主机上,这正是 Docker Compose 的局限所在。Kubernetes(K8s)正是为此而生的工具。K8s 创建一个网络,让容器之间可以通信和共享资源。它可以帮助你在需要更多计算/内存时在更多实例上启动容器,也可以在你不再需要它们时关闭容器,并帮助你的系统保持高可用性(high availability)。
K8s 是 2010 年代增长最快的技术之一。自 2014 年诞生以来,它如今已在生产系统中无处不在。Jeremy Jordan 为有兴趣进一步了解的读者写了一篇很好的 K8s 入门介绍。然而,K8s 不是最对数据科学家友好的工具,关于如何把数据科学工作负载从它上面迁移走,已经有很多讨论。27 我们将在下一节更详细地介绍 K8s。
27 Chip Huyen,“Why Data Scientists Shouldn’t Need to Know Kubernetes”,2021 年 9 月 13 日,https://huyenchip.com/2021/09/13/data-science-infrastructure.html;Neil Conway and David Hershey,“Data Scientists Don’t Care About Kubernetes”,Determined AI,2020 年 11 月 30 日,https://oreil.ly/FFDQW;I Am Developer 在 Twitter 上(@iamdevloper):“我连自己的感受都几乎搞不懂,怎么可能指望我搞懂 kubernetes”,2021 年 6 月 26 日,https://oreil.ly/T2eQE。
资源管理
在前云时代(甚至今天在维护自己数据中心的公司里),存储和计算是有限的。那时的资源管理围绕着如何充分利用有限的资源。增加一个应用的资源可能意味着减少其他应用的资源,需要复杂的逻辑来最大化资源利用率,即使这意味着需要更多的工程时间。
然而,在存储和计算资源弹性大得多的云世界里,关注点已经从如何最大化资源利用率转变为如何经济高效地使用资源。给一个应用增加更多资源并不意味着减少其他应用的资源,这大大简化了资源分配问题。许多公司可以接受给应用增加更多资源,只要增加的成本被回报所证明是合理的,例如额外的收入或节省的工程时间。
在绝大多数情况下,工程师的时间比计算时间更宝贵,因此公司愿意使用更多资源,如果这意味着能帮助工程师提高生产力的话。这意味着公司投资自动化工作负载可能是合理的——这可能会使资源使用不如手动规划工作负载那么高效,但能把工程师解放出来,专注于回报更高的工作。通常,如果一个问题的解决要么靠使用更多的非人力资源(例如投入更多的计算),要么靠使用更多的人力资源(例如要求更多的工程时间来重新设计),前者可能更受青睐。
在本节中,我们将讨论如何为 ML 工作流管理资源。我们将聚焦于基于云的资源;然而,所讨论的思想也适用于私有数据中心。
Cron、调度器与编排器
ML 工作流有两个影响其资源管理的关键特征:重复性(repetitiveness)和依赖性(dependencies)。
在本书中,我们详细讨论过开发 ML 系统是一个迭代过程。同样,ML 工作负载很少是一次性操作,而是重复性的。例如,你可能每周训练一次模型,或每四小时生成一批新的预测。这些重复的过程可以被调度和编排,以便利用可用资源平稳、经济高效地运行。
在固定时间调度重复任务,正是 cron 所做的事情。这也是 cron 的全部功能:在预定时间运行一个脚本,并告诉你任务是成功还是失败。它不关心它运行的任务之间的依赖关系——你可以用 cron 在任务 B 之后运行任务 A,但不能调度任何复杂的东西,比如"A 成功则运行 B,A 失败则运行 C”。
这引出了第二个特征:依赖性。ML 工作流中的步骤之间可能有复杂的依赖关系。例如,一个 ML 工作流可能由以下步骤组成:
- 从数据仓库拉取上周的数据。
- 从拉取的数据中提取特征。
- 在提取的特征上训练两个模型 A 和 B。
- 在测试集上比较 A 和 B。
- 如果 A 更好则部署 A;否则部署 B。
每一步都依赖于前一步的成功。第 5 步就是我们所说的条件依赖(conditional dependency):这一步的动作取决于前一步的结果。这些步骤之间的执行顺序和依赖关系可以用图来表示,如图 10-7 所示。
图 10-7. 一个展示简单 ML 工作流执行顺序的图,本质上是一个 DAG(有向无环图,directed acyclic graph)
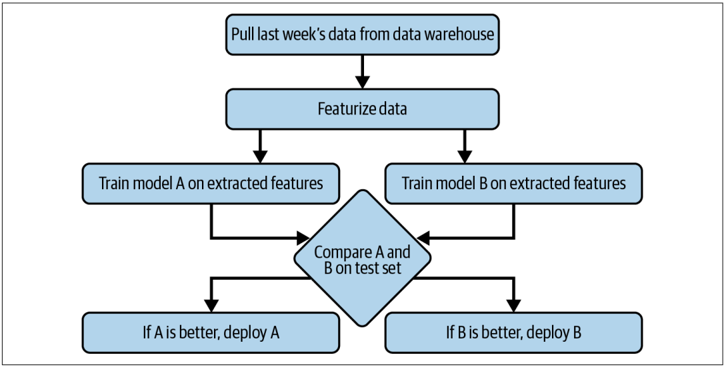
许多读者可能已经认出图 10-7 是一个 DAG:有向无环图。它必须是有向的,以表达步骤之间的依赖关系。它不能包含环,因为如果有环,任务就会永远运行下去。DAG 是表示计算工作流的常见方式,不仅仅适用于 ML 工作流。大多数工作流管理工具都要求你以 DAG 的形式指定工作流。
调度器(scheduler)是能处理依赖关系的 cron 程序。它接收工作流的 DAG,并相应地调度每一步。你甚至可以基于事件触发器来调度任务,例如,每当事件 X 发生时启动一个任务。调度器还允许你指定任务失败或成功时该做什么,例如,如果失败,在放弃之前重试多少次。
调度器往往利用队列(queue)来跟踪任务。任务可以被排队、设置优先级,并被分配执行所需的资源。这意味着调度器需要了解可用资源和运行每个任务所需的资源——所需资源要么在调度任务时作为选项指定,要么由调度器估计。例如,如果一个任务需要 8 GB 内存和两个 CPU,调度器需要在它管理的资源中找到一个 8 GB 内存、两个 CPU 的实例,并等到该实例不在执行其他任务时,再在这个实例上运行这个任务。
下面是一个用流行的调度器 Slurm 调度任务的示例,你需要指定任务名称、任务需要执行的时间,以及要为任务分配的内存和 CPU 数量:
sbatch --job-name=example --time=01:00:00 --mem=8GB --cpus-per-task=2 run.sh
调度器还应该优化资源利用率,因为它们拥有可用资源、要运行的任务以及每个任务运行所需资源的信息。然而,用户指定的资源数量并不总是正确的。例如,我可能估计并因此指定一个任务需要 4 GB 内存,但这个任务实际上只需要 3 GB 内存,或者峰值时需要 4 GB 内存而其他时候只需要 1-2 GB。像 Google 的 Borg 这样复杂的调度器会估计一个任务实际需要多少资源,并把未使用的资源回收给其他任务,28 从而进一步优化资源利用率。
设计一个通用的调度器很难,因为这个调度器需要能够管理几乎任意数量的并发机器和工作流。如果你的调度器宕机,它接触到的每一个工作流都会被中断。
如果说调度器关心的是何时运行任务以及运行这些任务需要什么资源,那么编排器(orchestrator)关心的则是从哪里获得这些资源。调度器处理任务类型的抽象,如 DAG、优先级队列、用户级配额(即一个用户同时可以使用的最大实例数)等。编排器处理更低层的抽象,如机器、实例、集群、服务级分组、复制(replication)等。如果编排器注意到任务比可用实例池中的实例多,它可以增加可用实例池中的实例数量。我们说它"调配(provision)“更多的计算机来处理工作负载。调度器通常用于周期性任务,而编排器通常用于服务——即你有一个长时间运行的服务器来响应请求。
28 Abhishek Verma, Luis Pedrosa, Madhukar Korupolu, David Oppenheimer, Eric Tune, and John Wilkes,“Large-Scale Cluster Management at Google with Borg”,EuroSys ‘15: Proceedings of the Tenth European Conference on Computer Systems(2015 年 4 月):18,https://oreil.ly/9TeTM。
今天最著名的编排器无疑是 Kubernetes,即我们在"从开发到生产:容器"一节(第 308 页)中讨论过的容器编排器。K8s 可以在本地使用(甚至可以通过 minikube 在你的笔记本电脑上使用)。然而,我从未遇到过喜欢自己搭建 K8s 集群的人,所以大多数公司把 K8s 作为由云提供商管理的托管服务来使用,例如 AWS 的 Elastic Kubernetes Service(EKS)或 Google Kubernetes Engine(GKE)。
许多人把调度器和编排器混用,因为调度器通常运行在编排器之上。像 Slurm 和 Google 的 Borg 这样的调度器有一定的编排能力,而像 HashiCorp Nomad 和 K8s 这样的编排器自带一定的调度能力。但你可以有独立的调度器和编排器,例如在 Kubernetes 之上运行 Spark 的任务调度器,或在 EKS 之上运行 AWS Batch 调度器。像 HashiCorp Nomad 这样的编排器,以及包括 Airflow、Argo、Prefect 和 Dagster 在内的数据科学专用编排器,都有各自的调度器。
数据科学工作流管理
我们已经讨论了调度器和编排器之间的区别,以及它们如何用于执行工作流。熟悉面向数据科学的工作流管理工具(如 Airflow、Argo、Prefect、Kubeflow、Metaflow 等)的读者可能会想,它们在调度器与编排器的讨论中处于什么位置。我们在这里讨论这个话题。
最简单地说,工作流管理工具管理工作流。它们通常允许你把工作流指定为 DAG,类似于图 10-7 中的那个。一个工作流可能包含一个特征化步骤、一个模型训练步骤和一个评估步骤。工作流可以用代码(Python)或配置文件(YAML)来定义。工作流中的每一步被称为一个任务(task)。
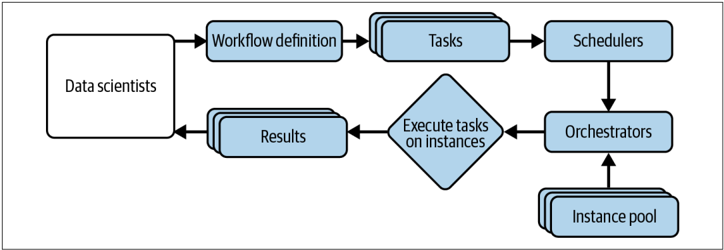
几乎所有的工作流管理工具都自带一些调度器,因此你可以把它们看作调度器,只不过它们关注的不是单个任务,而是整个工作流。一旦工作流被定义,底层的调度器通常与编排器合作来分配资源以运行工作流,如图 10-8 所示。
图 10-8. 工作流被定义后,该工作流中的任务被调度和编排
网上有很多文章比较不同的数据科学工作流管理工具。在本节中,我们将介绍五个最常见的工具:Airflow、Argo、Prefect、Kubeflow 和 Metaflow。本节并不打算对这些工具进行全面比较,而是让你了解一个工作流管理工具可能需要具备哪些不同的功能。
Airflow 最初由 Airbnb 开发并于 2014 年发布,是最早的工作流编排器之一。它是一个了不起的任务调度器,带有庞大的操作符(operator)库,可以轻松地将 Airflow 与不同的云提供商、数据库、存储选项等集成。Airflow 是"配置即代码(configuration as code)“原则的倡导者。它的创造者认为数据工作流是复杂的,应该用代码(Python)而不是 YAML 或其他声明式语言来定义。下面是一个取自该平台 GitHub 仓库的 Airflow 工作流示例:
from datetime import datetime, timedelta from airflow import DAG from airflow.operators.bash import BashOperator from airflow.providers.docker.operators.docker import DockerOperator dag = DAG( 'docker_sample', default_args={'retries': 1}, schedule_interval=timedelta(minutes=10), start_date=datetime(2021, 1, 1), catchup=False, ) t1 = BashOperator(task_id='print_date', bash_command='date', dag=dag) t2 = BashOperator(task_id='sleep', bash_command='sleep 5', retries=3, dag=dag) t3 = DockerOperator( docker_url='tcp://localhost:2375', # Set your docker URL command='/bin/sleep 30', image='centos:latest',
network_mode='bridge', task_id='docker_op_tester', dag=dag, ) t4 = BashOperator( task_id='print_hello', bash_command='echo "hello world!!!"', dag=dag ) t1 >> t2 t1 >> t3 t3 >> t4
然而,因为 Airflow 比其他大多数工具更早被创建,它没有可借鉴的前车之鉴,因此遭受许多缺点,Uber Engineering 的一篇博文对此有详细讨论。这里我们只介绍三点,让你有个概念。
第一,Airflow 是单体式的(monolithic),这意味着它把整个工作流打包到一个容器中。如果你的工作流中两个不同的步骤有不同的需求,理论上你可以使用 Airflow 的 DockerOperator 为它们创建不同的容器,但这样做并不容易。
第二,Airflow 的 DAG 不支持参数化,这意味着你不能向工作流传递参数。所以如果你想用不同的学习率运行同一个模型,你就得创建不同的工作流。
第三,Airflow 的 DAG 是静态的,这意味着它不能在运行时按需自动创建新的步骤。想象一下,你正在从一个数据库读取数据,你想创建一个步骤来处理数据库中的每条记录(例如,做一个预测),但你事先不知道数据库里有多少条记录。Airflow 将无法处理这种情况。
下一代工作流编排器(Argo、Prefect)就是为了解决 Airflow 的各种缺点而创建的。
Prefect 的 CEO Jeremiah Lowin 曾是 Airflow 的核心贡献者。他们早期的营销活动引发了 Prefect 与 Airflow 之间的激烈对比。Prefect 的工作流是参数化且动态的,相比 Airflow 是一个巨大的改进。它也遵循"配置即代码"原则,因此工作流用 Python 定义。
然而,与 Airflow 一样,容器化步骤并不是 Prefect 的首要任务。你可以在容器中运行每一步,但你仍然需要处理 Dockerfile,并在 Prefect 中把你的 docker 注册到工作流中。
Argo 解决了容器问题。Argo 工作流中的每一步都在自己的容器中运行。然而,Argo 的工作流用 YAML 定义,这让你可以在同一个文件中定义每一步及其需求。下面的代码示例取自 Argo 的 GitHub 仓库,演示如何创建一个抛硬币的工作流:
apiVersion : argoproj.io/v1alpha1 kind : Workflow metadata : generateName : coinflipannotations : workflows.argoproj.io/description : | This is an example of coin flip defined as a sequence of conditional steps. You can also run it in Python: https://couler-proj.github.io/couler/examples/#coin-flip spec : entrypoint : coinflip templates : -name : coinflip steps : - -name : flip-coin template : flip-coin - -name : heads template : heads when : "{{steps.flip-coin.outputs.result}} == heads" -name : tails template : tails when : "{{steps.flip-coin.outputs.result}} == tails" -name : flip-coin script : image : python:alpine3.6 command : [python] source : | import random result = "heads" if random.randint(0,1) == 0 else "tails" print(result) -name : heads container : image : alpine:3.6 command : [sh, -c] args : ["echo \"it was heads\""] -name : tails container : image : alpine:3.6 command : [sh, -c] args : ["echo \"it was tails\""]
Argo 的主要缺点——除了其凌乱的 YAML 文件之外——是它只能在 K8s 集群上运行,而 K8s 集群只在生产环境中可用。如果你想在本地测试同一个工作流,你必须在笔记本电脑上用 minikube 模拟一个 K8s,这可能会变得一团糟。
接下来是 Kubeflow 和 Metaflow,这两个工具旨在通过抽象掉通常运行 Airflow 或 Argo 所需的基础设施样板代码,帮助你在开发和生产环境中都运行工作流。它们承诺让数据科学家从本地笔记本就能访问生产环境的全部计算能力,这实际上让数据科学家能够在开发和生产环境中使用相同的代码。
尽管这两个工具都有一定的调度能力,但它们的设计目的是与真正意义上的调度器和编排器一起使用。Kubeflow 的一个组件是 Kubeflow Pipelines,它构建在 Argo 之上,设计用于 K8s 之上。Metaflow 可以与 AWS Batch 或 K8s 一起使用。
这两个工具都是完全参数化且动态的。目前,Kubeflow 更流行。然而,从用户体验的角度来看,在我看来 Metaflow 更胜一筹。在 Kubeflow 中,虽然你可以用 Python 定义工作流,但你仍然必须编写一个 Dockerfile 和一个 YAML 文件来指定每个组件(例如,处理数据、训练、部署)的规格,然后才能在一个 Python 工作流中把它们拼接起来。基本上,Kubeflow 帮你抽象掉其他工具的样板代码的方式,是让你写 Kubeflow 的样板代码。
在 Metaflow 中,你可以使用 Python 装饰器 @conda 来指定每个步骤的需求——所需的库、内存和计算需求——Metaflow 会自动创建一个包含所有这些需求的容器来执行该步骤。你省去了 Dockerfile 或 YAML 文件。
Metaflow 允许你从同一个笔记本/脚本中无缝地同时使用开发和生产环境。你可以先在本地机器上用小的数据集运行实验,当你准备好用大数据集在云上运行时,只需添加 @batch 装饰器,就可以在 AWS Batch 上执行。你甚至可以在不同的环境中运行同一个工作流中的不同步骤。例如,如果一个步骤需要的内存占用很小,它可以在你的本地机器上运行。但如果下一步需要很大的内存占用,你只需添加 @batch 在云端执行它。
# Example: sketch of a recommender system that uses an ensemble of two models. # Model A will be run on your local machine and model B will be run on AWS. class RecSysFlow (FlowSpec): @step def start(self): self.data = load_data() self.next(self.fitA, self.fitB)
# fitA requires a different version of NumPy compared to fitB @conda(libraries={"scikit-learn":"0.21.1", "numpy":"1.13.0"}) @step def fitA(self): self.model = fit(self.data, model="A") self.next(self.ensemble) @conda(libraries={"numpy":"0.9.8"}) # Requires 2 GPU of 16GB memory @batch(gpu=2, memory=16000) @step def fitB(self): self.model = fit(self.data, model="B") self.next(self.ensemble) @step def ensemble(self, inputs): self.outputs = ( (inputs.fitA.model.predict(self.data) + inputs.fitB.model.predict(self.data)) / 2 for input in inputs ) self.next(self.end) def end(self): print (self.outputs)
ML 平台
一家大型流媒体公司的 ML 平台团队经理给我讲了他团队起步的故事。他最初加入这家公司是去做推荐系统的。为了部署他们的推荐系统,他们需要构建特征管理、模型管理、监控等工具。去年,他的公司意识到,这些同样的工具也可以被其他 ML 应用使用,而不仅仅是推荐系统。他们创建了一个新团队——ML 平台团队,目标是为跨 ML 应用提供共享基础设施。由于推荐系统团队的工具最成熟,他们的工具被其他团队采用,推荐系统团队的一些成员也被邀请加入新的 ML 平台团队。
这个故事代表了自 2020 年初以来日益增长的趋势。随着每家公司发现 ML 在越来越多的应用中的用途,为多个应用利用同一套工具比支持每个应用各一套工具能获得更多收益。这套用于 ML 部署的共享工具构成了 ML 平台。
因为 ML 平台相对较新,到底什么构成 ML 平台因公司而异。即使在同一家公司内部,这也是一个持续讨论的话题。在这里,我将聚焦于我在 ML 平台中最常看到的组件,包括模型开发、模型存储和特征存储。
评估这些类别中的每个工具取决于你的用例。然而,你可能想记住两个通用方面:
该工具是否与你的云提供商兼容,或者允许你在自己的数据中心使用它
你需要从某个计算层运行和服务你的模型,而工具通常只支持与少数云提供商集成。没有人喜欢为了另一个工具而采用一个新的云提供商。
它是开源的还是托管服务
如果是开源的,你可以自行托管,不必太担心数据安全和隐私。然而,自行托管意味着需要额外的工程时间来维护它。如果是托管服务,你的模型以及可能你的一些数据会放在它的服务上,这可能不符合某些法规。一些托管服务与虚拟私有云(VPC,virtual private cloud)配合使用,这允许你把机器部署在自己的云集群中,有助于合规。我们将在"自建还是购买"一节(第 327 页)中进一步讨论这一点。
让我们从第一个组件开始:模型部署。
模型部署
模型被训练(并希望被测试)之后,你想让用户能够使用它的预测能力。在第 7 章中,我们详细讨论了模型如何提供预测:在线预测或批量预测。我们还讨论了部署模型的最简单方式:把模型及其依赖推送到生产环境可访问的位置,然后把模型作为端点(endpoint)暴露给你的用户。如果你做在线预测,这个端点会促使你的模型生成预测。如果你做批量预测,这个端点会获取预先计算好的预测。
部署服务可以帮助你把模型及其依赖推送到生产环境,并把模型暴露为端点。因为部署是这个领域的核心,部署是所有 ML 平台组件中最成熟的,为此存在许多工具。所有主要的云提供商都提供部署工具:AWS 有 SageMaker,GCP 有 Vertex AI,Azure 有 Azure ML,阿里云有 Machine Learning Studio,等等。还有大量提供模型部署工具的初创公司,如 MLflow Models、Seldon、Cortex、Ray Serve 等。
在选择部署工具时,重要的是考虑用这个工具做在线预测和批量预测有多容易。虽然用大多数部署服务在小规模下做在线预测通常很直接,但做批量预测通常更棘手。29 有些工具允许你把请求批量合并到在线预测中,这与批量预测不同。许多公司为在线预测和批量预测建立单独的部署流水线。例如,他们可能用 Seldon 做在线预测,但利用 Databricks 做批量预测。
模型部署的一个未解决问题是如何在模型部署前确保其质量。在第 9 章中,我们讨论了不同的生产测试技术,如影子部署(shadow deployment)、金丝雀发布(canary release)、A/B 测试等。在选择部署服务时,你可能想检查这个服务是否让你轻松执行你想要的测试。
模型存储
许多公司因为模型存储听起来很简单而不重视它。在"模型部署"一节(第 320 页)中,我们讨论了部署模型时,你必须打包模型并上传到生产环境可访问的位置。模型存储这个名字暗示它存储模型——你可以通过把模型上传到像 S3 这样的存储来做到这一点。然而,事情并没有那么简单。想象一下,现在你的模型对一组输入的性能下降了。被提醒这个问题的人是 DevOps 工程师,她在调查问题后,决定需要通知创建这个模型的数据科学家。但公司里可能有 20 位数据科学家;她应该联系谁?
想象一下,现在正确的数据科学家被拉进来了。数据科学家首先想在本地复现这个问题。她仍然有用这个模型生成模型的笔记本以及最终模型,所以她启动笔记本,用模型处理有问题的输入集。令她惊讶的是,模型在本地产生的输出与生产中产生的输出不同。很多事情都可能导致这种差异;这里只举几个例子:
- 现在生产中使用的模型不是她本地的那个模型。也许她上传了错误的模型二进制文件到生产环境?
- 生产中使用的模型是正确的,但使用的特征列表是错误的。也许她在推送到生产环境之前忘了在本地重新构建代码?
- 模型是正确的,特征列表是正确的,但特征化代码过时了。
- 模型是正确的,特征列表是正确的,特征化代码也是正确的,但数据处理流水线出了问题。
29 在小规模做在线预测时,你可以直接用一个端点发送请求负载并取回预测。批量预测需要设置批处理任务并存储预测。
在不知道问题原因的情况下,要修复它会非常困难。在这个简单的例子中,我们假设负责的数据科学家仍然可以访问生成模型的代码。如果那位数据科学家再也无法访问那个笔记本,或者她已经离职或正在休假呢?
许多公司已经意识到,仅仅把模型存储在 blob 存储中是不够的。为了帮助调试和维护,尽可能多地跟踪与模型相关的信息非常重要。下面是你可能想存储的八类产物。请注意,这里提到的许多产物是应该包含在模型卡(model card)中的信息,正如"创建模型卡"一节(第 351 页)所讨论的那样。
模型定义(model definition)
这是创建模型结构所需的信息,例如它使用什么损失函数。如果是神经网络,这包括它有多少隐藏层,每层有多少参数。
模型参数(model parameters)
这些是模型参数的实际值。这些值与模型的结构相结合,可以重建一个可用于预测的模型。有些框架允许你同时导出参数和模型定义。
特征化与预测函数
给定一个预测请求,你如何提取特征并将这些特征输入模型以获得预测?特征化(featurize)和预测(predict)函数提供了这样做的指令。这些函数通常被包装在端点中。
依赖
运行模型所需的依赖——例如 Python 版本、Python 包——通常被打包到一个容器中。
数据
用于训练这个模型的数据可能是指向数据存储位置的指针,或数据的名称/版本。如果你使用 DVC 这样的工具对数据做版本管理,这可以是生成该数据的 DVC 提交。
模型生成代码
这是指定模型如何被创建的代码,例如:
- 它使用了什么框架
- 它是如何被训练的
- 训练/验证/测试划分是如何创建的细节
- 运行的实验数量
- 考虑过的超参数范围
- 最终模型使用的实际超参数集
通常情况下,数据科学家通过在笔记本中写代码来生成模型。流水线更成熟的公司让他们的数据科学家把模型生成代码提交到他们在 GitHub 或 GitLab 上的 Git 仓库。然而,在许多公司,这个过程是临时拼凑的,数据科学家甚至不检查他们的笔记本。如果负责模型的数据科学家丢失了笔记本,或者离职或休假,就没有办法把生产中的模型映射到生成它的代码上,用于调试或维护。
实验产物
这些是在模型开发过程中生成的产物,正如"实验跟踪与版本管理"一节(第 162 页)所讨论的。这些产物可以是图表,如损失曲线。这些产物可以是原始数字,如模型在测试集上的性能。
标签(tags)
这包括帮助模型发现和筛选的标签,如所有者(这个模型的所有者是谁,个人或团队)或任务(这个模型解决的业务问题,如欺诈检测)。
大多数公司存储这些产物的一个子集,而不是全部。公司存储的产物可能不在同一个地方,而是分散的。例如,模型定义和模型参数可能在 S3 中。包含依赖的容器可能在 ECS(Elastic Container Service,弹性容器服务)中。数据可能在 Snowflake 中。实验产物可能在 Weights & Biases 中。特征化和预测函数可能在 AWS Lambda 中。一些数据科学家可能会手动跟踪这些位置,比如说,在一个 README 中,但这个文件很容易丢失。
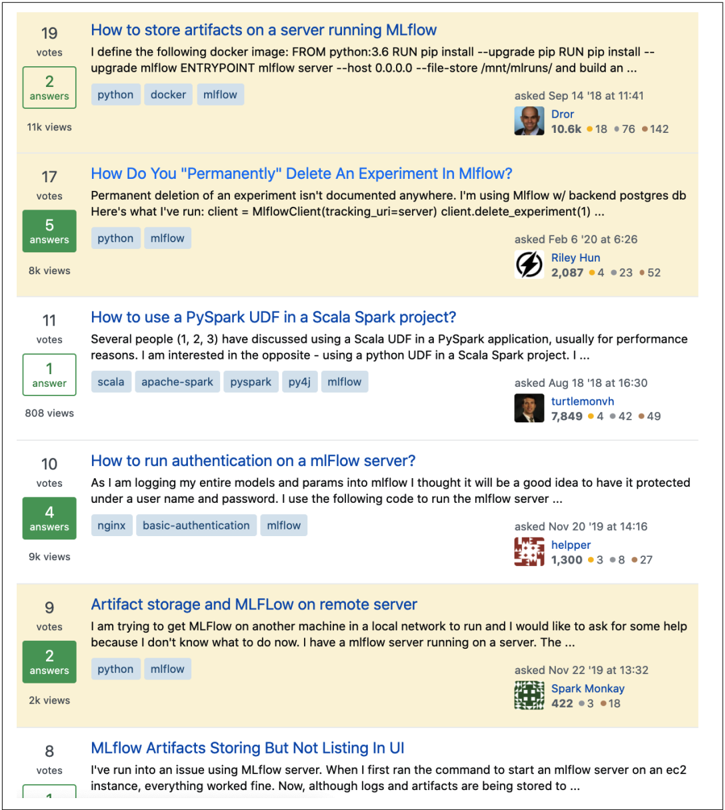
一个能够存储足够通用用例的模型存储远未解决。截至本书写作时,MLflow 无疑是与大型云提供商无关的最流行的模型存储。然而,Stack Overflow 上排名前六的 MLflow 问题中有三个是关于在 MLflow 中存储和访问产物的,如图 10-9 所示。模型存储该改头换面了,我希望在不久的将来有一家初创公司站出来解决这个问题。
图 10-9. MLflow 是最流行的模型存储,但它远未解决产物问题。Stack Overflow 上排名前六的 MLflow 问题中有三个是关于在 MLflow 中存储和访问产物的。来源:Stack Overflow 页面截图
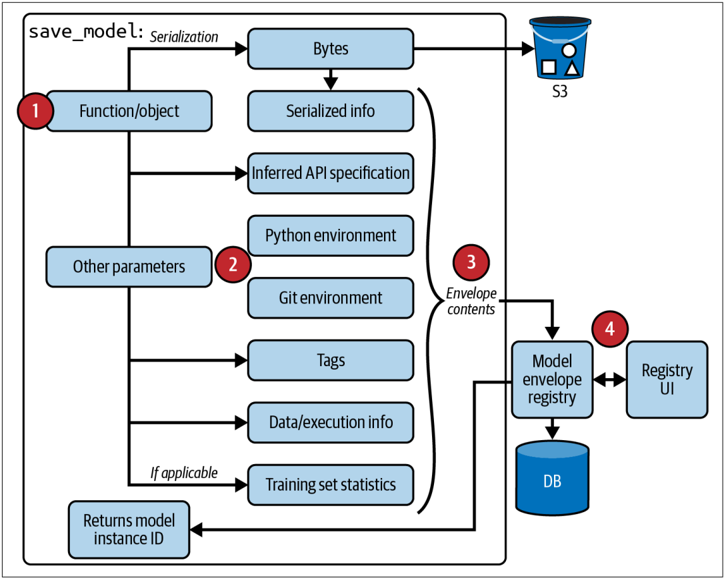
由于缺乏好的模型存储解决方案,像 Stitch Fix 这样的公司决定构建自己的模型存储。图 10-10 显示了 Stitch Fix 的模型存储跟踪的产物。当一个模型被上传到他们的模型存储时,这个模型附带序列化模型的链接、运行模型所需的依赖(Python 环境)、创建模型生成代码的 Git 提交(Git 信息)、标签(至少指定拥有该模型的团队)等。
图 10-10. Stitch Fix 的模型存储跟踪的产物。来源:改编自 Stefan Krawczyk 为 CS 329S(斯坦福大学)制作的幻灯片
特征存储
“特征存储"是一个越来越被滥用的术语,不同的人可能用它指代非常不同的东西。ML 从业者多次尝试定义特征存储应该具有哪些特征。30 就其核心而言,特征存储可以帮助解决三个主要问题:特征管理(feature management)、特征计算(feature computation)和特征一致性(feature consistency)。一个特征存储解决方案可能解决其中一个问题或这些问题的组合:
30 Neal Lathia,“Building a Feature Store”,2020 年 12 月 5 日,https://oreil.ly/DgsvA;Jordan Volz,“Why You Need a Feature Store”,Continual,2021 年 9 月 28 日,https://oreil.ly/kQPMb;Mike Del Balso,“What Is a Feature Store?",Tecton,2020 年 10 月 20 日,https://oreil.ly/pzy0I。
特征管理
一家公司可能有多个 ML 模型,每个模型使用大量特征。早在 2017 年,Uber 全公司就有大约 10,000 个特征!31 通常,一个模型使用的特征对另一个模型也可能有用。例如,A 团队可能有一个预测用户流失可能性的模型,B 团队有一个预测免费用户转化为付费用户可能性的模型。这两个模型可以共享很多特征。如果 A 团队发现特征 X 非常有用,B 团队也许也能利用它。
特征存储可以帮助团队共享和发现特征,以及管理每个特征的角色和共享设置。例如,你可能不希望公司里的每个人都能访问公司或其用户的敏感财务信息。在这种能力下,特征存储可以被看作一个特征目录(feature catalog)。特征管理工具的例子有 Amundsen(由 Lyft 开发)和 DataHub(由 LinkedIn 开发)。
特征计算 32
特征工程逻辑在被定义后,需要被计算。例如,特征逻辑可能是:使用昨天的平均备餐时间。计算部分涉及实际查看你的数据并计算这个平均值。
在之前的观点中,我们讨论了多个模型如何共享一个特征。如果这个特征的计算不太昂贵,那么每次模型需要时都重新计算可能是可以接受的。然而,如果计算很昂贵,你可能希望只在第一次需要时执行一次,然后存储起来供以后使用。
特征存储可以帮助执行特征计算并存储计算结果。在这种能力下,特征存储就像一个数据仓库。
特征一致性
在第 7 章中,我们讨论了同一个模型有两个独立流水线的问题:训练流水线从历史数据中提取批量特征,推理流水线提取流式特征。在开发期间,数据科学家可能会用 Python 定义特征和创建模型。然而,生产代码可能是用另一种语言编写的,如 Java 或 C,以追求性能。
31 Jeremy Hermann and Mike Del Balso,“Meet Michelangelo: Uber’s Machine Learning Platform”,Uber Engineering,2017 年 9 月 5 日,https://oreil.ly/XteNy。
32 有些人使用"特征变换(feature transformation)“这个术语。
这意味着开发期间用 Python 编写的特征定义可能需要转换成生产中使用的语言。所以你必须写两次相同的特征,一次用于训练,一次用于推理。首先,这很烦人且耗时。其次,它创造了额外的 bug 暴露面,因为生产中的一个或多个特征可能与训练中的对应特征不同,导致奇怪的模型行为。
现代特征存储的一个关键卖点是它们统一了批量特征和流式特征的逻辑,确保训练期间的特征与推理期间的特征之间的一致性。
特征存储是一个较新的类别,大约从 2020 年才开始起飞。虽然人们普遍同意特征存储应该管理特征定义并确保特征一致性,但它们的确切能力因厂商而异。一些特征存储只管理特征定义,不根据数据计算特征;一些特征存储两者都做。一些特征存储还做特征验证(feature validation),即检测特征何时不符合预定义的模式,而一些特征存储把这一方面留给监控工具。
截至本书写作时,最流行的开源特征存储是 Feast。然而,Feast 的优势在批量特征,而非流式特征。Tecton 是一个完全托管的特征存储,承诺能够同时处理批量特征和在线特征,但它们的实际推广进展缓慢,因为它们需要深度集成。像 SageMaker 和 Databricks 这样的平台也提供自己对特征存储的实现。在我于 2022 年 1 月调查的 95 家公司中,只有大约 40% 使用特征存储。在使用特征存储的公司中,一半自建特征存储。
自建还是购买
在本章开头,我们讨论了为你的 ML 需求搭建正确的基础设施有多难。你需要什么样的基础设施取决于你拥有的应用以及你运行这些应用的规模。
你需要在基础设施上投入多少也取决于你想自建什么、想购买什么。例如,如果你想使用完全托管的 Databricks 集群,你可能只需要一名工程师。然而,如果你想托管自己的 Spark Elastic MapReduce 集群,你可能需要再多五个人。
在一个极端,你可以把所有 ML 用例外包给一家端到端提供 ML 应用的公司,那么也许你唯一需要的基础设施就是数据移动:把你的数据从应用移到你的厂商那里,再把预测从厂商移回给你的用户。你的其余基础设施由厂商管理。
在另一个极端,如果你是一家处理敏感数据的公司,无法使用由另一家公司管理的服务,你可能需要在内部构建和维护所有基础设施,甚至拥有自己的数据中心。
然而,大多数公司都不在这两个极端。如果你在这些公司之一工作,你可能会有一些组件由其他公司管理,一些组件在公司内部开发。例如,你的计算可能由 AWS EC2 管理,数据仓库由 Snowflake 管理,但你有自己的特征存储和自己的监控仪表盘。
你的自建与购买决策取决于许多因素。在这里,我们将讨论我与基础设施负责人交谈时经常遇到的三个常见因素,他们是这样评估这些决策的:
你公司所处的阶段
在初期,你可能想利用厂商的解决方案尽快起步,这样你就可以把有限的资源集中在产品的核心功能上。然而,随着你的用例增长,厂商的成本可能变得过高,投资于自己的解决方案可能更便宜。
你认为公司应该专注什么,或公司的竞争优势是什么
Stitch Fix 的 ML 平台团队经理 Stefan Krawczyk 向我解释了他的自建与购买决策:“如果是我们想做得特别好的东西,我们就在内部管理。如果不是,我们就用厂商。“对于科技行业之外的绝大多数公司——例如零售、银行、制造业的公司——ML 基础设施不是它们的重点,所以它们倾向于购买。当我和这些公司交谈时,他们更喜欢托管服务,甚至是点解决方案(point solution)(例如,为他们解决一个业务问题的解决方案,比如需求预测服务)。对于许多技术是竞争优势、强大的工程团队更喜欢控制其技术栈的科技公司来说,它们倾向于自建。如果他们使用托管服务,他们可能更希望该服务是模块化和可定制的,这样他们就可以即插即用任何组件。
可用工具的成熟度
例如,你的团队可能决定需要一个模型存储,你更愿意使用厂商的,但没有足够成熟的厂商满足你的需求,所以你不得不自建特征存储,也许是在开源解决方案之上。
这正是行业早期采用 ML 时发生的事情。早期采用者,即大型科技公司,自建基础设施,因为没有足够成熟的解决方案满足它们的需求。这导致了每家公司的基础设施都不同的局面。几年后,解决方案的供应成熟了。然而,这些供应品很难卖给大型科技公司,因为不可能创建一个能与大多数定制基础设施兼容的解决方案。
在我们构建 Claypot AI 的过程中,其他创始人实际上建议我们避免向大型科技公司销售,因为如果我们这样做,我们会陷入他们所说的"集成地狱(integration hell)"——花更多时间把我们的解决方案与定制基础设施集成,而不是构建我们的核心功能。他们建议我们专注于起点更干净、更容易构建的初创公司。
有些人认为自建比购买便宜,这不一定正确。自建意味着你需要引入更多工程师来构建和维护自己的基础设施。它还可能带来未来成本:创新的成本。自有的定制基础设施让你很难采用可用的新技术,因为存在集成问题。
自建与购买的决策很复杂,高度依赖具体情境,很可能是基础设施负责人花大量时间反复思量的事情。Better.com 的前 CTO Erik Bernhardsson 在一条推文中说:“CTO 最重要的工作之一是厂商/产品选择,而由于基础设施领域发展如此之快,这项重要性每年都在快速上升。“33 一个小节不可能涵盖其所有细微差别。但我希望本节能为你提供一些开始讨论的要点。
33 Erik Bernhardsson 在 Twitter 上(@bernhardsson),2021 年 9 月 29 日,https://oreil.ly/GnxOH。
小结
如果你一直陪着我读到这里,我希望你同意,把 ML 模型带到生产环境是一个基础设施问题。为了让数据科学家能够开发和部署 ML 模型,搭建正确的工具和基础设施至关重要。
在本章中,我们介绍了 ML 系统所需的基础设施的不同层次。我们从存储与计算层开始,它为像 ML 项目这样需要密集数据和计算资源的工程项目提供关键资源。存储与计算层已被高度商品化,这意味着大多数公司按实际使用的存储和计算量向云服务付费,而不是自建数据中心。然而,虽然云提供商让公司起步很容易,但随着公司的发展,它们的成本变得高不可攀,越来越多的公司正在考虑从云端遣返到私有数据中心。
接着我们讨论了开发环境——数据科学家在其中编写代码并与生产环境交互。因为 dev 环境是工程师花费大部分时间的地方,dev 环境的改进直接转化为生产力的改进。公司为改进 dev 环境可以做的第一件事之一,是为同一团队工作的数据科学家和 ML 工程师标准化 dev 环境。我们在本章讨论了为什么推荐标准化以及如何做。
然后我们讨论了一个基础设施主题,过去几年它是否与数据科学家相关一直备受争论:资源管理。资源管理对数据科学工作流很重要,但问题是数据科学家是否应该被期望处理它。在本节中,我们追溯了资源管理工具从 cron 到调度器再到编排器的演变。我们还讨论了为什么 ML 工作流不同于其他软件工程工作流,以及为什么它们需要自己的工作流管理工具。我们比较了各种工作流管理工具,如 Airflow、Argo 和 Metaflow。
ML 平台是随着 ML 采用的成熟而最近出现的一个团队。因为它是一个新兴概念,关于 ML 平台应该包含什么仍然存在分歧。我们选择聚焦于对大多数 ML 平台至关重要的三套工具:部署、模型存储和特征存储。我们跳过了 ML 平台的监控,因为它已在第 8 章中涵盖。
在做基础设施工作时,一个问题不断困扰着工程经理和 CTO:自建还是购买?我们在本章结尾给出了一些讨论要点,希望它们能为你或你的团队提供足够的背景来做这些艰难的决策。