持续学习与生产环境测试
在第 8 章中,我们讨论了机器学习系统在生产环境中可能失败的种种方式。我们重点讨论了一个在研究人员和从业者中都引发了大量讨论的棘手问题:数据分布漂移(data distribution shift)。我们还讨论了多种用于检测数据分布漂移的监控技术和工具。
本章延续这一讨论:我们如何让模型适应数据分布漂移?答案是持续更新我们的机器学习模型。我们将从讨论什么是持续学习(continual learning)及其挑战开始——剧透一下:持续学习在很大程度上是一个基础设施问题。然后我们将制定一个四阶段计划,让持续学习成为现实。
一旦你搭建好了基础设施,可以随心所欲地频繁更新模型,你可能就会想考虑一个我遇到过的几乎每一位机器学习工程师都问过我的问题:“我应该多久重新训练一次模型?“这个问题是本书下一节的重点。
如果模型被重新训练以适应不断变化的环境,那么在一个静止不变的测试集上评估它就不够了。我们将介绍一个看似可怕但又必不可少的概念:生产环境测试(test in production)。这一过程是用生产环境中的实时数据来测试你的系统,以确保更新后的模型确实能正常工作,而不会带来灾难性后果。
本章和上一章的主题紧密耦合。生产环境测试与监控是互补的。如果说监控是被动地跟踪当前所用模型的输出,那么生产环境测试就是主动地选择由哪个模型来产生输出,以便我们评估它。监控和生产环境测试的目标都是了解模型的性能,并弄清楚何时该更新它。持续学习的目标则是安全、高效地将更新自动化。所有这些概念使我们能够设计出一个可维护、能适应环境变化的机器学习系统。
这是我最期待写的一章,我希望也能让你对它充满期待!
持续学习
听到"持续学习"这个词,很多人想到的是这样一种训练范式:模型在生产环境中用每一个新到的样本更新自己。实际上很少有公司这么做。首先,如果你的模型是神经网络,用每一个新到的样本学习会使它容易发生灾难性遗忘(catastrophic forgetting)。灾难性遗忘是指神经网络在学习新信息时,完全而突然地忘记先前所学信息的倾向。1
其次,这样做会让训练变得更加昂贵——如今大多数硬件后端都是为批处理(batch processing)设计的,因此一次只处理一个样本会造成巨大的算力浪费,而且无法利用数据并行(data parallelism)。
在生产环境中采用持续学习的公司会以微批(micro-batch)的方式更新模型。例如,他们可能会每处理 512 或 1,024 个样本就更新一次现有模型——每个微批的最佳样本数是因任务而异的。
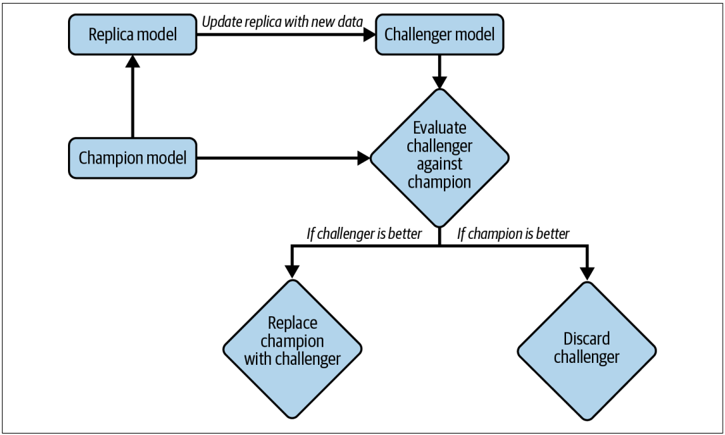
更新后的模型在评估通过之前不应部署。这意味着你不应该直接修改现有模型。相反,你应该创建现有模型的一个副本,用新数据更新这个副本,并且只有当更新后的副本被证明更优时,才用更新后的副本替换现有模型。现有模型被称为冠军模型(champion model),更新后的副本被称为挑战者(challenger)。这一过程如图 9-1 所示。为了便于理解,这是对该过程的过度简化。实际上,一家公司可能同时有多个挑战者,而且处理失败的挑战者的方式远比简单地丢弃它要复杂得多。
图 9-1. 持续学习在生产环境中可能运作方式的简化示意。实际上,处理失败挑战者的过程远比简单地丢弃它要复杂得多。
尽管如此,“持续学习"这个词还是让人们想象出非常频繁地更新模型的场景,比如每 5 或 10 分钟更新一次。许多人认为,大多数公司并不需要那么频繁地更新模型,原因有二。第一,他们没有足够的流量(即足够的新数据)来支撑这样的重训练计划。第二,他们的模型衰减得没那么快。我同意他们的看法。如果把重训练计划从每周一次改成每天一次,既没有回报又带来更多开销,那就没必要这么做。
无状态重训练与有状态训练
然而,持续学习的关键不在于重训练频率,而在于模型被重训练的方式。大多数公司做的是无状态重训练(stateless retraining)——每次从头训练模型。持续学习还意味着允许有状态训练(stateful training)——模型在新数据上继续训练。2 有状态训练也被称为微调(fine-tuning)或增量学习(incremental learning)。无状态重训练与有状态训练之间的区别如图 9-2 所示。
图 9-2. 无状态重训练与有状态训练
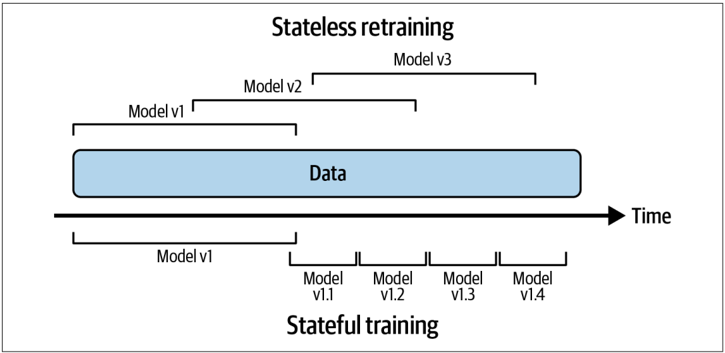
有状态训练允许你用更少的数据更新模型。从头训练一个模型往往比微调同一个模型需要多得多的数据。例如,如果你从头重训练模型,你可能需要使用过去三个月的所有数据。然而,如果你从昨天的检查点(checkpoint)微调模型,你只需要使用最近一天的数据。
Grubhub 发现,有状态训练能让他们的模型收敛得更快,并且需要的算力少得多。从每日无状态重训练改为每日有状态训练,使他们的训练计算成本降低了 45 倍,购买转化率(purchase-through rate)提高了 20%。3
有状态训练有一个常常被忽视的美妙特性:它可能让公司完全不必存储数据。在传统的无状态重训练中,一个数据样本可能在模型的多次训练迭代中被重复使用,这意味着数据需要被存储。这并不总是可行的,尤其是对于隐私要求严格的数据。在有状态训练范式下,每次模型更新只使用新鲜数据来训练,因此一个数据样本只被用于一次训练,如图 9-2 所示。这意味着你可以在不将数据存入永久存储的情况下训练模型,这有助于消除许多关于数据隐私的担忧。然而,这一点被忽视了,因为如今"记录一切"的实践仍然让许多公司不愿丢弃数据。
有状态训练并不意味着完全不做从头训练。最成功运用有状态训练的公司,也会偶尔在大量数据上从头训练模型来校准它。或者,他们也可能让从头训练与有状态训练并行进行,然后用参数服务器(parameter server)等技术把两个更新后的模型合并起来。4
一旦你的基础设施搭建好,允许无状态重训练和有状态训练并行存在,训练频率就只是一个可以随意调节的旋钮了。你可以每小时、每天更新一次模型,或者每当检测到分布漂移时更新。如何找到最优的重训练计划将在第 279 页的"多久更新一次模型"一节中讨论。
持续学习的本质是搭建这样一种基础设施:让你——数据科学家或机器学习工程师——无论何时需要,都能更新你的模型(无论从头训练还是微调),并快速部署这次更新。
你可能会想:有状态训练听起来很酷,但如果我想给模型添加一个新特征或新的一层,这该怎么运作?要回答这个问题,我们必须区分两种类型的模型更新:
模型迭代
向现有模型架构中添加一个新特征,或者改变模型架构。
数据迭代
模型架构和特征保持不变,但你用新数据刷新这个模型。
截至今天,有状态训练主要应用于数据迭代,因为改变模型架构或添加新特征仍然需要从头训练由此产生的模型。已有研究表明,通过使用知识迁移(knowledge transfer)(Google,2015)和模型手术(model surgery)(OpenAI,2019)等技术,有可能绕开模型迭代中的从头训练。据 OpenAI 称,“手术(Surgery)在确定模型哪些部分保持不变、哪些部分必须重新初始化的选择过程之后,将训练好的权重从一个网络迁移到另一个网络。”5 有几个大型研究实验室对此进行了实验;然而,据我所知,业界还没有明确的结果。
术语歧义
我用"持续学习"而不是"在线学习”(online learning),因为当我说"在线学习"时,人们通常会想到在线教育。如果你在谷歌上输入"online learning",排在前面的结果很可能是关于在线课程的。
有些人用"在线学习"来指代一种特定设置:模型从每一个新到的样本中学习。在这种设置下,持续学习是在线学习的一种泛化。
我也用"持续学习"而不是"连续学习"(continuous learning)。连续学习指的是模型连续不断地用每一个新到的样本学习的机制,而持续学习的"持续"是通过一系列批次或微批来完成的。
“连续学习"有时也被用来指机器学习的持续交付(continuous delivery of ML),这与持续学习密切相关,因为两者都能帮助公司加快机器学习模型的迭代周期。然而,区别在于:在这种含义下,“连续学习"是从 DevOps 的视角出发,关于搭建持续交付管道的;而"持续学习"是从机器学习的视角出发的。
由于"连续学习"这个词存在歧义,我希望业界能彻底避开这个词。
为什么需要持续学习?
我们已经讨论了持续学习关乎搭建基础设施,使你能随心所欲地快速更新模型并部署这些变更。但你为什么需要这种快速更新模型的能力呢?
持续学习的第一个用例是对抗数据分布漂移,尤其是在漂移突然发生时。想象你正在为 Lyft 这样的拼车服务构建一个定价模型。6 从历史上看,这个街区周四晚上的出行需求很平淡,所以模型预测的乘车价格较低,这让司机上路的吸引力变小。然而,这个周四晚上,街区里有一场大型活动,出行需求突然激增。如果你的模型不能足够快地响应这一变化——提高价格预测并调动更多司机去那个街区——乘客就得等很长时间才能打到车,这会造成糟糕的用户体验。他们甚至可能转而使用竞争对手的服务,导致你损失收入。
持续学习的另一个用例是适应罕见事件。想象你在一家像亚马逊这样的电商网站工作。黑色星期五(Black Friday)是一个每年只发生一次的重要购物节日。你不可能收集到足够的历史数据,让模型对顾客在今年整个黑色星期五期间的行为做出准确预测。为了提高性能,你的模型应该在这一天里用新鲜数据持续学习。2019 年,阿里巴巴以 1.03 亿美元收购了 Data Artisans——领导流处理框架 Apache Flink 开发的团队——以便该团队帮助阿里巴巴将 Flink 适配到机器学习用例。7 他们的旗舰用例是在"双十一”(Singles Day,一个类似于美国黑色星期五的中国购物节日)期间做出更好的推荐。
当今机器学习生产环境中的一个巨大挑战——持续学习可以帮助克服——是持续冷启动(continuous cold start)问题。冷启动问题(cold start problem)出现在你的模型必须为一个没有任何历史数据的新用户做预测时。例如,要向用户推荐他们接下来可能想看的电影,推荐系统通常需要知道该用户之前看过什么。但如果这个用户是新的,你就没有他的观看历史,只能给他生成一些泛泛的内容,比如你网站上当下最受欢迎的电影。8
持续冷启动是冷启动问题的一种泛化,9 因为它不仅可能发生在新用户身上,也可能发生在现有用户身上。例如,一个现有用户从笔记本电脑换到了手机,而他们在手机上的行为与在笔记本电脑上的行为不同。又比如用户没有登录——大多数新闻网站不要求读者登录才能阅读。
它也可能发生在用户极少访问某项服务、以至于该服务掌握的关于该用户的历史数据已经过时的时候。例如,大多数人每年只订几次酒店和机票。Coveo——一家为电商网站提供搜索引擎和推荐系统的公司——发现,电商网站上超过 70% 的购物者每年访问网站少于三次,这是很常见的。10
如果你的模型适应得不够快,那么在下一次模型更新之前,它都无法为这些用户做出相关的推荐。到那时,这些用户可能已经因为找不到任何与自己相关的内容而离开了这项服务。
如果我们能让模型在用户的一次访问会话内就适应每个用户,那么模型即使在用户第一次访问时也能做出准确、相关的预测。例如,TikTok 已经成功地将持续学习应用于其推荐系统,在几分钟内适应每个用户。你下载这个应用,看过几个视频后,TikTok 的算法就能高精度地预测你接下来想看什么。11 我并不认为每个人都应该试图打造像 TikTok 那样让人上瘾的东西,但它证明了持续学习可以释放强大的预测潜力。
“为什么需要持续学习?“应该改写为"为什么不需要持续学习?“持续学习是批式学习(batch learning)的超集,因为它允许你做传统批式学习能做的一切。但持续学习还能解锁批式学习做不到的用例。
如果持续学习与批式学习搭建起来一样费力、成本也一样,那就没有理由不做持续学习。在撰写本书时,搭建持续学习仍然面临很多挑战,我们将在下一节深入讨论。不过,用于持续学习的 MLOps 工具正在成熟,这意味着在不远的将来某一天,搭建持续学习可能会像搭建批式学习一样容易。
持续学习的挑战
尽管持续学习有很多用例,许多公司也成功地应用了它,但持续学习仍然面临许多挑战。在本节中,我们将讨论三大挑战:新鲜数据访问、评估和算法。
新鲜数据访问挑战
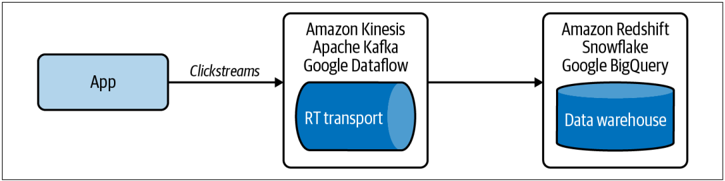
第一个挑战是获取新鲜数据(fresh data)。如果你想每小时更新一次模型,你就需要每小时都有新数据。目前,许多公司从它们的数据仓库(data warehouse)中拉取新的训练数据。你从数据仓库拉取数据的速度取决于数据沉积到数据仓库的速度。这个速度可能很慢,尤其是当数据来自多个来源时。另一种做法是允许在数据沉积到数据仓库之前就拉取数据,例如直接从 Kafka 和 Kinesis 等把数据从应用程序传输到数据仓库的实时传输(real-time transport)中拉取,12 如图 9-3 所示。
图 9-3. 在数据沉积到数据仓库之前直接从实时传输中拉取数据,可以让你获得更新鲜的数据
仅仅能拉取新鲜数据还不够。如果你的模型需要标注数据来更新——如今大多数模型都是如此——这些数据也需要被标注。在许多应用中,模型更新的速度受限于数据标注的速度。
持续学习的最佳候选任务是那些能通过短反馈回路(feedback loop)获得自然标签(natural label)的任务。这类任务的例子有:动态定价(基于估计的需求和可用性)、预计到达时间(estimated time of arrival)估算、股价预测、广告点击率预测,以及为推文、歌曲、短视频、文章等在线内容服务的推荐系统。
然而,这些自然标签通常不是以标签的形式直接生成的,而是以行为活动的形式存在,需要被提取成标签。让我们通过一个例子来说明。如果你运营一个电商网站,你的应用程序可能会记录:晚上 10:33,用户 A 点击了 ID 为 32345 的商品。你的系统需要回溯日志,看看这个商品 ID 是否曾被推荐给该用户;如果是,又是哪个查询触发了这次推荐,这样你的系统才能把这个查询与这次推荐匹配起来,并把这次推荐标记为一次好的推荐,如图 9-4 所示。
图 9-4. 从用户反馈中提取标签的过程的简化示意
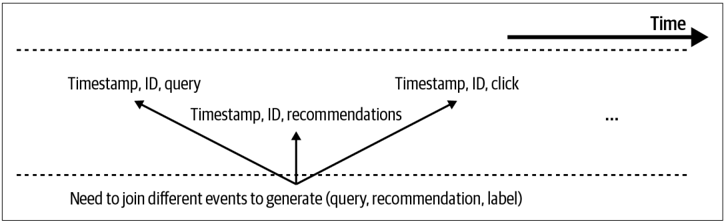
这种回溯日志以提取标签的过程被称为标签计算(label computation)。如果日志数量很大,标签计算的成本可能相当高。标签计算可以用批处理来完成:例如,先等日志沉积到数据仓库,再运行一个批处理任务,一次性从所有日志中提取标签。然而,如前所述,这意味着我们需要先等待数据沉积,再等待下一个批处理任务运行。一个快得多的方法是利用流处理(stream processing),直接从实时传输中提取标签。13
如果你的模型迭代速度受限于标注速度,你还可以利用 Snorkel 这样的程序化标注(programmatic labeling)工具来加快标注过程,以最少的人工干预快速生成标签。也可以利用众包标签(crowdsourced labels)来快速标注新鲜数据。
鉴于围绕流处理的工具仍然处于萌芽阶段,为获取新鲜数据、从实时传输中快速提取标签而设计一套高效的流优先(streaming-first)基础设施,可能是工程密集且成本高昂的。好消息是,围绕流处理的工具正在快速增长。建立在 Kafka 之上的 Confluent 平台,截至 2021 年 10 月是一家市值 160 亿美元的公司。2020 年底,Snowflake 组建了一个专注于流处理的团队。14 截至 2021 年 9 月,Materialize 已融资 1 亿美元用于开发流式 SQL 数据库。15 随着流处理工具的成熟,公司为机器学习开发流优先基础设施将会变得更容易、更便宜。
评估挑战
持续学习最大的挑战不在于编写一个持续更新模型的函数——你写个脚本就能做到!最大的挑战在于确保这次更新足够好、可以部署。在本书中,我们已经讨论了机器学习系统如何在生产环境中造成灾难性失败:从数百万少数族裔被不公正地拒绝贷款,到过于信任自动驾驶的司机卷入致命车祸。16
持续学习会放大灾难性失败的风险。首先,你更新模型的频率越高,更新失败的机会就越多。
其次,持续学习使你的模型更容易受到协同操纵和对抗性攻击(adversarial attack)。因为你的模型是从真实世界的数据中在线学习的,用户更容易输入恶意数据,诱骗模型学到错误的东西。2016 年,微软发布了 Tay——一个能够在 Twitter 上通过"随意、好玩的对话"学习的聊天机器人。Tay 一上线,网络喷子就开始向这个机器人发送种族主义和性别歧视的言论。这个机器人很快就开始发布煽动性和攻击性的推文,导致微软在它上线 16 小时后将其关闭。17
为了避免类似或更严重的事故,在把每次模型更新部署给更广泛的用户之前,彻底测试每次更新以确保其性能和安全性至关重要。我们已经在第 6 章讨论了模型离线评估(offline evaluation),本章将讨论在线评估(online evaluation),即生产环境测试。
在设计持续学习的评估管道时,要记住评估需要时间,这可能是模型更新频率的另一个瓶颈。例如,我合作过的一家大型在线支付公司有一个检测欺诈交易的机器学习系统。18 欺诈模式变化很快,所以他们希望快速更新系统以适应不断变化的模式。他们不能在新技术与现有模型进行 A/B 测试之前部署它。然而,由于这个任务类别不平衡——大多数交易都不是欺诈——他们需要大约两周时间才能积累足够多的欺诈交易,从而准确评估哪个模型更好。19 因此,他们只能每两周更新一次系统。
算法挑战
与新鲜数据挑战和评估挑战相比,这是一个"较软"的挑战,因为它只影响某些算法和某些训练频率。准确地说,它只影响那些希望非常快速地更新(例如每小时)的基于矩阵的模型和基于树的模型。
为了说明这一点,考虑两个不同的模型:一个神经网络和一个基于矩阵的模型,比如协同过滤(collaborative filtering)模型。协同过滤模型使用用户-物品矩阵(user-item matrix)和一种降维(dimensionality reduction)技术。
你可以用任意大小的数据批更新神经网络模型,甚至可以用单个数据样本执行更新步骤。然而,如果你想更新协同过滤模型,你首先需要用整个数据集构建用户-物品矩阵,然后对它进行降维。当然,你可以在每次用新数据样本更新矩阵时对矩阵应用降维,但如果你的矩阵很大,降维步骤会太慢、太昂贵,无法频繁执行。因此,这个模型比前面的神经网络模型更不适合用部分数据集学习。20
让神经网络这样的模型适应持续学习范式,比让基于矩阵和基于树的模型适应要容易得多。不过,也有一些算法可以创建能够从增量数据中学习的基于树的模型,最著名的是霍夫丁树(Hoeffding Tree)及其变体霍夫丁窗口树(Hoeffding Window Tree)和霍夫丁自适应树(Hoeffding Adaptive Tree),21 但它们的使用还不广泛。
不仅学习算法需要能处理部分数据集,特征提取代码也必须如此。我们在第 126 页的"缩放"一节中讨论过,通常需要用最小值、最大值、中位数、方差等统计量来缩放特征。要为一个数据集计算这些统计量,你通常需要遍历整个数据集。当你的模型每次只能看到一小部分数据时,理论上你可以为每个数据子集计算这些统计量。然而,这意味着这些统计量在不同子集之间会波动很大。从一个子集计算出的统计量可能与下一个子集差异悬殊,这使得在一个子集上训练的模型很难泛化到下一个子集。
为了在不同子集之间保持这些统计量的稳定,你可能需要在线计算这些统计量。与其一次性使用所有数据的均值或方差,不如在看到新数据时增量地计算或近似这些统计量,比如"Optimal Quantile Approximation in Streams"中概述的算法。22 当今流行的框架提供了一些计算运行统计量(running statistics)的能力——例如,sklearn 的 StandardScaler 有一个 partial_fit,允许特征缩放器使用运行统计量——但内置方法很慢,而且不支持广泛的运行统计量。
持续学习的四个阶段
我们已经讨论了什么是持续学习、为什么持续学习很重要,以及持续学习的挑战。接下来,我们将讨论如何克服这些挑战、让持续学习成为现实。截至本书写作之时,持续学习还不是公司一开始就会采用的东西。走向持续学习的转变分四个阶段发生,如下所述。我们将介绍每个阶段发生什么,以及从前一阶段进入该阶段所需满足的要求。
阶段 1:手动、无状态重训练
一开始,机器学习团队通常专注于开发机器学习模型,以解决尽可能多的业务问题。例如,如果你的公司是一个电商网站,你可能会按以下顺序开发四个模型:
- 一个检测欺诈交易的模型
- 一个向用户推荐相关商品的模型
- 一个预测卖家是否在滥用系统的模型
- 一个预测订单发货需要多长时间的模型
因为你的团队专注于开发新模型,更新现有模型就被放到了次要位置。只有当以下两个条件同时满足时,你才会更新现有模型:模型的性能已经退化到弊大于利的地步,并且你的团队有时间更新它。你的一些模型每半年更新一次,一些每季度更新一次,还有一些已经在生产环境中运行了一年却从未更新过。
更新模型的过程是手动的、临时的(ad hoc)。通常由某个人——通常是数据工程师——查询数据仓库获取新数据。另一个人清洗这些新数据、从中提取特征、在旧数据和新数据上从头重训练模型,然后把更新后的模型导出为二进制格式。然后又有一个人拿着那个二进制格式去部署更新后的模型。通常情况下,封装数据、特征和模型逻辑的代码在重训练过程中被修改了,但这些修改未能同步到生产环境,导致难以追踪的 bug。
如果这个过程让你感觉痛得熟悉,那你并不孤单。科技行业之外的大多数公司——例如,任何采用机器学习不到三年、且没有机器学习平台团队的公司——都处于这个阶段。23
阶段 2:自动化重训练
几年之后,你的团队已经成功部署模型解决了大多数显而易见的问题。你的生产环境中有 5 到 10 个模型。你的优先级不再是开发新模型,而是维护和改进现有模型。上一阶段提到的临时的、手动的模型更新过程已经发展成一个大到无法忽视的痛点。你的团队决定编写一个脚本来自动执行所有重训练步骤。这个脚本随后使用 Spark 之类的批处理过程定期运行。
大多数机器学习基础设施相对成熟的公司都处于这个阶段。一些先进的公司会运行实验来确定最优的重训练频率。然而,对于这个阶段的大多数公司来说,重训练频率是基于直觉设定的——比如"每天一次似乎差不多”,或者"让我们在每晚计算空闲时启动重训练过程”。
在编写脚本自动化系统的重训练过程时,你需要考虑到系统中的不同模型可能需要不同的重训练计划。例如,考虑一个由两个模型组成的推荐系统:一个为所有商品生成嵌入(embedding)的模型,另一个在给定查询时对每个商品的相关性进行排序的模型。嵌入模型可能需要重训练的频率远低于排序模型。因为商品的特征变化不那么频繁,你可能每周重训练一次嵌入就够了,24 而排序模型可能需要每天重训练一次。
如果你的模型之间存在依赖关系,自动化脚本可能会变得更加复杂。例如,因为排序模型依赖于嵌入,当嵌入变化时,排序模型也应该更新。
要求。如果你的公司有机器学习模型在生产环境中,那么你的公司很可能已经拥有自动化重训练所需的大部分基础设施组件。这个阶段的可行性取决于编写一个脚本来自动化工作流、并配置基础设施自动完成以下工作的可行性:
- 拉取数据。
- 在必要时对数据进行下采样或上采样。
- 提取特征。
- 处理标签和/或标注标签以创建训练数据。
- 启动训练过程。
- 评估新训练的模型。
- 部署它。
编写这个脚本需要多长时间取决于很多因素,包括脚本编写者的能力。但总体而言,影响这个脚本可行性的三大主要因素是:调度器(scheduler)、数据和模型存储(model store)。
调度器基本上是一种处理任务调度的工具,我们将在第 311 页的"Cron、调度器与编排器"一节中介绍。如果你还没有调度器,你需要花时间搭建一个。但如果你已经有 Airflow 或 Argo 这样的调度器,把脚本串联起来应该不难。
第二个因素是数据的可用性和可访问性。你需要自己把数据汇集到数据仓库吗?你需要跨多个组织连接数据吗?你需要从零开始提取大量特征吗?你还需要标注数据吗?你回答"是"的问题越多,搭建这个脚本需要的时间就越长。Stitch Fix 的机器学习/数据平台经理 Stefan Krawczyk 评论说,他怀疑大多数人会把大部分时间花在这里。
你需要的第三个因素是一个模型存储,用于自动对重现一个模型所需的全部工件进行版本管理和存储。最简单的模型存储可能只是一个 S3 存储桶,以某种结构化的方式存储模型的序列化 blob。然而,像 S3 这样的 blob 存储在工件版本管理方面并不擅长,也不易读。你可能需要一个更成熟的模型存储,比如 Amazon SageMaker(托管服务)和 Databricks 的 MLflow(开源)。我们将在第 321 页的"模型存储"一节中详细介绍什么是模型存储,并评估不同的模型存储。
特征复用(记录并等待)
在用新数据创建训练数据以更新模型时,请记住,新数据已经通过了预测服务。这个预测服务已经从新数据中提取了特征,输入模型进行预测。一些公司会复用这些提取出的特征来重训练模型,这既节省了计算,又保证了预测和训练之间的一致性。这种方法被称为"记录并等待”(log and wait)。这是减少第 8 章讨论的训练-服务偏差(train-serving skew)的经典方法(参见第 229 页"生产数据与训练数据不同"一节)。
记录并等待还不是一种流行的方法,但正变得越来越流行。Faire 有一篇很棒的博客文章,讨论了他们的"记录并等待"方法的优缺点。
阶段 3:自动化、有状态训练
在第 2 阶段,每次重训练模型时,你都是从头训练(无状态重训练)。这让你的重训练成本高昂,尤其是更高频率的重训练。你读了第 265 页的"无状态重训练与有状态训练"一节,决定要做有状态训练——既然可以只用最近一天的数据继续训练,为什么还要每天用过去三个月的数据训练呢?
所以在这个阶段,你重新配置你的自动更新脚本,使得模型更新被启动时,它首先定位之前的检查点,把它加载到内存中,然后在这个检查点上继续训练。
要求。这个阶段你需要的主要是心态上的转变:从头重训练是如此地习以为常——许多公司已经习惯了数据科学家每次把模型交给工程师从头部署——以至于很多公司根本没想过要搭建基础设施来支持有状态训练。
一旦你下定决心做有状态训练,重新配置更新脚本就很简单了。这个阶段你主要需要的是跟踪数据和模型谱系(lineage)的方法。想象你首先上传模型版本 1.0。这个模型用新数据更新,创建模型版本 1.1,以此类推创建模型 1.2。然后另一个模型被上传,称为模型版本 2.0。这个模型用新数据更新,创建模型版本 2.1。过一段时间,你可能有模型版本 3.32、模型版本 2.11、模型版本 1.64。你可能想知道这些模型如何随时间演化,哪个模型被用作基础模型,以及用哪些数据更新了它,以便你能重现和调试它。据我所知,现有的模型存储都没有这种模型谱系能力,所以你很可能得在公司内部自己构建解决方案。
如果你想从实时传输而不是数据仓库中拉取新鲜数据,如第 270 页的"新鲜数据访问挑战"一节所讨论的,而你的流式基础设施还不够成熟,你可能需要彻底改造你的流式管道。
阶段 4:持续学习
在第 3 阶段,你的模型仍然是按照开发人员设定的固定计划更新的。找到最优计划并不简单,而且可能因情况而异。例如,上周市场没什么大事,所以你的模型衰减得没那么快。然而,这周发生了很多事件,所以你的模型衰减得快得多,需要快得多的重训练计划。
与其依赖固定计划,你可能会希望模型在数据分布发生漂移、模型性能骤降时被自动更新。
圣杯是把持续学习与边缘部署(edge deployment)结合起来。想象你能把一个基础模型随新设备一起出货——手机、手表、无人机等等——而设备上的模型会不断更新、按需适应它的环境,无需与集中式服务器同步。不再需要集中式服务器,这意味着没有集中式服务器的成本。也不再需要在设备和云端之间来回传输数据,这意味着更好的数据安全和隐私!
要求。从第 3 阶段到第 4 阶段的跨越是陡峭的。你首先需要一个触发模型更新的机制。这个触发器可以是:
基于时间的
例如,每五分钟一次
基于性能的
例如,每当模型性能骤降时
基于数据量的
例如,每当标注数据总量增加 5% 时
基于漂移的
例如,每当检测到重大数据分布漂移时
要让这个触发机制发挥作用,你需要一个可靠的监控解决方案。我们在第 250 页的"监控与可观测性"一节中讨论过,难点不在于检测变化,而在于确定这些变化中哪些是重要的。如果你的监控解决方案产生大量误报,你的模型最终会被更新得比实际需要的频繁得多。
你还需要一个可靠的管道来持续评估你的模型更新。编写一个更新模型的函数与你在第 3 阶段做的并没有太大不同。难点在于确保更新后的模型正常工作。我们将在第 281 页的"生产环境测试"一节中介绍你可以使用的各种测试技术。
多久更新一次模型
现在你的基础设施已经搭建好,可以快速更新模型了,你开始问那个困扰着各种规模公司机器学习工程师的问题:“我应该多久更新一次模型?“在尝试回答这个问题之前,我们首先需要弄清楚模型从用新鲜数据更新中能获得多少收益。模型从更新鲜的数据中能获得的收益越大,它就越应该被频繁重训练。
数据新鲜度的价值
如果我们知道更新能提升多少模型性能,“多久更新一次模型"这个问题就会变得容易得多。例如,如果我们把重训练模型从每月一次改为每周一次,我们能获得多少性能提升?如果改为每天重训练呢?人们一直在说数据分布会漂移,所以更新鲜的数据更好,但更新鲜的数据到底好多少?
一种算出收益的方法是:用过去不同时间窗口的数据训练模型,再用今天的数据评估它,看看性能如何变化。例如,假设你有 2020 年的数据。为了衡量数据新鲜度的价值,你可以做实验:用 2020 年 1 月到 6 月的数据训练模型版本 A,用 4 月到 9 月的数据训练模型版本 B,用 6 月到 11 月的数据训练模型版本 C,然后用 12 月的数据测试每个模型版本,如图 9-5 所示。这些版本性能的差异会让你对模型从更新鲜数据中能获得的性能收益有所感觉。如果用三个月前的数据训练的模型比用一个月前的数据训练的模型差得多,你就知道不应该等一个季度才重训练模型。
图 9-5. 为了解从更新鲜数据中能获得的性能收益,用过去不同时间窗口的数据训练模型,并用今天的数据测试,看看性能如何变化
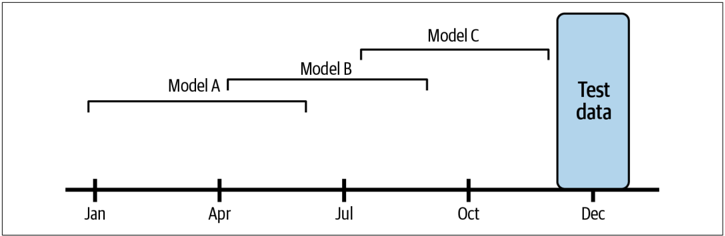
这是一个说明数据新鲜度实验如何运作的简单例子。在实践中,你可能希望实验粒度细得多,不是按月运作,而是按周、按天,甚至按小时或分钟。2014 年,Facebook 为广告点击率预测做了一个类似的实验,发现从每周重训练改为每天重训练可以将模型损失降低 1%,这个性能收益足够显著,让他们把重训练管道从每周改为每天。25 鉴于今天的在线内容如此多样化,用户的在线注意力变化也快得多,我们可以想象数据新鲜度对广告点击率的价值甚至更高。一些拥有先进机器学习基础设施的公司已经发现了足够的性能收益,把重训练管道改成了每几分钟一次。26
模型迭代与数据迭代
我们在本章前面讨论过,并非所有模型更新都是一样的。我们区分了模型迭代(向现有模型架构添加新特征或改变模型架构)和数据迭代(模型架构和特征不变,但用新数据刷新模型)。你可能会想,不仅多久更新一次模型,还要考虑执行哪种类型的模型更新。
理论上,你可以做这两种更新;实践中,你应该时不时地两者都做。然而,你在一种方法上投入的资源越多,你能投入另一种方法的资源就越少。
一方面,如果你发现对数据的迭代不能给你带来多少性能收益,那么你应该把资源花在寻找更好的模型上。另一方面,如果寻找更好的模型架构需要 100 倍的计算量进行训练,却只带来 1% 的性能提升,而用最近三小时的数据更新同一个模型只需要 1 倍的计算量,也带来 1% 的性能提升,那么你最好在数据上迭代。
也许在不久的将来,我们会获得更多理论上的理解,知道在什么情况下哪种方法会更好(此处应有"研究呼吁”),但截至今天,没有哪本书能告诉你哪种方法对你的特定任务上的特定模型更有效。你必须通过实验来弄清楚。
“多久更新一次模型"这个问题很难回答,我希望这一节已经充分解释了它的细微之处。一开始,当你的基础设施还很稚嫩、更新模型的过程手动而缓慢时,答案是:尽可能频繁地更新。
然而,随着你的基础设施成熟,模型更新过程部分自动化,可以在几小时内(如果不是几分钟内)完成,这个问题的答案取决于下面这个问题的答案:“我能从更新鲜的数据中获得多少性能收益?“运行实验来量化数据新鲜度对你模型的价值至关重要。
生产环境测试
在整本书(包括本章)中,我们都谈到了部署未经充分评估的模型的危险。要充分评估你的模型,你首先需要第 6 章讨论的离线评估和本节讨论的在线评估的结合。为了理解为什么离线评估不够,让我们回顾一下离线评估的两种主要测试类型:测试集划分(test split)和回测(backtest)。
你可能想到的第一种模型评估方式是古老而可靠的测试集划分,你可以用它在离线环境中评估模型,如第 6 章所述。这些测试集划分通常是静态的,而且必须是静态的,这样你才有一个可信的基准来比较多个模型。如果两个模型在不同的测试集上测试,就很难比较它们的测试结果。
然而,如果你更新模型以适应新的数据分布,在这个新分布之外的测试集划分上评估新模型是不够的。假设数据越新鲜,越有可能来自当前分布,一个想法是在你能获得的最新数据上测试你的模型。所以,在你用最近一天的数据更新模型之后,你可能想用最近一小时的数据测试这个模型(假设最近一小时的数据没有包含在更新模型所用的数据中)。这种在过去的特定时间段数据上测试预测模型的方法被称为回测。
问题是,回测是否足以取代静态测试集划分?并不完全够。如果你的数据管道出了问题,最近一小时的一些数据被破坏了,那么仅仅在这份近期数据上评估你的模型是不够的。
使用回测的同时,你仍然应该在一个你已经深入研究过并且(大部分)信任的静态测试集上评估你的模型,作为一种健全性检查。
因为数据分布会漂移,一个模型在最近一小时的数据上表现良好,并不意味着它会在未来的数据上继续表现良好。要知道一个模型在生产环境中是否会表现良好,唯一的方法就是部署它。这一洞见引出了一个看似可怕但必不可少的概念:生产环境测试。然而,生产环境测试不一定可怕。有一些技术可以帮助你(大部分)安全地在生产环境中评估模型。在本节中,我们将介绍以下技术:影子部署(shadow deployment)、A/B 测试(A/B testing)、金丝雀分析(canary analysis)、交错实验(interleaving experiments)和多臂老虎机(bandits)。
影子部署
影子部署(shadow deployment)可能是部署你的模型或任何软件更新最安全的方式。影子部署的工作方式如下:
- 将候选模型与现有模型并行部署。
- 对每个传入请求,将其路由到两个模型进行预测,但只把现有模型的预测结果提供给用户。
- 记录新模型的预测结果,供分析之用。
只有当你发现新模型的预测令人满意时,你才用新模型替换现有模型。
因为在你确认新模型的预测令人满意之前,你不会把新模型的预测提供给用户,所以新模型做出古怪行为的风险很低,至少不会高于现有模型。然而,这种技术并不总是可取的,因为它很昂贵。它使系统必须生成的预测数量翻倍,这通常意味着推理计算成本翻倍。
A/B 测试
A/B 测试是一种比较一个对象的两个变体的方法,通常通过测试对这两个变体的响应,来确定哪个变体更有效。在我们的场景中,现有模型是一个变体,候选模型(最近更新的模型)是另一个变体。我们将用 A/B 测试来根据一些预定义的指标确定哪个模型更好。
A/B 测试已经变得如此普遍,截至 2017 年,微软和谷歌这样的公司每年各进行超过 10,000 次 A/B 测试。27 它是许多机器学习工程师对"如何在生产环境中评估机器学习模型"的第一反应。A/B 测试的工作方式如下:
- 将候选模型与现有模型一起部署。
- 一定比例的流量被路由到新模型进行预测;其余流量被路由到现有模型进行预测。两个变体同时服务预测流量是很常见的。然而,有些情况下一个模型的预测可能会影响另一个模型的预测——例如,在拼车服务的动态定价中,一个模型预测的价格可能会影响可用司机和乘客的数量,这反过来又影响另一个模型的预测。在这些情况下,你可能不得不交替运行你的变体,比如第一天服务模型 A,第二天服务模型 B。
- 监控和分析两个模型的预测结果和用户反馈(如果有的话),以确定两个模型性能的差异是否具有统计显著性(statistical significance)。
要把 A/B 测试做对,需要把很多事做对。在本书中,我们将讨论两件重要的事。首先,A/B 测试由一个随机化实验组成:路由到每个模型的流量必须是真正随机的。如果不是,测试结果将无效。例如,如果流量路由到两个模型的方式存在选择偏差(selection bias),比如接触模型 A 的用户通常在用手机,而接触模型 B 的用户通常在用台式机,那么如果模型 A 的准确率高于模型 B,我们无法判断这是因为 A 比 B 好,还是"在手机上"影响了预测质量。
其次,你的 A/B 测试应该在足够的样本量上运行,以获得对结果的足够信心。如何计算 A/B 测试所需样本量是一个问题简单但答案非常复杂的问题,我建议读者参考一本关于 A/B 测试的书来了解更多。
这里的要点是,如果你的 A/B 测试结果显示一个模型在统计上显著地优于另一个模型,你就可以确定哪个模型确实更好。为了衡量统计显著性,A/B 测试使用统计假设检验(statistical hypothesis testing),比如双样本检验(two-sample test)。我们在第 8 章中见过双样本检验,当时我们用它来检测分布漂移。提醒一下,双样本检验是一种确定两个总体之间的差异是否统计显著的检验。在分布漂移的用例中,如果统计差异表明两个总体来自不同的分布,这意味着原始分布已经发生漂移。在 A/B 测试的用例中,统计差异意味着我们收集了足够的证据,表明一个变体优于另一个变体。
统计显著性虽然有用,但并非万无一失。假设我们运行一个双样本检验,得到的结果是模型 A 优于模型 B,p 值为 \(p = 0.05\),即 5%,而我们定义统计显著性为 \(p \le 0.5\)。这意味着如果我们多次运行同一个 A/B 测试实验,有(100 - 5 =)95% 的时间会得到 A 优于 B 的结果,另外 5% 的时间 B 优于 A。所以即使结果是统计显著的,如果我们再运行一次实验,仍有可能选中另一个模型。
即使你的 A/B 测试结果不显著,也并不意味着这次 A/B 测试失败了。如果你用大量样本运行了 A/B 测试,而被测试的两个模型之间的差异在统计上不显著,也许这两个模型之间没有太大差别,你用哪个可能都没问题。
对于有兴趣了解更多 A/B 测试和机器学习中其他重要统计概念的读者,我推荐 Ron Kohavi 的书 Trustworthy Online Controlled Experiments (A Practical Guide to A/B Testing)(剑桥大学出版社),以及 Michael Barber 写的很棒的数据科学统计学入门介绍(短得多)。
通常,在生产环境中,你不只有一个候选模型,而是有多个候选模型。用两个以上的变体做 A/B 测试也是可能的,这意味着我们可以做 A/B/C 测试,甚至 A/B/C/D 测试。
金丝雀发布
金丝雀发布(canary release)是一种降低在生产环境中引入新软件版本风险的技术:先把变更缓慢地推给一小部分用户,然后再推送到整个基础设施、让所有人都能用上。28 在机器学习部署的语境下,金丝雀发布的工作方式如下:
- 将候选模型与现有模型一起部署。候选模型被称为金丝雀(canary)。
- 一部分流量被路由到候选模型。
- 如果它的性能令人满意,就增加路由到候选模型的流量。如果不满意,就中止金丝雀,把所有流量都路由回现有模型。
- 当金丝雀服务了所有流量(候选模型已取代现有模型)或金丝雀被中止时,停止。
候选模型的性能是根据你关心的指标与现有模型的性能进行衡量的。如果候选模型的关键指标显著恶化,金丝雀就会被中止,所有流量将被路由到现有模型。
由于设置上的相似性,金丝雀发布可以用来实现 A/B 测试。然而,你也可以在没有 A/B 测试的情况下做金丝雀分析。例如,你不必随机化路由到每个模型的流量。一个合理的场景是:先把候选模型推给一个不那么关键的市场,然后再推给所有人。
对于有兴趣了解金丝雀发布在业界如何运作的读者,Netflix 和谷歌有一篇很棒的合作博客文章,介绍自动化金丝雀分析如何在他们公司被使用。
交错实验
想象你有两个推荐系统 A 和 B,你想评估哪个更好。每次,一个模型推荐用户可能喜欢的 10 个物品。用 A/B 测试的话,你会把你的用户分成两组:一组接触 A,另一组接触 B。每个用户只会接触到来自一个模型的推荐。
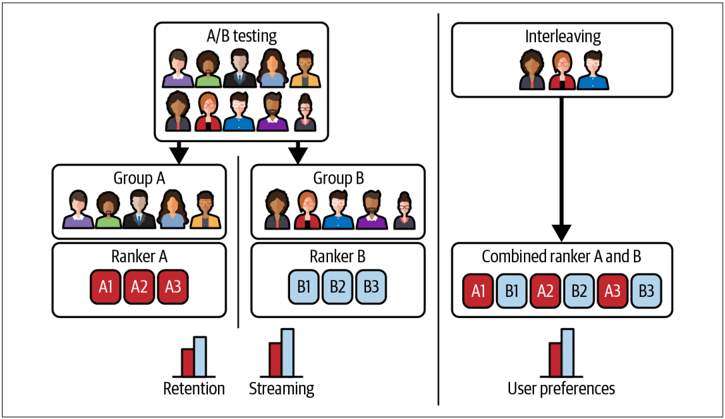
如果我们不让用户只接触来自一个模型的推荐,而是让用户接触来自两个模型的推荐,看看他们会点击哪个模型的推荐呢?这就是交错实验(interleaving experiments)背后的想法,最初由 Thorsten Joachims 在 2002 年为搜索排序问题提出。29 在实验中,Netflix 发现交错"与传统 A/B 测试相比,能以相当小的样本量可靠地识别出最佳算法”。30
图 9-6 展示了交错与 A/B 测试的不同。在 A/B 测试中,会在两组之间测量并比较留存率(retention)和流媒体播放(streaming)等核心指标。在交错中,可以通过测量用户偏好来比较两个算法。因为交错可以由用户偏好决定,所以无法保证用户偏好会带来更好的核心指标。
图 9-6. 交错与 A/B 测试的对比示意。来源:改编自 Parks 等人的图片
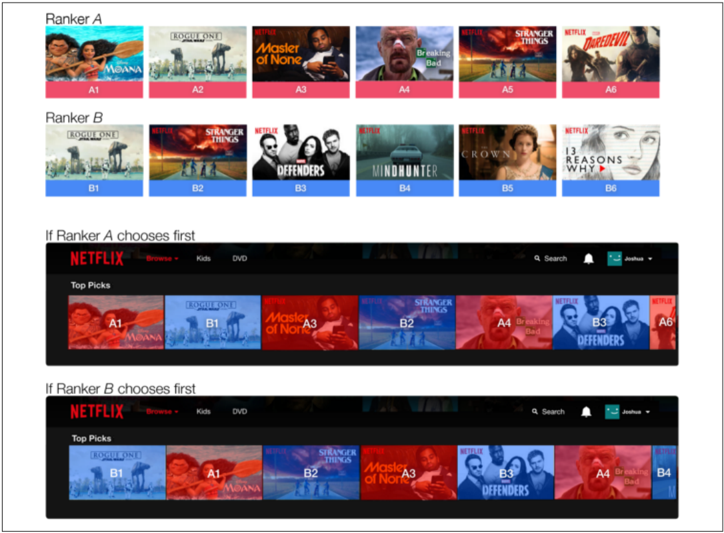
当我们向用户展示来自多个模型的推荐时,重要的是要注意推荐的位置会影响用户点击它的可能性。例如,用户点击顶部推荐的可能性远高于点击底部推荐。为了让交错产生有效的结果,我们必须确保在任何给定的位置上,推荐由 A 或 B 生成的可能性相等。为了确保这一点,我们可以使用的一种方法是团队选秀式交错(team-draft interleaving),它模仿体育中的选秀过程。对于每个推荐位置,我们以相等的概率随机选择 A 或 B,被选中的模型挑选尚未被选中的最佳推荐。31 这种团队选秀方法如何运作的可视化如图 9-7 所示。
图 9-7. 使用团队选秀对来自两个排序算法的视频推荐进行交错。来源:Parks 等人32
多臂老虎机
对于不熟悉的人来说,老虎机算法(bandit algorithms)起源于赌博。赌场里有多个老虎机, payout(赔付)各不相同。老虎机也被称为"独臂强盗”(one-armed bandit),算法因此得名。你不知道哪台老虎机赔付最高。你可以随着时间推移做实验,在最大化自己赔付的同时找出最好的老虎机。多臂老虎机(multi-armed bandits)是允许你在利用(exploitation,选择过去赔付最多的老虎机)和探索(exploration,选择其他可能赔付更多的老虎机)之间取得平衡的算法。
截至今天,在生产环境中测试模型的标准方法是 A/B 测试。用 A/B 测试,你随机把流量路由到每个模型进行预测,并在试验结束时衡量哪个模型效果更好。A/B 测试是无状态的:你可以在不知道模型当前性能的情况下把流量路由到每个模型。你甚至可以用批处理预测做 A/B 测试。
当你有多个模型要评估时,每个模型都可以被看作一台赔付(即预测准确率)未知的老虎机。老虎机算法允许你决定如何把流量路由到每个模型进行预测,以确定最佳模型,同时为用户最大化预测准确率。老虎机是有状态的:在把请求路由到某个模型之前,你需要计算所有模型当前的性能。这需要三样东西:
- 你的模型必须能够做在线预测。
- 最好有短反馈回路:你需要获得关于预测好坏的反馈。对于标签可以由用户反馈确定的任务通常如此,比如推荐——如果用户点击了一个推荐,就推断它很好。如果反馈回路短,你就能快速更新每个模型的收益。
- 一个收集反馈、计算并跟踪每个模型性能、根据它们当前的性能把预测请求路由到不同模型的机制。
老虎机在学术界得到了充分研究,并被证明比 A/B 测试节省数据得多(在许多情况下,老虎机甚至是最优的)。老虎机确定哪个模型最好所需的数据更少,同时因为它们更快地把流量路由到更好的模型,也降低了机会成本。参见 LinkedIn、Netflix、Facebook 和 Dropbox、Zillow 以及 Stitch Fix 关于老虎机的讨论。想了解更多理论视角,参见 Reinforcement Learning(Sutton 和 Barto,2020)第 2 章。
在谷歌的 Greg Rafferty 做的一个实验中,A/B 测试需要超过 630,000 个样本才能得到 95% 的置信区间,而一个简单的老虎机算法(汤普森采样,Thompson Sampling)用不到 12,000 个样本就确定了一个模型比另一个好 5%。33
然而,老虎机比 A/B 测试难实现得多,因为它需要计算和跟踪模型的收益。因此,除了少数几家大型科技公司外,老虎机算法在业界并未被广泛使用。
老虎机算法
许多解决多臂老虎机问题的方案都可以用在这里。最简单的探索算法是 ε-贪心(\(\varepsilon\)-greedy)。在百分之 ε 的时间里——比如 90% 的时间或 \(\varepsilon = 0.9\)——你把流量路由到当前性能最好的模型,在其余 10% 的时间里,你把流量路由到一个随机模型。这意味着你的系统生成的每个预测中,90% 来自当时最佳的模型。
两个最流行的探索算法是汤普森采样和上置信界(Upper Confidence Bound,UCB)。汤普森采样以"该模型在当前知识下是最优的"这一概率来选择模型。34 在我们的场景中,这意味着算法根据模型比其他所有模型具有更高值(更好性能)的概率来选择模型。另一方面,UCB 选择上置信界最高的物品。35 我们说 UCB 实现了"面对不确定性时的乐观”(optimism in the face of uncertainty),它给不确定的物品一个"不确定性奖励”,也叫"探索奖励”(exploration bonus)。
上下文老虎机作为探索策略
如果说用于模型评估的老虎机是为了确定每个模型的收益(即预测准确率),那么上下文老虎机(contextual bandits)就是为了确定每个动作的收益。在推荐/广告的场景中,一个动作就是向用户展示的一个物品/广告,收益就是用户点击它的可能性。和其他老虎机一样,上下文老虎机是提高模型数据效率的了不起的技术。
有些人也把用于模型评估的老虎机称为"上下文老虎机”。这会让对话变得混乱,所以在本书中,“上下文老虎机"指的是确定预测收益的探索策略。
想象你在构建一个有 1,000 个物品要推荐的推荐系统,这就成了一个 1,000 臂老虎机问题。每次你只能向用户推荐最相关的 10 个物品。用老虎机的术语说,你必须选出最好的 10 个臂。展示出来的物品会获得用户反馈,反馈通过用户是否点击它们来推断。但其他 990 个物品你不会得到反馈。这就是所谓的部分反馈问题(partial feedback problem),也叫老虎机反馈(bandit feedback)。你也可以把上下文老虎机看作一个带有老虎机反馈的分类问题。
假设每次用户点击一个物品,这个物品就获得 1 个价值点。当一个物品有 0 个价值点时,可能是因为这个物品从未被展示给用户,也可能是因为它被展示了但没有被点击。你想向用户展示对他们价值最高的物品,但如果你只向用户展示价值点最高的物品,你就会一直推荐同样那些热门物品,而从未展示过的物品会一直保持 0 个价值点。
上下文老虎机是帮助你在"向用户展示他们会喜欢的物品"和"展示你想获得反馈的物品"之间取得平衡的算法。36 这就是许多读者可能在强化学习(reinforcement learning)中遇到过的探索-利用权衡。上下文老虎机也被称为"单步”(one-shot)强化学习问题。37 在强化学习中,你可能需要采取一系列动作才能看到奖励。而在上下文老虎机中,你可以在一个动作之后立刻获得老虎机反馈——例如,推荐一个广告之后,你会立刻得到用户是否点击了这个推荐的反馈。
上下文老虎机得到了充分研究,并被证明能显著提高模型性能(参见 Twitter 和谷歌的报告)。然而,上下文老虎机甚至比模型老虎机更难实现,因为探索策略取决于机器学习模型的架构(例如,它是决策树还是神经网络),这使得它跨用例的可推广性较差。有兴趣把上下文老虎机与深度学习结合起来的读者,应该看看 Twitter 团队写的一篇很棒论文:“Deep Bayesian Bandits: Exploring in Online Personalized Recommendations”(Guo 等人,2020 年)。
在结束本节之前,有一点我想强调。我们已经介绍了多种针对机器学习模型的测试类型。然而,重要的是要注意,一个好的评估管道不仅关乎运行哪些测试,还关乎应该由谁来运行这些测试。在机器学习中,评估过程通常由数据科学家主导——开发模型的人负责评估它。数据科学家倾向于用他们喜欢的测试集临时地评估他们的新模型。首先,这个过程充满了偏见——数据科学家拥有大多数用户没有的关于他们模型的背景知识,这意味着他们可能不会以大多数用户会用的方式来使用这个模型。其次,这个过程的临时性意味着结果可能不稳定。一位数据科学家可能执行一组测试,发现模型 A 优于模型 B,而另一位数据科学家可能报告不同的结果。
生产环境中缺乏确保模型质量的机制,导致许多模型在部署后失败,这反过来又加剧了数据科学家部署模型时的焦虑。为了缓解这个问题,每个团队都应该制定清晰的管道,规定模型应如何被评估:例如,运行哪些测试、按什么顺序运行、必须通过什么阈值才能进入下一阶段。更好的做法是,这些管道应该被自动化,并且每当有新的模型更新时就被触发。结果应该被报告和审查,类似于传统软件工程中的持续集成/持续部署(CI/CD)流程。理解"一个好的评估过程不仅涉及运行哪些测试,还涉及由谁来运行这些测试"至关重要。
小结
本章触及了一个我认为最令人兴奋但尚未被充分探索的话题:如何在生产环境中持续更新模型,使它们适应不断变化的数据分布。我们讨论了一家公司在为持续学习现代化基础设施的过程中可能经历的四个阶段:从手动、从头训练的阶段,到自动化、无状态的持续学习。
然后我们审视了困扰着各种规模公司机器学习工程师的问题——“我应该多久更新一次模型?"——敦促他们考虑数据新鲜度对模型的价值,以及模型迭代和数据迭代之间的权衡。
与第 7 章讨论的在线预测类似,持续学习需要一个成熟的流式基础设施。持续学习的训练部分可以用批处理完成,但在线评估部分需要流式处理。许多工程师担心流式处理很难、很贵。三年前确实如此,但自那以后流式技术已经显著成熟。越来越多的公司提供解决方案,让公司更容易转向流式处理,包括 Spark Streaming、Snowflake Streaming、Materialize、Decodable、Vectorize 等等。
持续学习是机器学习特有的问题,但在很大程度上需要基础设施层面的解决方案。为了加快迭代周期、快速发现新模型更新中的失败,我们需要以正确的方式搭建基础设施。这需要数据科学/机器学习团队与平台团队携手合作。我们将在下一章讨论机器学习的基础设施。
Joan Serrà、Dídac Surís、Marius Miron 和 Alexandros Karatzoglou,“Overcoming Catastrophic Forgetting with Hard Attention to the Task,” arXiv,2018 年 1 月 4 日,https://oreil.ly/P95EZ。 ↩︎
是"有状态训练"而不是"有状态重训练”,因为这里没有"重新"训练。模型是从最后的状态继续训练的。 ↩︎
Alex Egg,“Online Learning for Recommendations at Grubhub,” arXiv,2021 年 7 月 15 日,https://oreil.ly/FBBUw。 ↩︎
Mu Li、Li Zhou、Zichao Yang、Aaron Li、Fei Xia、David G. Andersen 和 Alexander Smola,“Parameter Server for Distributed Machine Learning”(NIPS Workshop on Big Learning,加州太浩湖,2013 年),https://oreil.ly/xMmru。 ↩︎
Jonathan Raiman、Susan Zhang 和 Christy Dennison,“Neural Network Surgery with Sets,” arXiv,2019 年 12 月 13 日,https://oreil.ly/SU0F1。 ↩︎
这类问题也被称为"动态定价”(dynamic pricing)。 ↩︎
Jon Russell,“Alibaba Acquires German Big Data Startup Data Artisans for $103M,” TechCrunch,2019 年 1 月 8 日,https://oreil.ly/4tf5c。一位早期审阅者提到,这笔收购的主要目的也可能是为了扩大阿里巴巴的开源足迹——与其他科技巨头相比,其开源足迹微不足道。 ↩︎
如果你想让你的模型判断何时推荐一部还没有人看过、也没有人给出反馈的新电影,这个问题同样具有挑战性。 ↩︎
Lucas Bernardi、Jaap Kamps、Julia Kiseleva 和 Melanie J. I. Müller,“The Continuous Cold Start Problem in e-Commerce Recommender Systems,” arXiv,2015 年 8 月 5 日,https://oreil.ly/GWUyD。 ↩︎
Jacopo Tagliabue、Ciro Greco、Jean-Francis Roy、Bingqing Yu、Patrick John Chia、Federico Bianchi 和 Giovanni Cassani,“SIGIR 2021 E-Commerce Workshop Data Challenge,” arXiv,2021 年 4 月 19 日,https://oreil.ly/8QxmS。 ↩︎
Catherine Wang,“Why TikTok Made Its User So Obsessive? The AI Algorithm That Got You Hooked,” Towards Data Science,2020 年 6 月 7 日,https://oreil.ly/BDWf8。 ↩︎
参见第 74 页"数据流经实时传输"一节。 ↩︎
参见第 78 页"批处理与流处理"一节。 ↩︎
Tyler Akidau,“Snowflake Streaming: Now Hiring! Help Design and Build the Future of Big Data and Stream Processing,” Snowflake 博客,2020 年 10 月 26 日,https://oreil.ly/Knh2Y。 ↩︎
Arjun Narayan,“Materialize Raises a $60M Series C, Bringing Total Funding to Over $100M,” Materialize,2021 年 9 月 30 日,https://oreil.ly/dqxRb。 ↩︎
Khristopher J. Brooks,“Disparity in Home Lending Costs Minorities Millions, Researchers Find,” CBS News,2019 年 11 月 15 日,https://oreil.ly/SpZ1N;Lee Brown,“Tesla Driver Killed in Crash Posted Videos Driving Without His Hands on the Wheel,” New York Post,2021 年 5 月 16 日,https://oreil.ly/uku9S;“A Tesla Driver Is Charged in a Crash Involving Autopilot That Killed 2 People,” NPR,2022 年 1 月 18 日,https://oreil.ly/WWaRA。 ↩︎
James Vincent,“Twitter Taught Microsoft’s Friendly AI Chatbot to Be a Racist Asshole in Less Than a Day,” The Verge,2016 年 5 月 24 日,https://oreil.ly/NJEVF。 ↩︎
他们的欺诈检测系统由多个机器学习模型组成。 ↩︎
在第 287 页的"多臂老虎机"一节中,我们将了解老虎机(bandit)如何作为比 A/B 测试更节省数据的替代方案。 ↩︎
有些人把这种设置称为"部分信息学习"(learning with partial information),但部分信息学习指的是另一种设置,如 Gonen 等人(2016 年)的论文"Subspace Learning with Partial Information"所述。 ↩︎
Pedro Domingos 和 Geoff Hulten,“Mining High-Speed Data Streams,” in Proceedings of the Sixth International Conference on Knowledge Discovery and Data Mining(波士顿:ACM Press,2000 年),71-80;Albert Bifet 和 Ricard Gavaldà,“Adaptive Parameter-free Learning from Evolving Data Streams,” 2009 年,https://oreil.ly/XIMpl。 ↩︎
Zohar Karnin、Kevin Lang 和 Edo Liberty,“Optimal Quantile Approximation in Streams,” arXiv,2016 年 3 月 17 日,https://oreil.ly/bUu4H。 ↩︎
我们将在第 319 页的"机器学习平台"一节中介绍机器学习平台。 ↩︎
如果你每天都有很多新商品,你可能需要更频繁地训练嵌入模型。 ↩︎
Xinran He、Junfeng Pan、Ou Jin、Tianbing Xu、Bo Liu、Tao Xu、Tanxin Shi 等人,“Practical Lessons from Predicting Clicks on Ads at Facebook,” in ADKDD ‘14: Proceedings of the Eighth International Workshop on Data Mining for Online Advertising(2014 年 8 月):1-9,https://oreil.ly/oS16J。 ↩︎
Qian Yu,“Machine Learning with Flink in Weibo,” QCon 2019,视频,17:57,https://oreil.ly/Yia6v。 ↩︎
Ron Kohavi 和 Stefan Thomke,“The Surprising Power of Online Experiments,” Harvard Business Review,2017 年 9-10 月刊,https://oreil.ly/OHfj0。 ↩︎
Danilo Sato,“CanaryRelease,” 2014 年 6 月 25 日,MartinFowler.com,https://oreil.ly/YtKJE。 ↩︎
Thorsten Joachims,“Optimizing Search Engines using Clickthrough Data,” KDD 2002,https://oreil.ly/XnH5G。 ↩︎
Joshua Parks、Juliette Aurisset 和 Michael Ramm,“Innovating Faster on Personalization Algorithms at Netflix Using Interleaving,” Netflix Technology Blog,2017 年 11 月 29 日,https://oreil.ly/lnvDY。 ↩︎
Olivier Chapelle、Thorsten Joachims、Filip Radlinski 和 Yisong Yue,“Large-Scale Validation and Analysis of Interleaved Search Evaluation,” ACM Transactions on Information Systems 30, no. 1(2012 年 2 月):6,https://oreil.ly/lccvK。 ↩︎
Parks 等人,“Innovating Faster on Personalization Algorithms。” ↩︎
Greg Rafferty,“A/B Testing—Is There a Better Way? An Exploration of Multi-Armed Bandits,” Towards Data Science,2020 年 1 月 22 日,https://oreil.ly/MsaAK。 ↩︎
William R. Thompson,“On the Likelihood that One Unknown Probability Exceeds Another in View of the Evidence of Two Samples,” Biometrika 25, no. 3/4(1933 年 12 月):285-94,https://oreil.ly/TH1HC。 ↩︎
Peter Auer,“Using Confidence Bounds for Exploitation-Exploration Trade-offs,” Journal of Machine Learning Research 3(2002 年 11 月):397-422,https://oreil.ly/vp9mI。 ↩︎
Lihong Li、Wei Chu、John Langford 和 Robert E. Schapire,“A Contextual-Bandit Approach to Personalized News Article Recommendation,” arXiv,2010 年 2 月 28 日,https://oreil.ly/uaWHm。 ↩︎
根据维基百科,多臂老虎机是一个经典的强化学习问题,它体现了探索-利用权衡困境(“Multi-armed bandit"词条,https://oreil.ly/ySjwo)。这个名字源于想象一个赌徒面对一排老虎机(有时被称为"独臂强盗”),他必须决定玩哪些机器、每台机器玩多少次、按什么顺序玩,以及是继续用当前这台机器还是换一台不同的机器。 ↩︎