数据分布偏移与监控
让我们用一个高管告诉我的故事来开始本章,许多读者可能对此深有感触。大约两年前,他的公司聘请了一家咨询公司开发一个 ML 模型,用来预测下周每种杂货商品需要多少,以便据此补货。咨询公司花了六个月开发这个模型。当咨询公司交付模型后,他的公司部署了它,并对其性能非常满意。他们终于可以向投资者吹嘘自己是一家由 AI 驱动的公司了。
然而,一年后,他们的数字下滑了。某些商品的需求一直被高估,导致多余的货品过期。与此同时,某些商品的需求一直被低估,导致销售流失。¹ 起初,他的库存团队手动修改模型的预测以纠正他们注意到的模式,但最终模型的预测变得太差,他们无法再使用它。他们有三个选择:付给同一家咨询公司一笔天价费用来更新模型;付给另一家咨询公司更多的钱,因为这家公司需要时间上手;或者组建一支内部团队来长期维护这个模型。
¹ 这似乎是库存预测中相当常见的模式。Eugene Yan 在他的文章《部署机器学习后的 6 个鲜为人知的挑战》(6 Little-Known Challenges After Deploying Machine Learning,2021 年)中写了一个类似的故事,来说明退化反馈回路(degenerate feedback loops)问题。
他的公司以惨痛的方式学到了一个重要教训,整个行业也正在发现这一点:部署模型并不是过程的终点。模型投入生产后,性能会随时间退化。一旦模型被部署,我们仍然必须持续监控它的性能以发现问题,并部署更新来修复这些问题。
在本章和下一章中,我们将介绍帮助你让模型在生产中保持良好状态的必要主题。我们将从 ML 模型在开发阶段表现优异却在生产中失败的原因讲起。然后,我们将深入探讨一个几乎影响所有生产 ML 模型的、尤其普遍且棘手的问题:数据分布偏移(data distribution shifts)。当生产中的数据分布与模型在训练期间接触的数据分布不同并发生偏离时,就会出现这种情况。接下来我们会讲如何监控分布偏移。在下一章中,我们将介绍如何在生产中持续更新模型,以适应数据分布的偏移。
ML 系统故障的原因
在找出 ML 系统故障的原因之前,我们先简单讨论一下什么是 ML 系统故障。当系统的一个或多个期望被违背时,就发生了故障。在传统软件中,我们主要关心系统的运行期望(operational expectation):系统是否在预期的运行指标范围内执行其逻辑,例如延迟(latency)和吞吐量(throughput)。
对于 ML 系统,我们既关心它的运行指标,也关心它的 ML 性能指标。例如,考虑一个英法机器翻译系统。它的运行期望可能是:给定一个英文句子,系统在一秒延迟内返回法语翻译。它的 ML 性能期望是:返回的翻译有 99% 的时间是原英文句子的准确翻译。
如果你向系统输入一个英文句子却没有得到翻译,第一个期望被违背了,所以这是系统故障。
如果你得到了一个不正确的翻译,它不一定是系统故障,因为准确率期望允许一定的误差空间。然而,如果你不断向系统输入不同的英文句子,并不断得到错误的翻译,第二个期望就被违背了,这就构成了系统故障。
运行期望的违背更容易检测,因为它们通常伴随着运行层面的损坏,例如超时、网页上的 404 错误、内存不足错误或段错误(segmentation fault)。然而,ML 性能期望的违背更难检测,因为这需要测量和监控生产环境中 ML 模型的性能。在前面的英法机器翻译系统示例中,如果我们不知道正确译文应该是什么,就很难检测返回的译文是否 99% 的时间是正确的。有无数 Google 翻译错得离谱的例子被用户使用,因为他们并不知道这些是错误翻译。因此,我们说 ML 系统经常无声地失败(fail silently)。
为了有效检测和修复生产中的 ML 系统故障,理解一个模型在开发阶段被证明运行良好后,为什么会在生产中失败是很有用的。我们将考察两类故障:软件系统故障(software system failures)和 ML 特有故障(ML-specific failures)。
软件系统故障
软件系统故障是指那些也会发生在非 ML 系统上的故障。以下是一些软件系统故障的例子:
依赖故障(dependency failure)
你的系统所依赖的软件包或代码库出了问题,导致你的系统崩溃。当依赖由第三方维护时,这种故障模式很常见;如果维护该依赖的第三方已不存在,则尤其常见。²
部署故障(deployment failure)
由部署错误引起的故障,例如你意外部署了模型旧版本的二进制文件而不是当前版本,或者你的系统没有读取或写入某些文件的正确权限。
² 这也是许多公司对使用初创公司的产品犹豫不决、许多公司更愿意使用开源软件的原因之一。当你使用的产品不再由其创建者维护时,如果该产品是开源的,至少你还能访问代码库并自己维护它。
硬件故障(hardware failures)
用于部署模型的硬件(如 CPU 或 GPU)没有按预期方式运行。例如,你使用的 CPU 可能过热并损坏。³
停机或崩溃(downtime or crashing)
如果你系统的某个组件运行在某处的服务器上(如 AWS 或托管服务),而该服务器宕机,你的系统也会宕机。
仅仅因为某些故障并非 ML 特有,并不意味着它们对 ML 工程师来说不重要。2020 年,谷歌的两位 ML 工程师 Daniel Papasian 和 Todd Underwood 研究了谷歌一个大型 ML 管道(pipeline)出问题的 96 个案例。他们回顾了过去 15 年多的数据以确定原因,发现这 96 个故障中有 60 个是由与 ML 无直接关系的原因造成的。⁴ 大多数问题与分布式系统有关,例如工作流调度器或编排器出错;或与数据管道有关,例如来自多个来源的数据被错误地连接,或使用了错误的数据结构。
解决软件系统故障需要的不是 ML 技能,而是传统的软件工程技能,解决它们超出了本书的范围。由于传统软件工程技能在部署 ML 系统中的重要性,ML 工程主要是工程,而不是 ML。⁵ 对于有兴趣从软件工程角度学习如何让 ML 系统可靠的读者,我强烈推荐 O’Reilly 出版的《可靠机器学习》(Reliable Machine Learning)一书,Todd Underwood 是作者之一。
软件系统故障如此普遍的一个原因是,由于行业对 ML 的采用仍处于萌芽阶段,围绕 ML 生产的工具还很有限,最佳实践也尚未完善或标准化。然而,随着 ML 生产的工具和最佳实践日趋成熟,我们有理由相信软件系统故障的比例将会下降,而 ML 特有故障的比例将会上升。
³ 宇宙射线可能导致你的硬件损坏(维基百科,“软错误”(Soft error)词条,https://oreil.ly/4cvNg)。
⁴ Daniel Papasian 和 Todd Underwood,《ML 是如何崩溃的:一个大型 ML 管道十年的宕机》(How ML Breaks: A Decade of Outages for One Large ML Pipeline),谷歌,2020 年 7 月 17 日,视频,19:06,https://oreil.ly/WGabN。非 ML 故障也可能间接由 ML 引起。例如,服务器可能因为非 ML 原因崩溃,但由于 ML 系统往往需要更多算力,这可能使该服务器崩溃得更频繁。
⁵ 我职业生涯的巅峰:Elon Musk 同意了我的观点。
ML 特有故障
ML 特有故障是 ML 系统特有的故障。例子包括数据收集和处理问题、糟糕的超参数、训练管道中的更改没有在推理管道中正确复现(反之亦然)、导致模型性能随时间恶化的数据分布偏移、边界情况(edge cases)以及退化反馈回路。
在本章中,我们将重点讨论如何应对 ML 特有故障。尽管它们只占故障的一小部分,但它们可能比非 ML 故障更危险,因为它们难以检测和修复,而且可能让 ML 系统完全无法使用。我们已经在第 4 章详细介绍了数据问题,在第 6 章介绍了超参数调优,在第 7 章介绍了训练和推理使用两条独立管道的危险。在本章中,我们将讨论模型部署后出现的三个新但非常常见的问题:生产数据与训练数据不同、边界情况以及退化反馈回路。
生产数据与训练数据不同
当我们说 ML 模型从训练数据中学习时,意思是模型学习训练数据的底层分布,目标是利用这个学到的分布对未见过的数据——训练期间没见过的数据——做出准确的预测。我们将在第 237 页的"数据分布偏移"一节中讨论这在数学上意味着什么。当模型能够对未见数据做出准确预测时,我们说这个模型"泛化(generalize)到了未见数据"。⁶ 我们在开发期间用来评估模型的测试数据本应代表未见数据,而模型在测试数据上的性能本应让我们了解模型泛化得如何。
我在 ML 课程中学到的第一件事就是:训练数据和未见数据来自相似的分布是至关重要的。这里的假设是,未见数据来自一个与训练数据分布相同的平稳分布(stationary distribution)。如果未见数据来自不同的分布,模型可能无法很好地泛化。⁷
⁶ 当年线下学术会议还存在的时候,我经常听到研究人员争论谁的模型泛化得更好。“我的模型比你的模型泛化得更好"是最极致的炫耀。
⁷ Masashi Sugiyama 和 Motoaki Kawanabe,《非平稳环境中的机器学习:协变量偏移自适应导论》(Machine Learning in Non-stationary Environments: Introduction to Covariate Shift Adaptation)(剑桥,马萨诸塞州:MIT Press,2012 年)。
这个假设在大多数情况下是错误的,原因有二。第一,现实世界数据的底层分布不太可能与训练数据的底层分布相同。事实证明,策划一个能准确代表模型在生产中会遇到的数据的训练数据集非常困难。⁸ 现实世界的数据是多方面的,在许多情况下几乎是无限的,而训练数据是有限的,受限于数据集创建和处理过程中可用的时间、算力和人力资源。如第 4 章所讨论的,存在许多不同的选择和采样偏差(selection and sampling biases),它们可能使现实世界的数据偏离训练数据。这种偏离可能小到现实世界的数据使用不同类型的 emoji 编码。这种类型的偏离导致一种常见的故障模式,即训练-服务偏差(train-serving skew):一个在开发时表现很好、部署后却表现很差的模型。
第二,现实世界不是静止的(stationary)。事物在变化。数据分布在偏移。2019 年,当人们搜索"武汉"时,他们很可能想要获取旅游信息;但自 COVID-19 以来,当人们搜索"武汉"时,他们很可能想知道 COVID-19 的起源地。另一种常见的故障模式是:模型在刚部署时表现很好,但随着数据分布的变化,其性能随时间退化。只要模型还在生产中,这种故障模式就需要被持续监控和检测。
当我用 COVID-19 作为引起数据偏移的例子时,有些人会以为数据偏移只由异常事件引起,这暗示它们不常发生。其实数据偏移一直都在发生——突然地、渐进地或季节性地。它们可能因为某个特定事件而突然发生,例如现有竞争对手改变定价策略、你必须相应更新价格预测时;或者你把产品投放到一个新地区时;或者某位名人提到你的产品,导致新用户激增时;等等。它们可能因为社会规范、文化、语言、潮流、行业等随时间变化而渐进地发生。它们也可能因为季节性变化而发生,例如与春天相比,人们在寒冷多雪的冬天更可能叫网约车。
由于 ML 系统的复杂性以及部署它们时的不良实践,监控仪表盘上看起来像数据偏移的情况,有很大比例其实是由内部错误引起的,⁹ 例如数据管道中的 bug、错误录入的缺失值、训练和推理期间提取的特征不一致、使用错误数据子集的统计量来标准化特征、模型版本错误,或者应用界面中的 bug 迫使用户改变他们的行为。
⁸ John Mcquaid,《增长的极限:AI 对数据的贪婪胃口能被驯服吗?》(Limits to Growth: Can AI’s Voracious Appetite for Data Be Tamed?),Undark,2021 年 10 月 18 日,https://oreil.ly/LSjVD。
⁹ 一家监控服务公司的首席技术官(CTO)告诉我,据他估计,他的服务捕获的漂移中有 80% 是由人为错误引起的。
由于这是一种影响几乎所有 ML 模型的错误模式,我们将在第 237 页的"数据分布偏移"一节中详细讨论。
边界情况
想象有一辆自动驾驶汽车,99.99% 的时间都能安全载你出行,但另外 0.01% 的时间,它可能发生灾难性事故,让你终身受伤甚至死亡。¹⁰ 你会用这辆车吗?
如果你想说不,你并不孤单。一个在大多数情况下表现良好、但在少数情况下失败的 ML 模型,如果这些失败会造成灾难性后果,它可能就无法使用。因此,主要的自动驾驶汽车公司都专注于让它们的系统在边界情况(edge cases)下正常工作。¹¹
边界情况是那些极端到让模型犯灾难性错误的数据样本。尽管边界情况通常指来自同一分布的数据样本,但如果模型表现不佳的数据样本数量突然增加,这可能表明底层数据分布已经发生了偏移。
自动驾驶汽车经常被用来说明边界情况如何阻碍 ML 系统被部署。但这对任何安全攸关的应用也是如此,例如医疗诊断、交通控制、电子证据开示(e-discovery)¹² 等。对非安全攸关的应用也可能如此。想象一个客户服务聊天机器人,它对大多数请求给出合理的回复,但有时会吐出令人发指的种族主义或性别歧视内容。这个聊天机器人对任何想使用它的公司来说都是品牌风险,因此它无法被使用。
¹⁰ 这意味着自动驾驶汽车比普通人类司机稍微安全一点。截至 2019 年,每 10 万名持照司机中与交通相关的死亡比例为 15.8,即 0.0158%(《1990 年至 2019 年美国每 10 万名持照司机的事故死亡率》(Fatality Rate per 100,000 Licensed Drivers in the U.S. from 1990 to 2019),Statista,2021 年,https://oreil.ly/w3wYh)。
¹¹ Rodney Brooks,《自动驾驶汽车的边界情况》(Edge Cases for Self Driving Cars),Robots, AI, and Other Stuff,2017 年 6 月 17 日,https://oreil.ly/Nyp4F;Lance Eliot,《那些无穷无尽的边界或角落情况是否是 AI 自动驾驶汽车的长尾厄运》(Whether Those Endless Edge or Corner Cases Are the Long-Tail Doom for AI Self-Driving Cars),福布斯(Forbes),2021 年 7 月 13 日,https://oreil.ly/L2Sbp;Kevin McAllister,《自动驾驶汽车将由模拟和位置数据塑造》(Self-Driving Cars Will Be Shaped by Simulated, Location Data),Protocol,2021 年 3 月 25 日,https://oreil.ly/tu8hs。
¹² 电子证据开示(e-discovery),即电子化证据开示(electronic discovery),指法律程序中的证据开示,例如诉讼、政府调查或《信息自由法》(Freedom of Information Act)请求,其中所寻求的信息是电子格式的。
边界情况与离群值
你可能想知道离群值(outlier)和边界情况之间的区别。什么构成边界情况的定义因学科而异。在 ML 中,由于它最近才被应用于生产,边界情况仍在被发现中,这使得它们的定义存在争议。
在本书中,离群值指的是数据:一个与其他样本显著不同的样本。边界情况指的是性能:一个模型表现比其他样本显著差的样本。离群值可能导致模型表现异常糟糕,从而使其成为边界情况。然而,并非所有离群值都是边界情况。例如,一个人在高速公路上乱穿马路是一个离群值,但如果你的自动驾驶汽车能准确检测到那个人并适当地决定运动响应,那它就不是边界情况。
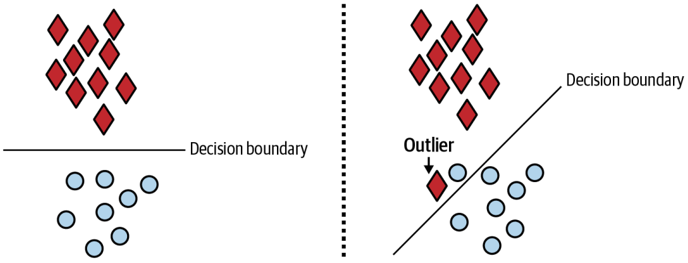
在模型开发期间,离群值会对模型性能产生负面影响,如图 8-1 所示。在许多情况下,移除离群值可能是有益的,因为它有助于模型学习更好的决策边界,并更好地泛化到未见数据。然而,在推理期间,你通常没有选择去移除或忽略与其他查询显著不同的查询。你可以选择对它进行变换——例如,当你在 Google 搜索中输入"mechin learnin"时,Google 可能会问你是指"machine learning”。但最有可能的是,你会希望开发一个即使面对意外输入也能表现良好的模型。
图 8-1. 左图显示没有离群值时的决策边界。右图显示有一个离群值时的决策边界,它与第一种情况下的决策边界差别很大,而且可能更不准确。
退化反馈回路
在第 91 页的"自然标签"一节中,我们把反馈回路(feedback loop)讨论为从预测展示到提供关于该预测的反馈所经过的时间。反馈可以用来提取自然标签(natural labels)以评估模型的性能,并训练模型的下一轮迭代。
当预测本身影响反馈,而反馈又影响模型的下一轮迭代时,就可能发生退化反馈回路(degenerate feedback loop)。更正式地说,当一个系统的输出被用来生成该系统未来的输入,而这些输入又影响系统未来的输出时,就产生了退化反馈回路。在 ML 中,系统的预测可以影响用户与系统的交互方式,而由于用户与系统的交互有时被用作同一系统的训练数据,退化反馈回路就可能发生并造成意想不到的后果。退化反馈回路在具有用户自然标签的任务中尤其常见,例如推荐系统和广告点击率预测。
为了让它具体化,想象你构建了一个向用户推荐他们可能喜欢的歌曲的系统。系统排名高的歌曲会首先展示给用户。因为它们首先被展示,用户点击它们更多,这使系统更加确信这些推荐是好的。一开始,两首歌 A 和 B 的排名可能只略有不同,但因为 A 最初排名稍高,它在推荐列表中显示得更高,使用户更多点击 A,这使系统把 A 排得更高。过了一段时间,A 的排名变得远高于 B。¹³ 退化反馈回路是热门电影、书籍或歌曲越来越受欢迎的原因之一,这也使新作品很难进入热门榜单。这类场景在生产中极其常见,并且被大量研究。它有许多不同的名字,包括"曝光偏差"(exposure bias)、“流行度偏差”(popularity bias)、“过滤气泡”(filter bubbles),有时也叫"回声室"(echo chambers)。
这里有另一个例子来说明退化反馈回路的危险。想象构建一个简历筛选模型来预测具有某份简历的人是否胜任该工作。模型发现特征 X 能准确预测某人是否胜任,因此它推荐具有特征 X 的简历。你可以把 X 替换为"毕业于斯坦福"、“曾在谷歌工作"或"认同为男性"等特征。招聘人员只面试模型推荐的简历,这意味着他们只面试具有特征 X 的候选人,这意味着公司只雇佣具有特征 X 的候选人。这反过来使模型更加重视特征 X。¹⁴ 对模型如何做出预测有可见性——例如如第 5 章所讨论的,测量每个特征对模型的重要性——可以帮助在这种情况下检测对特征 X 的偏见。
¹³ Ray Jiang、Silvia Chiappa、Tor Lattimore、András György 和 Pushmeet Kohli,《推荐系统中的退化反馈回路》(Degenerate Feedback Loops in Recommender Systems),arXiv,2019 年 2 月 27 日,https://oreil.ly/b9G7o。
¹⁴ 这与"幸存者偏差”(survivorship bias)有关。
如果放任不管,退化反馈回路最坏会让你的模型表现次优。在最坏的情况下,它们会延续并放大数据中嵌入的偏见,例如歧视没有特征 X 的候选人。
检测退化反馈回路。 如果退化反馈回路这么糟糕,我们怎么知道系统中的反馈回路是否是退化的呢?当系统离线时,退化反馈回路很难检测。退化回路源于用户反馈,而系统在在线(即部署给用户)之前不会有用户。
对于推荐系统任务,即使在系统离线时,也可以通过测量系统输出的流行度多样性(popularity diversity)来检测退化反馈回路。一个物品的流行度可以根据它在过去被交互过多少次(例如被看过、点赞过、购买过等)来衡量。所有物品的流行度很可能遵循长尾分布(long-tail distribution):少数物品被大量交互,而大多数物品几乎从不被交互。Brynjolfsson 等人(2011 年)、Fleder 和 Hosanagar(2009 年)以及 Abdollahpouri 等人(2019 年)提出的各种指标,如聚合多样性(aggregate diversity)和长尾物品的平均覆盖率(average coverage),可以帮助你衡量推荐系统输出的多样性。¹⁵ 得分低意味着你的系统输出是同质的,这可能是由流行度偏差引起的。
2021 年,Chia 等人更进一步,提出了针对流行度的命中率(hit rate)测量。他们首先根据物品的流行度将物品分桶——例如,桶 1 由被交互少于 100 次的物品组成,桶 2 由被交互超过 100 次但少于 1,000 次的物品组成,等等。然后他们测量推荐系统对每个桶的预测准确率。如果一个推荐系统在推荐流行物品方面比推荐不太流行的物品好得多,它很可能患有流行度偏差。¹⁶ 一旦你的系统投入生产,并且你注意到它的预测随时间变得越来越同质,它很可能患有退化反馈回路。
¹⁵ Erik Brynjolfsson、Yu (Jeffrey) Hu 和 Duncan Simester,《再见帕累托法则,你好长尾:搜索成本对产品销售集中度的影响》(Goodbye Pareto Principle, Hello Long Tail: The Effect of Search Costs on the Concentration of Product Sales),Management Science 第 57 卷第 8 期(2011 年):1373-86,https://oreil.ly/tGhHi;Daniel Fleder 和 Kartik Hosanagar,《大片文化的下一次崛起或衰落:推荐系统对销售多样性的影响》(Blockbuster Culture’s Next Rise or Fall: The Impact of Recommender Systems on Sales Diversity),Management Science 第 55 卷第 5 期(2009 年),https://oreil.ly/Zwkh8;Himan Abdollahpouri、Robin Burke 和 Bamshad Mobasher,《通过个性化重排序管理推荐系统中的流行度偏差》(Managing Popularity Bias in Recommender Systems with Personalized Re-ranking),arXiv,2019 年 1 月 22 日,https://oreil.ly/jgYLr。
¹⁶ Patrick John Chia、Jacopo Tagliabue、Federico Bianchi、Chloe He 和 Brian Ko,《超越 NDCG:使用 RecList 对推荐系统进行行为测试》(Beyond NDCG: Behavioral Testing of Recommender Systems with RecList),arXiv,2021 年 11 月 18 日,https://oreil.ly/7GfHk。
纠正退化反馈回路。 由于退化反馈回路是一个常见问题,有很多关于如何纠正它们的方法被提出。在本章中,我们将讨论两种方法。第一种是使用随机化(randomization),第二种是使用位置特征(positional features)。
我们已经讨论过退化反馈回路会使系统输出随时间变得更同质。在预测中引入随机化可以减少它们的同质性。在推荐系统的情况下,我们不只向用户展示系统为他们排名高的物品,而是向用户展示随机物品,并用他们的反馈来确定这些物品的真实质量。这就是 TikTok 采用的方法。每个新视频都被随机分配一个初始流量池(可以多达数百次曝光)。这个流量池被用来评估每个视频的无偏质量,以决定它应该被移入更大的流量池还是被标记为无关。¹⁷
随机化已被证明可以提高多样性,但代价是用户体验。¹⁸ 向用户展示完全随机的物品可能让用户对我们的产品失去兴趣。智能的探索(exploration)策略——例如第 289 页"作为探索策略的上下文老虎机"一节中讨论的那些——可以在可接受的预测准确率损失下提高物品多样性。Schnabel 等人使用少量随机化和因果推断技术来估计每首歌的无偏价值。¹⁹ 他们能够证明该算法可以纠正推荐系统,使推荐对创作者公平。
我们还讨论过,退化反馈回路是由用户对预测的反馈引起的,而用户对预测的反馈会因其展示位置而产生偏差。考虑前面的推荐系统示例,每次你向用户推荐五首歌。你意识到排名第一的推荐歌曲比另外四首歌更有可能被点击。你不确定是你的模型在挑选榜首歌曲方面特别出色,还是用户只要歌曲被推荐在首位就会点击。
¹⁷ Catherine Wang,《为什么 TikTok 让用户如此着迷?让你上瘾的 AI 算法》(Why TikTok Made Its User So Obsessive? The AI Algorithm That Got You Hooked),Towards Data Science,2020 年 6 月 7 日,https://oreil.ly/J7nJ9。
¹⁸ Gediminas Adomavicius 和 YoungOk Kwon,《使用基于排名的方法提高聚合推荐多样性》(Improving Aggregate Recommendation Diversity Using Ranking-Based Techniques),IEEE Transactions on Knowledge and Data Engineering 第 24 卷第 5 期(2012 年 5 月):896-911,https://oreil.ly/0JjUV。
¹⁹ Tobias Schnabel、Adith Swaminathan、Ashudeep Singh、Navin Chandak 和 Thorsten Joachims,《推荐即治疗:对学习和评估去偏》(Recommendations as Treatments: Debiasing Learning and Evaluation),arXiv,2016 年 2 月 17 日,https://oreil.ly/oDPSK。
如果预测的展示位置以任何方式影响其反馈,你可能想用位置特征(positional features)来编码位置信息。位置特征可以是数值型的(例如位置是 1、2、3……),也可以是布尔型的(例如预测是否显示在第一个位置)。注意,“位置特征"不同于第 5 章提到的"位置嵌入”(positional embeddings)。
这里有一个简单的例子来展示如何使用位置特征。在训练期间,你把"歌曲是否被首位推荐"作为一个特征添加到训练数据中,如表 8-1 所示。这个特征让你的模型学会"成为顶级推荐"在多大程度上影响歌曲被点击的可能性。
表 8-1. 将位置特征添加到训练数据中以缓解退化反馈回路
| ID | 歌曲 | 流派 | 年份 | 艺术家 | 用户 | 首位推荐 | 点击 |
|---|---|---|---|---|---|---|---|
| 1 | Shallow | Pop | 2020 | Lady Gaga | listenr32 | False | No |
| 2 | Good Vibe | Funk | 2019 | Funk Overlord | listenr32 | False | No |
| 3 | Beat It | Rock | 1989 | Michael Jackson | fancypants | False | No |
| 4 | In Bloom | Rock | 1991 | Nirvana | fancypants | True | Yes |
| 5 | Shallow | Pop | 2020 | Lady Gaga | listenr32 | True | Yes |
在推理期间,你想预测用户是否会点击一首歌,而不论这首歌被推荐在什么位置,所以你可能想把"首位推荐"特征设为 False。然后你查看模型对每个用户的各种歌曲的预测,并可以选择每首歌的展示顺序。
这是一个简单的例子,因为仅这样做可能不足以对抗退化反馈回路。更复杂的做法是使用两个不同的模型。第一个模型预测用户看到并考虑推荐的概率,同时考虑该推荐将被展示的位置。第二个模型然后预测在用户看到并考虑该物品后点击它的概率。第二个模型完全不涉及位置。
数据分布偏移
在上一节中,我们讨论了 ML 系统故障的常见原因。在本节中,我们将聚焦一个特别棘手的原因:数据分布偏移(data distribution shifts),简称数据偏移(data shifts)。数据分布偏移指的是监督学习中的一种现象:模型处理的数据随时间变化,导致模型的预测随时间推移变得不那么准确。模型训练所用数据的分布称为源分布(source distribution)。模型运行推理所用数据的分布称为目标分布(target distribution)。
尽管关于数据分布偏移的讨论只是近年随着 ML 在行业中的普及才变得常见,但对从数据中学习的系统中的数据分布偏移的研究早在 1986 年就开始了。²⁰ 还有一本关于数据集分布偏移的书:Quiñonero-Candela 等人编写的《机器学习中的数据集偏移》(Dataset Shift in Machine Learning),由 MIT Press 于 2008 年出版。
数据分布偏移的类型
虽然数据分布偏移经常与概念漂移(concept drift)和协变量偏移(covariate shift)互换使用,偶尔也与标签偏移(label shift)互换使用,但它们是数据偏移的三个不同子类型。注意,这个关于不同类型数据偏移的讨论数学味很重,而且主要从研究角度有用:要开发有效的算法来检测和应对数据偏移,需要理解这些偏移的原因。在生产中,遇到分布偏移时,数据科学家通常不会停下来思考它是什么类型的偏移。他们主要关心能做什么来处理这种偏移。如果你觉得这个讨论太密集,可以随意跳到第 241 页的"一般性数据分布偏移"一节。
要理解概念漂移、协变量偏移和标签偏移的含义,我们首先需要定义几个数学记号。让我们把模型的输入称为 \(X\),输出称为 \(Y\)。我们知道,在监督学习中,训练数据可以被看作来自联合分布 \(P(X, Y)\) 的一组样本,然后 ML 通常对 \(P(Y|X)\) 建模。这个联合分布 \(P(X, Y)\) 可以用两种方式分解:
\[ P(X, Y) = P(Y | X) P(X) \]\[ P(X, Y) = P(X | Y) P(Y) \]²⁰ Jeffrey C. Schlimmer 和 Richard H. Granger Jr.,《从噪声数据中增量学习》(Incremental Learning from Noisy Data),Machine Learning 1(1986 年):317-54,https://oreil.ly/FxFQi。
\(P(Y|X)\) 表示给定输入时输出的条件概率——例如,给定邮件内容时邮件是垃圾邮件的概率。\(P(X)\) 表示输入的概率密度。\(P(Y)\) 表示输出的概率密度。标签偏移、协变量偏移和概念漂移的定义如下:
协变量偏移(covariate shift)
当 \(P(X)\) 改变但 \(P(Y|X)\) 保持不变时。这指的是联合分布的第一种分解。
标签偏移(label shift)
当 \(P(Y)\) 改变但 \(P(X|Y)\) 保持不变时。这指的是联合分布的第二种分解。
概念漂移(concept drift)
当 \(P(Y|X)\) 改变但 \(P(X)\) 保持不变时。这指的是联合分布的第一种分解。²¹
如果你觉得这令人困惑,别慌。我们将在下一节中用例子来说明它们的区别。
协变量偏移
协变量偏移是研究最广泛的数据分布偏移形式之一。²² 在统计学中,协变量(covariate)是可能影响给定统计试验结果但不是直接研究对象的自变量。考虑你正在运行一个实验来确定位置如何影响房价。房价变量是你直接关心的,但你知道建筑面积影响价格,所以建筑面积是一个协变量。在监督 ML 中,标签是直接关心的变量,输入特征是协变量。
从数学上讲,协变量偏移是当 \(P(X)\) 改变但 \(P(Y|X)\) 保持不变时,这意味着输入的分布改变了,但给定输入时输出的条件概率保持不变。
为了让它具体化,考虑检测乳腺癌的任务。你知道 40 岁以上女性患乳腺癌的风险更高,²³ 所以你的输入中有一个"年龄"变量。你的训练数据中 40 岁以上的女性可能比推理数据中多,所以训练和推理数据的输入分布不同。然而,对于一个给定年龄的样本(例如 40 岁以上),该样本患乳腺癌的概率是恒定的。所以 \(P(Y|X)\)——给定年龄超过 40 岁时患乳腺癌的概率——是相同的。
²¹ 你可能会想,在第二种分解中,如果 \(P(X|Y)\) 改变而 \(P(Y)\) 保持不变会怎样。我从没遇到过针对这种设置的研究。我问过几位专门研究数据偏移的研究人员,他们也告诉我这种设置太难研究了。
²² Wouter M. Kouw 和 Marco Loog,《域自适应和迁移学习导论》(An Introduction to Domain Adaptation and Transfer Learning),arXiv,2018 年 12 月 31 日,https://oreil.ly/VKSVP。
²³ 《美国女性的乳腺癌风险》(Breast Cancer Risk in American Women),美国国家癌症研究所(National Cancer Institute),https://oreil.ly/BFP3U。
在模型开发期间,协变量偏移可能由于数据选择过程中的偏差而发生,这可能是由于难以收集某些类别的样本。例如,假设为了研究乳腺癌,你从一家女性去做乳腺癌检测的诊所获取数据。因为医生鼓励 40 岁以上的人去检查,你的数据以 40 岁以上的女性为主。因此,协变量偏移与样本选择偏差问题密切相关。²⁴
协变量偏移也可能因为训练数据被人为改动以让模型更容易学习而发生。如第 4 章所讨论的,ML 模型很难从不平衡的数据集中学习,所以你可能想收集更多稀有类别的样本,或在稀有类别上对数据过采样,让模型更容易学习稀有类别。
协变量偏移也可能由模型的学习过程引起,尤其是通过主动学习(active learning)。在第 4 章中,我们把主动学习定义为:不是随机选择样本来训练模型,而是根据某些启发式规则使用对该模型最有帮助的样本。这意味着训练输入分布被学习过程改变了,使其不同于现实世界的输入分布,协变量偏移是副产品。²⁵
在生产中,协变量偏移通常因为环境或应用使用方式的重大变化而发生。想象你有一个模型来预测免费用户转化为付费用户的可能性。用户的收入水平是一个特征。你们公司的市场部门最近发起了一项活动,吸引的人口统计数据比你们当前的人口统计更富裕。进入模型的输入分布改变了,但给定收入水平的用户会转化的概率保持不变。
如果你事先知道现实世界的输入分布将与你的训练输入分布有何不同,你可以利用重要性加权(importance weighting)等技术来训练模型,使其适用于现实世界的数据。重要性加权包括两个步骤:估计现实世界输入分布与训练输入分布之间的密度比,然后根据这个比率对训练数据加权,并在加权数据上训练 ML 模型。²⁶
²⁴ Arthur Gretton、Alex Smola、Jiayuan Huang、Marcel Schmittfull、Karsten Borgwardt 和 Bernard Schölkopf,《通过核均值匹配的协变量偏移》(Covariate Shift by Kernel Mean Matching),Journal of Machine Learning Research(2009 年),https://oreil.ly/s49MI。
²⁵ Sugiyama 和 Kawanabe,《非平稳环境中的机器学习》。
²⁶ Tongtong Fang、Nan Lu、Gang Niu 和 Masashi Sugiyama,《重新思考分布偏移下深度学习的重要性加权》(Rethinking Importance Weighting for Deep Learning under Distribution Shift),NeurIPS Proceedings 2020,https://oreil.ly/GzJ1r;Gretton 等人,《通过核均值匹配的协变量偏移》。
然而,因为我们事先不知道分布会如何变化,所以很难抢先训练模型使其对新的、未知的分布具有鲁棒性。有一些研究试图帮助模型学习跨数据分布不变的潜变量表示,²⁷ 但据我所知它们尚未在行业中被采用。
标签偏移
标签偏移(label shift),也称为先验偏移(prior shift)、先验概率偏移(prior probability shift)或目标偏移(target shift),是指 \(P(Y)\) 改变但 \(P(X|Y)\) 保持不变的情况。你可以把它想成:输出分布改变了,但对于给定的输出,输入分布保持不变。
记住,协变量偏移是输入分布改变。当输入分布改变时,输出分布也改变,导致协变量偏移和标签偏移同时发生。考虑前面关于协变量偏移的乳腺癌例子。因为训练数据中 40 岁以上的女性比推理数据多,训练期间 POSITIVE 标签的百分比更高。然而,如果你从训练数据中随机选择一位患乳腺癌的人 A,从测试数据中随机选择一位患乳腺癌的人 B,A 和 B 超过 40 岁的概率相同。这意味着 \(P(X|Y)\)——即给定患乳腺癌时年龄超过 40 岁的概率——是相同的。所以这也是标签偏移的一个案例。
然而,并非所有协变量偏移都会导致标签偏移。这是一个微妙的地方,所以我们再考虑另一个例子。想象现在有一种预防性药物,每位女性都服用,它能降低她们患乳腺癌的几率。概率 \(P(Y|X)\) 对所有年龄段的女性都降低了,所以这不再是协变量偏移的案例。然而,给定一个患乳腺癌的人,年龄分布保持不变,所以这仍然是标签偏移的案例。
因为标签偏移与协变量偏移密切相关,检测标签偏移并使模型适应标签偏移的方法与协变量偏移自适应方法类似。我们将在本章后面进一步讨论它们。
²⁷ Han Zhao、Remi Tachet Des Combes、Kun Zhang 和 Geoffrey Gordon,《论域自适应的不变表示学习》(On Learning Invariant Representations for Domain Adaptation),Proceedings of Machine Learning Research 97(2019 年):7523-32,https://oreil.ly/ZxYWD。
概念漂移
概念漂移(concept drift),也称为后验偏移(posterior shift),是指输入分布保持不变但给定输入时输出的条件分布改变的情况。你可以把它想成"相同输入,不同输出"。考虑你负责一个根据房屋特征预测房价的模型。在 COVID-19 之前,旧金山的一套三居室公寓可能要 2,000,000 美元。然而,在 COVID-19 开始时,许多人离开了旧金山,所以同一套公寓只要 1,500,000 美元。因此,即使房屋特征的分布保持不变,给定房屋特征时房屋价格的条件分布已经改变了。
在许多情况下,概念漂移是周期性或季节性的。例如,网约车价格在工作日与周末之间会波动,机票价格在假日季会上涨。公司可能有不同的模型来处理周期性和季节性漂移。例如,他们可能有一个模型预测工作日的网约车价格,另一个模型预测周末的。
一般性数据分布偏移
现实世界中还有其他类型的变化,虽然在研究中未被充分研究,但仍可能降低你的模型性能。
一种是特征变化(feature change),例如添加了新特征、移除了旧特征,或某个特征的所有可能值集合发生了变化。²⁸ 例如,你的模型曾经用"年"作为"年龄"特征,现在改用"月",所以该特征值的范围发生了漂移。有一次,我们的团队发现模型性能骤降,因为管道中的一个 bug 导致某个特征变成了 NaN(“not a number"的缩写)。
标签模式变化(label schema change)是指 \(Y\) 的可能值集合发生变化。在标签偏移中,\(P(Y)\) 改变但 \(P(X|Y)\) 保持不变。在标签模式变化中,\(P(Y)\) 和 \(P(X|Y)\) 都改变。模式(schema)描述数据的结构,所以任务的标签模式描述该任务标签的结构。例如,一个把类别映射到整数值的字典,如 {‘POSITIVE’: 0, ‘NEGATIVE’: 1},就是一个模式。
²⁸ 你可以把这想成 \(P(X)\) 和 \(P(Y|X)\) 都改变的情况。
对于回归任务,标签模式变化可能因为标签值的可能范围发生变化而发生。想象你在构建一个预测某人信用评分的模型。最初,你使用一个范围为 300 到 850 的信用评分系统,但你换成了一个范围为 250 到 900 的新系统。
对于分类任务,标签模式变化可能因为你有了新的类别。例如,假设你在构建一个诊断疾病的模型,现在有一种新疾病需要诊断。类别也可能变得过时或更细粒度。想象你负责一个分析提到你品牌的推文的情绪分析模型。最初,你的模型只预测三个类别:POSITIVE、NEGATIVE 和 NEUTRAL。然而,你们的市场部门意识到最具破坏性的推文是愤怒的推文,所以他们想把 NEGATIVE 类别拆成两个类别:SAD 和 ANGRY。你的任务不再是三个类别,而是四个类别。当类别数量改变时,你的模型结构可能改变,²⁹ 你可能需要重新标注数据并从头重训模型。标签模式变化在高基数任务(high-cardinality tasks)——类别数量很多的任务——中尤其常见,例如产品或文档分类。
没有规则说一次只能发生一种偏移。一个模型可能同时遭受多种类型的漂移,这使得处理它们困难得多。
检测数据分布偏移
数据分布偏移只有在导致模型性能退化时才是个问题。所以第一个想法可能是监控模型在生产中的准确率相关指标——准确率、F1 分数、召回率、AUC-ROC 等——看看它们是否改变了。“改变"在这里通常意味着"下降”,但如果我的模型准确率突然上升,或在我所知的原因之外显著波动,我会想调查一下。
准确率相关指标通过将模型的预测与真实标签(ground truth labels)进行比较来工作。³⁰ 在模型开发期间,你可以访问标签,但在生产中,你并不总能访问标签,即使你能访问,标签也会延迟,如第 91 页的"自然标签"一节所讨论的。在合理的时间窗口内获得标签将极大地帮助你了解模型性能。
²⁹ 如果你在分类任务中使用以 softmax 作为最后一层的神经网络,这个 softmax 层的维度是 \([number\_of\_hidden\_units \times number\_of\_classes]\)。当类别数量改变时,你的 softmax 层中的参数数量也会改变。
³⁰ 如果你使用无监督学习方法,你不需要真实标签,但今天绝大多数应用都是监督式的。
当真实标签不可用或延迟到无法使用时,我们可以转而监控其他感兴趣的分布。感兴趣的分布是输入分布 \(P(X)\)、标签分布 \(P(Y)\) 以及条件分布 \(P(X|Y)\) 和 \(P(Y|X)\)。
虽然监控输入分布不需要知道真实标签 \(Y\),但监控标签分布和两个条件分布都需要知道 \(Y\)。在研究中有一些努力试图在没有目标分布标签的情况下理解和检测标签偏移。其中之一是 Lipton 等人(2018 年)的黑盒偏移估计(Black Box Shift Estimation)。然而,在行业中,大多数漂移检测方法专注于检测输入分布的变化,尤其是特征的分布,我们将在本章详细讨论。
统计方法
在行业中,许多公司用来检测两个分布是否相同的简单方法是比较它们的统计量,如最小值、最大值、均值、中位数、方差、各种分位数(如 5%、25%、75% 或 95% 分位数)、偏度、峰度等。例如,你可以计算推理期间某个特征值的中位数和方差,并将它们与训练期间计算的指标进行比较。截至 2021 年 10 月,即使是 TensorFlow Extended 内置的数据验证工具也只使用汇总统计量来检测训练数据与服务数据之间的偏差,以及训练数据不同日期之间的偏移。这是一个好的开始,但这些指标远远不够。³¹ 均值、中位数和方差只对"均值/中位数/方差是有用摘要"的分布有用。如果这些指标显著不同,推理分布可能已经从训练分布偏移了。然而,如果这些指标相似,并不能保证没有偏移。
一个更复杂的解决方案是使用双样本假设检验(two-sample hypothesis test),简称双样本检验(two-sample test)。它是一种确定两个总体(两组数据)之间的差异是否具有统计显著性的检验。如果差异具有统计显著性,那么该差异是由抽样变异性(sampling variability)引起的随机波动的概率非常低,因此该差异是由这两个总体来自两个不同分布这一事实造成的。如果你把昨天的数据看作源总体,把今天的数据看作目标总体,并且它们在统计上显著不同,那么底层数据分布很可能在昨天和今天之间发生了偏移。
³¹ Hamel Husain 为 CS 329S:机器学习系统设计(斯坦福,2022 年)做了一场精彩的讲座,讲述为什么 TensorFlow Extended 的偏差检测如此糟糕。你可以在 YouTube 上找到这个视频。
一个注意事项是:仅仅因为差异具有统计显著性并不意味着它在实践上重要。然而,一个好的启发式规则是:如果你能从相对较小的样本中检测到差异,那么它可能是严重的差异。如果检测它需要大量样本,那么这个差异可能不值得担心。
一个基本的双样本检验是柯尔莫哥洛夫-斯米尔诺夫检验(Kolmogorov-Smirnov test),也称为 K-S 检验或 KS 检验。³² 它是一种非参数统计检验,意味着它不需要底层分布的任何参数就能工作。它对底层分布不做任何假设,这意味着它可以适用于任何分布。然而,KS 检验的一个主要缺点是它只能用于一维数据。如果你的模型预测和标签是一维的(标量数值),那么 KS 检验对于检测标签或预测偏移很有用。然而,它对高维数据不起作用,而特征通常是高维的。³³ KS 检验也可能很昂贵,并产生太多误报警报。³⁴
另一种检验是最小二乘密度差(Least-Squares Density Difference),一种基于最小二乘密度差估计方法的算法。³⁵ 还有 MMD,即最大均值差异(Maximum Mean Discrepancy)(Gretton 等人,2012 年),一种用于多元双样本检验的基于核的技术,以及它的变体学习核 MMD(Learned Kernel MMD)(Liu 等人,2020 年)。MMD 在研究界很流行,但截至撰写本书时,我不知道有任何公司将其用于行业。Alibi Detect 是一个很棒的开源包,实现了许多漂移检测算法,如图 8-2 所示。
因为双样本检验在低维数据上通常比在高维数据上表现更好,强烈建议你在对数据执行双样本检验之前先降低数据的维度。³⁶
³² I. M. Chakravarti、R. G. Laha 和 J. Roy,《应用统计方法手册》(Handbook of Methods of Applied Statistics),第 1 卷,《计算技术、描述性方法和统计推断》(Techniques of Computation, Descriptive Methods, and Statistical Inference)(纽约:Wiley,1967 年)。
³³ Eric Feigelson 和 G. Jogesh Babu,《当心柯尔莫哥洛夫-斯米尔诺夫检验!》(Beware the Kolmogorov-Smirnov Test!),宾夕法尼亚州立大学天体统计中心(Center for Astrostatistics),https://oreil.ly/7AHcT。
³⁴ Eric Breck、Marty Zinkevich、Neoklis Polyzotis、Steven Whang 和 Sudip Roy,《机器学习的数值验证》(Data Validation for Machine Learning),Proceedings of SysML,2019 年,https://oreil.ly/xoneh。
³⁵ Li Bu、Cesare Alippi 和 Dongbin Zhao,《一种基于密度差估计的无 pdf 变化检测检验》(A pdf-Free Change Detection Test Based on Density Difference Estimation),IEEE Transactions on Neural Networks and Learning Systems 第 29 卷第 2 期(2018 年 2 月):324-34,https://oreil.ly/RD8Uy。作者声称该方法适用于多维输入。
³⁶ Stephan Rabanser、Stephan Günnemann 和 Zachary C. Lipton,《大声失败:数据集偏移检测方法的实证研究》(Failing Loudly: An Empirical Study of Methods for Detecting Dataset Shift),arXiv,2018 年 10 月 29 日,https://oreil.ly/HxAwV。
图 8-2. Alibi Detect 实现的一些漂移检测算法。来源:该项目 GitHub 仓库的截图
| 检测器 | 表格 | 图像 | 时间序列 | 文本 | 类别特征 | 在线 | 特征级别 |
|---|---|---|---|---|---|---|---|
| Kolmogorov-Smirnov | √ | √ | √ | √ | √ | ||
| Cramér-von Mises | √ | √ | √ | √ | |||
| Fisher’s Exact Test | √ | √ | √ | √ | |||
| Maximum Mean Discrepancy (MMD) | √ | √ | √ | V | V | ||
| Learned Kernel MMD | √ | √ | √ | √ | |||
| Context-aware MMD | √ | √ | √ | √ | √ | ||
| Least-Squares Density Difference | √ | √ | √ | √ | √ | ||
| Chi-Squared | √ | √ | √ | ||||
| Mixed-type tabular data | √ | √ | √ | ||||
| Classifier | √ | √ | √ | √ | √ | ||
| Spot-the-diff | √ | √ | √ | √ | √ | √ | |
| Classifier Uncertainty | √ | √ | √ | √ | √ | ||
| Regressor Uncertainty | √ | √ | √ | √ | √ |
检测偏移的时间尺度窗口
并非所有类型的偏移都一样——有些比其他更难检测。例如,偏移以不同的速率发生,突然的变化比缓慢、渐进的变化更容易检测。³⁷ 偏移也可以跨两个维度发生:空间或时间。空间偏移(spatial shifts)是跨访问点发生的偏移,例如你的应用获得了一组新用户,或者你的应用现在在一种不同类型的设备上提供服务。时间偏移(temporal shifts)是随时间发生的偏移。为了检测时间偏移,一种常见的方法是把 ML 应用的输入数据当作时间序列数据。³⁸
³⁷ Manuel Baena-García、José del Campo-Ávila、Raúl Fidalgo、Albert Bifet、Ricard Gavaldà 和 Rafael Morales-Bueno,《早期漂移检测方法》(Early Drift Detection Method),2006 年,https://oreil.ly/Dnv0s。
³⁸ Nandini Ramanan、Rasool Tahmasbi、Marjorie Sayer、Deokwoo Jung、Shalini Hemachandran 和 Claudionor Nunes Coelho Jr.,《时间序列数据的实时漂移检测》(Real-time Drift Detection on Time-series Data),arXiv,2021 年 10 月 12 日,https://oreil.ly/xmdqW。
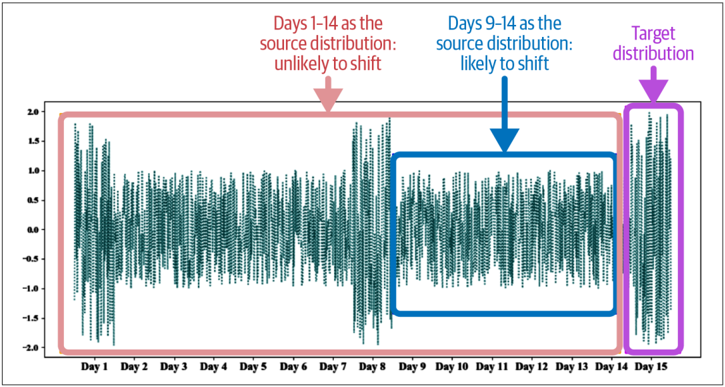
在处理时间偏移时,我们查看数据的时间尺度窗口(time scale window)会影响我们能检测到的偏移。如果你的数据有每周周期,那么小于一周的时间尺度检测不到这个周期。考虑图 8-3 中的数据。如果我们用第 9 天到第 14 天的数据作为源分布,那么第 15 天看起来像是一个偏移。然而,如果我们用第 1 天到第 14 天的数据作为源分布,那么第 15 天的所有数据点很可能由同一个分布生成。正如这个例子所示,当偏移与季节性变化混杂在一起时,检测时间偏移很困难。
图 8-3. 分布是否随时间发生漂移取决于所指定的时间尺度窗口
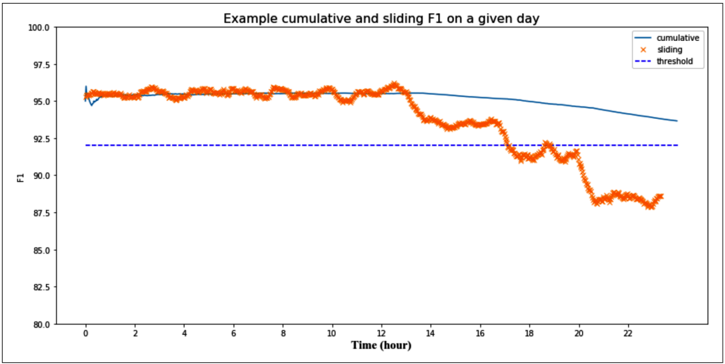
在计算随时间变化的滚动统计量时,区分累积统计量(cumulative statistics)和滑动统计量(sliding statistics)很重要。滑动统计量在单个时间尺度窗口内计算,例如一小时。累积统计量随着更多数据不断更新。这意味着在每个时间尺度窗口开始时,滑动准确率被重置,而累积准确率不被重置。因为累积统计量包含之前时间窗口的信息,它们可能掩盖特定时间窗口中发生的事情。图 8-4 显示了一个例子,说明累积准确率如何掩盖第 16 到 18 小时之间准确率的突然下降。
图 8-4. 累积准确率掩盖了第 16 到 18 小时之间准确率的突然下降。来源:改编自 MadeWithML 的一张图
在时间域中处理数据使事情变得复杂得多,需要时间序列分析技术(如时间序列分解)的知识,这超出了本书的范围。对于对时间序列分解感兴趣的读者,Lyft 工程团队有一个很棒的案例研究,介绍他们如何分解时间序列数据以应对市场的季节性。
截至今天,许多公司以训练数据的分布作为基准分布,并在一定的粒度级别(如每小时和每天)监控生产数据分布。³⁹ 你的时间尺度窗口越短,你就能越快检测到数据分布的变化。然而,时间尺度窗口太短可能导致偏移的误报,就像图 8-3 中的例子一样。
一些平台,尤其是处理实时数据分析(如监控)的平台,提供合并(merge)操作,允许将较短时间尺度窗口的统计量合并成较长时间尺度窗口的统计量。例如,你可以按小时计算你关心的数据统计量,然后将这些每小时统计量块合并成每日视图。
更先进的监控平台甚至尝试根因分析(root cause analysis,简称 RCA)功能,自动分析各种时间窗口大小的统计量,以精确定位数据发生变化的时间窗口。⁴⁰
³⁹ 我正在研究一个可以处理分钟级粒度的解决方案。
⁴⁰ 感谢 Goku Mohandas 在 MLOps Discord 服务器上分享这个技巧。
应对数据分布偏移
公司如何应对数据偏移取决于他们的 ML 基础设施有多成熟。在光谱的一端,有刚刚开始使用 ML、仍在努力让 ML 模型进入生产的公司,所以他们可能还没有到数据偏移对他们来说具有灾难性的地步。然而,在未来的某个时刻——也许三个月,也许六个月——他们可能会意识到他们最初部署的模型已经退化到弊大于利的程度。然后他们将需要让模型适应偏移后的分布,或用其他解决方案替换它们。
与此同时,许多公司假设数据偏移是不可避免的,所以他们定期重训模型——每月一次、每周一次或每天一次——无论偏移程度如何。如何确定重训模型的最佳频率是一个重要的决策,许多公司仍然凭直觉而不是实验数据来决定。⁴¹ 我们将在第 9 章进一步讨论重训频率。
要让模型适用于生产中的新分布,主要有三种方法。第一种是目前主导研究的方法:使用海量数据集训练模型。这里的希望是,如果训练数据集足够大,模型就能学到如此全面的分布,以至于模型在生产中遇到的任何数据点很可能都来自这个分布。
第二种方法在研究界不太流行:在不需要新标签的情况下让训练好的模型适应目标分布。Zhang 等人(2013 年)使用因果解释以及条件和边际分布的核嵌入来纠正模型在协变量偏移和标签偏移下的预测,而无需使用目标分布的标签。⁴² 类似地,Zhao 等人(2020 年)提出了域不变表示学习(domain-invariant representation learning):一种无监督的域自适应技术,可以学习对变化分布不变的表示。⁴³ 然而,这个研究领域被严重低估,尚未在行业中得到广泛采用。⁴⁴
⁴¹ 正如早期审稿人 Han-chung Lee 指出的,这也是因为较小的公司没有足够的模型数据。当你没有大量数据时,采用基于时间的方案比把方案过度拟合到不足的数据上要好。
⁴² Kun Zhang、Bernhard Schölkopf、Krikamol Muandet 和 Zhikun Wang,《目标和条件偏移下的域自适应》(Domain Adaptation under Target and Conditional Shift),Proceedings of the 30th International Conference on Machine Learning(2013 年),https://oreil.ly/C123l。
⁴³ Han Zhao、Remi Tachet Des Combes、Kun Zhang 和 Geoffrey Gordon,《论域自适应的不变表示学习》(On Learning Invariant Representations for Domain Adaptation),Proceedings of Machine Learning Research 97(2019 年):7523-32,https://oreil.ly/W78hH。
⁴⁴ Zachary C. Lipton、Yu-Xiang Wang 和 Alex Smola,《使用黑盒预测器检测和纠正标签偏移》(Detecting and Correcting for Label Shift with Black Box Predictors),arXiv,2018 年 2 月 12 日,https://oreil.ly/zKSlj。
第三种方法是今天行业通常采用的做法:使用来自目标分布的带标签数据重训模型。然而,重训模型并不是那么简单。重训可以意味着在旧数据和新数据上都从头重训模型,或者在新数据上继续训练现有模型。后一种方法也叫微调(fine-tuning)。
如果你想重训模型,有两个问题。第一,是从头训练模型(无状态重训,stateless retraining),还是从最后一个检查点继续训练(有状态训练,stateful training)。第二,使用什么数据:最近 24 小时、最近一周、最近 6 个月的数据,还是从数据开始漂移的那个点起的数据。你可能需要运行实验来确定哪种重训策略最适合你。⁴⁵
在本书中,我们用"重训”(retraining)来同时指代从头训练和微调。我们将在下一章进一步讨论重训策略。
熟悉数据偏移文献的读者可能经常看到数据偏移与域自适应(domain adaptation)和迁移学习(transfer learning)一起被提及。如果你把分布看作一个域,那么如何让模型适应新分布的问题就类似于如何让模型适应不同域的问题。
类似地,如果你把学习联合分布 \(P(X, Y)\) 看作一个任务,那么把一个在一个联合分布上训练的模型适应到另一个联合分布上,可以被表述为一种迁移学习。如第 4 章所讨论的,迁移学习指一系列方法,其中为一个任务开发的模型被重用为第二个任务模型的起点。区别在于,使用迁移学习时,你不会为第二个任务从头重训基础模型。然而,要让模型适应新分布,你可能需要从头重训模型。
应对数据分布偏移不必在偏移发生之后才开始。有可能设计你的系统使其对偏移更鲁棒。一个系统使用多个特征,不同的特征以不同的速率偏移。考虑你在构建一个预测用户是否会下载应用的模型。你可能想使用该应用在应用商店的排名作为一个特征,因为排名更高的应用往往被下载更多。然而,应用排名变化非常快。你可能想把每个应用的排名分桶为大致类别,例如前 10、11 到 100、101 到 1,000、1,001 到 10,000,依此类推。与此同时,应用的类别可能变化得不那么频繁,但它们预测用户是否会下载该应用的能力可能较弱。在为模型选择特征时,你可能要考虑特征的性能与稳定性之间的权衡:一个特征可能对准确率非常好,但退化很快,迫使你更频繁地训练模型。
⁴⁵ 一些监控供应商声称他们的解决方案不仅能检测你的模型何时应该重训,还能检测应该用什么数据重训。我无法验证这些说法的有效性。
你可能还想设计你的系统,使它更容易适应偏移。例如,旧金山等主要城市的房价可能比亚利桑那州乡村变化快得多,所以服务于亚利桑那州乡村的房价预测模型可能不需要像服务于旧金山的模型那样频繁更新。如果你用同一个模型服务两个市场,你将不得不使用两个市场的数据,以旧金山要求的频率更新模型。然而,如果你为每个市场使用单独的模型,你可以在必要时才更新每一个。
在我们进入下一节之前,我想重申,并非所有生产模型性能退化都需要 ML 解决方案。今天许多 ML 故障仍由人为错误引起。如果你的模型故障是由人为错误引起的,你首先需要找到这些错误来修复它们。检测数据偏移很难,但确定偏移的原因可能更难。
监控与可观测性
随着行业意识到 ML 系统可能出很多问题,许多公司开始投资于生产 ML 系统的监控(monitoring)和可观测性(observability)。
监控和可观测性有时被互换使用,但它们是不同的。监控指的是跟踪、测量和记录不同指标的行为,这些指标可以帮助我们确定何时出了问题。可观测性意味着把我们的系统设置为一种能让我们对系统有可见性的方式,以帮助调查出了什么问题。以这种方式设置系统的过程也叫"插桩"(instrumentation)。插桩的例子包括:给函数添加计时器、统计特征中的 NaN、跟踪输入如何通过系统被转换、记录异常事件(如异常长的输入)等。可观测性是监控的一部分。没有一定程度的可观测性,监控是不可能的。
监控完全是关于指标的。因为 ML 系统是软件系统,你需要监控的第一类指标是运行指标(operational metrics)。这些指标旨在传达系统的健康状况。它们通常分为三个层级:系统运行所在的网络、系统运行所在的机器以及系统运行的应用。这些指标的例子包括:延迟;吞吐量;你的模型在过去一分钟、一小时、一天内收到的预测请求数;返回 2xx 状态码的请求百分比;CPU/GPU 利用率;内存利用率;等等。无论你的 ML 模型有多好,如果系统宕机,你都不会从中受益。
让我们看一个例子。生产软件系统最重要的特征之一是可用性(availability)——系统多久能向用户提供合理性能。这个特征由正常运行时间(uptime)衡量,即系统正常运行的时间百分比。确定系统是否正常运行的条件在服务级别目标(service level objectives,简称 SLO)或服务级别协议(service level agreements,简称 SLA)中定义。例如,一个 SLA 可能规定:如果服务的中位延迟低于 200 毫秒且 99 分位延迟低于 2 秒,则认为服务正常运行。
服务提供商可能提供一个指定其正常运行时间保证(如 99.99% 的时间)的 SLA,如果这个保证没有达到,他们会把钱退给客户。例如,截至 2021 年 10 月,AWS EC2 服务提供至少 99.99%(四个九)的月度正常运行时间百分比,如果月度正常运行时间百分比低于这个值,他们会给你一笔用于未来 EC2 付款的服务积分。⁴⁶ 99.99% 的月度正常运行时间意味着服务每月只允许宕机 4 分多钟,而 99.999% 意味着每月只有 26 秒!
然而,对于 ML 系统,系统健康超越了系统正常运行时间。如果你的 ML 系统正常运行但它的预测是垃圾,你的用户不会高兴。你想要监控的另一类指标是告诉你 ML 模型健康状况的 ML 特有指标。
ML 特有指标
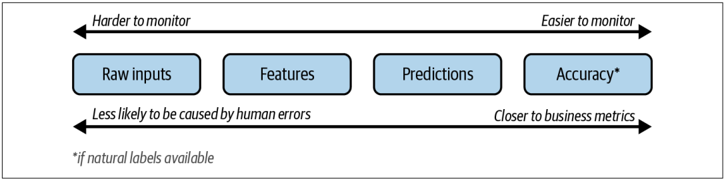
在 ML 特有指标中,通常有四个产物需要监控:模型的准确率相关指标、预测、特征和原始输入。这些是在 ML 系统管道的四个不同阶段生成的产物,如图 8-5 所示。一个产物在管道中越深入,它经历的变换就越多,这使得该产物的变化更可能是由其中一个变换的错误引起的。然而,一个产物经历的变换越多,它就变得越结构化,越接近你真正关心的指标,这使得它更容易监控。我们将在以下各节详细讨论这些产物中的每一个。
图 8-5. 一个产物经历的变换越多,其变化越可能是由其中一个变换的错误引起的
⁴⁶ 《Amazon 计算服务级别协议》(Amazon Compute Service Level Agreement),Amazon Web Services,最后更新于 2021 年 8 月 24 日,https://oreil.ly/5bjx9。
监控与准确率相关的指标
如果你的系统收到用户对其预测的任何类型的反馈——点击、隐藏、购买、点赞、点踩、收藏、书签、分享等——你绝对应该记录并跟踪它。一些反馈可以用来推断自然标签,然后可以用来计算模型的准确率相关指标。准确率相关指标是帮助你判断模型性能是否退化的最直接指标。
即使反馈不能直接用来推断自然标签,它也可以用来检测 ML 模型性能的变化。例如,当你在构建一个向用户推荐 YouTube 上接下来看什么视频的系统时,你不仅要跟踪用户是否点击了推荐的视频(点击率,click-through rate),还要跟踪用户在该视频上花费的时间以及他们是否完整看完了它(完成率,completion rate)。如果随着时间的推移,点击率保持不变但完成率下降,这可能意味着你的推荐系统在变差。⁴⁷
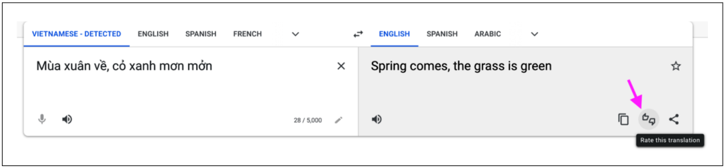
也可以设计你的系统以便收集用户反馈。例如,Google 翻译有让用户对译文点赞或点踩的选项,如图 8-6 所示。如果系统收到的点踩数量突然上升,可能有问题。这些点踩也可以用来指导标注过程,例如让人类专家为有点踩的样本生成新译文,以训练他们模型的下一轮迭代。
图 8-6. Google 翻译允许用户对译文点赞或点踩。这些投票将用于评估其翻译模型的质量,并指导标注过程。
监控预测
预测(prediction)是最常监控的产物。如果是回归任务,每个预测是一个连续值(例如房子的预测价格);如果是分类任务,每个预测是对应于预测类别的离散值。因为每个预测通常只是一个数字(低维),预测很容易可视化,它们的汇总统计量也很容易计算和解释。
⁴⁷ 小心使用完成率作为优化指标,因为它可能让你的推荐系统偏向短视频。
你可以监控预测是否有分布偏移。因为预测是低维的,计算双样本检验来检测预测分布是否偏移也更容易。预测分布偏移也是输入分布偏移的代理。假设从输入映射到输出的函数不变——模型的权重和偏置没有改变——那么预测分布的变化通常表明底层输入分布的变化。
你也可以监控预测是否有任何异常发生,例如连续预测了异常多的 False。预测和真实标签之间可能有很长的延迟,如第 91 页的"自然标签"一节所讨论的。准确率相关指标的变化可能几天或几周都不明显,而模型连续 10 分钟预测全部为 False 可以立即被检测到。
监控特征
行业中的 ML 监控解决方案专注于跟踪特征的变化,包括模型用作输入的特征,以及从原始输入到最终特征的中间变换。特征监控很有吸引力,因为与原始输入数据相比,特征结构良好,遵循预定义的模式。特征监控的第一步是特征验证(feature validation):确保你的特征遵循预期的模式。预期的模式通常从训练数据或常识生成。如果这些期望在生产中被违背,底层分布可能发生了偏移。例如,以下是你可以对给定特征检查的一些事项:
- 特征的最小值、最大值或中位数是否在可接受的范围内
- 特征的值是否满足正则表达式格式
- 特征的所有值是否属于预定义集合
- 特征的值是否总是大于另一个特征的值
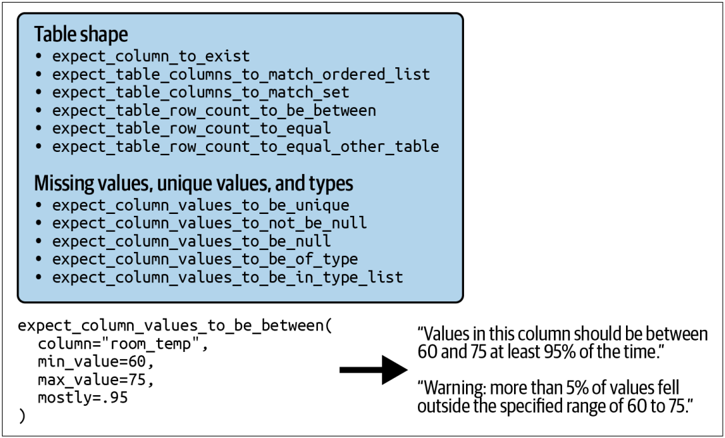
因为特征通常组织成表——每列代表一个特征,每行代表一个数据样本——特征验证也称为表测试(table testing)或表验证(table validation)。有些人称它们为数据单元测试。有许多开源库可以帮助你做基本的特征验证,最常用的两个是 Great Expectations 和 Deequ(AWS 出品)。图 8-7 显示了 Great Expectations 内置的部分特征验证函数以及使用示例。
图 8-7. Great Expectations 内置的部分特征验证函数以及使用示例。来源:改编自 Great Expectations GitHub 仓库中的内容
除了基本的特征验证,你还可以使用双样本检验来检测某个特征或一组特征的底层分布是否发生了偏移。由于一个特征或一组特征可能是高维的,你可能需要在对它们执行检验之前降低维度,这可能会使检验效果变差。
做特征监控时有四个主要关注点:
一家公司可能有数百个模型在生产中,每个模型使用数百个(如果不是数千个)特征。
即使只是每小时为所有这些特征计算汇总统计量这样简单的事情也可能很昂贵,不仅在所需算力方面,而且在所用内存方面。跟踪(即不断计算)太多指标也可能拖慢你的系统,增加用户经历的延迟以及你检测系统异常所需的时间。
虽然跟踪特征对调试很有用,但对检测模型性能退化不是很有用。
理论上,小的分布偏移可能导致灾难性故障,但在实践中,单个特征的微小变化可能完全不会损害模型性能。特征分布一直在偏移,其中大多数变化是良性的。⁴⁸ 如果你希望在某个特征似乎漂移时收到警报,你可能很快就会被警报淹没,并意识到这些警报大多是误报。这可能导致一种叫"警报疲劳"(alert fatigue)的现象:监控团队因为警报太频繁而停止关注它们。特征监控的问题变成了试图决定哪些特征偏移是关键、哪些不是的问题。
特征提取通常分多个步骤(如填充缺失值和标准化)完成,使用多个库(如 pandas、Spark),在多个服务(如 BigQuery 或 Snowflake)上进行。
你可能有一个关系数据库作为特征提取过程的输入,输出是一个 NumPy 数组。即使你检测到特征中的有害变化,也可能无法检测这个变化是由底层输入分布的变化引起的,还是由多个处理步骤之一的错误引起的。
你的特征遵循的模式会随时间变化。
如果你没有办法对模式进行版本控制并把每个特征映射到其预期模式,报告的警报原因可能是模式不匹配,而不是数据变化。
这些关注点并不是要否定特征监控的重要性;特征空间的变化是理解 ML 系统健康的有用信号来源。希望思考这些关注点能帮助你选择一个适合你的特征监控解决方案。
监控原始输入
如上一节所讨论的,特征的变化可能由处理步骤的问题引起,而不是由数据变化引起。如果我们监控处理之前的原始输入呢?原始输入数据可能不容易监控,因为它可能来自多个来源、格式各异、遵循多种结构。今天许多 ML 工作流的设置方式也使 ML 工程师无法直接访问原始输入数据,因为原始输入数据通常由数据平台团队管理,他们处理数据并将其移动到数据仓库等位置,ML 工程师只能从那个已经部分处理过的数据仓库中查询数据。因此,监控原始输入通常是数据平台团队的责任,而不是数据科学或 ML 团队的责任。因此,它超出了本书的范围。
⁴⁸ Rabanser、Günnemann 和 Lipton,《大声失败》。
到目前为止,我们讨论了要监控的不同类型的指标,从通常用于软件系统的运行指标到帮助你跟踪 ML 模型健康状况的 ML 特有指标。在下一节中,我们将讨论可以用来帮助指标监控的工具箱。
监控工具箱
为复杂系统测量、跟踪和解释指标不是一项简单的任务,工程师依赖一套工具来帮助他们做到这一点。行业通常把指标(metrics)、日志(logs)和追踪(traces)吹捧为监控的三大支柱。然而,我觉得它们之间的区别很模糊。它们似乎是从开发监控系统的人的角度产生的:追踪是日志的一种形式,指标可以从日志计算出来。在本节中,我想从监控系统用户的角度关注一套工具:日志、仪表盘(dashboards)和警报(alerts)。
日志
传统软件系统依赖日志(logs)来记录运行时产生的事件。事件是任何可能对系统开发人员感兴趣的东西,无论是在事件发生时,还是以后用于调试和分析。事件的例子有:容器启动时、它占用的内存量、函数被调用时、该函数运行完成时、该函数调用的其他函数、该函数的输入和输出等。另外,别忘了记录崩溃、堆栈跟踪、错误代码等。用 Etsy 的 Ian Malpass 的话说:“凡是动的东西,我们都要跟踪。“⁴⁹ 他们还跟踪尚未变化的东西,以防它们以后会动。
日志的数量会非常快地增长得非常大。例如,早在 2019 年,约会应用 Badoo 每天处理 200 亿个事件。⁵⁰ 当出问题时,你需要查询日志以找到导致问题的事件序列,这个过程就像大海捞针。
在软件部署的早期,一个应用可能是一个单一服务。当某件事发生时,你知道它发生在哪里。但今天,一个系统可能由许多不同的组件组成:容器、调度器、微服务、多语言持久化、网格路由、临时的自动扩缩实例、无服务器 Lambda 函数。一个请求从发出到收到响应可能经历 20-30 跳。困难的部分可能不在于检测什么时候发生了问题,而在于问题在哪里。⁵¹
⁴⁹ Ian Malpass,《测量一切》(Measure Anything, Measure Everything),Code as Craft,2011 年 2 月 15 日,https://oreil.ly/3KF1K。
⁵⁰ Andrew Morgan,《Badoo 的数据工程:每天处理 200 亿个事件》(Data Engineering in Badoo: Handling 20 Billion Events Per Day),InfoQ,2019 年 8 月 9 日,https://oreil.ly/qnnuV。
⁵¹ Charity Majors,《可观测性——三年回顾》(Observability-A 3-Year Retrospective),The New Stack,2019 年 8 月 6 日,https://oreil.ly/Logby。
当我们记录一个事件时,我们希望让以后尽可能容易地找到它。微服务架构中的这种做法称为分布式追踪(distributed tracing)。我们希望给每个进程一个唯一的 ID,这样当出问题时,错误消息(希望)包含这个 ID。这让我们可以搜索与之关联的日志消息。我们还希望记录每个事件所需的所有元数据:发生时间、发生在哪个服务、调用了哪个函数、与进程关联的用户(如果有)等。
因为日志变得如此庞大且难以管理,已经开发了许多工具来帮助公司管理和分析日志。日志管理市场在 2021 年估计价值 23 亿美元,预计到 2026 年将增长到 41 亿美元。⁵²
手动分析数十亿条日志事件是徒劳的,所以许多公司使用 ML 来分析日志。ML 在日志分析中的一个用例是异常检测:检测系统中的异常事件。更复杂的模型甚至可以根据优先级对每个事件进行分类,如正常、异常、例外、错误和致命。
ML 在日志分析中的另一个用例是:当某个服务失败时,知道相关服务受到影响的概率可能很有帮助。当系统遭受网络攻击时,这可能特别有用。
许多公司以批处理方式处理日志。在这种场景中,你收集大量日志,然后定期用 SQL 查询它们以寻找特定事件,或用批处理过程(如 Spark、Hadoop 或 Hive 集群)处理它们。这使得日志处理高效,因为你可以利用分布式和 MapReduce 过程来提高处理吞吐量。然而,因为你定期处理日志,你只能定期发现问题。
为了在日志一出现异常时就发现它,你希望在事件一被记录就处理它。这使得日志处理成为一个流处理问题。⁵³ 你可以使用 Kafka 或 Amazon Kinesis 等实时传输来传输被记录的事件。为了实时搜索具有特定特征的事件,你可以利用 KSQL 或 Flink SQL 等流式 SQL 引擎。
⁵² 《日志管理市场规模、份额和全球市场预测至 2026》(Log Management Market Size, Share and Global Market Forecast to 2026),MarketsandMarkets,2021 年,https://oreil.ly/q0xgh。
⁵³ 不熟悉流处理的读者,请参考第 78 页的"批处理与流处理"一节。
仪表盘
一图胜千言。一系列数字对你可能毫无意义,但把它们可视化成图表可能会揭示这些数字之间的关系。可视化指标的仪表盘对监控至关重要。
仪表盘的另一个用途是让非工程师也能进行监控。监控不只是系统开发人员的事,也是非工程利益相关者的事,包括产品经理和业务开发人员。
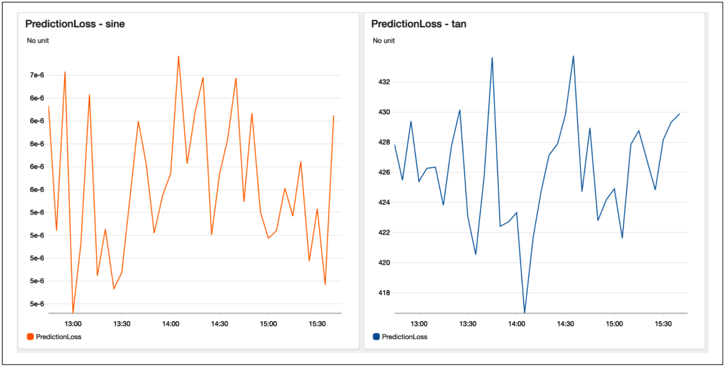
尽管图表对理解指标有很大帮助,但仅靠它们是不够的。你仍然需要经验和统计知识。考虑图 8-8 中的两个图表。从这些图表中唯一明显的是损失波动很大。如果这两个图表中任何一个存在分布偏移,我无法看出来。画一条抖动的线比理解这条抖动的线意味着什么更容易。
图 8-8. 图表有助于理解数字,但仅靠它们是不够的
仪表盘上过多的指标也可能适得其反,这种现象被称为仪表盘腐化(dashboard rot)。选择正确的指标或抽象出较低级别的指标以计算对你的特定任务更有意义的高级信号很重要。
警报
当我们的监控系统检测到可疑情况时,有必要提醒相关人员。一个警报由以下三个组件组成:
警报策略(alert policy)
这描述了警报的条件。你可能想在指标超过阈值时创建警报,可选地持续一定时间。例如,你可能想在模型准确率低于 90% 时被通知,或者 HTTP 响应延迟高于一秒并持续至少 10 分钟时被通知。
通知渠道(notification channels)
这描述了条件满足时要通知谁。警报会显示在你使用的监控服务中,如 Amazon CloudWatch 或 GCP Cloud Monitoring,但当相关人员不在这些监控服务上时,你也想联系到他们。例如,你可以配置警报发送到电子邮件地址(如 mlops-monitoring@[你们公司的邮箱域名])、发布到 Slack 频道(如 #mlops-monitoring)或发送到 PagerDuty。
警报的描述
这帮助被提醒的人理解发生了什么。描述应该尽可能详细,例如:
推荐模型准确率低于 90%
${timestamp}: 此警报来自服务 ${service-name}
根据警报的受众,通常有必要通过提供缓解说明或运行手册(runbook)——一组可能有助于处理警报的常规程序和操作——使警报可操作。
警报疲劳是一个真实存在的现象,正如本章前面所讨论的。警报疲劳可能令人士气低落——没有人喜欢半夜被叫醒处理职责范围之外的事情。它也很危险——接触琐碎的警报会使人们对关键警报麻木。设置有意义的条件很重要,这样只有关键警报才会被发送出去。
可观测性
自 2010 年代中期以来,行业开始接受"可观测性”(observability)这个术语,而不是"监控”。监控对系统内部状态与其输出之间的关系不做任何假设。你监控系统的外部输出来判断系统内部何时出错——不保证外部输出能帮助你找出哪里出了问题。
在软件部署的早期,软件系统足够简单,监控外部输出足以进行软件维护。一个系统曾经只由几个组件组成,一个团队曾经控制整个代码库。如果出了问题,可以对系统进行修改来测试并找出哪里出了问题。
然而,在过去十年中,软件系统变得复杂得多。今天,一个软件系统由许多组件组成。其中许多组件是其他公司运行的服务——所有云原生服务都是如此——这意味着一个团队甚至无法控制其系统所有组件的内部。当出问题时,团队不能再只是拆开系统来找出问题。团队必须依靠系统的外部输出来弄清楚内部发生了什么。
可观测性是用来应对这一挑战的术语。它是一个来自控制论的概念,指的是"利用[输出]在运行时从系统收集的数据,更好地理解软件的复杂行为"。⁵⁴
遥测
系统在运行时收集的输出也叫遥测(telemetry)。遥测是过去十年软件监控行业中出现的另一个术语。“telemetry"一词来自希腊语词根 tele,意为"远程”,以及 metron,意为"测量"。所以遥测基本上意味着"远程测量"。在监控语境中,它指从远程组件(如云服务或在客户设备上运行的应用)收集的日志和指标。
换句话说,可观测性做了一个比传统监控更强的假设:系统的内部状态可以从其外部输出的知识中推断出来。内部状态可以是当前状态,如"现在的 GPU 利用率",也可以是历史状态,如"过去一天的平均 GPU 利用率"。
当一个可观测的系统出问题时,我们应该能够通过查看系统的日志和指标来弄清楚出了什么问题,而不必向系统发布新代码。可观测性是关于以某种方式为系统插桩,以确保收集和分析足够多的系统运行时信息。
⁵⁴ Suman Karumuri、Franco Solleza、Stan Zdonik 和 Nesime Tatbul,《迈向大规模可观测性数据管理》(Towards Observability Data Management at Scale),ACM SIGMOD Record 第 49 卷第 4 期(2020 年 12 月):18-23,https://oreil.ly/oS5hn。
监控围绕指标展开,指标通常是聚合的。可观测性允许更细粒度的指标,这样你不仅能知道模型性能何时退化,还能知道模型对什么类型的输入、什么用户子组或在什么时间段内退化。例如,你应该能够查询日志来回答这样的问题:“显示过去一小时内模型 A 返回错误预测的所有用户,按邮政编码分组"或"显示过去 10 分钟内的离群请求"或"显示这个输入通过系统的所有中间输出”。要做到这一点,你需要使用标签和其他标识关键词记录系统输出,以便这些输出以后可以按数据的不同维度进行切分。
在 ML 中,可观测性包含可解释性(interpretability)。可解释性帮助我们理解 ML 模型如何工作,可观测性帮助我们理解整个 ML 系统(包括 ML 模型)如何工作。例如,当模型性能在过去一小时内退化时,能够解释哪个特征对过去一小时内的所有错误预测贡献最大,将有助于弄清楚系统出了什么问题以及如何修复。⁵⁵
在本节中,我们讨论了监控的多个方面,从监控什么数据和跟踪什么指标,到监控和可观测性的不同工具。尽管监控是一个强大的概念,但它本质上是被动的。你等待偏移发生来检测它。监控有助于发现问题的存在,但不能纠正它。在下一节中,我们将介绍持续学习(continual learning),一种可以主动帮助你更新模型以应对偏移的范式。
小结
这可能是本书中对我来说最难写的一章。原因是,尽管理解 ML 系统在生产中如何以及为何失败很重要,但围绕它的文献却很有限。我们通常认为研究先于生产,但这是 ML 中一个研究仍在努力追赶生产的领域。
为了理解 ML 系统的故障,我们区分了两类故障:软件系统故障(也会发生在非 ML 系统上的故障)和 ML 特有故障。尽管今天大多数 ML 故障不是 ML 特有的,但随着 MLOps 周围的工具和基础设施日趋成熟,这种情况可能会改变。
我们讨论了 ML 特有故障的三个主要原因:生产数据与训练数据不同、边界情况和退化反馈回路。前两个原因与数据有关,而最后一个原因与系统设计有关,因为它发生在系统输出影响同一系统输入的时候。
⁵⁵ 参见第 142 页的"特征重要性"一节。
我们深入探讨了一个近年备受关注的故障:数据分布偏移。我们研究了三种类型的偏移:协变量偏移、标签偏移和概念漂移。尽管研究分布偏移是 ML 研究的一个不断发展的子领域,但研究界尚未找到标准叙事。不同的论文用不同的名字称呼相同的现象。许多研究仍然基于这样的假设:我们事先知道分布将如何偏移,或者拥有源分布和目标分布数据的标签。然而,实际上,我们不知道未来的数据会是什么样子,而获取新数据的标签可能代价高昂、缓慢,甚至不可行。
为了能够检测偏移,我们需要监控我们部署的系统。监控是任何生产软件工程系统(不仅仅是 ML)的一套重要实践,这也是我们应该尽可能从 DevOps 世界学习的 ML 领域。
监控完全是关于指标的。我们讨论了需要监控的不同指标:运行指标——任何软件系统都应该监控的指标,如延迟、吞吐量和 CPU 利用率——以及 ML 特有指标。监控可以应用于准确率相关指标、预测、特征和/或原始输入。
监控很难,因为即使计算指标很便宜,理解指标也不简单。构建显示图表的仪表盘很容易,但理解图表意味着什么、它是否显示漂移的迹象,以及如果有漂移,它是由底层数据分布变化还是由管道中的错误引起的,要困难得多。理解数字和图表可能需要统计学知识。
检测生产中的模型性能退化是第一步。下一步是如何让我们的系统适应变化的环境,我们将在下一章讨论。