模型部署与预测服务
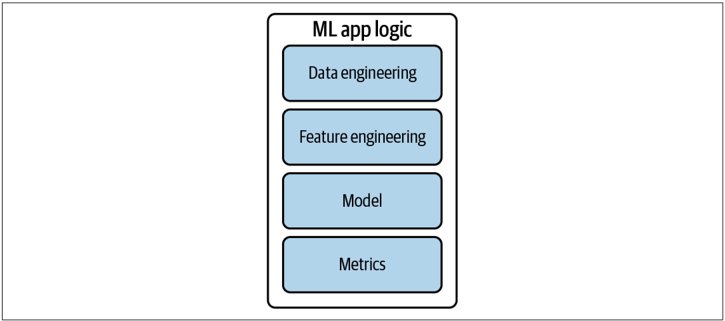
在第 4 章到第 6 章中,我们讨论了开发 ML 模型的考量因素,从创建训练数据、提取特征、开发模型,到设计评估该模型的指标。这些考量构成了模型逻辑(model logic)——关于如何从原始数据得到一个 ML 模型的指令,如图 7-1 所示。开发这一逻辑既需要 ML 知识,也需要领域专业知识(subject matter expertise)。在许多公司,这部分流程由 ML 或数据科学团队完成。
图 7-1. 构成 ML 模型逻辑的不同方面
在本章中,我们将讨论迭代过程中的另一部分:部署你的模型。“部署”(deploy)是一个宽泛的术语,通常指让你的模型运行起来并可供访问。在模型开发期间,你的模型通常在开发环境(development environment)中运行。¹ 要部署模型,它必须离开开发环境。你的模型可以部署到暂存环境(staging environment)进行测试,也可以部署到生产环境(production environment)供最终用户使用。在本章中,我们重点讨论将模型部署到生产环境。
在继续之前,我想强调,生产是一个谱系(spectrum)。对某些团队来说,生产意味着在 notebook 中生成漂亮的图表给业务团队看。对另一些团队来说,生产意味着让模型保持运行,每天服务数百万用户。如果你的工作属于第一种情况,你的生产环境与开发环境类似,本章与你的相关性较低。如果你的工作更接近第二种情况,请继续往下读。
我曾在网上某处读到:如果忽略所有困难的部分,部署很容易。如果你想部署一个模型给你的朋友玩,你只需要用 Flask 或 FastAPI 把你的 predict 函数包装成一个 POST 请求端点,把运行这个 predict 函数所需的依赖放进容器,² 然后把你的模型及其关联容器推送到 AWS 或 GCP 之类的云服务上,以暴露该端点:
# Example of how to use FastAPI to turn your predict function
# into a POST endpoint
@app.route('/predict', methods=['POST'])
def predict():
    X = request.get_json()['X']
    y = MODEL.predict(X).tolist()
    return json.dumps({'y': y}), 200
你可以将这个暴露的端点用于下游应用程序:例如,当应用程序收到用户的预测请求时,该请求会被发送到暴露的端点,端点会返回一个预测。如果你熟悉必要的工具,一小时内就能完成一个可用的部署。我的学生在 10 周课程结束后,都能部署一个 ML 应用作为他们的期末项目,尽管他们中很少有人之前有部署经验。³
困难的部分包括:让你的模型以毫秒级延迟和 99% 的可用率服务数百万用户;搭建基础设施,以便出问题时合适的人能立即收到通知;弄清哪里出了问题;以及无缝部署修复问题的更新。
¹ 我们将在第 10 章详细讨论开发环境。
² 我们将在第 9 章更深入地讨论容器。
³ 斯坦福大学 CS 329S:机器学习系统设计;你可以在 YouTube 上看到项目演示。
在许多公司,部署模型的责任落在开发这些模型的同一批人身上。在许多其他公司,一旦模型准备好部署,它就会被导出并移交给另一个团队去部署。然而,这种职责分离可能导致跨团队的高沟通成本,并使模型更新变慢。如果出了问题,也会让调试变得困难。我们将在第 11 章进一步讨论团队结构。
导出模型(exporting a model)意味着将模型转换为另一种应用程序可以使用的格式。有些人把这一过程称为"序列化"(serialization)。⁴ 模型有两个部分可以导出:模型定义(model definition)和模型的参数值(parameter values)。模型定义定义了模型的结构,例如它有多少个隐藏层以及每层有多少个单元。参数值为这些单元和层提供取值。通常,这两部分会一起导出。
在 TensorFlow 2 中,你可能会使用 tf.keras.Model.save() 将模型导出为 TensorFlow 的 SavedModel 格式。在 PyTorch 中,你可能会使用 torch.onnx.export() 将模型导出为 ONNX 格式。
无论你的工作是否涉及部署 ML 模型,了解你的模型是如何被使用的,都能让你理解它们的约束,并帮助你让模型契合其用途。
在本章中,我们首先讨论一些我经常从未部署过 ML 模型的人那里听到的关于 ML 部署的常见误区。然后我们讨论模型生成并向用户提供预测的两种主要方式:在线预测(online prediction)和批量预测(batch prediction)。生成预测的过程称为推理(inference)。
我们继续讨论生成预测的计算应该在哪里进行:在设备上(也称为边缘)还是在云端。模型如何提供和计算预测,会影响它的设计方式、所需的基础设施以及用户遇到的行为。
⁴ 参见第 53 页"数据格式"一节中关于"数据序列化"的讨论。
如果你来自学术界,本章讨论的一些主题可能超出你的舒适区。如果出现不熟悉的术语,花点时间查一下。如果某个小节过于密集,可以随意跳过。本章是模块化的,跳过一个小节不会影响你对另一个小节的理解。
机器学习部署的常见误区
如第 1 章所讨论的,部署 ML 模型可能与部署传统软件程序非常不同。这种差异可能会让从未部署过模型的人要么畏惧这一过程,要么低估它所需的时间和精力。在本节中,我们将破除一些关于部署过程的常见误区,希望能让你以良好的心态开始这一过程。本节对几乎没有部署经验的人最有帮助。
误区一:你一次只部署一两个 ML 模型
做学术项目时,有人建议我选择一个小问题来专注,这通常只产生一个模型。我接触过的许多学术界人士也倾向于从单一模型的视角看待 ML 生产。因此,他们头脑中的基础设施并不适用于实际应用,因为它只能支持一两个模型。
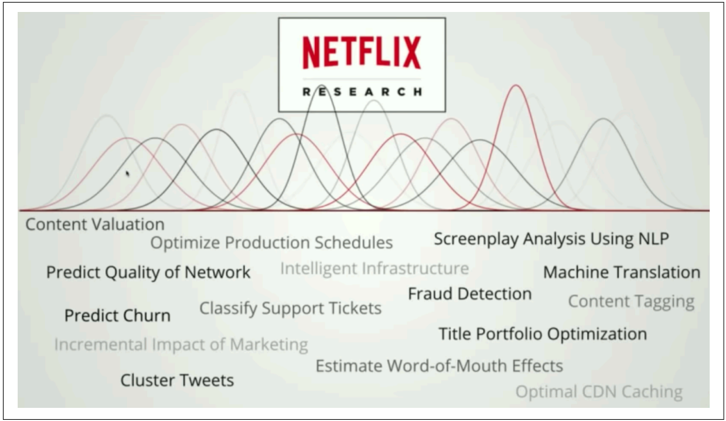
实际上,公司拥有非常非常多的 ML 模型。一个应用程序可能有许多不同的功能,每个功能可能需要自己的模型。想想像 Uber 这样的网约车应用。它需要模型来预测以下每个要素:乘车需求、司机可用性、预计到达时间、动态定价、欺诈交易、客户流失等等。此外,如果这个应用在 20 个国家运营,在你能拥有跨不同用户画像、文化和语言泛化的模型之前,每个国家都需要自己的一套模型。所以 20 个国家 × 每个国家 10 个模型,你已经有 200 个模型。图 7-2 展示了 Netflix 利用 ML 的广泛任务。
图 7-2. Netflix 中利用 ML 的不同任务。来源:Ville Tuulos ⁵
事实上,Uber 在生产环境中有数千个模型。⁶ 在任何时刻,Google 都有数千个模型在并行训练,参数规模达数千亿。⁷ Booking.com 有 150+ 个模型。⁸ Algorithmia 2021 年的一项研究显示,在员工超过 25,000 人的组织中,41% 在生产环境中有超过 100 个模型。⁹
误区二:如果我们什么都不做,模型性能保持不变
软件不会像陈年佳酿一样越陈越香。它老化的方式很糟糕。即使看起来什么都没变,软件程序的性能也会随时间退化,这种现象被称为"软件腐化"(software rot)或"位腐化"(bit rot)。
⁵ Ville Tuulos,“Human-Centric Machine Learning Infrastructure @Netflix,” InfoQ,2018 年,视频,49:11,https://oreil.ly/j4Hfx。
⁶ Wayne Cunningham,“Science at Uber: Powering Machine Learning at Uber,” Uber Engineering Blog,2019 年 9 月 10 日,https://oreil.ly/WfaCF。
⁷ Daniel Papasian 和 Todd Underwood,“OpML ‘20-How ML Breaks: A Decade of Outages for One Large ML Pipeline,” Google,2020 年,视频,19:06,https://oreil.ly/HjQm0。
⁸ Lucas Bernardi、Themistoklis Mavridis 和 Pablo Estevez,“150 Successful Machine Learning Models: 6 Lessons Learned at Booking.com,” KDD ‘19: Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining(2019 年 7 月):1743-51,https://oreil.ly/Ea1Ke。
⁹ “2021 Enterprise Trends in Machine Learning,” Algorithmia,https://oreil.ly/9kdcw。
ML 系统也不能幸免。此外,ML 系统还遭受所谓的数据分布漂移(data distribution shift)——模型在生产中遇到的数据分布与训练时用的数据分布不同。¹⁰ 因此,ML 模型往往在训练刚结束时表现最好,并随时间推移而退化。
误区三:你不需要频繁更新模型
人们倾向于问我:“我应该多久更新一次模型?“这是个错误的问题。正确的问题应该是:“我多久能更新一次模型?”
由于模型的性能会随时间衰减,我们希望尽可能快地更新它。这是 ML 中应该向现有 DevOps 最佳实践学习的一个领域。早在 2015 年,人们就已经在不断地向他们的系统推送更新。Etsy 每天部署 50 次,Netflix 每天数千次,AWS 每 11.7 秒一次。¹¹
虽然许多公司仍然每月甚至每季度才更新一次模型,但微博更新其部分 ML 模型的迭代周期是 10 分钟。¹² 我在阿里巴巴和字节跳动(TikTok 背后的公司)等公司也听说过类似的数字。
用 Josh Wills 的话说——他曾是 Google 的高级工程师(staff engineer)、Slack 的数据工程总监:“我们总是力求以人类可能的最快速度把新模型带入生产。“¹³
我们将在第 9 章进一步讨论重训模型的频率。
误区四:大多数 ML 工程师不需要担心规模问题
“规模”(scale)的含义因应用而异,但例子包括每秒处理数百个查询的系统,或每月服务数百万用户的系统。
你可能会争辩说,如果是这样,只有少数公司需要担心规模问题。Google 只有一个,Facebook 只有一个,Amazon 只有一个。确实如此,但少数大公司雇佣了大多数软件工程从业者。根据 Stack Overflow 2019 年开发者调查,超过一半的受访者为至少 100 名员工的公司工作(见图 7-3)。这不是完美的相关性,但一家 100 人的公司很可能要服务相当数量的用户。
¹⁰ 我们将在第 8 章进一步讨论数据分布漂移。
¹¹ Christopher Null,“10 Companies Killing It at DevOps,” TechBeacon,2015 年,https://oreil.ly/JvNwu。
¹² Qian Yu,“Machine Learning with Flink in Weibo,” QCon 2019,视频,17:57,https://oreil.ly/RcTMv。
¹³ Josh Wills,“Instrumentation, Observability and Monitoring of Machine Learning Models,” InfoQ 2019,https://oreil.ly/5Ot5m。
图 7-3. 软件工程师所在公司的规模分布。来源:改编自 Stack Overflow 的图片 ¹⁴
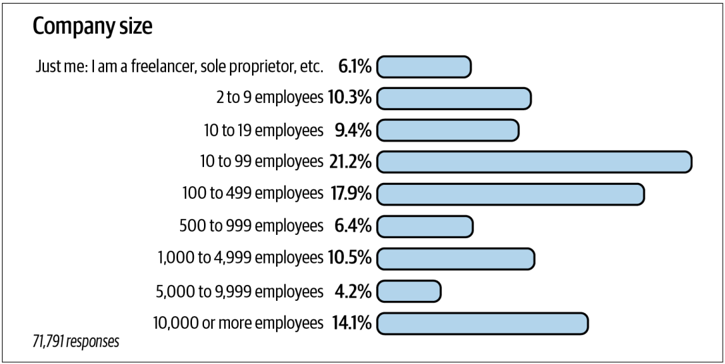
我找不到专门针对 ML 岗位的调查,所以我在 Twitter 上询问,得到了类似的结果。这意味着如果你在业界寻找 ML 相关工作,你很可能会为一家至少 100 名员工的公司工作,而该公司的 ML 应用可能需要可扩展。从统计上讲,ML 工程师应该关心规模。
批量预测与在线预测
你必须做出的一个基本决定——它将同时影响最终用户和系统开发者——是如何向最终用户生成并提供预测:在线还是批量。由于行业缺乏标准化实践,围绕批量预测和在线预测的术语仍然相当混乱。在本节中,我会尽力解释每个术语的细微差别。如果你觉得这里提到的任何术语太令人困惑,暂时忽略它们也没关系。如果你把其他一切都忘了,我希望你记住预测的三种主要模式:
- 批量预测,只使用批量特征(batch features)。
- 只使用批量特征的在线预测(例如,预计算的嵌入)。
- 同时使用批量特征和流式特征(streaming features)的在线预测。这也被称为流式预测(streaming prediction)。
¹⁴ “Developer Survey Results,” Stack Overflow,2019 年,https://oreil.ly/guYIq。
在线预测是指当预测请求到达时,立即生成并返回预测。例如,你在 Google 翻译中输入一个英文句子,立即得到法语翻译。在线预测也被称为按需预测(on-demand prediction)。传统上,做在线预测时,请求通过 RESTful API(如 HTTP 请求——参见第 73 页"服务间数据传递”)发送到预测服务。当预测请求通过 HTTP 请求发送时,在线预测也被称为同步预测(synchronous prediction):预测与请求同步生成。
批量预测是指周期性或随时触发地生成预测。预测存储在某个地方(如 SQL 表或内存数据库),需要时再取出。例如,Netflix 可能每四小时为所有用户生成电影推荐,预先计算好的推荐在用户登录 Netflix 时被取出并展示给用户。批量预测也被称为异步预测(asynchronous prediction):预测与请求异步生成。
术语混淆
“在线预测"和"批量预测"这两个术语可能令人困惑。两者都可以为多个样本(批量)或一次一个样本生成预测。为避免这种混淆,人们有时更喜欢"同步预测"和"异步预测"这两个术语。然而,这种区分也不完美,因为当在线预测利用实时传输将预测请求发送到模型时,请求和预测在技术上就是异步的。
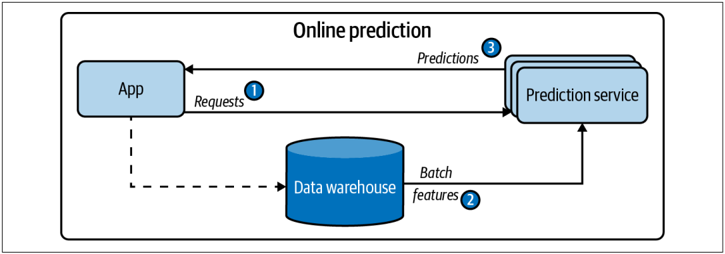
图 7-4 展示了批量预测的简化架构,图 7-5 展示了仅使用批量特征的在线预测的简化版本。我们接下来会讨论"仅使用批量特征"意味着什么。
图 7-4. 批量预测的简化架构
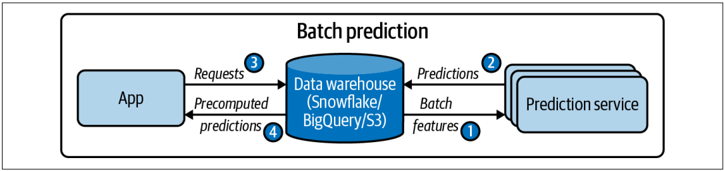
图 7-5. 仅使用批量特征的在线预测的简化架构
如第 3 章所讨论的,从历史数据(如数据库和数据仓库中的数据)计算出的特征是批量特征。从流式数据——实时传输中的数据——计算出的特征是流式特征。在批量预测中,只使用批量特征。然而,在线预测中可以使用批量特征和流式特征。例如,用户在 DoorDash 上下单后,可能需要以下特征来估算配送时间:
批量特征
这家餐厅过去的平均备餐时间
流式特征
在过去 10 分钟里,他们还有多少其他订单,有多少配送员可用
流式特征与在线特征
我听过"流式特征"和"在线特征"这两个术语被互换使用。它们其实不同。在线特征(online features)更宽泛,指用于在线预测的任何特征,包括存储在内存中的批量特征。
一种非常常见的用于在线预测的批量特征——尤其是基于会话的推荐——是物品嵌入(item embeddings)。物品嵌入通常在批处理中预先计算,在线预测需要时再取出。在这种情况下,嵌入可以被视为在线特征,但不是流式特征。
流式特征专指从流式数据计算出的特征。
图 7-6 展示了同时使用流式特征和批量特征的在线预测的简化架构。一些公司把这种预测称为"流式预测”,以区别于不使用流式特征的那种在线预测。
图 7-6. 同时使用批量特征和流式特征的在线预测的简化架构
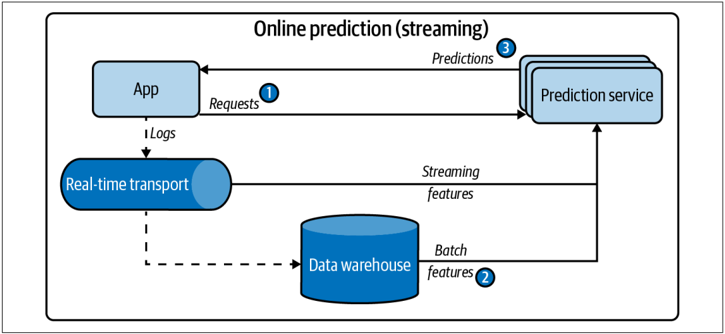
然而,在线预测和批量预测并不一定是互斥的。一种混合方案是:为热门查询预先计算预测,然后为不太热门的查询在线生成预测。表 7-1 总结了在线预测和批量预测需要考虑的要点。
表 7-1. 批量预测和在线预测之间的一些关键差异
| 批量预测(异步) | 在线预测(同步) | |
|---|---|---|
| 频率 | 周期性的,如每四小时 | 请求一到就立即 |
| 适用场景 | 处理累积数据且不需要立即结果时(如推荐系统) | 数据样本一产生就需要预测时(如欺诈检测) |
| 优化目标 | 高吞吐量 | 低延迟 |
在许多应用中,在线预测和批量预测会针对不同用例同时使用。例如,DoorDash 和 UberEats 等点餐应用使用批量预测来生成餐厅推荐——因为餐厅太多,在线生成这些推荐太耗时。然而,一旦你点击一家餐厅,食物推荐就会用在线预测生成。
许多人认为在线预测在成本和性能方面都不如批量预测高效,因为你可能无法将输入批量合并,从而利用向量化(vectorization)或其他优化技术。这并不一定是真的,正如我们在第 78 页"批处理与流处理"一节中已经讨论过的。
此外,使用在线预测,你不需要为没访问你网站的用户生成预测。想象你运营一个应用,每天只有 2% 的用户登录——例如,2020 年,Grubhub 有 3100 万用户和 62.2 万日均订单。¹⁵ 如果你每天为每个用户生成预测,用于生成 98% 预测的计算将被浪费。
从批量预测到在线预测
对于从学术界进入 ML 的人来说,更自然的提供预测方式可能是在线。你给模型一个输入,它一收到输入就生成预测。这很可能也是大多数人在原型设计时与模型互动的方式。对大多数公司来说,首次部署模型时,这也可能更容易做到。你导出模型,把导出的模型上传到 Amazon SageMaker 或 Google App Engine,然后得到一个暴露的端点。¹⁶ 现在,如果你向该端点发送一个包含输入的请求,它会返回基于该输入生成的预测。
在线预测的一个问题是你的模型生成预测可能太慢。与其在请求到达时立即生成预测,不如提前计算预测并存储在数据库中,等请求到达时再取出?这正是批量预测所做的。用这种方法,你可以一次为多个输入生成预测,利用分布式技术高效处理大量样本。
¹⁵ David Curry,“Grubhub Revenue and Usage Statistics (2022),” Business of Apps,2022 年 1 月 11 日,https://oreil.ly/jX43M;“Average Number of Grubhub Orders per Day Worldwide from 2011 to 2020,” Statista,https://oreil.ly/Tu9fm。
¹⁶ 服务的入口点 URL,在这里指你的 ML 模型的预测服务。
由于预测是预先计算的,你不用担心模型生成预测需要多长时间。因此,批量预测也可以看作一种降低更复杂模型推理延迟的技巧——取出预测的时间通常少于生成预测的时间。
当你想要生成大量预测且不需要立即得到结果时,批量预测很合适。你不必使用所有生成的预测。例如,你可以预测所有客户购买新产品的可能性,然后只联系前 10%。
然而,批量预测的问题是它让模型对用户偏好的变化反应变慢。即使在像 Netflix 这样技术更先进的公司,也能看到这种局限。假设你最近看了很多恐怖片,所以当你第一次登录 Netflix 时,恐怖片在推荐中占主导。但今天你心情明亮,你搜索"喜剧"并开始浏览喜剧类别。Netflix 应该学习并在推荐列表中向你展示更多喜剧,对吧?截至本书写作时,它要到下一批推荐生成时才能更新列表,但我毫不怀疑这个局限在不久的将来会被解决。
批量预测的另一个问题是,你需要事先知道要为哪些请求生成预测。在为用户推荐电影的情况下,你事先知道要为多少用户生成推荐。¹⁷ 然而,对于查询不可预测的情况——如果你有一个英译法的翻译系统,几乎不可能预见到所有需要翻译的英文文本——你需要用在线预测在请求到达时生成预测。
在 Netflix 的例子中,批量预测造成的是轻微不便(它与用户参与度和留存率紧密相关),而不是灾难性故障。有许多应用中批量预测会导致灾难性故障或根本行不通。在线预测至关重要的例子包括高频交易、自动驾驶汽车、语音助手、用面部或指纹解锁手机、老年人护理的跌倒检测和欺诈检测。能够检测出三小时前发生的欺诈交易仍然比完全检测不到好,但能够实时检测则可以阻止欺诈交易发生。
¹⁷ 如果有新用户加入,你可以给他们一些通用推荐。
批量预测是在线预测不够便宜或不够快时的一种变通办法。如果能在需要时以完全相同的成本和速度逐个生成预测,为什么还要提前生成一百万个预测并担心存储和取回它们呢?
随着硬件变得越来越定制化、越来越强大,更好的技术被开发出来以实现更快、更便宜的在线预测,在线预测可能会成为默认选择。
近年来,公司投入巨资从批量预测转向在线预测。为了克服在线预测的延迟挑战,需要两个组件:
- 一个(近)实时管道(pipeline),能够处理传入数据、提取流式特征(如果需要)、将其输入模型,并近乎实时地返回预测。具有实时传输的流式管道和流计算引擎可以帮上忙。
- 一个能够以最终用户可接受的速度生成预测的模型。对大多数消费类应用来说,这意味着毫秒级。
我们已经在第 3 章讨论了流处理。我们将在下一节继续讨论流管道与批量管道的统一。然后我们将在第 216 页"模型优化"一节讨论如何加速推理。
统一批量管道与流式管道
批量预测很大程度上是遗留系统的产物。在过去十年中,大数据处理一直被 MapReduce 和 Spark 等批处理系统主导,它们让我们能够非常高效地周期性处理大量数据。当公司开始使用 ML 时,他们利用现有的批处理系统来生成预测。当这些公司想为在线预测使用流式特征时,他们需要构建一个单独的流式管道。让我们通过一个例子来让这一点更具体。
想象你想为 Google Maps 这样的应用构建一个预测到达时间的模型。随着用户行程的推进,预测会不断更新。你可能想使用的一个特征是路径上所有汽车在过去五分钟的平均速度。训练时,你可能会使用过去一个月的数据。为了从训练数据中提取这个特征,你可能想把所有数据放进一个 dataframe,同时为多个训练样本计算该特征。推理时,这个特征会在滑动窗口上持续计算。这意味着在训练中,这个特征是批量计算的,而在推理时,这个特征是在流式过程中计算的。
用两条不同的管道处理数据是 ML 生产中 bug 的常见来源。bug 的一个原因是,一条管道的更改没有正确复制到另一条管道,导致两条管道提取出两组不同的特征。如果两条管道由两个不同的团队维护,这种情况尤其常见,例如 ML 团队维护用于训练的批量管道,而部署团队维护用于推理的流管道,如图 7-7 所示。
图 7-7. 训练和推理使用两条不同的管道是 ML 生产环境中 bug 的常见来源
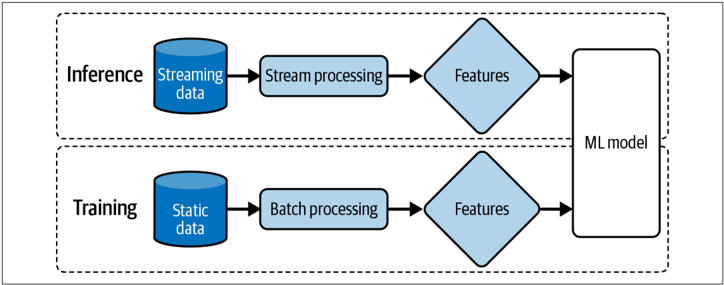
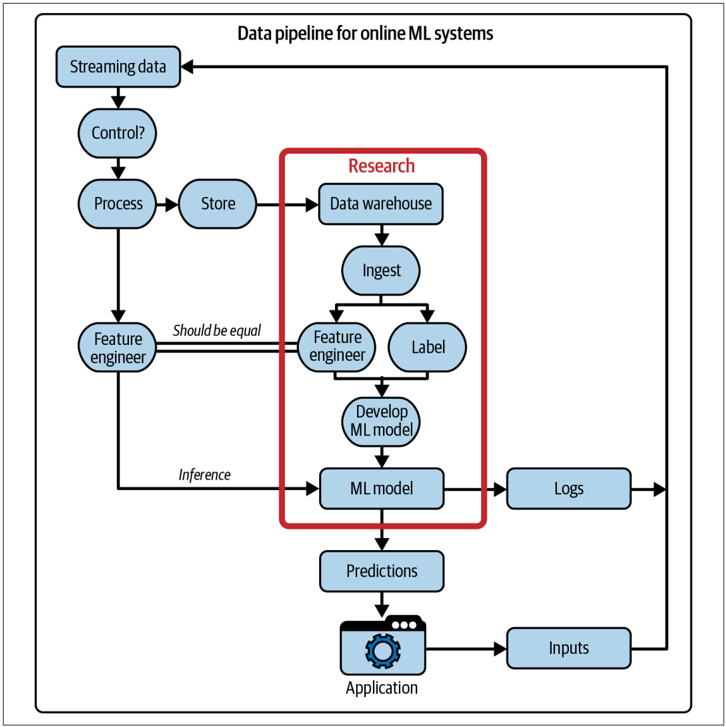
图 7-8 展示了做在线预测的 ML 系统更详细但也更复杂的数据管道。标有 Research 的方框元素是人们在学术环境中常接触到的东西。
图 7-8. 做在线预测的 ML 系统的数据管道
构建统一流处理和批处理的基础设施,近年来已成为 ML 社区的热门话题。Uber 和微博等公司通过使用 Apache Flink 这样的流处理器,进行了大规模基础设施改造来统一批量处理和流式处理管道。¹⁸ 一些公司使用特征存储(feature store)来确保训练时使用的批量特征与预测时使用的流式特征之间的一致性。我们将在第 10 章讨论特征存储。
¹⁸ Shuyi Chean 和 Fabian Hueske,“Streaming SQL to Unify Batch & Stream Processing w/ Apache Flink @Uber,” InfoQ,https://oreil.ly/XoaNu;Yu,“Machine Learning with Flink in Weibo。”
模型压缩
我们已经讨论过流式管道,它让 ML 系统能够(近)实时地从传入数据中提取流式特征并输入 ML 模型。然而,仅有(近)实时管道对在线预测来说还不够。在下一节,我们将讨论 ML 模型的快速推理技术。
如果你想部署的模型生成预测太慢,有三种主要方法可以降低其推理延迟:让它更快地进行推理、让模型更小,或者让部署它的硬件运行得更快。
让模型变小的过程称为模型压缩(model compression),让它更快推理的过程称为推理优化(inference optimization)。最初,模型压缩是为了让模型能装进边缘设备。然而,让模型变小通常也会让它们运行得更快。
我们将在第 216 页"模型优化"一节讨论推理优化,在第 212 页"云上的 ML 与边缘上的 ML"一节讨论专门为更快运行 ML 模型而开发的硬件后端格局。这里我们讨论模型压缩。
关于模型压缩的研究论文数量正在增长。现成的工具正在激增。截至 2022 年 4 月,Awesome Open Source 有一个"Top 168 Model Compression Open Source Projects”(前 168 个模型压缩开源项目)列表,而且这个列表还在增长。虽然正在开发许多新技术,但你最常遇到的四种技术类型是低秩优化(low-rank optimization)、知识蒸馏(knowledge distillation)、剪枝(pruning)和量化(quantization)。对全面综述感兴趣的读者可以看看 Cheng 等人的"A Survey of Model Compression and Acceleration for Deep Neural Networks”(深度神经网络模型压缩与加速综述),该文于 2020 年更新。¹⁹
低秩分解
低秩分解(low-rank factorization)的核心思想是用低维张量替换高维张量。²⁰ 一种低秩分解是紧凑卷积滤波器(compact convolutional filters),其中过度参数化(参数太多)的卷积滤波器被替换为紧凑块,既减少参数数量又提高速度。
¹⁹ Yu Cheng、Duo Wang、Pan Zhou 和 Tao Zhang,“A Survey of Model Compression and Acceleration for Deep Neural Networks,” arXiv,2020 年 6 月 14 日,https://oreil.ly/1eMho。
²⁰ Max Jaderberg、Andrea Vedaldi 和 Andrew Zisserman,“Speeding up Convolutional Neural Networks with Low Rank Expansions,” arXiv,2014 年 5 月 15 日,https://oreil.ly/4Vf4s。
例如,通过使用包括用 1 × 1 卷积替换 3 × 3 卷积在内的一系列策略,SqueezeNets 在 ImageNet 上达到了 AlexNet 级别的准确率,而参数数量减少了 50 倍。²¹
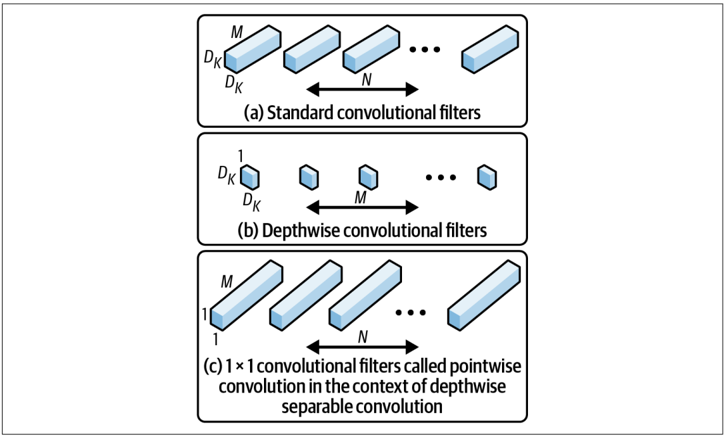
类似地,MobileNets 将大小为 K × K × C 的标准卷积分解为深度卷积(depthwise convolution,K × K × 1)和逐点卷积(pointwise convolution,1 × 1 × C),其中 K 是卷积核大小,C 是通道数。这意味着每个新卷积只使用 K² + C 个参数,而不是 K²C 个。如果 K = 3,这意味着参数数量减少八到九倍(见图 7-9)。²²
图 7-9. MobileNets 中的紧凑卷积滤波器。(a) 中的标准卷积滤波器被 (b) 中的深度卷积和 (c) 中的逐点卷积替换,以构建深度可分离滤波器。来源:改编自 Howard 等人的图片
这种方法已被用来开发更小且相比标准模型有显著加速的模型。然而,它往往特定于某些类型的模型(例如,紧凑卷积滤波器特定于卷积神经网络),并且设计时需要大量架构知识,所以它还不能广泛应用于许多用例。
²¹ Forrest N. Iandola、Song Han、Matthew W. Moskewicz、Khalid Ashraf、William J. Dally 和 Kurt Keutzer,“SqueezeNet: AlexNet-Level Accuracy with 50x Fewer Parameters and <0.5MB Model Size,” arXiv,2016 年 11 月 4 日,https://oreil.ly/xs3mi。
²² Andrew G. Howard、Menglong Zhu、Bo Chen、Dmitry Kalenichenko、Weijun Wang、Tobias Weyand、Marco Andreetto 和 Hartwig Adam,“MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications,” arXiv,2017 年 4 月 17 日,https://oreil.ly/T84fD。
知识蒸馏
知识蒸馏是一种让小模型(学生,student)模仿更大模型或模型集成(教师,teacher)的方法。部署的是较小的模型。虽然学生通常在预训练的教师之后训练,但两者也可以同时训练。²³ 生产中使用的蒸馏网络的一个例子是 DistilBERT,它将 BERT 模型的大小减少 40%,同时保留其 97% 的语言理解能力,并且速度快 60%。²⁴
这种方法的优点是,无论教师和学生网络之间的架构差异如何,它都有效。例如,你可以让随机森林当学生,Transformer 当教师。这种方法的缺点是它高度依赖教师网络的可用性。如果你用预训练模型作为教师模型,训练学生网络所需的数据更少,而且很可能更快。然而,如果你没有可用的教师,你必须在训练学生网络之前先训练教师网络,而训练教师网络需要多得多的数据和时间。这种方法还对应用和模型架构敏感,因此还没有在生产中找到广泛用途。
剪枝
剪枝最初是用于决策树的方法,即移除树中对分类不关键且冗余的部分。²⁵ 随着神经网络被更广泛采用,人们开始意识到神经网络是过度参数化的,并开始寻找减少额外参数带来的工作量的方法。
在神经网络的语境中,剪枝有两个含义。一个是移除神经网络的整个节点,这意味着改变其架构并减少其参数数量。更常见的含义是找到对预测最没用的参数并将其置为 0。在这种情况下,剪枝不会减少参数的总数,只减少非零参数的数量。神经网络的架构保持不变。这有助于减小模型大小,因为剪枝让神经网络更稀疏,而稀疏架构往往比稠密结构需要更少的存储空间。实验表明,剪枝技术可以将训练后网络的非零参数数量减少 90% 以上,在不大幅影响整体准确率的情况下降低存储需求并提高推理的计算性能。²⁶ 在第 11 章中,我们将讨论剪枝如何给模型引入偏差。
²³ Geoffrey Hinton、Oriol Vinyals 和 Jeff Dean,“Distilling the Knowledge in a Neural Network,” arXiv,2015 年 3 月 9 日,https://oreil.ly/OJEPW。
²⁴ Victor Sanh、Lysandre Debut、Julien Chaumond 和 Thomas Wolf,“DistilBERT, a Distilled Version of BERT: Smaller, Faster, Cheaper and Lighter,” arXiv,2019 年 10 月 2 日,https://oreil.ly/mQWBv。
²⁵ 因此得名"剪枝”。
虽然人们普遍认为剪枝有效,²⁷ 但对剪枝的实际价值有很多讨论。Liu 等人认为剪枝的主要价值不在于继承的"重要权重",而在于剪枝后的架构本身。²⁸ 在某些情况下,剪枝可以作为一种架构搜索范式,剪枝后的架构应该作为稠密模型从头开始重新训练。然而,Zhu 等人表明,剪枝后的大稀疏模型优于重新训练的稠密对应模型。²⁹
量化
量化是最通用、最常用的模型压缩方法。它实现起来直接,并且能泛化到各种任务和架构。
量化通过使用更少的比特来表示参数来减小模型大小。默认情况下,大多数软件包用 32 比特表示浮点数(单精度浮点)。如果一个模型有 1 亿个参数,每个参数需要 32 比特存储,它将占用 400 MB。如果我们用 16 比特表示一个数,内存占用将减少一半。用 16 比特表示浮点数称为半精度(half precision)。
除了使用浮点数,你还可以让模型完全使用整数;每个整数只需要 8 比特表示。这种方法也被称为"定点"(fixed point)。在极端情况下,有些人尝试过每个权重 1 比特的表示(二值权重神经网络,binary weight neural networks),例如 BinaryConnect 和 XNOR-Net。³⁰ XNOR-Net 论文的作者们创办了 Xnor.ai,一家专注于模型压缩的创业公司。2020 年初,它被苹果以据报道 2 亿美元的价格收购。³¹
²⁶ Jonathan Frankle 和 Michael Carbin,“The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks,” ICLR 2019,https://oreil.ly/ychdl。
²⁷ Davis Blalock、Jose Javier Gonzalez Ortiz、Jonathan Frankle 和 John Guttag,“What Is the State of Neural Network Pruning?” arXiv,2020 年 3 月 6 日,https://oreil.ly/VQsC3。
²⁸ Zhuang Liu、Mingjie Sun、Tinghui Zhou、Gao Huang 和 Trevor Darrell,“Rethinking the Value of Network Pruning,” arXiv,2019 年 3 月 5 日,https://oreil.ly/mB4IZ。
²⁹ Michael Zhu 和 Suyog Gupta,“To Prune, or Not to Prune: Exploring the Efficacy of Pruning for Model Compression,” arXiv,2017 年 11 月 13 日,https://oreil.ly/KBRjy。
³⁰ Matthieu Courbariaux、Yoshua Bengio 和 Jean-Pierre David,“BinaryConnect: Training Deep Neural Networks with Binary Weights During Propagations,” arXiv,2015 年 11 月 2 日,https://oreil.ly/Fwp2G;Mohammad Rastegari、Vicente Ordonez、Joseph Redmon 和 Ali Farhadi,“XNOR-Net: ImageNet Classification Using Binary Convolutional Neural Networks,” arXiv,2016 年 8 月 2 日,https://oreil.ly/gr3Ay。
³¹ Alan Boyle、Taylor Soper 和 Todd Bishop,“Exclusive: Apple Acquires Xnor.ai, Edge AI Spin-out from Paul Allen’s AI2, for Price in $200M Range,” GeekWire,2020 年 1 月 15 日,https://oreil.ly/HgaxC。
量化不仅减少内存占用,还提高计算速度。首先,它让我们能增大批大小。其次,更低的精度加快计算,这进一步减少训练时间和推理延迟。考虑两个数的加法。如果我们逐比特执行加法,每比特耗时 x 纳秒,那么 32 比特数需要 32x 纳秒,而 16 比特数只需要 16x 纳秒。
量化也有缺点。减少表示数字的比特数意味着你能表示的取值范围更小。对于超出该范围的值,你必须向上取整和/或缩放使它们在范围内。取整会导致舍入误差(rounding errors),而小的舍入误差可能导致大的性能变化。你还有把数字取整/缩放到下溢/溢出并变成 0 的风险。在底层实现高效的舍入和缩放并非易事,但幸运的是,主流框架已经内置了这些功能。
量化可以发生在训练期间(量化感知训练,quantization aware training)³²——模型以较低精度训练;也可以在训练后(post-training)进行——模型以单精度浮点训练,然后为推理进行量化。在训练期间使用量化意味着每个参数可以用更少的内存,这让你能在同样的硬件上训练更大的模型。
近年来,低精度训练越来越流行,大多数现代训练硬件都支持。NVIDIA 推出了 Tensor Cores(张量核心),即支持混合精度训练的处理单元。³³ Google TPU(张量处理单元,tensor processing unit)也支持用 Bfloat16(16 位 Brain 浮点格式)训练,该公司称其为"Cloud TPU 上高性能的秘密"。³⁴ 定点训练还没有那么流行,但已经有很多有前景的结果。³⁵
定点推理已成为行业标准。一些边缘设备只支持定点推理。最流行的设备端 ML 推理框架——Google 的 TensorFlow Lite、Facebook 的 PyTorch Mobile、NVIDIA 的 TensorRT——都免费提供训练后量化,只需几行代码。
³² 截至 2020 年 10 月,TensorFlow 的量化感知训练实际上并不是用更低比特的权重训练模型,而是收集统计信息用于训练后量化。
³³ Chip Huyen、Igor Gitman、Oleksii Kuchaiev、Boris Ginsburg、Vitaly Lavrukhin、Jason Li、Vahid Noroozi 和 Ravi Gadde,“Mixed Precision Training for NLP and Speech Recognition with OpenSeq2Seq,” NVIDIA Devblogs,2018 年 10 月 9 日,https://oreil.ly/WDT1l。这是我的文章!
³⁴ Shibo Wang 和 Pankaj Kanwar,“BFloat16: The Secret to High Performance on Cloud TPUs,” Google Cloud Blog,2019 年 8 月 23 日,https://oreil.ly/ZG5p0。
³⁵ Itay Hubara、Matthieu Courbariaux、Daniel Soudry、Ran El-Yaniv 和 Yoshua Bengio,“Quantized Neural Networks: Training Neural Networks with Low Precision Weights and Activations,” Journal of Machine Learning Research 18(2018):1-30;Benoit Jacob、Skirmantas Kligys、Bo Chen、Menglong Zhu、Matthew Tang、Andrew Howard、Hartwig Adam 和 Dmitry Kalenichenko,“Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference,” arXiv,2017 年 12 月 15 日,https://oreil.ly/sUuMT。
案例分析
为了更好地理解如何优化生产中的模型,来看一个来自 Roblox 的精彩案例研究,他们如何扩展 BERT 在 CPU 上每天服务超过 10 亿个请求。³⁶ 对它们的许多 NLP 服务来说,它们需要以低于 20 毫秒的延迟处理每秒超过 25,000 次推理,如图 7-10 所示。他们从一个固定形状输入的大 BERT 模型开始,然后用 DistilBERT 替换 BERT、用动态形状输入替换固定形状输入,最后进行量化。
图 7-10. 各种模型压缩方法带来的延迟改进。来源:改编自 Le 和 Kaehler 的图片
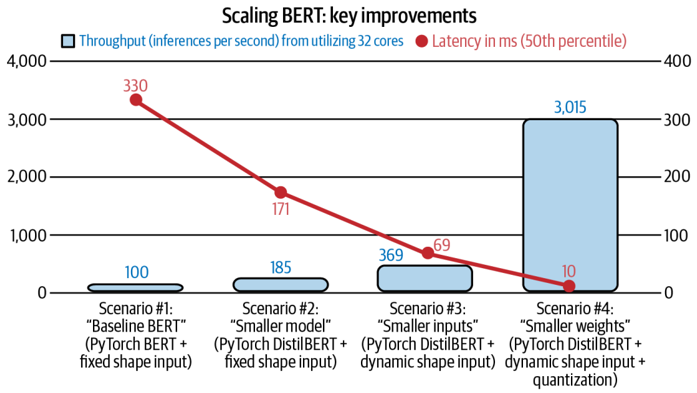
他们获得的最大性能提升来自量化。将 32 位浮点数转换为 8 位整数,延迟降低 7 倍,吞吐量提高 8 倍。
这里的结果对改善延迟似乎非常有前景;然而,应该持保留态度,因为没有提到每次性能改进后输出质量的变化。
³⁶ Quoc Le 和 Kip Kaehler,“How We Scaled Bert To Serve 1+ Billion Daily Requests on CPUs,” Roblox,2020 年 5 月 27 日,https://oreil.ly/U01Uj。
云上的 ML 与边缘上的 ML
你要考虑的另一个决定是模型的计算将在哪里进行:云端还是边缘。在云端意味着很大一部分计算在云上进行,无论是公有云还是私有云。在边缘意味着很大一部分计算在消费设备上进行——如浏览器、手机、笔记本电脑、智能手表、汽车、安防摄像头、机器人、嵌入式设备、FPGA(现场可编程门阵列,field programmable gate array)和 ASIC(专用集成电路,application-specific integrated circuit)——这些设备也被称为边缘设备(edge devices)。
最简单的方式是把模型打包并通过 AWS 或 GCP 这样的托管云服务部署,这也是许多公司在 ML 起步时的部署方式。云服务在让公司轻松把 ML 模型带入生产方面做得非常出色。
然而,云部署有很多缺点。首先是成本。ML 模型可能计算密集,而计算是昂贵的。早在 2018 年,Pinterest、Infor 和 Intuit 这样的大公司每年在云账单上就花费数亿美元。³⁷ 中小型公司的这个数字可能在每年 5 万美元到 200 万美元之间。³⁸ 云服务处理上的一个错误可能让创业公司破产。³⁹
随着云账单攀升,越来越多的公司在寻找把计算推向边缘设备的方法。在边缘完成的计算越多,云端需要的就越少,他们需要为服务器支付的就越少。
除了帮助控制成本,还有许多特性让边缘计算有吸引力。首先是它能让你的应用在云计算无法运行的地方运行。当你的模型在公有云上时,它们依赖稳定的互联网连接把数据发送到云端并返回。边缘计算让你的模型在没有互联网连接或连接不可靠的情况下工作,比如在乡村地区或发展中国家。我与几家有严格无互联网政策的公司和组织合作过,这意味着无论我们想卖给他们什么应用,都不能依赖互联网连接。
³⁷ Amir Efrati 和 Kevin McLaughlin,“As AWS Use Soars, Companies Surprised by Cloud Bills,” The Information,2019 年 2 月 25 日,https://oreil.ly/H9ans;Mats Bauer,“How Much Does Netflix Pay Amazon Web Services Each Month?” Quora,2020 年,https://oreil.ly/HtrBk。
³⁸ “2021 State of Cloud Cost Report,” Anodot,https://oreil.ly/5ZIJK。
³⁹ “Burnt $72K Testing Firebase and Cloud Run and Almost Went Bankrupt,” Hacker News,2020 年 12 月 10 日,https://oreil.ly/vsHHC;“How to Burn the Most Money with a Single Click in Azure,” Hacker News,2020 年 3 月 29 日,https://oreil.ly/QvCiI。我们将在第 300 页"公有云与私有数据中心"一节更详细地讨论公司如何应对高额云账单。
其次,当你的模型已经在消费者的设备上时,你可以少担心网络延迟。通过网络传输数据(把数据发送到云端的模型做预测,再把预测发回给用户)可能会让一些用例变得不可能。在许多情况下,网络延迟是比推理延迟更大的瓶颈。例如,你可能能把 ResNet-50 的推理延迟从 30 毫秒降到 20 毫秒,但网络延迟可能高达数秒,这取决于你所在的位置和你试图使用的服务。
在处理敏感用户数据时,把模型放在边缘也很有吸引力。云上的 ML 意味着你的系统可能必须通过网络发送用户数据,使其容易被拦截。云计算也常常意味着把许多用户的数据存储在同一个地方,这意味着一次入侵可能影响许多人。“近 80% 的公司在过去 18 个月中经历过云数据泄露,“Security 杂志称。⁴⁰
边缘计算让遵守 GDPR 等关于用户数据如何传输或存储的法规更容易。虽然边缘计算可能减少隐私问题,但它并不能完全消除。在某些情况下,边缘计算可能让攻击者更容易窃取用户数据,比如他们可以直接把设备拿走。
要把计算移到边缘,边缘设备必须足够强大以处理计算,有足够的内存来存储 ML 模型并把它们加载到内存中,还要有足够的电池或连接能源,让应用能运行合理的时间。在你的手机上运行一个全尺寸的 BERT——如果你的手机能运行 BERT 的话——是很快耗尽电池的方法。
由于边缘计算相比云计算有诸多好处,公司们正竞相开发针对不同 ML 用例优化的边缘设备。Google、Apple 和 Tesla 等老牌公司都宣布了制造自己芯片的计划。与此同时,ML 硬件创业公司已筹集数十亿美元来开发更好的 AI 芯片。⁴¹ 预计到 2025 年,全球活跃边缘设备数量将超过 300 亿。⁴²
有了这么多运行 ML 模型的新硬件产品,一个问题出现了:我们如何让模型在任意硬件上高效运行?在下一节,我们将讨论如何编译和优化模型,使其在特定硬件后端上运行。在此过程中,我们将介绍你在处理边缘模型时可能遇到的重要概念,包括中间表示(intermediate representation,IR)和编译器。
⁴⁰ “Nearly 80% of Companies Experienced a Cloud Data Breach in Past 18 Months,” Security,2020 年 6 月 5 日,https://oreil.ly/gA1am。
⁴¹ 参见 CS 329S 第 8 讲"部署-预测服务"的第 53 张幻灯片,2022 年,https://oreil.ly/cXTou。
⁴² “Internet of Things (IoT) and Non-IoT Active Device Connections Worldwide from 2010 to 2025,” Statista,https://oreil.ly/BChLN。
为边缘设备编译和优化模型
对于一个用特定框架(如 TensorFlow 或 PyTorch)构建的模型,要在硬件后端上运行,该框架必须得到硬件厂商的支持。例如,尽管 TPU 在 2018 年 2 月公开发布,但直到 2020 年 9 月 PyTorch 才在 TPU 上得到支持。在那之前,如果你想用 TPU,你必须使用 TPU 支持的框架。
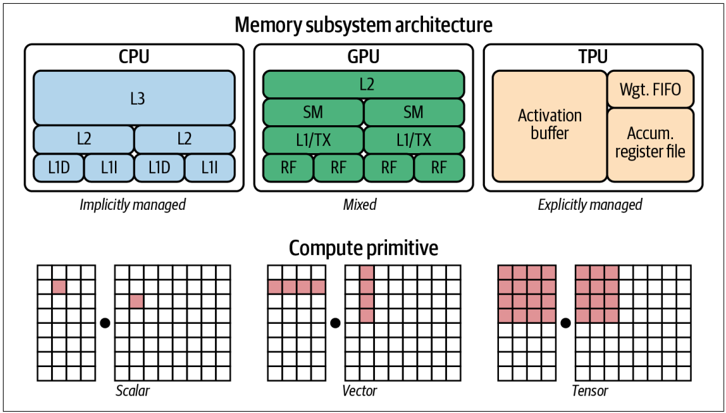
在硬件后端上提供对框架的支持既耗时又工程密集。把 ML 工作负载映射到硬件后端需要理解并利用该硬件的设计,而不同的硬件后端有不同的内存布局和计算原语,如图 7-11 所示。
图 7-11. CPU、GPU 和 TPU 的不同计算原语和内存布局。来源:改编自 Chen 等人的图片 ⁴³
⁴³ Tianqi Chen、Thierry Moreau、Ziheng Jiang、Lianmin Zheng、Eddie Yan、Meghan Cowan、Haichen Shen 等人,“TVM: An Automated End-to-End Optimizing Compiler for Deep Learning,” arXiv,2018 年 2 月 12 日,https://oreil.ly/vGnkW。
例如,CPU 的计算原语曾经是一个数(标量),GPU 的计算原语曾经是一维向量,而 TPU 的计算原语是二维向量(张量)。⁴⁴ 用一维向量执行卷积算子与用二维向量非常不同。类似地,你需要考虑不同的 L1、L2、L3 布局和缓冲区大小才能高效使用它们。
因为这一挑战,框架开发者倾向于只为一小部分服务器级硬件提供支持,硬件厂商倾向于为一小部分框架提供自己的内核库。把 ML 模型部署到新硬件需要大量人工。
与其为每个新硬件后端开发新的编译器和库,不如创建一个中间人来桥接框架和平台?框架开发者不再需要支持每种硬件;他们只需要把框架代码翻译成这个中间人。硬件厂商然后可以支持一个中间人,而不是多个框架。
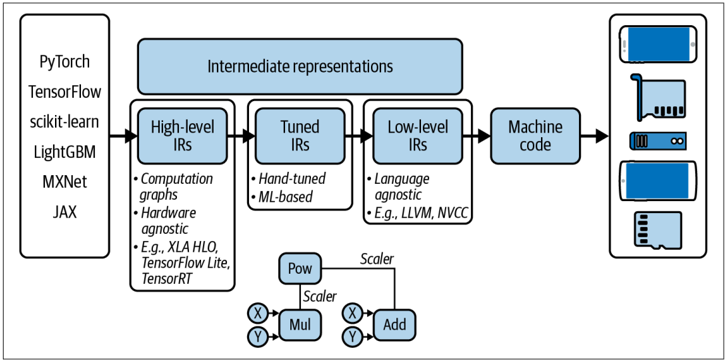
这种"中间人"被称为中间表示(intermediate representation,IR)。IR 是编译器工作方式的核心。从模型的原始代码出发,编译器生成一系列高层和低层 IR,然后生成硬件后端原生的代码,使其能在该硬件后端上运行,如图 7-12 所示。
图 7-12. 从原始模型代码到能在给定硬件后端上运行的机器码之间的一系列高层和低层 IR
⁴⁴ 如今,许多 CPU 有向量指令,一些 GPU 有张量核心,它们是二维的。
这个过程也被称为下降(lowering),就像你把高层框架代码"下降"为低层硬件原生代码。它不是翻译,因为两者之间没有一一对应的映射。
高层 IR 通常是 ML 模型的计算图(computation graph)。计算图是描述计算执行顺序的图。感兴趣的读者可以阅读 PyTorch 和 TensorFlow 中的计算图。
模型优化
在你把运行模型的代码"下降"到你选择的硬件之后,你可能遇到的一个问题是性能。生成的机器码也许能在硬件后端上运行,但可能无法高效运行。生成的代码可能没有利用数据局部性和硬件缓存,也可能没有利用能加速代码的向量或并行操作等高级特性。
一个典型的 ML 工作流由许多框架和库组成。例如,你可能用 pandas/dask/ray 从数据中提取特征。你可能用 NumPy 做向量化。你可能用 Hugging Face 的 Transformers 这样的预训练模型生成特征,然后用各种框架(如 sklearn、TensorFlow 或 LightGBM)构建的模型集成做预测。
尽管这些框架中的单个函数可能是优化的,但跨框架几乎没有优化。在这些函数之间移动数据进行计算的朴素方式可能导致整个工作流慢一个数量级。斯坦福 DAWN 实验室的研究人员的一项研究发现,使用 NumPy、pandas 和 TensorFlow 的典型 ML 工作负载在单线程下比手工优化代码慢 23 倍。⁴⁵
在许多公司,通常发生的情况是:数据科学家和 ML 工程师开发的模型在开发阶段看起来工作正常。然而,当这些模型被部署时,它们被发现太慢,所以公司聘请优化工程师(optimization engineers)为模型运行的硬件优化模型。Mythic 的优化工程师职位描述示例如下:
⁴⁵ Shoumik Palkar、James Thomas、Deepak Narayanan、Pratiksha Thaker、Rahul Palamuttam、Parimajan Negi、Anil Shanbhag 等人,“Evaluating End-to-End Optimization for Data Analytics Applications in Weld,” Proceedings of the VLDB Endowment 11, no. 9(2018):1002-15,https://oreil.ly/ErUIo。
这一愿景在 AI 工程团队中得以实现,我们的专业知识被用来开发针对我们硬件优化的 AI 算法和模型,并为 Mythic 的硬件和编译器团队提供指导。
AI 工程团队通过以下方式对 Mythic 产生重大影响:
- 开发量化和鲁棒性 AI 重训练工具
- 为我们的编译器研究利用神经网络适应性的新特性
- 开发针对我们硬件产品优化的新神经网络
- 与内部和外部客户对接,满足他们的开发需求
优化工程师很难找到,雇佣成本也很高,因为他们需要同时具备 ML 和硬件架构方面的专业知识。优化编译器(同时也优化你代码的编译器)是一种替代方案,因为它们可以自动化优化模型的过程。在把 ML 模型代码下降为机器码的过程中,编译器可以查看 ML 模型的计算图及其包含的算子——卷积、循环、交叉熵——并找到加速它的方法。
优化 ML 模型有两种方式:局部和全局。局部是优化模型的一个算子或一组算子。全局是端到端优化整个计算图。
有一些标准的局部优化技术已知可以加速模型,其中大多数是让事情并行运行或减少芯片上的内存访问。以下是四种常见技术:
向量化
给定一个循环或嵌套循环,不要一次执行一个元素,而是同时执行内存中连续的多个元素,以减少数据 I/O 造成的延迟。
并行化
给定一个输入数组(或 n 维数组),把它分成不同的、独立的工作块,对每个块单独执行操作。
循环分块(Loop tiling)⁴⁶
改变循环中的数据访问顺序,以利用硬件的内存布局和缓存。这类优化依赖硬件。在 CPU 上好的访问模式在 GPU 上不一定是好的访问模式。
算子融合(Operator fusion)
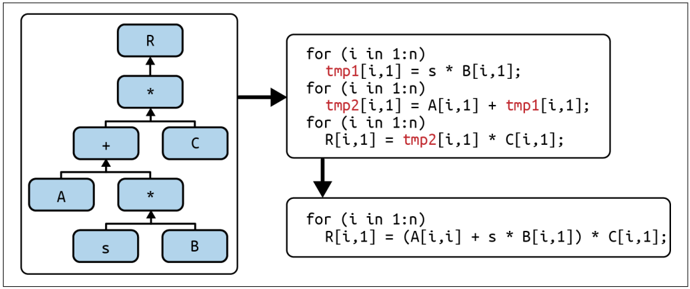
把多个算子融合成一个,以避免冗余的内存访问。例如,对同一个数组的两个操作需要对数组循环两次。融合的情况下,只需要一次循环。图 7-13 展示了算子融合的一个例子。
图 7-13. 算子融合的一个例子。来源:改编自 Matthias Boehm 的图片 ⁴⁷
要获得大得多的加速,你需要利用计算图的更高级结构。例如,卷积神经网络的计算图可以垂直或水平融合,以减少内存访问并加速模型,如图 7-14 所示。
⁴⁶ 关于循环分块的有用可视化,参见 Colfax Research 的演示"Access to Caches and Memory"的第 33 张幻灯片,这是他们"Programming and Optimization for Intel Architecture: Hands-on Workshop"系列的第 10 讲。整个系列可在 https://oreil.ly/hT1g4 获取。
⁴⁷ Matthias Boehm,“Architecture of ML Systems 04 Operator Fusion and Runtime Adaptation,” Graz University of Technology,2019 年 4 月 5 日,https://oreil.ly/py43J。
图 7-14. 卷积神经网络计算图的垂直和水平融合。来源:改编自 TensorRT 团队的图片 ⁴⁸
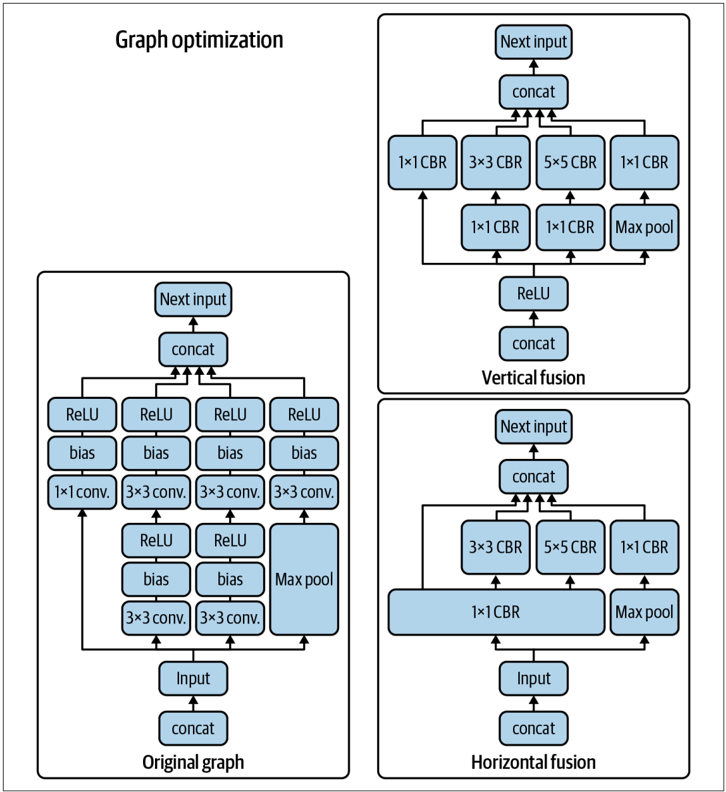
⁴⁸ Shashank Prasanna、Prethvi Kashinkunti 和 Fausto Milletari,“TensorRT 3: Faster TensorFlow Inference and Volta Support,” NVIDIA Developer,2017 年 12 月 4 日,https://oreil.ly/d9h98。CBR 代表"卷积、偏置和 ReLU”。
使用 ML 优化 ML 模型
正如上一节中卷积神经网络的垂直和水平融合所暗示的,执行给定计算图有许多可能的方式。例如,给定三个算子 A、B 和 C,你可以融合 A 和 B、融合 B 和 C,或者把 A、B、C 全部融合在一起。
传统上,框架和硬件厂商雇佣优化工程师,他们根据自己的经验提出如何最好地执行模型计算图的启发式方法。例如,NVIDIA 可能有一个工程师或工程师团队专门研究如何让 ResNet-50 在他们的 DGX A100 服务器上运行得非常快。⁴⁹
手工设计的启发式方法有几个缺点。首先,它们不是最优的。无法保证工程师提出的启发式方法是最好的解决方案。其次,它们不可自适应。在新框架或新硬件架构上重复这一过程需要巨大的努力。
模型优化取决于其计算图包含的算子,这使事情更加复杂。优化卷积神经网络不同于优化循环神经网络,也不同于优化 Transformer。NVIDIA 和 Google 这样的硬件厂商专注于为他们的硬件优化 ResNet-50 和 BERT 这样的流行模型。但如果你作为 ML 研究人员提出了一种新的模型架构呢?你可能需要自己优化它,先证明它很快,然后才会被硬件厂商采用和优化。
如果你没有好的启发式方法的思路,一个可能的解决方案是尝试执行计算图的所有可能方式,记录它们运行所需的时间,然后选择最好的一个。然而,考虑到路径的组合数量,探索所有路径是不可行的。幸运的是,近似解决不可行问题正是 ML 擅长的。如果我们用 ML 来缩小搜索空间,这样我们就不必探索那么多路径,并预测一条路径需要多长时间,这样我们就不必等待整个计算图执行完,怎么样?
事实证明,估计一条路径穿过计算图需要运行多长时间是困难的,因为它需要对图做很多假设。专注于图的一小部分要容易得多。
⁴⁹ 这也是为什么你不应该过度解读基准测试结果(如 MLPerf 的结果)。一个流行模型在某种硬件上运行得飞快,并不意味着任意模型在该硬件上都会运行得飞快。可能只是这个模型被过度优化了。
如果你在 GPU 上使用 PyTorch,你可能见过 torch.backends.cudnn.benchmark=True。当它被设置为 True 时,cuDNN autotune 将被启用。cuDNN autotune 在预定的一组选项中搜索执行卷积算子的方式,然后选择最快的方式。cuDNN autotune 尽管有效,但只对卷积算子有效。一个更通用的解决方案是 autoTVM,它是开源编译器栈 TVM 的一部分。autoTVM 处理子图而不仅仅是一个算子,所以它的搜索空间要复杂得多。autoTVM 的工作方式相当复杂,但简单来说:
- 它首先把你的计算图分解成子图。
- 它预测每个子图有多大。
- 它为每个子图分配搜索最佳路径的时间。
- 它把运行每个子图的最佳方式拼接在一起,以执行整个图。
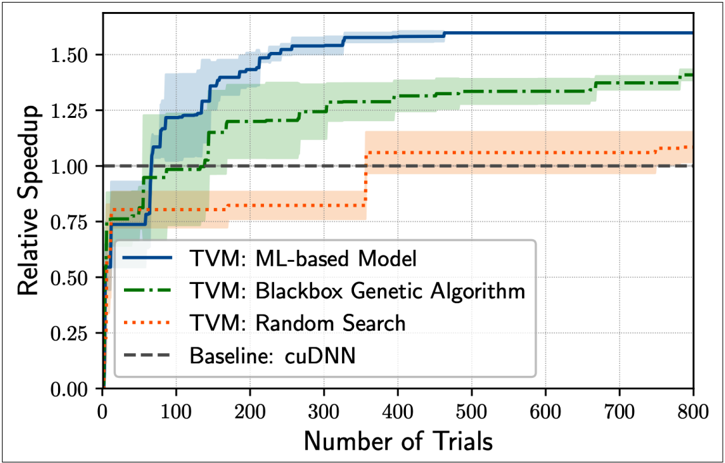
autoTVM 测量它探索的每条路径的实际运行时间,这为它提供了真实数据来训练一个成本模型(cost model),预测未来路径需要多长时间。这种方法的优点是,因为模型是用运行时生成的数据训练的,它可以适应它运行的任何类型的硬件。缺点是成本模型需要更多时间才开始改进。图 7-15 展示了在 NVIDIA TITAN X 上,autoTVM 相比 cuDNN 为 ResNet-50 带来的性能提升。
虽然 ML 驱动的编译器结果令人印象深刻,但它们有一个问题:它们可能很慢。你要遍历所有可能的路径并找到最优化的一条。这个过程可能需要数小时,对复杂的 ML 模型甚至需要数天。然而,这是一次性操作,优化搜索的结果可以被缓存,既用来优化现有模型,也为未来的调优会话提供起点。你为一个硬件后端优化一次模型,然后在同类型硬件的多个设备上运行它。当你有准备投入生产的模型和目标推理硬件时,这种优化是理想的。
图 7-15. autoTVM 相比 cuDNN 在 NVIDIA TITAN X 上为 ResNet-50 实现的加速。autoTVM 大约需要 70 次试验才能超过 cuDNN。来源:Chen 等人 ⁵⁰
浏览器中的 ML
我们一直在讨论编译器如何帮助我们生成机器原生代码,在特定硬件后端上运行模型。然而,通过让代码在浏览器中运行,生成可以在任何硬件后端上运行的代码是可能的。如果你能在浏览器中运行模型,你就能在支持浏览器的任何设备上运行模型:MacBook、Chromebook、iPhone、Android 手机等等。你不需要关心这些设备使用什么芯片。如果 Apple 决定从 Intel 芯片转向 ARM 芯片,那不是你的问题。
说到浏览器,很多人会想到 JavaScript。有些工具可以帮助你把模型编译成 JavaScript,比如 TensorFlow.js、Synaptic 和 brain.js。然而,JavaScript 很慢,而且它作为一种编程语言的能力对于从数据中提取特征这样的复杂逻辑来说有限。
⁵⁰ Chen 等人,“TVM: An Automated End-to-End Optimizing Compiler for Deep Learning。”
一个更有前景的方法是 WebAssembly(WASM)。WASM 是一个开放标准,允许你在浏览器中运行可执行程序。你在 scikit-learn、PyTorch、TensorFlow 或任何你用过的框架中构建模型后,与其把模型编译到特定硬件上运行,不如把模型编译成 WASM。你会得到一个可以直接与 JavaScript 一起使用的可执行文件。
WASM 是我在过去几年中看到的最令人兴奋的技术趋势之一。它性能好、易用,而且生态正在如火如荼地增长。⁵¹ 截至 2021 年 9 月,它得到了全球 93% 设备的支持。⁵²
WASM 的主要缺点是,因为 WASM 在浏览器中运行,它很慢。尽管 WASM 已经比 JavaScript 快得多,但相比在设备上原生运行代码(如 iOS 或 Android 应用)仍然很慢。Jangda 等人的一项研究表明,编译为 WASM 的应用比原生应用平均慢 45%(Firefox 上)到 55%(Chrome 上)。⁵³
小结
恭喜你,你完成了这本书中技术性最强的一章!这一章技术性强,因为部署 ML 模型是一个工程挑战,而不是 ML 挑战。
我们讨论了部署模型的不同方式,比较了在线预测与批量预测,以及边缘上的 ML 与云上的 ML。每种方式都有自己的挑战。在线预测让你的模型对用户偏好的变化反应更灵敏,但你必须担心推理延迟。批量预测是模型生成预测太慢时的一种变通办法,但它让模型不那么灵活。
类似地,在云端做推理很容易设置,但随着网络延迟和云成本变得不切实际。在边缘做推理需要边缘设备有足够的计算能力、内存和电池。
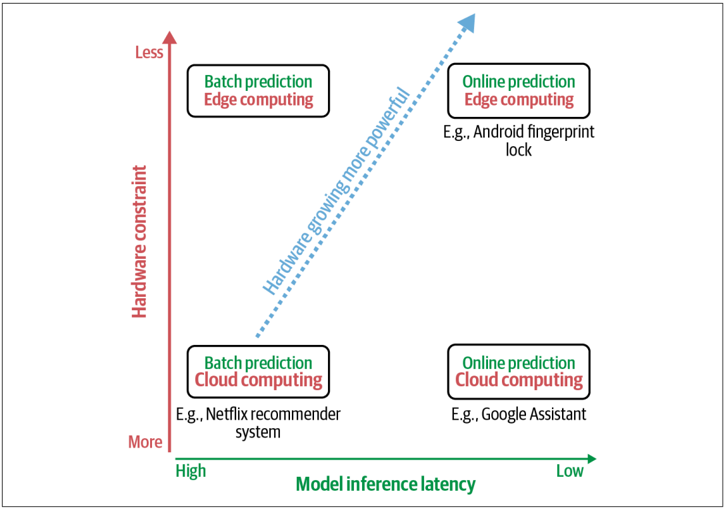
然而,我相信这些挑战中的大多数都是由于 ML 模型所运行的硬件的限制。随着硬件变得更强大并针对 ML 优化,我相信 ML 系统将转向在设备上进行在线预测,如图 7-16 所示。
⁵¹ Wasmer,https://oreil.ly/dTRxr;Awesome Wasm,https://oreil.ly/hlIFb。
⁵² Can I Use _____?,https://oreil.ly/slI05。
⁵³ Abhinav Jangda、Bobby Powers、Emery D. Berger 和 Arjun Guha,“Not So Fast: Analyzing the Performance of WebAssembly vs. Native Code,” USENIX,https://oreil.ly/uVzrX。
图 7-16. 随着硬件变得更加强大,ML 模型将转向在线预测和边缘部署
我以前认为 ML 项目在模型部署后就完成了,我希望本章已经清楚地表明我严重错了。把模型从开发环境移到生产环境会带来一大堆新问题。第一个是如何让模型在生产中保持运行。在下一章,我们将讨论模型在生产中可能如何失败,以及如何持续监控模型以发现问题并尽快解决。