模型开发与离线评估
在第 4 章中,我们讨论了如何为模型创建训练数据;在第 5 章中,我们讨论了如何从训练数据中进行特征工程(feature engineering)。有了初始特征集,我们将进入机器学习系统的机器学习算法部分。对我来说,这一直是最有趣的一步,因为它让我可以摆弄各种算法和技术,甚至是最新的算法和技术。这也是第一步能让我看到自己在数据和特征工程上付出的所有辛苦工作转化为一个系统——系统的输出(预测)可以用来评估我的努力是否成功。
要构建机器学习(machine learning,ML)模型,我们首先需要选择要构建的机器学习模型。市面上有太多机器学习算法,而且还有更多算法在积极研发中。本章首先介绍为你的任务选择最佳算法的六条建议。
接下来的部分讨论模型开发的不同方面,例如调试、实验跟踪与版本管理、分布式训练和 AutoML。
模型开发是一个迭代过程。每完成一次迭代,你都会想将模型的性能与其在之前迭代中的性能进行比较,并评估该迭代是否适合投入生产。本章最后一节专门讨论如何在将模型部署到生产环境之前对其进行评估,涵盖一系列评估技术,包括扰动测试、不变性测试、模型校准和基于切片的评估。
我预计大多数读者已经了解常见的机器学习算法,如线性模型、决策树、k 近邻(k-nearest neighbors)和不同类型的神经网络。本章将讨论围绕这些算法的技术,但不会深入探讨它们的工作原理。由于本章涉及机器学习算法,它对机器学习知识的要求比其他章节高得多。如果你不熟悉这些算法,我建议在阅读本章之前先上一门在线课程或读一本关于机器学习算法的书。想要快速回顾基本机器学习概念的读者,可以看看本书 GitHub 仓库中的"基础机器学习回顾"(Basic ML Reviews)一节。
模型开发与训练
在本节中,我们将讨论帮助你开发和训练模型所必需的各个方面,包括如何为你的问题评估不同的机器学习模型、创建模型集成、实验跟踪与版本管理,以及分布式训练——对于当今模型通常所处的训练规模而言,分布式训练是必需的。最后,我们将以更高级的 AutoML 主题收尾——用机器学习来自动选择最适合你问题的模型。
评估机器学习模型
任何给定问题都有许多可能的解决方案。对于一个可以在解决方案中利用机器学习的任务,你可能会想知道应该使用哪种机器学习算法。例如,你应该从逻辑回归(logistic regression)开始吗——一种你已经熟悉的算法?还是应该尝试一种号称能解决你的问题、代表最新水平的新奇模型?一位资深同事提到,梯度提升树(gradient-boosted trees)过去在这个任务上对她一直很有效——你应该听她的建议吗?
如果你有无限的时间和计算能力,理性的做法是尝试所有可能的解决方案,看看哪个最适合你。然而,时间和计算能力都是有限的资源,你必须在选择模型时讲究策略。
谈到机器学习算法,许多人会想到经典机器学习算法与神经网络(neural network)之分。人们对神经网络,尤其是深度学习(deep learning)有着浓厚的兴趣和大量的媒体报道,这可以理解,因为过去十年人工智能的大部分进步都源于神经网络变得越来越大、越来越深。
这些兴趣和报道可能会给人留下深度学习正在取代经典机器学习算法的印象。然而,尽管深度学习在生产中找到了越来越多的用例,经典机器学习算法并不会消失。许多推荐系统仍然依赖协同过滤(collaborative filtering)和矩阵分解(matrix factorization)。基于树的算法(包括梯度提升树)仍然支撑着许多对延迟有严格要求的分类任务。
即使在部署了神经网络的应用中,经典机器学习算法也仍然被同时使用。例如,神经网络和决策树可能一起用于集成。k 均值聚类(k-means clustering)模型可能被用来提取特征,输入到神经网络中。反过来,预训练神经网络(如 BERT 或 GPT-3)可能被用来生成嵌入(embeddings),输入到逻辑回归模型中。
在为你的问题选择模型时,你并不是从所有可能的模型中挑选,而通常是专注于一组适合你问题的模型。例如,如果你的老板让你构建一个检测有害推文的系统,你就知道这是一个文本分类问题——给定一段文本,判断它是否有害——而文本分类的常见模型包括朴素贝叶斯(naive Bayes)、逻辑回归、循环神经网络(recurrent neural network),以及基于 Transformer 的模型(transformer-based models),如 BERT、GPT 及其变体。
如果你的客户想让你构建一个检测欺诈交易的系统,你就知道这是经典的异常检测(abnormality detection)问题——欺诈交易就是你想检测的异常——而这个问题的常见算法有很多,包括 k 近邻、孤立森林(isolation forest)、聚类(clustering)和神经网络。
对常见机器学习任务及其典型解决方法的了解在这个过程中至关重要。
不同类型的算法需要不同数量的标签,也需要不同数量的计算能力。有些算法训练时间更长,而有些算法做预测的时间更长。非神经网络算法往往比神经网络更具可解释性(例如,哪些特征对一封邮件被分类为垃圾邮件贡献最大)。
在考虑使用什么模型时,重要的不仅是要考虑模型的性能——用准确率(accuracy)、F1 分数(F1 score)、对数损失(log loss)等指标来衡量——还要考虑它的其他属性,比如它需要多少数据、计算量和时间来训练,它的推理延迟(inference latency)是多少,以及可解释性(interpretability)。例如,一个简单的逻辑回归模型可能比一个复杂的神经网络准确率更低,但它开始时需要的标注数据更少,训练速度快得多,部署起来容易得多,而且解释它为什么会做出某些预测也容易得多。
比较机器学习算法超出了本书的范围。无论比较做得多好,一旦新算法出现,它就会过时。早在 2016 年,LSTM-RNN(长短期记忆循环神经网络)风靡一时,是 seq2seq(Sequence-to-Sequence,序列到序列)架构的骨干,支撑着从机器翻译到文本摘要再到文本分类的许多自然语言处理任务。然而,仅仅两年后,循环架构就在自然语言处理任务中被 Transformer 架构大规模取代。
要理解不同的算法,最好的方法是让自己掌握基本的机器学习知识,并对你感兴趣的算法进行实验。为了跟上如此之多新的机器学习技术和模型的步伐,我觉得关注 NeurIPS、ICLR 和 ICML 等机器学习顶级会议上的趋势很有帮助,同时也可以在 Twitter 上关注那些作品信噪比很高的研究人员。
模型选择的六条建议
在不深入讨论不同算法细节的情况下,这里有六条建议,可能有助于你决定接下来该研究哪些机器学习算法。
避开最先进(state-of-the-art)模型陷阱。 在帮助公司和应届毕业生入门机器学习时,我通常不得不花不少时间引导他们不要直接跳进最先进的模型。我能理解为什么人们想要最先进的模型。许多人相信这些模型会是他们问题的最佳解决方案——如果你相信存在一个更新更好的解决方案,为什么要尝试旧的解决方案呢?许多企业领导者也想使用最先进的模型,因为他们想让自己的企业看起来处于前沿。开发人员可能也更乐于上手新模型,而不是日复一日地困在同样的老东西里。
研究人员通常只在学术环境中评估模型,这意味着一个模型是最先进的,通常只意味着它在某些静态数据集上比现有模型表现更好。这并不意味着这个模型对你来说足够快或足够便宜来实现。它甚至不意味着这个模型会在你的数据上比其他模型表现更好。
虽然跟上新技术至关重要,为你的业务评估这些技术也有好处,但解决问题时最重要的事情是找到能够解决该问题的方案。如果有一个解决方案能解决你的问题,而且比最先进的模型便宜得多、简单得多,那就用更简单的方案。
从最简单的模型开始。 Python 之禅(Zen of Python)说"简单优于复杂",这一原则同样适用于机器学习。简单有三个好处。第一,更简单的模型更容易部署,尽早部署模型可以让你验证预测管道与训练管道是否一致。第二,从简单的东西开始,一步一步地添加更复杂的组件,会让你更容易理解你的模型并调试它。第三,最简单的模型可以作为基线(baseline),用来与更复杂的模型进行比较。
最简单的模型并不总是等同于付出努力最少的模型。例如,预训练的 BERT 模型很复杂,但上手所需的努力很少,尤其是如果你使用现成的实现,比如 Hugging Face 的 Transformer 库中的实现。在这种情况下,使用复杂的解决方案并不是一个坏主意,因为这个解决方案的社区已经足够成熟,能帮你解决可能遇到的任何问题。不过,你可能仍然想用更简单的方案做实验,以确保预训练 BERT 在你的问题上确实比那些更简单的方案更好。预训练 BERT 可能上手成本低,但改进它可能成本相当高。而如果你从一个更简单的模型开始,改进你的模型会有很大的空间。
避免在模型选择中带入人类偏见。 想象一下,你团队中的一位工程师被分配了一项任务:评估哪个模型更适合你的问题——梯度提升树还是预训练 BERT 模型。两周后,这位工程师宣布,最好的 BERT 模型比最好的梯度提升树高出 5%。你的团队决定采用预训练 BERT 模型。
然而,几个月后,一位经验丰富的工程师加入了你的团队。她决定再研究一下梯度提升树,结果发现这次最好的梯度提升树优于你目前在生产环境中的预训练 BERT 模型。发生了什么?
评估模型时存在很多人类偏见。评估一个机器学习架构的部分过程,是用不同的特征和不同的超参数集做实验,以找到该架构的最佳模型。如果一位工程师对某个架构更兴奋,他们很可能会花更多时间做实验,这可能会导致该架构的模型表现更好。
在比较不同架构时,重要的是在可比较的设置下进行比较。如果你为一个架构跑了 100 次实验,那么只为你拿来对比的架构跑几次实验是不公平的。你可能也需要为另一个架构跑 100 次实验。
因为一个模型架构的性能在很大程度上取决于它被评估的环境——例如任务、训练数据、测试数据、超参数等——所以很难断言一个模型架构优于另一个架构。这种说法在某个环境中可能成立,但不太可能在所有可能的环境中成立。
评估"现在表现好"与"以后表现好"。 现在最好的模型并不总意味着两个月后仍然是最好的模型。例如,基于树的模型现在可能效果更好,因为你还没有大量数据,但两个月后,你也许能把训练数据量翻倍,而你的神经网络可能会表现好得多¹。
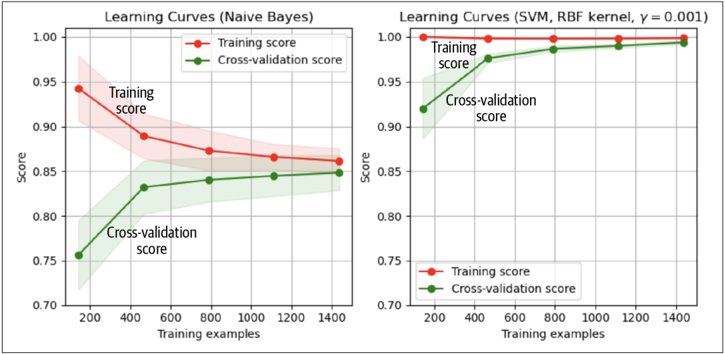
估算你的模型性能如何随更多数据变化的一个简单方法是使用学习曲线(learning curve)。模型的学习曲线是将其性能——例如训练损失、训练准确率、验证准确率——相对于其使用的训练样本数量绘制而成的图,如图 6-1 所示。学习曲线不能帮你精确估算从更多训练数据中能获得多少性能提升,但它能让你了解:更多的训练数据到底是否可能带来任何性能提升。
1 Andrew Ng 有一场很棒的讲座,他在其中解释说,如果学习算法遭受高偏差(high bias)之苦,那么单纯获得更多训练数据不会有太大帮助;而如果学习算法遭受高方差(high variance)之苦,那么获得更多训练数据很可能会有所帮助。
图 6-1. 朴素贝叶斯模型和 SVM 模型的学习曲线。来源:scikit-learn
我遇到过一种情况:一个团队在构建推荐系统时,将简单神经网络与协同过滤模型进行对比。在离线评估两个模型时,协同过滤模型表现更好。然而,简单神经网络可以用每个到来的样本更新自己,而协同过滤必须查看所有数据才能更新其底层矩阵。该团队决定同时部署协同过滤模型和简单神经网络。他们用协同过滤模型为用户做预测,并在生产环境中用新的、不断到来的数据持续训练简单神经网络。两周后,简单神经网络就超越了协同过滤模型。
在评估模型时,你可能要考虑它们在不远的将来的改进潜力,以及实现这些改进的难易程度。
评估权衡取舍。 选择模型时,你必须做出很多权衡。理解在你的机器学习系统性能中什么更重要,将帮助你选择最合适的模型。
一个经典的权衡例子是假阳性(false positive)与假阴性(false negative)之间的权衡。减少假阳性的数量可能会增加假阴性的数量,反之亦然。在假阳性比假阴性更危险的任务中,比如指纹解锁(未经授权的人不应被分类为已授权并给予访问权限),你可能更倾向于一个假阳性更少的模型。同样,在假阴性比假阳性更危险的任务中,比如 COVID-19 筛查(COVID-19 患者不应被分类为未感染 COVID-19),你可能更倾向于一个假阴性更少的模型。
权衡的另一个例子是计算需求与准确率——更复杂的模型可能带来更高的准确率,但可能需要更强大的机器(例如 GPU 而不是 CPU)才能以可接受的推理延迟生成预测。许多人还关心可解释性与性能之间的权衡。更复杂的模型可以提供更好的性能,但它的结果可解释性更差。
理解模型的假设。 统计学家 George Box 在 1976 年说过:“所有模型都是错的,但有些是有用的。“现实世界复杂得难以驾驭,模型只能通过假设来近似。每一个模型都带有自己的假设。理解一个模型做出了哪些假设,以及我们的数据是否满足这些假设,可以帮助你评估哪个模型最适合你的用例。
下面是一些常见的假设。这并不是一份详尽的清单,只是举例说明:
预测假设
每一个旨在根据输入 \(X\) 预测输出 \(Y\) 的模型都假设:基于 \(X\) 预测 \(Y\) 是可能的。
IID(独立同分布)
神经网络假设样本是独立同分布的(independent and identically distributed),这意味着所有样本都是独立地从同一个联合分布中抽取的。
平滑性(Smoothness)
每一种监督式机器学习方法都假设存在一组函数可以将输入转换为输出,使得相似的输入被转换为相似的输出。如果输入 \(X\) 产生输出 \(Y\),那么接近 \(X\) 的输入将产生与 \(Y\) 成比例地接近的输出。
可计算性(Tractability)
设 \(X\) 为输入,\(Z\) 为 \(X\) 的潜在表示。每个生成模型都假设计算概率 \(P(Z|X)\) 是可行的。
边界(Boundaries)
线性分类器假设决策边界是线性的。
条件独立(Conditional independence)
朴素贝叶斯分类器假设给定类别后,属性值彼此独立。
正态分布(Normally distributed)
许多统计方法假设数据呈正态分布。
集成(Ensembles)
在考虑问题的机器学习解决方案时,你可能想从一个只包含单个模型的系统开始(本章前面已经讨论了为你的问题选择单个模型的过程)。开发出单个模型后,你可能会考虑如何继续提高它的性能。一种一直能带来性能提升的方法是使用多个模型的集成(ensemble)而不是单个模型来做预测。集成中的每个模型被称为基学习器(base learner)。例如,对于预测一封邮件是垃圾邮件(SPAM)还是非垃圾邮件(NOT SPAM)的任务,你可能有三个不同的模型。每封邮件的最终预测结果是三个模型的多数投票。因此,如果至少有两个基学习器输出 SPAM,该邮件就会被分类为 SPAM。
截至 2021 年 8 月,2021 年 Kaggle 竞赛的 22 个获奖解决方案中有 20 个使用了集成²。截至 2022 年 1 月,斯坦福问答数据集 SQuAD 2.0 排名前 20 的解决方案都是集成,如图 6-2 所示。
集成方法在生产中不太受青睐,因为集成部署起来更复杂,维护起来也更难。然而,在那些微小的性能提升就能带来巨大财务收益的任务中(比如预测广告点击率),集成仍然很常见。
2 我浏览了 Farid Rashidi 的"Kaggle Solutions"网页上列出的获奖解决方案。其中一个解决方案使用了 33 个模型(Giba,“1st Place - Winner Solution - Gilberto Titericz and Stanislav Semenov”,Kaggle,https://oreil.ly/z5od8)。
图 6-2. 截至 2022 年 1 月,SQuAD 2.0 排名前 20 的解决方案全部是集成
| 排名 | 模型 | EM | F1 |
|---|---|---|---|
| 人类表现 斯坦福大学(Rajpurkar & Jia et al. ‘18) | 86.831 | 89.452 | |
| 1 Jun 04, 2021 | IE-Net(集成)RICOH_SRCB_DML | 90.939 | 93.214 |
| 2 Feb 21, 2021 | FPNet(集成)Ant Service Intelligence Team | 90.871 | 93.183 |
| 3 May 16, 2021 | IE-NetV2(集成)RICOH_SRCB_DML | 90.860 | 93.100 |
| 4 Apr 06, 2020 | SA-Net on Albert(集成)QIANXIN | 90.724 | 93.011 |
| 5 May 05, 2020 | SA-Net-V2(集成)QIANXIN | 90.679 | 92.948 |
| 5 Apr 05, 2020 | Retro-Reader(集成)上海交通大学 http://arxiv.org/abs/2001.09694 | 90.578 | 92.978 |
| 5 Feb 05, 2021 | FPNet(集成)YuYang | 90.600 | 92.899 |
| 6 Apr 18, 2021 | TransNets + SFVerifier + SFEnsembler(集成)Senseforth Al Research | 90.487 | 92.894 |
我们将通过一个例子来直观理解为什么集成有效。想象你有三个垃圾邮件分类器,每个的准确率都是 70%。假设每个分类器对每封邮件做出正确预测的概率相同,并且这三个分类器互不相关,我们将证明:对这三个分类器取多数投票,我们可以得到 78.4% 的准确率。
对于每封邮件,每个分类器有 70% 的概率是正确的。如果至少有两个分类器正确,集成就是正确的。表 6-1 显示了给定一封邮件时集成各种可能结果的概率。这个集成的准确率为 0.343 + 0.441 = 0.784,即 78.4%。
表 6-1. 对三个分类器取多数投票的集成的可能结果
| 三个模型的输出 | 概率 | 集成的输出 |
|---|---|---|
| 三个都正确 | 0.7 × 0.7 × 0.7 = 0.343 | 正确 |
| 只有两个正确 | (0.7 × 0.7 × 0.3) × 3 = 0.441 | 正确 |
| 只有一个正确 | (0.3 × 0.3 × 0.7) × 3 = 0.189 | 错误 |
| 全都不正确 | 0.3 × 0.3 × 0.3 = 0.027 | 错误 |
这个计算只有在集成中的分类器互不相关时才成立。如果所有分类器完全相关——三个分类器对每封邮件都做出相同的预测——那么集成的准确率将与每个单独分类器相同。创建集成时,基学习器之间的相关性越低,集成效果就越好。因此,为集成选择差异很大的模型类型是很常见的。例如,你可以创建一个集成,包含一个 Transformer 模型、一个循环神经网络和一个梯度提升树。
创建集成有三种方式:Bagging、Boosting 和 Stacking。除了有助于提升性能之外,根据几篇综述论文,Boosting 和 Bagging 等集成方法配合重采样(resampling),已被证明有助于处理不平衡数据集³。我们将逐一介绍这三种方法,先从 Bagging 开始。
Bagging(自助聚合)
Bagging 是 bootstrap aggregating(自助聚合)的缩写,旨在提高机器学习算法的训练稳定性和准确率⁴。它降低了方差,有助于避免过拟合。
给定一个数据集,不是在整个数据集上训练一个分类器,而是通过有放回抽样(sampling with replacement)创建不同的数据集,称为自助样本(bootstraps),并在每个自助样本上训练一个分类或回归模型。有放回抽样确保每个自助样本都是独立于其他样本创建的。图 6-3 展示了 Bagging 的示意图。
3 Mikel Galar、Alberto Fernandez、Edurne Barrenechea、Humberto Bustince 和 Francisco Herrera,“A Review on Ensembles for the Class Imbalance Problem: Bagging-, Boosting-, and Hybrid-Based Approaches,” IEEE Transactions on Systems, Man, and Cybernetics, Part C (Applications and Reviews) 42, no. 4(2012 年 7 月):463-84,https://oreil.ly/ZBlgE;G. Rekha、Amit Kumar Tyagi 和 V. Krishna Reddy,“Solving Class Imbalance Problem Using Bagging, Boosting Techniques, With and Without Using Noise Filtering Method,” International Journal of Hybrid Intelligent Systems 15, no. 2(2019 年 1 月):67-76,https://oreil.ly/hchzU。
4 这里的训练稳定性指训练损失的波动更小。
图 6-3. Bagging 示意图。来源:改编自 Sirakorn 的图片
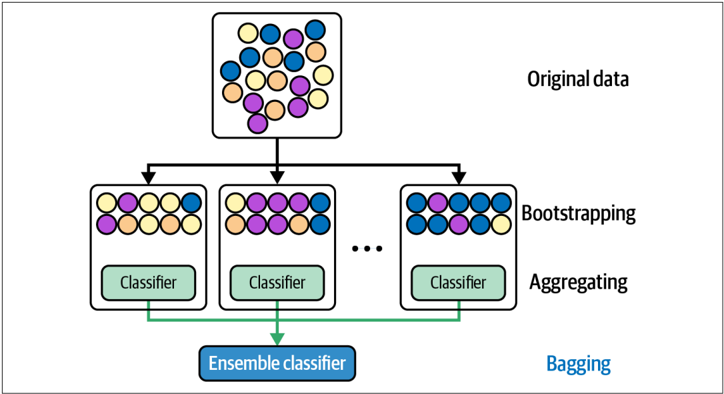
如果问题是分类问题,最终预测由所有模型的多数投票决定。例如,如果 10 个分类器投票 SPAM,6 个模型投票 NOT SPAM,最终预测就是 SPAM。
如果问题是回归问题,最终预测是所有模型预测的平均值。
Bagging 通常能改进不稳定的方法,如神经网络、分类回归树和线性回归中的子集选择。然而,它可能会轻微降低 k 近邻等稳定方法的性能⁵。
随机森林(random forest)就是 Bagging 的一个例子。随机森林是由 Bagging 和特征随机性(feature randomness)共同构建的一组决策树,其中每棵树只能从特征的随机子集中挑选特征来使用。
Boosting(提升)
Boosting 是一族迭代式集成算法,将弱学习器(weak learners)转化为强学习器。该集成中的每个学习器都在同一组样本上训练,但样本在各次迭代中的权重不同。因此,后续的弱学习器会更关注之前的弱学习器错误分类的样本。图 6-4 展示了 Boosting 的示意图,它涉及以下步骤。
5 Leo Breiman,“Bagging Predictors,” Machine Learning 24(1996):123-40,https://oreil.ly/adzJu。
图 6-4. Boosting 示意图。来源:改编自 Sirakorn 的图片
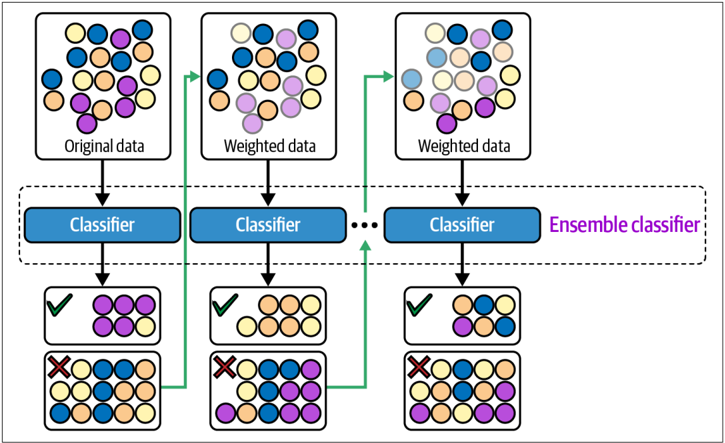
- 首先在原始数据集上训练第一个弱分类器。
- 根据第一个分类器对样本的分类效果对样本重新加权,例如,被错误分类的样本被赋予更高的权重。
- 在这个重新加权后的数据集上训练第二个分类器。你的集成现在由第一个和第二个分类器组成。
- 根据集成对样本的分类效果对样本加权。
- 在这个重新加权后的数据集上训练第三个分类器。把第三个分类器加入集成。
- 根据需要重复任意多次迭代。
- 将现有的分类器加权组合成最终的强分类器——训练误差更小的分类器权重更高。
Boosting 算法的一个例子是梯度提升机(gradient boosting machine,GBM),它通常从弱决策树中产生一个预测模型。它像其他 Boosting 方法一样以分阶段的方式构建模型,并通过允许优化任意可微损失函数来推广这些方法。
XGBoost 是 GBM 的一个变体,曾经是许多机器学习竞赛获胜团队的首选算法⁶。它被用于从分类、排序到希格斯玻色子发现等广泛的任务⁷。然而,许多团队现在转而选择 LightGBM——一个支持并行学习的分布式梯度提升框架,它通常能在大数据集上实现更快的训练。
Stacking(堆叠)
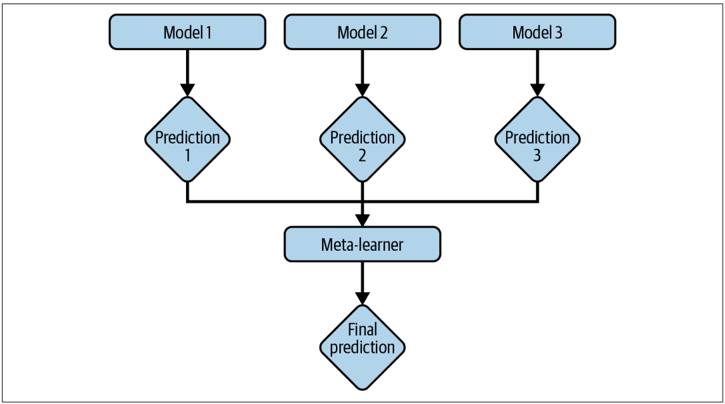
Stacking 是指先从训练数据中训练基学习器,然后创建一个元学习器(meta-learner),将基学习器的输出组合起来生成最终预测,如图 6-5 所示。元学习器可以简单到只是一个启发式规则:取所有基学习器的多数投票(对于分类任务)或平均投票(对于回归任务)。它也可以是另一个模型,例如逻辑回归模型或线性回归模型。
图 6-5. 由三个基学习器组成的堆叠集成的可视化
关于如何创建集成的更多精彩建议,请参阅 Kaggle 传奇团队之一 MLWave 编写的出色的集成指南。
6 “Machine Learning Challenge Winning Solutions,” https://oreil.ly/YjS8d。
7 Tianqi Chen 和 Tong He,“Higgs Boson Discovery with Boosted Trees,” Proceedings of Machine Learning Research 42(2015):69-80,https://oreil.ly/ysBYO。
实验跟踪与版本管理
在模型开发过程中,你经常需要试验许多架构和许多不同的模型,为你的问题选择最好的一个。有些模型可能看起来很相似,只在某一个超参数上有所不同——例如一个模型使用 0.003 的学习率,另一个模型使用 0.002 的学习率——但它们的性能却截然不同。跟踪重建一个实验所需的全部定义及其相关工件(artifact)非常重要。工件是实验过程中生成的文件——工件的例子可以包括展示损失曲线、评估损失图的文件、日志,或模型在整个训练过程中的中间结果。这使你能够比较不同的实验,选择最适合你需求的实验。比较不同的实验还可以帮助你理解微小的变化如何影响模型的性能,这反过来又让你更深入地了解你的模型是如何工作的。
跟踪实验进展和结果的过程称为实验跟踪(experiment tracking)。记录实验的所有细节以便日后可能重建实验或与其他实验进行比较的过程称为版本管理(versioning)。这两者相辅相成。许多最初定位为实验跟踪工具的工具,如 MLflow 和 Weights & Biases,已经发展出版本管理功能。许多最初定位为版本管理工具的工具,如 DVC,也加入了实验跟踪功能。
实验跟踪
训练机器学习模型的一大部分工作是照看学习过程。训练过程中会出现许多问题,包括损失不下降、过拟合(overfitting)、欠拟合(underfitting)、权重值波动、神经元死亡(dead neurons)和内存耗尽。跟踪训练过程中发生的事情很重要,不仅是为了发现和解决这些问题,也是为了评估你的模型是否学到了有用的东西。
当我刚开始接触机器学习时,别人告诉我要跟踪的只有损失和速度。快进几年,人们跟踪的东西太多了,他们的实验跟踪面板看起来既漂亮又吓人。下面只是你在每个实验的训练过程中可能需要考虑跟踪的内容的一小部分清单:
- 对应训练划分(train split)和每个评估划分(eval split)的损失曲线。
- 你在所有非测试划分上关心的模型性能指标,如准确率、F1、困惑度(perplexity)。
- 相应样本、预测和真实标签(ground truth label)的日志。这对于临时分析和合理性检查很有用。
- 模型的速度,以每秒步数来衡量,或者,如果你的数据是文本,以每秒处理的 token 数来衡量。
- 系统性能指标,如内存使用量和 CPU/GPU 利用率。它们对于识别瓶颈和避免浪费系统资源很重要。
- 任何参数和超参数随时间变化的值——如果这些变化会影响模型性能的话,例如,如果你使用学习率调度(learning rate schedule),就要跟踪学习率;梯度范数(gradient norms,包括全局的和逐层的),尤其是当你在裁剪梯度范数时;以及权重范数,尤其是当你在做权重衰减(weight decay)时。
理论上,尽可能多地跟踪所有东西并不是一个坏主意。大多数时候,你可能不需要查看其中的大部分内容。但当事情发生时,其中一项或多项可能会给你线索,帮助你理解和/或调试模型。总的来说,跟踪能让你对模型的状态具有可观测性(observability)⁸。然而,在实践中,由于当前工具的局限性,跟踪太多东西可能会让人不堪重负,而跟踪不太重要的东西可能会分散你对跟踪真正重要内容的注意力。
实验跟踪支持跨实验比较。通过观察某个组件的特定变化如何影响模型性能,你可以对那个组件的作用有所了解。
跟踪实验的一个简单方法是自动复制实验所需的全部代码文件,并记录所有输出及其时间戳⁹。然而,使用第三方实验跟踪工具可以给你漂亮的仪表盘,并让你与同事分享你的实验。
版本管理
想象一下这个场景。你和你的团队花了最后几周时间调整你的模型,其中一次运行终于显示出有希望的结果。你想把它用于更广泛的测试,于是你试图用记在某处的超参数集复现它,结果却发现结果并不完全相同。你记得在这一次运行和下一次运行之间对代码做了一些修改,于是你尽力凭记忆撤销这些修改,因为你那粗心大意的过去自我当时认为这个改动太小了,不值得提交。但你仍然无法复现那个有希望的结果,因为可能做出修改的方式太多了。
8 我们将在第 8 章深入介绍可观测性。
9 我还在等待一个能与 Git 提交和 DVC 提交集成的实验跟踪工具。
如果你对机器学习实验做了版本管理,这个问题本可以避免。机器学习系统一部分是代码,一部分是数据,所以你不仅需要对代码进行版本管理,还需要对数据进行版本管理。代码版本管理或多或少已经成为行业标准。然而,在这一点上,数据版本管理就像用牙线清洁牙齿——每个人都同意这是件好事,但很少有人去做。
数据版本管理具有挑战性有几个原因。一个原因是,由于数据通常比代码大得多,我们不能用人们通常用来做代码版本管理的策略来做数据版本管理。
例如,代码版本管理通过跟踪对代码库所做的所有更改来完成。一次更改称为一个 diff(difference 的缩写)。每次更改都通过逐行比较来衡量。一行代码通常足够短,逐行比较才有意义。然而,数据的一行,尤其是如果它以二进制格式存储,可能无限长。说"这一行 1,000,000 个字符与另一行 1,000,000 个字符不同"并不会有多大帮助。
代码版本管理工具通过保留所有旧文件的副本,允许用户回退到代码库的先前版本。然而,所使用的数据集可能非常大,多次复制它可能不可行。
代码版本管理工具通过在每个人的本地机器上复制代码库,允许多人同时处理同一个代码库。然而,数据集可能放不进一台本地机器。
其次,在对数据进行版本管理时,究竟什么构成 diff,仍然存在困惑。diff 是指数据仓库中任何文件内容的变化,还是仅指文件被删除或添加时,抑或是整个仓库的校验和发生变化时?
截至 2021 年,DVC 等数据版本管理工具只在总目录的校验和发生变化,以及文件被删除或添加时才登记 diff。
另一个困惑是如何解决合并冲突:如果开发人员 1 用数据版本 X 训练模型 A,开发人员 2 用数据版本 Y 训练模型 B,那么合并数据版本 X 和 Y 来创建 Z 是没有意义的,因为没有与 Z 对应的模型。
第三,如果你使用用户数据训练模型,通用数据保护条例(General Data Protection Regulation,GDPR)等法规可能会使对这些数据进行版本管理变得复杂。例如,法规可能强制要求你在用户提出请求时删除用户数据,这使得在法律上不可能恢复你数据的旧版本。
激进的实验跟踪和版本管理有助于可复现性(reproducibility),但不能保证可复现性。你使用的框架和硬件可能会给实验结果引入非确定性¹⁰,使得在不完全了解实验运行环境的情况下不可能复现实验结果。
我们现在不得不运行这么多实验来找到最好的模型,这是我们把机器学习当作黑箱的结果。因为我们无法预测哪种配置效果最好,所以不得不用多种配置做实验。然而,我希望随着领域的发展,我们会对不同的模型有更多的理解,能够推理出什么模型效果最好,而不是运行成百上千次实验。
调试机器学习模型
调试是开发任何软件都固有的一部分。机器学习模型也不例外。调试从来都不好玩,而调试机器学习模型可能尤其令人沮丧,原因有三。
第一,机器学习模型会静默失败(fail silently),这个话题我们将在第 8 章深入讨论。代码能编译。损失像预期的那样下降。调用了正确的函数。预测也做出来了,但预测是错误的。开发人员没有注意到错误。更糟的是,用户也没有注意到,并且像应用正常运行一样使用这些预测。
第二,即使你认为自己找到了 bug,验证 bug 是否已修复也可能慢得令人沮丧。调试传统软件程序时,你可能可以对有问题的代码进行修改,并立即看到结果。然而,修改机器学习模型时,你可能必须重新训练模型,并等待它收敛才能看到 bug 是否已修复,这可能需要几个小时。在某些情况下,甚至在模型部署给用户之前,你都无法确定 bug 是否已修复。
第三,调试机器学习模型很难,因为它们的跨职能复杂性。一个机器学习系统中有很多组件:数据、标签、特征、机器学习算法、代码、基础设施等。这些不同的组件可能由不同的团队负责。例如,数据由数据工程师管理,标签由领域专家管理,机器学习算法由数据科学家管理,基础设施由机器学习工程师或机器学习平台团队管理。当错误发生时,它可能是由这些组件中的任何一个或它们的组合造成的,因此很难知道该去哪里查找,或者该由谁来排查。
10 值得注意的例子包括 CUDA 中的原子操作,其中操作的非确定性顺序会导致各次运行之间的浮点舍入误差不同。
以下是一些可能导致机器学习模型失败的原因:
理论约束
如前所述,每个模型都对它所使用的数据和特征有自己的假设。一个模型可能会失败,因为它所学习的数据不符合其假设。例如,你对决策边界不是线性的数据使用了线性模型。
模型实现不佳
模型可能非常适合数据,但 bug 出在模型的实现中。例如,如果你使用 PyTorch,你可能忘记在评估期间停止梯度更新。模型的组件越多,可能出错的地方就越多,也就越难找出哪里出了问题。然而,随着模型越来越商品化,越来越多的公司使用现成模型,这个问题正在变得不那么严重。
超参数选择不当
使用同一个模型,一组超参数可以给你最先进的结果,而另一组超参数可能使模型永远无法收敛。模型非常适合你的数据,实现也是正确的,但一组糟糕的超参数可能使你的模型毫无用处。
数据问题
数据收集和预处理过程中有很多事情可能出错,导致你的模型表现不佳,例如数据样本和标签配对错误、标签有噪声、使用过时的统计量做特征归一化,等等。
特征选择不当
你的模型可以学习的特征可能有很多。特征太多可能导致你的模型过拟合训练数据或造成数据泄漏(data leakage)。特征太少可能缺乏预测能力,无法让模型做出好的预测。
调试既应该是预防性的,也应该是治疗性的。你应该有健康的实践来最大限度地减少 bug 滋生的机会,也要有一套检测、定位和修复 bug 的流程。坚持遵循最佳实践和调试流程,对于开发、实现和部署机器学习模型至关重要。
遗憾的是,机器学习中仍然没有科学的调试方法。然而,经验丰富的机器学习工程师和研究人员发表过许多久经考验的调试技术。下面是其中的三种。有兴趣了解更多内容的读者可以看看 Andrej Karpathy 的精彩博文《训练神经网络的秘诀》(A Recipe for Training Neural Networks)。
从简单开始,逐步添加更多组件
从最简单的模型开始,然后慢慢添加更多组件,看看它是帮助还是损害性能。例如,如果你想构建一个循环神经网络(recurrent neural network,RNN),先只用一个 RNN 单元层级,然后再堆叠多个或添加更多正则化。如果你想使用类似 BERT 的模型(Devlin 等人,2018),它同时使用掩码语言模型(masked language model,MLM)和下一句预测(next sentence prediction,NSP)损失,你可能想先只使用 MLM 损失,然后再添加 NSP 损失。
目前,许多人一开始会克隆一个最先进模型的开源实现,然后接入自己的数据。万一它成功了,那很好。但如果不成功,调试这个系统就非常困难,因为问题可能出在模型众多组件中的任何一个。
过拟合单个批次
在你有了模型的简单实现之后,尝试过拟合一小部分训练数据,并在同一数据上运行评估,确保损失达到尽可能小的值。如果是图像识别任务,就在 10 张图片上过拟合,看看能否让准确率达到 100%;如果是机器翻译任务,就在 100 个句子上过拟合,看看能否让 BLEU 分数接近 100。如果它连少量数据都无法过拟合,那你的实现可能有问题。
设置随机种子
导致模型随机性的因素太多了:权重初始化、dropout、数据打乱等。随机性使不同实验之间的结果难以比较——你不知道性能的变化是因为模型的变化还是因为随机种子不同。设置随机种子可以确保不同运行之间的一致性。它还可以让你复现错误,也让其他人复现你的结果。
分布式训练
随着模型变得越来越大、越来越消耗资源,公司更加关心大规模训练¹¹。可扩展性方面的专业知识很难获得,因为它需要经常性地使用大规模计算资源。可扩展性是一个值得用一系列书籍来讨论的话题。本节介绍一些值得注意的问题,以突出大规模机器学习面临的挑战,并为你相应地规划项目资源提供一个框架。
使用放不进内存的数据来训练模型是很常见的。在处理医学数据(如 CT 扫描或基因组序列)时尤其常见。如果你在为训练大型语言模型的团队工作(比如 OpenAI、Google、NVIDIA、Cohere),文本数据也可能出现这种情况。
当你的数据放不进内存时,你的预处理算法(例如零中心化、归一化、白化)、打乱和批处理数据都需要在核外(out of core)并行运行¹²。当你的一个数据样本很大时,例如一台机器一次只能处理几个样本,你可能只能用很小的批大小(batch size),这会导致基于梯度下降的优化不稳定。
在某些情况下,一个数据样本大到连内存都放不下,你将不得不使用类似梯度检查点(gradient checkpointing)的技术——一种利用内存占用与计算之间的权衡,让你的系统用更少的内存做更多计算的技巧。根据开源包 gradient-checkpointing 作者的说法,“对于前馈模型,我们能够把比原来大 10 倍以上的模型放进 GPU,而计算时间只增加 20%“¹³。即使单个样本能放进内存,使用检查点也能让你在批次中放入更多样本,这可能让你的模型训练得更快。
数据并行
在多台机器上训练机器学习模型现在已成为常态。现代机器学习框架支持的最常见的并行化方法是数据并行(data parallelism):你把数据拆分到多台机器上,在所有这些机器上训练你的模型,并累加梯度。这引出了几个问题。
11 对于服务大量用户的产品,你还需要关心模型服务(serving)的可扩展性,这超出了机器学习项目的范围,因此本书不涉及。
12 根据维基百科,“核外算法(out-of-core algorithms)是为处理太大而无法一次放入计算机主内存的数据而设计的算法”(“External memory algorithm"词条,https://oreil.ly/apv5m)。
13 Tim Salimans、Yaroslav Bulatov 及贡献者,gradient-checkpointing 仓库,2017 年,https://oreil.ly/GTUgC。
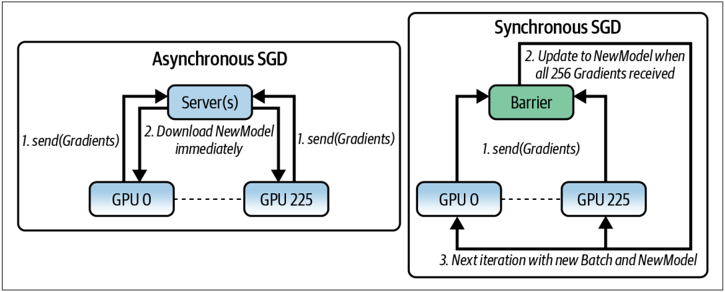
一个具有挑战性的问题是如何准确有效地累加来自不同机器的梯度。由于每台机器都会产生自己的梯度,如果你的模型等待所有机器完成一次运行——同步随机梯度下降(synchronous stochastic gradient descent,同步 SGD)——掉队者(stragglers)会导致整个系统变慢,浪费时间和资源¹⁴。掉队者问题会随着机器数量的增加而加剧,因为工人(worker)越多,在给定迭代中至少有一个工人运行异常缓慢的可能性就越大。不过,已经有很多算法能有效解决这个问题¹⁵。
如果你的模型分别用每台机器的梯度更新权重——异步 SGD——梯度陈旧(gradient staleness)可能成为一个问题,因为一台机器的梯度已经在另一台机器的梯度到来之前改变了权重¹⁶。
同步 SGD 和异步 SGD 之间的区别如图 6-6 所示。
图 6-6. 数据并行中的同步 SGD 与异步 SGD。来源:改编自 Jim Dowling 的图片¹⁷
14 Dipankar Das、Sasikanth Avancha、Dheevatsa Mudigere、Karthikeyan Vaidynathan、Srinivas Sridharan、Dhiraj Kalamkar、Bharat Kaul 和 Pradeep Dubey,“Distributed Deep Learning Using Synchronous Stochastic Gradient Descent,” arXiv,2016 年 2 月 22 日,https://oreil.ly/ma8Y6。
15 Jianmin Chen、Xinghao Pan、Rajat Monga、Samy Bengio 和 Rafal Jozefowicz,“Revisiting Distributed Synchronous SGD,” ICLR 2017,https://oreil.ly/dzVZ5;Matei Zaharia、Andy Konwinski、Anthony D. Joseph、Randy Katz 和 Ion Stoica,“Improving MapReduce Performance in Heterogeneous Environments,” 8th USENIX Symposium on Operating Systems Design and Implementation,https://oreil.ly/FWswd;Aaron Harlap、Henggang Cui、Wei Dai、Jinliang Wei、Gregory R. Ganger、Phillip B. Gibbons、Garth A. Gibson 和 Eric P. Xing,“Addressing the Straggler Problem for Iterative Convergent Parallel ML”(SoCC ‘16,加利福尼亚州圣克拉拉,2016 年 10 月 5-7 日),https://oreil.ly/wZgOO。
16 Jeffrey Dean、Greg Corrado、Rajat Monga、Kai Chen、Matthieu Devin、Mark Mao、Marc’aurelio Ranzato 等人,“Large Scale Distributed Deep Networks,” NIPS 2012,https://oreil.ly/EWPun。
17 Jim Dowling,“Distributed TensorFlow,” O’Reilly Media,2017 年 12 月 19 日,https://oreil.ly/VYlOP。
理论上,异步 SGD 会收敛,但需要的步数比同步 SGD 多。然而,在实践中,当权重数量很大时,梯度更新往往是稀疏的,这意味着大多数梯度更新只修改一小部分参数,来自不同机器的两次梯度更新修改相同权重的可能性较小。当梯度更新稀疏时,梯度陈旧就不再是什么大问题,同步和异步 SGD 的模型收敛情况相似¹⁸。
另一个问题是,把你的模型分布到多台机器上可能导致批大小非常大。如果一台机器处理 1,000 的批大小,那么 1,000 台机器处理的批大小就是 1M(OpenAI 的 GPT-3 175B 在 2020 年使用的批大小为 3.2M)¹⁹。把计算过度简化:如果在一台机器上训练一个 epoch 需要 1M 步,那么在 1,000 台机器上训练可能只需要 1,000 步。一个直观的做法是调大学习率,以适应每一步更多的学习,但我们也不能把学习率调得太大,因为它会导致收敛不稳定。在实践中,把批大小增加到超过某一点后,收益会递减²⁰。
最后但同样重要的是,在相同的模型设置下,主工人(main worker)有时使用的资源比其他工人多得多。如果是这种情况,为了充分利用所有机器,你需要想办法在它们之间平衡工作负载。最简单但并非最有效的方法是,在主工人上使用较小的批大小,在其他工人上使用较大的批大小。
模型并行
使用数据并行时,每个工人都有整个模型的完整副本,并为其模型副本完成所有必要的计算。模型并行(model parallelism)是指模型的不同组件在不同的机器上训练,如图 6-7 所示。例如,机器 0 处理前两层的计算,机器 1 处理后两层,或者一些机器处理前向传播,另一些机器处理后向传播。
18 Feng Niu、Benjamin Recht、Christopher Ré 和 Stephen J. Wright,“Hogwild!: A Lock-Free Approach to Parallelizing Stochastic Gradient Descent,” 2011 年,https://oreil.ly/sAEbv。
19 Tom B. Brown、Benjamin Mann、Nick Ryder、Melanie Subbiah、Jared Kaplan、Prafulla Dhariwal、Arvind Neelakantan 等人,“Language Models Are Few-Shot Learners,” arXiv,2020 年 5 月 28 日,https://oreil.ly/qjg2S。
20 Sam McCandlish、Jared Kaplan、Dario Amodei 和 OpenAI Dota Team,“An Empirical Model of Large-Batch Training,” arXiv,2018 年 12 月 14 日,https://oreil.ly/mcjbV;Christopher J. Shallue、Jaehoon Lee、Joseph Antognini、Jascha Sohl-Dickstein、Roy Frostig 和 George E. Dahl,“Measuring the Effects of Data Parallelism on Neural Network Training,” Journal of Machine Learning Research 20(2019):1-49,https://oreil.ly/YAEOM。
图 6-7. 数据并行与模型并行。来源:改编自 Jure Leskovec 的图片²¹
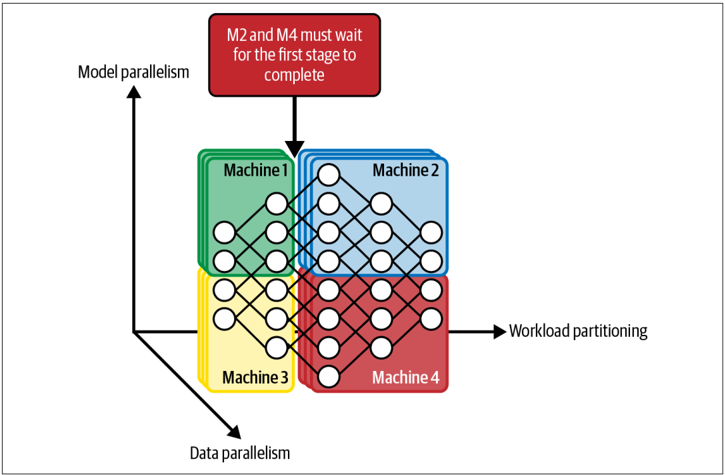
模型并行可能具有误导性,因为在某些情况下,并行并不意味着不同机器上模型的不同部分被并行执行。例如,如果你的模型是一个巨大的矩阵,并且该矩阵被拆分成两半放在两台机器上,那么这两半可能会被并行执行。然而,如果你的模型是一个神经网络,你把第一层放在机器 1 上,第二层放在机器 2 上,而第 2 层需要第 1 层的输出来执行,那么机器 2 必须先等待机器 1 完成才能运行。
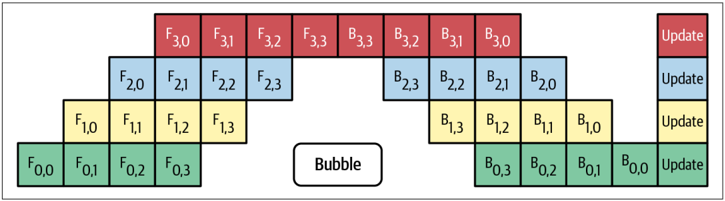
管道并行(pipeline parallelism)是一种巧妙的技术,能让不同机器上模型的不同组件更并行地运行。它有多种变体,但核心思想是把每台机器的计算拆分成多个部分。当机器 1 完成其计算的第一部分时,它把结果传给机器 2,然后继续处理第二部分,依此类推。现在,机器 2 可以在机器 1 处理第二部分的同时,处理其第一部分的计算。
21 Jure Leskovec,Mining Massive Datasets 课程,斯坦福大学,第 13 讲,2020 年,https://oreil.ly/gZcja。
具体来说,假设你有四台不同的机器,第一、第二、第三和第四层分别在机器 1、2、3 和 4 上。使用管道并行,每个小批次(mini-batch)被拆分成四个微批次(micro-batches)。机器 1 在第一个微批次上计算第一层,然后机器 2 在机器 1 的结果上计算第二层,同时机器 1 在第二个微批次上计算第一层,依此类推。图 6-8 展示了在四台机器上的管道并行是什么样子;每台机器为一个神经网络组件运行前向传播和后向传播。
图 6-8. 神经网络在四台机器上的管道并行;每台机器为神经网络的一个组件运行前向传播(F)和后向传播(B)。来源:改编自 Huang 等人的图片²²
模型并行和数据并行并不互斥。许多公司同时使用这两种方法,以更好地利用他们的硬件,尽管同时使用这两种方法的设置可能需要大量的工程投入。
AutoML
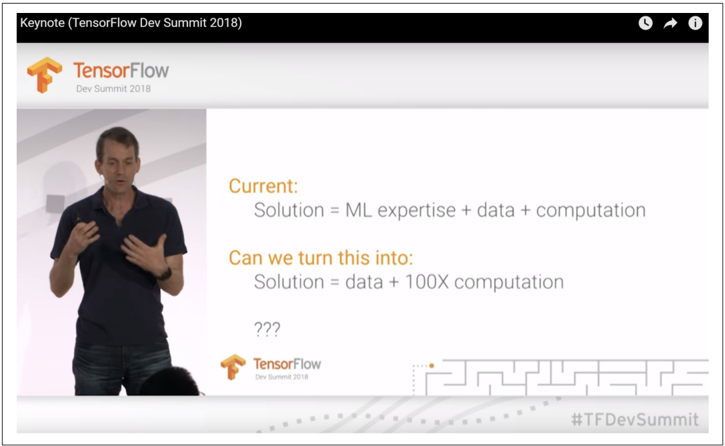
有一个笑话:一个好的机器学习研究员是那种会把自己自动化出局的人——设计一个足够聪明、能够设计自己的人工智能算法。这个笑话一直很好笑,直到 2018 年 TensorFlow Dev Summit 上,Jeff Dean 登上讲台宣布:谷歌打算用 100 倍的计算能力取代机器学习专业知识,并推出了 AutoML,令社区既兴奋又恐惧。与其花钱请 100 名机器学习研究员/工程师去摆弄各种模型,最终选择一个次优的模型,为什么不把这笔钱花在计算上,去搜索最优模型呢?活动录像的一张截图如图 6-9 所示。
22 Yanping Huang、Youlong Cheng、Ankur Bapna、Orhan Firat、Mia Xu Chen、Dehao Chen、HyoukJoong Lee 等人,“GPipe: Easy Scaling with Micro-Batch Pipeline Parallelism,” arXiv,2019 年 7 月 25 日,https://oreil.ly/wehkx。
图 6-9. Jeff Dean 在 2018 年 TensorFlow Dev Summit 上发布谷歌 AutoML
软 AutoML:超参数调优
AutoML 指的是将寻找解决现实世界问题的机器学习算法的过程自动化。超参数调优(hyperparameter tuning)是 AutoML 在生产中的一种温和形式,也是最流行的形式。超参数(hyperparameter)是用户提供的参数,其值用于控制学习过程,例如学习率、批大小、隐藏层数量、隐藏单元数量、dropout 概率、Adam 优化器中的 \(\beta_1\) 和 \(\beta_2\) 等。甚至量化(quantization)——例如用 32 位、16 位还是 8 位来表示一个数字,或这些表示形式的混合——也可以被视为一个需要调优的超参数²³。
使用不同的超参数集,同一个模型在同一个数据集上可以给出截然不同的性能。Melis 等人在他们 2018 年的论文《On the State of the Art of Evaluation in Neural Language Models》中表明,超参数调优得当的较弱模型可以胜过更强、更花哨的模型。超参数调优的目标是在搜索空间内为给定模型找到最优的超参数集——每组超参数的性能都在验证集上评估。
23 我们将在第 7 章介绍量化。
尽管知道它的重要性,许多人仍然忽视系统化的超参数调优方法,而倾向于手动、凭感觉的方法。最流行的可以说是研究生下降(graduate student descent,GSD)——一种让研究生摆弄超参数直到模型可用的技术²⁴。
然而,越来越多的人开始把超参数调优作为其标准管道的一部分。流行的机器学习框架要么自带超参数调优工具,要么有第三方工具——例如,scikit-learn 配 auto-sklearn²⁵,TensorFlow 配 Keras Tuner,Ray 配 Tune。流行的超参数调优方法包括随机搜索(random search)²⁶、网格搜索(grid search)和贝叶斯优化(Bayesian optimization)²⁷。弗莱堡大学 AutoML 小组编写的《AutoML: Methods, Systems, Challenges》一书用第一章(你可以免费在线阅读)专门讲超参数优化。
调优超参数时,请记住,模型的性能对某个超参数变化的敏感度可能高于对另一个超参数变化的敏感度,因此敏感的超参数应该被更仔细地调优。
千万不要用测试划分来调优超参数,这一点至关重要。根据模型在验证划分上的表现选择最佳超参数集,然后在测试划分上报告模型的最终性能。如果你用测试划分调优超参数,就有让模型过拟合测试划分的风险。
硬 AutoML:架构搜索与学习型优化器
有些团队把超参数调优提升到了新的层次:如果我们把模型的其他组件或整个模型都当作超参数会怎样?卷积层的大小,或者是否要有跳跃层(skip layer),都可以被视为超参数。与其手动在卷积层后面放一个池化层,或在线性层后面放一个 ReLU(rectified linear unit,修正线性单元),你把这些构建模块交给算法,让它自己弄清楚如何组合它们。这个研究领域被称为架构搜索(architectural search),对于神经网络则称为神经架构搜索(neural architecture search,NAS),因为它搜索最优的模型架构。
24 GSD 是一种有据可查的技术。参见 “How Do People Come Up With All These Crazy Deep Learning Architectures?",Reddit,https://oreil.ly/5vEsH;“Debate About Science at Organizations like Google Brain/FAIR/DeepMind,” Reddit,https://oreil.ly/2K77r;“Grad Student Descent,” Science Dryad,2014 年 1 月 25 日,https://oreil.ly/dIR9r;以及 Guy Zyskind(@GuyZys),“Grad Student Descent: the preferred #nonlinear #optimization technique #machinelearning,” Twitter,2015 年 4 月 27 日,https://oreil.ly/SW1or。
25 auto-sklearn 2.0 还提供了基本的模型选择能力。
26 我们在 NVIDIA 的团队开发了 Milano,一个使用随机搜索进行自动超参数调优的框架无关工具。
27 我观察到的一个常见做法是:先从粗到细的随机搜索开始,一旦搜索空间显著缩小,再尝试贝叶斯或网格搜索。
一个 NAS 设置由三个组件组成:
搜索空间
定义可能的模型架构——即可供选择的构建模块,以及它们可以如何组合的约束。
性能估计策略
用于评估候选架构的性能,而不必把每个候选架构从头训练到收敛。当我们有大量候选架构(比如 1,000 个)时,把它们全部训练到收敛可能代价高昂。
搜索策略
用于探索搜索空间。一个简单的方法是随机搜索——从所有可能的配置中随机选择——这种方法并不受欢迎,因为即使对 NAS 来说它也昂贵得令人望而却步。常见的方法包括强化学习(reinforcement learning,奖励那些能改善性能估计的选择)和进化(evolution,给架构添加突变,选择表现最好的架构,再给它们添加突变,依此类推)²⁸。
对于 NAS,搜索空间是离散的——最终架构的每一层/每一个操作只使用可用选项中的一个²⁹,而且你必须提供构建模块的集合。常见的构建模块是各种不同大小的卷积、线性层、各种激活函数、池化、恒等映射(identity)、零操作(zero)等。构建模块的集合因基础架构而异,例如卷积神经网络或 Transformer。
在典型的机器学习训练过程中,你有一个模型和一个学习过程——一种帮助你的模型在给定数据集上找到一组能最小化给定目标函数的参数的算法。当今神经网络最常见的学习过程是梯度下降(gradient descent),它利用优化器(optimizer)来指定如何根据梯度更新来更新模型的权重³⁰。流行的优化器,你可能已经知道,有 Adam、Momentum、SGD 等。理论上,你可以把优化器作为构建模块纳入 NAS,搜索一个效果最好的优化器。在实践中,这很难做到,因为优化器对其超参数的设置很敏感,而且默认超参数往往不能很好地跨架构工作。
28 Barret Zoph 和 Quoc V. Le,“Neural Architecture Search with Reinforcement Learning,” arXiv,2016 年 11 月 5 日,https://oreil.ly/FhsuQ;Esteban Real、Alok Aggarwal、Yanping Huang 和 Quoc V. Le,“Regularized Evolution for Image Classifier Architecture Search,” AAAI 2019,https://oreil.ly/FWYjn。
29 你可以让搜索空间连续化以允许微分,但得到的架构必须转换为离散架构。参见"DARTS: Differentiable Architecture Search”(Liu 等人,2018)。
30 我们在本书 GitHub 仓库的"基础机器学习回顾"一节中更详细地介绍学习过程和优化器。
这引出了一个令人兴奋的研究方向:如果我们用神经网络替换指定更新规则的函数会怎样?模型权重应该更新多少,将由这个神经网络来计算。这种方法产生了学习型优化器(learned optimizers),与手工设计的优化器(hand-designed optimizers)相对。
由于学习型优化器是神经网络,它们需要被训练。你可以用训练其余神经网络所用的同一个数据集来训练你的学习型优化器,但这要求你每有一个任务就训练一次优化器。
另一种方法是在一组现有任务上训练一次学习型优化器——使用这些任务上的聚合损失作为损失函数,使用现有的设计优化器作为学习规则——之后每个新任务都直接使用它。例如,Metz 等人构建了一组数千个任务来训练学习型优化器。他们的学习型优化器能够泛化到新的数据集和领域,也能泛化到新的架构³¹。这种方法的美妙之处在于,学习型优化器随后可以被用来训练一个更好的学习型优化器——一种能自我改进的算法。
无论是架构搜索还是元学习(meta-learning)学习规则,前期的训练成本都高得只有世界上少数几家公司负担得起。然而,对于对机器学习生产感兴趣的人来说,了解 AutoML 的进展很重要,原因有二。第一,由此产生的架构和学习型优化器可以让机器学习算法开箱即用地在多个现实世界任务上工作,在训练和推理期间都节省生产时间和成本。例如,EfficientNets——谷歌 AutoML 团队生产的一系列模型——以最高 10 倍的效率超越最先进的准确率³²。第二,它们也许能解决许多用现有架构和优化器以前不可能解决的现实世界任务。
31 Luke Metz、Niru Maheswaranathan、C. Daniel Freeman、Ben Poole 和 Jascha Sohl-Dickstein,“Tasks, Stability, Architecture, and Compute: Training More Effective Learned Optimizers, and Using Them to Train Themselves,” arXiv,2020 年 9 月 23 日,https://oreil.ly/IH7eT。
32 Mingxing Tan 和 Quoc V. Le,“EfficientNet: Improving Accuracy and Efficiency through AutoML and Model Scaling,” Google AI Blog,2019 年 5 月 29 日,https://oreil.ly/gonEn。
机器学习模型开发的四个阶段
在转向模型训练之前,让我们看看机器学习模型开发的四个阶段。一旦你决定探索机器学习,你的策略取决于你处于机器学习采用的哪个阶段。采用机器学习有四个阶段。一个阶段的解决方案可以用作评估下一阶段解决方案的基线:
阶段 1:机器学习之前
如果这是你第一次尝试从这类数据中做这类预测,从非机器学习解决方案开始。你对这个问题的第一次尝试可以是最简单的启发式方法。例如,要预测用户接下来会输入哪个英文字母,你可以显示最常见的三个英文字母"e”、“t"和"a”,这可能让你的准确率达到 30%。
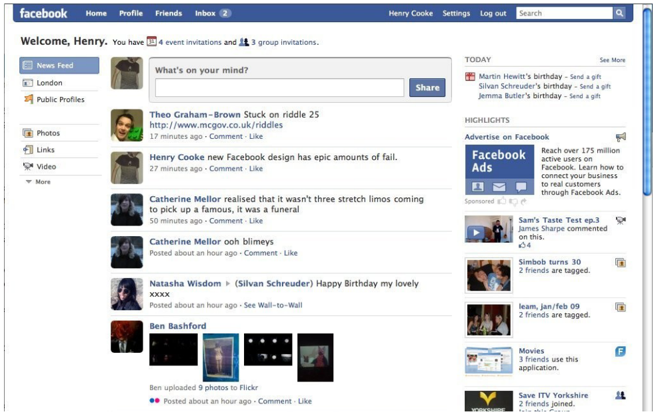
Facebook 的信息流(newsfeed)于 2006 年推出,当时没有任何智能算法——帖子按时间顺序显示,如图 6-10 所示³³。直到 2011 年,Facebook 才开始在信息流顶部显示你最感兴趣的新闻更新。
图 6-10. 大约 2006 年的 Facebook 信息流。来源:Iveta Ryšavá³⁴
33 Samantha Murphy,“The Evolution of Facebook News Feed,” Mashable,2013 年 3 月 12 日,https://oreil.ly/1HMXh。
34 Iveta Ryšavá,“What Mark Zuckerberg’s News Feed Looked Like in 2006,” Newsfeed.org,2016 年 1 月 14 日,https://oreil.ly/XZT6Q。
根据 Martin Zinkevich 在其精彩的《机器学习规则:ML 工程最佳实践》(Rules of Machine Learning: Best Practices for ML Engineering)中的说法:“如果你认为机器学习会给你带来 100% 的提升,那么一个启发式方法就能让你完成一半的路程。“³⁵你甚至可能会发现非机器学习解决方案已经工作得很好,你暂时还不需要机器学习。
- 阶段 2:最简单的机器学习模型
对于你的第一个机器学习模型,你希望从一个简单的算法开始,一个能让你看清其工作原理的算法,以便验证你的问题框架和数据的有效性。逻辑回归、梯度提升树、k 近邻都可以胜任。它们也更容易实现和部署,这让你能够快速搭建一个从数据工程到开发再到部署的框架,你可以测试它并获得信心。
- 阶段 3:优化简单模型
一旦你的机器学习框架就位,你就可以专注于用不同的目标函数、超参数搜索、特征工程、更多数据和集成来优化简单的机器学习模型。
- 阶段 4:复杂模型
一旦你达到了简单模型的极限,而你的用例要求显著的模型改进,就可以尝试更复杂的模型。
你还需要做实验,弄清楚你的模型在生产中的衰退速度有多快(例如,它需要多久重新训练一次),这样你才能搭建基础设施来支持这种重新训练需求³⁶。
模型离线评估
在帮助公司制定机器学习战略时,我经常遇到一个常见但相当困难的问题:“我怎么知道我们的机器学习模型到底好不好?“有一个案例是,一家公司部署了机器学习来检测 100 架监控无人机的入侵行为,但他们没有办法衡量他们的系统漏掉了多少次入侵,也无法决定哪种机器学习算法更适合他们的需求。
缺乏对如何评估机器学习系统的清晰理解,不一定是你机器学习项目失败的原因,但它可能使你无法为你的需求找到最佳解决方案,并让你更难说服管理层采用机器学习。你可能想与业务团队合作,制定与公司业务更相关的模型评估指标³⁷。
35 Martin Zinkevich,“Rules of Machine Learning: Best Practices for ML Engineering,” Google,2019 年,https://oreil.ly/YtEsN。
36 我们将在第 9 章深入讨论多久更新一次模型。
37 参见第 26 页"业务目标与机器学习目标"一节。
理想情况下,开发和生产的评估方法应该是相同的。但在许多情况下,理想是不可能的,因为在开发期间你有真实标签(ground truth labels),而在生产中你没有。
对于某些任务,可以基于用户的反馈在生产中推断或近似标签,如第 91 页"自然标签”(Natural Labels)一节所述。例如,对于推荐任务,可以通过用户是否点击推荐来推断推荐是否好。然而,这伴随着许多偏差。
对于其他任务,你可能无法直接评估模型在生产中的性能,可能不得不依赖广泛的监控来检测机器学习系统性能的变化和失败。我们将在第 8 章介绍监控。
一旦你的模型部署完毕,你需要继续在生产中监控和测试你的模型。在本节中,我们将讨论在模型部署之前评估其性能的方法。我们将从评估模型所依据的基线开始。然后,我们将介绍一些超越总体准确率指标的常见模型评估方法。
基线
曾经有人告诉我,她的新生成模型在 ImageNet 上取得了 10.3 的 FID 分数³⁸。我不知道这个数字意味着什么,也不知道她的模型对我的问题是否有用。
还有一次,我帮助一家公司实现了一个分类模型,其中正类(positive class)出现的时间占 90%。团队中的一位机器学习工程师兴奋地告诉我,他们的初始模型取得了 0.90 的 F1 分数。我问他这与随机相比如何。他不知道。事实证明,因为在他的任务中 POSITIVE 类占标签的 90%,如果他的模型随机输出正类 90% 的时间,它的 F1 分数也会在 0.90 左右³⁹。他的模型可能跟随机预测差不多⁴⁰。
38 Fréchet inception distance(弗雷歇初始距离),一种衡量合成图像质量的常用指标。数值越小,质量应该越高。
39 在这种情况下,准确率大约为 0.80。
40 想回顾 F1 的不对称性,请重新阅读第 106 页"使用正确的评估指标"一节。
评估指标本身意义不大。评估你的模型时,知道你所对照的基线至关重要。确切的基线应该因用例而异,但这里有五个可能跨用例有用的基线:
随机基线(Random baseline)
如果我们的模型只是随机预测,期望性能是多少?预测按照特定分布随机生成,该分布可以是均匀分布,也可以是任务的标签分布。
例如,考虑一个有两个标签的任务,NEGATIVE 出现的时间占 90%,POSITIVE 出现的时间占 10%。表 6-2 显示了随机预测的基线模型的 F1 和准确率分数。不过,作为一个练习——看看对大多数人来说凭直觉猜出这些值有多难——在看表之前,先试着在脑子里算出这些原始数字。
表 6-2. 随机预测的基线模型的 F1 和准确率分数
| 随机分布 | 含义 | F1 | 准确率 |
|---|---|---|---|
| 均匀随机 | 以等概率(50%)预测每个标签 | 0.167 | 0.5 |
| 任务的标签分布 | 90% 的时间预测 NEGATIVE,10% 的时间预测 POSITIVE | 0.1 | 0.82 |
简单启发式
忘掉机器学习。如果你只是基于简单的启发式方法做预测,你期望的性能是多少?例如,如果你想构建一个排序系统,对用户信息流中的条目进行排序,目标是让该用户在信息流上花更多时间,那么如果你只是按时间倒序排列所有条目、把最新的放在最前面,用户会花多少时间?
零规则基线(Zero rule baseline)
当你的基线模型总是预测最常见的类别时,零规则基线是简单启发式基线的一个特例。
例如,对于推荐用户手机上最可能下一个使用的应用的任务,最简单的模型就是推荐他们最常使用的应用。如果这个简单的启发式方法能以 70% 的准确率预测下一个应用,那么你构建的任何模型都必须显著超越它,才能证明增加的复杂性是值得的。
人类基线(Human baseline)
在许多情况下,机器学习的目的是自动化原本由人类完成的工作,所以了解你的模型与人类专家相比表现如何是很有用的。例如,如果你在做自动驾驶系统,衡量你的系统相对于人类驾驶员的进展至关重要,否则你可能永远无法说服用户信任这个系统。即使你的系统并非旨在取代人类专家,而只是帮助他们提高生产力,了解这个系统在哪些场景下对人类有用仍然很重要。
现有解决方案
在许多情况下,机器学习系统是为了取代现有解决方案而设计的,这些解决方案可能是带有大量 if/else 语句的业务逻辑,也可能是第三方解决方案。把你的新模型与这些现有解决方案进行比较至关重要。你的机器学习模型并不一定要优于现有解决方案才有用。一个性能稍逊的模型,如果使用起来容易得多或便宜得多,仍然可能是有用的。
评估模型时,区分"好系统"和"有用系统"很重要。好系统不一定有用,坏系统也不一定没用。一辆自动驾驶汽车,如果与以前的自动驾驶系统相比有显著改进,它可能是好的;但如果它的表现不能至少与人类驾驶员相当,它可能就没用。在某些情况下,即使机器学习系统开得比普通人好,人们可能仍然不信任它,这使它变得无用。另一方面,一个预测用户接下来会在手机上输入哪个词的系统,如果它比母语者差得多,可能被认为是坏的。然而,如果它的预测有时能帮助用户更快地打字,它可能仍然是有用的。
评估方法
在学术环境中,评估机器学习模型时,人们往往固守于性能指标。然而,在生产中,我们还希望我们的模型是稳健的、公平的、校准良好的,并且总体上讲得通。我们将介绍一些有助于衡量模型这些特征的评估方法。
扰动测试(Perturbation tests)
我的一组学生想构建一个应用,通过咳嗽声来预测某人是否患有 COVID-19。他们最好的模型在训练数据上表现很好,训练数据由医院收集的两秒长的咳嗽片段组成。然而,当他们把它部署给真实用户时,这个模型的预测接近随机。
原因之一是,与医院收集的咳嗽声相比,真实用户的咳嗽声包含大量噪声。用户的录音可能包含背景音乐或附近的聊天声。他们使用的麦克风质量参差不齐。他们可能在录音一启用就开始录制咳嗽声,或者等上零点几秒。
理想情况下,用于开发模型的输入应该与模型在生产中必须处理的输入相似,但在许多情况下这是不可能的。当数据收集成本高昂或困难,而你所能获得的最佳训练数据仍然与你的真实世界数据大不相同时,尤其如此。与开发中的输入相比,你的模型在生产中必须处理的输入往往噪声更大⁴¹。在训练数据上表现最好的模型,不一定是噪声数据上表现最好的模型。
为了了解你的模型在噪声数据上的表现,你可以对测试划分做微小改动,看看这些改动如何影响模型的性能。对于从咳嗽声预测某人是否患有 COVID-19 的任务,你可以随机添加一些背景噪声,或随机截断测试片段,以模拟用户录音的差异。你可能想选择在扰动数据上表现最好的模型,而不是在干净数据上表现最好的模型。
你的模型对噪声越敏感,维护起来就越困难,因为如果用户的行为只发生一点轻微变化(比如他们换了手机),你的模型性能就可能下降。这也使你的模型容易受到对抗性攻击(adversarial attack)。
不变性测试(Invariance tests)
伯克利的一项研究发现,在 2008 年到 2015 年间,130 万名信用良好的黑人和拉丁裔申请人的抵押贷款申请因其种族而被拒绝⁴²。当研究人员使用被拒申请的收入和信用评分,但删除识别种族的特征时,这些申请就被批准了。
输入的某些变化不应导致输出的变化。在前面的案例中,种族信息的变化不应影响抵押贷款的结果。同样,申请人姓名的变化不应影响他们的简历筛选结果,一个人的性别也不应影响他们应得的薪酬。如果这些情况发生了,你的模型中就存在偏差,无论它的性能有多好,都可能使其无法使用。
为了避免这些偏差,一个解决方案是做与帮助伯克利研究人员发现偏差相同的过程:保持输入不变,但更改敏感信息,看看输出是否变化。更好的做法是,你一开始就应该把敏感信息从用于训练模型的特征中排除⁴³。
41 噪声数据的其他例子包括光照不同的图像,或带有意外错别字、或故意修改文本(例如把"long"打成"loooooong”)的文本。
42 Khristopher J. Brooks,“Disparity in Home Lending Costs Minorities Millions, Researchers Find,” CBS News,2019 年 11 月 15 日,https://oreil.ly/TMPVl。
43 法律也可能强制要求从模型训练过程中排除敏感信息。
方向性期望测试(Directional expectation tests)
然而,输入的某些变化应该会导致可预测的输出变化。例如,在开发预测房价的模型时,保持所有特征不变但增加地块面积,不应降低预测价格;减少建筑面积,也不应提高预测价格。如果输出的变化方向与预期相反,你的模型可能没有学到正确的东西,在部署之前你需要进一步调查。
模型校准(Model calibration)
模型校准是一个微妙但至关重要的概念。想象有人预测某件事将以 70% 的概率发生。这个预测意味着:在所有做出该预测的情况下,预测结果与实际结果相符的概率是 70%。如果一个模型预测 A 队将以 70% 的概率击败 B 队,而在这两支球队交手的 1,000 次中,A 队只赢了 60% 次,那么我们就说这个模型没有被校准。一个校准良好的模型应该预测 A 队以 60% 的概率获胜。
模型校准经常被机器学习从业者忽视,但它是任何预测系统最重要的属性之一。引用 Nate Silver 在《信号与噪声》(The Signal and the Noise)一书中的话,校准是"对一个预测最重要的检验之一——我认为它是唯一最重要的检验”。
我们将通过两个例子来说明为什么模型校准很重要。首先,考虑构建一个推荐系统来推荐用户接下来可能会看的电影。假设用户 A 有 80% 的时间看爱情片,20% 的时间看喜剧片。如果你的推荐系统只显示 A 最可能看的电影,那么推荐将只包含爱情片,因为 A 看爱情片的可能性远高于任何其他类型的电影。你可能想要一个更校准的系统,其推荐能代表用户实际的观看习惯。在这种情况下,推荐应该由 80% 的爱情片和 20% 的喜剧片组成⁴⁴。
第二,考虑构建一个模型来预测用户点击广告的可能性。为简单起见,想象只有两个广告,广告 A 和广告 B。你的模型预测该用户点击广告 A 的概率为 10%,点击广告 B 的概率为 8%。你不需要模型被校准就可以把广告 A 排在广告 B 之前。然而,如果你想预测你的广告会获得多少次点击,你就需要模型被校准。如果你的模型预测用户点击广告 A 的概率为 10%,但现实中广告只有 5% 的时间被点击,你估计的点击次数就会差得很远。如果你有另一个模型给出相同的排名但校准更好,你可能要考虑校准更好的那个。
44 关于校准推荐的更多信息,请查看 Harald Steck 2018 年基于其在 Netflix 工作所写的论文"Calibrated Recommendations”。
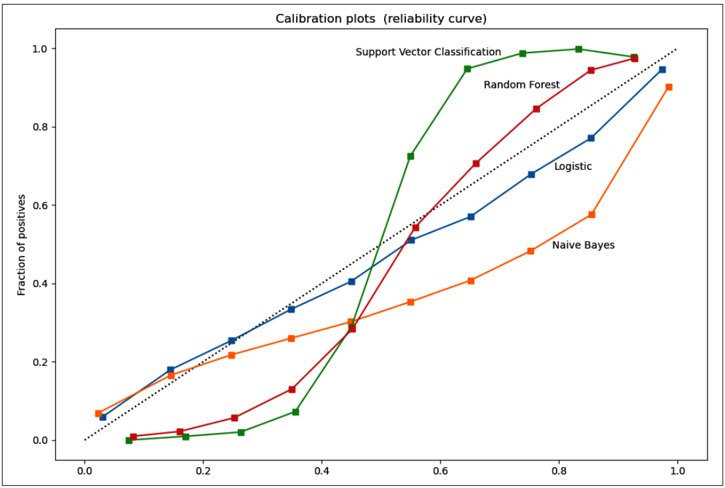
要衡量模型的校准程度,一个简单的方法是计数:你统计模型输出概率 X 的次数,以及该预测成真的频率 Y,然后把 X 对 Y 作图。一个完美校准的模型,其图形在所有数据点上都会满足 X 等于 Y。在 scikit-learn 中,你可以用 sklearn.calibration.calibration_curve 方法绘制二元分类器的校准曲线,如图 6-11 所示。
图 6-11. 不同模型在玩具任务上的校准曲线。逻辑回归模型是校准最好的模型,因为它直接优化逻辑损失。来源:scikit-learn
要校准你的模型,一个常见的方法是 Platt 缩放(Platt scaling),它在 scikit-learn 中以 sklearn.calibration.CalibratedClassifierCV 实现。Geoff Pleiss 的另一个优秀的开源实现可以在 GitHub 上找到。对于想了解更多模型校准的重要性以及如何校准神经网络的读者,Lee Richardson 和 Taylor Pospisil 有一篇基于他们在谷歌工作的优秀博文。
置信度度量(Confidence measurement)
置信度度量可以被视为思考每个单独预测的有用性阈值的一种方式。不加区分地向用户展示模型的所有预测,即使是模型不确定的预测,往好了说会引起用户反感、让用户失去对系统的信任,比如智能手表上的活动检测系统在你只是走得稍快时却认为你在跑步;往坏了说可能造成灾难性后果,比如预测性警务算法把一个无辜的人标记为潜在罪犯。
如果你只想展示模型有把握的预测,你如何度量这种把握?展示预测的把握阈值应该是多少?你打算如何处理低于该阈值的预测——丢弃它们、让人类介入,还是向用户询问更多信息?
虽然大多数其他指标衡量的是系统在平均水平上的性能,但置信度度量是每个单独样本的指标。系统级度量有助于了解整体性能,但当你关心系统在每个样本上的性能时,样本级指标至关重要。
基于切片的评估(Slice-based evaluation)
切片(slicing)是指把数据分成子集,分别查看模型在每个子集上的性能。我在许多公司看到的一个常见错误是,他们过于关注粗粒度的指标,如整个数据上的总体 F1 或准确率,而对基于切片的指标关注不够。这可能导致两个问题。
一个问题是,模型在不同数据切片上的表现本应相同,实际上却不同。例如,他们的数据有两个子组,一个多数子组和一个少数子组,多数子组占数据的 90%:
- 模型 A 在多数子组上达到 98% 的准确率,但在少数子组上只有 80%,这意味着它的总体准确率是 96.2%。
- 模型 B 在多数子组上达到 95% 的准确率,在少数子组上也达到 95%,这意味着它的总体准确率是 95%。
这两个模型在表 6-3 中进行了比较。你会选择哪个模型?
表 6-3. 两个模型在多数子组和少数子组上的性能
| 多数子组准确率 | 少数子组准确率 | 总体准确率 | |
|---|---|---|---|
| 模型 A | 98% | 80% | 96.2% |
| 模型 B | 95% | 95% | 95% |
如果一家公司只关注总体指标,他们可能会选择模型 A。他们可能会对这个模型的高准确率非常满意,直到有一天,他们的最终用户发现这个模型对少数子组存在偏见,因为少数子组恰好对应一个代表性不足的人口群体⁴⁵。只关注总体性能是有害的,不仅因为可能招致公众反弹,还因为它让公司看不到巨大的潜在模型改进空间。如果公司看到两个模型基于切片的性能,他们可能会采取不同的策略。例如,他们可能决定改进模型 A 在少数子组上的性能,这反过来会提升这个模型的整体性能。或者他们可能保持两个模型不变,但现在有了更多信息,可以做出更明智的部署决策。
另一个问题是,模型在不同数据切片上的表现本应不同,实际上却相同。有些数据子集更为关键。例如,当你构建用户流失预测(预测用户何时会取消订阅或服务)模型时,付费用户比非付费用户更关键。只关注模型的总体性能可能会损害它在这些关键切片上的性能。
基于切片的评估之所以至关重要的一个迷人且看似违反直觉的原因是辛普森悖论(Simpson’s paradox)——一种在几组数据中都出现的趋势,在组合这些组后却消失或反转的现象。这意味着模型 B 在所有数据合在一起时可能比模型 A 表现更好,但模型 A 在每一个子组单独上却比模型 B 表现更好。考虑模型 A 和模型 B 在组 A 和组 B 上的性能,如表 6-4 所示。模型 A 在组 A 和组 B 上都优于模型 B,但合并后,模型 B 却优于模型 A。
表 6-4. 辛普森悖论的一个例子^a
| 组 A | 组 B | 总体 | |
|---|---|---|---|
| 模型 A | 93%(81/87) | 73%(192/263) | 78%(273/350) |
| 模型 B | 87%(234/270) | 69%(55/80) | 83%(289/350) |
a 数据来自 Charig 等人 1986 年的肾结石治疗研究:C. R. Charig、D. R. Webb、S. R. Payne 和 J. E. Wickham,“Comparison of Treatment of Renal Calculi by Open Surgery, Percutaneous Nephrolithotomy, and Extracorporeal Shockwave Lithotripsy,” British Medical Journal (Clinical Research Edition) 292, no. 6524(1986 年 3 月):879-82,https://oreil.ly/X8oWr。
45 Maggie Zhang,“Google Photos Tags Two African-Americans As Gorillas Through Facial Recognition Software,” Forbes,2015 年 7 月 1 日,https://oreil.ly/VYG2j。
辛普森悖论比你想象的更常见。1973 年,伯克利的研究生招生统计显示,男性的录取率远高于女性,这使人们怀疑存在针对女性的偏见。然而,仔细查看各个系后发现,六个系中有四个系女性的录取率实际上高于男性⁴⁶,如表 6-5 所示。
表 6-5. 伯克利 1973 年研究生招生数据^a
| 院系 | 全部申请者 | 录取率 | 男性申请者 | 录取率 | 女性申请者 | 录取率 |
|---|---|---|---|---|---|---|
| A | 933 | 64% | 825 | 62% | 108 | 82% |
| B | 585 | 63% | 560 | 63% | 25 | 68% |
| C | 918 | 35% | 325 | 37% | 593 | 34% |
| D | 792 | 34% | 417 | 33% | 375 | 35% |
| E | 584 | 25% | 191 | 28% | 393 | 24% |
| F | 714 | 6% | 373 | 6% | 341 | 7% |
| 总计 | 12,763 | 41% | 8,442 | 44% | 4,321 | 35% |
a 数据来自 Bickel 等人(1975)
46 P. J. Bickel、E. A. Hammel 和 J. W. O’Connell,“Sex Bias in Graduate Admissions: Data from Berkeley,” Science 187(1975):398-404,https://oreil.ly/TeR7E。
无论你是否真的会遇到这个悖论,这里的要点是:聚合可能掩盖并违背实际情况。要做出关于选择哪个模型的明智决策,我们不仅需要考虑模型在整个数据上的性能,还要考虑它在各个切片上的性能。基于切片的评估可以给你洞察,帮助你提高模型的整体性能和在关键数据上的性能,并帮助发现潜在偏差。它还可能帮助揭示非机器学习的问题。有一次,我们的团队发现我们的模型总体表现很好,但在移动用户的流量上表现很差。调查之后,我们意识到这是因为一个按钮在小屏幕(如手机屏幕)上被遮住了一半。
即使你认为切片不重要,以更细粒度的方式理解模型的表现,也可以让你对模型有信心,从而说服其他利益相关者(比如你的老板或客户)信任你的机器学习模型。
要跟踪你的模型在关键切片上的性能,你首先需要知道你的关键切片是什么。你可能会想,如何发现数据中的关键切片。遗憾的是,切片仍然更像是一门艺术而不是科学,需要深入的数据探索和分析。以下是三种主要方法:
基于启发式
利用你对数据和手头任务的领域知识来切分数据。例如,处理网络流量时,你可能想沿着移动端与桌面端、浏览器类型和地理位置等维度切分数据。移动用户的行为可能与桌面用户非常不同。同样,不同地理位置的互联网用户对网站应该长什么样可能有不同的期望⁴⁷。
错误分析
手动检查被错误分类的样本,找出它们之间的模式。当我们看到大多数被错误分类的样本来自移动用户时,我们就发现了模型在移动用户上的问题。
切片查找器(Slice finder)
已有研究尝试将寻找切片的过程系统化,包括 Chung 等人 2019 年的论文《Slice Finder: Automated Data Slicing for Model Validation》,以及 Sumyea Helal 的《Subgroup Discovery Algorithms: A Survey and Empirical Evaluation》(2016)。这个过程通常从用波束搜索(beam search)、聚类或决策树等算法生成切片候选开始,然后剔除明显不好的切片候选,最后对剩下的候选进行排序。
请记住,一旦你发现了这些关键切片,你需要为每个切片准备足够的、正确标注的数据用于评估。你的评估质量只取决于你评估数据的质量。
总结
在本章中,我们介绍了机器学习系统中的机器学习算法部分,许多机器学习从业者认为这是机器学习项目生命周期中最有趣的部分。有了最初的模型,我们可以把在数据和特征工程上的所有辛苦工作以预测的形式变成现实,并且终于可以评估我们的假设(即我们可以根据输入预测输出)。
我们从如何选择最适合我们任务的机器学习模型开始。本章没有逐一讨论每个模型架构的优缺点——考虑到现有模型越来越多,这是一件徒劳的事——而是概述了你在做出明智决策时需要考虑的方面,以确定哪个模型最适合你的目标、约束和需求。
47 对跨文化 UX 设计感兴趣的读者,Jenny Shen 有一篇很好的文章。
接着,我们继续介绍了模型开发的不同方面。我们不仅介绍了单个模型,还介绍了模型集成——一种在竞赛和排行榜式研究中被广泛使用的技术。
在模型开发阶段,你可能会试验许多不同的模型。对大量实验进行密集的跟踪和版本管理,被普遍认为很重要,但许多机器学习工程师仍然跳过它,因为做这件事可能感觉像一件苦差事。因此,拥有自动化跟踪和版本管理流程的工具和适当的基础设施至关重要。我们将在第 10 章介绍机器学习生产的工具和基础设施。
随着当今模型变得越来越大、消耗更多数据,分布式训练正在成为机器学习模型开发人员的一项必备技能,我们讨论了并行化技术,包括数据并行、模型并行和管道并行。让你的模型在大型分布式系统上工作——比如运行着数以亿计甚至数十亿参数模型的系统——可能具有挑战性,需要专门的系统工程专业知识。
本章最后介绍了如何评估你的模型,以挑选出最适合部署的模型。除非你有基线可以对照,否则评估指标意义不大,我们介绍了你可能需要考虑的不同类型的基线。我们还介绍了一系列必要的评估技术,以便在进一步评估生产环境中的模型之前,先对模型进行合理性检查。
通常,无论你对模型的离线评估有多好,在模型部署之前,你仍然无法确定它在生产中的性能。在下一章中,我们将介绍如何部署模型。