特征工程
2014 年,论文《Practical Lessons from Predicting Clicks on Ads at Facebook》(从 Facebook 广告点击预测中得到的实用经验)声称,拥有正确的特征(feature)是开发机器学习(ML)模型最重要的事情。自那以后,我合作过的许多公司一次又一次地发现:一旦他们有了一个可用的模型,与超参数调优(hyperparameter tuning)这类巧妙的算法技巧相比,拥有正确的特征往往能带来最大的性能提升。最先进的模型架构,如果使用的特征组合不够好,仍然可能表现糟糕。
正因其重要性,许多机器学习工程和数据科学工作的一大部分就是提出新的有用特征。在本章中,我们将介绍特征工程(feature engineering)的常见技术和重要考量。我们会用一整节详细讨论一个微妙却极具破坏性的问题——它曾让许多生产环境中的机器学习系统脱轨:数据泄漏(data leakage),以及如何检测和避免它。
本章最后将讨论如何工程化好的特征,同时兼顾特征重要性(feature importance)和特征泛化性(feature generalization)。谈到特征工程,有些人可能会想到特征存储(feature store)。由于特征存储更接近用于支撑多个机器学习应用的基础设施,我们将在第 10 章介绍特征存储。
学习特征与手工特征
我在课堂上讲这个话题时,学生经常问:「为什么我们还要担心特征工程?深度学习(deep learning)不是承诺我们不再需要手工设计特征了吗?」
他们说得对。深度学习的承诺正是我们不必再手工打造特征,因此深度学习有时也被称为特征学习(feature learning)。1 许多特征可以由算法自动学习和提取。然而,我们距离所有特征都能自动化的程度还很远。更不用说,在撰写本书时,生产环境中的大多数机器学习应用并不是深度学习。让我们看一个例子,理解哪些特征可以被自动提取、哪些特征仍然需要手工打造。
假设你想构建一个情感分析(sentiment analysis)分类器,用来判断一条评论是否是垃圾评论(spam)。在深度学习出现之前,拿到一段文本,你必须手动应用经典文本处理技术,例如词形还原(lemmatization)、展开缩写、去除标点符号以及全部转小写。之后,你可能还想按自己选择的 n 值把文本切分成 n-gram。
为不熟悉的读者解释一下:n-gram 是给定文本样本中 n 个连续项(item)组成的序列。这些项可以是音素、音节、字母或单词。例如,对于帖子「I like food,」,其词级 1-gram 是 [‘I’, ’like’, ‘food’],词级 2-gram 是 [‘I like’, ’like food’]。如果我们希望 n 取 1 和 2,这句话的 n-gram 特征集合就是:[‘I’, ’like’, ‘food’, ‘I like’, ’like food’]。
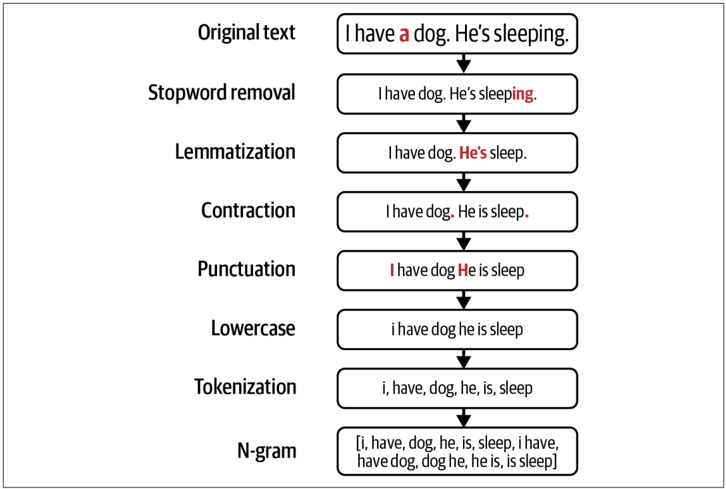
图 5-1 展示了你可以用来为文本手工打造 n-gram 特征的经典文本处理技术示例。
1 Loris Nanni, Stefano Ghidoni, and Sheryl Brahnam, “Handcrafted vs. Non-handcrafted Features for Computer Vision Classification,” Pattern Recognition 71(2017 年 11 月): 158-72, https://oreil.ly/CGfYQ; Wikipedia, s.v. “Feature learning,” https://oreil.ly/fJmwN.
图 5-1. 可用于为文本手工打造 n-gram 特征的技术示例
为训练数据生成 n-gram 后,你可以创建一个词汇表(vocabulary),把每个 n-gram 映射到一个索引。然后你可以根据帖子的 n-gram 索引把每个帖子转换为一个向量。例如,如果我们有一个包含 7 个 n-gram 的词汇表,如表 5-1 所示,每个帖子就可以是一个包含 7 个元素的向量,每个元素对应索引处的 n-gram 在帖子中出现的次数。「I like food」将被编码为向量 [1, 1, 0, 1, 1, 0, 1]。这个向量随后可以作为输入喂给机器学习模型。
表 5-1. 1-gram 和 2-gram 词汇表示例
| I | like | good | food | I like | good food | like food |
|---|---|---|---|---|---|---|
| 0 | 1 | 2 | 3 | 4 | 5 | 6 |
特征工程需要特定领域的专业知识——在这个例子中,领域是自然语言处理(natural language processing,NLP),以及文本的源语言。它往往是一个迭代过程,而且可能很脆弱。在我早期的一个 NLP 项目中遵循这种方法时,我不得不反复重启流程:要么是因为我忘了应用某个技术,要么是因为我用的某个技术效果很差、不得不回退。
然而,自深度学习兴起以来,这些痛苦中的大部分已经得到缓解。你不再需要担心词形还原、标点或停用词(stopword)去除,只需要把原始文本切分成词(即分词,tokenization),用这些词创建词汇表,再用词汇表把每个词转换为独热(one-hot)向量。你的模型有望学会从中提取有用的特征。在这种新方法中,文本的大部分特征工程已经自动化。图像领域也取得了类似的进展。你不再需要从原始图像中手动提取特征并把它们输入机器学习模型,只需把原始图像直接输入深度学习模型即可。
然而,一个机器学习系统很可能需要文本和图像之外的数据。例如,在判断一条评论是否是垃圾评论时,除了评论本身的文本,你可能还想使用关于以下方面的其他信息:
评论本身
它有多少赞/踩?
发布这条评论的用户
这个账号是什么时候创建的,他们发帖的频率如何,他们有多少赞/踩?
评论所在的主题帖
它有多少浏览量?热门主题帖往往更容易吸引垃圾评论。
你的模型中可以用到许多可能的特征,其中一些如图 5-2 所示。选择使用哪些信息、如何把这些信息提取成机器学习模型可用的格式,这个过程就是特征工程。对于像在 TikTok 上为用户推荐接下来要看的视频这样的复杂任务,使用的特征数量可能高达数百万。对于像预测一笔交易是否欺诈这样的特定领域任务,你可能需要具备银行和欺诈方面的专业知识,才能提出有用的特征。
图 5-2. 模型中可能包含的关于评论、主题帖或用户的部分特征
| 评论 ID | 时间 | 用户 | 文本 | 赞 | 踩 | 链接 | 图片数 | 主题帖 ID | 回复对象 | 回复数 | … |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 93880839 | 2020-10-30 T 10:45 UTC | gitrekt | Your mom is a nice lady. | 1 | 0 | 0 | 0 | 2332332 | n0tab0t | 1 | … |
| 用户 ID | 创建时间 | 用户 | 订阅 | 赞 | 踩 | 回复数 | Karma | 主题帖数 | 已验证邮箱 | 奖项 | …… |
| 4402903 | 3:09 PST 2015-01-57 T | gitrekt | [r/ml, r/memes, r/socialist] | 15 | 90 | 28 | 304 | 776 | No | ||
| 主题帖 ID | 时间 | 用户 | 文本 | 赞 | 踩 | 链接 | 图片数 | 回复数 | 浏览量 | 奖项 | … |
| 93883208 | 2020-10-30 T 2:45 PST | doge | Human is temporary, AGI is forever | 120 | 50 | 1 | 0 | 32 | 2405 | 1 |
常见的特征工程操作
由于特征工程在机器学习项目中的重要性和普遍性,人们开发了许多技术来简化这一过程。在本节中,我们将讨论在从数据中工程化特征时你可能需要考虑的几个最重要的操作,包括处理缺失值、缩放、离散化、编码类别特征,以及生成经典但依然非常有效的交叉特征(cross feature),还有更新颖、更令人兴奋的位置特征(positional feature)。这个列表远非全面,但它包含了一些最常见和最有用的操作,可以给你一个良好的起点。我们开始吧!
处理缺失值
你在生产环境中处理数据时首先注意到的可能是某些值缺失了。然而,我面试过的许多机器学习工程师不知道的一点是:并非所有类型的缺失值都一样。2 为了说明这一点,考虑预测某人是否会在未来 12 个月内买房的任务。我们拥有的部分数据如表 5-2 所示。
2 根据我的经验,一个人面试时对给定数据集缺失值处理得好不好,与他在日常工作中表现好不好高度相关。
表 5-2. 预测未来 12 个月内买房的示例数据
| ID | 年龄 | 性别 | 年收入 | 婚姻状况 | 子女数量 | 职业 | 买房? |
|---|---|---|---|---|---|---|---|
| 1 | A | 150,000 | 1 | Engineer | No | ||
| 2 | 27 | B | 50,000 | Teacher | No | ||
| 3 | A | 100,000 | Married | 2 | Yes | ||
| 4 | 40 | B | 2 | Engineer | Yes | ||
| 5 | 35 | B | Single | 0 | Doctor | Yes | |
| 6 | A | 50,000 | 0 | Teacher | No | ||
| 7 | 33 | B | 60,000 | Single | Teacher | No | |
| 8 | 20 | B | 10,000 | Student | No |
缺失值有三种类型。这些类型的官方名称有点令人困惑,所以我们将通过详细的例子来减少混淆。
非随机缺失(Missing not at random,MNAR)
指某个值缺失的原因在于真实值本身。在这个例子中,我们可能会注意到一些受访者没有透露他们的收入。调查后可能发现,未报告收入的受访者的收入往往高于那些披露了收入的人。收入值的缺失与这些值本身有关。
随机缺失(Missing at random,MAR)
指某个值缺失的原因不在于该值本身,而在于另一个已观测到的变量。在这个例子中,我们可能会注意到,性别为「A」的受访者的年龄值经常缺失,这可能是因为这项调查中 A 性别的人不喜欢透露自己的年龄。
完全随机缺失(Missing completely at random,MCAR)
指值的缺失没有任何模式。在这个例子中,我们可能会认为「职业」列的缺失值是完全随机的:既不是因为职业本身,也不是因为任何其他变量。人们有时就是无缘无故忘了填这个值。然而,这种缺失非常罕见。某些值缺失通常是有原因的,你应该去调查。
遇到缺失值时,你可以用某些值填充缺失值(插补,imputation),也可以删除缺失值(删除,deletion)。我们两种都会介绍。
删除
面试时我问候选人如何处理缺失值,许多人倾向于删除,不是因为它更好,而是因为它更容易做。
一种删除方式是列删除(column deletion):如果一个变量缺失值太多,就直接删除该变量。例如,在上面的例子中,「婚姻状况」变量有超过 50% 的值缺失,所以你可能会想把该变量从模型中移除。这种方法的缺点是,你可能删除重要信息并降低模型的准确率。婚姻状况可能与买房高度相关,因为已婚夫妇比单身人士更有可能拥有住房。3
另一种删除方式是行删除(row deletion):如果一个样本有缺失值,就直接删除该样本。当缺失值完全随机(MCAR)且含有缺失值的样本数量很少(例如小于 0.1%)时,这种方法可行。如果行删除意味着要移除 10% 的数据样本,你就不应该这么做。
然而,删除数据行也会移除模型做出预测所需的重要信息,尤其是当缺失值并非随机缺失(MNAR)时。例如,你不应该删除性别为 B 且收入缺失的样本,因为收入缺失这一事实本身就是信息(收入缺失可能意味着收入更高,因此与买房更相关),可以用来做出预测。
此外,删除数据行会给模型引入偏差(bias),尤其是当缺失值是随机缺失(MAR)时。例如,如果删除表 5-2 中所有年龄值缺失的样本,你就会从数据中删除所有性别为 A 的受访者,模型就无法对性别为 A 的受访者做出好的预测。
3 Rachel Bogardus Drew, “3 Facts About Marriage and Homeownership,” Joint Center for Housing Studies of Harvard University, 2014 年 12 月 17 日, https://oreil.ly/MWxFp.
插补
尽管删除因为容易而很诱人,但删除数据可能导致丢失重要信息和向模型引入偏差。如果你不想删除缺失值,就必须对它们进行插补,也就是「用某些值填充它们」。决定用哪些「某些值」才是难的部分。
一种常见做法是用默认值填充缺失值。例如,如果职业缺失,你可能会用空字符串 ’’ 填充。另一种常见做法是用均值、中位数或众数(最常见的值)填充缺失值。例如,如果某个数据样本的月份值是 7 月而温度值缺失,用 7 月的中位温度来填充并不算坏主意。
这两种做法在许多情况下效果不错,但有时它们会引发让人抓狂的 bug。有一次,在我帮忙的一个项目中,我们发现模型输出的全是垃圾,因为应用的前端不再要求用户输入年龄,年龄值缺失了,而模型用 0 填充了它们。但模型在训练时从未见过年龄值 0,所以它无法做出合理的预测。
一般来说,你应该避免用可能的值(possible value)填充缺失值,例如用 0 填充缺失的子女数量——0 本身是子女数量的一个可能取值。这会让人难以区分信息缺失的人和没有孩子的人。
处理特定数据集中的缺失值,可能会同时或依次使用多种技术。无论你使用什么技术,有一件事是确定的:没有处理缺失值的完美方法。删除,你有丢失重要信息或加剧偏差的风险;插补,你有把自己的偏差注入数据、给数据添加噪声的风险,更糟的是,还有数据泄漏的风险。如果你不知道数据泄漏是什么,别慌,我们会在第 135 页的「数据泄漏」一节介绍。
缩放
考虑预测某人是否会在未来 12 个月内买房的任务,以及表 5-2 所示的数据。在我们的数据中,「年龄」变量的值从 20 到 40,而「年收入」变量的值从 10,000 到 150,000。当我们将这两个变量输入机器学习模型时,它不会理解 150,000 和 40 代表不同的东西。它只会把它们都看作数字,而且因为 150,000 远大于 40,它可能会赋予它更多重要性,而不管哪个变量实际上对生成预测更有用。
在把特征输入模型之前,把它们缩放到相近的范围很重要。这个过程称为特征缩放(feature scaling)。这是你能做的最简单的事情之一,往往能给模型带来性能提升。忽略它可能导致模型做出胡言乱语般的预测,尤其是对于梯度提升树(gradient-boosted tree)和逻辑回归(logistic regression)这类经典算法。4
4 特征缩放曾经把我的模型性能提升了近 10%。
缩放特征的一种直观方法是让它们落在 [0, 1] 范围内。给定一个变量 x,可以用以下公式把它的值重新缩放到这个范围内:
\[x' = \frac{x - \min(x)}{\max(x) - \min(x)}\]你可以验证:如果 x 是最大值,缩放后的值 \(x'\) 就是 1;如果 x 是最小值,缩放后的值 \(x'\) 就是 0。
如果你希望特征落在任意范围 [a, b] 内——根据经验,我发现 [-1, 1] 比 [0, 1] 效果更好——可以使用以下公式:
\[x' = a + \frac{(x - \min(x))(b - a)}{\max(x) - \min(x)}\]当你不想对变量做任何假设时,缩放到任意范围效果很好。如果你认为变量可能服从正态分布,把它们归一化(normalize)成零均值、单位方差可能会有帮助。这个过程称为标准化(standardization):
\[x' = \frac{x - \bar{x}}{\sigma}\]其中 \(\bar{x}\) 是变量 x 的均值,\(\sigma\) 是它的标准差。
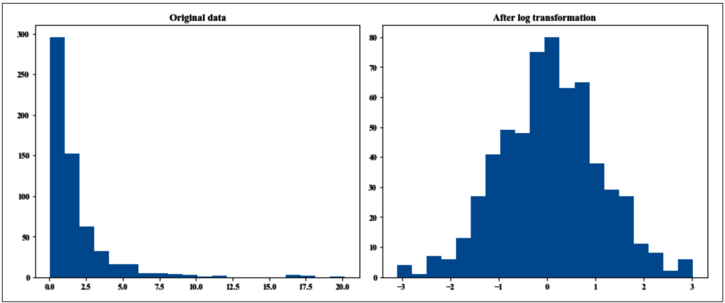
在实践中,机器学习模型往往难以处理服从偏态分布(skewed distribution)的特征。为了缓解偏度,一种常用技术是对数变换(log transformation):对特征应用 log 函数。图 5-3 展示了对数变换如何让数据不那么偏斜。虽然这种技术在许多情况下能带来性能提升,但它并不适用于所有情况,而且你应该警惕对对数变换后的数据(而不是原始数据)进行的分析。5
5 Changyong Feng, Hongyue Wang, Naiji Lu, Tian Chen, Hua He, Ying Lu, and Xin M. Tu, “Log Transformation and Its Implications for Data Analysis,” Shanghai Archives of Psychiatry 26, no. 2(2014 年 4 月): 105-9, https://oreil.ly/hHJjt.
图 5-3. 在许多情况下,对数变换有助于降低数据的偏度
关于缩放有两点需要注意。一是它是数据泄漏的常见来源(这一点将在第 135 页的「数据泄漏」一节更详细地介绍)。二是它通常需要全局统计量(global statistics)——你必须查看全部或部分训练数据来计算其最小值、最大值或均值。在推理(inference)时,你复用训练期间获得的统计量来缩放新数据。如果新数据与训练数据相比发生了显著变化,这些统计量就不太有用了。因此,经常重训模型以应对这些变化非常重要。
离散化
把这项技术写进本书是为了完整性,不过在实践里,我很少发现离散化有帮助。假设我们用表 5-2 的数据构建了一个模型。训练期间,模型见过「150,000」「50,000」「100,000」等年收入值。推理时,模型遇到一个年收入为「9,000.50」的样本。
凭直觉我们知道,每年 9,000.50 美元和每年 10,000 美元差别不大,我们希望模型对二者一视同仁。但模型不知道这一点。模型只知道 9,000.50 和 10,000 不同,它会区别对待它们。
离散化(discretization)是把连续特征变成离散特征的过程,也称为量化(quantization)或分箱(binning)。做法是为给定值创建桶(bucket)。对于年收入,你可能会想把它们分成三个桶,如下所示:
- 低收入:低于每年 35,000 美元
- 中等收入:每年 35,000 到 100,000 美元之间
- 高收入:高于每年 100,000 美元
模型不必学习无穷多种可能的收入,只需要专注于学习三个类别,这是一个容易得多的学习任务。这种技术在训练数据有限时应该更有帮助。
尽管按定义离散化是针对连续特征的,但它也可以用于离散特征。年龄变量是离散的,但把值分成如下桶可能仍然有用:
- 小于 18
- 18 到 22 之间
- 22 到 30 之间
- 30 到 40 之间
- 40 到 65 之间
- 大于 65
缺点是这种分类在类别边界处引入了不连续性——34,999 美元现在被当作与 35,000 美元完全不同的东西,而 35,000 美元与 100,000 美元却被同等对待。选择类别的边界可能并不容易。你可以尝试绘制值的直方图,选择有意义的边界。一般来说,常识、基本分位数(quantile),有时还有领域专业知识会有帮助。
编码类别特征
我们已经讨论了如何把连续特征变成类别特征。本节将讨论如何最好地处理类别特征(categorical feature)。
没在生产环境中处理过数据的人往往假设类别是静态的(static),也就是说类别不会随时间变化。这对许多类别来说是对的。例如,年龄段和收入段不太可能变化,你可以预先确切知道有多少个类别。处理这些类别很简单:给每个类别一个数字就行了。
然而,在生产环境中,类别是会变化的。假设你在构建一个推荐系统,预测用户可能想从亚马逊买什么产品。你想用的特征之一是产品品牌。查看亚马逊的历史数据时,你会发现品牌数量非常多。早在 2019 年,亚马逊上就已经有超过 200 万个品牌了!6
品牌数量多得惊人,但你想:「我还能应付。」你把每个品牌编码成一个数字,现在你有 200 万个数字,从 0 到 1,999,999,对应 200 万个品牌。你的模型在历史测试集上表现出色,你获准在今日 1% 的流量上测试它。
在生产环境中,你的模型崩溃了,因为它遇到了以前没见过的品牌,无法编码。新品牌一直在加入亚马逊。为了解决这个问题,你创建一个值为 2,000,000 的 UNKNOWN 类别,来接住所有模型在训练期间没见过的品牌。
你的模型不再崩溃了,但你的卖家抱怨他们的新品牌没有获得任何流量。这是因为你的模型在训练集中没见过 UNKNOWN 类别,所以它就是不推荐任何 UNKNOWN 品牌的产品。你通过只编码最受欢迎的 99% 品牌、把最底部的 1% 品牌编码为 UNKNOWN 来修复这个问题。这样,至少你的模型知道如何处理 UNKNOWN 品牌了。
你的模型似乎正常工作了大约一个小时,然后产品推荐的点击率(click-through rate)骤降。在过去的一个小时里,有 20 个新品牌加入了你的网站:有些是新的奢侈品牌,有些是可疑的仿冒品牌,有些是成熟的品牌。然而,你的模型对它们一视同仁,就像对待训练数据中不受欢迎的品牌一样。
这不是只有你在亚马逊工作才会发生的极端例子。这个问题相当常见。例如,如果你想预测一条评论是否是垃圾评论,你可能会想把发布这条评论的账号作为特征,而新账号一直在被创建。新产品类型、新网站域名、新餐厅、新公司、新 IP 地址等等也是如此。如果你与其中任何一类打交道,都必须处理这个问题。
找到解决这个问题的方法出乎意料地难。你不想把它们放进一组桶里,因为这真的很难——你究竟要怎么把新用户账号分到不同组里?
这个问题的一个解决方案是哈希技巧(hashing trick),由微软开发的 Vowpal Wabbit 包推广开来。7 这个技巧的核心是:用一个哈希函数为每个类别生成一个哈希值,哈希值将成为该类别的索引。因为你可以指定哈希空间(hash space),所以可以预先固定一个特征编码后的值的数量,而不必知道将来会有多少个类别。例如,如果选择 18 位的哈希空间,对应 \(2^{18}\) = 262,144 个可能的哈希值,那么所有类别——甚至模型从未见过的类别——都会被编码为 0 到 262,143 之间的索引。
6 “Two Million Brands on Amazon,” Marketplace Pulse, 2019 年 6 月 11 日, https://oreil.ly/zrqtd.
7 Wikipedia, s.v. “Feature hashing,” https://oreil.ly/tINTc.
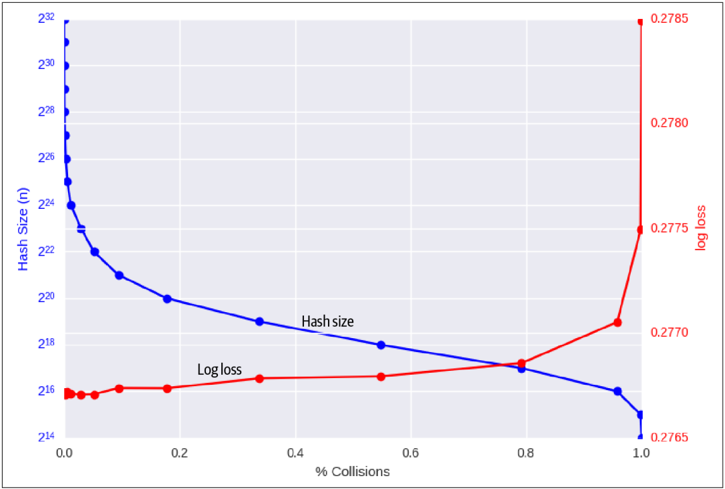
哈希函数的一个问题是碰撞(collision):两个类别被分配到同一个索引。然而,对于许多哈希函数来说,碰撞是随机的;新品牌可能与任何现有品牌共享索引,而不是总与不受欢迎的品牌共享索引——后者正是我们使用前面 UNKNOWN 类别时发生的情况。幸运的是,哈希特征碰撞的影响并没有那么糟糕。Booking.com 的研究表明,即使 50% 的特征发生碰撞,性能损失也小于 0.5%,如图 5-4 所示。8
图 5-4. 50% 的碰撞率只会使对数损失(log loss)增加不到 0.5%。来源:Lucas Bernardi
你可以选择足够大的哈希空间来减少碰撞。你也可以选择具有你想要的属性的哈希函数,例如局部敏感哈希(locality-sensitive hashing)函数,其中相似的类别(例如名称相似的网站)会被哈希到彼此接近的值。
8 Lucas Bernardi, “Don’t Be Tricked by the Hashing Trick,” Booking.com, 2018 年 1 月 10 日, https://oreil.ly/VZmaY.
因为它是个技巧(trick),学术界常常认为它不够正规,把它排除在机器学习课程之外。但它在工业界的广泛采用证明了它的有效性。它对 Vowpal Wabbit 至关重要,也是 scikit-learn、TensorFlow 和 gensim 框架的一部分。在持续学习(continual learning)场景中它尤其有用——模型在生产环境中从不断到来的样本中学习。我们将在第 9 章介绍持续学习。
特征交叉
特征交叉(feature crossing)是把两个或多个特征组合起来生成新特征的技术。这项技术对建模特征之间的非线性关系很有用。例如,对于预测某人是否会在未来 12 个月内买房的任务,你怀疑婚姻状况和子女数量之间可能存在非线性关系,于是你把它们组合起来,创建一个名为「婚姻与子女」的新特征,如表 5-3 所示。
表 5-3. 两个特征如何组合成新特征的示例
| 婚姻 | Single | Married | Single | Single | Married |
|---|---|---|---|---|---|
| 子女 | 0 | 2 | 1 | 0 | 1 |
| 婚姻与子女 | Single, 0 | Married, 2 | Single, 1 | Single, 0 | Married, 1 |
因为特征交叉有助于建模变量之间的非线性关系,它对无法学习或难以学习非线性关系的模型至关重要,例如线性回归(linear regression)、逻辑回归和基于树的模型(tree-based model)。它在神经网络中不那么重要,但仍然有用,因为显式的特征交叉偶尔能帮助神经网络更快地学习非线性关系。DeepFM 和 xDeepFM 就是成功利用显式特征交互来做推荐系统和点击率预测的模型家族。9
特征交叉的一个警示是它可能让特征空间爆炸。假设特征 A 有 100 个可能值,特征 B 有 100 个可能值,交叉这两个特征会得到一个有 100 × 100 = 10,000 个可能值的特征。模型需要多得多的数据才能学会所有这些可能值。另一个警示是,因为特征交叉增加了模型使用的特征数量,它可能让模型对训练数据过拟合(overfit)。
9 Huifeng Guo, Ruiming Tang, Yunming Ye, Zhenguo Li, and Xiuqiang He, “DeepFM: A Factorization-Machine Based Neural Network for CTR Prediction,” Proceedings of the Twenty-Sixth International Joint Conference on Artificial Intelligence (IJCAI, 2017), https://oreil.ly/1Vs3v; Jianxun Lian, Xiaohuan Zhou, Fuzheng Zhang, Zhongxia Chen, Xing Xie, and Guangzhong Sun, “xDeepFM: Combining Explicit and Implicit Feature Interactions for Recommender Systems,” arXiv, 2018, https://oreil.ly/WFmFt.
离散与连续位置嵌入
位置嵌入(positional embedding)最早由论文《Attention Is All You Need》(Vaswani 等人,2017 年)引入深度学习社区,如今已成为计算机视觉和 NLP 中许多应用的标准数据工程技术。我们将通过一个例子说明为什么位置嵌入是必要的,以及如何实现它。
考虑语言建模(language modeling)任务:你想根据前面的 token 序列预测下一个 token(例如一个词、一个字符或一个子词)。在实践中,序列长度可能高达 512,甚至更长。不过为了简单起见,我们以词为 token,序列长度为 8。给定任意 8 个词的序列,例如「Sometimes all I really want to do is,」,我们要预测下一个词。
嵌入
嵌入(embedding)是表示一段数据的向量。我们把同一算法为某类数据生成的所有可能嵌入的集合称为「嵌入空间(embedding space)」。同一空间中的所有嵌入向量大小相同。
嵌入最常见的用途之一是词嵌入(word embedding),即用向量表示每个词。不过,其他类型数据的嵌入也越来越流行。例如,Criteo 和 Coveo 等电商解决方案为产品做嵌入。10 Pinterest 为图像、图、查询甚至用户做嵌入。11 既然有这么多种类型的数据都有嵌入,人们对为多模态(multimodal)数据创建通用嵌入产生了浓厚兴趣。
如果我们使用循环神经网络(recurrent neural network),它会按顺序处理词,这意味着词的顺序是隐式输入的。然而,如果我们使用 transformer 这样的模型,词是并行处理的,因此必须显式输入词的位置,让模型知道这些词的顺序(「a dog bites a child」和「a child bites a dog」截然不同)。我们不想把绝对位置 0, 1, 2, …, 7 输入模型,因为根据经验,神经网络对不是单位方差(unit-variance)的输入效果不好(这就是我们在前面「缩放」一节(第 126 页)讨论过的为什么要缩放特征)。
10 Flavian Vasile, Elena Smirnova, and Alexis Conneau, “Meta-Prod2Vec: Product Embeddings Using Side-Information for Recommendation,” arXiv, 2016 年 7 月 25 日, https://oreil.ly/KDaEd; “Product Embeddings and Vectors,” Coveo, https://oreil.ly/ShaSY.
11 Andrew Zhai, “Representation Learning for Recommender Systems,” 2021 年 8 月 15 日, https://oreil.ly/OchiL.
如果我们把位置重新缩放到 0 到 1 之间,即 0, 1, 2, …, 7 变成 0, 0.143, 0.286, …, 1,那么两个位置之间的差异会太小,神经网络难以学会区分。
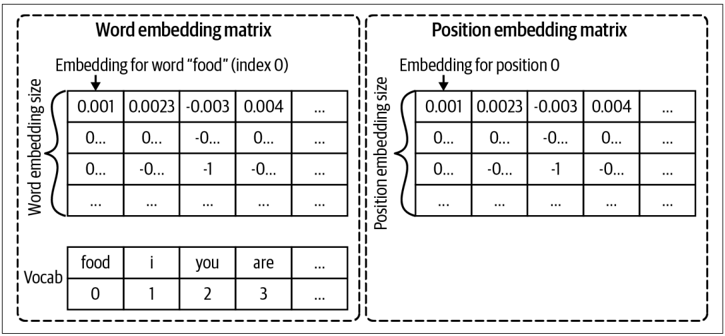
一种处理位置嵌入的方式是像处理词嵌入那样对待它。对于词嵌入,我们使用一个嵌入矩阵,其列数等于词汇表大小,每一列是对应索引处那个词的嵌入。对于位置嵌入,列数就是位置数。在我们的例子里,因为我们只处理大小为 8 的前置序列,位置从 0 到 7(见图 5-5)。
位置的嵌入大小通常与词的嵌入大小相同,这样它们才能相加。例如,位置 0 处单词「food」的嵌入,是单词「food」的嵌入向量与位置 0 的嵌入向量之和。截至 2021 年 8 月,Hugging Face 的 BERT 就是这样实现位置嵌入的。因为这些嵌入会随着模型权重的更新而变化,我们说这些位置嵌入是学习得到的(learned)。
图 5-5. 嵌入位置的一种方式:像对待词嵌入那样对待位置
位置嵌入也可以是固定的(fixed)。每个位置的嵌入仍然是一个有 S 个元素的向量(S 是位置嵌入大小),但每个元素是用一个函数预先定义的,通常用正弦和余弦。在原始 Transformer 论文中,如果元素位于偶数索引,就用正弦;否则用余弦。见图 5-6。
图 5-6. 固定位置嵌入示例。H 是模型输出的维度。
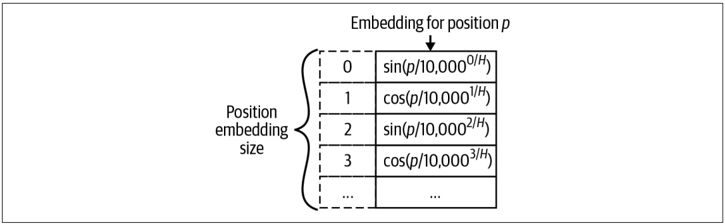
固定位置嵌入是所谓傅里叶特征(Fourier feature)的一个特例。如果位置嵌入中的位置是离散的,那么傅里叶特征也可以是连续的。考虑涉及 3D 物体(例如茶壶)表示的任务。茶壶表面的每个位置都由一个三维坐标表示,这个坐标是连续的。当位置是连续的时,构建一个列索引连续的嵌入矩阵会非常困难,但使用正弦和余弦函数的固定位置嵌入仍然有效。
以下是坐标 v 处嵌入向量的通用格式,也称为坐标 v 的傅里叶特征:
\[\gamma(v) = [\cos(2\pi Bv), \sin(2\pi Bv)]^T\]研究表明,对于以坐标(或位置)作为输入的任务,傅里叶特征能提升模型的性能。如果感兴趣,你可以阅读《Fourier Features Let Networks Learn High Frequency Functions in Low Dimensional Domains》(Tancik 等人,2020 年)了解更多。
数据泄漏
2021 年 7 月,麻省理工学院《技术评论》(MIT Technology Review)发表了一篇煽动性的文章,标题是《Hundreds of AI Tools Have Been Built to Catch Covid. None of Them Helped.》(人们构建了数百个 AI 工具来检测新冠,没有一个派上用场)。这些模型被训练用于从医学扫描中预测 COVID-19 风险。文章列举了多个例子,说明在评估时表现良好的机器学习模型在实际生产环境中却无法使用。
在一个例子中,研究人员用患者躺着和站着时拍摄的扫描图像的混合数据训练模型。「因为躺着扫描的患者更可能是重症患者,模型学会了根据一个人的姿势来预测重症新冠风险。」
在其他一些案例中,模型被「发现会抓住某些医院用来标注扫描图像的文本字体。结果,重症病例较多的医院的字体成了新冠风险的预测因子。」12
这两个都是数据泄漏的例子。数据泄漏指的是这样一种现象:某种形式的标签「泄漏」到了用于预测的特征集中,而同样的信息在推理时并不可用。
数据泄漏之所以棘手,是因为泄漏往往不明显。它之所以危险,是因为它可能让你的模型以意想不到的方式壮观地失败,即使经过了大量评估和测试。我们再来看一个例子来说明什么是数据泄漏。
假设你想构建一个机器学习模型,预测肺部 CT 扫描是否显示癌症迹象。你从 A 医院获得数据,移除医生的诊断,然后训练模型。它在 A 医院的测试数据上表现非常好,但在 B 医院的数据上表现很差。
经过大量调查,你了解到:在 A 医院,当医生认为患者可能患有肺癌时,他们会把患者送到更先进的扫描机器上,该机器输出的 CT 扫描图像略有不同。你的模型学会了依赖扫描机器的信息来预测扫描图像是否显示肺癌迹象。B 医院随机把患者送到不同的 CT 扫描机器,所以你的模型没有信息可以依赖。我们说标签在训练期间泄漏到了特征中。
数据泄漏不仅会发生在领域新手身上,也发生在几位我敬佩的经验丰富的研究人员身上,还发生在我自己的一个项目中。尽管数据泄漏如此普遍,机器学习课程却很少涉及它。
警示故事:Kaggle 竞赛中的数据泄漏
2020 年,利物浦大学(University of Liverpool)在 Kaggle 上发起了一场「离子开关」(Ion Switching)竞赛。任务是识别每个时间点打开的离子通道数量。他们从训练数据合成了测试数据,一些人能够通过逆向工程从泄漏中获取测试标签。13 这场竞赛的两个获胜队伍正是利用了泄漏的两支队伍,尽管不用泄漏他们可能仍然能赢。14
12 Will Douglas Heaven, “Hundreds of AI Tools Have Been Built to Catch Covid. None of Them Helped,” MIT Technology Review, 2021 年 7 月 30 日, https://oreil.ly/Ig1b1.
13 Zidmie, “The leak explained!” Kaggle, https://oreil.ly/1JgLj.
14 Addison Howard, “Competition Recap—Congratulations to our Winners!” Kaggle, https://oreil.ly/wVUU4.
数据泄漏的常见原因
在本节中,我们将介绍数据泄漏的一些常见原因以及如何避免它们。
按时间相关数据随机切分而不是按时间切分
我在大学学机器学习时,被教导要把数据随机切分成训练、验证和测试集。这也正是机器学习研究论文中经常报告的切分方式。然而,这也是数据泄漏的一个常见原因。
在许多情况下,数据是时间相关的(time-correlated),这意味着数据的生成时间会影响其标签分布。有时这种相关性很明显,比如股票价格。简而言之,相似股票的价格往往一起变动。如果今天 90% 的科技股下跌,另外 10% 的科技股也很可能下跌。在构建预测未来股价的模型时,你想按时间切分训练数据,比如用前六天的数据训练模型,用第七天的数据评估。如果随机切分数据,第七天的价格会进入训练集,把当天的市场状况泄漏给模型。我们说来自未来的信息泄漏进了训练过程。
然而,在许多情况下,这种相关性并不明显。考虑预测某人是否会点击歌曲推荐的任务。一个人是否会听一首歌,不仅取决于他的音乐品味,还取决于当天的整体音乐潮流。如果某位歌手某天去世,人们听这位歌手的可能性会大大增加。如果把某一天的样本放进训练集,当天的音乐潮流信息就会传入模型,使模型更容易对同一天的其他样本做出预测。
为了防止未来信息泄漏进训练过程、让模型在评估时作弊,只要有可能,就按时间切分数据,而不是随机切分。例如,如果你有五周的数据,用前四周作为训练集,然后把第 5 周随机切分为验证集和测试集,如图 5-7 所示。
图 5-7. 按时间切分数据,防止未来信息泄漏进训练过程
| 训练集 | 训练集 | 训练集 | 训练集 | 测试集 |
|---|---|---|---|---|
| 第1周 | 第2周 | 第3周 | 第4周 | |
| X11 | X21 | X31 | X41 | |
| X12 | X22 | X32 | X42 | |
| X23 | X33 | X43 | X13 | |
| X14 | X24 | X34 | X44 |
在切分之前缩放
如「缩放」一节(第 126 页)所讨论的,缩放特征很重要。缩放需要数据的全局统计量,例如均值、方差。一个常见错误是在切分成不同数据集之前,用整个训练数据生成全局统计量,把测试样本的均值和方差泄漏进训练过程,让模型能够针对测试样本调整预测。这些信息在生产环境中不可用,所以模型的表现很可能会下降。
要避免这种泄漏,务必先切分数据再缩放,然后用训练集的统计量来缩放所有数据集。有些人甚至建议在进行任何探索性数据分析(exploratory data analysis)和数据预处理之前就切分数据,以免意外获得关于测试集的信息。
用测试集的统计量填充缺失数据
处理特征缺失值的一种常见方式是用所有出现值的均值或中位数填充。如果均值或中位数是用整个数据而不是只用训练集计算的,就可能发生泄漏。这种泄漏类似于缩放造成的泄漏,可以通过只使用训练集的统计量来填充所有数据集中的缺失值来避免。
切分前对数据重复处理不当
如果数据中有重复或近似重复的数据,切分前不删除它们可能导致相同样本同时出现在训练集和验证/测试集中。数据重复在工业界相当常见,在流行的研究数据集中也有发现。例如,CIFAR-10 和 CIFAR-100 是两个用于计算机视觉研究的流行数据集。它们于 2009 年发布,但直到 2019 年,Barz 和 Denzler 才发现 CIFAR-10 和 CIFAR-100 测试集中分别有 3.3% 和 10% 的图像在训练集中存在重复。15
数据重复可能来自数据收集或不同数据源的合并。2021 年《自然》(Nature)杂志的一篇文章把数据重复列为使用机器学习检测 COVID-19 时的常见陷阱,发生原因是「一个数据集合并了其他几个数据集,却没有意识到其中一个组成数据集已经包含另一个组成数据集」。16 数据重复也可能由数据处理造成——例如,过采样(oversampling)可能导致某些样本被重复。
为了避免这个问题,切分前务必检查重复,切分后也再检查一遍以确保万无一失。如果要做过采样,在切分之后进行。
分组泄漏
一组样本的标签高度相关,却被分到了不同的数据集。例如,一个病人可能有两张相隔一周的肺部 CT 扫描,它们关于是否显示肺癌迹象的标签很可能相同,但一张在训练集,另一张在测试集。这种泄漏在目标检测(object detection)任务中很常见,这类任务包含间隔几毫秒拍摄的同一物体的照片——有些落在训练集,有些落在测试集。不理解数据是如何生成的,就很难避免这类数据泄漏。
15 Björn Barz and Joachim Denzler, “Do We Train on Test Data? Purging CIFAR of Near-Duplicates,” Journal of Imaging 6, no. 6 (2020): 41.
16 Michael Roberts, Derek Driggs, Matthew Thorpe, Julian Gilbey, Michael Yeung, Stephan Ursprung, Angelica I. Aviles-Rivero, et al., “Common Pitfalls and Recommendations for Using Machine Learning to Detect and Prognosticate for COVID-19 Using Chest Radiographs and CT Scans,” Nature Machine Intelligence 3 (2021): 199-217, https://oreil.ly/TzbKJ.
数据生成过程中的泄漏
前面关于 CT 扫描是否显示肺癌迹象的信息如何通过扫描机器泄漏的例子就属于这种泄漏。检测这类数据泄漏需要深入了解数据的收集方式。例如,如果你不知道有不同的扫描机器,也不知道两家医院的操作流程不同,就很难发现模型在 B 医院表现差是因为其扫描机器流程不同。
没有万无一失的方法可以避免这种泄漏,但你可以通过跟踪数据的来源、理解数据是如何被收集和处理的来降低风险。对数据做归一化,让来自不同来源的数据可以有相同的均值和方差。如果不同的 CT 扫描机器输出不同分辨率的图像,把所有图像归一化到相同分辨率会让模型更难知道哪张图像来自哪台扫描机器。而且别忘了把领域专家纳入机器学习设计过程,他们可能对数据如何被收集和使用有更多背景知识!
检测数据泄漏
数据泄漏可能发生在许多步骤中,从生成、收集、采样、切分和处理数据,到特征工程。在整个机器学习项目的生命周期中监控数据泄漏非常重要。
测量每个特征或一组特征相对于目标变量(标签)的预测能力。如果某个特征的相关性异常高,调查这个特征是如何生成的,以及这种相关性是否合理。有可能两个特征各自不包含泄漏,但两个特征合在一起就包含泄漏。例如,在构建预测员工会在公司待多久的模型时,入职日期和离职日期单独来看并不能告诉我们太多关于任职时长的信息,但两者合在一起就能给出这个信息。
做消融研究(ablation study),衡量一个特征或一组特征对模型有多重要。如果移除某个特征导致模型性能显著下降,调查为什么这个特征如此重要。如果你有海量特征,比如一千个特征,对它们的所有可能组合做消融研究可能不可行,但偶尔对你最怀疑的特征子集做消融研究仍然有用。这是领域专业知识在特征工程中派上用场的又一个例子。消融研究可以按你自己的安排在离线状态下运行,所以你可以利用机器空闲时间来干这个。
留意新加入模型的特征。如果添加一个新特征显著提升了模型性能,要么这个特征真的很好,要么它只是包含了关于标签的泄漏信息。
每次查看测试集都要非常小心。如果你以任何方式使用测试集——除了报告模型的最终性能之外——无论是为了想新特征的点子还是调超参数,你都有把未来的信息泄漏进训练过程的风险。
工程化好的特征
一般来说,添加更多特征会带来更好的模型性能。根据我的经验,生产环境中的模型使用的特征列表只会随时间增长。然而,特征更多并不总是意味着模型性能更好。特征太多在训练和模型服务阶段都可能不好,原因如下:
- 特征越多,数据泄漏的机会就越多。
- 特征太多可能导致过拟合。
- 特征太多会增加模型服务所需的内存,这可能反过来要求你用更贵的机器/实例来服务模型。
- 特征太多会增加在线预测时的推理延迟,尤其是当你需要在线上从原始数据中提取这些特征来做预测时。我们将在第 7 章更深入地讨论在线预测。
- 无用的特征会变成技术债(technical debt)。每当你的数据管道发生变化,所有受影响的特征都需要相应调整。例如,如果某天你的应用决定不再接收用户的年龄信息,所有使用用户年龄的特征都需要更新。
理论上,如果一个特征无助于模型做出好的预测,L1 正则化(L1 regularization)等正则化技术应该把该特征的权重降到 0。然而在实践中,如果移除不再有用(甚至可能有害)的特征、优先保留好特征,可能有助于模型学得更快。
你可以把移除的特征存起来,以后再加回来。你也可以只存储通用的特征定义,在组织的团队之间复用和共享。谈到特征定义管理,有些人可能会想到特征存储作为解决方案。然而,并非所有特征存储都管理特征定义。我们将在第 10 章进一步讨论特征存储。
评估一个特征对模型好不好时,你可能想考虑两个因素:对模型的重要性,以及对未见数据的泛化性。
特征重要性
衡量特征重要性的方法有很多。如果你使用梯度提升树这类经典机器学习算法,衡量特征重要性最容易的方法是使用 XGBoost 实现的内置特征重要性函数。17 想要更多与模型无关的方法,你可以看看 SHAP(SHapley Additive exPlanations,沙普利加性解释)。18 InterpretML 是一个很棒的开源包,它利用特征重要性帮助你理解模型是如何做出预测的。
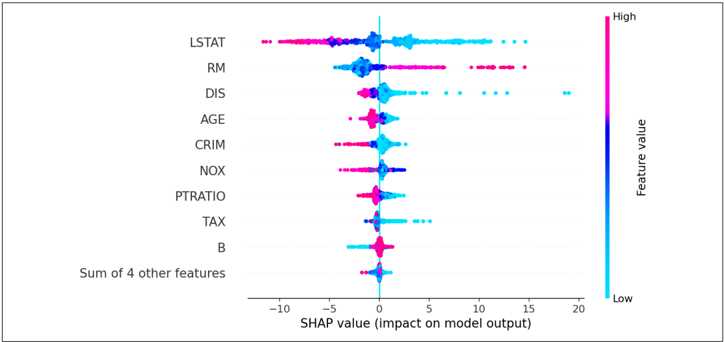
特征重要性度量的确切算法很复杂,但直观上,一个特征对模型的重要性,是通过移除该特征(或包含该特征的特征集)后模型性能下降多少来衡量的。SHAP 很棒,因为它不仅度量一个特征对整个模型的重要性,还度量每个特征对模型某个具体预测的贡献。图 5-8 和图 5-9 展示了 SHAP 如何帮助你理解每个特征对模型预测的贡献。
17 使用 XGBoost 的 get_score 函数。
18 一个很棒的计算 SHAP 的开源 Python 包可以在 GitHub 上找到。
图 5-8. 由 SHAP 度量的每个特征对模型单次预测的贡献。值 LSTAT = 4.98 对这次特定预测的贡献最大。来源:Scott Lundberg 19
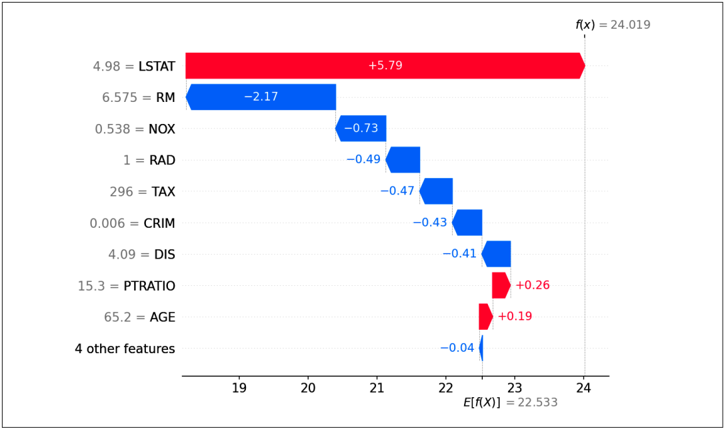
图 5-9. 由 SHAP 度量的每个特征对模型的贡献。特征 LSTAT 的重要性最高。来源:Scott Lundberg
19 Scott Lundberg, SHAP (SHapley Additive exPlanations), GitHub repository, last accessed 2021, https://oreil.ly/c8qqE.
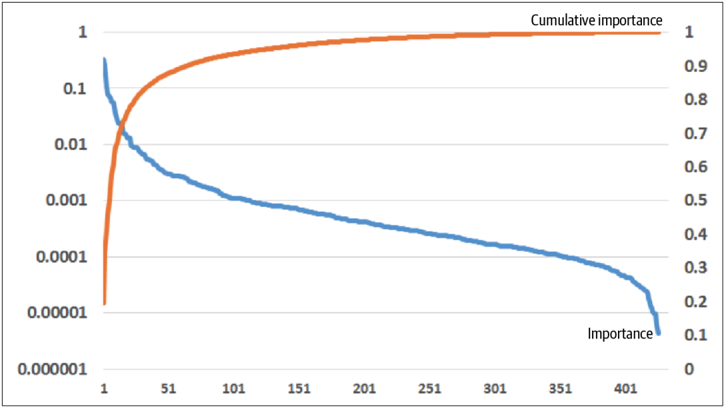
通常,少数特征占据了模型特征重要性的很大一部分。在为点击率预测模型度量特征重要性时,Facebook 广告团队发现,前 10 个特征约占模型总特征重要性的一半,而最后 300 个特征贡献的特征重要性不到 1%,如图 5-10 所示。20
图 5-10. 提升模型的特征重要性。X 轴对应特征数量。特征重要性为对数刻度。来源:He 等人
特征重要性技术不仅有助于选择正确的特征,也非常适合可解释性(interpretability),因为它们帮助你理解模型在内部是如何工作的。
特征泛化
由于机器学习模型的目标是对未见数据做出正确的预测,模型使用的特征应该能泛化到未见数据。并非所有特征的泛化能力都一样。例如,对于预测评论是否是垃圾评论的任务,每条评论的标识符完全不可泛化,不应该作为模型的特征。然而,发布评论的用户的标识符(例如用户名)可能仍然有助于模型做出预测。
20 Xinran He, Junfeng Pan, Ou Jin, Tianbing Xu, Bo Liu, Tao Xu, Yanxin Shi, et al., “Practical Lessons from Predicting Clicks on Ads at Facebook,” in ADKDD ‘14: Proceedings of the Eighth International Workshop on Data Mining for Online Advertising(2014 年 8 月): 1-9, https://oreil.ly/dHXeC.
度量特征泛化远不如度量特征重要性那么科学,除了统计知识外,它还需要直觉和领域专业知识。总的来说,关于泛化你可能想考虑两个方面:特征覆盖率(coverage)和特征值的分布。
覆盖率是数据中拥有该特征值的样本所占的百分比——缺失值越少,覆盖率越高。一个粗略的经验法则是:如果某个特征只出现在你数据的很小百分比中,它就不会有很好的泛化性。例如,如果你想构建一个模型预测某人是否会在未来 12 个月内买房,你认为某人的子女数量会是一个好特征,但你只能为 1% 的数据获取这个信息,那么这个特征可能不是很有用。
这个经验法则很粗略,因为即使某些特征在你的大部分数据中都缺失,它们仍然可能有用。当缺失值不是随机缺失时尤其如此,这意味着有没有这个特征本身可能就是其值的有力指示。例如,如果一个特征只出现在 1% 的数据中,但包含这个特征的样本有 99% 是正标签,这个特征就有用,你应该使用它。
特征的覆盖率在不同数据切片之间甚至在同一数据切片的不同时间都可能差异巨大。如果某个特征的覆盖率在训练集和测试集之间差异很大(例如它出现在训练集 90% 的样本中,但只出现在测试集 20% 的样本中),这说明你的训练集和测试集不来自同一分布。你可能想调查你的数据切分方式是否合理,以及这个特征是否是数据泄漏的一个原因。
对于存在的特征值,你可能想看看它们的分布。如果已见数据(如训练集)中出现的值集合与未见数据(如测试集)中出现的值集合没有重叠,这个特征甚至可能损害模型的性能。
举一个具体的例子:假设你想构建一个模型来估计某次出租车行程所需的时间。你每周重训这个模型,想用过去六天的数据来预测今天的 ETA(estimated time of arrival,预计到达时间)。其中一个特征是 DAY_OF_THE_WEEK,你认为它有用,因为工作日的交通通常比周末更拥堵。这个特征的覆盖率是 100%,因为每个样本都有它。然而,在训练集中,这个特征的值是周一到周六,而在测试集中,这个特征的值是周日。如果你不设计巧妙的日期编码方案就把这个特征放进模型,它无法泛化到测试集,还可能损害模型性能。
另一方面,HOUR_OF_THE_DAY 是一个很好的特征,因为一天中的时间也影响交通,而且这个特征在训练集中的取值范围与测试集 100% 重叠。
在考虑特征的泛化性时,泛化性和特异性之间存在权衡。你可能会意识到,一个小时的交通状况只取决于这个小时是否是高峰时段。于是你生成 IS_RUSH_HOUR 特征,如果小时在早上 7 点到 9 点之间或下午 4 点到 6 点之间,就设为 1。IS_RUSH_HOUR 比 HOUR_OF_THE_DAY 更可泛化,但特异性更低。只使用 IS_RUSH_HOUR 而不使用 HOUR_OF_THE_DAY 可能让模型丢失关于具体小时的重要信息。
小结
因为当今机器学习系统的成功仍然取决于它们的特征,所以对有兴趣在生产环境中使用机器学习的组织来说,投入时间和精力做特征工程非常重要。
如何工程化好的特征是一个复杂的问题,没有万无一失的答案。最好的学习方式是通过经验:尝试不同的特征,观察它们如何影响模型的性能。向专家学习也是可能的。我发现阅读 Kaggle 竞赛获胜队伍如何做特征工程极其有用,可以学到他们的技术和他们经历过的考量。
特征工程往往涉及领域专业知识,而领域专家不一定都是工程师,所以设计工作流时让非工程师也能参与这个过程非常重要。
以下是特征工程最佳实践的小结:
- 按时间把数据切分成训练/验证/测试集,而不是随机切分。
- 如果要做过采样,在切分之后进行。
- 在切分之后缩放和归一化数据,以避免数据泄漏。
- 只使用训练集的统计量(而不是整个数据)来缩放特征和处理缺失值。
- 理解你的数据是如何生成、收集和处理的。尽可能让领域专家参与。
- 跟踪数据的血缘(lineage)。
- 理解特征对模型的重要性。
- 使用泛化良好的特征。
- 从模型中移除不再有用的特征。
有了好的特征集,我们就进入工作流的下一部分:训练机器学习模型。在继续之前,我只想重申:进入建模阶段并不意味着我们处理数据和特征工程的工作结束了。我们永远不会结束与数据和特征打交道。在大多数现实世界的机器学习项目中,只要你的模型在生产环境中,收集数据和特征工程的过程就会一直持续。我们需要用新的、不断流入的数据来持续改进模型,这将在第 9 章介绍。