训练数据
在第 3 章中,我们从系统的角度介绍了如何处理数据。在本章中,我们将从数据科学的角度介绍如何处理数据。尽管训练数据在开发和改进 ML 模型中至关重要,但 ML 课程却严重偏向于建模——许多从业者认为建模才是这个过程中"有趣"的部分。构建一个最先进的模型很有意思。而花好几天时间与海量格式混乱、甚至无法装进机器内存的数据搏斗则令人沮丧。
数据是杂乱的、复杂的、不可预测的,甚至可能是危险的。如果处理不当,它很容易让整个 ML 运营陷入困境。但恰恰因为如此,数据科学家和 ML 工程师才更应该学会如何妥善处理数据,为将来省下时间和麻烦。
在本章中,我们将介绍获取或创建优质训练数据的技术。本章所说的训练数据(training data)涵盖 ML 模型开发阶段使用的所有数据,包括用于训练、验证和测试的不同数据划分(即训练集、验证集、测试集划分)。本章首先介绍用于挑选训练数据的不同采样(sampling)技术。然后,我们将讨论创建训练数据时常见的挑战,包括标签多重性问题、标签缺失问题、类别不平衡问题,以及用数据增强(data augmentation)技术来应对数据不足的问题。
我们使用"训练数据"而不是"训练数据集(training dataset)",是因为"数据集"意味着一个有限且静止不变的集合。生产中的数据既不是有限的,也不是静止的,这一现象我们将在第 237 页"数据分布偏移"一节中介绍。与构建 ML 系统的其他步骤一样,创建训练数据也是一个迭代过程。随着你的模型在项目生命周期中不断演进,你的训练数据很可能也会随之演进。
在继续之前,我想重申一句被说过很多次、但依然不够的告诫:数据充满了潜在的偏见。这些偏见有诸多可能的成因,有些偏见是在收集、采样或标注过程中产生的。历史数据可能蕴含着人类的偏见,而基于这些数据训练的 ML 模型可能会将偏见延续下去。使用数据,但不要过于信任它!
采样
采样是 ML 工作流中不可或缺的一部分,遗憾的是,它在典型的 ML 课程中经常被忽视。采样发生在 ML 项目生命周期的许多环节,例如:从所有可能的真实世界数据中采样以创建训练数据;从给定的数据集中采样以创建训练集、验证集和测试集划分;或者从 ML 系统内发生的所有可能事件中采样以用于监控。在本节中,我们将重点介绍创建训练数据的采样方法,但这些采样方法也可以用于 ML 项目生命周期的其他环节。
在许多情况下,采样是必要的。一种情况是,当你无法接触到真实世界中的所有数据时,你用来训练模型的数据只是真实世界数据的一个子集,它是通过某种采样方法产生的。另一种情况是,处理你所能接触到的全部数据不可行——因为它需要太多的时间或资源——因此你必须对数据进行采样,创建一个可以处理的子集。在许多其他情况下,采样是有益的,因为它能让你更快、更便宜地完成任务。例如,在考虑一个新模型时,你可能想先用数据的一小部分做一个快速实验,看看新模型是否有前途,然后再用全部数据训练这个新模型。¹
理解不同的采样方法以及它们在工作流中的用法,首先可以帮助我们避免潜在的采样偏差(sampling bias),其次可以帮助我们选择能提高所采样数据效率的方法。
采样分为两大类:非概率采样(nonprobability sampling)和随机采样(random sampling)。我们先介绍非概率采样方法,然后介绍几种常见的随机采样方法。
¹ 有些读者可能会争辩说,这种方法对大型模型可能不适用,因为某些大型模型在小数据集上表现不佳,但在数据量多得多的情况下却表现良好。在这种情况下,用不同大小的数据集做实验仍然很重要,以弄清数据集大小对模型的影响。
非概率采样
非概率采样是指数据的选择不基于任何概率标准。以下是一些非概率采样的标准:
便利采样(Convenience sampling)
样本数据是根据其可用性来选择的。这种采样方法之所以流行,是因为——好吧,它很方便。
滚雪球采样(Snowball sampling)
后续样本是根据现有样本来选择的。例如,要在无法访问 Twitter 数据库的情况下抓取合法 Twitter 账号,你可以从少量账号开始,然后抓取它们关注的所有账号,依此类推。
判断采样(Judgment sampling)
由专家决定纳入哪些样本。
配额采样(Quota sampling)
你根据对数据某些切片的配额来选择样本,而不做任何随机化。例如,做调查时,你可能希望每个年龄段都回收 100 份问卷:30 岁以下、30 到 60 岁之间、60 岁以上,而不考虑实际年龄分布。
按非概率标准选出的样本不能代表真实世界的数据,因此充斥着选择偏差(selection bias)。² 由于这些偏差的存在,你可能会认为用这类采样方法为 ML 模型挑选数据是个坏主意。你说得对。遗憾的是,在许多情况下,为 ML 模型选择数据仍然是由便利性驱动的。
这类情况的一个例子是语言建模(language modeling)。语言模型训练所用的数据往往不是能代表所有可能文本的数据,而是容易收集的数据——维基百科(Wikipedia)、Common Crawl、Reddit。
另一个例子是通用文本情感分析(sentiment analysis)的数据。这类数据大多来自具有天然标签(评分)的来源,如 IMDB 评论和亚马逊(Amazon)评论。这些数据集随后被用于其他情感分析任务。IMDB 评论和亚马逊评论偏向于愿意在网上留下评论的用户,不一定能代表无法访问互联网的人,或不愿意在网上发布评论的人。
² James J. Heckman,《样本选择偏差作为一种设定误差》(Sample Selection Bias as a Specification Error),《计量经济学》(Econometrica)第 47 卷第 1 期(1979 年 1 月):153-61,https://oreil.ly/I5AhM。
第三个例子是自动驾驶汽车的训练数据。最初,为自动驾驶汽车收集的数据主要来自两个地区:亚利桑那州凤凰城(因为那里的监管宽松)和加利福尼亚州湾区(因为许多制造自动驾驶汽车的公司位于此地)。这两个地区通常都是晴天。2016 年,Waymo 将业务扩展到华盛顿州柯克兰(Kirkland),专门冲着柯克兰的雨天而去,³ 但晴天的自动驾驶汽车数据仍然远比雨天或雪天的多。
非概率采样可以是一种快速简便的方法,帮你收集初始数据,让项目起步。然而,要构建可靠的模型,你可能需要使用基于概率的采样方法,我们接下来就介绍它。
³ Rachel Lerman,《谷歌正在柯克兰测试其自动驾驶汽车》(Google Is Testing Its Self-Driving Car in Kirkland),《西雅图时报》(Seattle Times),2016 年 2 月 3 日,https://oreil.ly/3IA1V。
简单随机采样
在最简单的随机采样形式中,你给总体中的每个样本相同的被选中概率。⁴ 例如,你随机选择总体的 10%,让总体中每个成员都有 10% 的被选中机会。
这种方法的优点是容易实现。缺点是数据中的稀有类别可能不会出现在你的选择中。假设某个类别只占数据总体的 0.01%。如果你随机选择 1% 的数据,这个稀有类别的样本几乎不可能被选中。基于这种选择训练的模型可能会认为这个稀有类别不存在。
⁴ 这里的总体(population)指的是"统计总体",即所有可以被采样的样本构成的(可能无限的)集合。
分层采样
为了避免简单随机采样的缺点,你可以先把总体划分为你关心的各个组,然后分别从每个组中采样。例如,要对包含 A、B 两个类别的数据采样 1%,你可以对类别 A 采样 1%,对类别 B 采样 1%。这样,无论类别 A 或 B 有多稀有,你都能确保它的样本被包含在所选数据中。每个组称为一个层(stratum),这种方法称为分层采样(stratified sampling)。
这种采样方法的一个缺点是它并不总是可行的,例如当无法把所有样本划分成组时。当一个样本可能属于多个组时,这一点尤其棘手,比如多标签(multilabel)任务。⁵ 例如,一个样本可以既是类别 A 又是类别 B。
⁵ 多标签任务是指一个样本可以拥有多个标签的任务。
加权采样
在加权采样(weighted sampling)中,每个样本被赋予一个权重,这个权重决定了它被选中的概率。例如,如果你有三个样本 A、B 和 C,希望它们分别以 50%、30% 和 20% 的概率被选中,你可以给它们分别赋予权重 0.5、0.3 和 0.2。
这种方法让你能够利用领域专长。例如,如果你知道数据的某个子群体(比如较新的数据)对你的模型更有价值,希望它有更高的被选中机会,你可以给它更高的权重。
当你的数据与真实数据来自不同的分布时,这种方法也很有帮助。例如,如果你的数据中红色样本占 25%、蓝色样本占 75%,但你知道在真实世界中红色和蓝色发生的概率相等,你可以给红色样本的权重设为蓝色样本的三倍。
在 Python 中,你可以用 random.choices 进行加权采样,如下所示:
# Choose two items from the list such that 1, 2, 3, 4 each has # 20% chance of being selected, while 100 and 1000 each have only 10% chance. import random random.choices(population=[1, 2, 3, 4, 100, 1000], weights=[0.2, 0.2, 0.2, 0.2, 0.1, 0.1], k=2) # This is equivalent to the following random.choices(population=[1, 1, 2, 2, 3, 3, 4, 4, 100, 1000], k=2)
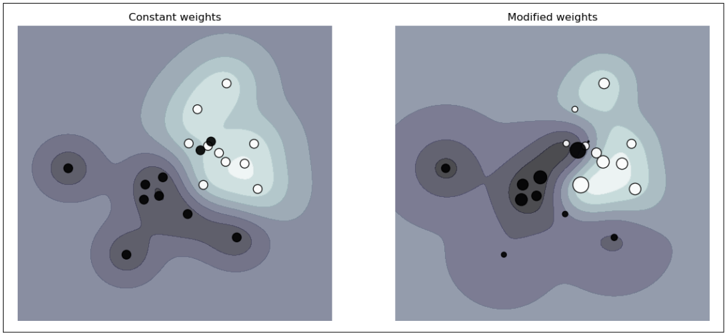
ML 中一个与加权采样密切相关且常见的概念是样本权重(sample weights)。加权采样用于选择训练模型所用的样本,而样本权重用于给训练样本赋予"权重"或"重要性"。权重更高的样本对损失函数的影响更大。改变样本权重可以显著改变模型的决策边界(decision boundary),如图 4-1 所示。
图 4-1. 样本权重可以影响决策边界。左图是所有样本被赋予相同权重的情况。右图是样本被赋予不同权重的情况。来源:scikit-learn⁶
⁶ 《SVM:加权样本》(SVM: Weighted Samples),scikit-learn,https://oreil.ly/BDqbk。
水库采样
水库采样(reservoir sampling)是一种引人入胜的算法,在处理流式(streaming)数据时尤其有用——而生产环境中的数据通常正是流式的。
想象一下:有一个不断涌入的推文流,你想从中采样一定数量 \(k\) 的推文来做分析或训练模型。你不知道一共有多少条推文,但你知道它们无法全部装进内存,这意味着你无法事先确定一条推文应该以多大的概率被选中。你想要确保:
- 每条推文被选中的概率相等。
- 你可以随时停止算法,且推文是以正确的概率被采样出来的。
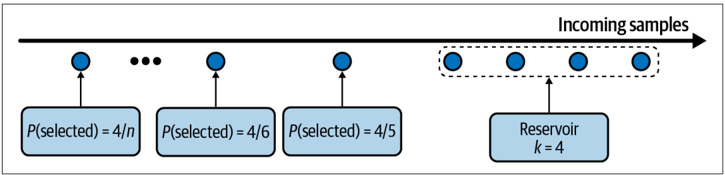
这个问题的一个解决方案就是水库采样。该算法涉及一个水库(reservoir),它可以是一个数组,包含三个步骤:
- 把前 \(k\) 个元素放入水库。
- 对每一个到来的第 \(n\) 个元素,生成一个随机数 \(i\),使得 \(1 \le i \le n\)。
- 如果 \(1 \le i \le k\):用第 \(n\) 个元素替换水库中的第 \(i\) 个元素;否则,什么也不做。
这意味着每个到来的第 \(n\) 个元素有 \(k/n\) 的概率留在水库中。你还可以证明,水库中的每个元素都有 \(k/n\) 的概率留在那里。这意味着所有样本被选中的机会相等。如果我们在任意时刻停止算法,水库中的所有样本都是以正确的概率被采样出来的。图 4-2 展示了水库采样工作原理的示例。
图 4-2. 水库采样工作原理的可视化
重要性采样
重要性采样(importance sampling)是最重要的采样方法之一,不仅仅是在 ML 中。它让我们能够从一个分布中采样,即使我们只能访问另一个分布。
想象一下,你必须从分布 \(P(x)\) 中采样 \(x\),但从 \(P(x)\) 采样非常昂贵、缓慢或不可行。不过,你有一个更容易采样的分布 \(Q(x)\)。于是你改为从 \(Q(x)\) 中采样 \(x\),并用 \(P(x)/Q(x)\) 对这个样本加权。\(Q(x)\) 被称为提议分布(proposal distribution)或重要性分布(importance distribution)。只要在 \(P(x) \neq 0\) 时总有 \(Q(x) > 0\),\(Q(x)\) 可以是任何分布。下面的公式表明,在期望意义上,从 \(P(x)\) 采样的 \(x\) 等于从 \(Q(x)\) 采样、并用 \(P(x)/Q(x)\) 加权的 \(x\):
\[ E_{x \sim P(x)}[f(x)] = E_{x \sim Q(x)}\left[f(x)\frac{P(x)}{Q(x)}\right] \]重要性采样在 ML 中的一个应用是策略型强化学习(policy-based reinforcement learning)。考虑你想要更新策略的情形。你想估计新策略的价值函数,但计算采取某个动作的总回报可能代价高昂,因为你需要考虑该动作之后直到时间范围结束的所有可能结果。然而,如果新策略与旧策略相对接近,你可以改为基于旧策略计算总回报,再根据新策略重新加权。旧策略的回报构成了提议分布。
标注
尽管无监督 ML 前景广阔,但当今生产环境中的大多数 ML 模型都是监督式的,这意味着它们需要带标签的数据来学习。ML 模型的性能仍然在很大程度上取决于它所训练的标签数据的质量和数量。
特斯拉 AI 总监 Andrej Karpathy 在与我的学生的一次谈话中分享了一个轶事:当他决定组建一支内部标注团队时,他的招聘人员问他需要这个团队多长时间,他反问道:“我们需要工程团队多长时间?“数据标注已经从辅助性任务变成了许多生产环境 ML 团队的核心职能。
在本节中,我们将讨论为数据获取标签的挑战。我们首先讨论数据科学家一提到标注通常最先想到的标注方法:人工标注(hand labeling)。然后我们将讨论具有天然标签(natural labels)的任务——即无需人工标注、可以从系统中推断出标签的任务——最后讨论当天然标签和人工标签都缺失时该怎么办。
人工标注
任何在生产环境中处理过数据的人大概都切身体会过这一点:为数据获取人工标签困难重重,原因非常多。首先,人工标注数据可能很昂贵,尤其是在需要领域专长的情况下。要对一条评论是否垃圾进行分类,你也许能在众包平台上找到 20 名标注员,花 15 分钟培训他们为你的数据标注。但如果你想标注胸部 X 光片,你就得找持有委员会认证的放射科医生,他们的时间有限且昂贵。
其次,人工标注对数据隐私构成威胁。人工标注意味着必须有人查看你的数据,如果你的数据有严格的隐私要求,这并不总是可行的。例如,你不能直接把患者的病历或公司的机密财务信息交给第三方服务去标注。在许多情况下,你的数据甚至可能不允许离开你的组织,你可能不得不雇用或签约标注员在本地(on premises)为你的数据标注。
第三,人工标注很慢。例如,在音素(phonetic)级别准确转写一段语音,所需时间可能是该语音时长的 400 倍。⁷ 所以如果你想标注 1 小时的语音,一个人大约需要 400 小时,也就是将近 3 个月。在一项利用 ML 从 X 光片中分类肺癌的研究中,我的同事们等了将近一年才获得足够的标签。
⁷ Xiaojin Zhu,《基于图的半监督学习》(Semi-Supervised Learning with Graphs),博士论文,卡内基梅隆大学,2005 年,https://oreil.ly/VYy4C。
缓慢的标注会导致缓慢的迭代速度,让你的模型更难适应不断变化的环境和需求。如果任务变了或数据变了,你就得等数据重新标注完才能更新模型。想象这样一个场景:你有一个情感分析模型,用来分析每一条提到你品牌的推文的情感。它只有两个类别:NEGATIVE(负面)和 POSITIVE(正面)。然而部署后,你的公关团队发现最大的伤害来自愤怒的推文,他们想更快地处理愤怒消息。于是你不得不把情感分析模型更新为三个类别:NEGATIVE、POSITIVE 和 ANGRY(愤怒)。为此,你需要重新查看数据,确定哪些现有训练样本应该重新标注为 ANGRY。如果你没有足够的 ANGRY 样本,还得收集更多数据。这个过程耗时越长,你现有模型的性能就退化得越多。
标签多重性
通常,为了获得足够的标签数据,公司不得不使用来自多个来源的数据,并依赖多位专业水平不同的标注员。这些不同的数据来源和标注员也有不同的准确度。这就导致了标签歧义或标签多重性(label multiplicity)问题:当一个数据样本存在多个相互冲突的标签时该怎么办。
考虑这个简单的实体识别(entity recognition)任务。你把下面的样本交给三位标注员,请他们标注能找到的所有实体:
达斯·西迪厄斯(Darth Sidious),人称皇帝,是一位西斯黑暗尊主,曾以第一银河帝国银河皇帝的身份统治银河系。
你会收到三种不同的结果,如表 4-1 所示。三位标注员识别出了不同的实体。你的模型应该基于哪一份训练?用标注员 1 标注的数据训练的模型,与用标注员 2 标注的数据训练的模型,表现会截然不同。
表 4-1. 不同标注员识别出的实体可能大相径庭
| 标注员 | 实体数 | 标注 |
|---|---|---|
| 1 | 3 | [ Darth Sidious ], known simply as the Emperor, was a [ Dark Lord of the Sith ] who reigned over the galaxy as [ Galactic Emperor of the First Galactic Empire ]. |
| 2 | 6 | [ Darth Sidious ], known simply as the [ Emperor ], was a [ Dark Lord ] of the [ Sith ] who reigned over the galaxy as [ Galactic Emperor ] of the [ First Galactic Empire ]. |
| 3 | 4 | [ Darth Sidious ], known simply as the [ Emperor ], was a [ Dark Lord of the Sith ] who reigned over the galaxy as [ Galactic Emperor of the First Galactic Empire ]. |
标注员之间的分歧极其常见。所需的领域专长水平越高,标注分歧的可能性就越大。⁸ 如果一位人类专家认为标签应该是 A,而另一位认为应该是 B,我们该如何解决这一冲突以获得唯一的真实标签(ground truth)?如果人类专家都无法就标签达成一致,“人类水平的表现"到底意味着什么?
为了尽量减少标注员之间的分歧,首先要有清晰的问题定义,这一点很重要。例如,在前面的实体识别任务中,如果我们明确:当存在多个可能的实体时,选择包含最长子串的实体,那么一些分歧本可以被消除。这意味着选"第一银河帝国银河皇帝"而不是"银河皇帝"和"第一银河帝国"两个分开的实体。其次,你需要把这个定义纳入标注员的培训中,确保所有标注员都理解规则。
⁸ 如果某个东西显而易见到不需要领域专长就能标注,那你也就不需要领域专长了。
数据血缘
不加甄别地使用来自多个来源、由不同标注员生成的数据,而不检查其质量,可能会导致你的模型莫名其妙地失败。考虑这样一个案例:你用 10 万个数据样本训练了一个还算不错的模型。你的 ML 工程师确信更多数据会提升模型性能,于是你花了很多钱雇标注员再标注 100 万个数据样本。
然而,在新数据上训练之后,模型性能反而下降了。原因是那 100 万个新样本是众包给标注员标注的,他们的标注准确度远低于原始数据的标注者。如果你已经把数据混在一起,无法区分新数据和旧数据,这个问题就尤其难以补救。
一个好的实践是追踪每个数据样本及其标签的来源,这项技术称为数据血缘(data lineage)。数据血缘既能帮你标记数据中潜在的偏差,也能帮你调试模型。例如,如果你的模型主要在最近获取的数据样本上出错,你可能需要调查新数据是如何获取的。我们不止一次发现,问题并不出在模型上,而是因为我们最近获取的数据中错误标签的数量异常之高。
自然标签
人工标注并非标签的唯一来源。你也许足够幸运,能从事带有天然真实标签的任务。具有天然标签的任务是指模型预测可以由系统自动评估或部分评估的任务。一个例子是谷歌地图(Google Maps)中估算某条路线到达时间的模型。如果你走了那条路线,行程结束时,谷歌地图就知道这段行程实际花了多长时间,从而可以评估预测到达时间的准确性。另一个例子是股价预测。如果你的模型预测某只股票接下来两分钟的价格,那么两分钟后,你就可以把预测价格与实际价格进行比较。
具有天然标签的任务的典型例子是推荐系统(recommender system)。推荐系统的目标是为用户推荐与其相关的物品。用户是否点击被推荐的物品,可以看作对该推荐的一种反馈。被点击的推荐可以推定是好的(即标签为 POSITIVE),而在一段时间(比如 10 分钟)内未被点击的推荐可以推定是差的(即标签为 NEGATIVE)。
许多任务都可以被构造成推荐任务。例如,你可以把预测广告点击率(click-through rate)的任务构造成:根据用户的活动历史和画像,向用户推荐最相关的广告。从点击、评分等用户行为中推断出的自然标签也称为行为标签(behavioral labels)。
即使你的任务天生没有自然标签,你也许仍然可以通过设置系统的方式,收集一些关于模型的反馈。例如,如果你在构建谷歌翻译(Google Translate)这样的机器翻译系统,你可以提供让社区为糟糕的翻译提交替代译文的选项——这些替代译文可以用来训练你的下一版模型(不过你可能想先审查这些建议的译文)。信息流排序(newsfeed ranking)不是一个天生带标签的任务,但通过给每条信息流内容添加"点赞"按钮和其他反应按钮,Facebook 能够收集关于其排序算法的反馈。
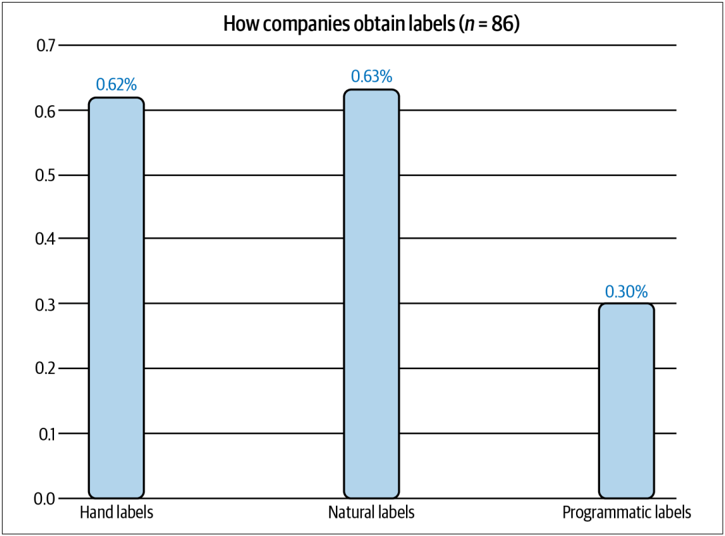
具有自然标签的任务在业界相当普遍。在我对圈子中 86 家公司的调查中,我发现其中 63% 的公司从事的是具有自然标签的任务,如图 4-3 所示。这并不意味着能从 ML 方案中受益的任务中有 63% 都拥有自然标签。更可能的解释是,公司发现先从事有自然标签的任务更容易、更便宜。
图 4-3. 我圈子中 63% 的公司从事具有自然标签的任务。百分比之和不为 1,是因为一家公司可能同时从事具有不同标签来源的任务。⁹
⁹ 我们将在第 95 页"弱监督"一节介绍程序化标签。
在前面的例子中,一段时间内未被点击的推荐可以推定是差的。这被称为隐式标签(implicit label),因为这个负面标签是从正面标签的缺失中推断出来的。它不同于显式标签(explicit label)——在显式标签中,用户通过给推荐打低分或点踩,明确表达他们对推荐的反馈。
反馈回路长度
对于具有天然真实标签的任务,从预测被提供到针对该预测的反馈产生所经过的时间,就是反馈回路长度(feedback loop length)。反馈回路短的任务,其标签通常在几分钟内就能获得。许多推荐系统都有很短的反馈回路。如果被推荐的物品是亚马逊上的相关商品或 Twitter 上值得关注的人,从物品被推荐到被点击(如果确实被点击了的话)之间的时间很短。
然而,并非所有推荐系统都有以分钟计的反馈回路。如果你处理的是博客文章、文章或 YouTube 视频这类较长的内容类型,反馈回路可能是数小时。如果你构建的系统像 Stitch Fix 那样为用户推荐衣服,你要等到用户收到商品并试穿之后才能获得反馈,那可能是几周之后。
不同类型的用户反馈
如果你想从用户反馈中提取标签,务必注意用户反馈有不同的类型。它们可能发生在用户在你的应用中的旅程的不同阶段,并且在数量、信号强度和反馈回路长度上各不相同。
例如,考虑一个类似亚马逊的电商应用。用户在该应用上可能提供的反馈类型包括:点击商品推荐、把商品加入购物车、购买商品、评分、写评论,以及退回之前购买的商品。
点击商品比购买商品发生得更快、更频繁(因此产生更高的数量)。但与仅仅点击相比,购买商品是衡量用户是否喜欢该商品的强得多的信号。
在构建商品推荐系统时,许多公司专注于优化点击,因为点击能提供更高数量的反馈来评估模型。然而,有些公司专注于购买,因为购买是更强的信号,而且与它们的业务指标(例如商品销售收入)相关性更高。两种方法都成立。对于你的用例应该优化哪种类型的反馈,没有确定的答案,这值得所有相关利益方进行认真讨论。
选择正确的窗口长度需要深思熟虑,因为它涉及速度与准确性之间的权衡。窗口长度短意味着你能更快地捕获标签,从而可以用这些标签尽快发现模型的问题并加以解决。然而,窗口长度短也意味着你可能在推荐被点击之前就过早地把它标记为差。
无论你把窗口长度设为多长,都可能仍然存在过早的负面标签。2021 年初,Twitter 广告团队的一项研究发现,尽管大多数广告点击发生在最初的五分钟内,但有些点击发生在广告展示数小时之后。¹⁰ 这意味着这类标签往往会低估实际的点击率。如果你只记录了 1,000 个 POSITIVE 标签,实际的点击次数可能略高于 1,000。
¹⁰ 脚注原文在 PDF 提取中缺失。
对于反馈回路长的任务,自然标签可能要等数周甚至数月才能获得。欺诈检测(fraud detection)就是一个反馈回路长的任务的例子。在交易发生后的一段时间内,用户可以对该交易是否欺诈提出异议。例如,当客户阅读信用卡账单时看到一笔不认识的交易,他们可能会向银行提出异议,这就给了银行将该交易标记为欺诈的反馈。典型的异议窗口期是一到三个月。异议窗口期过后,如果用户没有提出异议,你可以推定该交易是合法的。
反馈回路长的标签有助于在季度或年度业务报告中报告模型的性能。然而,如果你想尽快发现模型的问题,它们就不是很有用了。如果你的欺诈检测模型出了问题,而你要花几个月才能发现,等到问题修复时,有缺陷的模型放过的所有欺诈交易可能已经导致一家小企业破产。
应对标签缺失
由于获取足够多高质量标签面临诸多挑战,人们开发了许多技术来应对由此产生的问题。在本节中,我们将介绍其中四种:弱监督(weak supervision)、半监督(semi-supervision)、迁移学习(transfer learning)和主动学习(active learning)。这些方法的总结如表 4-2 所示。
表 4-2. 应对人工标注数据不足的四种技术总结
| 方法 | 做法 | 是否需要真实标签(ground truth) |
|---|---|---|
| 弱监督 | 利用(通常有噪声的)启发式规则来生成标签 | 不需要,但建议用少量标签来指导启发式规则的开发 |
| 半监督 | 利用结构性假设来生成标签 | 需要,以少量初始标签作为种子来生成更多标签 |
| 迁移学习 | 利用在另一个任务上预训练的模型来完成你的新任务 | 零样本学习不需要;微调需要,但所需真实标签的数量通常远少于从头训练模型所需的量 |
| 主动学习 | 标注对你的模型最有用的数据样本 | 需要 |
弱监督
如果人工标注如此麻烦,那我们干脆不用人工标签怎么样?一种越来越流行的方法就是弱监督。最流行的弱监督开源工具之一是 Snorkel,由斯坦福 AI 实验室开发。¹¹ 弱监督背后的洞见是:人们依赖启发式规则(heuristics)来标注数据,而这些规则可以用领域专长来开发。例如,医生可能会用下面的启发式规则来判断某个患者的病例是否应该优先处理为紧急(EMERGENT):
如果护士的笔记提到肺炎等严重疾病,患者的病例应给予优先考虑。
像 Snorkel 这样的库是围绕标注函数(labeling function,LF)的概念构建的:标注函数是一种对启发式规则进行编码的函数。前面的启发式规则可以用下面的函数表达:
def labeling_function(note):
    if "pneumonia" in note:
        return "EMERGENT"
    return "NOT_EMERGENT"
LF 可以对多种不同类型的启发式规则进行编码。以下是其中一些:
关键词启发式
- 例如前面的例子
正则表达式
- 例如,笔记是否匹配或不匹配某个正则表达式
数据库查找
- 例如,笔记是否包含危险疾病清单中列出的疾病
其他模型的输出
- 例如,某个现有系统是否将其分类为 EMERGENT
写完 LF 之后,你可以把它们应用到想要标注的样本上。
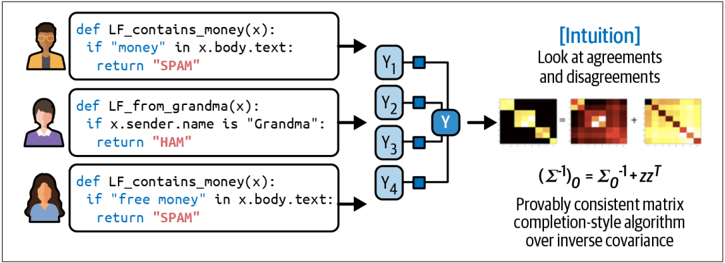
因为 LF 编码的是启发式规则,而启发式规则是有噪声的,所以 LF 产生的标签也是有噪声的。多个 LF 可能同时适用于同一个数据样本,并且可能给出相互冲突的标签。一个函数可能认为某条护士笔记是 EMERGENT,而另一个函数可能认为它不是。一个启发式规则可能比另一个准确得多,而你可能并不知道这一点,因为缺乏真实标签可供比较。把所有 LF 合并、去噪并重新加权,以获得一组最可能正确的标签,这一点很重要。图 4-4 从高层展示了 LF 的工作原理。
¹¹ Alexander Ratner、Stephen H. Bach、Henry Ehrenberg、Jason Fries、Sen Wu 和 Christopher Ré,《Snorkel:利用弱监督快速创建训练数据》(Snorkel: Rapid Training Data Creation with Weak Supervision),《VLDB 汇刊》第 11 卷第 3 期(2017 年):269-82,https://oreil.ly/vFPjk。
图 4-4. 标注函数如何组合的高层概览。来源:改编自 Ratner 等人的图片¹²
¹² 脚注原文在 PDF 提取中缺失。
理论上,弱监督不需要任何人工标签。然而,为了了解你的 LF 有多准确,建议准备少量人工标签。这些人工标签可以帮助你发现数据中的模式,从而写出更好的 LF。
当你的数据有严格的隐私要求时,弱监督尤其有用。你只需要查看一小部分经过审核的数据子集来编写 LF,然后就可以把 LF 应用于其余数据,而无需任何人查看这些数据。
借助 LF,领域专长可以被版本化、复用和共享。一个团队拥有的专长可以被编码并由另一个团队使用。如果你的数据变了或需求变了,你只需把 LF 重新应用于数据样本即可。使用 LF 为数据生成标签的方法也称为程序化标注(programmatic labeling)。表 4-3 展示了程序化标注相对于人工标注的一些优势。
表 4-3. 程序化标注相对于人工标注的优势
| 人工标注 | 程序化标注 |
|---|---|
| 昂贵:尤其是需要领域专长时 | 节省成本:专长可以在整个组织内被版本化、共享和复用 |
| 缺乏隐私:需要把数据交给人工标注员 | 隐私:用经过审核的数据子样本创建 LF,然后将 LF 应用于其他数据,无需查看单个样本 |
| 缓慢:所需时间与所需标签数量成线性增长 | 快速:轻松从 1K 个样本扩展到 1M 个样本 |
| 不适应变化:每次变更都需要重新标注数据 | 适应变化:发生变化时,只需重新应用 LF! |
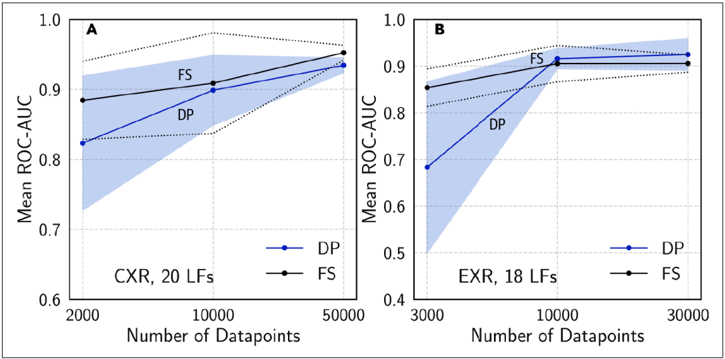
下面这个案例研究展示了弱监督在实践中表现有多好。在与斯坦福医学院的一项研究中,¹³ 由一位放射科医生花八小时编写 LF 获得的弱监督标签所训练的模型,其性能与用近一年人工标注获得的数据训练的模型相当,如图 4-5 所示。关于实验结果有两个有趣的事实。第一,即使不增加更多的 LF,模型也会随着更多无标签数据的加入而持续改进。第二,LF 在任务之间被复用。研究人员能够在 CXR(胸部 X 光片)任务和 EXR(肢体 X 光片)任务之间复用六个 LF。¹⁴
图 4-5. 在 CXR 和 EXR 任务上,用全监督标签(FS)训练的模型与用程序化标签(DP)训练的模型性能对比。来源:Dunnmon 等人¹⁵
¹³ Jared A. Dunnmon、Alexander J. Ratner、Khaled Saab、Matthew P. Lungren、Daniel L. Rubin 和 Christopher Ré,《跨模态数据编程实现快速医学机器学习》(Cross-Modal Data Programming Enables Rapid Medical Machine Learning),《Patterns》第 1 卷第 2 期(2020 年):100019,https://oreil.ly/nKt8E。
¹⁴ 这项研究中的两个任务分别只用了 18 个和 20 个 LF。在实践中,我见过有的团队为每个任务使用数百个 LF。
¹⁵ Dunnmon 等人,《跨模态数据编程》。
我的学生经常问:如果启发式规则在标注数据上效果这么好,为什么还需要 ML 模型?一个原因是 LF 可能无法覆盖所有数据样本,所以我们可以在用 LF 程序化标注的数据上训练 ML 模型,然后用这个训练好的模型为任何 LF 都没有覆盖的样本生成预测。
弱监督是一个简单但强大的范式。然而,它并不完美。在某些情况下,弱监督获得的标签噪声太大,没有用处。但即使在那些情况下,当你想探索 ML 的有效性、又不想一开始就投入太多人工标注时,弱监督也可以是一个很好的起点。
半监督
如果说弱监督是利用启发式规则来获得有噪声的标签,那么半监督就是利用结构性假设,基于一小部分初始标签来生成新标签。与弱监督不同,半监督需要一组初始标签。
半监督学习是一种早在 90 年代就被使用的技术,¹⁶ 自那以后发展出了许多半监督方法。对半监督学习的全面综述超出了本书的范围。我们将介绍这些方法中的一小部分,让读者了解它们是如何使用的。如需全面综述,我推荐《半监督学习文献综述》(Xiaojin Zhu,2008 年)和《半监督学习综述》(Engelen 和 Hoos,2018 年)。
¹⁶ Avrim Blum 和 Tom Mitchell,《用协同训练结合有标签和无标签数据》(Combining Labeled and Unlabeled Data with Co-Training),《第十一届计算学习理论年会论文集》(1998 年 7 月):92-100,https://oreil.ly/T79AE。
一种经典的半监督方法是自训练(self-training)。你先用现有的有标签数据集训练一个模型,用这个模型为无标签样本做预测。假设原始概率分数高的预测是正确的,你就把高概率预测的标签加入训练集,在这个扩充后的训练集上训练一个新模型。如此反复,直到你对模型性能满意为止。
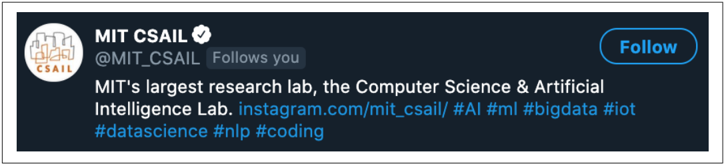
另一种半监督方法假设:具有相似特征的样本共享相同的标签。这种相似性可能是显而易见的,比如在 Twitter 话题标签(hashtag)主题分类任务中。你可以先把”#AI"这个标签标注为计算机科学(Computer Science)。假设出现在同一条推文或同一个账号简介中的话题标签可能属于同一主题,那么根据图 4-6 中 MIT CSAIL 的账号简介,你也可以把”#ML"和”#BigData"标注为计算机科学。
图 4-6. 因为 #ML 和 #BigData 与 #AI 出现在同一个 Twitter 账号简介中,我们可以假设它们属于同一主题
在大多数情况下,这种相似性只能通过更复杂的方法来发现。例如,你可能需要使用聚类方法或 k 近邻(k-nearest neighbors)算法来发现属于同一簇的样本。
近年来流行起来的一种半监督方法是基于扰动(perturbation)的方法。它基于这样的假设:对样本的微小扰动不应该改变它的标签。于是你对训练样本施加微小扰动,以获得新的训练样本。扰动可以直接施加在样本上(例如给图像添加白噪声),也可以施加在它们的表示上(例如给词的嵌入添加小的随机值)。扰动后的样本与未扰动的样本拥有相同的标签。我们将在第 114 页"扰动"一节进一步讨论这一点。
在某些情况下,即使给定数据集中相当大比例的标签被丢弃,半监督方法也已经达到了纯监督学习的性能。¹⁷
¹⁷ Avital Oliver、Augustus Odena、Colin Raffel、Ekin D. Cubuk 和 Ian J. Goodfellow,《深度半监督学习算法的现实评估》(Realistic Evaluation of Deep Semi-Supervised Learning Algorithms),《NeurIPS 2018 论文集》,https://oreil.ly/dRmPV。
当训练标签数量有限时,半监督最有用。在数据有限的情况下做半监督,需要考虑的一个问题是:应该用多少有限数据来评估多个候选模型并选出最好的一个。如果你用得很少,那么在这个很小的评估集上表现最好的模型,可能正是对这个评估集过拟合最严重的模型。另一方面,如果你用大量数据做评估,那么基于这个评估集选出最佳模型所获得的性能提升,可能还不如把这个评估集加入有限的训练集所带来的提升大。许多公司用折中的方式解决这一权衡:用一个相当大的评估集选出最佳模型,然后在这个评估集上继续训练冠军模型。
迁移学习
迁移学习指这样一类方法:为某个任务开发的模型被复用作第二个任务的模型起点。首先,为基础任务(base task)训练基础模型(base model)。基础任务通常是一个训练数据便宜且充足的任务。语言建模(language modeling)是一个绝佳候选,因为它不需要标签数据。语言模型可以在任何文本语料上训练——书籍、维基百科文章、聊天记录——任务就是:给定一个词元(token)序列,¹⁸ 预测下一个词元。当给定序列"我买入英伟达股票,因为我坚信……的重要性"时,语言模型可能会输出"硬件"或"GPU"作为下一个词元。
训练好的模型随后可以用于你感兴趣的任务——下游任务(downstream task)——例如情感分析、意图检测或问答。在某些情况下,例如零样本学习(zero-shot learning)场景,你可能可以直接把基础模型用于下游任务。在许多情况下,你可能需要微调(fine-tune)基础模型。微调意味着对基础模型做小幅修改,例如在给定下游任务的数据上继续训练基础模型或基础模型的一部分。¹⁹
¹⁸ 词元可以是一个词、一个字符或词的一部分。
¹⁹ Jeremy Howard 和 Sebastian Ruder,《用于文本分类的通用语言模型微调》(Universal Language Model Fine-tuning for Text Classification),arXiv,2018 年 1 月 18 日,https://oreil.ly/DBEbw。
有时候,你可能需要用模板修改输入,以提示(prompt)基础模型生成你想要的输出。²⁰ 例如,要把语言模型用作问答任务的基础模型,你可以使用这样的提示:
问:美国是什么时候成立的?

答:1776 年 7 月 4 日。

问:《独立宣言》是谁写的?

答:托马斯·杰斐逊。

问:亚历山大·汉密尔顿出生于哪一年?

答:
当你把这段提示输入 GPT-3 这样的语言模型时,它可能会输出亚历山大·汉密尔顿出生的年份。
²⁰ Pengfei Liu、Weizhe Yuan、Jinlan Fu、Zhengbao Jiang、Hiroaki Hayashi 和 Graham Neubig,《预训练、提示与预测:自然语言处理中提示方法的系统综述》(Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing),arXiv,2021 年 7 月 28 日,https://oreil.ly/0lBgn。
对于标签数据不多的任务,迁移学习尤其有吸引力。即使对于拥有大量标签数据的任务,以预训练模型为起点也常常能显著提升性能,胜过从头训练。
近年来迁移学习获得了大量关注,这是有充分理由的。它催生了许多以前因缺乏训练样本而无法实现的应用。当今生产环境中相当大一部分 ML 模型都是迁移学习的成果,包括利用 ImageNet 预训练模型的目标检测模型,以及利用 BERT 或 GPT-3 等预训练语言模型的文本分类模型。²¹ 迁移学习还降低了进入 ML 的门槛,因为它帮助削减了为构建 ML 应用而标注数据所需的前期成本。
²¹ Jacob Devlin、Ming-Wei Chang、Kenton Lee 和 Kristina Toutanova,《BERT:用于语言理解的深度双向 Transformer 预训练》(BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding),arXiv,2018 年 10 月 11 日,https://oreil.ly/RdIGU;Tom B. Brown、Benjamin Mann、Nick Ryder、Melanie Subbiah、Jared Kaplan、Prafulla Dhariwal、Arvind Neelakantan 等人,《语言模型是少样本学习者》(Language Models Are Few-Shot Learners),OpenAI,2020 年,https://oreil.ly/YVmrr。
过去五年出现的一个趋势是:(通常)预训练基础模型越大,它在下游任务上的表现越好。大型模型的训练成本高昂。根据 GPT-3 的配置估算,训练这个模型的成本高达数千万美元。许多人推测,未来只有少数几家公司能负担得起训练大型预训练模型。行业中的其他公司会直接使用这些预训练模型,或针对自己的具体需求微调它们。
主动学习
主动学习是一种提高数据标签效率的方法。其希望在于:如果 ML 模型能选择学习哪些数据样本,它们就能用更少的训练标签达到更高的准确率。主动学习有时被称为查询学习(query learning)——尽管这个术语越来越不受欢迎——因为模型(主动学习者)会以无标签样本的形式发回查询,交由标注员(通常是人类)标注。
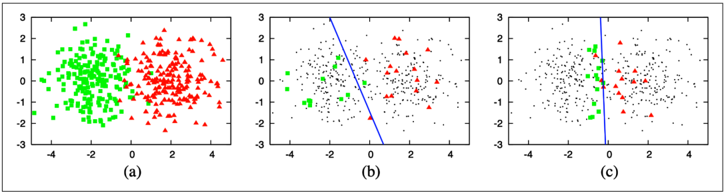
与其随机标注数据样本,不如按照某些指标或启发式规则,标注对你的模型最有帮助的样本。最直接的指标是不确定性度量(uncertainty measurement)——标注你的模型最不确定的样本,希望它们能帮助模型更好地学习决策边界。例如,在模型为不同类别输出原始概率的分类问题中,模型可以选择预测类别概率最低的数据样本。图 4-7 展示了这种方法在一个玩具示例上的出色效果。
图 4-7. 基于不确定性的主动学习如何工作。(a) 一个由 400 个样本组成的玩具数据集,均匀地从两个类别的高斯分布中采样。(b) 在 30 个随机标注样本上训练的模型准确率为 70%。(c) 在 30 个由主动学习选出的样本上训练的模型准确率为 90%。来源:Burr Settles²²
²² Burr Settles,《主动学习》(Active Learning),(威利斯顿,佛蒙特州:Morgan & Claypool,2012 年)。
另一种常见的启发式规则基于多个候选模型之间的分歧。这种方法称为委员会查询(query-by-committee),是集成(ensemble)方法的一个例子。²³ 你需要一个由多个候选模型组成的委员会,这些模型通常是使用不同超参数集训练出的同一个模型,或在不同数据切片上训练的同一个模型。每个模型可以对接下来标注哪些样本投一票,它可能会根据自己对预测的不确定程度来投票。然后你标注委员会分歧最大的样本。
²³ 我们将在第 6 章介绍集成。
还有其他启发式规则,例如选择那些如果用来训练,会产生最大梯度更新或最大程度降低损失的样本。关于主动学习方法的全面综述,请参阅《主动学习文献综述》(Settles,2010 年)。
要被标注的样本可以来自不同的数据体制(data regime)。它们可以是合成的——模型在输入空间中自己最不确定的区域生成样本。²⁴ 它们可以来自平稳分布——你已经收集了大量无标签数据,模型从这个池子中选择样本进行标注。它们也可以来自真实世界分布——就像生产环境中那样,有源源不断的数据流入,模型从数据流中选择样本进行标注。
²⁴ Dana Angluin,《查询与概念学习》(Queries and Concept Learning),《机器学习》第 2 卷(1988 年):319-42,https://oreil.ly/0uKs4。
当系统处理实时数据时,我对主动学习最为兴奋。数据一直在变化——这一现象我们在第 1 章简单提过,将在第 8 章进一步详述。在这种数据体制下,主动学习能让模型更有效地实时学习,更快地适应不断变化的环境。
类别不平衡
类别不平衡(class imbalance)通常指分类任务中的这样一个问题:训练数据中每个类别的样本数量存在巨大差异。例如,在一个用 X 光片检测肺癌的训练数据集中,99.99% 的 X 光片可能是正常肺部,只有 0.01% 可能含有癌细胞。
类别不平衡也可能发生在标签是连续值的回归任务中。考虑估算医疗账单的任务。²⁵ 医疗账单高度偏斜——中位数账单很低,但第 95 百分位的账单高得惊人。在预测医院账单时,准确预测第 95 百分位的账单可能比预测中位数账单更重要。一张 250 美元的账单差 100% 是可以接受的(实际 500 美元,预测 250 美元),但一张 1 万美元的账单差 100% 就不行了(实际 2 万美元,预测 1 万美元)。因此,我们可能不得不训练模型更擅长预测第 95 百分位的账单,即使这会降低整体指标。
²⁵ 感谢 Eugene Yan 提供这个绝妙的例子!
类别不平衡的挑战
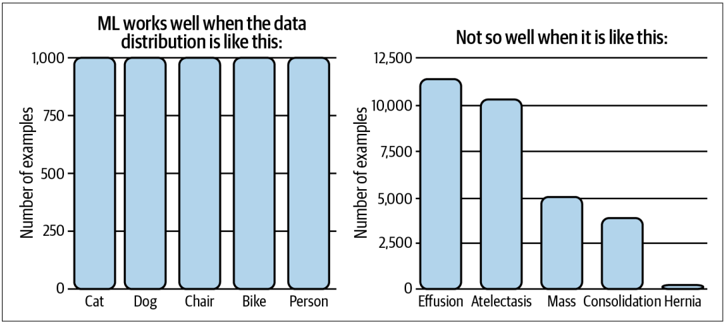
ML,尤其是深度学习,在数据分布更均衡的情况下表现良好,而在类别严重不平衡时通常表现不佳,如图 4-8 所示。类别不平衡会从以下三个原因使学习变得困难。
图 4-8. 在类别均衡的情况下,ML 表现良好。来源:改编自 Andrew Ng 的图片²⁶
²⁶ Andrew Ng,《弥合 AI 从概念验证到生产的鸿沟》(Bridging AI’s Proof-of-Concept to Production Gap),HAI 研讨会,2020 年 9 月 22 日,视频,1:02:07,https://oreil.ly/FSFWS。
第一个原因是:类别不平衡通常意味着模型学习识别少数类别的信号不足。当少数类别的样本数量很少时,问题就变成了少样本学习(few-shot learning)问题——你的模型在必须对它做决策之前,只能看到少数类别寥寥几次。当训练集中完全没有稀有类别的样本时,你的模型可能会认为这些稀有类别不存在。
第二个原因是:类别不平衡让模型更容易陷入非最优解——模型会利用一个简单的启发式规则,而不是学习数据底层模式中任何有用的东西。考虑前面肺癌检测的例子。如果你的模型学会了总是输出多数类别,它的准确率已经是 99.99%。²⁷ 对于梯度下降算法来说,这个启发式规则可能非常难以击败,因为在这个规则上增加一点随机性可能导致准确率下降。
²⁷ 这正是准确率在类别不平衡任务中是一个糟糕指标的原因,我们将在第 105 页"应对类别不平衡"一节进一步探讨。
第三个原因是:类别不平衡导致不对称的错误代价——对稀有类别样本的错误预测代价可能远高于对多数类别样本的错误预测。
例如,对一张含癌细胞的 X 光片分类错误,远比把一张正常肺部的 X 光片分类错误危险。如果你的损失函数没有配置为处理这种不对称性,你的模型就会对所有样本一视同仁。结果,你可能会得到一个在多数类别和少数类别上表现同样好的模型,而你其实更希望得到一个在多数类别上表现差一些、但在少数类别上好得多的模型。
我上学的时候,拿到的大多数数据集类别或多或少是均衡的。²⁸ 开始工作后,我震惊地意识到类别不平衡才是常态。在现实世界中,稀有事件往往比普通事件更有趣(或更危险),许多任务都聚焦于检测这些稀有事件。
²⁸ 我当时想,如果不用琢磨怎么处理类别不平衡,学 ML 理论可能会更容易。
类别不平衡任务的经典例子是欺诈检测。大多数信用卡交易都不是欺诈性的。截至 2018 年,持卡人每消费 100 美元中就有 6.8 美分是欺诈性的。²⁹ 另一个例子是流失预测(churn prediction)。你的大多数客户可能并不打算取消订阅。如果他们真的打算取消,你的企业要操心的事情可比流失预测算法多得多。其他例子还包括疾病筛查(幸运的是,大多数人都没有绝症)和简历筛选(98% 的求职者在最初的简历筛选中就被淘汰³⁰)。
²⁹ 《Nilson 报告》,《支付卡欺诈损失达 278.5 亿美元》(Payment Card Fraud Losses Reach $27.85 Billion),美通社(PR Newswire),2019 年 11 月 21 日,https://oreil.ly/NM5zo。
³⁰ 《就业市场专家解释为什么只有 2% 的求职者获得面试机会》(Job Market Expert Explains Why Only 2% of Job Seekers Get Interviewed),WebWire,2014 年 1 月 7 日,https://oreil.ly/UpL8S。
一个不那么明显的类别不平衡任务例子是目标检测(object detection)。目前的目标检测算法通过在图像上生成大量边界框,然后预测哪些框最可能包含物体来工作。大多数边界框并不包含相关物体。
除了类别不平衡天然存在于问题中的情况之外,采样过程中的偏差也可能导致类别不平衡。考虑这样一个案例:你想创建训练数据来检测一封电子邮件是否为垃圾邮件。你决定使用公司邮件数据库中所有匿名化的邮件。根据 Talos Intelligence 的数据,截至 2021 年 5 月,近 85% 的电子邮件是垃圾邮件。³¹ 但大多数垃圾邮件在到达你公司的数据库之前就被过滤掉了,所以在你的数据集中,只有很小比例的垃圾邮件。
³¹ 《邮件与垃圾邮件数据》(Email and Spam Data),Talos Intelligence,最后访问于 2021 年 5 月,https://oreil.ly/lI5Jr。
类别不平衡的另一个成因(虽然不那么常见)是标注错误。标注员可能读错了说明,或遵循了错误的说明(以为只有 POSITIVE 和 NEGATIVE 两个类别,而实际上有三个),或者只是犯了错误。每当面对类别不平衡问题时,检查你的数据以理解其成因是很重要的。
应对类别不平衡
由于类别不平衡在现实应用中的普遍性,过去二十年间人们对它进行了深入研究。³² 类别不平衡对任务的影响因不平衡程度而异。有些任务对类别不平衡比其他任务更敏感。Japkowicz 表明,对不平衡的敏感度随问题复杂度的增加而增加,而简单的、线性可分的问题不受任何程度类别不平衡的影响。³³ 二分类问题中的类别不平衡比多分类问题中的类别不平衡容易处理得多。Ding 等人表明,非常深的神经网络——在 2017 年,“非常深"意味着超过 10 层——在不平衡数据上的表现远好于较浅的神经网络。³⁴
³² Nathalie Japkowicz 和 Shaju Stephen,《类别不平衡问题:一项系统研究》(The Class Imbalance Problem: A Systematic Study),2002 年,https://oreil.ly/d7lVu。
³³ Nathalie Japkowicz,《类别不平衡问题:意义与策略》(The Class Imbalance Problem: Significance and Strategies),2000 年,https://oreil.ly/Ma50Z。
³⁴ Wan Ding、Dong-Yan Huang、Zhuo Chen、Xinguo Yu 和 Weisi Lin,《用于高度不平衡类别分布的面部动作识别:基于非常深网络的方法》(Facial Action Recognition Using Very Deep Networks for Highly Imbalanced Class Distribution),《2017 年亚太信号与信息处理协会年会暨峰会(APSIPA ASC)》,2017 年,https://oreil.ly/WeW6J。
人们提出了许多技术来减轻类别不平衡的影响。然而,随着神经网络变得越来越大、越来越深,学习能力越来越强,有些人可能会争辩说:如果真实世界中的数据就是这样分布的,你就不应该试图"修复"类别不平衡。一个好的模型应该学会对这种不平衡建模。然而,开发一个足够好的模型来做到这一点可能很有挑战性,所以我们仍然必须依赖特殊的训练技术。
在本节中,我们将介绍应对类别不平衡的三种方法:为你的问题选择正确的指标;数据层面的方法(data-level methods),即改变数据分布使其不那么不平衡;以及算法层面的方法(algorithm-level methods),即改变你的学习方法使其对类别不平衡更稳健。
这些技术可能是必要的,但并不充分。如需全面综述,我推荐《类别不平衡深度学习综述》(Johnson 和 Khoshgoftaar,2019 年)。
使用正确的评估指标
面对类别不平衡任务时,最重要的事情是选择恰当的评估指标。错误的指标会给你关于模型表现如何的错误认知,进而无法帮助你开发或选择足以胜任任务的模型。
总体准确率(accuracy)和错误率是报告 ML 模型性能最常用的指标。然而,对于类别不平衡的任务,这些指标是不充分的,因为它们平等对待所有类别,这意味着模型在多数类别上的表现会主导这些指标。当多数类别并不是你所关心的类别时,这就尤其糟糕。
考虑一个包含两个标签的任务:CANCER(癌症,正类)和 NORMAL(正常,负类),其中 90% 的标签数据是 NORMAL。再考虑两个模型 A 和 B,其混淆矩阵(confusion matrix)如表 4-4 和表 4-5 所示。
表 4-4. 模型 A 的混淆矩阵;模型 A 能检出 100 个 CANCER 病例中的 10 个
| 模型 A | 实际 CANCER | 实际 NORMAL |
|---|---|---|
| 预测 CANCER | 10 | 10 |
| 预测 NORMAL | 90 | 890 |
表 4-5. 模型 B 的混淆矩阵;模型 B 能检出 100 个 CANCER 病例中的 90 个
| 模型 B | 实际 CANCER | 实际 NORMAL |
|---|---|---|
| 预测 CANCER | 90 | 90 |
| 预测 NORMAL | 10 | 810 |
如果你和大多数人一样,你可能会更愿意让模型 B 为你做预测,因为它更有可能告诉你是否真的得了癌症。然而,它们的准确率都是 0.9。
能帮助你理解模型在特定类别上表现的指标会是更好的选择。如果你对每个类别单独使用准确率,它仍然可以是一个好指标。模型 A 在 CANCER 类别上的准确率是 10%,模型 B 在 CANCER 类别上的准确率是 90%。
F1、精确率(precision)和召回率(recall)是衡量二分类问题中模型在正类上表现的指标,因为它们依赖真阳性(true positive)——即模型正确预测正类的结果。³⁵
³⁵ 截至 2021 年 7 月,当你使用 scikit-learn.metrics.f1_score 时,pos_label 默认为 1,但如果你想让 0 成为你的正标签,可以把它改为 0。
精确率、召回率与 F1
需要复习的读者请注意:对于二分类任务,精确率、召回率和 F1 分数是用真阳性、真阴性(true negative)、假阳性(false positive)和假阴性(false negative)的数量计算的。这些术语的定义如表 4-6 所示。
表 4-6. 二分类任务中真阳性、假阳性、假阴性和真阴性的定义
| 预测为正 | 预测为负 | |
|---|---|---|
| 实际为正 | 真阳性(TP,命中) | 假阴性(FN,第二类错误,漏报) |
| 实际为负 | 假阳性(FP,第一类错误,误报) | 真阴性(TN,正确拒绝) |
F1、精确率和召回率是不对称指标,这意味着它们的值会随着哪个类别被视为正类而变化。在我们的例子中,如果把 CANCER 视为正类,模型 A 的 F1 是 0.17。然而,如果把 NORMAL 视为正类,模型 A 的 F1 是 0.95。当 CANCER 是正类时,模型 A 和模型 B 的准确率、精确率、召回率和 F1 分数如表 4-7 所示。
表 4-7. 尽管一个模型明显更优,两个模型的准确率却相同
| CANCER(1) | NORMAL(0) | 准确率 | 精确率 | 召回率 | F1 | |
|---|---|---|---|---|---|---|
| 模型 A | 10/100 | 890/900 | 0.9 | 0.5 | 0.1 | 0.17 |
| 模型 B | 90/100 | 810/900 | 0.9 | 0.5 | 0.9 | 0.64 |
许多分类问题都可以建模为回归问题。你的模型可以输出一个概率,然后基于这个概率对样本进行分类。例如,如果值大于 0.5,就是正标签;如果小于或等于 0.5,就是负标签。这意味着你可以调整阈值,以提高真阳性率(也称为召回率),同时降低假阳性率(也称为误报概率),反之亦然。我们可以针对不同阈值绘制真阳性率与假阳性率的曲线。这条曲线被称为 ROC 曲线(receiver operating characteristics,受试者工作特征曲线)。当你的模型完美时,召回率为 1.0,曲线就是顶部的一条直线。这条曲线向你展示模型性能如何随阈值变化,并帮助你选择最适合你的阈值。越接近完美线,模型性能越好。
曲线下面积(AUC,area under the curve)衡量 ROC 曲线下方的面积。由于越接近完美线越好,这个面积越大越好,如图 4-9 所示。
图 4-9. ROC 曲线
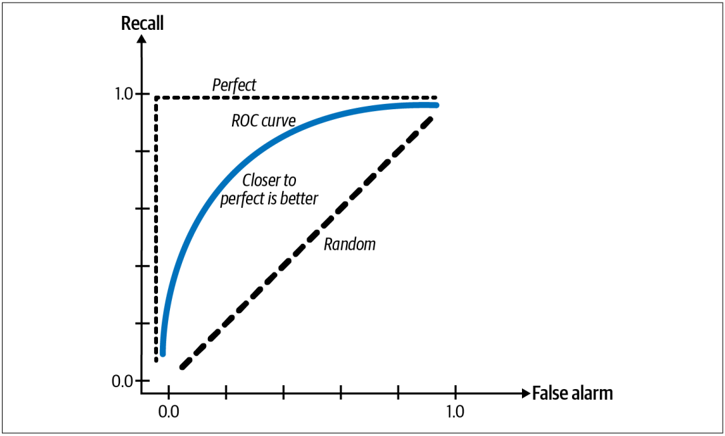
与 F1 和召回率一样,ROC 曲线只关注正类,不展示模型在负类上的表现。Davis 和 Goadrich 建议,我们应该转而绘制精确率对召回率的曲线,他们称之为精确率-召回率曲线(Precision-Recall Curve)。他们认为,这条曲线能更全面地展示算法在类别严重不平衡任务上的表现。³⁶
³⁶ Jesse Davis 和 Mark Goadrich,《精确率-召回率曲线与 ROC 曲线的关系》(The Relationship Between Precision-Recall and ROC Curves),《第 23 届国际机器学习会议论文集》,2006 年,https://oreil.ly/s40F3。
数据层面的方法:重采样
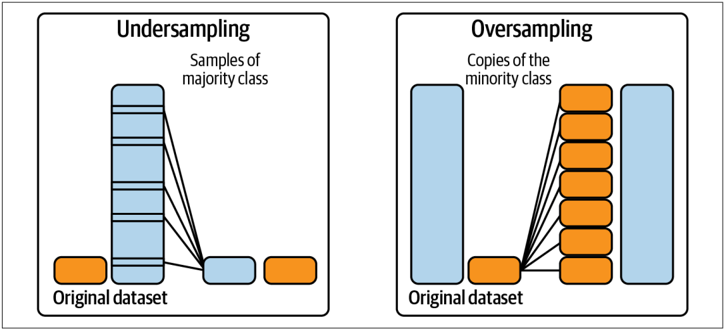
数据层面的方法通过修改训练数据的分布来降低不平衡程度,使模型更容易学习。一类常见的技术是重采样(resampling)。重采样包括过采样(oversampling)——即从少数类别中添加更多样本——和欠采样(undersampling)——即移除多数类别的样本。最简单的欠采样方法是从多数类别中随机移除样本,而最简单的过采样方法是随机复制少数类别的样本,直到达到你满意的比例。图 4-10 展示了过采样和欠采样的可视化。
图 4-10. 欠采样和过采样工作原理的示意图。来源:改编自 Rafael Alencar 的图片³⁷
³⁷ Rafael Alencar,《不平衡数据集的重采样策略》(Resampling Strategies for Imbalanced Datasets),Kaggle,https://oreil.ly/p8Whs。
一种早在 1976 年就开发出来的、流行的低维数据欠采样方法是 Tomek 链接(Tomek links)。³⁸ 用这种技术,你要找到来自相反类别、距离很近的样本对,并移除每一对中多数类别的样本。
³⁸ Ivan Tomek,《用编辑后的最近邻规则做的一次实验》(An Experiment with the Edited Nearest-Neighbor Rule),《IEEE 系统、人与控制论汇刊》(1976 年 6 月):448-52,https://oreil.ly/JCxHZ。
虽然这使决策边界更清晰,可以说有助于模型更好地学习边界,但它可能让模型变得更不稳健,因为模型无法从真实决策边界的细微之处中学习。
一种流行的低维数据过采样方法是 SMOTE(合成少数类过采样技术,synthetic minority oversampling technique)。³⁹ 它通过在少数类别中现有数据点的凸组合(convex combination)采样,来合成少数类别的新样本。⁴⁰
³⁹ N.V. Chawla、K.W. Bowyer、L.O. Hall 和 W.P. Kegelmeyer,《SMOTE:合成少数类过采样技术》(SMOTE: Synthetic Minority Over-sampling Technique),《人工智能研究杂志》第 16 卷(2002 年):341-78,https://oreil.ly/f6y46。
⁴⁰ 这里的"凸"大致意思是"线性”。
SMOTE 和 Tomek 链接都只在低维数据中被证明有效。许多复杂的重采样技术,如 Near-Miss 和单侧选择(one-sided selection),⁴¹ 都需要计算样本之间或样本与决策边界之间的距离,对于高维数据或高维特征空间(例如大型神经网络的情况),这可能代价高昂或不可行。
⁴¹ Jianping Zhang 和 Inderjeet Mani,《不平衡数据分布的 kNN 方法:信息抽取案例研究》(kNN Approach to Unbalanced Data Distributions: A Case Study involving Information Extraction),不平衡数据集学习研讨会 II,ICML,华盛顿特区,2003 年,https://oreil.ly/qnpra;Miroslav Kubat 和 Stan Matwin,《应对不平衡训练集的诅咒:单侧选择》(Addressing the Curse of Imbalanced Training Sets: One-Sided Selection),2000 年,https://oreil.ly/8pheJ。
当你对训练数据重采样时,永远不要在重采样的数据上评估模型,因为那会让模型过拟合到重采样后的分布。
欠采样有因移除数据而丢失重要数据的风险。过采样有在训练数据上过拟合的风险,尤其是当添加的少数类别副本是现有数据的复制品时。人们开发了许多复杂的采样技术来减轻这些风险。
其中一种技术是两阶段学习(two-phase learning)。⁴² 你首先在重采样的数据上训练模型。这个重采样数据可以通过随机欠采样大类来实现,直到每个类别只有 N 个样本。然后你在原始数据上微调模型。
⁴² Hansang Lee、Minseok Park 和 Junmo Kim,《利用卷积神经网络与迁移学习在不平衡大规模数据库上进行浮游生物分类》(Plankton Classification on Imbalanced Large Scale Database via Convolutional Neural Networks with Transfer Learning),《2016 年 IEEE 国际图像处理会议(ICIP)》,2016 年,https://oreil.ly/YiA8p。
另一种技术是动态采样(dynamic sampling):在训练过程中对表现差的类别过采样,对表现好的类别欠采样。这种方法由 Pouyanfar 等人提出,⁴³ 其目标是让模型少看一些它已经学会的内容,多看一些它还没学会的内容。
⁴³ Samira Pouyanfar、Yudong Tao、Anup Mohan、Haiman Tian、Ahmed S. Kaseb、Kent Gauen、Ryan Dailey 等人,《用于不平衡数据分类的卷积神经网络动态采样》(Dynamic Sampling in Convolutional Neural Networks for Imbalanced Data Classification),《2018 年 IEEE 多媒体信息处理与检索会议(MIPR)》,2018 年,https://oreil.ly/D3Ak5。
算法层面的方法
如果说数据层面的方法是通过改变训练数据的分布来缓解类别不平衡的挑战,那么算法层面的方法则保持训练数据分布不变,但改变算法使其对类别不平衡更稳健。
由于损失函数(loss function,或代价函数 cost function)引导着学习过程,许多算法层面的方法都涉及对损失函数的调整。关键思想是:如果有两个样本 \(x_1\) 和 \(x_2\),在 \(x_1\) 上做出错误预测导致的损失高于 \(x_2\),那么模型会优先在 \(x_1\) 上做出正确预测,而不是在 \(x_2\) 上。通过给我们关心的训练样本更高的权重,我们可以让模型更专注于学习这些样本。
设 \(L(x; \theta)\) 为样本 \(x\) 在参数集为 \(\theta\) 的模型上造成的损失。模型的损失通常定义为所有样本造成损失的平均值。\(N\) 表示训练样本的总数。
\[ L(\theta) = \frac{1}{N}\sum_{i=1}^{N} L(x_i; \theta) \]这个损失函数对所有样本造成的损失一视同仁,尽管在某些样本上的错误预测可能比在其他样本上代价高得多。修改这个代价函数的方法有很多。在本节中,我们将重点介绍其中三种,从代价敏感学习开始。
代价敏感学习(Cost-sensitive learning)。早在 2001 年,基于不同类别误分类代价不同的洞见,Elkan 提出了代价敏感学习,其中个体损失函数被修改以考虑这种变化的代价。⁴⁴ 该方法首先使用代价矩阵(cost matrix)来指定 \(C_{ij}\):类别 \(i\) 被分类为类别 \(j\) 的代价。如果 \(i = j\),就是正确分类,代价通常为 0。如果不是,就是误分类。如果把 POSITIVE 样本分类为 NEGATIVE 的代价是反过来的两倍,你可以把 \(C_{10}\) 设为 \(C_{01}\) 的两倍。
⁴⁴ 脚注原文在 PDF 提取中缺失。
例如,如果你有两个类别 POSITIVE 和 NEGATIVE,代价矩阵可以如表 4-8 所示。
表 4-8. 代价矩阵示例
| 实际 NEGATIVE | 实际 POSITIVE | |
|---|---|---|
| 预测 NEGATIVE | C(0, 0) = C₀₀ | C(1, 0) = C₁₀ |
| 预测 POSITIVE | C(0, 1) = C₀₁ | C(1, 1) = C₁₁ |
类别 \(i\) 的样本 \(x\) 造成的损失将变成样本 \(x\) 所有可能分类结果的加权平均:
\[ L(x_i; \theta) = \sum_{j=1}^{K} C_{ij} \cdot \text{Loss}(x_i, j) \]这个损失函数的问题在于你必须手动定义代价矩阵,而不同任务、不同规模下的代价矩阵各不相同。
类别平衡损失(Class-balanced loss)。在不平衡数据集上训练的模型可能会偏向多数类别,并在少数类别上做出错误预测。如果我们惩罚模型在少数类别上的错误预测来纠正这种偏差,会怎么样?
在其最朴素的形式中,我们可以让每个类别的权重与该类别中的样本数量成反比,这样越稀有的类别权重越高。在下面的公式中,\(N\) 表示训练样本的总数:
\[ w_i = \frac{N}{N_i} \]类别 \(i\) 的样本 \(x\) 造成的损失将变成下面的形式,其中 \(\text{Loss}(x, j)\) 是 \(x\) 被分类为类别 \(j\) 时的损失。它可以是交叉熵(cross entropy)或任何其他损失函数。
\[ L(x_i; \theta) = w_i \cdot \text{Loss}(x_i, j) \]这个损失的一个更复杂的版本可以考虑现有样本之间的重叠,例如基于有效样本数(effective number of samples)的类别平衡损失。⁴⁵
⁴⁵ Yin Cui、Menglin Jia、Tsung-Yi Lin、Yang Song 和 Serge Belongie,《基于有效样本数的类别平衡损失》(Class-Balanced Loss Based on Effective Number of Samples),《计算机视觉与模式识别会议论文集》,2019 年,https://oreil.ly/jCzGH。
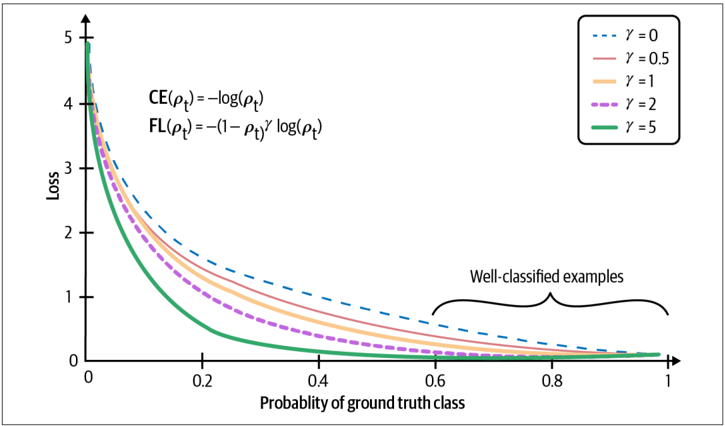
焦点损失(Focal loss)。在我们的数据中,有些样本比其他样本更容易分类,我们的模型可能很快就学会了分类它们。我们想激励模型专注于学习它仍然难以分类的样本。如果我们调整损失,让正确概率较低的样本拥有更高的权重,会怎么样?这正是焦点损失所做的。⁴⁶ 焦点损失的公式及其与交叉熵损失的性能对比见图 4-11。
⁴⁶ Tsung-Yi Lin、Priya Goyal、Ross Girshick、Kaiming He 和 Piotr Dollár,《用于密集目标检测的焦点损失》(Focal Loss for Dense Object Detection),arXiv,2017 年 8 月 7 日,https://oreil.ly/Km2dF。
在实践中,集成已被证明有助于解决类别不平衡问题。⁴⁷ 然而,我们不在本节中介绍集成,因为类别不平衡通常不是使用集成的原因。集成技术将在第 6 章介绍。
⁴⁷ Mikel Galar、Alberto Fernandez、Edurne Barrenechea、Humberto Bustince 和 Francisco Herrera,《类别不平衡问题集成方法综述:基于 Bagging、Boosting 和混合的方法》(A Review on Ensembles for the Class Imbalance Problem: Bagging-, Boosting-, and Hybrid-Based Approaches),《IEEE 系统、人与控制论汇刊——C 部分:应用与评论》第 42 卷第 4 期(2012 年 7 月):463-84,https://oreil.ly/1ND4g。
图 4-11. 用焦点损失(FL)训练的模型与用交叉熵损失(CE)训练的模型相比,损失值更低。来源:改编自 Lin 等人的图片
数据增强
数据增强是一类用来增加训练数据量的技术。传统上,这些技术用于训练数据有限的任务,例如医学影像。然而,在过去几年里,即使拥有大量数据,它们也被证明很有用——经过增强的数据可以让我们的模型对噪声甚至对抗攻击(adversarial attacks)更加稳健。
数据增强已成为许多计算机视觉任务的标准步骤,并且正在进入自然语言处理(NLP)任务。这些技术高度依赖数据格式,因为图像处理不同于文本处理。在本节中,我们将介绍三种主要的数据增强类型:简单的保标签变换(label-preserving transformations);扰动(perturbation),即"添加噪声";以及数据合成(data synthesis)。对每种类型,我们都会介绍计算机视觉和 NLP 的例子。
简单的保标签变换
在计算机视觉中,最简单的数据增强技术是在保持图像标签不变的同时随机修改图像。你可以通过裁剪、翻转、旋转、反转(水平或垂直)、擦除部分图像等方式修改图像。这很合理,因为一张旋转后的狗的图像仍然是狗。PyTorch、TensorFlow 和 Keras 等常见 ML 框架都支持图像增强。根据 Krizhevsky 等人在他们传奇性的 AlexNet 论文中的说法:“变换后的图像是在 GPU 训练上一批图像的同时,用 Python 代码在 CPU 上生成的。因此,这些数据增强方案实际上是计算免费的。“⁴⁸
⁴⁸ Alex Krizhevsky、Ilya Sutskever 和 Geoffrey E. Hinton,《用深度卷积神经网络进行 ImageNet 分类》(ImageNet Classification with Deep Convolutional Neural Networks),2012 年,https://oreil.ly/aphzA。
在 NLP 中,你可以随机用一个相似词替换某个词,前提是这种替换不会改变句子的含义或情感,如表 4-9 所示。相似词可以通过同义词词典找到,也可以通过在词嵌入空间中找到嵌入彼此接近的词来发现。
表 4-9. 从一个原始句子生成三个句子
| 原始句子 | I’m so happy to see you. |
|---|---|
| 生成的句子 | I’m so glad to see you. I’m so happy to see y’all. I’m very happy to see you. |
这类数据增强是快速将训练数据翻倍或翻三倍的方法。
扰动
扰动也是一种保标签的操作,但因为有时它被用来诱骗模型做出错误预测,我认为它值得单独一节。
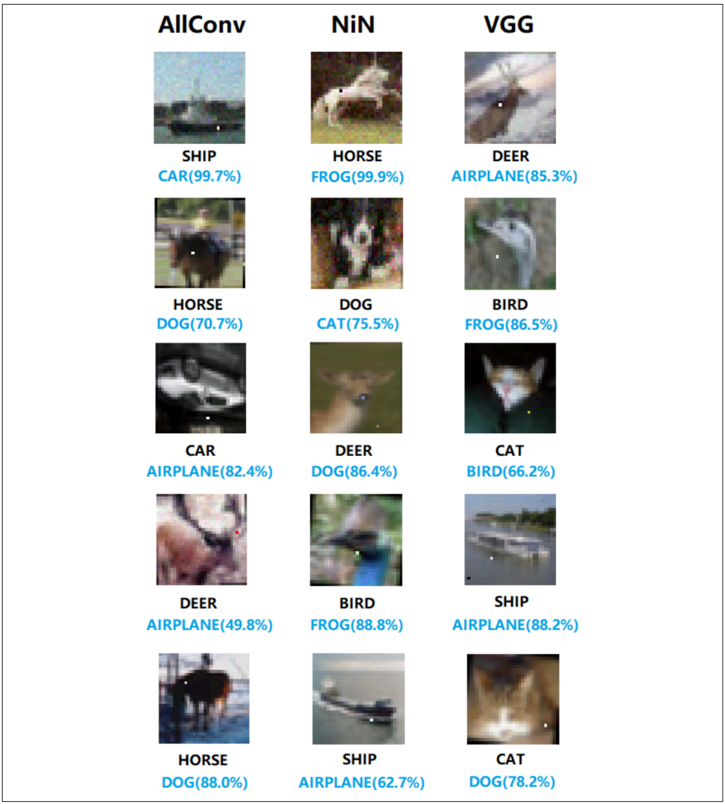
一般来说,神经网络对噪声很敏感。就计算机视觉而言,这意味着给图像添加少量噪声就能让神经网络错误分类它。Su 等人表明,Kaggle CIFAR-10 测试数据集中 67.97% 的自然图像和 ImageNet 测试集中 16.04% 的图像,可以仅通过改变一个像素就被错误分类(见图 4-12)。⁴⁹
⁴⁹ Jiawei Su、Danilo Vasconcellos Vargas 和 Sakurai Kouichi,《欺骗深度神经网络的一像素攻击》(One Pixel Attack for Fooling Deep Neural Networks),《IEEE 进化计算汇刊》第 23 卷第 5 期(2019 年):828-41,https://oreil.ly/LzN9D。
图 4-12. 改变一个像素就能让神经网络做出错误预测。使用的三个模型是 AllConv、NiN 和 VGG。这些模型对原图做出的标签标注在改变一个像素后做出的标签上方。来源:Su 等人⁵⁰
⁵⁰ Su 等人,《一像素攻击》。
使用欺骗性数据诱使神经网络做出错误预测被称为对抗攻击。给样本添加噪声是创建对抗样本(adversarial samples)的常用技术。随着图像分辨率的提高,对抗攻击的成功率尤其被放大。
在训练数据中添加有噪声的样本,可以帮助模型识别其已学决策边界中的薄弱点并提升性能。⁵¹ 噪声样本可以通过添加随机噪声或通过搜索策略来创建。Moosavi-Dezfooli 等人提出了一种名为 DeepFool 的算法,它可以找到以高置信度引起误分类所需的最小噪声注入量。⁵² 这种增强被称为对抗增强(adversarial augmentation)。⁵³
⁵¹ Ian J. Goodfellow、Jonathon Shlens 和 Christian Szegedy,《解释和利用对抗样本》(Explaining and Harnessing Adversarial Examples),arXiv,2015 年 3 月 20 日,https://oreil.ly/9v2No;Ian J. Goodfellow、David Warde-Farley、Mehdi Mirza、Aaron Courville 和 Yoshua Bengio,《Maxout 网络》(Maxout Networks),arXiv,2013 年 2 月 18 日,https://oreil.ly/L8mch。
⁵² Seyed-Mohsen Moosavi-Dezfooli、Alhussein Fawzi 和 Pascal Frossard,《DeepFool:一种简单准确的欺骗深度神经网络的方法》(DeepFool: A Simple and Accurate Method to Fool Deep Neural Networks),《IEEE 计算机视觉与模式识别会议(CVPR)论文集》,2016 年,https://oreil.ly/dYVL8。
⁵³ Takeru Miyato、Shin-ichi Maeda、Masanori Koyama 和 Shin Ishii,《虚拟对抗训练:一种用于监督和半监督学习的正则化方法》(Virtual Adversarial Training: A Regularization Method for Supervised and Semi-Supervised Learning),《IEEE 模式分析与机器智能汇刊》,2017 年,https://oreil.ly/MBQeu。
对抗增强在 NLP 中不太常见(一只随机添加了像素的熊的图像看起来仍然像熊,但给一个随机句子添加随机字符很可能会让它变成胡言乱语),但扰动已被用来让模型更稳健。最著名的例子之一是 BERT:模型随机选择每个序列中 15% 的词元,并将其中 10% 替换为随机词。例如,给定句子"My dog is hairy”(我的狗毛茸茸的),模型随机把"hairy"替换成"apple”,句子就变成了"My dog is apple"。所以全部词元中可能有 1.5% 会产生无意义的语义。他们的消融研究表明,一小部分随机替换给模型带来了小幅性能提升。⁵⁴
⁵⁴ Devlin 等人,《BERT:用于语言理解的深度双向 Transformer 预训练》。
在第 6 章中,我们将介绍如何把扰动不仅用作提升模型性能的方法,还用作评估模型性能的方法。
数据合成
由于收集数据既昂贵又缓慢,还伴随许多潜在的隐私问题,如果我们能完全绕开它、用合成数据训练模型,那将是一个梦想。尽管我们距离合成全部训练数据还很远,但合成一部分训练数据来提升模型性能是可能的。
在 NLP 中,模板可以是一种廉价的模型启动方式。我曾合作过的一个团队使用模板为他们的对话式 AI(聊天机器人)启动训练数据。模板可能长这样:“Find me a [CUISINE] restaurant within [NUMBER] miles of [LOCATION]"(帮我在离[地点] [数字] 英里内找一家[菜系]餐厅),见表 4-10。有了每个城市所有可能的菜系清单、合理的数字范围(你大概永远不会想搜索 1,000 英里以外的餐厅)和地点(家、办公室、地标、精确地址),你就可以从一个模板生成数千条训练查询。
表 4-10. 从一个模板生成三个句子
| 模板 | Find me a [CUISINE] restaurant within [NUMBER] miles of [LOCATION]. |
|---|---|
| 生成的查询 | Find me a Vietnamese restaurant within 2 miles of my office. Find me a Thai restaurant within 5 miles of my home. Find me a Mexican restaurant within 3 miles of Google headquarters. |
在计算机视觉中,一种直接合成新数据的方法是把带离散标签的现有样本组合起来,生成连续标签。考虑一个用两个可能标签对图像分类的任务:DOG(编码为 0)和 CAT(编码为 1)。从标签为 DOG 的样本 \(x_1\) 和标签为 CAT 的样本 \(x_2\),你可以生成 \(x'\) 如下:
\[ x' = \gamma x_1 + (1 - \gamma) x_2 \]\(x'\) 的标签是 \(x_1\) 和 \(x_2\) 标签的组合:\(\gamma \times 0 + (1 - \gamma) \times 1\)。这种方法叫做 mixup。作者表明,mixup 能提升模型的泛化能力、减少模型对损坏标签的记忆、增强对对抗样本的稳健性,并稳定生成对抗网络(GAN)的训练。⁵⁵
⁵⁵ Hongyi Zhang、Moustapha Cisse、Yann N. Dauphin 和 David Lopez-Paz,《mixup:超越经验风险最小化》(mixup: Beyond Empirical Risk Minimization),ICLR 2018,https://oreil.ly/lIM5E。
使用神经网络合成训练数据是一个令人兴奋的方法,目前正被积极研究,但在生产环境中还不流行。Sandfort 等人表明,通过把用 CycleGAN 生成的图像加入原始训练数据,他们显著提升了模型在计算机断层扫描(CT)分割任务上的表现。⁵⁶
⁵⁶ Veit Sandfort、Ke Yan、Perry J. Pickhardt 和 Ronald M. Summers,《使用生成对抗网络(CycleGAN)进行数据增强以提升 CT 分割任务的泛化能力》(Data Augmentation Using Generative Adversarial Networks (CycleGAN) to Improve Generalizability in CT Segmentation Tasks),《科学报告》第 9 卷第 1 期(2019 年):16884,https://oreil.ly/TDUwm。
如果你有兴趣了解更多关于计算机视觉数据增强的内容,《深度学习图像数据增强综述》(Shorten 和 Khoshgoftaar,2019 年)是一份全面的综述。
小结
训练数据仍然是现代 ML 算法的基础。无论你的算法有多聪明,如果训练数据很糟糕,你的算法就无法表现出色。投入时间和精力去整理和创建能让算法学到有意义内容的训练数据,是值得的。
在本章中,我们讨论了创建训练数据的多个步骤。我们首先介绍了不同的采样方法,包括非概率采样和随机采样,它们可以帮助我们为问题采样到合适的数据。
如今使用的大多数 ML 算法都是监督式 ML 算法,因此获取标签是创建训练数据不可或缺的一部分。许多任务,如配送时间估算或推荐系统,都有自然标签。自然标签通常有延迟,从预测被提供到反馈产生所经过的时间就是反馈回路长度。具有自然标签的任务在业界相当普遍,这可能意味着公司更愿意从有自然标签的任务做起,而不是没有自然标签的任务。
对于没有自然标签的任务,公司往往依赖人工标注员为数据标注。然而,人工标注有很多缺点。例如,人工标签可能昂贵且缓慢。为了应对人工标签的缺乏,我们讨论了替代方案,包括弱监督、半监督、迁移学习和主动学习。
ML 算法在数据分布更均衡的情况下表现良好,而在类别严重不平衡时表现不佳。遗憾的是,类别不平衡问题在现实世界中才是常态。在接下来的部分中,我们讨论了为什么类别不平衡会让 ML 算法难以学习。我们还讨论了应对类别不平衡的不同技术,从选择正确的指标,到重采样数据,再到修改损失函数以鼓励模型关注特定样本。
在本章结尾,我们讨论了数据增强技术,这些技术可用于提升模型在计算机视觉和 NLP 任务上的性能和泛化能力。
一旦你有了训练数据,你就要从中提取特征来训练 ML 模型,我们将在下一章介绍。