数据工程基础
近年来机器学习的兴起与大数据(big data)的兴起紧密相关。大型数据系统,即使没有机器学习,也相当复杂。如果你没有花很多年与它们打交道,很容易迷失在一堆缩写词中。这些系统带来了许多挑战和可能的解决方案。行业标准——如果存在的话——随着新工具的出现和行业需求的扩大而快速演变,营造出一个动态且不断变化的环境。如果你观察不同科技公司的数据技术栈,看起来似乎每家都在各搞一套。
在本章中,我们将介绍数据工程(data engineering)的基础知识,希望能在你为自己的需求探索这片领域时,给你一块坚实的立足之地。我们将从典型机器学习项目中可能遇到的不同的数据来源(data source)讲起,然后继续讨论数据可以以哪些格式存储。存储数据只有在你还打算以后取回这些数据时才有意义。要取回存储的数据,不仅需要知道它的格式,还需要知道它的结构。数据模型(data model)定义了以特定数据格式存储的数据是如何组织的。
如果数据模型描述的是现实世界中的数据,那么数据库(database)则规定了数据应该如何存储在机器上。我们将继续讨论数据存储引擎(storage engine),也就是数据库,以及两大主要处理类型:事务处理与分析处理。
在生产环境中处理数据时,你通常要跨多个进程和服务来处理数据。例如,你可能有一个特征工程(feature engineering)服务,从原始数据计算特征;还有一个预测服务,基于计算好的特征生成预测。这意味着你必须把计算好的特征从特征工程服务传递到预测服务。在本章的下一节中,我们将讨论跨进程传递数据的不同模式。
在讨论不同的数据传递模式时,我们会接触到两种截然不同的数据:存储在数据存储引擎中的历史数据(historical data),以及实时传输(real-time transport)中的流式数据(streaming data)。这两种不同类型的数据需要不同的处理范式,我们将在第 78 页的「批处理与流处理」一节中讨论。
知道如何收集、处理、存储、检索并处理日益增长的数据量,对于想要构建生产级机器学习系统的人来说至关重要。如果你已经熟悉数据系统,可以直接跳到第 4 章,了解如何采样和生成标签以创建训练数据(training data)。如果你想从系统角度了解更多数据工程知识,我推荐 Martin Kleppmann 的杰出著作《Designing Data-Intensive Applications》(中文版《数据密集型应用系统设计》,O’Reilly, 2017)。
数据源
一个机器学习系统可以使用来自许多不同来源的数据。这些数据具有不同的特征,可以用于不同的目的,并且需要不同的处理方法。了解数据的来源可以帮助你更高效地使用数据。本节旨在为那些不熟悉生产环境数据的人快速概述不同的数据来源。如果你已经在生产环境中使用机器学习一段时间了,可以跳过本节。
一种来源是用户输入数据(user input data),即用户明确输入的数据。用户输入可以是文本、图像、视频、上传的文件等。只要用户有哪怕一丝可能输入错误的数据,他们就一定会那么做。因此,用户输入数据很容易格式错误。文本可能太长或太短。在期望数值输入的地方,用户可能不小心输入了文本。如果你允许用户上传文件,他们可能上传错误格式的文件。用户输入数据需要更严格的检查和更重的处理。
除此之外,用户也几乎没有耐心。在大多数情况下,当我们输入数据时,期望立即得到结果。因此,用户输入数据往往需要快速处理。
另一种来源是系统生成数据(system-generated data)。这是由系统各个组件生成的数据,包括各种类型的日志和系统输出,例如模型预测。
日志可以记录系统的状态和重要事件,例如内存使用量、实例数量、调用的服务、使用的包等。它们可以记录不同作业的结果,包括大规模数据处理和模型训练的批处理作业。这些类型的日志让我们能看清系统的运行状况。这种可见性的主要目的是调试和潜在的应用改进。大多数时候,你不必查看这些类型的日志,但当系统出问题时,它们至关重要。
由于日志是系统生成的,它们远不像用户输入数据那样容易出现格式错误。总的来说,日志不需要像用户输入数据那样一到达就必须立刻处理。对许多用例来说,定期处理日志是可以接受的,比如每小时甚至每天处理一次。不过,你可能仍然希望快速处理日志,以便在发生有趣的事情时能够检测到并收到通知。1
由于调试机器学习系统很困难,一种常见的做法是尽可能记录一切。这意味着你的日志量会非常非常快地增长。这导致了两个问题。第一个问题是,因为信号淹没在噪声中,你可能很难知道该从哪里看起。已经有许多服务来处理和分析日志,例如 Logstash、Datadog、Logz.io 等。其中许多使用机器学习模型来帮助你处理和理解海量日志。
第二个问题是如何存储快速增长的大量日志。幸运的是,在大多数情况下,你只需要在日志还有用时保存它们,当它们对调试当前系统不再有用时就可以丢弃。如果你不需要频繁访问日志,它们也可以存储在低访问频率的存储中,这种存储比高访问频率的存储便宜得多。2
系统还会生成数据来记录用户的行为,例如点击、选择某个建议、滚动、缩放、忽略弹窗,或在某些页面上花费异常长的时间。尽管这些是系统生成的数据,它们仍然被视为用户数据的一部分,可能受隐私法规的约束。3
1 在生产环境中,「有趣」通常意味着灾难性事件,例如崩溃,或者你的云账单达到天文数字。
2 截至 2021 年 11 月,AWS S3 Standard——允许你以毫秒级延迟访问数据的存储选项——每 GB 的价格大约是 S3 Glacier 的五倍;S3 Glacier 是允许你以 1 分钟到 12 小时之间的延迟取回数据的存储选项。
3 一位机器学习工程师曾告诉我,他的团队只用用户过去的产品浏览和购买记录来推荐他们接下来可能想看的内容。我回应道:「所以你们完全不用个人数据?」他困惑地看着我。「如果你指的是人口统计数据,比如用户的年龄、位置,那确实不用。但我得说,一个人的浏览和购买行为是极其私人的。」
还有内部数据库(internal databases),由公司内的各种服务和应用程序生成。这些数据库管理公司的资产,如库存、客户关系、用户等。这类数据可以被机器学习模型直接使用,也可以被机器学习系统的各个组件使用。例如,当用户在亚马逊上输入搜索查询时,一个或多个机器学习模型会处理该查询以检测其意图——如果有人输入『frozen』,他们是在找冷冻食品,还是迪士尼的《冰雪奇缘》(Frozen)系列?——然后亚马逊需要检查其内部数据库,确认这些产品的可用性,再对它们进行排序并展示给用户。
然后是奇妙又古怪的第三方数据(third-party data)世界。第一方数据(first-party data)是你的公司已经收集的关于你的用户或客户的数据。第二方数据(second-party data)是另一家公司就其自己的客户收集的数据,他们将这些数据提供给你,不过你很可能需要为此付费。第三方数据公司收集的是并非其直接客户的公众的数据。
互联网和智能手机的兴起使得各类数据的收集变得更加容易。智能手机尤其容易,因为每部手机曾经都有一个唯一的广告商标识符——iPhone 有苹果的广告商标识符(Identifier for Advertisers,IDFA),安卓手机有安卓广告标识符(Android Advertising ID,AAID)——它充当唯一 ID,用来聚合手机上的所有活动。来自应用程序、网站、签到服务等的数据被收集并(希望是)匿名化,以生成每个人的活动历史。
各种数据都可以买到,例如社交媒体活动、购买历史、网页浏览习惯、汽车租赁记录,以及不同人群的政治倾向——细分程度可以精确到 25-34 岁、在科技行业工作、住在湾区的男性。从这些数据中,你可以推断出诸如喜欢品牌 A 的人也喜欢品牌 B 之类的信息。这类数据对于推荐系统(recommender system)等系统尤其有用,可以帮助它们生成与用户兴趣相关的结果。第三方数据通常由供应商清洗和处理后出售。
然而,随着用户对数据隐私的要求越来越高,各公司纷纷采取措施限制广告商标识符的使用。2021 年初,苹果将 IDFA 改为用户主动选择加入(opt-in)。这一改变大幅减少了 iPhone 上可用的第三方数据量,迫使许多公司更加专注于第一方数据。4 为了对抗这一改变,广告商一直在投资各种变通方案。例如,中国广告协会——一个由中国政府支持的广告行业贸易协会——投资了一个名为 CAID 的设备指纹识别系统,允许 TikTok 和腾讯等应用继续追踪 iPhone 用户。5
4 John Koetsier, “Apple Just Crippled IDFA, Sending an $80 Billion Industry Into Upheaval,” Forbes, 2020 年 6 月 24 日, https://oreil.ly/rqPX9.
5 Patrick McGee 和 Yuan Yang, “TikTok Wants to Keep Tracking iPhone Users with State-Backed Workaround,” Ars Technica, 2021 年 3 月 16 日, https://oreil.ly/54pkg.
数据格式
一旦你有了数据,你可能想要存储它(用技术术语说就是「持久化」)。由于你的数据来自多个来源,且具有不同的访问模式(access pattern),6 存储数据并不总是一帆风顺,在某些情况下还可能成本高昂。思考数据将来会如何被使用很重要,这样才能让所选的格式真正合理。以下是一些你可能需要考虑的问题:
- 如何存储多模态数据(multimodal data),例如一个样本可能同时包含图像和文本?
- 把数据存在哪里,才能既便宜又仍然快速访问?
- 如何存储复杂模型,使它们能在不同的硬件上被正确加载和运行?
把数据结构或对象状态转换成一种可以存储或传输、之后还能重建的格式的过程,称为数据序列化(data serialization)。数据序列化格式非常多。在考虑选用哪种格式时,你可能需要考虑不同的特性,例如人类可读性、访问模式,以及它是基于文本还是二进制——这会影响文件的大小。表 3-1 只列出了你工作中可能遇到的少数几种常见格式。更完整的列表,可以看看维基百科上优秀的「数据序列化格式比较」页面。
表 3-1. 常见数据格式及其用途
| 格式 | 二进制/文本 | 人类可读 | 示例用途 |
|---|---|---|---|
| JSON | 文本 | 是 | 无处不在 |
| CSV | 文本 | 是 | 无处不在 |
| Parquet | 二进制 | 否 | Hadoop、Amazon Redshift |
| Avro | 主要二进制 | 否 | Hadoop |
| Protobuf | 主要二进制 | 否 | Google、TensorFlow(TFRecord) |
| Pickle | 二进制 | 否 | Python、PyTorch 序列化 |
我们将介绍其中的几种格式,从 JSON 开始,还会介绍两种常见且代表两种不同范式的格式:CSV 和 Parquet。
6 「访问模式(access pattern)」指系统或程序读取或写入数据的模式。
JSON
JSON,即 JavaScript 对象表示法(JavaScript Object Notation),无处不在。尽管它源于 JavaScript,但它与语言无关——大多数现代编程语言都能生成和解析 JSON。它人类可读。它的键值对范式简单却强大,能够处理不同结构化程度的数据。例如,你的数据可以存储为如下结构化格式:
{ "firstName" : "Boatie", "lastName" : "McBoatFace", "isVibing" : true , "age" : 12, "address" : { "streetAddress" : "12 Ocean Drive", "city" : "Port Royal", "postalCode" : "10021-3100" } }
同样的数据也可以存储为如下的非结构化文本块:
{ "text" : "Boatie McBoatFace, aged 12, is vibing, at 12 Ocean Drive, Port Royal, 10021-3100" }
因为 JSON 无处不在,它带来的痛苦也无处不在。一旦你把 JSON 文件中的数据提交给某个模式(schema),事后想要回头修改这个模式就非常痛苦。JSON 文件是文本文件,这意味着它们占用大量空间,我们将在第 57 页的「文本格式与二进制格式」一节中看到这一点。
行优先与列优先格式
两种常见且代表两种不同范式的格式是 CSV 和 Parquet。CSV(逗号分隔值,comma-separated values)是行优先(row-major)的,这意味着同一行中相邻的元素在内存中紧挨着存储。Parquet 是列优先(column-major)的,这意味着同一列中相邻的元素紧挨着存储。
因为现代计算机处理顺序数据比处理非顺序数据更高效,如果一个表是行优先的,那么按行访问会比按列访问更快(在期望意义上)。这意味着对于行优先格式,按行访问数据预计比按列访问更快。
假设我们有一个包含 1,000 个样本的数据集,每个样本有 10 个特征。如果我们像机器学习中常见的那样,把每个样本看作一行、每个特征看作一列,那么像 CSV 这样的行优先格式更适合访问样本,例如访问今天收集的所有样本。像 Parquet 这样的列优先格式更适合访问特征,例如访问所有样本的时间戳。见图 3-1。
图 3-1. 行优先格式与列优先格式
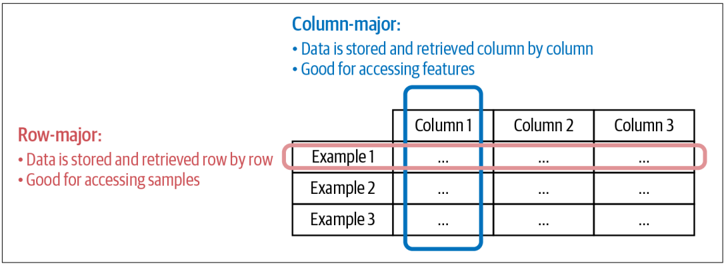
列优先格式允许灵活的按列读取,尤其是当你的数据很大、有成千上万个特征时。设想你有关于网约车交易的数据,有 1,000 个特征,但你只想要 4 个特征:时间、地点、距离、价格。使用列优先格式,你可以直接读取与这四个特征对应的四列。然而,使用行优先格式,如果你不知道行的长度,就必须读取所有列,然后过滤出这四列。即使你知道行的长度,也可能仍然很慢,因为你必须在内存中来回跳跃,无法利用缓存。
行优先格式允许更快的数据写入。设想你需要不断向数据中添加新的单个样本。对于每一个样本,把它写入已经是行优先格式的文件会快得多。
总的来说,当你需要大量写入时,行优先格式更好;而当你需要大量按列读取时,列优先格式更好。
NumPy 与 pandas
有一个很多人没注意到的微妙之处,导致了对 pandas 的误用:这个库是围绕列式格式构建的。
pandas 围绕 DataFrame 构建,这个概念受 R 语言的 Data Frame 启发,是列优先的。DataFrame 是一个有行和列的二维表。
在 NumPy 中,可以指定主序(major order)。创建 ndarray 时,如果你不指定顺序,默认是行优先。从 NumPy 转过来的人倾向于像对待 ndarray 一样对待 DataFrame,例如尝试按行访问数据,然后发现 DataFrame 很慢。
在图 3-2 的左图中,你可以看到按行访问 DataFrame 比按列访问同一个 DataFrame 慢得多。如果你把这个 DataFrame 转换成 NumPy ndarray,按行访问就会快得多,如图右图所示。7
# Iterating pandas DataFrame by column df_np = df.to_numpy() start = time.time() n_rows, n_cols = df_np.shape for col in df.columns: for item in df[col]: pass # Iterating NumPy ndarray by column print(time.time() - start, "seconds") start = time.time() for j in range(n_cols): 0.06656503677368164 seconds 4 for item in df_np[:, jl: pass # Iterating pandas DataFrame by row print(time.time() - start, "seconds") n_rows = len(df) 0.005830049514770508 seconds 4 start = time.time() for i in range(n_rows): for item in df.iloc[i]: # Iterating NumPy ndarray by row pass start = time.time() print(time.time() - start, "seconds") for i in range(n_rows): for item in df_np[i]: 2.4123919010162354 seconds pass print(time.time() - start, "seconds" 0.019572019577026367 seconds
图 3-2. (左)按列迭代 pandas DataFrame 需要 0.07 秒,但按行迭代同一个 DataFrame 需要 2.41 秒。(右)把同一个 DataFrame 转换成 NumPy ndarray 后,按行访问快得多。
7 更多 pandas 的怪癖,请看我的 Just pandas Things GitHub 仓库。
我用 CSV 作为行优先格式的例子,因为它很流行,而且我在科技行业交谈过的每个人都认识它。不过,这本书的一些早期审阅者指出,他们认为 CSV 是一种糟糕的数据格式。它对非文本字符的序列化很差。例如,当你把浮点值写入 CSV 文件时,可能会损失一些精度——0.12345678901232323 可能被任意四舍五入成『0.12345678901』——正如 Stack Overflow 和微软社区(Microsoft Community)帖子中所抱怨的那样。Hacker News 上的人们也激烈地反对使用 CSV。
文本格式与二进制格式
CSV 和 JSON 是文本文件,而 Parquet 文件是二进制文件。文本文件(text file)是纯文本形式的文件,通常意味着它们是人类可读的。二进制文件(binary file)是泛指所有非文本文件的统称。顾名思义,二进制文件通常只包含 0 和 1,并且旨在由知道如何解释原始字节的程序来读取或使用。程序必须确切知道二进制文件内部数据的布局才能使用该文件。如果你在文本编辑器(例如 VS Code、记事本)中打开文本文件,你能够读出其中的文本。如果你在文本编辑器中打开二进制文件,你会看到成块的数字,很可能以十六进制值显示,对应文件中的各个字节。
二进制文件更紧凑。这里有一个简单的例子来说明二进制文件相比文本文件如何节省空间。假设你想存储数字 1000000。如果把它存在文本文件中,需要 7 个字符;如果每个字符是 1 字节,就需要 7 字节。如果把它作为 int32 存在二进制文件中,只需要 32 位,也就是 4 字节。
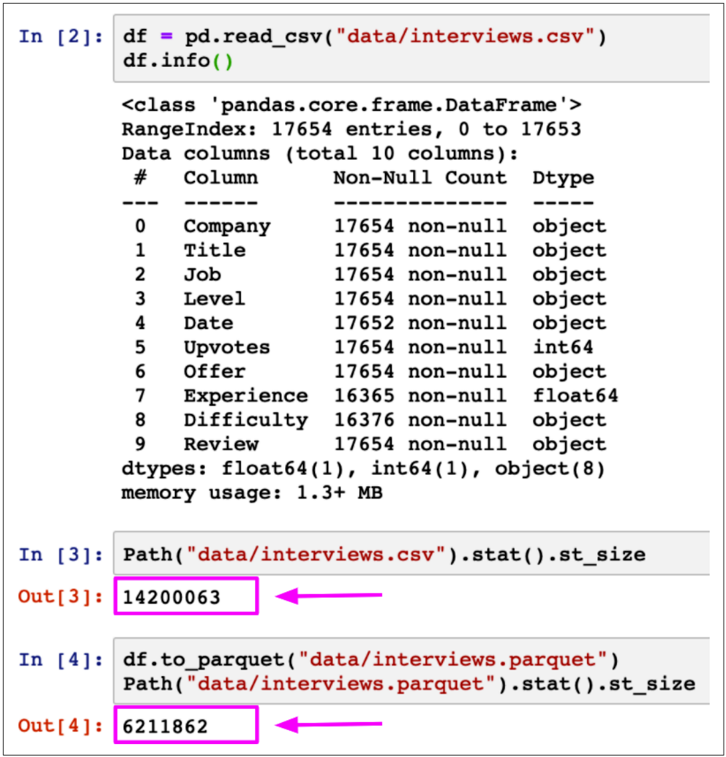
作为示例,我使用 interviews.csv,这是一个 17,654 行、10 列的 CSV 文件(文本格式)。当我把它转换成二进制格式(Parquet)时,文件大小从 14 MB 降到了 6 MB,如图 3-3 所示。
AWS 建议使用 Parquet 格式,因为「与文本格式相比,Parquet 格式在 Amazon S3 中的卸载速度最高快 2 倍,存储占用最高减少 6 倍。」8
8 “Announcing Amazon Redshift Data Lake Export: Share Data in Apache Parquet Format,” Amazon AWS, 2019 年 12 月 3 日, https://oreil.ly/ilDb6.
图 3-3. 以 CSV 格式存储时,我的面试数据文件是 14 MB;但以 Parquet 存储时,同一个文件只有 6 MB。
数据模型
数据模型描述数据是如何表示的。以现实世界中的汽车为例。在数据库中,一辆汽车可以用它的品牌、型号、年份、颜色和价格来描述。这些属性构成了汽车的一种数据模型。或者,你也可以用它的车主、车牌号和注册地址历史来描述一辆汽车。这是汽车的另一种数据模型。
你选择如何表示数据,不仅影响你的系统如何构建,也影响你的系统能解决什么问题。例如,第一种数据模型中表示汽车的方式,让想买车的人更容易使用;而第二种数据模型让警察更容易追踪罪犯。
在本节中,我们将研究两种看起来截然相反、但实际上正在趋同的模型:关系模型(relational model)和 NoSQL 模型。我们会通过例子来说明每种模型适合解决哪类问题。
关系模型
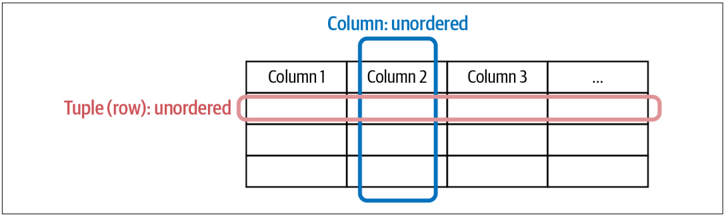
关系模型是计算机科学中最持久的思想之一。它由 Edgar F. Codd 于 1970 年发明,9 直到今天依然强劲,甚至越来越流行。这个想法简单但强大。在这种模型中,数据被组织成关系(relation);每个关系是一组元组(tuple)。表是关系的一种公认的可视化表示,表的每一行构成一个元组,10 如图 3-4 所示。关系是无序的。你可以打乱关系中行的顺序或列的顺序,它仍然是同一个关系。遵循关系模型的数据通常以 CSV 或 Parquet 等文件格式存储。
9 Edgar F. Codd, “A Relational Model of Data for Large Shared Data Banks,” Communications of the ACM 13, no. 6(1970 年 6 月): 377-87.
10 对细节敏感的读者:并非所有表都是关系。
图 3-4. 在关系中,行和列的顺序都不重要
关系通常需要规范化(normalization)。数据规范化可以遵循各种范式(normal form),如第一范式(1NF)、第二范式(2NF)等,感兴趣的读者可以在维基百科上了解更多。在本书中,我们将通过一个例子展示规范化是如何工作的,以及它如何减少数据冗余(data redundancy)并提高数据完整性(data integrity)。
考虑表 3-2 中所示的 Book 关系。这些数据中有很多重复。例如,第 1 行和第 2 行几乎完全相同,只是格式和价格不同。如果出版社信息发生变化——例如出版社名称从『Banana Press』改为『Pineapple Press』——或者国家发生变化,我们就必须更新第 1、2、4 行。如果我们把出版社信息拆分成单独的表,如表 3-3 和表 3-4 所示,那么当出版社信息变化时,我们只需要更新 Publisher 关系。11 这种做法让我们可以在不同列中标准化同一个值的拼写。它也让我们更容易修改这些值,无论是这些值本身发生变化,还是你想把它们翻译成不同的语言。
表 3-2. 最初的 Book 关系
| 标题 | 作者 | 格式 | 出版社 | 国家 | 价格 |
|---|---|---|---|---|---|
| Harry Potter | J.K. Rowling | Paperback | Banana Press | UK | $20 |
| Harry Potter | J.K. Rowling | E-book | Banana Press | UK | $10 |
| Sherlock Holmes | Conan Doyle | Paperback | Guava Press | US | $30 |
| The Hobbit | J.R.R. Tolkien | Paperback | Banana Press | UK | $30 |
| Sherlock Holmes | Conan Doyle | Paperback | Guava Press | US | $15 |
表 3-3. 更新后的 Book 关系
| 标题 | 作者 | 格式 | 出版社 ID | 价格 |
|---|---|---|---|---|
| Harry Potter | J.K. Rowling | Paperback | 1 | $20 |
| Harry Potter | J.K. Rowling | E-book | 1 | $10 |
| Sherlock Holmes | Conan Doyle | Paperback | 2 | $30 |
| The Hobbit | J.R.R. Tolkien | Paperback | 1 | $30 |
| Sherlock Holmes | Conan Doyle | Paperback | 2 | $15 |
表 3-4. Publisher 关系
| 出版社 ID | 出版社 | 国家 |
|---|---|---|
| 1 | Banana Press | UK |
| 2 | Guava Press | US |
规范化的一大缺点是,你的数据现在分散在多个关系中。你可以把不同关系的数据重新连接(join)起来,但对大表来说,连接可能代价很高。
围绕关系数据模型构建的数据库就是关系数据库(relational database)。一旦你把数据放进数据库,你就需要一种取回它的方式。用来指定你想从数据库获取哪些数据的语言称为查询语言(query language)。今天关系数据库最流行的查询语言是 SQL。尽管 SQL 受到关系模型的启发,但它背后的数据模型已经偏离了最初的关系模型。例如,SQL 表可以包含重复行,而真正的关系不能包含重复。不过,这个细微差别被大多数人安全地忽略了。
11 你还可以进一步规范化 Book 关系,例如把格式拆分成单独的关系。
关于 SQL 最重要的一点是,它是一种声明式语言(declarative language),而 Python 是一种命令式语言(imperative language)。在命令式范式中,你指定完成某个动作所需的步骤,计算机执行这些步骤并返回输出。在声明式范式中,你指定你想要的输出,由计算机自己弄清楚得到所查询输出所需的步骤。
使用 SQL 数据库时,你指定想要的数据模式——你想从哪些表获取数据、结果必须满足什么条件、基本的数据转换如连接(join)、排序(sort)、分组(group)、聚合(aggregate)等——但不需要指定如何检索数据。如何把查询拆分成不同部分、用什么方法执行查询的每个部分、以什么顺序执行查询的不同部分,都由数据库系统决定。
加上某些特性后,SQL 可以是图灵完备(Turing-complete)的,这意味着理论上 SQL 可以用来解决任何计算问题(但不保证所需的时间或内存)。然而在实践中,编写一个查询来解决特定任务并不总是容易的,执行一个查询也不总是可行或可处理的。任何使用过 SQL 数据库的人可能都有过噩梦般的回忆:那些长得离谱、根本无法理解、没人敢碰的 SQL 查询,生怕一碰就出问题。12
弄清楚如何执行任意查询是困难的部分,这是查询优化器(query optimizer)的工作。查询优化器检查执行查询的所有可能方式,并找到最快的方式。13 有可能利用机器学习,基于对传入查询的学习来改进查询优化器。14 查询优化是数据库系统中最具挑战性的问题之一,而规范化意味着数据分散在多个关系中,这让把它们连接起来更加困难。尽管开发查询优化器很难,但好消息是,你通常只需要一个查询优化器,所有应用程序都可以利用它。
12 Greg Kemnitz 是 Postgres 原始论文的合著者之一,他在 Quora 上分享说,他曾经编写过一个 700 行长的报表 SQL 查询,在查找或连接中访问了 27 张不同的表。这个查询约有 1,000 行注释,帮他记住自己在做什么。他花了三天时间编写、调试和调优。
13 Yannis E. Ioannidis, “Query Optimization,” ACM Computing Surveys (CSUR) 28, no. 1(1996): 121-23, https://oreil.ly/omXMg.
14 Ryan Marcus et al., “Neo: A Learned Query Optimizer,” arXiv preprint arXiv:1904.03711(2019), https://oreil.ly/wHy6p.
从声明式数据系统到声明式机器学习系统
也许是受到声明式数据系统成功的启发,许多人期待声明式机器学习(declarative ML)。15 使用声明式机器学习系统,用户只需要声明特征的模式(schema)和任务,系统就会找出用给定特征执行该任务的最佳模型。用户不必编写代码来构建、训练和调优模型。流行的声明式机器学习框架有 Uber 开发的 Ludwig 和 H2O AutoML。在 Ludwig 中,用户可以在特征的模式和输出之上指定模型结构——例如全连接层的数量和隐藏单元的数量。在 H2O AutoML 中,你不需要指定模型结构或超参数。它会实验多种模型架构,并根据给定的特征和任务挑选出最佳模型。
这里有一个例子展示 H2O AutoML 是如何工作的。你把数据(输入和输出)交给系统,并指定你想实验的模型数量。它会实验那么多模型,并展示表现最佳的模型:
# Identify predictors and response x = train.columns y = "response" x.remove(y) # For binary classification, response should be a factor train[y] = train[y].asfactor() test[y] = test[y].asfactor() # Run AutoML for 20 base models aml = H2OAutoML(max_models=20, seed=1) aml.train(x=x, y=y, training_frame=train) # Show the best-performing models on the AutoML Leaderboard lb = aml.leaderboard # Get the best-performing model aml.leader
虽然声明式机器学习在许多情况下很有用,但它没有回答生产环境中机器学习面临的最大挑战。今天的声明式机器学习系统抽象掉了模型开发部分,而在接下来的六章中我们会讲到,随着模型越来越商品化,模型开发往往是较容易的部分。困难的部分在于特征工程、数据处理、模型评估、数据漂移检测、持续学习等。
15 Matthias Boehm, Alexandre V. Evfimievski, Niketan Pansare, and Berthold Reinwald, “Declarative Machine Learning—A Classification of Basic Properties and Types,” arXiv, 2016 年 5 月 19 日, https://oreil.ly/OvW07.
NoSQL
关系数据模型已经能够推广到很多用例,从电子商务到金融再到社交网络。然而,对于某些用例,这个模型可能具有限制性。例如,它要求你的数据遵循严格的模式,而模式管理很痛苦。Couchbase 在 2014 年的一项调查中,对模式管理的不满是他们采用其非关系数据库的首要原因。16 为专门的应用程序编写和执行 SQL 查询也可能很困难。
反对关系数据模型的最新运动是 NoSQL。NoSQL 最初只是一个讨论非关系数据库的聚会(meetup)的标签(hashtag),后来被追溯性地重新解读为 Not Only SQL,17 因为许多 NoSQL 数据系统也支持关系模型。非关系模型的两大主要类型是文档模型(document model)和图模型(graph model)。文档模型面向的是数据以自包含文档形式出现、文档与文档之间关系很少的用例。图模型则走向相反方向,面向数据项之间关系常见且重要的用例。我们将逐一研究这两种模型,先从文档模型开始。
16 James Phillips, “Surprises in Our NoSQL Adoption Survey,” Couchbase, 2014 年 12 月 16 日, https://oreil.ly/ueyEX.
17 Martin Kleppmann, 《Designing Data-Intensive Applications》(Sebastopol, CA: O’Reilly, 2017).
文档模型
文档模型围绕「文档」(document)的概念构建。一个文档通常是一个连续的字符串,编码为 JSON、XML 或 BSON(Binary JSON,二进制 JSON)等二进制格式。文档数据库中的所有文档都假定以相同的格式编码。每个文档都有一个唯一的键来代表该文档,可以用它来取回文档。
一组文档可以类比于关系数据库中的表,一个文档可以类比于一行。事实上,你可以这样把关系转换成文档集合。例如,你可以把表 3-3 和表 3-4 中的图书数据转换成示例 3-1、3-2 和 3-3 中所示的三个 JSON 文档。然而,文档集合比表灵活得多。表中的所有行必须遵循相同的模式(例如具有相同的列顺序),而同一集合中的文档可以具有完全不同的模式。
示例 3-1. 文档 1:harry_potter.json
{ "Title" : "Harry Potter", "Author" : "J .K. Rowling", "Publisher" : "Banana Press", "Country" : "UK", "Sold as" : [ { "Format" : "Paperback", "Price" : "$20"}, { "Format" : "E-book", "Price" : "$10"} ] } Example 3-2. Document 2: sherlock_holmes.json { "Title" : "Sherlock Holmes", "Author" : "Conan Doyle", "Publisher" : "Guava Press", "Country" : "US", "Sold as" : [ { "Format" : "Paperback", "Price" : "$30"}, { "Format" : "E-book", "Price" : "$15"} ] } Example 3-3. Document 3: the_hobbit.json { "Title" : "The Hobbit", "Author" : "J.R.R. Tolkien", "Publisher" : "Banana Press", "Country" : "UK", "Sold as" : [ { "Format" : "Paperback", "Price" : "$30"}, ] }
因为文档模型不强制模式,它常常被称为无模式(schemaless)。这个说法有误导性,因为如前所述,存储在文档中的数据以后会被读取。读取文档的应用程序通常假定文档具有某种结构。文档数据库只是把假定结构的责任从写入数据的应用程序转移到了读取数据的应用程序。
文档模型比关系模型有更好的局部性(locality)。考虑表 3-3 和 3-4 中的图书数据例子,其中关于一本书的信息分散在 Book 表和 Publisher 表(可能还有 Format 表)中。要取回关于一本书的信息,你必须查询多张表。
在文档模型中,关于一本书的所有信息都可以存储在一个文档中,取回起来容易得多。
然而,与关系模型相比,跨文档执行连接比跨表连接更困难、效率也更低。例如,如果你想找出所有价格低于 $25 的书,你必须读取所有文档、提取价格、与 $25 比较,然后返回所有包含价格低于 $25 的书的文档。
由于文档数据模型和关系数据模型各有不同的优势,在同一个数据库系统中针对不同任务同时使用这两种模型是很常见的。越来越多的数据库系统,如 PostgreSQL 和 MySQL,同时支持这两种模型。
图模型
图模型围绕「图」(graph)的概念构建。图由节点(node)和边(edge)组成,边表示节点之间的关系。使用图结构存储数据的数据库称为图数据库(graph database)。如果说文档数据库把每个文档的内容放在首位,那么图数据库把数据项之间的关系放在首位。
因为关系在图模型中是被显式建模的,所以基于关系检索数据更快。考虑图 3-5 中图数据库的例子。这个例子的数据可能来自一个简单的社交网络。在这个图中,节点可以有不同的数据类型:人、城市、国家、公司等。
图 3-5. 一个简单图数据库的示例
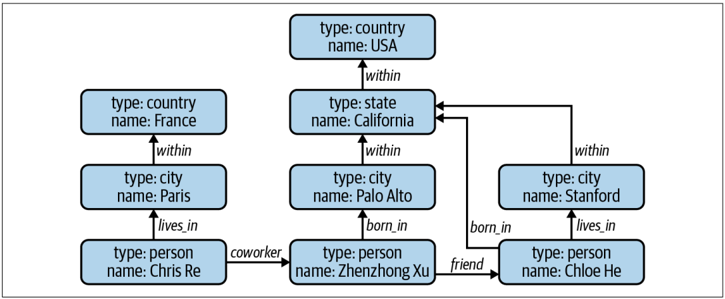
想象你想找到所有在美国出生的人。给定这个图,你可以从 USA 节点出发,沿着『within』和『born_in』边遍历图,找到所有『person』类型的节点。现在想象一下,我们不用图模型来表示这些数据,而是用关系模型。要编写一个 SQL 查询来找出所有在美国出生的人,没有容易的办法,尤其是考虑到国家和人之间的跳数是不确定的——Zhenzhong Xu 和 USA 之间有三跳,而 Chloe He 和 USA 之间只有两跳。类似地,用文档数据库执行这种类型的查询也没有容易的办法。
许多在一种数据模型中容易执行的查询,在另一种数据模型中更难执行。为你的应用选择正确的数据模型,会让你的生活轻松很多。
结构化与非结构化数据
结构化数据(structured data)遵循预定义的数据模型,也称为数据模式(data schema)。例如,数据模型可能规定每个数据项由两个值组成:第一个值『name』是最多 50 个字符的字符串,第二个值『age』是 0 到 200 之间的 8 位整数。预定义的结构让你的数据更容易分析。如果你想知道数据库中人的平均年龄,你只需要提取所有年龄值并求平均。
结构化数据的缺点是,你必须把数据提交给预定义的模式。如果你的模式发生变化,你就得追溯性地更新所有数据,这常常在过程中引发难以捉摸的 bug。例如,你以前从不保存用户的电子邮件地址,但现在要保存了,所以你必须追溯性地为所有老用户更新电子邮件信息。我的一个同事遇到过的最奇怪的 bug 之一,是他们无法再在交易中使用用户的年龄,因为他们的数据模式把所有 null 年龄替换成了 0,然后他们的机器学习模型认为这些交易是 0 岁的人进行的。18
18 在这个具体例子中,把 null 年龄值替换成 -1 解决了问题。
因为业务需求会随时间变化,把自己绑定在预定义的数据模式上可能变得过于受限。或者,你可能拥有来自多个你无法控制的数据源的数据,不可能让它们遵循同一个模式。这时非结构化数据(unstructured data)就变得有吸引力了。非结构化数据不遵循预定义的数据模式。它通常是文本,但也可以是数字、日期、图像、音频等。例如,你的机器学习模型生成的日志文本文件就是非结构化数据。
尽管非结构化数据不遵循模式,它仍然可能包含能帮助你提取结构的内在模式。例如,下面的文本是非结构化的,但你可以注意到一个模式:每一行包含两个用逗号分隔的值,第一个值是文本,第二个值是数值。然而,并不能保证所有行都必须遵循这个格式。你可以在文本中添加新的一行,即使这一行不遵循这个格式。
Lisa, 43 Jack, 23 Huyen, 59
非结构化数据也允许更灵活的存储选项。例如,如果你的存储遵循模式,你就只能存储符合该模式的数据。但如果你的存储不遵循模式,你就可以存储任何类型的数据。你可以把所有数据,无论类型和格式,都转换成字节串并存储在一起。
存储结构化数据的仓库称为数据仓库(data warehouse)。存储非结构化数据的仓库称为数据湖(data lake)。数据湖通常用于在处理前存储原始数据。数据仓库用于存储已经处理成可用格式的数据。表 3-5 总结了结构化数据和非结构化数据的关键区别。
表 3-5. 结构化数据与非结构化数据的关键区别
| 结构化数据 | 非结构化数据 |
|---|---|
| 模式清晰定义 | 数据不必遵循模式 |
| 易于搜索和分析 | 到达速度快 |
| 只能处理具有特定模式的数据 | 可以处理来自任何来源的数据 |
| 模式变化会带来很多麻烦 | 暂时无需担心模式变化,因为担忧转移到了使用这些数据的下游应用上 |
| 存储于数据仓库 | 存储于数据湖 |
数据存储引擎与处理
数据格式和数据模型规定了用户存储和取回数据的接口。存储引擎,也就是数据库,是在机器上实现数据如何存储和取回的部分。了解不同类型的数据库是有用的,因为你的团队或相邻团队可能需要为你的应用选择合适的数据库。
通常,数据库针对两种工作负载进行优化:事务处理(transactional processing)和分析处理(analytical processing),两者之间有很大区别,我们将在本节中介绍。然后我们会介绍 ETL(提取、转换、加载,extract, transform, load)流程的基础知识,这是你在构建生产级机器学习系统时必然会遇到的。
事务处理与分析处理
传统上,事务(transaction)指买卖某物的行为。在数字世界中,事务指任何类型的动作:发推文、通过网约车服务叫车、上传新模型、观看 YouTube 视频等等。尽管这些不同的事务涉及不同类型的数据,但它们的处理方式在不同应用中都是相似的。事务在生成时被插入,在发生某些变化时偶尔被更新,在不再需要时被删除。19 这种类型的处理称为在线事务处理(online transaction processing,OLTP)。
因为这些事务通常涉及用户,它们需要被快速处理(低延迟),不能一直让用户等待。处理方法需要有高可用性(availability)——也就是说,无论用户什么时候想进行事务,处理系统都需要可用。如果你的系统无法处理某个事务,这个事务就无法完成。
事务数据库(transactional database)被设计用来处理在线事务,满足低延迟、高可用性的要求。人们听到事务数据库时,通常会想到 ACID(原子性、一致性、隔离性、持久性,atomicity, consistency, isolation, durability)。以下是给需要快速回顾的人的 ACID 定义:
原子性(Atomicity):保证一个事务中的所有步骤作为一个整体全部成功完成。如果事务中的任何一步失败,所有其他步骤也必须失败。例如,如果用户的支付失败,你不会还想给该用户派司机。
一致性(Consistency):保证所有通过的事务必须遵循预定义的规则。例如,事务必须由有效用户发起。
隔离性(Isolation):保证两个同时发生的事务就像彼此隔离一样。两个用户同时访问同一份数据时,不会同时修改它。例如,你不希望两个用户同时预订同一个司机。
持久性(Durability):保证事务一旦被提交,即使在系统故障的情况下也会保持已提交状态。例如,在你下单叫车后,即使手机没电了,你仍然希望车能到来。
然而,事务数据库不一定要满足 ACID,有些开发者觉得 ACID 限制太严格。根据 Martin Kleppmann 的说法,「不满足 ACID 标准的系统有时被称为 BASE,代表基本可用(Basically Available)、软状态(Soft state)和最终一致性(Eventually consistent)。这比 ACID 的定义还要模糊。」20
19 这一段以及本章的许多部分,灵感来自 Martin Kleppmann 的《Designing Data-Intensive Applications》。
20 Kleppmann, 《Designing Data-Intensive Applications》
因为每个事务通常作为一个单元独立于其他事务处理,事务数据库通常是行优先的。这也意味着,事务数据库可能无法高效回答诸如「九月份旧金山所有行程的平均价格是多少?」这类问题。这种分析性问题需要跨多行数据按列聚合数据。分析数据库(analytical database)就是为此设计的。它们能高效处理允许你从不同视角查看数据的查询。我们称这种类型的处理为在线分析处理(online analytical processing,OLAP)。
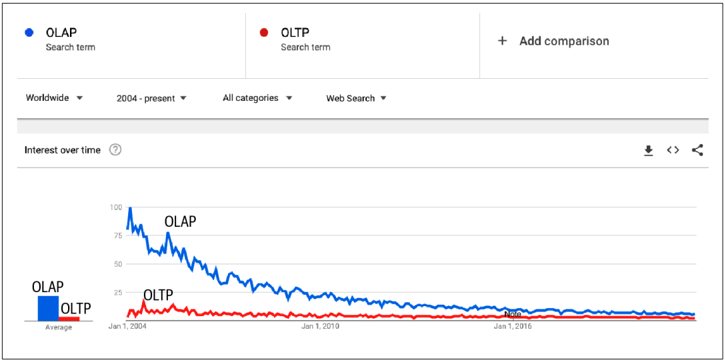
然而,OLTP 和 OLAP 这两个术语都已经过时了,如图 3-6 所示,原因有三。第一,事务数据库和分析数据库的分离是技术限制造成的——很难造出能同时高效处理事务查询和分析查询的数据库。但这种分离正在弥合。今天,我们有能处理分析查询的事务数据库,例如 CockroachDB。我们也有能处理事务查询的分析数据库,例如 Apache Iceberg 和 DuckDB。
图 3-6. 根据 Google Trends,截至 2021 年,OLAP 和 OLTP 已是过时的术语
第二,在传统的 OLTP 或 OLAP 范式中,存储和处理紧密耦合——数据的存储方式就是数据的处理方式。这可能导致同一份数据被存储在多个数据库中,并使用不同的处理引擎来解决不同类型的查询。过去十年中一个有趣的范式是让存储与处理(也称为计算,compute)解耦,许多数据厂商采用了这一做法,包括 Google 的 BigQuery、Snowflake、IBM 和 Teradata。21 在这种范式中,数据可以存储在同一个地方,上面加一层可以针对不同类型查询进行优化的处理层。
21 Tino Tereshko, “Separation of Storage and Compute in BigQuery,” Google Cloud blog, 2017 年 11 月 29 日, https://oreil.ly/utf7z;Suresh H., “Snowflake Architecture and Key Concepts: A Comprehensive Guide,” Hevo blog, 2019 年 1 月 18 日, https://oreil.ly/GyvKl;Preetam Kumar, “Cutting the Cord: Separating Data from Compute in Your Data Lake with Object Storage,” IBM blog, 2017 年 9 月 21 日, https://oreil.ly/Nd3xD;“The Power of Separating Cloud Compute and Cloud Storage,” Teradata, 最后访问于 2022 年 4 月, https://oreil.ly/f82gP.
第三,「在线」(online)已经成为一个过载的术语,可以指很多不同的东西。Online 曾经只意味着「连接到互联网」。后来,它又增加了「在生产环境中」的意思——我们说一个特性上线了(online),是指这个特性已经被部署到生产环境中。
在今天的数据世界里,online 可能指你的数据处理和可用的速度:在线(online)、近线(nearline)或离线(offline)。根据维基百科的定义,在线处理意味着数据立即可用于输入/输出。Nearline,即 near-online 的简称,意味着数据不是立即可用的,但可以在没有人工干预的情况下快速转为在线。Offline 意味着数据不是立即可用的,需要一些人工干预才能转为在线。22
22 Wikipedia, “Nearline storage,” 最后访问于 2022 年 4 月, https://oreil.ly/OCmiB.
ETL:提取、转换与加载
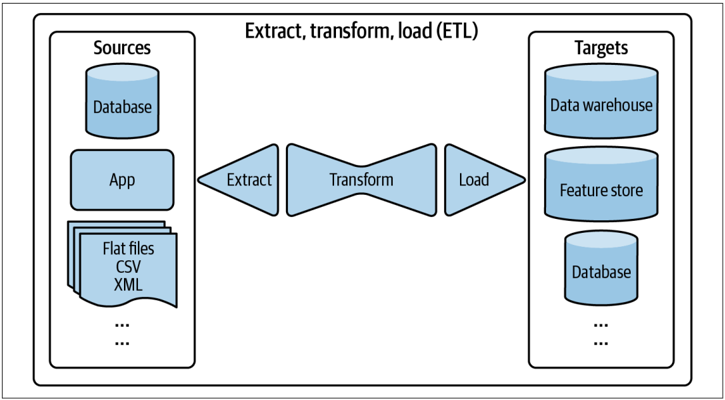
在关系数据模型的早期,数据大多是结构化的。当数据从不同来源提取出来时,它首先被转换成所需的格式,然后才被加载到目标位置,例如数据库或数据仓库。这个过程称为 ETL,代表提取(extract)、转换(transform)和加载(load)。
甚至在机器学习出现之前,ETL 在数据世界就已经风靡一时,今天它对于机器学习应用仍然适用。ETL 指的是把数据按照你想要的形状和格式进行通用处理和聚合。
提取(Extract)是从你所有的数据来源中提取你想要的数据。其中一些来源的数据可能已损坏或格式错误。在提取阶段,你需要验证数据,并拒绝不符合要求的数据。对于被拒绝的数据,你可能需要通知来源方。由于这是流程的第一步,正确地做它可以为你下游节省大量时间。
转换(Transform)是流程中最核心的部分,大部分数据处理都在这里完成。你可能想要连接来自多个来源的数据并清洗它。你可能想要标准化值的范围(例如,一个数据源用『Male』和『Female』表示性别,但另一个用『M』和『F』或『1』和『2』)。你可以应用诸如转置、去重、排序、聚合、派生新特征、更多数据验证等操作。
加载(Load)是决定如何以及多久一次把转换后的数据加载到目标位置,目标位置可以是文件、数据库或数据仓库。
ETL 的想法听起来简单但强大,它是许多组织数据层的基础结构。ETL 流程的概览如图 3-7 所示。
图 3-7. ETL 流程概览
当互联网首次变得无处不在、硬件变得更加强大时,收集数据突然变得容易多了。数据量迅速增长。不仅如此,数据的性质也发生了变化。数据来源的数量扩大了,数据模式也在演变。
一些公司发现让数据保持结构化很困难,于是产生了这样的想法:「为什么不把所有数据都存储到数据湖里,这样我们就不用处理模式变化了?任何需要数据的应用都可以从那里拉取原始数据并自行处理。」这种先把数据加载到存储中、之后再处理的过程有时被称为 ELT(提取、加载、转换,extract, load, transform)。这种范式允许数据快速到达,因为数据在存储前几乎不需要处理。
然而,随着数据不断增长,这个想法变得不那么有吸引力了。在海量原始数据中搜索你想要的数据是低效的。23 与此同时,随着公司转向在云上运行应用、基础设施变得标准化,数据结构也变得标准化。把数据提交给预定义的模式变得更加可行。
23 在本书的初稿中,我把成本列为不应该把所有东西都存下来的理由。然而,到今天,存储已经便宜到存储成本很少成为问题的程度。
在公司权衡存储结构化数据与存储非结构化数据的利弊时,厂商也在演进,提供结合了数据湖的灵活性和数据仓库的数据管理能力的混合方案。例如,Databricks 和 Snowflake 都提供湖仓一体(data lakehouse)解决方案。
数据流的模式
在本章中,我们一直在讨论单个进程上下文内使用的数据的格式、模型、存储和处理。在生产环境中,大多数时候你不只有一个进程,而是有多个。于是出现一个问题:我们如何在共享内存的不同进程之间传递数据?
当数据从一个进程传递到另一个进程时,我们说数据从一个进程流向另一个进程,这就构成了数据流(dataflow)。主要有三种数据流模式:
- 通过数据库传递数据
- 通过服务传递数据,使用诸如 REST 和 RPC API 提供的请求(例如 POST/GET 请求)
- 通过实时传输传递数据,例如 Apache Kafka 和 Amazon Kinesis
我们将在本节中逐一介绍。
通过数据库传递数据
在两个进程之间传递数据最简单的方式是通过数据库,我们已经在第 67 页的「数据存储引擎与处理」一节中讨论过。例如,要把数据从进程 A 传递到进程 B,进程 A 可以把数据写入数据库,进程 B 只需从该数据库读取。
然而,这种方式并不总是有效,原因有二。第一,它要求两个进程都必须能够访问同一个数据库。这可能不可行,尤其是当这两个进程由两家不同的公司运行时。
第二,它要求两个进程都通过数据库访问数据,而数据库的读/写可能很慢,使它不适合对延迟有严格要求的应用——例如几乎所有面向消费者的应用。
通过服务传递数据
在两个进程之间传递数据的一种方式是,通过连接这两个进程的网络直接发送数据。要把数据从进程 B 传递到进程 A,进程 A 首先向进程 B 发送一个请求,指定 A 需要的数据,B 通过同一个网络返回所请求的数据。因为进程通过请求进行通信,我们说这是请求驱动(request-driven)的。
这种数据传递模式与面向服务的架构(service-oriented architecture)紧密耦合。服务(service)是可以被远程访问的进程,例如通过网络访问。在这个例子中,B 作为服务暴露给 A,A 可以向它发送请求。为了让 B 能从 A 请求数据,A 也需要作为服务暴露给 B。
相互通信的两个服务可以由不同公司的不同应用运行。例如,一个服务可能由证券交易所运行,跟踪当前的股票价格。另一个服务可能由投资公司运行,请求当前股价并用它们预测未来的股价。
相互通信的两个服务也可以是同一个应用的不同部分。把应用的不同组件结构化为独立服务,可以让每个组件独立于其他组件进行开发、测试和维护。把应用结构化为独立服务,就得到了微服务架构(microservice architecture)。
把微服务架构放到机器学习系统的语境中,想象你是一名机器学习工程师,在一家拥有 Lyft 这类网约车应用的公司做价格优化问题。实际上,Lyft 的微服务架构中有数百个服务,但为了简单起见,我们只考虑三个服务:
司机管理服务
预测未来一分钟内给定区域会有多少司机可用。
行程管理服务
预测未来一分钟内给定区域会请求多少行程。
价格优化服务
预测每次行程的最优价格。行程的价格应该低到乘客愿意支付,又要高到司机愿意出车、公司能够盈利。
因为价格取决于供给(可用的司机)和需求(被请求的行程),价格优化服务需要来自司机管理服务和行程管理服务的数据。每次用户请求行程时,价格优化服务都会请求预测的行程数和预测的司机数,来预测这次行程的最优价格。24
通过网络传递数据最流行的请求风格是 REST(表征状态转移,representational state transfer)和 RPC(远程过程调用,remote procedure call)。对它们的详细分析超出了本书的范围,但一个主要区别是,REST 是为跨网络请求设计的,而 RPC「试图让对远程网络服务的请求看起来和调用你编程语言中的函数或方法一样」。正因为如此,「REST 似乎是公共 API 的主要风格。RPC 框架的主要关注点是同一组织拥有的服务之间的请求,通常在同一数据中心内。」25
24 在实践中,价格优化服务不一定每次要做价格预测时都要请求预测的行程数/司机数。常见的做法是使用缓存的预测行程数/司机数,大约每分钟请求一次新的预测。
25 Kleppmann, 《Designing Data-Intensive Applications》
26 Tyson Trautmann, “Debunking the Myths of RPC and REST,” Ethereal Bits, 2012 年 12 月 4 日(通过互联网档案馆访问), https://oreil.ly/4sUrL.
REST 架构的实现被称为 RESTful。尽管许多人把 REST 等同于 HTTP,但 REST 并不完全等于 HTTP,因为 HTTP 只是 REST 的一种实现。26
通过实时传输传递数据
要理解实时传输的动机,让我们回到前面那个有三个简单服务的网约车应用例子:司机管理、行程管理和价格优化。在上一节中,我们讨论了价格优化服务如何需要来自行程管理和司机管理服务的数据来预测每次行程的最优价格。
现在,想象司机管理服务也需要知道行程管理服务的行程数,以便知道要调动多少司机。它还希望从价格优化服务获得预测价格,把它们作为对潜在司机的激励(例如,如果你现在上路,可以获得 2 倍溢价(surge charge))。类似地,行程管理服务可能也想要来自司机管理服务和价格优化服务的数据。如果我们像上一节讨论的那样通过服务传递数据,那么每个服务都需要向另外两个服务发送请求,如图 3-8 所示。
图 3-8. 在请求驱动架构中,每个服务都需要向另外两个服务发送请求
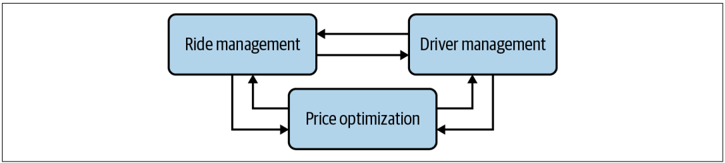
只有三个服务,数据传递就已经变得复杂了。想象一下大型互联网公司那样有成百上千个服务。服务间数据传递会爆炸式增长并成为瓶颈,拖慢整个系统。
请求驱动的数据传递是同步的:目标服务必须监听请求,请求才能完成。如果价格优化服务向司机管理服务请求数据,而司机管理服务宕机了,价格优化服务会一直重发请求直到超时。如果价格优化服务在收到响应之前宕机,响应就会丢失。一个宕机的服务可能导致所有需要它数据的服务都宕机。
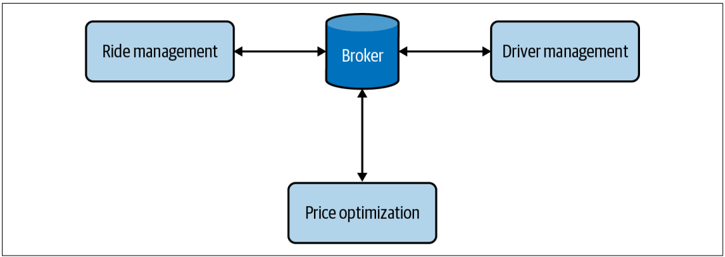
如果有一个代理(broker)来协调服务之间的数据传递会怎样?与其让服务直接互相请求数据、形成一张复杂的服务间数据传递之网,每个服务只需要与代理通信,如图 3-9 所示。例如,与其让其他服务向司机管理服务请求未来一分钟的预测司机数,不如让司机管理服务每次做出预测时,把预测广播(broadcast)给代理?任何想要司机管理服务数据的服务都可以去代理那里查看最新的预测司机数。类似地,每当价格优化服务对未来一分钟的溢价做出预测时,这个预测也会广播给代理。
图 3-9. 有了代理,服务只需要与代理通信,而不是与其他服务通信
从技术上讲,数据库可以充当代理——每个服务可以把数据写入数据库,需要数据的其他服务可以从该数据库读取。然而,正如第 72 页的「通过数据库传递数据」一节中提到的,对延迟要求严格的应用来说,读写数据库太慢了。我们不用数据库来代理数据,而是用内存存储(in-memory storage)来代理数据。实时传输可以被看作是服务间传递数据的内存存储。
广播到实时传输的一条数据称为事件(event)。因此,这种架构也称为事件驱动(event-driven)。实时传输有时也称为事件总线(event bus)。
请求驱动架构适合更依赖逻辑而非数据的系统。事件驱动架构更适合数据密集型的系统。
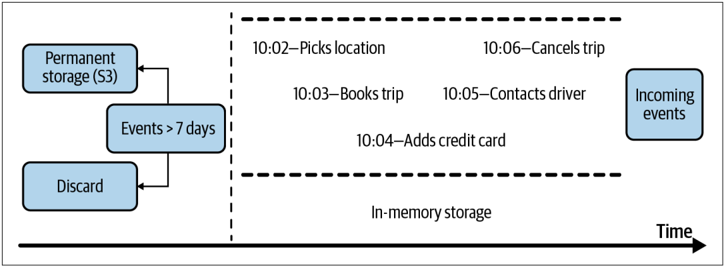
最常见的两种实时传输类型是 pubsub——发布-订阅(publish-subscribe)的简称——和消息队列(message queue)。在 pubsub 模型中,任何服务都可以向实时传输中的不同主题(topic)发布内容,任何订阅了某个主题的服务都可以读取该主题中的所有事件。生产数据的服务不关心什么服务消费它们的数据。Pubsub 解决方案通常有保留策略(retention policy)——数据会在实时传输中保留一定时间(例如七天),然后被删除或移到永久存储(如 Amazon S3)。见图 3-10。
图 3-10. 传入的事件存储在内存存储中,之后被丢弃或移到更永久的存储
在消息队列模型中,一个事件通常有预期的消费者(有预期消费者的事件称为消息,message),消息队列负责把消息送到正确的消费者手中。
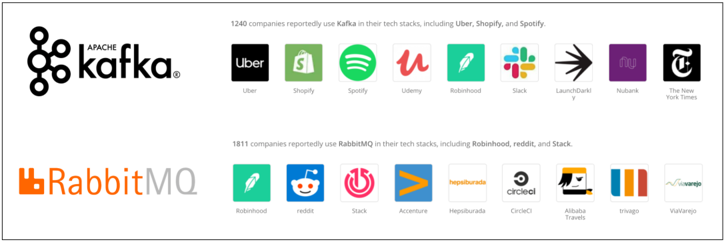
Pubsub 解决方案的例子有 Apache Kafka 和 Amazon Kinesis。27 消息队列的例子有 Apache RocketMQ 和 RabbitMQ。两种范式在过去几年都获得了大量关注。图 3-11 展示了使用 Apache Kafka 和 RabbitMQ 的一些公司。
27 如果你想了解更多 Apache Kafka 的工作原理,Mitch Seymour 有一个很棒的水獭动画来解释它!
图 3-11. 使用 Apache Kafka 和 RabbitMQ 的公司。来源:Stackshare 截图
批处理与流处理
一旦你的数据到达数据库、数据湖或数据仓库等数据存储引擎中,它就变成了历史数据。这与流式数据(仍在流入的数据)相对。历史数据通常在批作业(batch job)中处理——批作业是定期启动的作业。例如,你可以每天启动一次批作业,计算过去一天所有行程的平均溢价。
当数据在批作业中处理时,我们称之为批处理(batch processing)。批处理作为研究课题已经几十年了,公司已经提出了像 MapReduce 和 Spark 这样的分布式系统来高效处理批量数据。
当你在 Apache Kafka 和 Amazon Kinesis 这样的实时传输中有数据时,我们就说你有流式数据。流处理(stream processing)指的是对流式数据进行计算。对流式数据的计算也可以定期启动,但周期通常比批作业短得多(例如每五分钟,而不是每天)。对流式数据的计算也可以在需要时随时启动。例如,每当用户请求行程时,你就处理数据流,看看当前有哪些司机可用。
流处理如果做得好,可以提供低延迟,因为你可以在数据一生成时就处理它,而不必先把它写入数据库。许多人认为流处理不如批处理高效,因为你无法利用 MapReduce 或 Spark 这样的工具。这并不总是对的,原因有二。第一,Apache Flink 等流式技术已被证明具有高度可扩展性和完全分布式,这意味着它们可以并行计算。第二,流处理的强项在于有状态计算(stateful computation)。考虑你想要处理 30 天试用期内的用户参与度的情况。如果你每天启动这个批作业,你就必须每天都对过去 30 天进行计算。而使用流处理,可以只每天继续计算新数据,并把新数据的计算与旧数据的计算连接起来,避免冗余。
因为批处理的频率远低于流处理,在机器学习中,批处理通常用于计算变化不那么频繁的特征,例如司机的评分(如果一个司机已经跑了几百单,他们的评分不太可能一天之内发生显著变化)。批特征(batch features)——通过批处理提取的特征——也称为静态特征(static features)。
流处理用于计算变化很快的特征,例如当前有多少司机可用、过去一分钟内请求了多少行程、未来两分钟内将完成多少行程、该地区最近 10 次行程的中位价格等。像这样关于系统当前状态的特征对做出最优价格预测很重要。流特征(streaming features)——通过流处理提取的特征——也称为动态特征(dynamic features)。
对许多问题来说,你不仅需要批特征或流特征,而是两者都需要。你需要既允许处理流式数据、也允许处理批量数据并把它们连接起来输入机器学习模型的基础设施。我们将在第 7 章更详细地讨论如何把批特征和流特征一起用于生成预测。
要对数据流进行计算,你需要一个流计算引擎(stream computation engine)(就像 Spark 和 MapReduce 是批计算引擎(batch computation engine)一样)。对于简单的流式计算,你可能可以凑合使用 Apache Kafka 这类实时传输自带的流计算能力,但 Kafka 的流处理在处理各种数据源方面的能力有限。
对于利用流特征的机器学习系统来说,流式计算很少是简单的。欺诈检测(fraud detection)和信用评分(credit scoring)这类应用中使用的流特征数量可以达到数百甚至数千个。流特征提取逻辑可能需要涉及不同维度上的连接和聚合的复杂查询。要提取这些特征,需要高效的流处理引擎。为此,你可能想看看 Apache Flink、KSQL 和 Spark Streaming 等工具。在这三个引擎中,Apache Flink 和 KSQL 在行业中更受认可,并且为数据科学家提供了不错的 SQL 抽象。
流处理更困难,因为数据量是无界的,数据以可变的速率和速度到达。让流处理器做批处理,比让批处理器做流处理更容易。Apache Flink 的核心维护者多年来一直主张,批处理是流处理的一个特例。28
28 Kostas Tzoumas, “Batch Is a Special Case of Streaming,” Ververica, 2015 年 9 月 15 日, https://oreil.ly/IcIl2.
小结
本章建立在第 2 章奠定的基础上,即数据在开发机器学习系统中的重要性。在本章中,我们学到,为存储数据选择正确的格式很重要,这能让数据在将来更容易被使用。我们讨论了不同的数据格式,以及行优先与列优先格式、文本与二进制格式各自的优缺点。
我们继续介绍了三大数据模型:关系模型、文档模型和图模型。尽管由于 SQL 的流行,关系模型最为人熟知,但今天这三种模型都被广泛使用,每种模型都适合某一类任务。
在谈论关系模型与文档模型的对比时,许多人认为前者是结构化的,后者是非结构化的。结构化数据与非结构化数据之间的界限相当模糊——关键问题是,谁必须承担假定数据结构的责任。结构化数据意味着写入数据的代码必须假定结构。非结构化数据意味着读取数据的代码必须假定结构。
我们继续介绍了数据存储引擎与处理。我们研究了针对两种截然不同类型的数据处理进行优化的数据库:事务处理和分析处理。我们把数据存储引擎和处理放在一起研究,是因为传统上存储与处理是耦合的:事务数据库用于事务处理,分析数据库用于分析处理。然而,近年来,许多厂商致力于让存储和处理解耦。今天,我们有能处理分析查询的事务数据库,也有能处理事务查询的分析数据库。
在讨论数据格式、数据模型、数据存储引擎和处理时,数据被假定位于一个进程之内。然而,在生产环境中工作时,你很可能要处理多个进程,并且很可能需要在它们之间传输数据。我们讨论了三种数据传递模式。最简单的模式是通过数据库传递。最流行的进程间数据传递模式是通过服务传递。在这种模式下,一个进程作为服务暴露出来,另一个进程可以向它发送数据请求。这种数据传递模式与微服务架构紧密耦合,在微服务架构中,应用的每个组件都被设置为一个服务。
过去十年中越来越流行的一种数据传递模式是通过实时传输传递数据,例如 Apache Kafka 和 RabbitMQ。这种数据传递模式介于通过数据库传递和通过服务传递之间:它允许异步数据传递,同时具有相当低的延迟。
由于实时传输中的数据与数据库中的数据具有不同的性质,它们需要不同的处理技术,正如第 78 页的「批处理与流处理」一节所讨论的。数据库中的数据通常在批作业中处理并产生静态特征,而实时传输中的数据通常使用流计算引擎处理并产生动态特征。有些人认为批处理是流处理的特例,流计算引擎可以用来统一两条处理管道。
一旦我们把数据系统搞定,就可以收集数据并创建训练数据,这将是下一章的重点。