机器学习系统设计导论
在第一章中,我们概述了现实世界中的 ML 系统,现在可以进入真正有趣的部分——实际设计一个 ML 系统。重申第一章的内容:ML 系统设计(ML systems design)是对 MLOps 采取系统化的方法,这意味着我们要从整体上考虑 ML 系统,确保所有组件——业务需求、数据栈、基础设施、部署、监控等——及其利益相关者能够协同工作,满足既定的目标和需求。
本章从讨论目标开始。在开发 ML 系统之前,我们必须理解为什么需要这个系统。如果这个系统是为业务构建的,它必须由业务目标(business objectives)驱动,而业务目标又需要转化为 ML 目标(ML objectives),以指导 ML 模型的开发。
一旦大家对 ML 系统的目标达成共识,我们就需要制定一些需求来指导系统的开发。在本书中,我们将考虑四个需求:可靠性(reliability)、可扩展性(scalability)、可维护性(maintainability)和适应性(adaptability)。然后,我们将介绍为满足这些需求而设计系统的迭代过程。
你可能会想:有了这些目标、需求和流程,我终于可以开始构建 ML 模型了吗?还早着呢!在使用 ML 算法解决问题之前,你首先需要把你的问题定义成一个 ML 能够解决的任务。我们将继续本章,介绍如何定义你的 ML 问题。你的工作难度会因你如何定义问题而发生显著变化。
由于 ML 是一种数据驱动的方法,一本关于 ML 系统设计的书如果不讨论数据在 ML 系统中的重要性,那将是不完整的。本章的最后一部分触及近年来 ML 文献中争论不休的一个话题:数据和智能算法哪个更重要?
让我们开始吧!
业务与 ML 目标
我们首先需要考虑拟议 ML 项目的目标。在做 ML 项目时,数据科学家往往关心 ML 目标:他们可以衡量的、关于 ML 模型性能的指标,如准确率(accuracy)、F1 分数(F1 score)、推理延迟(inference latency)等。他们为模型准确率从 94% 提升到 94.2% 而兴奋不已,并可能为此投入大量资源——数据、算力和工程时间。
但事实是:大多数公司并不在乎花哨的 ML 指标。除非能推动某些业务指标,否则他们不在乎把模型准确率从 94% 提升到 94.2%。我在许多短命的 ML 项目中看到一种模式:数据科学家过于专注于打磨 ML 指标,而不关注业务指标。然而,他们的经理只关心业务指标,在看不到 ML 项目如何推动业务指标之后,就过早地叫停了项目(还可能解雇了参与其中的数据科学团队)。1
那么公司到底关心什么指标?尽管大多数公司都想让你相信别的,但根据诺贝尔奖得主经济学家米尔顿·弗里德曼(Milton Friedman)的说法,企业的唯一目的就是为股东最大化利润。2
因此,企业内任何项目的终极目标都是增加利润,无论是直接还是间接:直接方式如提高销售额(转化率)和削减成本;间接方式如提高客户满意度、增加用户在网站上的停留时间。
要让 ML 项目在企业组织内取得成功,关键是把 ML 系统的性能与整体业务绩效挂钩。这个新的 ML 系统应该影响哪些业务绩效指标,例如广告收入金额、月活跃用户数?
1 Eugene Yan 有一篇很棒的文章,讲数据科学家如何理解所参与项目的业务意图和背景。
2 米尔顿·弗里德曼(Milton Friedman),《弗里德曼主义——企业的社会责任是增加利润》,《纽约时报杂志》,1970 年 9 月 13 日,https://oreil.ly/Fmbem。
假设你在一家关注购买转化率(purchase-through rate)的电商网站工作,想把推荐系统从批量预测(batch prediction)改为在线预测(online prediction)。3 你可能会推断,在线预测能给出对用户当下更相关的推荐,从而带来更高的购买转化率。你甚至可以做实验证明,在线预测能把推荐系统的预测准确率提高 X%,而且从历史上看,在你的网站上,推荐系统预测准确率每提高一个百分点,都会带来购买转化率的某种提升。
广告点击率(click-through rate)预测和欺诈检测之所以成为当今 ML 最流行的用例之一,原因之一就在于很容易把 ML 模型的性能映射到业务指标上:点击率每提高一点都会带来实实在在的广告收入,每拦截一笔欺诈交易都能省下真金白银。
许多公司会自创指标来把业务指标映射到 ML 指标。例如,Netflix 用采纳率(take-rate)来衡量推荐系统的性能:用户看到的推荐中,高质量播放(quality plays)的数量除以推荐总数。4 采纳率越高,推荐系统越好。Netflix 还把推荐系统的采纳率放在其他业务指标的背景下考察,比如总流媒体播放时长和订阅取消率。他们发现,更高的采纳率也会带来更高的总流媒体播放时长和更低的订阅取消率。5
ML 项目对业务目标的影响可能很难推断。例如,一个能给客户提供更多个性化解决方案的 ML 模型,可以让客户更满意,进而在你的服务上花更多钱。同一个 ML 模型也能更快地解决客户的问题,这又会让他们在你的服务上花更少的钱。
要确切回答 ML 指标如何影响业务指标的问题,通常需要做实验。许多公司通过 A/B 测试(A/B testing)之类的实验来做这件事,并选择能带来更好业务指标的模型,不管这个模型的 ML 指标是否更好。
3 我们将在第 7 章介绍批量预测和在线预测。
4 Ashok Chandrashekar、Fernando Amat、Justin Basilico 和 Tony Jebara,《Netflix 的艺术品个性化》,Netflix 技术博客,2017 年 12 月 7 日,https://oreil.ly/UEDmw。
5 Carlos A. Gomez-Uribe 和 Neil Hunt,《Netflix 推荐系统:算法、商业价值与创新》,《ACM 管理信息系统汇刊》第 6 卷第 4 期(2016 年 1 月):13,https://oreil.ly/JkEPB。
然而,即使做了严谨的实验,也可能不足以理解 ML 模型输出与业务指标之间的关系。假设你在一家检测并阻止安全威胁的网络安全公司工作,ML 只是他们复杂流程中的一个组件。一个 ML 模型用于检测流量模式中的异常。这些异常随后会经过一组逻辑判断(例如一系列 if-else 语句)来归类它们是否构成潜在威胁。这些潜在威胁再由安全专家审查,以确定它们是否真的是威胁。真正的威胁随后会进入另一个不同的流程来阻止它们。当这个流程未能阻止某个威胁时,可能根本无法弄清楚 ML 组件是否与之有关。
许多公司喜欢说他们在系统中使用了 ML,因为单是"由 AI 驱动"这一点就能帮他们吸引客户,不管 AI 部分是否真的做了有用的事。6
通过业务视角评估 ML 解决方案时,重要的是对预期回报保持现实态度。由于媒体和那些在 ML 采纳中有利害关系的从业者共同营造的炒作氛围,一些公司可能误以为 ML 能一夜之间神奇地改变他们的业务。
神奇:有可能。一夜之间:不可能。
确实有很多公司从 ML 中获得了回报。例如,ML 帮助 Google 改善搜索、以更高价格卖出更多广告、提高翻译质量,并构建更好的 Android 应用。但这些收益几乎都不是一夜之间发生的。Google 投资 ML 已有数十年。
ML 投资回报在很大程度上取决于采纳的成熟阶段。你采纳 ML 的时间越长,你的管道运行就越高效,开发周期就越快,所需工程时间就越少,云账单就越低,所有这些都会带来更高的回报。根据 Algorithmia 2020 年的一项调查,在 ML 采纳更成熟的公司中(模型上线生产超过五年),近 75% 能在 30 天内部署一个模型。而在刚开始构建 ML 管道的公司中,60% 部署一个模型需要超过 30 天(见图 2-1)。7
6 Parmy Olson,《近半数"AI 初创公司"靠炒作赚钱》,《福布斯》,2019 年 3 月 4 日,https://oreil.ly/w5kOr。
7 《2020 企业机器学习现状》,Algorithmia,2020 年,https://oreil.ly/FlIV1。
图 2-1. 公司将模型投入生产所需的时间与其使用 ML 的时间长短成正比。来源:改编自 Algorithmia 的一幅图
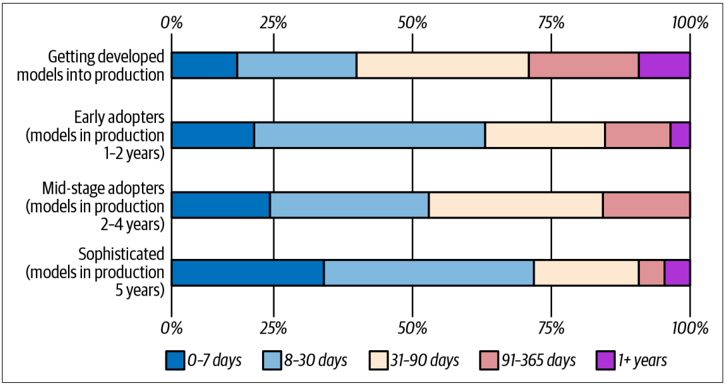
ML 系统的需求
不知道系统必须满足哪些需求,就不能说我们成功构建了一个 ML 系统。ML 系统的具体需求因用例而异。不过,大多数系统都应具备这四个特征:可靠性、可扩展性、可维护性和适应性。我们将逐一详细介绍这些概念。先仔细看看可靠性。
可靠性
系统即使在逆境中(硬件或软件故障,甚至人为错误)也应继续以期望的性能水平执行正确的功能。
对于 ML 系统,“正确性"可能很难确定。例如,你的系统可能正确地调用了 predict 函数——如 model.predict()——但预测结果是错的。如果我们没有真实标签(ground truth labels)可以比对,怎么知道一个预测是错的呢?
对于传统软件系统,你通常会得到警告,比如系统崩溃、运行时错误或 404。然而,ML 系统可能会静默失败。终端用户甚至不知道系统已经失败,可能还在像它正常工作一样继续使用。例如,如果你用 Google 翻译把一句话翻译成你不懂的语言,即使翻译错了,你可能也很难发现。我们将在第 8 章讨论 ML 系统在生产中是如何失败的。
可扩展性
ML 系统有多种增长方式。它可以在复杂度上增长。去年你用的是一个逻辑回归(logistic regression)模型,能装进亚马逊云服务(Amazon Web Services,AWS)免费层 1 GB 内存的实例里;今年你换成了一个 1 亿参数的神经网络,需要 16 GB 内存才能生成预测。
你的 ML 系统可以在流量规模上增长。刚开始部署 ML 系统时,你每天只服务 10,000 个预测请求。但随着公司用户群的增长,你的 ML 系统每天服务的预测请求数量在 100 万到 1,000 万之间波动。
ML 系统可能在模型数量上增长。最初,你可能只为一种用例准备一个模型,比如检测 Twitter 这类社交网站上的热门话题标签。但随着时间推移,你想为这个用例增加更多功能,于是再加一个模型来过滤 NSFW(不适合工作场合)内容,再加一个模型来过滤机器人生成的推文。这种增长模式在面向企业用例的 ML 系统中尤其常见。最初,一家初创公司可能只服务一个企业客户,这意味着这家初创公司只有一个模型。但随着这家初创公司获得更多客户,他们可能为每个客户准备一个模型。我工作过的一家初创公司为他们的 8,000 个企业客户维护着 8,000 个生产模型。
无论你的系统以哪种方式增长,都应该有合理的方法来应对这种增长。说到可扩展性,大多数人想到的是资源伸缩(resource scaling),包括扩容(up-scaling,扩大资源以应对增长)和缩容(down-scaling,不需要时减少资源)。8
例如,在高峰期,你的系统可能需要 100 块 GPU(图形处理器)。但大多数时候,它只需要 10 块 GPU。让 100 块 GPU 一直开着成本很高,所以你的系统应该能缩容到 10 块 GPU。
自动伸缩(autoscaling)是许多云服务中不可或缺的功能:根据使用情况自动增减机器数量。这个功能实现起来可能很棘手。连亚马逊都栽过跟头——他们的自动伸缩功能在 Prime Day 当天失效,导致系统崩溃。据估计,一小时的宕机让亚马逊损失了 7,200 万到 9,900 万美元。9
8 扩容和缩容是"横向扩展”(scaling out)的两个方面,与"纵向扩展"(scaling up)不同。横向扩展是并行增加功能等价的组件来分摊负载;纵向扩展是把单个组件变得更大或更快以处理更大的负载(Leah Schoeb,《云可扩展性:纵向扩展与横向扩展》,Turbonomic 博客,2018 年 3 月 15 日,https://oreil.ly/CFPtb)。
9 Sean Wolfe,《亚马逊 Prime Day 一小时宕机可能造成高达 1 亿美元销售损失》,《商业内幕》,2018 年 7 月 19 日,https://oreil.ly/VBezI。
然而,应对增长不仅仅是资源伸缩,还包括工件管理(artifact management)。管理一百个模型与管理一个模型截然不同。对于一个模型,你也许可以手动监控这个模型的性能,并手动用新数据更新模型。因为只有一个模型,你只需要一个文件,就能在需要时随时复现这个模型。但对于一百个模型,监控和再训练两个方面都需要自动化。你需要一种管理代码生成的方法,以便在需要时能充分复现模型。
由于可扩展性贯穿 ML 项目工作流的始终,我们将在本书的不同部分讨论它。具体来说,我们会在第 168 页的「分布式训练」一节、第 216 页的「模型优化」一节和第 311 页的「资源管理」一节中讨论资源伸缩方面。我们会在第 162 页的「实验跟踪与版本管理」一节和第 302 页的「开发环境」一节中讨论工件管理方面。
可维护性
会有很多人参与 ML 系统的工作。他们是 ML 工程师、DevOps 工程师和领域专家(subject matter experts,SMEs)。他们可能来自非常不同的背景,使用非常不同的编程语言和工具,并可能拥有流程的不同部分。
重要的是,要以一种让不同贡献者都能使用自己熟悉的工具工作的方式来组织工作负载和搭建基础设施,而不是让某一群贡献者把自己的工具强加给其他群体。代码应该有文档。代码、数据和工件应该做版本管理。模型应该具备足够的可复现性,这样即使原作者不在,其他贡献者也能有足够的上下文在他们工作的基础上继续。当问题发生时,不同的贡献者应该能够一起找出问题并实施解决方案,而不是互相指责。
我们将在第 334 页的「团队结构」一节深入讨论这一点。
适应性
为了适应不断变化的数据分布和业务需求,系统应具备一定的能力:既能发现性能改进的方面,又能在不中断服务的情况下进行更新。
由于 ML 系统一半是代码、一半是数据,而数据可能变化很快,ML 系统需要能够快速进化。这与可维护性紧密相关。我们将在第 237 页的「数据分布漂移」一节讨论变化的数据分布,并在第 264 页的「持续学习」一节讨论如何用新数据持续更新模型。
迭代过程
开发 ML 系统是一个迭代的、而且在大多数情况下永无止境的过程。10 一旦系统投入生产,就需要持续监控和更新。
在部署我的第一个 ML 系统之前,我以为这个过程是线性的、直截了当的。我以为我要做的只是收集数据、训练模型、部署模型,然后完事。但我很快意识到,这个过程更像一个循环,不同步骤之间有很多来回反复。
例如,下面是你在构建一个 ML 模型(预测用户输入搜索词时是否应该展示广告)时可能遇到的工作流:11
- 选择一个要优化的指标。例如,你可能想优化曝光次数(impressions)——广告被展示的次数。
- 收集数据并获得标签。
- 进行特征工程。
- 训练模型。
- 在错误分析(error analysis)中,你发现错误是由标签错误引起的,于是重新标注数据。
- 再次训练模型。
- 在错误分析中,你发现你的模型总是预测不该展示广告,原因是你的数据中 99.99% 都是负标签(NEGATIVE labels,即不该展示的广告)。所以你不得不收集更多应该展示的广告数据。
- 再次训练模型。
- 模型在你现有的测试数据上表现良好,但这份测试数据如今已有两个月的历史。然而,它在昨天的数据上表现很差。你的模型已经过时了,需要用更新的数据更新它。
- 再次训练模型。
- 部署模型。
- 模型似乎表现不错,但随后业务人员来敲你的门,问为什么收入在下降。原来是广告展示了,但点击的人很少。于是你想改变模型,改成为优化广告点击率。
- 回到第 1 步。
10 正如一位早期审稿人指出的,这也是传统软件的一个特性。
11 祈祷和哭泣没有出现在流程中,但贯穿整个过程。
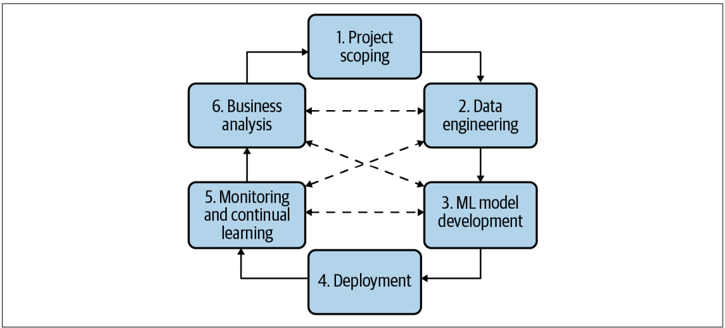
图 2-2 从数据科学家或 ML 工程师的视角,展示了生产环境中开发 ML 系统的迭代过程的极简示意。从 ML 平台工程师或 DevOps 工程师的视角来看,这个过程看起来不同,因为他们对模型开发的上下文了解可能没那么深入,可能会花更多时间在搭建基础设施上。
图 2-2. 开发 ML 系统的过程更像一个循环,各步骤之间有很多来回反复
后面的章节将深入探讨每个步骤在实践中需要什么。这里,我们先简要看看它们是什么意思:
Step 1. 项目范围界定
一个项目从界定范围开始,明确目标、目的和约束。应该识别利益相关者并让他们参与进来。应该估算并分配资源。我们已经在第 1 章讨论了不同的利益相关者以及生产环境 ML 项目的一些重点。我们也在本章前面讨论了如何在业务背景下界定 ML 项目的范围。我们将在第 11 章讨论如何组织团队以确保 ML 项目的成功。
Step 2. 数据工程
当今绝大多数 ML 模型都是从数据中学习的,因此开发 ML 模型始于数据工程(data engineering)。在第 3 章,我们将讨论数据工程的基础知识,涵盖如何处理来自不同来源和格式的数据。拿到原始数据后,我们会想通过采样和生成标签从中整理出训练数据,这将在第 4 章讨论。
Step 3. ML 模型开发
有了初始训练数据,我们就需要提取特征,并利用这些特征开发初始模型。这是最需要 ML 知识、也最常在 ML 课程中讲到的阶段。在第 5 章,我们将讨论特征工程(feature engineering)。在第 6 章,我们将讨论模型选择、训练和评估。
Step 4. 部署
模型开发完成后,需要让用户能够访问它。开发 ML 系统就像写作——你永远不会到达系统"完成"的时刻。但你的确会到达必须把系统发布出去的时刻。我们将在第 7 章讨论部署 ML 模型的不同方式。
Step 5. 监控与持续学习
一旦投入生产,模型就需要被监控以防性能衰减,并保持维护以适应用户环境的变化和需求的变化。这一步将在第 8 章和第 9 章讨论。
Step 6. 业务分析
需要对照业务目标评估模型性能,并进行分析以产生业务洞察。这些洞察可以用来淘汰没有产出的项目,或规划新项目。这一步与第一步密切相关。
定义 ML 问题
想象一下,你是一家面向千禧一代用户银行的 ML 工程负责人。一天,你的老板听说一家竞争对手银行用 ML 加速客户服务支持,据说帮助那家银行把处理客户请求的速度提高了一倍。他命令你的团队也研究用 ML 加速你们的客户服务支持。
客户支持慢是一个问题,但它不是 ML 问题。ML 问题由输入、输出和指导学习过程的目标函数来定义——这三个组成部分没有一个是老板的要求里显而易见的。作为经验丰富的 ML 工程师,你的工作是用你关于 ML 能解决什么问题的知识,把这个请求定义成一个 ML 问题。
经过调查,你发现响应客户请求的瓶颈在于把客户请求路由到正确的部门——会计、库存、人力资源(human resources,HR)和 IT 四个部门之一。你可以通过开发一个 ML 模型来预测请求应该去这四个部门中的哪一个,从而缓解这个瓶颈。这使它成为一个分类(classification)问题。输入是客户请求。输出是请求应该去的部门。目标函数是最小化预测部门与实际部门之间的差异。
我们将在第 5 章详细讨论如何从原始数据中提取特征作为 ML 模型的输入。在本节,我们将聚焦两个方面:模型的输出,以及指导学习过程的目标函数。
ML 任务的类型
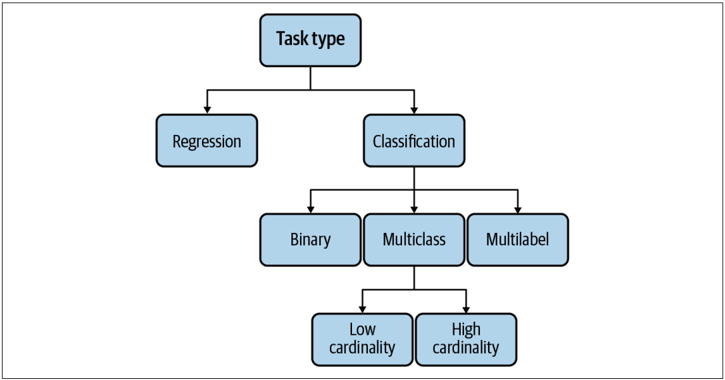
模型的输出决定了你的 ML 问题的任务类型。最常见的 ML 任务类型是分类(classification)和回归(regression)。在分类内部,还有更多子类型,如图 2-3 所示。我们将逐一介绍这些任务类型。
图 2-3. ML 中常见的任务类型
分类与回归
分类模型把输入分类到不同类别中。例如,你想把每封电子邮件分类为垃圾邮件或非垃圾邮件。回归模型输出一个连续值。一个例子是房价预测模型,输出给定房屋的价格。
回归模型很容易被定义成分类模型,反之亦然。例如,如果我们把房价量化为若干区间,如 10 万美元以下、10 万–20 万美元、20 万–50 万美元,依此类推,然后预测房屋应处于哪个区间,房价预测就变成了分类任务。
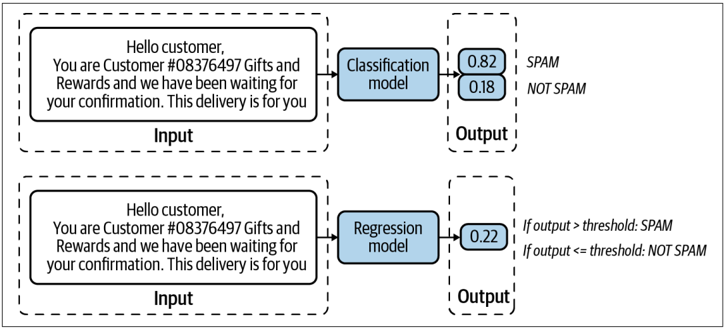
电子邮件分类模型也可以变成回归模型:让它输出 0 到 1 之间的值,然后定一个阈值来决定哪些值算垃圾邮件(例如,如果值大于 0.5,该邮件就是垃圾邮件),如图 2-4 所示。
图 2-4. 电子邮件分类任务也可以被定义成回归任务
二分类与多分类
在分类问题中,要分的类别越少,问题越简单。最简单的是二分类(binary classification),只有两个可能的类别。二分类的例子包括:判断一条评论是否有害、肺部扫描是否显示癌症迹象、一笔交易是否欺诈。目前尚不清楚这类问题在业界如此常见,是因为它们本质上就常见,还是仅仅因为 ML 从业者最擅长处理它们。
当类别超过两个时,问题就变成了多分类(multiclass classification)。处理二分类问题比处理多分类问题容易得多。例如,当只有两个类别时,计算 F1 和可视化混淆矩阵(confusion matrix)要直观得多。
当类别数量很大时——比如疾病诊断中疾病种类可达数千种,或商品分类中商品数量可达数万种——我们就说这个分类任务具有高基数(high cardinality)。高基数问题可能非常有挑战性。第一个挑战在于数据收集。根据我的经验,ML 模型要学会分类某个类别,通常每个类别至少需要 100 个样本。所以如果你有 1,000 个类别,你至少需要 100,000 个样本。对于稀有类别,数据收集可能尤其困难。当你有数千个类别时,其中有些类别很可能是稀有的。
当类别数量很大时,分层分类(hierarchical classification)可能会很有用。在分层分类中,你先用一个分类器把每个样本分类到几个大组之一;然后用另一个分类器把该样本分类到其中一个子组。例如,对于商品分类,你可以先把每件商品分类到四个主要类别之一:电子产品、家居厨房、时尚或宠物用品。一件商品被分到某个类别(比如时尚)后,你可以用另一个分类器把它放进某个子组:鞋、衬衫、牛仔裤或配饰。
多分类与多标签分类
在二分类和多分类中,每个样本恰好属于一个类别。当一个样本可以属于多个类别时,我们就面临多标签分类(multilabel classification)问题。例如,在构建一个把文章分类到四个主题——科技、娱乐、财经、政治——的模型时,一篇文章可以既属于科技又属于财经。
多标签分类问题有两大主流方法。第一种是把它当作多分类来处理。在多分类中,如果有四个可能的类别 [科技、娱乐、财经、政治],一个样本的标签是娱乐,你就用向量 [0, 1, 0, 0] 来表示这个标签。在多标签分类中,如果一个样本同时有娱乐和财经两个标签,它的标签就表示为 [0, 1, 1, 0]。
第二种方法是把它变成一组二分类问题。对于文章分类问题,你可以有四个模型对应四个主题,每个模型输出一篇文章是否属于该主题。
在所有任务类型中,多标签分类通常是我见过公司问题最多的一种。多标签意味着一个样本可以拥有的类别数量因样本而异。首先,这使标签标注变得困难,因为它加剧了我们在第 4 章讨论的标签多重性(label multiplicity)问题。例如,一个标注者可能认为某个样本属于两个类别,而另一个标注者可能认为同一个样本只属于一个类别,要解决他们的分歧可能很困难。
其次,这种类别数量的变化使得从原始概率中提取预测变得困难。考虑同样的把文章分类到四个主题的任务。假设给定一篇文章,你的模型输出这样的原始概率分布:[0.45, 0.2, 0.02, 0.33]。在多分类场景中,当你知道一个样本只能属于一个类别时,你直接选择概率最高的类别,本例中就是 0.45。在多标签场景中,因为你不知道一个样本可以属于多少个类别,你可能会选择概率最高的两个类别(对应 0.45 和 0.33),或概率最高的三个类别(对应 0.45、0.2 和 0.33)。
定义问题的多种方式
改变你定义问题的方式,可能会让你的问题变得明显更难或更简单。考虑预测手机用户接下来想使用哪个应用的任务。一种天真的做法是把它定义成一个多分类任务——用用户特征和环境特征(用户人口统计信息、时间、地点、之前用过的应用)作为输入,输出用户手机上每一个应用的概率分布。设 \(N\) 为你考虑推荐给用户的应用数量。在这种定义下,对于给定用户在给定时刻,只需要做一次预测,预测结果是一个大小为 \(N\) 的向量。这种设置在如图 2-5 中可视化。
图 2-5. 对于预测用户接下来最可能打开哪个应用的问题,你可以把它定义成一个分类问题。输入是用户特征和环境特征。输出是手机上所有应用上的一个概率分布。
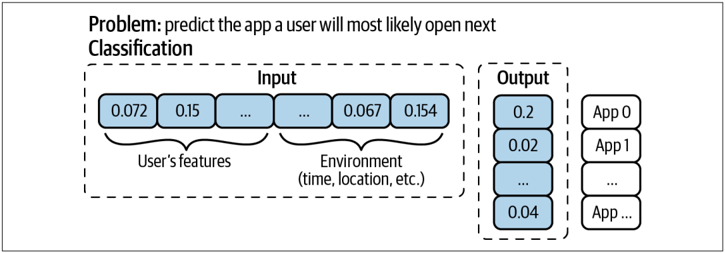
这是一种糟糕的做法,因为每当添加一个新应用,你可能都得从头重新训练模型,或者至少重新训练模型中参数数量依赖于 \(N\) 的所有组件。更好的做法是把它定义成一个回归任务。输入是用户、环境和应用的特征。输出是 0 到 1 之间的单个值;值越高,用户在给定上下文中打开该应用的可能性越大。在这种定义下,对于给定用户在给定时刻,需要做 \(N\) 次预测,每个应用一次,但每次预测只是一个数字。这种改进后的设置在如图 2-6 中可视化。
图 2-6. 对于预测用户接下来最可能打开哪个应用的问题,你可以把它定义成一个回归问题。输入是用户特征、环境特征和应用特征。输出是 0 到 1 之间的单个值,表示用户在给定上下文中打开该应用的可能性。
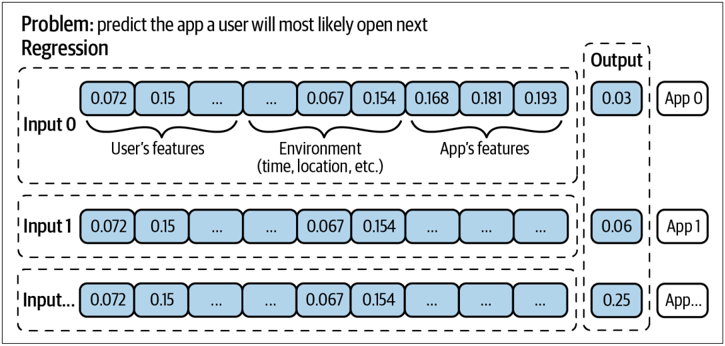
在这种新定义下,每当有一个你想考虑推荐给用户的新应用,你只需要用包含这个新应用特征的新输入,而不必从头重新训练你的模型或模型的一部分。
目标函数
为了学习,ML 模型需要一个目标函数(objective function)来指导学习过程。12 目标函数也叫损失函数(loss function),因为学习过程的目标通常是最小化(或优化)错误预测造成的损失。对于监督式 ML,这个损失可以通过用均方根误差(root mean squared error,RMSE)或交叉熵(cross entropy)之类的度量,把模型的输出与真实标签进行比较来计算。
为了说明这一点,让我们再次回到之前把文章分类到四个主题 [科技、娱乐、财经、政治] 的任务。考虑一篇属于政治类的文章,比如它的真实标签是 [0, 0, 0, 1]。假设给定这篇文章,你的模型输出这样的原始概率分布:[0.45, 0.2, 0.02, 0.33]。给定这个样本,这个模型的交叉熵损失,就是 [0.45, 0.2, 0.02, 0.33] 相对于 [0, 0, 0, 1] 的交叉熵。在 Python 中,你可以用下面的代码计算交叉熵:
12 注意,目标函数是数学函数,不同于本章前面讨论的业务目标和 ML 目标。
import numpy as np

def cross_entropy(p, q):
    return -sum([p[i] * np.log(q[i]) for i in range(len(p))])

p = [0, 0, 0, 1]
q = [0.45, 0.2, 0.02, 0.33]
cross_entropy(p, q)
选择目标函数通常很简单,但并不是因为目标函数容易。想出一个有意义的目标函数需要代数知识,所以大多数 ML 工程师只是使用常见的损失函数:回归用 RMSE 或 MAE(平均绝对误差,mean absolute error),二分类用对数损失(logistic loss,也叫 log loss),多分类用交叉熵。
解耦目标
当你想最小化多个目标函数时,定义 ML 问题可能会很棘手。假设你在构建一个对用户信息流(newsfeed)中的条目进行排序的系统。你最初的目标是最大化用户参与度。你想通过以下三个目标来实现这个目标:
- 过滤垃圾信息
- 过滤 NSFW 内容
- 按参与度对帖子排序:用户点击它的可能性有多大
然而,你很快发现,仅优化用户参与度可能会引发可疑的伦理问题。因为极端帖子往往能获得更多参与,你的算法学会了优先展示极端内容。13 你想创造一个更健康的信息流。于是你有了一个新目标:在最大化用户参与度的同时,最小化极端观点和虚假信息的传播。为了实现这个目标,你在原有计划上增加了两个新目标:
- 过滤垃圾信息
- 过滤 NSFW 内容
- 过滤虚假信息
- 按质量对帖子排序
- 按参与度对帖子排序:用户点击它的可能性有多大
13 Joe Kukura,《Facebook 员工薪酬受青睐愤怒帖子的"危险"算法推动》,SFist,2019 年 9 月 24 日,https://oreil.ly/PXtGi;Kevin Roose,《一个 YouTube 激进分子的养成》,《纽约时报》,2019 年 6 月 8 日,https://oreil.ly/KYqzF。
现在两个目标相互冲突。如果一篇帖子很吸引人但质量存疑,它应该排得高还是低?
一个目标由一个目标函数表示。要按质量对帖子排序,你首先需要预测帖子的质量,并且希望帖子的预测质量尽可能接近其实际质量。本质上,你想最小化质量损失(quality_loss):每篇帖子的预测质量与其真实质量之间的差异。14
同样,要按参与度对帖子排序,你首先需要预测每篇帖子会获得多少次点击。你想最小化参与度损失(engagement_loss):每篇帖子的预测点击数与其实际点击数之间的差异。
一种方法是把这两个损失合并成一个损失,训练一个模型来最小化这个损失:
\[ loss = \alpha \times quality\_loss + \beta \times engagement\_loss \]你可以随机试不同的 α 和 β 值,找到效果最好的值。如果你想更系统地调整这些值,可以了解一下帕累托优化(Pareto optimization),“多准则决策中关注涉及多个目标函数同时优化的数学优化问题的一个领域”。15
这种方法的一个问题是,每次你调整 α 和 β——例如,如果用户信息流的质量上升了,但用户参与度下降了,你可能想降低 α、提高 β——你都得重新训练模型。
另一种方法是训练两个不同的模型,每个模型优化一个损失。于是你有两个模型:
quality_model
最小化 quality_loss,输出每篇帖子的预测质量
engagement_model
最小化 engagement_loss,输出每篇帖子的预测点击数
你可以把两个模型的输出结合起来,按组合得分对帖子排序:
\[ \alpha \times quality\_score + \beta \times engagement\_score \]现在你可以在不重新训练模型的情况下调整 α 和 β 了!
14 为简单起见,我们先假装知道如何衡量一篇帖子的质量。
15 维基百科,“帕累托优化”,https://oreil.ly/NdApy。趁此机会,你可能还想读一读 Jin 和 Sendhoff 关于将帕累托优化应用于 ML 的优秀论文,作者声称"机器学习本质上是一个多目标任务"(Yaochu Jin 和 Bernhard Sendhoff,《基于帕累托的多目标机器学习:概述与案例研究》,《IEEE 系统、人与控制论汇刊——C 部分:应用与评论》第 38 卷第 3 期 [2008 年 5 月],https://oreil.ly/f1aKk)。
一般来说,当有多个目标时,先把它们解耦是个好主意,因为这会让模型开发和维护更容易。首先,如前所述,不重新训练模型就能更容易地调整系统。其次,维护更容易,因为不同的目标可能需要不同的维护节奏。垃圾信息技术比人们对帖子质量的看法演化得快得多,所以垃圾过滤系统需要的更新频率远高于质量排序系统。
智能与数据
过去十年的进展表明,ML 系统的成功在很大程度上取决于它训练所用的数据。大多数公司不是专注于改进 ML 算法,而是专注于管理和改进数据。16
尽管使用海量数据的模型取得了成功,仍有许多人对把数据作为前进方向的做法持怀疑态度。在过去五年里,我参加的每一次学术会议上,总会有一些关于智能与数据孰强的公开辩论。智能可能以归纳偏置(inductive bias)或巧妙架构设计的形式出现。数据可能和算力归为一类,因为更多的数据往往需要更多的算力。
理论上,你可以同时追求架构设计和利用大数据与算力,但花时间在其中一个上往往会挤占另一个的时间。17
在"智能胜过数据"阵营中,有图灵奖得主 Judea Pearl 博士,他以因果推断(causal inference)和贝叶斯网络(Bayesian network)的研究而闻名。他的著作《为什么》(The Book of Why)的导言题为"智能胜过数据",他在其中强调:“数据是极其愚蠢的。“在 2020 年他一条颇有争议的推文中,他表达了对严重依赖数据的 ML 方法的强烈反对,并警告以数据为中心的 ML 从业者可能在三到五年内失业:“三到五年后,ML 将不再是现在的样子,继续遵循当前以数据为中心范式的 ML 从业者会发现他们过时了,甚至失业。请注意。“18
16 Anand Rajaraman,《更多数据通常胜过更好的算法》,Datawocky,2008 年 3 月 24 日,https://oreil.ly/wNwhV。
17 Rich Sutton,《苦涩的教训》,2019 年 3 月 13 日,https://oreil.ly/RhOp9。
18 Judea Pearl 博士(@yudapearl)的推文,2020 年 9 月 27 日,https://oreil.ly/wFbHb。
还有更温和的观点,来自斯坦福人工智能实验室主任 Christopher Manning 教授,他认为巨大的算力和海量数据加上简单的学习算法,会造就极其糟糕的学习器。结构让我们能够设计出用更少数据学到更多的系统。19
如今 ML 界的许多人站在"数据胜过智能"阵营。阿尔伯塔大学计算机科学教授、DeepMind 杰出研究科学家 Richard Sutton 教授写了一篇很棒的博文,他在文中声称,选择追求智能设计而不是利用算力的研究者最终会学到苦涩的教训:“从 70 年的 AI 研究中能读到的最大的教训是,利用算力的通用方法最终是最有效的,而且领先幅度很大……为了寻求短期内能见效的改进,研究者试图利用他们对领域的人类知识,但从长远来看,唯一重要的就是利用算力。“20
当被问及 Google 搜索为什么做得这么好时,Google 搜索质量总监 Peter Norvig 强调,在他们的成功中,拥有大量数据比智能算法更重要:“我们没有更好的算法。我们只是有更多的数据。“21
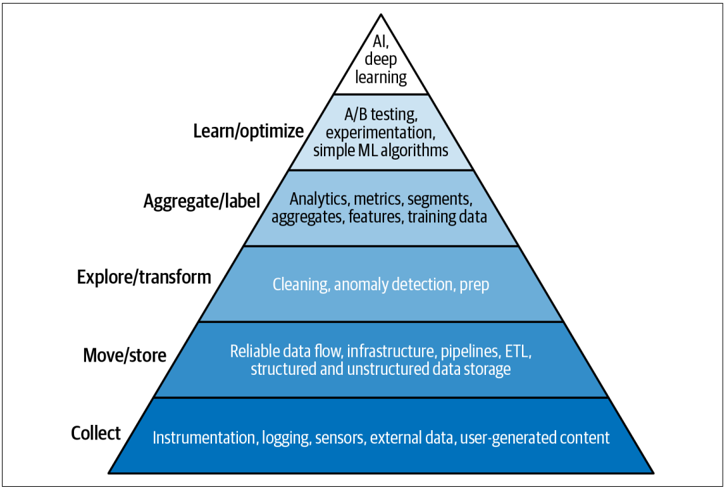
Jawbone 前数据副总裁 Monica Rogati 博士认为,数据位于数据科学的基础地位,如图 2-7 所示。如果你想用数据科学(ML 是其中一个学科)来改进你的产品或流程,你需要从构建你的数据开始,既包括质量也包括数量。没有数据,就没有数据科学。
这场辩论不是关于有限数据是否必要,而是关于它是否充分。这里的"有限"一词很重要,因为如果我们有无限的数据,我们也许就能直接查出答案。拥有大量数据与拥有无限数据是不同的。
19 《深度学习与先天先验》(Chris Manning 对 Yann LeCun 的辩论),2018 年 2 月 2 日,视频,1:02:55,https://oreil.ly/b3hb1。
20 Sutton,《苦涩的教训》。
21 Alon Halevy、Peter Norvig 和 Fernando Pereira,《数据不可思议的有效性》,IEEE 计算机学会,2009 年 3/4 月,https://oreil.ly/WkN6p。
图 2-7. 数据科学需求层次。来源:改编自 Monica Rogati 的一幅图 22
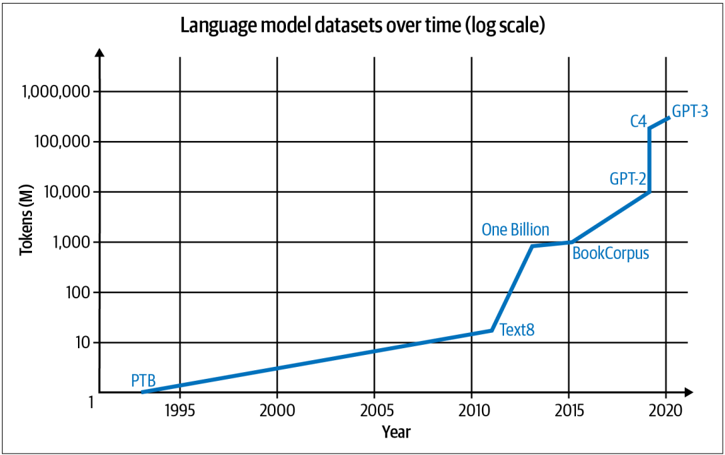
无论最终哪个阵营被证明是对的,目前没有人能否认数据是必不可少的。近几十年的研究和行业趋势都表明,ML 的成功越来越依赖于数据的质量和数量。模型变得越来越大,使用的数据越来越多。早在 2013 年,当用于语言建模的 One Billion Word 基准(One Billion Word Benchmark)发布时,人们非常兴奋,它包含 8 亿个 token。23 六年后,OpenAI 的 GPT-2 使用了 100 亿个 token 的数据集。又过了一年,GPT-3 使用了 5,000 亿个 token。数据集规模的增长率如图 2-8 所示。
22 Monica Rogati,《AI 需求层次》,Hackernoon 通讯,2017 年 6 月 12 日,https://oreil.ly/3nxJ8。
23 Ciprian Chelba、Tomas Mikolov、Mike Schuster、Qi Ge、Thorsten Brants、Phillipp Koehn 和 Tony Robinson,《用于衡量统计语言建模进展的十亿词基准》,arXiv,2013 年 12 月 11 日,https://oreil.ly/1AdO6。
图 2-8. 语言模型所用数据集规模(对数刻度)随时间的变化
尽管过去十年深度学习的许多进展都是由越来越多的数据推动的,但更多的数据并不总能给模型带来更好的性能。质量更低的数据——比如过时的数据或标签错误的数据——甚至可能损害模型的性能。
小结
希望本章让你对 ML 系统设计以及设计 ML 系统时需要考虑的因素有了一个入门了解。
每个项目都必须从"为什么需要做这个项目"开始,ML 项目也不例外。我们在本章开头假设:大多数企业不在乎 ML 指标,除非它们能推动业务指标。因此,如果 ML 系统是为企业构建的,它必须由业务目标驱动,而业务目标需要转化为 ML 目标,以指导 ML 模型的开发。
在构建 ML 系统之前,我们需要理解系统为了称得上一个好系统必须满足的需求。确切的需求因用例而异,在本章中,我们聚焦四个最通用的需求:可靠性、可扩展性、可维护性和适应性。满足每个需求的技术将在全书中介绍。
构建 ML 系统不是一次性任务,而是一个迭代过程。在本章中,我们讨论了开发满足前述需求的 ML 系统的迭代过程。
我们在本章结尾对数据在 ML 系统中的角色进行了一番哲学讨论。仍有许多人相信,拥有智能算法最终会胜过拥有大量数据。然而,包括 AlexNet、BERT 和 GPT 在内的系统的成功表明,过去十年 ML 的进展依赖于能获得大量数据。24 无论数据能否压过智能设计,没有人能否认数据在 ML 中的重要性。本书将有相当一部分篇幅用来阐明各种数据问题。
复杂的 ML 系统是由更简单的构建块组成的。既然我们已经介绍了生产环境中 ML 系统的高层概览,我们将在接下来的章节中聚焦它的构建块,从下一章的数据工程基础开始。如果本章提到的任何挑战对你来说还很抽象,我希望后面章节中的具体例子能让它们变得更具体。
24 Alex Krizhevsky、Ilya Sutskever 和 Geoffrey E Hinton,《基于深度卷积神经网络的 ImageNet 分类》,《神经信息处理系统进展》第 25 卷,F. Pereira、C.J. Burges、L. Bottou 和 K.Q. Weinberger 编(Curran Associates,2012 年),https://oreil.ly/MFYp9;Jacob Devlin、Ming-Wei Chang、Kenton Lee 和 Kristina Toutanova,《BERT:用于语言理解的深度双向 Transformer 预训练》,arXiv,2019 年,https://oreil.ly/TN8fN;《更好的语言模型及其影响》,OpenAI 博客,2019 年 2 月 14 日,https://oreil.ly/SGV7g。