机器学习系统概述
2016 年 11 月,谷歌宣布将其多语言神经机器翻译系统整合进谷歌翻译(Google Translate),这标志着深度人工神经网络在大规模生产环境中取得的首批成功案例之一¹。据谷歌称,通过这次更新,翻译质量的提升幅度在单次跃升中超过了此前 10 年的总和。
深度学习的这一成功,重新点燃了业界对机器学习(machine learning,ML)的广泛兴趣。自那以后,越来越多的公司转向机器学习,用其解决最具挑战性的问题。仅仅五年时间,机器学习几乎渗透到我们生活的方方面面:我们如何获取信息、如何沟通、如何工作、如何寻找爱情。机器学习的普及如此迅速,以至于我们已经很难想象没有它的生活。然而,在医疗保健、交通、农业,甚至帮助人类理解宇宙等领域,还有更多的机器学习用例等待探索²。
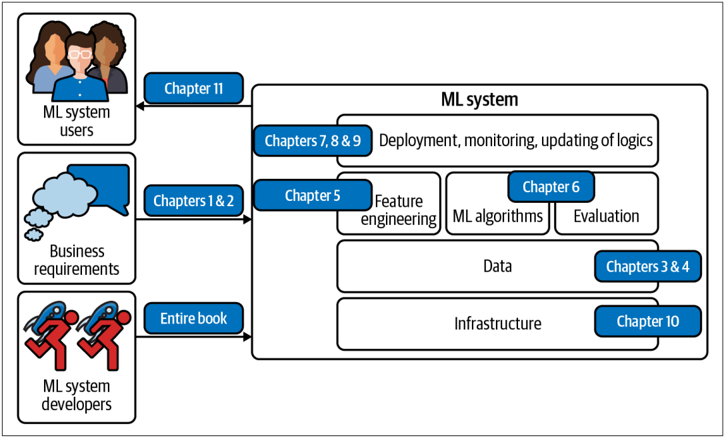
许多人听到"机器学习系统"时,只会想到所使用的机器学习算法,比如逻辑回归(logistic regression)或各种类型的神经网络(neural network)。然而,算法只是生产环境中机器学习系统的一小部分。系统还包括催生机器学习项目的业务需求、用户和开发人员与系统交互的界面、数据栈(data stack)、开发/监控/更新模型的逻辑,以及支撑这些逻辑交付的基础设施。图 1-1 展示了机器学习系统的各个组成部分,以及本书将在哪些章节中介绍它们。
1 Mike Schuster、Melvin Johnson 和 Nikhil Thorat,《利用谷歌多语言神经机器翻译系统实现零样本翻译》,Google AI Blog,2016 年 11 月 22 日,https://oreil.ly/2R1CB。
2 Larry Hardesty,《一种为黑洞成像的方法》,MIT News,2016 年 6 月 6 日,https://oreil.ly/HpL2F。
MLOps 与机器学习系统设计的关系
MLOps(Machine Learning Operations,机器学习运维)中的 Ops 源自 DevOps(Development and Operations,开发与运维)。将某事物"运营化"(operationalize)意味着把它带入生产环境,包括部署、监控和维护。MLOps 是一套将机器学习带入生产环境的工具与最佳实践。
机器学习系统设计(ML systems design)以系统化的视角看待 MLOps,即从整体上考虑机器学习系统,确保所有组件及其利益相关者能够协同工作,满足既定的目标与需求。
图 1-1. 机器学习系统的不同组成部分。“机器学习算法"通常是人们说到机器学习时最先想到的东西,但它只是整个系统中的一小部分。
市面上有许多关于各种机器学习算法的优秀书籍。本书不会深入介绍任何特定算法,而是帮助读者从整体上理解机器学习系统。换言之,本书的目标是为你提供一个框架,让你能够针对自己的问题开发出最合适的解决方案,无论你最终选择哪种算法。算法可能会随着新算法的不断涌现而迅速过时,但本书提出的框架应该依然适用于新算法。
本书第一章旨在让你概览将机器学习模型带入生产环境所需的一切。在讨论如何开发机器学习系统之前,有必要先提出一个根本性问题:什么时候该用机器学习,什么时候不该用。我们将介绍一些流行的机器学习用例来说明这一点。
介绍完用例之后,我们将转向部署机器学习系统的挑战,并通过将生产中的机器学习与研究中的机器学习、以及与传统软件进行对比来展开。如果你一直在一线开发应用型机器学习系统,本章的内容你可能已经很熟悉了。但如果你只在学术环境中接触过机器学习,本章将向你呈现机器学习在现实世界中的真实面貌,为你第一次做应用打下成功的基础。
何时使用机器学习
随着机器学习在工业界的采用迅速增长,它已被证明是解决广泛问题的强大工具。尽管领域内外的人们制造了令人难以置信的热情和炒作,机器学习并不是能解决所有问题的魔法工具。即使对于机器学习能够解决的问题,机器学习方案也不一定是最优方案。在启动机器学习项目之前,你不妨先问问自己:机器学习是否有必要,或者是否具有成本效益³。
为了理解机器学习能做什么,让我们看看机器学习方案通常会做什么:
机器学习是一种方法,用来(1)从(3)已有数据中(2)学习复杂模式,并利用这些模式对(5)未见数据做出(4)预测。
我们将逐一审视上述表述中斜体的关键词,理解它们对机器学习可解决问题的影响:
- 学习:系统具备学习能力
关系型数据库(relational database)不是机器学习系统,因为它没有学习能力。你可以显式地声明关系型数据库中两列之间的关系,但它不太可能自己弄清楚这两列之间的关系。
机器学习系统要学习,必须有可供学习的对象。在大多数情况下,机器学习系统从数据中学习。在监督学习(supervised learning)中,基于成对的输入输出示例,机器学习系统学习如何为任意输入生成输出。例如,如果你想构建一个机器学习系统来预测 Airbnb 房源的租金价格,你需要提供一个数据集,其中每个输入都是具有相关特征的房源(面积、房间数、所在社区、便利设施、该房源的评分等),对应的输出是该房源的租金价格。学习完成后,这个机器学习系统应该能够根据一个新房源的特征预测其价格。
3 我没有问机器学习是否足够,因为答案永远是否定的。
2. 复杂模式:存在可学习的模式,而且这些模式很复杂
机器学习方案只有在存在可学习模式时才有用。正常人不会花钱去构建机器学习系统来预测一枚公平骰子的下一次结果,因为这些结果的产生方式没有任何模式⁴。然而,股票定价是有模式的,因此公司们投入了数十亿美元构建机器学习系统来学习这些模式。
模式是否存在可能并不明显;即便模式存在,你的数据集或机器学习算法也可能不足以捕捉它们。例如,埃隆·马斯克(Elon Musk)的推文如何影响加密货币价格,可能存在某种模式。然而,除非你在他的推文上严格训练和评估了机器学习模型,否则你无从知晓。即使你的所有模型都无法对加密货币价格做出合理预测,也不代表不存在模式。
想想 Airbnb 这类拥有大量房源列表的网站,每个房源都带有邮政编码。如果你想按房源所在的州对列表进行分类,你并不需要机器学习系统。因为这个模式很简单——每个邮政编码都对应一个已知的州——你只需要一个查找表(lookup table)就够了。
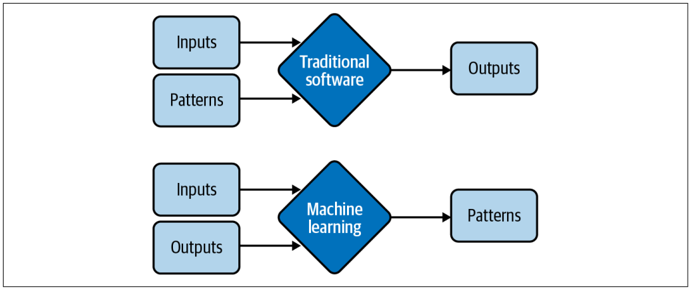
租金价格与其所有特征之间的关系遵循复杂得多的模式,人工指定会非常困难。机器学习正是解决这个问题的好方案。你不需要告诉系统如何根据特征列表计算价格,只需提供价格和特征,让机器学习系统自己找出模式。机器学习方案与查找表方案以及一般传统软件方案的区别如图 1-2 所示。因此,机器学习也被称为软件 2.0(Software 2.0)⁵。
机器学习在对象检测(object detection)和语音识别(speech recognition)等具有复杂模式的任务上非常成功。对机器来说复杂的东西与对人类来说复杂的东西是不同的。许多对人类来说很难的任务对机器来说很容易——例如,计算一个数的 10 次幂。另一方面,许多对人类来说很容易的任务对机器来说可能很难——例如,判断一张图片里有没有猫。
4 模式不同于分布。我们知道公平骰子结果的分布,但结果的产生方式没有模式。
5 Andrej Karpathy,《软件 2.0》,Medium,2017 年 11 月 11 日,https://oreil.ly/yHZrE。
图 1-2. 机器学习方案不需要手工指定计算输出的模式,而是从输入和输出中学习模式
3. 已有数据:数据可用,或者有可能收集到数据
因为机器学习从数据中学习,所以必须有可供学习的数据。想着构建一个模型来预测一个人一年该交多少税很有趣,但除非你能获得大量人口的税务和收入数据,否则这是不可能的。
在零样本学习(zero-shot learning,有时也叫零数据学习)的语境下,机器学习系统有可能在没有针对该任务的数据进行训练的情况下,就对某个任务做出很好的预测。不过,这个系统此前是使用其他任务的数据训练的,而这些任务通常与当前任务相关。所以,即使系统不需要当前任务的数据来学习,它仍然需要数据才能学习。
也有可能在没有数据的情况下启动一个机器学习系统。例如,在持续学习(continual learning)的语境下,机器学习模型可以在没有经过任何数据训练的情况下部署,但它们会在生产环境中从来袭数据中学习⁶。然而,向用户提供训练不足的模型是有一定风险的,比如糟糕的客户体验。
在没有数据、也没有持续学习的情况下,许多公司遵循"先假装、后成真”(fake-it-till-you-make-it)的做法:先推出一个由人类而非机器学习模型提供预测的产品,希望以后用生成的数据来训练机器学习模型。
6 我们将在第 9 章讨论在线学习(online learning)。
4. 预测:这是一个预测性问题
机器学习模型做的是预测,因此它们只能解决需要预测性答案的问题。当你能够从大量廉价但近似(approximate)的预测中获益时,机器学习会特别有吸引力。在英语中,“predict"意为"估计未来的某个值”。例如:明天天气会怎样?今年谁会赢得超级碗?用户接下来想看什么电影?
随着预测机器(如机器学习模型)越来越有效,越来越多的问题被重新框定为预测性问题。无论你遇到什么问题,你总是可以把它框定为:“这个问题的答案会是什么?"——不管这个问题关乎未来、现在还是过去。
计算密集型问题是被成功重新框定为预测问题的典型类别。与其计算一个过程的精确结果(这甚至可能比机器学习更耗费计算资源和时间),你可以把问题框定为:“这个过程的结果会是什么样?“然后用机器学习模型来近似。输出将是精确输出的近似值,但通常已经足够好了。这在图形渲染中很常见,如图像去噪(image denoising)和屏幕空间着色(screen-space shading)⁷。
5. 未见数据:未见数据与训练数据共享模式
你的模型从已有数据中学到的模式,只有在未见数据也共享这些模式时才有用。一个预测应用是否会在 2020 年圣诞节被下载的模型,如果它用的是 2008 年的数据训练——当时 App Store 上最流行的应用是 Koi Pond——表现就不会很好。Koi Pond 是什么?正是如此。
用术语来说,这意味着你的未见数据和训练数据应该来自相似的分布。你可能会问:“如果数据是未见的,我们怎么知道它来自什么分布?“我们不知道,但我们可以做假设——比如假设明天的用户行为和今天的用户行为不会差太多——并希望我们的假设成立。如果假设不成立,我们就会得到一个表现不佳的模型,而这可以通过第 8 章讨论的监控发现,并通过第 9 章讨论的生产测试来验证。
7 Steke Bako、Thijs Vogels、Brian McWilliams、Mark Meyer、Jan Novák、Alex Harvill、Pradeep Sen、Tony Derose 和 Fabrice Rousselle,《用于蒙特卡洛渲染去噪的核预测卷积网络》,ACM Transactions on Graphics 36 卷,第 4 期(2017):97,https://oreil.ly/EeI3j;Oliver Nalbach、Elena Arabadzhiyska、Dushyant Mehta、Hans-Peter Seidel 和 Tobias Ritschel,《深度着色:用于屏幕空间着色的卷积神经网络》,arXiv,2016,https://oreil.ly/dSspz。
由于当今大多数机器学习算法的学习方式,如果你的问题还具有以下额外特征,机器学习方案将尤其出彩:
- 重复性
人类非常擅长少样本学习(few-shot learning):你可以给孩子们看几张猫的图片,大多数孩子下次见到猫时就能认出来。尽管少样本学习研究取得了令人振奋的进展,大多数机器学习算法仍然需要大量示例才能学会一个模式。当一个任务是重复性的,每个模式都会重复出现多次,这让机器更容易学习。
- 错误预测的成本很低
除非你的机器学习模型的表现 100% 完美——对于任何有意义的任务来说这都极不可能——否则你的模型一定会犯错。当错误预测的成本很低时,机器学习尤其适用。例如,当今机器学习最大的用例之一就是推荐系统(recommender system),因为在推荐系统中,一个糟糕的推荐通常是可以被原谅的——用户只是不会点击这个推荐而已。
如果一次预测错误可能带来灾难性后果,机器学习仍然可能是合适的方案,前提是平均而言,正确预测的收益大于错误预测的成本。开发自动驾驶汽车极具挑战性,因为算法错误可能导致死亡。然而,许多公司仍然想开发自动驾驶汽车,因为一旦自动驾驶汽车在统计上比人类驾驶员更安全,它们就有潜力挽救许多生命。
- 规模化
机器学习方案通常需要在数据、算力、基础设施和人才上投入不菲的前期成本,所以如果我们能大量使用这些方案,才说得通。
“规模化"对不同任务意味着不同的东西,但总的来说,它意味着做出大量预测。例如,每年筛选数百万封邮件,或者预测每天数以千计的工单应该路由到哪个部门。
一个问题看起来可能只是一个单独的预测,但实际上它是一连串的预测。例如,预测谁将赢得美国总统大选的模型,看起来每四年才做一次预测,但它实际上可能每小时甚至更频繁地做预测,因为这个预测必须不断更新以纳入新信息。
问题达到规模化也意味着你有大量数据可以收集,这对训练机器学习模型很有用。
- 模式不断变化
文化在变。品味在变。技术在变。今天流行的事物明天可能就过时了。想想电子邮件垃圾邮件分类这个任务。今天垃圾邮件的标志是"尼日利亚王子”,明天可能就是一个悲痛欲绝的越南作家。
如果你的问题涉及一个或多个不断变化的模式,硬编码方案(如手工编写的规则)可能会迅速过时。弄清楚你的问题发生了怎样的变化,以便相应地更新手工规则,可能代价过高甚至根本不可能。因为机器学习从数据中学习,你可以用新数据更新机器学习模型,而无需弄清楚数据发生了什么变化。你还可以把系统设置成能适应不断变化的数据分布,这种方法我们将在第 264 页"持续学习"一节中讨论。
用例清单还可以继续列下去,而且随着机器学习在工业界的采用日趋成熟,它还会变得更长。尽管机器学习能很好地解决一部分问题,但它无法解决、也不应该用于很多问题。当今大多数机器学习算法在以下任何一种情况下都不应使用:
- 它不道德。我们将在第 341 页"案例研究一:自动评分器的偏见"一节中讨论一个可以被认为是机器学习算法不道德使用的案例。
- 更简单的方案就能解决问题。在第 6 章中,我们将介绍机器学习模型开发的四个阶段,其中第一阶段应该是非机器学习方案。
- 它不具成本效益。
然而,即使机器学习无法解决你的问题,也有可能把你的问题分解成更小的组成部分,用机器学习解决其中一部分。例如,如果你无法构建一个能回答所有客户问题的聊天机器人,也许可以构建一个机器学习模型来预测某个问题是否与某个常见问题(FAQ)匹配。如果匹配,就把客户引导到答案;如果不匹配,就把他们引导到客服。
我还想提醒一点:不要因为一项新技术目前不如现有技术有成本效益就否定它。大多数技术进步都是渐进的。一种技术现在可能效率不高,但随着更多投入,它可能会随着时间变得高效。如果你等到这项技术向业界其他公司证明了自己的价值再入局,你最终可能会落后竞争对手数年甚至数十年。
机器学习的用例
机器学习在企业应用和消费者应用中都得到了越来越多的使用。自 2010 年代中期以来,利用机器学习为消费者提供更优质或此前不可能实现的服务应用出现了爆炸式增长。
随着信息和服务的大爆炸,如果没有机器学习的帮助,我们很难找到想要的东西——无论是通过搜索引擎还是推荐系统。当你访问 Amazon 或 Netflix 这类网站时,你会看到被预测为最符合你口味的推荐商品。如果你不喜欢任何推荐,你可能会搜索特定商品,而你的搜索结果很可能由机器学习驱动。
如果你有智能手机,机器学习很可能已经在许多日常活动中帮助你了。在手机上打字因为有预测输入(predictive typing)而变得更容易,这是一个能给你接下来想说什么建议的机器学习系统。你的照片编辑应用里可能运行着一个机器学习系统,建议如何最好地美化你的照片。你可能用指纹或人脸解锁手机,这需要一个机器学习系统来预测指纹或人脸是否与你匹配。
把我吸引进这个领域的机器学习用例是机器翻译(machine translation)——自动从一种语言翻译成另一种语言。它有可能让不同文化背景的人互相交流,消除语言障碍。我的父母不会说英语,但多亏了谷歌翻译,现在他们能读我写的东西,也能和我那些不会说越南语的朋友交谈。
机器学习正越来越多地进入我们的家庭,比如 Alexa 和 Google Assistant 这样的智能个人助理。智能安防摄像头可以让你知道你的宠物什么时候离开了家,或者家里有没有不速之客。我有一个朋友担心他年迈的母亲独自生活——如果她摔倒了,没人扶她起来——所以他依赖一套家庭健康监测系统,这套系统可以预测家里是否有人摔倒。
尽管面向消费者的机器学习应用市场正在蓬勃发展,但大多数机器学习用例仍然在企业世界。企业机器学习应用的需求和考量往往与消费者应用截然不同。虽然有很多例外,但在大多数情况下,企业应用可能对准确性的要求更严格,而对延迟的要求更宽容。例如,把语音识别系统的准确率从 95% 提高到 95.5%,大多数消费者可能注意不到,但把资源分配系统的效率提高仅仅 0.1%,就能帮助谷歌或通用汽车这样的公司节省数百万美元。与此同时,一秒钟的延迟可能会让消费者分心、去打开别的东西,但企业用户可能对高延迟更宽容。对于想用机器学习应用创业的人来说,消费者应用可能更容易分发,但变现要难得多。然而,大多数企业用例并不显眼,除非你自己亲身遇到过。
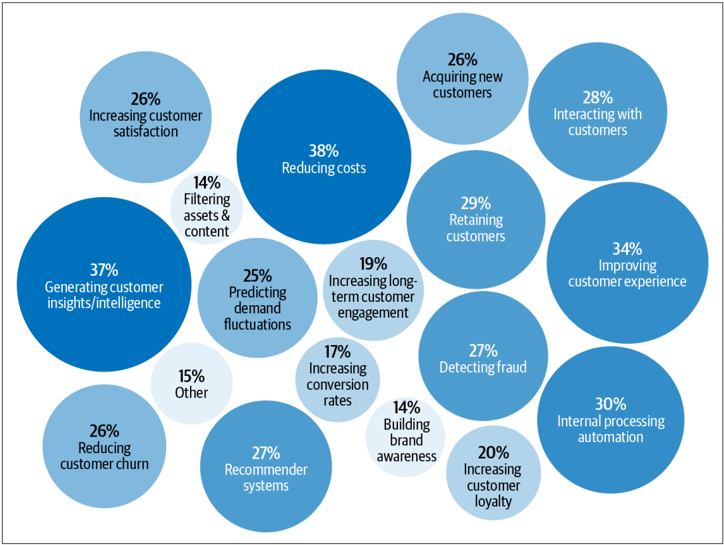
根据 Algorithmia 的《2020 年企业机器学习现状》调查,企业中的机器学习应用多种多样,既服务于内部用例(降低成本、生成客户洞察与情报、内部流程自动化),也服务于外部用例(改善客户体验、留住客户、与客户互动),如图 1-3 所示⁸。
图 1-3. 2020 年企业机器学习现状。来源:改编自 Algorithmia 的图片
8 《2020 年企业机器学习现状》,Algorithmia,2020,https://oreil.ly/wKMZB。
欺诈检测(fraud detection)是企业界最早应用机器学习的场景之一。如果你的产品或服务涉及任何有价值的交易,就容易遭受欺诈。通过利用机器学习方案进行异常检测(anomaly detection),你可以让系统从历史欺诈交易中学习,预测未来的交易是否具有欺诈性。
决定为你的产品或服务收取多少费用,可能是最难做的商业决策之一;为什么不交给机器学习来做呢?价格优化(price optimization)就是在特定时间段内估计一个价格,以最大化某个定义的目标函数,例如公司的利润率、收入或增长率。基于机器学习的定价优化最适合交易量大、需求波动、消费者愿意接受动态价格的情况——例如互联网广告、机票、住宿预订、拼车和活动票务。
要经营好一门生意,能够预测客户需求非常重要,这样你才能编制预算、备货、分配资源、更新定价策略。例如,如果你经营一家杂货店,你想备足货,让顾客能找到他们想要的东西,但你也不想库存过多,因为如果囤多了,杂货可能会变质,你就会亏钱。
获取一个新用户成本高昂。截至 2019 年,一个应用获取一名会进行应用内购买的用户,平均成本为 86.61 美元⁹。Lyft 的获客成本估计为每名乘客 158 美元¹⁰。对企业客户来说,这个成本还要高得多。客户获取成本被投资者称为"创业公司杀手"¹¹。把客户获取成本降低一点点,就能带来利润的大幅增长。这可以通过更好地识别潜在客户、投放更有针对性的广告、在正确的时间发放折扣等方式实现——所有这些都适合用机器学习来做。
你花了这么多钱获取一个客户,如果他们走了就太可惜了。获取一个新用户的成本大约是留住一个现有用户的 5 到 25 倍¹²。流失预测(churn prediction)就是预测某个特定客户何时将要停止使用你的产品或服务,以便你采取适当的行动挽回他们。流失预测不仅可用于客户,也可用于员工。
9 《2018 年 9 月至 2019 年 8 月全球移动应用用户获取平均成本,按用户行为和操作系统划分》,Statista,2019,https://oreil.ly/2pTCH。
10 Jeff Henriksen,《对 Lyft 估值需要深入审视单位经济学》,Forbes,2019 年 5 月 17 日,https://oreil.ly/VeSt4。
11 David Skok,《创业公司杀手:客户获取成本》,For Entrepreneurs,2018,https://oreil.ly/L3tQ7。
12 Amy Gallo,《留住正确客户的价值》,Harvard Business Review,2014 年 10 月 29 日,https://oreil.ly/OlNkl。
为了防止客户流失,重要的是及时解决他们的疑虑,让他们保持满意。自动化工单分类(automated support ticket classification)可以帮忙。以前,客户提交一张支持工单或发一封邮件后,工单需要先经过处理,然后被转来转去,直到到达某个能处理它的人的收件箱。机器学习系统可以分析工单内容,预测它应该转到哪里,从而缩短响应时间、提升客户满意度。它也可以用来对内部 IT 工单进行分类。
企业界另一个流行的机器学习用例是品牌监测(brand monitoring)。品牌是企业的宝贵资产¹³。监测公众和客户如何看待你的品牌很重要。你可能想知道它在何时、何地、以何种方式被提及——无论是显式的(例如有人说"谷歌”)还是隐式的(例如有人说"那个搜索引擎巨头”)——以及与之相关的情感倾向。如果你的品牌提及中突然出现负面情绪的激增,你可能想尽快处理。情感分析(sentiment analysis)是一个典型的机器学习任务。
最近让许多人兴奋的一组机器学习用例出现在医疗保健领域。有机器学习系统可以检测皮肤癌、诊断糖尿病。尽管许多医疗保健应用面向消费者,但由于它们对准确性和隐私的严格要求,它们通常通过医院这样的医疗服务提供方提供,或者用来辅助医生进行诊断。
理解机器学习系统
理解机器学习系统将有助于设计和开发它们。在本节中,我们将介绍机器学习系统与研究中(或学校里常教的)机器学习的差异,以及与传统软件的差异,这正是本书的写作动机。
研究中的机器学习与生产中的机器学习
由于机器学习在工业界的使用仍然相当新,大多数具备机器学习专长的人都是通过学术界获得的:上课、做研究、读学术论文。如果你的背景正是如此,那么要理解在生产环境中部署机器学习系统的挑战、并在令人眼花缭乱的解决方案中找到方向,对你来说可能是一条陡峭的学习曲线。生产中的机器学习与研究中的机器学习非常不同。表 1-1 列出了五个主要差异。
13 Marty Swant,《全球最有价值的 20 个品牌》,Forbes,2020,https://oreil.ly/4uS5i。
表 1-1. 研究中的机器学习与生产中的机器学习的主要差异
| 研究 | 生产 | |
|---|---|---|
| 需求 | 在基准数据集上取得最先进的(state-of-the-art)模型性能 | 不同利益相关者有不同需求 |
| 计算优先级 | 快速训练,高吞吐量 | 快速推理,低延迟 |
| 数据 | 静态ᵃ | 不断变化 |
| 公平性 | 通常不是重点 | 必须考虑 |
| 可解释性 | 通常不是重点 | 必须考虑 |
ᵃ 研究的一个子领域专注于持续学习:开发能适应不断变化的数据分布的模型。我们将在第 9 章介绍持续学习。
不同的利益相关者与需求
参与研究和排行榜(leaderboard)项目的人往往在单一目标上保持一致。最常见的目标就是模型性能——开发一个在基准数据集上取得最先进结果的模型。为了在性能上挤出一小点提升,研究人员经常采用一些让模型过于复杂而无法实用的技术。
把一个机器学习系统带入生产环境会涉及许多利益相关者。每个利益相关者都有自己的需求。不同、且往往相互冲突的需求,会让设计、开发和选择一个满足所有需求的机器学习模型变得困难。
设想一个向用户推荐餐厅的手机应用。这个应用通过向餐厅收取每笔订单 10% 的服务费来赚钱。这意味着高额订单比廉价订单给应用带来更多收入。这个项目涉及机器学习工程师、销售人员、产品经理、基础设施工程师和一位经理:
机器学习工程师
想要一个推荐用户最可能下单餐厅的模型,他们认为可以用更复杂的模型和更多的数据来实现这一点。
销售团队
想要一个推荐更贵餐厅的模型,因为这些餐厅带来更多的服务费。
产品团队
注意到延迟每增加一点,通过该服务下的订单就会减少,所以他们想要一个能在 100 毫秒内返回推荐餐厅的模型。
机器学习平台团队
随着流量增长,这个团队经常在半夜被叫醒,因为现有系统扩展出了问题,所以他们想暂缓模型更新,优先改进机器学习平台。
经理
想要最大化利润率,实现这一目标的方法之一可能是裁掉机器学习团队¹⁴。
“推荐用户最可能点击的餐厅"和"推荐能为应用带来最多收入的餐厅"是两个不同的目标,我们将在第 41 页"目标解耦"一节讨论如何开发满足不同目标的机器学习系统。剧透:我们将为每个目标开发一个模型,然后合并它们的预测。
现在让我们设想有两个不同的模型。模型 A 是推荐用户最可能点击餐厅的模型,模型 B 是推荐能为应用带来最多收入的餐厅的模型。A 和 B 可能是非常不同的模型。应该把哪个模型部署给用户?让这个决定更困难的是,A 和 B 都不满足产品团队提出的要求:它们都无法在 100 毫秒内返回餐厅推荐。
在开发机器学习项目时,机器学习工程师理解所有相关利益相关者的需求、以及这些需求的严格程度是很重要的。例如,如果 100 毫秒内返回推荐是必须满足的需求——公司发现,如果模型推荐餐厅耗时超过 100 毫秒,10% 的用户会失去耐心关掉应用——那么模型 A 和模型 B 都不行。但如果这只是一个锦上添花的需求,你也许仍然可以考虑模型 A 或模型 B。
生产环境的需求与研究不同,这也是成功的研究项目不一定会在生产中应用的原因之一。例如,集成(ensembling)是一种在许多机器学习竞赛获胜者中很流行的技术,包括著名的 100 万美元 Netflix 大奖,但它并没有在生产中被广泛使用。集成把"多种学习算法组合起来,以获得比任何单一组成学习算法单独所能获得的更好的预测性能"¹⁵。虽然它能让你的机器学习系统获得一小点性能提升,但集成往往会让系统过于复杂而无法在生产中实用,例如预测更慢或结果更难解释。我们将在第 156 页"集成"一节进一步讨论集成。
14 在公司的集体裁员中,机器学习团队和数据科学团队往往是最先被裁掉的之一,这并不罕见,IBM、Uber、Airbnb 都有相关报道。另见 Sejuti Das 的分析《危机之下,数据科学家同样容易受到裁员影响》,Analytics India Magazine,2020 年 5 月 21 日,https://oreil.ly/jobmz。
15 维基百科,“集成学习"词条,https://oreil.ly/5qkgp。
对于许多任务来说,性能的小幅提升就能带来收入的大幅增长或成本的大幅节约。例如,产品推荐系统的点击率(click-through rate)提高 0.2%,就能为电商网站带来数百万美元的收入增长。然而,对许多任务来说,小幅提升用户可能注意不到。对于第二类任务,如果简单模型就能做得不错,那么复杂模型必须表现显著更好,才能为自身的复杂性正名。
对机器学习排行榜的批评
近年来,对机器学习排行榜的批评很多,无论是 Kaggle 这类竞赛,还是 ImageNet 或 GLUE 这类研究排行榜。
一个显而易见的论点是,在这些竞赛中,构建机器学习系统所需的许多艰难步骤都已经替你完成了¹⁶。
一个不那么明显的论点是,由于多重假设检验(multiple-hypothesis testing)场景的存在——多个团队在同一个留出(hold-out)测试集上测试——一个模型可能仅仅靠运气就比其他模型表现更好¹⁷。
研究与生产之间的利益错位已经被研究人员注意到了。在 EMNLP 2020 的一篇论文中,Ethayarajh 和 Jurafsky 认为,基准(benchmark)通过激励人们创建更准确的模型推动了自然语言处理(natural language processing,NLP)的进步,但代价是牺牲了实践者看重的其他品质,如紧凑性、公平性和能源效率¹⁸。
计算优先级
在设计机器学习系统时,没有部署过机器学习系统的人常常犯一个错误:过于关注模型开发部分,而对模型部署和维护部分关注不足。
在模型开发过程中,你可能会训练许多不同的模型,每个模型都会对训练数据做多次遍历。每个训练好的模型随后会对验证数据生成一次预测,以报告分数。验证数据通常比训练数据小得多。在模型开发期间,训练是瓶颈。然而,一旦模型部署上线,它的工作就是生成预测,因此推理(inference)是瓶颈。研究通常优先考虑快速训练,而生产通常优先考虑快速推理。
16 Julia Evans,《机器学习不是 Kaggle 竞赛》,2014,https://oreil.ly/p8mZq。
17 Lauren Oakden-Rayner,《人工智能竞赛并不能产出有用的模型》,2019 年 9 月 19 日,https://oreil.ly/X6RlT。
18 Kawin Ethayarajh 和 Dan Jurafsky,《效用取决于用户:对 NLP 排行榜的批判》,EMNLP,2020,https://oreil.ly/4Ud8P。
这带来的一个推论是:研究优先考虑高吞吐量(throughput),而生产优先考虑低延迟(latency)。如果你需要复习一下:延迟指的是从收到查询到返回结果所花的时间。吞吐量指的是一段特定时间内处理了多少个查询。
术语冲突
有些书区分了延迟和响应时间(response time)。按照 Martin Kleppmann 在《设计数据密集型应用》(Designing Data-Intensive Applications)一书中的说法:“响应时间是客户端看到的东西:除了处理请求的实际时间(服务时间)之外,它还包括网络延迟和排队延迟。延迟是请求等待被处理的时间——在这段时间里请求处于潜伏(latent)状态,等待服务。“¹⁹
在本书中,为了简化讨论并与机器学习社区使用的术语保持一致,我们用延迟指代响应时间,因此一个请求的延迟衡量的是从请求发出到收到响应所经过的时间。
例如,谷歌翻译的平均延迟就是用户点击"翻译"到译文显示出来所用的平均时间,吞吐量则是它每秒处理和服务的查询数量。
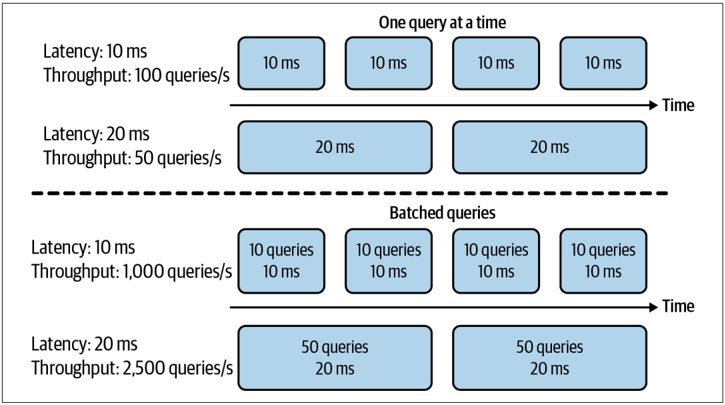
如果你的系统总是逐个处理查询,更高的延迟就意味着更低的吞吐量。如果平均延迟是 10 毫秒,意味着处理一个查询需要 10 毫秒,那么吞吐量就是每秒 100 个查询。如果平均延迟是 100 毫秒,吞吐量就是每秒 10 个查询。
然而,由于大多数现代分布式系统会把查询分批(batch)在一起处理,而且往往并发处理,更高的延迟也可能意味着更高的吞吐量。如果你一次处理 10 个查询,运行一个批次需要 10 毫秒,那么平均延迟仍然是 10 毫秒,但吞吐量现在是原来的 10 倍——每秒 1,000 个查询。如果你一次处理 50 个查询,运行一个批次需要 20 毫秒,那么现在的平均延迟是 20 毫秒,吞吐量是每秒 2,500 个查询。延迟和吞吐量都提高了!逐个处理查询与批量处理查询在延迟—吞吐量权衡上的差异如图 1-4 所示。
19 Martin Kleppmann,《设计数据密集型应用》(Sebastopol, CA: O’Reilly,2017)。
图 1-4. 逐个处理查询时,更高的延迟意味着更低的吞吐量。然而,批量处理查询时,更高的延迟也可能意味着更高的吞吐量。
如果你还想对在线查询做批处理,情况就更复杂了。批处理要求系统等待足够多的查询凑成一个批次再处理,这会进一步增加延迟。
在研究中,你更关心每秒能处理多少个样本(吞吐量),而不太关心每个样本处理需要多长时间(延迟)。你愿意为了提高吞吐量而增加延迟,例如采用激进的批处理。
然而,一旦你把模型部署到现实世界,延迟就非常重要了。2017 年,Akamai 的一项研究发现,100 毫秒的延迟会使转化率(conversion rate)下降 7%²⁰。2019 年,Booking.com 发现,延迟增加约 30% 会损失约 0.5% 的转化率——“对我们的业务来说这是一笔可观的成本"²¹。2016 年,谷歌发现,超过一半的移动用户会在页面加载超过三秒时离开²²。如今的用户更加没有耐心。
20 Akamai Technologies,《Akamai 在线零售性能报告:毫秒至关重要》,2017 年 4 月 19 日,https://oreil.ly/bEtRu。
21 Lucas Bernardi、Themis Mavridis 和 Pablo Estevez,《150 个成功的机器学习模型:Booking.com 学到的 6 个经验》,KDD ‘19,2019 年 8 月 4-8 日,阿拉斯加州安克雷奇,https://oreil.ly/G5QNA。
22 《消费者洞察》,Think with Google,https://oreil.ly/JCp6Z。
为了降低生产中的延迟,你可能不得不减少同一硬件上一次能处理的查询数量。如果你的硬件能够同时处理多得多的查询,却用它处理更少的查询,就意味着硬件利用率不足,提高了处理每个查询的成本。
在思考延迟时,要记住延迟不是一个单独的数字,而是一个分布。用平均值(算术平均)这样的单一数字来简化这个分布很有诱惑力,但这个数字可能具有误导性。设想你有 10 个请求,延迟分别是 100 毫秒、102 毫秒、100 毫秒、100 毫秒、99 毫秒、104 毫秒、110 毫秒、90 毫秒、3,000 毫秒、95 毫秒。平均延迟是 390 毫秒,这让你的系统看起来比实际更慢。实际情况可能是,一次网络错误让一个请求比其他请求慢得多,你应该调查那个有问题的请求。
通常最好用百分位数(percentile)来思考,因为它们能告诉你一定比例的请求的情况。最常见的百分位数是第 50 百分位,缩写为 p50,也就是中位数。如果中位数是 100 毫秒,那么一半的请求耗时超过 100 毫秒,一半的请求耗时不到 100 毫秒。
更高的百分位数还能帮你发现异常值(outlier),它们可能是出问题的征兆。通常你会关注 p90、p95 和 p99。上面那 10 个请求的第 90 百分位(p90)是 3,000 毫秒,这是一个异常值。
更高的百分位数值得关注,因为尽管它们只占用户的一小部分,但有时他们可能是最重要的用户。例如,在 Amazon 网站上,请求最慢的客户往往是账户数据最多的人,因为他们买了很多东西——也就是说,他们是最有价值的客户²³。
用高百分位数来规定系统的性能需求是常见做法;例如,产品经理可能会规定系统的第 90 百分位或第 99.9 百分位延迟必须低于某个数值。
数据
在研究阶段,你处理的数据集往往是干净且格式良好的,让你可以专注于开发模型。它们本质上是静态的,这样社区才能用它们来基准测试新的架构和技术。这意味着很多人可能已经使用和讨论过相同的数据集,数据集的怪癖也为人所知。你甚至可能找到开源脚本来处理数据并直接输入你的模型。
在生产中,数据(如果有的话)要杂乱得多。它有噪声,可能非结构化,不断变化。它很可能有偏差,而且你很可能不知道偏差在哪里。标签(如果有的话)可能稀疏、不平衡或错误。项目或业务需求的变化可能需要更新你现有标签的一部分或全部。如果你处理用户数据,你还得担心隐私和监管问题。我们将在第 344 页"案例研究二:“匿名"数据的危险"一节讨论一个用户数据被不当处理的案例。
在研究中,你主要处理历史数据,例如已经存在并存储在某处的数据。在生产中,你很可能还必须处理由用户、系统和第三方数据不断生成的数据。
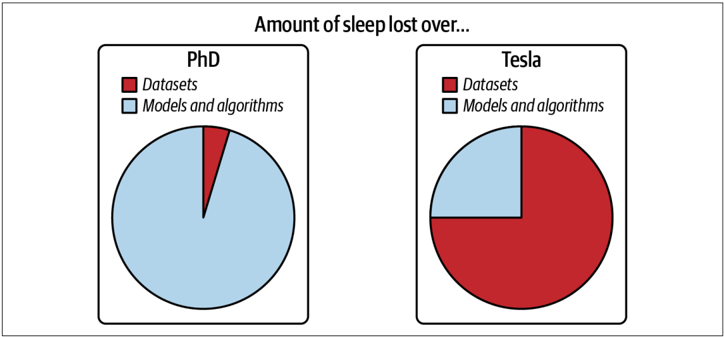
图 1-5 改编自特斯拉 AI 总监 Andrej Karpathy 的一幅精彩图表,它展示了他在攻读博士期间遇到的数据问题与他在特斯拉期间遇到的问题的对比。
图 1-5. 研究中的数据与生产中的数据。来源:改编自 Andrej Karpathy 的图片²⁴
公平性
在研究阶段,模型还没有用到人身上,所以研究人员很容易把公平性(fairness)当作事后才考虑的事:“我们先做到最先进,等到了生产阶段再操心公平性。“等到了生产阶段,就太晚了。如果你优化模型的准确率或降低延迟,你可以证明你的模型击败了最先进水平。但截至本书写作时,公平性指标还没有与之相当的最先进水平。
24 Andrej Karpathy,《构建软件 2.0 技术栈》,Spark+AI Summit 2018,视频,17:54,https://oreil.ly/Z21Oz。
你或你身边的某个人,可能已经在不知情的情况下成为有偏见的数学算法的受害者。你的贷款申请可能被拒绝,因为机器学习算法盯上了你的邮政编码,而邮政编码承载着关于一个人社会经济背景的偏见。你的简历可能被排名靠后,因为雇主使用的排名系统盯上了你名字的拼写。你的抵押贷款利率可能更高,因为它部分依赖信用评分,而信用评分偏袒富人、惩罚穷人。现实世界中机器学习偏见的其他例子还有预测性警务算法、潜在雇主进行的性格测试,以及大学排名。
2019 年,“伯克利的研究人员发现,2008 年至 2015 年间,面对面和在线贷款机构共拒绝了 130 万名有信用的黑人和拉丁裔申请人”。当研究人员"使用被拒申请的收入和信用评分、但删除种族标识后,抵押贷款申请被批准了"²⁵。想看更令人愤慨的例子,我推荐 Cathy O’Neil 的《数学杀伤性武器》(Weapons of Math Destruction)²⁶。
机器学习算法预测的不是未来,而是编码了过去,从而延续了数据中的偏见,甚至更多。当机器学习算法大规模部署时,它们就能大规模地歧视人。人类操作员一次可能只对少数几个人做出武断的判断,而机器学习算法可以在瞬间对数以百万计的人做出武断的判断。这对少数群体的成员伤害尤其大,因为对他们的错误分类可能只会对模型的整体性能指标产生微小影响。
如果一个算法已经能对 98% 的人口做出正确预测,而改进另外 2% 的预测需要付出数倍的成本,有些公司可能不幸地选择不去做。在 2019 年 McKinsey & Company 的一项研究中,受访的大型公司中只有 13% 表示正在采取措施降低公平公正方面的风险,例如算法偏见和歧视²⁷。不过,这种情况正在迅速改变。我们将在第 11 章讨论公平性和负责任 AI 的其他方面。
25 Khristopher J. Brooks,《研究人员发现,住房贷款差异让少数族裔损失数百万》,CBS News,2019 年 11 月 15 日,https://oreil.ly/UiHUB。
26 Cathy O’Neil,《数学杀伤性武器》(纽约:Crown Books,2016)。
27 斯坦福大学以人为本人工智能研究院(HAI),《2019 年 AI 指数报告》,2019,https://oreil.ly/xs8mG。
可解释性
2020 年初,图灵奖得主 Geoffrey Hinton 教授提出了一个引发激烈争论的问题,关于可解释性(interpretability)在机器学习系统中的重要性。“假设你得了癌症,你不得不在两个外科医生之间选择:一个无法解释自己如何工作、但治愈率 90% 的黑箱 AI 外科医生,和一个治愈率 80% 的人类外科医生。你希望 AI 外科医生被定为非法吗?“²⁸
几周后,当我向一组 30 位非科技上市公司的高管问这个问题时,只有一半人希望这个高效但无法解释的 AI 外科医生给自己动手术。另一半人想要人类外科医生。
虽然我们大多数人都能安然使用微波炉而不需要理解它的工作原理,但许多人还没有对 AI 抱有同样的感觉,尤其是当这个 AI 会对他们的生活做出重要决定时。
由于大多数机器学习研究仍然以单一目标——模型性能——来评估,研究人员没有动力去研究模型的可解释性。然而,对工业界的大多数机器学习用例来说,可解释性不只是可选的,而是一项要求。
首先,可解释性对用户很重要——无论是商业领袖还是终端用户——他们要理解为什么做出某个决定,从而信任模型,并发现前面提到的潜在偏见²⁹。其次,对开发人员来说,能够调试和改进模型也很重要。
可解释性是一项要求,并不代表每个人都在做。截至 2019 年,只有 19% 的大型公司正在努力改进其算法的可解释性³⁰。
讨论
有些人可能会说,只了解机器学习的学术一面也没关系,因为研究领域有大量的工作机会。第一部分——只了解机器学习的学术一面没关系——是对的。第二部分是错的。
虽然追求纯粹的研究很重要,但大多数公司负担不起,除非它能带来短期业务应用。在研究界采取"越大越好”(bigger, better)路线的当下尤其如此。新模型往往需要海量数据,仅算力一项就要数千万美元。
随着机器学习研究和开箱即用的模型变得越来越容易获得,越来越多的人和组织会想为它们寻找应用场景,这增加了对生产环境机器学习的需求。
绝大多数与机器学习相关的工作将——而且已经是——在生产化机器学习。
28 Geoffrey Hinton(@geoffreyhinton)的推文,2020 年 2 月 20 日,https://oreil.ly/KdfD8。
29 在有些国家的某些用例中,用户拥有"解释权”(right to explanation):即有权获得算法输出的解释。
30 斯坦福 HAI,《2019 年 AI 指数报告》。
机器学习系统与传统软件
既然机器学习是软件工程(software engineering,SWE)的一部分,而软件在生产环境中成功使用已经超过半个世纪,有些人可能会想:为什么不直接采用软件工程中久经考验的最佳实践,把它们应用到机器学习上呢?
这是个绝妙的主意。事实上,如果机器学习专家是更好的软件工程师,机器学习生产环境会好得多。许多传统软件工程工具可以用来开发和部署机器学习应用。
然而,许多挑战是机器学习应用独有的,需要它们自己的工具。在软件工程中,有一个基本假设:代码和数据是分离的。事实上,在软件工程中,我们希望尽可能地保持模块化和分离(参见维基百科上关于关注点分离的词条)。
恰恰相反,机器学习系统一部分是代码,一部分是数据,还有一部分是由这两者创造出来的产物。过去十年的趋势表明,拥有最多/最好数据的应用获胜。大多数公司不会专注于改进机器学习算法,而是专注于改进他们的数据。因为数据可能快速变化,机器学习应用需要适应不断变化的环境,这可能需要更快的开发和部署周期。
在传统软件工程中,你只需要专注于测试代码和给代码做版本管理。在机器学习中,我们还得测试数据、给数据做版本管理,而这是最难的部分。如何给大型数据集做版本管理?如何判断一个数据样本对你的系统是好是坏?并非所有数据样本都是平等的——有些样本对你的模型比其他的更有价值。例如,如果你的模型已经在一百万张正常肺部扫描图上训练过,而癌变肺部扫描图只有一千张,那么一张癌变肺部扫描图的价值远高于一张正常肺部扫描图。不加区分地接受所有可用数据可能会损害模型的性能,甚至使其容易受到数据投毒攻击(data poisoning attack)³¹。
机器学习模型的规模是另一个挑战。截至 2022 年,机器学习模型拥有数亿甚至数十亿参数已属常见,这需要数 GB 的随机存取存储器(random-access memory,RAM)才能把它们加载进内存。几年后,十亿参数可能看起来都显得古朴——就像"你能相信把人类送上月球的电脑只有 32 MB 内存吗?”
然而,就目前而言,把这些大型模型带入生产环境——尤其是在边缘设备(edge device)³²上——是一项巨大的工程挑战。然后还有如何让这些模型跑得足够快、快得有用的问题。如果一个自动补全模型建议下一个字符所需的时间比你自己打字的时间还长,那它就毫无用处。
31 Xinyun Chen、Chang Liu、Bo Li、Kimberly Lu 和 Dawn Song,《利用数据投毒对深度学习系统进行定向后门攻击》,arXiv,2017 年 12 月 15 日,https://oreil.ly/OkAjb。
32 我们将在第 7 章介绍边缘设备。
在生产中监控和调试这些模型也绝非易事。随着机器学习模型变得越来越复杂,再加上对其内部工作缺乏可见性,很难弄清楚哪里出了问题,也很难在出问题时及时收到警报。
好消息是,这些工程挑战正以惊人的速度被攻克。早在 2018 年,当 BERT(Bidirectional Encoder Representations from Transformers,来自 Transformers 的双向编码器表示)论文刚发表时,人们还在说 BERT 太大、太复杂、太慢,无法实用。这个预训练的大型 BERT 模型有 3.4 亿个参数,大小为 1.35 GB³³。两年后,BERT 及其变体已经被用于谷歌上几乎每一次英语搜索³⁴。
小结
这一开篇章节旨在让读者理解把机器学习带入现实世界需要什么。我们从回顾当今生产环境中机器学习用例的广泛范围开始。虽然大多数人对面向消费者的机器学习应用很熟悉,但大多数机器学习用例其实是为企业服务的。我们还讨论了什么时候适合采用机器学习方案。尽管机器学习能很好地解决许多问题,但它不能解决所有问题,也肯定不是所有问题都适合用机器学习。然而,对于机器学习无法解决的问题,机器学习有可能成为解决方案的一部分。
本章还强调了研究中的机器学习与生产中的机器学习的差异。这些差异包括利益相关者的参与、计算优先级、所用数据的性质、公平性问题的严重程度,以及对可解释性的要求。这一节对从学术界进入机器学习生产领域的人最有帮助。我们还讨论了机器学习系统与传统软件系统的不同之处,这正是本书的写作动机。
机器学习系统是复杂的,由许多不同的组件组成。在生产环境中与机器学习系统打交道的数据科学家和机器学习工程师很可能会发现,只关注机器学习算法部分远远不够。了解系统的其他方面很重要,包括数据栈、部署、监控、维护、基础设施等。本书以系统化的方法开发机器学习系统,这意味着我们将从整体上考虑系统的所有组件,而不仅仅是机器学习算法。我们将在下一章详细说明这种整体性方法意味着什么。
33 Jacob Devlin、Ming-Wei Chang、Kenton Lee 和 Kristina Toutanova,《BERT:用于语言理解的深度双向 Transformer 预训练》,arXiv,2018 年 10 月 11 日,https://oreil.ly/TG3ZW。
34 Google Search On,2020,https://oreil.ly/M7YjM。