TikTok 的个性化推荐系统:世界上最有价值的 AI 系统
本章以案例研究的形式把我们迄今学到的知识汇集在一起。你将设计、构建并部署一个大规模运行、实时的个性化视频推荐系统。它的灵感来自 TikTok 的推荐系统——正是这个 AI 系统让 TikTok 通过实时 AI 创新把 YouTube 拉下了王座。我们将使用面向实时个性化 AI 系统的检索-排序架构(retrieval-and-ranking architecture)来构建我们的推荐系统。我们还将扩展视频推荐系统,加入用自然语言进行视频智能体搜索(agentic search)的功能。最后,我们将以 MLOps 的"十二大谬误"(dirty dozen of fallacies)来结束本书——希望你在读完本书后不再犯这些错误——并附上一些关于你作为 AI 系统构建者所肩负的伦理责任的建议。感谢你坚持读到这里,让我们开始动手做与 AI 打交道最有成就感的部分——构建能够让世界变得更好的真实 AI 系统。
推荐系统简介
推荐系统(recommender system)帮助用户在面向用户的系统中发现相关内容。内容可以是任何东西,从视频到音乐,从电子商务到社交媒体帖子。最早的推荐系统方法并不是个性化的。基于内容的推荐系统(content-based recommendation system)可以利用类型、导演、演员或情节关键词来推荐与用户此前观看并喜欢的视频相似的视频。训练基于内容的推荐模型只需要内容使用特征(content usage feature),因此它们很容易扩展。Netflix 和 YouTube 至今仍把基于内容的推荐作为它们提供的多种推荐类型之一。
下一类推荐系统建立在交互数据集(interaction dataset)之上,其中包含用户对内容的操作事件,例如观看、点赞和分享。物品到物品(item-to-item,i2i)推荐关注物品本身之间的关系,从而支持"购买了该商品的顾客还购买了……“或"如果你喜欢这个视频,你可能会喜欢……“之类的功能。交互数据集提供了共同消费的模式或相似性,i2i 方法让用户可以轻松探索相关选项。
用户到物品(user-to-item,u2i)推荐则采取不同的方法,把推荐的中心放在单个用户身上。这里的目标是根据用户的历史偏好和行为,或借鉴相似用户的经验,向用户推荐物品。i2i 和 u2i 推荐系统第一种被广泛使用的方法是协同过滤(collaborative filtering),但它在处理海量数据和稀疏数据(即大多数用户只与极小一部分物品互动)时面临挑战。因子分解机(factorization machine)被引入以更好地处理数据稀疏性,但在大数据量和实时更新方面也存在可扩展性问题。
在下一节中,我们将研究解决这些挑战的最先进的检索-排序架构,但我们将从查看构建推荐系统所需收集的数据开始。表 15-1 展示了用于训练视频推荐模型的常用特征。
| 分组 | 特征 | 变换 | 数据量/更新速度 |
|---|---|---|---|
| 用户画像 | 性别、年龄、语言、设备、兴趣、位置、最近观看 | 与模型无关、与模型相关 | GB/TB 级,批处理和流式 |
| 视频 | 标题、类型、时长、年龄、点击量、CTR、点赞、描述、内容 | 与模型无关、与模型相关 | GB/TB 级,批处理和流式 |
| 交互 | 观看、跳过、点赞、分享、观看时长 | 与模型无关、与模型相关 | TB/PB 级,批处理和流式 |
| 实时上下文 | 热门(附近的人、你的同类型人群、好友) | 与模型无关、按需 | GB/TB 级,流式 |
| 会话内浏览 | 设备、使用模式(连续刷视频等)、最后一次点击、会话时长 | 按需 | GB/TB 级,实时处理 |
| 图/社交 | 社交行为(如好友点赞)、社交亲密度 | 与模型相关、按需 | GB/TB 级,批处理和流式 |
总体而言,对构建推荐模型有用的特征围绕用户、物品(在我们的案例中是视频)以及用户与物品之间的交互展开。其中一些特征包含变化缓慢的数据,存储在数据仓库中,由批处理特征管道更新;例如,关于用户观看行为的信息,如视频的平均观看百分比,以及按视频类型压缩的观看统计。
另一些特征则包含关于全球或局部观看趋势的实时上下文信息。例如,为了让推荐系统快速传播突发新闻,点击量和点击率(click-through rate,CTR)都是视频的重要实时上下文特征,它们由流式特征管道更新。对于传播突发新闻来说,批处理特征管道太慢了。
会话内浏览特征同样包含关于用户近期活动的宝贵实时信号,但它们是根据请求时参数按需计算的。例如,如果用户开始观看关于烹饪的视频,但随后转向了体育,推荐系统可以推荐用户历史上互动过的体育内容,以及与该用户历史上观看过的其他视频时长相同的视频。
基于检索-排序架构的 TikTok 推荐系统
TikTok 是 2025 年全球最受欢迎的视频流平台。它有几种不同的视频推荐方式,包括好友信息流和关注信息流。但正是它的"为你推荐”(For You)信息流让 TikTok 与其他视频流平台区分开来。它确实是为你个性化的,并且会根据你的活动实时更新推荐。要让用户感知到信息流对他们的行为做出了反应,更新就不能超过几秒钟;否则它就会显得"卡顿”(laggy),而不是智能。
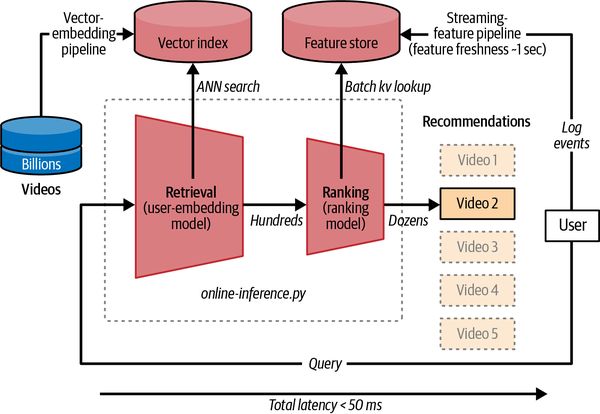
我们将基于图 15-1 所示的检索-排序架构,构建我们自己的个性化"为你推荐"信息流版本。我们将推荐视频的问题分解为两个阶段:(1)检索阶段,使用可扩展的向量索引返回几百个候选视频;(2)排序阶段,根据我们要优化的指标(如提高用户互动)对几百个候选视频进行排序。
图示:说明 TikTok 的个性化推荐系统,它使用检索-排序架构高效处理并对数十亿个视频进行排序,为用户生成个性化推荐。
构建大规模个性化推荐系统所面临的关键系统挑战(其中一些在 TikTok 的 Monolith 研究论文中有介绍)如下:
- 非平稳性挑战
- 用户偏好和热门视频不断变化,导致特征在几秒钟内就会过期,需要持续重训模型。当环境是动态的时,你的系统需要不断适应。在短时间尺度上,这意味着要有新鲜的预计算特征(流处理)和从请求参数实时计算的特征。在较长时间尺度上,这意味着要频繁重训模型以防止概念漂移(concept drift)。TikTok 使用 Flink 实现从用户动作(点击、点赞等)亚秒级计算流式特征,并使用 Cassandra(键值存储)和 Redis(缓存)进行实时特征服务。TikTok 的 Monolith 还包括模型的持续重训(每分钟一次),但我们可以简化为调度每小时运行的批训练作业。
- 稀疏特征挑战
- 大多数用户和视频特征都是高基数(high-cardinality)类别变量,其原始形式极其稀疏。例如,推荐系统通常把观看历史存储为独热向量(one-hot vector),其中 1 表示用户看过某个视频,0 表示用户没看过。这会导致极高维度且大部分为零值(稀疏)的矩阵,而协同过滤和因子分解机等技术无法扩展到所需的更高内存和计算复杂度。稀疏特征还存在冷启动(cold-start)问题,因为它们意味着这些实体几乎没有数据,难以生成好的推荐。模型倾向于只推荐热门物品,忽略了互动较少的物品的"长尾"(long tail),从而降低了推荐的多样性和惊喜感。稀疏特征还可能导致过拟合,因为模型可能会"记住"罕见的用户-物品交互,而不是泛化。神经网络通常需要稠密表示,而原始交互数据是稀疏的。我们将使用嵌入(embedding)来解决稀疏特征数据问题。嵌入将高维稀疏特征转换为低维稠密向量。然而,我们还面临连接两个不同数据源的挑战:用户行为数据和视频数据。我们将通过在单个双塔架构(two-tower architecture)中训练两个模型(一个用户嵌入模型和一个视频嵌入模型)(见下一节)并使用交互数据(用户事件,如观看/点赞视频等)来解决这个问题。
- 检索挑战
- 我们将使用向量索引进行相似性搜索,在几毫秒内从包含数十亿个视频的目录中检索出几百个候选视频。我们将使用在双塔架构中训练的视频嵌入模型,构建一个为系统中所有视频建立索引的向量索引。我们将获取一个用户动作以及用户历史数据,用用户嵌入模型创建一个向量嵌入。我们将用该用户嵌入查询向量索引,找到"最近的"视频。最近是基于交互数据得出的——给定这个用户查询和历史,这些是该用户最可能点击或观看时间最长的视频(在构建双塔嵌入架构时,你可以自行决定优化什么指标)。
- 个性化排序挑战
- 检索阶段返回几百个候选视频,以确保相关的物品被包含在内。也就是说,它应该有高召回率(recall)。然后我们需要通过排序来提高推荐的精确率和效用,让吸引人/相关的视频出现在顶部。目标应该是学习一个排序函数,根据期望的指标为每个用户对物品排序。例如,如果你想优化用户与视频的互动,那么概率最高的视频应该出现在每个用户推荐列表的最顶部。注意,2012 年 YouTube 把优化目标从用户点击视频(观看次数)改为用户观看推荐视频的时长(观看时长),获益巨大。排序通常使用低延迟模型(如 XGBoost)和捕捉近期趋势的实时特征。
- 可扩展性挑战
- 系统需要能够处理数百万并发请求、存储 PB 级数据,并且需要计算和内存高效的设计,以及高可用架构以防止停机。对于检索阶段,我们将使用 Hopsworks 的向量索引(OpenSearch),它在节点上分区并复制以实现高可用。它可以扩展到存储海量数据(最高 PB 级)并处理数千个并发请求。延迟取决于向量索引的大小(条目数)、向量嵌入的大小、它们存储在内存还是磁盘上,以及 Facebook AI 相似性搜索(FAISS)引擎中的存储配置。可以实现 10 毫秒以下的延迟,你需要应用一些技巧才能在数据量巨大时保持这么低的延迟。排序阶段需要检索候选视频的预计算特征。这意味着要在单次批量操作中进行几百次键值查找。我们将使用 Hopsworks 构建在 RonDB 之上的特征存储,在 10-20 毫秒(p99)内检索一个批次,并且可以扩展以处理数万个并发批请求。
- 数据源挑战
- 我们需要用户画像数据、视频数据和交互数据来构建我们的个性化视频播放器。鉴于缺乏高质量的开源数据集,我们将创建模拟用户与视频交互的合成数据。学习用户观看行为最重要的数据源是用户与视频之间的交互。
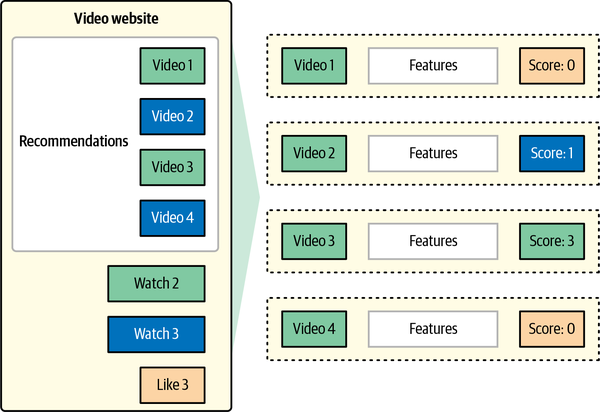
图 15-2 展示了正交互(如观看和点赞)和负交互(如忽略推荐视频)。我们将为检索阶段训练嵌入模型,帮助预测用户在给定其长期观看行为、近期短期观看行为以及其他用户当前观看行为的情况下,可能观看/点赞哪个视频。
图示:说明用户-视频交互(如观看和点赞)如何作为双塔模型和排序模型的训练数据被记录下来,并带有分配的交互分数。
我们将为推荐给用户的视频的用户交互分配一个 interaction_score:
- 0:用户没有观看推荐的视频(或在极短时间内滑走了视频)。
- 1:用户观看了推荐的视频。
- 2:用户点赞了推荐的视频。
- 3:用户分享了推荐的视频。
如果用户观看了一个视频,我们还会通过计算观看两个视频之间的时间差来度量 watch_time(用户观看该视频的时长)(你也可以添加一个停止观看事件,但大多数观众只会滑动切换视频)。
在下一节中,你将基于这种检索-排序架构设计你自己的个性化、实时的 AI 驱动推荐系统,包括数据模型和 FTI 管道。
Note
Google 在 RecSys 2016 发表的《用于 YouTube 推荐的深度神经网络》中普及了用于个性化推荐的检索-排序架构。2025 年,Netflix 推出了一个用于预测用户下一次交互的基础 Transformer 模型。看看 Transformer 能否像颠覆 NLP 一样颠覆推荐模型,将会很有趣。
实时个性化推荐系统
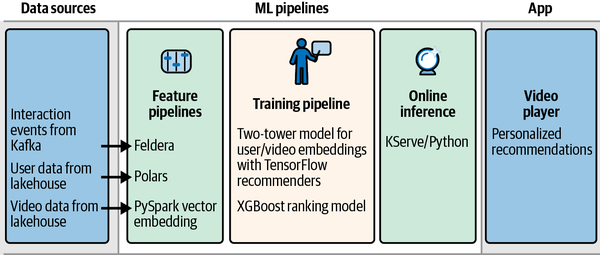
你的个性化视频推荐系统的起点是构建一个 MVPS(见第2章)。图 15-3 中的看板展示了 FTI 管道所用的不同技术、数据源(一个 Kafka 主题和外部湖仓表),以及预测消费者——视频播放器的个性化推荐。对于你的特征管道,你将需要流处理(Feldera)、批处理(Polars)和向量嵌入(PySpark)管道。
图示:看板图,展示最小可行视频推荐系统的组件,包括数据源、机器学习管道,以及面向个性化视频推荐的应用集成。
我们选择这些数据变换框架是因为 Feldera 和 Polars 的学习曲线最平缓,并且可以扩展以处理我们预期的负载(数百万用户);我们将使用 PySpark 计算向量嵌入,因为从视频数据回填向量嵌入的计算量很大,而 PySpark 可以横向扩展以运行在许多节点上。我们将使用双塔模型,配合 TensorFlow Recommenders 库,训练用于检索系统的用户嵌入模型和视频嵌入模型。TensorFlow Recommenders 内置了对训练双塔嵌入模型的支持。我们将使用 XGBoost 作为排序模型,因为它的性能好且预测延迟低。我们将把在线推理管道作为 Python 服务器(FastAPI)托管在 KServe 中,视频播放器应用通过 REST API 调用它。我们将在 Hopsworks 上运行管道并部署模型。
Note
Netflix 等大公司把这种检索-排序架构同时用于个性化推荐和搜索——“一个可以服务所有搜索和推荐任务的统一上下文推荐系统”。Netflix 有基于同一检索-排序基础设施构建的推荐系统 PreQuery 和 MoreLikeThis,以及一个搜索系统,它们使用许多相同的数据源和特征。统一平台降低了维护成本,并让搜索或推荐中的创新也能惠及另一个领域。
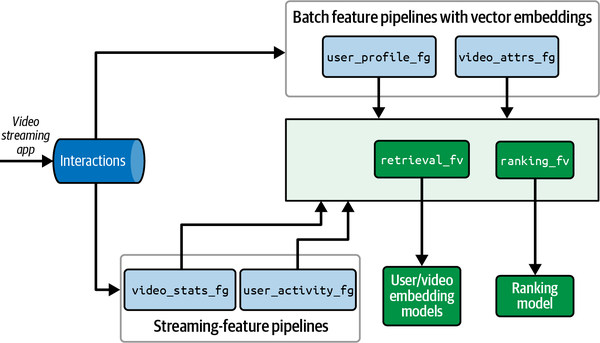
在接下来的几节中,我们将逐一介绍 ML 管道,但首先我们将设计系统架构:从数据源到特征管道的类型(批处理还是流式)、特征组,以及模型所需的特征视图。图 15-4 展示了我们的 MVPS 需要四个特征组和两个特征视图,并将创建三个模型。
图示:说明视频推荐系统的特征组和特征视图,展示交互数据如何通过流式和批处理管道处理,为检索-排序模型生成输入。
图中展示了交互数据到达 Kafka,流式特征管道计算聚合观看统计,批处理管道计算用户画像、视频属性和排序特征数据。这些特征组包含向量嵌入和一些实时特征。我们的检索系统基于向量索引,需要两个嵌入模型——一个用于用户数据,一个用于视频数据——我们为这些模型创建一个检索特征视图。对于排序模型,我们还创建一个排序特征视图。
我们的管道代码以及如何运行这些 ML 管道的说明都在本书的源代码仓库中。现在,我们将研究如何为推荐系统实现 FTI 管道。
特征管道
我们从交互数据开始,它作为事件到达由所有视频播放器应用生成的 Kafka 主题。我们假设有一个外部事件溯源管道,把历史交互事件存储在湖仓表中。在源代码仓库中,我们创建合成交互数据并把它写入 Kafka 主题。同样的代码还可以用历史交互数据回填一个 interaction_fg 特征组。用户画像数据将由用户在视频播放器应用中的操作更新。视频属性将由定期运行的批处理管道更新,以处理用户上传的新视频。图 15-4 还展示了各特征组的特征管道类别(批处理、流式、向量嵌入)。同样,我们有合成数据生成程序来创建这些数据。创建合成数据生成程序的提示词在本书的源代码仓库中。所有特征组都将同时具备离线和在线能力。离线数据用于训练,在线数据用于检索和排序阶段。
我们将需要一个流式特征管道来计算视频的窗口聚合( video_stats_fg ):
- cnt_views_last_{h/d/w/m}
- 视频在之前一小时、一天、一周和一个月的观看次数
- ctr
- 之前一小时、一天、一周和一个月的点击率
并计算用户观看历史的状态( user_activity_fg ):
- recently_viewed
- 每个用户最近观看的 N 个视频
- last_login
- 用户最后登录的时间戳
- mean_session_duration
- 上周用户会话的平均时长
- std_session_duration
- 上周用户会话时长的标准差
我们将使用 Feldera 计算流式特征管道,它也可以在回填模式下运行,以处理历史交互数据。
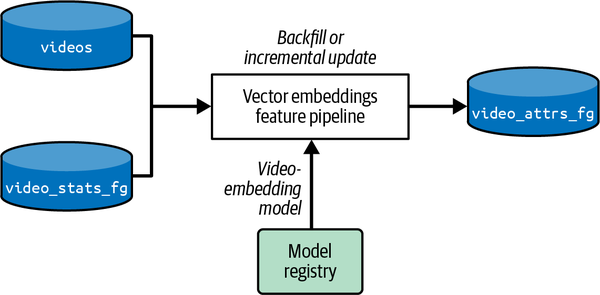
视频的特征(不包括视频使用统计)存储在 video_attrs_fg 中。它包含取自湖仓中 videos 表的视频名称、描述、类型和评分等特征。它还包含用于检索阶段相似性搜索的向量索引。你需要用批处理向量嵌入管道定期更新 video_attrs_fg,如图 15-5 所示。
图示:说明向量嵌入特征管道,它使用注册表中的模型,以视频详情和统计信息为输入来更新 video_attrs_fg。
我们使用向量嵌入模型(在我们的交互数据上训练,见下一节)计算向量嵌入,输入来自 videos(名称、描述、类型、时长、评分)以及来自 video_stats_fg 的视频观看统计。这种特征组合让我们的检索阶段不仅可以根据视频的静态属性(名称、描述、类型、评分)选择视频,还可以根据动态属性(如它们的热度分数(trending score))来选择。如果视频的流行度突然变化怎么办?检索阶段只会在向量索引条目更新时才适应视频流行度的变化。动态属性还会增加向量索引的写入负载和管道的计算需求。你的管道程序可能会从 GPU 中受益,因为与 CPU 相比,GPU 在计算向量嵌入时应该能带来约 10 倍的吞吐量提升。不过,你的管道随后可能会遇到写入向量索引的瓶颈。例如,Hopsworks 使用 OpenSearch 的向量索引,使用批量 API 每秒可以处理几万次更新。如果我们用一堆 worker 运行 Spark 向量嵌入管道,我们可能不需要 GPU,因为 OpenSearch 将是瓶颈,添加 GPU 不会让更新更快。例如,如果你有 1 亿个视频,每秒可以更新 1 万次,那么更新所有条目需要 150 分钟。这为刷新向量索引的频率设定了一个上限。不过,你也许不需要在每次增量更新时都更新所有条目——你可以为视频流行度的变化设置一个阈值,只有当视频的流行度高于/低于阈值时才更新条目。这将把需要更新的视频数量减少两三个数量级,让你能以高得多的节奏更新条目。
另一个批处理特征管道更新 user_profile_fg(位置、年龄、性别等),使用从 users 湖仓表计算出来的大多是静态的特征,并且只做有限的特征工程(例如,出生日期被转换为年龄)。该特征组是在线的,因为我们将在在线推理管道中使用它的预计算特征。由于该管道数据变化缓慢,可以每天调度一次做增量更新,但它也可以以回填模式运行。对于这个特征管道和之前的特征管道,你应该添加数据验证规则,比如第8章中介绍的 Great Expectations。例如,用户画像和视频属性不应有缺失值。
从这些特征组中,我们可以创建包含三个模型(用户/查询嵌入模型、视频嵌入模型和排序模型)将使用的特征的特征视图。
训练管道
我们将使用由四个不同特征组构建的单一训练数据集来训练用户嵌入模型和视频嵌入模型。为此,我们创建一个特征视图,从我们的交互数据集开始,把它挂载为外部 interactions 特征组,其中存储我们的标签 interaction_score,以及指向 user_id 和 video_id 的外键。我们通过从 user_profile_fg、video_attrs_fg、video_stats_fg 和 user_activity_fg 连接更多特征来创建特征视图。
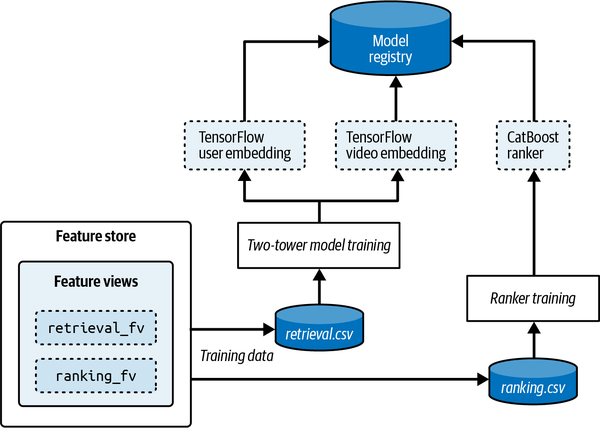
类似地,我们从 interactions 创建 ranking_fv,同样使用 interaction_score 作为标签。我们可以使用许多相同的特征,但也可以使用实时特征,包括按需特征和在流式特征管道中计算的特征。排序模型可以更快地响应热门视频和用户行为的变化。图 15-6 展示了检索和排序特征视图如何分别用于为嵌入模型和排序模型创建训练数据。
图示:说明使用特征存储中的特征视图创建训练数据集的过程,涉及用检索和排序特征视图生成用户和视频嵌入,并将模型注册到模型注册表。
我们将训练数据从特征存储物化为 CSV 文件,因为数据量可能太大,无法在训练管道中存储在内存中。
双塔嵌入模型
到目前为止,在本书中我们只研究了预训练嵌入模型,例如把文本转换为维度为 d(浮点数数组的长度)的稠密向量表示的 sentence-transformers。
我们想用双塔模型架构训练我们自己的自定义嵌入模型,使用交互数据、用户数据和视频数据。交互数据告诉我们,具有特定画像和观看历史的用户观看了具有某种类型、描述和流行度的视频。交互数据还应包括负样本,即用户没有观看该视频的情况,以及用户点赞或分享视频的情况。我们将使用交互数据以及用户和视频特征,训练两个把这两种不同模态(用户和视频)联系起来的嵌入模型。
双塔模型架构的输入是来自用户-视频交互数据集的样本(行),以及每个交互的分数作为样本的标签。我们将准备训练数据集,为它连接以下列:
- 用户特征
- 来自用户画像和用户观看历史
- 视频特征
- 画像、观看统计和视频
用户特征和视频特征被输入两个独立的神经网络(塔),一个处理用户特征,一个处理视频特征。每个塔中可以包含的特征和层的一些示例:
- 用户嵌入层
- 用户 ID 和用户类别特征
- 视频嵌入层
- 视频 ID 和视频类别特征
- 前馈层
- 归一化的数值特征,如用户年龄和视频时长
- Transformer 块
- 文本特征,如视频描述,以及序列特征,如用户历史
- CNN
- 图像特征
用户塔接收用户特征(用户条目),先经过任意初始层到嵌入层(用户和视频 ID 的嵌入查找表),再经过前馈层,输出一个向量:长度为 d 的用户嵌入。视频塔接收视频特征(视频条目),先经过初始层到嵌入层,再经过前馈层,输出长度为 d 的视频嵌入。图 15-7 展示了从训练数据到两个嵌入塔、再到输出和损失函数的架构。
图示:说明双塔神经网络模型,它将用户和视频交互处理为嵌入,并使用点积进行比较以预测互动结果。
用户嵌入和视频嵌入使用相似性函数(如点积或余弦相似度)进行比较。我们把输出压缩为两类之一:正 = 强或弱互动(1、2、3),负 = 无互动(0)。双塔模型用于检索阶段,其目标只是找出任何潜在有趣的候选传给排序阶段。细粒度的偏好(例如"点赞"与"分享")更适合在排序模型中处理,排序模型可以获取更丰富的特征并进行个性化评分。
正或负的结果使用对比损失(contrastive loss)函数(如信息噪声对比估计(InfoNCE)或采样 softmax)与二元标签(正或负)进行比较。计算出的损失用于更新用户塔和视频塔网络中的权重。更大的损失会导致更大的权重更新,驱动嵌入塔优化相似度分数,使正样本排在负样本之上。
Note
推荐模型需要负采样吗?如果推荐服务本身还没有上线,没有交互数据怎么办?如果你有一些正样本(观看、点赞),你可以使用随机采样之类的策略——把用户条目与随机视频组合成负数据,引导训练数据。
构建视频向量索引
双塔模型训练完成后,你需要编写一个向量嵌入管道,它可以从交互数据集回填向量索引,也可以增量处理交互数据集中的新条目。向量嵌入管道将为它从交互数据集中处理的每一行创建一个视频向量嵌入,并把它写入向量索引。
当推荐系统要为某个用户查询检索候选视频时,它首先用用户嵌入模型从用户特征计算用户向量嵌入。然后,它使用向量索引上的 ANN 搜索,检索与给定用户嵌入最相似的前 N 个(通常为 50-1,000 个)候选视频。返回的候选视频应该使用排序模型进行排序。
排序模型
排序模型把 N 个候选视频作为输入,使用更丰富的特征(包括用户和视频之间的显式交叉特征,这是双塔模型难以处理的)精确地重新排序。排序器还可以使用更多实时特征(按需特征或在流式特征管道中计算的特征),使其对视频流行度和用户行为的近期变化更敏感。例如,排序模型把"热度分数"作为每个视频的众多输入特征之一,并学习"热度"对每个用户有多重要。排序模型也需要正样本和负样本(观看和未观看),并且可以预测更细粒度的交互,如点赞和分享。排序器的例子包括 Wide & Deep、DCN 和 DeepFM。
一种被广泛使用的排序指标是归一化折损累积增益(NDCG)。它把排序结果与所有相关物品都排在列表顶部的理想顺序进行比较。另一个流行的排序指标是平均倒数排名(mean reciprocal rank,MRR)。前 K 平均精度均值(mean average precision at K,MAP@K)是一种排序指标,用于评估推荐系统中的排序质量。它既衡量推荐物品的相关性,也衡量系统把更相关的物品放在顶部的能力。
在线推理管道
在线推理管道是一个部署在 KServe 上的 Python 预测器脚本,作为 FastAPI Python 服务器运行。它接受预测请求,在执行完第 2 到第 6 步后返回排序后的推荐视频列表,如图 15-8 所示。
图示:说明部署在 KServe 上的在线推理管道,突出显示视频播放器、预测器和排序模型之间的各个组件与数据流。
在线推理管道是一个部署对象,带有一个部署 API,把会话内特征和实体 ID 作为参数。它执行以下步骤:
- 1. 检索
- 用
user_id从特征存储读取用户特征,并与按需特征和传入特征合并。这些user_features被传给用户嵌入模型,返回用户嵌入,然后发送到向量索引,返回 200 个候选视频。
- 用
- 2. 过滤
- 我们用
ranking_fv和video_ids读取 200 个候选视频的特征。现在我们有了候选视频的特征,就知道了每个视频的评级,因此可以过滤掉不适合用户年龄的视频。
- 我们用
- 3. 排序
- 最后,我们对包含过滤后候选视频的 DataFrame 执行
model.predict()。模型使用所有可用的 CPU 核并行执行这些预测,使总延迟最小化。
- 最后,我们对包含过滤后候选视频的 DataFrame 执行
在线推理管道(预测器脚本)的伪代码如图 15-9 所示,包括对特征存储的调用,以及每一步延迟的一些估计。
图示:模型部署图,展示用户模型和排序模型使用特征存储进行候选检索与特征增强,并给出总计 45 毫秒的延迟分解。
图中显示了 45 毫秒的 P95 延迟目标,每一步的分解如下:
- 检索用户特征是一次主键查找,需要约 1 毫秒,用户嵌入计算需要约 4 毫秒,这一步总计约 5 毫秒。
- 向量索引上的 ANN 搜索需要约 10 毫秒(如果你有数亿个视频,你的查询和向量索引将需要认真调优才能把延迟保持在这个水平)。
- 在 Python 中内存中过滤掉不合适的视频,应该不到 1 毫秒。
- 在特征存储中对视频特征进行一次批量主键查找需要约 23 毫秒。
- 排序模型为每个候选视频估计排序分数,在所有可用 CPU 核上并行执行预测,需要约 5 毫秒。
- 异步记录输入特征和预测需要约 1 毫秒。
我们假设按需特征的计算时间不到 1 毫秒,总计约 45 毫秒。如果你的向量索引和特征存储查找的标准差很高,你应该警惕规模下的长尾(tail at scale)现象,此时 p99 延迟可能会显著增加。
由于我们记录了排序模型的所有特征和预测请求,我们可以通过编写模型监控作业来监控它的性能,就像我们在第14章中所做的那样。结果会在交互数据中产生(你应该等几分钟,让用户观看或不观看推荐内容),你可以轻松地将预测与结果进行比较。如果预测性能下降,你将需要重训排序模型或重新设计它。或者,预测性能下降可能是检索阶段上游问题的结果,在这种情况下,你可能需要重训或重新设计嵌入模型。
视频的智能体搜索
你的实时推荐系统是摇钱树,应该让用户在视频播放器上停留更长时间。但现在,你想用新的 AI 驱动功能让用户惊叹。你可以扩展系统,允许用户用自由文本搜索视频。你还可以添加新的特征管道来转录视频、从视频中提取帧,并允许用户附加描述视频关键时刻的标签。图 15-10 展示了一个由 LLM 驱动的智能体的架构,它能够提供这种自由文本搜索能力。
图示:说明 AI 驱动的视频搜索系统架构,展示用于转录和帧提取的 Whisper 和 YoloX 管道等组件,以及集成 LLM 来解释用户查询以检索相关视频标签。
用户可以观看一个视频并询问关于视频中某个时刻或场景的问题。然后我们可以使用当前的 video_id 检索该视频的 video_tags,由 LLM 根据标签的描述判断哪个最合适,并把视频中的偏移量改到所选 video_tags 行中的 pos_ms。当用户正在观看视频时,智能体(由 LLM 驱动)会解释自然语言查询,检索当前 video_id 的所有 video_tags,并选择最相关的一个。然后系统会跳转到与该标签关联的 pos_ms 时间戳。
类似地,用户可以询问关于所有视频的问题,对 transcripts 向量索引进行 ANN 搜索,找到最相似的视频转录,然后播放匹配的视频。对于跨所有视频的查询,智能体可以对 transcripts 向量索引或 videos 向量索引执行 ANN 搜索,找到语义相似的内容片段或完整视频,然后播放最佳匹配。
案例研究到此结束,我将用一些关于不要做什么的建议来结束本书。这是对贯穿全书许多经验教训的总结,并加上了一点诙谐。
MLOps 的十二大谬误
MLOps 从业者经常犯一些谬误(错误的假设),导致 AI 系统永远无法上线。我们在前面的章节中已经讲过这些谬误,但在这里把它们作为复习呈现,让你看看如果陷入某个谬误会发生什么:
- 1. 把所有事情都放在一个单体 ML 管道中完成
- 我们看到,批 ML 系统可以写成单个单体管道(参数化后在训练或推理模式下运行)。但是,你不能用单个 ML 管道运行实时 ML 系统,也不能用单个程序构建智能体 RAG 系统。*这一谬误的影响及如何克服:*如果没有构建 AI 系统的统一架构,构建每一个新的批处理或实时 AI 系统都像是从零开始。这让开发人员难以从构建一种类型的 AI 系统过渡到另一种。你可以通过把 AI 系统分解为特征/训练/推理管道(FTI 管道),并把它们连接起来构成你的批处理/实时/LLM AI 系统来克服这一挑战。
- 2. 用于 AI 的数据是静态的
- 学会用静态数据集训练模型的数据科学家习惯于模型只做一次预测、只创造一次价值。在现实世界中,AI 系统使用动态数据源,并随着新数据的到来反复创造价值。*这一谬误的影响及如何克服:*如果开发人员不具备从动态数据源提取和管理数据的技能,他们就难以处理动态数据源。开发人员难以区分按计划做预测的批 ML 系统和响应预测请求做预测的实时 ML 系统。你可以在构建 AI 系统时遵循 FTI 架构来克服这一点。
- 3. 用于 AI 的所有数据变换都是一样的
- 数据变换并不都一样。与模型无关的变换在特征管道中创建可复用的特征数据。与模型相关的变换在从特征存储读取数据之后执行,需要在训练和推理管道中一致地实现。按需变换使用请求时数据创建特征。它们在特征管道用历史数据回填时以及在在线推理管道处理请求时数据时都会执行。按需变换在特征管道和在线推理管道中的实现不应有任何偏差。*这一谬误的影响及如何克服:*如果你不支持与模型相关的变换,你就无法在特征存储中复用特征。如果你不支持按需变换,你就没有相同的代码来从预测请求参数计算实时特征和在特征管道中回填特征数据。如果你既不支持与模型相关的变换也不支持按需变换,你就难以构建一个可观测的、记录/监控可解释特征的 AI 系统。解决方案是把你的数据变换梳理为与模型无关的、与模型相关的和按需变换三类。
- 4. 不需要特征存储
- 特征存储是连接特征管道与训练/推理管道的数据层。如果你不关心复用特征,并且愿意自己实现治理、血缘、特征/预测日志和监控的解决方案,那么在没有特征存储的情况下构建批 ML 系统是可能的。但是,如果你处理的是时序数据,你还得自己实现从表中创建时间点正确训练数据的方案。如果你正在构建实时 ML 系统,你需要一个特征存储(或自己构建一个)来为在线模型提供预计算特征(作为上下文/历史)。特征存储还确保离线变换和在线变换之间没有偏差。简而言之,没有特征存储,你也许能推出你的第一个批 ML 系统,但之后每增加一个批模型的开发速度都不会提高。对于实时 ML 系统,你需要特征存储来为在线模型提供历史/上下文,并需要基础设施来确保特征正确、受治理、可观测。*这一谬误的影响及如何克服:*你最终会自己构建特征存储的能力,花大量时间研究如何正确处理可变数据、如何创建时间点正确的训练数据,以及如何同步列式数据存储与面向在线推理的低延迟行式存储中的数据。由于把特征做成预计算特征需要付出努力,你在在线模型中会使用更少的特征。你不会规范化你的数据模型(雪花模式),因为那太难了。构建和部署每个新模型的成本总是很高,并且不会随时间下降。解决方案是使用特征存储。
- 5. 实验跟踪是 MLOps 所必需的
- 许多团队错误地认为安装实验跟踪服务是构建 AI 系统的起点。实验跟踪会拖慢你到达第一个 MVPS 的速度。实验跟踪是 MLOps 中的过早优化。你可以把模型注册表用于运营需求,如模型存储、治理、模型性能/偏差评估和模型卡。实验跟踪是模型训练的研究日志。*这一谬误的影响及如何克服:*就像猴子拉绳实验(猴子会不断殴打任何试图爬绳的猴子,尽管没有猴子知道为什么不允许爬绳)一样,许多 ML 工程师认为 MLOps 项目的起点是安装实验跟踪服务。解决方案是从模型注册表开始,存储模型及其训练运行所需的元数据,直到你真正需要实验跟踪服务(大多数 ML 工程师可能永远不需要)。
- 6. MLOps 只是面向 ML 的 DevOps
- 与 DevOps 一样,MLOps 需要对管道源代码进行自动化测试;但与 DevOps 不同,MLOps 还需要对输入数据进行版本管理和测试。数据验证测试可以防止垃圾进、垃圾出。同样,模型验证测试在 DevOps 中没有对应物。还有一个区别是,由于数据和模型漂移,AI 系统的性能往往会随时间下降。*这一谬误的影响及如何克服:*没有数据测试,你的训练或推理数据可能会被污染。没有模型测试,你的模型可能有偏差或性能不佳。由于缺乏特征监控和模型性能监控,你的 AI 系统性能可能会随时间下降。请遵循 MLOps 最佳实践,进行离线数据验证、模型验证以及特征/模型监控。
- 7. 对模型进行版本管理就足以安全升级/回滚
- 对于有状态的实时 ML 系统,模型部署与为其提供预计算特征的带版本特征视图紧密耦合。当你升级模型部署时,仅仅更新模型版本是不够的。你可能还需要升级模型部署所使用的特征视图的版本。*这一谬误的影响及如何克服:*如果不把模型部署版本与特征版本耦合,你可能会引入难以察觉的 bug。例如,如果你的新部署使用旧的特征版本,但新的特征组版本与旧版本模式兼容,系统看起来会像以前一样工作。然而,它的性能会下降,而且这将是一个很难找到的 bug。解决方案是把模型部署的版本与喂给它的特征视图紧密耦合。
- 8. 不需要数据版本管理
- 训练数据的可复现性需要数据版本管理。*这一谬误的影响及如何克服:*没有数据版本管理,如果你重新创建一个训练数据集,而自第一个训练数据集创建以来有延迟到达的数据,那么延迟数据将被包含在后续的训练数据集创建中。这是因为没有为延迟到达的数据记录摄入时间戳。解决方案是支持数据版本管理,就像湖仓表那样,包括为数据点记录摄入时间戳。这让你能够精确地重新创建训练数据在最初创建时的样子。
- 9. 模型签名就是模型部署的 API
- 实时 ML 系统使用*模型部署来响应预测请求做预测。客户端发送给模型部署 API的参数通常与模型的输入参数(模型签名,model signature)不同。这一谬误的影响及如何克服:*开发人员可能会把模型部署 API 误认为模型签名。如果没有对部署 API 的显式支持,开发人员将被迫阅读源代码来推断它。你需要为一个部署显式定义 API(或模式)。
- 10. 在线预测延迟就是模型预测所花的时间
- 当你在网络端点后面服务模型时,你通常需要在最终用最终特征向量调用
model.predict()之前执行大量操作。*这一谬误的影响及如何克服:*你不能假设网络托管模型的预测延迟只是模型预测所花的时间。你必须把所有预处理(构建特征向量、RAG 等)和后处理(特征/预测日志)的时间都包括在内。
- 当你在网络端点后面服务模型时,你通常需要在最终用最终特征向量调用
- 11. LLMOps 与 MLOps 不同
- LLM 在推理和微调时需要 GPU。同样,LLM 需要可扩展计算、可扩展存储和可扩展模型服务的支持。然而,许多 MLOps 平台既不支持 GPU 也不支持扩展,结果 LLM 常常被视为 MLOps 之外的东西,属于一门新的 LLMOps 学科。但是,LLM 仍然遵循同样的 FTI 架构。如果你的 MLOps 平台支持 GPU 和扩展,LLMOps 就只是带 LLM 的 MLOps。特征管道用于为指令和对齐数据集分块、清洗和评分文本。它们还用于计算存储在向量索引中供 RAG 使用的向量嵌入。训练管道用于微调和对齐基础 LLM。分词是一种与模型相关的变换,需要在训练和推理之间保持一致——没有平台支持,用户常常会出错,在推理时为他们的 LLM 使用了错误版本的分词器。智能体和工作流存在于在线推理管道中,通过 RAG 和函数调用调用外部系统也是如此。你的 MLOps 团队应该能够把与批处理和实时 ML 系统相同的架构和工具应用于 LLM 系统。*这一谬误的影响及如何克服:*如果你支持与 MLOps 栈分离的 LLMOps 栈,你可能会重复建设 AI 基础设施。如果你把 LLMOps 当作大规模的 MLOps 对待,开发人员应该能够轻松地从批处理/实时 ML 系统过渡到 LLM AI 系统——如果你遵循 FTI 架构的话。
- 12. 运行 ML 管道需要 ML 编排器
- 你并不需要一个 ML 专用的编排器(如 Kubeflow/Metaflow/ZenML/SageMaker Pipelines)来运行你的 ML 管道。ML 编排器是为批 ML 系统设计的,通常只能运行少数几种不同的数据处理和 ML 框架。例如,你不能在 Kubeflow 中运行 Spark 特征管道。而且,ML 编排器不能运行流式特征管道。如果你想在一个平台上支持批处理、实时甚至 LLM AI 系统,并不是所有的 ML 管道或服务都能由你的 ML 编排器管理。这意味着 ML 编排器并不了解所有 AI 系统的所有血缘信息。相比之下,数据层(特征存储、模型注册表)了解所有类别的 ML 管道的所有血缘信息,通常应该是血缘的真相来源。这样你就可以自由使用最适合你的 FTI 管道需求的编排器。*这一谬误的影响及如何克服:*自诞生以来,MLOps 一直与 ML 编排器(如 Kubeflow)联系在一起。但最近批处理和流处理数据引擎的寒武纪大爆发意味着你可能想为特征管道使用专业框架,如 Apache Flink、Feldera 或 Polars。ML 编排器跟不上。它们最初也被设计为存储血缘信息。如果你在 ML 编排器之外运行 ML 管道,血缘信息将对它丢失。相反,血缘信息应该由特征存储和模型注册表管理,而不是由编排器管理。你可以自由地为每个 ML 管道使用最好的编排器。
AI 构建者的伦理责任
最后,说说你在构建 AI 系统时的伦理责任。在投入构建 AI 系统之前,你应该始终考虑系统的任何潜在负面影响。你不仅负有遵守法律和法规的责任,还有确保不造成直接或间接伤害的责任。例如,个性化推荐系统必须是负责任的 AI 系统。爱尔兰 RTÉ 电视台《黄金时间》(Prime Time)栏目在 2024 年 5 月的一项调查发现,“滚动浏览一小时后,TikTok 的推荐系统向它认为是 13 岁的用户展示了一连串几乎全部与抑郁、自残和自杀念头有关的视频。“如果你在一家构建这种 AI 系统的公司工作,要么修复系统,要么离开公司并举报。构建合法但不道德的软件并不光荣。
我们可以从历史中吸取教训,瑞典瓦萨号(Vasa)战舰的故事对各地的工程师来说既是警告也是教训。国王古斯塔夫二世·阿道夫想要一艘配备 64 门重炮的战舰(1627 年世界上最多的)。专家告诉他这不可能。尽管如此,造船工人还是造了它,尽管知道他们的工作既徒劳又危险。工程师们和这艘船一样软弱无力。瓦萨号在下水时就沉没了,约 30 人丧生。不要成为那个构建有害 AI 系统的开发者。我们可以一起让 AI 成为一股向善的力量,但如果没有法律的帮助,我们需要一个公认的伦理准则才能做到这一点。遵循这个伦理准则并帮助执行它,当你日后回顾自己的人生时,你会感谢自己。
小结
本章介绍了一个案例研究:构建你自己的类似 TikTok 的个性化视频推荐服务。它涵盖了检索-排序架构,该架构建立在用于检索的双塔嵌入模型和用于个性化推荐的排序模型之上。我们介绍了系统的流式、批处理和向量嵌入特征管道;用户嵌入模型、视频嵌入模型和排序模型的训练管道;以及实现用户请求检索和排序的在线推理管道。最后,我们还锦上添花,添加了一个由 LLM 驱动的智能体来支持跨视频和视频内的自由文本搜索。最后,我们以 MLOps 和 LLMOps 的十二大谬误结束全书,如果你想在构建 AI 系统方面取得成功,就应该避免这些谬误。而历史上没有任何时候比今天更适合构建 AI 系统。鉴于改进的速度,今天永远会是构建 AI 系统最重要的一天。去创造吧,愿原力与你同在。
索引
A
- A/B 测试
- 面向智能体,在线 A/B 测试
- 面向批推理,批推理的 A/B 测试
- 消融研究(ablation studies),模型可解释性
- Adam(自适应矩估计)优化器,模型架构
- ADF(Azure 数据工厂),云提供商工作流编排器
- 智能体卡片(Agent Cards),智能体到智能体(A2A)协议 - 智能体到智能体(A2A)协议
- 智能体追踪(agent traces),智能体的日志与指标
- 智能体到智能体(A2A)协议,智能体到智能体(A2A)协议 - 智能体到智能体(A2A)协议
- 智能体管道(agentic pipeline),推理管道
- 智能体工作流模式(agentic workflow pattern),从 LLM 工作流到智能体
- 智能体工作流,定义,使用特征存储的 AI 系统类别
- 智能体(agentic AI 系统),机器学习系统的解剖结构
- Hopsworks 中的智能体部署,Hopsworks 中的智能体部署 - Hopsworks 中的智能体部署
- 智能体到智能体(A2A)协议,智能体到智能体(A2A)协议 - 智能体到智能体(A2A)协议
- 定义,机器学习系统简史
- 智能体的开发过程,智能体的开发过程 - 智能体的开发过程
- 面向智能体的评测,面向智能体的评测 - 历史评测需要时间点正确的 RAG 数据
- LLM 辅助的合成评测生成,LLM 辅助的合成评测生成 - LLM 辅助的合成评测生成
- 历史评测的时间点正确 RAG 数据,历史评测需要时间点正确的 RAG 数据
- 从 LLM 工作流到智能体的演进,从 LLM 工作流到智能体 - 领域特定(中间)表示
- 领域特定(中间)表示,领域特定(中间)表示
- 规划,规划 - 规划
- 安全挑战,安全挑战
- 从 LLM 到智能体的演进,从 LLM 到智能体 - 使用 LlamaIndex 的智能体和工作流
- 使用 LlamaIndex 的智能体和工作流,使用 LlamaIndex 的智能体和工作流 - 使用 LlamaIndex 的智能体和工作流
- 上下文窗口,上下文窗口 - 上下文窗口
- 提示工程,提示工程 - 提示工程
- 提示管理,提示管理 - 提示管理
- LLM 工作流与智能体对比,从 LLM 工作流到智能体,规划
- 日志与指标,智能体的日志与指标 - LLM 指标
- 聚合(aggregations),行和列缩减变换
- (另见 滚动聚合;窗口聚合)
- AI 湖仓(AI lakehouse),特征存储简史
- AI 系统(一般)
- 定义,AI 系统的统一架构:特征、训练和推理管道
- 特征/训练/推理(FTI)管道,AI 系统的统一架构:特征、训练和推理管道 - AI 系统的统一架构:特征、训练和推理管道
- 与 ML 系统对比,机器学习系统简史
- 空气质量预报服务(案例研究),你身边的空气质量预报服务 - 小结与练习
- AI 系统概览,AI 系统概览 - AI 系统概览
- 空气质量数据,空气质量数据 - 空气质量数据
- 批推理管道,批推理管道 - 批推理管道
- 创建/回填特征组,创建和回填特征组 - 创建和回填特征组
- 探索性数据集分析,探索性数据集分析 - 天气数据
- 特征管道,特征管道 - 特征管道
- 使用 LLM 的函数调用,使用 LLM 的函数调用 - 使用 LLM 的函数调用
- 运行管道,运行管道 - 将仪表盘构建为 GitHub Page
- 将仪表盘构建为 GitHub Page,将仪表盘构建为 GitHub Page
- 将管道调度为 GitHub Action,将管道调度为 GitHub Action - 将管道调度为 GitHub Action
- 将管道调度为 GitHub Action,将管道调度为 GitHub Action - 将管道调度为 GitHub Action
- 训练管道,训练管道 - 训练管道
- Airflow,Airflow
- 算法评测(algorithmic evals),评测策展
- Apache Airflow,Airflow
- Apache Flink,特征管道,Apache Flink
- Apache Iceberg,版本管理
- Apache Kafka,事件数据,流式数据源
- Apache Spark,特征管道
- API 抓取的数据,API 抓取的数据,API 和 SaaS 数据源
- Arize,批处理和在线模型的日志
- 安排-行动-断言模式(arrange, act, assert pattern),测试方法
- Arrow,向量化计算、多核和 Arrow - 向量化计算、多核和 Arrow
- ASOF 连接(ASOF JOIN),ASOF 连接与变换的组合 - ASOF 连接与变换的组合
- 原子性(atomicity),特征管道
- 审计日志(audit logs),审计日志
- 自动容器化(automatic containerization),Modal,自动容器化和作业 - Modal 作业
- Hopsworks 中的环境和作业,Hopsworks 中的环境和作业 - Hopsworks 中的环境和作业
- Modal 作业,Modal 作业
- 自回归模型(autoregressive models),自监督和无监督学习
- AWS SageMaker,批处理和在线模型的日志
- AWS Step Functions,云提供商工作流编排器
- Azure 数据工厂(ADF),云提供商工作流编排器
B
- 回填(backfilling)
- 面向回填的批数据源,特征管道数据源
- 批处理特征管道,一个程序中的回填和增量处理
- 定义,批处理特征管道,回填和增量更新
- 与全量加载对比,回填和增量更新
- 背压(backpressure),流式原生架构
- 向后填充(backward filling),缺失值插补
- 批数据管道(batch data pipelines),批处理特征管道
- 批处理特征管道(batch feature pipelines),特征管道,批处理特征管道 - 小结与练习
- 回填/增量更新,回填和增量更新 - 一个程序中的回填和增量处理
- 一个程序中的回填/增量处理,一个程序中的回填和增量处理
- 用于增量数据的轮询和 CDC,用于增量数据的轮询和 CDC - 变更数据捕获
- 数据契约,数据契约
- 在 Hopsworks 中使用 Great Expectations 进行数据验证,在 Hopsworks 中使用 Great Expectations 进行数据验证 - 在 Hopsworks 中使用 Great Expectations 进行数据验证
- 特征管道数据源,特征管道数据源 - API 和 SaaS 数据源
- API 和 SaaS 数据源,API 和 SaaS 数据源
- 批数据源,批数据源 - 批数据源
- 流式数据源,流式数据源
- 对象存储/文件系统中的非结构化数据,对象存储和文件系统中的非结构化数据 - 对象存储和文件系统中的非结构化数据
- 作业编排器,作业编排器 - Hopsworks 作业
- Hopsworks 作业,Hopsworks 作业 - Hopsworks 作业
- Modal,Modal - Modal
- 使用 LLM 合成信用卡数据,使用 LLM 合成信用卡数据 - 生成合成数据的 LLM 提示词
- 生成合成数据的 LLM 提示词,生成合成数据的 LLM 提示词 - 生成合成数据的 LLM 提示词
- 数据集市和 LLM 的逻辑模型,数据集市和 LLM 的逻辑模型 - 数据集市和 LLM 的逻辑模型
- 工作流编排器,工作流编排器 - 云提供商工作流编排器
- Airflow,Airflow
- 云提供商,云提供商工作流编排器
- 回填/增量更新,回填和增量更新 - 一个程序中的回填和增量处理
- 批推理(batch inference),批推理,批推理的 A/B 测试
- 批推理数据,批推理数据 - 批推理数据
- 批推理管道,推理管道,批推理管道 - 神经网络的批推理
- 空气质量预报服务案例研究,批推理管道 - 批推理管道
- 面向 LLM 的批推理,面向 LLM 的批推理 - 面向 LLM 的批推理
- 面向神经网络的批推理,面向神经网络的批推理
- 面向实体的批预测,面向实体的批预测 - 面向实体的批预测
- 面向时间范围的批预测,面向时间范围的批预测 - 面向时间范围的批预测
- 面向批推理的数据建模,面向批推理的数据建模 - 面向批推理的数据建模
- 使用 PySpark 扩展批推理,使用 PySpark 扩展批推理 - 使用 PySpark 扩展批推理
- 批作业指标,批模型指标 - 批模型指标
- 批 ML 系统,构建机器学习系统,机器学习系统简史,使用特征存储的 AI 系统类别
- 批模型日志,批处理和在线模型的日志 - 批处理和在线模型的日志
- 批处理(batch processing),批处理特征管道
- 基准测试(benchmarking),Feldera
- BERT Transformer 模型,自监督和无监督学习
- 偏差(bias)
- 模型偏差测试,模型偏差测试
- 面向偏差的训练管道测试,面向模型性能和偏差的训练管道测试 - 面向模型性能和偏差的训练管道测试
- 二分类(binary classification),面向智能体的评测
- 蓝绿测试(blue/green tests),测试模型部署
- Box-Cox 变换,变换数值变量
- 破坏性模式变更(breaking schema change),特征组版本管理
C
- CatBoost,编码类别变量
- CBPE(基于置信度的性能估计),使用 NannyML 进行模型监控 - 使用 NannyML 进行模型监控
- CCPA(加州消费者隐私法案),可变数据
- 思维链(CoT)提示,提示工程
- 变更数据捕获(CDC),特征组的变更数据捕获,变更数据捕获
- 面向 LLM 的聊天模板,面向 LLM 的分词器和聊天模板
- ChatGPT,机器学习的类型
- 检查点(checkpoints),用于故障恢复的检查点
- CI/CD 架构,从开发到生产 - 从开发到生产
- CI/CD 测试
- 面向批推理的 A/B 测试,面向批推理的 A/B 测试
- AI 系统,面向 AI 系统的 CI/CD 测试 - 历史评测需要时间点正确的 RAG 数据
- 面向智能体的评测,面向智能体的评测 - 历史评测需要时间点正确的 RAG 数据
- 测试模型部署,测试模型部署 - 测试模型部署
- 面向模型性能/偏差的训练管道测试,面向模型性能和偏差的训练管道测试 - 面向模型性能和偏差的训练管道测试
- 分类模型,分类和回归的模型性能
- 用监督学习解决的分类问题,机器学习的类型
- Claude,提示管理
- CleanLab,基于模型的数据清洗变换
- CNN(卷积神经网络),模型架构
- Colab(Google Colaboratory)笔记本,为 ML 管道编写模块化代码,探索性数据集分析
- 冷启动问题(cold-start problem),在线模型指标
- 协作,特征存储用于,借助 FTI 管道架构改善协作 - 借助 FTI 管道架构改善协作
- 协同过滤(collaborative filtering),推荐系统简介
- 复杂事件处理(CEP)库,Apache Flink
- 概念漂移(concept drift),监控特征和模型
- 基于置信度的性能估计(CBPE),使用 NannyML 进行模型监控 - 使用 NannyML 进行模型监控
- 基于内容的推荐(content-based recommendation),推荐系统简介
- 上下文长度(context length),上下文窗口
- 上下文窗口(context window),机器学习系统简史
- 持续部署(CD),MLOps 和 LLMOps
- 持续集成(CI)平台,MLOps 和 LLMOps
- 卷积神经网络(CNN),模型架构
- 交叉熵损失(cross-entropy loss),模型架构
- CSV 文件格式,训练数据
D
- DAG(见 有向无环图)
- 数据准确性(data accuracy),空气质量数据
- 数据清洗(data cleaning),基于模型的数据清洗变换
- 数据契约(data contracts),为 ML 管道编写模块化代码,数据契约
- 数据摄入漂移(data ingestion drift),监控特征和模型,数据摄入漂移 - 数据摄入漂移
- 数据泄漏(data leakage),面向时序数据
- 数据建模(data modeling),面向批推理的数据建模 - 面向批推理的数据建模
- 数据模型(data models),特征组的数据模型 - 雪花模式数据模型
- 数据管道,定义,批处理特征管道
- 使用 PCA 的数据重构,多变量特征漂移
- 数据跳过(data skipping),特征组,特征数据的更快查询
- ML 系统的数据源,数据源 - API 抓取的数据
- 数据验证(data validation)
- 特征存储与,数据验证
- Hopsworks 中的 Great Expectations,在 Hopsworks 中使用 Great Expectations 进行数据验证 - 在 Hopsworks 中使用 Great Expectations 进行数据验证
- WAP 模式,在 Hopsworks 中使用 Great Expectations 进行数据验证
- 数据有效性(data validity),空气质量数据
- 数据金库模型(data vault model),特征组的数据模型
- 数据版本管理(data versioning),特征组中的数据版本管理和时间旅行
- 以数据为中心的 AI(data-centric AI),训练管道
- 数据并行训练(data-parallel training),使用 Ray 进行分布式训练
- Databricks,批处理和在线模型的日志
- 数据流图(dataflow graph),特征函数 DAG
- 数据流程序(dataflow program),编写流式特征管道
- 数据流编程(dataflow programming),数据流编程
- 数据帧(DataFrames)
- 数据流,定义,编写流式特征管道
- DBSP(受信号处理启发的数据库),带增量视图的滚动聚合
- 基于决策树的模型,变换数值变量,模型架构
- 用于自动容器化的装饰器,Modal
- 模型/特征视图的部署 API,模型和特征视图的部署 API - 模型和特征视图的部署 API
- 维度建模(dimension modeling)
- 特征组与,信用卡数据集市的维度建模 - 特征存储和 SCD 类型
- 特征存储和 SCD 类型,特征存储和 SCD 类型 - 特征存储和 SCD 类型
- 标签和特征,标签是事实,特征是维度
- 直接评分(direct grading),智能体的开发过程
- 直接损失估计(DLE),使用 NannyML 进行模型监控
- 有向无环图(DAG)
- 特征函数,特征函数 DAG - 特征组的隐式或显式模式
- 数据类型,数据类型 - 特征组的隐式或显式模式
- 惰性数据帧,惰性数据帧
- 向量化计算/多核/Arrow,向量化计算、多核和 Arrow - 向量化计算、多核和 Arrow
- 作业编排器与,Hopsworks 作业
- 特征函数,特征函数 DAG - 特征组的隐式或显式模式
- 每周发现(Discovery Weekly,Spotify),机器学习系统的解剖结构
- 分布式训练(distributed training)
- 识别瓶颈,识别分布式训练中的瓶颈 - 识别分布式训练中的瓶颈
- Ray 与,使用 Ray 进行分布式训练 - 使用 Ray 进行分布式训练
- DLE(直接损失估计),使用 NannyML 进行模型监控
- 域分类器(domain classifier),多变量特征漂移
- 漂移检测(drift detection),监控特征和模型 - 何时重训或重新设计模型
- 动态 RBAC,使用项目在集群级别进行访问控制
E
- 急切求值(eager evaluation),惰性数据帧
- EDA(探索性数据分析),最小可行预测服务,特征类型和与模型相关的变换
- 嵌入式(边缘)ML 系统,使用特征存储的 AI 系统类别
- 嵌入式模型的推理,嵌入式模型的推理 - Python 中 AI 应用的 UI
- 嵌入式 AI 应用,嵌入式 AI 应用
- 流处理 AI 应用,流处理 AI 应用 - 流处理 AI 应用
- Python 中 AI 应用的 UI,Python 中 AI 应用的 UI - Python 中 AI 应用的 UI
- 嵌入漂移(embedding drift),监控向量嵌入
- 错误分析(error analysis),错误分析 - 评测策展
- AI 构建者的伦理责任,AI 构建者的伦理责任
- ETL 管道,批处理特征管道
- 评测(evals)
- 智能体,面向智能体的评测 - 历史评测需要时间点正确的 RAG 数据
- 策展,评测策展 - 评测策展
- LLM 辅助的合成评测生成,LLM 辅助的合成评测生成 - LLM 辅助的合成评测生成
- 历史评测的时间点正确 RAG 数据,历史评测需要时间点正确的 RAG 数据
- 评估数据(evaluation data),模型评估和模型验证,模型偏差测试
- 评估器(程序),面向智能体的评测
- 事件数据(event data),事件数据
- 事件溯源(event sourcing),信用卡数据集市的维度建模,流式原生架构
- 事件流平台(event-streaming platforms),事件数据,事件流平台
- 实验跟踪服务(experiment tracking services),使用 Ray Tune 进行超参数调优
- 显式模式(explicit schemas),特征组的隐式或显式模式
- 探索性数据分析(EDA),最小可行预测服务,特征类型和与模型相关的变换
- 指数变换公式,变换数值变量
- 外部特征组(external feature groups),外部特征组,一个程序中的回填和增量处理
F
- 事实表(fact table),信用卡数据集市的维度建模
- 因子分解机(factorization machines),推荐系统简介
- FastAPI,使用 FastAPI 进行模型部署 - 使用 FastAPI 进行模型部署
- Feast 特征存储,特征存储简史
- 特征数据(feature data),特征组存储未变换的特征数据
- 特征数据验证管道,特征管道
- 特征定义(feature definitions),特征定义和特征组
- 特征漂移(feature drift),监控特征和模型
- 特征工程(feature engineering),可变数据
- 特征新鲜度(feature freshness),特征管道
- 特征函数(feature functions),为 ML 管道编写模块化代码 - 为 ML 管道编写模块化代码
- 特征组(feature groups),特征组 - 数据验证
- 为空气质量预报服务创建/回填,创建和回填特征组 - 创建和回填特征组
- 数据模型,特征组的数据模型 - 雪花模式数据模型
- 数据验证,数据验证
- 使用信用卡数据集市进行维度建模,信用卡数据集市的维度建模 - 特征存储和 SCD 类型
- 外部,外部特征组
- 特征定义与,特征定义和特征组
- 特征新鲜度,特征新鲜度
- Hopsworks,特征组 - 特征组的变更数据捕获
- 实时信用卡欺诈检测 ML 系统,实时信用卡欺诈检测 ML 系统 - 雪花模式数据模型
- 根/标签特征组,根和标签特征组 - 根和标签特征组
- 未变换特征数据的存储,特征组存储未变换的特征数据
- 在其中存储变换后的特征数据,在特征组中存储变换后的特征数据
- 其中的非结构化数据/标签,特征组中的非结构化数据和标签 - 监督学习需要标签
- 其中的向量索引,向量索引
- 版本管理,特征组版本管理 - 特征组版本管理
- 写入,写入特征组 - 数据验证
- 特征哈希(feature hashing),编码类别变量
- 特征管道(feature pipelines),特征管道 - 特征管道
- 空气质量预报服务案例研究,特征管道 - 特征管道
- Feldera 与,Feldera 中的滞后特征和特征管道 - Feldera 中的滞后特征和特征管道
- 功能,AI 系统的统一架构:特征、训练和推理管道
- 与模型无关的变换和,特征管道 - 特征管道
- 测试,特征管道测试 - 特征管道测试
- TikTok 个性化推荐系统,特征管道 - 特征管道
- 编写流式特征管道,编写流式特征管道 - Feldera
- Apache Flink,Apache Flink
- 基准测试,Feldera
- 数据流编程,数据流编程
- Feldera,Feldera
- 无状态/有状态数据变换,无状态和有状态数据变换 - 无状态和有状态数据变换
- 特征平台(feature platform),特征存储简史
- 特征注册表(feature registry),AI 资产的发现和复用
- 特征复用(feature reuse),AI 资产的发现和复用
- 特征选择(feature selection),特征选择 - 特征选择
- 特征偏差(feature skew),消除离线-在线特征偏差
- 特征存储(一般),特征存储 - 小结与练习
- 解剖结构,特征存储的解剖结构 - 特征存储的解剖结构
- 简史,特征存储简史
- 使用特征存储的 AI 系统类别,使用特征存储的 AI 系统类别 - 本书使用的 ML 框架和 ML 基础设施
- 推理的数据模型,特征存储的推理数据模型 - 批推理
- 定义,特征存储
- 特征组,特征组 - 数据验证
- 使用特征存储的欺诈防护系统,面向欺诈预测的特征存储 - 面向欺诈预测的特征存储
- Hopsworks(见 Hopsworks 特征存储)
- Spine 数据帧中的标签,星型模式数据模型
- 使用特征视图读取特征数据,使用特征视图读取特征数据 - 使用特征视图进行在线推理
- 使用特征视图进行在线推理,使用特征视图进行在线推理
- 使用特征视图的时间点正确训练数据,使用特征视图的时间点正确训练数据 - 使用特征视图的时间点正确训练数据
- 用途,何时需要特征存储? - 在单一平台中集中 AI 数据
- 在单一平台中集中 AI 数据,在单一平台中集中 AI 数据 - 在单一平台中集中 AI 数据
- 实时 ML 系统中的上下文/历史,实时 ML 系统中的上下文和历史
- AI 资产的发现/复用,AI 资产的发现和复用
- 消除离线-在线特征偏差,消除离线-在线特征偏差
- ML 系统的治理,ML 系统的治理
- 借助 FTI 管道架构改善协作,借助 FTI 管道架构改善协作 - 借助 FTI 管道架构改善协作
- 时序数据,面向时序数据 - 面向时序数据
- 特征变换(feature transformations),特征变换 - 在特征组中存储变换后的特征数据
- 特征类型(feature types),特征类型和与模型相关的变换 - 特征类型和与模型相关的变换
- 特征视图(feature views),用 ML 管道构建的泰坦尼克号生存 ML 系统
- Hopsworks 特征存储,特征视图 - 在线推理数据
- 使用特征视图进行在线推理,使用特征视图进行在线推理
- 使用特征视图的时间点正确训练数据,使用特征视图的时间点正确训练数据 - 使用特征视图的时间点正确训练数据
- 使用特征视图读取特征数据,使用特征视图读取特征数据 - 使用特征视图进行在线推理
- 特征视图中的变换,特征视图中的变换 - 特征视图中的变换
- 特征/训练/推理(FTI)管道,AI 系统的统一架构:特征、训练和推理管道 - AI 系统的统一架构:特征、训练和推理管道,借助 FTI 管道架构改善协作 - 借助 FTI 管道架构改善协作
- 前馈神经网络(feed-forward neural NNs),模型架构
- Feldera,特征管道,Feldera
- 增量视图维护,带增量视图的滚动聚合
- 滞后特征/特征管道,Feldera 中的滞后特征和特征管道 - Feldera 中的滞后特征和特征管道
- Flink,Apache Flink
- 外键(foreign key),特征组
- 特征数据的新鲜度,特征管道
- FTI(特征/训练/推理)管道,AI 系统的统一架构:特征、训练和推理管道 - AI 系统的统一架构:特征、训练和推理管道,借助 FTI 管道架构改善协作 - 借助 FTI 管道架构改善协作
- 全量加载(full load),回填和增量更新
- 全表扫描(full table scan),批数据源
- 函数调用 LLM(function-calling LLMs),工具和函数调用 LLM,工具和函数调用 LLM
G
- GDPR(通用数据保护条例),可变数据
- 生成对抗网络(GAN),自监督和无监督学习
- GitHub Actions
- 在 GitHub Action 中运行 pytest,在 GitHub Action 中运行 pytest
- 为空气质量预报服务调度管道,将管道调度为 GitHub Action - 将管道调度为 GitHub Action
- GitHub Page,将仪表盘构建为 GitHub Page
- 全局窗口(global window),窗口聚合
- Google Cloud Composer,云提供商工作流编排器
- Google Colaboratory(Colab)笔记本,为 ML 管道编写模块化代码,探索性数据集分析
- 治理(governance),治理 - 审计日志
- GPU,用于故障恢复的检查点
- 图数据(graph data),图数据
- GraphRAG,使用图数据库检索
- Great Expectations,在 Hopsworks 中使用 Great Expectations 进行数据验证 - 在 Hopsworks 中使用 Great Expectations 进行数据验证
- 护栏(guardrails),护栏 - 护栏
H
- 硬件加速器(hardware accelerators),用于故障恢复的检查点
- 分层数据格式 5(Hierarchical Data Format 5,HDF5),训练数据
- Hive 风格分区(Hive-style partitioning),特征组
- 跳跃(滑动)窗口(hopping (sliding) windows),时间窗口聚合 - 时间窗口聚合
- Hopsworks
- 其中的智能体部署,Hopsworks 中的智能体部署 - Hopsworks 中的智能体部署
- 审计日志,审计日志
- 用于 Hopsworks 的 CI/CD 架构,从开发到生产 - 从开发到生产
- 使用 Great Expectations 进行数据验证,在 Hopsworks 中使用 Great Expectations 进行数据验证 - 在 Hopsworks 中使用 Great Expectations 进行数据验证
- 环境和作业,Hopsworks 中的环境和作业 - Hopsworks 中的环境和作业
- 第一个开源特征存储,特征存储简史
- 特征视图中的变换,特征视图中的变换 - 特征视图中的变换
- Hopsworks 特征存储,Hopsworks 特征存储 - 小结与练习
- 特征数据的更快查询,特征数据的更快查询 - 特征数据的更快查询
- 特征组,特征组 - 特征组的变更数据捕获
- 特征视图,特征视图 - 在线推理数据
- 项目,Hopsworks 项目 - 使用项目在集群级别实现访问控制
- 使用项目在集群级别实现访问控制,使用项目在集群级别实现访问控制 - 使用项目在集群级别实现访问控制
- 项目内的访问控制,项目内的访问控制
- 在项目中存储文件,在项目中存储文件
- Hopsworks 作业,Hopsworks 作业 - Hopsworks 作业
- 混合流批架构(hybrid streaming-batch architecture),混合流批架构 - 混合流批架构
- 超参数调优(hyperparameter tuning),随机、时序和分层切分,切分训练数据,使用 Ray Tune 进行超参数调优 - 使用 Ray Tune 进行超参数调优
I
- i2i(物品到物品)推荐,推荐系统简介
- 幂等性(idempotence),特征管道
- 不可变数据集(immutable datasets),可变数据
- 隐式模式(implicit schemas),特征组的隐式或显式模式
- 上下文学习(in-context learning),机器学习的类型,提示工程
- 增量加载(incremental load),回填与增量更新
- 增量查询(incremental queries),特征组中的数据版本控制与时间旅行
- 增量更新(incremental updates),回填与增量更新 - 在同一个程序中实现回填与增量处理
- 在同一个程序中实现回填/增量处理,在同一个程序中实现回填与增量处理
- 增量数据的轮询与 CDC,增量数据的轮询与 CDC - 变更数据捕获
- 增量视图,基于增量视图的滚动聚合,基于增量视图的滚动聚合 - 基于增量视图的滚动聚合
- 推理辅助列(inference helper columns),按需变换
- 推理管道(inference pipelines),推理管道 - 推理管道,推理管道 - 小结与练习
- 面向 LLM 的批推理,面向 LLM 的批推理 - 面向 LLM 的批推理
- 批推理管道,批推理管道 - 神经网络的批推理
- 神经网络的批推理,神经网络的批推理
- 针对实体的批预测,针对实体的批预测 - 针对实体的批预测
- 针对时间范围的批预测,针对时间范围的批预测 - 针对时间范围的批预测
- 批推理的数据建模,批推理的数据建模 - 批推理的数据建模
- 使用 PySpark 扩展批推理,使用 PySpark 扩展批推理 - 使用 PySpark 扩展批推理
- 定义,推理管道
- 功能,AI 系统的统一架构:特征、训练和推理管道
- 使用嵌入式模型的推理,使用嵌入式模型的推理 - 用 Python 为 AI 应用编写 UI
- 嵌入式 AI 应用,嵌入式 AI 应用
- 流处理 AI 应用,流处理 AI 应用 - 流处理 AI 应用
- 用 Python 为 AI 应用编写 UI,用 Python 为 AI 应用编写 UI - 用 Python 为 AI 应用编写 UI
- 使用 KServe 的模型服务框架,使用 KServe 的模型服务框架 - 使用 KServe 的模型服务框架
- 在线推理管道,在线推理管道 - 模型与特征视图的部署 API
- 模型与特征视图的部署 API,模型与特征视图的部署 API - 模型与特征视图的部署 API
- 确保库的离线-在线一致性,确保库的离线-在线一致性 - 确保库的离线-在线一致性
- LLM 部署,LLM 部署
- 使用 FastAPI 进行模型部署,使用 FastAPI 的模型部署 - 使用 FastAPI 的模型部署
- 性能与故障处理,性能与故障处理 - 模型部署 SLO
- 在线推理管道中的故障处理,在线推理管道中的故障处理 - 在线推理管道中的故障处理
- 混合模式 UDF,混合模式 UDF - 混合模式 UDF
- 模型部署 SLO,模型部署 SLO - 模型部署 SLO
- 原生 UDF/记录并等待,原生 UDF 与记录并等待
- 推理存储,定义,批推理管道
- 信息隐藏原则(information hiding principle),模型与特征视图的部署 API
- 摄入时间(ingestion time),特征组中的数据版本控制与时间旅行 - 特征组中的数据版本控制与时间旅行
- 内连接(inner joins),连接变换
- 指令数据集(instruction datasets),监督学习需要标签
- 交互式 ML 系统(见 实时 ML 系统)
- 可解释性(interpretability),模型可解释性
- 不变量(invariant),实现 pytest 单元测试
- 物品到物品(item-to-item,i2i)推荐,推荐系统简介
J
- 越狱(jailbreaking),越狱与提示注入
- 作业编排器(job orchestrators),作业编排器 - Hopsworks 作业
- Hopsworks 作业,Hopsworks 作业 - Hopsworks 作业
- Modal,Modal - Modal
- Jupyter 笔记本(Jupyter Notebooks),探索性数据集分析
K
- k 折交叉验证(k-fold cross-validation),切分训练数据
- k 近邻(k-nearest neighbor,kNN)算法,行和列大小缩减变换,自监督学习与无监督学习
- 看板(kanban board),定义,最小可行预测服务
- Kappa 架构,混合流批架构
- KPI 恶化(KPI degradation),监控特征与模型
- KServe,使用 KServe 的模型服务框架 - 使用 KServe 的模型服务框架
- Kubernetes 上的 KServe,在线模型的指标,在线模型的指标
L
- 标签编码(label encoding),编码类别变量
- 标签特征组(label feature groups),星型模式数据模型,根特征组与标签特征组 - 根特征组与标签特征组
- 标签偏移(label shift),监控特征与模型
- 标签相关变换(label-dependent transformations),目标/标签相关变换
- 标签(labels)
- 维度建模与,标签是事实,特征是维度
- Spine 数据帧,星型模式数据模型
- 特征组中的非结构化数据/标签,特征组中的非结构化数据与标签 - 监督学习需要标签
- 非结构化数据的标签,监督学习需要标签
- 自监督/无监督学习,自监督学习与无监督学习
- 监督学习与标签,监督学习需要标签 - 监督学习需要标签
- 湖仓表(lakehouse tables)
- 湖仓(lakehouse),在单一平台集中管理 AI 数据,批处理数据源
- Lambda 架构,混合流批架构
- 大语言模型(见 LLM 相关条目)
- 大型推理模型(large reasoning models,LRMs),提示工程,规划,智能体的日志记录与指标
- 惰性数据帧(Lazy DataFrames),惰性数据帧
- 惰性求值(lazy evaluation),惰性数据帧
- 左(外)连接(left (outer) joins),连接变换
- Lightly,作为基于模型的变换的数据清洗
- 李克特量表(Likert scale),智能体的 Evals
- 血缘(lineage),ML 系统的治理,血缘 - 血缘
- LlamaIndex,使用 LlamaIndex 构建智能体与工作流 - 使用 LlamaIndex 构建智能体与工作流
- LLM 工作流(LLM workflows),智能体与 LLM 工作流 - 小结与练习
- 与智能体的对比,从 LLM 工作流到智能体,规划
- 从 LLM 工作流到智能体的演进,从 LLM 工作流到智能体 - 领域特定(中间)表示
- 领域特定(中间)表示,领域特定(中间)表示
- 规划,规划 - 规划
- 安全挑战,安全挑战
- 从 LLM 到智能体的演进,从 LLM 到智能体 - 使用 LlamaIndex 构建智能体与工作流
- 使用 LlamaIndex 构建智能体与工作流,使用 LlamaIndex 构建智能体与工作流 - 使用 LlamaIndex 构建智能体与工作流
- 上下文窗口,上下文窗口 - 上下文窗口
- 提示工程,提示工程 - 提示工程
- 提示词管理,提示词管理 - 提示词管理
- 模型上下文协议,模型上下文协议 - 模型上下文协议
- 检索增强生成,检索增强生成 - 使用图数据库检索
- 工具/函数调用 LLM,工具与函数调用 LLM
- 何时使用,规划
- LLMOps,MLOps 与 LLMOps - MLOps 与 LLMOps
- LLM
- 批推理,面向 LLM 的批推理 - 面向 LLM 的批推理
- 在线推理管道的部署,LLM 部署
- 参数高效微调,LLM 的参数高效微调 - LLM 的参数高效微调
- 文本数据,对象存储与文件系统中的非结构化数据
- 对数变换(log transformations),变换数值变量,变换数值变量
- 逻辑模型(logical models),数据集市与 LLM 的逻辑模型 - 数据集市与 LLM 的逻辑模型
- 日志/日志记录(logs/logging)
- 智能体,智能体的日志记录与指标 - LLM 指标
- 定义,AI 系统的可观测性与监控
- ML 模型,ML 模型的日志记录与指标 - 批处理模型的指标
- 批处理与在线模型的日志记录,批处理与在线模型的日志记录 - 批处理与在线模型的日志记录
- 批处理模型的指标,批处理模型的指标 - 批处理模型的指标
- 在线模型的指标,在线模型的指标 - 在线模型的指标
- 长短期记忆(long short-term memory,LSTM)网络,模型架构
- LoRA,LLM 的参数高效微调
- 上下文丢失问题(lost context problem),检索增强生成
- Lovable,机器学习系统的剖析
- LRM(大型推理模型,large reasoning models),提示工程,规划,智能体的日志记录与指标
M
- 机器学习管道(machine learning pipelines),机器学习管道 - 小结
- 用 ML 管道构建 ML 系统,用 ML 管道构建 AI 系统 - 为 ML 管道编写模块化代码
- 最小可行预测服务,最小可行预测服务 - 最小可行预测服务
- 编写模块化代码,为 ML 管道编写模块化代码 - 为 ML 管道编写模块化代码
- 案例研究:泰坦尼克号生存预测,用 ML 管道构建的泰坦尼克号生存 ML 系统 - 用 ML 管道构建的泰坦尼克号生存 ML 系统
- 其中的数据变换,ML 管道中数据变换的分类法 - ML 变换分类法与 ML 管道
- 特征类型/与模型相关的变换,特征类型与模型相关变换 - 特征类型与模型相关变换
- ML 变换分类法,ML 变换分类法与 ML 管道 - ML 变换分类法与 ML 管道
- 用按需变换实现实时特征,用按需变换实现实时特征
- 用模型无关变换实现可复用特征,用模型无关变换实现可复用特征
- 特征管道,特征管道 - 特征管道
- FTI(特征/训练/推理)管道,AI 系统的统一架构:特征、训练和推理管道 - AI 系统的统一架构:特征、训练和推理管道
- 推理管道,推理管道 - 推理管道
- 训练管道,训练管道 - 训练管道
- 用 ML 管道构建 ML 系统,用 ML 管道构建 AI 系统 - 为 ML 管道编写模块化代码
- 机器学习系统(一般)
- ML 系统的剖析,机器学习系统的剖析 - 可变数据
- 构建基础,构建机器学习系统 - 本书使用的 ML 框架和 ML 基础设施
- 简史,机器学习系统简史 - 机器学习系统简史
- 带特征存储的 AI 系统类别,带特征存储的 AI 系统类别 - 本书使用的 ML 框架和 ML 基础设施
- 特征/训练/推理(FTI)管道,AI 系统的统一架构:特征、训练和推理管道 - AI 系统的统一架构:特征、训练和推理管道
- MLOps 与 LLMOps,MLOps 与 LLMOps - MLOps 与 LLMOps
- 掩码语言建模(masked language modeling),自监督学习与无监督学习
- 掩码(masking),机器学习的类型
- MCP(模型上下文协议,Model Context Protocol),机器学习系统简史,模型上下文协议 - 模型上下文协议,智能体到智能体(A2A)协议
- MDT(见 与模型相关的变换)
- K 处的平均精度均值(mean average precision at K,MAP@K),排序模型
- 平均倒数排名(mean reciprocal rank,MRR),排序模型
- 指标注册表(metrics registry),在线模型的指标
- 指标,定义,AI 系统的可观测性与监控
- Michelangelo,机器学习系统简史,特征存储简史
- 最小可行预测服务(minimal viable prediction service,MVPS),最小可行预测服务 - 最小可行预测服务
- 最小可行产品(minimum viable product,MVP),MLOps 与 LLMOps
- MIT(见 与模型无关的变换)
- ML 管道,定义,机器学习管道
- ML 系统与 AI 系统对比,机器学习系统简史
- MLOps
- 十二大谬误,MLOps 的十二大谬误 - MLOps 的十二大谬误
- ML 系统架构的演进与,MLOps 与 LLMOps - MLOps 与 LLMOps
- Modal
- 作业编排,Modal - Modal
- 管道调度,将管道调度为 GitHub Action
- 模型卡(model cards),模型卡 - 模型卡
- 模型上下文协议(Model Context Protocol,MCP),机器学习系统简史,模型上下文协议 - 模型上下文协议,智能体到智能体(A2A)协议
- 模型部署管道(model deployment pipeline),训练管道
- 模型部署(model deployments),特征存储的解剖结构,测试模型部署 - 测试模型部署
- 模型评估/验证(model evaluation/validation),模型评估与模型验证 - 模型卡
- 模型偏见测试,模型偏见测试
- 模型卡,模型卡 - 模型卡
- 模型评估管道,训练管道
- 模型文件格式与模型注册表,模型文件格式与模型注册表
- 模型可解释性,模型可解释性
- 分类与回归的模型性能,分类与回归的模型性能
- 模型可解释性(model interpretability),模型可解释性
- 模型注册表(model registry),模型文件格式与模型注册表
- KServe 模型服务框架,使用 KServe 的模型服务框架 - 使用 KServe 的模型服务框架
- 模型训练(model training),模型训练 - 识别分布式训练中的瓶颈
- 用于故障恢复的检查点,用于故障恢复的检查点
- 使用 XGBoost 的信用卡欺诈模型,使用 XGBoost 的信用卡欺诈模型 - 使用 XGBoost 的信用卡欺诈模型
- 使用 Ray 进行分布式训练,使用 Ray 进行分布式训练 - 使用 Ray 进行分布式训练
- 使用 Ray Tune 进行超参数调优,使用 Ray Tune 进行超参数调优 - 使用 Ray Tune 进行超参数调优
- 识别分布式训练中的瓶颈,识别分布式训练中的瓶颈 - 识别分布式训练中的瓶颈
- 模型架构,模型架构 - 模型架构
- LLM 的参数高效微调,LLM 的参数高效微调 - LLM 的参数高效微调
- 模型验证管道(model validation pipeline),模型评估与模型验证
- 基于模型的清洗(model-based cleaning),作为基于模型的变换的数据清洗
- 基于模型的漂移检测(model-based drift detection),监控特征与模型
- 以模型为中心的 AI(model-centric AI),训练管道
- 与模型相关的变换(model-dependent transformations,MDTs),特征类型与模型相关变换,与模型相关的变换和按需变换 - 特征视图中的变换
- 确保库的离线-在线一致性,确保库的离线-在线一致性 - 确保库的离线-在线一致性
- 特征偏差与,消除离线-在线特征偏差
- 特征变换,特征变换 - 在特征组中存储变换后的特征数据
- Hopsworks,模型依赖转换
- 与 MIT 的对比,ML 变换分类法与 ML 管道
- 模型特定变换,模型特定变换 - LLM 的 tokenizer 与聊天模板
- 特征视图中的变换,特征视图中的变换 - 特征视图中的变换
- Scikit-Learn 管道中的变换,Scikit-Learn 管道中的变换 - Scikit-Learn 管道中的变换
- 写放大与,特征组存储未变换的特征数据
- 与模型无关的变换(model-independent transformations,MITs),特征存储的解剖结构,与模型无关的变换 - 小结与练习
- 变换的组合,变换的组合 - 变换的组合
- 信用卡欺诈检测特征,信用卡欺诈特征 - 信用卡欺诈特征
- 特征函数的 DAG,特征函数的有向无环图(DAG) - 特征组的隐式或显式模式
- 面向数据帧的数据变换,面向数据帧的数据变换 - 连接变换
- 特征管道,特征管道 - 特征管道
- 惰性数据帧,惰性数据帧
- 与 MDT 的对比,ML 变换分类法与 ML 管道
- 可复用特征,用模型无关变换实现可复用特征
- 源代码组织,源代码组织 - 源代码组织
- 模型并行训练(model-parallel training),使用 Ray 进行分布式训练
- 模型特定变换(model-specific transformations),模型特定变换 - LLM 的 tokenizer 与聊天模板
- 作为基于模型的变换的数据清洗,作为基于模型的变换的数据清洗
- 昂贵特征按需计算,昂贵特征在需要时计算
- 填补缺失值,填补缺失值 - 填补缺失值
- 离群值处理方法,离群值处理方法
- 目标/标签相关变换,目标/标签相关变换
- LLM 的 tokenizer/聊天模板,LLM 的 tokenizer 与聊天模板
- ML 管道的模块化代码,为 ML 管道编写模块化代码 - 为 ML 管道编写模块化代码
- 模块化(modularity),AI 系统的统一架构:特征、训练和推理管道
- 监控(见 可观测性与监控)
- 单仓库(monorepo),源代码组织
- 多变量特征漂移(multivariate feature drift),多变量特征漂移 - 多变量特征漂移
- 可变数据(mutable data),可变数据 - 可变数据
- MVP(最小可行产品),MLOps 与 LLMOps
- MVPS(见 最小可行预测服务)
N
- NannyML,多变量特征漂移,使用 NannyML 进行模型监控 - 使用 NannyML 进行模型监控
- 自然语言处理(natural language processing,NLP)
- 自监督学习与,机器学习的类型
- 文本数据,对象存储与文件系统中的非结构化数据
- Netflix 的检索-排序架构,实时个性化推荐系统
- 神经网络的批推理,神经网络的批推理
- 归一化公式,变换数值变量
- 归一化折损累积增益(normalized discounted cumulative gain,NDCG),排序模型
- 笔记本作为 ML 管道,为 ML 管道编写模块化代码
- NPY 文件格式,训练数据
- 数值变量(numerical variables),ML 管道中数据变换的分类法
O
- 可观测性与监控(observability and monitoring),AI 系统的可观测性与监控 - 总结与练习
- 智能体的日志记录与指标,智能体的日志记录与指标 - LLM 指标
- ML 模型的日志记录与指标,ML 模型的日志记录与指标 - 批处理模型的指标
- 批处理与在线模型的日志记录,批处理与在线模型的日志记录 - 批处理与在线模型的日志记录
- 批处理模型的指标,批处理模型的指标 - 批处理模型的指标
- 在线模型的指标,在线模型的指标 - 在线模型的指标
- 监控特征与模型,监控特征与模型 - 何时重训或重新设计模型
- 数据摄入漂移,数据摄入漂移 - 数据摄入漂移
- 使用 NannyML 进行模型监控,使用 NannyML 进行模型监控 - 使用 NannyML 进行模型监控
- 监控向量嵌入,监控向量嵌入
- 多变量特征漂移,多变量特征漂移 - 多变量特征漂移
- 单变量特征漂移,单变量特征漂移
- 何时重训或重新设计模型,何时重训或重新设计模型
- ODT(见 按需变换)
- 离线存储(offline stores),在单一平台集中管理 AI 数据,离线存储(湖仓表) - 数据统计
- 离线测试(offline testing),离线测试
- 离线-在线偏差(offline-online skew),消除离线-在线特征偏差,混合流批架构
- 按需特征(on-demand features),ML 变换分类法与 ML 管道
- 按需 SQL 变换(on-demand SQL transformations),右移架构
- 按需变换(on-demand transformations,ODTs),特征存储的解剖结构,按需变换
- 确保库的离线-在线一致性,确保库的离线-在线一致性 - 确保库的离线-在线一致性
- 特征偏差与,消除离线-在线特征偏差
- 与 MDT 的对比,ML 变换分类法与 ML 管道
- 实时特征,用按需变换实现实时特征
- 变换函数与,在线推理数据
- 单张大表(one big table,OBT)数据模型,特征组的数据模型
- 在线推理(online inference),在线推理,使用特征视图进行在线推理
- 在线推理数据(online inference data),在线推理数据
- 在线推理管道(online inference pipelines),推理管道,在线推理管道 - 模型与特征视图的部署 API
- 模型与特征视图的部署 API,模型与特征视图的部署 API - 模型与特征视图的部署 API
- 确保库的离线-在线一致性,确保库的离线-在线一致性 - 确保库的离线-在线一致性
- LLM 部署,LLM 部署
- 使用 FastAPI 进行模型部署,使用 FastAPI 的模型部署 - 使用 FastAPI 的模型部署
- TikTok 个性化推荐系统,在线推理管道 - 在线推理管道
- 在线 ML 模型的指标,在线模型的指标 - 在线模型的指标
- 在线模型的日志记录,批处理与在线模型的日志记录 - 批处理与在线模型的日志记录
- 在线存储(online store),在单一平台集中管理 AI 数据
- 开放表格式(open table formats,OTFs),在单一平台集中管理 AI 数据
- OpenTelemetry,在线模型的指标
- 编排(见 作业编排器)
- 外连接(outer joins),连接变换
P
- Pandas,特征管道,填补缺失值
- 并行化编排(parallelized orchestration),从 LLM 工作流到智能体
- 参数高效微调(parameter-efficient fine-tuning,PEFT),LLM 的参数高效微调
- Parquet 文件格式,训练数据
- 管道,定义,机器学习管道
- Polars,特征管道
- 轮询(polling),轮询
- pytest 单元测试中的后置条件/前置条件,实现 pytest 单元测试
- 前置条件(precondition),实现 pytest 单元测试
- 预测漂移(prediction drift),监控特征与模型
- 预测器脚本(predictor script),模型与特征视图的部署 API,模型与特征视图的部署 API
- 偏好数据集(preference datasets),监督学习需要标签
- 主键(primary key),特征组
- 投影下推(projection pushdown),特征数据的更快查询
- Hopsworks 项目,Hopsworks 项目 - 使用项目在集群级别实现访问控制
- 使用项目在集群级别实现访问控制,使用项目在集群级别实现访问控制 - 使用项目在集群级别实现访问控制
- 项目内的访问控制,项目内的访问控制
- 在项目中存储文件,在项目中存储文件
- Prometheus,在线模型的指标
- 提示链(prompt chaining),从 LLM 工作流到智能体
- 提示分解(prompt decomposition),提示工程
- 提示工程(prompt engineering),提示工程 - 提示工程
- 提示注入(prompt injection),越狱与提示注入
- 提示模板(prompt template),提示词管理
- PySpark
- 填补缺失的时序数据,填补缺失值
- 使用 PySpark 扩展批推理,使用 PySpark 扩展批推理 - 使用 PySpark 扩展批推理
- pytest,使用 pytest - 测试方法论
- 测试方法论,测试方法论
- 单元测试,单元测试 - 作为 GitHub Action 的一部分运行 pytest
- 用 Python 为 AI 应用编写 UI,用 Python 为 AI 应用编写 UI - 用 Python 为 AI 应用编写 UI
- PyTorch 变换,PyTorch 变换 - PyTorch 变换
Q
R
- RAG(见 检索增强生成)
- 随机切分(random splits),随机、时序和分层切分
- Ray,使用 Ray 进行分布式训练 - 使用 Ray 进行分布式训练
- Ray Data,使用 Ray 进行分布式训练
- Ray Tune,使用 Ray Tune 进行超参数调优 - 使用 Ray Tune 进行超参数调优
- RBAC(基于角色的访问控制,role-based access control),项目内的访问控制,使用项目在集群级别实现访问控制
- 实时数据变换(real-time data transformations),ML 管道中数据变换的分类法
- 实时特征(real-time features),用按需变换实现实时特征
- (另见 流式特征)
- 交互式 AI 系统与,交互式 AI 系统需要实时特征 - 交互式 AI 系统需要实时特征
- 左移还是右移,左移还是右移? - 流原生架构
- 实时 ML 系统(real-time ML systems),机器学习系统简史
- 定义,带特征存储的 AI 系统类别
- 特征存储与,实时 ML 系统的上下文与历史
- 其中的实时数据变换,ML 管道中数据变换的分类法
- 雪花模式与星型模式对比,雪花模式数据模型
- TikTok 推荐引擎,机器学习系统的剖析
- 倒数变换公式,变换数值变量
- 推荐系统(见 TikTok 个性化推荐系统)
- 回归模型(regression models),分类与回归的模型性能
- 强化学习(reinforcement learning),机器学习的类型
- 基于人类反馈的强化学习(reinforcement learning with human feedback,RLHF),监督学习需要标签,LLM 的参数高效微调
- 重排序(reranking),检索增强生成
- REST API,审计日志
- 检索-排序架构(retrieval-and-ranking architecture),基于检索-排序架构的 TikTok 推荐系统 - 基于检索-排序架构的 TikTok 推荐系统
- 检索增强生成(retrieval-augmented generation,RAG),机器学习系统简史 - 机器学习系统简史,从 LLM 到智能体,检索增强生成 - 使用图数据库检索
- 历史 eval 的时间点正确数据,历史 eval 需要时间点正确的 RAG 数据
- 使用文档存储检索,使用文档存储检索 - 使用文档存储检索
- 使用特征存储检索,使用特征存储检索
- 使用图数据库检索,使用图数据库检索
- 环形全归约(ring all-reduce)架构,识别分布式训练中的瓶颈
- RLHF(基于人类反馈的强化学习),监督学习需要标签,LLM 的参数高效微调
- 基于角色的访问控制(role-based access control,RBAC),项目内的访问控制,使用项目在集群级别实现访问控制
- 角色扮演(提示工程策略),提示工程
- 滚动聚合(rolling aggregations),滚动聚合 - 滚动聚合
- 增量视图与,基于增量视图的滚动聚合 - 基于增量视图的滚动聚合
- 分块时间窗口聚合与,信用卡欺诈流式特征
- RonDB 在线特征存储,在线存储
- 根特征组(root feature groups),根特征组与标签特征组 - 根特征组与标签特征组
- 路由 LLM 工作流(routing LLM workflow),从 LLM 工作流到智能体
- 路由模式(routing pattern),从 LLM 工作流到智能体
S
- 可扩展性(scalability),特征管道
- SCD(缓慢变化维度,slowly changing dimensions),使用信用卡数据集市进行维度建模,特征存储与 SCD 类型 - 特征存储与 SCD 类型
- 特征组的模式,特征组的隐式或显式模式
- 模式化标签(schematized tags),模式化标签 - 模式化标签
- Scikit-Learn
- 非时序数据的插补,填补缺失值
- 离群值处理,离群值处理方法
- Scikit-Learn 管道中的变换,Scikit-Learn 管道中的变换 - Scikit-Learn 管道中的变换
- 搜索引擎(search engine),使用文档存储检索
- 智能体的安全挑战,安全挑战
- 自监督学习(self-supervised learning),机器学习的类型
- 服务键(serving keys),创建特征视图
- 会话窗口(session window),窗口化聚合
- SFT(监督微调,supervised fine-tuning),监督学习需要标签,LLM 的参数高效微调
- 左移架构(shift-left architectures),左移架构 - 流原生架构
- 右移架构(shift-right architectures),右移架构 - 右移架构
- 汇(sink),定义,事件流平台
- 缓慢变化维度(slowly changing dimensions,SCDs),使用信用卡数据集市进行维度建模,特征存储与 SCD 类型 - 特征存储与 SCD 类型
- 雪花模式数据模型(snowflake schema data model),雪花模式数据模型
- 软件即服务(software-as-a-service,SaaS)系统,API 抓取的数据
- Spark Structured Streaming,特征管道
- Spine 数据帧(Spine DataFrame),星型模式数据模型,针对实体的批预测
- Spine 组(Spine Group),批推理数据
- 切分训练数据(splitting training data),随机、时序和分层切分,切分训练数据 - 切分训练数据
- Spotify 每周发现(Spotify Discovery Weekly),机器学习系统的剖析
- SQL
- 稳定扩散网络(stable diffusion networks),自监督学习与无监督学习
- 标准化公式,变换数值变量
- 星型模式数据模型(star schema data model),星型模式数据模型 - 星型模式数据模型
- 有状态数据变换(stateful data transformations),流原生架构,无状态与有状态数据变换
- 无状态数据变换(stateless data transformations),流原生架构,无状态与有状态数据变换 - 无状态与有状态数据变换
- 无状态在线 ML 系统(stateless online ML systems),机器学习系统简史
- 统计假设检验方法(statistical hypothesis testing methods),监控特征与模型
- 随机梯度下降(stochastic gradient descent),模型架构
- 分层切分(stratified splits),随机、时序和分层切分,切分训练数据
- 流处理特征管道(stream processing feature pipelines),特征管道
- 流处理 ML 系统,定义,带特征存储的 AI 系统类别
- 流处理 AI 应用(stream-processing AI-enabled applications),流处理 AI 应用 - 流处理 AI 应用
- 流式数据管道,定义,批处理特征管道
- 流式特征(streaming features),流式与实时特征 - 小结与练习
- 背压,流原生架构
- 信用卡欺诈流式特征,信用卡欺诈流式特征 - Feldera 中的滞后特征与特征管道
- ASOF 连接与变换组合,ASOF 连接与变换组合 - ASOF 连接与变换组合
- Feldera 中的滞后特征/特征管道,Feldera 中的滞后特征与特征管道 - Feldera 中的滞后特征与特征管道
- 事件流平台,事件流平台
- 交互式 AI 系统需要实时特征,交互式 AI 系统需要实时特征 - 交互式 AI 系统需要实时特征
- 左移还是右移,左移还是右移? - 流原生架构
- 窗口化聚合,窗口化聚合 - 基于增量视图的滚动聚合
- 为聚合选择最佳窗口类型,为聚合选择最佳窗口类型
- 滚动聚合,滚动聚合 - 滚动聚合
- 基于增量视图的滚动聚合,基于增量视图的滚动聚合 - 基于增量视图的滚动聚合
- 时间窗口聚合,时间窗口聚合 - 为聚合选择最佳窗口类型
- 编写流式特征管道,编写流式特征管道 - Feldera
- Apache Flink,Apache Flink
- 基准测试,Feldera
- 数据流编程,数据流编程
- Feldera,Feldera
- 无状态/有状态数据变换,无状态与有状态数据变换 - 无状态与有状态数据变换
- 流原生架构(streaming-native architecture),流原生架构 - 流原生架构
- 字符串到数值表示的变换,ML 管道中数据变换的分类法
- 结构化数据(structured data),非结构化数据
- 结构化输出(structured output),提示工程
- 监督微调(supervised fine-tuning,SFT),监督学习需要标签,LLM 的参数高效微调
- 监督学习(supervised learning),机器学习的类型
- 合成数据(synthetic data)
- 生成合成数据的 LLM 提示词,用于生成合成数据的 LLM 提示词 - 用于生成合成数据的 LLM 提示词
- LLM 与,使用 LLM 生成合成信用卡数据 - 用于生成合成数据的 LLM 提示词
- 数据集市与 LLM 的逻辑模型,数据集市与 LLM 的逻辑模型 - 数据集市与 LLM 的逻辑模型
- LLM 辅助生成合成 eval,LLM 辅助的合成 eval 生成 - LLM 辅助的合成 eval 生成
T
- 表格数据(tabular data),表格数据
- 模式化标签,模式化标签 - 模式化标签
- 目标相关变换(target-dependent transformations),目标/标签相关变换
- 任务并行(task parallelism),数据流编程
- 时间连接(temporal joins),时序数据,使用特征视图创建时间点正确的训练数据
- 张量并行(tensor parallelism),使用 Ray 进行分布式训练
- 张量(tensors),数组、结构体、映射和张量 - 数组、结构体、映射和张量
- 基于词项的检索方法(term-based retrieval method),使用文档存储检索
- 测试 AI 系统(testing AI systems),测试 AI 系统 - 总结与练习
- 自动容器化与作业,自动容器化与作业 - Modal 作业
- Hopsworks 中的环境和作业,Hopsworks 中的环境与作业 - Hopsworks 中的环境与作业
- Modal 作业,Modal 作业
- CI/CD 测试,AI 系统的 CI/CD 测试 - 历史 eval 需要时间点正确的 RAG 数据
- 批量推理的 A/B 测试,批量推理的 A/B 测试
- 智能体的 Evals,智能体的 Evals - 历史 eval 需要时间点正确的 RAG 数据
- 特征管道测试,特征管道测试 - 特征管道测试
- 测试模型部署,测试模型部署 - 测试模型部署
- 模型性能与偏差的训练管道测试,模型性能与偏差的训练管道测试 - 模型性能与偏差的训练管道测试
- 从开发到生产的代码推进,从开发到生产 - 从开发到生产
- 治理,治理 - 审计日志
- 离线测试,离线测试
- 在线 A/B 测试,在线 A/B 测试
- 自动容器化与作业,自动容器化与作业 - Modal 作业
- 测试 ML 系统(testing ML systems),MLOps 与 LLMOps
- 文本分块(text chunking),LLM 的 tokenizer 与聊天模板
- 文本数据(text data),对象存储与文件系统中的非结构化数据
- 文本分词(text tokenization),LLM 的 tokenizer 与聊天模板
- TFRecord 文件格式,数组、结构体、映射和张量,训练数据
- TikTok 个性化推荐系统,TikTok 的个性化推荐系统:世界上最有价值的 AI 系统 - 小结
- 分块时间窗口聚合(tiled time window aggregations),信用卡欺诈流式特征
- 生存时间(time to live,TTL),生存时间(Time to live),右移架构
- 时间窗口聚合(time window aggregations),时间窗口聚合 - 为聚合选择最佳窗口类型
- 面向时序数据的特征存储,时序数据 - 时序数据
- 时序切分(time-series splits),随机、时序和分层切分
- 时间旅行(time-travel),特征组中的数据版本控制与时间旅行
- 泰坦尼克号乘客数据集,可变数据
- 泰坦尼克号生存预测案例研究,用 ML 管道构建的泰坦尼克号生存 ML 系统 - 用 ML 管道构建的泰坦尼克号生存 ML 系统
- tokenizer(分词器),LLM 的 tokenizer 与聊天模板
- 主题(Apache Kafka 队列),流式数据源
- 追踪(traces),智能体的 Evals,从日志到智能体追踪
- 训练数据(training data),训练数据 - 可复现的训练数据
- 数据帧或文件,训练数据:DataFrame 或文件 - 可复现的训练数据
- 随机/时序/分层切分,随机、时序和分层切分
- 可复现,可复现的训练数据
- 可复现的训练数据,可复现的训练数据
- 切分,切分训练数据 - 切分训练数据
- 训练数据集管道(training dataset pipeline),训练管道
- 训练辅助列(training helper columns),模型偏见测试
- 训练管道(training pipelines),训练管道 - 训练管道,训练管道 - 小结与练习
- 空气质量预报服务案例研究,训练管道 - 训练管道
- 特征选择,特征选择 - 特征选择
- 功能,AI 系统的统一架构:特征、训练和推理管道
- 模型评估与模型验证,模型评估与模型验证 - 模型卡
- 模型偏见测试,模型偏见测试
- 模型卡,模型卡 - 模型卡
- 模型文件格式与模型注册表,模型文件格式与模型注册表
- 模型可解释性,模型可解释性
- 分类与回归的模型性能,分类与回归的模型性能
- 模型训练,模型训练 - 识别分布式训练中的瓶颈
- 用于故障恢复的检查点,用于故障恢复的检查点
- 使用 XGBoost 的信用卡欺诈模型,使用 XGBoost 的信用卡欺诈模型 - 使用 XGBoost 的信用卡欺诈模型
- 使用 Ray 进行分布式训练,使用 Ray 进行分布式训练 - 使用 Ray 进行分布式训练
- 使用 Ray Tune 进行超参数调优,使用 Ray Tune 进行超参数调优 - 使用 Ray Tune 进行超参数调优
- 识别分布式训练中的瓶颈,识别分布式训练中的瓶颈 - 识别分布式训练中的瓶颈
- 模型架构,模型架构 - 模型架构
- LLM 的参数高效微调,LLM 的参数高效微调 - LLM 的参数高效微调
- 根特征组与标签特征组,根特征组与标签特征组 - 根特征组与标签特征组
- 模型性能与偏差的测试,模型性能与偏差的训练管道测试 - 模型性能与偏差的训练管道测试
- TikTok 个性化推荐系统,训练管道 - 排序模型
- 训练数据,训练数据 - 可复现的训练数据
- 特征组中的非结构化数据与标签,特征组中的非结构化数据与标签 - 监督学习需要标签
- 非结构化数据的标签,监督学习需要标签
- 自监督/无监督学习,自监督学习与无监督学习
- 监督学习与标签,监督学习需要标签 - 监督学习需要标签
- 变换(transformations),用按需变换实现实时特征
- (另见 特定类型,例如:按需变换)
- 特征类型/与模型相关的变换,特征类型与模型相关变换 - 特征类型与模型相关变换
- ML 管道,ML 管道中数据变换的分类法 - ML 变换分类法与 ML 管道
- 用按需变换实现实时特征,用按需变换实现实时特征
- 用模型无关变换实现可复用特征,用模型无关变换实现可复用特征
- 标准化与归一化对比,变换数值变量
- 分类法,ML 变换分类法与 ML 管道 - ML 变换分类法与 ML 管道
- 变换后的特征数据,特征组存储未变换的特征数据
- Transformer,模型架构
- 基于树的模型(tree-based models),变换数值变量,模型架构
- TTL(生存时间),生存时间(Time to live),右移架构
- 翻滚窗口(tumbling windows),时间窗口聚合 - 时间窗口聚合
- 双塔嵌入模型(two-tower embedding model),双塔嵌入模型 - 双塔嵌入模型
U
- u2i(用户到物品)推荐,推荐系统简介
- Uber(Michelangelo 平台),机器学习系统简史,特征存储简史
- UDF(见 用户自定义函数)
- UDTF(用户自定义表函数,user-defined table functions),行/列大小增扩变换
- 单变量特征漂移(univariate feature drift),单变量特征漂移
- 非结构化数据(unstructured data),非结构化数据
- 标签,监督学习需要标签
- 对象存储/文件系统,对象存储与文件系统中的非结构化数据 - 对象存储与文件系统中的非结构化数据
- 无监督学习(unsupervised learning),机器学习的类型
- 用户自定义函数(user-defined functions,UDFs),模型依赖转换
- 混合模式,混合模式 UDF - 混合模式 UDF
- 原生 UDF/记录并等待,原生 UDF 与记录并等待
- 用户自定义表函数(user-defined table functions,UDTFs),行/列大小增扩变换
- 用户到物品(user-to-item,u2i)推荐,推荐系统简介
V
- 向量嵌入管道(vector embedding pipeline),特征管道,构建视频向量索引
- 向量嵌入(vector embeddings),行和列大小缩减变换,监控向量嵌入
- 向量索引(vector indexes),向量索引 - 向量索引
- 向量化计算引擎(vectorized compute engines),向量化计算、多核与 Arrow - 向量化计算、多核与 Arrow
- 可验证的 eval(verifiable evals),评估策展
- 版本控制(versioning),MLOps 与 LLMOps,特征组版本控制 - 特征组版本控制,版本化 - 版本化
W
- 弱监督(weak supervision),监督学习需要标签
- 窗口化聚合(windowed aggregations),实时信用卡欺诈检测 ML 系统
- 为聚合选择最佳窗口类型,为聚合选择最佳窗口类型
- 滚动聚合,滚动聚合 - 滚动聚合
- 基于增量视图的滚动聚合,基于增量视图的滚动聚合 - 基于增量视图的滚动聚合
- 时间窗口聚合,时间窗口聚合 - 时间窗口聚合
- 写放大(write amplification),特征组存储未变换的特征数据,批推理的数据建模
- 写入-审计-发布(write-audit-publish,WAP)模式,在 Hopsworks 中使用 Great Expectations 进行数据验证
X
- 使用 XGBoost 进行模型训练,使用 XGBoost 的信用卡欺诈模型 - 使用 XGBoost 的信用卡欺诈模型
关于作者
**Jim Dowling 是 Hopsworks 的首席执行官,曾任瑞典皇家理工学院(KTH Royal Institute of Technology)副教授。他领导了 Hopsworks 的开发,包括第一个用于机器学习的开源特征存储。他在数据与 AI 的交汇领域拥有独特的背景。在数据方面,他曾就职于 MySQL,之后领导了 HopsFS 的开发——这是一个分布式文件系统,于 2017 年荣获 IEEE 规模奖(IEEE Scale Prize)。在 AI 方面,他的博士论文引入了协作强化学习(collaborative reinforcement learning),并于 2016 年在瑞典开发并讲授了第一门深度学习课程。他还发布了一门广受欢迎的、使用 Python 的无服务器机器学习在线课程,网址为 serverless-ml.org。这种数据与 AI 相结合的背景,帮助他实现了基于通用编程语言构建机器学习特征存储的愿景,而不是像 Uber 早先在 DSL 上开展的特征存储工作。他是特征存储最早的布道者,通过行业会议(如 Data/AI Summit、PyData 和 OSDC)上的演讲以及关于特征存储的教育文章,帮助开创了特征存储这一产品类别。他是年度特征存储峰会(feature store summit)大会和 featurestore.org 社区的组织者,同时也是 PyData 斯德哥尔摩(PyData Stockholm)的联合组织者。
版权说明(Colophon)
《使用特征存储构建机器学习系统》(Building Machine Learning Systems with a Feature Store)封面上的动物是一只红胸侏儒鹦鹉(red-breasted pygmy parrot,学名 Micropsitta bruijnii),原产于马鲁古群岛(Maluku Islands)和美拉尼西亚(Melanesia)。
这只鹦鹉属于体型最小的鹦鹉属,平均体长八厘米(略超过三英寸)。与许多其他侏儒鹦鹉不同,它生活在高海拔环境中,在树洞或树桩中筑巢。它以地衣为食,行动短促而急促,经常沿着树皮攀爬。与许多鸟类一样,红胸侏儒鹦鹉表现出性别二态性(sexual dimorphism),雄性与雌性外观不同:两者都是绿色,但雄性有红色胸部和粉橙色喉咙,而雌性主要为绿色,带有蓝色冠羽和白色面部。
它的寿命与其他小型鹦鹉相似,最长可达十年。与某些其他鹦鹉不同,这个物种在人工饲养下表现不佳。其 IUCN 保护等级为无危(Least Concern)。奥莱利(O’Reilly)封面上的许多动物都处于濒危状态;它们对世界都很重要。
封面插图由 José Marzan Jr. 绘制,基于《利德克皇家自然史》(Lydekker’s Royal Natural History)中的一幅古董线雕版画。系列设计由 Edie Freedman、Ellie Volckhausen 和 Karen Montgomery 完成。封面字体为 Gilroy Semibold 和 Guardian Sans;正文字体为 Adobe Minion Pro;标题字体为 Adobe Myriad Condensed;代码字体为 Dalton Maag 的 Ubuntu Mono。