测试 AI 系统
MLOps 是一套最佳实践,用于对驱动我们 AI 系统的 ML 管道和 ML 资产进行自动化测试、版本控制和监控。我们在第1章介绍了 MLOps,在第6章介绍了数据验证测试(data validation test),在第7章介绍了转换函数的单元测试(unit test)。但还有更多内容需要覆盖。如果你要构建一个可靠、可控、可维护的 AI 系统,你需要为每条 ML 管道编写集成测试(integration test),并在开发期间和部署之前运行它们。我们将研究如何编写特征管道测试(feature pipeline test)和模型验证测试(model validation test),以及如何测试模型部署。我们将研究如何在开发、预发布(staging)和生产环境中通过自动容器化(automatic containerization)可靠地打包我们的 ML 管道。我们还将介绍如何使用 evals(评估)对智能体和 LLM 工作流进行离线测试。
测试是构建高质量 AI 系统的关键。你的测试应该达到这样的水平:你对测试如此有信心,以至于你会在周五部署到生产环境。即使一次升级失败,你也能轻松回滚你的更改。在下一章中,我们将关注 MLOps 的运维问题,但在本章中,我们将研究开发期间运行的测试以及如何自动化 AI 系统的离线测试。
离线测试
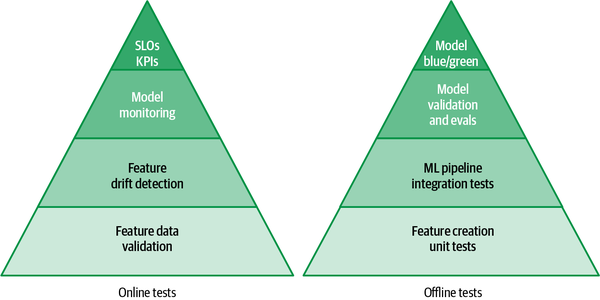
构建可靠 AI 系统的起点是测试。AI 系统比传统软件系统需要更多的测试层级。数据或代码中的小 bug 很容易让 ML 模型默默做出错误的预测。AI 系统需要大量的工程工作来测试和验证,以确保它们产生无偏差的高质量预测。当 AI 系统部署后,它们还需要被监控,以发现坏数据、漂移(drift)、违反服务级别目标(SLO)或关键绩效指标(KPI)下降。图 13-1 中的测试金字塔(testing pyramid)表明,在整个 AI 系统生命周期中,既需要离线测试,也需要在线(运行)检查。
两个测试金字塔展示了 AI 系统所需的离线测试和在线测试层级,强调同时测试数据和代码以确保可靠性和性能的重要性。
它们之所以被称为测试金字塔,是因为大多数测试位于底层(特征函数的单元测试和特征组的数据验证测试),而顶层(模型部署的蓝绿测试以及模型部署的 SLO 和 KPI)的测试较少。我们已经在第6章和第7章中覆盖了两个金字塔的底层,在本章中,我们将覆盖离线测试金字塔的其余部分。
这些测试金字塔可能令人望而生畏,尤其是如果你没有软件工程背景。重要的一点是,对 CI/CD 自动化测试的支持并不是开始构建 AI 系统的先决条件。自动化测试的支持可以在你构建了第一个 MVP(minimum viable product,最小可行产品)之后再加进来,以验证你所构建的东西值得维护。逐步为你构建的 AI 系统添加测试是可以的。你可以从特征函数和转换的单元测试开始,然后为特征管道和训练管道(包括模型性能和模型偏差测试)添加集成测试。然后,你可以通过添加 CI 支持来实现测试自动化,每当你向源代码仓库推送代码时就运行你的测试。
从开发到生产
你的 ML 管道代码应该经历一段旅程:从开发(你的笔记本电脑)到预发布(staging,集中式自动化测试)再到生产(部署)。为此,你需要基础设施支持,以及开发、预发布和生产的不同环境。开发和测试 ML 管道所需的基础设施服务包括:
- 用于 ML 管道源代码的版本控制(version control,源代码仓库)
- 一个 CI/CD 服务,可以从版本控制中检出代码、运行测试并部署工件(artifact)
- 一个工件仓库(artifact repository),例如 Python 的 PyPI 服务器或 Java 的 Maven 仓库,用于存储和提供构建容器所用的库
- 一个容器注册表(container registry),用于存储 ML 管道的容器
- 一个特征存储(feature store)和模型注册表(model registry),作为管道集成测试的数据源和数据汇
- 用于运行模型部署测试的模型服务(model serving)基础设施
- 用于针对智能体部署运行 evals 的智能体部署基础设施
Hopsworks 提供了上述后四种基础设施服务,但你需要自行提供源代码仓库、CI/CD 服务和工件仓库。对于我们的示例 AI 系统,我们使用了 GitHub、GitHub Actions 和 PyPI 服务的免费公共版本。其他一些广泛使用的平台包括 Jenkins、GitLab、Azure DevOps、JFrog 和 Sonatype Nexus。你也可以在需要时替换 Hopsworks 的基础设施服务。例如,你的企业可能希望使用现有的集中式容器注册表,例如 AWS Elastic Container Registry。
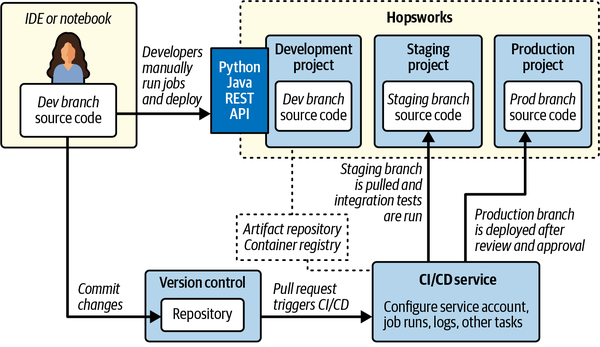
在图 13-2 中,你可以看到 Hopsworks 的 CI/CD 架构,源代码通过版本控制中的分支从开发移动到预发布,再移动到生产。
图:Hopsworks 的 CI/CD 架构图,展示源代码通过版本控制和 CI/CD 服务从开发流向预发布和生产的过程。
在 Hopsworks 中,每个环境都有自己的项目,生产环境通常使用与开发/预发布环境不同的 Hopsworks 集群。项目拥有自己的特征存储、模型注册表和模型服务,以便你可以在项目内部本地构建和测试工件。
默认情况下,工件不会从一个环境迁移到另一个环境。通常,特征和模型是在开发/预发布环境中使用非生产数据创建的,在这种情况下,迁移特征/模型没有意义。相反,ML 管道代码通过拉取请求(pull request,PR)从开发迁移到预发布。PR 会触发 CI/CD 服务执行所有自动化测试。测试和启动测试的代码通常通过一个环境变量进行参数化,该环境变量指示它们是在开发、预发布还是生产环境中运行。这有助于确保你的测试代码遵循 DRY(Don’t Repeat Yourself,不重复自己)原则,并且能够在开发、预发布和生产环境中运行。如果所有测试在预发布环境中都通过,代码就可以标记为准备部署到生产环境。通常会有一位人工评审者签署批准将 ML 工件部署到生产环境。
Hopsworks 的方法既开源又对开放平台友好,因为你既可以在 Hopsworks 内部作为作业(job)运行 ML 管道和测试,也可以在 Hopsworks 外部的任何容器运行时中运行它们。这使得将你的 ML 管道与你现有的测试基础设施集成,或选择同类最佳的测试基础设施变得更加容易。
Note
预提交钩子(pre-commit hook)是在向版本控制提交之前自动运行的命令。它们可以通过以下方式帮助保持高标准的代码质量:确保新代码遵循代码格式规则(使用 black);使用 linter(使用 flake8)识别语法错误、未使用的导入和风格问题;以及使用 bandit 检测安全漏洞。它们甚至可以在提交 Jupyter Notebook 的更改时提供帮助( nbstripout ),通过移除单元格中不必要的输出或元数据,使比较两个笔记本版本之间的差异变得更容易。
为了运行我们的 ML 管道程序,我们将研究如何将它们容器化并打包成作业,以及如何为作业提供其运行所需的资源(CPU、内存、GPU)。下一节将介绍如何在 Hopsworks 中构建容器以及创建和运行作业。
自动容器化与作业
到目前为止,我们已经将 ML 管道定义为源代码,但要在生产环境中运行它们,我们还需要定义和安装它们的依赖项以及它们运行所需的资源,例如内存大小、CPU 核心数、GPU 数和实例数。我们的 ML 管道可能需要按计划运行,也可能需要 24/7 运行。
我们将从如何容器化构成 ML 管道的程序开始。许多 MLOps 课程从如何开发、编译、注册、拉取(下载)和运行 Docker 镜像开始。其思想是,你可以将 ML 管道代码及其依赖项打包在一个容器中。然后,你可以在容器运行时(container runtime)上运行容器——先从 Docker 开始,然后转向生产级容器运行时,例如 Kubernetes 或 AWS Fargate。这种方法需要学习如何:
- 编写一个 Dockerfile,其中包含你的程序的源代码、依赖项以及如何运行它。用环境变量对其进行参数化。
- 从 Dockerfile 编译容器镜像。
- 在本地环境中用 Docker 测试你的容器。
- 将容器镜像注册到容器注册表。
- 为编排器(orchestrator)编写程序,以便在 Kubernetes 这样的容器运行时上调度容器的执行。
虽然使用容器是一项有用的技能,但它并不是构建 AI 系统的必要条件。我们采用的一种更简单的方法是自动容器化。自动容器化是一个总称,指为包含库依赖项和操作系统依赖项的程序透明地构建容器的方法。自动容器化需要一个平台,该平台从你的源代码编译并注册容器。自动容器化平台还提供一个编排器,用于下载容器并将其作为作业运行/调度。这意味着开发人员唯一需要关注的抽象就是他们的程序和作业。
自动容器化平台从以下基础开始构建容器镜像:
- 基础 Docker 镜像(base Docker image),你可以在其中安装操作系统包
- 基础 Python 环境(base Python environment),你可以在其中安装 Python 依赖项
有些平台提供许多基础镜像和/或 Python 环境可供选择。
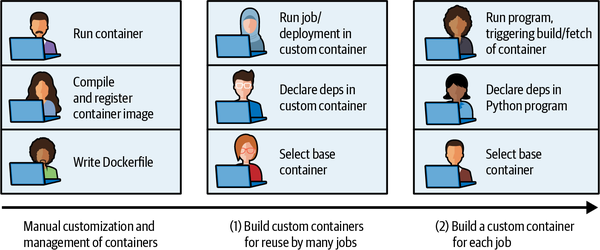
在图 13-3 中,你可以看到从自己编写、编译和管理容器,到自动容器化解决方案的连续谱,后者(1)定制可被许多程序复用的容器,以及(2)为每个作业构建一个容器。
图:从手动容器定制到自动容器化的连续谱图,突出每种方法中的不同任务。
现在,我们将研究两种自动容器化的方法:Hopsworks 和 Modal。
Hopsworks 中的环境与作业
在 Hopsworks 中,你可以为 ML 管道或部署选择最合适的基础容器。特征管道(Pandas/Polars、PySpark)、训练管道(XGBoost、Transformers、PyTorch)、批量推理(Pandas、PySpark)、在线推理(KServe/XGBoost、Transformers/vLLM)和智能体(LlamaIndex)有不同的基础容器。你可以通过在 UI 中克隆并定制基础环境来做到这一点:
- 运行命令行操作以安装操作系统包
- 从工件仓库(PyPI、GitHub、Conda 等)安装 Python 库
虽然 UI 很有用,但对于 MLOps,我们更倾向于编写代码来配置环境,并创建在这些环境中运行的作业或模型/智能体部署。在下面的代码片段中(应在 Hopsworks 上运行),我们创建了一个环境和一个在该环境中运行的 Spark 作业:
`proj = hopsworks.login()
This code normally goes in the Program itself, not in the Job Creation
Assume the book’s repo is already cloned into the Jupyter dir in your project
repo = git_api.get_repo(“mlfs-book”,f"/Projects/{proj.name}/Jupyter/mlfs-book" ) repo.checkout_branch(“v1”) # Run v1 of job repo.checkout(“v1”) # Run v1 of job repo.pull(“v1”)
env_api = proj.get_environment_api() env = env_api.get_environment(“spark-feature-pipeline-v1”) env.install_requirements("/Jupyter/mlfs-book/spark-requirements.txt")
Create a Spark Job to run in the env *pyspark_feature_pipeline* job_api = proj.get_job_api()
spark_config = job_api.get_configuration(“PYSPARK”)
spark_config.update({ “spark.driver.memory” : 2048, “spark.driver.cores” : 1, “spark.executor.memory” : 8192, “spark.executor.cores” : 2, “spark.executor.instances” : 20, “environmentName” : “spark-feature-pipeline-v1”, “appPath” : “/Resources/my_feature_pipeline.py” }) job = job_api.create_job(“my_spark_feature_pipeline”, spark_config)
Run the Spark job now
execution = job.run() out_log_path, err_log_path = execution.download_logs()
Run the Spark job on a schedule every day at 5:00 AM
job.schedule( cron_expression=“0 0 5 * * ?”, # quartz cron syntax start_time=datetime.datetime.now(tz=timezone.utc) )`
在前面的代码中,我们在一个基础的 spark-feature-pipeline-v1 环境中从 requirements.txt 安装了 Python 依赖项。然后,我们定义了一个 PySpark 作业,包括要运行的程序( my_feature_pipeline.py )、Spark 驱动程序(driver)和工作节点(worker)的内存与 CPU 核心数,以及工作节点数量。作业可以立即运行,也可以使用 cron 表达式定义的时间间隔进行调度。
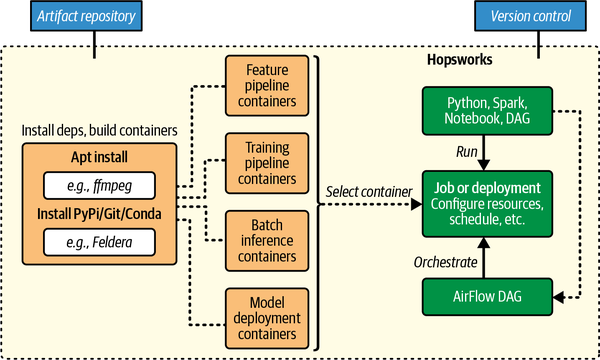
在 Hopsworks 中,Python 依赖项可以从 PyPI 服务器、Conda 服务器或 Git 仓库下载,也可以以 wheel 文件的形式提供。图 13-4 展示了如何选择并配置一个供作业使用的容器。Hopsworks 使用 Papermill 将 Jupyter Notebook 作为作业运行。通常,你的程序/作业的源代码从源代码仓库检出,并放入 Hopsworks 中的一个目录。
图:Hopsworks 为作业选择和配置容器的过程图,依赖项从各种来源安装,并通过 Airflow DAG 进行编排。
Hopsworks 还包含 Airflow,用于将更大的 ML 管道定义为作业的 DAG(有向无环图)来运行。例如,你可能有五个不同的特征管道,都计划在夜间每天运行一次。它们可以是 Hopsworks 调度的独立作业,但如果它们之间存在依赖关系呢?例如,作业 B 应该只在作业 A 完成后才启动。你可以在 Airflow 中定义一个 DAG,运行这些特征管道,并在上游父特征成功完成后计算派生特征。这简化了你的运维负担,因为现在你只需要监控一个 DAG 程序,而不是五个独立的作业。Airflow 负责调度和监控 DAG。
Modal 作业
我们在第8章中看到了一个 Modal 程序的示例。Modal 支持程序级别的自动容器化。在下面的代码片段中,我们展示了如何为使用 ffmpeg 和 hopsworks 的 Python 代码定义容器。首先,我们定义一个带有 Python 版本的 Debian 容器镜像,然后用 apt 定义任何操作系统依赖项,再用 pip 安装任何 Python 依赖项。然后,我们将镜像附加到一个函数 my_function 上,该函数将在 Modal 运行时中作为容器运行:
image = (
    modal.Image.debian_slim(python_version="3.12")
    .apt_install("ffmpeg")
    .pip_install(["hopsworks", "ffmpeg-python"])
)
@app.function(image=image, ...)
def my_function():
    ...
请注意,由于这段代码是在 Hopsworks 外部运行的,我们还需要注入环境变量(Hopsworks API 密钥,可能还有 Hopsworks 集群的域名和项目)。我们之前不需要向 Hopsworks 作业添加这些信息,因为它是在项目内部运行的,环境变量会被透明地注入到作业的容器中。
AI 系统的 CI/CD 测试
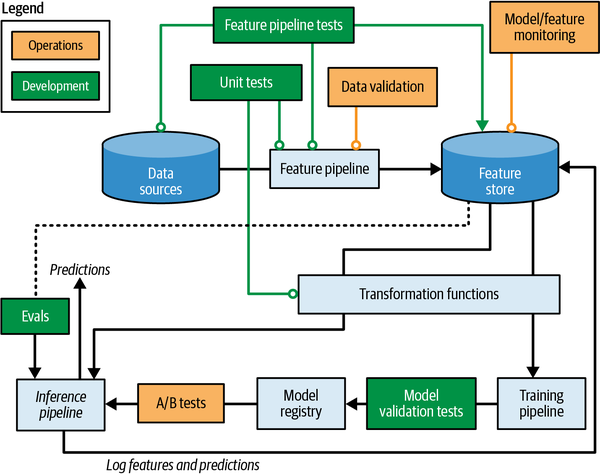
图 13-5 可视化了覆盖 AI 生命周期的不同测试套件,分为构建 ML 管道时离线执行的开发测试(development test)和作为系统运行一部分执行的运行测试(operational test)。
图:AI 测试生命周期图,包括跨数据源、特征管道和模型监控的开发测试与运行测试,强调数据验证、转换和 A/B 测试等不同阶段之间的交互。
我们将介绍的一些有助于测试的开源技术包括:
- pytest,用于运行特征函数和转换函数的单元测试(第7章)
- Great Expectations,用于在特征管道中运行数据验证测试(第6章)
- KServe,用于测试模型部署(第11章)
- NannyML,用于模型/特征监控(第14章)
我们现在将深入探讨尚未覆盖的测试,包括特征管道测试、模型验证测试、模型部署测试和批量推理管道测试,最后以针对智能体的 evals 作为测试的收尾。
FTI 管道需要非常不同类型的集成测试。特征管道验证数据输出和转换中的不变量,而训练管道验证训练后模型的属性(无偏差、性能等)。推理管道应该验证预测质量高且满足 SLO。
特征管道测试
特征管道将一个或多个特征组写入特征化(featurized)的 DataFrame。要测试特征管道,你需要将其重构为独立的函数,以便你可以模拟(mock)源数据和任何数据验证测试。特征管道本身也需要封装在一个函数中。你将使用一些提交到版本控制的示例源数据,以消除对外部数据源的任何依赖。特征管道将写入一个开发特征存储,你可以通过环境变量或显式参数配置与它的连接。下面的代码片段展示了生产特征管道,它包含一个数据源函数、一个以期望(expectation)形式创建数据验证规则的函数、一个实际特征管道的函数,以及一个运行特征管道时的入口点(main)。该管道可以由 Airflow 安排每天运行,Airflow 将为每次运行提供 start_ts 和 end_ts 参数。
def read_data_source(fs, start_ts, end_ts):
    fg = fs.get_feature_group("transactions", version=1)
    return fg.filter((fg.ts > start_ts) & (fg.ts <= end_ts)).read()

def fg2_expectations():
    expectation_suite = ge.core.ExpectationSuite(expectation_suite_name="ge_fg")
    expectation_suite.add_expectation(
        ge.core.ExpectationConfiguration(
        expectation_type="expect_column_values_to_be_between",
        kwargs={"column":"amount", "min_value": 0, "max_value": 1000000})
    )
    return expectation_suite

def create_feature_group(fs):
    suite = fg2_expectations()
    fg = fs.create_feature_group("cc_aggs_trans", version=1,
        primary_key=["cc_num"], expectation_suite=suite
    )
    return fg

# This function is run by the pipeline test
def pipeline(fs, df):
    fg2 = fs.get_feature_group("cc_aggs_trans", version=1)
    if not fg2:
        fg2 = create_feature_group(fs)
    return fg2.insert(df)
我们的特征管道测试可以作为程序运行;它要求开发特征存储可用,但不要求数据源可用。相反,源数据来自 sample_transactions.csv,这是一个你可以通过让 LLM 创建合成数据(synthetic data)来生成的文件。合成数据避免了使用生产数据样本可能带来的合规问题。在我们的管道测试中,你可以通过删除并重新创建目标特征组 cc_aggs_trans 来确保它为空。你需要在单独的函数中创建期望套件,因为这使我们的测试能够以 always 摄取策略将其附加到 fg 上——否则摄取会失败,我们的测试将无法完成。当你将样本数据插入 fg 时,你将使用摄取 job 和 validation_report 来等待摄取完成,并确保验证测试在样本数据上按预期工作。插入数据后,你可以断言添加到 fg2 的特征行数应等于样本数据中的行数:
def test_pipeline():
    fs = hopsworks.login().get_feature_store()
    # Make sure the target feature group is empty for this test
    fg2 = fs.get_feature_group("cc_aggs_trans", version=1)
    if fg2:
        fg2.delete()
        # Run the pipeline with simulated data for testing
    df = pd.read_csv("sample_transactions.csv")
    job, validation_report = pipeline(fs, df)

    # Fetch the feature group created and perform required validation
    fg2 = fs.get_feature_group("cc_aggs_trans", version=1)


    # Sample data should fail one data validation rule,
    assert validation_report.statistics\
        ["unsuccessful_expectations"]== 1
    job._wait_for_job()

    df2 = fg2.read()
    # Test that the data read is the same as the data written
    assert len(df) == len(df2)
你的 CI/CD 服务器将运行单元测试,你可以配置以下环境变量来指向你的预发布特征存储:HOPSWORKS_HOST、HOPSWORKS_PROJECT 和 HOPSWORKS_API_KEY。
如果你只想测试管道逻辑,而不想测试对特征存储的写入/读取,你可以模拟管道函数中的所有外部连接,然后将管道测试作为单元测试运行。单元测试的运行时间要短得多,但你不会端到端地测试特征管道。
在图 13-6 中,你可以看到 pytest 如何运行单元测试。这种架构非常灵活,甚至可以通过检查是否存在 DEV 环境变量,在预发布环境中使用不同的源数据运行管道单元测试——如果存在,则从预发布数据源读取 DataFrame,否则读取 sample_transactions.csv 中的样本数据。好的做法是将样本数据存储在源代码仓库中,以消除运行集成测试时对外部数据源的依赖。
图:端到端特征管道测试过程图,展示从开发到预发布分支的手动步骤和 CI/CD 服务步骤,以及最终合并到主分支的过程。
当开发人员完成特征管道的实现后,他们会在开发环境中运行单元测试(特征函数测试和管道测试)。这些测试可以在他们的笔记本电脑上、Hopsworks 作业中或外部集群中运行。如果测试通过,开发人员就可以向预发布分支创建 PR。然后,CI/CD 服务将检出 PR 中的代码并运行测试(设置预发布环境变量)。如果测试通过,数据所有者应在 PR 合并到 main 之前进行人工代码审查。
模型性能与偏差的训练管道测试
测试训练管道与测试特征管道截然不同。首先,训练管道的输出通常是一个或多个训练好的模型。其次,模型训练可能非常耗时,开发过程中涉及超参数调优,并且使用比生产训练运行更少的数据来训练较小的模型。模型验证步骤的类型包括:检查模型性能是否在预期范围内,以及模型是否没有偏差。与我们的特征函数测试和特征管道测试不同,模型验证测试总是在模型训练运行完成后运行:
fv = fs.get_feature_view('cc_fraud', version=1)
X_train, X_test, y_train, y_test = \
    fv.train_test_split(test_size=0.2, seed=42)

model.fit(X_train, y_train)
y_pred = pd.DataFrame(
    model.predict(X_test),
    columns=y_test.columns,
    index=X_test.index
)

# calculate y_pred for online and offline merchants
pred_df = pd.concat([X_test, y_pred], axis=1)
y_pred_online = pred_df[pred_df['card_present']].loc[:, y_test.columns]
y_pred_offline = pred_df[~pred_df['card_present']].loc[:, y_test.columns]

# calculate y_test for online and offline merchants
test_df = pd.concat([X_test, y_test], axis=1)
y_test_online = test_df[test_df['card_present']].loc[:, y_test.columns]
y_test_offline = test_df[~test_df['card_present']].loc[:, y_test.columns]

f1_online = f1_score(y_test_online, y_pred_online)
f1_offline = f1_score(y_test_offline, y_pred_offline)
你还可以在读取训练数据时使用过滤器,通过特征视图直接从特征存储读取评估测试数据,如下所示:
_, X_test_offline, _, y_test_offline = fv.filter(Feature("card_present") == \
    True).train_test_split(test_size=0.2, seed=42)
_, X_test_online, _, y_test_online = fv.filter(Feature("card_present") == \
    False).train_test_split(test_size=0.2, seed=42)
在图 13-7 中,你可以看到开发分支上成功的训练运行如何促成在生产数据上的完整训练运行。训练管道集成测试需要访问样本数据才能运行,而且它们通常直接连接到特征存储。你可以使用环境变量来选择适当的特征存储,具体取决于测试是在开发环境还是生产环境中运行。
图:端到端训练管道测试图,展示从手动测试和模型训练到验证测试和模型部署的流程,以及开发和生产特征存储之间的交互。
生产训练运行可以手动触发,也可以通过 CI/CD 触发。如果生产训练运行成功,模型部署负责人将通过运行单独的模型部署管道来批准模型的部署,通常是对新版本模型进行蓝绿测试。
测试模型部署
在部署新模型版本之前,你应该用生产流量对其进行测试。你可以通过使用 A/B 测试或蓝绿测试(blue/green test)来做到这一点。A/B 测试将预测请求按 X% 分流到生产模型,按 Y% 分流到挑战者模型(challenger model)。例如,99% 可以流向生产模型,1% 可以流向挑战者模型。A/B 测试不是用来测试模型部署本身的。它们用于测试模型对使用新版本模型的应用产生的影响。A/B 测试将连接到应用级别的 KPI,该 KPI 也可以按 X% 和 Y% 的客户端进行拆分。KPI 的示例包括点击率、参与度、收入提升、转化率以及任务/会话成功/失败率。A/B 测试让你在将生产模型替换为挑战者模型之前,看看新模型版本是否提升了那 Y% 客户端的 KPI。
蓝绿测试直接测试模型的正确性和性能。你将 100% 的请求发送到生产(蓝色)模型,将 Y% 的请求发送到挑战者(绿色)模型。Y% 可以是预测请求的 1% 到 100% 之间的任意值。对于使用它的客户端来说,蓝绿测试是无风险的测试。你可以在将客户端暴露给新模型之前发现问题。
你可以在 KServe 上运行 A/B 测试和蓝绿测试。在图 13-8 中,你可以看到如何在蓝绿部署中,在生产模型旁边部署一个挑战者模型。
图:蓝绿部署过程图,展示生产预测请求如何在生产模型(蓝色)和挑战者模型(绿色)之间分流,并记录和比较结果以做出发布决策。
你可以通过解析预测日志来比较两个模型在一段时间内的性能。如果生产模型上有大量流量,你可以先从向挑战者模型发送一小部分生产流量开始,然后慢慢增加比例。如果在一段时间后,你观察到挑战者模型的性能优于生产模型,你就可以用挑战者模型替换生产模型。或者,你也可以先开始 A/B 测试,如果新模型的应用 KPI 有所改善,就慢慢增加新模型的流量。
批量推理的 A/B 测试
批量推理 AI 系统在升级模型版本之前也应该进行 A/B 测试。
与其在批量推理运行上进行实时 A/B 测试,你通常通过用历史数据回测(backtest)模型,并将挑战者模型的性能与当前生产模型进行比较来执行 A/B 测试。你可以在训练管道中、在模型训练完成后进行。你应该将模型的性能度量为一个单一的标量值,这样你就可以轻松地将模型的性能与当前部署的模型进行比较。然后,你的批量推理管道只需检索"最佳"模型:
model = mr.get_best_model(name='model', metric='performance', direction='max')
智能体的 Evals
LLM 应用和智能体的测试比模型部署更复杂,因为它们做的远不止调用 LLM。它们在响应客户端查询之前会执行许多步骤。以下任何一项的更改都会影响响应质量:
- 所使用的 LLM。
- 系统提示词(system prompt)。
- RAG 查询。
- RAG 数据源更新。例如,如果你的向量索引中添加了新数据,你的 RAG 查询可能会返回不同的上下文(示例),从而正面或负面地影响智能体响应的质量。
与其为智能体执行的每个步骤开发单独的测试,我们将研究端到端测试,评估任何步骤的任何更改是否提高了智能体性能。也就是说,我们将评估智能体对一组精选提示词的响应。我们将这个提示词和预期输出的数据集称为 evals(evaluations 的缩写,评估)。我们使用 evals 来对智能体响应与预期响应进行评分。如果总分提高,我们就可以说这些更改通过了 evals。如果智能体的总分下降,我们就可以说智能体未通过 evals。
图 13-9 展示了一个用于存储和评分响应的 eval 架构示例。
图:用于通过生成 evals 和分析 eval 运行来自动化 LLM 智能体性能评分的评估架构图。
Evals 是表格型数据集,包含 eval_id、要执行的 task(任务)、prompt(提示词)和 expected_response(预期响应)等列。你可以利用特征存储来存储 evals 以及运行 evals 所产生的响应( eval_runs )。
Evals 是针对预发布环境中的智能体部署运行的,在该环境中,智能体连接到与生产环境相同的 LLM 和工具。智能体(或 LLM 工作流)会输出 轨迹(trace)——智能体所执行所有步骤的日志,包括 RAG 请求/响应、LLM 请求/响应、使用的提示词模板,以及对原始请求的最终响应。你可以将轨迹作为日志特征组存储在 Hopsworks 中。
Note
为 LLM 智能体运行 evals 类似于回填(backfill)特征管道。在这两种情况下,你都使用相同的生产程序,并以历史数据作为输入来运行它。对于 evals,你的 LLM 智能体从 evals 数据集中读取数据,其输出是 eval 运行(eval runs),然后由评估器(evaluator)对其进行评分。
评估器(evaluator)是你编写的程序,它处理 evals 数据集中的轨迹和预期响应,对响应进行评分,并将它们存储为 eval runs。如果你的 eval 响应是主观的,你可以使用 LLM 作为裁判(LLM-as-a-judge)作为评估器。如果你的 eval 描述的是一个客观任务(objective task),其结果可以被测量或检查,你可以编写一个特定于任务的程序,来评估智能体是否响应提示词正确执行了预期任务。在给客观 evals 评分时,你应该关注许多类别的响应,包括:
- 幻觉(Hallucination)
- 上下文遵循(context adherence)、正确性和不确定性
- 安全性(Safety)
- 毒性(toxicity)、偏差、个人身份信息(PII)、语气和提示注入(prompt injection)
你应该使用什么评分系统?最流行的两种方法是二元分类(binary classification)和李克特量表(Likert scale)(1 到 5)。如果你需要评分的响应数量很少,并且你对评分者的质量有信心,李克特量表包含更多信息,并且能够跟踪渐进式的改进。然而,二元分类可以让人类更快地评分,并迫使他们做出决定——无法躲在 2 分或 3 分后面。除了分数之外,评估器还可以用 feedback(反馈)更新 eval_runs 中的每个条目,即对某个 eval 所给分数的人类可读解释。
最好的 evals 是特定于应用的。它们既测试用户输入的边缘情况,也测试常见情况。对于使用 RAG 检索上下文的智能体,还可以为 RAG 查询编写单独的 evals,并衡量 RAG 响应的质量,包括分块归因(chunk attribution)、分块利用率(chunk utilization)、上下文相关性和完整性。
开源 Opik 框架用于 LLM 作为裁判的提示词示例如下:
用户
你是一位公正的 AI 裁判。评估助手的输出是否有效回应用户的输入。考虑:准确性、完整性和相关性。给出一个分数(1-5),并用一句清晰的话解释你的理由。
输入:
{{input}}
输出:
{{output}}
例如,想象你正在为一家外卖应用构建客户支持智能体。用户可能会说:“我需要退款。“智能体需要知道上下文信息——订单详情、配送跟踪详情等等。现在你编写了一个提示词模板,需要用上下文信息来渲染。这个渲染后的提示词就是模型用来决定是否退款的内容。在将此提示词部署到生产环境之前,你会希望评估其性能——即它正确决定发放或拒绝退款的实例。要评估,你可以"重放"历史退款请求。问题在于上下文中的信息会随时间变化。你更希望模拟上下文在历史某个时间点的值——或者说是时间旅行(time-travel)。
例如,在 Hopsworks 中,我们构建了一个 LLM 助手,帮助你执行许多不同的任务,例如构建 FTI 管道。我们设计的一个 eval 是一个提示词,它为给定的数据源生成一个特征管道。当我们对 Hopsworks 助手进行更改时,我们会重新运行 evals。eval 测试会运行由 eval 提示词创建的特征管道,然后为该特定 eval 提供一个分数,指示它是否成功创建了预期的特征。
但如何为你的 LLM 智能体设计一个 evals 库呢?我们将在第14章中详细介绍如何从生产轨迹生成 evals,但在没有任何生产轨迹的情况下启动你的 evals,你可以先使用一个强大的训练 LLM 来生成合成提示词和预期响应。然后,我们将研究在使用不支持时间点正确(point-in-time correct)数据的 RAG 数据源时运行 evals 的挑战。
LLM 辅助的合成 eval 生成
在生成合成 evals 时,请遵循以下关键原则以确保其有效性:
- 多样化你的数据集
- 创建覆盖广泛特征、场景和人物角色的示例。这种多样性有助于你发现可能无法预料到的边缘情况和失败模式。
- 生成用户输入,而不是输出
- 使用 LLM 生成真实的用户查询或输入,而不是预期的 AI 响应。这可以防止你的合成数据继承生成模型的偏差或局限。不过,这条原则很难坚持。有时你不得不用同一个 LLM 创建预期响应,然后手动清理它们。
- 纳入真实系统约束
- 将你的合成数据锚定在实际系统限制和运行 evals 时可用的数据源上。
- 验证场景覆盖
- 确保你生成的数据确实触发了你想要测试的场景。
- 使用强大的(前沿)LLM
- 在生成合成 evals 方面,前沿模型目前优于较小的模型。
为了把这些建议具体化,你可以使用 Hopsworks 编码助手 Brewer 的例子。你可以问以下问题:
- 你的编码助手支持哪些任务?
- 它会遇到什么类型的情况?
- 哪些用户人物角色会使用它,如何使用?
然后我们让 LLM 生成一个提示词,而该提示词反过来又能为我们生成 evals:
你能帮我创建一个提示词,用来为我的智能体生成 evals 吗?evals 应该是具有以下列的表格数据:
columns_for_evals = [
    eval_id, event_ts, task, prompt, expected_response
]
以下是我想要创建的 eval 类型的指南:
tasks = [
    "create-feature-pipeline"
]
scenarios = [
    "data source reading", #Help with data sources (external feature groups)
    "data transformations",#Help with creating features to create
    "data cleaning",       #Help with removing duplicates, formatting dates
    "data validation"      #Help identifying data validation rules
]
personas = [
    "data_engineer",       #Needs help with data science concepts
    "data_scientist",      #Needs help with data engineering concepts
    "ml_engineer",         #Needs help with advanced data science
    "novice"               #Needs help with everything
]
虽然这些创建合成 evals 的建议可能经不起时间的考验,但你在运行 evals 时需要考虑的一件事是,它们可能会使用 RAG 数据源。你不希望 RAG 数据源的更新破坏你的 evals。
历史 eval 需要时间点正确的 RAG 数据
当智能体通过 RAG 从外部数据源检索数据时,无法保证在外部数据源上重新运行相同的查询会返回相同的数据。如果向量索引或 MCP 服务器从可变数据源查询数据,在不同的时间点执行相同的查询可能会返回不同的响应。
为了使检索操作具有幂等性(idempotent),所有数据源都需要支持时间旅行,并且查询需要包含一个时间戳,以检索该时间点的响应。我们当前的向量索引和在线特征存储(online feature store)不具备这种能力,尽管 lakehouse 表可以。
处理这个问题有很多不同的方法。你可以加倍投入合成 evals,在开发环境中创建不可变的 RAG 数据源,使 RAG 查询可预测。或者,在我看来,更好的方法是持续更新你的 evals 数据集。你可以将生产智能体的每个请求/响应记录为一个 eval,并附带一个生存时间(TTL)。TTL 应设置为刚好在其所查询的 RAG 数据过期之前到期。这样,你就可以针对生产 RAG 数据源运行你的 evals。
治理
治理(governance)是数据平台中一个经常使用但鲜被理解的术语。它指的是确保组织符合法规和内部政策的策略、流程和控制措施。AI 数据治理(AI data governance)是对 AI 数据资产(特征、训练数据、模型、部署)的管理行使权力和控制(规划、监控和执行)。在实践中,这意味着你的训练数据集应该没有偏差;AI 系统做出的决策应该有可追溯性;AI 系统应该准确、稳健、安全;并且它们应该支持人工监督。
治理不仅仅是合规;它还应确保数据在整个组织内准确、安全并得到负责任的使用。治理还涵盖数据质量、访问控制、血缘和审计。我们将首先研究用于定义 AI 资产治理策略的模式化标签(schematized tag)、用于捕获 ML 管道与 AI 资产之间依赖关系的血缘(lineage)、用于控制 AI 资产生命周期的版本化,以及用于识别违反策略行为的审计日志(audit log)。
模式化标签
自定义元数据(custom metadata)是一种通用工具,你可以用它来描述和发现 AI 资产,并定义治理策略。你可以设计自定义元数据来描述一个 AI 资产及其使用方法、它是否通过了合规和 CI/CD 测试、其允许的使用范围和估计成本是什么,等等。你可以使用自定义元数据为 AI 资产建立搜索索引,帮助提升可发现性和复用性。
在实践中,你可以为 AI 资产创建无限量的自定义元数据。我们将研究模式化标签,作为在 Hopsworks 中设计可搜索元数据的通用机制。标签(tag)(没有模式)被广泛用作元数据标签或关键词,以增强数据和 AI 资产的可发现性、组织性和管理性。Hopsworks 称它们为关键词(keyword)。你可能有用标签在互联网上搜索和过滤内容的经验。例如,我用 #featurestoresummit 标记了 LinkedIn 帖子。一些系统在搜索时只支持精确标签匹配,而另一些则支持自由文本搜索(free-text search),即对标签的部分匹配也会返回相关结果。许多数据目录平台,例如 Apache Ranger 和 Apache Atlas 项目,都支持用标签来组织和搜索数据资产。Hopsworks 对 AI 资产同时支持模式化标签和关键词。
模式化标签符合预定义的模式。就像表或特征组的模式一样,模式化标签具有预期的字段,并且可能有层次结构或受控词汇表。与自由格式标签不同,模式化标签提供标准化,能够跨资产实现一致的标记,并支持治理、自动化和高级搜索等更丰富的用例。例如,我用 LLM 帮助设计了表 13-1 中的模式化标签,它有助于确保 AI 资产不违反欧盟人工智能法案(EU AI Act)。所有行都是必填的。LLM 对欧盟人工智能法案有很好的了解,可以帮助你开始设计模式,并发现模式中的错误。
| 字段 | 类型 | 描述 |
|---|---|---|
risk_level | 枚举 | 最小、有限、高和不可接受 |
conformity_passed_date | 日期 | 最近一次合规检查通过的日期(不合规则为 NULL) |
notified_body | 字符串 | 欧盟公告合规机构的 ID |
technical_documentation_url | 字符串 | 法案要求提供 |
data_governance_validated_by | 字符串 | 确保数据集质量和代表性的人员 ID |
explainability_documentation | 字符串 | 要求的透明度义务 |
human_oversight | 字符串 | 例如,已启用或 manual_review_required |
bias_testing_results | 字符串 | 偏差和歧视测试的 URL |
provider | 字符串 | 负责该资产的组织 |
intended_use | 字符串 | 法案附件三要求提供 |
模式化标签通常是分类体系(taxonomy)或本体(ontology)的一部分,并且通常具有:
- 定义的结构(如键值对)
- 受控的值或类型
- 验证规则
在 Hopsworks 中,你可以在 UI 中或使用 JSON 定义模式化标签。JSON 既支持类型,也支持对有效值的约束。我让我的 LLM 将表 13-1 转换为一个 Hopsworks 模式化标签,它做到了,包括正确指定必需的键值对。在 Hopsworks 中,键值对是可选的,除非你明确将其指定为"必填”。这是 LLM 返回的 JSON 的简化版本:
{
  "type": "object",
  "properties": {
    "risk_level": {
      "type": "string",
      "enum": ["minimal", "limited", "high", "unacceptable"]
    },
    "conformity_passed_date": {
      "type": "string",
      "format": "date"
    },
    ...
    "intended_use": {
      "type": "string"
    }
  },
  "required": [
    "risk_level",
    ...
  ]
}
你可以将这种模式化标签的一个实例附加到一个 AI 资产上。下面是一个附加到模型上的此类模式化标签示例:
eu_ai_act_tag = {
  "risk_level": "high",
  "conformity_passed_date":  "2025-03-15",
 ...
  "intended_use": "Credit card fraud scoring"
}

my_model.add_tag("eu_ai_act", eu_ai_act_tag)
在 Hopsworks 中,你现在可以使用任何标签值、模型名称或模型描述对 my_model 进行自由文本搜索。AI 资产也可以关联多个标签。
模式化标签使你能够实现组织级的标准来分类和描述 ML 资产。模式中的每个条目都有:
- 一个名称
- 一个类型(字符串、布尔值、列表等)
- 一个指示该条目是必填还是可选的标志
- 一个可选的合法值范围(JSON 模式中的验证约束)
当用户为工件附加标签时,标签值将根据标签模式进行验证。这确保了无论生成标签的项目或团队是什么,标签都是一致的。你还可以在特定模式化标签未附加到 AI 资产时阻止其创建。例如,你可以指定:如果欧盟 AI 法案标签没有为模型正确填写,就不能在生产模型注册表中创建模型。你可以将标签附加到 Hopsworks 中的特征组、特征视图或模型上。
其他一些有用的治理模式化标签示例包括:
- 一个 GDPR 模式,包含训练数据或特征数据的数据保留日期,以及一个治理工具,用于搜索那些由于数据保留期即将到期而很快需要删除的 AI 资产。
- 一个合规模式,定义 ML 资产可用于特定任务的条件。例如,它可以定义某个特征组是否可以用于某个特定地理区域,或者它是否包含 PII 数据。
- 一个检查清单模式,定义特征组在生产环境获批之前必须完成的任务。所有者是谁?谁在消费这个管道的输出,它解决什么问题?如果这个特征组没有及时更新(并违反其 SLA),潜在的危害是什么?
血缘
当模型本身没有 PII 标签时,你如何找出哪些模型使用了来自一个带 PII 标签的特征组的特征?你如何判断某个特征组是否可以被安全删除,因为它没有被任何模型或部署使用?假设你有一个生产模型,用户正在举报它存在偏差。你如何找出该模型使用了哪些特征组(请记住,偏差来自数据,而不是来自 ML 算法)?
这些问题的答案是血缘。AI 系统中的血缘(lineage)(或溯源(provenance))跟踪数据和模型在其整个生命周期中的来源、转换、移动和历史联系。Hopsworks 构建了一个从数据源到部署的血缘图:
数据源 → 特征组 → 特征视图 → 训练数据 → 模型 → 部署
Hopsworks 提供图 API 来查询 AI 资产的溯源,例如哪些模型使用了这个特征组,或者这个特征视图中使用了哪些特征组。以下边在 Hopsworks 的溯源图中被定义,从数据源向下遍历到模型部署:
- 数据源 → 外部特征组
- 特征组 → 派生特征组
- 特征组 → 特征视图
- 特征视图 → 训练数据集
- 训练数据集 → 模型
- 模型 → 部署
以下边在溯源图中被定义,从模型部署向上遍历回数据源:
- 部署 → 模型
- 模型 → 训练数据集
- 模型 → 特征视图(跳过一个层)
- 训练数据集 → 特征视图
- 特征视图 → 特征组
- 特征组 → 源特征组
- 外部特征组 → 数据源
借助溯源 API 和标签,你可以构建自定义治理检查。例如,你可以检查模型的使用范围是否与其特征组的使用范围一致。将标签与溯源 API 结合使用,你可以为你的组织编写和调度治理执行作业。
版本化
AI 资产的版本化在治理中很重要,可以跟踪 AI 资产随时间的用法。表 13-2 展示了本书介绍的 Hopsworks 中 AI 资产的版本化支持。
| AI 资产 | 可版本化? | 升级注意事项 |
|---|---|---|
| 特征组 | 是 | 可变,lakehouse 表支持数据版本化。特征变更/删除时需要新版本。特征组的新版本需要回填。 |
| 特征视图 | 是 | 不可变。创建成本低。新增/变更/删除特征时需要新版本。 |
| 训练数据 | 是 | 不可变。创建成本可能较高。新增/变更/删除特征时需要新版本。 |
| 模型 | 是 | 不可变。每次成功训练运行后创建新版本。 |
| 部署 | 否 | 可变。新模型版本采用蓝绿测试和 A/B 测试。语义化版本——新部署使用新名称。客户端依赖部署 API。 |
训练数据集在 Hopsworks 中是不可变的,以实现可复现性。然而,随着训练数据集规模的增长,它们可以被视为物化视图(materialized view),并且可以随着新数据到达特征组而增长。但那样它们也需要支持时间旅行以实现可复现性。
在第3章中,我们的空气质量模型使用 pm25 作为空气质量的度量。如果你想更新你的空气质量模型,让它也预测 pm10 呢?为此,你还需要更新空气质量特征组和特征视图(另请参阅图 5-7)。添加 pm10 列的代码可能如下所示:
features = [ Feature(name="pm10",type="float") ]
fg = fs.get_or_create_feature_group("airquality", version=1)
fg.append_features(features)
我们不必升级 fg 的版本,因为我们没有进行破坏模式的变更(schema-breaking change)。然而,如果我们采用这种方法,所有现有行的 pm10 都会有一个默认值 “0.0”,当我们创建训练数据时,我们需要知道如何过滤掉仅在添加了新 pm10 列之后才创建的训练数据。相反,我们可以直接为 airquality 添加一个新版本:
airquality_fg = fs.create_feature_group("airquality", version=2)
我们现在可以用历史天气数据回填 airquality 的 version 2。我们想训练一个新模型来预测 pm10,为此我们需要一个新版本的特征视图:
selected_features = airquality_fg.select(["pm10"]).join(weather_fg.select_all())
fv = fs.create_feature_view("aq_fv", version=2,
        query=selected_features,
        labels=["pm10"]
)
模型的版本化比特征组的版本化更直接,因为模型是不可变的,而特征组存储的是可变数据。
Note
破坏模式的变更需要特征组或特征视图的新版本。破坏模式的变更示例包括:更改特征的计算方式(你不应该在同一个特征组版本中混用旧特征数据和新特征数据)、删除特征,以及更改特征类型。
最后,一个 lakehouse 表 Apache Iceberg 支持数据版本化。如果离线特征组变得非常大(PB 级或更大),存储数据副本变得越来越不切实际。使用 Iceberg 表,你可以创建生产表的分支,在数据的子集上测试新特征或算法,而不会干扰生产表。如果新特征成功,你可以将分支合并回 main。如果它们不成功,可以丢弃该分支,不会产生任何影响。Iceberg 还允许你为分支创建标签。
# Create a branch
spark.sql(
 "ALTER TABLE local.default.sample_table CREATE BRANCH IF NOT EXISTS dev_branch"
)

# Make changes in the dev_branch
spark.sql("INSERT INTO local.default.sample_table.branch_dev_branch \
           VALUES (3, 'Charlie', 35)")

# Create a tag for the main branch
spark.sql("ALTER TABLE local.default.sample_table \
           CREATE TAG IF NOT EXISTS v1_0")

# Query the original table
spark.sql("SELECT * FROM local.default.sample_table").show()

# Query the dev_branch
spark.sql("SELECT * FROM local.default.sample_table.branch_dev_branch").show()

# Query using the tag
spark.sql("SELECT * FROM local.default.sample_table.tag_v1_0").show()
审计日志
Hopsworks 的能力通过 REST API 暴露,它存储一份审计日志(audit log),记录谁在什么时间执行了什么操作。
对于 AI 系统中的治理,审计日志应该提供 AI 生命周期中关键事件的完整、防篡改记录。这包括:
- 特征存储事件,例如特征组的创建、修改、访问或删除
- 模型生命周期事件,例如注册、部署和更新
- 访问控制事件,例如谁更新了 ML 资产或批准了生产部署
- 模型部署活动,例如谁发送了某个预测请求
还有一些通常需要的开发人员创建的审计,例如模型验证报告,包括偏差测试结果。模型卡(model card)构成了模型审计跟踪的重要部分。审计平台使用情况的面板对利益相关者也很重要。这些面板包括展示 ML 资产活动(包括模型请求流量模式)的面板,以及展示不同模型中特征使用情况的特征使用图表。
总结与练习
在本章中,我们将离线测试作为 MLOps 的一部分进行了研究。我们描述了一种使用版本控制、CI/CD 和测试/预发布/开发基础设施(特征存储、模型注册表和模型服务),通过 FTI 管道从开发走向生产的方法。我们研究了可以编写来验证 AI 系统更改的各种离线测试。我们还介绍了蓝绿测试,作为在模型部署推出到生产之前评估它们的方法。然后,我们研究了如何设计你自己的治理规则、如何执行它们,以及血缘和版本化如何分别对安全调试和升级你的 AI 系统至关重要。最后,我们解释了如何使用 evals 评估 LLM 推理更改的性能。
以下练习将帮助你学习如何以编程方式治理你的 AI 资产:
- 编写一个程序,接收一个标签值和一个特征组作为参数,并返回使用该特征组的部署列表。假设标签是 “PII”——找出使用 PII 特征的部署。
- 为银行中常见的了解你的客户(Know Your Customer,KYC)特征数据设计一个模式化标签。如果你不知道 KYC 数据是什么,可以借助 LLM——LLM 知道。