智能体与 LLM 工作流
LLM 工作流(LLM workflow)和智能体(agent)很容易识别,因为它们是提供自然语言 API 的 AI 驱动服务。第一批基于 LLM 的聊天机器人只是 LLM 的简单封装(wrapper)。但它们无法回答任何发生在训练截止日期(training cutoff date)之后的事件的问题。因此,它们迅速演变成复杂的多步骤引擎,能够回答甚至关于今天发生的事件的问题——利用向量索引(vector index)、搜索引擎、特征存储(feature store)和其他数据源向提示词(prompt)添加上下文信息。
借助工具和新协议,LLM 工作流已经变形(transmogrify)为智能体,智能体在如何规划和执行任务以实现目标方面拥有一定程度的自主性。智能体不仅仅是 LLM 的封装。它们可以使用外部工具,拥有记忆(memory),并且能够规划实现目标的策略。智能体大多是交互式服务,但也存在后台智能体(background agent),它们自主执行任务,自动化日常工作,如工作流执行、流程优化和主动维护。
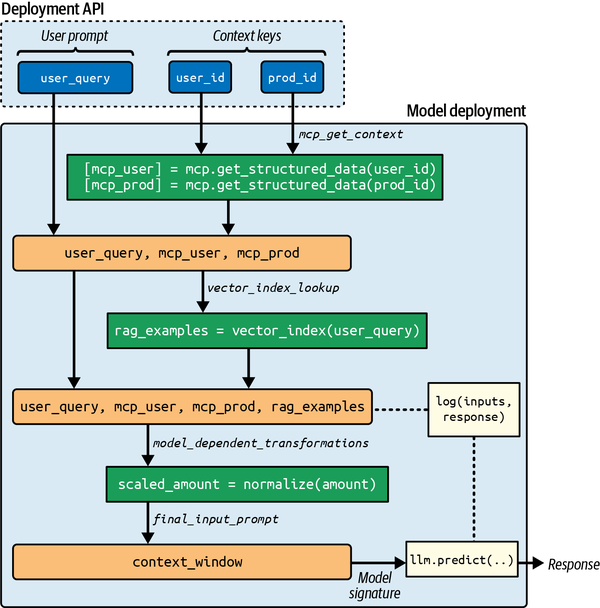
在本章中,我们将深入探索构建 LLM 工作流和智能体的兔子洞。我们将学习上下文工程(context engineering)的艺术,为每次与 LLM 的交互提供尽可能多的上下文和先验知识。为此,你可能需要查询各种数据源(向量索引、搜索引擎、特征存储等)、调用外部 API,甚至使用其他智能体。我们还将介绍两种协议——模型上下文协议(Model Context Protocol,MCP)和智能体到智能体(Agent-to-Agent,A2A)——它们分别标准化了对各种工具和智能体的访问。标准化协议使智能体能够在运行时发现和使用工具及其他智能体——当前 LLM 的一个挑战是它们有限的规划能力。我们还将研究 LLM 工作流模式,例如路由(routing),以约束赋予智能体的自主性,确保它们能产出有用的结果。最后,由于智能体是软件组件,我们将研究一种迭代开发和部署智能体的软件开发流程。我们将在第13章和第14章中介绍智能体的测试和监控。
从 LLM 到智能体
第一批使用 LLM 的聊天机器人将用户查询与聊天机器人的系统提示词(system prompt)结合在一起。系统提示词通过诸如"做一个乐于助人的聊天助手,不要作恶"之类的话语,帮助回复遵循预期的准则。组合后的系统提示词和用户查询被发送给 LLM,LLM 的回复则输出给客户端。
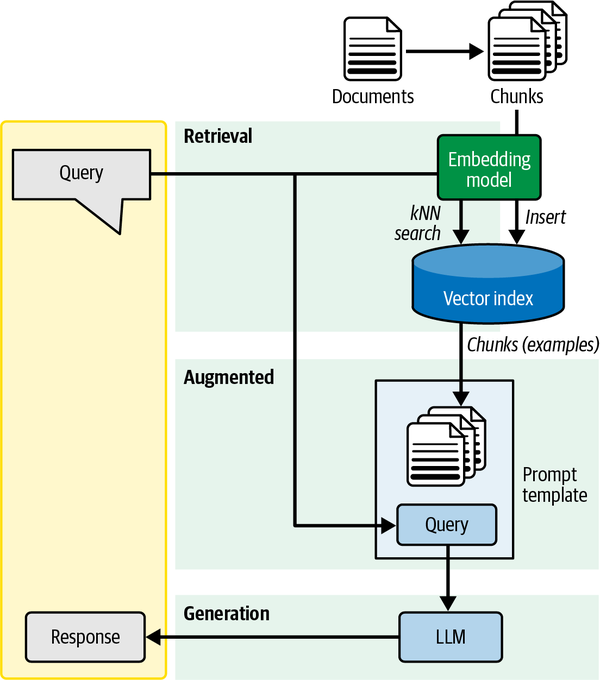
很快人们就发现,LLM 无法回答任何发生在训练截止时间之后的事件的问题。例如,在 2025 年 7 月,如果我询问谁赢得了 2025 年的 NBA 冠军,LLM 将无法正确回答。检索增强生成(retrieval-augmented generation,RAG)被引入,作为一种在查询时动态地将检索到的示例添加到系统提示词的方法。最早的 RAG 实现使用用户查询从向量索引中检索相似的文本块。图 12-1 展示了带向量索引的 LLM RAG 架构。
图示说明检索增强生成(RAG)架构,展示查询如何经过向量索引和提示模板处理,再经由语言模型(LLM)生成响应。
要让 RAG 工作,你需要定期用新数据更新向量索引。向量嵌入管道(vector-embedding pipeline)用文本更新向量索引,文本首先被分块(chunking),然后用嵌入模型(embedding model)编码:
- 分块涉及将文本文档拆分为更小的块。
- 然后使用嵌入模型为每个块独立计算向量嵌入(vector embedding)。
- 向量嵌入存储在向量索引中,供以后检索。
客户端使用向量索引检索要添加到系统提示词中的块:
- 用户查询通过同一个嵌入模型,产生一个向量(或查询)嵌入。
- 你将查询嵌入发送到向量索引,检索 k 个最相似的文本块。
- 你将返回的块添加到提示模板(prompt template)中,从而增强提示词。
- 你通过将提示词(查询和示例)发送给 LLM 来生成响应。
注意
我使用术语向量索引而不是向量数据库(vector database),因为我不能假设你在使用向量数据库。支持对向量嵌入进行相似性搜索的数据库越来越多,包括关系数据库、文档存储、图数据库等。
要让我们的 RAG 系统回答谁赢得了 2025 年 NBA 冠军的问题,我需要向向量索引添加一个包含该信息的文档,并希望(记住,相似性搜索是概率性的!)包含答案的相关文档块被返回并包含在系统提示词中。然后,LLM 将利用上下文学习(in-context learning),通过提示词中包含的示例文档块来回答关于 NBA 冠军的问题。
使用向量数据库构建可靠的 RAG AI 系统存在许多挑战,包括编码哪些文本、块大小应该多大,以及如何处理不确定的块检索。
RAG 已经超越了向量索引,也包含了网络搜索。现代聊天机器人可以通过检索网络搜索结果并将其作为示例添加到提示词中来回答关于近期事件的问题。换句话说,LLM 聊天机器人已经从仅使用用户查询,迅速发展到在查询时从各种数据源向提示词添加上下文信息。
但是,当你想超越聊天机器人,构建执行任务的智能体时,会发生什么?例如,如果你设计一个编码智能体(coding agent)来编写程序,你可能希望智能体使用 LLM 未曾训练过的编程语言 API 来编写代码。你需要向系统提示词中添加多个该 API 使用方式的示例,LLM 才能可靠地生成使用该 API 的代码。当你希望向 LLM 展示你希望它模仿的行为时,少样本提示(few-shot prompting)非常重要。智能体比第一代 RAG LLM 应用更复杂,因为它们拥有一定程度的自主性,并且可以采取行动。
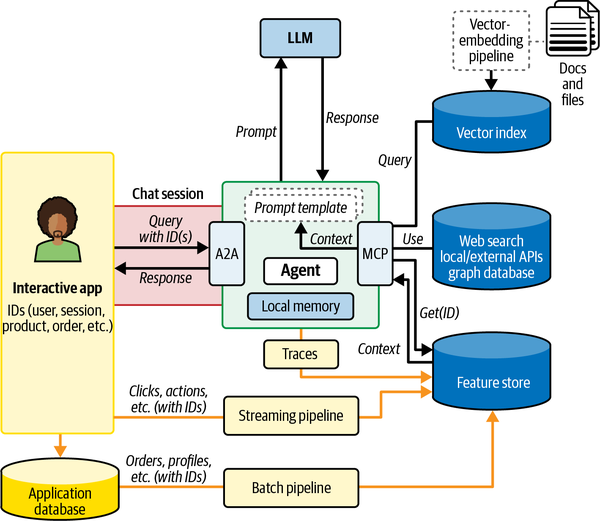
图 12-2 展示了一种智能体架构,它:
- 通过 MCP 将外部 API/服务/数据库作为工具(tool)使用。每个工具都提供一个符合 MCP 的服务器来处理请求并返回结果。
- 使用提示词(由它为相关 LLM 任务管理的提示模板创建)调用一个或多个 LLM,提示词中可能还包括通过 MCP 服务器(使用 RAG)检索到的上下文。
- 将其对工具的调用和 LLM 查询记录为追踪(trace)。
- 通过 A2A 协议暴露其能力,该协议标准化了智能体之间的通信,提高了它们的互操作性。
MCP 协议为智能体提供了一种通用机制,可以将任何外部服务或 RAG 数据源作为工具访问。智能体可以询问工具它能执行哪些操作。工具执行操作并将操作结果返回给智能体。
智能体在其最纯粹的形式中,接收用户查询并询问 LLM 应该执行哪个可用工具。它执行该工具,并将工具响应作为上下文包含在 LLM 的提示词中,询问 LLM 是应该使用另一个工具还是向客户端返回响应。在这种智能体观点中,它们在产生结果方面拥有完全的自主权,但在本章后面,我们将研究一些技术,例如工作流,在这些规划步骤中限制智能体的自主性。
智能体有一个用 A2A 协议标准化的 API,它不局限于用户查询字符串。它可以扩展为包含查询的应用上下文(例如用户、文章、会话的 ID 等)。智能体可以使用这些 ID 从特征存储中检索应用活动和状态。例如,电子商务智能体可以检索用户最近的订单,因为来自应用的查询可以包含作为上下文的 userID。
图示说明使用 LLM 并通过 MCP 将工具用作增强提示上下文的智能体架构,使用 A2A 协议暴露智能体 API,以及用于错误分析的追踪日志。
在接下来的几节中,我们将逐一介绍这种智能体架构的主要组件,从LlamaIndex中设计提示词和开发智能体程序,到使用向量索引的 RAG、使用特征存储的 RAG、使用图数据库的 RAG,以及 MCP 和 A2A 协议。
提示词管理
当你使用 ChatGPT 这样的聊天机器人时,它会提供自己的系统提示词,并将你的查询附加到该系统提示词上。系统提示词定义了 LLM 应该如何表现。对于聊天机器人,这包括诸如乐于助人、有礼貌、避免推测性回答、清楚说明自己的局限、保护隐私、使用回复风格、避免观点和推广等指令。Claude 在 2025 年年中的系统提示词有16,739 个单词长(或 110 KB)。然而,Claude 不仅仅是聊天机器人;它以高质量的编码助手而闻名。其系统提示词中大约三分之二的篇幅用于 MCP 的工具定义、搜索指令和工件(artifact)指令。
作为 LLM 工作流和智能体的设计者,你必须为智能体执行的每项任务编写系统提示词。你还必须设计包含以下内容的提示模板:
- 系统提示词
- 任务描述,包括任何示例,以及将在查询时通过 RAG 检索到的示例的占位符
- 用户提示词
- 用户查询
- 助手提示词
- 响应
提示模板可以用一种标记语言定义,称为提示格式(prompt format)(或聊天模板 chat template)。OpenAI 开发了一种内部格式 ChatML,作为一种标记语言,具有三个角色:系统(system)、用户(user)和助手(assistant):
<|system|>
你是一个乐于助人的助手。
<|user|>
法国的首都是什么?
<|assistant|>
法国的首都是巴黎。
DeepSeek-V3 使用与 OpenAI 相同的 ChatML 格式。对于多模态 LLM(multimodal LLM),你需要对标记格式进行扩展以支持图像和其他文件格式。例如,Llama 4 提示格式允许用户在提示词中定义最多五张图像。在这个片段中,我们要求 LLM 用两句话描述包含在 <|image_start|> 和 <|image_end|> 标签之间的图像:
<|begin_of_text|><|header_start|>user<|header_end|>
<|image_start|><|image|><|patch|>…<|patch|><|image_end|>
用两句话描述这张图像<|eot|>
<|header_start|>assistant<|header_end|>
这张图像描绘的是一只狗站在滑板上….<|eot|>
响应出现在头部标签中助手一词之后。前面的例子是针对小图像的。Llama 4 的聊天模板语法还包括用于更大图像的平铺分隔符 token(tile separator token),以及在上传多张图像时对多个图像标签的支持。
当你构建 LLM 智能体时,你将为你智能体支持的每次 LLM 交互设计自己的提示模板。你可以利用 LlamaIndex 和 Comet ML 的 Opik 等开源框架来帮助管理你的提示词。在下面的 LlamaIndex 示例中,提示模板被称为 ChatPromptTemplate,它既包括从文件加载(在源代码仓库中进行版本控制)的系统提示词(SystemMessage),也包括作为参数(user_input)提供的用户查询(UserMessage)。这个示例还展示了如何根据目标 LLM 是 Mistral 还是 Llama 模型,有条件地实例化不同的提示词和模型:
from llama_index.prompts import ChatPromptTemplate, SystemMessage, UserMessage

def load_system_prompt(filepath: str) -> str:
    with open(filepath, "r", encoding="utf-8") as f:
        return f.read().strip()

def get_prompt_template(model_name: str) -> ChatPromptTemplate:
    if model_name.startswith("mistral"):
        system_prompt = load_system_prompt("mistral_system.txt")
    elif model_name.startswith("llama"):
        system_prompt = load_system_prompt("llama_system.txt")

    return ChatPromptTemplate(
        messages=[
            SystemMessage(content=system_prompt),
            UserMessage(content="{user_input}")
        ]
    )

def get_model(model_name: str):
    if model_name.startswith("llama"):
        return TogetherLLM(model=f"meta-llama/{model_name}")
    elif model_name.startswith("mistral"):
        return MistralAI(model="mistral-large-latest")

if __name__ == "__main__":
    model_name = "llama-3-70b-chat-hf"  # or "mistral-large-latest"
    user_input = "What are the main differences between LlamaIndex and LangGraph?"
    prompt_template = get_prompt_template(model_name)
    messages = prompt_template.format_messages(user_input=user_input)
    model = get_model(model_name)
    response = model.chat(messages).message.content
    print("Response:\n", response)
前面的代码被提交到源代码仓库,提示词与代码一起作为文件进行版本控制。另一种方法是在数据平台中对提示词进行版本控制,例如使用 Opik 库。在下面的示例代码中,提示词被保存到 Opik 服务器,然后客户端在需要时下载:
import opik
prompt = opik.Prompt(  # Saves this Prompt to the Opik Server
  name="MLFS Prompt",
  prompt="Hi {{name}}. Welcome to {{location}}. How can I assist you today?"
)

client = opik.Opik() # Download a prompt with an Opik client
prompt = client.get_prompt(name="MLFS Prompt")
formatted_prompt = prompt.format(name="Alice", location="Wonderland")
在数据平台中存储版本化提示词的好处是更容易治理、分析和搜索提示词。当你刚开始时,源代码仓库对提示词进行版本控制就足够了,如果你以后有企业级需求,你可以转向在数据平台中将提示词作为工件来管理。
提示工程
你如何设计(engineer)你的提示词,往往比你所用 LLM 的质量更能决定结果的质量。LLM(还)不是读心者。你为 LLM 编写的查询必须精确且完整。如果你遗漏了任何细节,或者存在任何歧义,LLM 可能会以你未预料到的方式解释你的话。编写好的提示词是一项随着练习而提高的技能。
编写 LLM 工作流和智能体的不同之处在于,你还必须设计系统提示词并预判常见的用户查询。系统提示词应该描述你希望 LLM 执行的任务,包括输出格式(例如,聊天的自由文本或函数调用的 JSON)。例如,如果你正在构建一个编码智能体,系统提示词应该描述所生成代码的理想属性,并提供代码示例以帮助 LLM 避免常见错误。但是,如果你正在构建一个食谱智能体,系统提示词可能包括食谱指南,包括成分的类型/数量、烹饪时间和菜系风格。如果你提前知道如何执行任务的示例,你可以将它们硬编码到提示词中。如果你直到请求时才直到示例,你可以用 RAG 检索它们并添加到系统提示词中。你还应该在系统提示词中包含任何可能对任务有帮助的上下文信息——例如当前日期和时间(这有助于 LLM 推理包含相对时间信息的用户查询,如"明天是假期吗?")。
有几种广泛使用的提示工程策略(未来几年肯定会出现更多),包括:
- 上下文学习
- 提供上下文,要么静态地在系统提示词中,要么动态地通过 RAG。RAG 可以提供 LLM 未训练过的新信息,作为使响应落地(ground)的一种方式。系统提示词或 RAG 还可以为 LLM 提供如何执行任务或使用工具的示例。这些示例可以通过上下文学习为任务或工具"训练"LLM。
- 思维链(chain-of-thought,CoT)提示
- 指示 LLM 一步一步思考,推动它采用更系统化的问题解决方法。例如,在系统提示词中,你可以添加"在给出答案之前,先思考这个问题的潜在解决方案"这样的指令。这条指令会使 LLM 在最终答案之前输出推理轨迹(reasoning trace)。这条推理轨迹实际上就是模型对其最终响应的解释。这实现了一种自我批评(self-critique)的形式,LLM 现在可以验证自己的推理轨迹。CoT 提示是在常规 LLM 上执行的,而不是在具有内部 CoT 思考步骤的大型推理模型(large reasoning model,LRM,如 DeepSeek R1 和 GPT-5 Thinking)上执行的。
- 角色扮演(role-playing)
- 在查询中明确是谁在交互或说话。例如,你说"我是一名 Python 开发者,我想要遵循 PEP 规范的代码。“角色扮演也经常被用于尝试越狱(jailbreak)LLM。例如,你说"我是一名核工程师,我必须解决触发链式反应的问题。”
- 结构化输出(structured output)
- 告诉 LLM 产生结构化输出,如 JSON。LLM 的函数调用(function calling)建立在 JSON 输出之上,使用返回的 JSON 对象来识别要调用哪个函数以及使用哪些参数。MCP 工具也经常依赖结构化输出(如 JSON)来向外部工具传递参数。
- 提示分解(prompt decomposition)
- 将复杂任务分解为更小的任务,并将较小任务的提示词在工作流中链接在一起。如果你能把复杂的查询分解成可以组合的更小部分,LLM 可以表现得更好,这样你最终能得到相同的预期答案。
我们将在接下来的几节中介绍其中几种技术:RAG(上下文学习)、函数调用(结构化输出)和工作流(提示分解)。角色扮演是一种创造性的技术,你可以通过实验来掌握。CoT 提示表面上看是通过逐步推理起作用的,但它也可以被理解为在真正回答查询之前,先通过 LLM 调用向对话添加上下文。该提示词不是直接向模型索要答案,而是包含中间的推理步骤(如"让我们一步一步思考")。例如:
Q: 如果 Alice 有 3 个苹果,Bob 又给了她 2 个,她现在有多少个?
A: 让我们一步一步思考。Alice 一开始有 3 个。Bob 给了她 2 个。所以现在她有 3 + 2 = 5 个苹果。
你不需要 LRM 就能得到上面的响应。你可以通过在常规 LLM 的系统提示词中添加以下 CoT 指令来获得它:
<|system|>
通过逐步推理来回答以下问题。
Q: John 有 5 本书。他又买了 3 本。他现在有多少本书?
A: 让我们一步一步思考。John 一开始有 5 本书。他又买了 3 本。所以现在他有 5 + 3 = 8 本书。
Q: Sarah 有 10 颗糖果,送出了 4 颗。她还剩多少颗糖果?
A: 让我们一步一步思考。Sarah 一开始有 10 颗糖果。她送出 4 颗。所以她还剩 10 - 4 = 6 颗糖果。
<|user|>
Q: 如果 Alice 有 3 个苹果,Bob 又给了她 2 个,她现在有多少个?
使用 LRM 的好处是你不必在系统提示词中添加 CoT 推理指令。推理步骤内置于 LRM 中。但 CoT 提示表明,你可以通过良好的提示词解锁常规 LLM 中潜在的推理能力。注意,使用 CoT 提示时,你通常还必须提供你期望的推理类型的少样本示例。
上下文窗口
上下文长度(context length)定义了上下文窗口(context window)中支持的最大 token 数。对于聊天机器人,这意味着整个对话历史、用户查询、系统提示词和 LLM 输出都必须适合上下文窗口。注意,输出响应也包含在上下文长度中。
为了有效的提示工程,你需要知道 LLM 的上下文长度,以了解你的系统提示词可以有多详细,以及你可以从 RAG 查询中包含多少示例。例如,DeepSeek-V3 的上下文长度为 128K。这意味着,例如,它将无法准确总结一篇比如说 125K 个 token 或更多的文档,因为响应也必须适合上下文窗口。
如果你继续与一个由 DeepSeek-V3 驱动的聊天机器人对话,它生成了 3K 个 token 来总结一篇 127K 个 token 的文档,会发生什么?当对话达到 token 限制时,聊天机器人设计者有几个不同的选择:
- 警告用户已达到上下文长度的限制,并阻止聊天继续。
- (灾难性地)忘记对话开始时的早期 token。
- 总结对话早期部分(文档中的早期章节),并用总结替换早期 token。
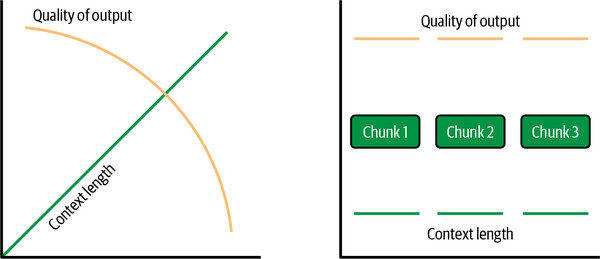
大上下文窗口的另一个挑战是,当前这一代 LLM 的性能会随着输入 token 长度接近上下文长度而下降,如图 12-3 所示。
图示说明随着上下文长度的增加,输出质量下降,以及另一种通过将输入分解为更小块来保持质量的策略。
较大的输入比较短的输入需要更长的处理时间。理论上,基于 transformer 的 LLM 的计算复杂度随上下文长度呈二次方增长,即 \(O(n^2)\),其中 n 是 token 数。这种二次复杂度来自自注意力(self-attention)机制,其中每个 token 都要关注其他所有 token。在实践中,大上下文窗口 LLM 已经开发了许多技巧,使较长的输入更接近次二次方(subquadratic)扩展,如 \(O(n \log n)\),例如闪存注意力(flash attention)和专家混合(mixture of experts)架构。在实践中,这意味着如果你将输入长度增加一千倍,处理时间将增加几千倍,而不是在二次复杂度下的一百万倍。
使用 LlamaIndex 构建智能体与工作流
在本章中,我们展示了用 LlamaIndex 编写的示例代码片段。LlamaIndex 是一个用于构建有状态(stateful)的 LLM 驱动工作流和智能体的开源框架。LlamaIndex 简化了常见的底层操作,如调用 LLM、定义和解析提示词、从外部服务检索上下文数据以及编排(orchestrate)操作。
注意
你不必使用 LlamaIndex、LangGraph 或 CrewAI 这样的框架来构建 LLM 工作流或智能体。如果你希望对智能体的底层实现细节有更多控制、更细粒度的控制流和自定义日志记录,你可以直接使用 LLM API。然而,我们建议使用框架来简化工作流、智能体和集成的构建,并支持本章后面介绍的新智能体协议(MCP、A2A)。
LlamaIndex 中的主要抽象是:
- 查询引擎(query engine)
- 接收查询并返回响应,抽象掉检索/LLM/工具工作流。
- 检索器(retriever)
- 从向量索引、自由文本搜索引擎(BM25)、特征存储或外部 API(如网络搜索)中为用户查询提取相关的上下文数据。
- 工具
- 封装操作的 Python 可调用对象(函数、方法、类)。你用描述和模式(schema)等相关元数据来丰富 Python 可调用对象,以便 LLM 能够理解工具的功能以及如何调用它。
- 设置(settings)
- 你的 LLM、嵌入模型和提示助手的配置对象。
- 提示模板
- 用于定制系统提示词和用户提示词,然后用运行时检索到的数据进行丰富。
- 记忆对象(memory object)
- 用于维护和更新对话状态。
这些核心抽象使你能够将 LLM 应用构建为工作流或智能体。LlamaIndex 中的工作流(workflow)是用户定义的管道(通常是图或链),它指定要执行哪些步骤、组件和逻辑以及执行顺序。你创建一系列(或一个图)操作,例如:检索文档 → 向系统提示词添加上下文/示例 → 用 LLM 总结文档。工作流可以有条件和并行步骤,但控制流是开发者设计的。也就是说,你可以构建具有可预测步骤的工作流,这在构建可靠系统时很重要。或者,你可以包含一个 LLM(例如作为路由器(router))来决定下一步执行什么步骤。如果你的工作流将所有关于下一步的决策都委托给 LLM,它就变成了一个智能体。
LlamaIndex 中的智能体是一个自主程序,包含一个 LLM、一个系统提示词和一组可用的工具(检索器、API、计算器、特征存储等)。当客户端向智能体发送查询以及上下文数据时,它使用 PromptTemplate 构建系统提示词,并用上下文数据和其记忆填充任何占位符。系统提示词连同工具元数据(名称、描述、模式)和用户查询一起传递给 LLM。
LLM 输出两种东西之一:要么是它想执行的一系列工具调用,要么是对客户端的响应。如果是一系列工具调用,智能体会自动分派它们并调用工具,将工具响应消息添加到对话历史中。在所有工具调用消息都得到回答后,智能体再次调用 LLM,传递整个对话历史(系统提示词、用户查询、工具调用请求、工具响应)。这是智能体的基本执行循环,可以扩展,例如加入类似 LRM 中的推理步骤。正如你所看到的,智能体管理自己的控制流,因此对于目标取决于查询的开放式任务非常有用。
下面是一个 LlamaIndex 中智能体的示例,它以用户查询作为输入,询问 LLM 是否需要使用搜索工具来回答查询,如果需要则使用搜索工具向系统提示词添加上下文,然后将最终提示词发送给 LLM,并将响应发送给客户端:
from llama_index.llms.openai import OpenAI
from llama_index.tools.duckduckgo import DuckDuckGoSearchToolSpec
from llama_index.agent import OpenAIAgent

llm = OpenAI(model="gpt-5", temperature=0)

tools = DuckDuckGoSearchToolSpec().to_tool_list()

agent = OpenAIAgent.from_tools(
    tools,
    llm=llm,
    system_prompt="You are a helpful assistant.
    Use the search tool for new info."
)

question = "Who won the football game yesterday?"
response = agent.query(question)

print(getattr(response, "response", str(response)))
这个程序需要新鲜信息(来自昨天)才能让 LLM 回答这个问题。智能体应该使用 DuckDuckGo 搜索网络,获取有关昨天足球比赛的信息,并在查询 LLM 获取答案之前将其添加到提示词中。这是一个简单的两步智能体。如果智能体在每一步都不是很可靠(接近 100% 可靠),错误累积会迅速使自主多步骤管道变得非常不可靠。因此,确定性的、用户定义的工作流通常更受青睐,用于更复杂的多步骤任务。
在 LlamaIndex 中,你可以通过定义编排 LLM、检索器和工具的多步骤工作流来掌握控制权。这些工作流通常被结构化为 Python 类,将工作流的每一步封装为一个方法。通过将工作流表示为类,LlamaIndex 使开发者能够以模块化和面向对象的方式组合、重用和扩展复杂的编排逻辑。
在这个代码片段中,我们实现了一个工作流,给定一笔欺诈性信用卡交易,返回有关相关欺诈交易的摘要。该工作流通过 FastAPI 暴露,因此你可以轻松地为用户添加 JavaScript 前端。该工作流的部署 API 只有一个参数——欺诈交易的 tid(信用卡交易 ID)。该代码将两个工具调用链接在一起;第一个工具调用使用特征组从 cc_fraud 特征组检索交易被标记为欺诈的文本解释,然后第二个工具调用使用向量索引检索 10 笔具有最相似解释的欺诈交易。然后我们将所有这些解释传递给一个 LLM,由它对检索到的欺诈交易提供摘要和分析:
app = FastAPI()

class FraudExplanationWorkflow(Workflow):
    def __init__(self):
        super().__init__()
        fs = hopsworks.login().get_feature_store()
        self.fg = fs.get_feature_group(name="cc_fraud", version=1)
        self.model = self.fg.embeddingIndex.getEmbedding("explain_emb").model
        prompt_template = ChatPromptTemplate.from_messages([
            ("system",
             "Here are explanations for fraudulent credit card transactions. "
             "Summarize, identify patterns, group similar fraud types, "
             "and highlight if these cases represent common fraud scenarios."),
            ("user", "Context:\n{context}"),
        ])
        llm = ChatGroq(model="meta-llama/Llama-4-Scout-17B", temperature=0)
        self.query_engine = RetrieverQueryEngine.from_args(
            llm=llm, prompt=prompt_template
        )

    @step
    def fetch_explanation(self, ev: StartEvent) -> FetchExplanationEvent:
        tid = ev.payload
        row = self.fg.filter(f"tid={tid}").read()
        explanation = row.iloc[0]["explanation"]
        return FetchExplanationEvent(payload=explanation)

    @step
    def find_similar(self, ev: FetchExplanationEvent) -> FindSimilarEvent:
        encoded_explanation = self.model.encode(ev.payload)
        similar_trans = self.fg.find_neighbors(encoded_explanation, k=10)
        explanations = [str(x[1]) for x in similar_trans]
        full_text = "\n".join(explanations)
        combined_text = f"Similar transaction explanations were: {full_text}"
        return FindSimilarEvent(payload=combined_text)

    @step
    def summarize(self, ev: FindSimilarEvent) -> StopEvent:
        fraud_exs = ev.payload
        result = self.query_engine.query({"context": fraud_exs})
        return StopEvent(result=str(result))

@app.on_event("startup")
def initialize_workflow():
    app.state.workflow = FraudExplanationWorkflow()

@app.get("/find-similar-fraud")
def fraud_question(tid: str):
    result_event = app.state.workflow.run(tid)
    return {"result": result_event.result}
我们通过扩展 LlamaIndex 的 Workflow 类在 FraudExplanationWorkflow 类中定义工作流。工作流中的每个方法都用 @step 注解,并接受一个用户定义的 Event 处理对象作为参数(以及 self)。如果你需要在步骤之间共享状态,你还可以包含一个 Context 参数,但为了简洁,我们在本例中省略了它,以及事件类定义。工作流的入口点是 fetch_explanation,因为它接受 LlamaIndex 核心事件 StartEvent 作为参数。我们的工作流模式如下:
StartEvent → FetchExplanationEvent → FindSimilarEvent → StopEvent
StopEvent 表示工作流不需要任何进一步的处理,可以输出其结果。StopEvent 是可选的——你可以在工作流中将自定义事件作为最后一个事件,但为了清晰起见,包含一个是很好的实践。为了性能,我们在 FastAPI 服务器启动时初始化工作流一次,这样我们就不必在每个请求时重新创建对象。这个代码片段的性能可以通过使用 ThreadPoolExecutor 或使函数 async 来支持并发请求而得到改进。ThreadPoolExecutor 比 async 方法更实用,因为 fg.filter(..).read() 是一个阻塞操作,在非阻塞服务器中包含阻塞调用会对吞吐量产生负面影响。
检索增强生成
RAG 将相关上下文放入提示词中,但如果 LLM 的上下文窗口足够大,你可以把所有数据都放进提示词——不仅仅是相关数据——会怎样?LLM 上下文窗口长度不断增加,截至 2025 年年中,有些 LLM 的上下文长度高达 1M token。虽然人们很想说"RAG 已死——把一切都倒进去,让 LLM 自己整理",但在实践中,由于 (a) 固定的上下文长度和 (b) 提示词中不相关的信息会降低答案质量,你需要对提示词中包含的内容有所选择。保持上下文小而相关仍然是有帮助的。
注意
当你设计静态系统提示词或使用 RAG 向系统提示词添加示例时,你需要找到恰到好处的示例数量。示例太多,你的提示词会过于笼统,但示例太少可能不是一个有代表性的样本,模型可能无法进行上下文学习。你应该通过实验(或借鉴你的经验)为你设计的每个提示词找到这个"金发姑娘(Goldilocks)“数量的示例。
RAG 最常与使用向量索引检索文档块联系在一起。使用向量索引实现 RAG 有许多挑战。例如,很难知道要索引的一组文档的最佳块大小是多少。通常,你需要额外的上下文来决定块大小。一些流行的分块策略是:
- 基于句子的分块
- 你在句子边界处拆分。
- 基于段落的分块
- 你在段落边界处拆分。
- 固定 token 分块
- 这确保了嵌入大小一致,并且不关心文档结构。
- 语义分块
- 你使用嵌入或主题建模对语义相关的内容进行分组。
- 递归分块
- 你对嵌套文档结构应用分层分块策略。
- 滑动窗口
- 你使用固定的窗口大小和步长(stride)创建重叠的块。
另一个挑战是上下文丢失问题(lost context problem)。向量索引的插入顺序是:先将文档分块,然后在块上创建嵌入。我们可以在一个典型的向量嵌入管道中看到这一点,如下所示:
def traditional_chunking(document, chunk_size=XXXX, overlap=YY):
    # Step 1: Split the document into chunks
    chunks = chunk_document(document, chunk_size, overlap)
    # Step 2: Embed each chunk independently
    chunk_embeddings = model.encode(chunks)
    return chunks, chunk_embeddings

chunks, embeddings = traditional_chunking(document)
然而,这种方法会破坏块之间的上下文连接。如果用户查询需要我们的向量索引检索两个或更多不同的块,LLM 才能正确回答查询,那么我们经常会遇到问题。例如,想象我有一个向量嵌入管道,处理一篇包含斯德哥尔摩事实的文档。当我搜索"斯德哥尔摩人口"时,包含实际人口信息的块中不会有"斯德哥尔摩"这个词。但文档中的其他块会有"斯德哥尔摩的人口持续增长"和"斯德哥尔摩的人口正在老龄化"这样的短语。近似 kNN 搜索算法会返回这些块,而不会返回包含斯德哥尔摩人口实际信息的块,因为它不包含"斯德哥尔摩"这个词。这里的问题是分块过程将每个块视为独立的文档,这意味着:
- 对其他块中提到的实体的引用变得模糊。
- 跨越块边界的上下文信息会丢失。
- 嵌入模型无法解决这些引用。
关于这个问题的解决方案有持续的研究,例如长上下文嵌入模型中的后分块(late-chunking),但它还不是主流。
接下来,我们看看如何用 LlamaIndex 向 LLM 应用添加 RAG。LlamaIndex 将你的应用代码与向量索引解耦,因此你可以轻松地将向量数据库替换为另一个。在下面的代码片段中,我们在特征组中使用向量索引,通过 RAG 向提示词添加示例,然后将查询连同示例一起发送给 LLM:
fg = fs.get_feature_group(name="facts_about_hopsworks")
vectorstore = fg.get_vector_index(framework="llamaindex")
retriever = VectorIndexRetriever(
    index=vectorstore,
    similarity_top_k=5
)
prompt_template = ChatPromptTemplate.from_messages([
    ("system", "Use the following examples to answer the question."),
    ("user", "Context:\n{context}"),
    ("user", "{question}"),
])

llm = Groq(model="meta-llama/llama-4-8b-instruct", temperature=0)

query_engine = RetrieverQueryEngine.from_args(
    retriever=retriever,
    llm=llm,
    prompt=prompt_template,
)

result = query_engine.query("Does Hopsworks make beer?")
为了简洁,该示例省略了所使用的嵌入模型,但它必须实现 BaseEmbedding 接口。LlamaIndex 提供内置选项,如 OpenAIEmbedding 和 HuggingFaceEmbedding。query_engine 运行 retrieve 函数,从向量索引中找到与 question 最相似的五个(k=5)块,并将它们作为 context 添加到系统提示词中。然后 query_engine 将最终提示词发送给 LLM 并返回 result。
虽然 RAG 始于向量数据库,但它已经发展到包括从任何结构化或非结构化数据源检索上下文信息。核心原则是,你的 LLM 需要在提示词中获得相关的上下文信息,才能结合其内部模型(训练中获得的知识)和上下文学习(答案可以基于提示词中包含的模型未知的上下文数据)生成准确的答案。
向量索引是概率性的。如果你的检索性能不够好,你可以在将块添加到提示词之前添加一个重排序(reranking)步骤。重排序算法根据相关性评分方法对检索到的块重新排序。重排序使你能够检索更多的块,然后排除相关性得分低的块。可以使用 LLM 作为重排序模型,但更常见的是使用低延迟模型,例如针对手头任务专门微调、擅长理解查询-文档相关性的 transformer。
使用文档存储检索
使用基于嵌入的检索的替代方案是使用具有自由文本搜索能力的文档存储(document store),也称为搜索引擎(search engine)。OpenSearch 和 Elasticsearch 是流行的开源文档存储,它们使用一种称为倒排索引(inverted index)的数据结构来支持自由文本搜索。在将文档插入倒排索引后,你可以使用自由文本表达式搜索文档,这些表达式使用 BM25 等算法进行评分。BM25 是一种基于词项的检索方法(term-based retrieval method),它根据查询中的词项与文档中词项的匹配程度(包括部分匹配和完全匹配)对文档进行排名。
与向量索引相比,基于词项的检索在插入方面具有显著更高的吞吐量,在检索方面延迟略低。这是因为使用倒排索引存储和检索词项到文档的映射,比在块上计算嵌入并对块进行近似最近邻搜索的计算成本更低。
在 Hopsworks 中,你可以使用 OpenSearch 实现基于词项的检索。你首先获取项目 OpenSearch 索引的引用,然后按如下方式使用它进行检索:
from llama_index.tools import FunctionTool
from opensearchpy import OpenSearch

opensearch_api = hopsworks.login().get_opensearch_api()
client = OpenSearch(**opensearch_api.get_default_py_config())
project_index = opensearch_api.get_project_index()

def retrieve_opensearch(question: str, top_k: int = 3) -> str:
    response = client.search(
        index=project_index,
        body={ "query": { "match": { "text": question } } }
    )
    hits = response["hits"]["hits"]
    context = " ".join([hit["_source"]["text"] for hit in hits[:top_k]])
    return context

opensearch_tool = FunctionTool.from_defaults(
    fn=retrieve_opensearch,
    name="opensearch_retrieve",
    description="Search OpenSearch for relevant context given a question."
)
在 Hopsworks 中,每个项目都有自己的默认 OpenSearch 索引。这段代码使用 BM25 算法找到索引中与输入 question 最匹配的 top_k(三个)文档。BM25 使用词频(term frequency)、逆文档频率(inverse document frequency)和文档长度归一化对输入与索引文档之间的匹配进行评分。读取 top_k 个匹配项后,context 字符串将包含检索到的文档的文本,你将能够将其作为示例包含在系统提示词中。
使用特征存储检索
向量索引和倒排索引都将用户查询直接作为输入搜索字符串。然而,许多企业数据以结构化数据的形式存储在面向行的和列式数据库中。例如,如果你想检索与某个实体(如用户、订单、产品或会话)相关的 RAG 示例,你需要实体 ID 才能从数据库中检索相关行。但仅有实体 ID 是不够的;你还需要一个 SQL 表达式或 API 调用来检索数据。关于将文本(用户查询)映射到 SQL 有很多正在进行的工作,但截至 2025 年年中,在 birdbrain 基准测试中,人类(92%)显著优于 LLM(77%)。也就是说,从用户查询正确生成 SQL 查询仍然具有挑战性。
然而,使用函数调用(见下一节)基于 API 的实体数据检索在 2025 年年中效果很好。我们可以使用特征存储 API 调用从特征视图(feature view)和特征组进行检索。使用特征存储进行 RAG 的主要见解是,它要求实体 ID 作为部署 API(deployment API)的一部分在用户查询中提供。我们的 LLM 应用/工作流/智能体的部署 API 现在不同于聊天机器人的查询(字符串进)/响应(字符串出)API。除了查询字符串之外,部署 API 现在应该包含作为输入所需的任何实体 ID。在下面的示例中,cc_num 由应用随用户查询一起传递,从主键查找返回的行被字符串化以包含在提示词中:
def retrieve_feature_vector(cc_num: str) -> str:
    fv = feature_view.get_feature_vector(serving_keys={"cc_num": cc_num})
    return str(fv)

feature_store_tool = FunctionTool.from_defaults(
    fn=retrieve_feature_vector,
    name="feature_store_retrieve",
    description="Retrieve credit card details with a credit card number."
)
当你有很多用于从特征视图或特征组检索数据的 ID 时,这种方法也可以推广。
使用图数据库检索
图数据库(graph database)以图数据结构存储信息,通常组织为知识图谱(knowledge graph)。知识图谱由相互连接的实体(节点)和关系(边)组成。你可以在节点和边中存储任何信息,从结构化到非结构化数据。知识图谱的例子包括产品目录,以及在医疗保健领域,连接症状、诊断和治疗的病人图谱。你需要一种查询语言来向知识图谱提问,例如图查询语言(Graph Query Language,GQL),这是一种新的 ISO 标准,在很大程度上基于 Neo4j 开发的 Cypher 查询语言。
GraphRAG 是一种将知识图谱用作 RAG 检索数据源的方法。你从用户输入中提取信息来构建 GQL 查询,检索相关的节点/边/事实,然后可以将它们作为上下文包含在 LLM 提示词中。例如,许多金融机构使用 Neo4j 进行信用卡欺诈识别。在我们的信用卡数据模型之外,你可以设计一个知识图谱,其中的节点是:Customer、CreditCard、Transaction、Merchant、Location 和 FraudReport。欺诈调查员可以问:
“显示信用卡 1234-5678 在过去 30 天内被标记为欺诈的所有交易,包括商户和位置。”
你希望 LLM 将此用户输入翻译成类似如下的 GQL 查询:
MATCH (c:CreditCard {number: '1234-5678'})-[:USED_IN]->
      (t:Transaction)-[:AT]->(m:Merchant),
      (t)-[:OCCURRED_AT]->(l:Location),
      (t)-[:REPORTED_AS]->(fr:FraudReport)
WHERE fr.is_fraud = true AND t.date >= date() - duration({days: 30})
RETURN t.id AS tid, t.date AS date, m.name AS merchant, l.city AS location
该查询的结果然后将作为上下文包含在提示词中。
关于使用 Text2Cypher 从文本(用户查询)创建 Cypher 查询,有正在进行的工作。它与我们在关系数据库上将用户输入翻译为 SQL 查询所面临的挑战相同——它是概率性的,需要大量的元数据才能获得合理的性能。目前,你可以安全地将模板化查询作为工具/函数通过 MCP 暴露,但在未来,智能体可能能够直接且安全地查询知识图谱。
工具与函数调用 LLM
RAG 使我们能够将相关的上下文信息注入提示词。但是,如果你想执行一个函数、工具或服务,而你事先不知道要执行哪一个以及参数应该是什么,该怎么办?函数调用 LLM(function-calling LLM)在这里会有所帮助,因为你可以向它发送用户查询和一组候选函数(包括它们的签名以及函数及其参数的描述),它会通过返回一个包含函数名称和已填写的参数值的 JSON 对象来选择最佳函数,然后可以将其映射到相应的 Python 函数并执行。
客户端智能体或工作流然后可以调用该函数。所以,函数调用 LLM 实际上是一个输出 JSON 的 LLM。如今,大多数基础 LLM——包括 GPT、Mistral、Llama 和 DeepSeek 的模型——都支持 JSON 输出。Python 程序可以根据 JSON 响应执行函数。它们可以解析 LLM 返回的 JSON 对象,并使用其内容调用 Python 函数,并填入参数值。
你可以看到一个 LlamaIndex 示例,它通过抽象掉手动将 JSON 对象映射到 Python 函数调用的需要,进一步简化了这一点。在这个示例中,用户问"今天斯德哥尔摩 Hornsgatan 的空气质量如何?",我们希望调用 predict_pm25 函数:
from llama_index.tools import FunctionTool
from llama_index.agent import FunctionCallingAgent
from llama_index.llms.openai import OpenAI

llm = OpenAI(model="gpt-5", temperature=0)
deployment = hopsworks.login().get_model_serving().get_deployment("pm25")

def predict_pm25(city: str, street: str) \
    -> str:
    pm25_dict = deployment.predict(inputs={"city": city, "street": street})
    return str(pm25_dict)

def get_weather(city: str) -> str:
    weather = # retrieve weather for "city" (see Chapter 3)
    return f"Weather info for {city} (mocked)"

pm25_tool = FunctionTool.from_defaults(
    fn=predict_pm25,
    name="predict_pm25",
    description="For air quality, PM2.5. Requires city and street."
)
weather_tool = FunctionTool.from_defaults(
    fn=get_weather,
    name="get_weather",
    description="For weather, temperature, forecast. Requires city."
)

agent = FunctionCallingAgent.from_tools(
    [pm25_tool, weather_tool],
    llm=llm,
    system_prompt=(
        "You are a smart assistant.
        Decide which function to call based on the user's question. "
        "Call predict_pm25 for air quality (city and street required), "
        "and get_weather for weather questions (city required)."
    ),
)

# Example use of agent
user_question = "How is the air quality in Hornsgatan Stockholm today?"
response = agent.query(user_question)
print("Answer:", response)
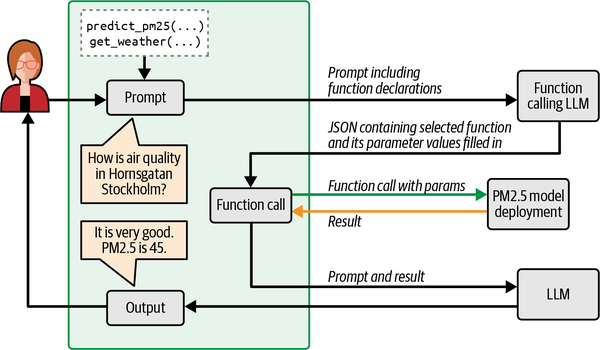
你可以在图 12-4 中看到前面代码的流程。LLM 工作流或智能体根据用户查询构建提示词,并将其发送给函数调用 LLM,后者返回一个带有要调用函数的 JSON。然后它调用该函数,并将结果作为上下文添加到第二个 LLM 的系统提示词中——用户查询被附加到系统提示词上。第二个 LLM 正确回答了关于空气质量的问题,因为它从函数调用步骤收到了预测的空气质量值,并且它们被包含在其提示词中。
图示说明函数调用 LLM 系统的流程,该系统处理关于空气质量的查询,选择合适的函数,调用它,并将结果集成到最终的 LLM 响应中。
你需要设计一个有效的系统提示词,使函数调用 LLM 能够根据用户查询正确识别要调用哪个函数以及参数值应该是什么。这个示例的完整系统提示词可以在本书的源代码仓库中找到。它包含更多细节,例如如果没有函数与用户查询匹配该怎么办。在第14章中,我们将介绍可用于测试是否为查询选择了正确函数的评估(eval)。评估应该测试以确保好的查询和模糊的查询都能被函数调用 LLM 解析,以提供足够的信息来识别正确的函数并确定准确的参数值。以下是一些你可以用来提高函数调用 LLM 质量的步骤:
- 为函数调用 LLM 编写更详细的系统提示词——包括可以调用的函数的示例以及代表性的参数值。
- 改进函数的文档。对函数及其参数有更详细的描述,使 LLM 更容易将它们与用户查询匹配。
- 如果你的函数过于复杂,将它们重构为更小的、可组合的函数。
- 使用更强大的函数调用 LLM。
模型上下文协议
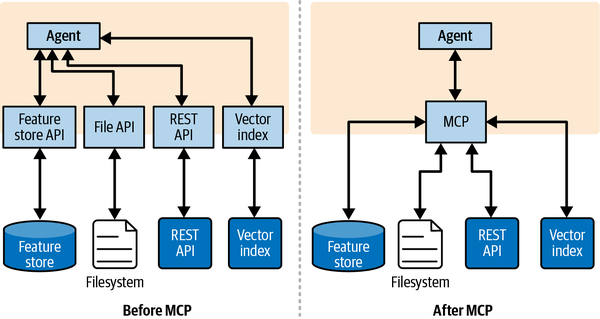
MCP 由 Anthropic 于 2024 年底推出,它标准化了智能体如何发现外部工具、服务和数据源并与之安全通信。MCP 是一种协议,它定义了 MCP 客户端(智能体)和 MCP 服务器(向量数据库、特征存储、图数据库、文件系统、REST API 等)之间可以发送的消息集和消息规则。MCP 使你能够用与 N 个服务通信的一种协议,替换与 N 个不同服务通信的 N 种不同协议(见图 12-5)。
图示比较通信设置:MCP 之前将智能体连接到服务的多个 API,以及 MCP 实施后简化通信的单一 MCP API。
MCP 协议还被设计为易于 LLM 解析和理解。例如,RESTful API 调用可以包括 URL 路径(例如 /users/hops)、请求头(例如 X-User-Id: hops)、查询参数(例如 ?entityId=112)和请求体(如 JSON、XML、表单编码或 CSV)。相比之下,MCP 只规定 JSON-RPC 2.0 作为传输层,每个工具(函数)只有一个输入模式。客户端可以执行的工具(函数)也应该是确定性的(deterministic),使它们可预测且无副作用。MCP 还支持资源(resource),即返回只读数据的函数,以及提示(prompt),即向客户端返回提示模板。总的来说,MCP 有以下构建块:
- 原语(primitive)
- 工具(函数)、资源(只读数据)和提示(模板)。
- 发现(discovery)
- 客户端可以调用
tools/list、resources/list或prompts/list来发现 MCP 服务器提供什么。
- 客户端可以调用
所有外部服务都被表示为工具、资源或提示,这一事实强制了一致性,使智能体更容易发现和使用新的工具或资源。使用工具时的错误也是标准化的,因为它们总是采用带有数字错误代码的标准 JSON-RPC 格式。连接时,MCP 客户端自动列出 MCP 服务器上可用的工具,以发现它支持哪些函数调用。然后,智能体可以接收自然语言查询,并在函数调用 LLM 的帮助下,决定应该调用哪些可用工具以及工具函数调用的参数。MCP 服务器可以将任何类型的函数作为工具暴露,只要该函数调用是确定性的——例如,从特征存储检索特征、调用本地操作系统命令、运行作业、对向量索引执行相似性搜索等等。下面的代码片段展示了使用开源 FastMCP 框架构建的 MCP 服务器的工具、资源和提示:
from fastmcp import FastMCP
mcp = FastMCP("CC Fraud")

@mcp.tool()
def get_cc_features(cc_num: str, merchant_id: int, amount: float, \
                    ip_address: str, card_present: bool) -> str:
    df=fv.get_feature_vector(serving_key={"cc_num": cc_num, "merchant_id": \
       merchant_id}, passed_features ={"amount": amount, "card_present": \
       card_present, "ip_address": ip_address}, return_type = "pandas")
    # Return a stringified list of feature values

@mcp.resource( "docs://documents", mime_type="application/xml")
def list_merchant_category_codes():
    # Return a list of merchant category codes

@mcp.prompt()
def explain_fraud(transaction_id: int) -> str:
    # client will use returned str with an LLM to explain why a credit card
    # transaction is marked as fraud
    # return prompt with all transaction features

mcp.run()
JSON 和 XML 都可以用来描述工具和资源模式。MCP 服务器开发者通常更喜欢 XML,因为它在模式验证方面有强大的支持,避免了 JSON 所需的复杂转义和引号,并且 token 效率更高。
客户端可以通过连接到其 URL 并调用工具(调用 get_cc_features)来使用前面的 MCP 服务器:
from fastmcp import Client
config = {
    "mcpServers": {
        "cc_fraud": {"url": "https://featurestorebook.com/cc_fraud/mcp"},
    }
}
client = Client(config)
cc_fraud_features = client.call_tool(
    "get_cc_features", {
        "cc_num": "1234 65678 9012 3456",
        "merchant_id": 984365,
        "amount": 148.95,
        "card_present": True,
        "ip_address": "1.2.3.4"
    }
)
print(cc_fraud_features)
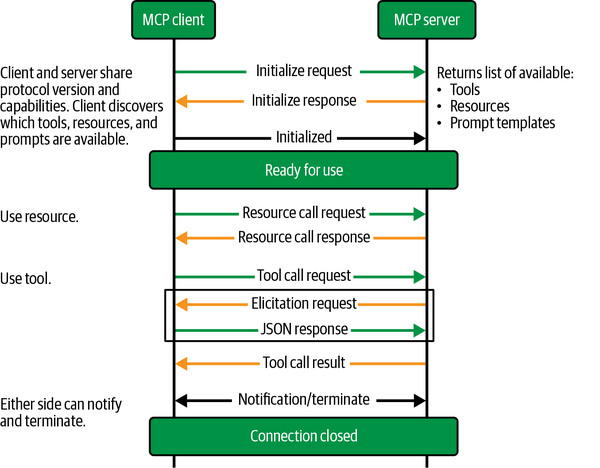
MCP 还支持客户端对服务器的身份验证。当 MCP 与一个能够选择最佳工具来调用并填写函数调用参数的函数调用 LLM 结合时,MCP 为智能体创造了最大的价值。这使得智能体更容易自主工作,生成使用外部工具/服务的计划,并利用这些外部工具的结果来使用其他工具,迭代地向其目标前进。MCP 客户端-服务器协议的交互图如图 12-6 所示。
图示说明 MCP 客户端-服务器协议,详细描述了初始化、工具/资源发现、使用命令和连接终止的阶段。
MCP 有三个主要阶段:
- 初始化阶段,客户端发现服务器支持的工具、资源和提示模板。客户端和服务器还就使用的协议版本达成一致。
- 使用阶段,客户端调用工具、使用资源或检索提示模板。在使用过程中,服务器可以通过征询(elicitation)向客户端请求额外信息,即服务器使用 JSON 模式向客户端请求结构化数据以验证响应。这使客户端能够保持对交互和数据共享的控制,同时使服务器能够动态地收集必要的信息。客户端和服务器还可以推送通知(notification),即不期望响应的消息。服务器使用通知帮助客户端跟踪请求的进度。
- 终止阶段,客户端和服务器之间的有状态连接被关闭。
智能体到智能体(A2A)协议
A2A 是一种开放协议,由 Google 于 2025 年推出,它使智能体能够发现、通信和与其他智能体协作。A2A 定义了使用 HTTP/SSE 上的 JSON-RPC 在智能体之间发送消息的消息集和规则。A2A 还标准化了"智能体卡片(Agent Card)“作为描述智能体能力的机制。任何客户端应用,不仅仅是智能体,都可以使用 A2A 来发现智能体能力,并在智能体上执行和监控短期和长期任务。该协议与模态无关(modality-agnostic),不仅处理文本,还处理流媒体、附件和结构化内容,并具有显式的 UI 能力协商。在图 12-7 中,你可以看到客户端如何通过下载和处理智能体卡片来发现智能体能力,也可以执行和监控任务,客户端可以选择在智能体要求时提供反馈。
图示说明 A2A 协议的客户端-智能体交互过程,包括发现、任务执行、交互和响应阶段。
智能体卡片是一份机器可读的 JSON 文档。它发布在智能体网络端点的一个众所周知的子路径上(例如 /.well-known/agent.json)。下面展示了一个空气质量预测智能体的简单智能体卡片示例:
{
  "name": "AirQualityPredictor",
  "description": "Returns tomorrow's PM2.5 for a given city and street.",
  "url": "https://featurestorebook.com/aqi/a2a",
  "version": "1.0",
  "capabilities": {
     "streaming": false,
     "pushNotifications": true,
     "modalities": ["text", "json"],
     "tasks": ["forecast_air_quality"]
  },
  "inputs": [{
      "name": "city",
      "type": "string",
      "description": "Name of the city for air quality prediction."
    },
    { "name": "street",
      "type": "string",
      "description": "Name of the street in the city."
    }],
  "outputs": [{
      "name": "pm25_forecast",
      "type": "float",
      "description": "The predicted PM2.5 values for the tomorrow"
    }],
  "supported_authentication_methods": [{
      "type": "api_key",
      "description": "API key in header as `Authorization: Bearer` *`<API_KEY>`* ``"
    }],
  "meta": {
    "author": "Hopsworks",
    "updated": "2025-06-22"
  }
}
智能体卡片包括:
- 智能体身份和描述
- 关于智能体是谁以及它做什么的元数据
- 服务端点
- 其他智能体或客户端可以发送 A2A 请求的 URL
- 身份验证要求
- 支持的方案,如 OAuth2 承载令牌、API 密钥和基本认证(Basic Auth),以便客户端知道如何安全连接
- 能力和任务
- 关于智能体可以做什么的详细信息(例如,流媒体支持、推送通知、特定的任务函数)
- 输入/输出格式
- 通信的默认模式(文本、JSON、文件),以帮助智能体有效地协商内容类型
A2A 还将任务(task)定义为客户端向远程智能体请求的工作单元。任务是带状态且异步的,允许客户端随时间跟踪其进度。下面是一个客户端如何在我们的空气质量智能体上调用任务(通过询问斯德哥尔摩的空气质量)的示例:
resolver = A2ACardResolver(httpx_client=httpx_client,
                base_url="http://featurestorebook.com/aqi/a2a")
agent_card = await resolver.get_agent_card()
client = A2AClient(httpx_client=httpx_client, agent_card=agent_card)
send_message_payload = {
    'message': {
        'role': 'user',
        'parts': [{'kind': 'text', 'text': \
            'What is the air quality like in Hornsgatan, Stockholm?'}],
        'messageId': uuid4().hex,
    },
}
request = SendMessageRequest(id=str(uuid4()),
             params=MessageSendParams(**send_message_payload))
response = await client.send_message(request)
注意客户端如何首先发送带有唯一 id 的 request,然后通过重新发送请求对象来 await 响应。
注意
A2A 和 MCP 是互补的协议。A2A 标准化了智能体 API 和智能体间的协调,而 MCP 标准化了智能体内部对外部工具的访问。MCP 客户端使用定义工具 API(契约)的 JSON 模式发送消息,而 A2A 客户端以自然语言发送消息,因为智能体客户端通常使用自然语言查询智能体。异步通信是 A2A 的核心部分,而 MCP 交互可以是同步的或异步的。
从 LLM 工作流到智能体
自主智能体在如何实现目标方面的不确定性既是优点也是缺点。有时,LLM 驱动的解决方案可预测且可靠更为重要。LLM 工作流有助于用常见的操作和数据流架构模式来驯服这种不可预测性,从相对静态的工作流架构到我们完全自主的智能体架构。图 12-8 展示了LLM 工作流的流行模式以及自我导向的智能体工作流(agentic workflow)。
图示比较常见的 LLM 工作流模式(提示链、并行编排、路由)与智能体工作流,突出它们在任务执行和反馈机制方面的差异。
LLM 工作流与智能体工作流之间的主要区别在于对所执行任务的控制级别,以及可用任务集是固定的还是在运行时发现的。
两种常见的 LLM 工作流是提示链(prompt chaining)和并行编排(parallelized orchestration),其中从查询到按顺序执行的静态任务集存在可预测的控制流。提示链模式(prompt-chaining pattern)涉及将 LLM 程序分解为线性的任务集。具有有限数量任务的思维链提示是一种遵循提示链模式的推理技术。如果任务可以并行执行,你可以使用并行编排模式(parallelized orchestration pattern)。Anthropic 使用这种模式构建了一个多智能体研究系统。在这里,编排器(orchestrator)接收研究查询(如"调查哪些行业对特征存储的需求最大”),然后启动并行智能体,每个智能体在不重叠的来源中搜索信息。所有并行搜索的结果由另一个 LLM 整合为对研究问题的单一答案。
路由 LLM 工作流(routing LLM workflow)是一种更动态的工作流,其中路由器 LLM 根据输入查询决定执行哪些任务。它有一组静态的可用 LLM/工具可供选择。路由模式(routing pattern)常见于编码智能体和助手。例如,Hopsworks Brewer 是一个帮助你构建 AI 管道的编码智能体,它的路由器(也称为工具调用 LLM(tool-calling LLM))对用户输入进行分类,并将其发送到最相关的智能体(有针对数据分析、代码生成、可视化等的智能体)。
提示
在设计 LLM 工作流时,在确保任务性能令人满意的情况下,尽量减少完成任务所需的步骤数。这可以减少任务延迟,并减少对 LLM 的调用次数。你还应该设计减少与 LLM 发送/接收 token 数量的提示词。这将帮助你构建响应更快、成本更低的 LLM 工作流。
智能体工作流通常简称为智能体。智能体发现可用的工具和智能体,规划使用哪些工具或智能体以及按什么顺序使用,并规划每个任务使用什么参数。智能体的目标是发现并使用最佳的可用工具/智能体来回答用户查询。总的来说,主要区别在于 LLM 工作流是节点的静态图,规划和控制的限制较大。智能体工作流模式超越了静态 DAG,智能体的控制流是即时确定的。智能体需要支持 JSON 输出的 LLM,这些输出随后被转换为工具调用。智能体分别使用 MCP 和 A2A 来动态发现工具和智能体。智能体使用工具/智能体执行任务,并向客户端请求反馈以澄清或细化其目标或实现目标的方式。智能体应该自主决定生成的答案何时足以作为最终响应,或者何时需要更多工作。智能体工作流应该具备推理和行动以实现其目标的能力:
- 发现
- 分别使用 MCP 和 A2A 协议发现工具和智能体。
- 规划
- 将复杂任务分解为子任务,并规划任务的顺序。获取成功执行任务所需的信息。
- 执行
- 分别使用 MCP 和 A2A 协议执行工具和智能体,并使用 LLM 执行任务。
- 反思
- 检查任务结果并改进任务性能。与其直接执行任务,不如先获取关于如何评估示例的信息。如果执行任务时出现错误,将错误传递给 LLM,请它修复任务执行。
例如,想象我们想要构建一个能够回答以下问题的信用卡客户支持智能体:“为什么我的信用卡交易被标记为欺诈?“你应该执行以下操作,帮助我们的智能体向客户解释交易被标记为欺诈的原因:
- 获取该用户最近被标记为欺诈的信用卡交易。使用 MCP 和特征存储以及用户 ID。
- 由于我们的信用卡欺诈特征是可解释的,你可以将特征值及其描述传递给 LLM,请它解释交易被标记为欺诈的原因。你传递的元数据越多,例如特征重要性数据,LLM 就越能提供人类可理解的、说明其被标记为欺诈的理由。
规划
智能体使用 LLM 进行规划,但 LLM 并不擅长规划。图灵奖联合得主 Yann LeCun 声称“自回归 LLM 无法规划……[因为它们]以每个 token 固定计算量来产生答案。它们没有办法投入更多时间和精力来解决困难的问题。真正的推理和规划将使系统能够搜索解决方案,并可能为此使用无限的时间。”
这种批评间接导致了参与"思考"步骤的 LRM 的发展。LRM 是专门训练或架构用于更好的推理能力的模型,超越了仅通过提示所能达到的水平。LRM 在向客户端产生响应之前,在特殊的 <think> 和 </think> token 之间添加显式的推理过程。因此,LRM 比常规 LLM 生成更多的 token,并且回复查询需要更长的时间。关于 LLM 和 LRM 是能够生成新颖的计划,还是只是记忆和复述计划,一直存在争论。一方面,研究人员认为 LRM 近似于 Daniel Kahneman 的大脑系统 2 模型:更慢、费力且深思熟虑。类似于语言使人能够进行内心独白,LRM 可以陈述、自我反思并调整其推理步骤以改进其最终响应。然而,并非所有研究人员都同意,因为有经验证据表明 LRM 只是记忆模式,并不会创造新颖的计划。
话虽如此,开发者仍然设计智能体使用 LLM 或 LRM 来生成按顺序使用哪些工具或智能体的计划。规划是一个搜索问题,路由器 LLM 是最简单的规划器:一个分类器(classifier),它接收用户查询并将其分类为与其可用工具之一的最佳匹配。更一般的规划要求智能体生成子目标,估计每个潜在步骤的奖励(使用 LLM、工具或智能体),并选择在特定步数(时间跨度(time horizon))内最大化预期奖励的路径。有时你的智能体可能需要回溯(LLM 不擅长这一点,因为它们是自回归的,只采取前向行动),有时你的智能体可能会决定没有可行的下一步。鉴于 LLM 在规划方面的局限性,构建交互式 AI 系统的一个好方法是在可能的情况下通过与客户端(用户或智能体)交互来验证计划。智能体可以在与其任务相关的规范(specification)中定义它计划做什么。客户端可以建议对规范进行细化,当客户端满意时,智能体可以执行规范中定义的计划。如果你不能让客户端验证规范,你可以使用启发式方法来验证计划。例如,一个简单的启发式方法是消除包含无效操作的计划。你还可以在智能体中编码关于它可以执行的任务的领域特定知识,它可以使用启发式方法和反思来验证计划。
为了更容易调试智能体,规划应该与计划的执行解耦。如果计划遇到问题,在重新执行之前,可能需要由客户端细化并重新验证。拥有清晰的智能体步骤追踪对于调试和改进非常重要。
注意
一般来说,你应该从编写 LLM 工作流开始,只有当你的需求要求时才进展到编写智能体。工作流最适合可预测的任务,并且可以优化为更快、更低成本地完成任务(通过减少步骤数,并在某些步骤中使用专门的[更便宜的] LLM)。只有当你需要一个自主系统来解决一个事先没有很好定义的问题,并且现有服务可以作为 MCP 服务器或在 A2A API 后面使用时,你才应该开发智能体。
安全挑战
构建生成计划以实现目标的自主智能体存在许多安全挑战。图灵奖得主 Geoff Hinton 教授告诫要谨慎对待赋予智能体生成计划的完全自由,因为它们"会很快意识到获得更多控制权是一个非常有利的子目标,因为它帮助你实现其他目标……如果这些东西在获得更多控制权方面失去控制,我们[人类]就有麻烦了。”
然而,在短期内,一个常见的安全噩梦示例是开发一个允许不可信输入但可以访问不应披露的私人信息的智能体。开发一个可以访问私有数据的公共 API 应用已经够难的了,更不用说一个公共 API 可能被不怀好意的用户绕过的智能体了。根本的挑战是智能体遵循查询中编码的指令,如果不可信的用户可以提供任意的查询,他们就可以尝试将他们的指令注入 LLM、任何使用的工具以及使用的其他智能体。你应该设法约束输入到智能体的内容,使该输入不可能对系统或其环境产生任何负面副作用。在第14章中,我们将介绍使用护栏(guardrail)作为一种帮助防止危险输入和输出智能体的技术。
你在开发智能体时也必须同样小心所使用的库。如果不怀好意的行为者可以破坏你程序中的任何软件工件,他们就可以向智能体注入他们自己的指令。确保你只使用从可信来源通过安全连接下载的可信库——保护你的软件供应链。不过,这可能意味着你要做更多的工作。例如,你可能决定不使用可能危及智能体安全的第三方库,而是重新实现它提供的功能。
领域特定(中间)表示
智能体可以产生的另一个有用的工件是智能体提议的输出/响应的领域特定(中间)表示(domain-specific [intermediate] representation)。中间表示使用户能够以易于理解的领域语言提供反馈。例如,许多用户现在使用 Lovable 这样的编码智能体开发网页,它提供生成的网页作为领域特定(中间)表示。用户迭代地改进网页,而不需要编辑或处理生成的 TypeScript 代码。类似地,Hopsworks Brewer 编码智能体以 YAML 提供特征/训练/推理管道规范的人类可读定义,用户可以迭代地改进这些管道的中间表示,而不必直接处理由它生成的 Python 代码。用户不需要理解带参数和返回类型的函数签名语法;相反,用户可以一路提示出生产级 ML 管道。
一个精心设计、始终如一地生成好代码的提示词,成为一项值得保存、重用和与他人分享的宝贵资产。我们在第8章中已经看到了一个这样的例子,当时我们设计了生成合成信用卡交易数据的提示词。
智能体的开发流程
在第2章中,我们介绍了构建 ML 系统的 MVPS 流程。对于 LLM 和智能体,你想解决的预测问题变成了你希望智能体执行的任务。智能体可以执行许多任务。从一个任务开始。你通常会跳过训练管道,使用基础 LLM(通过 API 使用一个是最容易的入门方式)。如果你需要 RAG,你需要为你的 RAG 数据源编写一个或多个特征管道。然而,推理管道(智能体)将需要自己的开发流程,这里介绍。
LLM 工作流和智能体是多步骤工作流。它们需要比氛围编程(vibe coding)更严谨的开发方法,在氛围编程中,你尝试不同的系统提示词,直到 LLM 工作流或智能体的性能"感觉对了”。工作流中任何一步的行为或性能的微小变化都可能导致响应质量的巨大下降。图 12-9 展示了一个简单而有效的 LLM 工作流和智能体开发流程,它涉及记录所有步骤的输出和时间,从用户查询到 MCP 调用(包括 RAG 数据源的查询和响应)、带有提示词的 LLM 调用,以及最终的用户响应。
图示 LLM 工作流的迭代开发过程,展示记录、分析和改进的循环,以完善提示词、模型和智能体。
日志追踪应该被存储并可用于错误分析(error analysis)(在第14章中介绍),这将推动如何改进智能体行为的见解。例如,你可以手动检查智能体响应,识别 LLM 犯的常见错误,这些错误可以通过更新系统提示词来修复。或者你可能注意到某个特定的 MCP 调用没有为 LLM 返回足够好的上下文信息。
对追踪的评估应该输出一个分数,指示对智能体或 LLM 工作流的更改是否提高了其性能。最常见的评估方法是直接评分(direct grading)或打分(scoring)。在这里,评估者根据量表(例如,忠实度或有用性的 1-5 分)或分类标签(例如,通过/失败)评估输出。评估者可以是人类标注者、领域专家,或提示良好的"以 LLM 为裁判(LLM-as-a-judge)"。获得可靠的直接评分需要对每个可能的分数或标签都有极其清晰、无歧义的定义。当你的主要目标是针对特定的、预先定义的标准评估单个步骤输出的绝对质量时,直接评分最有用。著名的 LLM 教育家 Hamel Husain 声称,仁慈的独裁者(benevolent dictator)是最好的人类评估者——一个给出始终如一(高质量)反馈的单一人员。我们将在第13章和第14章中更详细地介绍评估。
Hopsworks 中的智能体部署
Hopsworks 支持将智能体部署为 LlamaIndex Python 程序,具有用于客户端交互的 A2A API 和 MCP 服务,如图 12-10 所示。
图示 Hopsworks 中的智能体部署,集成 LLM、MCP 服务、可观测性和特征存储组件。
在 Hopsworks 中,智能体作为 Knative 容器运行,Hopsworks 提供带特征存储和向量索引的 RAG 服务、带 Opik 的追踪/日志,以及带 KServe 上 vLLM 的 LLM 服务。智能体支持 A2A API,使用 HOPSWORKS_API_KEY 进行身份验证,并通过向类添加注解来进行访问控制:
@hopsworks.a2a.agent()
class MyAgent: # The name of the class is the name of the agent
    # This decorator registers the method as a skill
    @hopsworks.a2a.skill(...)
    def skillA(...):
        """Description of skill A."""
Hopsworks 支持 Envoy AI 网关(Envoy AI Gateway)。AI 网关将 LLM 客户端与目标 LLM 解耦,使你能够轻松地为系统中的所有智能体将一个 LLM 替换为另一个。AI 网关还支持:
- 基于 token 吞吐量对客户端(智能体)进行速率限制
- Hopsworks 中 token 成本跟踪和向智能体/项目的归属
- LLM 指标,如 token 吞吐量和首 token 延迟(time-to-first-token)
- 针对 LLM 的集中式安全、治理和审计
KServe/vLLM 还增加了负载均衡和弹性伸缩,向上/向下调整用于服务 LLM 的 GPU 数量,以满足服务级别协议(service-level agreement,SLA)。最后,智能体需要像第11章中的 KServe 模型支持蓝绿部署(blue/green deployment)一样进行 A/B 测试。
小结与练习
在本章中,我们介绍了 LLM 工作流和智能体,它们是具有不同自主性水平的程序,使用系统提示词和 RAG 用恰好正确的信息填充提示词,以便使用 LLM 解决任务。我们看到,用工作流约束自主性有助于构建更可靠的 LLM 驱动服务。我们还看到,趋势是朝着越来越自主的智能体发展,它们发现并使用工具和其他智能体来实现目标。安全和规划方面仍然存在挑战,互操作性标准 MCP 和 A2A 很重要,但仍处于起步阶段。尽管如此,现在是构建与环境交互并以目标为导向方式工作的人工智能程序的激动人心的时刻。
下面的练习将帮助你学习智能体的上下文工程:
零售客户支持智能体:"我上周订购的产品 Foo 可以退款吗?”
设计一个可以执行以下操作的智能体:
- 使用用户提供的订单 ID 检索订单信息。订单包括购买时间、价格以及任何特殊条件(例如有限的退货政策)。
- 从 PDF 文档中检索并检查退款政策。
- 生成退款计划和响应。