推理管道
推理管道(inference pipeline)决定了你所构建的 AI 系统的类型。批推理管道(batch inference pipeline)是批式 AI 系统,在线推理管道(online inference pipeline)是实时 AI 系统,而智能体工作流(agentic workflow)则是基于 LLM 的 AI 系统。推理管道 是一个程序,它获取推理数据,对输入数据应用变换以产生一个或多个特征向量(feature vector),然后将这些特征向量馈送给一个或多个输出预测的模型。推理管道可以是批处理/流式/嵌入式程序,也可以是带 SLO 的网络服务,还可以是使用 LLM 和工具来实现目标的智能体。推理管道会记录其输入和输出,以便你能够监控和调试它们的性能。
本章涵盖编写批式、在线、嵌入式(embedded)和流式(streaming)推理程序时面临的挑战。智能体和 LLM 工作流将在第12章中介绍。你将学习如何设计批推理管道,并使用 PySpark 将其横向扩展。你将学习如何编写在线推理管道,从特征存储(feature store)中检索上下文/历史信息,以及如何在部署 API 背后的模型服务基础设施中部署模型。你还将学习如何将模型嵌入到流处理应用程序中,以及如何用 Python 为你的 AI 系统编写用户界面。
批推理管道
批推理管道进行非时间关键的预测,按计划运行,并将预测输出到某种推理存储(inference store),消费者从中异步检索他们的预测。它们通常通过查询特征存储来获取推理数据。例如,在第3章的空气质量系统中,我们日常的批推理管道从特征存储中读取天气预报数据,做出空气质量预测,并将预测/特征记录到特征存储中。推理存储 是任何存储批推理管道预测结果的数据存储。它可以是任何东西,从数据库到特征存储、对象存储,或事件流平台。你的批推理管道不一定非要写入推理存储——空气质量系统本可以只发布其仪表盘,而不写入预测(也不发布后报(hindcast))。但在生产系统中,你的仪表盘通常是根据推理存储中的预测创建的,而运营系统(如第1章中的 Spotify 每周发现(Discovery Weekly)示例)和监控系统(我们空气质量系统的后报)也会消费推理存储中的预测。
一个典型的批推理管道执行以下步骤:
- 使用特征视图(feature view)从湖仓表(lakehouse table)中读取/查询预计算的推理(预计算特征)数据。
- 对推理数据应用 MDT(模型相关变换(model-dependent transformation,MDT))。
- 使用变换后的推理数据调用
model.predict(..)。
推理数据是用于做出预测的特征数据。你如何查询推理数据取决于你正在解决什么类型的批推理问题。在接下来的几节中,我们将描述做出以下预测的批推理管道:
- 基于一段时间范围内的推理数据(例如昨天到达的数据或未来七天的预报)
- 针对实体的预测,例如对所有客户的预测或对所有有库存产品的预测
我们还将研究如何使用 PySpark 横向扩展批推理管道,以及如何重构你的数据模型,以在写入湖仓表时提高性能。
针对时间范围的批预测
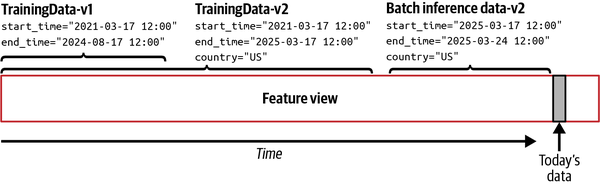
图 11-1 展示了如何使用特征视图同时检索训练数据和特定时间范围的批量推理数据。每批数据都使用查询(query)读取(见第5章)。在 v1 中,查询包含训练数据的开始和结束时间。在 v2 中,查询还包含一个过滤器,用于筛选 country 为 US 的数据。请注意,如果你只用 US 的数据训练模型,那么你的推理数据也应该只检索 US 的数据。训练和推理中应使用相同的过滤器。这既适用于批推理,也适用于在线推理。
说明特征视图如何检索特定时间范围的训练数据和批推理数据,并强调为美国数据匹配过滤器的示意图。
用于创建我们模型训练数据的同一个特征视图(名称 和 版本)按如下方式用于读取模型的批推理数据:
model_mr = model_registry.get_model(name="cc_fraud", version=1)
model_dir = model_mr.download()
model.load_model(model_dir + "/cc_fraud.json")
fv = model_mr.get_feature_view()
df = fv.get_batch_data(start_time ="YYYYMMDD HH:mm", end_time="YYYYMMDD HH:mm")
predictions = model.predict(df)
start 和 end time 参数可以是字符串,也可以是 datetime 对象。特征视图确保在使用 training_dataset_version 检索推理数据时应用相同的过滤器。
当你从模型获取特征视图时,模型返回的特征视图已使用注册在模型上的 training_dataset_version 初始化。这意味着在创建模型训练数据集时使用的任何附加过滤器,也将在读取推理数据时被应用。使用特征视图读取批推理数据或在线推理数据时,都会应用这些过滤器。例如,在你的训练管道中,你可以附加一个过滤器,比如 country 为 US,然后显式地将 training_dataset_version 与模型一起存储,如下所示:
features, labels = feature_view.training_data(train_start="...", \
    train_end="...", extra_filter=(fg.gender == "Male"))
training_dataset_version = feature_view.get_last_accessed_training_dataset()
...
model = mr.python.create_model(...
    feature_view=feature_view,
    training_dataset_version=training_dataset_version)
在读取训练数据时,feature_view 还会创建一个 training_dataset_version 来存储查询的附加元数据。查询元数据包括源特征组的 commit_ids,以及在训练数据创建时应用的任何附加过滤器。training_dataset_version 标识用于训练模型的那份训练数据。当你在模型注册表(model registry)中注册模型时,你可以显式提供其 training_dataset_version(如上一个示例所示),也可以只注册 feature_view,在这种情况下,它会注册该特征视图创建的最新 training_dataset_version。
当你实现批推理管道时,你要从模型注册表下载 model,并从下载的模型中获取 feature_view。在模型返回 feature_view 之前,它会用注册在模型上的 training_dataset_version 对其进行初始化。你可以通过调用以下方法,显式地用 training_dataset_version 初始化特征视图以进行批推理:
feature_view.init_batch_scoring(
    training_dataset_version=training_dataset_version
)
或者,在在线推理管道中,调用这个初始化函数:
feature_view.init_serving(training_dataset_version=training_dataset_version)
如果你使用 Hopsworks 的模型注册表,你可能不需要调用前面列出的初始化方法(到目前为止展示的示例都不需要初始化特征视图,因为它们在检索时会被自动初始化)。但是,如果你使用的是 Hopsworks 之外的模型注册表,你就需要调用它们。如果你不初始化 feature_view,它的 training_dataset_version 默认为 1。
针对实体的批预测
存储批推理离线特征数据的湖仓表通常按时间分区(例如按小时或按天,取决于传入数据的速率)。这样可以高效地按时间范围查询特征数据。但是,如果你的表按时间分区,而你想检索实体的最新特征数据或实体在特定时间范围内的特征数据,这将处理表中的所有行。如果表中包含大量行,全表扫描(full table scan)是非常昂贵的。
例如,在我们的信用卡系统中,如果你想读取每张信用卡的最新交易,你可以运行以下代码,它返回每张信用卡最近的一笔交易:
df = feature_view.get_batch_data(latest_features=True)
如果你有更复杂的推理数据检索逻辑,你可能需要直接在湖仓表上执行 SQL 查询。例如,下面的查询读取每张信用卡最近的三笔交易,然后(使用时间连接(temporal join))连接商户表中的特征,包括 merchants_fg 中一个新的 avg_daily_spend 特征:
WITH latest_transactions AS (
    SELECT cc_num, ts, amount, merchant_id
    FROM (
        SELECT
            cc_num, ts, amount, merchant_id,
            ROW_NUMBER() OVER (PARTITION BY cc_num ORDER BY ts DESC) AS rn
        FROM cc_trans_fg
    ) t
    WHERE rn <= 3
)
SELECT
    t.cc_num,
    t.ts,
    t.amount,
    t.merchant_id,
    m.avg_daily_spend
FROM latest_transactions t
ASOF LEFT JOIN merchants_fg m
    ON t.merchant_id = m.merchant_id
    AND m.merchants_ts <= t.ts
ORDER BY t.cc_num, t.ts DESC;
该查询会处理 cc_trans_fg 中的所有行(进行全表扫描)。由于 cc_trans_fg 是湖仓表,你可以直接在某一列上添加 Z-order 二级索引(在 Apache Hudi 和 Delta Lake 中),对分区内的行进行排序。类似地,在 Apache Iceberg 中,你可以为分区表添加排序顺序(sort ordering)。然而,使用这个查询仍然会读取所有文件。对于 Delta Lake,最近的一个替代方案是跳过 Hive 风格的分区,改用液态聚类(liquid clustering)在 cc_num 上添加二级索引,这可能有助于提高基于 cc_num 的查询性能。但是,每张表只能定义一个液态聚类索引,因此这会增加按时间范围过滤的查询的延迟。
但如果你不需要扫描表来发现预测所需的实体 ID(和时间戳),因为你已经从另一个数据源检索到了它们,那该怎么办呢?在这种情况下,你可以直接在主干 DataFrame(Spine DataFrame)中提供实体 ID 和时间戳。我们在第5章中介绍了主干组(Spine Group),如果你的特征视图中的根特征组是主干组,你需要提供一个包含子特征组实体 ID 和时间戳的 DataFrame。构建包含这些 ID 的 DataFrame 是你的责任。例如,在我们的信用卡欺诈示例中,你可能想为所有在 merchant_id=12 的商户使用过的信用卡做出预测。在这种情况下,你会编写如下代码:
input_df = cc_transactions_fg.filter(Feature('merchant_id')==12)\
            .select(['cc_num', 'merchant_id', 'ts']).read()
output_df = feature_view.get_batch_data(spine=input_df)
predictions = model.predict(output_df)
在这段代码片段中,我们仍然会对 transactions 进行全表扫描。实际上,只有当你有一种更高效的方式来读取所需的实体 ID(可能来自外部系统)时,你才会使用主干 DataFrame。
使用 PySpark 扩展批推理
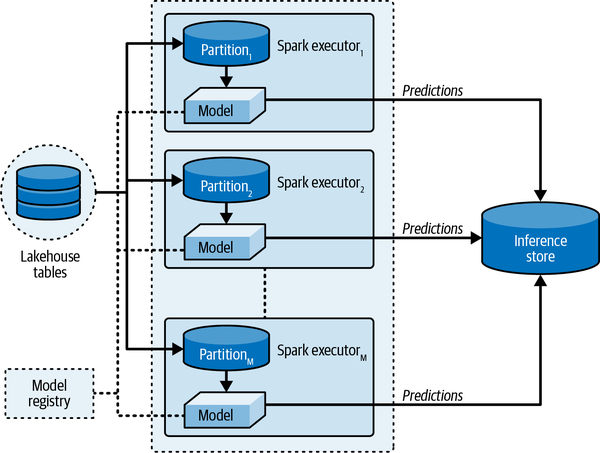
如果你有数十亿行甚至更多的批推理数据,以至于单台主机内存无法容纳,该怎么办?你可以使用分布式数据处理框架(如 PySpark 或 Ray)来横向扩展批推理。在图 11-2 中,我们展示了如何使用 Spark 横向扩展批推理程序:每个 Spark 执行器(executor)(a)从模型注册表下载一份本地模型副本,(b)从特征组(湖仓表)读取批推理数据的一个分区,(c)用模型做出预测并将结果保存到推理存储(如特征组)中。
说明使用 PySpark 的分布式批推理过程,其中 Spark 执行器下载模型并从湖仓表读取数据分区,以生成存储在推理存储中的预测的示意图。
在 PySpark 中,也可以在驱动器中读取模型,然后将序列化后的模型广播(broadcast)给执行器。然而,XGBoost 模型并不能使用 Python 的 pickle 或 cloudpickle 原生地完全序列化。PyTorch 和 TensorFlow 模型也类似地存在问题。你可以将 XGBoost 模型转换为 JSON 并广播给工作节点,但我们改为利用 HopsFS FUSE 客户端,将本地路径广播给所有工作节点,然后它们可以从自己的本地 FUSE 目录加载模型(模型通过 FUSE 客户端从 HopsFS 读取):
model_name = "example_model"
mr_model= model_registry.get_model(name=model_name, version=1)
fv = mr_model.get_feature_view()
model_dir = mr_model.download_model() # Download into hopsfs-FUSE client path

model_path = f"{model_dir}/{model_name}.json"
broadcasted_model_path = spark.sparkContext.broadcast(model_path)

@pandas_udf(returnType=FloatType())
def pred_udf(features: pd.Series) -> pd.Series:
    xgb_model = xgb.XGBClassifier()
    xgb_model.load_model(broadcasted_model_path.value)
    feature_array = pd.DataFrame(features.tolist()).values
    predictions = xgb_model.predict(feature_array)
    return pd.Series(predictions, dtype=float)

yesterday=datetime.today() - timedelta(days=1)
df = fv.get_batch_data(start_date=yesterday, primary_key=True)
df = df.select("id", pred_udf(struct(col("f1"), col("f2"))).alias("prediction"))

# store inference results in an inference store feature group
fg = fs.get_or_create_feature_group(name="inference_store", version=1,
              description = "Inference store for predictions",
primary_key=["id"])
fg.insert(df)
在这段代码片段中,Spark 执行器都将 pred_udf 作为 Pandas UDF 执行,从广播路径加载 XGBoost 模型。然后 xgb_model 通过对 Pandas DataFrame features 调用 predict() 来做出预测。预测结果存储在新的 prediction 列中,该列被添加到原始特征中,然后写入 inference_store 特征组以供后续消费。这段代码的性能还可以通过缓存 xgb_model 进一步提高,这样它每个 Spark 应用只加载一次,而不是每个分区加载一次。
批推理的数据建模
批推理程序通常只处理来自湖仓表的数据。理解开放表格式(open table format,OTF)的某些特性,对于设计更高效的数据模型非常重要。例如,我们的实时信用卡欺诈系统可以很容易地修改为批式 AI 系统——每天晚上,你安排一个批推理程序,识别前一天涉嫌欺诈的交易。许多组织从批预测开始,以获得组织对 AI 的认可,然后再转向构建实时 AI 系统。当信用卡欺诈报告到达时——可能是几周或几个月之后——你运行一个 Spark 作业,更新 cc_trans_fg 表中受影响行的 is_fraud 列值。然而,该作业需要异常长的时间才能完成,并且更新了大量的数据。你的 cc_trans_fg 表有数十亿行,但你的 Spark 作业只更新几千行。为什么它会重写湖仓表中 25% 的 Parquet 文件?
湖仓表对于频繁的小更新来说效率不高。它们会遭受写放大(write amplification)问题,即更新单行可能导致整个 Parquet 文件(从 128 MB 到 1 GB 不等)被重写。出于这个原因,OTF 支持在面向行的文件(Avro 文件格式)中累积更新,当查询到达时,它会在一个称为读取时合并(merge on read)的过程中将这些 Avro 文件与 Parquet 文件合并。随着 Avro 文件的累积,你的查询会变慢,因为 Avro 是面向行的格式,而查询在列式数据上运行更快。为了克服这一点,可以安排一个后台压缩作业或表服务(table service)运行(每小时/每天/每周一次),将 Avro 文件合并到 Parquet 文件中,并合并任何小的 Parquet 文件。
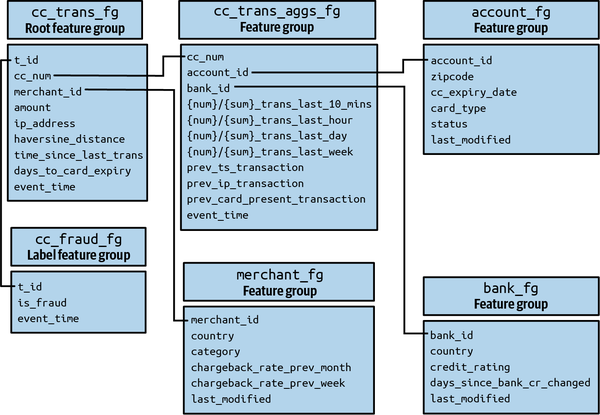
然而,另一种通常可以减少写放大的方法是重构数据模型,将更新隔离到更小的表中。在我们的信用卡欺诈示例中,我们可以将 is_fraud 标签移到 cc_fraud_fg 中——它是根特征组的一个新的子特征组,如图 11-3 所示。新的 cc_fraud_fg 表通过 t_id 外键与根特征组连接。
说明批推理的新数据模型,显示重构后的结构,其中 cc_fraud_fg 作为子特征组,通过外键连接到根特征组 cc_trans_fg 的示意图。
有了这个新数据模型,当欺诈报告到达时,我们只需将它们追加到 cc_fraud_fg 中,这不会产生写放大。但是,你必须将 cc_fraud_fg 添加到你的特征视图中,并更新你的特征管道以将标签写入 cc_fraud_fg。使用新特征视图查询训练数据和批推理数据时,会为新表增加一个连接操作,给查询引擎带来一些开销。
神经网络的批推理
使用深度学习模型的批推理可以从 GPU 加速中受益。数据以批次加载,预处理为张量(tensor),并以评估模式( model.eval() )通过模型,以禁用 dropout。推理数据的批大小(batch size)应根据可用的 GPU 内存进行调优,以避免 OOM(out-of-memory,内存不足)错误。推理前应应用与训练中相同的特征和预处理变换,以确保一致性。最后,使用 torch.inference_mode() 对于最大化性能、避免不必要的梯度计算至关重要。
我们现在展示如何对第10章中的 MNIST 示例进行批推理。首先,我们从模型注册表获取模型。从模型中,我们下载并反序列化(unpickle)我们的模型权重( state )和 MDT( transform ),并从 training_metrics 中检索超参数。我们获取模型的特征视图来检索批推理数据(自 MNIST 最初发布以来的所有新图像)。我们的 CustomMnist 在其前向传播中返回 logits,我们通过对预测应用 softmax 函数将它们转换为概率:
model_mr = model_registry.get_model("mnist", version=1)
artifact_dir = model_mr.download()
state = joblib.load(os.path.join(artifact_dir, "model.pkl"))
transform = joblib.load(os.path.join(artifact_dir, "transform.pkl"))
fv = model_mr.get_feature_view()
layer_sz = model_mr.training_metrics.get("layer_sz")
dropout = model_mr.training_metrics.get("dropout")

model = CustomMnist(layer_sz=layer_sz, dropout=dropout) # from Chapter 10
model.load_state_dict(state)
model.eval() # disable Dropout

df = fv.get_batch_data(start_time="19980301 00:00")  # inference images
dataset = ImageDataset(transform, df) # from Chapter 10
loader = DataLoader(dataset, batch_size=64, shuffle=False)

top1_probs = []
with torch.inference_mode(): # disable gradient computation
    for imgs in loader:
        logit_preds = model(imgs)
        probs = torch.softmax(logit_preds, dim=1)
        top1_probs.extend(probs.max(dim=1).values.tolist())
print(top1_probs)
面向 LLM 的批推理
你可以使用 Pandas、Polars 或 PySpark 编写批推理程序。这样一个简单的程序会读取批推理数据,将其应用到一个提示词模板(prompt template)中,将批推理请求发送给 LLM,并将输出存储到推理存储中。最简单的入门方式是使用 API 调用 LLM。
也可以下载开放基础模型(open-foundation LLM),但这不太常见。如果你想下载 2025 年最好的开源 LLM——DeepSeek V3 671B,完整 32 位权重(约 2.543 TB)——你将需要相当于八块 NVIDIA B200 GPU 的资源。即使是量化后的 4 位版本也需要约 436 GB 的 GPU 内存。出于这个原因,我们将研究通过 API 调用进行 LLM 批推理。
在推理中,通过在上下文窗口(context window)(提示词)中提供更多任务特定信息,LLM 可以给出更好、更可预测的结果。你还可以在上下文窗口中提供任务的示例,从而让 LLM 能够利用上下文内学习(in-context learning)来学习如何解决该任务。以下术语被广泛用来指代 LLM 在提示词的上下文窗口中获得多少个示例:
- 零样本(Zero-shot)
- 只给 LLM 任务描述,不提供示例。
- 单样本(Single-shot)
- 在任务描述之前给 LLM 一个示例。
- 少样本(Few-shot)
- 在任务描述之前给 LLM 多个示例。
你使用提示词模板来设计你的 LLM 查询,因为如上所示,它使你可以更容易地向上下文窗口添加示例。上下文窗口包含发送给 LLM 的查询,包括任务描述以及任何示例或附加上下文信息。
当你设计 LLM 批推理管道时,它应该包含以下步骤:
- 从你的数据源读取批推理数据。
- 对于批推理数据的每一行,使用提示词模板构建一个可能包含单样本或少样本示例的查询。
- 一次一个地将查询发送到 LLM API 端点,直到所有推理数据都被处理完(考虑 API 速率限制、成本,以及 LLM 每分钟/每小时将为你处理的数据大小限制)。
- 将 LLM 响应保存到推理存储中供分析/处理,或者在收到一批响应时急切地执行操作。
下面是一个更详细的代码示例,它使用 OpenAI LLM 来回答过去 10 分钟内到达的问题。我们从离线特征组 questions 中读取推理数据。我们将这些问题发送到 LLM 端点,并将响应保存到离线的 responses 特征组中供后续消费:
from tenacity import retry, wait_exponential, stop_after_attempt
from openai import OpenAI

questions_fg = fs.get_feature_group("questions", version=1)
responses_fg = fs.get_feature_group("responses", version=1)
openai_api_key = proj.get_secrets_api().get_secret("OPENAI_API_KEY").value
client = OpenAI(api_key=openai_api_key)

ten_minutes_ago = datetime.now(timezone.utc) - timedelta(minutes=10)
df = questions_fg.filter(questions_fg["ts"] > ten_minutes_ago).read()

model = "gpt-5"
max_tokens = 500
temperature = 0.7

def generate_prompt(question, example):
    return (
        "Answer the question clearly and accurately.\n\n"
        f"Example: \n{example}\n"
        f"Q: {question}\nA:"
    )

@retry(wait=wait_exponential(min=4, max=60), stop=stop_after_attempt(5))
def single_predict(question, example):
    prompt = generate_prompt(question, example)
    response = client.responses.create(
                model=model,
                input=prompt,
                max_output_tokens=max_tokens,
                temperature=temperature,
                reasoning={"effort": "minimal"}
    )
    return response.output_text.strip()

df['response'] = df.apply( \
    lambda row: single_predict(row['question'], row['example']), axis=1)
responses_fg.insert(df[["question", "response"]])
这段代码一次一个地将预测请求发送到 LLM API 端点。它包含一个单样本提示词(带有一个如何回答该问题的示例)。我们将答案写入一个单独的特征组,而不是写入 questions 中的 answer 列,因为向湖仓表追加数据远比更新现有的湖仓表高效得多。
该代码使用由 tenacity 库定义的注解,以防止你超出 API 速率限制和令牌配额(token quota)。令牌配额是在指定时间范围内(例如每天)允许的最大令牌数。temperature 参数控制 OpenAI 模型输出的随机性。较低的值产生更确定性的响应,而较高的值则产生更多样化、更有创意的答案。你可能需要根据你的用例、LLM 提供商协议和负载来调整这些参数。
如果你能为你的任务找到或创建一个足够小的微调模型,那么也可能从基于 API 的批推理切换到使用嵌入式模型的批推理。现在还出现了一些用于 LLM 批推理的新库,例如 fenic,其中 LLM 推理是 DataFrame 上的列操作( map / classify / extract / semantic.join )。
在线推理管道
初出茅庐的 ML 工程师最向往的一句话可能是"部署模型"(deploying a model)。但你很少只部署一个模型。你通常部署的是一个在线推理管道——一个 24/7 全天候运行在网络端点之后的操作服务,接受预测请求并输出预测和日志。如果模型不在远程 API 后面,那么在线推理管道首先将模型从模型注册表下载到模型服务(model-serving)服务中,使模型可以通过在线推理管道的 API 调用(而不是模型自身的签名)。在线推理管道还连接到一个特征存储,该存储提供预计算特征、相似性搜索和日志记录。
确保库的离线-在线一致性
在第2章中,我们说过你需要确保 ODT(按需变换(on-demand transformation,ODT))和 MDT 的离线和在线实现之间不存在偏差(skew)。然而,你还必须确保特征/训练/推理管道中 ODT/MDT 所使用的库彼此兼容。例如,如果你在训练管道中用 joblib 1.2 对模型进行 pickle 序列化,然后试图在你的(批式或在线)推理管道中用 joblib 1.1 下载并反序列化它,你很可能会得到一个错误。
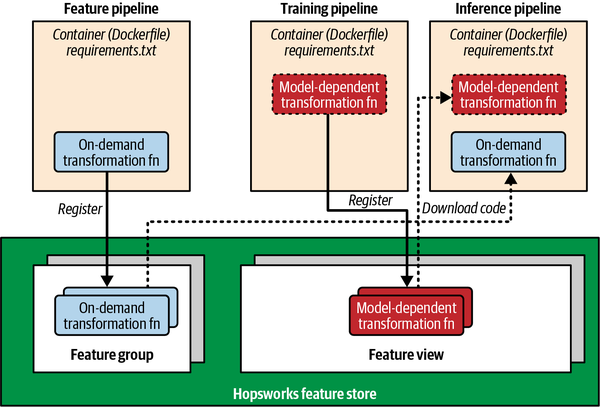
图 11-4 展示了 Hopsworks 如何将 ODT 存储在特征组中、将 MDT 存储在特征视图中。当你在推理管道中使用特征视图时,它会透明地下载 ODT 或 MDT 的 Python 源代码,确保推理中使用相同的函数(及其状态)。
说明 Hopsworks 如何在特征、训练和推理管道中将按需变换和模型相关变换存储在特征组和视图中,并提供带兼容库版本的 FTI 基础容器的示意图。
该图还展示了 Hopsworks 如何为 FTI 管道提供基础容器,这些容器在三种不同的管道中具有兼容版本的库。如果你通过添加 Python 依赖来自定义容器,或者你没有在 Hopsworks 上运行 ML 管道,你需要确保在你的 FTI 管道中安装兼容版本的库。
使用 FastAPI 的模型部署
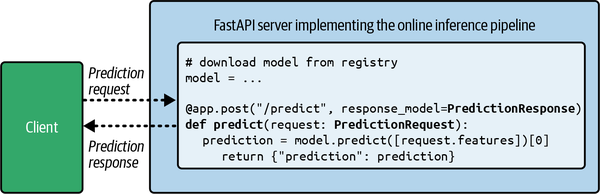
图 11-5 展示了一个简化的模型部署。它使用 FastAPI 框架通过 HTTP API 使模型可调用。
使用 FastAPI 的模型部署服务器示意图,显示客户端发起预测请求与接收响应之间的流程。
FastAPI 是一个高性能的 Web 框架,用于在 Python 中构建基于 HTTP 的服务 API。它构建在 Pydantic 框架之上,使用类型提示来验证、序列化和反序列化预测请求和响应。在 FastAPI 中,你使用 PredictionRequest 和 PredictionResponse(Pydantic 类)来定义模型部署的模式(schema)。它们分别是部署模式的参数和返回类型。下面是一个 FastAPI 的示例代码:
from fastapi import FastAPI
from pydantic import BaseModel
app = FastAPI()

mr = hopsworks.login().get_model_registry()
model_dir = mr.get_model("simple_model", version=1).download()
model = XGBRegressor()
model.load_model(os.path.join(model_dir, "model.json"))

class PredictionRequest(BaseModel):
    features: list[float]

class PredictionResponse(BaseModel):
    prediction: float


@app.post("/predict", response_model=PredictionResponse)
def predict(request: PredictionRequest):
    prediction = model.predict([request.features])[0]
    return PredictionResponse(prediction=float(prediction))
首先,模型从模型注册表下载到本地目录,然后从 model.json 加载为 XGBoost 回归模型。predict 方法从 PredictionRequest 对象中提取参数,作为 model.predict() 的输入特征,并返回 prediction(一个 float)。在这个简单示例中,部署 API 和模型签名(model signature)(模型的按序输入和返回类型)是相同的。
LLM 部署
你能使用 FastAPI 来服务任意大小的 LLM 吗?是的,你可以。但你需要 GPU、大量内存,以及高性能的存储和网络。开始服务 LLM 的最简单方式是使用预训练模型(pretrained model)。Hugging Face 是一个流行的预训练模型市场,你可以使用它的 transformers 库直接从其网站下载模型。例如,你可以下载一个模型及其分词器(tokenizer),然后将它们一起注册到 Hopsworks 的模型注册表中,如下所示:
from transformers import AutoTokenizer, AutoModelForCausalLM

tokenizer = AutoTokenizer.from_pretrained("deepseek-ai/DeepSeek-V3")
model = AutoModelForCausalLM.from_pretrained("deepseek-ai/DeepSeek-V3")

deepseek_local_dir = "deepseek_dir"
model.save_pretrained(deepseek_local_dir)
tokenizer.save_pretrained(deepseek_local_dir)

deepseek = mr.llm.create_model(
    name="deepseek-V3",
    description="DeepSeek-V3 671B model (via HF)"
)
deepseek.save(deepseek_local_dir)
这段代码以 .safetensors 文件格式下载 DeepSeek V3(6710 亿参数,FP8 精度)的文件,以及它的分词器。总共有 163 个 .safetensor 文件。几乎所有这些文件的大小都是 4.3 GB,模型在磁盘上总共约为 700 GB。由于这个模型如此之大,最好在你的本地模型注册表中保存一次,而不是每次想要部署它进行服务时都从 Hugging Face 下载。Hopsworks 模型注册表将模型文件存储在 HopsFS 中,这是一个分层分布式文件系统,支持在 HopsFS 数据节点的本地(NVMe)磁盘上对近期文件进行时间缓存。HopsFS 的长期存储层是一个 S3 对象存储。需要 NVMe 磁盘来存储和加载庞大的 LLM 文件,以防止训练和推理管道受磁盘 I/O 限制。DeepSeek 推出了自己的分布式文件系统,名为 Fire-Flyer 文件系统(Fire-Flyer File System,3FS),它使用 NVMe 磁盘来优化训练期间的文件系统性能。
模型与特征视图的部署 API
在大多数在线推理管道中,(模型)部署 API 和模型签名是不同的,因为并非所有特征都通过预测请求传入。特征可以从特征存储中检索,也可以按需计算。例如,当模型需要历史/上下文信息时,可以在预测请求中发送实体 ID,并使用这些实体 ID 从特征存储中检索预计算特征。
对于 LLM,你可以使用提示词模板向用户提供的提示词添加额外文本,或者使用 RAG(检索增强生成(retrieval-augmented generation,RAG))从向量索引(vector index)中检索文本块。最终提示词中的文本在发送给 LLM 之前还需要进行分词。LLM 的部署 API 应该是清晰的文本输入和输出,而 LLM 的模型签名则期望编码后的文本作为输入,并产生清晰的文本作为输出。
部署 API 定义了客户端向其发送预测请求的在线推理管道的接口。图 11-6 展示了我们信用卡系统模型部署的一个简化示例。部署 API 接收一笔信用卡交易的参数(参见我们在图 4-9 中的数据模型)。部署 API 有两种不同类型的参数:
- 服务键(Serving keys)
- 用于从在线特征存储中读取预计算特征
- 请求参数(Request parameters)
- 用作 ODT 的参数,或作为传递特征(passed feature)(直接进入特征向量的特征值,覆盖特征存储可能返回的任何预计算特征值)
说明部署 API 使用用户提示词、上下文键和结构化数据构建特征向量,以使用模型生成预测的过程的示意图。
在线推理管道实现为一个 Python 程序,它在启动时加载模型和任何依赖项,然后提供一个或多个 predict 方法对模型进行预测。在 Hopsworks 中,实现在线推理管道的代码可以在所谓的预测器脚本(predictor script)中实现如下:
class Predictor():
    def __init__(self):
        mr = hopsworks.login().get_model_registry()
        mr_model = mr.get_model("cc_model", version=1)
        self.model = XGBClassifier()
        self.model.load_model(os.path.join(mr_model.download(), "model.json"))
        self.fv = mr_model.get_feature_view()

    def predict(self, inputs):
        features = self.fv.get_feature_vector(
            serving_keys = {"cc_num": inputs[0]["cc_num"],
                            "merchant_id": inputs[0]["merchant_id"]},
            passed_features = {"amount": inputs[0]["amount"],
                      "card_present": inputs[0]["card_present"]},
            request_parameters = {"ts": inputs[0]["ts"],
                                  "ip_addr": inputs[0]["ip_addr"]}
        )
        prediction = self.model.predict(features)
        self.fv.log(features, predictions = prediction)
        return prediction
Predictor.init() 方法在启动时调用一次,它下载模型并检索特征视图。在 predict() 的代码中,fv.get_feature_vector(..) 执行以下步骤:
- 从在线特征存储中检索预计算特征。
- 合并预计算特征和传递特征值。
- 使用
request_parameters和预计算特征计算 ODT。 - 计算在特征视图上定义的 MDT。
- 删除任何索引列和/或推理辅助列。
- 将变换后的特征向量作为 DataFrame 或列表返回。
在这里,cc_num 和 merchant_id 是服务键,而我们需要显式地定义 predict 的哪些参数是传递特征,哪些是用于变换函数的请求参数。
amount 和 card_present 都是传递特征,而 ts 和 ip_addr 是 ODT 的参数。预计算特征 prev_ip 和 prev_ts 是 ODT 的参数,但不是模型的特征。出于这个原因,它们在特征视图中被定义为推理辅助列(inference helper column)。由于预计算特征以列表或 DataFrame 的形式返回,推理辅助列需要从列表或 DataFrame 中删除。特征和预测在返回给客户端之前也会被记录。在 Hopsworks 中,日志会异步写入特征视图的一个日志特征组中。
前面的 Predictor 部署程序相当复杂,但幸运的是,你可以通过调用以下方法自动生成它:
deployment = model.deploy(passed_features=["amount","card_present"])
这将创建一个 predictor.py Python 源代码文件,其中包含带有 init() 和 predict() 方法的 Predictor 类,以及上述所有用于检索模型和特征视图、然后从请求参数、预计算特征和变换创建特征向量的调用。
注意
你也可以在 Hopsworks 中创建一个特征视图部署(feature view deployment),而不带模型。如果你的模型服务基础设施与你的特征存储是分开的,这很有用。你可以调用 deploy 一个特征视图,它会创建与模型部署相同的部署,只是去掉模型本身。特征视图部署计算变换、记录特征值,并将变换后的特征向量返回给客户端,由客户端执行模型预测。
预测器脚本随后作为模型部署部署到 Hopsworks 上的模型服务基础设施( KServe/vLLM )上,带有 REST 或 gRPC 端点,准备接受预测请求。你还可以使用以下命令检查部署的 API:
print(deployment.schema)
它将打印出你的部署的请求参数、传递参数、服务键和返回类型。这是你的客户端应用程序应该依赖的 API。部署 API 应该比模型签名更稳定。部署 API 遵循信息隐藏原则(information-hiding principle)。只要请求参数、服务键和返回类型不变,你就可以安全地更改预测器的实现方式。
部署 API 的另一个优点是,模型版本可以随时间变化而不会破坏客户端。例如,你可以升级 XGBoost 模型,或者用按需计算的特征替换预计算特征,而不需要客户端进行任何更改。部署 API 是一个契约(contract),它不仅包含模式,还应该有 SLO(服务级别目标(service-level objective,SLO)),定义每天/每月/每年可接受的停机时间,以及响应的 p99 延迟。p99 值是一个延迟阈值,99% 的请求必须在该延迟阈值内完成;否则,就违反了 SLO。例如,在实时推荐中,99% 的请求应该在 10 毫秒内返回。相比之下,对于 LLM,p99 可能高达数十秒。
在 Hopsworks 中,你还可以创建特征视图部署,外部客户端可以通过 REST 或 gRPC API 访问它们。如果你将模型托管在 Hopsworks 之外的模型服务基础设施上,但又想使用 Hopsworks 作为特征存储,这很有用。你可以按如下方式部署特征视图:
fv_deployment = fv.deploy(passed_features=["amount","card_present"],
        resources={"instances"="1", "cores": 0.5, "memory_mb": 1024*2})
生成的预测脚本代码与模型服务的情况相同,只是省略了与模型相关的代码。部署模型或特征视图的代码还会为部署分配容器。你应该配置正确的资源量(包括容器实例的数量)以及每个容器的资源:CPU 数量、内存量和 GPU 数量。你还可以利用自动扩缩(autoscaling)来根据指标变化(例如每秒预测请求数)增加/减少活动容器的数量。
使用 KServe 的模型服务框架
FastAPI 缺乏许多企业级能力,例如 GPU 分配、弹性可扩展性、认证、访问控制和审计。这些能力通常由模型服务平台提供。我们将主要研究 KServe,它是一个基于 Kubernetes 的开源模型服务平台,支持多种后端,以满足不同的 ML 框架和用例。KServe 提供:
- 可插拔的模型服务后端
- 对于较小的决策树模型,你可以使用 FastAPI 这样的轻量级框架;对于需要 GPU 的模型,可以使用 NVIDIA Triton 作为性能更高的全能型后端;对于服务最大的 LLM,可以使用 vLLM。
- A/B 测试
- 你可以在模型的两个版本(蓝绿)之间路由请求,从而在流量最终切换到新模型版本之前比较它们的性能,前提是其行为可接受。
- 多模型服务
- 多个模型可以部署在单个容器中。
- 无服务器部署(Serverless deployments)
- 部署根据请求负载自动扩缩,包括缩容到零,以及通过创建容器实例并在它们之间进行负载均衡来扩容。
- 指标、监控和日志记录
- 这些为模型部署提供可观测性。通过监控请求处理延迟并发出告警,你可以为模型部署支持 SLO。
KServe 还使你能够将在线推理管道分解为两个 Python 程序:变换器(transformer)和预测器(predictor)。在上一节中,我们介绍了执行预处理、模型预测和后处理步骤的 Predictor 类。在 KServe 中,可以将预处理和后处理步骤重构到一个单独的变换器容器中,而预测器容器只执行模型预测。如果你的预处理或后处理任务计算复杂但不需要 GPU,而你的预测器需要 GPU,那么变换器就很有用。如果只使用预测器混合执行 CPU 密集型与 GPU 密集型的操作,会降低 GPU 利用率。变换器和预测器合在一起被称为推理服务( InferenceService )。
在图 11-7 中,你可以看到 KServe 上的一个模型部署,它同时包含变换器和预测器,并连接到 Hopsworks 中的许多基础设施服务。
说明 KServe 模型部署利用 Hopsworks 的特征、日志记录和 GPU 管理服务,展示变换器与预测器组件之间连接的示意图。
预测器是一个模型服务框架。KServe 支持的后端包括:
- TensorFlow Serving
- 该后端针对服务 TensorFlow 模型进行了优化,提供高性能推理,并支持版本控制和 A/B 测试等功能。
- TorchServe
- TorchServe 专为 PyTorch 模型设计,提供多模型服务、日志记录和指标,并支持 REST 和 gRPC 两种协议。
- ONNX Runtime
- 它支持开放神经网络交换(Open Neural Network Exchange,ONNX)格式的模型,实现跨平台互操作性和跨不同硬件的优化性能。
- Python server
- 这是一个灵活、低开销、与 ML 框架无关的后端,常用于服务 XGBoost 和 Scikit-Learn 模型。它构建在 FastAPI 服务器之上。
- NVIDIA Triton 推理服务器
- 这是一个高性能的模型服务平台,支持多种框架,主要在 GPU 上运行。
- vLLM
- 它针对服务 LLM 进行了优化。
Triton 和 vLLM 是两个性能最高的后端,提供动态批处理(dynamic batching)和优化内存管理等高级功能,可以显著提高吞吐量并降低特定工作负载的延迟。
KServe 推理服务需要连接到其模型部署所需的基础设施服务。Hopsworks 为 KServe 提供日志记录和指标(OpenSearch 用于日志,Prometheus 用于指标)的插桩,添加认证和访问控制,管理部署的 KServe 容器,并将部署连接到特征存储、模型注册表和向量索引。
最后,虽然 KServe 是我们在这里用来部署模型的 API,但你可能还必须配置后端的模型服务框架。例如,要部署我们之前注册到模型注册表的预训练 DeepSeek V3 模型,你必须为 vLLM 后端提供一个额外的 YAML 文件,例如:
path_to_config_file = "deepseek_vllmconfig.yaml"
deepseek_depl = deepseek.deploy(
    name="deepseek-V3",
    config_file=path_to_config_file,
    resources={"num_instances": 1,
    "requests": {"cores": 24, "memory_mb": 1024*512, "gpus": 8}},
)
性能与故障处理
我们将研究如何用 Python 编写 ODT 和 MDT,使它们能够以更低的延迟作为 Python UDF 在在线推理管道中运行,并以更高的吞吐量作为 Pandas UDF 在特征管道中运行。如果你需要更低延迟的 ODT,我们将研究原生函数(native function)。
混合模式 UDF
为了估计 Python UDF 和 Pandas UDF 之间的延迟差异,我编写了一个计算输入数字平方的简单函数。我在我的八核 Linux 笔记本电脑上将该函数作为 Python UDF 与 Pandas UDF 进行了基准测试。对于单行数据(包括创建 DataFrame 所需的时间),Python UDF 版本所花的时间是 Pandas UDF 的千分之一。例如,下面是一个从三个参数返回最大值的变换函数。请注意,由于 hopsworks.udf 装饰器,我们不能直接调用该函数,而必须通过 invoke() 包装函数调用来调用它:
import numpy as np

@hopsworks.udf(float)
def max_param(param1, param2, param3):
    result = np.maximum.reduce([param1, param2, param3])
    return result

# Example usage as a Python UDF
result_python = max_param.invoke(1.0, 2.0, 3.0)

batch_size = 2500000
data = pd.DataFrame(np.random.rand(batch_size, 3),
                      columns=['param1', 'param2', 'param3'])

# Example usage as a Pandas UDF on a batch of rows
results_batch = \
    max_param.invoke(data['param1'], data['param2'], data['param3'])
由于 Python 中的动态类型(dynamic typing),这段代码可以在混合的 Python/Pandas UDF 模式下执行。我们没有显式定义参数的类型。实际上,Python 解释器会将 param1、param2 和 param3 的类型推断为 Union[float, pd.Series]。也就是说,当作为 Python UDF 执行时,param1/2/3 是浮点数;当作为 Pandas UDF 执行时,它们是 pd.Series。在我的笔记本电脑上,Python UDF 执行需要 0.0598 毫秒,而处理 250 万行的 Pandas UDF 只需要 60.8871 毫秒。用 Python UDF 处理 250 万行运行 max_param 需要 5,663.67 毫秒——比 Pandas UDF 慢 100 倍。这意味着前面的代码对在线推理管道具有较低的延迟,但又可以扩展以在特征管道中回填大量特征数据。
然而,有时变换逻辑无法编写成可以在混合模式下执行。例如,在下面的代码片段中,我们创建了 250 行、20 列的合成数据(混合字符串和整数)。该变换按某一列对行进行排序,并返回前五行。如果我们想将此代码作为 Python UDF 运行,我们应该将行作为数组传入。相比之下,Pandas UDF 应该接收 DataFrame 或 Series,并使用向量化的 Pandas 操作来处理它,而不是遍历单个行:
def process_rows_array(rows, sort_column_index):
    sorted_rows = sorted(rows, key=lambda x: x[sort_column_index], reverse=True)
    return sorted_rows[:5]

def process_rows_pandas(df, sort_col_name):
    return df.sort_values(sort_col_name, ascending=False).head(5)

rows, cols = 250, 20
col_names, data, sort_col_name, sort_col_index = generate_sample_data(rows, cols)
top5_array = process_rows_array(data, sort_col_index)
df = pd.DataFrame(data, columns=col_names)
top5_pandas = process_rows_pandas(df, sort_col_name)
在我的笔记本电脑上,Python UDF 执行需要 0.076 毫秒,而 Pandas UDF 需要 0.621 毫秒。但是,前面的代码不包括创建 Pandas DataFrame 的成本。Hopsworks 在线特征存储以面向行的格式返回预计算特征,默认情况下是数组。将面向行的记录加载并转置为列式的 Pandas DataFrame 总是有成本的。如果 Pandas UDF 引入了太多延迟,但你仍然需要在特征管道中使用 ODT,你应该支持两种不同的实现,确保两种实现产生等效的结果。编写一个单元测试,确保两个函数在典型输入参数下返回相同的结果。如果你不需要在特征管道中使用 ODT,你可以使用原生 UDF 进一步降低变换延迟。
原生 UDF 与记录并等待
如果你需要最低延迟的 UDF 来实现 ODT,你应该用编译型语言(如 C、C++ 或 Rust)来实现它们。用原生代码实现特征函数的主要缺点是,目前没有开源的可扩展 DataFrame 库可以轻松地在特征管道或训练管道中执行它们。也就是说,你无法轻松地针对历史数据运行你的特征函数。但是,如果你永远不需要从历史数据创建特征——也就是说,如果你能从在线系统记录特征函数的输出,并等待收集到足够的特征数据,使你有足够的数据来训练模型——这就不是问题。
在 2023 年的特征存储峰会(Feature Store Summit)上,Jin Shang 介绍了微信的实时特征计算引擎,他们在 C++ 中定义特征函数,引擎自适应地选择两个计算引擎之一来执行特征函数,目标是最小化计算延迟。当特征请求以小批量到达时(通常少于八行),它执行原生 C++ 函数。对于较大的批量,它使用 LLVM 即时(just-in-time,JIT)编译引擎(Gandiva)将特征函数编译为向量化的 Arrow 函数。对于较小的批量,与原生版本相比,向量化的 Arrow 函数会增加延迟;而对于较大的批量,与原生版本相比,向量化执行会降低延迟。
在线推理管道中的故障处理
模型部署是需要对数据问题、失败或缓慢的特征管道以及请求失败具有鲁棒性的操作服务。你的在线推理管道应该对缺失或延迟的特征数据以及外部服务调用的失败具有鲁棒性。
首先,在线推理程序包含逻辑,并可能从许多不同的来源读取数据。你应该在代码中将操作(包括错误)记录到标准输出( stdout )和标准错误( stderr ),以便所有部署的日志都被传送到一个集中式日志平台。Hopsworks 透明地将部署的 stdout / stderr 记录到 OpenSearch,聚合日志并使它们可以通过 OpenSearch Dashboards 搜索。Splunk 和 Elastic 是你可能使用的另外两种流行的日志管理系统。日志管理系统支持在出现错误时发出告警、实时故障排除,以及对部署中的错误进行根因分析。
失败的第二大原因是数据。在线推理管道可以从许多不同的来源接收数据,并可能面临如下问题:
- 请求参数值可能缺失。
- 预计算特征可能因特征管道的问题而缺失或延迟——特征管道可能允许缺失数据,或者本身可能缓慢/延迟。
- 预计算特征或 RAG 数据可能因特征存储或向量索引不可访问(由于网络或服务器问题)而缺失。
- ODT 可能有缺失或无效的参数值。
- MDT 可能有缺失或无效的参数值。
- 第三方 API 调用可能超时或返回错误数据。
糟糕的数据挑战应该由特征管道中针对预计算特征的数据验证逻辑来处理。你的在线推理管道应该处理请求参数缺失值和第三方 API 调用的问题。你应该将缺失值记录到 stdout / stderr,以便你能识别和排查问题,但你仍然需要设计回退策略(fallback strategy),例如:
- 插补缺失值:
- 对于数值特征,使用训练数据集中的均值/中位数/众数
- 使用轻量级预测模型进行基于模型的插补
- 用默认值替换缺失值。
- 如果无法从特征存储中检索到特征的最新值,则使用缓存或历史值。例如,你可以添加一个线程安全的字典(dict),其中键是你的特征视图的服务键,值是该服务键最近返回的行。只有当无法从特征存储中检索到最新特征值时,才应该从缓存中获取最近的值。
- 如果数据缺失,则回退到更简单的模型。
模型部署 SLO
模型预测延迟在测试时可能很低,但在部署后却很高。这是为什么?图 11-8 显示,总延迟是你在在线推理管道中所有步骤所用时间的总和。
说明在线模型预测中不同步骤的延迟分解,突出显示预计算特征检索、变换、模型预测和日志记录的不同时间范围(从亚毫秒到数秒不等)的示意图。
你可能需要从特征存储或向量索引中检索预计算特征,使用 ODT 从请求参数创建特征,应用 MDT,对模型调用 predict,记录特征值和预测结果,然后返回预测响应。所有这些步骤都会增加预测请求的延迟,从客户端到模型部署的网络延迟也是如此。在 KServe 中,如果你将推理服务拆分为变换器和预测器容器,也会增加延迟。为了降低延迟,如果可能的话,只使用预测器容器。
Hopsworks 的库实现了许多减少特征检索延迟的技术:
- 对特征视图中多个服务键并行发出主键查找
- 当你拥有雪花模式(snowflake schema)数据模型时,将
LEFT JOIN下推到 RonDB - 在 RonDB 中下推投影(projection),只读取特征视图中表示的特征组中你需要的特征
- 将请求时聚合(request-time aggregation)下推到 RonDB
- 在单独的线程控制流中进行异步非阻塞日志记录
对于 RAG,你可以通过减少 k(相似性搜索中的响应数量)来降低延迟。对于 LLM 的函数调用(function calling),你需要注意你调用的函数或工具在有限时间内提供响应或返回错误。对于任何进行网络调用的数据检索步骤,你需要为网络故障或服务故障设置较短的超时时间。如果超时到期而没有响应,你的在线推理管道应该捕获异常,并根据 SLO 是否允许,它可以重试调用或插补缺失的特征数据。
使用嵌入式模型的推理
许多支持 AI 的应用程序无法承受或容忍为检索预计算特征或第三方数据而进行的网络调用。例如,自动驾驶汽车、机器人和高频交易系统要求模型预测在某个延迟界限内返回,例如 1 毫秒或 50 微秒。尽管许多开发者认为"快"就是实时的同义词,但实时系统的主要特征是其操作必须在固定的时间间隔内完成。确保有界延迟(bounded latency)的最佳方法是使用嵌入式模型(embedded model)或主机本地模型(host-local model)。你通常需要消除对不可靠网络(互联网只提供尽力而为(best-effort)的保证)或分布式服务(可能失败或缓慢)的依赖。
使用嵌入式模型的应用程序可以随应用程序包一起分发模型,例如将模型添加到你的容器中,或者将模型从模型注册表下载到本地存储。图 11-9 展示了模型如何从模型注册表下载到本地磁盘,然后直接在应用程序中加载,或者在应用程序使用的模型服务进程中加载。
展示在应用程序中使用模型的两种方法的示意图:一种是将模型从本地磁盘嵌入到应用程序中,另一种是使用进程间通信访问同一主机上的模型服务进程。
通过在启动时从本地磁盘加载模型,应用程序或模型服务进程避免依赖远程模型注册表的可用性和可访问性。在设计嵌入式模型时,你需要考虑应用程序设备的限制。模型预测是使用应用程序的硬件进行的,所以如果模型需要硬件加速,你需要确保主机上会有可用的硬件加速。
嵌入式 AI 应用
大多数高性能和边缘(edge)应用程序不是用 Python 编写的,而是用 C/C++、Rust、Go 和 Java 等编译型语言编写的。一些 ML 框架支持这些语言。例如,XGBoost/LightGBM 有 C++ 库和 Java 原生接口(Java Native Interface,JNI)绑定。你可以将特征/训练管道保留在 Python 中,但仍然使用 C/C++/Java 进行嵌入式推理,方法是使用语言原生的库直接将模型加载到应用程序中。类似地,ONNX 格式提供了 C++ API,同样使 C++ 和 Java 应用程序能够调用深度学习模型(深度学习模型通常也需要硬件加速才能获得良好性能)。
流处理 AI 应用
流处理程序可以使用嵌入式模型对传入的数据流做出预测。例如,网络入侵检测系统处理来自事件流平台的实时网络流量日志/事件,以预测当前网络活动是异常的(入侵尝试)还是正常的。使用 Apache Flink 或 Spark Structured Streaming 等框架编写的流处理应用程序,可以使用嵌入式 XGBoost 分类器对流量流进行高吞吐量、低延迟的预测。
下面的代码片段展示了一个使用嵌入式模型进行预测的 Spark Structured Streaming 流处理管道:
# to enable workers to reuse the cached model persists across tasks, set
# spark.conf.set("spark.python.worker.reuse", "true")

schema = StructType([
    StructField("duration", FloatType(), True),
    StructField("src_bytes", FloatType(), True),
    StructField("dst_bytes", FloatType(), True),
    StructField("flag", StringType(), True)
])

xgb_path = # path to model on S3 or HopsFS
bcast_model_path = spark.sparkContext.broadcast(xgb_path)

_xgb_model = None

# Load the model once per worker, instead of once per partition
def _get_model_once():
    global _xgb_model
    if _xgb_model is None:
        m = xgb.XGBClassifier()
        m.load_model(bcast_model_path.value)
        _xgb_model = m
    return _xgb_model

@pandas_udf(DoubleType())
def predict_udf(duration, src_bytes, dst_bytes, flag):
    features_df = pd.DataFrame({
        'duration': duration,
        'src_bytes': src_bytes,
        'dst_bytes': dst_bytes,
        'flag': flag
    })

    model = _get_model_once()
    predictions = model.predict(features_df)
    return pd.Series(predictions, dtype="float64")

raw_stream = spark.readStream.format("kafka") \
    .option("kafka.bootstrap.servers", "IP_ADDRESS_KAFKA_BROKER:9092") \
    .option("subscribe", "network-traffic") \
    .option("startingOffsets", "latest") \
    .load()

json_stream = raw_stream.selectExpr("CAST(value AS STRING) as json") \
    .select(from_json(col("json"), schema).alias("data")) \
    .select("data.*")

predictions_stream = json_stream.withColumn("prediction",
    predict_udf(
        col("duration"), col("src_bytes"), col("dst_bytes"), col("flag")
    )
)

fg_sink = fs.get_feature_group("predictions_fg", version=1)
query = fg_sink.insert_stream(predictions_stream)

query.awaitTermination()
该程序从 network-traffic Kafka 主题读取数据,包括流量流的 duration(持续时间)、源发送的字节数( src_bytes )、目标发送的字节数( dst_bytes ),以及一个表示传输层(通常是 TCP)连接状态的 flag(标志)——成功、拒绝、重置等。例如,一个 duration 很长、src_bytes 非常高且 dst_bytes 几乎为零的连接可能表明存在数据泄露或拒绝服务攻击。类似地,如果短时间内从源 IP 产生了大量流量流,且标志表示连接被拒绝,则可能表明存在端口扫描。关于使用 AI 进行网络入侵检测的更多细节,请参见 Sarika Choudhary 和 Nishtha Kesswani 的文章“Analysis of KDD-Cup'99, NSL-KDD and UNSW-NB15 Datasets using Deep Learning in IoT”。
用 Python 为 AI 应用编写 UI
通常,你需要为你的 AI 系统开发一个快速的 UI,以向利益相关者反馈系统将如何工作。重量级的生产方法是,在模型服务基础设施上部署你的模型,并用 JavaScript 编写 UI。但如果你不会 JavaScript 编程怎么办?幸运的是,你可以用 Python 编写 UI,下载模型,并在 Python 程序中本地执行推理。使用 Streamlit、Gradio 和 Taipy 等框架,可以快速开发带 UI 的 Python 应用程序。每个框架都有自己的强项。Streamlit 通过声明式、基于脚本的编码简化了 UI 的创建。Gradio 程序具有更简洁、基于函数的风格,对初学者更友好。Taipy 支持更好地集成 JavaScript 和 CSS,以构建更复杂的 UI。作为 Python 程序,它们可以从模型注册表下载模型,并将其用作嵌入式模型。这通常是你能为 AI 系统构建的最快的 UI,有时它甚至可以是 AI 系统的最终 UI。
对于我们的信用卡欺诈系统,本书的源代码仓库中有一个 Streamlit UI。该 UI 允许你生成合成信用卡交易,并在模型将交易标记为欺诈时通知你。Streamlit 的一个挑战是,刷新 UI 的选定部分并不容易。Streamlit 会同时刷新整个 UI,这会导致执行 UI 程序中的所有 Python 代码。该代码在高层结构如下:
import streamlit as st

@st.cache_data()
def download_model():
    ...
@st.cache_resource()
def read_batch_inference_data():
     ...

if submit_button:
    df["prediction"] = model.predict(df)
    st.dataframe(df)
这里使用装饰器来缓存函数输出,这样它们就不会在每次重新运行时被重新计算:
@st.cache_data用于纯的、确定性的函数,并缓存返回值。@st.cache_resource用于返回有状态(资源密集型)对象的函数,例如从特征存储读取的推理数据 DataFrame。
对于我们的信用卡欺诈示例,你应该缓存模型和特征视图对象,这样就不必在每次 UI 刷新时重新下载它们。
总结与练习
本章考察了批式、在线、嵌入式(embedded)和流式推理管道。对于批推理,我们研究了如何使用特征视图检索一段时间范围内的推理数据和针对实体的推理数据,以及如何使用 PySpark 扩展批推理。对于在线推理管道,我们介绍了用于隐藏模型签名的部署 API,并研究了如何使用 Python/Pandas/原生 UDF 优化在线推理的延迟和吞吐量、处理故障以及满足 SLO。对于 LLM,我们研究了基于 API 的批推理和使用 KServe 的 GPU 服务。
完成以下练习,以帮助你学习如何扩展你的推理管道:
- 为产品推荐构建一个批推理管道。你的模型只在美国可用的产品上训练过——你的产品表有一个 “country” 列(即
country = 'US')。描述你将如何确保只为批推理检索到正确的批推理数据。 - 当你使用 PySpark 和 XGBoost 模型进行批推理时,将模型作为 JSON 字符串广播与在每个执行器上从分布式存储加载模型之间有哪些权衡?
- 你想为实时信用卡欺诈预测部署一个 p99 为 10 毫秒的在线推理管道。描述你将如何最小化整个管道的延迟,考虑到变换函数、模型加载、特征检索和日志记录。