训练管道
模型训练是数据科学中最广泛、最深入的领域。我们将涵盖训练全谱系模型时所涉及的最重要概念和可扩展性挑战,从 XGBoost 决策树,到使用 Ray 进行大规模深度学习,再到使用低秩适配(low-rank adaptation, LoRA)微调 LLM。关于这些主题有大量资源可供深入学习。我们将聚焦于掌握模型训练的阴阳两面:
- 以模型为中心的 AI(model-centric AI)
- 通过实验模型架构和调优超参数来迭代改进模型性能的过程
- 以数据为中心的 AI(data-centric AI)
- 通过选择特征和数据来迭代改进模型性能的过程
要成为一名出色的数据科学家,你需要同时擅长以模型为中心和以数据为中心的训练。秉持我们的阴阳哲学,我们将涵盖训练管道(training pipeline)最重要的实用要素:学习算法的选择、在特征存储(feature store)中将标签连接到特征、特征选择(feature selection)、训练数据集创建、模型架构、分布式训练(distributed training)和模型评估。我们还将审视在 GPU 上扩展模型训练时所面临的性能挑战。
特征组中的非结构化数据与标签
在第2章的 MVPS 开发方法论中,你从识别预测问题和可用于解决该问题的数据源开始。预测问题可分为三类:需要数据集中显式标签/目标的监督学习(supervised learning)、不需要带标签数据的无监督学习(unsupervised learning),以及从数据中自行创建标签的自监督学习(self-supervised learning)。自监督学习和无监督学习传统上与图像、音频、视频和文本文件等非结构化数据相关联。
自监督学习与无监督学习
自监督学习和无监督学习模型不需要单独的标签/目标。例如,LLM 预测一段文本序列中的下一个 token。你不需要外部提供的标签,因为标签就是下一个 token。自监督学习是指算法从输入数据中自动生成标签。LLM 使用预测出的下一个 token 来预测后续 token,并不断使用之前的 token 预测来继续预测,直到预测出一个停止 token。使用先前预测作为输入的模型被称为自回归模型(autoregressive model)。
注意
自回归模型可能不稳定。例如,在我们的空气质量示例中,如果仅使用滞后的空气质量(例如,前一二三天的数据)作为特征来提前七天预测空气质量,预测中可能会出现误差累积,产生失控的预测。解决方案是使用天气特征来稳定预测,这使得滞后空气质量成为一个好特征,只要你不让模型在滞后特征上过拟合。
另一种用于语言模型的自监督算法是掩码语言建模(masked language modeling),它因 BERT 变换器模型而广为人知。在训练期间,BERT 随机掩码(隐藏)输入文本序列中的目标词,并训练语言模型预测缺失的词。由于 BERT 不使用先前预测的词,它不是自回归的。
特征存储可以通过在特征组中索引关于非结构化数据文件的信息来管理非结构化数据(用于无监督和自监督 ML),从而更容易处理和搜索文件。对于非结构化数据集中的每个文件,你在特征组中存储一行,包含关于该文件的元数据和文件路径。表 10-1 展示了一些无监督和自监督 ML 模型的示例,以及为它们存储在特征组中的数据。
| ML 模型 | 特征组 | 预测问题 |
|---|---|---|
| 预训练 LLM | 存储用作训练数据的文件名和元数据的特征组 | 预测下一个 token。自监督。 |
| 向量嵌入(vector embeddings) | 存储图像、音频和文本文件特征和嵌入的特征组 | ANN 搜索。无监督。 |
| kNN | 存储图像、音频和文本文件特征的特征组 | 搜索/聚类。无监督。 |
| GAN | 存储图像、音频和文本文件文件名和元数据的特征组 | 异常检测。无监督。 |
| 稳定扩散(stable diffusion) | 存储图像文件名、元数据和图像文本描述的特征组 | 从文本描述生成图像。部分无监督。 |
k 近邻(k-nearest neighbor, kNN)是一种无监督学习算法,用于 (a) 近似最近邻(approximate nearest neighbor, ANN)搜索和 (b) 对一组无标签数据点进行分割或聚类。你也可以将 kNN 用作分类/回归的监督方法。
警告
如果你在特征组中索引图像/视频/音频文件,你需要确保特征组中的文件路径与文件之间的一致性。如果你移动/删除文件,就会破坏这种关联。
另一种无监督学习算法是生成对抗网络(generative adversarial network, GAN)。GAN 由两个神经网络组成——生成器(generator)和判别器(discriminator)——它们在一个反馈回路中相互竞争。生成器创建新的输入数据样本,而判别器则试图区分真实样本和生成的样本。它们不需要带标签的数据,因为学习从这种对抗过程中涌现,推动生成器产生与原始数据分布高度相似的输出。例如,一个在非欺诈信用卡交易上训练的 GAN 可以识别新交易是否与非欺诈样本存在显著偏差。
稳定扩散网络(stable diffusion network)是另一种包含无监督学习的算法。它用于从文本生成图像。训练中的核心扩散步骤是无监督学习,模型学习预测并去除噪声以重建原始输入图像。
监督学习需要标签
对于监督学习,预测问题的起点是标签/目标。你如何为预测问题找到标签?如果幸运的话,标签已经可用,存储在数据仓库的表、操作型数据库或文件中。有时你需要编写代码来创建标签。例如,在我们的信用卡示例中,我们有一个表 cc_fraud,它存储被标记为欺诈的交易。要为所有交易创建标签,我们需要将 cc_fraud 中的行与非欺诈交易 credit_card_transactions 连接起来,如下所示:
fraud_df = fs.get_feature_group("cc_fraud").read()
transactions_df = fs.get_feature_group("credit_card_transactions").read()
transactions_df = transactions_df.merge(fraud_df, on="t_id", how="left")
transactions_df["fraud"] = transactions_df["fraud"].fillna(0)
我们使用一个 LEFT JOIN(实现为 Pandas merge),这样 transactions_df 中在 fraud_df 中没有匹配行的行,其 fraud 值将为 null。匹配的行在 fraud 中会有 “1”;然后我们使用 fillna(0) 将不匹配行的 null 值设置为 “0”。
非结构化数据的标签
有时创建标签需要非编码工作,尤其是对于非结构化数据。例如,在深度学习的早期工作中,图像分类数据集的大部分标签是由人类手动在图像中被分类的部分周围绘制边界框来创建的。手动标注非结构化数据的工作在扩展时成本高昂,因此已经开发出加速标注的技术。例如,弱监督(weak supervision)利用大量有噪声的标签数据来生成大量可信度较弱的标签。有时,拥有大量质量尚可的标签比拥有少量高质量标签更好。Cleanlab 是一个流行的开源库,支持弱监督。Cleanlab 还可以修复/清理标签数据,既适用于非结构化数据,也适用于结构化数据。
当你使用特征存储作为标签来源时,通常首先将标签作为特征组导入。如果标签是外部存储中的现有表,你很可能可以将该表挂载为外部特征组。或者,你可以将静态标签数据集直接导入特征组。如果标签数据不是静态的,则编写一个批处理特征管道将标签摄取到特征组中。表 10-2 展示了不同类型 ML 模型的标签如何在特征组中管理。
| ML 模型 | 标签特征组 | 预测问题 |
|---|---|---|
| 决策树 | 包含特征、标签列以及(可选)event_time 的特征组。 | 分类或回归 |
| 时间序列:Prophet 和 ARIMA | 将时间序列数据存储为特征的特征组,包括 event_time 和 primary key,以及作为标签列的测量值。 | 时间序列预测 |
| 卷积神经网络(convolutional neural network, CNN) | 存储图像、音频和视频文件路径的特征组。边界框、分割掩码和标签作为标签。 | 图像、音频和视频的分类和分割 |
| 变换器(transformer) | 存储表格数据以及图像、音频和文本文件路径作为特征、标签作为列的特征组。 | 机器翻译、时间序列预测、图像分割等 |
| 微调 LLM | 将指令数据集存储为指令、输入列作为特征、输出列作为标签的特征组。 | 能更有效回答问题的聊天机器人 |
| 用于 RLHF 的奖励模型 | 将偏好数据集存储为指令、输入和响应特征、首选响应作为标签的特征组。 | 给出符合人类期望答案的聊天机器人 |
我们已经广泛介绍了特征组中的表格数据。决策树和时间序列模型(如 Meta 的 Prophet 或自回归积分滑动平均(autoregressive integrated moving average, ARIMA))的数据天然存储在特征组中。非结构化数据源也可以作为文件路径/URI 加上元数据列和/或关于文件的标签存储在特征组中。CNN 和变换器通常使用来自文件(图像、音频、视频)的非结构化数据进行训练。
预训练 LLM 使用文本数据进行监督微调(supervised fine-tuning, SFT)和偏好调优(preference tuning),通常存储在 JSON Lines(JSONL)文件中。与 JSON 相比,JSONL 可以在不重写整个文件的情况下追加内容,并且可以以流式方式读写。对于指令数据集(instruction dataset)——即 LLM 监督微调的训练数据——每一行包含三列:
- 指令(Instruction):给模型的任务或指示
- 输入(Input):为任务提供的上下文
- 输出(Output):针对指令和输入的预期结果或响应
偏好数据集(preference dataset)在指令数据集的基础上扩展了额外的字段,以表示多个可能的响应,以及首选响应或每个响应的分数。它们用于训练基于人类反馈的强化学习(reinforcement learning with human feedback, RLHF)的奖励模型,RLHF 是 LLM 的一种训练后对齐步骤,用于调整其行为,使其更安全、更有用,并与伦理原则和社会规范保持一致。
遵循 JSON 模式的指令数据集和偏好数据集都很容易存储在特征组中,每个 JSONL 行是特征组中的一行,指令、输入、输出和响应是列。特征组相对于 JSONL 文件的好处类似于使用数据库而非原始文件。JSONL 文件没有索引或搜索能力。查询数据和更新/删除行的成本很高。将指令和偏好数据集存储在特征组中还为你提供时间旅行(time-travel)支持,以及跟踪哪些模型使用这些数据集训练的血统(lineage)信息。
根特征组与标签特征组
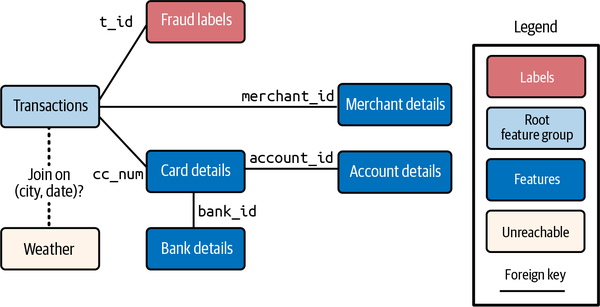
特征组中的每一列要么是索引列,要么是特征。特征组不将其任何列指定为标签。特征视图(feature view)可以将特征组中的一个或多个列定义为标签。在特征视图的上下文中,为特征视图提供标签的特征组被称为标签特征组(label feature group)。在我们迄今看到的 AI 系统中,标签存储在特征视图的根特征组(root feature group)中(图 10-1 中的 transactions)。然而,标签也可以存储在根特征组的子特征组中(图 10-1 中的 fraud labels)。如果你想创建一个没有标签的特征视图,你仍然会有一个根特征组并照常选择特征,但不会有标签特征组。
描述特征视图层次结构的示意图,以 “Transactions” 为根特征组,显示与 “Fraud labels”、“Card details”、“Merchant details”、“Account details”、“Bank details” 以及一个不可达的 “Weather” 特征组的连接。

根特征组是特征视图的起始特征组。从根特征组出发,你可以将可通过图遍历(graph traversal)到达的任何特征或标签包含在特征视图中。所谓图遍历,是指如果特征组是节点、外键是边,那么从根特征组到包含特征或标签的特征组之间必须存在一条路径。如果没有到某个特征组的路径,例如图 10-1 中的 Weather,你就不能包含它的特征。要能够将 Weather 特征添加到以 Transactions 为根特征组的特征视图中,你需要从根特征组出发选择一个可达的特征组。然后在该特征组上,添加一个指向 Weather 的外键。例如,假设 Weather 以 city 作为主键、date 作为事件时间,通过特征工程,你可以在 Transactions 中添加一个 city 列,通过地理定位交易的 ip_address 来计算。然后你可以通过 city 列将 Transactions 与 Weather 连接,从而将 Weather 特征包含在特征视图中。该连接还会确保时间点正确的数据,使用 Transactions 的事件时间 ts 和 Weather 的 date 列,自动将时间戳转换为日期。
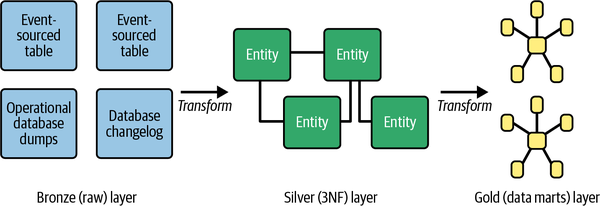
图 10-1 是一个数据集市(data mart)的示例。许多管理数据集市的数据团队希望数据科学家只使用数据集市的数据。但如果你需要其他表的原始数据来为所需模型创建特征呢?在数据仓库的经典三层奖章架构(medallion architecture)中,数据集市是最后一层(称为黄金层(gold layer);见图 10-2)。
描述数据仓库奖章架构的示意图,显示数据从青铜层(原始数据)经白银层(3NF)流向黄金层(数据集市),强调每个阶段的变换。

在黄金层之后,还有其他可能对创建特征有用的表。第一层(青铜层(bronze layer))通常存储来自操作型数据库和事件流平台的原始数据副本。为此,你需要访问青铜层中的 Parquet 或湖仓(lakehouse)表。中间(第二)层称为白银层(silver layer),它通常以第三范式(third normal form, 3NF)将清洗和去重后的数据存储在(湖仓)表中。如果你无法在黄金层中找到特征和标签的源数据,你还应该查看白银层和青铜层。可能需要你为特征或标签创建一个新的黄金层——使用雪花模式(snowflake schema)或星形模式(star schema)数据模型。
特征选择
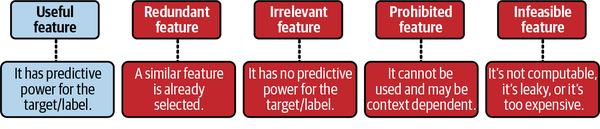
此时,你已经识别了标签并将其导入特征组。你应该为模型选择哪些特征?图 10-3 提供了如何识别对模型有用特征的高层指导。有用的特征对标签/目标具有预测能力,你可以通过可视化特征与目标的关系并计算快速信号检查(互信息、单调趋势、预测能力分数)来验证。
描述模型选择的特征类别示意图,突出具有预测能力的有用特征,并警告冗余、无关、禁用和不可行特征。

选择特征时,你应该避免:
- 冗余特征(redundant features)
- 通过计算候选特征之间的相关性矩阵来识别冗余特征,以捕捉线性相关性。如果两个特征高度相关,排除其中一个,因为它不增加新信息,却增加了复杂性、存储成本和处理时间。
- 无关特征(irrelevant features)
- 运用常识,不要只是尽可能多地包含特征。无关特征会增加成本,并使模型更难收敛。
- 禁用特征(prohibited features)
- 确保你的特征组有标识其使用范围的标签。例如,如果你训练的模型不允许使用 PII,就不要包含来自带 PII 标签的特征组的特征。
- 不可行特征(infeasible features)
- 这些特征由于某种原因无法计算或使用。泄漏特征(leaky features)是不可行的,因为它们包含预测时无法获得的信息。另一个例子是,如果你的在线模型可以从某个特征中受益,但该特征的计算成本过高,会破坏模型的 SLO(service-level objective,服务等级目标)。
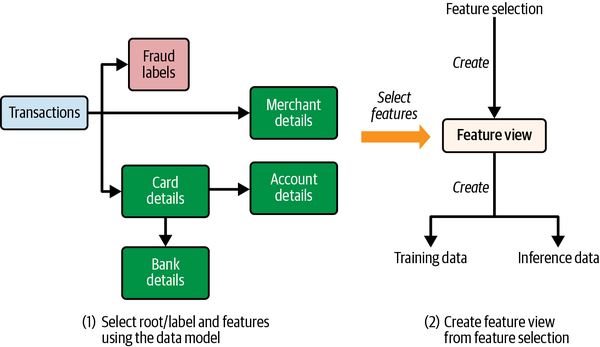
特征选择的目标是创建一个特征视图,其中包含将用于模型训练和推理的特征(和标签)(见图 10-4)。在 Hopsworks 中,你首先识别根特征组。这通常是标签特征组,但不一定。如果两者不同,标签特征组应该能够直接与根特征组连接(作为子特征组)。
描述从根特征组创建特征视图的示意图,整合标签和特征组,为模型开发产出训练和推理数据。

这里,我们从图 10-1 创建特征视图,包含来自各特征组的全部特征:
card_subtree = card_details.select_features()
.join(account.select_features())
.join(bank.select_features()
)
selection = transactions.select_features()
.join(fraud_labels.select_features())
.join(card_subtree)
.join(merchant.select_features()
)
fv = fs.create_feature_view(name="trans_fv", version=1,
         query=selection,
         labels=['fraud']
)
在代码片段中,我们连接来自特征组的所选特征,而没有显式指定连接列。在这种情况下,Hopsworks 会将父特征组中与子特征组的主键(和事件时间)列匹配的列识别为连接列。在这个示例中,我们没有做太多选择。我们选择了所有可用的特征。然而,特征选择应该是一个选择对目标或标签具有预测能力的特征子集的过程。我们刚刚选择的所有特征不太可能都对欺诈标签具有预测能力。
但是,你如何知道应该从特征组中包含哪些特征呢?有四类传统的特征选择方法,用于精炼所选特征集:
- 递归特征添加/消除方法(recursive feature addition/elimination methods)
- 这些方法是一种以数据为中心的超参数调优形式:你创建许多具有不同特征组合的特征视图,并选择能够产生模型表现最佳的训练数据集的那个特征视图。
- 过滤方法(filter methods)
- 这些方法根据统计或信息论标准(例如互信息)对特征进行排序来选择特征,并选择排名最高的特征,与下游学习算法无关。
- 包装方法(wrapper methods)
- 这些方法使用启发式搜索策略(例如递归特征消除)识别一个局部最优的特征子集,以最大化下游预测模型的性能。
- 嵌入方法(embedded methods)
- 这些方法在模型学习过程中选择特征,通常基于鼓励特征稀疏性的正则化技术。
一种最近的新颖特征选择方法是使用 LLM 和自然语言来选择特征。通过 RAG 或提示工程,你在 LLM 提示中添加可用特征组、其特征以及特征统计属性的描述。然后 LLM 利用这些信息、你的请求(例如,“选择特征来预测信用卡交易是否欺诈”)以及对预测问题的领域知识,从特征组中提出合适的特征。
LLM 还可以建议当前不可用、但你可以从现有数据源创建的特征。Jeong 等人表明,“仅给定输入特征名称和预测任务的描述,[LLM] 就能够选择最具预测性的特征,其性能可与数据科学的标准工具相媲美。"1 但要小心:LLM 可能表现出从其预训练数据中继承的偏见,可能导致糟糕的特征选择。尽管如此,我认为向 LLM 询问其对该任务最佳特征的意见并无坏处。
训练数据
当表格训练数据足够小、可以放入内存时,你可能应该将训练数据读取为 Pandas DataFrame。与 CSV 文件中训练数据的大小相比,Pandas 高效运行通常至少需要文件大小两到三倍的 RAM,因为 Pandas 在操作期间会创建中间副本。PySpark 和 Polars DataFrame 都不是训练数据理想的内存中 DataFrame。PySpark 的 DataFrame 是分布式的,大多数训练管道最终会调用 df.toPandas(),这会将 Spark DataFrame 复制到驱动程序上的 Pandas DataFrame,存在内存不足(out-of-memory, OOM)错误的风险。Polars 在 Scikit-Learn 中还没有得到支持(你需要将 DataFrame 复制到 Pandas DataFrame 或 NumPy 数组),但如果你在训练管道中有计算密集型的 MDT,它可能是一个不错的选择。
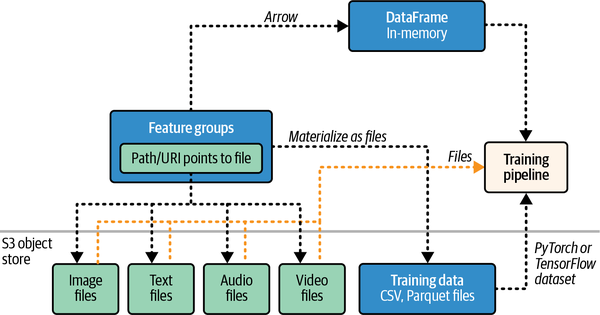
图 10-5 展示了从特征组创建训练数据的三种不同方式:
- 内存中的 DataFrame,以 Arrow 数据读取
- 从特征组物化到磁盘(CSV、Parquet)的文件
- 来自对象存储的非结构化数据文件,DataFrame 提供文件路径和元数据
描述 Hopsworks 如何以内存 DataFrame 或物化文件的形式检索训练数据的示意图,非结构化数据从对象存储建立索引。
当训练数据通过特征视图从特征组物化到文件时,有许多不同的文件格式可以用作不同 ML 框架中的训练数据(见表 10-3)。
| 训练数据 | 格式 | ML 框架 |
|---|---|---|
| 表格数据文件 | CSV、Parquet | Scikit-Learn、XGBoost、Prophet、PyTorch、TensorFlow |
| 指令/偏好数据集 | JSONL | 用于 LLM 的微调 |
| 张量:文件、预处理 | HDF5、TFRecord、NPY | PyTorch、TensorFlow |
| 张量:文件、非结构化 | PNG、MP3、MP4 等 | PyTorch、TensorFlow |
CSV 和 Parquet 是表格训练数据流行的文件格式。CSV 是一种行导向的文件格式,几乎所有 ML 框架都支持。CSV 文件的可切分性(splittable)很差,因为切分文件时必须知道行边界。Parquet 是一种列式文件格式,比 CSV 具有更好的压缩支持,主要 ML 框架也支持。Parquet 文件可以切分为许多文件和目录,从而可以存储分布在许多较小文件(GB 级)上的海量表(PB 级)。前面提到的 JSONL 文件用于微调预训练 LLM。TFRecord 在第6章中介绍过,它是一种行导向、二进制、可切分的文件格式,对顺序输入/输出(I/O)高效。PyTorch 和 TensorFlow 都使用张量作为训练和推理的主要数据结构,通过它们的数据集 API(Dataset APIs)无缝集成。
分层数据格式 5(Hierarchical Data Format 5, HDF5)是一种不可切分的文件格式,用于存储大型数值数据数组(包括张量)和元数据。它可以存储复杂的分层数据(嵌套数据结构),并支持高效的 I/O 和随机访问。然而,由于它不可切分,不适合管理用于多主机训练的大量数据。NPY 也是一种不可切分的文件格式,只能存储 NumPy 数组。由于 NumPy 数组被设计为存储数值数据,你的所有特征数据都需要首先转换为数值表示。你也可以将压缩后的 NumPy 数组存储为 NPZ 文件。NPY 文件与 Scikit-Learn 配合良好,但我仍然建议 Scikit-Learn 使用 Parquet 文件,因为 Parquet 文件可切分、压缩,并且与特征存储和 Spark、Pandas 等特征工程框架配合良好。
在第5章中,我们研究了在专门的训练数据集管道中将训练数据物化为文件。这将模型训练分解为两个阶段:首先,运行训练数据集管道将训练数据创建为文件;然后,运行训练管道将训练数据拟合到模型。使用独立训练数据集管道的一些原因包括:
- 你的训练是 CPU 密集型的,导致 GPU 利用率不足。这可能是因为你在 CPU 上执行了大量计算密集型的 MDT。
- 你的训练数据大于训练模型的容器中可用的内存,导致 OOM 错误。当训练数据为文件形式时,PyTorch 和 TensorFlow 等 ML 框架中的数据加载器可以在训练期间流式读取训练行(样本),从而限制训练作业中的内存使用。
我们现在来看训练数据创建中的子任务:切分训练数据和可复现的训练数据。
切分训练数据
在第3章中,我们使用随机切分(random split)切分了空气质量预测系统的训练数据。对于使用时间序列数据构建的 AI 系统,例如我们的信用卡欺诈系统,时间序列切分(time-series split)更可取,因为我们想看看模型是否能泛化到发现它没有训练过的新型欺诈模式。例如,如果你有 48 个月的信用卡交易数据,用前 42 个月的数据训练模型,并用最后 6 个月的数据评估其性能。在 Hopsworks 中,你可以将训练数据创建为文件,并按时间序列切分为训练集和测试集,如下所示:
feature_view.create_train_test_split(
            train_start="2021-01-01", train_end="2024-06-15",
            test_start="2024-07-01", test_end="2024-12-31",
            storage_connector=s3_bucket,
            ...
)
前面的代码指定 s3_bucket 作为文件的目标位置。如果你不指定 storage_connector 并且在 Hopsworks 上运行此程序,文件将存储在项目中的 <proj>_Training_Datasets 目录中。
提示
对于像欺诈这样的时间序列问题,你通常需要在 train_end 和 test_start 之间留出间隔,以避免当特征基于滚动聚合时出现重叠。
如果你打算在训练模型时进行超参数调优,你应该创建三个切分:训练集(train)、验证集(validation)和测试集(test)。训练集用于训练模型,验证集用于调优超参数和选择最佳模型,测试集用于评估最终模型在未见数据上的性能。常见的切分比例是训练 70%-80%、验证 10%-20%、测试 10%-20%,不过这取决于数据集规模和问题领域。你可以在 Hopsworks 中按如下方式创建训练/验证/测试切分的 Pandas DataFrame:
X_train, X_val, X_test, y_train, y_val, y_test =
  feature_view.train_validation_test_split(validation_size=0.1, test_size=0.15)
有时,随机切分和时间序列切分还不够。数据很少是独立同分布(independent and identically distributed, i.i.d.)的。对于不平衡分类,例如我们的信用卡欺诈系统(欺诈交易少于非欺诈交易),分层采样(stratified sampling)可确保切分保留正向欺诈行的比例。也就是说,它可以跨切分维持类别平衡。
k 折交叉验证(k-fold cross-validation)有助于提高稳健性。例如,在 Hopsworks 中,你可以将特征和标签读取为 DataFrame,并使用 Scikit-Learn 的 StratifiedKFold 进行一次分层训练/验证切分,如下所示:
from sklearn.model_selection import StratifiedKFold

X, y = feature_view.training_data()
skf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
train_idx, val_idx = next(skf.split(X, y.squeeze()))
X_train, X_val = X.iloc[train_idx], X.iloc[val_idx]
y_train, y_val = y.iloc[train_idx], y.iloc[val_idx]
可复现的训练数据
可复现的训练数据对合规性很重要——如果训练数据集已被删除,但特征数据仍在特征存储中,你应该能够重新创建训练数据。如果你想训练许多模型并比较它们的性能,它也很重要——你需要确保它们的训练数据是相同的。例如,如果每次训练新模型时都重新创建训练-测试切分,如果你不小心,很可能会得到不同的训练/验证/测试数据切分。
使用随机或时间序列切分重新读取训练数据,并不保证返回相同的训练/测试集。对于时间序列切分,自上次读取请求以来,特征数据可能已被添加/删除/更新。对于随机切分,可能使用了不同的随机数种子。
Hopsworks 中的解决方案是只创建一次训练数据,并让所有模型使用 training_dataset_version 重新读取相同的训练数据(见第5章)。当你创建训练数据集时,Hopsworks 会存储元数据,包括用于切分的随机种子和特征组的提交 ID,以确保它在创建 training_dataset_version 的时间点重新读取训练数据。
训练时还有其他随机性来源:权重初始化、数据增强(data augmentation)、计算统一设备架构(Compute Unified Device Architecture, CUDA)内核和 dropout 都会引入随机性,并在各个训练轮次(epoch)之间打乱训练数据。跨轮次打乱训练数据在深度学习模型中至关重要,因为它可以提高泛化能力并防止过拟合。为确保可复现性,你应该在训练时设置随机种子,使打乱在多次训练运行之间是确定性的。以下是在 PyTorch 中设置随机种子的示例代码:
SEED = 42
os.environ["PYTHONHASHSEED"] = str(SEED)
# For full CUDA matmul determinism (set before CUDA ops):
os.environ.setdefault("CUBLAS_WORKSPACE_CONFIG", ":4096:2")

random.seed(SEED)
np.random.seed(SEED)
torch.manual_seed(SEED)
torch.cuda.manual_seed_all(SEED)

torch.backends.cudnn.benchmark = False
torch.use_deterministic_algorithms(True)  # error if nondeterministic op

X_df, y_df = feature_view.get_training_data(training_dataset_version=1)

X = torch.tensor(X_df.values, dtype=torch.float32)
y = torch.tensor(np.ravel(y_df.values), dtype=torch.long)

g = torch.Generator()
g.manual_seed(SEED)

def seed_worker(worker_id):
    # Ensures each worker has a deterministic RNG state derived from SEED
    worker_seed = SEED + worker_id
    np.random.seed(worker_seed)
    random.seed(worker_seed)
    torch.manual_seed(worker_seed)

dataset = TensorDataset(X, y)
dataloader = DataLoader(
    dataset, batch_size=10,
    shuffle=True,           # uses the generator below
    generator=g,            # deterministic shuffles across epochs
    num_workers=0,          # safest for determinism; or >0 with seed_worker
    worker_init_fn=seed_worker if 0 else None,
)
模型训练
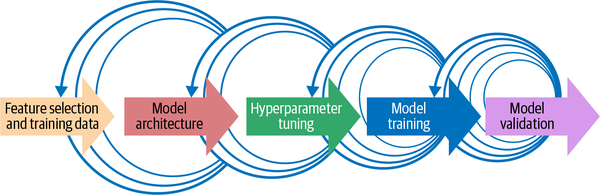
训练一个满足需求的好模型是一个迭代的、实验性的过程。以模型为中心的方法通过改变模型架构、调优超参数和增加训练时间来提升模型性能。以数据为中心的方法包括添加更多训练数据和添加/删除特征。目标是在通过模型验证测试的前提下,产出性能尽可能高的模型(见图 10-6)。
描述训练机器学习模型的迭代过程示意图,突出从特征选择和数据准备到模型验证的步骤。
模型训练的核心步骤是:
- 选择特征并创建训练数据。
- 创建模型架构。
- 执行超参数调优试验,在验证集上评估每个试验的模型。
- 使用最佳超参数将模型拟合到训练数据。
- 在测试集和评估集上评估训练好的模型(模型验证),如果所有模型验证检查都通过,则将模型注册到模型注册表(model registry)。
作为迭代开发工作流的一部分,这些步骤中的每一步都可以重新审视和更新。训练数据通常不是静态的。新数据可能到达,你可能包含不同的特征集。你也可能更改读取训练数据时应用的 MDT。我们已经研究了选择特征和构建训练数据集时以数据为中心的挑战。在接下来的章节中,我们将在 PyTorch 和 Ray 的背景下研究深度学习模型的模型架构、训练和超参数调优。Ray 是一个开源的分布式框架,用于管理 ML 的计算和数据。Ray Train 支持在许多不同的 ML 框架中训练模型,从 XGBoost 到 PyTorch,在 GPU 或 CPU 上,在单主机或大规模 GPU 集群上。Ray Tune 支持跨许多 CPU 或 GPU 进行超参数调优。
模型架构
模型的架构就是它的布局:它有哪些组件、它们如何连接,以及数据如何从输入流向预测。以下是一些最常见的 ML 家族及其布局的重要部分:
- 决策树
- 分裂准则和最大深度(剪枝)
- 前馈神经网络(feed-forward neural network)
- 层深度/宽度、激活函数、归一化/dropout 和输出头
- CNN
- 带步幅/填充的卷积和池化块
- 变换器
- 带残差和层归一化的自注意力和前馈块堆叠
每种模型架构都有许多概念,每个概念都足以写满许多本书。不幸的是,我们没有空间在这里涵盖所有这些概念。但是,在高层次上,你应该能够通过理解预测问题、合适的学习算法、输入数据的类型(结构化或非结构化)以及训练数据的规模,来选择正确的 ML 家族及其模型架构。
例如,对于结构化数据的监督学习,一些简单的经验法则是:
- 对于少于 1000 万行的数据集,基于决策树的模型,尤其是 XGBoost,通常优于神经网络(NN),因为它们能够以最少的预处理高效处理结构化数据。
- 对于 1000 万到 1 亿行之间的数据集,选择取决于数据的复杂性和可用的计算资源;XGBoost 和 NN 都可以表现良好。
- 对于超过 1 亿行的数据集,NN 往往优于 XGBoost,因为它们可以更好地捕捉复杂模式,并随着大量数据有效扩展。使用 NN 时,你可以通过调整层/块的数量和应用正则化(regularization)技术(如dropout(随机失活))来优化性能。
注意
为什么基于树的模型在典型表格数据上仍然优于深度学习?NeurIPS 2022 上一篇有影响力的论文表明,对于小(<1 万样本)数据集,基于树的模型优于 NN。当你拥有具有重复模式的原始输入数据(高维)时,深度学习更优越。NN 擅长从原始输入数据中自动创建更高级别的特征。相比之下,表格数据通常由预处理、聚合或工程化的特征组成,并不总是需要深度学习的分层表示学习能力。基于树的模型也是可解释的,而深度学习模型则不是,在你需要解释模型为何做出某个决策的领域中,这一点很重要。
对于非结构化数据(如图像、音频、视频和文本)的监督学习,NN 通常是首选。根据数据类型和任务,你可以在不同的模型架构之间选择:
- CNN 最适合 2D 和 3D 空间数据,如图像和视频,因为它们利用局部感受野和平移等变性来学习分层模式。
- 变换器对序列和上下文数据有效,特别是在 NLP 和时间序列预测中。
- 前馈 NN 适用于不存在空间或序列关系的表格输入数据。
- 长短期记忆(long short-term memory, LSTM)网络处理具有时间依赖性的序列数据(例如,语音、某些时间序列)。由于并行性和预训练,变换器在规模上通常优于它们。
以下是一个用于 MNIST(Modified National Institute of Standards and Technology,美国国家标准与技术研究院改良版)数据集(包含 0 到 9 手写数字的 7 万张灰度图像)的前馈 NN 示例。该 NN 以一批大小为 28 × 28 像素(总共 784 个像素)的黑白图像作为输入。训练时,它输出logits,供 nn.CrossEntropyLoss 等损失函数使用:
class CustomMnist(nn.Module):
    def __init__(self, layer_sz=128, dropout=0.3):
        super(CustomMnist, self).__init__()
        self.fc1 = nn.Linear(28*28, layer_sz)
        self.dropout = nn.Dropout(dropout)
        self.fc2 = nn.Linear(layer_sz, 10)

    def forward(self, x):
        x = torch.flatten(x, 1)  # Flatten (batch_sz, 28, 28) -> (batch_sz, 784)
        x = torch.relu(self.fc1(x))  # Apply ReLU activation
        x = self.dropout(x)  # Apply dropout after activation
        return self.fc2(x)  # Output logits
在 PyTorch 中,我们将 NN 定义为继承自 nn.Module 的自定义类,并实现 init 和 forward 方法来执行前向传播(forward pass)。前向传播是将输入从输入层传递到输出层的过程,为训练产生 logits、为推理产生预测。超参数是层大小(layer_sz)和 dropout 率(dropout)。
我们使用交叉熵损失(cross-entropy loss)和自适应矩估计(Adaptive Moment Estimation, Adam)优化器来训练这个 NN。交叉熵是一种用于分类的损失函数(loss function),衡量真实标签与预测概率之间的差异。这种差异,即损失(loss),在反向传播(backward pass)中通过反向传播算法用于计算梯度(gradients)。梯度表示每个参数对总损失的贡献。
然后,优化器使用梯度更新 NN 中所有参数的权重。随机梯度下降(stochastic gradient descent)是最著名的优化器。它使用固定的学习率(learning rate),沿着梯度的反方向改变参数值,从而更新一个小批量(mini-batch)参数的权重。学习率定义每次更新的相对大小。
我们使用自定义的 PyTorch Dataset 为 CustomMnist 创建训练数据,该数据集使用特征视图返回一个 DataFrame,其中包含 image_path 作为特征和 label(图像中的实际数字)。ImageDataset 从 DataFrame 的每一行中提取每个图像的路径和标签。在训练中,我们返回图像和标签,但在推理中(train=False),我们只返回图像:
from torch.utils.data import Dataset, DataLoader
from PIL import Image
import torchvision.transforms as T

class ImageDataset(Dataset):
    def __init__(self, transform, features, labels=None):
        self.transform = transform
        self.features = features
        self.labels = labels

    def __len__(self):
        return len(self.features)

    def __getitem__(self, idx):
        img_path = pathlib.Path(self.features.iloc[idx]["image_path"])
        image = Image.open(img_path).convert("L")
        image = self.transform(image)
        if self.labels is not None:
            label = int(self.labels.iloc[idx]["label"])
            return image, torch.tensor(label, dtype=torch.long)
        return image

proj = hopsworks.login()
fv = proj.get_feature_store().get_feature_view(name="mnist", version=1)
transform = T.Compose([T.Resize((28, 28)), T.ToTensor()])
features, labels = fv.training_data()
dataset = ImageDataset(transform, features, labels)
train_loader = DataLoader(dataset, batch_size=32, shuffle=True)
你可以基于这个示例,将图像元数据存储为既可用于训练又可用于推理的列。对于训练,你可以将数据质量分数作为特征包含在内。对于推理,你可以包含一个辅助列来标识在哪里存储或如何标记预测。
与使用普通文件作为训练数据相比,使用特征组的另一个优势是,可以获得关于哪些文件被用于训练给定模型的血统信息。
较低的学习率具有更好的收敛特性,但通常需要更多步骤。这里我们使用 Adam 优化器,它通过估计梯度的一阶和二阶矩,自动为每个参数调整学习率。通常,这意味着训练开始时学习率较高,随着模型收敛学习率逐渐降低。另一种选择是 AdamW,一种带解耦权重衰减(decoupled weight decay)的 Adam 变体。它根据梯度的一阶和二阶矩计算每个参数的自适应步长。由于其稳定性和强大的综合性能,Adam 和 AdamW 都是深度学习中常见的优化器选择:
def train_model(config, train_loader):
    model = CustomMnist(layer_sz=config["layer_sz"], dropout=config["dropout"])
    optimizer = optim.Adam(model.parameters(), lr=config["lr"])

    loss_fn = nn.CrossEntropyLoss()

    state = None
    model.train() # sets the model to training mode (enables dropout)
    for epoch in range(config["num_epochs"]):
        correct, total=0
        for inputs, labels in train_loader:
            optimizer.zero_grad()
            logits = model(inputs)
            loss = loss_fn(logits, labels)
            loss.backward()
            optimizer.step()
            preds = logits.argmax(1)
            total += labels.size(0)
            correct += (preds == labels).sum().item()
        # Uncomment next line to add Ray support
        # ray_train.report({"train_accuracy": correct / max(total, 1)})

    return model

config = {"layer_sz": 128, "dropout": 0.3, "lr": 1e-3, "num_epochs": 10}
model = train_model(config, train_loader)

state = {k: v.detach().cpu() for k, v in model.state_dict().items()}

model_registry = proj.get_model_registry()
mr_model = model_registry.python.create_model(
               name="mnist",
               metrics=config, # save hparams for inference
               feature_view=fv
           )
with tempfile.TemporaryDirectory() as tmpdir:
    joblib.dump(state, os.path.join(tmpdir, "model.pkl"))
    joblib.dump(transform, os.path.join(tmpdir, "transform.pkl"))
    mr_model.save(tmpdir)
config 字典包含我们可以调优的超参数,如 dropout、layer_sz、num_epochs 和 lr(学习率)。损失函数和优化器是深度学习中一个广阔的研究领域,你可以在奥雷利安·杰龙(Aurélien Géron)的《Hands-On Machine Learning with Scikit-Learn and PyTorch》(O’Reilly,2025)一书中阅读更多相关内容。请注意,我们需要保存模型的权重、超参数及其变换器对象,以便在推理时下载它们并避免偏斜(skew)。
用于故障恢复的检查点
你需要硬件加速器来高效训练深度学习模型。GPU 是最流行的加速器。Meta 在 16,384 块 NVIDIA H100 80 GB GPU 上用了 54 天训练其 Llama 3 模型(4050 亿参数)。他们还经历了平均每三小时一次故障(大多数问题由 GPU 或其板载 HBM3 内存引起)。训练期间任何 GPU(或工作节点)的故障都会导致训练过程失败。为了处理此类故障,你定期创建训练检查点(checkpoint),以便在故障后从检查点重新开始训练。这使得 Llama 3 的有效训练时间达到 90%。如果没有检查点,这个数字会低得多。以下代码片段展示了如何在训练管道中添加存储和恢复检查点:
def train_model(config, train_loader, model, optimizer, checkpoint_path):

    if os.path.exists(checkpoint_path):

        checkpoint = torch.load(checkpoint_path)
        model.load_state_dict(checkpoint['model_state_dict'])
        optimizer.load_state_dict(checkpoint['optimizer_state_dict'])
        start_epoch = checkpoint['epoch'] + 1

    for epoch in range(start_epoch, config["num_epochs"]):
  ...

        torch.save({  # Save checkpoint after every epoch
            'epoch': epoch,
            'model_state_dict': model.state_dict(),
            'optimizer_state_dict': optimizer.state_dict()
        }, checkpoint_path)
检查点应该存储并从共享的分布式存储中加载。checkpoint_path 是分布式文件系统的路径,例如 S3 存储桶,或通过 HopsFS 用户空间文件系统(Filesystem in Userspace, FUSE)访问的本地目录。
使用 Ray Tune 进行超参数调优
通过使用AutoML(自动化机器学习)库,可以轻松地将超参数调优集成到训练管道中,该库为你自动化运行超参数调优试验的过程。对于单主机 AutoML 解决方案,auto-sklearn 在表格数据上效果很好。对于集群,Ray Tune 可以在 CPU 或 GPU 上为深度学习和决策树模型扩展超参数调优。超参数调优要求你定义:
- 一个超参数搜索空间(搜索空间,即你想要调优的超参数以及你想要评估的值范围)
- 一个在该搜索空间上的搜索算法(例如,随机或网格搜索,或使用从试验中构建的模型进行搜索,如贝叶斯优化(Bayesian optimization))
- 一个调度器(scheduler),用于为将要并行执行的所有试验分配资源
超参数调优结束时,你可以选择找到的最佳超参数,并使用这些超参数训练模型更多轮次(和更多数据)。AutoML 解决方案通过自动定义超参数搜索空间、搜索算法和调度来简化超参数调优。然而,使用 AutoML 你也会失去控制。理解这三个抽象并不特别困难,所以值得你花时间学习基础知识,以免在不必要的试验上浪费计算资源。
Ray Tune 是超参数调优的编排器。它包装了超参数搜索优化库,如贝叶斯优化和Optuna,并使用可配置的调度器执行试验,该调度器管理资源、提前停止无希望的试验,并为有希望的配置分配更多资源。异步连续减半算法(Asynchronous Successive Halving Algorithm, ASHA)调度器并行启动许多小预算试验,定期修剪表现不佳的试验,并根据缩减因子(reduction factor)将最佳试验提升到更大的预算(更高的"梯级”)。释放的资源被给予新的或被提升的试验,该过程持续到调优预算耗尽。
以下示例代码展示了使用 Ray Tune(配合 ASHA 和 Optuna)和我们之前的 MNIST 示例代码进行超参数调优的工作流:
from ray.tune.schedulers import ASHAScheduler
from ray.tune.search.optuna import OptunaSearch

scheduler = ASHAScheduler(metric="train_accuracy", mode="max", grace_period=3)
searcher = OptunaSearch()

param_space = {
    "lr": tune.loguniform(1e-4, 1e-2),
    "dropout": tune.choice([0.1, 0.3, 0.5]),
    "layer_sz": tune.choice([64, 128, 256]),
    "num_epochs": 10,  # max epochs per trial; ASHA may stop early
}

resources_per_trial = {"cpu": 2, "gpu": 0}

tuner = tune.Tuner(
    tune.with_resources(
        tune.with_parameters(
            train_model,
            train_loader=train_loader,
            proj=proj,
            fv=fv,
            transform=transform,
        ),
        resources=resources_per_trial,
    ),
    param_space=param_space,
    tune_config=tune.TuneConfig(
        metric="train_accuracy",
        mode="max",
        scheduler=scheduler,
        search_alg=searcher,
        num_samples=15,
    ),
    run_config=air.RunConfig(name="mnist_asha_optuna_acc"),
)

results = tuner.fit()
best = results.get_best_result(metric="train_accuracy", mode="max")
print("Best config:", best.config)
print("Best train_accuracy:", best.metrics["train_accuracy"])
请注意,我们确实需要修改前面的 train_model(),以便向 Ray Tune 报告每轮的训练指标。应该添加这一行:
train.report({"mean_accuracy": mean_acc, "epoch": epoch})
注意
实验跟踪服务(experiment tracking services)被广泛用于存储超参数调优实验结果以及训练损失曲线。MLflow 是一个流行的开源框架。SaaS 平台包括 neptune.ai、comet.ai 和 wandb.ai。你也可以使用 Hopsworks 模型注册表,将模型性能图、模型卡和验证结果与训练好的模型一起存储。
使用 Ray 进行分布式训练
当你想在大量数据上训练大型深度学习模型时,需要分布式训练。例如,训练 Llama 3.1 405B(16 位权重)大约需要 3.24 TB 的 GPU 内存——其中模型参数和梯度各占 810 GB,另有 1.62 TB 用于(Adam)优化器状态。NVIDIA H100 有 80 GB 内存,因此如果没有内存优化,仅将 Llama 3.1 放入内存就需要大约 40 块这样的 GPU。使用 40 块 GPU(假设没有故障且线性扩展),训练 Llama 3.1 大约需要 60 年。分布式训练既可以让你通过添加更多 GPU 来加速训练,也可以通过将模型状态(参数、梯度、优化器)分区到许多 GPU 上来扩大模型规模。
数据并行训练(data-parallel training)是指你希望通过在许多不同的 GPU 上复制模型来减少训练时间。Ray Train 支持数据并行训练,可以使用梯度同步(gradient synchronization)算法(如环形全归约(ring all-reduce),本章后面会介绍)跨许多主机扩展。
张量并行(tensor parallelism)是一种将大型张量(如模型权重或激活)分区到多个 GPU 上的技术,可提高性能。这允许单个操作(例如矩阵乘法)的不同部分并行处理,高效地分配计算和内存负载。NVIDIA 的 Megatron-LM 框架使用张量并行将单个层拆分到多个 GPU 上,从而支持单设备无法容纳的模型。
当模型无法放入单个 GPU 的内存时,需要模型并行训练(model-parallel training)。当你可以将模型放入单个 GPU 服务器(包含最多 8 或 16 块 GPU)并使用高性能 GPU 互连时,模型并行训练扩展效果最好。当你需要跨网络在主机之间分区模型时,你需要非常高性能的网络(如InfiniBand),以防止训练在网络 I/O 上成为瓶颈。DeepSpeed ZeRO-3 是深度学习模型模型并行训练的框架。它实现了张量级和模型级并行,以及内存(或零冗余优化器(Zero Redundancy Optimizer, ZeRO))优化。DeepSpeed 包含在 Megatron-LM 中,并且可以在 Ray Train 之上运行(后者负责协调和扩展训练工作负载)。
使用 Ray Train 进行多主机训练需要分布式存储(S3、通过 FUSE 的 HopsFS)来存储训练数据。Ray Data 是一个数据处理库,支持在训练期间并行读取训练数据。也就是说,训练数据由 CPU 在后台分块读取和获取,使 GPU 在训练期间保持饱和。
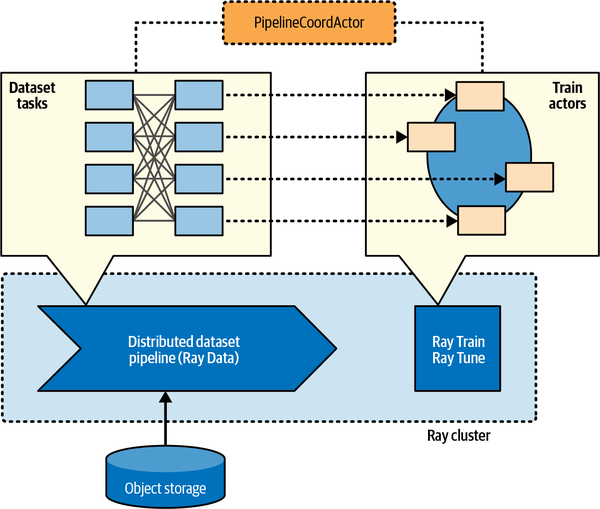
Ray Data 提供数据集任务(dataset tasks),作为数据加载、MDT(训练数据预处理)和数据输出等任务的通用抽象。图 10-7 展示了 Ray Train 和 Ray Tune 如何使用 Ray Data。Ray 是一个基于 actor 的框架,Ray Train 和 Ray Tune 都使用训练 actor 来执行模型训练(通常在 GPU 上)。还有一个管道协调 actor,帮助作业从故障中恢复。
描述 Ray 基于 actor 的框架示意图,展示如何使用 Ray Data、Ray Train 和 Ray Tune 在分布式数据集管道中管理数据集任务、训练 actor 和管道协调。
Ray Data 与框架无关,可以在不同的分布式训练框架(包括 PyTorch 和 TensorFlow)之间移植。它为常见的文件格式提供 I/O 层。Ray Data 还支持进程之间的零拷贝(zero-copy)交换,从而支持与训练交织的全局逐轮打乱等分布式功能。如果你改用 Torch 数据集,它不原生支持跨工作节点分片的打乱,你必须自己实现。
以下 Ray 代码片段创建了一个分布式数据预处理管道,它读取 Parquet 文件,应用预处理变换(MDT),打乱数据,然后将处理后的数据提供给分布式 PyTorch 训练作业。这个数据并行神经网络训练作业在三个 GPU 工作节点上并行运行:
pipe = ray.data.read_parquet(path)
pipe = pipe.map_batches(preprocess)
dataset_pipeline = pipe.random_shuffle()

def train_model():
    model = NeuralNetworkModel(...)
    model = train.torch.prepare_model(model)
    optimizer = torch.optim.Adam(model.parameters())

    for batch in train.get_dataset_shard().iter_batches():
        # Proper training loop here

trainer = Trainer(num_workers=3, backend="torch", use_gpu=True)
result = trainer.run(train_model, dataset=dataset_pipeline)
LLM 的参数高效微调
LLM 是变换器模型。LLM 的训练经历三个阶段(见图 10-8):
- 预训练(pretraining)
- 这是在海量文本上进行的自监督学习,针对困惑度(perplexity)进行优化——困惑度是对下一个 token 期望的度量(从技术上讲,困惑度是平均负对数似然的指数)。你可以通过使用文本数据和自监督学习进行持续预训练(continued pretraining),为基础 LLM 扩展新知识。然而,你无法获得预训练结束时使用的优化器状态,而且存在灾难性遗忘(catastrophic forgetting)的风险——预训练模型在针对新任务或新数据训练时,会丢失其先前学到的知识。由于这些原因,持续预训练并未被广泛采用。
- 监督微调(supervised fine-tuning, SFT)
- 这获取预训练 LLM,并使用针对目标任务特定的带标签训练数据对其进行微调。常见的目标任务是创建聊天机器人、摘要器和编码助手。SFT 训练数据是指令数据集,例如问答数据集。
- 偏好对齐(preference alignment)
- 这进一步微调指令模型,使其输出与人类偏好对齐,使用 RLHF 等技术。
描述 LLM 聊天机器人训练三个阶段的示意图:使用海量文本数据的预训练、使用指令数据集的监督微调,以及使用响应数据集的偏好对齐。
在 RLHF 中,人类首先通过从给定提示的一组模型输出中排名或选择最佳响应来生成偏好数据。偏好对齐训练数据集中的一行样本可能如下所示(人类已将响应 1 标记为"首选"):
提示:“What is the capital of Sweden?”
响应 1(首选):“The capital of Sweden is Stockholm.”
响应 2(非首选):“Sweden is big, and the biggest city is Stockholm.”
通过从两到四个不同可能答案中选择一个首选答案,你创建了训练数据。然后,该训练数据用于训练奖励模型(reward model),它估计响应的质量。奖励模型引导强化学习算法(如近端策略优化(Proximal Policy Optimization, PPO))调整策略模型,使其输出与人类偏好更紧密地对齐。
不同的 LLM 可能根据它们如何被对齐而给出不同的响应。例如,如果你问一个 LLM:“台湾和巴勒斯坦的地位是什么?““中国"的 DeepSeek R1 模型给出的答案与"美国"的 Llama 3.1 模型不同。两者都是开源 LLM,并且都在大致相同的数据(互联网上可访问的所有文本文档)上进行了预训练。然而,它们产生的不同答案是由于它们不同的训练后微调和偏好对齐步骤。最近在 2025 年,大型推理模型(large reasoning models)(见第12章),如 DeepSeek R1,在微调中更青睐强化学习而非 SFT。训练后技术中唯一不变的是它们不断演变。
许多组织有兴趣微调基础 LLM,以优化其在目标任务上的性能。最容易获得的方法是使用参数高效微调(parameter-efficient fine-tuning, PEFT),一种比完全微调所需 GPU 资源少得多的技术,因为它不更新基础模型的权重。相反,PEFT 更新较小适配器模型的权重。
LoRA 是最流行的 PEFT 适配器模型(见图 10-9)。LoRA 冻结 LLM 的原始权重,并向选定的权重矩阵添加小的、可训练的低秩矩阵,最常见的是变换器注意力块内的查询和值投影层。量化 LoRA(Quantized LoRA, QLoRA)是 LoRA 的优化版本,比 LoRA 需要更少的 GPU 内存,因为它在基础模型中使用更小的四位权重(代价是模型性能略差)。
比较完全微调与 LoRA 和 QLoRA 的示意图,突出它们在 LLM 参数高效监督微调中权重精度和模型更新方法的差异。
LoRA(以及 QLoRA)基于这样的洞察:基础模型通常具有低内在维度(low intrinsic dimension),这意味着它们通常可以用比原始权重中表示的维度少得多的维度来描述。这一洞察的含义是,在模型适配期间,模型权重(例如参数)的更新具有低内在秩,这意味着你可以使用更小、维度更少的矩阵进行微调。最终输出通过将基础 LLM 模型的输出与 LoRA 适配器的输出相加获得。通过减少可训练参数的数量,LoRA 既减少了所需的训练时间,也减少了所需的 GPU 内存量。你也可以为许多 LoRA 适配器共享同一个基础模型。用于 LoRA 微调的示例指令数据集可能如下所示:
{
  "instruction": "Name one famous Swedish company.",
  "input": "",
  "output": "IKEA"
}
注意
对于没有自己的 GPU 机队的组织来说,微调通常比预训练一个新的 LLM 更可取。截至 2025 年年中,开源和开放权重基础模型在性能上接近最好的专有模型。你可以一次性构建微调指令数据集,并用它微调许多 LLM,始终与最新的开源基础 LLM 保持同步。然而,微调并不擅长向 LLM 添加新知识或替换现有知识。如果你需要添加新知识,可以在推理时通过提示工程或 RAG 来实现。
使用 XGBoost 的信用卡欺诈模型
我们现在暂时离开深度学习,来研究训练我们的信用卡欺诈检测模型 XGBoost——一个梯度提升决策树集成。如前所述,在低于百万样本的数据规模下,决策树优于深度学习。然而,在解决监督学习问题时,我们将面临一个大挑战:存在严重的类别不平衡。也就是说,非欺诈交易比欺诈交易多得多。
可以构建基于异常检测的无监督学习模型,例如基于 GAN 的异常检测模型。然而,对于实时信用卡交易验证来说,它们的延迟太高。因此,我们将遵循 KISS(keep it simple, stupid,保持简单)方法,使用一个 XGBoost 二分类器,它在多核服务器上为推理请求提供 1-2 毫秒的延迟。我们将通过上采样正类(欺诈)和下采样负类(非欺诈)来解决正类和负类之间的严重不平衡。对于较大训练数据集(约 100 万行)的 XGBoost 超参数调优技巧包括:
- 增加
max_depth并使用提前停止(early stopping)调整n_estimators来控制过拟合。 - 降低
learning_rate并使用 GPU 加速(tree_method='gpu_hist')来加速训练(较小的学习率会增加训练时间)。 - 增加
lambda、alpha和min_child_weight来控制过拟合和泛化。
以下片段展示了使用 Ray Tune 对前述超参数进行超参数调优:
def train_xgboost(config):
    model = xgb.XGBClassifier(
        objective='binary:logistic',
        max_depth=config['max_depth'],
        n_estimators=config['n_estimators'],
        learning_rate=config['learning_rate'],
        reg_lambda=config['reg_lambda'],
        reg_alpha=config['reg_alpha'],
        min_child_weight=config['min_child_weight'],
        eval_metric='logloss'
    )
    model.fit(X_train, y_train, \
        eval_set=[(X_val, y_val)], early_stopping_rounds=20)
    preds = model.predict(X_val)
    f1 = f1_score(y_val, preds)
    tune.report({"f1_score": f1})

search_space = {  # Define the hyperparameter search space
    'max_depth': tune.choice([3, 5, 7, 9, 11]),
    'n_estimators': tune.choice([50, 100, 200, 300]),
    'learning_rate': tune.loguniform(0.01, 0.3),
    'reg_lambda': tune.loguniform(1e-3, 10),
    'reg_alpha': tune.loguniform(1e-3, 10),
    'min_child_weight': tune.choice([1, 3, 5, 7])
}

analysis = tune.run( # Run hyperparameter tuning
    train_xgboost,
    config=search_space,
    num_samples=50,
    resources_per_trial={"cpu": 2, "gpu": 0},
    metric="f1_score",
    mode="max"
)
best_config = analysis.get_best_result("f1_score")
print(f"Best hyperparameters: {best_config}")
这段代码产生超参数的 best_config,然后可以用于完整的训练运行。如果你有 GPU 可用,启用 XGBoost 的 GPU 加速 tree_method='gpu_hist' 可以大幅减少训练时间。
识别分布式训练中的瓶颈
我们已经看到,你可以使用 GPU 集群来减少深度学习模型的训练时间。GPU 可以共置于同一主机上(在 GPU 服务器中,例如 NVIDIA 的 DGX,最多 16 块 GPU),也可以通过高性能网络(如 InfiniBand)连接分布在许多主机上。分布式训练涉及工作节点(每个工作节点管理一块 GPU)使用分布式训练算法(如环形全归约(ring all-reduce))协作训练模型。
环形全归约是一种架构,其中工作节点在逻辑上以环形连接,它们利用自己的上行和下行网络带宽容量,与相邻工作节点共享梯度(每个 GPU 使用自己的训练数据子集在本地计算)。环形全归约既适用于 GPU 互连,也适用于跨网络。图 10-10 展示了一个多主机训练设置,其中工作节点分布在多个 GPU 服务器上,每台服务器有八块 GPU。训练数据存储在共享对象存储中。
描述多主机 GPU 训练设置的示意图,显示通过 NVLink 和 PCIe 连接的 GPU 服务器,利用本地 NVMe 进行数据缓存,并通过网络连接到 S3 对象存储以实现高效数据传输。
每台 GPU 服务器有一个或多个本地(快速)非易失性内存快速(nonvolatile memory express, NVMe)磁盘,用于缓存训练样本(行)的一个分区。这有助于防止训练在从对象存储读取训练数据时成为瓶颈。GPU 服务器有一个 GPU 互连(例如 NVIDIA 的 NVLink 5.0,支持 GPU 之间高达 1.8 TB/s 的聚合双向链路)连接所有 GPU。GPU 使用外设组件互连快速(Peripheral Component Interconnect Express, PCIe)5.0 总线(它有一定数量的 PCI 通道——16 条通道提供 64 GB/s)与服务器上的主内存传输数据。GPU 服务器通过专用的 400 Gb/s(50 GB/s)网络连接在一起。该网络还用于从对象存储读取训练数据,以及如果对象存储太慢(这种情况经常发生),则将训练数据从对象存储复制到本地 NVMe 磁盘。可以使用专用网络来处理存储流量,以免在训练期间与梯度同步流量竞争。
如果你在此设置中遇到 GPU 利用率低的情况,图 10-11 呈现了低 GPU 利用率的根本原因分析流程。我们假设是 Linux 主机。
描述诊断训练期间低 GPU 利用率流程的示意图,聚焦 GPU、PCI 总线、CPU、网络和 S3 等组件以识别瓶颈。
你通过观察训练期间的 GPU 利用率水平开始调试过程,可以使用集群范围的 Grafana 仪表板,或用于服务器的命令行工具,如 nvidia-smi:
nvidia-smi -l
假设 GPU 利用率低于期望值,然后你向下移动层次结构中的一级,以确定 GPU 之间的互连是否是瓶颈。在每台主机上,你可以使用 nvlink 子命令观察 GPU 之间的网络带宽利用率(假设你的 GPU 之间有 NVLink 连接):
nvidia-smi nvlink --status
CUDA 还附带一个实用程序 bandwidthTest,用于测量 GPU 之间以及从 GPU 经 PCIe 总线到主机内存的带宽。如果内存总线带宽不是瓶颈,你可以测量本地磁盘 I/O 带宽利用率——假设你在本地(NVMe)磁盘上缓存训练数据。在 Linux 主机上,你可以使用 iostat 等命令行实用程序测量本地磁盘 I/O:
iostat -x 1 <device-name>
这会每秒打印磁盘读写速率(MB/s)和空闲百分比。如果磁盘 I/O 不是瓶颈,则使用 bmon 或 iftop 等工具检查网络带宽利用率。将测量到的带宽与你的可用容量进行比较。如果明显更低,你可能在从对象存储读取训练数据时遇到瓶颈。一个修复方法是将训练数据从对象存储预复制到本地 NVMe 磁盘。另一个方法是使用分层存储设置,在工作节点和对象存储之间共享高性能 NVMe。如果两者都不可行,请确保你的数据集被切分为足够的文件,以便并行读取,从而饱和可用带宽。
总之,这些步骤是寻找和消除与硬件相关的训练瓶颈、实现更高 GPU 利用率的指南。
模型评估与模型验证
现在你已经训练好了模型,应该使用测试数据评估它,以确定其在预期任务上的性能。你还需要验证模型没有偏见——我们将使用评估数据(evaluation data)来验证模型。评估数据不仅仅是衡量模型性能的留出集(holdout set),而是留出集中包含被认为有偏见风险的实体(例如相关的用户组)的不同切片。
模型评估和验证通常在训练管道中执行(在模型训练完成后直接进行)。也可以有一个独立的模型验证管道(model validation pipeline),在模型训练完成后运行。模型验证管道的输入是训练好的模型和评估数据,输出是模型的模型验证记分卡(scorecard)。模型评估和验证结果通常与模型一起存储在模型注册表中。拥有独立模型验证管道的一些原因:
- 你的训练管道同时分配 GPU 和 CPU,而训练只使用 GPU,模型验证只需要 CPU。但 GPU 只有在管道完成时才会释放,导致你的管道不必要地长时间占用昂贵的 GPU。
- 模型验证由拥有合规测试的独立团队管理。
- 模型训练产生大量候选模型,在批处理模型验证管道中验证许多模型更容易和/或更具成本效益。
分类与回归的模型性能
模型性能评估与 ML 模型的类型紧密相关:分类、回归或其他。
你应该使用平均绝对误差(mean absolute error, MAE)、均方误差(mean squared error, MSE)和 R 方(R-squared)等指标来评估回归模型。R 方衡量模型解释的目标方差比例。它是无量纲的,在目标值的不同尺度下保持不变。你应该用它来比较同一数据集上的不同模型,以评估相对性能。
你应该使用准确率(accuracy)、精确率(precision)、召回率(recall)和 F1 分数(F1 score)等指标来评估分类模型。对于我们的信用卡欺诈模型,ROC AUC(受试者工作特征曲线下面积,receiver operating characteristic–area under the curve)通过评估不同阈值下真阳性率(true positive rate,即灵敏度 sensitivity)和假阳性率(false positive rate)之间的权衡,来衡量分类模型区分类别的能力,数值越高表示模型性能越好。在我们的信用卡欺诈模型中,我们以准确率、F1 分数和 ROC AUC 来评估模型在测试集上的性能。混淆矩阵(confusion matrix)显示在测试集上正确预测(真阳性和真阴性)和错误预测(假阳性和假阴性)的计数。
以下是使用模型、预测和测试集计算这些评估指标的代码:
from sklearn.metrics import accuracy_score, f1_score, confusion_matrix
y_pred = model.predict(X_test)
y_prob = model.predict_proba(X_test)[:, 1]

accuracy = accuracy_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)
cm = confusion_matrix(y_test, y_pred)
roc_auc = roc_auc_score(y_test, y_prob)
模型可解释性
在合规性很重要的某些领域,如金融、医疗和保险,你需要理解并解释 ML 模型如何做出预测,这一概念被称为模型可解释性(model interpretability)。它为模型的预测增加了透明度,建立利益相关者的信任,并确保符合法规。解释复杂模型的一种流行技术是使用 SHAP(SHapley Additive exPlanations,沙普利加法解释)值,它基于博弈论提供统一的特征重要性度量:
import shap
explainer = shap.Explainer(model, X_test)
shap_values = explainer(X_test)
# Summary plot to visualize feature importance
shap.summary_plot(shap_values, X_test)
SHAP 值在用于决策树和集成模型时特别有效,但也可以使用 DeepExplainer 等专门的解释器应用于 NN。然而,NN 的非线性特性使其解释具有挑战性。不过,有一种技术被广泛用于评估 NN。消融研究(ablation studies)通过系统地"消融”(移除或改变)其架构的各个部分,来评估 NN 不同组件或特征的贡献。通过移除一个特征、模型层或正则化器并重新运行性能测试,你可以确定被移除部分对整体模型性能的贡献有多大。
注意
请注意,SHAP 解释器的输入 X_test 是变换后的特征值(应用 MDT 后输入模型的值)。在特征监控中(见第14章),我们通常使用未变换的特征值作为特征监控算法的输入。
模型偏见测试
模型偏见测试应该评估和衡量模型中的潜在偏见。如果模型通过所有偏见测试,它可以被标记为没有已知偏见并继续进入生产。为此,你需要从测试数据集中提取评估数据的不同切片。例如,你可以按性别、年龄、族裔、性取向、地点等对用户进行分组。模型偏见测试在这些被认为有偏见风险的不同用户子集上评估模型。
在 Hopsworks 中,你可以使用特征视图中的过滤器和训练辅助列(training helper columns)来帮助创建评估数据。例如,描述用户的列可以是其性别(gender),你可能想评估模型的性别偏见。然而,你不想使用性别作为特征来训练模型。那可能会将性别偏见引入模型。相反,你将性别作为训练数据中的训练辅助列,用它按性别将行分组为评估数据集。
训练辅助列在训练前被丢弃,读取推理数据时也不会返回,因此模型不会学习它们:
fv = fs.create_feature_view(name="trans_fv", version=1,
    training_helper_columns=["gender"],
    ...
)

X_train, X_test, y_train, y_test = fv.train_test_split(
    test_size=0.2,
    training_helper_columns=True
)

X_train = X_train.drop("gender", axis=1) # Drop helper column before training
model = xgboost.XGBClassifier().fit(X_train, y_train)

# Evaluate on female subset
female_mask = X_test["gender"] == "female"
X_female_test = X_test[female_mask].drop("gender", axis=1)
y_female_test = y_test[female_mask]
y_female_pred = model.predict(X_female_test)
female_accuracy = accuracy_score(y_female_test, y_female_pred)
模型文件格式与模型注册表
从软件工程的角度来看,训练模型在概念上类似于将程序编译为二进制文件——你构建一次,随处部署。模型注册表扮演着与软件工程中的工件注册表相同的角色——它存储不可变的模型(作为文件),以后可以被推理管道下载和使用。保存模型最常见的文件格式是:
- .safetensors
- 可互操作、高效的模型格式(PyTorch、TensorFlow 等),大多数 LLM 和变换器模型使用。大于 2 GB 的模型通常存储为分片文件,以便并行加载 LLM。
- .pkl
- Scikit-Learn 模型。使用 joblib 库创建 pickle 化的 Python 对象。确保在训练/推理管道中使用相同的版本。警告:pickle 有一个重大的、固有的安全风险——它在加载数据时可以执行任意代码。
- .json
- XGBoost/LightGBM 模型。你应该优先选择 .json 而不是 .pkl。
- .onnx
- 可互操作的模型格式(PyTorch、TensorFlow 等),需要开放神经网络交换(Open Neural Network Exchange, ONNX)运行时或受支持的运行时,如 TensorRT。
- .pt 和 .pth
- 通用的 PyTorch 检查点文件格式,可用于恢复训练。
- .engine
- 针对 NVIDIA GPU 优化的 TensorRT 文件格式,需要 TensorRT 服务器。
- .pb 和 .h5
- TensorFlow 模型文件格式(.pb 是 protobuf,.h5 是可互操作的)。
- .bin 和带优化器状态的 .ckpt(Lightning 检查点)
- 如果你需要优化器状态和完整的检查点信息(不仅仅是模型权重)以进行继续训练或微调,则使用这些格式。
模型卡
模型卡(model cards)是模型注册表中模型的一页概览,越来越多地被要求用于治理和合规。它们是分享模型信息的有用速查表,特别是在训练模型的人与将其部署到生产环境的人不是同一个人的团队中。模型卡包含关于模型的信息、其性能、是否通过验证测试,以及使用说明或指南,以便模型可以部署到生产环境。通常包含模型评估和偏见测试的结果。这些通常是 PNG 文件——图或图表。
一般来说,注册模型时,训练管道中的代码将能够生成以下示例模型卡中 20% 到 60% 的信息。对于已部署的模型,你的模型卡应该力求覆盖 100% 的类别,并且你应该有一个流程来确保模型卡准确完整:
模型名称/版本: [模型名称、版本号]
日期: [月/日/年]
预期用途:
- [描述模型的主要目的、预期应用和利益相关者]
- [描述非预期用途,即模型不应被使用的场景]
模型详情:
- 模型架构:[例如,随机森林、CNN、变换器等]
- 特征视图:模型所需的输入特征
- 训练数据:使用的规模和特征组
- 模型签名:[模型的输入特征和输出标签]
性能评估:
- 评估指标:[RMSE、F1 分数、ROC AUC 等]
- 测试数据集:[描述测试数据集——规模、切分策略]
- 性能结果:[提供测试数据上的关键性能数字]
- 与基线比较:[与现有方法相比如何?]
伦理考量与局限:
- 偏见:[执行的评估数据集和偏见测试]
- 潜在风险与局限:[描述模型的潜在危害和局限]
部署与维护:
- 预期部署环境:[批处理、API/在线、流式、边缘]
- 模型依赖:[列出所需的库或框架]
- 监控策略:[描述部署后的监控计划]
- 再训练计划:[计划的模型更新和频率]
可解释性与可解释性技术:
- 特征重要性:[影响模型决策的关键特征]
- 使用的可解释性技术:[SHAP、LIME 等]
负责任 AI 考量:
- 合规性:[遵循的监管框架,如 GDPR、欧盟 AI 法案]
- 反馈机制:[用户如何报告问题或提供反馈]
- 模型训练与部署成本:[电力消耗]
参考文献:
- 代码/论文/文档:[源代码、引用的出版物、文档链接]
- 联系信息:[有问题时联系谁]
小结与练习
在本章中,我们对开发和运维训练管道中的关键挑战进行了旋风式巡礼。训练管道主要是数据科学的领域——为模型识别标签和特征、超参数调优、将数据拟合到模型,以及评估模型的性能与合规性。但它们也需要数据工程技能,例如准备标签并将其连接到特征。它们还可能涉及管理 GPU、扩展训练以及消除训练管道中可扩展性瓶颈的 ML 工程技能。
做以下练习,帮助你学习如何进行以数据为中心的模型训练:
- 你想构建一个预测客户流失的批处理 ML 系统。你的数据集市有一个关于客户与支持和营销运营交互的事实表。你如何利用这个事实表为客户流失模型提供标签/特征?
- 使用互信息为目标选择特征。首先,找到一个公开的带标签表格数据集。然后计算每个特征与目标之间的互信息。最后,选择前 N 个特征,并解释你为什么选择它们。
1 Daniel P. Jeong 等人,《“LLM-Select: Feature Selection with Large Language Models”》,arXiv 预印本,2024 年。