流式与实时特征
如果你想构建一个可扩展的实时机器学习系统,其特征新鲜度(feature freshness)只有几秒钟,那么你需要流式特征管道。流式特征管道(streaming feature pipeline) 是一个 24/7 全天候运行的流处理程序,它从流式数据源消费事件,可能还会用其他数据源的数据来丰富这些事件,应用数据变换来创建特征,并将输出的特征数据写入特征存储(feature store)。
在运维层面,流式管道与微服务(microservice)的共同点比与批处理管道的共同点多。如果流式管道发生故障,往往需要立即修复,你不能等到下一个计划中的批处理运行再来修复。流处理程序会将无限的事件流划分(分区)为相关事件的分组,这些分组在窗口(window)中一起被处理。窗口 是一组受时间约束的事件。例如,流式管道可以创建一个窗口,按信用卡号对过去一小时的信用卡交易进行分组,并基于这些事件计算特征,比如每张卡在过去一小时的交易次数。在这种情况下,你需要考虑如何处理在其处理窗口关闭之后才姗姗来迟的数据。例如,一笔迟到了两个小时的信用卡交易应该怎么处理?尽管存在这些挑战,流式特征管道正越来越多地被用于构建实时机器学习系统。随着流处理框架现在支持 SQL 和 Python,以及 Java 等传统语言,它们对开发者来说也变得越来越容易上手。
但流处理并不总是实时特征所必需的。有时,捕获世界最近事件信息的新鲜特征——例如用户在过去 30 秒内点击按钮的次数——可以在在线推理管道中利用原始事件数据作为 ODT 来计算。我们将首先探讨实时特征对于构建能够实时智能地响应用户输入和环境变化的交互式 AI 系统是多么关键。
交互式 AI 系统需要实时特征
交互式 AI 系统会根据上下文、用户操作和环境变化实时调整其行为。交互式 AI 系统可以建立在经典机器学习模型、深度学习模型或 LLM 之上。在第1章中,我们以 TikTok 为例介绍了交互式 AI 系统:它利用 AI 根据用户最近的操作和上下文来推荐视频。TikTok 的制造商字节跳动构建了庞大的实时数据处理基础设施,以确保其 AI 感觉响应迅速而不卡顿。TikTok 的推荐系统借助经典机器学习模型和深度学习模型,能在一秒左右内适应你的非语言操作(滑动、点赞、搜索)。
交互式应用还可以利用智能体(agent)和基于 LLM 的应用(见第12章)成为实时 AI——方法是将智能体的 API 扩展为除了用户提示词之外还包含 ID。应用会使用许多 ID 来跟踪用户、用户操作、点击流和应用状态(订单、文章、交易等)。当应用向智能体或 LLM 应用发出查询时,它还可以将应用 ID 作为查询上下文的一部分包含在内。例如,如果用户问"我上周订购的鞋子怎么了?",智能体将收到该查询以及用户 ID。然后可以用该用户 ID 从特征存储中检索上一周与该用户相关的所有事件。这些事件可以连同用户查询一起作为上下文传入系统提示词,使 LLM 能够综合出正确的答案:鞋子已于昨天发货。实际上,我们可以将在线特征存储用作智能体和 LLM 的 RAG 检索引擎(见图 9-1)。
描述交互式 AI 应用如何使用 ID 从智能体和在线特征存储中查询与检索信息的示意图,该架构通过流式数据集成支持实时数据处理。
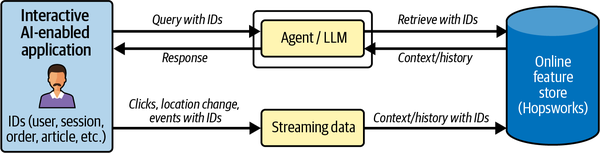
这种特征存储 RAG 架构为智能体增强了关于应用中已发生事件的记忆,而应用 ID 正是智能体用来为当前应用上下文检索正确记忆的钥匙。要使这种实时智能体架构生效,它需要低延迟的流处理来处理应用事件,并需要在线特征存储。在生产系统中,应用会将事件发布到事件流平台,流处理应用消费这些事件、对它们进行变换,并将结果发布到在线特征存储。也可以将原始事件直接推送到在线特征存储,把变换步骤推迟到 ODT 中执行。在接下来的几节中,我们将逐一审视该架构的各个组成部分,从事件流平台开始。
事件流平台
流式数据源以事件、消息或记录序列的形式提供数据。我们把这种实时数据称为事件流(event stream)。事件流由流式或批处理特征管道增量地摄取和处理。对构建交互式 AI 应用有用的事件流示例包括:
- 从操作型数据库进行的变更数据捕获(CDC)或轮询
- 应用中的活动日志
- 应用使用的传感器,例如位置、摄像头、边缘/IoT 设备,以及制造系统中的监控与数据采集(SCADA)传感器
- 应用上下文信息(服务故障、资源问题等)
- 第三方数据(来自订阅某个 API,该 API 发送事件通知)
来自这些不同数据源的事件流集中在一个事件流平台(event-streaming platform)(或事件总线)中,它充当枢纽,客户端可以订阅它以接收实时事件流。事件流平台是可扩展的数据平台,负责管理实时事件流,并将事件存储有限的一段时间(通常几天或几周)。事件由数据源产生,随后由解耦的客户端消费。广泛使用的事件流平台示例有:
- Apache Kafka
- 一个开源、可扩展的分布式事件流平台
- Amazon Kinesis
- 一个云原生的托管式事件流服务
- Google Cloud Pub/Sub
- 一个云原生事件流服务
事件流平台是流式特征管道的主要数据源。通常,事件包含时序数据,事件中带有在数据源处添加的时间戳。流式特征管道使用事件时间(event time)而非摄取时间(ingestion time)来聚合事件和创建特征。流处理程序包含一个汇(sink),即数据处理结果的存储位置。汇的示例包括事件流平台本身(构建数据处理 DAG)、湖仓(lakehouse)(事件流式化)以及用于实时机器学习系统的特征存储。
下一节将介绍计算实时特征的不同架构。如果你只想直接开始编写流式特征管道,可以放心跳到“编写流式特征管道”。
左移还是右移?
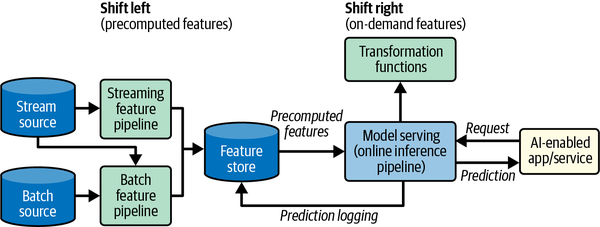
流式特征管道会预计算特征,为在线模型提供历史和上下文。然而,也可以响应来自 AI 应用或服务的预测请求,按需计算实时特征。作为架构师,你必须选择是左移(shift left)特征计算到特征管道中,还是右移(shift right)特征计算到请求时计算特征。术语左移源于传统软件开发生命周期中的实践:将软件开发过程的某个阶段在时间线上向左移动;而右移则是将该阶段向运维方向移动。
就特征工程而言,左移意味着预计算特征,并通过特征存储提供检索。右移意味着在 ODT 或 MDT 中计算特征。左移有助于降低预测请求的延迟,因为从特征存储检索预计算特征通常比按需计算特征更快。如果所有新鲜特征都可以按需计算,右移可以消除对特征管道的需求(降低系统复杂度)。图 9-2 展示了左移特征计算如何在特征管道中执行,而右移特征计算如何在在线推理管道中使用 ODT 或 MDT 执行。
描述左移与右移特征工程的示意图,其中左移涉及在管道中预计算特征以便更快检索,右移涉及在在线推理管道中按需计算特征。
通常,应用需求有助于决定是预计算特征还是按需创建特征。左移特征计算的理由包括:
- 应用需要非常低延迟的预测(例如,它有 P99 10 毫秒的延迟要求,即 99% 的预测在 10 毫秒内收到)。
- 与 ODT 或 MDT 相比,在性能强大的流式引擎中预计算特征可以降低总体计算负担。
右移特征计算的理由包括:
- 预测请求对延迟不敏感,因此可以按需计算特征,避免浪费 CPU 周期去预计算那些不会被使用的特征
- 避免运行流式特征管道的基础设施负担
表 9-1 展示了一些倾向于预计算特征的实时机器学习用例,以及其他倾向于按需计算特征的用例。
| 用例 | 预计算特征还是按需计算? |
|---|---|
| 欺诈 | 左移。这需要低延迟的实时决策。预计算特征可确保推理管道能够快速检索这些特征,从而最大限度地减少昂贵的实时计算需求。 |
| 个性化推荐 | 左移。推荐需要以低延迟提供。预计算用户偏好、产品相似度分数和历史行为,使系统无需复杂的实时计算即可快速响应。不过,轻量级的实时更新(例如纳入最近的点击或浏览)可以作为补充。 |
| 动态定价 | 右移。定价通常取决于快速变化的因素,如供需、竞争对手定价和外部事件。这些变量可能需要在运行时通过第三方 API 检索,因此需要 ODT。 |
| 带浏览器会话上下文的聊天机器人 | 右移。聊天机器人的预测必须考虑动态的、会话特有的上下文(例如用户最近的查询、正在进行的对话上下文)。这使得预计算效果较差,因为系统主要依赖即时的对话上下文来进行特征计算。 |
| 预测性维护 | 左移。维护预测通常基于历史遥测数据、预计算的故障可能性和趋势。左移方法能够高效分析设备健康状况,并通过预计算移动平均、异常分数等特征来降低预测期间的计算负担。 |
| PII 移除 | 左移与右移兼有。根据数据最小化原则,你应尽早地在管道中移除 PII(个人身份信息),以降低敏感信息在整个数据处理生命周期中暴露的风险。你可能仍然需要在请求时检查 PII,因此需要 ODT。 |
与计算领域的惯例一样,选择意味着权衡。左移可能带来过多的运维开销,并且需要流处理方面的新技能;而右移可能会给预测增加过多延迟和成本。此外,某些类型的 ODT(例如聚合)可能需要在线特征存储提供特定支持才能高效计算。
右移架构
图 9-3 展示了一种按需特征计算架构:其中没有流式特征管道,实时特征由 ODT 计算,而 ODT 将聚合计算下推(push down)到在线特征存储。
描述按需特征计算架构的示意图,AI 应用将事件流式传输到特征存储,实现实时变换和模型服务。
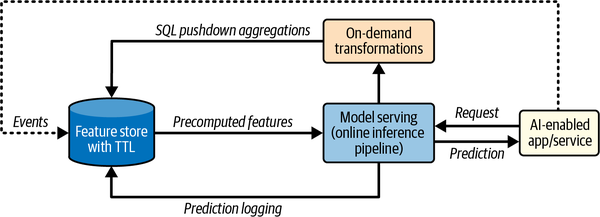
在这种架构中,AI 应用或服务将自身产生的原始事件直接流式传输到特征存储(通过 Kafka 或 REST API)。事件以行的形式存储在在线特征组中,并异步物化到离线特征存储(湖仓表)。ODT 函数中可以执行的不同类型数据变换包括:
- 无状态变换(stateless transformation)
- 仅使用请求参数计算
- 有状态变换(stateful transformation)
- 使用请求参数与从特征存储读取的预计算特征的组合来计算
- 基于原始事件的有状态变换
- 从在线特征存储中以 DataFrame 形式读取记录,然后对 DataFrame 执行变换
- 基于 SQL 的有状态变换
- 直接在在线特征存储中以 SQL 表达式执行变换,将变换后的数据以 DataFrame 形式返回;例如下推聚合(pushdown aggregation),如图 9-3 所示
能够执行无状态变换和预计算变换的 ODT 已在第7章中以 Python UDF 和 Pandas UDF 的形式介绍过。基于原始事件的有状态变换计算密集度更高,可能给在线推理管道、网络和特征存储带来高负载。图 9-4 展示了一种右移架构:聚合既可以在 ODT 中对原始记录使用 DataFrame 执行,也可以下推到在线特征存储,由后者以 SQL 执行。
描述右移架构的示意图,来自事件流的事件在流式特征管道中被过滤和变换,然后在本地聚合,或使用在线特征存储中的 SQL 聚合。
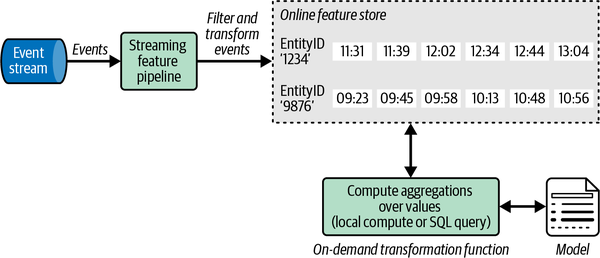
一般而言,ODT 读取原始记录并用 DataFrame 处理它们,其延迟和计算开销要比将聚合下推到在线特征存储并以 SQL 执行高得多。
我们已经看过 ODT 如何防止离线-在线偏斜(offline-online skew),那么按需 SQL 变换又是如何防止偏斜的呢?同样的 SQL 应该在特征管道中对历史数据执行,关键在于系统是否提供语言级 API 调用来生成最终执行的 SQL。例如,在 Hopsworks 中,RonSQL(针对 RonDB REST 服务器运行的 SQL)和 Spark SQL/DuckDB 都支持兼容 Postgres 的 SQL 方言。
按需 SQL 的一个注意事项是,在线特征存储必须支持 SQL API。例如,并非所有在线特征存储都支持下推聚合,因为许多在线特征存储是不支持 SQL 的键值存储。在线特征存储的另一个要求是应支持行的 TTL。TTL 可以在表级别或行级别指定。需要 TTL 的原因是,在线特征组通常只为实体存储最新的特征值。但是,当你想执行在线聚合时,原始的历史事件数据(包括 event_time 较早的特征)应该存储在那里。如果你的特征管道现在将原始数据写入在线特征存储(而不是更新实体的特征值),你的在线特征数据会不断增长,最终在线存储可能会耗尽可用存储空间。限制在线存储增长的最简单方法是指定在线特征组中的行具有 TTL。这样,行在 TTL 到期后就会被"垃圾回收",持续释放存储空间。
行的 TTL 在以下条件满足时到期:
\[current\_time > (event\_time + TTL)\]其中 TTL 按行或按表定义。按表 TTL(per-table TTL) 意味着表中所有行在创建时被赋予相同的 TTL。Hopsworks 同时支持按表和按行 TTL(通过其在线存储 RonDB)。行被创建(或更新)后,当前时间不断前进,最终该行的 TTL 到期,届时它会被安排自动删除。
不过,这里可能出现一个问题:写入和删除可能因特征管道中的延迟或故障而失去同步。由于删除总是在 TTL 间隔发生时发生,写入延迟可能意味着某些实体的数据变得不可用。Uber 在 2024 年特征存储峰会上的一次演讲中描述了这个问题。在写入延迟的情况下,你也应该延迟删除。虽然 Uber 由于 Cassandra 不支持追溯更新已写入行的 TTL 而无法做到这一点,但 Hopsworks 的数据库 RonDB 提供了清除窗口(purge window):过期的行只有在清除窗口过去后才会被删除。你可以启用读取 TTL 已到期但清除窗口尚未过去的行。如果延迟显著,你还可以临时延长清除窗口。
左移架构
现在我们进入本章剩余部分的主题——在流式特征管道中预计算特征数据。我们首先介绍构建流式特征管道的原始(现已过时的)混合方法:将在线特征工程放在流处理层、离线特征创建放在批处理管道中,作为两条独立的管道。然后,我们转向现代的流原生(streaming-native)架构:同一个流处理程序同时用于在线和离线特征工程。
混合流批架构
混合流批架构(hybrid streaming-batch architecture) 是一种包含两个独立处理层的设计:一个用于实时特征工程的流处理管道,和一个用于历史特征数据创建(回填,backfilling)的批处理管道。Klarna 在 2024 年 AWS re:Invent 大会上展示了其该架构的实现(见图 9-5)。
描述 Klarna 混合流批架构的示意图,展示使用 Amazon ECS 和 DynamoDB 的实时处理,以及使用 AWS Glue 和 S3 的离线处理,两者集成用于特征工程和决策。
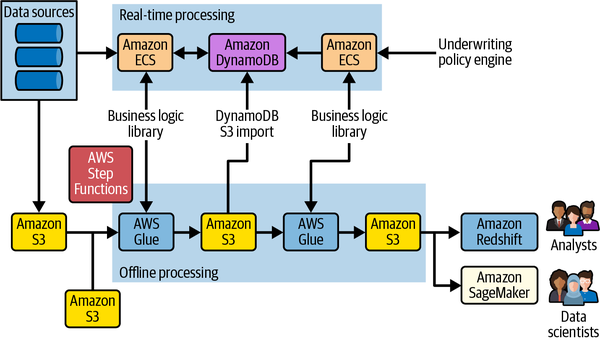
在该系统中,Klarna 通过将变换逻辑一次性写入一个共享库来防止离线-在线偏斜,该库同时用于批处理管道和流处理管道。鉴于流式程序和批处理程序都需要用能够使用相同共享特征计算库的语言编写,他们使用了一个自定义的流处理框架。一般来说,你应该避免这种架构,因为它需要自定义基础设施,并且库中需要复杂的逻辑才能让流式和批处理管道都能正确运行。相反,我们更倾向于流原生架构(streaming-native architecture):单个流处理管道既可以处理实时数据,也可以回填用于训练的特征数据。
提示
在流处理社区中,混合流批架构被称为 Lambda 架构,而流原生架构被称为 Kappa 架构。了解这些术语可能有助于你与数据工程师沟通,但 混合流批架构 和 流原生架构 这两个术语更容易解释。
流原生架构
流原生架构使用流式特征管道同时处理实时事件流和历史数据(见图 9-6)。
描述流式特征管道的示意图,该管道处理实时和历史事件流,使用本地存储管理状态,通过检查点(checkpointing)支持故障恢复,并将数据输出到特征存储。
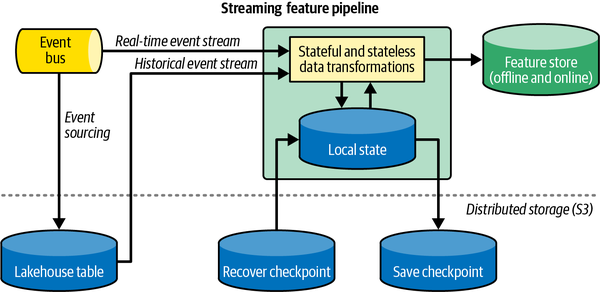
为了消除处理历史数据的批处理层,流式特征管道需要能够针对流式和批处理数据源运行,并根据处理的是实时数据还是历史数据而以不同的运行模式运行。流式特征管道最常见的运行模式是:
- 实时模式(real-time mode)
- 流式管道连续处理实时事件流,数据来源于事件流平台或其他流式数据源。流式引擎 24/7 运行,应具有高可用性,能够从部分或完全故障中自动恢复。
- 流重放(stream replay)
- 此模式通过流式管道重放历史事件,模拟实时处理。被重放的数据可以来自流式数据源(如事件流平台)或批处理数据源,并按与原始流相同的顺序和时序处理。重放完成后管道退出。
- 回填(backfilling)
- 此模式用于填补数据空白或处理来自批处理数据源(通常是 S3 兼容对象存储上的湖仓表)的历史数据。回填过程完成后,流式管道退出。
- 流重处理(stream reprocessing)
- 在此模式下,通过重新执行流,将更新后的逻辑应用到已处理过的数据。数据源通常是原始事件流平台,但也可能是批处理数据源中的事件溯源数据。流重处理通常用于创建特征组的新版本(使用不同的特征实现)。流式管道可以继续 24/7 运行,或者如果重处理是一次性任务则退出。
许多组织通过一种称为事件溯源(event sourcing)的过程在事件流平台之外保存事件的完整副本。这涉及将事件流复制到对象存储中更便宜的长期存储中。事件溯源通常是必需的,因为事件流平台不是长期数据存储,它们只保留数据相对较短的时间。例如,Apache Kafka 默认只存储数据 7 天。但有了事件溯源,S3 兼容对象存储上的湖仓表就可以用作流式特征管道的数据源,用于重放、回填或重处理历史事件流。如果没有事件溯源,当数据从事件流平台被清除后,你往往会失去重放、回填或重处理历史事件流的能力。
流式程序与批处理程序的主要区别在于,流式程序可以执行无状态和有状态两种数据变换,而批处理程序只执行无状态数据变换。在我们的信用卡欺诈系统中,我们使用有状态数据变换来创建有状态特征。例如,不同时间段内信用卡交易的计数和求和等聚合特征需要历史数据才能计算。有状态数据变换是部分开发者认为流处理开发环境具有挑战性的原因之一。开发者的另一个复杂度来源是事件源和流式引擎提供的一组数据处理保证:
- 精确一次(exactly-once)
- 每个事件只被处理一次且仅一次,确保没有重复或遗漏。
- 至少一次(at-least-once)
- 事件被处理一次或多次,确保不丢失数据,但允许重复事件。
- 至多一次(at-most-once)
- 事件被处理一次或完全不处理,优先保证低延迟,但存在数据丢失风险。
尽管一些流处理引擎支持精确一次语义,但默认情况下它们大多提供至少一次语义。至少一次语义的挑战在于,并非你自己的过错,你的特征管道也可能引入重复数据。幸运的是,我们不必担心重复数据,因为我们将使用 Hopsworks 特征存储作为汇。它通过以下方式将至少一次数据处理升级为精确一次:
- 将重复事件转变为在线存储(RonDB)的幂等更新
- 为离线存储(Apache Hudi)移除重复事件
这意味着在 Hopsworks 中,你不必编写额外代码来对流式管道中的数据进行去重。如果你使用的特征存储不提供精确一次处理保证,你将需要手动去重数据,或在训练和推理管道中处理重复数据。
背压
流式特征管道产生的负载往往在一天中或季节间变化很大。你应该对流处理系统进行容量规划,使其能够处理预期的写入负载。许多流处理框架可以通过背压(backpressure)来处理意外的事件流量峰值。背压 是流处理中的一种流控机制,它使数据源处的数据生产速率与汇处的数据消费速率相匹配。例如,当 Apache Flink 中的流式特征管道检测到其处理数据的速度慢于接收数据的速度时,它会向上游组件发出信号,要求它们减速或暂时暂停数据流。反过来,Apache Kafka 可以对生产者进行限流,使系统能够优雅地处理负载而不丢失数据。
编写流式特征管道
在第6章中,我们介绍了批处理特征管道如何被构造成数据流图(dataflow graph):数据源作为输入,DataFrame 作为节点,特征函数作为边,特征组作为汇。我们所说的特征函数 DAG 实际上就是一个数据流程序。数据流程序(dataflow program) 将计算建模为有向图,数据在操作之间流动,从而实现并行和增量处理。类似地,流式特征管道是一个以一个或多个事件流作为输入的数据流程序。节点是算子(operator)(执行数据变换),边表示数据依赖,特征组是汇。
批处理 ETL 程序使用 DataFrame 工作,而流处理程序使用数据流(datastream)工作。数据流表示随时间生成的数据记录的连续、无界序列(即事件流)。数据流与 DataFrame 的对比见表 9-2。
| 数据流(Datastream) | 数据帧(DataFrame) | |
|---|---|---|
| 性质 | 有模式数据的连续、无界流 | 有模式数据的静态、有限集合 |
| 处理 | (近)实时处理,产生新鲜的特征数据 | 批处理,特征数据延迟高 |
| 窗口化 | 需要窗口来切分数据 | 对整个数据集操作 |
| 状态 | 有状态或无状态数据处理 | 无状态数据处理 |
| 示例 | 金融交易和点击流 | 数据库表 |
数据流和 DataFrame 都有模式(schema)。对数据流的操作通常是有状态的且对时间敏感(低延迟)。窗口将无限流转换为一起处理的有限事件集合。数据流还支持轻松的增量计算。相比之下,DataFrame 表示静态、有界的数据集合(一张表),并以批处理方式处理。
数据流编程
在基于数据流的数据流编程(dataflow programming)中,算子从其输入(数据源或其他算子)消费数据,对数据执行计算,并产生数据到其输出(其他算子或一个或多个数据汇)。没有输入边的算子称为数据源(data source),没有输出边的算子称为数据汇(data sink)。数据流图必须至少有一个数据源和一个数据汇。流式特征管道有一个或多个数据源,并以一个或多个特征组作为数据汇。
算子可以接受多个输入流并产生多个输出流。它们还可以将单个输入流拆分为多个输出流以进行并行处理。例如,如果你有大量数据要处理,你可以按事件的主键拆分流,这样事件就可以在不同的 CPU 或服务器上并行处理,帮助你的系统扩展以并行处理更多数据。你也可以使用连接(join)变换将多个输入流合并为单个输出流。
为了提高吞吐量并最小化延迟,不同的算子(或管道阶段)可以并行运行,这一概念被称为任务并行(task parallelism)。算子之间的数据交换可以通过多种机制进行:
- 转发式数据交换(forward data exchange)
- 数据直接传递给下一个下游算子,不改变分布或路由。
- 广播式数据交换(broadcast data exchange)
- 相同数据的一份副本发送给所有下游算子,这对于分发配置或查找表等共享数据很有用。
- 基于键的数据交换(key-based data exchange)
- 数据按键路由,确保具有相同键的记录由同一个算子处理,从而支持并行的有状态操作(例如聚合、连接)。
- 随机数据交换(random data exchange)
- 数据在算子之间随机分布,为无状态操作平衡负载,但不保留数据局部性。
现在我们已经介绍了流处理数据流编程中的主要抽象,接下来我们将看看算子中的数据变换。
无状态与有状态数据变换
无状态数据处理(stateless data processing) 不维护任何内部状态,无状态数据变换(stateless data transformation) 不依赖任何过去的事件。因此,无状态数据变换很容易并行化,因为事件可以独立地、以任意顺序处理。在发生故障时,无状态数据变换可以安全地重新运行,前提是对输出特征存储的更新是幂等和/或原子的。
注意
乱序数据是指事件到达处理的顺序与其事件时间顺序不同(例如,由于网络延迟、断连操作等原因)。乱序数据必须在流处理管道中处理,因为它被认为是正常操作的一部分,而非异常情况。
流处理支持有状态数据变换,能够高效实现机器学习特征的数据变换,例如:
- 滚动聚合(rolling aggregation)
- 你可以在一段时间内使用它们来捕捉时序数据的趋势(例如过去一小时/一天/一周的信用卡支出)。
- 基于会话的特征(session-based feature)
- 包括用户会话的点击次数或持续时间。
- 滞后特征(lag feature)
- 捕捉变量在先前时间步的值(例如昨天的空气质量)。
- 累计和与累计计数(cumulative sum and count)
- 包括通过客户消费金额来捕捉客户终身价值。
- 距上次事件的时间(time since last event)
- 包括信用卡最近一次使用的时间和地点,有助于识别地理欺诈攻击。
- 窗口化聚合(windowed aggregation)
- 提供对近期活动激增或骤降的洞察(例如某个地理区域的异常欺诈活动)。
- 有状态连接(stateful join)
- 例如,你可以使用它将传入的信用卡交易与从湖仓表读取的信用卡元数据流进行连接。
有状态数据处理会维护关于先前已处理事件的状态。在处理新事件时可以更新状态,并且可以使用状态来参数化数据变换。出于这些原因,并行化有状态数据变换比并行化无状态数据变换更具挑战性。状态需要被正确分区,并在发生故障时可靠恢复。
可用于实现无状态和有状态数据变换的流处理框架越来越多。在这里,我们介绍最流行的、支持多种编程语言的开源流处理框架:
- Apache Flink
- 它支持许多内置的有状态和无状态数据变换操作,以及使用 DataStream API(Java)或 Table API(SQL)编写的高性能用户自定义函数(UDF)。
- Quix 和 Pathway
- 它们是提供 Python API 的单主机流处理引擎。它们支持使用内置算子进行有状态和无状态数据变换(Pathway 使用 Rust 引擎以获得高性能)。
- RisingWave
- 这是一个用 Rust 构建的分布式流处理引擎,支持用 SQL 和 Python 编写内置的有状态和无状态数据变换算子。它还包括自己的行式存储,因此你可以直接用 SQL 查询流式状态。
- Apache Spark Structured Streaming
- 它使用高性能的 Java/Scala 引擎支持许多内置的有状态和无状态数据变换算子,也支持用 Python 编写性能较低的用户自定义函数。
- Feldera
- 这是一个用 Rust 构建的开源流处理引擎,支持用 SQL 编写内置的有状态和无状态数据变换算子,并支持高性能的增量计算。用户自定义函数可以用 Rust 实现。
我们现在将更详细地了解其中两个流式引擎:Apache Flink 是使用最广泛、功能最丰富的分布式流处理引擎;Feldera 是一个对开发者友好的 SQL 流式引擎,支持增量视图。Apache Flink 将函数式编程与 Java 流式 API 以及 SQL 中的 Table API 相结合,而 Feldera 则强调声明式 SQL。与依赖微批处理(microbatching)的框架(如 Apache Spark)不同,Flink 和 Feldera 都以连续事件驱动的方式在数据到达时处理数据。逐事件处理(per-event processing)使实时机器学习系统能够实现亚秒级特征新鲜度,而微批处理则会将特征新鲜度提高到数十秒或更长。Apache Flink 是分布式的,可以在集群上横向扩展(最多数千个节点),而 Feldera 目前是单主机引擎(不过它在现代硬件上仍然可以扩展,对许多流式工作负载每秒处理 >100 万事件)。
Apache Flink
Flink 的 DataStream API 支持对事件流的数据变换算子,包括:
- map
- 对流中的每个事件应用一个函数:stream.map(evt -> evt.value * 2)
- filter
- 移除不匹配条件的事件:stream.filter(evt -> evt.value > 10)
- keyBy
- 基于键对流进行分区,以便许多工作进程并行处理事件。它返回一个
KeyedStream:stream.keyBy(evt -> evt.pk)
- 基于键对流进行分区,以便许多工作进程并行处理事件。它返回一个
- reduce
- 对 KeyedStream 执行增量聚合,使用用户自定义的关联函数合并具有相同键的事件:stream.keyBy(evt -> evt.pk) .reduce((a, b) -> a + b);
- window
- 在
KeyedStream上,按时间或计数将元素分组为有限集合以进行聚合:stream.keyBy(evt ->evt.pk) .window(TumblingEventTimeWindows.of(Time.seconds(10)))
- 在
如果你用 Java 实现自定义 UDF,函数应该是 Java 可序列化的,以便可以分发到工作进程。对于 Apache Flink 的 Table SQL API,查询会被优化并转换为原生 Flink 作业。
Apache Flink 还提供了一个复杂事件处理(Complex Event Processing,CEP)库,可以用有限状态机来指定匹配特定事件序列的模式。例如,在我们的信用卡欺诈系统中,我们可以实现这样的规则:“阻止一张在过去 5 分钟内被使用超过 10 次的信用卡”:
Pattern<Transaction, ?> fraudPattern =
  Pattern.<Transaction>begin("chainAttack")
    .where(evt -> evt.amount > 50) // Only transactions > 50 dollars
    .timesOrMore(10)  // 10 or more times
    .within(Time.minutes(5));  // Within 5 minutes
PatternStream<Transaction> patternStream =
  CEP.pattern(transactions, fraudPattern);
DataStream<String> alerts = patternStream
    .select((PatternSelectFunction<Transaction, String>) pattern -> {
        Transaction first = pattern.get("largeTx").get(0);
        return "Fraud detected on card: " + first.cardId;
    });
Feldera
Feldera 提供 SQL API,支持对事件流(内部表示为记录表)的各种数据变换算子:
- Map
- 通过
SELECT子句实现,将表达式直接应用于每条记录:SELECT value * 2 AS transformed_value FROM stream
- 通过
- Filter
- 通过
WHERE子句实现,移除不匹配条件的记录:SELECT * FROM stream WHERE value > 10
- 通过
- Reduce
- 类似于 Flink 的 reduce 算子,通过用 SQL 或 Rust 编写 UDF,并将其作为关联函数与
GROUP BY一起应用来实现:SELECT MY_UDF(value) AS reduced_value FROM stream GROUP BY key
- 类似于 Flink 的 reduce 算子,通过用 SQL 或 Rust 编写 UDF,并将其作为关联函数与
- Partition
PARTITION BY按键对流进行逻辑分区,使并行处理能够跨可用 CPU 进行。它通常用于窗口或聚合函数之前:SELECT key, value FROM stream PARTITION BY key
- Windowing
- Feldera 提供自定义 SQL 扩展,可直接在查询中定义窗口:SELECT key, COUNT(*) AS count FROM stream WINDOW TUMBLING (10 SECONDS) GROUP BY key
使用 Feldera 编写流式程序时,一个重要的考虑因素是,长时间运行的窗口可能会无限累积状态。为防止无界的状态增长(以及潜在的 out-of-memory 错误),你可以使用 RETAIN 定义状态过期策略。例如,以下查询创建一个 10 秒的翻滚窗口,并指定每个窗口的状态在其关闭 1 小时后被丢弃:
SELECT key, COUNT(*) AS count FROM stream WINDOW TUMBLING (10 SECONDS)
    RETAIN 1 HOUR GROUP BY key;
基准测试
流式系统在延迟和吞吐量之间存在权衡。你希望既以低延迟处理事件,又保持高吞吐量。然而,如果你将吞吐量推高到某个阈值以上,处理延迟就会上升。大多数流式特征管道应为第 95 或第 99 百分位延迟发布 SLO。当系统过载且吞吐量持续增加时,延迟最终会超过该 SLO。你应该进行基准测试,以找出流式特征管道的延迟和吞吐量扩展极限。
窗口化聚合
窗口在事件流上定义开始和结束边界,使你能够对窗口内的数据计算函数(例如聚合)。对于特征工程,窗口化聚合(windowed aggregation)有助于捕捉时间模式或趋势,为欺诈检测、推荐引擎和预测性维护应用等实时机器学习系统增加预测能力。图 9-7 展示了一个通用流式架构,它对输入事件流计算窗口化聚合,并将计算出的特征写入特征组。
描述流式架构的示意图,其中窗口分配器函数将事件映射到窗口以计算窗口化聚合,包括创建或关闭窗口、评估数据以及写入特征组的流程。
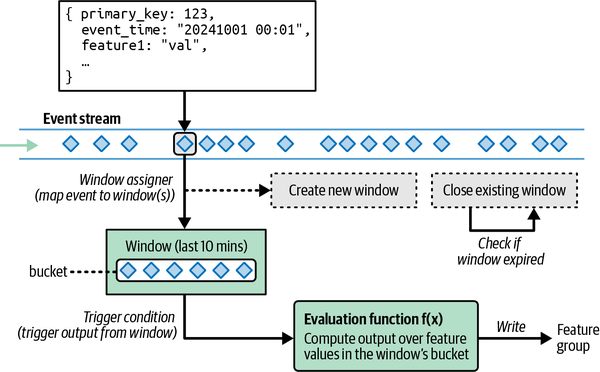
计算窗口化聚合所涉及的主要组件是:
- 无界事件流(unbounded event stream)
- 来自一个或多个流式数据源的传入事件。
- 窗口分配器(window assigner)
- 窗口分配器从事件中提取时间戳,然后将事件映射到一个或多个窗口。例如,在 10 分钟时间窗口聚合中,一个时间条件会检查事件流中的事件,看它们的
event_time是否落在窗口的 10 分钟边界内。如果事件满足该条件,它就被分配到该窗口。
- 窗口分配器从事件中提取时间戳,然后将事件映射到一个或多个窗口。例如,在 10 分钟时间窗口聚合中,一个时间条件会检查事件流中的事件,看它们的
- 窗口类型、状态保留策略和水印(watermark)
- 这些定义了窗口何时被创建和/或销毁。
- 触发条件(trigger condition)
- 指定何时评估窗口。触发条件取决于窗口类型。有些窗口只在窗口结束时输出结果,有些则在每个新事件到达时都输出。
- 评估函数(evaluation function)
- 通常是 count、sum、max 等聚合函数,在窗口的事件上计算。
- 汇(sink)
- 汇是特征存储中用于存放计算出的特征值的目标特征组。
不同的流处理引擎支持不同的窗口类型。例如,Apache Flink 支持会话窗口和全局窗口(见图 9-8)。
比较会话窗口和全局窗口聚合的示意图,会话窗口根据活动开始和结束,全局窗口则无限期保持打开。
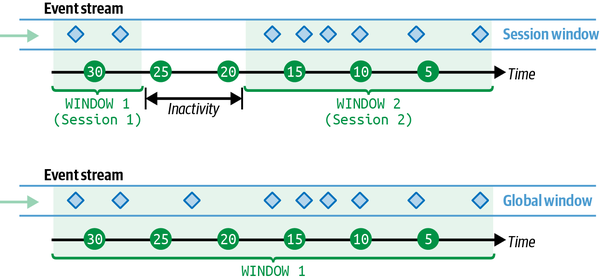
会话窗口(session window)在计算娱乐和零售应用中用户会话的特征(例如每个会话的活动量和参与度)时非常有用。每个事件通常包含一个会话 ID(或根据活动/不活动间隔推断出一个)。窗口分配器将事件映射到其会话窗口。会话窗口在会话开始时启动,在一段不活动期后关闭。会话窗口的数量通常与活动会话的数量一致,不过窗口可能在不活动之后短暂存留才关闭。当会话结束时(触发条件),聚合特征被计算并写入特征存储。
全局窗口(global window)对于计算全局特征(例如电商网站的热门产品)非常有用。它的窗口分配器将所有相关事件(例如购买、页面浏览)放入一个跨越整个流式作业运行时间的全局窗口中。窗口在流式作业启动时创建,在作业结束时关闭。聚合通常按固定间隔输出(例如每小时、每天)。
虽然全局窗口和会话窗口很有用,但对于为机器学习计算聚合特征,还有其他更流行的窗口类型——滚动聚合和时间窗口。
滚动聚合
滚动聚合在流式特征管道中创造出最新鲜的聚合特征。
它们是窗口化聚合的一种形式,但没有截然不同的固定窗口。相反,它们在连续移动的时间间隔上计算。我们仍将这个间隔称为"窗口",因为它的行为就像一个受时间约束的、时间相关事件的有限集合。
窗口分配器提取每个事件的 event_time,并将其映射到一个或多个滚动窗口。例如,如果有两个滚动窗口,一个覆盖前 1 分钟,一个覆盖前 1 小时:
- 一个 10 秒前的事件会被同时添加到两个窗口。
- 一个 70 秒前的事件只会被添加到小时窗口。
- 迟到的事件会被两个窗口忽略,但应单独处理以用于历史处理。
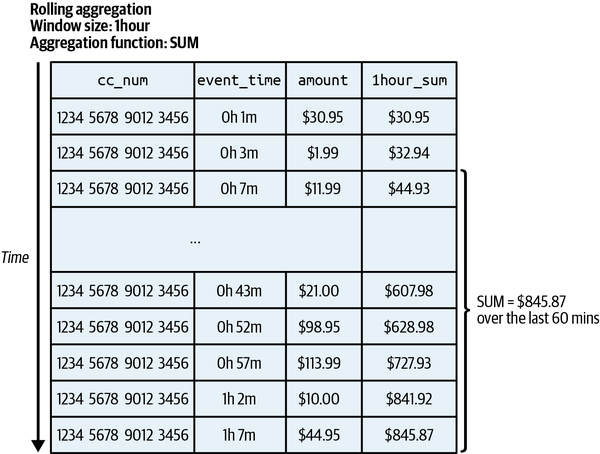
滚动聚合在新事件到达时立即评估,给出尽可能低的延迟。每次到达都会触发一个新的聚合值,这使得滚动聚合成为保持行数不变(row size-preserving)的变换。这意味着它们是内存密集型的变换。
大多数流式引擎提供内置的聚合函数(min、max、mean、median、sum、standard deviation、percentile)来计算滚动聚合。在图 9-9 中,我们计算过去一小时内 amount 列上的 sum 聚合,其中使用 event_time 列来选择过去一小时的行。
说明对一小时窗口内的金额进行滚动求和聚合的示意图,展示了信用卡随着新事件到达而更新。
在流处理中,滚动聚合历来被认为对于大规模工作负载来说计算成本过高,因为每个新事件都会触发对窗口内所有事件的重新计算。增量视图(本章后面介绍)的引入将这种复杂度从线性时间(相对于窗口大小)降低到常数时间。如果你的流处理引擎不支持增量视图,你可能应该使用时间窗口聚合,因为它们的计算强度要低得多。
时间窗口聚合
时间窗口(time window) 是一组时间相关、通常连续的事件。时间窗口聚合在固定时长内汇总数据:
- 窗口长度(window length)
- 窗口开始与结束之间的时间
- 窗口大小(window size)
- 窗口桶中的事件数量
- 窗口分配器
- 根据事件的
event_time是否落在窗口开始和结束时间之间,将事件映射到窗口
- 根据事件的
与滚动聚合不同,许多时间窗口可以同时为不同的(可能重叠的)时间间隔打开。随着时间推移,窗口不断被创建和关闭,分别分配和释放资源。
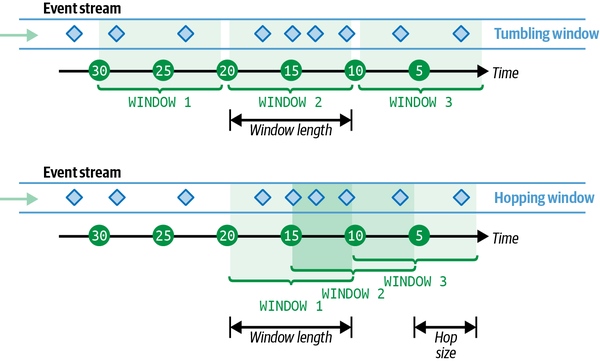
两种最常见的窗口化聚合类型(如图 9-10 所示)是:
- 翻滚窗口(tumbling window)
- 具有固定大小且不重叠的窗口。事件将被分配到恰好一个窗口。
- 跳跃(或滑动)窗口(hopping/sliding window)
- 以固定间隔(称为跳跃步长(hop size)或滑动长度(slide length))前进且可能与先前窗口重叠的窗口:
- 每次跳跃都会触发窗口的评估函数,即使没有事件发生变化也会产生输出。
- 如果跳跃步长小于窗口长度,窗口可以被更频繁地评估,并且同一事件可以被分配到多个窗口。
- 在 Apache Flink 中,每次跳跃都会创建一个新窗口,这意味着事件会在多个窗口间重复。如果跳跃步长远小于窗口长度,数据重复会变得过大,损害管道的可扩展性。
- 以固定间隔(称为跳跃步长(hop size)或滑动长度(slide length))前进且可能与先前窗口重叠的窗口:
比较翻滚窗口和跳跃窗口的示意图,翻滚窗口不重叠,跳跃窗口是否重叠取决于跳跃步长与窗口长度的相对关系。
时间窗口需要在某个时刻关闭以释放其资源(内存)。窗口的状态保留策略定义了包含事件的桶在被关闭之前保留多长时间。
你可以通过为窗口定义水印(watermark)来让时间窗口保持打开(以接受时间戳介于窗口开始和结束之间的事件)更长时间。水印是事件的时间戳可以被分配到该时间窗口的迟到上限。水印过后,窗口被触发并由流式引擎关闭。
例如,如果我在计算信用卡交易的一小时时间窗口聚合:
- 使用三小时水印,迟到两小时的事件仍会被分配到正确的窗口。
- 使用一小时水印,同一个事件会被标记为迟到并被排除。
在选择水印时长时,你应该要么:
- 确信在上限之后不会再有延迟事件到达。
- 接受上限之后到达的迟到事件将被忽略。
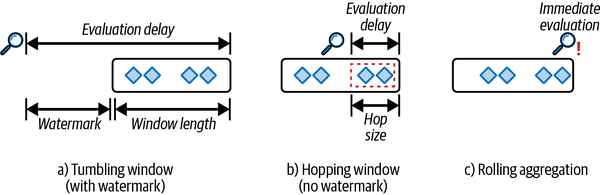
水印是一个难以推理的概念。它们还通过增加窗口聚合的评估延迟,使实时机器学习系统的"实时性"降低(见图 9-11)。
比较带水印的翻滚窗口、无水印的跳跃窗口和滚动聚合的示意图,突出评估延迟和即时评估。
另一方面,水印使那些可能因网络或设备问题而偶尔断连的应用和服务,仍然能够为我们的机器学习系统提供实时数据。例如,一些信用卡终端可以在与互联网断开的情况下使用(例如在飞机上),当它们重新联网时,会发送其信用卡交易进行处理。迟到的事件如果被添加到更长时间窗口(例如一天时间窗口)中,可能仍然有助于预测未来的信用卡欺诈。
我们可能仍然希望保存迟到事件,以便从中计算历史特征,从而将其转换为用于训练新模型的历史特征数据。也就是说,即使迟到事件没有被用于在线存储中的任何特征计算,它仍然应该进入离线特征存储:
- 在 Apache Flink 中,你可以使用侧输出(side output)来处理迟到事件,而不会干扰主处理流程。
- 在 Hopsworks 中,你的流式应用可以通过更新 Kafka 事件的头部,将"迟到"(late)属性设置为 true 来处理迟到事件。在摄取时,Hopsworks 随后只将"迟到"事件写入离线存储,而不写入在线存储。
提示
如果你采用流原生架构,并且之后需要迟到事件来创建训练数据或用于 RAG,就不应该丢弃它们。这个问题有两种解决方案。一种是通过事件溯源存储所有原始事件。然后,当你从历史数据创建特征数据时,可以针对事件溯源数据运行同一条流式特征管道。另一种解决方案是让流式特征管道计算迟到数据上的特征,但只将其写入离线存储。如果你不想遗漏任何数据,无论它有多晚,你都应该选择事件溯源。
为聚合选择最佳窗口类型
表 9-3 对翻滚窗口、跳跃窗口和滚动聚合进行了比较。
| 翻滚窗口 | 跳跃窗口 | 滚动聚合 | |
|---|---|---|---|
| 输出行数 | 行数缩减。窗口内的事件被归约为单个聚合结果。 | 行数缩减。结果在多个事件上聚合,产生的行数少于输入。 | 行数保持。结果为每个输入事件重新计算。每个事件一个输出。 |
| 计算开销 | 低。每个窗口计算一次聚合。 | 中/高。随跳跃步长反向缩放。 | 有增量视图时低。无增量视图时高。 |
| 内存开销 | 低。窗口不重叠。 | 中/高。窗口重叠。 | 低/中。窗口不重叠。 |
| 特征新鲜度 | 低。在每个固定窗口间隔结束时触发。 | 中。按固定间隔触发,无论是否有新事件到达。 | 高。每个进入或离开窗口的事件都会触发。 |
翻滚窗口适用于数据量大、可能包含迟到数据、变化缓慢的长时间窗口。例如,一周的翻滚聚合可以"升级"为跳跃步长为一天的跳跃窗口,以产生更新鲜的输出。
一般来说,如果可行,你应该使用滚动聚合。它们能提供最新鲜的特征,且无需水印或评估延迟。只要满足以下条件,它们就可以扩展:
- 你的在线特征存储支持所需的写入速率和存储容量。
- 你的流式引擎支持增量视图。
基于增量视图的滚动聚合
滚动聚合可以在 Apache Flink 中使用 OVER 聚合实现:对于每一行输入,在有序行范围内计算一个聚合值。然而,尽管 Apache Flink 的 OVER 聚合可以在许多工作进程上分区,但它们并不能随着窗口大小和事件吞吐量的增加而良好扩展,因为每个新事件都会触发聚合函数的重新计算,而其计算成本与窗口大小成正比(见图 9-12)。
比较无增量视图和有增量视图的滚动聚合的示意图,无增量视图时显示完整重算成本为 O(N),有增量视图时成本降为每事件 O(1)。
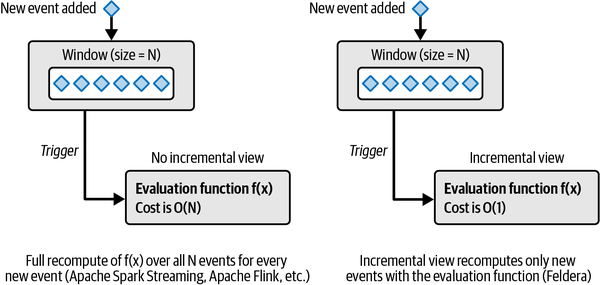
增量视图(incremental view)通过避免在新事件到达时对聚合进行完整重新计算来解决扩展性挑战。相反,它们复用先前计算的值,只应用新事件或移除事件带来的变化。因此,所做的工作与输入/输出的变化量成正比,而非窗口大小。
Feldera 通过其流式引擎 DBSP(受信号处理启发的数据库,DataBase inspired by Signal Processing) 支持增量视图维护。DBSP 使用 Z 集(Z-set)实现增量视图——Z 集是关系集合的推广,不仅跟踪哪些元素存在,还跟踪它们的计数如何随时间变化。在传统关系集合中,一个元素要么存在(count = 1),要么不存在(count = 0)。在 Z 集中,每个元素都有一个整数计数,可以是正数、零或负数:
- 正计数表示插入(添加事件)。
- 负计数表示删除(移除事件)。
这使得 Z 集能够表示增量(delta)——两个状态之间的净变化,而无需在每一步存储完整状态。
例如,如果先前状态为 {apple: 5},新状态为 {apple: 3},则增量为 {apple: -2}。DBSP 将此增量应用于现有状态,以高效更新结果。
由于 DBSP 在单台服务器上运行,它可以假设线性时间,并且每个状态恰好有一个前驱。这简化了开发者的流处理逻辑,同时保持聚合更新快速且可扩展。
现在,我们来看看如何在 Feldera 中实现滚动聚合。决定如何实现任何类型的窗口化聚合的一般流程如下:
- 为你的模型选择预测能力最高的聚合(sum、count 等)。选择分组的键(可选):定义聚合所应用的组,例如信用卡号或商户 ID。
- 选择窗口大小和窗口类型:滚动聚合或时间窗口。如果你选择时间窗口,请从翻滚、跳跃或其他类型中选择。
- 处理缺失数据:决定如何处理没有数据的窗口(例如,用零或 NaN 填充)。
信用卡欺诈流式特征
在我们的信用卡欺诈系统中,我们对信用卡交易的聚合感兴趣,因此在计算聚合之前,我们按 cc_num 对交易进行分组。我们将使用交易总和与计数的滚动聚合,因为这两个特征的异常值都能预测信用卡欺诈。我们将使用增量视图实现滚动聚合,因为它们能产生预计算的最新特征,并且会给在线推理管道带来最小延迟,从而帮助我们的系统满足低延迟要求。
下面,我们展示 Feldera 中的 SQL,用于计算不同时间间隔(10 分钟、1 小时、1 天、1 周)和两种不同聚合(sum 和 count)下的信用卡交易滚动聚合:
CREATE TABLE credit_card_transactions ( t_id BIGINT,
    ts TIMESTAMP,
    cc_num VARCHAR,
    merchant_id VARCHAR,
    amount DOUBLE,
    ip_addr VARCHAR,
    card_present BOOLEAN
) WITH (
    'connectors' = '[{transaction_source_config}]'
);

CREATE MATERIALIZED VIEW rolling_aggregates AS SELECT t.cc_num,
    t.ts AS event_time,
    t.ip_addr,
    t.card_present,
    SUM(COALESCE(amount, 0)) OVER window_10_minute AS sum_10min,
    COUNT(amount) OVER window_10_minute AS count_10min,
    SUM(COALESCE(amount, 0)) OVER window_1_hour AS sum_1hour,
    COUNT(amount) OVER window_1_hour AS count_1hour,
    SUM(COALESCE(amount, 0)) OVER window_1_day AS sum_1day,
    COUNT(amount) OVER window_1_day AS count_1day,
    SUM(COALESCE(amount, 0)) OVER window_7_day AS sum_7day,
    COUNT(amount) OVER window_7_day AS count_7day
FROM
    credit_card_transactions AS t

WINDOW window_10_minute AS (
        PARTITION BY cc_num
        ORDER BY ts
        RANGE BETWEEN INTERVAL '10' MINUTE PRECEDING AND CURRENT ROW
    ),
    window_1_hour AS (
        PARTITION BY cc_num
        ORDER BY ts
        RANGE BETWEEN INTERVAL '1' HOUR PRECEDING AND CURRENT ROW
    ),
    window_1_day AS (
        PARTITION BY cc_num
        ORDER BY ts
        RANGE BETWEEN INTERVAL '1' DAY PRECEDING AND CURRENT ROW
    ),
    window_7_day AS (
        PARTITION BY cc_num
        ORDER BY ts
        RANGE BETWEEN INTERVAL '7' DAY PRECEDING AND CURRENT ROW
    );
- 创建一个代表事件流的交易表。我们使用 Feldera 到 Apache Kafka 的输入连接器来提供交易事件流。
- 创建一个物化视图,其中包含原始交易事件以及我们附加的滚动聚合。
SELECT语句决定输出中包含哪些列。物化视图包含所有交易列,以及包含滚动聚合的附加列——10 分钟、1 小时、1 天和 7 天窗口的 sum 和 count。请注意,COUNT忽略NULL值,而COALESCE将NULL值替换为 0。- 对于我们的滚动聚合列,我们定义了不同的窗口长度:
10_minute、1_hour、1_day和7_day。每个窗口包含以下参数:(1)用于按行分组的列cc_num,(2)event_time列,以及(3)包含当前行的窗口(间隔)长度。
分块时间窗口聚合
Airbnb 的 Chronon 框架 提供了一种降低滚动聚合计算开销的替代解决方案,称为分块时间窗口聚合(tiled time window aggregation)。分块(tile)将长度为 N 的窗口划分为 M 个分块,其中 \(M \ll N\),并通过组合区间开始和结束处未对齐事件的分块来构成聚合。
例如,假设你想在中午 12:00 用 24 小时分块(每天计算)构成一个精确的 240 小时聚合。你还没有为当天的事件(从凌晨 12:00 到中午 12:00)计算分块,而且你也不会有一个用于区间内最后一天中午 12:00 之后事件的分块(当天的分块包含不在区间内的事件)。分块聚合的计算方式是:将预计算的分块与区间开始和结束处未对齐事件上的按需聚合组合起来。分块聚合将左移(预计算的分块)与右移(按需聚合)结合在一起。相比之下,增量视图将整个聚合计算左移,从而降低实时机器学习系统聚合特征的延迟。
ASOF 连接与变换组合
通常,你需要通过将事件数据与其他数据源的历史数据连接来丰富事件流。例如,我们可能希望在交易事件中添加执行交易的信用卡的 status(active、blocked、Lost/Stolen)。我们还希望用执行交易的卡对应的 account_id 和 bank_id 来丰富交易事件。
在这两个示例中,我们将事件流中的事件与数据仓库中的时序数据连接,为此,我们需要执行 ASOF JOIN。之所以需要 ASOF JOIN,是因为流式特征管道应该既能在实时模式下运行,也能在回填模式下运行。在实时模式下,某张信用卡可能处于"blocked"状态,而在回填时,它在某个时间点处于"active"状态。连接需要用交易发生时间点上正确的卡 status 来丰富交易。
我们还可以组合数据变换,例如使用派生数据定义聚合或过滤器。可组合变换使我们能够构建分层系统、复用经过测试的代码,并遵循 DRY 原则。
在下一个代码片段中,我们定义了一个新的 invalid_card 变换,它是一个物化视图,用于过滤那些在 card_details 中未被标记为 active 的卡产生的交易。此变换使用 ASOF JOIN,数据变换是一个过滤器(而非聚合):
CREATE TABLE card_details (
    cc_num VARCHAR NOT NULL,
    cc_expiry_date TIMESTAMP,
    account_id VARCHAR NOT NULL,
    bank_id VARCHAR NOT NULL,
    issue_date TIMESTAMP,
    card_type VARCHAR,
    status VARCHAR,
    last_modified TIMESTAMP
) WITH (
    'connectors' = '[{card_details_source_config}]'
);

CREATE MATERIALIZED VIEW invalid_card_transaction AS
SELECT
    t.cc_num,
    t.ts AS event_time,
    (cd.status != 'active') AS invalid_card
FROM credit_card_transactions AS t
LEFT ASOF JOIN card_details AS cd
    MATCH_CONDITION (t.ts >= cd.last_modified)
    ON t.cc_num = cd.cc_num
;
Feldera 支持 LEFT ASOF JOIN 操作,用于时间点正确(point-in-time correct)的连接(见第4章)。你还可以使用嵌套视图(nested view)组合数据变换。在下面的代码片段中,我们定义了一个由 invalid_card_transaction 视图计算得到的物化视图。这个派生特征统计一天滚动聚合中来自无效卡的交易数量:
CREATE MATERIALIZED VIEW invalid_card_transaction_count AS
SELECT
    cc_num,
    SUM(CASE WHEN invalid_card THEN 1 ELSE 0 END)
        OVER window_1_day AS invalid_1day
FROM
    invalid_card_transaction
WINDOW
    window_1_day AS (
PARTITION BY cc_num
ORDER BY event_time RANGE BETWEEN
      INTERVAL '1' DAY PRECEDING AND CURRENT ROW
    );
这些数据变换向你展示了如何连接和丰富交易事件以及组合变换。现在让我们看看如何将连接得到的特征添加到 cc_trans_aggs_fg 特征组,并在 Feldera 中将滞后特征定义为变换。
Feldera 中的滞后特征与特征管道
在上一节中,我们介绍了在 Feldera 中为 cc_trans_aggs_fg 创建滚动聚合特征的流式数据变换。
我们还需要为 cc_trans_aggs_fg 添加以下特征:
- account_id
- bank_id
- prev_ts_transaction
- prev_ip_transaction
- prev_card_present
我们将通过与 card_details 的连接变换来添加 account_id 和 bank_id 特征。Feldera 提供了 LAG 算子,我们可以用它将有状态数据变换高效地计算滞后特征。首先,我们将创建两个中间物化视图 cc_trans_card 和 lagged_trans,然后将它们连接起来,为我们的特征组 cc_trans_aggs_fg 生成最终特征:
def build_last_tr_sql(transaction_src_config: str, fs_sink_config: str) -> str:
    return f"""

--Point-in-time correct join of rolling_aggregates view with card_details table
CREATE MATERIALIZED VIEW cc_trans_card AS
SELECT
    ra.*,
    cd.account_id,
    cd.bank_id
FROM rolling_aggregates AS ra
LEFT ASOF JOIN card_details AS cd
    MATCH_CONDITION (ra.event_time >= cd.last_modified)
    ON ra.cc_num = cd.cc_num
;

-- Compute lagged features for transactions
CREATE LOCAL VIEW lagged_trans AS
SELECT
    ctc.*,
    LAG(event_time) OVER
      (PARTITION BY cc_num ORDER BY event_time ASC) AS prev_ts_transaction,
    LAG(ip_addr) OVER
      (PARTITION BY cc_num ORDER BY event_time ASC) AS prev_ip_transaction,
    LAG(card_present) OVER
      (PARTITION BY cc_num ORDER BY event_time ASC) AS prev_card_present
FROM cc_trans_card AS ctc;

-- Write the final features to the feature group sink
CREATE VIEW cc_trans_aggs_fg
WITH (
    'connectors' = '[{fs_sink_config}]'
)
AS
    SELECT cc_num,
        event_time,
        account_id,
        bank_id,
        sum_10min,
        count_10min,
        sum_1hour,
        count_1hour,
        sum_1day,
        count_1day,
        sum_7day,
        count_7day,
        prev_ts_transaction,
        prev_ip_transaction,
        prev_card_present
    FROM lagged_trans;
"""
- 显式选择所有列,而不是使用
lagged_trans,以防止如果lagged_trans中添加了新列而破坏模式(schema breaking)变更。
我们希望这些 Feldera 变换从交易数据源(Apache Kafka 主题)读取数据,并将数据写入 Hopsworks 特征组作为汇。为此,你需要定义输入数据源并将它们组合在一起以运行 Feldera 管道,如下所示:
transaction_src_config = # Apache Kafka Topic
card_details_src_config = # card_details table in data mart
fs_sink_config = # Hopsworks Feature Group output
last_tr_sql = build_last_tr_sql(transaction_src_config, fs_sink_config)
last_tr_pipeline = PipelineBuilder(client, name = \
    "hopsworks_delta_kafka_last_tr", sql = last_tr_sql).create_or_replace()
last_tr_pipeline.start()
流式特征管道的输出是写入特征组的行。特征组在写入之前应该已经存在。你通常不会在流式特征管道程序中创建特征组。相反,最佳实践是在单独的程序(或 notebook)中预先创建特征组,并在其中显式定义特征组的模式,如下面的代码所示:
from hsfs.feature import Feature
features = [
    Feature(name="cc_num", type="string", online_type="varchar(16)"),
    Feature(name="account_id", type="string"),
    Feature(name="bank_id", type="string"),
    Feature(name="event_time", type="TIMESTAMP"),
   ...
]

fg = fs.create_feature_group(name="cc_trans_aggs_fg",
                             features=features,
                             ...)
fg.save(features)
小结与练习
流式特征管道和 ODT 使实时机器学习系统能够在人类交互的时间尺度上对应用或服务中的非语言操作做出反应。在本章中,我们展示了如何将实时特征的计算右移:将原始事件数据存储在在线特征存储中,然后按需计算特征——既可以在在线推理管道中直接计算,也可以将 SQL 查询下推到在线特征存储。然而,本章的大部分内容关注的是通过流式管道预计算特征来左移实时特征计算。我们介绍了构建流式应用的基本概念,包括窗口化聚合和不同类型的窗口。我们介绍了两个用于构建流式特征管道的流处理引擎:Apache Flink 和 Feldera。我们还介绍了用于聚合的不同窗口类型,并展示了增量视图维护如何使滚动聚合具备可扩展性和新鲜的特征。最后,我们以 Feldera 中为信用卡欺诈检测系统计算实时特征的 SQL 示例程序作为本章的结尾。
做以下练习,帮助你学习如何设计和编写流式特征管道:
- 编写一个函数,将交易中的
ip_addr变换为位置(location)特征。 - 为一个新的位置特征组计算新特征,该特征组由之前计算的位置特征组合而成。例如,计算按位置分组的时间窗口内的交易活动计数。
- 在 Feldera 中编写一个自定义数据校验规则,并将任何坏记录写入一个包含坏交易数据的汇特征组。
- 添加一个过去 5 分钟、1 小时、24 小时和 7 天的商户消费(
count)特征。