批处理特征管道
在前两章中,我们探讨了如何实现数据变换来创建可复用特征和模型专属特征。现在,我们将研究如何使用批处理特征管道(batch feature pipeline)将可复用特征数据的创建过程生产化。批处理特征管道是一个程序,它从数据源读取数据,对提取的数据应用 MIT,并将计算出的特征数据存储在特征存储中。批处理特征管道可以按计划运行,例如每小时或每天运行一次,增量处理新到达且可供处理的数据。它也可以按需运行,将大量历史数据变换为特征,这一过程被称为回填(backfilling)。
批处理特征管道的目标是在所谓的批处理(batch processing)中自动化特征创建,与一次处理单条记录相比,批处理在资源利用上更高效。例如,想象一下比较一次一个玻璃杯或一个盘子地清空洗碗机与成批卸下盘子和玻璃杯所需的时间。类似地,在数据处理中,成批处理数据比一次处理一条记录要高效得多。此外,如果每天执行批处理,你可以利用夜间成本更低的非高峰处理时间。与流处理相比,另一个运维上的好处是,错误只需要在下一次计划运行的批处理特征管道之前修复——你可能不需要被寻呼机叫醒来修复管道。批处理的缺点是,你的特征数据的新鲜度只能保证到批处理运行的时间间隔。
在本章中,你还将学习如何通过提示 LLM 创建一个生成合成数据的程序,为我们的信用卡欺诈数据集市创建合成数据。你还将学习如何编写一个可以针对数据源进行参数化的批处理特征管道,使其能够在回填或生产(增量数据处理)模式下运行。我们将介绍用于运行批处理特征管道的编排器(orchestrator)。最后,你将学习如何通过提供数据质量保证来为特征组设计数据契约(data contract)。这将涉及在特征数据存储到特征存储之前,使用 Great Expectations 验证特征数据,并使用特征组的模式化标签(schematized tag)执行数据治理检查。
批处理特征管道
特征管道是一种数据管道(data pipeline)——一个自动化地将数据从一个或多个数据源传输和变换到目标数据存储(称为数据汇(data sink))的程序。在第4章中,我们介绍了数据管道的两个流行类别:ETL 和 ELT 管道。ETL 管道在数据写入目标之前进行变换,而 ELT 管道先将数据写入目标,然后就地变换数据(通常使用数据仓库中的 SQL)。数据管道是需要按计划运行(称为批处理数据管道(batch data pipeline))或全天候运行(称为流式数据管道(streaming data pipeline))的运维服务。批处理特征管道是将源数据变换为特征数据的批处理数据管道,通常将其输出存储在特征存储中。
批处理特征管道可以实现为 ELT 或 ETL 管道,但最常见的是 ETL 管道。ELT 管道是 SQL 程序,它们高效且易于创建聚合、统计特征和滞后特征等流行特征。然而,SQL 在特征工程能力上有限,大多数批处理特征管道是 ETL 程序。作为 ETL 程序的批处理特征管道通常是 Python 程序(Pandas、Polars、PySpark),并通过利用 Python 生态系统的数据变换库来支持更丰富的特征创建能力。例如,有用于创建向量嵌入、网页抓取、从第三方 API 读取数据以及轻松集成 LLM API 进行数据处理和信息检索的 Python 库。
作为 ETL 程序的批处理特征管道具有共同的结构:
- 程序的一次执行运行由编排器调度或触发。
- 从一个或多个数据源读取输入数据,并带有本次运行要处理的输入数据时间范围的开始/结束时间戳。
- 一个由 MIT 组成的有向无环图(DAG)为特征组创建特征数据。
- 对特征数据应用一组数据和模式验证检查。
- 特征数据被保存到一个或多个特征组。
我们将从研究特征管道(批处理和流式)的不同类型数据源开始。
特征管道数据源
AI 系统的数据源头由连接到用户、机器和现实世界的应用程序、服务和设备组成。它们产生的数据存储在运营数据库、湖仓或数据仓库(基于对象存储)以及事件流平台中。这些数据存储是特征管道的主要数据源,它们属于三类之一:批处理数据源、(事件)流数据源和 API 数据源(参见图 8-1)。
图示:展示从运营数据库、对象存储和 API 到特征管道的数据流,说明批处理、流式和 API 数据源与特征存储的集成。
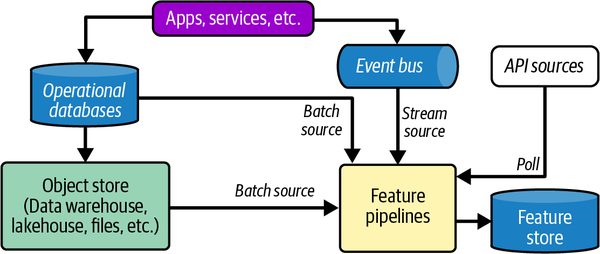
回填通常使用批处理数据源(列式数据库、行式数据库、对象存储)读取历史数据。计划运行的批处理特征管道或流式特征管道从批处理、流式和 API 数据源中的任意一个或全部读取新的增量数据。特征管道通过 ODT 可以将外部 API 用作数据源。流式特征管道通常以事件流平台(流数据源)作为主要数据源。
批处理数据源
列式存储、行式存储、对象存储和 NoSQL 存储是批处理数据源的典型例子。批处理数据以结构化数据的形式读取,你的批处理程序使用驱动库(driver library)(通常需要安装的依赖项)和连接信息(主机名/端口、数据库和用于身份验证的凭据)从中读取数据。
构建 AI 系统最重要的批处理数据源包括:
- 关系数据库
- 它们将数据行存储在表中。
- 对象存储和文件系统
- 它们将数据以文件形式存储在目录中。文件既可以包含非结构化数据(例如 PDF 文件中的文本、PNG 文件中的图像),也可以包含结构化数据(例如湖仓表中的 JSON 文件或 Parquet 文件)。
- NoSQL 数据存储
- 它们是可扩展的运营数据存储,存储专门类型的数据:
- 键值存储(key-value store)(如 DynamoDB 和 Redis)专为低延迟和高扩展性而设计。客户端可以通过提供一个或多个键来读取值。
- 面向文档的存储(document-oriented store)(如 OpenSearch 和 Elasticsearch)专为文档内文本的全文搜索而设计。
- 类 JSON 文档存储(如 MongoDB)专为低延迟和高扩展性而设计,客户端可以读写 JSON 对象。
- 图数据库(graph database)(如 Neo4j)专为存储和查询以节点和边构成的图结构数据而设计。
- 向量数据库(vector database)(如 Weaviate 和 Qdrant)专为对压缩数据进行相似性搜索而设计,客户端可以存储和搜索向量嵌入。
- 它们是可扩展的运营数据存储,存储专门类型的数据:
批处理数据源之间的一个显著区别是,它们提供的是带有模式的数据(称为结构化数据(structured data)或表格数据(tabular data)),还是没有模式的数据(称为非结构化数据(unstructured data))。例如,PDF 文件包含文本和图像,但它们没有模式。视频和图像数据也被视为非结构化数据。相比之下,来自 SQL 和 NoSQL 数据源的大部分数据是结构化/表格数据。关系数据库中的表具有包含命名/类型化列的模式。JSON 对象包含(嵌套的)键值对,其中键是字符串,值可以是字符串、数字、对象、数组、布尔值或 null。事件流平台中的事件可以是 JSON 对象,也可以具有 Avro 模式(就像具有命名/类型化列的表)。向量嵌入具有数据类型(具有固定维数的浮点数)。
图 8-2 展示了湖仓作为批处理或流式特征管道的批处理数据源。
图示:说明批处理和流式特征管道处理湖仓中信用卡交易表的数据,更新特征组中的记录,包括在线存储、向量索引和离线存储。
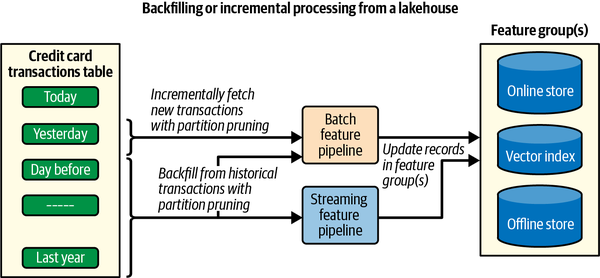
湖仓表按天分区存储,当批处理程序每天运行一次时,它只读取和处理昨天的数据,从而限制需要处理的数据量。当批处理程序从历史数据回填时,它将需要更多资源,因为它将读取和处理更多的数据分区。如果一批数据的大小超过单台机器的内存或处理能力,你将需要使用分布式批处理程序,例如 PySpark,它可以扩展以使用许多并行工作进程处理更大的批次。另一种方法是为每个分区重新运行批处理程序,但这将比使用 PySpark 慢一个数量级。因此,我的建议是选择一个能够满足回填期间最大预期负载的批处理框架。使用流式程序回填时不会遇到同样的资源挑战,因为它们增量处理数据。注意,它们在完成回填后会立即退出。
在这个例子中,批处理特征管道是一个 ETL 程序。但是,如果你有 SQL 数据源,你可以通过将 SQL 查询下推到数据库或数据仓库来创建特征。如果特征的数据汇只是离线存储,这可以正常工作。例如,在 Hopsworks 中,外部特征组可以是外部湖仓中的表。然而,如果你需要将特征数据加载到在线存储或向量索引中,则需要 ETL 程序。
这里关于分区的建议适用于列式存储,但不适用于作为批处理数据源的运营数据库。对于行式数据存储,按时间间隔对数据进行分区不太常见。相反,可以在表的列上定义索引来加速读取查询。如果你想从行式表中回填,它应该有一个时间戳列(事件时间),并且你应该在该列上有索引;否则,增量运行和回填运行将读取表中的所有记录。这被称为全表扫描(full table scan),应不惜一切代价避免。它会在数据库中消耗大量资源,以至于危及数据库服务其他并发客户端的能力。
流式数据源
事件流(event stream)是连续的数据源,是实时 ML 系统的构建块。事件流平台(event-streaming platform)是事件数据的存储,在生产者(producer)和消费者(consumer)之间传输事件。例如,生产者可以是应用程序或服务,而消费者可以是流式或批处理特征管道(参见图 8-3)。
图示:说明信用卡交易事件通过 Apache Kafka 流向流式和批处理特征管道,这些管道更新诸如在线和离线存储之类的特征组。
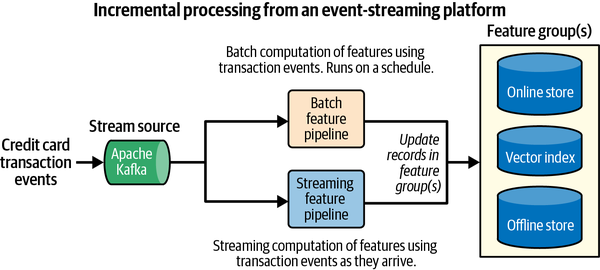
事件流作为无界(可能无限)的输入数据被持续处理,写入特征存储的输出特征在大小上也是无界的。用于存储和发布事件最流行的事件流平台是 Apache Kafka、RabbitMQ、Amazon Kinesis、Google Cloud Pub/Sub 和 Azure Event Hubs。
Apache Kafka 是一个流行的开源事件流平台,它将生产者创建的事件存储在称为主题(topic)的队列中。消费者可以监听主题以获取新事件,并在事件可用时处理它们。消费者还可以重新连接到主题,并读取自上次(消费者)连接以来到达的所有事件。例如,Spark Structured Streaming 应用程序可以持续运行,消费 Kafka 主题中的事件,计算特征并将其写入特征存储。类似地,PySpark 批处理应用程序可以按计划运行,消费主题上到达的最新事件,计算特征,将其写入特征存储,然后退出。如果你的 AI 系统需要来自事件流源的新鲜特征数据,你应该编写流式特征管道(参见第9章);如果它没有严格的特征新鲜度要求,那么批处理特征管道可能更容易运维且运行更高效。
对象存储与文件系统中的非结构化数据
文本数据、图像数据、视频数据和大量科学数据(如医学影像数据和地球观测数据)统称为非结构化数据。它之所以是非结构化的,是因为它缺乏模式——也就是说,它不是具有类型化列的表格数据。非结构化数据通常以文件形式存储在对象存储或文件系统中。
以文件形式处理非结构化数据的批处理特征管道按基于时间的计划运行,或者可以由新文件可用于处理的通知触发。对象存储和一些文件系统提供 CDC API 来提供此类通知。图 8-4 显示了对象存储中的文件按带时间戳的目录组织,以实现高效的回填和增量处理。例如,如果批处理程序以已处理文件的最新日期进行参数化,它可以将要处理的文件剪枝(prune)到那些包含在给定日期之后添加的文件的目录。
图示:说明通过批处理特征管道对非结构化数据进行增量和回填处理,展示从带日期戳的目录到对象存储和特征组的数据流,实现高效的数据变换和索引。
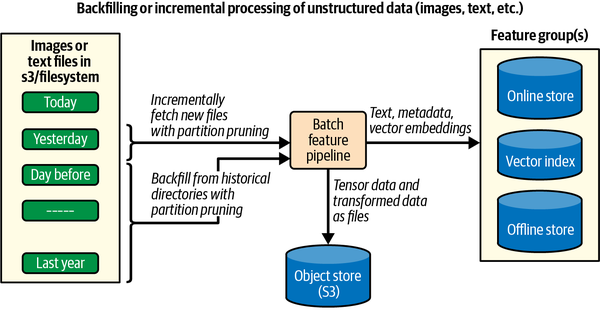
音频、视频和图像数据通常以压缩文件的形式存储在文件系统或对象存储中。批处理特征管道将这些文件变换为新文件以及特征组中的行。存储在对象存储中的新文件可以包含张量数据(例如用于训练和推理的 TFRecord 文件),或包含增强/变换/清洗后数据的新文件。可以从图像/视频/音频文件中提取元数据,并从中计算向量嵌入,这些表格数据可以存储在特征组中。因此,特征组可用于索引音频、视频和图像数据,从而支持使用向量索引进行相似性搜索以及使用元数据列进行过滤/查找。
文本数据在 AI 系统中被广泛用于自然语言处理(natural language processing,NLP)和 LLM,大规模流行的 AI 驱动服务的例子包括 Google Translate 和 OpenAI 的 ChatGPT。用于训练 LLM 的文本数据(现在也包括图像数据)是海量的——“Llama 3 在超过 15T 个 token 上进行了预训练,这些 token 全部来自公开可用的来源”,由数亿个或更多文本文件组成。这包括 HTML、PDF、MD 和其他文件格式。批处理特征管道可以将这些文本文件变换为存储在特征组列中的文本块。例如,你可以从 PDF 文件中提取文本段落,并且对于每个段落,在特征组中单独添加源文件名、页码、段落号和段落文本的向量嵌入等列。然后,你可以使用向量索引轻松进行全文搜索来查找段落。你可以将文件名、页码和段落号设为主键,从而支持文本的过滤和快速查找。
API 与 SaaS 数据源
随着 SaaS 和微服务架构的出现,越来越多的企业数据只能通过 API 访问,通常是 HTTP/REST API。流行的企业 SaaS API 包括 Salesforce 和 HubSpot,许多企业分别在其中存储销售和营销数据。一般来说,API 数据源不太适合特征管道,因为特征管道的流行技术(如 Spark 和 Python)通常必须发出阻塞式 REST 调用,这会拖慢特征管道。行业中更常见的架构模式是,由数据集成平台将先从 API 抓取的历史数据写入数据仓库或事件流平台。数据集成平台(data integration platform)是 ETL 或 ELT 工具,可以从数百个数据源回填和增量复制数据到集中式数据平台,如湖仓。流行的开源数据集成平台包括 dltHub 和 Airbyte。然而,在某些用例中,用于计算在线特征的源数据必须在运行时通过(HTTP)API 检索。对于这些情况,特征存储提供对 ODT 的支持,ODT 可以在请求时从 API 读取源数据并创建特征。
使用 LLM 生成合成信用卡数据
现在我们已经介绍了常见的数据源,我们将为信用卡欺诈预测系统构建数据集市。合成数据作为一种数据源正在被越来越多地采用,用于构建和试验 AI 系统,特别是在受监管的行业中,真实数据可能稀缺,或者对处理隐私敏感数据有限制。许多公司现在在受监管行业中提供可购买的合成数据。合成数据也越来越多地用于训练 LLM,因为 LLM 正撞上扩展之墙,已经用尽了全球可用的文本数据集作为训练数据。
数据集市与 LLM 的逻辑模型
目前,没有包含信用卡交易数据的高质量公开数据集可以用来构建我们的欺诈检测系统。出于数据隐私的原因,信用卡发卡机构不会公开信用卡交易详情。为了克服这一点,我们将使用 LLM 和我在这个领域处理问题获得的一些领域知识来生成合成数据。
首先,我们需要清楚地描述我们想要创建的合成数据。如果你的描述含糊不清,LLM 会填补任何空白,这是使用自然语言时容易落入的陷阱。我们将不使用自然语言,而是为信用卡数据集市定义一个逻辑模型(logical model),并要求 LLM 为该逻辑模型创建合成数据。逻辑模型是图 4-8 中实体关系(entity-relationship,ER)图的扩展。定义逻辑模型是数据库设计中概念设计之后的典型步骤,但要在创建实际表(物理模型(physical model))之前。逻辑模型补充了列的详细信息——它们的数据类型、基数和分布,以及它们是主键还是外键。我们还将为表添加详细信息,例如描述和应包含的行数。
在将我们的逻辑模型添加到 LLM 的提示词中之后,我们将要求它编写代码,为这些表创建合成数据,并将该数据存储在 Hopsworks 的特征组中。我们的逻辑模型是对表的全面描述,包括:
- 表的名称和描述,包括行数
- 表中每列的名称、数据类型和描述
- 如果列是索引列,则为以下类型之一:主键、外键(包括关系:一对一或一对多)、分区键或事件时间
- 如果列是类别变量,则列出所有类别(包括它们的相对百分比分布)
- 列的基数(该列中存在的唯一值的数量)
- 数值列中值分布的形状
- 日期和时间戳的格式(例如,信用卡到期日只包含年和月)
- 任何缺失值(包括 null 值所占的百分比)
我们需要为数据集市中的五张表以及包含标签的 cc_fraud 表定义逻辑模型。这里是六张表之一的逻辑模型示例。其他逻辑模型可以在本书的源代码仓库中找到。
商家详情(Merchant Details):
名称: merchant_details
描述: 执行交易的商家的详细信息。
大小: 5,000 行
列:
merchant_id:字符串(主键)- 描述:每个商家的唯一标识符
- 基数:5,000 个唯一商家
last_modified:datetime(主键)- 分布:当前日期之前 0 到 3 年的均匀分布
country:字符串- 描述:商家所在的国家
- 基数:世界上最大的 160 个国家,不包括朝鲜
cnt_chrgeback_prev_day:decimal(10,2)- 描述:该商家前一天(周一至周日)的拒付(chargeback)次数
我们现在为 LLM 精心设计一个提示词,要求它将这些表创建为 DataFrame,并使用 Polars 而不是 Pandas,因为 Polars 在生成数百万行数据时扩展性更好。
用于生成合成数据的 LLM 提示词
我在 GPT 4.1 上测试了以下提示词,它创建了一个 Python 程序,为我们的表生成合成数据:
在这些说明下面,你将找到 6 个不同的数据库表逻辑模型。编写一个 Polars 程序,将这些表的数据生成为 DataFrame。尽量使用 Polars 表达式以提高效率。如果做不到,也可以使用 Faker 库。将你创建的 DataFrame 写入你在 Hopsworks 中创建的新特征组。
<在此粘贴 6 张表的逻辑模型>
我们的 LLM 输出的 Python 程序按以下顺序创建 DataFrame:
- 雪花模式(snowflake schema)数据模型中的叶节点:
account_details、bank_details和merchant_details - 内部节点(从最低到最高):
card_details - 根节点:
credit_card_transactions,然后是它依赖的cc_fraud
合成数据不包含任何欺诈交易。我们需要在表中添加一些欺诈交易,以便我们的模型能够学习识别它们。为此,我们可以编写如下提示词:
编写一个循环,重复 1,000 次。从 card\_details 中随机选择一个信用卡号,并为该卡创建一笔欺诈交易,代表一次地理攻击——IP 地址的位置相距如此之远,而交易之间的时间如此之短,以至于持卡人不可能在交易之间的时间内实际往返于两个地点之间。该交易的 card\_present 字段应为 true,并且 cc\_fraud 应将其添加为一行。
再从 card\_details 中随机选择另一个信用卡号,并为该卡创建一笔欺诈交易,该卡在短时间内(15 分钟到 1 小时之间)被用于进行许多小额支付(5 到 50 笔之间)。在 cc\_fraud 中将该交易添加为欺诈交易。
现在我们拥有了一些历史信用卡交易的合成数据。我们想要模拟对数据集市的更新。账户、银行和商家详情表将作为批处理作业在夜间更新(它们是缓慢变化维度)。为我们的 LLM 编写一个每天运行的 Polars 程序的提示词概要如下:
编写一个 Polars 程序,将 credit\_card\_transactions 特征组前一天的内容作为 Polars DataFrame 读取。然后读取 bank\_details、card\_details、account\_details 和 merchant\_details 特征组的全部内容。
然后按如下方式修改 DataFrame,并将它们作为对 Hopsworks 特征组的更新保存回去:
保留 0.001% 的卡状态为 ‘Active’ 的卡行,并将该状态改为 ‘Blocked’ 或 ‘Lost/Stolen’(均匀随机选择)。对于交易表,按商家分组,对每个商家的交易金额求和,然后将该数字乘以 0.01% 到 0.1% 之间的均匀随机数。结果就是该商家的 cnt\_chrgeback\_prev\_day。用 cnt\_chrgeback\_prev\_day 的新值结果更新 merchants\_fg,并将 last\_modified 更新为当前时间。
你应该将生成的程序计划为每天运行一次;参见本书的源代码仓库。最后,你需要提示你的 LLM 生成一个持续运行的 Python 程序,将合成信用卡交易写入数据集市中的 Apache Kafka 主题。同样,详情参见本书的源代码仓库。
回填与增量更新
有了新的合成数据生成程序,我们现在可以运行它们来:
- 为我们的数据集市创建历史数据,包括欺诈交易。
- 每天更新缓慢变化的表。
- 持续向 Apache Kafka 添加新的信用卡交易。
我们将使用第6章和第7章中的变换,使用这些合成数据为我们的特征组创建特征数据。在第9章中,我们将研究更新 cc_trans_aggs_fg 特征组的流式特征管道。现在,我们专注于包含 MIT 的批处理特征管道。
Note
在数据工程中,术语全量加载(full load)经常被用来代替回填,而增量加载(incremental load)比增量处理更受青睐。全量加载会删除现有表,然后从数据源重新计算其数据。随着支持更新和删除(不仅仅是追加)的湖仓表的采用,全量加载已经变得不那么常见。我们更喜欢回填而不是全量加载,因为它是一个更宽泛的术语,既涵盖重新计算所有特征数据(全量加载),也涵盖重新计算缺失数据。
我们从回填特征组开始。当你从历史数据创建新特征数据时,就要进行回填。这可能是因为你的特征组中没有现有数据,你需要特征数据来训练模型,或者因为上游数据故障或维护窗口导致生产特征数据存在缺口。首次回填特征组后,你需要通过处理新到达或更改的数据来保持特征组是最新的。我们将使用增量处理,只处理自批处理特征管道最近一次运行以来发生变化的数据。
增量处理是处理任何新到达数据的有效机制,支持频繁且可控的更新。增量数据的批次应该以这样的频率处理:
- 确保下游训练和推理管道满足特征新鲜度要求(或其他 SLO)
- 确保你的批处理管道处理能力与新数据的到达速率相匹配——管道不会因一个时间间隔内数据过多而不堪重负(导致内存不足错误或无法及时处理数据),也不会在其他时间间隔内过度配置过多的 CPU 和内存资源。
增量数据的轮询与 CDC
当你对数据源运行任何特征管道时,你需要识别它应该处理的数据。识别数据源中哪些数据已更改的两种最常见方法是:
- 轮询(polling)
- 每个表中用户定义的列,包含该行的最后修改时间戳。这本质上就是特征组的事件时间。批处理程序检索时间戳高于其最近处理行的记录。
- 变更数据捕获(change data capture,CDC)
- 由系统管理的时间戳(和/或提交 ID),存储每行的摄取时间(ingestion time)。系统管理的时间戳/提交通常通过 CDC API 公开,客户端可以读取自特定提交 ID 或时间戳以来更改的所有数据。许多行式和列式数据库——例如分别是 Postgres 和 Snowflake——支持 CDC API。甚至湖仓,如 Apache Hudi,也提供 CDC API。
执行增量处理的批处理特征管道应该使用轮询或 CDC。一般来说,CDC 比轮询更可取,因为轮询可能会错过更改,而 CDC 能捕获所有更改。
轮询
轮询只用于批处理数据源。你定义要读取的数据(通过查询)以及多久对数据源运行一次(轮询间隔(polling interval))。查询应该为事件时间索引或分区键设置 start_time 和 end_time,以便只读取请求的数据并返回给客户端。当你有大表时,需要分区剪枝,因为客户端读取所有数据并过滤出新数据的替代方案会导致内存不足错误。对于轮询:
- 你需要一个默认的行获取大小,以防止内存不足错误。
- 轮询可能会错过对表的更新——例如,如果一行在一个轮询间隔内被添加和删除,轮询将永远不会看到它。
- 如果客户端只读取最近的分区(小时/天),轮询也可能会错过列式表中的延迟到达数据,因为延迟到达的数据可能存储在先前的分区中。
变更数据捕获
CDC 解决了轮询间隔内缺失(或幽灵(ghost))行和延迟到达数据的问题。CDC API 建立在变更日志之上,变更日志包含表中或数据库中每次插入、删除或更新事件的不可变事件。例如,如果你插入一行然后删除同一行,CDC 历史中会有两个单独的事件。延迟到达的数据也将是 CDC 历史中的事件。
大多数湖仓表(Apache Hudi、Delta Lake 和 Apache Iceberg)、云数据仓库(Snowflake、BigQuery、Redshift)和行式数据库(Postgres、MySQL)都提供 CDC API。例如,在 Hopsworks 特征组中,你可以使用以下命令读取特征组在 start_timestamp 和 end_timestamp 之间的更改:
df = fg.asof(end_timestamp, exclude_until=start_timestamp).read()
在同一个程序中实现回填与增量处理
一个被参数化以针对历史数据或增量数据运行的批处理特征管道,需要抽象出数据源,以便可以从数据源读取的查询被赋予要处理的数据范围的 start_time 和 end_time。除了这个区别之外,同一个批处理程序应该能够处理历史数据或增量数据,前提是它被提供了足够的资源(内存和计算)。
在 Hopsworks 中,我们可以通过将数据库、湖仓和数据仓库中的表挂载为外部特征组来简化这个问题。外部特征组有一个连接到外部数据源的连接器,为其可以通过查询读取的数据提供模式,并且有一个 event_time 列,我们用轮询来读取某个时间范围的数据。当你从外部特征组读取数据时,你指定 start_time 和可选的 end_time。如果你省略 end_time,它将读取 event_time 值大于 start_time 的所有可用记录。如果你同时省略 start_time 和 end_time,它将读取所有可用数据。对于可以在单台机器上处理的数据量,特征管道可以用 Pandas 或 Polars 编写。对于更大的数据量,你应该使用 PySpark。运行程序时,开始和结束时间可以作为命令行参数或环境变量(此处所示)提供:
start_time = os.environ.get('START_TIME')
end_time = os.environ.get('END_TIME')
df = credit_card_transactions_fg.read(start_time=start_time, end_time=end_time)
不过,在编写能够处理可变数据量的批处理特征管道时,有一种数据变换你必须考虑到——时间窗口聚合。在创建时间窗口聚合时,重要的是要注意,你为处理而读取的批数据需要足够大以计算窗口,并且你需要"滑动"遍历批数据,为批中的每一天计算新窗口。例如,如果你在批中读取了 30 天的数据,对于长度为 3 天的时间窗口,你只能计算 28 天的时间窗口聚合。批中最旧的 2 天没有前 3 天的交易,因此你无法为它们计算窗口聚合。所以相应地调整你的开始和结束时间。
我们现在继续讨论管理批处理程序调度和执行的编排器。作业调度器支持基于 cron 的批处理程序调度,但有时你需要功能更强大的工作流调度器来调度和管理程序(任务)DAG 的执行。
作业编排器
在第3章中,我们使用 GitHub Actions 按每日计划运行特征管道和批处理推理管道。我们使用 GitHub Actions 的原因是它通过免费层级支持基于 cron 的 Python 程序调度。然而,它不是编排器——它是一个无服务器 DevOps 平台。编排器(orchestrator)是一种服务,用于调度和协调程序的执行,并提供日志记录和容错能力。编排的目标是简化和优化频繁、可重复流程的执行,从而帮助数据团队更轻松地管理复杂的任务和工作流。
作业编排器(job orchestrator)调度 Pandas/Polars/PySpark 程序的执行。有许多开源、无服务器和嵌入式作业编排器可供你选择,用于管理批处理特征管道(和批处理推理管道)的执行。作业调度器提供的不仅仅是运行程序的能力。它们提供:
- 一种将程序与其所有依赖项打包的方法,例如打包为容器
- 对一个或多个执行运行时的支持,例如 Kubernetes 或 AWS Fargate
- 对来自不同语言和框架(如 Pandas、Polars 和 PySpark)的程序的执行和监控支持
- 执行运行的日志
一些作业调度器还提供作业的资源监控、失败作业的告警以及失败作业的重试。你必须为作业(或每次执行)定义的内容包括:
- 要执行的程序及其依赖项(或容器)
- 程序参数和环境变量,例如用于增量处理的
start_time和end_time - 请求的资源(CPU 数量、GPU 数量和内存量)
如果作业是 Python 程序,你需要 Python 程序及其依赖项(requirements.txt 文件)或将程序打包为容器。如果你的作业是 PySpark 作业,你还需要定义需要随程序分发的任何文件,例如 JAR 文件、Python 模块和驱动程序。我们现在将研究两个不同的作业调度器:Modal 和 Hopsworks。
Modal
Modal 是一个对开发者友好的无服务器平台,用于部署、调度和管理 Python 作业。Modal 支持自动容器化(automatic containerization)。也就是说,无需编写和编译你自己的容器镜像。相反,你向 Python 函数添加装饰器来指示:
- 你想使用哪种 Linux 操作系统系列(例如 Debian)
- 镜像将使用多少资源(CPU、GPU、内存)
- 你的函数使用哪些
pip版本化的 Python 库 - 你想并行执行该函数的多少个实例
- 从哪里读取共享密钥
- 运行 Python 程序的 cron 计划
当你第一次运行程序时,Modal 会为其编译容器并缓存它们。如果你不做会使容器镜像失效的更改,后续的程序运行将具有非常快的启动时间。当你从命令行运行 Modal 程序时,其容器的 stdout 和 stderr 会流式传输回你的控制台。下面是一个由 Modal 编排的批处理特征管道示例,它每天下载天气数据并将其作为 Pandas DataFrame 写入 Hopsworks:
import modal

image = modal.Image.debian_slim(python_version="3.12").pip_install("hopsworks")

secret = modal.Secret.from_name(
    "hopsworks-secret",
    required_keys=["HOPSWORKS_API_KEY"],
)
app = modal.App("hopsworks-feature-group")

@app.function(
    schedule=modal.Period(days=1),
    image=image,
    cpu=4.0,
    memory=8192,
    secrets=[secret]
)
def daily_hopsworks_job():
    import hopsworks
    import pandas as pd
    fs = hopsworks.login().get_feature_store()
    weather_forecast_df = # call remote API
    fg = fs.get_feature_group(name="weather", version=1)
    fg.insert(weather_forecast_df)

if __name__ == "__main__":
    app.deploy()
Modal 程序是固执己见的(opinionated)、启动快且易于调试,日志输出到 stdout 和 stderr。所有依赖项都定义在你的 Python 程序中,通过自动容器化(参见第13章),Modal 代表你管理程序的打包及其作为容器的执行。Modal 按每秒使用的计算/内存/GPU 收费。
Hopsworks 作业
Hopsworks 作业在与安装 Hopsworks 相同的 Kubernetes 集群上运行,可以是 Python(Pandas、Polars 等)或 PySpark 批处理程序。Hopsworks 作业在本书使用的 Hopsworks Serverless 上不可用,但在商业产品中可用。作业作为容器在与你的作业所属的 Hopsworks 项目所使用的相同 Kubernetes 命名空间中执行。与 Modal 一样,Hopsworks 支持自动容器化,无需编译(Docker)容器,因为当你从项目中的众多 Python 环境之一安装/移除 Python 依赖项时,Hopsworks 会在后台构建它们。你可以使用 Hopsworks UI 或 API 自定义特征、训练或推理基础容器镜像之一,并且它可以被许多不同的作业复用。创建作业时,你需要指定:
- 程序、其参数以及它将使用的容器镜像
- 对于 PySpark 作业,任何额外的文件依赖项或配置参数
- 程序的资源(CPU、GPU、内存):
- 对于 Pandas/Polars 作业,这是 CPU 数量和内存量。
- 对于 PySpark 作业,你指定 CPU 和内存(对于 driver 和 executor)以及 executor 的数量(静态数量或随运行时工作负载增加而扩展的动态数量)。
- 运行程序的可选 cron 计划
下面是一个在 Hopsworks 中创建和调度 PySpark 作业的示例:
job_api = hopsworks.login().get_job_api()

spark_config = job_api.get_configuration('PYSPARK')
spark_config['appPath'] = '/projects/ccfraud/Resources/f_pipeline.py'
spark_config['spark.driver.memory'] = 2048
spark_config['spark.driver.cores'] = 1
spark_config['spark.executor.memory'] = 8192
spark_config['spark.executor.cores'] = 1
spark_config['spark.dynamicAllocation.maxExecutors']= 2
spark_config['spark.dynamicAllocation.enabled'] = True

job = job_api.create_job('my_spark_job', spark_config)

job.schedule(
    cron_expression="0 */5 * ? * * *",
    start_time=datetime.datetime.now(tz=timezone.utc)
)
job.save()

execution = job.run()
print(execution.success)
out_log_path, err_log_path = execution.download_logs()
Note
许多工作流编排器(如 Airflow)会捕获并可视化它们计算的 DAG 的血缘(lineage)信息。作业编排器通常将 DAG 可视化委托给数据处理框架。例如,PySpark 支持 DAG 可视化,但 Polars、Pandas 和 DuckDB 不支持。为了克服这一点,Hopsworks 允许你在创建特征组时显式定义血缘信息,方法是在构造函数的 parents 参数中指示哪些特征组位于当前特征组的上游。该血缘信息在 Hopsworks UI 中可视化,并可通过 Hopsworks API 访问。
工作流编排器
与执行单个程序的作业编排器相比,工作流编排器(workflow orchestrator)编排许多程序(或任务)的执行,这些程序组织在一个 DAG 中。多步骤工作流将批处理特征管道分解为任务,任务之间存在依赖关系,从而易于调度、执行和监控任务依赖前一步骤成败的管道。工作流编排器有助于将较大的程序分解为较小的任务,并在任务失败时提供可观测性和重试支持。任务也可以使用不同的框架(Spark、Polars、dbt 等)来实现。然而,通常一个单一的程序作为批处理特征管道就足够了,使用工作流编排器通常是杀鸡用牛刀。例如,Polars 和 PySpark 程序也实现为变换的 DAG,执行单个程序通常比执行许多不同任务的 DAG 更快且资源效率更高。
话虽如此,有许多编排器是为执行 ML 管道而设计的。然而,鉴于许多厂商对什么是 ML 管道感到困惑,这些框架中有许多将特征管道视为数据管道,认为它们不在 ML 管道的范围内。ML 管道编排器包括:
- Kubeflow
- 这是一个用于 ML 管道的 Kubernetes 原生编排器,最初由 Google 开发,现在由社区维护。Kubeflow 是为训练管道设计的;它无法扩展到特征管道或批处理推理管道。
- Metaflow
- 这最初由 Netflix 开发,它将工作流定义为 Python 中的 DAG,并支持类似于 Modal 的自动容器化,但它可以运行在 Kubernetes 上。它缺乏对可扩展特征管道的原生支持。
- Flyte
- 这最初在 Lyft 开发,它支持在 Kubernetes 中运行容器作为训练和批处理推理管道。它缺乏对可扩展特征管道的支持。
- ZenML
- 这是一个类似于 Metaflow 的开源 ML 管道编排器,它运行在 Kubernetes 上,并与云平台有良好的集成。它缺乏对可扩展特征管道的支持。
- Vertex AI Pipelines、Azure ML 和 SageMaker Pipelines
- 这些都是专门用于训练管道的,而不是特征/批处理推理管道。它们使用带有流行 ML 框架预构建二进制的容器,但你也可以手动创建自己的容器镜像。
数据工程中流行的、可以用来运行 ML 管道的工作流编排器包括:
- 云原生的基于 Python 的工作流编排器,如 Dagster 和 Prefect
- Databricks Workflows、Snowflake tasks 和 Google Dataform,它们都是用于运行更可扩展的 Spark 或 SQL 作业的编排器
我们现在将研究最流行的 Python 工作流编排器 Airflow(一个通用工作流编排器),以及 Azure、AWS 和 GCP 的云厂商工作流编排器。
Airflow
Apache Airflow 是一个流行的开源编排器,允许你定义、调度和监控工作流。Airflow 的工作流以 Python 编写为任务的 DAG,其中每个任务本身可以是一个由操作器(operator)执行的程序。Airflow 支持丰富多样的操作器,包括用于运行 PySpark 程序的 Spark 操作器和用于在 Kubernetes 上运行(Python)程序的 Kubernetes 操作器。还有一个用于运行 Hopsworks 作业的 Hopsworks 作业操作器。Airflow 是一个通用工作流调度器,具有丰富的调度选项和用于检查运行和日志以及调度新运行的用户界面。DAG 和任务可以使用 cron 表达式调度,也可以基于传感器(sensor)确定任务何时可以调度的事件来调度。例如,FileSensor(或 S3KeySensor)可用于仅在特定目录中创建特定文件后运行任务。其他流行的传感器是 HttpSensor(轮询 HTTP 端点直到收到特定响应)和 ExternalTaskSensor(检查另一个 DAG 中任务的完成情况)。你可以在定义 DAG 的 Python 程序中直接定义任务之间的依赖关系。
云厂商工作流编排器
Azure Data Factory(ADF)是一个通用工作流编排器,你可以使用它在 Azure 上运行 Spark、Pandas 和 Polars 程序。ADF 将工作流组织为管道(pipeline),管道定义了数据集成或变换所需的一系列步骤或活动。每个管道可以包含一系列活动,如数据移动、数据变换和触发外部系统。ADF 在单个管道内按特定顺序编排这些活动,处理依赖关系和条件分支。
AWS Step Functions 是 AWS 的通用无服务器工作流编排器,用于协调多个 AWS 服务,并使用 PySpark、Polars、Pandas 和 DuckDB 等框架构建工作流。
Google Cloud Composer 是 GCP 上基于 Airflow 构建的完全托管编排服务。它允许用户连接和编排各种 Google Cloud 服务和 API,包括 BigQuery 命令、Dataproc 上的 Spark 作业以及 GCP Vertex 上的 ML 管道。
Note
许多工作流编排器自带 DAG 中任务的内置血缘信息。然而,该血缘信息通常不连接到 ML 系统中的工件(artifact),如特征组、模型和部署。ML 资产的血缘信息存储在 MLOps 平台中,如 Hopsworks、Vertex、Databricks 和 SageMaker。
数据契约
特征组的数据契约与软件工程中的接口契约目标相似。它们应该确保客户端读写符合接口(或模式)的数据。也就是说,DataFrame 中列的名称和类型应该与正在写入或读取的相应特征组中列的名称和类型匹配。例如,Hopsworks 在向特征组写入数据时执行模式验证——检查数据值是否与特征组模式中定义的数据类型相对应,以及字符串和行是否不超过其最大长度。模式检查还验证完整性约束,例如确保没有缺失的主键值或缺失的 event_time 值(如果特征组存储时序数据)。
除了模式验证之外,数据契约还应该为数据质量及其及时交付给数据消费者提供保证。AI 系统的许多数据源不提供此类保证,因此 AI 系统有责任通过回答以下问题来提供数据质量和及时性保证:
- 特征组的服务水平目标(service-level objective,SLO)是什么?
- 任何给定特征的值域(有效范围)是什么?
- 特征数据的预期和最坏情况新鲜度是什么?
- 数据可以迟到多久才应该被丢弃?
- 对于给定的特征,可以容忍多大百分比的缺失值?
在 Hopsworks 中,你可以使用标签(tag)描述特征组的 SLO。然后你需要实现机制来强制执行标签中定义的 SLO。第13章和第14章介绍了 MLOps 的技术,可以帮助你实现自定义数据契约。
你还可以使用标签设计治理策略,例如特征组是否允许包含个人身份信息(personally identifiable information,PII)。下面,我们展示如何使用标签将元数据附加到特征组:
fg = fs.get_feature_group("cc_trans_fg", version=1)
fg.add_tag(name="PII", value="false")
你可以在代码中强制执行治理策略,方法是检查资产(如特征组、特征视图、模型或部署)是否设置了正确的标签和/或标签值。例如,这里我们在特征存储中搜索所有具有 " PII " 标签的特征组、特征视图或特征:
search_api = project.get_search_api()
tag_search_result = search_api.featurestore_search("PII")
tag_search_result.to_dict()
然后我们可以检查返回的 ML 资产是否符合治理策略,如果存在违规,则发送告警。
在 Hopsworks 中使用 Great Expectations 进行数据验证
数据质量保证是数据契约的一部分,需要数据验证。在数据工程中,在数据写入数据仓库之后异步验证数据通常是可以的。这是因为许多仪表板按计划更新,只要数据在仪表板更新之前经过验证,你就不存在显示垃圾数据的风险。
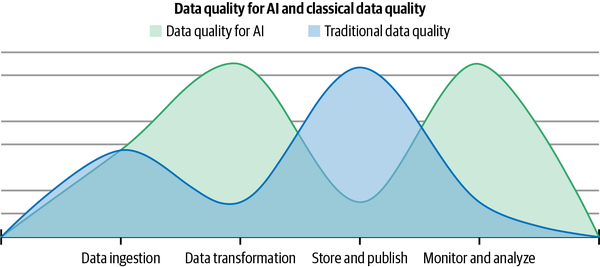
图 8-5 展示了与商业智能的数据工程相比,ML 如何将数据验证工作转移到数据生命周期中更早的阶段。数据在写入特征组之前就经过验证,因为一个坏数据点就可能导致训练或推理运行失败。
图示:比较 AI 系统和传统系统的数据质量流程,突出 AI 从摄取到监控阶段的更早验证。
WAP 模式
在数据工程中,与 ML 相比,数据验证在数据生命周期中被右移。例如,写入-审计-发布(write-audit-publish,WAP)模式首先将所有源数据原封不动地摄取到落地区(landing area),通常采用不可变格式。在审计阶段,一个或多个数据管道应用数据验证规则、检测异常并识别重复项。在发布阶段,管道将验证后的数据变换为下游应用程序可消费的层。奖章架构(medallion architecture)是这种模式的一个变体,包含青铜(bronze)、白银(silver)和黄金(gold)表。
如第3章所述,在 Hopsworks 中,我们可以将数据验证规则实现为 Great Expectations 中的期望套件(expectation suite)。数据契约的另一个重要部分是治理策略,应该在插入数据之前强制执行。治理既需要定义策略的方式,也需要执行策略的机制。Hopsworks 提供标签和模式化标签(schematized tag)(参见第13章)来定义策略并将其附加到特征组。
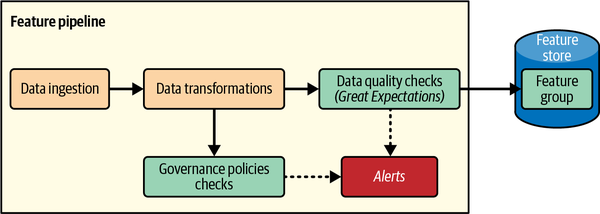
图 8-6 展示了一个特征管道,它执行数据变换,然后在将数据摄取到特征组之前应用数据验证检查和治理策略强制检查。
图示:展示一个特征管道,该管道执行数据摄取、变换、使用 Great Expectations 进行质量检查以及治理策略检查,最终进入特征存储;发现问题时会触发告警。
你在 Great Expectations 中定义的期望套件中为特征定义数据验证规则。我们在第3章中看到,你可以在创建特征组时将期望套件附加到特征组。你还可以将期望套件添加到现有特征组,并按如下方式从特征组中移除期望套件:
expectation_suite = ge.core.ExpectationSuite( .. )
fg.save_expectation_suite(
    expectation_suite, run_validation=True, validation_ingestion_policy="ALWAYS"
)

# remove the expectation suite from the feature group
fg.delete_expectation_suite()
注意,这里我们将 validation_ingestion_policy 设置为 ALWAYS,在这种情况下,即使数据验证规则失败,数据也会写入特征组。默认策略是 STRICT,在这种情况下,如果任何数据验证规则失败,特征管道将失败——不会有数据写入特征组。
在特征管道中,我们可以将治理策略定义为标签,并实现我们自己的强制检查。例如,我们可以定义一个 NO_PII 标签并将其附加到特征组。策略是该特征组不应包含 PII 数据。我们可以实现一个 check_for_pii_data() 函数来强制执行此策略。首先,我们通过检查特征组是否具有 NO_PII 标签来检查该策略是否适用于该特征组。如果适用,我们将数据传递给 check_for_pii_data(),如果数据包含 PII 数据,我们发出告警:
if fg.contains_tag("NO_PII"):
    if check_for_pii_data(df):
        fg.create_alert(receiver="email", severity="warning",\
            status=f"PII data")
check_for_pii_data() 函数可以使用诸如 DataProfiler 之类的库来实现。在不久的将来,LLM 可能会被用来辅助 PII 检查。
小结与练习
批处理特征管道是按计划运行的程序,对从批处理/流式/API 数据源读取的数据应用 MIT,以创建可复用的特征数据,这些数据在写入特征组之前应该经过验证。在本章中,我们首先研究了批处理特征管道的不同类型数据源,然后继续使用 LLM 为信用卡欺诈数据集市生成合成数据。我们展示了如何为信用卡欺诈问题设计一个以 start_time 和 end_time 为参数的批处理特征管道,使其能够回填历史特征数据或对新到达的数据执行增量处理。我们还研究了如何使用作业编排器或工作流编排器运行批处理特征管道。最后,我们介绍了数据契约,并研究了如何通过数据验证和数据治理策略强制执行,确保特征管道为特征组数据提供 SLO。
以下练习将帮助你学习如何将 MIT 组合成批处理特征管道:
- 编写 PySpark 代码,通过计算 sum、count 和每日平方和聚合,使用单日聚合计算多日聚合的标准差。注意:多天期间的方差(标准差是方差的平方根)可以使用以下公式计算:方差 = \(\frac{\sum x^2}{n} - \left(\frac{\sum x}{n}\right)^2\)
- 编写一个 Polars 程序,使用 HyperLogLog 通过单日去重计数聚合计算信用卡交易的近似多日去重计数。使用 datasketch 库。