与模型相关的变换和按需变换
在本章中,我们将研究训练与推理管道中的数据变换,以及如何确保两条管道中的变换是等价的。我们在第2章中介绍过,与模型相关的变换(model-dependent transformation,MDT)是在数据从特征存储读出之后执行的、为某个特定模型创建特征的数据变换。MDT 有两大类——特征变换(针对数值特征和类别特征),以及仅与一个模型紧密耦合的变换。前者的例子是对类别变量进行独热编码,后者的例子是面向 LLM 的文本编码。
我们还将研究如何防止在训练和推理管道中分别应用的 MDT 之间出现偏差(skew)。这并不总是像在训练和推理管道中应用同一个带版本函数那样简单,因为许多 MDT 是有状态的,需要把相同的状态(模型的训练数据统计量)作为参数同时传入训练和推理管道。我们首先介绍特征变换的常见示例以及不同类别的模型特定变换。然后,我们研究防止偏差的不同机制,包括 Scikit-Learn 管道、PyTorch 变换,以及 Hopsworks 特征视图中的变换函数。我们还将介绍最后一类数据变换——按需变换(on-demand transformation,ODT),它存在于在线推理管道和特征管道中,通常是无状态的变换函数。最后,我们用 pytest 对变换函数进行单元测试来结束本章。
特征变换
特征变换可以提升各类 ML 模型的性能和收敛性。例如,大多数 ML 算法不能接受字符串作为输入,需要将其变换为数值格式。ML 模型的最终输入通常是一个数值数组。类似地,深度学习模型通常要求数值特征被归一化或变换为服从正态分布,以确保正确收敛。
不同的特征变换针对特定的特征类型(类别型或数值型)执行。特征类型有助于确定哪种特征变换是合适的。例如,编码(encoding)用于将类别变量转换为数值格式,而缩放(scaling)用于调整数值变量的范围或分布。这些变换通常以训练数据的属性为参数,例如类别集合或描述性统计量(最小值、最大值、均值、标准差或众数)。例如,当你对类别变量进行独热编码时,必须首先枚举训练数据中的所有类别,然后才能将该字符串编码为二元向量。类似地,当对数值变量应用标准化(standardization,也称为 z 分数归一化)时,必须先从训练数据中计算出均值和标准差,然后用它们一致地缩放数据集中的所有特征值。
编码类别变量
在特征编码算法中,类别集合可能随时间变化,为了处理这一点,你应该包含一个特殊类别(称为 “unknown” 或 “other”),用于推理期间出现的任何新类别。例如,信用卡支付给出的商户类别代码(merchant category code)对许多奖励计划很重要,这些计划为特定类型的消费(如旅行)提供积分。每个商户通常有一个添加到信用卡支付中的单一类别。在表 7-1中,我们对类别进行了独热编码。为简单起见,我只展示四个类别,而实际上有数百个。每个独热编码数组表示一个类别,在数组的该类别位置为 1,在其他所有位置为 0。
| 商户类别 | 独热编码 |
|---|---|
| 航空公司 | [1,0,0,0] |
| 餐饮场所和餐厅 | [0,1,0,0] |
| 汽车租赁 | [0,0,1,0] |
| 酒店、汽车旅馆和度假村 | [0,0,0,1] |
当存在高基数(high cardinality,即类别数量很大)时,不建议使用独热编码,因为每个类别都会增加一个新维度,从而增加内存使用量。当类别之间存在序数关系时,它也不适用,因为它不保留顺序,如表 7-2所示。
如果变量之间存在序数关系,那么序数编码器(ordinal encoder)会在变换后的类别中保留顺序。
| 算法 | 用途 | 使用场景 |
|---|---|---|
| 独热编码器 | 将类别数据变换为独热编码向量(一个字节数组,每个类别代表一位) | 在不存在序数关系且基数较低到中等时,变换为独热编码 |
| 序数编码器 | 将类别数据变换为一个整数 | 对具有序数关系的特征进行编码 |
| 特征哈希器 | 使用哈希技巧将类别数据变换为固定大小的向量 | 具有许多唯一类别的高维数据 |
| 标签编码器 | 用 0 到 n_classes-1 之间的值对目标标签进行编码 | 对目标/标签变量进行编码 |
对于具有大量类别的特征,特征哈希(特征哈希器编码算法)通过将类别映射到固定大小的哈希表来降低维度,尽管这引入了哈希冲突(hash collision,即不同类别映射到相同值)的风险。如果你使用特征哈希器,请确保你的 ML 算法能够容忍可能的哈希冲突。最后,标签编码(label encoding)通常用于将目标/标签变量编码为整数,从而保留顺序。许多 ML 算法(如 Scikit-Learn 的逻辑回归和 XGBoost 的多类分类)要求标签(目标变量)为整数编码。
请注意,对于某些基于树的算法,如 CatBoost,你不需要对类别变量进行编码。CatBoost 可以处理高基数的类别变量,并保留序数信息——无需花费 CPU 周期来编码类别数据。CatBoost 还可以训练包含大量类别变量的模型,性能优于 XGBoost,例如通过自动提取类别特征之间的复杂交互并减少过拟合。
数值变量的分布
许多 ML 算法只有在数值特征遵循特定数据分布时才能良好工作。例如,如果你的数值特征数据的分布是偏斜的,并且你的 ML 算法基于梯度下降(如神经网络或线性回归),你应该对数据进行标准化。标准化将数值变量的分布变换为均值为零、方差(标准差)为一。这将提高梯度下降的收敛速度和随后的模型稳定性。
图 7-1展示了一些最常见的数值变量分布。良好的做法是识别每个数值变量的分布,这样当你对特征使用 ML 算法时,你就知道要对特征数据应用哪种变换算法(如果有的话)。
图示:八种常见数值特征分布的示意图,包括正态、均匀、二项、泊松、指数、偏斜、双峰和对数正态分布,突出它们各自不同的形状和特征。
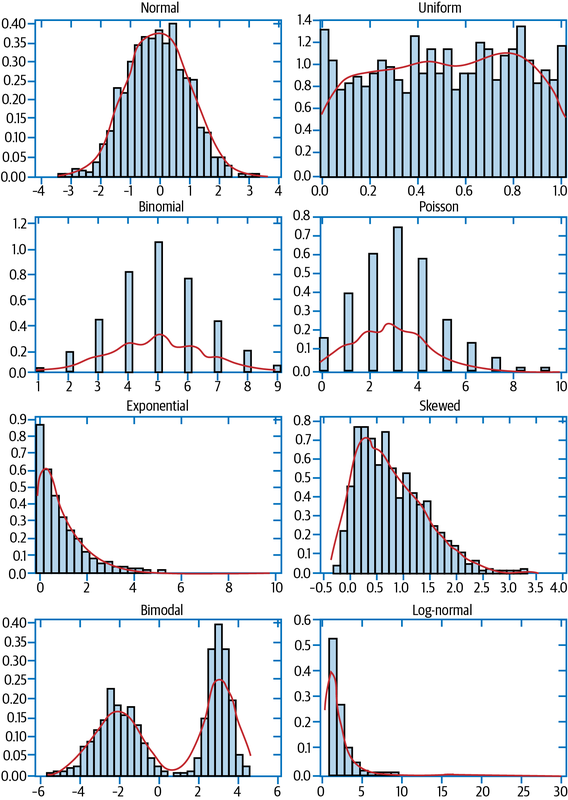
回到我们的信用卡欺诈系统,我们给出这些分布在信用卡交易中的示例:
- 银行的
credit_rating通常遵循正态分布(normal distribution),少数银行拥有最高和最低的评级,大多数银行聚集在平均评级附近。 - 均匀分布(uniform distribution)意味着每个可能的值出现的概率相等。我们信用卡模型中的任何特征都不是真正均匀的。通常,变量可能从均匀分布开始,但通过分组或变换,你可以提取出具有更多信息量的非均匀分布的新特征。
- 二项分布(binomial distribution)对多个独立试验中的离散结果(成功/失败)建模。虽然不是我们信用卡模型中的特征,但商户终端是否正常工作的概率可以表示为二项分布,其可靠概率比如说 0.98;也就是说,98% 的交易会被成功处理而无错误。
- 泊松分布(Poisson distribution)对固定时间间隔内独立事件发生的次数建模。例如,我们可以将每天平均发生多少次信用卡欺诈检测建模为泊松分布。当信用卡欺诈检测的数量被认为异常时,模型可以决定何时生成警报。
- 指数分布(exponential distribution)可以对独立交易之间的时间建模,此时事件以恒定的平均速率连续且独立地发生。例如,卡交易之间的平均等待时间是三个小时,这意味着短间隔(分钟)很常见,而更长的等待(天)则较少发生。
- 信用卡交易的金额遵循偏斜分布(skewed distribution),大量小额和少量大额。
- 双峰分布(bimodal distribution)可以帮助我们用两个不同的子群来建模每个客户在假期花费的金额——每个子群都遵循正态分布。普通购物者平均花费 200 美元(第一个峰值),假日购物者平均花费 800 美元(第二个峰值)。
- 最后,单笔信用卡交易的金额通常遵循一种称为对数正态分布(log-normal distribution)的偏斜分布。其特征是金额非负且向右正偏斜(大多数支付是小的,较大的支付较少)。
变换数值变量
标准化数值特征分布是一种常见的变换,应该对许多 ML 算法执行——不仅是前面提到的梯度下降,还包括 kNN 和支持向量机(support vector machine,SVM)。标准化的替代方案是归一化(normalization,也称为 min-max 缩放),它同样提高模型收敛速度,但只缩放值的范围。归一化将值重新缩放到固定范围(例如 0 到 1),同时保留其原始分布形状。相比之下,标准化还会变换分布形状。
例如,信用卡交易金额的范围可以从 0.01 美元到 10,000 美元,账户余额的范围可以从 0 美元到数百万美元。如果你不标准化或归一化金额和余额,梯度下降在训练期间可能会产生巨大且不稳定的更新。聚类算法(如 kNN 和 SVM)依赖距离值,也从标准化或归一化中受益,概率模型(如高斯朴素贝叶斯)也是如此。在这类模型中,如果不进行标准化或归一化,具有大值范围的金额或账户余额可能会主导模型中的其他特征。
那么什么时候应该选择归一化而不是标准化?这里有两个经验法则:
- 归一化通常适合神经网络,以及当原始特征分布很重要时。例如,如果数据中的离群值是有意义的而不是异常,归一化可能是首选,因为它保留了分布的原始形状。
- 线性模型、基于距离的算法,以及当你假设特征应该服从正态分布时,通常首选标准化。
最终,最佳选择取决于你的数据和模型,因此你可能需要同时尝试这两种方法。
另一类重要的变换是对数变换(log transformation)。高度偏斜的数值变量(如交易金额)会对模型性能产生负面影响,尤其是当离群值主导数据时。对数变换有助于减少偏斜并压缩值的范围,使分布更接近正态,并减少极端值的影响。对数变换对右偏数据特别有效。但是,你的数据不应包含零或负值,因为对数在这些情况下是未定义的。如果你的数据确实包含零,你可以使用修改后的变换,如 \(\log(1 + x)\)。
不过,并非所有 ML 算法都需要变换数值特征。对于基于树的模型(如梯度提升决策树和随机森林),无需变换数值特征,因为它们在分裂节点时不受特征尺度的影响。然而,某些变换(如减少极端偏斜或简化特征交互)可以提高树模型的性能。例如,对高度偏斜的变量进行对数变换有助于平衡分裂,并让模型更好地捕捉整个数据范围内的模式。
在计算变换时,你必须首先对某些特征值进行完整的遍历,以计算描述性统计量(如均值、标准差、最小值和最大值)。然后,第二次遍历可以通过应用变换来更新每个数据点。以下是常见变换的计算示例:
- 归一化涉及调整特征值的范围,使其适合特定范围,通常介于零和一之间。最常见的归一化方法是 min-max 缩放,其中对于每个数据点,减去最小值并除以最大值减去最小值:\(x_{\text{normalized}} = \frac{x - x_{\min}}{x_{\max} - x_{\min}}\)
- 标准化涉及对每个数据点减去均值并除以标准差。它将数据以零为中心,并根据标准差进行缩放:\(x_{\text{standardized}} = \frac{(x - \mu)}{\sigma}\),其中 \(\sigma\) 是标准差,\(\mu\) 是均值
- 对数变换对每个数据点应用对数函数,通常以 10 为底或以 e 为底(记为 ln):\(x_{\log} = \ln(x)\)
- 倒数变换(reciprocal transformation)取每个值的倒数(即逆)。数字 x 的倒数是 1/x。它有助于减少数据集的偏斜并稳定其方差:\(x_{\text{reciprocal}} = 1/x\)
- 数值变量 x 的指数变换(exponential transformation)涉及应用指数函数。当处理指数增长或衰减模式时,它可以线性化变量之间的关系,或者可以给数据集中较大的值更大的权重:\(x_{\exp} = a \cdot e^{b \cdot x}\),其中 a 是缩放因子,b 控制增长率
- Box-Cox 变换(Box-Cox transformation)稳定数值变量的方差,使其更接近正态分布。可以使用最大似然估计来估计超参数 \(\lambda\) 的良好值,使其最小化变换后数据的偏斜,尽可能接近正态。当 \(\lambda = 0\) 时,Box-Cox 变换变为自然对数:\(x_{\text{box-cox}}(\lambda) = \frac{x^{\lambda} - 1}{\lambda}\)
在特征组中存储变换后的特征数据
通常,你不应该在特征组中存储变换后的特征数据,因为这会妨碍模型对特征的复用,并在向特征组写入新数据时引入写放大(write amplification)。然而,在需要实时 ML 系统尽可能低延迟的情况下,尽可能多地预计算有助于从预测请求延迟中节省微秒或毫秒。对于某些公司来说,毫秒可能价值数百万。如果你绝对必须在特征存储之前应用特征变换,你可以为你的模型创建一个单独的仅在线特征组,包括其专用的特征管道。该特征管道应使用你的模型的训练数据集统计量来应用特征变换。这个"变换后"的特征组应该仅在线,这样它只存储最新的特征值,你就不需要为每次写入重新计算现有的特征数据。如果某些特征在其他模型中被复用,你应该更新你的特征管道,首先计算未变换的特征并将它们写入共享的未变换特征组。然后,在应用特征变换之后,将变换后的特征写入变换后的在线特征组。这适用于批处理和流式特征管道。
模型特定变换
模型特定变换(model-specific transformation)是一个总括术语,指任何不是特征变换但与某个模型特定相关的数据变换。我们将看几个这样的变换示例。例如,一种流行的填补缺失推理数据的方法,是先计算训练数据中特征的均值/中位数/众数,然后用计算出的值之一替换缺失值。另一个不需要训练数据统计量的例子,是确定如何变换特征的时间戳,使其与目标/标签的时间戳对齐。这种变换使你能够用更高效的 INNER JOIN 而不是 ASOF LEFT JOIN 来创建训练数据。
离群值处理方法
离群值检测(outlier detection)识别并处理可能使模型训练产生偏差并导致预测不佳的异常数据点。在可能的情况下,最好不要将异常数据点摄取到特征组中,例如在特征管道中使用 Great Expectations 来识别和移除它们。然而,有时特征组可能包含异常数据,这时你就必须将离群值检测作为 MDT 执行。
Scikit-Learn 对单变量(单特征)和多变量(多特征)方法都有很好的支持。对于单变量数据,它包括统计技术,如 z 分数和四分位距(interquartile range,IQR)方法。对于多变量数据,它提供隔离森林(Isolation Forest)和局部离群因子(Local Outlier Factor,LOF)等算法。下面是一个移除信用卡交易中小额离群支付(金额最低的 0.2%)的示例:
Q1 = df['amount'].quantile(0.002)
outliers = df[(df['amount'] < Q1)]
如果仍然存在大额离群支付,对数变换可以通过压缩高值来帮助减少其影响。通常,你应该在对数变换之前执行离群值移除,并且记住,对数变换对小的或负的离群值没有帮助。
填补缺失值
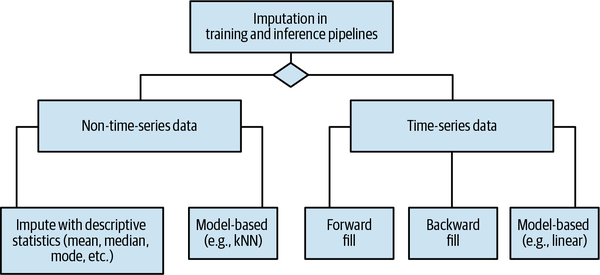
缺失值有时可以在 EDA 中识别出来,并通过不在特征视图中包含特征来处理。例如,你可能因为某个特征有太多缺失值而不为模型选择它。在生产特征管道中,行中的缺失值可能非常重要,以至于使该行中的所有其他值都失效——在这种情况下,整行都会被丢弃。然而,我们经常选择通过在训练和推理管道中填补(imputation)缺失值来处理它们。填补缺失数据的流行技术列表如图 7-2所示。
图示:在训练和推理管道中填补缺失数据的技术示意图,区分非时序数据和时序数据的方法。
在 Pandas 中,我们可以使用向前填充(forward filling)填补缺失的时序数据,如下所示:
df_forward_filled =
    df.sort_values("event_time").groupby("cc_num")["amount"].ffill()
向前填充取最后一个有效(非缺失)值,用它向前填充 DataFrame 中所有列的缺失值,并将输出存储在新的 DataFrame 中。
也可以使用向后填充来填补缺失值,它取下一个有效(非缺失)值,用它向后填充缺失值。在这个 Pandas 操作中,我们只向后填充 amount 列并更新同一个 DataFrame:
df["amount"] = df.sort_values("event_time").groupby("cc_num")["amount"].bfill()
如果数据量大(几十 GB 或更多),Pandas 无法扩展处理怎么办?你可以使用 PySpark 而不是 Pandas。PySpark 没有原生库支持,但你可以使用窗口函数(window function,unboundedPreceding 或 unboundedFollowing)来为特定列分别实现向前和向后填充。这里,我们向前填充 amount 并指定主键为 orderBy 列:
window_spec = Window.partitionBy("cc_num").orderBy("event_time")
    .rowsBetween(Window.unboundedPreceding, Window.currentRow)
# Forward fill the 'amount' column with missing values
df_forward_filled = df.withColumn(
    "filled_amount", F.last("amount", ignoreNulls=True).over(window_spec)
)
这将在每个 cc_num 内按 event_time 对数据进行排序。因此,如果存在缺失的 amount,它将被该卡上最近的信用卡金额替换。以下是向后填充缺失值的相同示例:
window_spec_back = Window.partitionBy("cc_num").orderBy("event_time")
    .rowsBetween(Window.currentRow, Window.unboundedFollowing)

# Backward fill the 'amount' column with missing values
df_backward_filled = df.withColumn(
    "filled_amount", F.first("amount", ignoreNulls=True).over(window_spec_back))
请注意,这些操作在 Spark 中代价很高,需要在所有 worker 上对数据进行混洗(shuffle)和排序。要在 PySpark 中扩展窗口函数,你需要设置分区键并确保分区大小均衡(如果分区大小存在偏斜,性能将受到负面影响)。相比之下,在 Pandas 中排序是一种相对廉价的内存操作。
那么如何使用填补来填充非时序数据呢?在 Scikit-Learn 管道中,我们可以使用其 impute 模块中的类(如 SimpleImputer)来填补缺失值:
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
pipeline = Pipeline(steps=[
    ('imputer', SimpleImputer(strategy='mean'))
])

df_imputed = pd.DataFrame(
    pipeline.fit_transform(df[["amount"]]),
    columns=["amount"]
)
这段代码用 DataFrame 中所选列上计算出的均值替换所有缺失值。如果 DataFrame 存储的是训练集,这很有效。Pipeline 对象可以与其中嵌入的模型一起存储在模型注册表中。这使得相同的 Scikit-Learn 管道对象可以被下载到推理管道中,在推理期间应用相同的填补变换,从而确保没有训练-服务偏差(training-serving skew)。
同样,如果数据太大而无法放在单台机器上怎么办?Scikit-Learn 管道只能在单台机器上工作,因此在这种情况下,你可以在 Hopsworks 的特征视图上使用声明式 MDT。Hopsworks 可以使用 Pandas 或 Spark 作为后端,通过特征视图创建训练数据集,因此该解决方案可以扩展到非常大的(TB 级或更大)训练数据集。在这个例子中,当我们使用特征视图对象创建训练数据时,我们对 amount 特征进行 min_max_scale:
from hopsworks.hsfs.builtin_transformations import min_max_scaler

feature_view = fs.create_feature_view(
    name='transactions_view',
    query=query,
    labels=["fraud_label"],
    transformation_functions = [min_max_scaler("amount")]
)
# missing values will be imputed during training data creation
feature_view.create_training_data(test_size=0.2)
对于更高级的用例,你可以尝试基于模型的填补,它使用统计模型来估计和填充缺失值。详情请参见 Roderick Little 和 Donald Rubin 所著的 Statistical Analysis with Missing Data(Wiley 出版)。
作为基于模型的变换的数据清洗
数据清洗可以由启发式方法、训练数据统计量或基于数据训练的模型来指导。当特征及其分布在训练和推理之间保持相对稳定时,基于模型的清洗最有效。数据清洗的一个例子是 Meta 在预训练 LLM 之前为清洗文本数据所做的预处理。预训练受益于移除低质量 token 中的噪声。Meta 表示,在训练 Llama 3.1 时,“我们使用 token 分布的 Kullback-Leibler 散度(Kullback-Leibler divergence)来过滤掉与训练语料分布相比包含过多离群 token 的文档……我们开发了一系列数据过滤管道……使用启发式过滤器、NSFW(not safe for work,即不宜在工作场所观看)过滤器、语义去重方法和文本分类器来预测数据质量。“这听起来像是一个先有鸡还是先有蛋的问题。当你想创建干净的训练语料时,你怎么知道训练语料分布是什么?他们的解决方案是:“我们使用 Llama 2 来生成为 Llama 3 提供动力的文本质量分类器的训练数据。“也就是说,他们假设用于预训练 LLM 的文本从版本 2 到版本 3 遵循稳定的分布。因此,Llama 3.1 的训练数据也可以用于训练 Llama 4 的文本质量分类器,依此类推。
请注意,LLM 的文本质量分类器只在训练数据集(或特征)管道中运行。它们不是在训练和推理管道中都运行的 MDT。训练前需要数据清洗,但你在未清洗的数据上进行预测,所以你不应该在推理期间应用数据清洗变换。
有许多优秀的开源库可用于基于模型的数据清洗。例如,Cleanlab 是一个 Python 包,它识别并纠正训练数据集中的标签错误,为每个标签的正确性提供置信度估计。Lightly 是一个用于计算机视觉的开源库,它创建图像嵌入,然后使用聚类和相似性搜索来帮助选择、优先排序或伪标记样本,而无需完整的手动标注。这使得 Lightly 在获取标注数据困难或昂贵的图像任务中非常有用。Cleanlab 更广泛地用于表格数据集,可以在其中识别和纠正标签错误,尽管它也可以用于文本和图像数据集。
目标/标签相关变换
有些数据变换以标签/目标的属性(如时间戳)为参数。有时,你可以延迟计算特征,直到标签及其属性已知。这使你能够只在需要时计算这些特征。在信用卡欺诈检测的背景下,标签相关变换(label-dependent transformation)的一个很好的例子是 time_since_last_transaction,它相对于当前交易的时间戳和最近一次先前交易的时间戳来计算:
def time_since_last_transaction(event_time, prev_ts_transaction):
    return event_time - prev_ts_transaction
昂贵特征在需要时计算
有时在特征管道中为所有实体预计算特征太昂贵了。如果你的 AI 系统不会消费所有已预计算的特征,你可以将它们作为 MDT 计算。例如,想象你编写了一个每天运行的批处理特征管道来计算 days_since_bank_cr_changed。但是你的(重新)训练管道每月只运行一次,而使用该特征的批处理推理管道每周只运行一次。那么你必须在 days_since_bank_cr_changed 用于推理之前重新计算它 7 次,在用于训练之前重新计算 30 次。这是大量浪费的计算。相反,你的训练管道可以在训练和批处理推理管道中将 days_since_bank_cr_changed 作为 MDT 计算。如果你所有的特征都可以实现为 MDT,你甚至可能能够消除特征管道,从而减少运维负担。
LLM 的 tokenizer 与聊天模板
当你将文本传递给 LLM 进行训练或推理时,该文本需要首先由 LLM 的 tokenizer 变换为 token,然后才能输入 LLM。每个 LLM 都有自己的 tokenizer,这个过程被称为 tokenization(分词)。例如,Llama 3 的 tokenizer 平均将一个单词分词为两到三个 token——每个 token 平均四个字符长。Llama 3 有一个包含 128K token 词汇量的分词字典。
分词是一种 MDT,因为它与你的 LLM 版本紧密耦合。例如,Llama 3 分词后的文本不能输入 Llama 2 或 Llama 4 模型。我在微调 LLM 的从业者中常见的一个问题,是他们由于训练管道和在线推理管道中 tokenizer 版本不同而遇到训练和推理之间的偏差。一种解决方案是使用 Hugging Face(HF)聊天模板。HF 聊天模板与 tokenizer 紧密耦合,它们将对话定义为单个字符串,可以按模型期望的格式进行分词:
from transformers import AutoTokenizer
tokenizer=AutoTokenizer.from_pretrained("meta-llama/Meta-Llama-3-8B")

chat = [
   {"role": "user", "content":
    "How do I prevent training/inference skew for tokenization in LLMs?"},
   {"role": "assistant", "content": "A chat template can help"}
]
tokenized_prompt = tokenizer.apply_chat_template(chat, tokenize=True)
使用 HF 聊天模板,我们只需要确保在训练和推理中实例化相同的模型版本,以防止由于分词引起的偏差。
Note
用于微调和 RAG 的 LLM 文本分块(text chunking)将文档分解为片段(页面、段落、句子等),是一种在特征管道中执行的 MIT。分块后的文本可以在推理时与 RAG 一起复用。然而,文本分词(text tokenization)是模型相关的,因此在训练和推理管道中执行。如果你想在向量索引中为 LLM 索引可复用的分块文本,你不应该将文本分块与文本分词耦合。
Scikit-Learn 管道中的变换
Scikit-Learn 提供了一个变换器(transformer)库,可以在训练和推理管道中无偏差地实现 MDT。Scikit-Learn 还提供了一个管道对象来管理变换器序列和模型。你可以将管道对象 pickle 并保存到模型注册表中,而不是只保存模型。管道对象既包括变换器和模型,也包括应用特征变换所需的任何训练数据参数(均值、最小值、最大值和编码映射)。然后,在推理管道中,你下载管道对象(而不是模型),并使用它在一次方法调用中应用 MDT 并做出预测。在训练管道中,你按如下方式创建和使用管道:
import joblib
X_train, X_test, y_train, y_test = fv.train_test_split(test_size=0.2)
categorical_features = \
    [ col for col in X_train.columns if X_train[col].dtype == object ]
numerical_features = \
    [ col for col in X_train.columns if X_train[col].dtype != object ]

numeric_transformer = Pipeline(
    steps=[
        ("imputer", SimpleImputer(strategy="median")),
        ("scaler", StandardScaler()),
    ]
)
categorical_transformer = Pipeline(
    steps=[
        ("encoder", OneHotEncoder(handle_unknown="ignore")),
    ]
)

preprocessor = ColumnTransformer(
    transformers=[
        ("num", numeric_transformer, numerical_features),
        ("cat", categorical_transformer, categorical_features),
    ]
)

clf = Pipeline(
    steps=[
        ("preprocessor", preprocessor),
        ("classifier", LogisticRegression()),
    ]
)

clf.fit(X_train, y_train)
joblib.dump(clf, "cc_fraud/cc_fraud.pkl")
mr_model = mr.register_sklearn_model(name="cc_fraud", feature_view=fv,..)
mr_model.save("cc_fraud")
我们使用 joblib 而不是 Python 原生的 pickle 库,因为它在保存/加载 Scikit-Learn 管道中常见的大型 NumPy 数组时更高效。在批处理推理中,我们从特征存储中读取一批要评分的特征值,下载管道对象(包括变换器和模型),并做出预测:
model_dir = mr.download_model(name="cc_fraud", version=1)
clf = joblib.load(os.path.join(model_dir, "cc_fraud.pkl"))

# Get feature data arrived since yesterday for scoring
df = fv.get_batch_data(start_time=datetime.now()-timedelta(days=1))
df["predicted_fraud"] = clf.predict(df)
model.predict() 方法在调用模型的 predict 之前应用所有管道变换。你需要注意在构建训练和推理管道的容器时使用相同版本的 joblib;否则,你可能会在反序列化管道时遇到问题。
Scikit-Learn 有许多内置变换,可能对你的训练和推理管道有用。对于填补值,Scikit-Learn 变换器可以用默认值或计算值替换缺失值、NaN(“not a number”,非数字)或其他占位符。SimpleImputer 是一种单变量算法,它仅使用该特征的非缺失值来填补特征的缺失值。你可以用 missing_values 参数定义什么是缺失值(默认是 np.nan)。可用的 SimpleImputer 策略是 mean、median、constant(还要将 fill_value 参数设置为替换缺失值的默认值)和 most_frequent,即该特征的众数。相比之下,IterativeImputer 实现基于模型的填补,使用所有特征来估计缺失值(它是一种多变量算法)。另一种更复杂的技术是生成多个填补值,并对填补值应用分析管道。
对于类别变量,Scikit-Learn 支持 OneHotEncoder,它适用于基数较低或中等的类别变量。你可以使用 min_frequency 参数排除不频繁的类别,它会移除基数小于 min_frequency 的类别。你还可以通过将 handle_unknown 参数设置为 'infrequent_if_exist' 来指定一个名为 infrequent 的默认类别,这将把推理中遇到的任何新类别设置为 infrequent。你也可以将 handle_unknown 设置为 ignore,这将产生一个所有列都为 0 的独热编码数组。handle_unknown 的默认行为是在推理期间遇到新类别时引发错误。Scikit-Learn 还支持 OrdinalEncoder,用于具有自然顺序的类别,以及 TargetEncoder,用于编码具有高基数的无序类别,例如美国(US)的邮政编码。
对于数值变量,Scikit-Learn 在 sklearn.preprocessing 包中提供了许多类。StandardScaler 类标准化数值特征,它实现 Scikit-Learn 的 Transformer API 来计算训练集(X_train)的均值和标准差,然后将其保存在 Pipeline 对象中。MinMaxScaler 将特征缩放到介于零和一之间(或某个其他最小值和最大值),保留分布的形状。MaxAbsScaler 比 MinMaxScaler 更擅长保留稀疏性。
其他重要的数值变换是分位数(quantile)和幂(power)变换,它们执行单调变换以逼近高斯分布,保留数据的秩顺序。它们都可以将特征数据从任何分布映射到近似高斯分布的分布。在幂变换中,Scikit-Learn 同时支持 Box-Cox 和 Yeo-Johnson 算法。
在 Scikit-Learn 中,你可以通过应用 preprocessing.normalize 函数来归一化 NumPy 数组(或由 NumPy 数组支持的 Pandas DataFrame),指定可用的范数之一:l1、l2(默认)或 max。l1 范数更新(缩放)值,使绝对值之和为 1,l2 范数缩放值,使值的平方和等于 1,max 范数缩放值,使每个样本中的最大绝对值为 1。例如,使用 l2 范数,值数组 [3, 4, 0] 将被归一化为 [0.6, 0.8, 0]。
截至 2025 年,Scikit-Learn 预处理包中的变换算法操作 NumPy 数组,并不原生支持 Arrow 支持的数据帧。Arrow 支持的数据帧(如 PySpark 和 Pandas 中的)对于大型数据集更具可扩展性。在下一节中,我们将介绍适用于 Arrow 支持的数据帧的 Hopsworks 特征视图的特征变换。
特征视图中的变换
Hopsworks 中的特征视图支持在从特征存储读取特征时执行变换函数。有内置的变换函数——如 one_hot_encoder、min_max_scalar 和 label_encoder——可以作为特征视图的一部分来定义。它们将特征视图中的特征作为输入参数,并返回一个或多个变换后的特征值。你也可以为特征视图中的特征编写自己的用户定义(自定义)变换函数。
变换函数在 Hopsworks 客户端使用特征视图读取数据之后、返回特征数据之前执行。特征视图变换是保证训练和推理之间无偏差的 MDT。应用特征变换所需的任何训练数据参数(均值、最小值、最大值和编码映射)都存储在训练数据集对象中,这些对象与模型以及用于创建训练数据的特征视图一起保存在模型注册表中。然后在推理管道中,下载模型及其特征视图和训练数据对象,其特征视图检索特征数据并应用 MDT 来创建用于模型预测的特征向量。
在下面的代码片段中,我们定义了覆盖信用卡交易特征的特征视图,并声明式地将三个内置特征变换应用于三个不同的特征——对 amount 特征应用 min_max_scaler,对 category 特征应用 one_hot_encoder,对 fraud 标签应用 label_encoder。
from hopsworks.hsfs.builtin_transformations \
    import min_max_scaler, label_encoder, one_hot_encoder

fv = fs.create_feature_view(
    name='transactions',
    query=fg_credit_card.select_features(),
    labels=["fraud"],
    transformation_functions = [
        one_hot_encoder("category"),
        min_max_scaler("amount"),
        label_encoder("fraud")
    ]
)
当你创建特征视图时,transformation_functions 列表指定应用于特征视图中命名特征的变换。列表中的每个条目包含变换函数的名称和特征视图中作为输入参数的特征名称。你还可以将索引列或辅助列作为参数包含在变换函数中。在上面的示例中,变换函数是单变量(一对一)函数,它接受单个特征作为输入并返回变换后的值作为输出。你还可以编写自定义多变量函数,它可以接受一个到多个特征作为输入,并返回一个到多个变换后的特征作为输出。
如果在 transformation_functions 列表中没有显式提供特征名称,变换函数将默认使用特征视图中与变换函数定义中参数名称匹配的特征名称。这对用户定义的变换效果很好,但对内置变换则不然。最好在特征视图定义中明确提供特征名称,以便开发人员可以看到哪些变换应用于哪些特征。
让我们看看特征视图的变换函数在实践中如何工作。在下面的代码片段中,我们使用特征视图读取包含训练集和测试集中特征和标签的 DataFrame。默认情况下,变换函数在 train_test_split 方法内执行,返回的 DataFrame 包含变换后的特征数据:
X_train, X_test, y_train, y_test = fv.train_test_split(test_size=0.1)
类似地,当我们读取一批推理数据时,默认情况下它会返回变换后的特征数据。然而,这里我们通过设置 Transformed=False 使用特征视图读取未变换的推理数据:
features = fv.get_batch_data(
    start_date=(datetime.now() - timedelta(1)), transformed=False
)
对于特征视图的在线 API,当你读取特征向量时,变换函数同样默认在客户端中透明执行(transformed=True 是默认值):
features = fv.get_feature_vector(serving_keys={"cc_num": "1234 0432 0122 9833"})
变换函数可以改变从特征视图读取的特征数据的模式(schema),因为它们可以返回比特征视图中特征数量更多或更少的列。例如,one_hot_encoding 可以将字符串列变换为返回 DataFrame 中的数百列(每个类别一列)。然而,特征视图确保在读取训练和推理数据时,返回数据的列数和顺序保持一致。作为开发人员,你只需要处理模型的特征视图以及由它创建的训练/推理数据。你通常不需要处理模型签名——输入模型的 DataFrame 的模式。特征视图负责将其特征映射到模型签名以及从模型签名映射回来。这意味着,例如,在处理类别特征时,你只处理字符串列(在特征视图中),而不是独热编码列(在训练/推理数据中)。
你还可以为特征视图定义自己的自定义变换,作为用户定义的变换函数。用户定义的变换函数(user-defined transformation function)是带有 @hopsworks.udf 注解的 Python 或 Pandas UDF。Pandas UDF 可以扩展以处理大量数据(在 Pandas 或 PySpark 中),而 Python UDF 则不能很好地扩展。然而,Python UDF 在在线推理管道中的延迟比 Pandas UDF 低。因此,在可能的情况下,最佳实践是编写可以作为 Pandas UDF(在特征/训练/批处理推理管道中)或 Python UDF(在在线推理管道中)执行的 Python 函数形式的变换函数。我们将这类变换函数称为混合模式(mixed-mode)UDF,因为它们可以根据上下文作为 Pandas UDF 或 Python UDF 运行。通常,只有简单的 UDF 才能写成混合模式 UDF。
下面是一个混合模式变换函数的示例,它对交易偏离训练数据集平均交易金额的程度进行编码。Hopsworks 会自动在 stats 对象中填充训练数据集的统计量:
stats = TransformationStatistics("amount")
@hopsworks.udf(float)
def transaction_amount_deviation(amount, statistics=stats):
    return amount / statistics.amount.mean
在训练管道中,amount 是 pd.Series,statistics.amount.mean 是标量,因此它作为 Pandas 中的向量化函数执行。然而,在在线推理中,amount 是浮点数,因此该函数作为低延迟的 Python UDF 执行。
我们还可以显式定义一个用户定义的变换函数,在训练和推理中都运行在 Pandas 模式下。这可以由 PySpark 作为 Pandas UDF 执行。在这里,我们在变换函数中计算 days_to_card_expiry,它接受来自特征视图的两个特征 cc_expiry_date 和 event_time 作为输入,期望它们是包含日期的 pd.Series。它为每个输入计算并返回 int 值的 days_to_card_expiry:
@hopsworks.udf(return_type=int, mode="pandas")
def days_to_card_expiry(cc_expiry_date, event_time):
    return (cc_expiry_date - event_time).dt.days
在在线推理中,这个变换函数也将接受 Pandas DataFrame 作为输入,与 Python UDF 相比,这可能会增加几百微秒的额外延迟。
由于这个变换函数不包含训练数据统计量,它也可以用作 Hopsworks 中特征/在线推理管道中的 ODT(见下一节)。
有时特征可以实现为 MIT 或 MDT。例如,在第6章中,我们描述了如何在特征管道中使用 MIT 计算 days_to_card_expiry。然而,特征管道必须每天运行以确保 days_to_card_expiry 是正确的。如果特征管道在某一天未能运行(或在午夜以外的任何时间运行),客户端就有读取错误特征数据的风险。还有运行特征管道的运维开销,这是 MDT 所没有的,MDT 只在训练和推理管道中需要时才运行。
图 7-3 中的流程图有助于指导你如何实现 days_to_card_expiry:作为 MIT、MDT 或 ODT。
图示:根据批处理 ML 系统中的使用情况或实时计算,实现 “days_to_card_expiry” 特征作为 MIT、MDT 或 ODT 的决策路径流程图。
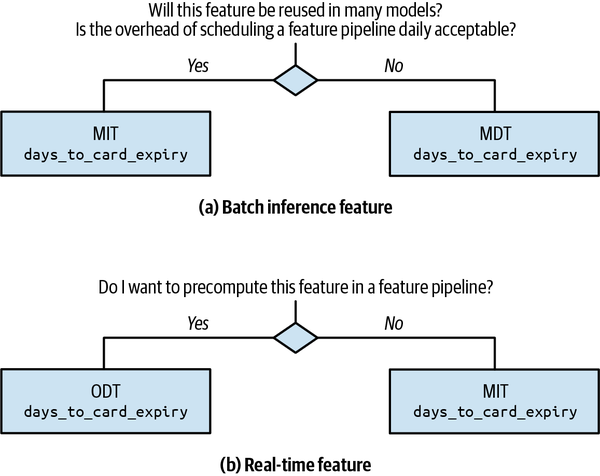
如果该特征将由批处理 ML 系统使用,并且你不会复用计算出的特征,或者你不想承担特征管道的开销,你应该将该特征实现为 MDT。否则,它应该是 MIT。如果 days_to_card_expiry 是一个实时特征,需要至少一个请求时间参数来计算,并且你不想能够使用历史数据预计算该特征并将其保存在特征存储中供许多模型使用,你应该将其实现为 MDT。否则,它应该是 ODT。
在我们的另一个用户定义变换示例中,transaction_amount_deviation 必须是 MDT,因为它将 amount 作为请求时间参数,将训练数据统计量(amount.mean)作为参数。ODT 没有训练数据统计量作为参数,因为它们在特征管道中离线计算(那里没有训练数据,只有可复用的特征数据)。
用户定义的变换函数与内置变换函数一样附加到特征视图:
fv = fs.create_feature_view(
    ...
    transformation_functions = \
        [ days_to_card_expiry("cc_expiry_date", "event_time")
    ]
)
你可以按如下方式阅读前面的语法:days_to_card_expiry 变换函数应用于特征视图中的 cc_expiry_date 和 event_time 特征。特征视图中没有定义 days_to_card_expiry 特征,只有创建它的变换函数。days_to_card_expiry 函数在训练管道和批处理推理管道中作为 Pandas UDF 运行。如果你需要创建大量训练数据,你应该编写一个 PySpark 训练数据集管道,使用 fv.create_train*(..) 方法之一将训练数据保存为文件。PySpark 将 DataFrame 分区到多个 worker 上,并在每个 worker 上将变换函数作为 Pandas UDF 执行,各 worker 独立地将它们创建的训练数据保存为文件。
按需变换
特征视图中使用的相同变换函数可以用作 Hopsworks 中的 ODT,只要它们不将训练数据统计量作为参数。ODT 可以组合请求时间参数和使用特征视图读取的预计算特征。有时你会在特征视图中添加推理辅助列(inference helper column),因为它们提供用于计算 ODT 的预计算特征数据。ODT 与 MDT 的不同之处在于它们注册的位置。你将 ODT 注册到特征组而不是特征视图,因为 ODT 可以在特征管道中执行。特征视图知道其哪些特征被计算为 ODT,并在在线推理管道中计算它们。ODT 也可以是单变量或多变量函数。在下面的代码中,为 cc_trans_fg 定义了一个实时特征 days_to_card_expiry:
fg = feature_store.create_feature_group(name="cc_trans_fg",
                version=1,
                description="Transaction Features",
                online_enabled=True,
                primary_key=['id'],
                event_time='event_time'
                transformation_functions=
                    [days_to_card_expiry("cc_expiry_date", "event_time")]
                )

fg.insert(df) # transformation functions are run on insertion
当你调用 fg.insert(df) 时,ODT 在此特征管道中执行。days_to_card_expiry 函数的参数名称需要与 df 中的列名匹配;否则,你会得到一个错误。有时 df 可以包含用于计算 ODT 的列,但这些列不是特征组中的特征。在这种情况下,你可以告诉 ODT 在特征计算完成后从 df 中 drop 这些列:
@hopsworks.udf(return_type=float, drop=["cc_expiry_date"])
MDT 也可以使用相同的 drop 语法来删除列。在第11章中,我们将研究 ODT 和 MDT 如何在在线推理管道中执行。
PyTorch 变换
我们现在切换赛道,看看非结构化数据(图像、音频、视频或文本数据)上的变换。使用非结构化数据训练的 ML 系统通常使用深度学习算法,并将数据变换为张量作为模型输入。卷积神经网络(convolutional neural network,CNN)和 transformer 架构(transformer)是最流行的深度学习模型架构。PyTorch 是最流行的深度学习框架,替代方案包括 TensorFlow 和 JAX。在使用 PyTorch 构建的 ML 系统中,我们也可以受益于将数据变换代码重构为 FTI 管道中的 MIT、MDT 和 ODT。然而,这些数据变换将输出张量或处理张量——到目前为止,我们只研究了处理表格数据的 MIT、MDT 和 ODT。
我们将从示例 ML 系统的角度研究 PyTorch 变换,该系统使用图像分类模型预测你的名人双胞胎。1 图 7-4 展示了基于 FTI 架构的实时 ML 系统。训练管道使用 CelebA 数据集微调 ResNet 模型。在线推理管道将上传的人物图像作为输入,图像被变换为输入张量,模型使用输入张量预测最相似的名人。此示例的源代码可以在本书的 GitHub 仓库中找到。
图示:使用图像分类预测名人双胞胎的实时 ML 系统示意图,展示包括特征、训练和在线推理过程在内的不同变换管道。
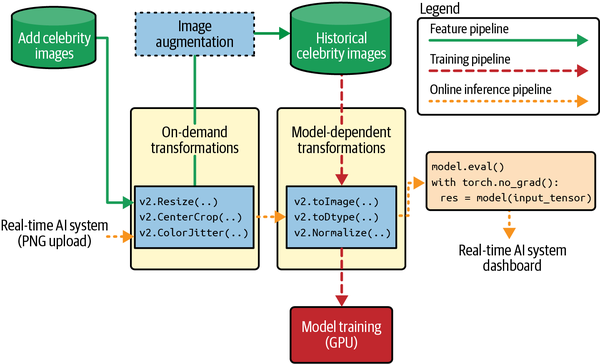
FTI 架构在此示例中的好处是,它将图像变换从训练管道转移到特征管道。这减少了在输入张量传递给 GPU 进行模型训练之前,训练管道中 CPU 上执行的图像变换数量。如果训练因大量图像预处理而导致 CPU 负载过高而成为瓶颈,将变换卸载到特征管道将提高训练期间的 GPU 利用率。特征管道执行以下任务:图像调整大小、图像居中、抖动控制和图像增强。图像增强(image augmentation)发生在你为训练数据创建同一输入图像的许多变体时——你可以翻转图像、更改其颜色或随机擦除图像的一部分(用于 transformer 的自监督学习)。图像增强有助于 CNN 更好地泛化,因为同一图像的不同变体通过学习对变换不变的(invariant)特征来防止模型过拟合单个图像。
图像增强发生在我们对图像进行调整大小、中心裁剪和颜色抖动之后。因此,如果我们想将 ImageAugmentation 从训练管道迁移到特征管道,我们还需要将 Resize、CenterCrop 和 ColorJitter 迁移到特征管道中作为 ODT 运行。我们还需要在在线推理管道中对上传的图像运行这些变换。特征管道将输出变换和增强后的图像作为 PNG 文件。在训练和在线推理中,我们都需要将 PNG 文件转换为张量,这在 MDT 中执行。
PyTorch 提供了一个名为 Torchvision v2 的图像变换库,它支持图像的内置变换。下面的代码片段展示了如何通过组合变换函数来定义自定义的 ImageAugmentation 变换:
import torchvision.transforms.v2 as v2

class ImageAugmentation(nn.Module):
    def __init__(self, flip_prob=0.5, rotation_range=(-30, 30)):
        self.flip_prob = flip_prob
        self.rotation_range = rotation_range

    def forward(self, img):
        ...

on_demand_transforms = v2.Compose([
    v2.Resize(...),
    v2.CenterCrop(...),
])
model_independent_transforms = v2.Compose([
    v2.Resize(...),
    v2.CenterCrop(...),
    ImageAugmentation(...)
])
model_dependent_transforms = v2.Compose([
    v2.ToImage(...),
    v2.ToDtype(...),
    v2.Normalize(...)
])
PyTorch 提供 datasets(数据集)作为存储特征和标签的数据结构。有预创建的数据集,你也可以使用提供的基类创建自己的自定义数据集。你可以在训练模型之前将变换应用于 PyTorch 中的数据集,如下所示:
dataset = datasets.ImageFolder(root='images/train',
    transform=model_independent_transforms )
dataloader = DataLoader(dataset, batch_size=32, num_workers=4)
for images, labels in dataloader:
    # Your training code goes here
从这个示例 PyTorch 系统,你可以看到 FTI 管道架构在改进代码模块化和使用特征管道预处理图像方面的好处。
使用 pytest
特征管道中的变换函数和特征函数创建特征。一旦特征被创建并被下游训练或推理管道使用,那么在创建特征的函数和特征的使用者之间就存在一个隐含的约定:特征逻辑不应意外更改。特征计算方式的变化可能会破坏客户端。单元测试有助于确保开发人员不会意外更改特征的计算方式,这有助于开发人员对其 ML 管道进行安全、增量的升级。
由于本书的大部分重点在 Python 上,我们将详细介绍 Python 中最流行的单元测试框架 pytest,以及如何使用它来测试变换函数,以及稍后的特征管道。如果你用其他语言编写特征管道,例如 SQL 或 Java/Spark,那么你可以使用其他测试框架,例如分别使用 dbt 和 JUnit 进行单元测试。
单元测试
让我们看看我们的示例特征 days_to_card_expiry,以及我们如何以及为什么要测试它:
def days_to_card_expiry(cc_expiry_date, event_time):
    return (cc_expiry_date - event_time).dt.days
这是一个简单但没有文档说明的函数。一位初级开发人员发现,如果卡在使用的同一天过期,该函数将无法与对数变换一起使用。如果值为零或负数,对数变换是未定义的。因此,开发人员将代码改为返回 1 而不是负数:
def days_to_card_expiry(cc_expiry_date, event_time):
    days_remaining = (cc_expiry_date - event_time).dt.days
    return max(days_remaining, 1)
一位高级开发人员,由于当前项目压力很大,进行了粗略的审查,批准了代码,并让它进入生产环境。突然,信用卡欺诈检测模型的性能下降。高级开发人员回退了变换函数的更改并移除了对数变换,暂时解决了这个错误。
我们怎么能在它推出之前识别出这个问题?研究表明,代码审查和文档在发现许多错误方面不是很有效。执行单元测试是一种在代码审查之前更早发现错误的更结构化方法。以下是 days_to_card_expiry 的一些单元测试。test_days_to_today_expiry 测试会因初级开发人员的更改而失败,该更改永远不会进入生产环境:
import pytest
def test_days_to_future_expiry():
    future_date = datetime.date.today() + datetime.timedelta(days=30)
    assert days_to_card_expiry(future_date, datetime.date.today()) == 30

def test_days_to_today_expiry():
    today_date = datetime.date.today()
    assert days_to_card_expiry(today_date, today_date) == 0

def test_expired_card():
    past_date = datetime.date.today() - datetime.timedelta(days=10)
    with pytest.raises(ValueError, match="Credit card is expired."):
        days_to_card_expiry(past_date, datetime.date.today())
这些单元测试是 LLM 给我建议的——我复制了函数并要求它为我编写一些 pytest 单元测试。这些单元测试涵盖了以下潜在错误情况:
- test_days_to_future_expiry
- 这是"正常"情况,即卡在未来若干天过期(LLM 选择了 30 天作为合理的未来日期)。也可以是 10 或 40 或 80 天。也许不是 10,000 天。实际上,这里没有对未来太多天的测试。你可以把这个测试作为练习添加。
- test_days_to_today_expiry
- 计算机科学家从零开始计数,但凡人从一开始计数,所以我们经常有差一(off-by-one)错误。这是一个很好的边界情况测试。
- test_expired_card
days_to_card_expiry的新实现确保如果cc_expiry_date在交易日期之前,将抛出ValueError。
LLM 在为我们的函数生成单元测试方面表现相当不错,因为它的函数名、参数名和变量名是人类可读的。LLM 理解了函数的语义——函数应该做什么。当然,我对 LLM 生成的单元测试进行了代码审查,我对它们很满意。如果你想要更复杂的特征函数,你可能需要自己编写——或者至少自己处理一些边界情况。不要盲目相信 LLM 会生成正确的单元测试。信任是好的,但验证更好。
Note
未能引入自动化测试,是 2024 年年中全球 IT 基础设施崩溃的原因,当时安全公司 CrowdStrike 在 Windows 内核中引入了一个错误,导致 Windows 崩溃。这个错误是,开发人员在使用结构体中的元素之前没有检查它是否为空。他们承认他们没有测试已经部署到全球服务器的代码更改,导致机场和铁路大范围延误,以及许多零售商和其他互联网公司出现问题。我不想成为那个初级开发人员,但他们不是主要罪魁祸首。工程领导没有引入自动化测试,这是一种基本的软件工程实践,本可以在错误投入生产之前检测到它。
实现 pytest 单元测试
单元测试定义在 Python 函数上。如果你想对单个特征进行单元测试,你应该重构你的代码,使每个特征由单个函数计算。由于我们使用 Python 函数来实现特征逻辑,我们可以使用单元测试来验证计算特征的代码是否正确遵循单元测试本身定义的规范。也就是说,单元测试是特征逻辑的不变量(invariant)、前置条件(precondition)和后置条件(postcondition)的规范:
- 不变量(Invariant)
- 在函数整个生命周期中保持为真的条件——它在函数调用之前和之后都为真,并且在函数的作用域内也为真。不变量更适用于有状态对象,在多次函数调用中某些属性需要保持不变。
- 前置条件(Precondition)
- 在函数可以正确执行之前必须为真。它定义了函数无错误执行的合法输入和/或状态。
- 后置条件(Postcondition)
- 在函数或方法完成执行后必须成立的一个或多个条件。通常,它们与有状态函数相关——修改外部状态的函数——但你也可以验证无状态函数的输出。
在我们的 days_to_card_expiry 函数中,我们可以看到我们条件的示例:
- 前置条件
cc_expiry_date不能早于transaction_date。
- 后置条件
- 我们的函数是无状态的(它只依赖于其输入参数),但我们仍然可以验证后置条件——如果它不抛出异常,它应该返回零或正整数。
- 不变量
- 我们前面的单元测试中没有测试不变量,主要是因为我们在测试的是无状态函数调用。
你还需要理解三个额外的概念才能用 pytest 编写单元测试:测试函数(test function)、断言(assertion)和测试设置(test setup)。单元测试可以写成函数(如前面的示例)或类中的方法。此外,pytest 有一个命名约定来自动发现测试模块/类/函数。测试类必须命名为 Test</em>,测试函数或方法必须命名为 test_</em>(如前面的示例)。
在图 7-5中,我们可以看到 pytest 在开发期间作为离线测试运行——而不是在管道部署到生产环境后(作为在线测试)运行。
图示:不同的测试阶段示意图,包括用于开发测试(如特征变换、ML 管道和模型评估)的 pytest,以及用于运维检查(如数据验证和模型监控)的工具。
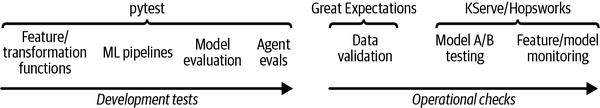
你通常在创建拉取请求(pull request,PR)之前在开发环境中运行单元测试。当你将 PR 提交到暂存分支时,CI/CD 环境也应该运行单元测试,如果任何单元测试失败,要求你修复代码并重新提交 PR。使用第6章中的目录结构(你依赖 Python 的默认行为将当前目录放入 sys.path),你可以从源代码仓库中信用卡项目目录的根目录运行开发环境中的单元测试:
python -m pytest
你只需要在开发期间或在提交代码到 GitHub 后运行自动化测试时安装 pytest 库。你不需要在生产管道中安装 pytest。
作为 GitHub Action 的一部分运行 pytest
你可以定义一个 GitHub Action,每当代码推送到 main 分支或为 main 分支创建拉取请求时,运行 pytest 单元测试:
name: Credit Card Fraud Test
on:
  push:
    branches:
      - main
  pull_request:
    branches:
      - main

jobs:
  test:
    runs-on: ubuntu-latest

    steps:
    - name: Check out repository code
      uses: actions/checkout@v3
    - name: Set up Python
      uses: actions/setup-python@v5
      with:
        python-version: '3.12'
    - name: Install dependencies
      run: |
        cd ccfraud
        python -m pip install --upgrade pip
        pip install -r requirements.txt
    - name: Run tests
      run: |
        pytest
你可以点击 GitHub 中失败的 action 来查看单元测试失败原因的日志。最后,当测试通过并经过代码审查后,你想将新的 PR 合并到 main 分支。当你合并 PR 时,你应该压缩你的提交(将你所有的提交变成一个大的提交),以摆脱你凌乱的提交痕迹。从长远来看,保持整洁是值得的!
测试方法论
在涵盖了定义单元测试、运行测试和自动化测试的所有战术工作之后,我们需要考虑我们如何编写测试以及我们应该测试什么。为此,我们需要一种构建测试用例的方法论。我建议使用 arrange, act, assert 模式(安排、行动、断言)——它安排输入和目标,对目标行为采取行动,并断言预期结果。这是我们在这里的示例中使用的结构。然而,你怎么知道要测试什么以及如何测试它?并不是所有特征都需要测试。如果特征是你公司的收入驱动因素,那么你可能应该彻底测试它,但如果你的特征是实验性的,那么也许现在只需要最少或不需要测试。话虽如此,我们首选的测试方法论是一个简单的配方:
- 为所有特征和变换函数(MIT、MDT 和 ODT)编写单元测试,并检查你的测试代码覆盖率(单元测试覆盖了多少百分比的代码路径)。
- 使用端到端测试测试特征管道、训练管道和批处理推理管道。
- 为实用函数和其他重要的未测试代码路径编写单元测试。
这种方法论将帮助你入门,但它不是万灵药。例如,想象你编写了一个计算月度聚合的特征,但忘记包含处理闰年的代码。使用这种方法论,你不会看到闰年代码路径没有被测试代码覆盖率覆盖。只有当你第一次发现这个错误时,你才会修复它,然后你应该编写一个单元测试,以确保没有再次出现闰年错误的回归。有帮助的是在输入数据中测试更多边界情况并预测边界情况。你应该使用 LLM 来帮助建议测试的边界情况。
尽管关于测试驱动开发有不同的学派,但我们不认为在你进行实验时先写测试的开发方式是有成效的。一个好的开始方式是列出你想测试的内容。然后决定哪些应该使用 pytest 离线测试,哪些应该在运行时使用数据验证检查、A/B 测试和特征/模型监控来测试。
小结与练习
在本章中,我们从数据科学和工程的角度研究了 MDT 和 ODT。我们介绍了为什么以及如何将类别变量和数值特征变换为数值表示。我们研究了在训练和推理管道之间没有任何偏差的情况下实现 MDT 的不同框架。我们介绍了 Scikit-Learn 中的管道和变换器,它们适用于 NumPy 数组中较小的数据量。我们研究了 Hopsworks 中的变换函数,它们如何使用 Pandas UDF 扩展以处理大数据量,以及它们如何用于实现 MDT 和 ODT。然后,我们使用示例 PyTorch 系统研究了如何在 FTI 管道中组织变换。这包括为图像和张量数据编写不同的 MIT、MDT 和 ODT。最后,我们以 pytest 的介绍结束,以及如何使用它对变换函数进行单元测试。既然我们已经介绍了用于创建特征的 MIT、MDT 和 ODT,我们可以看看如何编写运行它们的管道。
以下练习将帮助你学习如何设计自己的 MDT 和 ODT:
- 我有一个特征想实现,它特定于一个模型,但计算非常复杂。我想最小化检索或计算它的在线延迟。我应该将其实现为 MIT、MDT 还是 ODT?
- 我正在构建一个需要每日重新训练并每日预测的批处理 ML 系统。我可以使用 MIT 或 MDT 将其实现为单个整体式管道吗?
1 名人双胞胎匹配被视为分类问题,当你有多张同一名人的图像落入同一类(名人的名字是类)时,这比使用相似性搜索和嵌入效果更好。