与模型无关的变换
现在我们的焦点转向如何为特征管道编写数据变换逻辑。正如我们在第2章中解释的那样,特征管道(feature pipeline)是执行与模型无关的数据变换以产生可复用特征并将其存储在特征存储中的程序。也就是说,创建的特征数据可能被许多不同的模型使用——而不仅仅是你正在为其开发特征管道的第一个模型。特征复用通过增加使用量和测试来提高特征质量,降低存储成本,并降低特征开发和运维成本。请记住,成本最低的特征管道是你根本不需要创建的那条。
与模型无关的变换(model-independent transformation,MIT)的例子包括提取、验证、聚合、压缩(EVAC)变换:
- 特征提取(滞后特征、分箱以及用于 LLM 的分块)
- 数据验证(使用 Great Expectations)与数据清洗
- 聚合(时间窗口内的计数与求和)
- 压缩(向量嵌入)
我们还将探讨如何在特征管道中组合变换,以提高特征管道的模块化、可测试性和性能。不过,我们将从搭建开发流程开始——如何将源代码组织成包,以及可以使用哪些技术来实现特征管道中的变换。
源代码组织
我们将使用信用卡欺诈项目的源代码作为模板,示范如何组织源代码,使其遵循开发 ML 管道的生产最佳实践。要构建生产级质量的管道,我们必须超越仅仅编写 notebook 的做法,这意味着要遵循软件工程实践,例如采用持续集成与持续部署(continuous integration and continuous deployment,CI/CD)的测试驱动开发。如果你修改了源代码,测试会给你更大的信心,相信你的改动不会破坏某条管道,也不会破坏依赖于你的管道所产出的工件(无论是特征、训练数据集、模型还是预测)的客户端。通过自动化执行测试,你在开发时不会拖慢迭代速度。如果你从未写过单元测试,别担心——LLM(如 ChatGPT)可以帮助你入门编写单元测试。
我们采用一种目录结构,来组织构建、测试和运行整个信用卡欺诈预测系统所需的全部源代码(参见图 6-1)。
图示:信用卡欺诈预测系统中用于组织源代码的目录结构,包含 notebooks、pipelines、features、tests 和 scripts 等独立目录。
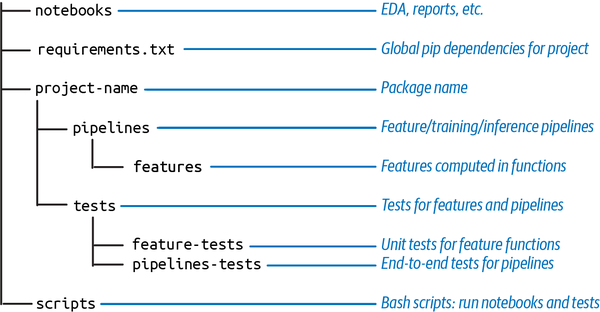
不同 FTI 管道的源代码存储在 pipelines 目录中。为了便于维护,我们将测试放在管道程序之外的专用目录中的独立文件里,这样就把管道的代码与测试的代码分开了。我们将有两类不同的测试:特征测试(feature test),即用于计算特征的单元测试;以及管道测试(pipeline test),即针对管道的端到端测试。类似地,最好将用于计算特征的函数与实现 FTI 管道的程序分开。我们把特征函数放在 features 目录中。如果你遵循这种代码结构,你就能快速迭代,而不必在以后为生产环境重构代码。
我们把这种项目结构称为单体仓库(monorepo),因为我们整个 AI 系统的源代码都位于单个源代码仓库中。与为 FTI 管道分别建仓库相比,单体仓库的优势在于,我们不必为 ML 管道之间的任何共享代码创建和管理可安装的 Python 库。单体仓库也不会妨碍为 FTI 管道创建独立的生产级部署。例如,每条 ML 管道都可以在自己的目录中拥有自己的 requirements.txt 文件,用于为 ML 管道构建可执行的容器镜像。
请注意,notebooks 是一个独立的目录。它通常不属于项目中的生产代码。它的存在是为了产生创建生产代码所需的洞见——执行 EDA(探索性数据分析,exploratory data analysis)以理解数据和预测问题,并将这些洞见传达给其他利益相关者。话虽如此,在一些平台(如 Hopsworks 和 Databricks)上,你可以将 notebook 作为作业运行,所以如果你真的想,也可以把特征管道、训练管道和批量推理管道作为作业来运行。scripts 目录不是生产代码,它用于存放开发期间对管道运行测试的实用 shell 脚本。
容器化 ML 管道程序需要 Python 库依赖,这些依赖以至少一个全局 requirements.txt 文件(适用于所有 ML 管道)的形式包含在项目目录中。你们中大多数有 Python 开发经验的人都已经领略过 pip 依赖地狱的滋味。某个你从未听说过的库因不向后兼容的升级而导致你的程序失败,这是 Python 开发者必经的成人礼。所以,请务必对你的 Python 依赖进行版本固定。
在我们的信用卡欺诈项目中,我把三条 ML 管道各自的、带版本号的 Python 库依赖放在了一个 requirements.txt 文件中。你可以通过以下命令在虚拟环境中安装 Python 依赖:
uv pip install -r requirements.txt
我们使用 uv pip,因为它比 pip 快得多。也可以使用功能更丰富的依赖管理库,例如 Poetry。Poetry 非常适合大型项目,它通过 pyproject.toml 文件管理 Python 虚拟环境的生命周期。我们将使用 uv / pip 和 requirements.txt 文件,因为它们的入门门槛更低,并且与那些从 requirements.txt 文件构建容器镜像的平台集成得更好。
特征管道
特征管道从某些数据源读取数据,变换这些数据以创建特征,并将其输出的特征数据写入特征存储。在深入探讨特征工程之前,我们先来看一些流行的开源数据变换引擎。给定一组你想一起计算(并写入特征组)的特征,你应该根据预期的数据量和特征的时效性要求,理解使用不同可用引擎之间的权衡取舍。大多数特征工程计算引擎都属于以下计算范式之一:
- 面向流式特征管道的流处理(Python、Java 或 SQL)
- 面向批量特征管道的数据帧(DataFrames)(Python)
- 面向批量特征管道的数据仓库(SQL)
还有一些其他专门的特征工程计算引擎,包括一些利用 GPU 的引擎,但由于篇幅考虑,我们只介绍被广泛采用的开源引擎:Pandas、Polars、Apache Spark、Apache Flink 和 Feldera(一个使用 SQL 的流处理引擎)。在图 6-2 中,你可以看到如何选择最佳的数据处理框架,这些框架按以下标准组织:
- 能够扩展以处理单台服务器无法处理的大数据(Apache Spark、Apache Flink)
- 是流处理框架(Feldera、Apache Flink、Spark Structured Streaming)
- 支持在预测请求中实时计算特征数据(Python UDF)
- 是批量数据变换(Pandas、Polars、DuckDB 和 PySpark)
图示:说明各种数据变换框架的延迟与可扩展性,Python UDF 和 Feldera SQL 提供较低延迟,而 Polars、DuckDB 和数据仓库中的 SQL 提供较高延迟的变换。
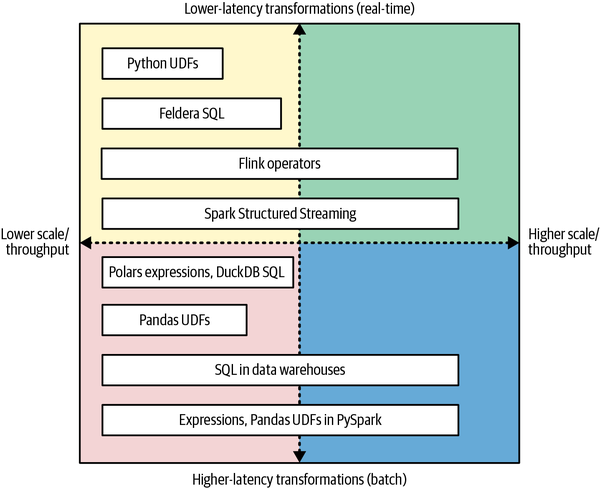
对于流处理,Apache Flink 和 Spark Structured Streaming 作为分布式、可扩展的框架被广泛使用。然而,两者都有陡峭的学习曲线和高昂的运维开销。Feldera 是一个单机流处理引擎,支持用 SQL 进行增量计算,入门门槛较低(参见第9章)。
对于使用数据帧的批量处理,Pandas、Polars 和 PySpark 是本章我们将使用的主要框架。使用 SQL 的批量处理可以在数据仓库(如 Snowflake、BigQuery、Databricks Photon 和 Redshift)中执行,也可以在单主机 SQL 引擎(如 DuckDB)上执行。dbt 框架因将特征工程管道编排为一系列 SQL 命令而变得流行。表 6-1 提供了何时应该选择某一引擎而非另一引擎的指南。
| 数据量 | 特征时效性 | 候选框架 | 适用于 AI 系统的示例特征管道 |
|---|---|---|---|
| 大 | 1-3 秒 | Flink (Java) | 可扩展推荐系统的点击流 |
| 小-中 | 1-3 秒 | Feldera (SQL) | 实时物流、较小规模的点击流处理和网络安全事件 |
| 小 | 1-3 秒 | Python: Pathway 和 Quix | 入侵检测、工业 4.0 和边缘计算 |
| 大 | 分钟到小时 | PySpark 或 dbt/SQL | 个性化营销活动和细分、批量欺诈、客户流失、信用评分和需求预测 |
| 大的非结构化数据 | 分钟到小时 | PySpark | 图像增强、文本处理(例如分块)和视频预处理(PySpark) |
| 小-中 | 分钟到小时 | Pandas、Polars 和 DuckDB | 与上一项相同,适用于更小的数据量和从 API 获取数据 |
| 小-大 | 分钟到小时 | 可选配 GPU:Pandas、Polars 和 PySpark | 面向 RAG 和视频预处理的向量嵌入文本分块管道 |
一般来说,如果你正在构建需要新鲜预计算特征的实时 ML 系统,你应该选择流处理。如果特征时效性不重要,你很可能应该编写批量特征管道,因为它的运维成本更低。在以下情况下,你应该优先选择数据帧计算引擎(Pandas/Polars/PySpark)而不是 SQL:
- 你需要从 API 获取数据。
- 需要进行大量的数据清洗。
- 你需要变换非结构化数据(图像、视频、文本)。
- 你需要使用仅在 Python 中可用的特征工程库。
- 你需要用自定义逻辑编写变换。
在单台机器上,你可以通过从 Pandas 切换到 Polars 来扩展基于数据帧的特征工程,Polars 能更好地利用可用的内存和 CPU。当数据量对单台机器来说太大时,你可以使用 PySpark,它可以横向扩展到许多工作节点,处理 TB 级或 PB 级的工作负载。
我们现在简要介绍用于特征工程的 SQL。当你拥有批量特征管道、所有源数据都在数据仓库或湖仓(lakehouse)中,并且你的特征工程可以用 SQL 实现时,你应该使用 SQL 而不是数据帧。基于 SQL 的特征工程是声明式的,它利用了关系运算的能力,以及数据仓库或湖仓表之上的查询引擎的规模优势。
例如,在 Hopsworks 中,你可以针对外部特征组或存储在 Hopsworks 中的特征组运行基于 SQL 的变换。对于外部特征组,你可以直接在源数据仓库中用 dbt/SQL 编写特征管道。它们直接变换外部表中的数据。如果外部特征组启用了在线功能,你需要在 dbt 工作流中加入一个 Python 模型,将更新后的数据写入在线特征组。对于 Hopsworks 中的特征组,你可以使用 Spark SQL 或 DuckDB。Spark SQL 可用于变换 Spark 数据帧中的数据,然后将变换后的数据帧写入 Hopsworks 中的特征组。对于 DuckDB,你可以在 Python 程序中用 SQL 执行变换,并将最终的特征数据以 Arrow 表(Arrow table)的形式传递给 Pandas 或 Polars 数据帧,然后写入特征组。
面向数据帧的数据变换
使用数据帧和 SQL 表进行特征工程都涉及对数据执行逐行和逐列的变换。理解每种数据变换的一个有用方法,是研究它如何变换你的数据帧或 SQL 表中的行和列。
你需要知道数据变换的结果会是什么——它们会增加或删除列、减少行数,还是增加更多行?图 6-3 展示了可以对表格数据执行的不同类别的变换。在接下来的讨论中,我们将只讨论数据帧上的数据变换。代码片段混合使用 PySpark、Pandas 和 Polars。与 Pandas 类似,Polars 是一个运行在单台机器上的数据帧引擎,但由于更好的内存管理和多核支持,它可以扩展到处理大得多的数据量。我们将介绍几个重要的变换类别:
- 表达式(
df.with_columns(..))在 Polars 和 PySpark 中都可用。 - Pandas 用户自定义函数(user-defined function,UDF)在 PySpark 中可用。
- Python UDF(
apply)在 Pandas 和 Polars 中可用。 filter和join变换在 Polars、Pandas 和 PySpark 中都可用。groupBy(Polars 中为group_by)和aggregate在 Polars、Pandas 和 PySpark 中都可用。
图示:说明数据帧上不同的数据变换操作,展示特征提取、聚合、过滤和连接等各种变换如何通过改变行数和列数来影响数据帧的形状。
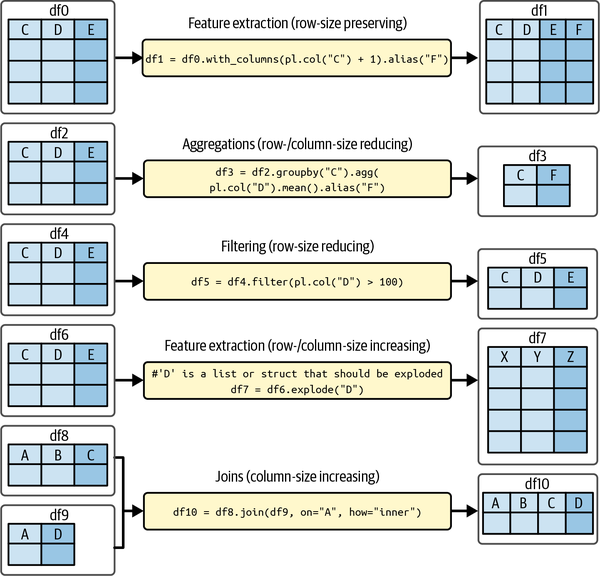
我们可以将数据帧变换分为以下几类基数(cardinality):
- 行大小保持变换
- 使用这种变换时,你在不改变行数的情况下向现有数据帧添加一个新列。特征提取就是这种数据变换的典型例子。
- 行/列大小缩减变换
- 使用这种变换时,输入数据帧的行数多于输出数据帧。这类变换的例子包括分组聚合(group by aggregation)、过滤和数据压缩(向量嵌入和主成分分析,principal component analysis)。
- 行/列大小增扩变换
- 使用这种变换时,输入数据帧的行数少于输出数据帧。一个常见的例子是涉及展开(explode)存储在数据帧列中的 JSON 对象、列表或字典的特征提取。交叉连接(cross join)也属于这一类,用户自定义表函数(在 PySpark 中)也是如此。
- 连接变换
- 这类变换将两个输入数据帧合并在一起,产生一个数据帧(其列数多于任一输入数据帧)。当你拥有来自不同来源的数据,并且想使用两个来源的数据计算特征时,就需要连接。有时需要连接来构建最终写入特征组的数据帧。
行大小保持变换
下面是一个行大小保持变换的例子,实现为一个操作 Series(数据帧中的列)的 Pandas 函数,它通过在数据帧的新列中为 is_outlier 设置布尔值来识别包含异常值的行:
def detect_outliers(value_series: pd.Series) -> pd.Series:
    """Add a column that indicates whether the row is an outlier"""
    mean = value_series.mean()
    std_dev = value_series.std()
    z_scores = (value_series - mean) / std_dev
    return np.abs(z_scores) > 3

df["is_outlier"] = detect_outliers(df["value"])
我们可以在 Pandas 中将此变换与一个删除被视为异常值的行的行缩减变换组合起来:
def remove_outliers(df: pd.DataFrame) -> pd.DataFrame:
    """Remove the rows in the DataFrame where is_outlier is True"""
    return df[df["is_outlier"] == False]

df_filtered = remove_outliers(df)
其他行大小保持的数据变换的例子包括:
- 在 Polars 中将 UDF 作为 lambda 函数应用(或在 Pandas 中应用
apply,或在 PySpark 中应用 Pandas UDF)。下面这段将某列的平方值存储在new_col中的 Polars 代码,使用map_elements函数将 lambda 函数应用于col1。请注意,map_elements逐行执行 Python 函数,不是向量化的:df = df.with\_columns( pl.col(“col1”).map\_elements(lambda x: x * 2).alias(“new\_col”) ) - Polars 中的滚动窗口表达式,计算过去三天在信用卡上花费的平均金额:df.with\_columns( (col(“amount”).rolling\_mean(3).over(“cc\_num”)).alias(“rolling\_avg”) )
- 条件变换(
when、then、otherwise、select)。这里,如果col为 0,则将new_col设置为positive。如果不是,则将其设置为non_positive:df.with\_columns( (pl.when(df[“col”]==0) .then(“positive”).otherwise(“non\_positive”)) .alias(“new\_col”) ) - 捕获数据中与时间相关信息的时态变换。这里,我们计算自银行信用评级上次变更以来的天数:df.with\_columns( (pl.lit(datetime.now()) - pl.col(“last\_modified”)) .dt.total\_days() .alias(“days\_since\_bank\_cr\_changed”) )
- 排序和排名。这段代码在
rank_col中计算col中每个值的排名:df.with\_columns(pl.col(“col”).rank().alias(“rank\_col”)) - 数学变换。这里,我们将
col1和col2的和存储在sum_col中:df.with\_columns((pl.col(“col1”) + pl.col(“col2”)).alias(“sum\_col”)) - 字符串变换。此变换将
name中的字符串转为大写,并存储在uppercase_name中:df.with\_columns(uppercase\_name = pl.col(“name”).str.to\_uppercase()) - 滞后(lag)和超前(lead)。这段代码将昨天的
pm25值存储在lagged_pm25中:df.with\_columns(lagged\_pm25 = pl.col(“pm25”).shift(1))
行和列大小缩减变换
聚合(aggregation)是一种众所周知的数据变换,它减少输入数据帧(或表)的行数。聚合在某一列上汇总数据,并且可选地附加一个时间窗口(一段数据的时间范围),以捕捉趋势或时间模式。聚合在数据稀疏且具有时间模式的 AI 系统中非常有用,例如欺诈检测、推荐引擎和预测性维护应用。
聚合是对一个数据窗口进行汇总的函数。数据可以包含全部输入数据,也可以是一个时间窗口(time window),即执行聚合的时间段。常见的聚合函数包括:
- 计数(Count)
- 事件数量
- 求和(Sum)
- 总值(例如交易总金额)
- 均值/中位数(Mean/median)
- 平均值
- 最大值/最小值(Max/min)
- 极值
- 标准差/方差(Standard deviation/variance)
- 变异程度的度量
- 百分位数(Percentiles)
- 特定阈值,例如第 90 百分位
聚合是针对实体计算的,例如:
- 每张信用卡
- 每个客户
- 每个商户/银行
- 每个产品/商品
在 SQL 和 PySpark 中,你使用 group_by 和窗口(window)。Polars 通过 groupby_rolling 和 groupby_dynamic 方法支持按时间窗口分组,然后应用聚合。Pandas 通过 resample 和 rolling 支持基于时间的分组,它们可以与聚合函数组合使用。下面是一个 Polars 中不带时间窗口的聚合示例,它通过前向填充策略(forward fill strategy,用数据中较早出现的最后一个有效非空值替换空值)填充缺失值来处理缺失数据,然后再分组并对金额求和:
filled_df = (df.with_columns(pl.col("amount").fill_null(strategy="forward"))
              .group_by("cc_num", maintain_order=True)
              .agg([
                  pl.col("event_time"),
                  pl.col("amount").sum().alias("total_amount")
              ])
              .explode(["event_time"]))
在上面的代码片段中,输出数据帧 filled_df 包含来自 df 的 event_time 列,并新增了包含聚合结果的 total_amount 列。df 的所有其他列都没有保留,因为聚合通常会减少列数。例如,如果你在计算某信用卡号的交易总和,在该变换中保留 category 列就没有意义。如果你想对 category 列计算聚合,你需要对该列单独执行一次变换。
聚合支持不同类型的时间窗口,其中有些会缩减行大小,有些则不会。滚动窗口聚合为源数据帧中的每一行计算一个输出,因此不会缩减行大小。相比之下,滚动窗口(tumbling window)为一个窗口长度内的所有事件计算一个输出,因此它们通常会减少行数。例如,如果你的窗口长度为一周,平均每周有 20 笔交易,那么你平均会将行数减少 20 倍。
有时聚合需要组合变换。例如,假设我们要计算:「找出每个 cc_num 中,在同一类别下有两笔或更多交易的最大金额。」首先,我们需要按 cc_num 分组,然后删除那些在给定类别下只有一条记录的交易,接着对每个剩余的类别(交易数 >1)找出最大金额。这看起来可能是一个复杂的例子,但当你需要从数据中找出对当前问题有预测力的特定信号时,这种情况并不少见。Polars 让我们能够优雅而高效地组合 group_by 聚合和表达式:
df3 = df.group_by("cc_num").agg(
    pl.col("amount").filter(pl.col("category").count() > 1).max()
)
向量嵌入(vector embedding)是另一种数据变换类型,它将输入数据压缩为更少的行和列。你可以通过将某些高维输入数据(行和列)输入嵌入模型(embedding model)来创建向量嵌入,嵌入模型随后输出一个向量。该向量是一个固定大小的数组(其长度被称为维度,dimension),包含(通常为 32 位的)浮点数。嵌入模型是一个深度学习模型,因此如果你要将大量数据变换为向量嵌入,在 GPU 而不是 CPU 上执行数据变换可能会大幅加快处理速度。在下面的示例代码中,我们用 SentenceTransformer 嵌入模型对一笔欺诈性信用卡交易的 explanation 字符串进行编码:
from sentence_transformers import SentenceTransformer
model = SentenceTransformer('all-MiniLM-L6-v2')
embeddings = model.encode(df["explanation"].to_list())
df = df.with_columns(embedding_explanation=pl.lit(embeddings))
如果你将此向量嵌入写入向量数据库(或 Hopsworks 中的特征组),就可以使用k 近邻(k-nearest neighbors,kNN)搜索来搜索具有相似 explanation 字符串的记录。kNN 搜索是一种概率算法,它返回 k 条包含与所给向量嵌入在语义上接近的向量嵌入的记录。k 的大小可以从几条到几百条不等。
行/列大小增扩变换
将 JSON 对象存储在表的列中正变得越来越普遍。要从 JSON 对象中的值创建特征,你可能需要先将 JSON 对象中的值提取为新的列和/或新的行。你可以通过展开(explode)包含 JSON 对象的列来实现。在 Polars 中,这涉及调用 unnest 将结构体展开为单独的列:
df = pl.DataFrame({
    "json_col": [
        {"name": "Alice", "age": 25, "city": "Palo Alto"},
        {"name": "Bob", "age": 30, "city": "Dublin"},
    ]})

df_exploded = df.unnest("json_col")
如果在某一列中有 JSON 对象,在 Polars 中,你可以先将它们定义为一个结构体,然后对列执行 unnest 以将细节展开到单独的列中。最终,df_exploded 包含列 ["name", "age", "city"]。
在 PySpark 中,用户自定义表函数(user-defined table function,UDTF)是将单个输入行变换为多个输出行的函数。相比之下,UDF 是逐行工作的。例如,UDTF 可以根据深层嵌套的字段将列中的 JSON 结构展开为多行。Polars 或 Pandas 中没有 UDTF。UDTF 在 Spark 任务中并行执行。PySpark 自 Spark 3.5 起支持自定义 UDTF。从 Spark 4.0 开始,UDTF 既支持通过 Apache Arrow 的向量化执行(以获得更高性能),也支持多态模式(即输出模式可以依赖于输入参数)。为了获得最大性能,可以用 Java/Scala Spark 编写自定义 UDTF。
展开 JSON 对象并不是唯一的行大小增扩数据变换。假设我们要为每个客户按交易类别统计的总消费创建一个特征。然而,交易是按 cc_num(实体 ID)组织的,所以我们需要对数据帧执行透视(pivot),将列变换为行,并计算 spend_category 列:
pivot = (
    df.group_by(["cc_num", "category"])
    .agg(pl.col("amount").sum())
    .pivot(on="category", values="amount", index="cc_num")
    .fill_null(0)
)
pivot = pivot.rename(
    {col: f"spend_{col}" for col in pivot.columns if col != "cc_num"}
)
类似地,我们也可以使用 unpivot 将列逆透视为行:
dv_unpivot = df.unpivot(index=["cc_num"], on=["category"])
连接变换
为模型选择特征时,一个常见需求是包含「属于」不同实体的特征。例如,假设你在不同的特征组中有具有不同实体 ID(如 cc_num、account_id)的特征,但你希望在模型中使用来自两个特征组的特征。在这种情况下,你通常需要使用共同的连接键(join key)将两个或多个数据帧连接在一起。
下面是一个在 Polars 中将两个数据帧连接在一起的示例。请注意,对于此操作,Pandas 使用 merge 方法而不是 join(PySpark 使用 join):
merged_df = transaction_df.join(account_df, on="cc_num", how="inner")
这里我们执行的是内连接(inner join),它会取 transaction_df 中的每一行,并在 account_df 中查找匹配的 cc_num。它会跳过 transaction_df 中在 account_df 里没有匹配 cc_num 的行。但是,如果一笔交易没有账户信息,而我们仍然想包含这笔交易(因为我们可以在训练或推理期间为账户推断出合理的值),该怎么办?在这种情况下,我们可以把策略改为左(外)连接,即 how="left"。INNER JOIN 和 LEFT JOIN 是特征工程中使用最广泛的连接。请注意,LEFT (OUTER) JOIN 对于连接操作中的左侧数据帧来说是一种行大小保持变换,而 INNER JOIN 则可能是行大小保持变换或行大小缩减变换,具体取决于右侧数据帧中是否为左侧数据帧的所有行都存在匹配行(存在则是保持,不存在则是缩减)。
特征函数的有向无环图(DAG)
在第2章中,我们认为特征逻辑(变换)应该被分解为特征函数,以提高代码的模块化程度,并使变换可进行单元测试。特征管道是一系列定义良好的步骤,它将源数据变换为写入特征存储的特征:
- 从一个或多个数据源读取数据到一个或多个数据帧中。
- 应用特征函数将数据变换为特征,并将特征连接在一起。
- 将包含特征化数据的数据帧写入相应的特征组。
你应该以数据输入为参数对特征管道进行参数化,这样你就可以用历史数据或新的增量数据运行特征管道。假设你的数据源支持数据跳过(data skipping),你应该只选择需要的列,并过滤掉不需要的行。如果你处理的是小数据,也许可以省事地把数据源中的所有数据读入数据帧,然后删除多余的列并过滤掉不需要的数据。然而,对于大数据量,这是不可能的,你需要将选择和过滤下推到数据源。
一旦你将源数据读入数据帧,特征管道就会在数据流图(dataflow graph)中组织特征函数。数据流图是一个有向无环图(directed acyclic graph,DAG),它有输入(数据源)、节点(数据帧)、边(特征函数)和输出(特征组)。图 6-4 展示了三个不同的特征函数——g()、h() 和 j()——其中 df 从数据源读取,g() 应用于 df 产生 df1。然后,h() 和 j() 并行应用于 df1 中(可能不同的)列,分别产生 dfM 和 dfN。(请注意,PySpark 和 Polars 支持并行执行,而 Pandas 不支持。)
图示:说明使用有向无环图(DAG)的特征管道对数据帧应用数据变换,产生的输出被写入特征组。
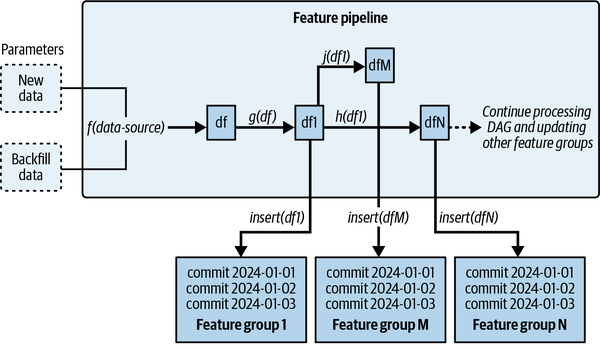
图结构本身就表示变换之间的依赖关系,因为一个特征化数据帧可以是另一个的输入。当一个变换的输出被用作另一个变换的输入时,我们说这些数据变换已经被组合(compose),如第4章所述。DAG 中的中间节点和叶节点都可以将数据帧写入特征组。这里,df1 被写入特征组 1,dfM 被写入特征组 M,dfN 被写入特征组 N。
惰性数据帧
Pandas 支持对数据帧操作的即时求值(eager evaluation)。每条命令都会立即被处理,在 Jupyter notebook 中,你可以在操作执行后直接查看操作结果。这是学习用 Pandas 编写数据变换的有力方法。相比之下,支持惰性求值(lazy evaluation)的数据帧框架,如 Polars 和 PySpark,可以在命令执行前跨多个步骤等待。等待提供了优化各步骤执行的可能性。但你要等多久才执行呢?惰性数据帧就像一个量子态,观察的行为本身就给了你结果。对于惰性数据帧,一个动作(action,读取数据帧的内容或将其写入外部存储)会触发对其执行变换。虽然即时求值对初学者很友好,但对性能并不友好。随着数据量不可阻挡地增长,你应该学会使用惰性数据帧。Polars 和 PySpark 都是围绕惰性数据帧构建的。
下面这段 Polars 代码从 CSV 文件创建一个惰性数据帧,计算 amount 列的 mean 值,然后通过从 amount 中减去 mean 来计算 deviation_from_mean。这是检测信用卡欺诈时很有用的特征。然而,所有这些步骤只有在代码执行到最后一行时才会被执行——那里有一个动作 collect() 来读取其内容:
# Lazy loading with pl.scan_csv
lazy_df = pl.scan_csv("transactions.csv")

# Compute the mean, then create a new column for deviation from mean
lazy_df = lazy_df.with_columns([
    (pl.col("amount") - pl.col("amount").mean()).alias("deviation_from_mean")
])

# Trigger execution and collect the result
result = lazy_df.collect()
向量化计算、多核与 Arrow
出于性能考虑,我们避免使用数据帧和 Python 原生语言特性(如 for/while 循环、列表推导式和 map/reduce 函数)编写数据变换代码。到目前为止我们介绍的代码示例都基于 with_columns(...) 和 Pandas UDF 等惯用写法。遵循这些惯用写法的数据帧变换由向量化计算引擎执行,而不是在原生 Python 代码中执行。它们比原生 Python 代码快几个数量级,主要有两个原因。首先,Python 的标准执行模型是解释型字节码,缺乏原生向量化。其次,Python 程序受到全局解释器锁(Global Interpreter Lock,GIL)的约束,它阻止程序在多个 CPU 核上高效扩展。
向量化计算引擎通过同时对多个数据点应用单条指令,在大数组或数据结构上执行操作。这个过程被称为单指令多数据(single instruction, multiple data,SIMD)。这些操作还可以跨多个 CPU 核并行化,以进一步提高可扩展性。Pandas、Polars 和 PySpark 都有向量化计算引擎。Polars 和 PySpark 都有良好的多核支持,而使用 PyArrow 后端的 Pandas 2.x 有一些多核支持。
你应该编写数据变换,让它们在向量化计算引擎中执行,而不是作为解释型字节码在 Python 中运行(参见图 6-5)。一个简单的反面例子是用 for 循环处理 Pandas 数据帧。拜托,别这样做。Pandas 中更常见的性能瓶颈是你 apply 到数据帧上的 Python UDF。这涉及将数据从后备存储(在 Pandas v2 中支持 Arrow)复制到 Python 对象中,在其中执行 UDF,然后再转换回 Arrow 格式。
图示:比较缓慢的 Python 变换与更快的向量化变换,后者在 PySpark、Pandas、Polars 和 DuckDB 等工具中使用 Arrow 进行零拷贝数据传输。
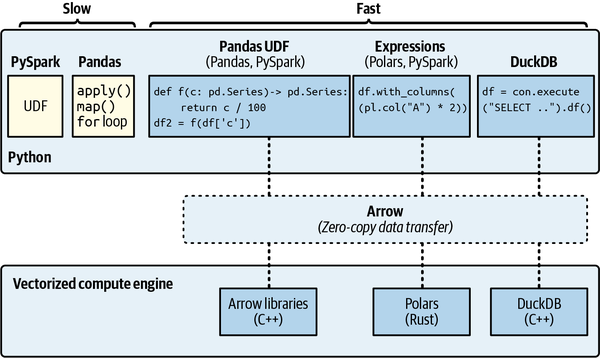
例如,下面这个用 Pandas 的 apply 执行的 Python UDF,在我的笔记本电脑(Windows Subsystem for Linux,32 GB 内存,8 个 CPU)上耗时 7.35 秒:
num_rows = 10_000_000
df = pd.DataFrame({ 'value': np.random.rand(num_rows) * 100})

def python_udf(val: float) -> float:
    return val * 1.1 + math.sin(val)

df['apply_result'] = df['value'].apply(python_udf)
Pandas 2.x 支持使用 NumPy 或 Arrow 作为后备向量化计算引擎。如果我把同一个 UDF 改写成使用 NumPy 的原生 UDF,它只需 0.28 秒即可完成:
import numpy as np
def numpy_udf(series: pd.Series) -> pd.Series:
    return series * 1.1 + np.sin(series)

df['pandas_udf_result'] = numpy_udf(df['value'])
我还可以把同样的代码改写成 Polars 中的表达式,它的执行时间与 Pandas 中的向量化 UDF 大致相同:
import polars as pl
df_polars = pl.DataFrame({'value': np.random.rand(num_rows) * 100})

df_polars_expr = df.with_columns(
    (pl.col("value") * 1.1 + pl.col("value").sin()).alias("result")
)
在这种情况下,Polars 代码并不比 Pandas 快。Polars 有良好的多核支持,但这段代码不容易并行化。不过,对于更大的数据量,Polars 有更好的内存管理。我可以用 5 亿行运行这段 Polars 代码,但 Pandas 代码在该规模下会崩溃。
我还可以把上面的代码改写为带 Pandas UDF 的 PySpark 程序。PySpark 支持惰性求值、withColumn 表达式和 Pandas UDF:
from pyspark.sql.functions import pandas_udf, col
df = spark.createDataFrame(
    pd.DataFrame({'value': np.random.rand(num_rows) * 100})
)

@pandas_udf("double")
def sample_pandas_udf(value: pd.Series) -> pd.Series:
    return value * 1.1 + np.sin(value)

df = df.withColumn("pandas_udf_result", sample_pandas_udf(col("value")))
上面的代码使用 Arrow 在 PySpark 的 Java 虚拟机(Java Virtual Machine,JVM)与 Python 之间高效地传输数据。我们还可以把之前的代码改写成 PySpark 中的 withColumn 表达式:
from pyspark.sql.functions import col, sin

df = df.withColumn(
    "result", (col("value") * 1.1 + sin(col("value")))
)
这段代码使用 PySpark 的 SQL 表达式 API,在 Spark JVM 引擎中原生执行,无需将数据从 JVM 传输到 Pandas UDF。
最后,我们可以使用 DuckDB(一个高性能的嵌入式 SQL 引擎)在 Python 中改写上面的代码:
import duckdb
con = duckdb.connect()
con.register("input_df", df)

result_df = con.execute("""
    SELECT
        value,
        value * 1.1 + SIN(value) AS result
    FROM input_df
""").fetchdf()
这将 result_df 作为 Pandas 数据帧返回,并使用 Arrow 与 Pandas 之间来回传输数据。
Pandas、Polars、PySpark 和 DuckDB 都可以原生地以 Arrow 表的形式交换数据,这被称为零(内存)拷贝(zero (memory) copy)。因此,你可以通过将源数据帧读取为 Arrow 表,然后在目标框架中从该 Arrow 表创建数据帧,从而在 Pandas、Polars 和 DuckDB 之间移动数据帧。这样,你就可以编写这样的特征管道:在 DuckDB 中执行一些数据变换,在 Pandas 中执行一些,在 Polars 中再执行一些——在不同的引擎之间移动数据帧时没有任何开销。相比之下,PySpark 是一个分布式计算引擎,数据帧会被分区到各个工作节点上。将 PySpark 数据帧转换为 Pandas 数据帧需要先在驱动节点上收集分布式的 PySpark 数据帧——这个过程可能会使驱动节点过载,导致内存不足(out-of-memory)错误。
Arrow
Arrow 是一种与语言无关的内存列式格式,是不同编程语言和框架之间高效的数据交换格式,它还支持字典压缩。由于 Arrow 数据已经是序列化格式,可以直接通过网络发送或在进程之间共享,而无需转换为其格式或从其他格式转换。例如,Arrow Flight 是一种网络协议,用于将 Arrow 数据从 Hopsworks 传输到 Python 客户端。Arrow 对于特征工程任务(例如在列上计算聚合)也很高效,因为它是一种内存列式格式。PyArrow 是处理 Arrow 数据的流行 Python 库。
下面的代码片段演示了如何构建一个特征管道,它在不同的计算引擎中执行处理步骤,并使用 Arrow 在它们之间高效地传输数据:
import pyarrow as pa

pdf = pd.DataFrame({
    'name': ['Alice', 'Bob', 'Charlie', 'David'],
    'age': [25, 30, 35, 40],
    'salary': [50000, 60000, 75000, 90000]
})

# Convert Pandas DataFrame to PyArrow Table (zero-copy if possible)
# Zero-copy if all columns are already Arrow-compatible types


arrow_table = pa.Table.from_pandas(pdf)

# Convert to Polars DataFrame (zero-copy)
pldf = pl.from_arrow(arrow_table)

pldf_transformed = pldf.with_columns([
    pl.when(pl.col('age') < 35)
    .then(pl.lit('Young'))
    .otherwise(pl.lit('GettingOn'))
    .alias('age_category')
])

arrow_table_transformed = pldf_transformed.to_arrow()

con = duckdb.connect()
con.register('employee_table', arrow_table_transformed)

# Transform salary to categorical in DuckDB SQL
result_df = con.execute("""
    SELECT name, age_category,
        CASE
            WHEN salary < 60000 THEN 'Junior'
            WHEN salary BETWEEN 60000 AND 80000 THEN 'Senior'
            ELSE 'Staff'
        END as salary_band
    FROM employee_table
""").df()
con.close()

fg.insert(result_df)
首先,我们创建一个包含员工姓名、年龄和薪水的 Pandas 数据帧 pdf。然后将其转换为 PyArrow 表 arrow_table,(通常)零拷贝。接下来,我们将其加载到 Polars 中,将员工的 age 变换为一个新的类别列 age_category。之后,我们将 Polars 数据帧转换回 Arrow,并在 DuckDB 中将其注册为表,在 DuckDB 里我们用 SQL 添加一个类别变量 salary_band(初级、高级或正式员工,junior、senior 或 staff)。最终结果是我们插入特征组的数据帧。
数据类型
在 ML 管道中编写代码时,你使用相应的 Polars/Pandas/PySpark/SQL 数据类型。然而,ML 管道通过一个共享数据层——特征存储——进行互操作,而每个特征存储都有自己支持的一组数据类型。如果你在特征管道中使用的框架与训练/推理管道中使用的框架不同,就会出现一个复杂情况。例如,特征管道可以在 PySpark 中运行,而训练管道可以使用 Pandas 向模型提供样本。然而,PySpark 支持的一组数据类型与 Pandas 支持的不同。特征存储通过以自身的原生数据类型存储数据,并在框架的数据类型之间进行转换(casting),把这两条管道连接起来。
例如,假设你的 PySpark 特征管道向特征组写入一个具有四列类型——TimestampType、DateType、StringType 和 BinaryType——的 Spark 数据帧。训练管道和批量推理管道将这些特征读取到 Pandas 数据帧中。这些管道应从离线特征组中读取具有兼容数据类型的数据。Hopsworks 使用 Hive 数据类型存储离线特征数据,因此当 Pandas 客户端使用 Hopsworks API 读取特征时,它们会被转换为 Pandas 数据类型,变成 datetime64[ns]、datetime64[ns]、object 和 object。
特征存储负责以自身的原生数据类型存储特征数据,并确保不同框架的组合能够按预期读写数据。它应确保,无论你为特征管道使用 SQL、Pandas、Polars、PySpark 还是 Flink,训练管道和推理管道都将能够在受支持的数据帧引擎中读取特征数据。不过,你可能会遇到一个例外情况。如果你的特征管道计算引擎支持比特征存储更高精度的数据类型,或者训练/推理管道计算引擎支持比特征存储更低精度的数据类型,那么某些数据类型可能会损失精度。还有一个额外的复杂情况:特征存储同时将数据存储在离线表和在线表中,而它们各自可能支持不同的数据类型。
在 Hopsworks 中,离线表使用 Hive 数据类型,而在线表使用 MySQL 数据类型。从 Spark 和 Pandas 数据类型到相应的 Hive 和 MySQL 数据类型的映射细节,可以在 Hopsworks 文档 中找到。
数组、结构体、映射和张量
Hopsworks 存储预期的原始数据类型(int、string、boolean、float、double、long、decimal、timestamp、date)以及复杂数据类型,例如数组、结构体和映射。向量嵌入以浮点数数组的形式存储。机器学习中另一个主要的数据结构是张量。张量(tensor)是一种多维数值数据结构,可以表示一个或多个维度的数据。与传统的二维矩阵不同,张量可以扩展到三个或更多维度。在深度学习中,张量通常由非结构化数据构建,例如图像(用于 3D 张量)、视频(用于 4D 张量)和音频信号(用于 1D 张量),从而能够表示和处理复杂的数据格式(参见图 6-6)。
图示:说明从标量(0D 张量)到数组(1D 张量)、矩阵(2D 张量)以及更高维张量(3D、4D 等)的演进过程。
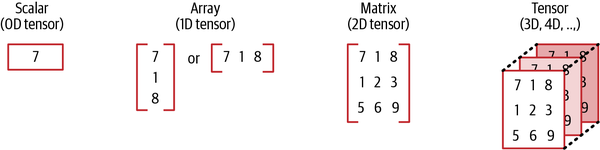
音频数据是 1D 的,因为音频输入会被采样和量化,不过当你有很多音轨(例如立体声的左右声道)时,它也可以存储为 2D 数据。图像数据通常包含具有 X、Y 偏移和颜色通道的像素——使其成为三维(3D)数据。视频数据还有一个用于帧号的额外通道——使其成为 4D 数据。音频、图像和视频可以被变换为张量数据,用于深度学习的训练和推理。
PyTorch 是最流行的深度学习框架。PyTorch 将张量表示为 torch.Tensor 类的实例,默认数据类型为 torch.float32(torch.int64 是整数张量的默认值)。你可以使用 torch.Tensor 的 shape 属性打印张量的形状:print(tensor.shape)。
我们通常不会把张量存储在特征存储中。相反,训练/推理管道在从文件中读取非结构化数据(以压缩文件格式存储,例如分别用于图像、视频和声音的 PNG、MP4 和 MP3)后,将其变换为张量:
import torch
from torchvision import transforms
from PIL import Image
image = Image.open("path/to/your/image.png")

# Define a transformation pipeline to convert the image into a tensor
transform = transforms.Compose([ transforms.ToTensor() ])
image_tensor = transform(image)
然而,有时希望在训练数据集管道中预处理文件,以文件形式输出张量,例如输出为 TFRecord 文件。TFRecord 是一种原生存储序列化张量的文件格式。使用 TFRecord 文件可以省去将非结构化数据变换为张量的需要,从而减少训练管道所需的 CPU 预处理量。假设 CPU 预处理是训练管道中的瓶颈,这有助于提高 GPU 利用率。
特征组的隐式或显式模式
在第5章中,我们描述了特征组的模式(schema)如何从插入其中的第一个数据帧推断出来。你可能已经编写过在 Pandas、Polars 或 PySpark 中将 CSV 文件读取为数据帧的程序,并注意到它们并不总能推断出「正确」的数据类型。所谓正确,我们指的是你想要的数据类型,而不是你得到的数据类型。例如,Pandas 在读取 CSV 文件时可以推断列的模式,但如果其中一列是 datetime 列,Pandas 默认会将其推断为 object(字符串)dtype。你可以通过传入一个包含日期列的参数来修复(parse_dates=['col1',..,'colN'])。PySpark 在解析 CSV 文件方面也好不了多少,除非你设置 inferSchema=True,否则它假定所有列都是字符串。
在生产特征管道中,显式指定特征组的模式通常被认为是最佳实践,这有助于防止推断数据类型时出现任何类型推断错误或精度错误。如有疑问,就把模式(schema)明确写出来。下面是一个在 Hopsworks 中为特征组指定显式模式的示例:
from hsfs.feature import Feature
features = [
    Feature(name="id",type="int", online_type="int"),
    Feature(name="name",type="string",online_type="varchar(2000)")
]

fg = fs.create_feature_group(name="fg_with_explicit_schema",
                             features=features,
                             ...)
fg.save(features)
请注意,你还可以在特征组模式中显式定义离线存储(type="..")和在线存储(online_type="..")的数据类型。
信用卡欺诈特征
现在我们来看用于为信用卡欺诈检测系统创建特征的 MIT。我们首先指出构建稳健的信用卡欺诈检测系统时与数据相关的挑战。它们包括:
- 类别不平衡(Class imbalance)
- 与非欺诈交易相比,我们的欺诈样本非常少。
- 非平稳预测问题(Nonstationary prediction problems)
- 欺诈者不断想出新的欺诈策略,因此我们需要频繁地用最新数据重新训练模型。
- 数据漂移(Data drift)
- 当交易活动中出现未见过的模式很常见时,就会产生数据漂移。
- ML 欺诈模型(ML fraud models)
- 这些模型通常与检测简单欺诈手法和模式的基于规则的方法配合使用。
在第4章中,我们介绍了要从源数据创建的特征。现在我们介绍用于创建这些特征的 MIT。图 6-7 展示了以数据集市(data mart)中的表(和事件流平台)作为数据源的特征管道。数据集市包括:作为事件流平台中事件的信用卡交易、信用卡交易事件持久化到的事实表、四个维度「明细」表,以及包含标签的 cc_fraud 表。
图示:说明从数据集市通过与模型无关的变换到特征组的数据流图,展示了来自卡、账户和商户等各种实体的数据的集成与变换。
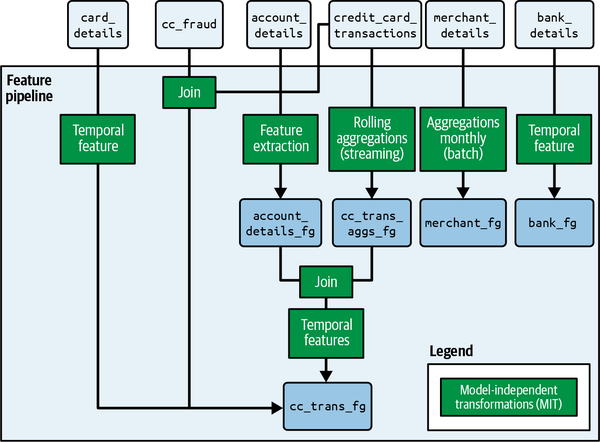
我们现在采用一种新的方法来定义变换逻辑。我们不展示源代码,而是展示我用 LLM 创建变换逻辑时使用的提示词(prompt)。表 6-2 展示了我在本书源代码仓库中创建变换代码时使用的提示词。截至 2025 年年中,LLM 非常擅长根据自然语言指令生成 Pandas、Polars 和 PySpark 源代码。你可能需要在前面加上表的逻辑模型(参见第8章),以便 LLM 理解它所处理的列的数据类型和语义。Hopsworks 提供了自己的 LLM 助手 Brewer,它提供数据源和特征组的详细信息,使开发变换逻辑变得更加容易。
| 特征 | 编写特征代码的提示词 |
|---|---|
chargeback_rate_prev_week | 从 merchant_details 出发,编写 Polars 代码,使用 chargeback_rate_prev_day 计算一个 7 天滚动窗口(tumbling window)。从特征组向上读取,与开始日期前 7 天有重叠,因为我们不希望开头为空。我们希望这个特征函数接收开始/结束日期,这样它既可以回填,也可以接收新数据。 |
time_since_last_trans | 使用 cc_num 将 cc_trans_aggs_fg 与 cc_trans_fg 连接,生成数据帧 df。然后,在 Python UDF 中计算 time_since_last_trans,用 Polars 将 prev_ts_transaction 从 event_time 中减去。将 Python UDF 应用于 df 以计算新特征。 |
days_to_card_expiry | 使用 cc_num 将 card_details 与 cc_trans_fg 连接,生成数据帧 df。然后,在 Pandas UDF 中计算 days_to_card_expiry,将 cc_expiry_date 减去 event_time。将 Pandas UDF 应用于 df 以计算新特征。 |
我们的信用卡示例系统还有许多其他数据变换,你可以在本书的源代码仓库中找到。这些特征混合了简单特征(直接从源表复制)、一些使用映射函数计算的特征(days_since_credit_rating_changed),以及大量需要在数据变换之间维护状态的特征,例如那些总结在时间窗口(如一小时、一分钟或一天)内观察到的事件的特征。特别是,为 cc_trans_aggs_fg 特征组计算的所有特征都需要有状态的数据变换。在第9章中,我们将探讨如何在流式特征管道中实现这些与模型无关的数据变换。
在 LLM 的帮助下编写数据变换时,要考虑到生成的代码有时会有 bug。例如,有时 GPT-4o 会幻觉出 Polars 数据帧支持被广泛使用的 Pandas 数据帧 apply 函数(该函数用于将 UDF 应用于数据帧)。当我遇到错误时,我会把错误日志粘贴到 LLM 的提示词中,让它修复 bug。通常这很有效。但你仍然需要理解生成的代码。归根结底,由你来签字确认代码是正确的。因此,对特征函数进行单元测试变得更加关键。同样,我也会用 LLM 为我编写的特征函数生成单元测试。同样,在采用生成的单元测试之前,我会检查它们的正确性。
变换的组合
在批量管道中,我们经常在时间窗口(例如一小时或一天)上计算聚合(如最小值、最大值、均值、中位数和标准差)。通常不止一个时间窗口包含对模型有用的预测信号。例如,我们可以每天计算一次聚合,但同时也计算过去 7 天和过去 30 天的聚合,如图 6-8 所示。
图示:展示特征管道中使用事实表或事件总线中的当前和历史数据计算单日和多日聚合的过程。
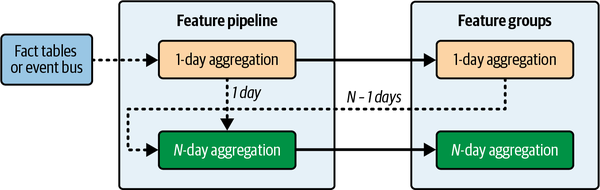
理想情况下,我们应该从最小的窗口(1 天)计算出更大的窗口(30 天和 7 天),以减少计算聚合所需的工作量。表 6-3 展示了如何从较小的窗口计算出较大窗口的常用聚合。
| 聚合 | 如何从 1 天聚合计算 7 天聚合 |
|---|---|
| count | 将前 7 天求和。 |
| sum | 将前 7 天求和。 |
| max/min | 取前 7 天的最大值/最小值。 |
| stddev | 我们需要计算并存储额外的每日数据。对于每一天,我们还需要记录数。然后,我们可以使用平方和计算 7 天聚合。 |
| mean | 我们需要计算并存储额外的每日数据。对于每一天,我们还需要记录数。然后,我们可以将 7 天聚合计算为加权平均值。 |
| approxQuantile | 我们需要计算并存储每日值的完整排序列表。借助 T-Digest 或直方图等近似摘要,我们可以通过合并每日分布来近似计算 7 天分位数。 |
| distinct count | 为了获得准确结果,我们需要存储每一天的唯一值并执行集合求并。近似答案可以通过 HyperLogLog(内存效率高但精度最差)或 位图/布隆过滤器(Bitmap/Bloom Filters,内存效率适中且精度更好)实现。 |
例如,在 PySpark 中,我们可以使用加权平均方法计算多日均值。PySpark 代码如下:
def compute_mean(days):
    window_spec = \
        Window.partitionBy("user_id").orderBy("date").rowsBetween(-days, 0)
        df = df.withColumn(f"{days}d_avg",
        F.sum(F.col("daily_mean") * F.col("daily_count")).over(window_spec) /
        F.sum("daily_count").over(window_spec))
平方和是我们本可以使用的另一种方法,但它需要一个额外的列来存储平方和,所以我们更倾向于加权平均方法,因为它在我们每日聚合特征组中少存储一列。
小结与练习
在本章中,我们介绍了在特征管道中编写与模型无关的变换的指南。我们首先描述了如何以最佳实践的方式在单体仓库中组织系统源代码、特征管道的常见数据源是什么,以及编写特征管道时需要处理的数据类型。我们研究了数据帧的不同类别数据变换,这取决于它们如何添加或删除列和/或行。我们还研究了 Pandas、Polars 和 PySpark 中的数据变换示例,以及 Arrow 如何在这些不同引擎之间高效地传输数据。最后,我们介绍了信用卡欺诈系统的与模型无关的数据变换示例,包括类别数据的分箱、映射函数、RFM 特征和聚合。
以下练习将帮助你学习如何设计和编写 MIT:
- 你的任务是开发一个信用卡欺诈检测 ML 系统。信用卡发卡机构估计,今年的交易量最多为每天 5 万笔,未来两年将增长到最多每天 10 万笔。你有 12 个月的历史交易数据。你的团队没有很强的数据工程背景。你的数据集市表存储在 S3 上的 Iceberg 中。你会选择哪个数据工程框架来编写批量特征管道?
- 再次回答上一个问题,但这次的数据量是每天 1000 万笔交易。
- 假设你在
account_details表中有一个新列email。使用 LLM 帮助编写一个特征函数,将电子邮件地址变换为表示电子邮件地址质量的数值特征。提示:使用 LLM,告诉它使用 email-validator Python 库,并告诉它使用电子邮件地址的域名来帮助确定电子邮件地址的「评分」。