Hopsworks 特征存储
在本章中,我们将深入探讨 Hopsworks 特征存储(feature store)。Hopsworks 是一个用于在规模上开发与运维批处理(batch)、实时(real-time)以及 LLM AI 系统的平台。它可以安装在一台服务器上,也可以安装在多达数百台服务器上。Hopsworks 包含一个特征存储,以及一个完整的 MLOps 与计算平台,但本章我们将聚焦于特征存储。我们将展示如何在 Hopsworks 中实现第4章中信用卡欺诈模型的数据模型。我们还将通过 Python 代码片段,看到上一章介绍的特征存储概念在 Hopsworks 中是如何体现的。我们将从 Hopsworks 中的项目(project)开始——一个用于存储特征数据、训练数据和模型的安全协作空间。
Hopsworks 项目
Hopsworks 集群按项目(project)组织,每个项目都有唯一的名称。Hopsworks 项目是团队协作、管理 AI 数据和模型的安全空间。类似于 GitHub 中的仓库(repository),项目有团队成员(带基于角色的访问控制,role-based access control,RBAC),但与存储源代码不同,Hopsworks 项目存储的是用于 AI 的数据。每个项目都有自己的特征存储、模型注册表(model registry)、模型部署(model deployment),以及用于通用文件存储的数据集(dataset)。
下面的代码片段展示了当你登录 Hopsworks 时如何获得一个项目对象的引用。如果你不输入项目名称,Hopsworks 将返回你的主项目(即你在hopsworks.ai注册账户时创建的项目)的引用。有了项目之后,你可以按如下方式获取其特征存储的引用:
import hopsworks
project = hopsworks.login()
fs = project.get_feature_store()
hopsworks.login() 方法还有用于 Hopsworks 集群的主机名(hostname)(或 IP)和端口的参数,以及 API 密钥(密钥值或包含 API 密钥的文件)。在本书中,我们将使用无服务器(serverless)Hopsworks,其主机名为 c.app.hopsworks.ai,端口为 443。在本书中,我们调用不带参数的 hopsworks.login(),而是在你的程序中把 HOPSWORKS_API_KEY 设置为环境变量。如果你不使用 Hopsworks serverless,你还需要设置 HOPSWORKS_HOST 和 HOPSWORKS_PROJECT 环境变量——把它们设置在本书源代码仓库根目录下的 .env 文件中。
在项目中存储文件
Hopsworks 中的每个项目都有可以存储数据的目录。通过 UI 或数据集 API(Datasets API),你可以上传和下载文件。例如,从本书的 GitHub 仓库,你可以按如下方式把 titanic.csv 文件上传到项目中的一个名为 Resources 的目录:
dataset_api = project.get_dataset_api()
path = dataset_api.upload("data/titanic.csv", "Resources", overwrite=True)
设置 overwrite=True 使上传操作具备幂等性(idempotent)。你可以通过文件路径从 Hopsworks 下载文件(在 Hopsworks 的文件资源管理器 UI 中右键单击文件即可获得其路径):
dataset_api.download(uploaded_path, overwrite=True)
如果你导航到 Project Settings → File Browser,你将看到 表5-1 中列出的项目目录。
| 目录 | 描述 |
|---|---|
| Airflow/ | 存储此项目的 Airflow Python 程序(DAG 文件)。本书不使用此目录。 |
| Brewer/ | 存储对话历史以及使用 Hopsworks 的 LLM 助手 Brewer 创建的产物。 |
| DataValidation/ | 当期望(expectation)被附加到特征组时,每次插入/删除都会生成一个验证报告,以 JSON 文件的形式存储在 <feature_group_name> / <version> 子目录中。 |
| <proj>_featurestore.db/ | 这是离线特征存储目录,包含特征存储湖仓(lakehouse)表文件。 |
| <proj>_Training_Datasets/ | 当你将训练数据保存为文件时,默认情况下它们会被保存在 <training_dataset_name> / <version> 子目录中(作为 Parquet 或 CSV 文件)。 |
| Jupyter/ | 你将在此处存储运行在 Hopsworks 上的 Jupyter notebook。通常,你会在此目录中检出 Git 仓库。本书不使用此目录。 |
| Logs/ | 对于在 Hopsworks 中运行的(Python、Spark、Flink)作业,其输出会存储在此处的子目录中:[Spark/Python/Flink]/job_name/execution_id。本书不使用此目录。 |
| Models/ | 保存在 Hopsworks 模型注册表中的模型存储在 <model_name> / <version> 子目录中,连同其产物(artifact)一起。 |
| Resources/ | 用于项目中文件的通用目录。 |
| Statistics/ | 为特征组和训练数据集计算的统计数据存储在遵循命名约定 <name>_<version> 的子目录中。 |
项目中有两个目录用于存储程序(Jupyter notebook、Airflow DAG)。然而,本书不会使用这些目录,因为我们将使用无服务器 Hopsworks——我们将在 Hopsworks 之外运行我们的程序。相反,如果你有自己的 Hopsworks 集群,你可以使用 Hopsworks 的 Git/Bitbucket 支持,把本书的源代码克隆到 Jupyter 目录,并从 Hopsworks 内部运行 Jupyter notebook 和作业。
项目内的访问控制
项目在项目内部支持基于角色的访问控制(RBAC)。每个活跃的项目成员拥有两种角色之一:数据所有者(data owner)角色,在项目内拥有管理员权限;或者数据科学家(data scientist)角色,该角色对特征存储是只读的,但可以创建训练数据和训练模型。这两种角色的权限如表5-2所示。
| 数据所有者 | 数据科学家 | |
|---|---|---|
| 项目成员资格 | 添加/移除/更新 | |
| 特征存储 | 读/写/更新 | 读 |
| 模型注册表 | 添加/移除 | 添加/移除 |
| 模型部署 | 创建/启动/停止 | |
| 项目目录 | 读/写/删除 | 读/写/删除所有内容,但 <proj>_featurestore.db/ 为只读 |
| 跨项目数据共享 | 是 | 否 |
使用项目在集群级别实现访问控制
我们还可以通过把用户和数据放置在不同的项目中,并有选择地跨项目边界共享数据访问权限,来使用项目实现访问控制。我们将通过一个示例来考察这些能力。在图5-1中,我们可以看到来自第4章的五个特征组是如何组织在一个名为 credit_card_transactions 的单一项目中的。该项目的成员是 Denzel(项目所有者,负责特征管道和模型部署)以及 Jack 和 Tay(数据科学家,负责训练模型)。
显示 “credit_card_transactions” 项目的图示,其成员为 Denzel、Jack 和 Tay,以及五个特征组:“cc_trans_fg”、“cc_trans_aggs_fg”、“bank_fg”、“account_fg” 和 “merchant_fg”。
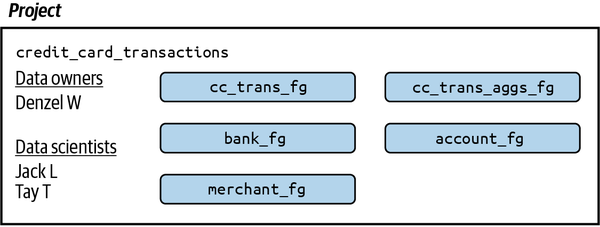
Hopsworks 项目是一个安全边界;它们实现了一种多租户(multitenant)安全模型,其中每个项目都是 Hopsworks 集群中的一个租户(tenant)。因此,Hopsworks 支持项目级多租户。你可以在共享集群上的 Hopsworks 项目中安全地存储数据,默认情况下,不是项目成员的用户将无法访问你项目中的资源。
如果你有自己的 Hopsworks 集群,你运行的所有作业都遵循动态 RBAC(dynamic RBAC)。使用标准 RBAC 时,成为多个项目的成员会让你能够在项目之间复制或移动数据。动态 RBAC 改变了这一点:用户作业总是在特定项目的上下文中运行,并且只能访问该项目内的资源。你的作业不会继承来自其他项目的所有权限。相反,它只以你在作业启动所在项目中拥有的权限运行。如果你切换到另一个项目并在那里运行作业,它将拥有你在该项目中拥有的任何权限。Hopsworks 通过为每个用户在其所属的每个项目中分配一个唯一的项目特定身份(project-specific identity)来实现动态 RBAC。你在项目中执行的操作使用这个项目特定身份,这意味着你的权限被限制在该项目内。
但是,如果你想在项目之间共享数据怎么办?Hopsworks 支持与其他项目安全共享数据。这使我们能够把图5-1中的项目重构为更小的项目,这些项目相互共享特征组,但对数据有更严格的访问控制。也就是说,你可以通过把敏感数据放在一个成员受限的独立项目中,然后有选择地把这些数据共享给那些需要访问权限的项目,来实现最小权限原则(principle of least privilege,即给用户完成工作所需的最小权限集,不多给一分)。
在图5-2中,我们重新组织了图5-1中的特征组,把 account_fg 移到一个新的 know_your_customer 项目中,并把 bank_fg 和 merchant_fg 移到一个新的 commercial_banking 项目中。
说明特征组如何分布在三个项目中的图示:“know_your_customer”、“commercial_banking” 和 “credit_card_transactions”,并标明了读和写访问的共享权限。
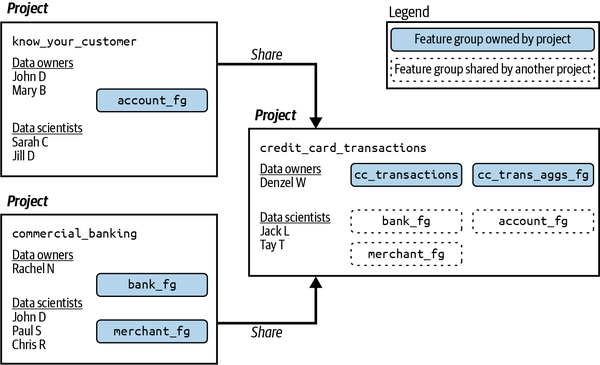
然后,我们以只读形式把这些特征组共享给原来的 credit_card_transactions 项目,其成员现在拥有与之前(当所有特征组都在单个项目中时)相同的数据读权限。然而,数据所有者 Denzel 失去了对 account_fg、bank_fg 和 merchant_fg 的写权限。这种类型的数据组织通常被称为数据网格(data mesh),在数据网格中,不是由(单个项目中的)中央数据团队管理所有数据,而是数据所有权分布在不同的业务领域(项目)中。
组织项目中的数据和用户的最佳实践,取决于你是在做开发、在预发布(staging)环境中测试,还是在生产中运行。为了减少开发中的摩擦,你应该给每个团队/开发者自己的开发项目(所有用户都拥有数据所有者角色)。对于预发布和生产环境,你应该遵循最小权限原则——给用户完成其任务所需的最小的读/写/执行权限。我经常看到的一种做法是,给开发项目对生产数据的只读访问权。有时这是由巨大的数据量所决定的,但总的来说,这消除了把数据比喻性地"扔过墙"扔给数据科学家的需要。
特征组
Hopsworks 中的特征组(feature group)是一张特征表,特征管道(feature pipeline)更新其特征数据,而训练/推理管道通过特征视图(feature view)读取其数据。在图5-3中,我们可以看到 Hopsworks 中特征组数据的离线(offline)、在线(online)和向量索引(vector index)存储。
Hopsworks 特征存储图示,说明特征管道如何跨在线、离线和向量索引存储写入特征组,数据通过特征视图使用各种 API 访问。
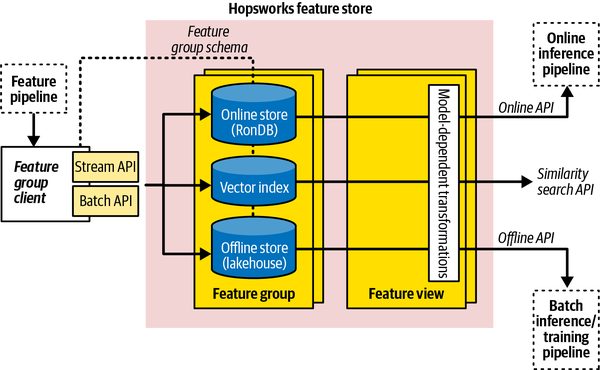
Hopsworks 的在线存储是 RonDB,一个由 Hopsworks 开发、从开源 MySQL NDB(网络数据库,network database)Cluster 分叉而来的开源、分布式、高可用、实时数据库。离线存储是一个湖仓表(Apache Hudi、Delta Lake、Apache Iceberg),存储在兼容 S3 的对象存储或 Hopsworks 原生的分布式文件系统 HopsFS 中。也可以创建外部特征组(external feature group),其离线存储是外部数据仓库,例如 Snowflake、BigQuery 或 Redshift。因此,离线存储可以是外部表与 Hopsworks 托管的湖仓表的混合。你还可以在特征组的向量索引中存储向量嵌入(vector embedding)。客户端通常使用特征视图从特征组读取数据。特征视图提供离线和在线 API,分别查询离线存储和在线存储中的数据。还有一个针对存储向量嵌入的特征组的相似性搜索 API,它使你能够找到 K 行与客户端提供的向量嵌入最接近的行。
要在 Hopsworks 中创建特征组,你首先要登录并为你的项目获取一个特征存储对象。然后,你可以使用 create_feature_group()(如果特征组已存在则返回错误),或 get_or_create_feature_group()(这是一个幂等操作,如果特征组已存在则返回该特征组)。下面的代码片段展示了创建带向量嵌入和某些数据验证规则的在线特征组的示例代码。特征组模式(schema)取自插入的 DataFrame:
from hopsworks.hsfs import embedding
fs = hopsworks.login().get_feature_store()
df = # Read data into (Pandas/Polars/PySpark) DataFrame

# Use the default Embedding Index
emb = embedding.EmbeddingIndex()
# Define the column that contains vector embeddings
emb.add_embedding(df['col_with_embedding'])

expectation_suite = ... # Define Data Validation Rules for ingestion

fg_cc_aggs = fs.create_feature_group(
    name="cc_trans_aggs_fg",
    version=1,
    description="Aggregated credit card transaction features",
    primary_key=['cc_num'],
    partition_key=['date'],
    event_time='datetime',
    online_enabled=True,
    time_travel_format='DELTA',
    embedding_index=emb,
    expectation_suite=expectation_suite,
)
fg_cc_aggs.insert(df)
特征组必须有一个名称(name)、一个版本(version)和一个主键(primary key)。你可以为特征组提供可选的描述(description)。也可以使用特征组对象为单个特征设置描述。特征组可以是仅离线(online_enabled=False,这是默认值),也可以是在线(online_enabled=True),在这种情况下,会为该特征组在离线和在线存储中都创建表。对于离线表,你可以指定离线表的表格式。可用的表格式有 Apache Hudi('HUDI')、Delta Lake('DELTA')和 Apache Iceberg('ICEBERG')。特征组定义中包含的索引列是:
- 一个必填的主键,定义在一列或多列上
- 一个可选的事件时间(event time),定义在一列上(为时序数据设置)
- 一个可选的分区键(partition key),定义在一列或多列上
- 可选外键(foreign key),定义在一列或多列上
特征组的主键唯一地标识特征组中的一个实体(entity)。如果特征组有 event_time 列,那么该实体在特征组中可能有许多行。该实体的每一行都有不同的 event_time 值,并且在每个时间点可能有不同的特征值。event_time 在特征组中定义,每行的唯一标识符是 primary_key 和 event_time 的组合。例如,在第4章的 cc_trans_fg 特征组中,可能有许多具有相同 cc_num 的交易(行),但每行都有不同的 event_time,指示具有该 cc_num 的信用卡发生交易的时间。主键可以定义在一列上,也可以定义在两列或多列上(作为复合主键,composite primary key)。例如,在 bank_fg 中,我们可以把主键设为 bank_id 和 country 两列的组合,这样 bank_id 就可以指代银行的国家特定子公司。把一列定义为外键(表示它引用另一个特征组中的主键)的原因是,表示在为你选择的特征组选择特征列时不应包含它(外键是索引列,不是特征)。
注意
外键是特征组中的一列,用于连接来自另一个特征组的特征。连接列必须指向不同特征组中的主键。在 Hopsworks 中,外键不会静态绑定到特定特征组。相反,它们支持延迟绑定(late binding)。也就是说,当你创建特征视图时,你指定从一个特征组到另一个特征组的连接键(join key)。Hopsworks 会验证该连接键是外键,并且它指向被连接特征组中的主键。由于外键不会静态绑定到特征组,Hopsworks 不会强制执行外键约束,例如 ON DELETE CASCADE。
Hopsworks 还支持离线(湖仓)表的数据布局优化,这有助于加速你的查询。你可以在一列或多列上定义 partition_key 来对离线存储中的数据进行分区(它对在线存储没有影响,因为 RonDB 会自动分区数据)。partition_key 决定了数据(Parquet)文件在离线存储中被写入的子目录(对于多部分分区键,则是嵌套子目录)。也就是说,特征组中具有相同分区键值的所有行,其 Parquet 文件存储在特征组的同一个子目录中。在前面的特征组创建代码片段中,date 列被设置为分区键,所以当你插入一个 DataFrame 时,所有具有相同 date 值的行最终都会在同一个子目录中(在特征组的目录内)。然后,当你从该特征组查询数据时(例如,使用 date="2024-11-11"),只会读取 “2024-11-11” 子目录中的 Parquet 文件——跳过所有其他包含特征数据的日期的其他子目录中的数据文件。这被称为Hive 风格分区(Hive-style partitioning),当查询可以跳过读取许多数据文件时,它被称为数据跳过(data skipping)。如果你有一个或多个基数(cardinality)相对较低的列,Hive 风格分区效果很好。然而,如果你选择了一个高基数的 partition_key,那么 partition_key 的每个唯一值都会有一个新目录。所以,例如,不要把 partition_key 设为主键!
分区最常见的用例是:你有一个每小时/每天/每周运行一次并产生 GB/TB 级数据的特征管道,然后你创建一个新的 date 列(通过从 event_time 列中提取日期)并把它作为 partition_key。每次你的特征管道运行时,都会创建一个新目录,并在特征组中存储该日期的数据。然后,当你查询数据并对某个时间段内的 date 设置过滤器(filter)时,只会从离线存储中读取所请求时间段的数据,从而加速查询。确保你把日期设置为 ISO 8601 格式(YYYY-MM-DD)的单一分区键,以便按字母顺序存储日期,这样你的范围查询才能正确工作。这意味着诸如(date >= '2025-01-31' AND date <= '2025-02-28')之类的范围查询将被分区剪枝(partition pruning)。相反,如果你决定用三列——年、月、日——创建一个多部分分区键,那么你的嵌套范围查询将极难编写。
版本控制
Hopsworks 支持创建多个版本的特征组,每个版本包含自己的离线/在线表和向量索引。Hopsworks 还支持给定特征组版本内的数据版本控制(data versioning)。也就是说,每次向特征组添加/更新/删除数据时,Hopsworks 都会存储这些更改,从而支持对特征组进行类似 Git 的操作。数据版本控制基于湖仓表中的时间旅行(time-travel)能力。
特征组中的数据版本控制与时间旅行
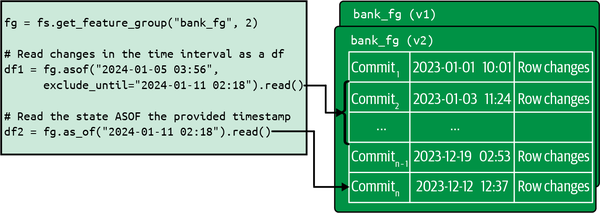
Hopsworks 把对特征组的变更(追加、更新、删除)记录为提交(commit)。当数据被上插(upsert,插入或更新)到特征组或从特征组删除时,对特征组中行的每一组更改都称为一个提交。每个提交都有唯一的 ID 和时间戳(参见图5-4)。
图示显示在特征组中上插和删除记录的过程,以及反映随时间变化的提交时间线。
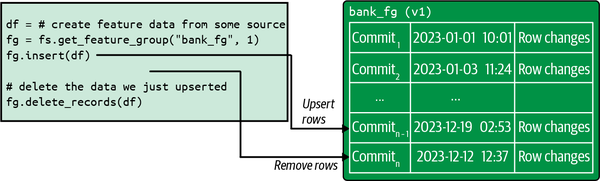
一个提交包含对特征组中行的一组更新/删除/追加。每个提交都有相关联的时间戳,只要提交未被压实(compacted),你就可以在特征组上进行时间旅行,读取其在给定时间戳"截至"(as of)的状态。在图5-4中,你还可以看到如何通过提供一个包含待删除行主键值的 DataFrame df,然后调用 fg.delete_records(df) 来移除特征组中的行。
特征组同时支持时间旅行查询和增量(incremental)查询(注意:对于 Hopsworks 4.x,这仅由 Spark 客户端支持):
- 时间旅行查询读取特征组中在提供的时间戳或提交 ID
ASOF(截至)时的数据。这里的时间戳不是指特征组中的event_time列,而是指提交的摄取时间(ingestion time)。 - 增量查询读取在指定时间范围内特征组提交中更改的数据——即行级上插(插入或更新)。
你可以把摄取时间作为参数提供给 as_of() 方法,以读取特征组在那个时间点 ASOF 的状态(参见图5-5)。你还可以读取在指定时间间隔内上插的记录更改。时间范围由起始时间戳(asof)和可选的结束时间戳(exclude_until)指定。如果没有设置结束时间戳,返回的范围将包含自起始时间戳以来的所有记录。
图示说明读取 bank_fg 特征组中更改和状态的过程,突出显示使用带特定时间戳的 as_of 方法来更新数据帧(df1 和 df2)。
请注意,摄取时间指的是该提交被摄取到 Hopsworks 中的物理(实际)时间。摄取时间可能令人困惑,因为你的特征组可能还有一个 event_time 列,指示特征在某个时间点的值。摄取时间和事件时间是不同的概念。例如,想象在第3章的空气质量项目中,一个传感器在第 4 天到第 9 天离线,如图5-6所示。
图示显示第 4 天到第 9 天的空气质量测量在第 10 天迟到到达,此时训练数据集 v1 已经创建,突出显示事件时间与摄取时间之间的差异。
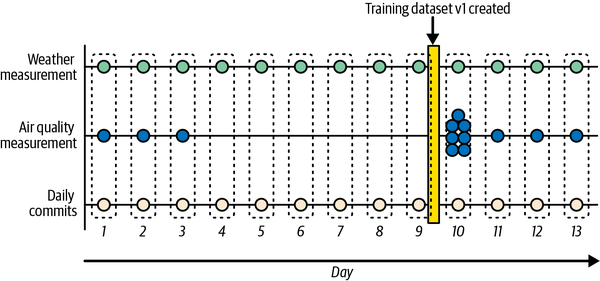
每天的天气更新都到了,但在第 10 天,我们收到了缺失的六天空气质量测量数据。它们迟到了。这六个迟到到达的 event_time 值对应第 4 天到第 9 天,这很合理,因为 event_time 指的是进行空气质量测量的那一天。然而,这些迟到数据的摄取时间是第 10 天——所以事件时间与摄取时间不匹配。在真实世界的系统中,数据迟到是常态,系统需要为此进行设计。
如果你在第 9 天读取特征组,它将不包含第 4 天到第 9 天的任何空气质量测量数据,但如果你在第 10 天读取它,它将包含第 4 天到第 10 天的测量数据。然而,训练数据集 v1 是在第 9 天创建的,它不包含第 4 天到第 9 天的数据。如果我后来删除了训练数据集 v1 但必须重新生成它,我希望它与原始数据集完全相同(合规性会要求这一点)。我不希望它包含第 4 天到第 9 天的空气质量数据。然而,如果我仅使用基于事件时间的查询来重新生成训练数据集,它将包含第 4 天到第 9 天的数据。解决方案是使用摄取时间来重新创建训练数据集 v1,使其与第 9 天创建时完全一致。幸运的是,当你调用特征视图的任何方法来使用其版本号重新创建训练数据时,Hopsworks 会为你透明地完成这一点,例如:
X, y = feature_view.get_train_test_split(training_dataset_version=1)
注意
我们已经在不同的上下文中两次看到术语 ASOF。当你重新创建训练数据集时,你想要包含特征数据在摄取时间 ASOF 的状态(即该时间点存在的特征数据)。但是当你创建时间点正确(point-in-time correct)的训练数据时,你想要特征在事件时间 ASOF 的值,因为你想要包含该特征在那个时间点的正确值。
特征组版本控制
数据版本控制只关心特征组中行的更改。但是,如果你想添加、移除或更新特征组中的特征呢?你可以按如下方式向特征组添加新特征,特征组的现有客户端将像以前一样工作:
features = [
    Feature(name="limit", type="int", default_value=1000)
]
fg = fs.get_feature_group(name="cc_trans_fg", version=1)
fg.append_features(features)
然而,如果你想更改特征的数据类型或从特征组中删除特征,那么你就是在进行破坏性模式更改(breaking schema change)。特征组的现有客户端将无法工作,因为它们期望的一个或多个特征要么数据类型错误,要么不存在。另一个不那么明显的破坏性更改是改变特征的计算方式。你不应该在特征组的同一个特征中混合旧特征值和新特征值。这不会破坏客户端,但你在混合特征数据上训练的任何模型可能表现不佳。
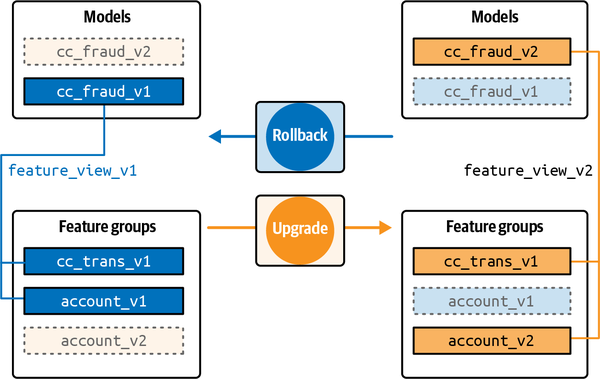
破坏性(模式)更改的解决方案是创建带有新特征的特征组新版本。例如,在图5-7中,cc_fraud_v1 模型被升级为 cc_fraud_v2,它使用账户特征组的新版本 v2。当一个模型依赖特征组提供预计算特征时,模型和特征版本紧密耦合,需要同步升级和回滚模型/特征版本。
图示说明 cc_fraud 模型与账户特征组 v1 和 v2 之间的升级和回滚过程,突出显示模型与特征组之间的依赖关系。
当你创建新的特征组版本时,会创建新的离线/在线表,所以你需要用旧特征组版本的数据回填(backfill)新特征组版本。离线/在线存储中的后备表(backing table)名称是 < feature_group_name >__< version >。
当一个特征组有大量数据时,你可能希望避免创建新版本的特征组,因为回填成本很高。有时,你可以继续追加新特征,把旧特征版本留在特征组中。这也可能很昂贵,因为追加新特征需要用 default_value 更新表中的所有现有行。例如,假设你有一个数百列、存储数十 TB 数据的特征组,但你只想改变一列的计算方式。你不想创建新版本的特征组并回填整个特征组。你也不想追加新特征,因为那需要更新特征组中的所有行,加入新列及其默认值——在湖仓表中,这可能需要重写所有数据文件。相反,你可以创建一个名称不同、但主键和事件时间与原始特征组相同的新特征组(参见图5-8)。你需要为该特征组回填新列,但这将比回填数百列便宜得多。
图示说明了在一个新特征组中,“limit” 特征从数值型转换为类别型的过程,并展示它如何影响特征视图和模型版本。
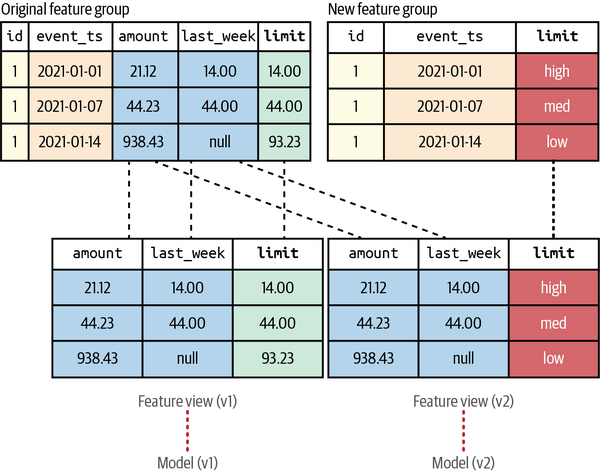
来自图5-8的新特征,是我们新特征组中的一个类别型 limit 特征,我们将从稀疏的 limit 特征计算得出。你需要编写一个转换函数,把数值型 limit 值转换为类别值(high、med 或 low)。该转换函数可用于用原始特征组的所有值回填新特征组,并且它也应该包含在更新新特征组的特征管道中。
现在,假设我们有一个模型 v1,我们想把它更新到 v2,以使用新的类别型 limit 特征而不是数值型 limit。我们可以做的是创建一个新的特征视图 v2,用新的类别型 limit 替换旧的数值型 limit,但保留特征视图 v1 的所有其他特征。创建特征视图是纯元数据操作,所以很便宜。新的特征视图现在可以创建新的训练数据并训练模型 v2。
现在假设你有一个使用旧特征的生产模型,你想部署一个使用新版本特征的新模型版本。对于新模型,你创建一个新的特征视图,它使用前一个模型特征视图的所有特征,用新特征替换旧特征。当你从新特征视图读取训练/推理数据时,它将把原始特征(不包括你正在替换的特征)与你的新版本特征连接起来。
在线存储
当你创建特征组时,你必须决定特征数据是否存储在在线存储中。默认情况下,不会在在线存储中创建表。要启用在线存储,你必须在创建特征组时指定 online_enabled=True。相比之下,离线存储中总是会创建表。如果特征数据将被交互式或实时 ML 系统读取,你应该让特征组 online_enabled。如果特征数据只被批处理 ML 系统使用,那么不要让它 online_enabled,因为它会增加数据存储和更新的成本。如果你想要一个仅在线的特征组,离线存储中没有数据,那么你可以指定写入不应物化(materialize)到离线存储:
fg.insert(df,
    write_options={"start_offline_materialization":False}
)
Hopsworks 将在线特征数据存储在内存中或磁盘列(on-disk columns)中。默认情况下,它使用内存表(in-memory tables),与磁盘列相比,内存表具有更低的延迟和更高的吞吐量。然而,内存表需要足够的 RAM 来存储数据,当你的特征组将存储数十 TB 的在线数据时,使用磁盘表可能更具成本效益。你可以在创建特征组时指定在线特征数据将存储在磁盘上(online_disk=True),如下所示:
fs.create_feature_group(
    ...
    online_enabled=True,
    online_disk=True
)
代码还展示了如何在 RonDB 中为磁盘表配置 table_space——你在 RonDB 的 table space 中为磁盘数据分配存储空间。
RonDB 在线特征存储
Hopsworks 的在线存储是 RonDB,一个开源、分布式、实时数据库,同时具有键值(key-value)和 SQL API。它可以配置为在数据中心内高可用(基于两阶段提交协议的非阻塞变体的复制),也可以跨地理分离的数据中心高可用(使用异步复制)。RonDB 可以扩展为存储数十 TB 的内存表,或者把特征列存储为磁盘列。主键和索引存储在内存中。RonDB 被设计为支持特征存储工作负载,支持投影下推(projection pushdown)、谓词下推(predicate pushdown)、下推聚合(pushdown aggregations)、复合主键和下推左连接(pushdown left joins)。关于这些能力对性能影响的进一步阅读,我推荐我们在 SIGMOD 2024 上的研究论文。
生存时间(Time to live)
默认情况下,event_time 列不包含在在线表中,在线表只为每个实体存储最新的特征值。当你为某个实体写入新的特征数据时,包含该实体特征数据的行会被覆盖。这使你的在线表大小与表中的实体数量挂钩。
然而,如果你有数亿个实体,并且特征数据在一段时间后对某个实体变得过时怎么办?或者,如果你想对某个实体执行在线聚合怎么办?那么你将需要把 event_time 列包含在在线表中,以便能够为每个实体存储多行。在这两种情况下,你都应该为行指定一个生存时间(time-to-live,TTL)值,当行超过在特征组上定义的指定 TTL 时,它们会从数据库中被移除。例如,如果 TTL 是一小时,那么在一行的 event_time 过去一小时之后,该行将被安排删除。你可以在创建 online_enabled 特征组时,以分钟级粒度定义 TTL:
ttl=timedelta(days=7)
fs.create_feature_group( ...
    ttl=ttl
)
当你为 ttl 设置值时,ttl_enabled 会被设置为 True,并且实体 ID 的主键约束会被移除。也就是说,与离线存储一样,每行由主键(实体 ID)和 event_time 的组合唯一标识。TTL 过期是一个后台进程,过期的行通常会在过期后 15 分钟内被删除,尽管在数据库负载较高的情况下,可能需要稍长的时间。
处理由 TTL 引起的潜在数据泄漏(data leakage)非常重要。当你创建训练数据时,如果 label.event_time 是 01:00,而该标签的 feature.event_time 是 00:15,但 TTL 是 30 分钟,会发生什么?你不应该包含该特征值;否则会有泄漏。原因是在线存储会在 00:45 移除该特征行,即其 TTL 过期时。当标签事件在 01:00 到达时,将没有特征值可检索。这是一种微妙但有害的数据泄漏形式,Hopsworks 通过向查询添加回看窗口(lookback window)来防止它。这里的一般规则是,当你使用带 TTL 的特征组中的特征创建训练数据时,如果以下条件成立,特征值将为 null:
label.event_time - feature.event_time > TTL
向量索引
向量嵌入使 online_enabled 特征组中的行能够进行近似最近邻(approximate nearest neighbor,ANN)搜索(也称为相似性搜索)。你通过获取高维数据(如文本、图像或混合数据)并将其传递给嵌入模型(embedding model)来创建向量嵌入,嵌入模型然后把输入数据压缩成一个固定大小的浮点数数组。向量嵌入就是输出的浮点数数组,令人惊讶的是,即使在压缩之后,它仍然保留了关于原始输入数据的语义信息。你可以获取数百万张图像或整本书的文本(按段落拆分),从中计算向量嵌入,然后输入一张新图像或一段新文本,ANN 搜索将找到与新数据最接近的图像或文本段落。尽管这是概率匹配,但它们的效果非常好。
要把向量嵌入添加到特征组中,你指定 DataFrame 中的哪些列包含向量嵌入。列值随后被插入到向量索引中,这样你就可以在特征组上调用 find_neighbors() 来查找具有相似值的行。然而,在把行插入嵌入特征组(embedding feature group)之前,你首先需要使用嵌入模型为列计算向量嵌入。有许多现成的嵌入模型可以使用,例如下面示例中的 sentence transformers 模型。你也可以训练自己的嵌入模型。
特征组中的向量索引
当你设计一个包含嵌入特征组的数据模型时,你应该知道,向向量索引写入行比向在线特征存储写入要慢得多。在线特征存储支持每秒数百万次并发写入,而向量索引要慢几个数量级。如果一个嵌入特征组中有非向量嵌入列,其更新频率高于向量嵌入列,你可能应该重构你的特征组,把频繁更新的列移到一个单独的特征组。
我们现在来看我们的信用卡交易欺诈系统示例,以及我们如何添加向量嵌入支持。假设你正在对欺诈交易做一些 EDA(探索性数据分析),并且想找到与标记为欺诈的行最相似的行。这很难,因为可能有数万行甚至更多的欺诈交易。cc_fraud 表(在 Postgres 中)包含欺诈标签,还有一个名为 explanation 的字符串列。该列包含人工撰写的关于该交易被标记为欺诈原因的描述。你可以把 cc_fraud 表中的数据作为一个新的特征组(cc_fraud_fg)添加进来,以使用 explanation 对欺诈交易进行相似性搜索。然后你可以运行以下代码,从一个外部特征组读取源数据(用于 cc_fraud),并使用一个开源的 sentence-transformers(嵌入)模型创建向量嵌入,把 explanation 映射到一个 384 维数组。向量嵌入作为列存储在 cc_fraud_fg 中:
from sentence_transformers import SentenceTransformer
model = SentenceTransformer('all-MiniLM-L6-v2')

df = cc_fraud.read()
embedding_body = model.encode(df['explanation'])

df['embed_explanation'] = pd.Series(embedding_body.tolist())
emb = embedding.EmbeddingIndex()
emb.add_embedding('explanation', model.get_sentence_embedding_dimension())

cc_fraud_fg = fs.create_feature_group(
    name="cc_fraud_fg",
    version=1,
    description="Credit Card Fraud Data",
    primary_key=['tid'],
    event_time='datetime',
    embedding=emb
)
cc_fraud_fg.insert(df)
然后你可以在 cc_fraud_fg 上执行相似性搜索,把向量嵌入传递给特征组的 find_neighbor() 方法:
model = SentenceTransformer('all-MiniLM-L6-v2')
search_query = "Geographic attack in South Carolina"
cc_fraud_fg.find_neighbors(model.encode(search_query), k=3)
前面的代码将返回特征组中 explanation 列值与搜索字符串 “Geographic attack in South Carolina” 最相似的三行。
离线存储(湖仓表)
Hopsworks 的离线存储是湖仓表。Hopsworks 支持三种不同类型的湖仓表,每种都有自己的优势:Apache Iceberg、Apache Hudi 和 Delta Lake。所有三种格式都支持时间旅行,但 Hopsworks 还利用了其他属性:
- 主键唯一性
- 由 Hudi 强制保证,但 Iceberg 或 Delta 不强制。
- 数据跳过
- 所有三种文件格式都支持 Hive 风格分区,但此外还有 Z-ordering(Hudi、Delta)、液滴聚类(liquid clustering,Delta)和希尔伯特空间填充曲线(Hilbert space-filling curves,Hudi)。
- Read_changes
- 文件格式支持 CDC 查询(变更数据捕获查询),尽管完整支持要到 Iceberg v3 才会到来。
Delta 和 Iceberg 不强制主键的唯一性约束,这意味着当你创建训练数据时会有重复行。ASOF LEFT JOIN(第4章中用于创建训练数据的连接方式)把特征连接到标签上,如果在被连接的特征组中有多行匹配,那么你的标签特征组中的每一行都会得到多行输出。这不是期望的行为,因为一个特征对于给定的标签应该只有一个值。
外部特征组
如果你在数据仓库或对象存储中已经有包含特征数据的现有表,你可以从这些表创建外部特征组。在外部特征组中,离线表就是外部数据存储或数据仓库(如 S3、Snowflake、BigQuery、Redshift,或任何与 Java 数据库连接 [JDBC] 兼容的数据库)。Hopsworks 中不会存储离线数据;只会在那里存储元数据。例如,我们信用卡数据集市(data mart)中的所有表(credit_card_transactions、card_details、merchant_details、account_details、bank_details)都可以创建为外部特征组,从而很容易把它们用作特征管道的数据源。
外部特征组首先需要为你的外部存储提供一个数据源(data source)。外部特征组与普通特征组可以互换使用——你可以为它们读取特征数据,在特征视图中使用它们,等等。通常,你在 Hopsworks UI 中创建外部特征组,在那里你可以输入数据源的连接详细信息,然后在 LLM 的帮助下选择你想要包含的外部表。你也可以通过 API 调用创建外部特征组。在这里,我们展示如何把 account_fg 定义为外部特征组,假设你已经创建了 Snowflake 数据源对象:
data_source = fs.get_data_source("my_snowflake")
external_fg = fs.create_external_feature_group(
            name="sales",
            version=1,
            description="Physical shop sales features",
            primary_key=['account_id'],
            event_time='event_time',
            data_source=data_source
            ).save()
如果你的外部特征组是 online_enabled 的,你需要安排一个作业,把数据从离线存储同步到在线存储。
数据统计
当你向离线特征组写入数据时,默认情况下,Hopsworks 会计算并保存特征的描述性统计(descriptive statistics)。统计数据既用于 EDA,也用于特征漂移(feature drift)监控(参见第14章)。Hopsworks 可以为类别变量计算直方图(histograms)(每个类别的计数)、特征的相关矩阵(correlation matrix)(帮助识别可以移除的冗余特征)、数值特征的描述性统计(最小值、最大值、均值、标准差),以及通过 exact_uniqueness 计算特征的稀疏性(值越接近 1 表示唯一值越多)。你在 statistics_config 字典的 columns 参数中提供你想计算统计的特征列表:
fg_cc = feature_store.create_feature_group(name="cc_trans_fg",
    statistics_config={
        "enabled": True,
        "histograms": True,
        "correlations": True,
        "exact_uniqueness": False,
        "columns": ["feature1"]
    }
)
fg_cc.compute_statistics()
请注意,计算统计信息是昂贵的,特别是当它们在大量数据上计算时。
特征组的变更数据捕获
有时,通过在特征组中的行发生变化时执行操作来构建事件驱动的 ML 系统是很有用的。一个用例是当你拥有大量实体,并且想在实体的特征值发生变化后对它们进行预测。你可以通过为特征组提供一个 Kafka topic 来启用特征组的变更数据捕获(change data capture,CDC)API:
kafka_api = project.get_kafka_api()
my_schema = kafka_api.create_schema(SCHEMA_NAME, schema)
my_topic = kafka_api.create_topic(
    TOPIC_NAME, SCHEMA_NAME, 1, replicas=3, partitions=8
)

fg_cc_ags = feature_store.create_feature_group(name="cc_trans_fg",
    notification_topic_name=TOPIC_NAME,
)
在 cc_trans_fg 特征组中更新的行会被发布到 Kafka topic(TOPIC_NAME),变更的消费者可以订阅该 Kafka topic 来消费被更新的行。
特征视图
正如第4章中介绍的,特征视图通过把模型的接口定义为输入特征和输出标签/目标的列表,弥合了特征组和模型之间的差距。创建和使用特征视图的主要步骤是:
- 选择你的模型将使用的特征和标签/目标
- 定义你想对特征执行的任何 MDT(模型依赖转换)
- 从你的特征选择和 MDT 创建特征视图
特征视图的主要用例是:
- 为你的模型创建训练数据
- 为你的模型创建批处理推理数据
- 为你的模型创建在线推理数据
我们将使用信用卡欺诈示例,并使用特征视图为我们的模型创建训练和推理数据。
特征选择
当你想创建模型时,你将需要从特征组中选择模型将使用的列,以及 AI 系统需要的列——例如,用于日志记录或与外部系统交互。许多被选中的列将是模型的特征和标签/目标,但你可能还需要用于训练和推理管道的辅助列(helper columns)。你可以通过从特征组中选择和连接列来创建特征视图,无论特征组是按星型模式(star schema)还是雪花模式(snowflake schema)数据模型组织的。
创建特征视图时,你首先要为特征视图确定标签特征组(label feature group)。每个特征视图至多有一个包含标签的标签特征组。如果你想用标签特征组连接特征,你的标签特征组需要有一个指向包含这些特征的特征组的外键。在第10章中,我们将研究如何向标签特征组添加外键,但就目前而言,我们假设这些外键已经存在。任何与标签特征组连接的特征组,反过来也可以有指向其他特征组的外键,这些特征组也可以包含在特征选择中。你也可以创建没有标签的特征视图,用于无监督学习,在这种情况下,标签特征组只是特征选择语句中的根特征组(root feature group)。
在我们的信用卡欺诈雪花数据模型中,cc_trans_fg 中的 cc_num 是指向 cc_trans_aggs_fg 的外键。类似地,cc_trans_fg 中的 merchant_id 是指向 merchant_fg 的外键。我们还可以传递性地包含来自 bank_fg 和 account_fg 的特征,因为它们的主键是 cc_trans_aggs_fg 中的外键。我们首先获取这些特征组的引用:
labels = fs.get_feature_group("cc_trans_fg", version=1)
aggs = fs.get_feature_group("cc_trans_aggs_fg", version=1)
merchant = fs.get_feature_group("merchant_fg", version=1)
bank = fs.get_feature_group("bank_fg", version=1)
account = fs.get_feature_group("account_fg", version=1)
你通过调用特征组上的一个 select 方法来指定要连接哪些特征:
- select_features()
- 选择所有特征列(不包括索引列和外键)
- select_all()
- 选择所有列(包括索引列和外键)
- select_except([‘f1’, ‘f2’, …])
- 选择除提供列表中的列之外的所有列
- select([‘f1’, ‘f2’, …])
- 只选择提供列表中的列
select 方法返回一个表示特征选择的 Query 对象。你可以使用 Query 对象读取特征数据,添加过滤器以读取特征数据的子集,检查用于读取特征数据的查询字符串,最重要的是,可以在其上调用 join() 与其他 Query 对象(表示从其他特征组选择的特征)连接。以下是用于创建信用卡欺诈模型中使用的特征(和标签)选择的 select 和 join 方法:
aggs_subtree = aggs.select_features()
.join(bank.select_features())
.join(account.select_features())

selection = labels.select_features()
.join(merchant.select_features())
.join(aggs_subtree)
在前面的代码中,我们没有显式指定任何连接键。Hopsworks 会在左侧特征组中查找与右侧(被连接)特征组主键具有相同名称和类型的列。如果没有匹配,你必须显式定义连接键。例如,如果 account_fg 的主键是 id(而不是 account_id),你将不得不按如下方式构造连接:
aggs.select_features().join(bank.select_features(),
left_on=["account_id"], right_on=["id"])
如果左侧和右侧特征组之间的特征名称发生冲突(也就是说,如果两个特征组都有一个同名的特征),那么在 join 方法中,你可以使用 prefix="abc_" 参数为右侧特征组的特征名称添加前缀。
模型依赖转换
在 Hopsworks 中,你可以声明性地把转换函数(transformation function)附加到特征视图中任何被选中的特征上。转换函数在客户端使用特征视图从特征存储读取数据后执行。由于特征视图只在训练和推理管道中使用,这些转换函数就是 MDT。你可以使用内置转换(如 min_max_scaler),也可以定义你自己的自定义转换函数,例如:
from hopsworks.transformation_statistics import TransformationStatistics

@hopsworks.udf(float)
def f1(amount, days_until_expired, stats: TransformationStatistics):
    return (amount * days_until_expired) / stats.amount.mean
在这个示例中,我们可以看到转换函数由 TransformationStatistics 对象参数化,该对象包含在训练数据集上计算的特征统计信息。TransformationStatistics 对象来自特征视图拥有的训练数据集对象——要么是特征视图在训练管道中创建的训练数据集,要么是特征视图在推理管道中用训练数据集对象初始化的。
在这个自定义转换中,我们使用来自训练数据集的 amount 的 mean(均值)。转换函数既可以定义为 Python 用户定义函数(user-defined functions,UDF),也可以定义为 Pandas UDF。Pandas UDF 可以扩展到处理大量数据(例如,在 PySpark 训练数据集管道中),但它们会在在线推理管道中增加少量延迟。相比之下,Python UDF 在数据量增加时扩展性差,但它们在在线推理管道中具有更低的延迟。
创建特征视图
一旦你选择了特征并定义了 MDT,你可以按如下方式创建特征视图:
feature_view = fs.create_feature_view(
    name='cc_fraud',
    query=selection,
    labels=["is_fraud"],
    transformation_functions = [ min_max_scaler("amount") ],
    inference_helper_columns=['cc_expiry_date','prev_loc_transaction',
'prev_ts_transaction']
)
你通常为一个模型或一族相关模型创建一个特征视图。例如,如果你有面向不同地理区域客户的模型,你可以使用同一个特征视图来表示所有客户的模型,然后在创建训练数据或批处理推理数据时应用过滤器,只返回模型地理区域的数据:
feature_view.training_data(extra_filter = account.region=="Europe")
当你使用一个或多个过滤器创建训练数据时,这些过滤器会作为元数据存储在训练数据集对象中。当你从已用同一个训练数据集对象初始化的特征视图读取批处理推理数据时,模型将应用相同的过滤器。此外,如果你仅使用元数据和特征视图重新生成训练数据,过滤器将被重新应用。
特征视图没有主键;相反,它有服务键(serving keys)。当你使用特征视图通过在线 API 检索一行或多行特征(称为特征向量,feature vectors)时,你必须提供服务键的值。服务键是特征视图的标签特征组中的外键。在我们的信用卡欺诈示例中,来自 cc_trans_fg 的服务键是 cc_num 和 merchant_id,因为这两个外键都用于创建我们的特征视图。你可以按如下方式检查特征视图的服务键:
print(feature_view.serving_keys)
创建特征视图时可以提供的其他参数是 training_helper_columns 和 inference_helper_columns。有时,在训练或推理期间,你需要不会用作特征的辅助列。例如,辅助列可以用作转换函数的输入,但它们本身不会是特征。在我们的信用卡欺诈系统中,我们定义了三列作为 inference_helper_columns,因为它们都被用作计算按需特征(on-demand feature)的转换函数中的参数:haversine_distance、time_since_last_trans 和 days_to_card_expiry。当你使用特征视图读取在线推理数据时,你将收到这些列,然后用它们计算按需特征(它们是转换函数的参数)。然而,调用 model.predict() 时你不会把它们作为输入参数。当你使用同一个特征视图读取训练数据(fv.training_data())时,它不会返回 inference_helper_columns,因为它们只在推理时需要(训练管道中没有 ODT 函数)。类似地,training_helper_columns 在创建训练数据时返回,但读取(批处理或在线)推理数据时不返回。
训练数据:DataFrame 或文件
使用你的特征视图,你可以把训练数据读取为 Pandas DataFrame,或者把训练数据创建为文件(参见表5-3)。
| 特征视图方法 | 输出 | 使用时机 |
|---|---|---|
fv.train_test_split(...) fv.training_data(...) | 使用 Arrow Flight 的 Pandas DataFrame | 表格数据 < 1-10 GB Scikit-Learn 或 XGBoost |
fv.create_train_test_split(...) fv.create_training_data(...) | S3 或 HopsFS 中的 Parquet 或 CSV 文件形式的训练数据 | 表格数据 > 1-10 GB PyTorch 或 TensorFlow |
假设你的 Python 程序中有足够的内存,并且你的训练数据小于 10 GB,你可以直接把训练数据读取到 Pandas DataFrame 中。然而,如果你的训练数据更大(TB 级甚至 PB 级),你可以运行一个训练数据集管道程序,创建训练数据并将其保存为输出文件系统(如 S3 或 Hopsworks 上的 HopsFS)中的文件。读取、连接和保存训练数据集文件的代码在 PySpark 中运行。你可以直接在 PySpark 程序中运行它,但如果你从 Python 程序把训练数据创建为文件,它将以你的名义在 Hopsworks 上启动一个 Spark 作业。把训练数据创建为 DataFrame 或文件的方法有两个版本:training_data() 版本输出特征和标签,train_test_split() 版本使用随机或时序切分(time-series split)把训练数据切分为训练集和测试集。
随机、时序和分层切分
你可以读取训练数据,使用随机切分(random split)把特征(X_)和标签(y_)切分为训练集和测试集,如下所示:
X_train, X_test, y_train, y_test = fv.train_test_split(test_size=0.2)
前面的示例给你 80% 的数据在训练集(X_train、y_train)中,20% 在测试集(X_test、y_test)中。有时,除了训练集和测试集之外,你还需要一个验证集(validation set)。例如,如果你想进行超参数调优(hyperparameter tuning),你不应该使用测试集来评估模型性能(否则测试集可能泄漏到模型训练中)。相反,你可以创建一个额外的验证集,在验证集上评估使用不同超参数的训练运行:
X_train, X_validation, X_test, y_train, y_validation, y_test = \
    fv.train_validation_test_split(validation_size=0.15, test_size=0.15)
在这种情况下,测试集是用于在超参数调优完成后评估最终模型性能的留出集(holdout set)。
同样的 train_test_split 和 train_validation_test_split 函数也可以返回训练数据的时序切分。作为一条规则,你永远不应该对时序数据创建随机切分——因为时间模式和趋势会在随机化中丢失。相反,为你的训练、验证和测试集分别指定时间范围。在下面的示例代码中,训练集时间窗口是 2024 年 1 月 1 日到 31 日,测试数据是 2024 年 2 月 1 日到 7 日之间到达的数据:
X_train, X_test, y_train, y_test = \
    fv.train_test_split(start_train_time="20240101", end_train_time="20240131",\
        start_test_time="20240201", end_test_time="20240207")
如果你省略 start_test_time,测试集将从 end_train_time 之后开始。此外,如果你省略 end_test_time,测试集将包含 2024 年 2 月 1 日之后到达的所有数据。
有时,你需要一种比随机或时序切分更复杂的方式来切分训练数据。例如,在预测信用卡欺诈时,你可以训练一个二分类器,但正类(欺诈)与负类(非欺诈)相比严重不足。不平衡比率(imbalance ratio)可能是几千比一或更高。当你把数据切分为训练集和测试集时,存在正负类比率不相同的很高风险,这将导致模型性能评估不佳,因为训练集和测试集中的标签分布不相同。
在这种情况下,一般来说,如果你的数据集不平衡,你应该使用分层切分(stratified split)。为此,你应该把训练数据读取为单个 DataFrame,然后在需要时使用合适的库(如 scikit-learn)自己实现分层切分:
training_data = fv.training_data()
# apply custom splits into training and test/validation sets
警告
当类别分布偏斜时,监督学习效果不佳。对于二分类器,你应该对一个类别进行上采样(upsample)或下采样(downsample),以改善类别之间的平衡。在 Python 中,imbalance 库被广泛用于上采样/下采样。如果不平衡程度过高,你可能需要考虑替代技术,例如使用无监督学习的异常检测(anomaly detection),而不是二分类器。
可复现的训练数据
当你把训练数据读取为 DataFrame 或把训练数据创建为文件时,Hopsworks 会存储所创建训练数据的元数据,包括使用的特征视图、创建训练数据时使用的任何过滤器、训练数据集 ID、任何随机数种子(random number seed),以及读取训练数据所依据的特征组的提交 ID。这样,你可以删除训练数据,而 Hopsworks 仍然可以仅使用训练数据集 ID 精确地重新生成该训练数据:
X_train, X_test, y_train, y_test = fv.get_train_test_split(training_data_id=111)
有时,由于存储成本或合规原因(如你公司的数据保留策略),你需要删除训练数据集。在这些情况下,精确重新创建训练数据的能力很重要。
实验跟踪与可复现的训练数据
数据科学一直渴望成为一门科学而非工程,强调可复现性(reproducibility)和可复制性(replicability),因为它们是科学方法的基石。这导致了实验跟踪(experiment tracking)平台的流行,这些平台存储训练运行中的超参数,从而可以使用实验跟踪元数据重新生成模型。可复现的训练数据受到的关注相对较少,但现在借助特征存储已经可以实现,并且随着 AI 监管的到来,它应该会变得越来越重要。
批处理推理数据
你可以使用特征视图从离线存储读取批量推理数据。批处理推理管道中一个流行的用例是读取自上次批处理推理管道运行以来到达的所有新数据:
last_run_timestamp = "2024-05-10 00:01"
fv = fs.get_feature_view(...)
fv.init_batch_scoring(training_data_version=1)
df = fv.get_batch_data(start_time=last_run_timestamp)
df["prediction"] = model.predict(df)
fv.log(df)
在这里,我们在特征视图上调用 init_batch_scoring,告诉它如果必须计算 MDT,要使用哪个训练数据集版本。在第11章中,我们将看到,你通常会跳过从模型注册表中与模型一起获取预初始化的特征视图对象。这避免了用于训练模型的训练数据版本与这里批处理推理管道中使用的版本之间潜在的偏差(skew)。在获得正确初始化的特征视图之后,我们从特征存储中读取一个 Pandas DataFrame df,其中包含在 last_run_timestamp 之后到达的转换后的输入特征数据。最后,我们用模型对 df 进行预测(假设模型可以把 Pandas DataFrame 作为输入,这对于 XGBoost 和 Scikit-Learn 模型是可能的)。你还可以使用 fv.log(df) 记录预测和特征值。
有时,在读取批处理推理数据时你需要更多的灵活性。例如,想象你想用特征视图读取所有实体的最新特征数据(如所有信用卡的最新交易和欺诈特征)。为此,你可以使用 Spine 组(Spine Group)。一个Spine 组包含用于为特征视图读取特征的服务键行,以及每个服务键的时间戳值。它被称为 spine(脊柱),因为它是围绕其构建训练数据或批处理推理数据的结构。Spine 组只在批处理推理中使用——它们不用于在线推理。Spine 组只能是特征视图中的标签(或根)特征组。你可以按如下方式定义 Spine 组:
trans_spine = fs.get_or_create_spine_group(
    name="cc_trans_spine_fg",
    ...
    dataframe=trans_df
)
注意,你必须包含一个 DataFrame trans_df 来提供特征组的模式。Spine 组本身不会向特征存储物化任何数据,检索训练或批处理推理的特征时总是需要提供其数据。你可以把它想象成一个临时特征组,在从中读取数据时被一个 DataFrame 替换。当你想用包含 Spine 组作为标签特征组的特征视图创建训练数据时,你可以这样做:
df = # (serving keys, timestamp for label values)
X_train, X_test, y_train, y_test =
feature_view.train_test_split(0.2, spine=df)
类似地,对于批处理推理,你可以按如下方式读取推理数据:
input_df = # (serving keys, timestamp for feature values)
output_df = feature_view.get_batch_data(spine=input_df)
predictions = model.predict(output_df)
如果可能避免使用 Spine 组,你应该避免,因为它们增加了复杂性,并把构建训练数据集和批处理推理数据的大量工作外化到客户端。
在线推理数据
特征视图也用于以低延迟从在线存储检索特征行。在我们的欺诈示例中,get_feature_vector() 方法调用为给定的信用卡号(服务键)检索一行预计算特征:
feature_vector = feature_view.get_feature_vector(entry={"cc_num":
"1234", "merchant_id": 4321}, return_type = "pandas")
结果(特征向量)以 Pandas DataFrame 的形式返回,但你也可以读取 NumPy 数组或列表类型(这是默认值)。还有一个检索多行的此方法版本,叫做 get_feature_vectors,其中 entry 参数是服务键的列表。
前面介绍的转换函数也可以用来定义 ODT(按需转换)函数。例如,按需的 days_to_card_expiry 特征可以按如下方式计算:
@hopsworks.udf(int, mode="python", drop=["expiry_date"])
def days_to_card_expiry(expiry_date):
    return (datetime.today().date() - expiry_date.date()).days
你需要在特征组上注册 ODT(参见第7章)。你在在线推理管道中按如下方式调用这个转换函数:
feature_vector = feature_view.get_feature_vector(\
    entry={"cc_num": "1234", "merchant_id": 4321}, return_type = "pandas")

cc_expiry = days_to_card_expiry(feature_vector["expiry_date"])
feature_vector = feature_vector.drop(columns=["expiry_date"])
prediction = model.predict(feature_vector)
注意,当你调用 feature_view.get_feature_vector() 时,expiry_date 不会被检索,因为它是一个推理辅助列。推理辅助列可以通过使用相同的服务键调用 feature_view.inference_helpers() 来检索。在第11章中,我们将把所有在线推理步骤整合在一起,包括 MDT、记录预测/特征值,以及监控特征/模型。
特征数据的更快查询
我们以如何用过滤器读取特征数据来结束本章。当读取特征数据的子集时,应用过滤器可以带来巨大的性能提升。例如,在离线存储中,当数据量很大时,如果你先把大量数据读入(Pandas 或 PySpark)DataFrame,然后删除你不需要的列和行,你将招致巨大的开销。它要么非常慢,要么可能因内存不足错误而无法工作。数据跳过(减少查询中读取的数据量)的两种主要技术是:
- 投影下推
- 只读取你请求的列。
- 下推过滤器
- 只读取你提供的过滤器值对应的数据。这包括分区剪枝和谓词下推。
当你读取特征组中特征的子集,并且只把那些特征的数据返回给客户端时,这被称为投影下推。Hopsworks 开箱即用地支持投影下推。当你定义一个只使用特征组中部分特征的特征视图时,使用该特征视图的读取将以投影下推方式读取。Hopsworks 的在线特征存储(RonDB)和离线存储(湖仓表)都支持投影下推。没有投影下推的在线存储——例如 Redis——要求客户端读取特征组中的所有列,并且只在客户端中过滤掉它不需要的数据。投影下推特别需要用于以下情况:你有一个包含许多列的宽特征组,并且这些列的一个子集被许多不同的模型使用。
当你使用特征视图读取训练或批处理推理数据时,你可以提供如下过滤器:
X_features, y_labels = fv.training_data(extra_filter=fg.date=="2024-01-10")
你也可以使用过滤器直接从特征组读取数据:
df = fg.filter(fg.date > "2024-01-10").read()
当你的特征视图包含来自多个特征组的特征时,你可以链式使用过滤器,这些过滤器都可能被下推到支撑的特征组。例如,假设我们有一个包含来自两个特征组特征的特征视图。第一个特征组按 date 列分区,第二个按 country 列分区。在这种情况下,我们链式调用过滤器函数。在下面的特征视图查询中,我们使用一个 Feature 对象来标识要过滤的特征:
df = fv.training_data( extra_filter =
    ( Feature("date")=="2024-01-10" and Feature("country") == "Ireland")
)
我们之前已经介绍了分区,但我们没有介绍如何为多列分区键编写过滤查询。例如,如果你把两列定义为分区键,列的顺序很重要。如果你有 ['date', 'country'] 作为分区键,一个为给定日期(最左侧列)过滤的查询将跳过读取不包含该日期值的行对应的文件。然而,它将返回该 date 的所有国家/地区的数据。但是,如果你只按 country 过滤而不按 date 过滤,分区剪枝将不起作用。那是因为分区剪枝遵循你的分区键顺序:它只能基于第一个键(date)剪枝,而不能基于第二个键(country),除非第一个键也被指定。
另一种可以减少读取数据量的下推谓词需要底层表上有索引。在 Hopsworks 的在线存储中,RonDB 支持在列上定义用户索引。这些是类似 B 树的索引,针对内存布局进行了优化。在 Hopsworks 的离线存储中,Apache Hudi 表支持 Z 序索引(Z-ordered indexes),Delta Lake 支持液滴聚类索引。对于离线查询,Hopsworks 特征查询服务(Feature Query Service)可以利用湖仓表索引在 Parquet 文件级别和行组(row group)级别执行数据跳过。这些索引使用底层湖仓表收集的列级统计信息(例如,Parquet 文件的列最小/最大值)在读取数据时跳过文件,并使用 Parquet 文件元数据中的区域映射(zone maps),使读取器只获取包含查询中提供的参数值的行组。
注意
湖仓表把数据存储为 Parquet 文件。湖仓表可以由数千个 Parquet 文件组成。设计良好的特征管道将确保 Parquet 文件大小均匀且大小合理(几十 MB 到几 GB)。小文件太多会损害查询性能,因为有太多文件需要处理。文件太少或文件大小偏斜会导致查询执行期间数据跳过效率低下。Hopsworks 有表服务(table services),可以定期运行以动态调整文件大小并垃圾回收未使用的文件。
总结与练习
本章探讨了 Hopsworks 特征存储,强调了创建和使用特征组与特征视图的 API 调用。我们首先研究了如何使用 Hopsworks 项目和 RBAC 实现特征数据的访问控制。我们研究了特征组的内部结构:离线存储(湖仓)、在线存储(RonDB)和向量索引。我们研究了如何创建特征视图,并使用它们创建训练数据和推理数据。最后,我们就如何使用过滤器提高特征存储查询的性能给出了一些建议。
以下练习将帮助你学习如何在 Hopsworks 上入门:
- 用 LLM(如 ChatGPT)为两个 CSV 文件创建一些合成数据,其中第二个 CSV 文件的主键也是第一个 CSV 文件中的一列。创建两个特征组,每个 CSV 文件一个。
- 创建一个特征视图,从你创建的两个特征组中选择特征。
- 使用随机切分创建训练数据。
- 在你原始的 CSV 文件中添加一个
event_time列,并确保两个 CSV 文件中都有具有相同连接键值的行。创建两个新的特征组和一个使用两者特征的特征视图。使用特征视图以时序切分创建训练数据。