特征存储
正如我们在前三章中所看到的,数据管理是构建和运维 AI 系统最具挑战性的方面之一。在上一章中,我们使用特征存储(feature store)构建了空气质量预测系统。特征存储存储了特征管道(feature pipeline)的输出,为训练管道提供训练数据,并为批推理管道提供推理数据。特征存储是一个核心数据平台,它为训练和推理存储、管理并提供特征。它还确保训练和推理中使用的特征之间的一致性,并通过提供共享数据层和定义良好的 API 来连接 FTI 管道,从而支持构建模块化的 AI 系统。
在本章中,我们将更深入地探讨特征存储,并回答以下问题:
- 特征存储解决了哪些问题,我什么时候需要它?
- 什么是特征组(feature group),它如何存储数据,我如何向其中写入数据?
- 如何为特征组设计数据模型?
- 如何读取分布在许多特征组中的特征数据用于训练或推理?
我们将了解特征存储是如何由列式存储(columnar store)、行式存储(row-oriented store)和向量索引(vector index)构建的。我们将描述特征存储如何解决与特征复用相关的挑战、如何管理时序数据(time-series data),以及如何防止 FTI 管道之间的偏差(skew)。在本章中,我们还将穿插一个预测信用卡欺诈的实时 ML 系统作为激励性示例。
用于欺诈预测的特征存储
我们首先介绍如何为一个对信用卡交易进行实时欺诈预测的 ML 系统设计特征存储。该系统的 ML 系统卡片如表 4-1所示。
| 动态数据源 | 预测问题 | UI 或 API | 监控 |
|---|---|---|---|
| 信用卡交易到达事件流平台。信用卡、发卡行和商户的详细信息以表的形式存储在数据仓库中。 | 信用卡交易是否被怀疑为欺诈 | 拒绝可疑欺诈交易的实时 API | 对可疑欺诈与实际报告的欺诈进行离线调查 |
我们的 ML 系统的源数据来自一个数据集市(data mart),它由一个数据仓库和一个事件流平台(如 Apache Kafka 或 AWS Kinesis)组成(见图 4-1)。
该图展示了设计特征存储的过程,从数据集市中识别并创建特征开始,将它们组织成特征组,创建特征视图,并生成训练和推理数据。
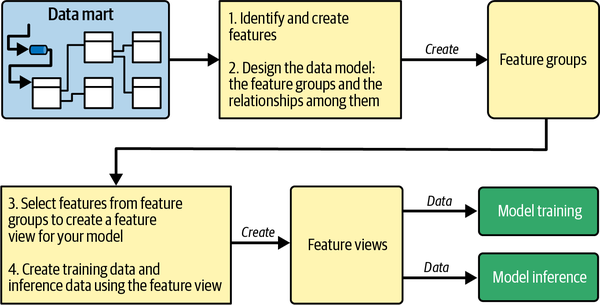
从数据源开始,我们将学习如何通过四个主要步骤构建特征存储:
- 识别实体(entity)以及这些实体的特征。
- 将实体组织成特征表(特征组),并识别特征组之间的关系。
- 在特征视图(feature view)中,为模型选择可能来自不同特征组的特征。
- 使用特征视图检索模型训练以及批/在线推理所需的数据。
本章将更详细地介绍什么是特征组和特征视图,但在此之前,我们先来看看特征存储的历史、特征存储的组成(其解剖结构),以及何时可能需要特征存储。
特征存储简史
如第 1 章所述,Uber 作为其 Michelangelo 平台的一部分引入了第一个特征存储。Michelangelo 包含一个特征存储(称为 Palette)、一个模型注册表(model registry)和模型服务(model serving)能力。Michelangelo 还引入了一种领域特定语言(domain-specific language,DSL)来定义特征管道。在 DSL 中,你可以定义在什么数据源上计算什么类型的特征(例如,使用 clicks 表计算用户在过去七天内的点击次数),Michelangelo 会把你的特征定义转译(transpile)成一个 Spark 程序,并按计划运行它(例如每小时或每天)。
2018 年底,Hopsworks 推出了第一个开源特征存储。Hopsworks 也是第一个基于 API 的特征存储,外部管道使用 DataFrame API 读写特征数据,并且没有内置的管道编排(pipeline orchestration)。基于 API 的特征存储使你能够使用不同的框架/语言(例如 Flink、PySpark 和 Pandas)编写管道。2019 年底,开源Feast 特征存储采用了相同的基于 API 的架构(datasets,数据集)来读写特征数据。如今,GCP、AWS 和 Databricks 的特征存储都遵循基于 API 的架构,而最流行的基于 DSL 的特征存储是 Tecton。在本章的其余部分,我们将描述基于 API 和基于 DSL 的特征存储提供的常见功能,而在下一章中,我们将研究 Hopsworks 特征存储,它是基于 API 的特征存储的代表。
Note
特征平台(feature platform)一词已被用来描述支持托管特征管道的特征存储。大多数特征存储,包括 Hopsworks,根据这个定义也都是特征平台。最后,AI 湖仓(AI lakehouse)是一种特征存储,它使用湖仓(lakehouse)表作为其离线存储,并有一个集成的在线存储来构建实时 ML 系统。
特征存储的解剖结构
特征存储是一个生产并存储特征数据的工厂。它通过管理用于训练和推理的数据的存储和变换,实现更快地生产更高质量的特征,并允许你在任何模型中复用特征。在图 4-2中,我们可以看到特征存储管理的主要输入、输出和数据变换。
该图展示了数据在特征存储中的流动,说明新数据和回填(backfill)数据如何被变换为模型的训练数据、批推理和在线推理数据,数据变换包括与模型无关的、与模型相关的和按需的变换。
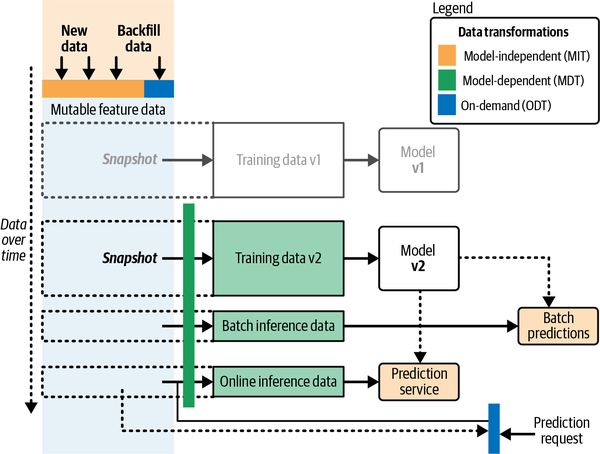
特征管道是为特征存储提供特征数据的程序。它们以新数据或历史数据作为输入,并使用与模型无关的变换(model-independent transformations,MIT)将其变换为可复用的特征数据。按需变换(on-demand transformations,ODT)也可以应用于特征管道中的历史数据。特征管道可以是批处理或流式程序,它们会随时间更新特征数据。也就是说,特征存储存储的是可变(mutable)的特征数据。对于监督式 ML,标签(label)也可以存储在特征存储中,并且在用于创建训练或推理数据之前被视为特征数据,在这种情况下,特征存储知道哪些列是特征、哪些列是标签。
特征存储通过获取特征数据的时间点一致的快照(point-in-time consistent snapshot)(见“时序数据”),然后对特征(和标签)应用与模型相关的变换(model-dependent transformations,MDT),从而支持创建带版本控制的训练数据集。训练数据集用于训练模型,特征存储应该为模型存储训练数据集的血缘(lineage)。特征存储还会为批推理创建特征数据的时间点一致快照,这些快照应该应用与创建批推理所用模型的训练数据时相同的 MDT。
特征存储还为在线应用程序或服务提供低延迟的特征数据。模型部署(model deployment)接收预测请求,预测请求中的参数可用于计算按需特征,并从特征存储中检索预先计算好的特征数据行。任何按需特征和预先计算的特征都会被合并成一个特征向量(feature vector),在模型使用变换后的特征向量进行预测之前,可以对其应用进一步的 MDT(与训练中应用的相同)。
特征存储支持并组织第 2 章分类法中的数据变换。MIT 仅在特征管道中对新数据或历史数据应用,以产生可复用的特征数据。ODT 是一类特殊的 MIT,在特征管道和在线推理管道中都会应用——特征存储应保证在特征管道和在线推理管道中执行完全相同的变换;否则,就有偏差的风险。MDT 在训练管道、批推理管道和在线推理管道中应用。同样,特征存储应确保在训练和推理管道中执行相同的变换,以防止偏差。
特征存储通过强制执行"MDT 总是跟在与模型无关(和按需)的变换之后"这一约束,支持在管道中组合 MIT、MDT 和 ODT。也就是说,MDT 总是有向无环图(directed acyclic graph,DAG)中的最后一个变换,就在模型被调用之前。此外,ODT 通常在 DAG 中位于 MIT 之后,因为 MIT 是预先计算好的特征,而 ODT 只能在请求时计算(并且可以把预先计算的特征作为参数)。不过,本章主要关注特征数据的存储、建模和查询。第 6 章和第 7 章将讨论 MIT、MDT 和 ODT。
何时需要特征存储?
什么时候适合使用特征存储?许多组织已经拥有运营数据库、对象存储,以及数据仓库或湖仓。他们为什么还需要一个新的数据平台?以下是特征存储可以发挥作用的场景。
实时 ML 系统的上下文与历史
我们在第 1 章中看到了实时 ML 系统如何需要历史和上下文来做出个性化预测。一般来说,当你有实时预测问题,但预测请求的信息含量很低时,你可以从特征存储中受益,它提供上下文和历史来丰富预测请求。例如,一笔信用卡交易的预测请求中包含的信息很有限——只有信用卡号、商户 ID(唯一标识符)、时间戳、用于确定交易位置的 IP 地址、关于信用卡购买是在终端还是在线上进行(即卡是否存在)的数据,以及花费的金额。仅使用这些输入数据,用 AI 构建一个准确的信用卡欺诈预测服务几乎是不可能的,因为你会缺少关于信用卡交易的历史信息。但是有了特征存储,你可以在运行时用信用卡近期使用情况、客户详细信息、发卡行详细信息和商户详细信息等历史和上下文信息来丰富预测请求,从而构建一个强大的欺诈预测模型。
时序数据
许多零售、电信和金融 ML 系统都构建在时序数据之上。第 3 章中的空气质量和天气数据就是时序数据,我们每天更新一次,并将其与每次观测或预测的时间戳一起存储在特征组中。时序数据是连续时间点上的一系列数据点。将时序数据用于 ML 的一个主要挑战是如何读取(查询)分布在许多表上的特征数据——你希望从不同的表中读取时间点正确的训练数据,而不引入未来的数据泄漏或包含任何过期的特征值(见图 4-3)。
该图说明了创建时间点正确的训练数据的挑战:从不同表中连接最新的特征值,同时避免未来的数据泄漏或过期的特征值。
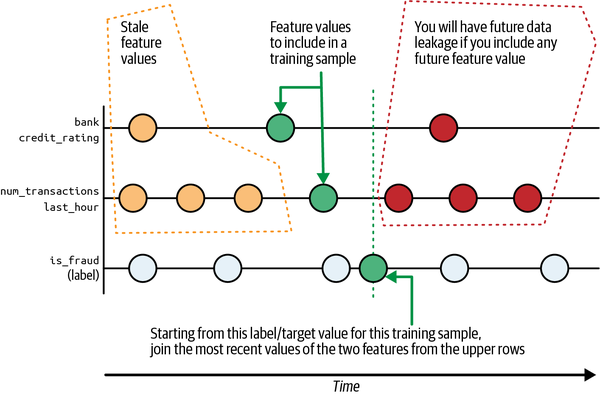
特征存储支持从包含时序特征数据的不同表中读取时间点正确的训练数据。本章后面将描述的解决方案是使用时间连接(temporal join)查询数据。编写正确的时间连接很难,但特征存储通过提供使用时间连接读取特征数据一致快照的 API,使这一工作变得更容易。
Note
你可能以前在训练模型的场景中遇到过数据泄漏。例如,如果你把测试集或任何外部数据集中的数据泄漏到训练数据集中,你的模型在测试时的表现可能会好于在生产环境中对未见数据的表现。未来数据泄漏(future data leakage)发生在你从时序数据构建训练数据集时,错误地引入了一个或多个来自未来的特征数据点。过期特征(stale feature)包含的特征值比观测时刻的实际特征值更旧。
通过 FTI 管道架构改善协作
许多模型无法投入生产的一个重要原因是,组织在协作开发和运维 AI 系统的团队之间存在孤岛。在图 4-4中,你可以看到一个孤岛式的组织:数据工程团队和数据科学团队之间有一堵比喻意义上的墙,数据科学团队和 ML 工程团队之间也有类似的墙。在这种孤岛式组织中,协作涉及数据和模型被从一堵墙扔到另一堵墙,从一个团队传给另一个团队。
该图展示了孤岛式的跨团队协作,数据和模型在数据工程、数据科学和运维团队之间通过比喻意义上的墙传递。
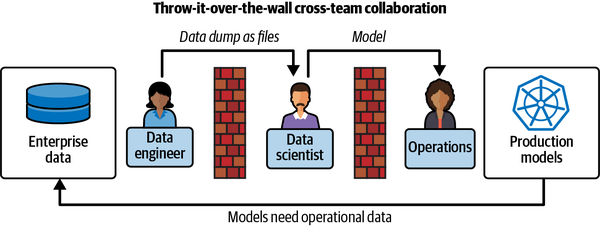
该组织的协作系统是康威定律(Conway’s Law)的一个例子,根据该定律,协作的过程(把资产扔过墙)反映了团队之间孤岛式的沟通结构。特征存储通过提供一个共享的协作平台来构建和运维 AI 系统,解决了团队间协作的组织挑战。第 2 章中的 FTI 管道也有助于协作。它们把 AI 系统分解为模块化管道,这些管道使用特征存储作为连接各管道的共享数据层。FTI 管道的职责清晰地映射到开发和运维生产 AI 系统的团队:
- 数据科学家和数据工程师协作构建和运维特征管道。
- 数据科学家训练和评估模型。
- 数据科学家和运维工程师编写推理管道,并将模型与外部系统集成。
但如果数据科学家帮助构建运维管道并将模型部署到生产环境,他们就不再是数据科学家,而是 ML 工程师。我相信,这就是当今大多数数据科学家的未来。你必须能够构建和运维 AI 系统,否则你的雇主会找一个替你完成这项工作的 ML 工程师。
ML 系统的治理
特征存储有助于确保组织的治理流程在其整个生命周期内保持特征数据的安全和可问责。这意味着要审计特征存储中的操作以实现问责,并跟踪从源数据到特征再到模型的血缘。特征存储管理需要符合监管要求的可变数据,例如欧盟的《AI 法案》(AI Act),它将 AI 系统分为四个不同的风险等级:不可接受、高、有限和最低。
除了数据存储之外,特征存储还需要支持血缘,以符合其他法律和监管要求,这些要求涉及跟踪 AI 系统中数据源、特征、训练数据和模型的来源、历史和使用情况。血缘还能实现特征、训练数据和模型的可复现性;通过更快的根因分析改进调试;以及对特征的使用情况分析。血缘告诉你 AI 资产在哪里被使用,但它不能告诉你某个特定特征是否被允许在某个特定模型中使用——例如,在高风险 AI 系统中。访问控制虽然是必要的,但在这里也无济于事,因为它只告诉你是否有权读写数据,而不是如果你使用某个特征,你的模型是否会合规。为了合规,特征存储支持自定义元数据来描述特征可以被使用的范围和上下文。例如,你可以标记包含个人可识别信息(personally identifiable information,PII)的特征。有了血缘(从数据源到特征,再到训练数据,再到模型)和特征的 PII 元数据标签,你可以很容易地识别哪些模型使用了包含 PII 数据的特征。
AI 资产的发现与复用
特征复用(feature reuse)是特征存储一个被广泛宣传的好处。Meta 报告称,在其特征存储中,“大多数特征被许多模型使用”,最受欢迎的一百个特征每个都被一百多个不同的模型复用。特征复用的好处包括:通过更多的使用和审查提高特征质量、降低存储成本,以及降低特征开发和运维成本,因为复用特征的模型不需要新的特征管道。计算好的特征存储在特征存储中,并发布到特征注册表(feature registry),使用户能够轻松地发现和理解特征。特征注册表是特征存储中的一个组件,它提供 API 和 UI 来浏览和搜索可用的特征、特征定义、特征数据的统计信息以及描述特征的元数据。
消除离线-在线特征偏差
特征偏差(feature skew)发生在离线管道(分别是特征管道或训练管道)中 ODT 或 MDT 的数据变换代码与相应推理管道中 ODT 或 MDT 的数据变换代码之间存在显著差异时。特征偏差会导致难以发现的、静默的模型性能下降。它可能表现为模型在推理时无法很好地泛化到新数据,原因就在于数据变换的差异。如果没有特征存储,很容易为 ODT 或 MDT 编写不同的实现——一个用于特征管道或训练管道,另一个用于推理管道。在软件工程中,我们说这种数据变换代码不是 DRY(Don’t Repeat Yourself,不要重复自己)。特征存储支持 ODT 和 MDT 的定义和管理,并确保在离线和推理管道中应用相同的函数。
在单一平台集中管理 AI 数据
特征存储的目标是成为一个管理训练和运维 AI 系统所需的所有数据的中央平台。现有的特征存储采用混合架构,包括一个离线存储(offline store)和一个在线存储(online store),并带有向量索引来存储向量嵌入(vector embedding)并支持相似性搜索。
在线存储被在线应用程序用来检索实体的特征向量。它是一种行式数据存储,数据存储在关系表中或 NoSQL 数据结构中(如键值对或 JSON 对象)。行式数据存储的关键属性是:
- 使用 SQL 或 NoSQL 进行低延迟、高吞吐量的 CRUD(创建、读取、更新、删除)操作
- 支持主键(primary key)来检索特定实体的特征
- 支持表和/或行的生存时间(time to live,TTL)以使过期的特征数据失效
- 通过复制实现高可用性,并通过 ACID(原子性、一致性、隔离性、持久性)事务保证数据完整性
- 支持二级索引以支持更复杂的查询(如在线聚合)
离线存储是一种列式存储。面向列的数据存储:
- 是存储用于分析的历史数据的中央数据平台
- 以高延迟的行级数据检索为代价,为大量数据提供低成本的存储(包括数据的列式压缩)
- 通过更高效的数据裁剪(data pruning)和数据移动,以及为支持复杂查询而设计的数据模型,实现比行式存储更快的复杂查询
现有特征存储的离线存储是湖仓。湖仓是用于存储的数据湖(data lake)和用于查询数据的数仓(data warehouse)的组合。与数据仓库相比,湖仓是一个开放平台,它将列式数据的存储与使用它的查询引擎分离。湖仓表可以被许多不同的查询引擎查询。湖仓的主要开源标准是用于数据存储的开放表格式(open table formats,OTF)(Apache Iceberg、Delta Lake、Apache Hudi)。OTF 由数据文件(Parquet 文件)和元数据组成,元数据支持对 Parquet 文件进行 ACID 更新——每次批量追加/更新/删除操作都有一个提交(commit)。提交历史作为元数据存储,为湖仓表提供时间旅行(time-travel)支持,你可以(使用提交 ID 或时间戳)查询表的历史版本。湖仓表还支持模式演进(schema evolution)(你可以在不破坏客户端的情况下向表中添加列),以及分区、索引和数据跳过(data skipping)以加快查询速度。
离线存储和/或在线存储还可以支持在向量索引中存储向量嵌入,向量索引支持对特征数据进行近似最近邻(approximate nearest neighbor,ANN)搜索。特征存储要么包含一个独立的向量数据库(如 Weaviate 或 Pinecone),要么使用一个支持向量索引和 ANN 搜索的现有行式数据库(如 Postgres PGVector、OpenSearch 或 MongoDB)。现在我们已经介绍了为什么以及何时可能需要特征存储,接下来我们将研究如何在特征存储中以特征组的形式存储数据。
特征组
特征存储使用特征组来隐藏在不同离线/在线数据存储中写入和读取数据的复杂性。我们在第 2 章和第 3 章中遇到过特征组,但我们还没有正式定义它们。特征组是特征作为列、特征数据存储在离线和在线存储中的表。并非所有特征存储都使用特征组这个术语——一些厂商称它们为特征集(feature set)或特征表(feature table),但它们指的是同一个概念。我们更喜欢特征组这个术语,因为数据可能存储在一组表中,分布在多个存储中。我们将介绍特征组最显著和最基本的属性,但请注意,你的特征存储可能会有一些差异,因此在构建特征管道之前请查阅其文档。Caveat emptor(买者自负)。
一个特征组由一个模式(schema)、元数据、离线存储中的一张表、在线存储中的一张可选表,以及一个可选的向量索引组成。元数据通常包含特征组的:
- 名称
version(版本号)entity_id(主键,定义在一个或多个列上)online_enabled——特征组的在线表是否被使用event_time列(可选)- 用于帮助发现和治理的标签(tag)
entity_id 用于检索在线特征数据的行并防止重复数据,而 version 号支持不同模型对特征进行 A/B 测试,并允许对特征组进行破坏性模式变更。event_time 列被特征存储用来从时序特征数据创建时间点一致的训练数据。根据你的特征存储,特征组可能支持以下部分或全部功能:
foreign_key列(对另一个特征组中主键的引用)partition_key列(用于通过分区裁剪实现更快的查询)- 为相似性搜索建立索引的
vector embedding特征 - 定义用于创建特征组中所存特征的数据变换的特征定义(feature definition)
在图 4-5中,我们可以看到包含信用卡交易相关不同列的特征组。你会注意到大多数列不是特征列。
该图展示了一个信用卡交易的特征组,包含索引列(cc_num、ts、account_id、day)和用于机器学习的特征列(amount、category、embedding_col、is_fraud),突出了高效查询和模型训练的结构。
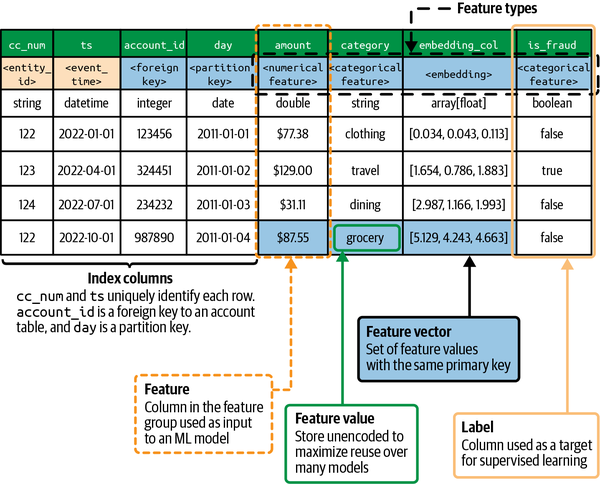
前四列统称为索引列(index column)——cc_num 是实体 ID,ts 是交易的时间戳(其事件时间),account_id 是指向 account_fg(未显示)的外键(foreign key),day 是分区键(partition key)列,通过只读取所需数据使按 day 过滤的查询更快(例如,读取昨天的特征数据不会读取所有行,只会读取 day 值为昨天的行)。接下来的三列(amount、category 和 embedding_col)是特征——embedding_col 是一个在向量索引中建立索引以进行相似性搜索的向量嵌入。最后,is_fraud 列也是一个特征列,但在图中被标识为标签。这是因为特征也可以是标签——is_fraud 列在某个模型中可能是标签,但在另一个模型中可能是特征。因此,标签不是在特征组中定义的,而是在你为模型选择特征和标签时才定义。
你可以对特征组执行插入、更新和删除操作,既可以通过批处理(DataFrame)API,也可以通过流式 API(用于实时 ML 系统)。由于特征组有模式,你的特征存储定义了所支持的特征数据类型——字符串、整数、数组等。在大多数特征存储中,你可以显式定义特征组的模式,或者特征存储会使用写入它的第一个 DataFrame 推断其模式。如果特征组包含时序数据,event_time 列的值应该捕获该行中特征值有效的时间戳(而不是该行数据被摄入的时间)。如果特征组包含非时序数据,你可以省略 event_time 列。
实体 ID(entity ID)是具有特征值的实体的唯一标识符。实体 ID 可以是自然键(natural key)或代理键(surrogate key)。自然键的一个例子是用户的电子邮件地址或社会安全号码,而代理键的一个例子是表示用户的序号,如自动递增的数字。
特征组存储未变换的特征数据
特征管道将未变换的特征数据写入特征组。在训练和推理管道中读取的特征数据应用 MDT 之后,未变换的特征数据就变成了变换后的特征数据(transformed feature data)。一般来说,特征组不应存储变换后的特征值(即不应应用 MDT),因为:
- 特征数据不能跨模型复用(特定于模型的变换将数据变换为供单个模型或一组相关模型使用)。
- 它可能会引入写放大(write amplification)。如果 MDT 以训练数据为参数,例如对数值特征进行标准化(standardizing),那么执行一次写入所需的时间将与特征组中的行数成正比,而不是与正在写入的行数成正比。以标准化为例,这是因为更新首先需要读取所有现有行,重新计算均值和标准差,然后用新的均值和标准差更新所有行的值。
- 探索性数据分析(exploratory data analysis)对未编码的特征数据效果最好——数据科学家很难理解经过缩放(scaled)的数值特征的描述性统计。
特征定义与特征组
特征定义是定义用于在特征组中创建一个或多个特征的数据变换的源代码。在基于 API 的特征存储中,这是你的特征管道中 MIT(和 ODT)的源代码。例如,它可以是用于批特征管道的 Pandas、Polars 或 Spark 程序。在基于 DSL 的特征存储中,特征定义不仅是创建特征的声明式变换,还是特征管道(批处理、流式或按需)的规范。
写入特征组
特征存储提供 API 来摄入特征数据。特征存储代表你管理摄入后在离线存储、在线存储和向量索引中更新特征数据的复杂性——后台的更新对你作为开发者是透明的。图 4-6 展示了两种不同类型的摄入特征数据的 API。在图 4-6(a) 中,客户端只有一个用于向离线存储写入特征数据的批处理 API。离线存储通常是湖仓表,它提供变更数据捕获(change data capture,CDC)API,你可以从中读取最新提交的数据变更。后台进程定期或持续运行,读取自上次运行以来的任何新提交,并将它们复制到在线存储和/或向量索引。对于存储时序数据的特征组,在线存储只存储每个实体的最新特征数据(每个主键对应 event_time 键值最近的行)。
该图展示了两种特征存储架构:(a) 使用批处理 API 进行离线存储,并定期同步到在线存储;(b) 同时包含批处理和流式 API,直接更新在线存储以实现更低的延迟。
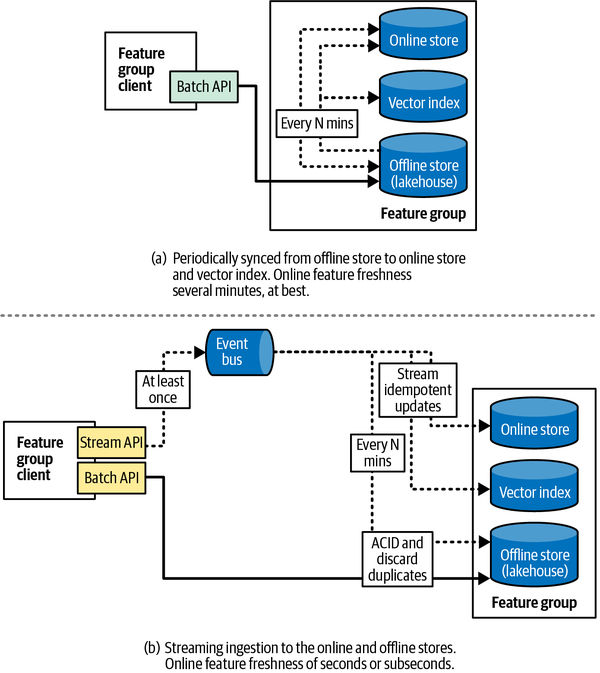
在图 4-6(b) 中,有两个 API:批处理 API(batch API)和流式 API(stream API)。客户端可以使用批处理 API 只写入离线存储。如果特征组是 online_enabled,客户端就写入流式 API。写入流式 API 的客户端既可以是批处理程序(Spark、Pandas、Polars),也可以是流处理程序(Flink、Spark Structured Streaming)。客户端可以使用流式 API 直接写入在线存储和向量索引(这里通过事件流平台),更新会定期物化到离线存储。通过流式 API,特征数据在在线存储中能以更低的延迟可用——也就是说,流式 API 支持更新鲜(fresher)的特征。对于存储时序数据的特征组,在线存储可以再次存储每个实体的最新特征数据(每个主键对应 event_time 键值最近的行),或者存储受 TTL 约束的实体的所有特征数据。也就是说,可以为每行或每个特征组指定 TTL,这样当 TTL 过期时,特征数据就会被移除。
特征新鲜度
特征组中特征数据的新鲜度(freshness)定义为从特征管道首次读取事件到计算出的特征可供推理管道使用所花费的总时间(见图 4-7)。它包括特征数据到达在线特征存储所花费的时间,以及从在线存储读取所花费的时间。
该图说明了特征新鲜度的过程,展示了从数据事件经过特征、训练和推理管道到达客户端的流程,突出了从数据摄入到特征可用之间的时间。
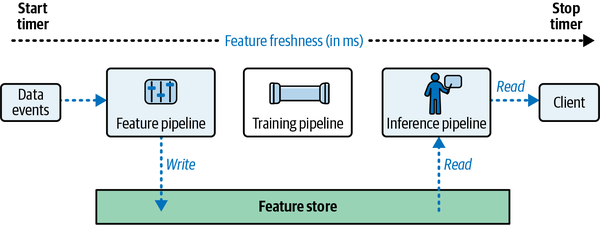
实时 ML 系统的新鲜特征通常需要流式特征管道,通过流式 API 更新特征存储。在第 15 章中,我们将实现一个类似 TikTok 的推荐系统,其中的特征是在流式特征管道中使用你的观看活动信息创建的。在用户操作的一秒内,特征值就会被创建,并作为预先计算的特征在特征组中可供预测使用。如果这需要几分钟而不是几秒钟,TikTok 的推荐器就不会感觉像是在实时跟踪你的意图——AI 会感觉太滞后,无法作为推荐器使用。
数据验证
一些特征存储在向特征组写入特征数据时支持数据验证(data validation)。对于每个特征组,你可以为有效的特征数据值指定约束。例如,如果特征是成年用户的年龄,你可以指定年龄应大于 17 且小于 125。数据验证有助于避免特征组中的数据质量问题。请注意,“垃圾进,垃圾出”(garbage in, garbage out)这一普遍原则有一些例外。例如,特征组中存在缺失的特征值通常是可以的,因为你可以在训练和推理管道中稍后对这些缺失值进行插补(impute)。
现在我们已经介绍了特征组是什么、它存储什么,以及如何更新它,接下来让我们看看如何为特征组设计数据模型。
特征组的数据模型
如果特征存储要成为我们 AI 数据的来源,我们需要理解如何建模存储在其特征组中的数据。特征存储的数据建模是决定以下内容的过程:
- 为哪些实体创建哪些特征,以及特征组中包含哪些特征
- 特征组之间的关系是什么样的
- 特征数据的新鲜度要求是什么
- 将对特征组执行什么类型的查询
数据建模包括数据模型的设计。数据模型(data model)是数据库理论中的一个术语,指我们如何将数据分解到不同的特征组(表)中,其目标是:
- 确保数据的完整性
- 提高写入数据的性能
- 提高读取(查询)数据的性能
- 随着数据量和/或吞吐量的增加,提高系统的可扩展性
你可能听说过关系数据库中的实体-关系图(entity-relationship diagram,ERD)(例如,见图 4-8)。这类图提供了一种识别实体以及这些实体之间关系的方法。例如,一笔信用卡交易可以有对持卡人账户、发卡银行和处理交易的商户的引用(外键)。在关系数据模型中,实体通常映射到表,关系通常映射到外键。类似地,在特征存储中,实体映射到特征组,关系映射到特征组中的外键。
从需求和数据源到特征组数据模型(如实体-关系图)的过程是怎样的?我们可以使用两种基本技术:
- 规范化(normalization)
- 减少数据冗余并提高数据完整性。
- 反规范化(denormalization)
- 通过增加数据冗余并危及数据完整性来提高查询性能。
这两种技术产生的数据模型可以分为两种类型:包含冗余(重复)数据的反规范化数据模型,以及消除冗余数据的规范化数据模型。两种方法的优缺点如表 4-2所示。
| 反规范化数据模型 | 规范化数据模型 | |
|---|---|---|
| 数据存储成本 | 更高,因为(行式)在线存储中存在冗余数据 | 更低,因为没有冗余数据 |
| 查询复杂度 | 更低,因为从在线存储读取时需要的连接更少 | 更高,因为查询数据时需要更多的连接 |
一般来说,反规范化的数据模型在列式数据存储(湖仓和数据仓库)中更普遍,因为列式存储通常可以使用列式压缩技术(如游程编码,run-length encoding)高效地压缩列中的冗余数据。另一方面,行式数据存储无法高效压缩冗余数据,因此它们更倾向于规范化的数据模型。
在我们开始识别实体、特征以及实体/特征的特征组之前,我们应该考虑将使用特征数据的 AI 系统的类型:
- 批 ML 系统
- 实时 ML 系统(包括 LLM/智能体)
对于批 ML 系统,特征组只需要在其离线存储中存储数据。因此,对于列式存储,我们可以考虑现有的数据模型,例如在分析和商业智能环境中广泛使用的星型模式或雪花模式。对于实时 ML 系统,我们的特征组在离线和在线存储中都有表。请注意,这里我们不需要考虑向量索引,因为它们只是现有在线表中的列。
如果我们想要一个对批处理和实时查询都同样有效的通用数据模型,我们将在下一节看到,雪花模式(一种规范化的数据模型)是我们为特征存储进行数据建模的首选方法。然而,一些特征存储只支持星型模式,因此我们将介绍这两种数据模型。星型模式和雪花模式都是将数据组织成连接维度表的事实表的数据模型。在星型模式中,维度表中的列可以是冗余的(重复的),但雪花模式扩展了星型模式,使维度表可以连接到其他维度表,从而实现没有冗余数据的规范化数据模型。我们现在来看看如何使用维度建模(dimension modeling)设计一个包含事实表和维度表的星型模式或雪花模式数据模型。
Note
列式存储中使用的其他流行数据模型包括数据金库模型(data vault model)(用于高效处理数据摄入,数据可能迟到、模式变更频繁)和大宽表(one big table,OBT)数据模型(通过将尽可能多的数据存储在单个宽表中来简化数据建模)。OBT 不适合 AI 系统,因为它会把所有标签和特征存储在一个反规范化的表中,这会爆炸式地增加(行式)在线存储的存储需求,而且不适合存储随时间变化的特征值。你可以在 Joe Reis 和 Matt Housley 合著的《数据工程基础》(Fundamentals of Data Engineering,O’Reilly,2022)中了解更多关于数据建模的内容。
使用信用卡数据集市进行维度建模
数据仓库中最流行的数据建模技术是维度建模,它将数据分为事实(fact)和维度(dimension)。事实通常是测量得到的量,但也可以是定性的。维度是事实的属性。有些维度的值会随时间变化,被称为缓慢变化维度(slowly changing dimension,SCD)。让我们看一个信用卡交易数据集市中事实和维度的例子。数据集市是数据仓库(或湖仓)的子集,包含专注于特定业务线、团队或产品的数据。
在我们的示例中,信用卡交易是事实,维度是关于信用卡交易的数据,如持卡人、其账户详细信息、银行详细信息和商户详细信息。我们将使用这个数据集市来驱动一个预测信用卡欺诈的实时 ML 系统。但首先,让我们看一下我们的数据集市,如图 4-8中使用雪花模式数据模型的实体-关系图所示。
雪花模式数据模型图,展示了信用卡交易事实如何与维度表连接,突出了用于交易处理和欺诈预测的关系和外键。
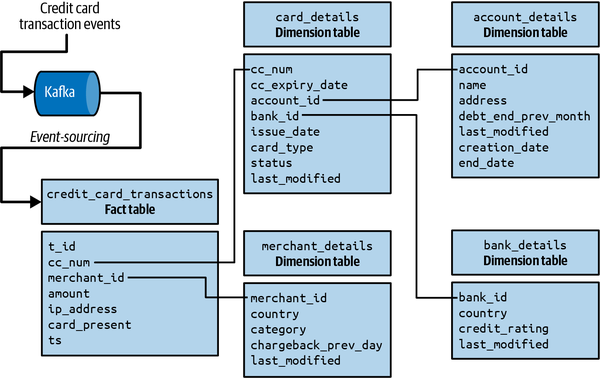
事实表(fact table)存储 credit_card_transactions、交易的唯一 ID(t_id)、信用卡号(cc_num)、交易时间戳(ts)、花费金额(amount)、商户的 IP 地址,以及指示交易是在线还是实体的代码(card_present)。
信用卡交易的维度表是:
- card_details(卡详细信息)
- 卡的
expiry_date(到期日)和issue_date(签发日)、卡的类型(信用卡、借记卡、预付卡或虚拟卡)、其状态(有效、冻结或丢失/被盗),以及指向账户和银行详细信息表的外键(外键使其成为雪花模式数据模型)
- 卡的
- account_details(账户详细信息)
- 账户持有人的姓名和地址、其上个月末的债务、账户创建和关闭的日期(
end_date),以及一行数据被last_modified(最后修改)的日期
- 账户持有人的姓名和地址、其上个月末的债务、账户创建和关闭的日期(
- bank_details(银行详细信息)
- 银行的
credit_rating(信用评级)、其country(国家),以及一行数据被last_modified(最后修改)的日期
- 银行的
- merchant_details(商户详细信息)
- 商户前一天拒付(chargeback)的次数(
chargeback_prev_day)、商户的类别代码(category)、其country(国家),以及一行数据被last_modified(最后修改)的日期
- 商户前一天拒付(chargeback)的次数(
信用卡交易表使用事件溯源(event sourcing)模式填充,即每小时一次,一个 ETL Spark 作业读取前一个小时到达 Kafka 的所有信用卡交易,并将这些事件作为行持久化到 credit_card_transactions 表中。维度表由 ETL(提取、转换、加载)或 ELT(提取、加载、转换)管道更新,这些管道读取运营数据库(未显示)中的维度变更。我们现在来看看如何使用 Kafka 中的信用卡交易事件和维度表来构建我们的实时欺诈检测 ML 系统。
标签是事实,特征是维度
在特征存储中,事实是我们模型的标签(或目标/观测值),而特征是对应标签的维度。与事实一样,标签是不可变的事件,通常带有与之关联的时间戳。例如,在我们的信用卡欺诈模型中,对于一笔给定的信用卡交易,我们会有一个 is_fraud 标签,以及一个该笔信用卡交易发生的时间戳。该模型的特征将是卡使用统计、卡本身的详细信息(到期日)、持卡人、银行和商户。这些特征是标签的维度,而且通常是可变数据。有时它们是 SCD,但在实时 ML 系统中,它们可能是快速变化的维度。无论特征值变化是慢还是快,如果我们想把一个特征用作模型的训练数据,关键在于保存特征在所有时间点的所有值。如果你不知道特征的值何时以及如何随时间变化,那么使用该特征创建的训练数据就可能出现未来数据泄漏或包含过期的特征值。
特征存储与 SCD 类型
数据仓库中的维度建模引入了 SCD 类型来存储维度(特征)的变化值。至少有五种众所周知的实现 SCD 的方法(SCD 类型),每种方法都针对维度变化的不同方式进行优化。在数据集市中实现不同的 SCD 类型是一项具有挑战性的工作。然而,我们可以大大简化特征存储中 SCD 的管理,原因有二。首先,由于特征值是对可测量量的观测,每个新的特征值都会替换旧的特征值(一个特征在同一时间不能有多个可选值)。其次,读取特征数据的查询模式数量有限——你从离线存储中读取训练数据和批推理数据,从在线存储中读取特征向量行。也就是说,特征存储不需要支持所有五种 SCD 类型;相反,它们需要一组非常特定的 SCD 类型(0、2 和 4),并且你可以通过在特征组中简单地指定 event_time 列,悄悄地为特征组添加对这些类型的支持。这样,与通用数据仓库相比,特征存储简化了对 SCD 的支持。
表 4-3展示了特征存储如何以指定存储 event_time 的特征组列这一相对简单的方式实现 SCD 类型 0、2 和 4。
| SCD 类型 | 用途 | 描述 | 特征存储 |
|---|---|---|---|
| 类型 0 | 不可变的特征数据 | 不保留特征数据的历史,因此该类型适用于不可变的特征。 | 不带 event_time 的特征组 |
| 类型 2 | 批 ML 系统使用的可变特征数据 | 当某个实体 ID 的特征值被更新时,会创建一个带有新 event_time(但实体 ID 相同)的新行。每个新行都是特征数据的一个新版本。 | 带 event_time 的离线特征组 |
| 类型 4 | 实时 ML 系统的在线特征;用于训练离线数据 | 特征作为记录存储在两张不同的表中——在线存储中存储最新特征值的表和离线存储中存储历史特征值的表。 | 带 event_time 的在线/离线特征组 |
类型 0 SCD 是存储不可变特征数据的特征组。如果你没有为特征组定义 event_time 列,你就拥有一个类型 0 SCD 的特征组。类型 2 SCD 是仅离线的特征组(用于批 ML 系统),其中保存了时序数据的历史记录。在经典的类型 2 SCD 中,假设行同时需要 end_date(结束日期)和 effective_date(生效日期)(因为在任何时间点可能有多个维度值有效)。然而,在特征存储中,我们不需要 end_date——只需要 effective_date,即所谓的 event_time,因为在任何给定的时间点只有一个特征值有效。类型 4 SCD 实现为一个由在线和离线存储中的表支持的特征组。在线存储中的表存储最新的特征数据值,离线存储中同名的同模式表存储所有历史特征数据值。在传统的类型 4 SCD 中,历史表不存储最新的值,但特征存储支持类型 4 SCD 的一种变体,即离线存储同时存储最新的特征值和历史值。
特征存储通过在读写 API 中实现这些数据模型,隐藏了设计实现这三种不同 SCD 类型的数据模型的复杂性。例如,在 AWS SageMaker 特征存储(一个基于 API 的特征存储)中,你只需在定义特征组时指定 event_time 列:
feature_group.create(
    description = "Some info about the feature group",
    feature_group_name = "feature_group_name",
    event_time_feature_name = event_time_feature_name,
    enable_online_store = True,
    ...
    tags = ["tag1","tag2"]
)
对这个特征组的写入将创建类型 4 SCD 特征,最新特征数据位于键值存储(ElastiCache 或 DynamoDB)中,历史特征数据位于列式存储(Apache Iceberg)中。
实时信用卡欺诈检测 ML 系统
现在让我们开始设计我们的实时 ML 系统,以预测一笔信用卡交易是否欺诈。这个运营 ML 系统(在线推理管道)有一个 50 ms 或更低延迟的服务级目标(service-level objective,SLO),用于做出是否存在欺诈嫌疑的决定。它接收包含信用卡交易详细信息的预测请求,从特征存储中检索预先计算的特征,计算 ODT,将预先计算的特征和实时特征合并到单个特征向量中,应用任何 MDT,做出预测,记录预测和特征,并将预测(欺诈或非欺诈)返回给客户端。
为了构建这个系统并满足我们的 SLO,我们将需要编写一个流式特征管道,直接从 Kafka 的事件创建特征,如图 4-8所示。流处理使我们能够计算信用卡近期历史活动的聚合,例如一张卡在过去 5 分钟、15 分钟或 1 小时内被使用了多少次。这些特征被称为窗口聚合(windowed aggregation),因为它们对在某个时间窗口内发生的事件计算聚合。如果我们只使用数据集市中的 credit_card_transactions 表,就不可能在我们的 SLO 内计算这些特征,因为该表每小时才更新一次。然而,我们可以从数据集市计算其他特征,例如发行信用卡的银行的信用评级,以及处理信用卡交易的商户的拒付次数。
我们还将使用 ODT 从输入请求数据创建实时特征。一个对地理欺诈攻击有良好预测能力的特征是连续两笔信用卡交易之间的距离和时间。如果距离大而时间短,这通常表明存在欺诈。为此,我们计算 haversine_distance(哈弗辛距离)和 time_since_last_transaction(距上一笔交易的时间)特征。
我们在这里描述了一个包含使用流处理、批处理和 ODT 计算的特征混合的 ML 系统。然而,当我们想用这些特征训练模型时,训练数据将存储在特征存储的特征组中。因此,我们需要识别特征,然后为特征组设计一个数据模型。
实时欺诈检测 ML 系统的数据模型
我们使用监督式 ML 模型来预测欺诈,因此我们需要一些标记的欺诈观测数据。为此,有一个不在数据集市中的新表 cc_fraud,它有一个 t_id 列(信用卡交易的唯一标识),包含被识别为欺诈的信用卡交易,以及报告欺诈的人和解释该交易为何被标记为欺诈的列。欺诈团队每周在其管理的 Postgres 数据库中更新 cc_fraud 表。使用 cc_fraud 表、数据集市和事件流平台,我们可以创建对欺诈有预测力的特征和标签,如表 4-4所示。
| 数据源 | 简单特征 | 工程化特征 |
|---|---|---|
credit_card_transactions account_details | amount ip_address card_present | {num}/{sum}_trans_last_10_mins {num}/{sum}_trans_last_hour {num}/{sum}_trans_last_day {num}/{sum}_trans_last_week prev_ts_transaction prev_ip_transaction prev_card_present_transaction haversine_distance time_since_last_transaction |
cc_fraud credit_card_transactions | is_fraud | |
credit_card_transactions card_details | card_type status | days_to_card_expiry |
account_details | zipcode | |
merchant_details | category | chargeback_rate_prev_month chargeback_rate_prev_week |
bank_details | credit_rating | days_since_bank_cr_changed |
有许多框架和编程语言可以用来创建这些特征,我们将在接下来的几章中查看它们的源代码。目前,我们感兴趣的是为我们的特征组设计的数据模型,我们将用它来存储和查询这些特征以及欺诈标签。特征组将需要同时存储在在线和离线存储中,因为我们分别将在实时 ML 系统中使用这些特征进行推理,并在离线训练管道中使用它们进行训练。我们现在将设计两种不同的数据模型,首先使用星型模式,然后使用雪花模式。
星型模式数据模型
星型模式数据模型得到所有主流特征存储的支持。在图 4-9中,我们可以看到包含欺诈标签的 cc_trans_fg 特征组被称为标签特征组(label feature group)。
信用卡欺诈预测系统的星型模式数据模型图,展示了作为维度表的特征组和作为事实的标签。
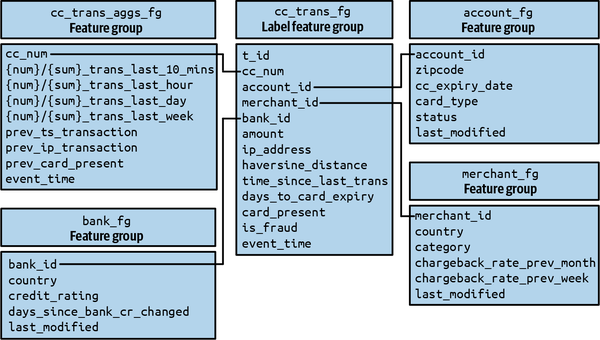
包含我们信用卡交易(欺诈或非欺诈)标签的特征组被称为标签特征组。在实践中,标签特征组只是一个普通的特征组。正如我们稍后将看到的,只有当我们为模型选择特征和标签时,才需要将特征组中的列标识为特征或标签。
脊柱 DataFrame 中的标签
一些特征存储不支持在特征组中存储标签。相反,对于这些特征存储,客户端在创建训练数据和推理数据时,需要提供标签、标签时间戳(event_time)以及特征组的实体 ID(包含他们想要包含的特征)。在Feast 特征存储中,客户端在一个名为脊柱 DataFrame(Spine DataFrame)的 DataFrame 中提供标签、标签时间戳和实体 ID。脊柱 DataFrame 包含与我们的标签特征组相同的数据,但它不会持久化到特征存储中。脊柱 DataFrame 还可以包含用于创建训练数据的附加列(特征)。然而,这是不好的做法,因为附加列可能导致偏差,因为你必须确保在读取训练数据时提供的任何附加列,在读取推理数据时也要包含(以相同的顺序、相同的数据类型)。
在星型模式数据模型中,你可以看到标签特征组包含指向四个特征组的外键,这四个特征组包含从数据集市表和事件流平台计算出的特征。这些特征组都在各自独立运行的特征管道中独立更新。例如,cc_trans_aggs_fg 特征组由流式特征管道计算,而 account_fg、bank_fg 和 merchant_fg 特征组由每天运行的批处理作业计算。请注意,我们遵循在特征组名称后附加 _fg 的习惯,以将它们与数据集市中的表区分开来。
雪花模式数据模型
雪花模式(snowflake schema)是一种数据模型,与星型模式一样,由包含标签和特征的表组成。然而,与星型模式相比,在雪花模式中特征数据是规范化的,这使得雪花模式适合作为在线和离线表的数据模型。每个特征都被拆分,直到规范化(见图 4-10)。也就是说,特征表中没有冗余——没有重复的特征。
雪花模式数据模型图,展示了用于信用卡欺诈预测的、具有规范化特征的相互连接的表,突出了标签特征组中更少的外键。
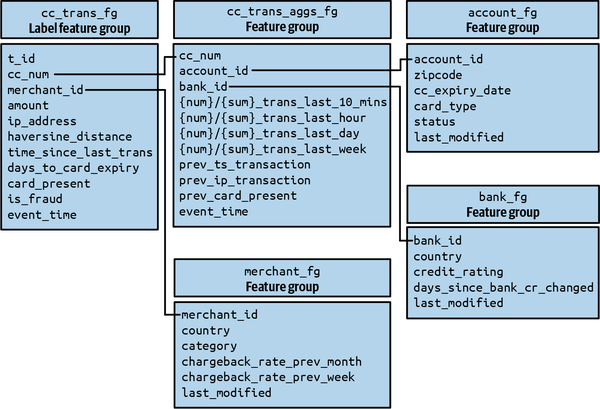
在雪花模式中,你可以看到标签特征组现在只有两个外键,而星型模式数据模型中有四个外键。正如我们将在下一节中看到的,在构建实时 ML 系统时,雪花模式在这里相对于星型模式的优势最为明显。在实时 ML 系统中,标签特征组中的外键需要由客户端作为预测请求的一部分提供。使用雪花模式,客户端只需要提供 cc_num 和 merchant_id 作为请求参数,就能检索所有特征——嵌套表中的特征通过子查询检索。然而,在星型模式中,我们的实时 ML 系统还需要额外提供 bank_id 和 account_id 作为请求参数。这使得实时 ML 系统更复杂——要么客户端提供 bank_id 和 account_id 的值作为参数,要么你必须维护一个从 cc_num 到 bank_id 和 account_id 的附加映射表。
推理的特征存储数据模型
标签在推理期间显然不可用——我们的模型预测它们。同样,我们的标签特征组(cc_trans_fg)中的索引列、事件时间和特征在在线推理时也不能作为预先计算的特征使用。它们都可以作为参数在预测请求中传递(指向特征组的外键和 amount 特征)、通过映射表解析(对于星型模式),或用 ODT(time_since_last_trans、haversine_distance 和 days_to_card_expiry)或 MDT 计算。标签特征组不存储特征的推理数据。标签特征组仅离线,只存储特征的历史数据,用于创建离线训练数据。
在线推理
对于在线推理,预测请求包含实体 ID(外键)、任何传递的特征值(用于标签特征组中的特征),以及计算按需特征所需的任何参数(见图 4-11)。在线推理管道使用外键从子在线特征组中检索所有预先计算的特征。特征存储提供语言级 API(如 Python)或 REST API 来检索预先计算的特征。
该图展示了在线推理的特征存储结构,显示了标签特征组、传递的特征、按需特征以及各种特征组和维度表之间的连接。
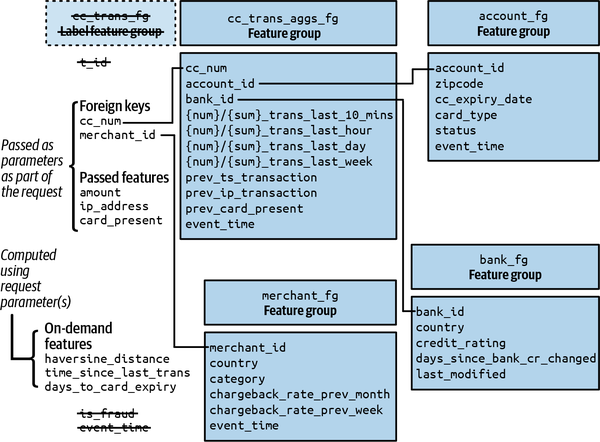
批推理
批推理具有与在线推理类似的数据建模挑战。想象一下我们的实时信用卡欺诈预测问题是一个批 ML 系统,它预测昨天的每笔信用卡交易是否欺诈。在这种情况下,标签当然不可用。我们可以用批特征管道替换更新 cc_trans_fg 的流式特征管道。或者,我们可以使用数据集市中的 credit_card_transactions 表,并将三个 ODT 重新实现为 MDT(在训练和批推理管道中)。
特征存储通常支持批推理数据 API,例如:
- 读取在给定时间范围内到达的所有特征数据。
- 读取一批实体(如所有活跃用户)的所有最新特征数据。
另一种 API 是允许批推理客户端提供包含特征外键和时间戳的脊柱 DataFrame。特征存储接收脊柱 DataFrame,并从特征组中连接包含特征值的列(使用外键和时间戳检索正确的特征值)。脊柱 DataFrame 方法对情况 (1) 效果不佳,但对情况 (2) 效果很好。脊柱 DataFrame 也只适用于星型模式数据模型。你必须把所有的外键都加到脊柱 DataFrame 中,如果我们想读取所有用户的最新特征值,这很容易,我们传入一个包含所有用户 ID 的脊柱 DataFrame。然而,读取自昨天以来的所有特征数据需要对特征组进行更复杂的查询,在这种情况下,支持此类查询的专用批推理 API 会很有帮助。
使用特征视图读取特征数据
为特征存储设计好数据模型后,你需要能够查询它以读取训练和推理数据。特征存储不提供读取特征数据的完整 SQL 查询支持。相反,它们提供语言级 API(Python、Java 等)和/或 REST API 来检索训练数据、批推理数据和在线推理数据。但是,读取预先计算的特征数据并不是特征存储的唯一任务。特征存储还应该在向客户端返回特征数据之前应用任何 MDT 和 ODT。
特征存储提供了一种抽象,称为特征视图,它隐藏了为特定模型(或一组相关模型)检索/计算训练和推理特征的复杂性。
特征视图是一个或多个模型用于训练和推理的特征以及可选的标签的选择。特征视图中的特征可以来自一个或多个特征组。
定义特征视图后,你通常可以用它来:
- 检索时间点正确的训练数据
- 检索时间点正确的批推理数据
- 使用外键(实体 ID)检索预先计算的特征
- 在读取用于训练和推理的特征数据时对特征应用 MDT
- 在在线推理管道中应用 ODT
特征视图通过确保在读取训练和推理数据时返回相同顺序的特征序列,以及确保对从特征存储读取的训练和推理数据应用相同的 MDT,来防止训练和推理之间的偏差。特征视图还在在线推理管道中应用 ODT,并确保它们与特征管道一致。
对于训练和批推理数据,特征存储支持以 DataFrame 或文件的形式读取数据。对于小数据量,Pandas DataFrame 很流行,但当数据量超过几 GB 时,一些特征存储支持读取到 Polars 和/或 Spark DataFrame。不过,Spark DataFrame 在训练管道中并不那么广泛使用,即使使用,它们通常也会调用 df.to_pandas() 将 Spark DataFrame 转换为 Pandas DataFrame。对于大量数据(无法放入 Polars 或 Pandas DataFrame 的数据),特征存储支持在外部文件系统或对象存储中创建训练数据文件,文件格式包括 Parquet、CSV 和 TFRecord(TensorFlow 的行式文件格式,PyTorch 也支持)。
不同的特征存储对特征视图使用不同的名称,包括 FeatureLookup(Databricks)和 FeatureService(Feast、Tecton)。我更喜欢特征视图这个术语,因为它与关系数据库中的视图关系密切——特征视图是从不同特征组中选择的列,并且它只包含元数据(特征视图不存储数据)。特征视图在训练或批推理管道中使用时也不是一个服务,而且它不只是特征的选择(正如 FeatureLookup 所暗示的那样)。在在线推理中,特征视图既可以部署为网络服务,也可以嵌入到模型部署中。出于这些原因,我们使用特征视图这个术语。
特征视图可以扩展以支持客户端变换(MDT 和 ODT)。例如,Hopsworks 支持以声明方式将 MDT 附加到特征视图中的选定特征,并且特征视图在从特征存储读取数据时会透明地计算 MDT 和 ODT。
使用特征视图创建时间点正确的训练数据
在从时序特征创建训练数据时,目标是确保时间点正确性(point-in-time correctness):连接到标签的每个特征值必须是标签事件时间可用的那个值,而不包含未来数据或过期的值。这通常通过时间连接(temporal join)来完成。
时间连接从包含标签的表开始,然后基于匹配的实体 ID 和事件时间对齐,从其他表连接特征。以下规则适用于每一行标签:
- 连接只包含
event_time小于或等于标签event_time的特征行。 - 从这些行中,选择
event_time在标签时间戳之前或等于标签时间戳的最接近(最新)的行。 - 如果没有特征行满足条件,连接将为这些特征返回
NULL值。
时间连接实现为 ASOF LEFT JOIN。ASOF 条件确保连接的特征值没有未来数据泄漏,LEFT JOIN 确保即使没有匹配的特征行,标签行也会被保留。训练数据中的行数应该与包含标签的表中的行数相同。
Note
ASOF 关键字还不是 ANSI SQL 标准的一部分。因此,一些数据库(如 ClickHouse 和 Feldera)使用 LEFT ASOF JOIN,其他数据库(如 DuckDB)使用 ASOF LEFT JOIN,而 Snowflake 支持 ASOF JOIN(它只能是左连接)。
在图 4-12中,我们可以看到 ASOF LEFT JOIN 如何从四个不同的特征组创建训练数据(为简洁起见,我们省略了 account_fg)。从标签特征组(cc_trans_fg)开始,它按照 cc_trans 中的 event_time,从其他三个特征组(cc_trans_aggs_fg、bank_fg、merchant_fg)连接特征。
该图展示了 ASOF LEFT JOIN 工作流,从多个特征表创建时间点正确的训练数据,通过基于事件时间将特征与标签连接来避免未来数据泄漏。
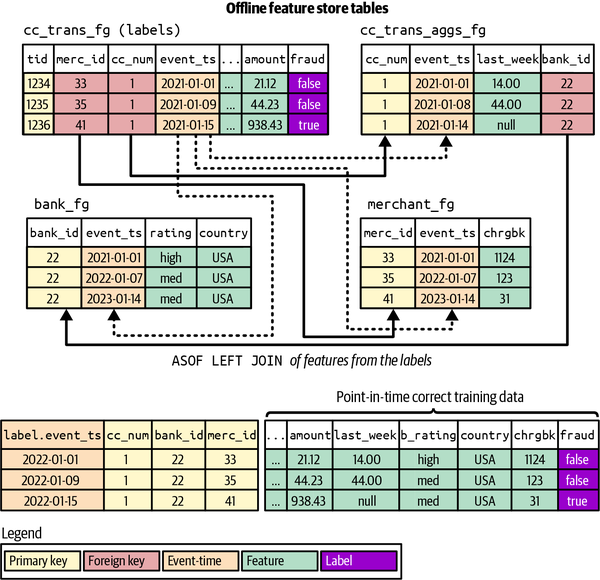
例如,在我们的信用卡欺诈数据模型中,如果我们想创建自 2022 年 1 月 1 日以来的训练数据,我们可以在标签表和特征组上执行以下嵌套的 ASOF LEFT JOIN(为简洁起见,某些列名被缩写):
SELECT
    label.amount,
    aggs.last_week,
    bank.country,
    bank.credit_rating AS b_rating,
    merchant.chrgbk,
    label.fraud
FROM cc_trans_fg AS label
ASOF LEFT JOIN cc_trans_aggs_fg AS aggs
    ON label.cc_num = aggs.cc_num
    AND aggs.event_ts <= label.event_ts
ASOF LEFT JOIN bank_fg AS bank
    ON aggs.bank_id = bank.bank_id
    AND bank.event_ts <= label.event_ts
ASOF LEFT JOIN merchant_fg AS merchant
    ON label.merc_id = merchant.merc_id
    AND merchant.event_ts <= label.event_ts
WHERE label.event_ts > '2022-01-01 00:00';
上述查询返回标签特征组中 event_ts 大于 2022 年 1 月 1 日的所有行,并将每一行与来自 cc_trans_aggs_fg 的一列(last_week)、来自 bank_fg 的两列(rating 和 country)以及来自 merchant_fg 表的一列(chrgbk)连接。对于最终输出中的每一行,连接的行具有最接近但小于标签特征组中 event_ts 值的 event_ts。这是 LEFT JOIN 而不是 INNER JOIN,因为 INNER JOIN 会把标签表中的外键与特征表中的行不匹配的行从训练数据中排除。
使用特征视图进行在线推理
在在线推理中,特征视图提供 API 来检索预先计算的特征、使用向量索引进行相似性搜索,以及计算 ODT 和 MDT。在信用卡欺诈示例 ML 系统中,在请求时从我们的数据模型检索特征需要两个查询:
- 使用
merchant_id对商户特征进行主键查找 - 使用
cc_num左连接以读取聚合特征和银行特征
特征视图提供了一个单一 API 调用 get_feature_vector(),它执行这两个查询,并在返回特征向量之前应用任何 ODT 和 MDT:
feature_vector = feature_view.get_feature_vector(
entry = [{"cc_num": 1234567811112222, "merchant_id": 212}]
)
feature_vector 可以是列表类型、NumPy 数组,甚至是 DataFrame,具体取决于模型期望的输入格式。
总结与练习
特征存储是 AI 系统的数据层。我们深入研究了特征存储的解剖结构,并探讨了什么时候适合使用它。我们研究了特征组如何将特征数据存储在多种数据存储中:行式、列式和向量索引。我们还学习了如何为批和实时 ML 系统在数据模型中组织特征数据。我们介绍了特征视图,并描述了它们如何在没有偏差的情况下查询训练和推理的特征数据。在下一章中,我们将研究一个具体的特征存储——Hopsworks 特征存储。
以下练习将帮助你学习如何设计自己的数据模型。在每个练习中,问自己是否需要向现有特征组添加新的特征组或新的外键,你将如何计算新特征(批处理还是流式),等等:
- 描述你将用来计算新特征"商户月均消费额"的特征管道。它的输入/输出是什么,是批处理还是流式,你会把该特征添加到我们数据模型中的什么位置?
- 添加一个"信用卡终身总消费额"特征。
- 每笔信用卡交易现在都带有一个新的设备 ID。你将如何更新特征组的数据模型?你可以使用哪些新特征?