自动化特征化:图像特征提取与深度学习
视觉和听觉是人类与生俱来的感官输入。我们的大脑天生就具备快速进化处理视觉与听觉信号的能力,有些系统甚至在出生之前就已经开始对刺激作出反应(Eliot, 2000)。相比之下,语言能力是后天习得的:它需要数月时间才能发展起来,数年时间才能熟练掌握。许多人把自己视觉和听觉的发展视为理所当然,但我们所有人都必须刻意训练自己的大脑去理解和运用语言。
有趣的是,机器学习的情况恰恰相反。我们在文本分析应用上取得的进展,远多于图像或音频分析。以搜索问题为例。多年来,人们在信息检索(information retrieval)和文本搜索方面一直享受着相对的成功,而图像和音频搜索仍在不断完善之中(不过,过去五年深度学习模型的突破,或许终于预示着图像和语音分析领域期盼已久的革命即将到来)。
进展的难度,与从各类数据中提取有意义特征的难度直接相关。机器学习模型需要语义上有意义的特征,才能做出语义上有意义的预测。在文本分析中——尤其是英语这类基本语义单元(单词)很容易提取的语言中——进展可以非常迅速。而图像和音频则是以数字像素(pixel)或波形(waveform)的形式记录的。图像中的单个"原子"是一个像素;在音频数据中,它是对波形强度的一次测量。它们所包含的语义信息比文本数据的一个原子——一个词——要少得多。因此,特征提取和特征工程(feature engineering)在图像和音频上的任务,要比在文本上困难得多。
在过去 20 年里,计算机视觉(computer vision)研究一直专注于手工定义的流水线来提取良好的图像特征。有一段时间,SIFT 和 HOG 这类图像特征提取器(在后续小节中会介绍)是标准做法。深度学习研究的近期进展,通过在基础层中融入自动特征提取,扩展了传统机器学习模型的触及范围。它们本质上是把手工定义的图像特征提取器,替换为能够自动学习和提取特征的手工定义模型。手工工作依然存在,只是被进一步抽象进了建模巨兽的腹中。
在本章中,我们将从最流行的图像特征提取器讲起,然后深入本书所覆盖的最复杂的建模机器:用于特征学习的深度学习(deep learning)。
最简单的图像特征(以及为什么它们行不通)
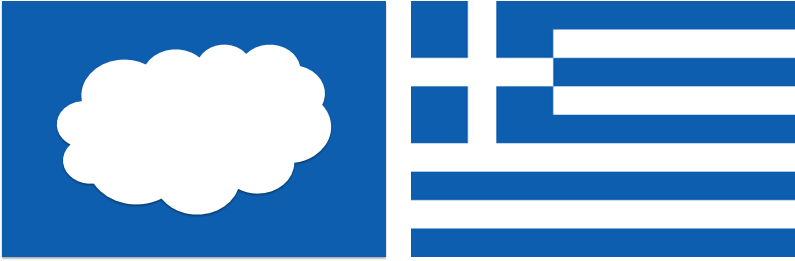
从一幅图像中提取的正确特征是什么?答案当然取决于我们要用这些特征做什么。假设我们的任务是图像检索(image retrieval):给定一张图片,要求从图像数据库中找出相似的图片。我们需要决定如何表示每一幅图像,以及如何度量它们之间的差异。我们能不能只看一幅图像中不同颜色的占比?图 8-1 展示了两张色彩分布大致相同但含义截然不同的图片:一张看起来像蓝天中的白云,另一张是希腊国旗。所以,颜色信息很可能不足以刻画一幅图像。
另一个简单的想法是度量图像之间像素值的差异。首先,把图像缩放成相同的宽度和高度。每幅图像用一个像素值矩阵表示。这个矩阵可以按行或按列堆叠成一个长向量。每个像素的颜色(例如颜色的 RGB 编码)现在成了图像的一个特征。最后,度量这些长像素向量之间的欧几里得距离(Euclidean distance)。这固然能让我们区分开希腊国旗和白云,但作为相似度度量,它过于严苛了。一朵云可以有上千种不同的形状,但它仍然是云。它可以被移到图像的边上,或者有一半落在阴影里。所有这些变换都会增大欧几里得距离,但都不应该改变"这张照片拍的仍然是云"这一事实。
问题在于,单个像素并不携带足够的关于图像的语义信息。因此,它们不是好的分析原子单元。
手动特征提取:SIFT 与 HOG
1999 年,计算机视觉研究者找到了一种利用图像块(image patch)统计量来表示图像的更好方法:尺度不变特征变换(Scale Invariant Feature Transform,SIFT)[Lowe, 1999]。
SIFT 最初是为目标识别(object recognition)任务开发的,该任务不仅要求正确地把图像标记为包含某个目标,还要精确定位目标在图像中的位置。这个过程包括:在一个可能尺度的金字塔上分析图像;检测可能指示目标存在的兴趣点(interest point);围绕兴趣点提取特征(在计算机视觉中通常称为图像描述子(image descriptor));以及确定目标的姿态。
多年来,SIFT 的用途扩展到不仅为兴趣点提取特征,还为整幅图像提取特征。SIFT 的特征提取过程与另一项技术——方向梯度直方图(Histogram of Oriented Gradients,HOG)[Dalal and Triggs, 2005]——非常相似。两者本质上都是计算梯度方向(gradient orientation)的直方图。下面我们详细描述这个过程。
图像梯度
要想做得比原始像素值更好,我们必须以某种方式把像素"组织"成更具信息量的单元。相邻像素之间的差异往往非常有用。在目标的边界处、有阴影的地方、图案内部或纹理表面上,像素值通常会有差异。相邻像素值的差异被称为图像梯度(image gradient)。
计算图像梯度最简单的方法,是分别计算图像沿水平(x)轴和垂直(y)轴的差异,然后把它们组合成一个二维向量。这涉及两次一维差分运算,可以很方便地用向量掩码(mask)或滤波器(filter)来表示。掩码 [1, 0, -1] 取左邻像素与右邻像素之差,或上邻像素与下邻像素之差,具体取决于我们把掩码应用于哪个方向。二维梯度滤波器也存在,不过就本例而言,一维滤波器已经足够了。
要把滤波器应用于图像,我们需要执行卷积(convolution)。它先把滤波器翻转,再与图像的一小块区域做内积,然后移到下一块区域。卷积在信号处理(signal processing)中非常常见。我们用 ∗ 来表示该运算:
\[ [a\; b\; c] \ast [1\; 2\; 3] = c \cdot 1 + b \cdot 2 + a \cdot 3 \]像素 \((i, j)\) 处的 x 和 y 梯度为:
\[ g_x(i, j) = [1\; 0\; -1] \ast [I(i-1, j)\; I(i, j)\; I(i+1, j)] = -I(i-1, j) + I(i+1, j) \]\[ g_y(i, j) = [1\; 0\; -1] \ast [I(i, j-1)\; I(i, j)\; I(i, j+1)] = -I(i, j-1) + I(i, j+1) \]它们合在一起构成梯度:
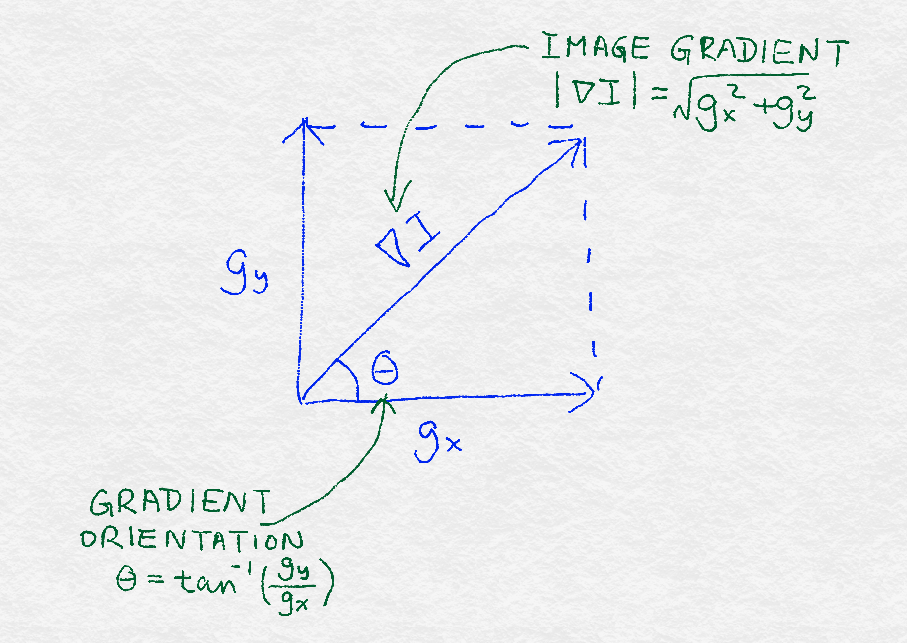
\[ \nabla I(i, j) = \begin{bmatrix} g_x(i, j) \\ g_y(i, j) \end{bmatrix} \]一个向量可以完全由它的方向和大小来描述。梯度的大小等于梯度的欧几里得范数 \(\sqrt{g_x^2 + g_y^2}\),它表示像素周围的像素值变化有多大。梯度的方向(或朝向)取决于水平与垂直方向变化的相对大小,可以计算为 \(\theta = \arctan\left(\frac{g_y}{g_x}\right)\)。图 8-2 阐明了这些数学概念。
图 8-3 展示了由垂直梯度和水平梯度组成的简单图像梯度的示例。每个示例都是一幅九个像素的图像,每个像素标有一个灰度值(较小的数对应较深的颜色)。每个图像下方显示了中心像素的梯度。左边的图像包含水平条纹,颜色只沿垂直方向变化,因此水平梯度为零,而垂直方向的梯度非零。中间的图像包含垂直条纹,因此水平梯度为零。右边的图像包含对角条纹,其梯度也是对角方向的。
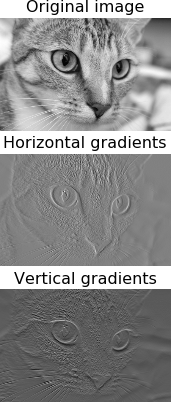
这个定义在合成的小玩具示例上是成立的。但它在真实图像上表现如何呢?在示例 8-1 中,我们用来自 scikit-image 的一张猫的图片来检验这一点,图 8-4 展示了这张图及其水平梯度和垂直梯度。由于梯度是在原始图像的每个像素位置计算的,我们最终得到两个新矩阵,每个矩阵都可以可视化为一张图像。
示例 8-1:用 Python 计算简单图像梯度
>>> import matplotlib.pyplot as plt
>>> import numpy as np
>>> from skimage import data, color
### Load the example image and turn it into grayscale
>>> image = color.rgb2gray(data.chelsea())
### Compute the horizontal gradient using the centered 1D filter.
### This is equivalent to replacing each non-border pixel with the
### difference between its right and left neighbors. The leftmost
### and rightmost edges have a gradient of 0.
>>> gx = np.empty(image.shape, dtype=np.double)
>>> gx[:, 0] = 0
>>> gx[:, -1] = 0
>>> gx[:, 1:-1] = image[:, :-2] - image[:, 2:]
### Same deal for the vertical gradient
>>> gy = np.empty(image.shape, dtype=np.double)
>>> gy[0, :] = 0
>>> gy[-1, :] = 0
>>> gy[1:-1, :] = image[:-2, :] - image[2:, :]
### Matplotlib incantations
>>> fig, (ax1, ax2, ax3) = plt.subplots(3, 1,
...     figsize=(5, 9),
...     sharex=True,
...     sharey=True)
>>> ax1.axis('off')
>>> ax1.imshow(image, cmap=plt.cm.gray)
>>> ax1.set_title('Original image')
>>> ax1.set_adjustable('box-forced')
>>> ax2.axis('off')
>>> ax2.imshow(gx, cmap=plt.cm.gray)
>>> ax2.set_title('Horizontal gradients')
>>> ax2.set_adjustable('box-forced')
>>> ax3.axis('off')
>>> ax3.imshow(gy, cmap=plt.cm.gray)
>>> ax3.set_title('Vertical gradients')
>>> ax3.set_adjustable('box-forced')
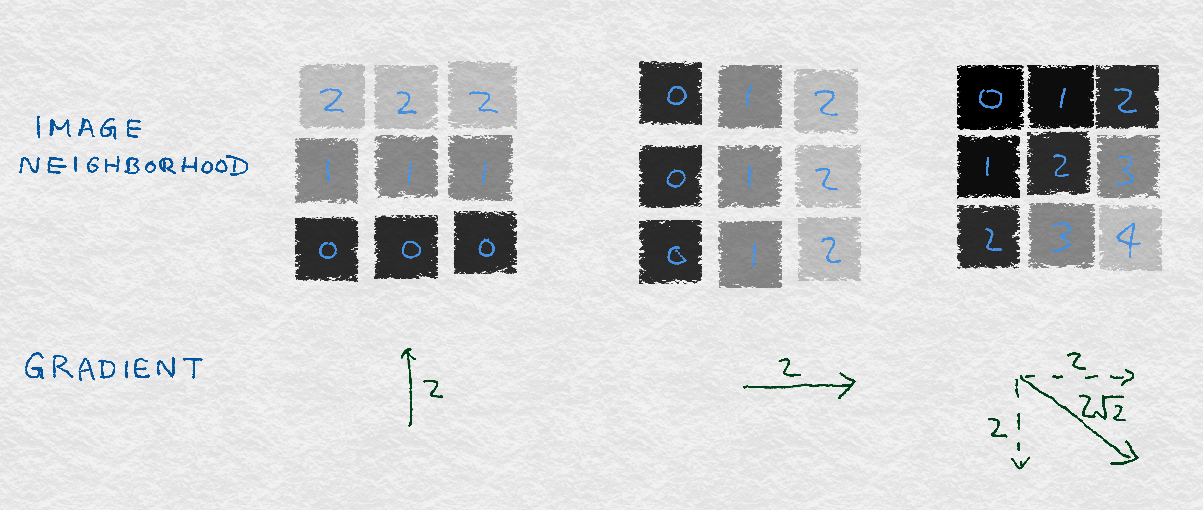
注意,水平梯度挑出的是强烈的垂直图案,比如猫眼睛的内缘;而垂直梯度挑出的是强烈的水平图案,比如胡须以及眼睛的上眼睑和下眼睑。乍一看这可能有点反直觉,但稍微想一想就明白了。水平(x)梯度识别的是水平方向的变化。一个强烈的垂直图案在大致相同的 x 位置上横跨多个 y 像素。因此,垂直图案会导致像素值在水平方向上产生差异。这也是我们的眼睛所察觉到的。
梯度方向直方图
单个图像梯度可以挑出图像邻域中细微的差异。但我们的眼睛看到的是比这更大的图案。例如,我们看到的是猫的一整根胡须,而不只是一小段。人类的视觉系统识别的是一个区域内的连续图案,所以要把图像邻域中的梯度汇总起来,我们还有更多工作要做。
我们到底该如何汇总向量呢?统计学家会回答:“看分布!“SIFT 和 HOG 都采用了这条路径。具体来说,它们计算梯度向量的(归一化)直方图作为图像特征。直方图把数据划分成若干桶(bin),并统计每个桶中有多少个数据点;这是一个(未归一化的)经验分布。归一化保证所有计数之和为 1。用数学语言说,就是它具有单位 \(\ell_1\) 范数。
图像梯度是一个向量,而向量可以用两个分量表示:方向和大小。所以,我们还需要决定如何设计直方图,把这两个分量都考虑进去。SIFT 和 HOG 都采用了一种方案:按梯度的方向角 \(\theta\) 对图像梯度分桶,并用每个梯度的大小作为权重。具体步骤如下:
- 把 0°–360° 分成大小相等的桶。
- 对邻域中的每个像素,把权重 \(w\) 加到与其方向 \(\theta\) 对应的桶中。\(w\) 是梯度大小和其他相关信息(比如该像素到图像块中心的距离的倒数)的函数。其思想是:梯度越大权重越大,而且靠近图像邻域中心的像素比远离中心的像素更重要。
- 对直方图进行归一化。
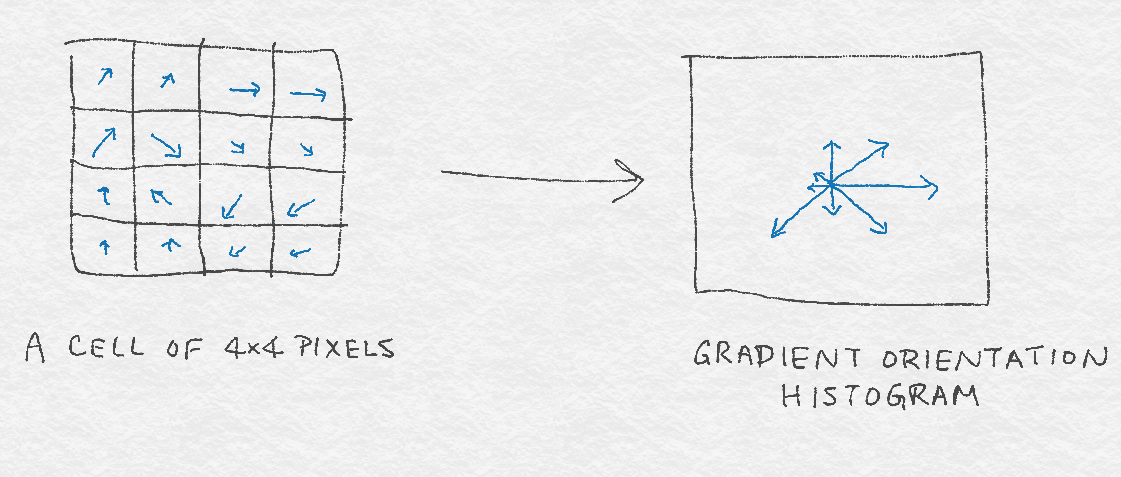
图 8-5 展示了一个由 4 × 4 像素的图像邻域构成的、具有 8 个桶的梯度方向直方图。
当然,在基本的梯度方向直方图算法中,有许多旋钮可以调节,还有一些可选的附加功能。和往常一样,正确的设置很可能高度依赖于人们想要分析的特定图像。
接下来,我们看看其中一些需要做的决策,以及它们可能对你的模型产生的影响。
应该有多少个桶?它们应该覆盖 0°–360°(有符号梯度)还是 0°–180°(无符号梯度)?
桶越多,对梯度方向的量化就越精细,因此保留了更多关于原始梯度的信息。但桶太多也没必要,还可能导致对训练数据的过拟合(overfitting)。例如,在一幅图像中识别猫,很可能并不依赖于猫的胡须恰好朝向 3°。
还有一个问题是,桶应该覆盖 0°–360°(这样会保留梯度沿 y 轴的符号),还是 0°–180°(不保留垂直梯度的符号)。HOG 原始论文的作者(Dalal and Triggs, 2005)通过实验确定,覆盖 0°–180° 的 9 个桶效果最好;而 SIFT 论文(Lowe, 2004)推荐覆盖 0°–360° 的 8 个桶。
应该使用什么样的权重函数?
HOG 论文比较了各种梯度大小加权方案:大小本身、它的平方或平方根、二值化,或者在高低两端做截断。在作者的实验中,朴素的大小本身(不加任何修饰)表现最好。
SIFT 也使用朴素的梯度大小。此外,它希望避免因图像窗口位置的微小变化而导致特征描述子的突变,因此它用一个以窗口中心度量的高斯距离函数,来降低来自邻域边缘的梯度的权重。换句话说,梯度大小被乘以 \(\frac{1}{2\pi\sigma^2} e^{-\|p - p_0\|^2 / 2\sigma^2}\),其中 \(p\) 是产生该梯度的像素的位置,\(p_0\) 是图像邻域中心的位置,而高斯宽度 \(\sigma\) 被设为邻域半径的一半。
SIFT 还希望避免因单个图像梯度方向的微小变化而导致方向直方图的大幅变化。因此,它使用一种插值技巧,把来自单个梯度的权重分摊到相邻的方向桶中。具体来说,根桶(梯度被分配到的桶)获得 1 乘以加权大小的投票;每个相邻桶获得 \(1 - d\) 的投票,其中 \(d\) 是它与根桶之间相差的直方图桶单位数。
总的来说,SIFT 中单个图像梯度的投票为:
\[ w(\nabla p, b) = w_b \sigma \|\nabla p\| \]其中 \(\nabla p\) 是像素 \(p\) 在桶 \(b\) 中的梯度,\(w_b\) 是桶 \(b\) 的插值权重,\(\sigma\) 是从 \(p\) 到中心的高斯距离。
邻域如何定义?它们应该如何覆盖图像?
HOG 和 SIFT 都采用了两级图像邻域表示:首先把相邻像素组织成单元(cell),再把相邻的单元组织成块(block)。为每个单元计算一个方向直方图,然后把各单元的直方图向量拼接起来,形成整个块的最终特征描述子。
SIFT 使用 16 × 16 像素的单元,组织成 8 个方向桶,再按 4 × 4 个单元组成块,这样每个图像邻域就有 4 × 4 × 8 = 128 个特征。
HOG 论文实验了矩形和圆形两种单元与块的形状。矩形单元称为 R-HOG 块,发现的最佳设置为 8 × 8 像素、每个单元 9 个方向桶、按 2 × 2 个单元组成块。圆形单元称为 C-HOG 块,其变体取决于中心单元的半径、单元是否按径向划分、外围单元的宽度等。
无论邻域如何组织,它们通常会重叠,以构成整幅图像的特征向量。换句话说,单元和块在图像上水平、垂直地移动,一次移动几个像素,直到覆盖整幅图像。
邻域架构的主要要素是多级组织和在图像上滑动的重叠窗口。同样的要素也被用于深度学习网络的设计中。
应该进行何种归一化?
归一化使特征描述子变得均衡,让它们具有可比的大小。它等同于我们在第 4 章中讨论过的缩放(scaling)。我们当时发现,对文本特征进行特征缩放(以 tf-idf 的形式)对分类准确率没有太大影响。图像特征的情况则大不相同,它们对自然图像中出现的照明和对比度变化相当敏感。例如,考虑一张苹果在强烈聚光灯下的图像,与一张苹果在透过窗户的柔和漫射光下的图像。即使目标相同,图像梯度的幅度也会相差很大。因此,计算机视觉中的图像特征化(featurization)通常从全局颜色归一化开始,以消除照明和对比度的差异。对于 SIFT 和 HOG,事实证明只要我们对特征做归一化,这类预处理并非必要。
SIFT 采用"归一化—阈值化—归一化"方案。首先,把块特征向量归一化为单位长度(\(\ell_2\) 归一化)。然后,把特征截断到某个最大值,以去除极端的照明效应,比如相机造成的颜色饱和。最后,把截断后的特征再次归一化为单位长度。
HOG 论文实验了涉及 \(\ell_2\) 和 \(\ell_1\) 范数的各种归一化方案,包括 SIFT 论文中使用的"归一化—阈值化—归一化"方案。作者发现,纯粹的 \(\ell_1\) 归一化比其他方法(它们的表现相当)略不可靠。
SIFT 架构
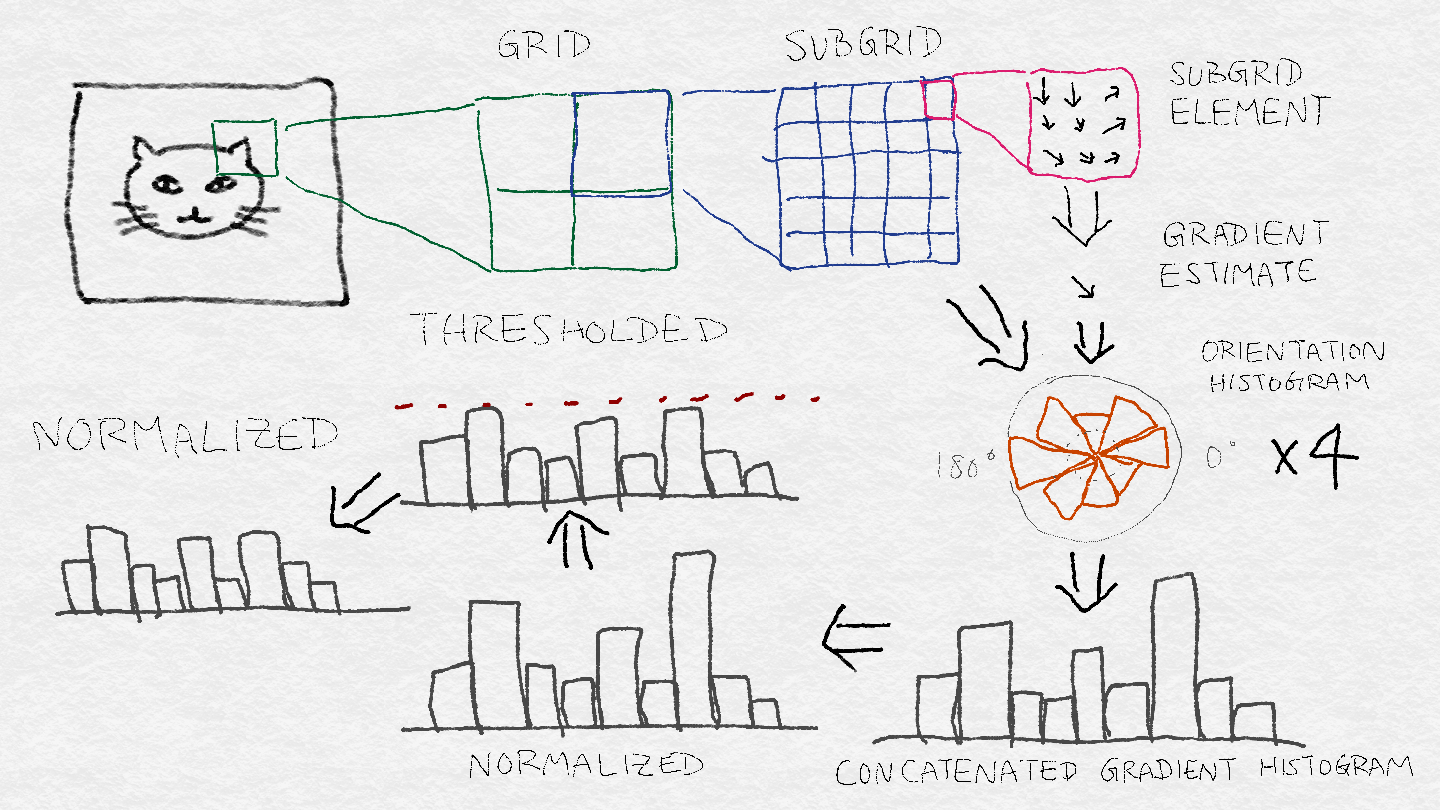
SIFT 流水线需要相当多的步骤。HOG 稍微简单一些,但遵循许多相同的基本步骤,例如创建梯度直方图和归一化。图 8-6 展示了 SIFT 架构。从原始图像中的一个感兴趣区域开始,我们首先把该区域划分成网格。每个网格单元再进一步划分成子网格。每个子网格元素包含若干像素,每个像素产生一个梯度。每个子网格元素产生一个加权梯度估计,其中权重的选取使得子网格元素之外的梯度也能有所贡献。然后,这些梯度估计被聚合为子网格的方向直方图,其中梯度可以像前面描述的那样进行加权投票。每个子网格的方向直方图再拼接起来,形成整个网格的一个长梯度方向直方图。(如果网格被划分成 2 × 2 个子网格,那么就有 4 个梯度方向直方图要拼接成 1 个。)这就是该网格的特征向量,它随后要经过"归一化—阈值化—归一化"过程:首先,把向量归一化为单位范数;然后,把各个值截断到最大阈值;最后,把阈值化后的向量再次归一化。这就是该图像块的最终 SIFT 特征描述子。
用深度神经网络学习图像特征
SIFT 和 HOG 在定义良好图像特征方面走过了很长的路。然而,计算机视觉领域最新的进展来自一个完全不同的方向:深度神经网络(deep neural network)模型。突破发生在 2012 年的 ImageNet 大规模视觉识别挑战赛(ILSVRC)上,多伦多大学的一组研究人员把上一年冠军的错误率几乎降低了一半。他们把自己的方法命名为"深度学习”(deep learning),以强调与前几代架构的神经网络模型不同,最新一代包含许多层层堆叠的神经网络和变换。2012 年 ILSVRC 的获胜模型——后来以第一作者的名字命名为 AlexNet——有 13 层(Krizhevsky et al., 2012)。2014 年 ILSVRC 的获胜者 GoogLeNet 有 22 层(Szegedy et al., 2014)。
从表面上看,堆叠神经网络的机制与 SIFT 和 HOG 的图像梯度直方图似乎截然不同。但对 AlexNet 的可视化显示,前几层本质上是在计算边缘梯度和其他简单图案,与 SIFT 和 HOG 非常相似;随后的层把局部图案组合成更全局的图案。最终得到的特征提取器远比之前的一切都更强大。
堆叠神经网络层(或任何其他分类模型)的基础设施并不新鲜。但训练如此复杂的模型需要大量的数据和大量的算力,这在不久前还无法实现。ImageNet 数据集包含来自 1,000 个类别的 120 万张带标签的图像。现代 GPU 加速了矩阵—向量计算,而后者正是许多机器学习模型(包括神经网络)的内核。深度学习方法的成功,建立在大量数据和大量 GPU 时长的可得性之上。
深度学习架构可以由几种类型的层组成。例如,AlexNet 包含全连接层(fully connected layer)、卷积响应归一化层(convolutional response normalization)和最大池化层(max-pooling)。下面我们逐一考察这些层。
全连接层
所有神经网络的核心都是输入的线性函数。我们在第 4 章中遇到的逻辑回归(logistic regression),就是一个神经网络的例子。全连接神经网络不过是对所有输入特征的一组线性函数。回忆一下,线性函数可以写成输入特征向量与权重向量的内积,再加上一个可能的常数项。一组线性函数可以表示为一个矩阵—向量乘积,其中权重向量变成了权重矩阵(\(\mathbf{W}\))。
全连接层的数学定义是:
\[ z = \mathbf{W}\mathbf{x} + \mathbf{b} \]其中 \(\mathbf{W}\) 的每一行都是一个权重向量,它把整个输入向量 \(x\) 映射为 \(z\) 中的一个输出。\(\mathbf{b}\) 是一个标量向量,表示每个神经元的常数偏移(即偏置(bias))。
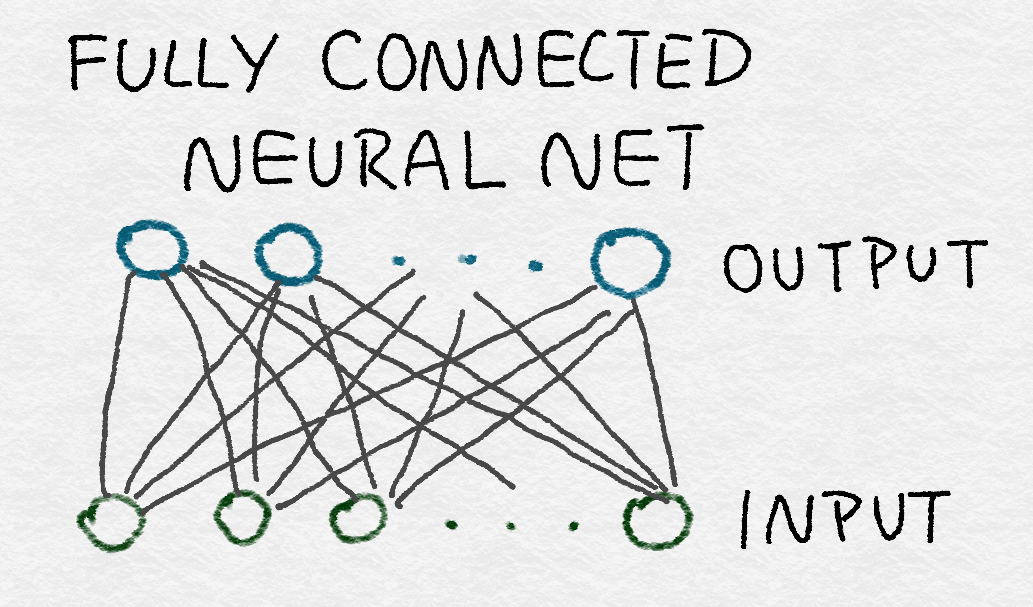
全连接层之所以叫"全连接”,是因为每个输入都可以参与每个输出的计算。数学上,这意味着矩阵 \(\mathbf{W}\) 中的值没有任何限制。(我们很快就会看到,卷积层对每个输出只使用一小部分输入。)从图形上看,全连接神经网络可以表示为一个完全二分图(complete bipartite graph),其中输入的每个节点都与输出的每个节点相连(见图 8-7)。
全连接层包含最大可能数量的参数(#输入 × #输出),因此被认为是昂贵的。这种稠密连接使网络能够检测可能涉及所有输入的全局图案。AlexNet 的最后两层就是全连接层,原因正在于此。给定输入后,各输出之间仍然相互独立。
卷积层
与全连接层相反,卷积层对每个输出只使用一部分输入。这个变换在输入上"移动",每次用少数几个特征产生输出。为了简化,可以对不同的输入集使用相同的权重,而不是为每组输入学习新的权重。
数学上,卷积算子接收两个函数作为输入,产生一个函数作为输出。它翻转其中一个输入函数,让它扫过另一个函数,并在每个点上输出两条相乘曲线下的总面积:
\[ (f \ast g)(t) = \int_{-\infty}^{\infty} f(\tau)\, g(t - \tau)\, d\tau = \int_{-\infty}^{\infty} g(\tau)\, f(t - \tau)\, d\tau \]计算曲线下总面积的方法是求积分。这个算子对输入是对称的,也就是说,翻转第一个输入还是第二个输入并不重要,输出是相同的。
我们在讨论图像梯度(“图像梯度”)时已经见过一个简单卷积的例子。但卷积的数学定义可能看起来仍然有点绕。这种"疯狂"自有其道理。用一个信号处理的例子来解释卷积背后的直觉最容易。
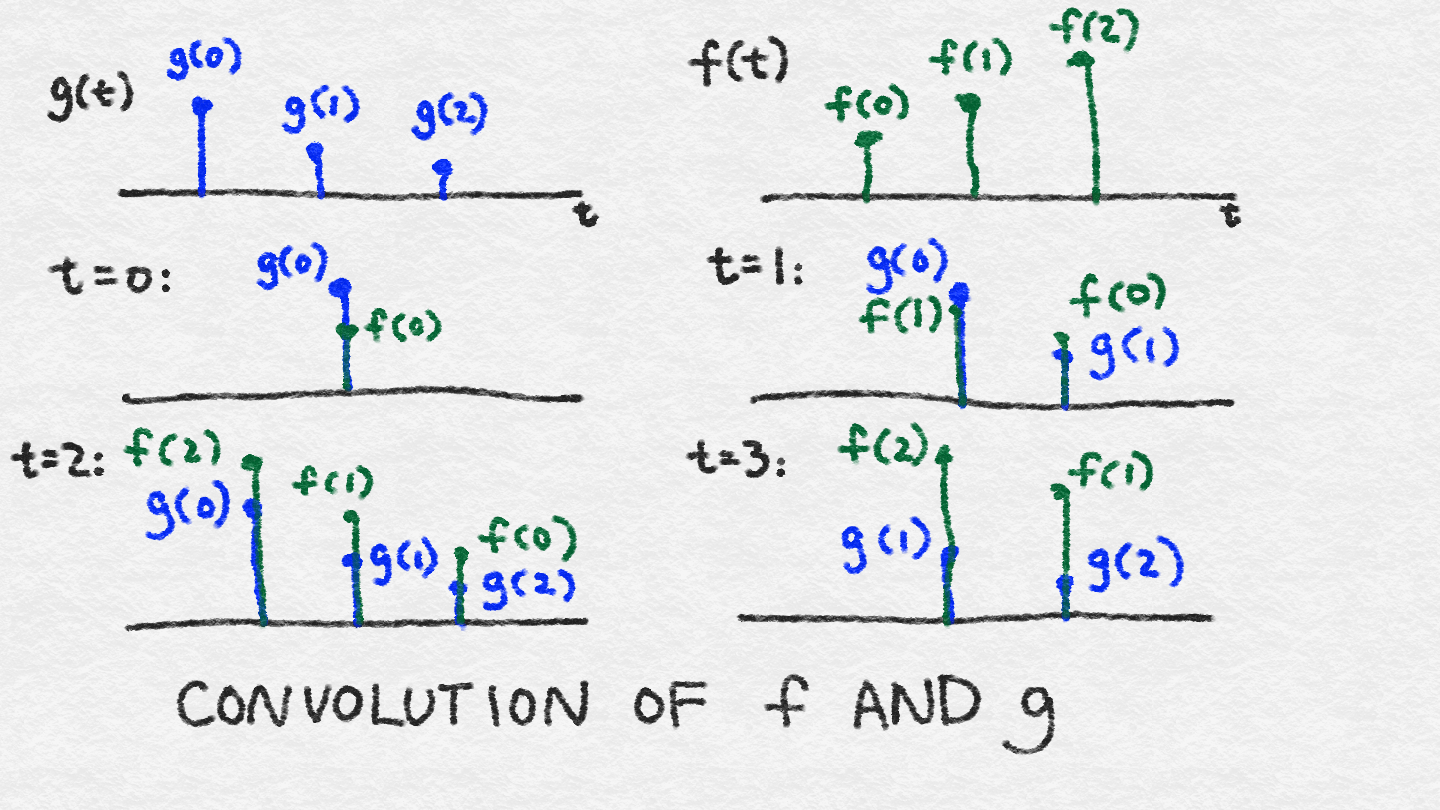
想象我们有一个小黑匣子。为了弄清黑匣子做什么,我们向它输入一个单位的刺激,把输出记录在一张小纸上,然后一直等到对原始刺激不再有任何响应为止。随时间变化的这个函数就是响应函数(response function),我们把它记作 \(g(t)\)。
现在想象我们有一个疯狂而狂野的信号 \(f(t)\),我们把它送入黑匣子。在时间 \(t = 0\) 时,\(f(0)\) 与黑匣子交互,产生 \(f(0)\) 乘以 \(g(0)\)。在时间 \(t = 1\) 时,\(f(1)\) 进入黑匣子并乘以 \(g(0)\);与此同时,黑匣子继续响应之前的信号 \(f(0)\),现在它被乘以 \(g(1)\)。所以 \(t = 1\) 时刻的总输出是 \((f(0) \cdot g(1)) + (f(1) \cdot g(0))\)。到时间 \(t = 2\) 时,情况变得更加复杂:\(f(2)\) 登场,而 \(f(0)\) 和 \(f(1)\) 还在继续产生各自的响应。\(t = 2\) 时刻的总输出是 \((f(0) \cdot g(2)) + (f(1) \cdot g(1)) + (f(2) \cdot g(0))\)。就这样,响应函数实际上在时间上被翻转了:\(\tau = 0\) 总是与当前进入黑匣子的信号交互,而响应函数的尾部与之前进入的信号交互。
图 8-8 展示了每个时间步参与运算的量(注意,为了方便描述,我们把时间离散化了——实际上时间是连续的,所以求和其实应该是积分)。在计算卷积在某个特定时间步的值时,你把重叠的信号相乘再求和。
这个黑匣子被称为线性系统(linear system),因为它所做的不过是标量乘法和求和。卷积算子干净利落地刻画了线性系统的效应。
卷积背后的直觉
卷积算子刻画了一个线性系统的效应:它把输入信号与其响应函数相乘,并对当前对过去所有输入的响应求和。
在我们的例子中,\(g(t)\) 用来表示响应函数,\(f(t)\) 表示输入。但由于卷积是对称的,谁是响应、谁是输入其实并不重要,输出只是两者的结合。\(g(t)\) 也被称为滤波器(filter)。1
图像是二维信号,所以我们需要一个二维滤波器。二维卷积滤波器(convolutional filter)把一维情形扩展到对两个变量求积分:
\[ (f \ast g)[i, j] = \sum_{u=0}^{m} \sum_{v=0}^{n} f[u, v]\, g[i - u, j - v] \]由于数字图像具有离散的像素,卷积积分变成了离散求和。此外,由于像素数量是有限的,滤波器函数只需要有限个元素。在图像处理中,二维卷积滤波器也被称为核(kernel)或掩码(mask)。
对图像应用卷积滤波器时,人们不一定定义一个覆盖整幅图像的巨型滤波器。相反,人们构造一个只覆盖几个像素乘几个像素的小滤波器,并在整幅图像上应用同一个滤波器,沿水平和垂直像素方向移动(见图 8-9)。
由于整幅图像使用同一个滤波器,我们只需要定义一小套参数。代价是滤波器一次只能吸收一小块像素邻域内的信息。换句话说,卷积神经网络识别的是局部图案,而不是全局图案。
卷积滤波器示例
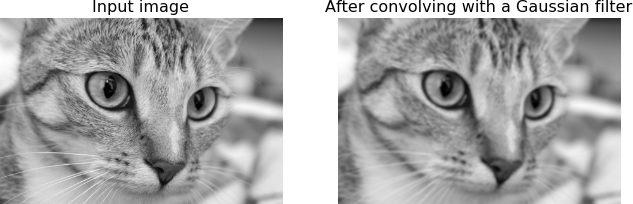
在这个例子中,我们对一幅图像应用高斯滤波器。高斯函数在零点周围形成一个平滑且对称的"土丘"。该滤波器对附近函数值取加权平均。当应用于图像时,它的效果是模糊相邻的像素值。二维高斯滤波器的定义是:
\[ G(x, y) = \frac{1}{2\pi\sigma^2} e^{-\frac{x^2 + y^2}{2\sigma^2}} \]其中 \(\sigma\) 是高斯函数的标准差,它控制"土丘"的宽度。
在示例 8-2 中,我们首先创建一个二维高斯滤波器,然后把它与我们的最爱——那张猫的图片——做卷积,得到一只模糊的猫(见图 8-10)。注意,这并不是计算高斯滤波器最精确的方式,但它最容易理解。更好的实现会在每个离散点上取加权平均值,而不是简单的点估计。
示例 8-2:在图像上应用简单的高斯滤波器
>>> import numpy as np
# First create X,Y meshgrids of size 5x5 on which we compute the Gaussian
>>> ind = [-1., -0.5, 0., 0.5, 1.]
>>> X, Y = np.meshgrid(ind, ind)
>>> X
array([[-1. , -0.5,  0. ,  0.5,  1. ],
       [-1. , -0.5,  0. ,  0.5,  1. ],
       [-1. , -0.5,  0. ,  0.5,  1. ],
       [-1. , -0.5,  0. ,  0.5,  1. ],
       [-1. , -0.5,  0. ,  0.5,  1. ]])
# G is a simple, unnormalized Gaussian kernel where the value at (0,0) is 1.0
>>> G = np.exp(-(np.multiply(X, X) + np.multiply(Y, Y)) / 2)
>>> G
array([[ 0.36787944,  0.53526143,  0.60653066,  0.53526143,  0.36787944],
       [ 0.53526143,  0.77880078,  0.8824969 ,  0.77880078,  0.53526143],
       [ 0.60653066,  0.8824969 ,  1.        ,  0.8824969 ,  0.60653066],
       [ 0.53526143,  0.77880078,  0.8824969 ,  0.77880078,  0.53526143],
       [ 0.36787944,  0.53526143,  0.60653066,  0.53526143,  0.36787944]])
>>> from skimage import data, color
>>> cat = color.rgb2gray(data.chelsea())
>>> from scipy import signal
>>> blurred_cat = signal.convolve2d(cat, G, mode='valid')
>>> import matplotlib.pyplot as plt
>>> fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 4),
...     sharex=True, sharey=True)
>>> ax1.axis('off')
>>> ax1.imshow(cat, cmap=plt.cm.gray)
>>> ax1.set_title('Input image')
>>> ax1.set_adjustable('box-forced')
>>> ax2.axis('off')
>>> ax2.imshow(blurred_cat, cmap=plt.cm.gray)
>>> ax2.set_title('After convolving with a Gaussian filter')
>>> ax2.set_adjustable('box-forced')
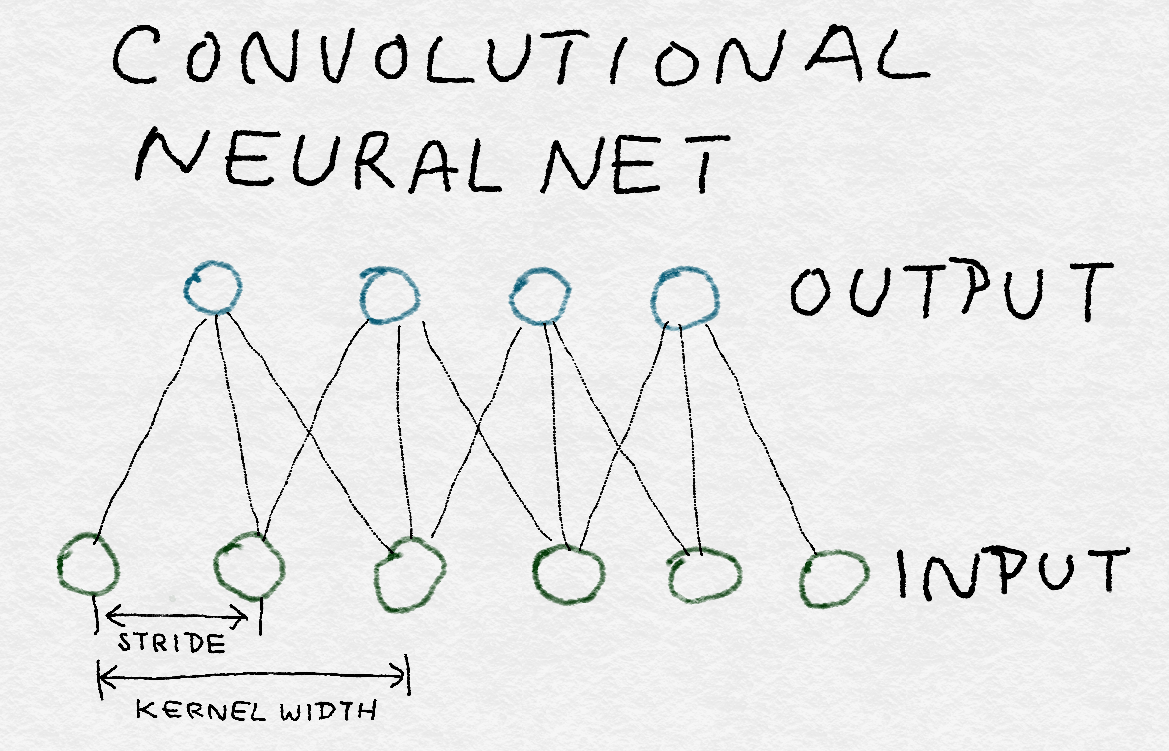
AlexNet 中的卷积层是三维的。换句话说,它们对来自上一层的体素(voxel,即表示图像三维空间的数组中的值)进行操作。第一个卷积神经网络接收原始 RGB 图像,为跨越全部三个颜色通道的局部图像邻域学习卷积滤波器。后续层接收跨空间和核维度的体素作为输入。更多细节见图 8-14。
修正线性单元(ReLU)变换
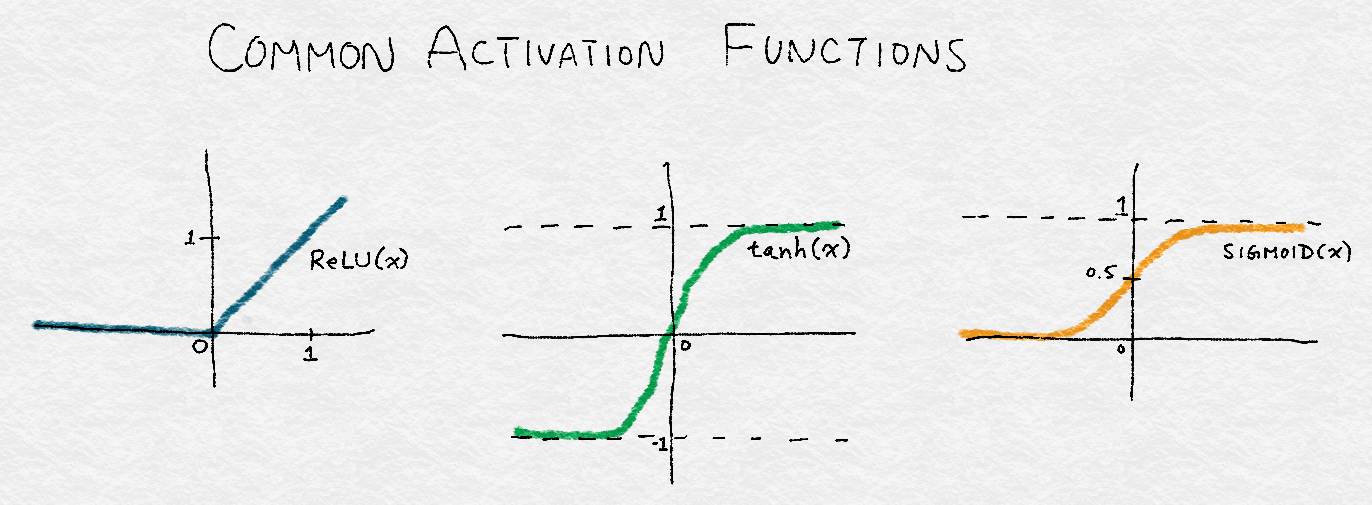
神经网络的输出通常还要经过另一个非线性变换,也称为激活函数(activation function)。常见的选择有 tanh 函数(一个界于 -1 和 1 之间的平滑非线性函数)、sigmoid 函数(一个界于 0 和 1 之间的平滑非线性函数,在“用逻辑回归做分类”中介绍过),或者所谓的修正线性单元(rectified linear unit,ReLU)。ReLU 是线性函数的一个简单变体,把负的部分清零。换句话说,它裁掉负值,但让正的部分保持无界。ReLU 的取值范围从 0 延伸到 ∞。
常见激活函数
ReLU 是把负部分清零的线性函数:
\[ \text{ReLU}(x) = \max(0, x) \]tanh 函数是一个三角函数,从 -1 平滑地增加到 1:
\[ \tanh(x) = \frac{\sinh(x)}{\cosh(x)} = \frac{e^x - e^{-x}}{e^x + e^{-x}} \]sigmoid 函数从 0 平滑地增加到 1:
\[ \text{sigmoid}(x) = \frac{1}{1 + e^{-x}} \]这三个函数如图 8-11 所示。
ReLU 变换对非负函数(如原始图像或高斯滤波器)没有影响。然而,一个训练好的神经网络——无论是全连接的还是卷积的——很可能会输出负值。AlexNet 使用 ReLU 而不是其他变换,理由是训练时收敛更快(Krizhevsky et al., 2012)。它对每一个卷积层和全连接层都应用 ReLU。
响应归一化层
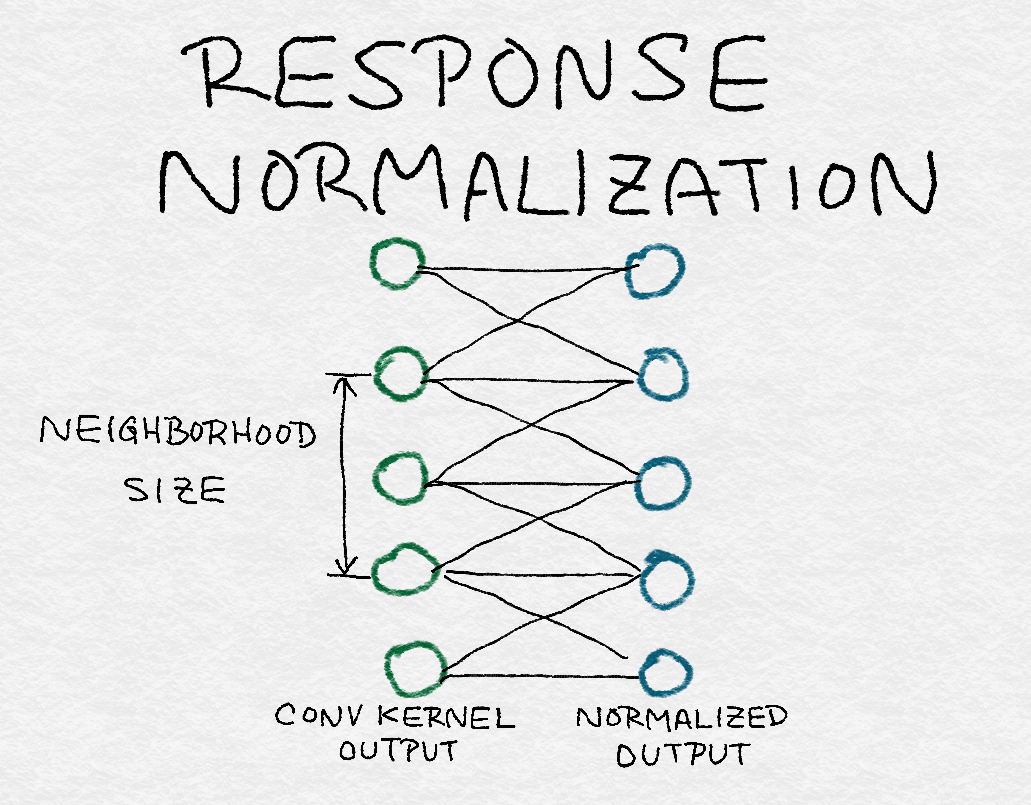
经过第 4 章和本章前面的讨论,归一化现在应该是一个熟悉的概念了。归一化是用集体总响应的某个函数去除单个输出。因此,理解归一化的另一种方式是:它在相邻者之间制造竞争,因为每个输出的强度现在是相对于其邻居来度量的(见图 8-12)。AlexNet 在不同的核之间对每个位置的输出进行归一化。
局部响应归一化在相邻核之间制造竞争
顾名思义,局部响应归一化(local response normalization)是用一个值及其邻居的某种组合来除它。公式如下:
\[ y_k = \frac{x_k}{\left( c + \alpha \sum_{\ell \in \text{neighborhood of } k} x_\ell^2 \right)^\beta} \]这里,\(x_k\) 是第 \(k\) 个核的输出,\(y_k\) 是相对于邻域中其他核归一化后的响应。归一化对每个输出位置分别进行。也就是说,对每个输出位置 \((i, j)\),我们在附近的卷积核输出上做归一化。注意,这与在图像邻域或输出位置上做归一化不是一回事。核邻域的大小、\(c\)、\(\alpha\) 和 \(\beta\) 都是超参数,通过一个验证图像集来调优。
池化层
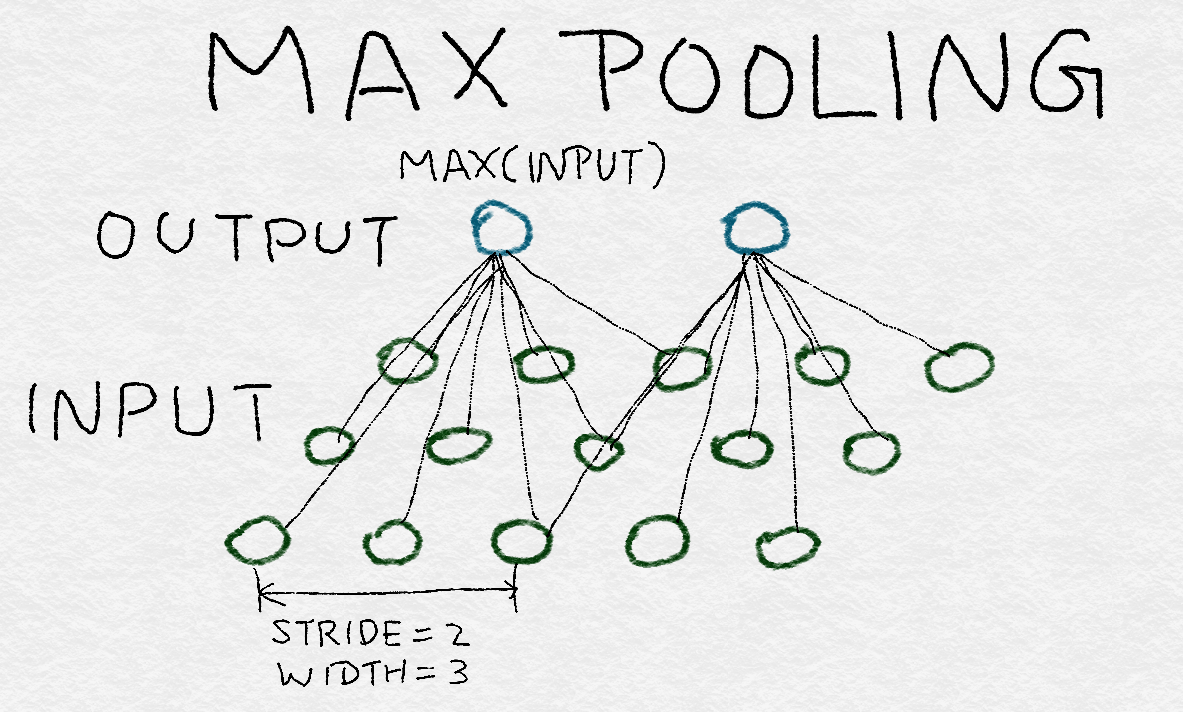
池化层(pooling layer)把多个输入合并成单个输出。当卷积滤波器在图像上移动时,它为镜头下的每个邻域生成一个输出。池化强制一个局部图像邻域产生一个值,而不是许多值。这减少了深度学习网络中间层的输出数量,从而有效降低了网络对训练数据过拟合的概率。
池化输入的方式有多种:取平均、求和(或计算广义范数),或者取最大值。池化在图像或中间输出层上移动。AlexNet 使用重叠的最大池化(max pooling),以两个像素(或输出)为步幅在图像上移动,并对三个邻居做池化。
AlexNet 的结构
总的来说,AlexNet 包含五个卷积层、两个响应归一化层、三个最大池化层和两个全连接层。再加上最终的分类输出层,模型中一共有 13 个神经网络层,组成 8 个层组。详见图 8-14。
输入图像首先被缩放到 256 × 256 像素。实际输入是大小为 224 × 224、带有 3 个颜色通道的随机裁剪。前两个卷积层各自后面跟着一个响应归一化层和一个最大池化层,最后一个卷积层后面跟着最大池化。原始论文把训练数据和计算拆分到两块 GPU 上。层之间的通信大多限制在同一块 GPU 内部;例外是第 2 和第 3 层组之间,以及第 5 层组之后。在这些边界点上,下一层接收来自上一层、横跨两块 GPU 的核体素作为输入。每个中间层之后都跟着 ReLU 变换。
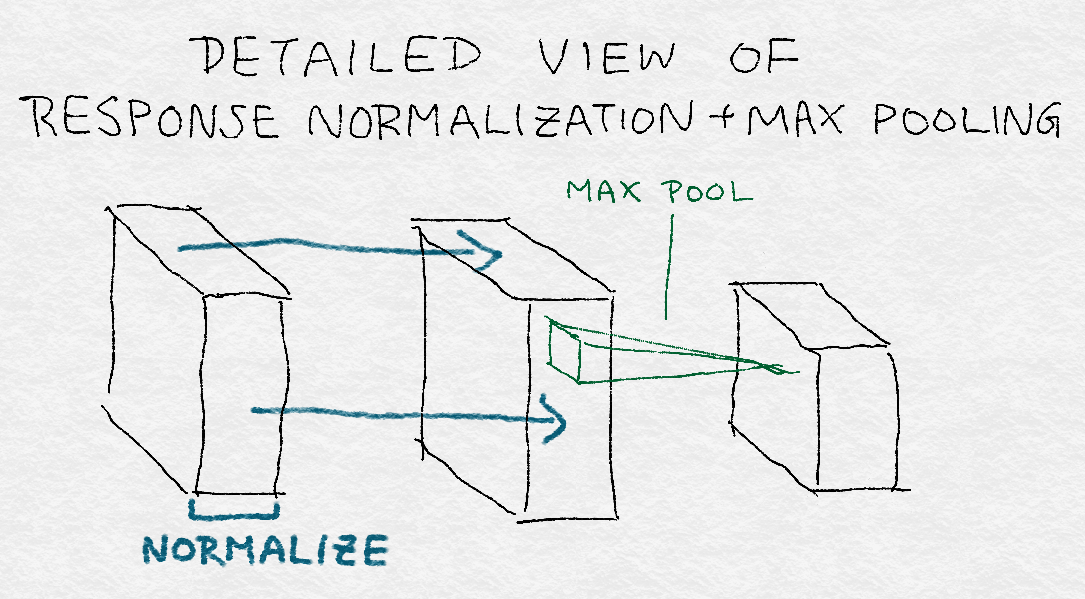
图 8-15 展示了"卷积 + 响应归一化 + 最大池化"的详细视图。注意,归一化常数是在核之间计算的,而池化是在图像区域上进行的。此外,池化会降低该层的维度。
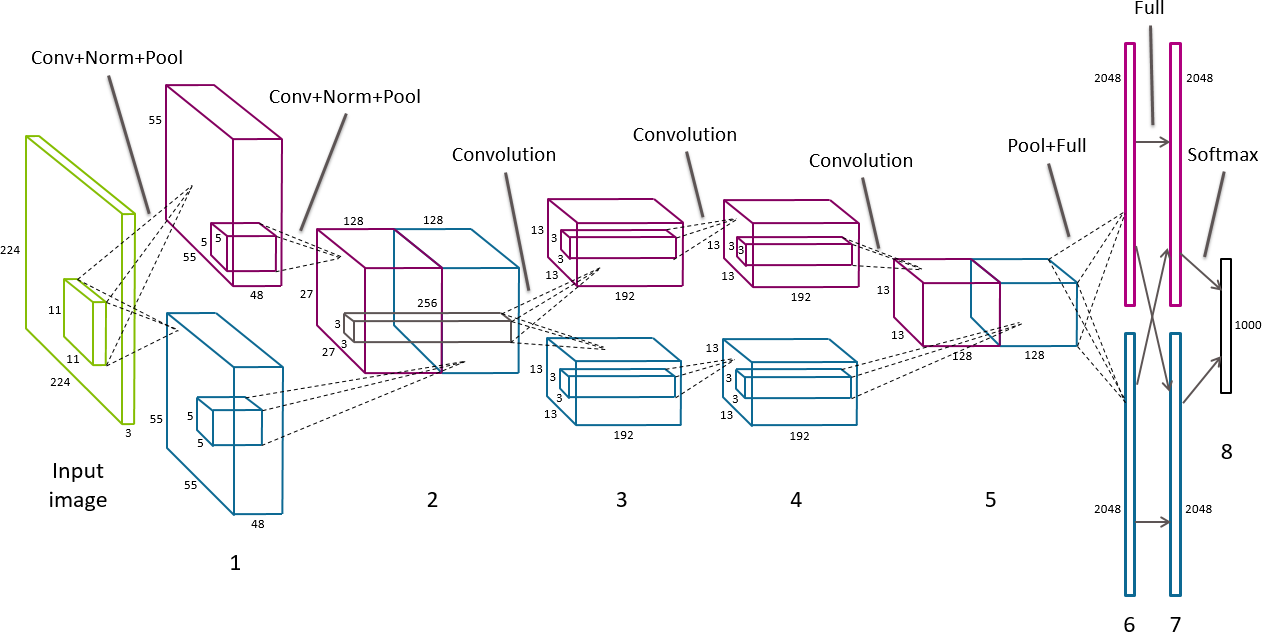
注意,AlexNet 的架构让人想起 SIFT/HOG 特征提取器的"梯度直方图—归一化—阈值化—归一化"架构(见图 8-6),但层数要多得多。(“深度学习"中的"深"正源于此。)然而,与 SIFT/HOG 不同的是,卷积核和全连接权重是从数据中学习得来的,而不是预先定义的。另外,SIFT 中的归一化步骤是在整个图像区域的特征向量上进行的,而 AlexNet 中的响应归一化层是在卷积核之间做归一化。
从高层次看,该模型首先从局部图像邻域中提取图案。每一层都建立在前一层输出的基础上,实际上覆盖了原始图像上越来越大的区域。因此,即使前五个卷积层的核宽度都很小,后面的层也能形成更全局的图案。最后的全连接层是最全局的。
虽然图案的要点在概念上是清晰的,但要可视化每一层实际挑出的图案却是一个难题。图 8-16 和 8-17 展示了模型学习到的前两层卷积核的可视化。第一层由不同方向的灰度边缘和纹理,以及颜色块和颜色纹理的检测器组成;第二层似乎包含各种平滑图案的检测器。
尽管该领域取得了巨大进步,图像特征化仍然更像一门艺术,而不是一门科学。十年前,人们用图像梯度、边缘检测、方向、空间线索、平滑和归一化的组合,手工打造特征提取步骤。如今,深度学习架构师构建的模型封装了许多同样的思想,但参数是从训练图像中自动学习出来的。那种神奇的黑魔法依然存在,只是被隐藏到了模型里更深一层的抽象之中!
小结
临近尾声,我们可以借助已建立的直觉,更好地理解为什么最直白、最简单的图像特征,在做图像分类这类任务时并不总是最有用的。与其把每个像素表示为一个原子单元,更重要的是考虑像素与周围其他像素之间的关系。我们可以把为其他任务开发的技术——比如 SIFT 和 HOG——改造过来,通过分析邻域中的梯度,更好地跨整幅图像提取特征。
近年来下一个重大飞跃,是把深度神经网络应用于计算机视觉,把图像特征提取推得更远。这里要记住的关键是,深度学习把许多神经网络层和变换层层堆叠在一起。其中一些层,单独考察时,开始梳理出与人类视觉的构建模块可对应的特征:勾勒线条、梯度、颜色映射。
参考文献
“CS231n: Convolutional Neural Networks for Visual Recognition.” Retrieved from http://cs231n.github.io/convolutional-networks/.
Dalal, Navneet, and Bill Triggs. “Histograms of Oriented Gradients for Human Detection.” Proceedings of the 2005 IEEE Computer Society Conference on Computer Vision and Pattern Recognition (2005): 886-893.
Eliot, Lise. What’s Going On in There? How the Brain and Mind Develop in the First Five Years of Life. New York: Bantam Books, 2000.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey Hinton. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems 25 (2012): 1097-1105.
Lowe, David G. “Object Recognition from Local Scale-Invariant Features.” Proceedings of the International Conference on Computer Vision (1999): 1150-1157.
Lowe, David G. “Distinctive Image Features from Scale-Invariant Keypoints.” International Journal of Computer Vision 60:2 (2004): 91-110.
Malisiewicz, Tomasz. “From Feature Descriptors to Deep Learning: 20 Years of Computer Vision.” Tombone’s Computer Vision Blog, January 20, 2015. http://www.computervisionblog.com/2015/01/from-feature-descriptors-to-deep.html.
Szegedy, Christian, Wei Liu, Yangqing Jia, Pierre Sermanet, Scott Reed, Dragomir Anguelov, Dumitru Erhan, Vincent Vanhoucke, and Andrew Rabinovich. “Going Deeper with Convolutions.” Proceedings of the 2015 IEEE Conference on Computer Vision and Pattern Recognition (2015): 1-9.
Zeiler, Matthew D., and Rob Fergus. “Visualizing and Understanding Convolutional Networks,” Proceedings of the 13th European Conference on Computer Vision (2014): 818-833.
[1] 严格来说,滤波器是一种消除傅里叶频谱(Fourier spectrum)中某些分量的变换。但如今把"滤波器"用作通用术语已经越来越普遍。