非线性特征化:K-Means 模型堆叠
当数据位于线性子空间中时——比如一张扁平的薄饼——PCA 非常有用。但如果数据形成更复杂的形状呢?[1] 一个平面(线性子空间)可以推广为流形(manifold)(非线性子空间),可以把它想象成一张以各种方式被拉伸和卷曲的表面。[2]
如果线性子空间是一张平纸,那么卷起来的纸就是非线性流形的一个简单例子。非正式地,这被称为瑞士卷(Swiss roll)(见图 7-1)。一旦卷起来,一张 2D 平面就占据了 3D 空间。然而它本质上仍然是一个 2D 物体。换句话说,它具有低内在维度(intrinsic dimensionality)——这个概念我们在第 6 章的"直觉"一节已经接触过。如果我们能以某种方式把瑞士卷展开,就能恢复那张 2D 平面。这正是非线性降维(nonlinear dimensionality reduction)的目标:它假设流形比它所占据的完整维度更简单,并试图将其展开。
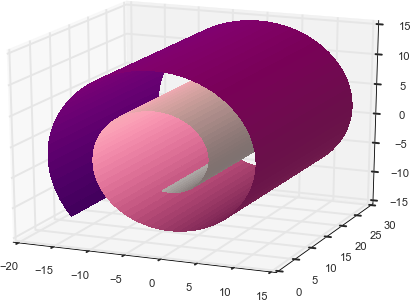
关键的观察是:即使一个大的流形看起来复杂,每个点周围的局部邻域也常常可以用一小片平面很好地近似。换句话说,就是用局部结构(小块)来编码全局结构。[3] 非线性降维也被称为非线性嵌入(nonlinear embedding)或流形学习(manifold learning)。非线性嵌入对于把高维数据激进地压缩成低维数据很有用,它们常常用于二维或三维的可视化。
然而,特征工程的目标与其说是把特征维度压得尽可能低,不如说是为任务找到正确的特征。在本章中,正确的特征就是那些表示数据空间特性的特征。
聚类算法(clustering algorithm)通常不被当作学习局部结构的技术来介绍,但事实上它们恰恰能做到这一点。彼此接近的点(“接近"可以由选定的度量来定义)属于同一个簇(cluster)。给定一个聚类结果,一个数据点可以用它的簇隶属向量(cluster membership vector)来表示。如果簇的数量小于原始特征的数量,那么新的表示就会比原来的维度更少;原始数据被压缩到了更低的维度。我们将在本章展开这个想法。
与非线性嵌入技术相比,聚类可能产生更多的特征。但如果最终目标是特征工程而不是可视化,这就不是问题。
我们将用一个常见的聚类算法——k-means——来说明局部结构学习的想法。它简单易懂、易于实现。与其说是非线性流形降维,更准确的说法是:k-means 执行的是非线性流形特征提取(nonlinear manifold feature extraction)。使用得当,它可以成为我们特征工程武器库中的强大工具。
K-Means 聚类(k-Means Clustering)
k-means 是一种聚类算法。聚类算法根据数据在空间中的布局对数据进行分组。它们是无监督(unsupervised)的,因为它们不需要任何标签——推断簇标签是算法的工作,仅基于数据本身的几何形状。
聚类算法依赖于度量(metric)——数据点之间接近程度的度量。最流行的度量是欧几里得距离(Euclidean distance)或欧几里得度量(Euclidean metric)。它来自欧几里得几何,度量两点之间的直线距离。它对我们来说应该非常自然,因为这就是我们在日常物理现实中看到的距离。
两个向量 \(\mathbf{x}\) 和 \(\mathbf{y}\) 之间的欧几里得距离是 \(\mathbf{x} - \mathbf{y}\) 的 \(\ell_2\) 范数。(关于 \(\ell_2\) 范数的更多内容,参见第 2 章的”\(\ell_2\) 归一化"一节。)用数学语言说,它通常写作 \(\lVert \mathbf{x} - \mathbf{y} \rVert_2\),或简写为 \(\lVert \mathbf{x} - \mathbf{y} \rVert\)。
k-means 建立的是硬聚类(hard clustering),也就是说每个数据点被分配到且仅被分配到一个簇。算法学习定位簇中心(cluster center),使得每个数据点到其簇中心的欧几里得距离总和最小化。对于那些喜欢读数学而不是文字的人,这里是目标函数:
\[ \min_{C_1, \ldots, C_k, \boldsymbol{\mu}_1, \ldots, \boldsymbol{\mu}_k} \sum_{i=1}^{k} \sum_{\mathbf{x} \in C_i} \lVert \mathbf{x} - \boldsymbol{\mu}_i \rVert_2 \]每个簇 \(C_i\) 包含一个数据点子集。簇 \(i\) 的中心等于簇中所有数据点的平均值:
\[ \boldsymbol{\mu}_i = \frac{\sum_{\mathbf{x} \in C_i} \mathbf{x}}{n_i} \]其中 \(n_i\) 表示簇 \(i\) 中数据点的数量。
图 7-2 展示了 k-means 在两个不同的随机生成数据集上的工作效果。(a)中的数据由均值不同但方差相同的随机高斯分布生成。(c)中的数据是均匀随机生成的。这些玩具问题非常容易解决,k-means 做得很好。(结果可能对簇的数量敏感,而簇的数量必须事先提供给算法。)
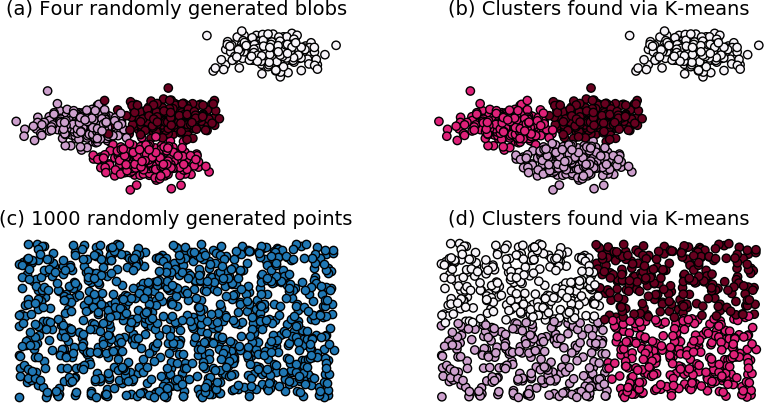
这个示例的代码见示例 7-1。
示例 7-1:生成 K-Means 示例的代码
>>> import numpy as np
>>> from sklearn.cluster import KMeans
>>> from sklearn.datasets import make_blobs
>>> import matplotlib.pyplot as plt
>>> n_data = 1000
>>> seed = 1
>>> n_clusters = 4
# Generate random Gaussian blobs and run k-means
>>> blobs, blob_labels = make_blobs(n_samples=n_data, n_features=2,
...                                 centers=n_centers, random_state=seed)
>>> clusters_blob = KMeans(n_clusters=n_centers, random_state=seed).fit_predict(blobs)
# Generate data uniformly at random and run k-means
>>> uniform = np.random.rand(n_data, 2)
>>> clusters_uniform = KMeans(n_clusters=n_clusters,
...                           random_state=seed).fit_predict(uniform)
# Matplotlib incantations for visualizing results
>>> figure = plt.figure()
>>> plt.subplot(221)
>>> plt.scatter(blobs[:, 0], blobs[:, 1], c=blob_labels, cmap='gist_rainbow')
>>> plt.title("(a) Four randomly generated blobs", fontsize=14)
>>> plt.axis('off')
>>> plt.subplot(222)
>>> plt.scatter(blobs[:, 0], blobs[:, 1], c=clusters_blob, cmap='gist_rainbow')
>>> plt.title("(b) Clusters found via K-means", fontsize=14)
>>> plt.axis('off')
>>> plt.subplot(223)
>>> plt.scatter(uniform[:, 0], uniform[:, 1])
>>> plt.title("(c) 1000 randomly generated points", fontsize=14)
>>> plt.axis('off')
>>> plt.subplot(224)
>>> plt.scatter(uniform[:, 0], uniform[:, 1], c=clusters_uniform, cmap='gist_rainbow')
>>> plt.title("(d) Clusters found via K-means", fontsize=14)
>>> plt.axis('off')
聚类即表面铺瓦(Clustering as Surface Tiling)
聚类的常见应用假设存在可以找到的自然簇;也就是说,在原本空旷的空间中散布着一些数据密集的区域。在这些情况下,存在"正确"簇数量的概念,人们发明了聚类索引(clustering index)来衡量数据分组的质量,以便选择 k。
然而,当数据像图 7-2(c)那样相当均匀地铺开时,就不再存在正确的簇数量了。在这种情况下,聚类算法扮演的角色是向量量化(vector quantization),即把数据划分成有限数量的块。簇的数量可以根据使用量化向量代替原始向量时的可接受近似误差来选择。
从视觉上看,k-means 的这种用法可以想象成用小块覆盖数据表面,就像图 7-3 那样。这确实是我们在瑞士卷数据集上运行 k-means 得到的结果。
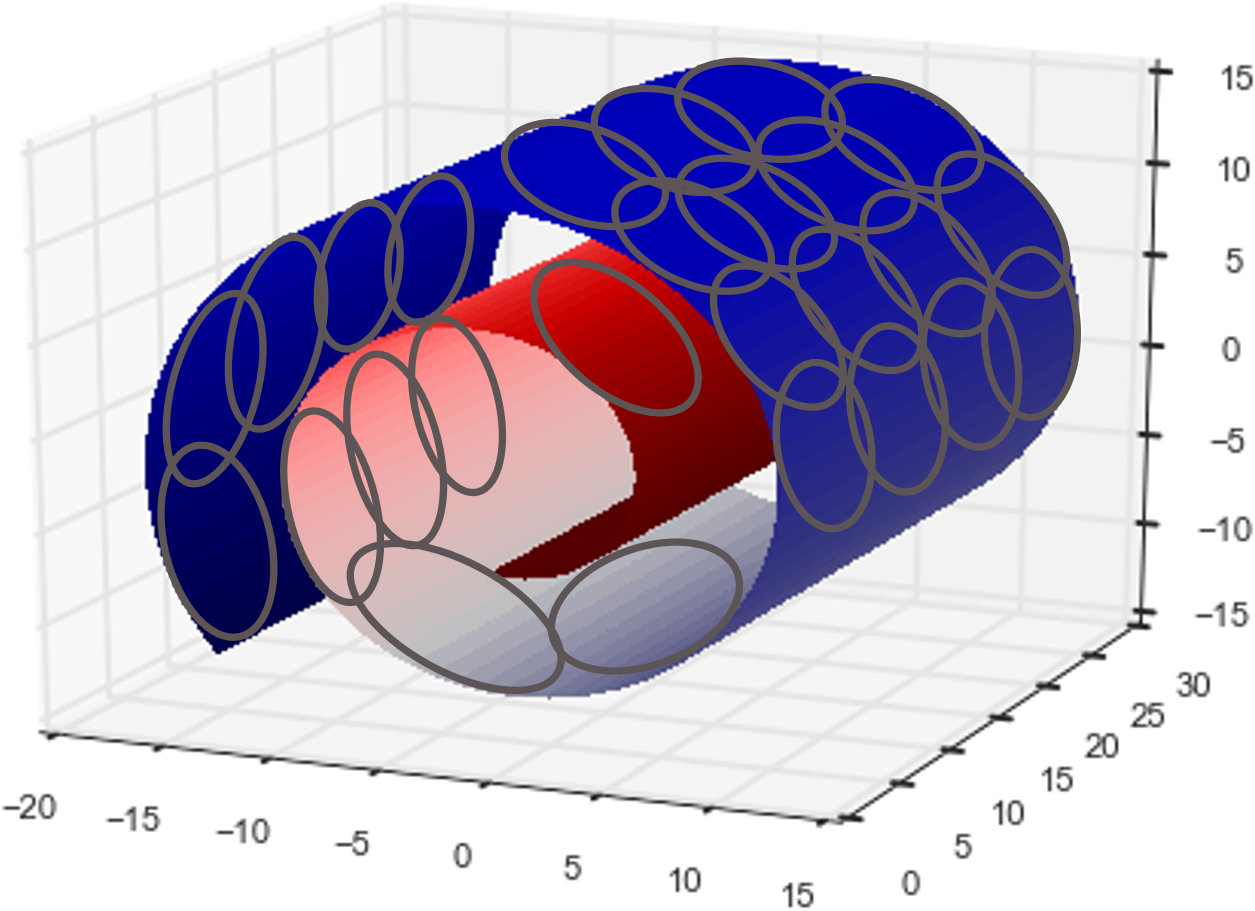
示例 7-2 使用 scikit-learn 在瑞士卷上生成一个带噪声的数据集,用 k-means 对它聚类,并用 Matplotlib 可视化聚类结果。数据点根据它们的簇 ID 着色。
示例 7-2:对瑞士卷做 K-Means
>>> from mpl_toolkits.mplot3d import Axes3D
>>> from sklearn import manifold, datasets
# Generate a noisy Swiss roll dataset
>>> X, color = datasets.samples_generator.make_swiss_roll(n_samples=1500)
# Approximate the data with 100 k-means clusters
>>> clusters_swiss_roll = KMeans(n_clusters=100, random_state=1).fit_predict(X)
# Plot the dataset with k-means cluster IDs as the color
>>> fig2 = plt.figure()
>>> ax = fig2.add_subplot(111, projection='3d')
>>> ax.scatter(X[:, 0], X[:, 1], X[:, 2], c=clusters_swiss_roll, cmap='Spectral')
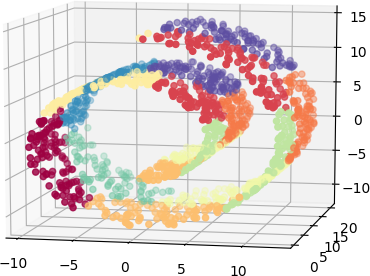
在这个示例中,我们在瑞士卷表面上随机生成了 1,500 个点,并要求 k-means 用 100 个簇来近似它。我们是从帽子里随便抓出 100 这个数字的,因为它看起来是一个相当大的数字,足以覆盖一个相当小的空间。结果(图 7-4)看起来不错;簇确实非常局部,流形的不同部分被映射到不同的簇。太好了!我们完成了吗?
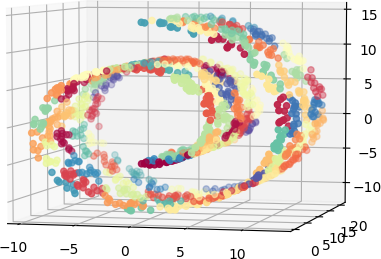
问题在于,如果我们选的 k 太小,那么从流形学习的角度看结果就不会那么好。图 7-5 展示了 k-means 在瑞士卷上使用 10 个簇的输出。我们可以清楚地看到流形上相距很远的区域的数据被映射到相同的簇(例如黄色、紫色、绿色和品红色的簇——看吧,我们告诉过你这些插图最好用彩色看!)。
如果数据在空间中均匀分布,那么选择正确的 k 就归结为一个球填充问题(sphere-packing problem)。在 \(d\) 维空间中,大约可以放下 \(1/r^d\) 个半径为 \(r\) 的球体。每个 k-means 簇就是一个球体,半径是用质心(centroid)表示该球体中点的最大误差。所以,如果我们愿意容忍每个数据点的最大近似误差为 \(r\),那么簇的数量就是 \(O(1/r^d)\),其中 \(d\) 是数据原始特征空间的维度。
均匀分布是 k-means 的最坏情况。如果数据密度不均匀,那么我们就能用更少的簇表示更多的数据。一般来说,很难判断数据在高维空间中是如何分布的。可以保守一点,选一个更大的 k,但它不能太大,因为 k 将成为下一步建模的特征数量。
用于分类的 K-Means 特征化(k-Means Featurization for Classification)
当把 k-means 用作特征化过程时,一个数据点可以用它的簇隶属关系来表示(簇隶属关系这一类别变量的稀疏独热编码(one-hot encoding);参见第 5 章的"独热编码"一节),我们现在就来演示这一点。
如果目标变量(target variable)也可用,那么我们可以选择把该信息作为提示提供给聚类过程。合并目标信息的一种方法是简单地把目标变量作为额外的输入特征加入 k-means 算法。由于目标是最小化所有输入维度上的总欧几里得距离,聚类过程将尝试在目标值的相似性与原始特征空间的相似性之间取得平衡。目标值可以被缩放,以从聚类算法那里获得多或少一些的关注。目标值差异越大,产生的簇就越关注分类边界。
K-Means 特征化(k-Means Featurization)
聚类算法分析数据的空间分布。因此,k-means 特征化创建了数据的压缩空间索引,可以将其馈入下一阶段的模型。这是模型堆叠(model stacking)的一个例子。
示例 7-3 展示了一个简单的 k-means 特征化器(featurizer)。它被定义为一个类对象,可以拟合训练数据,并变换任何新数据。
示例 7-3:K-Means 特征化器
>>> import numpy as np
>>> from sklearn.cluster import KMeans
>>> class KMeansFeaturizer:
...     """Transforms numeric data into k-means cluster memberships.
...
...     This transformer runs k-means on the input data and converts each data point
...     into the ID of the closest cluster. If a target variable is present, it is
...     scaled and included as input to k-means in order to derive clusters that
...     obey the classification boundary as well as group similar points together.
...     """
...
...     def __init__(self, k=100, target_scale=5.0, random_state=None):
...         self.k = k
...         self.target_scale = target_scale
...         self.random_state = random_state
...     def fit(self, X, y=None):
...         """Runs k-means on the input data and finds centroids.
...         """
...         if y is None:
...             # No target variable, just do plain k-means
...             km_model = KMeans(n_clusters=self.k,
...                              n_init=20,
...                              random_state=self.random_state)
...             km_model.fit(X)
...
...             self.km_model_ = km_model
...             self.cluster_centers_ = km_model.cluster_centers_
...             return self
...
...         # There is target information. Apply appropriate scaling and include
...         # it in the input data to k-means.
...         data_with_target = np.hstack((X, y[:, np.newaxis] * self.target_scale))
...
...         # Build a pre-training k-means model on data and target
...         km_model_pretrain = KMeans(n_clusters=self.k,
...                                   n_init=20,
...                                   random_state=self.random_state)
...         km_model_pretrain.fit(data_with_target)
...
...         # Run k-means a second time to get the clusters in the original space
...         # without target info. Initialize using centroids found in pre-training.
...         # Go through a single iteration of cluster assignment and centroid
...         # recomputation.
...         km_model = KMeans(n_clusters=self
... [truncated]
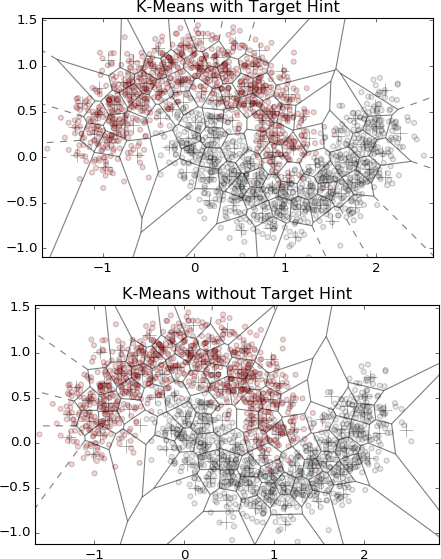
为了说明在聚类时使用和不使用目标信息的区别(示例 7-4),我们把特征化器应用到一个由 scikit-learn 的 make_moons 函数生成的合成数据集上,并绘制簇边界的 Voronoi 图(Voronoi diagram)。
示例 7-4:有无目标提示的 K-Means 特征化
>>> from scipy.spatial import Voronoi, voronoi_plot_2d
>>> from sklearn.datasets import make_moons
>>> training_data, training_labels = make_moons(n_samples=2000, noise=0.2)
>>> kmf_hint = KMeansFeaturizer(k=100, target_scale=10).fit(training_data,
...                                                         training_labels)
>>> kmf_no_hint = KMeansFeaturizer(k=100, target_scale=0).fit(training_data,
...                                                           training_labels)
>>> def kmeans_voronoi_plot(X, y, cluster_centers, ax):
...     """Plots the Voronoi diagram of the k-means clusters overlaid with the data"""
...     ax.scatter(X[:, 0], X[:, 1], c=y, cmap='Set1', alpha=0.2)
...     vor = Voronoi(cluster_centers)
...     voronoi_plot_2d(vor, ax=ax, show_vertices=False, alpha=0.5)
图 7-6 展示了结果的对比。数据集的两个月亮根据它们的类别标签着色。下面板展示的是没有目标信息训练的簇。注意有不少簇横跨两个类别之间的空白区域。上面板展示的是:当聚类算法被给予目标信息时,簇边界沿类别边界对齐得好得多。
让我们检验一下 k-means 特征用于分类的有效性。示例 7-5 把逻辑回归(logistic regression,LR)应用在由 k-means 聚类特征增强的输入数据上,并把结果与径向基函数核支持向量机(radial basis function kernel support vector machine,RBF SVM)、k 近邻(k-nearest neighbors,kNN)、随机森林(random forest,RF)和梯度提升树(gradient boosting tree,GBT)分类器进行比较。RF 和 GBT 是性能处于前沿的流行非线性分类器。RBF SVM 是欧几里得空间中合理的非线性分类器。kNN 根据其 k 个最近邻居的平均值对数据进行分类。
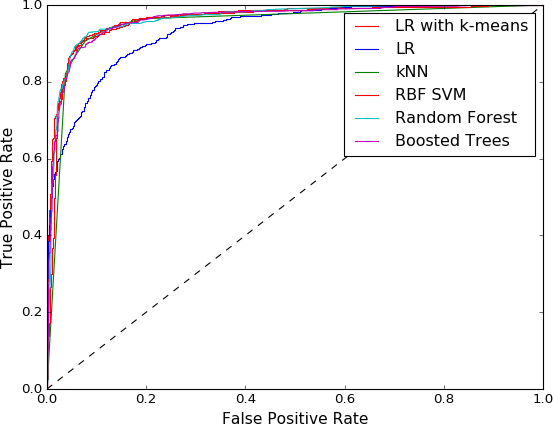
分类器的默认输入数据由每个数据点的 2D 坐标组成。逻辑回归还额外获得了簇隶属特征(在图 7-7 中标注为"LR with k-means")。作为基线,我们还尝试了只在 2D 坐标上做逻辑回归(标注为"LR")。
示例 7-5:用 K-Means 聚类特征做分类
>>> from sklearn.linear_model import LogisticRegression
>>> from sklearn.svm import SVC
>>> from sklearn.neighbors import KNeighborsClassifier
>>> from sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifier
### Generate some test data from the same distribution as training data
>>> test_data, test_labels = make_moons(n_samples=2000, noise=0.3)
### Use the k-means featurizer to generate cluster features
>>> training_cluster_features = kmf_hint.transform(training_data)
>>> test_cluster_features = kmf_hint.transform(test_data)
### Form new input features with cluster features
>>> training_with_cluster = scipy.sparse.hstack((training_data,
...                                              training_cluster_features))
>>> test_with_cluster = scipy.sparse.hstack((test_data, test_cluster_features))
### Build the classifiers
>>> lr_cluster = LogisticRegression(random_state=seed).fit(training_with_cluster,
...                                                        training_labels)
>>> classifier_names = ['LR',
...                     'kNN',
...                     'RBF SVM',
...                     'Random Forest',
...                     'Boosted Trees']
>>> classifiers = [LogisticRegression(random_state=seed),
...                KNeighborsClassifier(5),
...                SVC(gamma=2, C=1),
...                RandomForestClassifier(max_depth=5, n_estimators=10,
...                                       max_features=1),
...                GradientBoostingClassifier(n_estimators=10,
...                                           learning_rate=1.0,
...                                           max_depth=5)]
>>> for model in classifiers:
...     model.fit(training_data, training_labels)
### Helper function to evaluate classifier performance using ROC
>>> def test_roc(model, data, labels):
...     if hasattr(model, "decision_function"):
...         predictions = model.decision_function(data)
...     else:
...         predictions = model.predict_proba(data)[:, 1]
...     fpr, tpr, _ = sklearn.metrics.roc_curve(labels, predictions)
...     return fpr, tpr
### Pl... [truncated]
图 7-7 展示了每个分类器在测试集上评估时的受试者工作特征(receiver operating characteristic,ROC)曲线。ROC 曲线展示当我们改变分类决策边界时,真正例与假正例之间的权衡。(更多细节参见 Zheng [2015]。)一个好的分类器应该迅速达到高的真正例率和低的假正例率,所以那些朝左上角急剧上升的曲线是好的。
我们的图显示,逻辑回归在使用簇特征时比不使用表现好得多。事实上,有了簇特征,线性分类器的表现与非线性分类器一样好。一个小提醒是:在这个玩具示例中,我们没有为任何模型调优超参数。一旦模型被充分调优,性能可能会有差异,但至少这说明了 LR 搭配 k-means 有可能与非线性分类器并驾齐驱。这是一个很好的结果,因为线性分类器的训练成本比非线性分类器低得多。更低的计算成本让我们能在同样的时间内尝试更多带有不同特征的模型,这增加了最终得到更好模型的机会。
替代的稠密特征化(Alternative Dense Featurization)
除了独热的簇隶属关系,一个数据点也可以用它对每个簇中心的逆距离(inverse distance)构成的稠密向量来表示。这比简单的二值簇分配保留了更多信息,但表示现在是稠密的。这里有一个权衡。独热簇隶属关系产生非常轻量的稀疏表示,但可能需要更大的 k 才能表示复杂形状的数据。逆距离表示是稠密的,对建模步骤来说可能更昂贵,但或许可以用更小的 k 应付过去。
稀疏和稠密之间的一种折中是:只为最接近的 p 个簇保留逆距离。但现在 p 成了一个需要调优的额外超参数。(你能理解为什么特征工程需要这么多折腾吗?)天下没有免费的午餐。
优点、缺点与注意事项(Pros, Cons, and Gotchas)
用 k-means 把空间数据变成特征是模型堆叠的一个例子,其中一个模型的输入是另一个模型的输出。堆叠的另一个例子是使用决策树类模型(随机森林或梯度提升树)的输出作为线性分类器的输入。近年来,堆叠已经成为越来越流行的技术。非线性分类器的训练和维护成本很高。堆叠的关键直觉是:把非线性推到特征里,用非常简单的、通常是线性的模型作为最后一层。特征化器可以离线训练,这意味着可以使用那些需要更多算力或内存、但能产生有用特征的昂贵模型。顶层的简单模型可以快速适应在线数据不断变化的分布。这是准确率和速度之间的绝佳权衡,这种策略经常被用于定向广告等需要快速适应变化数据分布的应用中。
模型堆叠的关键直觉(Key Intuition for Model Stacking)
使用复杂的基础层(通常是昂贵的模型)来生成好的(通常是非线性的)特征,再搭配一个简单而快速的顶层模型。这通常能在模型准确率和速度之间取得恰当的平衡。
与使用非线性分类器相比,k-means 堆叠逻辑回归的训练和存储成本更低。表 7-1 详细列出了多种机器学习模型在训练和预测时的计算与内存复杂度。n 表示数据点数量,d 表示(原始)特征数量。
表 7-1:多种机器学习模型的训练与预测复杂度
| 模型 | 时间 | 空间 |
|---|---|---|
| k-means 训练 | \(O(nkd)\) [a] | \(O(kd)\) |
| k-means 预测 | \(O(kd)\) | \(O(kd)\) |
| LR + 聚类特征 训练 | \(O(n(d+k))\) | \(O(d+k)\) |
| LR + 聚类特征 预测 | \(O(d+k)\) | \(O(d+k)\) |
| RBF SVM 训练 | \(O(n^2 d)\) | \(O(n^2)\) |
| RBF SVM 预测 | \(O(sd)\) | \(O(sd)\) |
| GBT 训练 | \(O(nd \cdot 2^m t)\) | \(O(nd + 2^m t)\) |
| GBT 预测 | \(O(2^m t)\) | \(O(2^m t)\) |
| kNN 训练 | \(O(1)\) | \(O(nd)\) |
| kNN 预测 | \(O(nd + k \log n)\) | \(O(nd)\) |
[a] 流式 k-means 可以在 \(O(nd(\log k + \log \log n))\) 时间内完成,对于大的 k 来说比 \(O(nkd)\) 快得多。
对于 k-means,训练时间是 \(O(nkd)\),因为每次迭代都涉及计算每个数据点与每个(k 个)质心之间的 \(d\) 维距离。我们乐观地假设迭代次数不是 \(n\) 的函数,尽管并非所有情况下都如此。预测需要计算新数据点与 k 个质心之间的距离,即 \(O(kd)\)。存储空间需求是 \(O(kd)\),用于存放 k 个质心的坐标。
逻辑回归的训练和预测在数据点数量和特征维度上都呈线性。RBF SVM 训练成本很高,因为它需要为每一对输入数据计算核矩阵。RBF SVM 预测比训练便宜;它在支持向量(support vector)数量 s 和特征维度 d 上呈线性。GBT 的训练和预测在数据规模和模型规模上呈线性(t 棵树,每棵最多 \(2^m\) 个叶节点,其中 m 是树的最大深度)。kNN 的朴素实现完全不需要训练时间,因为训练数据本身就是模型。代价在预测时支付:输入必须与每个原始训练点比较,并进行部分排序以找出 k 个最近的邻居。
总体而言,k-means + LR 是唯一在训练和预测时都呈线性(相对于训练数据规模 \(O(nd)\) 和模型规模 \(O(kd)\))的组合。其复杂度与 GBT 最相似,GBT 的成本在数据点数量、特征维度和模型规模(\(O(2^m t)\))上都是线性的。很难说 k-means + LR 和 GBT 哪个会产生更小的模型——这取决于数据的空间特性。
数据泄漏的可能性(Potential for Data Leakage)
还记得我们在第 5 章关于数据泄漏(data leakage)的告诫吗(参见"防止数据泄漏"一节)?那些人可能会问:在 k-means 特征化步骤中包含目标变量是否会造成这样的问题。答案是"会",但不像分箱计数那么严重。如果我们用同一个数据集来学习簇和构建分类模型,那么关于目标的信息就会泄漏到输入变量中。结果,在训练数据上的准确率评估可能会过于乐观,但在留出验证集(hold-out validation set)或测试集上评估时,偏差会消失。此外,泄漏也不会像分箱计数统计量那样严重(参见"分箱计数"一节),因为聚类算法的有损压缩会抽象掉其中一部分信息。为了格外小心地防止泄漏,可以像分箱计数那样,留出一个单独的数据集来推导簇。
k-means 特征化对实值、有界的数值特征很有用,这些特征在空间中形成密集区域的团块。团块可以是任何形状,因为我们只需增加簇的数量来近似它们。(与经典的聚类设定不同,我们并不关心发现"真正"的簇数量;我们只需要覆盖它们。)
k-means 无法处理欧几里得距离没有意义的特征空间——即分布怪异的数值变量或类别变量。如果特征集包含这些变量,有几种处理方法:
- 只对实值、有界的数值特征应用 k-means 特征化。
- 定义一个自定义度量来处理多种数据类型,并使用 k-中心点(k-medoids)算法。(k-medoids 与 k-means 类似,但允许任意的距离度量。)
- 把类别变量转换为分箱统计量(参见"分箱计数"一节),然后用 k-means 对它们做特征化。
结合处理类别变量和时间序列的技术,k-means 特征化可以经过调整来处理客户营销和销售分析中经常出现的丰富数据。得到的簇可以看作用户细分(user segment),对下一步建模是非常有用的特征。
小结(Summary)
本章用一种有点非常规的方法说明了模型堆叠的概念:把带监督的 k-means 与简单的线性分类器结合起来。k-means 通常被用作无监督建模方法,在特征空间中找到数据点的密集簇。但在这里,k-means 可选地把类别标签作为输入。这有助于 k-means 找到与类别边界更好地对齐的簇。
深度学习(deep learning)——我们将在下一章讨论——通过把神经网络一层层堆叠起来,把模型堆叠带到了一个全新的水平。ImageNet 大规模视觉识别挑战赛(ImageNet Large Scale Visual Recognition Challenge)最近的两届获胜者分别使用了 13 层和 22 层神经网络。它们利用了大量无标签训练图像的可获得性,寻找能产生良好图像特征的像素组合。本章的技术把 k-means 特征化器与线性分类器分开训练。但也可以联合优化特征化器和分类器(原书此处误作 classier)。正如我们将看到的,深度学习训练走的是后一条路。
参考文献(Bibliography)
Dunning, Ted. 此人是一本行走的数据科学百科全书。他是行业会议的常客,喜欢啤酒和好人。请他喝杯啤酒,和他聊聊。你不会后悔的。
Zheng, Alice. Evaluating Machine Learning Models. Sebastopol, CA: O’Reilly Media, 2015.
注释
[1] 本章的灵感来自与 Ted Dunning 的一次谈话,他是 Apache 的活跃贡献者和知名作者。模型堆叠的例子直接来自 Ted,他在写作过程中提供了许多有益的评论。如果单个章节也能有合著者,Ted 将是本章的合著者。
[2] 我们在本章中交替使用"表面"和"流形"这两个词。这个类比对于嵌入三维空间的二维流形很有效,但超出三维就失效了。高维流形不符合我们通常对"表面"的概念。一些更怪异的流形有洞,还有一些以真实物理世界永远不会发生的方式环回自身(例如 M.C. Escher 的无尽瀑布)。大多数数据模型假设的是良性的流形,而不是那些疯狂的。
[3] 这是数学中久经考验的想法。例如,函数的导数度量每个点的变化速度。从全局来看,函数可能会做各种奇怪的事情。但在局部,它可以用导数的线性函数来近似。如果我们知道每个点的导数,微积分就能让我们或多或少地恢复出整个原始函数。