降维:用 PCA 压扁数据煎饼
借助自动数据收集和特征生成技术,人们可以很快获得大量特征。但并非所有特征都有用。在第 3 章和第 4 章中,我们讨论了基于频率的过滤和特征缩放,作为修剪无用信息特征的方法。现在我们来仔细看看使用主成分分析(principal component analysis,PCA)进行特征降维的话题。
本章标志着我们进入基于模型的特征工程技术。在此之前,大多数技术都可以在不参考数据的情况下定义。例如,基于频率的过滤可能会说:“去掉所有小于 \(n\) 的计数”,这个流程不需要数据本身提供更多输入就可以执行。
另一方面,基于模型的技术需要来自数据的信息。例如,PCA 是围绕数据的主轴定义的。在前几章中,数据、特征和模型之间总是有一条清晰的界线。从本章起,区别变得越来越模糊。这正是当前特征学习研究中激动人心的地方。
直觉
降维(dimensionality reduction)就是在保留关键信息的同时去掉"无信息量的信息"。“无信息量"有很多种定义方式。PCA 关注的是线性相关(linear dependency)的概念。在《矩阵剖析》中,我们把数据矩阵的列空间(column space)描述为所有特征向量的张成(span)。如果列空间相对于特征总数来说很小,那么大多数特征都是少数关键特征的线性组合。线性相关的特征浪费空间和计算能力,因为这些信息本可以用少得多的特征来编码。为了避免这种情况,主成分分析试图通过把数据压扁到一个低得多的线性子空间中,来减少这种"冗余”。
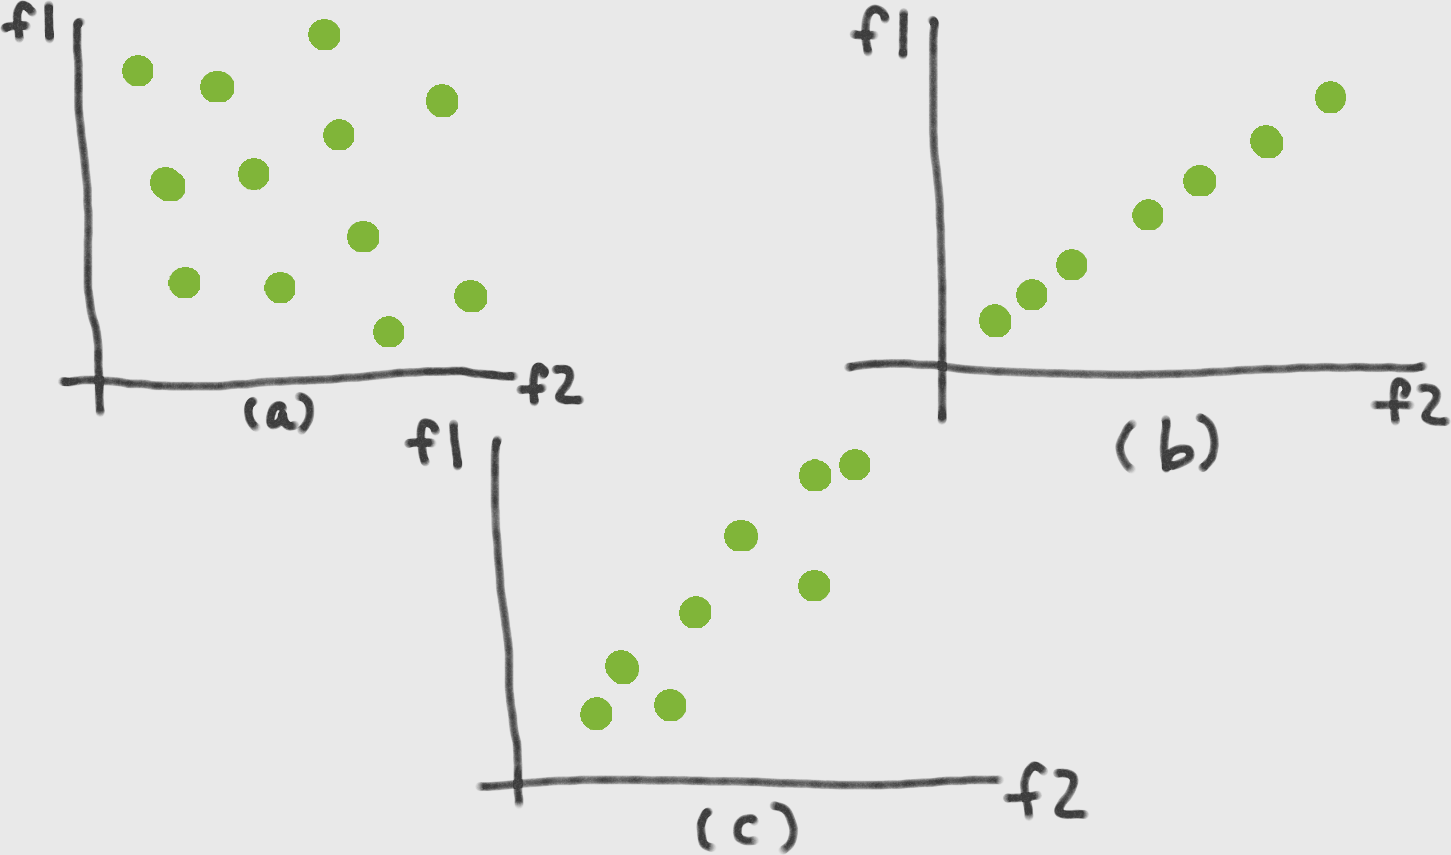
想象特征空间中的一组数据点。每个数据点是一个点,整组数据点形成一个团块(blob)。在图 6-1(a)中,数据点均匀地散布在两个特征维度上,团块填满了空间。在这个例子中,列空间是满秩的。然而,如果其中一些特征是其他特征的线性组合,那么团块就不会那么饱满;它会更像图 6-1(b),一个扁平的团块,其中特征 1 是特征 2 的重复(或标量倍数)。在这种情况下,我们说这个团块的内在维度(intrinsic dimensionality)是 1,尽管它位于二维特征空间中。
在实践中,事物很少完全相等。更常见的情况是,我们看到一些特征非常接近相等,但又不完全相等。在这种情况下,数据团块可能看起来像图 6-1(c)。这是一个"瘦身"的团块。如果我们想减少传给模型的特征数量,那么可以用一个新特征来代替特征 1 和特征 2,也许可以叫它特征 1.5,它位于原始两个特征之间的对角线上。这样,原始数据集就可以用一个数字——沿特征 1.5 方向的位置——来充分表示,而不是用 \(f_1\) 和 \(f_2\) 两个数字。
这里的关键思想是用少数新特征替换冗余特征,这些新特征充分总结了原始特征空间中包含的信息。当只有两个特征时,很容易说出新特征应该是什么。当原始特征空间有几百或几千个维度时,就要难得多。我们需要一种方法来数学地描述我们寻找的新特征。然后可以用优化技术来找到它们。
数学上定义"充分总结信息"的一种方式是:新的数据团块应该尽可能多地保留原始体积。我们把数据团块压扁成一张扁平的煎饼,但我们希望煎饼在正确的方向上尽可能大。这意味着我们需要一种测量体积的方法。
体积与距离有关。但数据点团块中距离的概念有些模糊。可以测量任意两点对之间的最大距离,但事实证明这是一个很难数学优化的函数。另一种做法是测量点对之间的平均距离,或者等价地,每个点与其均值之间的平均距离,也就是方差(variance)。事实证明这要容易优化得多。(生活是艰难的。统计学家学会了走方便的捷径。)在数学上,这转化为在新特征空间中最大化数据点的方差。
阅读线性代数公式的小技巧
为了在线性代数的世界里保持方向感,请留意哪些量是标量(scalar)、哪些是向量(vector),以及向量的方向——是竖直还是水平。要清楚矩阵的维度,因为它们往往告诉你感兴趣的向量在行中还是列中。把矩阵和向量画成页面上的矩形,并确保形状匹配。就像在代数中注意度量单位就能走得很远一样(距离用英里,速度用英里每小时),在线性代数中,你只需要维度。
推导
和之前一样,让 \(\mathbf{X}\) 表示 \(n \times d\) 的数据矩阵,其中 \(n\) 是数据点数量,\(d\) 是特征数量。让 \(\mathbf{x}\) 为包含单个数据点的列向量。(所以 \(\mathbf{x}\) 是 \(\mathbf{X}\) 中某一行的转置。)让 \(\mathbf{v}\) 表示我们试图寻找的新特征向量之一,即主成分(principal component)。
矩阵的奇异值分解(SVD)
任何矩形矩阵都可以分解成三个具有特定形状和特性的矩阵:
\[ \mathbf{X} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^T \]这里,\(\mathbf{U}\) 和 \(\mathbf{V}\) 是正交矩阵(orthogonal matrix)(即 \(\mathbf{U}^T \mathbf{U} = I\) 且 \(\mathbf{V}^T \mathbf{V} = I\))。\(\boldsymbol{\Sigma}\) 是一个对角矩阵(diagonal matrix),包含 \(\mathbf{X}\) 的奇异值(singular value),奇异值可以为正、为零或为负。假设 \(\mathbf{X}\) 有 \(n\) 行 \(d\) 列且 \(n \ge d\)。那么 \(\mathbf{U}\) 的形状是 \(n \times d\),\(\boldsymbol{\Sigma}\) 和 \(\mathbf{V}\) 的形状是 \(d \times d\)。(关于 SVD 和矩阵特征分解的完整回顾,参见《奇异值分解(SVD)》。)
线性投影
让我们一步一步拆解 PCA 的推导过程。图 6-2 展示了整个过程。
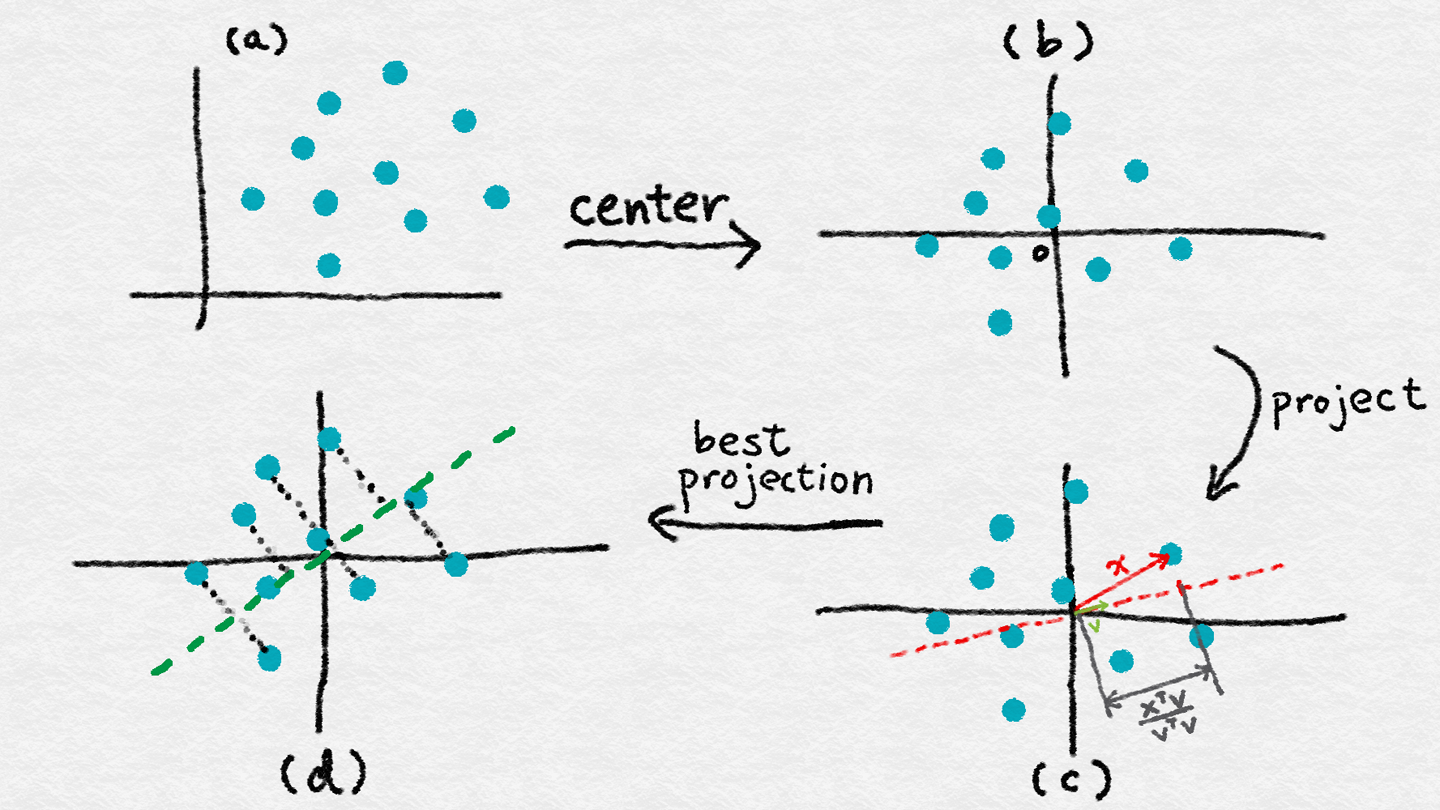
PCA 使用线性投影(linear projection)把数据变换到新的特征空间。图 6-2(c)展示了线性投影的样子。当我们把 \(\mathbf{x}\) 投影到 \(\mathbf{v}\) 上时,投影的长度与两者之间的内积(inner product)成正比,再除以 \(\mathbf{v}\) 的范数(即它自身的内积)。稍后,我们会约束 \(\mathbf{v}\) 具有单位范数。所以唯一相关的部分就是分子——我们把它叫做 \(z\)(见公式 6-1)。
公式 6-1:投影坐标
\[ z = \mathbf{x}^T \mathbf{v} \]注意 \(z\) 是标量,而 \(\mathbf{x}\) 和 \(\mathbf{v}\) 是列向量。由于有一大堆数据点,我们可以把它们在新的特征 \(\mathbf{v}\) 上的所有投影坐标组成向量 \(\mathbf{z}\)(公式 6-2)。这里,\(\mathbf{X}\) 是我们熟悉的数据矩阵,每一行是一个数据点。得到的 \(\mathbf{z}\) 是一个列向量。
公式 6-2:投影坐标向量
\[ \mathbf{z} = \mathbf{X} \mathbf{v} \]方差与经验方差
下一步是计算投影的方差。方差定义为到均值的平方距离的期望(公式 6-3)。
公式 6-3:随机变量 Z 的方差
\[ \mathrm{Var}(Z) = E[(Z - E(Z))^2] \]有一个小问题:我们的问题表述没有提到均值 \(E(Z)\);它是一个自由变量。一种解决方案是把它从方程中去掉:从每个数据点中减去均值。得到的数据集均值为零,这意味着方差就简单地是 \(Z^2\) 的期望。从几何上说,减去均值的效果是让数据居中(见图 6-2(a-b))。
一个密切相关的量是两个随机变量 \(Z_1\) 和 \(Z_2\) 之间的协方差(covariance)(公式 6-4)。可以把它看作方差(单个随机变量的)概念向两个随机变量的推广。
公式 6-4:两个随机变量 Z₁ 和 Z₂ 之间的协方差
\[ \mathrm{Cov}(Z_1, Z_2) = E[(Z_1 - E(Z_1))(Z_2 - E(Z_2))] \]当随机变量均值为零时,它们的协方差与线性相关(linear correlation) \(E[Z_1 Z_2]\) 一致。我们稍后会更多地讨论这个概念。
方差和期望等统计量定义在数据分布上。在实践中,我们没有真实的分布,只有一堆观测到的数据点 \(z_1, \dots, z_n\)。这被称为经验分布(empirical distribution),它给出方差的经验估计(公式 6-5)。
公式 6-5:基于观测 z 的 Z 的经验方差
\[ \mathrm{Var}_{\mathrm{emp}}(Z) = \frac{1}{n-1} \sum_{i=1}^{n} z_i^2 \]主成分:第一种表述
结合公式 6-1中 \(z_i\) 的定义,我们得到公式 6-6中最大化投影数据方差的表述。(我们从经验方差的定义中去掉了分母 \(n-1\),因为它是一个全局常数,不影响最大值出现的位置。)
公式 6-6:主成分的目标函数
\[ \max_{\mathbf{w}} \sum_{i=1}^{n} (\mathbf{x}_i^T \mathbf{w})^2, \quad \text{其中 } \mathbf{w}^T \mathbf{w} = 1 \]这里的约束强制 \(\mathbf{w}\) 与自身的内积为 1,这等价于说向量必须有单位长度。这是因为我们只关心 \(\mathbf{w}\) 的方向而不关心它的大小。\(\mathbf{w}\) 的大小是一个多余的自由度,所以我们通过把它设为一个任意值来去掉它。
主成分:矩阵-向量表述
接下来是棘手的一步。公式 6-6中的平方和项相当笨拙。用矩阵-向量格式会干净得多。能做到吗?答案是可以。关键在于平方和恒等式:一堆平方项之和等于以这些项为元素的向量的范数平方,也就是该向量与自身的内积。有了这个恒等式,我们可以把公式 6-6改写成矩阵-向量记法,如公式 6-7所示。
公式 6-7:主成分的目标函数(矩阵-向量表述)
\[ \max_{\mathbf{w}} \mathbf{w}^T \mathbf{X}^T \mathbf{X} \mathbf{w}, \quad \text{其中 } \mathbf{w}^T \mathbf{w} = 1 \]这种 PCA 表述更清楚地展示了目标:我们寻找一个使输出范数最大化的输入方向。听起来耳熟吗?答案就在 \(\mathbf{X}\) 的奇异值分解(singular value decomposition,SVD)中。事实证明,最优的 \(\mathbf{w}\) 是 \(\mathbf{X}\) 的主左奇异向量,也就是 \(\mathbf{X}^T \mathbf{X}\) 的主特征向量。投影后的数据被称为原始数据的一个主成分(principal component)。
主成分的一般解
这个过程可以重复。一旦找到第一个主成分,我们可以重新运行公式 6-7,并加上新向量必须与之前找到的向量正交的约束(见公式 6-8)。
公式 6-8:第 k+1 个主成分的目标函数
\[ \max_{\mathbf{w}} \mathbf{w}^T \mathbf{X}^T \mathbf{X} \mathbf{w}, \quad \text{其中 } \mathbf{w}^T \mathbf{w} = 1 \text{ 且 } \mathbf{w}^T \mathbf{w}_1 = \cdots = \mathbf{w}^T \mathbf{w}_k = 0 \]解是 \(\mathbf{X}\) 的第 \(k+1\) 个左奇异向量,按奇异值降序排列。因此,前 \(k\) 个主成分对应 \(\mathbf{X}\) 的前 \(k\) 个左奇异向量。
变换特征
一旦找到主成分,我们就可以用线性投影来变换特征。设 \(\mathbf{X} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^T\) 是 \(\mathbf{X}\) 的 SVD,\(\mathbf{V}_k\) 是列中包含前 \(k\) 个左奇异向量的矩阵。\(\mathbf{X}\) 的维度是 \(n \times d\),其中 \(d\) 是原始特征的数量,\(\mathbf{V}_k\) 的维度是 \(d \times k\)。与公式 6-2中单个投影向量不同,我们可以在一个投影矩阵中同时投影到多个向量上(公式 6-9)。
公式 6-9:PCA 投影矩阵
\[ \mathbf{W} = \mathbf{V}_k \]投影坐标矩阵很容易计算,并且可以利用奇异向量彼此正交的事实进一步简化(见公式 6-10)。
公式 6-10:简单的 PCA 变换
\[ \mathbf{Z} = \mathbf{X}\mathbf{W} = \mathbf{X}\mathbf{V}_k = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^T \mathbf{V}_k = \mathbf{U}_k \boldsymbol{\Sigma}_k \]投影值就是前 \(k\) 个左奇异向量乘以前 \(k\) 个奇异值。因此,整个 PCA 解——无论是主成分还是投影——都可以方便地通过对 \(\mathbf{X}\) 做 SVD 得到。
实现 PCA
许多 PCA 推导涉及先对数据居中,然后对协方差矩阵做特征分解。但实现 PCA 最简单的方法是取居中数据矩阵的奇异值分解。
PCA 实现步骤
- 居中数据矩阵:\(\mathbf{C} = \mathbf{X} - \mathbf{1}\boldsymbol{\mu}^T\),其中 \(\mathbf{1}\) 是全 1 的列向量,\(\boldsymbol{\mu}\) 是包含 \(\mathbf{X}\) 各行平均值的列向量。
- 计算 SVD:\(\mathbf{C} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^T\)
- 找到主成分。前 \(k\) 个主成分是 \(\mathbf{V}\) 的前 \(k\) 列;即对应于 \(k\) 个最大奇异值的右奇异向量。
- 变换数据。变换后的数据就是 \(\mathbf{U}\) 的前 \(k\) 列。(如果需要白化,则用奇异值的倒数缩放这些向量。这要求所选奇异值非零。参见《白化与 ZCA》。)
PCA 实战
让我们把 PCA 应用在一些图像数据上,更好地感受它是如何工作的。MNIST 数据集包含 0 到 9 的手写数字图像。原始图像是 28 × 28 像素。该数据集的一个低分辨率子集随 scikit-learn 分发,其中每张图像被降采样为 8 × 8 像素。scikit-learn 中的原始数据有 64 个维度。在示例 6-1中,我们对数据集应用 PCA,并用前三个主成分进行可视化。
示例 6-1:对 scikit-learn 手写数字数据集(MNIST 数据集的子集)做主成分分析
>>> from sklearn import datasets
>>> from sklearn.decomposition import PCA
# Load the data
>>> digits_data = datasets.load_digits()
>>> n = len(digits_data.images)
# Each image is represented as an 8-by-8 array.
# Flatten this array as input to PCA.
>>> image_data = digits_data.images.reshape((n, -1))
>>> image_data.shape
(1797, 64)
# Groundtruth label of the number appearing in each image
>>> labels = digits_data.target
>>> labels
array([0, 1, 2, ..., 8, 9, 8])
# Fit a PCA transformer to the dataset.
# The number of components is automatically chosen to account for
# at least 80% of the total variance.
>>> pca_transformer = PCA(n_components=0.8)
>>> pca_images = pca_transformer.fit_transform(image_data)
>>> pca_transformer.explained_variance_ratio_
array([ 0.14890594,  0.13618771,  0.11794594,  0.08409979,  0.05782415,
        0.0491691 ,  0.04315987,  0.03661373,  0.03353248,  0.03078806,
        0.02372341,  0.02272697,  0.01821863])
>>> pca_transformer.explained_variance_ratio_[:3].sum()
0.40303958587675121
# Visualize the results
>>> import matplotlib.pyplot as plt
>>> from mpl_toolkits.mplot3d import Axes3D
>>> %matplotlib notebook
>>> fig = plt.figure()
>>> ax = fig.add_subplot(111, projection='3d')
>>> for i in range(100):
...     ax.scatter(pca_images[i, 0], pca_images[i, 1], pca_images[i, 2],
...                marker=r'${}$'.format(labels[i]), s=64)
>>> ax.set_xlabel('Principal component 1')
>>> ax.set_ylabel('Principal component 2')
>>> ax.set_zlabel('Principal component 3')
前 100 张投影图像显示在图 6-3的 3D 图中。标记对应标签。前三个主成分大约占数据集总方差的 40%。这远非完美,但它提供了一个方便的低维可视化。我们看到 PCA 把相似的数字分到了一起。数字 0 和 6 位于同一区域,1 和 7 也是,3 和 9 也是。空间大致被划分为一边是 0、4 和 6,另一边是其余数字。
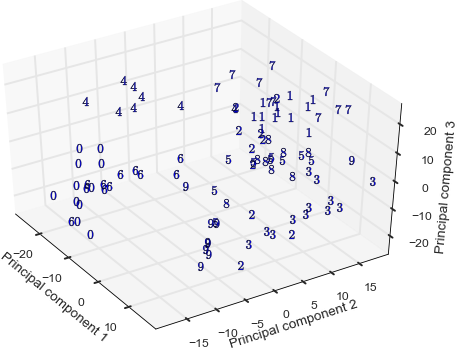
由于数字之间有相当多的重叠,在投影空间中使用线性分类器很难把它们区分开。因此,如果任务是给手写数字分类,而选定的模型是线性分类器,那么前三个主成分作为特征是不够的。尽管如此,看到 64 维数据集的多少信息可以被仅仅 3 个维度捕捉,还是很有趣的。
白化与 ZCA
由于目标函数中的正交性约束,PCA 变换产生了一个不错的副作用:变换后的特征不再相关。换句话说,特征向量两两之间的内积为零。利用奇异向量的正交性很容易证明这一点:
\[ \mathbf{Z}^T \mathbf{Z} = \boldsymbol{\Sigma}_k \mathbf{U}_k^T \mathbf{U}_k \boldsymbol{\Sigma}_k = \boldsymbol{\Sigma}_k^2 \]结果是一个对角矩阵,包含奇异值的平方,代表每个特征向量与自身的内积,也就是它的 \(\ell_2\) 范数。
有时,把特征的尺度也归一化为 1 是很有用的。用信号处理的术语说,这被称为白化(whitening)。它产生一组与自身单位相关、彼此零相关的特征。数学上,白化可以通过把 PCA 变换乘以奇异值的倒数来实现(见公式 6-11)。
公式 6-11:PCA + 白化
\[ \mathbf{W}_{\mathrm{white}} = \mathbf{V}_k \boldsymbol{\Sigma}_k^{-1} \]\[ \mathbf{Z}_{\mathrm{white}} = \mathbf{X}\mathbf{V}_k \boldsymbol{\Sigma}_k^{-1} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^T \mathbf{V}_k \boldsymbol{\Sigma}_k^{-1} = \mathbf{U}_k \]白化与降维相互独立;可以只做其中一个而不做另一个。例如,零相位分量分析(zero-phase component analysis,ZCA)(Bell 和 Sejnowski,1996)就是一种与 PCA 密切相关、但不减少特征数量的白化变换。ZCA 白化使用完整的主成分集合 \(\mathbf{V}\) 而不做缩减,并额外乘回一个 \(\mathbf{V}^T\)(公式 6-12)。
公式 6-12:ZCA 白化
\[ \mathbf{W}_{\mathrm{ZCA}} = \mathbf{V} \boldsymbol{\Sigma}^{-1} \mathbf{V}^T \]\[ \mathbf{Z}_{\mathrm{zca}} = \mathbf{X}\mathbf{V} \boldsymbol{\Sigma}^{-1} \mathbf{V}^T = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^T \mathbf{V} \boldsymbol{\Sigma}^{-1} = \mathbf{U} \]简单的 PCA 投影(公式 6-10)在新特征空间中产生坐标,主成分作为基。这些坐标只表示投影向量的长度,不表示方向。与主成分相乘则给出长度和方向。另一种合理的解释是,额外的乘法把坐标旋转回原始特征空间。(\(\mathbf{V}\) 是正交矩阵,而正交矩阵旋转其输入时既不拉伸也不压缩。)因此,ZCA 产生尽可能接近(在欧氏距离意义上)原始数据的白化数据。
PCA 的考量与局限
使用 PCA 进行降维时,必须回答使用多少个主成分(\(k\))的问题。与所有超参数一样,这个数字可以根据最终模型的质量来调整。但也有不涉及昂贵计算方法的启发式方法。
一种可能性是选择 \(k\) 使其解释期望比例的总方差。(这个选项在 scikit-learn 包的 PCA 中可用。)投影到第 \(k\) 个主成分上的方差是:
也就是 \(\mathbf{X}\) 的第 \(k\) 大奇异值的平方。矩阵的奇异值按序排列的列表称为它的谱(spectrum)。因此,要确定使用多少个主成分,可以对数据矩阵做一次简单的谱分析,并挑选保留足够方差的阈值。
基于解释方差选择 k
要保留足够多的主成分以覆盖数据总方差的 80%,选择 \(k\) 使得
\[ \frac{\sum_{i=1}^{k} \sigma_i^2}{\sum_{i=1}^{d} \sigma_i^2} \ge 0.8 \]选择 \(k\) 的另一种方法涉及数据集的固有维度。这是一个更模糊的概念,但也可以从谱中确定。基本上,如果谱包含几个大的奇异值和许多微小的奇异值,那么很可能只需收割最大的奇异值并丢弃其余部分。有时谱的其余部分并不小,但头部和尾部值之间有一个很大的间隙。那也会是一个合理的截断点。这种方法需要目视检查谱,因此不能作为自动化流水线的一部分来执行。
对 PCA 的一个关键批评是,这个变换相当复杂,因此结果很难解释。主成分和投影向量都是实数值,可正可负。主成分本质上是(居中的)行的线性组合,投影值是列的线性组合。例如,在股票收益应用中,每个因子都是股票收益时间切片的线性组合。这意味着什么?很难为学到的因子表达一个人类可以理解的理由。因此,分析师很难信任这些结果。如果你无法解释为什么应该把数十亿别人的钱投进某些股票,你大概不会选择使用那个模型。
PCA 计算代价高昂。它依赖 SVD,而 SVD 是一个昂贵的过程。计算一个矩阵的完整 SVD 需要 \(O(nd^2 + d^3)\) 次运算(Golub 和 Van Loan,2012),假设 \(n \ge d\)——即数据点比特征多。即使我们只想要 \(k\) 个主成分,计算截断 SVD(\(k\) 个最大的奇异值和向量)仍然需要 \(O((n+d)^2 k) = O(n^2 k)\) 次运算。当数据点或特征数量很大时,这是不可行的。
以流式方式、批量更新方式或从完整数据的样本中执行 PCA 都很困难。SVD 的流式计算、SVD 的更新以及从子样本计算 SVD 都是困难的研究问题。算法是存在的,但代价是精度降低。一个推论是,当把测试数据投影到训练集中找到的主成分上时,应该预期表示精度较低。随着数据分布的变化,必须在当前数据集中重新计算主成分。
最后,最好不要把 PCA 应用于原始计数(词计数、音乐播放计数、电影观看计数等)。原因在于这类计数往往包含巨大的离群值。(极有可能存在一个粉丝看了《指环王》314,582 遍,这个数字使其他所有计数都相形见绌。)正如我们所知,PCA 寻找特征内部的线性相关。相关性和方差统计量对大的离群值非常敏感;一个大的数字就可能大幅改变统计量。所以,最好先修剪数据中的大值(《基于频率的过滤》),或者应用像 tf-idf(第 4 章)或对数变换(《对数变换》)这样的缩放变换。
用例
PCA 通过寻找特征之间的线性相关模式来降低特征空间维度。由于涉及 SVD,PCA 在特征超过几千个时就计算昂贵了。但对于数量不多的实值特征,非常值得一试。
PCA 变换会丢弃数据中的信息。因此,下游模型训练起来可能更便宜,但精度更低。在 MNIST 数据集上,有人观察到使用 PCA 降维后的数据会导致分类模型精度下降。在这些情况下,使用 PCA 有利也有弊。
PCA 最酷的应用之一是时间序列的异常检测。Lakhina 等人(2004)使用 PCA 检测和诊断互联网流量中的异常。他们关注的是流量异常(volume anomaly),即从一个网络区域到另一个网络区域的流量出现激增或骤降。这些突然的变化可能表明网络配置错误或协同的拒绝服务攻击。无论哪种情况,知道这些变化何时何地发生对互联网运营商来说都很有价值。
由于互联网上的总流量如此之大,小区域内的孤立激增很难检测。相对少数的主干链路承载了大部分流量。他们的关键洞见是,流量异常会同时影响多条链路(因为网络数据包需要经过多个节点才能到达目的地)。把每条链路视为一个特征,把每个时间步的流量视为一次测量。一个数据点是网络上所有链路流量测量的一个时间切片。这个矩阵的主成分指示网络上的总体流量趋势。其余的主成分代表残余信号,其中包含异常。
PCA 也常用于金融建模。在这些用例中,它充当一种因子分析(factor analysis),这个术语描述了一族统计方法,旨在用少数未观测的因子来描述数据中观测到的变异性。在因子分析应用中,目标是找到解释性成分,而不是变换后的数据。
股票收益这类金融量往往彼此相关。股票可能同时上涨和下跌(正相关),也可能朝相反方向运动(负相关)。为了平衡波动性和降低风险,投资组合需要一组互不相关的多样化股票。(如果篮子会沉,不要把所有的鸡蛋放在一个篮子里。)找到强相关模式有助于决定投资策略。
股票相关模式可能是全行业范围的。例如,科技股可能一起涨跌,而航空股在油价高企时往往下跌。但行业可能不是解释结果的最佳方式。分析师也在观察统计量中寻找意想不到的相关性。特别是,统计因子模型(statistical factor model)(Connor,1995)对个股收益的时间序列矩阵运行 PCA,以寻找共同波动的股票。在这种用例中,最终目标是主成分本身,而不是变换后的数据。
ZCA 在从图像学习时是一个有用的预处理步骤。在自然图像中,相邻像素往往有相似的颜色。ZCA 白化可以去除这种相关性,使后续的建模工作能够专注于更有趣的图像结构。Krizhevsky(2009)的论文《Learning Multiple Layers of Features from Images》包含很好的例子,展示了 ZCA 白化对自然图像的效果。
许多深度学习模型把 PCA 或 ZCA 作为预处理步骤,尽管这并不总是必要的。在《Factored 3-Way Restricted Boltzmann Machines for Modeling Natural Images》中,Ranzato 等人(2010)评论道:“白化不是必需的,但可以加快算法的收敛。“在《An Analysis of Single-Layer Networks in Unsupervised Feature Learning》中,Coates 等人(2011)发现 ZCA 白化对某些模型有帮助,但对所有模型并非如此。(注意这篇论文中的模型是无监督特征学习模型,因此 ZCA 是作为一种特征工程方法被用于其他特征工程方法。方法堆叠和串联在机器学习流水线中很常见。)
小结
关于 PCA 的讨论到此结束。关于 PCA 需要记住的两件主要事情是它的机制(线性投影)和目标(最大化投影数据的方差)。解涉及协方差矩阵的特征分解,这与数据矩阵的 SVD 密切相关。也可以用这样的心理图景来记住 PCA:把数据压扁成一张尽可能蓬松的煎饼。
PCA 是模型驱动的特征工程的一个例子。(只要目标函数出现,就应该立刻怀疑背后藏着一个模型。)这里的建模假设是,方差能充分代表数据中包含的信息。等价地,模型寻找特征之间的线性相关。这在几个应用中被用来减少相关性或寻找输入中的共同因子。
PCA 是一种著名的降维方法。但它也有局限性,比如计算成本高、结果不可解释。它作为预处理步骤很有用,尤其是当特征之间存在线性相关时。
当被看作一种消除线性相关的方法时,PCA 与白化的概念相关。它的近亲 ZCA 以可解释的方式对数据做白化,但不降低维度。
参考文献
Bell, Anthony J. and Terrence J. Sejnowski. “Edges Are the ‘Independent Components’ of Natural Scenes.” Advances in Neural Information Processing Systems 9 (1996): 831-837.
Coates, Adam, Andrew Y. Ng, and Honglak Lee. “An Analysis of Single-Layer Networks in Unsupervised Feature Learning.” Proceedings of the 14th International conference on Artificial Intelligence and Statistics (2011): 215-223.
Connor, Gregory. “The Three Types of Factor Models: A Comparison of Their Explanatory Power.” Financial Analysts Journal 51:3 (1995) 42-46.
Golub, Gene H., and Charles F. Van Loan. Matrix Computations. 4th ed. Baltimore, MD: Johns Hopkins University Press, 2012.
Krizhevsky, Alex. “Learning Multiple Layers of Features from Tiny Images.” MSc thesis, University of Toronto, 2009.
Lakhina, Anukool, Mark Crovella, and Christophe Diot. “Diagnosing Network-wide Traffic Anomalies.” Proceedings of the 2004 Conference on Applications, Technologies, Architectures, and Protocols for Computer Communications (2004): 219-230.
Ranzato, Marc’Aurelio, Alex Krizhevsky, and Geoffrey E. Hinton. “Factored 3-Way Restricted Boltzmann Machines for Modeling Natural Images.” Proceedings of the 13th International Conference on Artificial Intelligence and Statistics (2010): 621-628.