类别变量:在机器人母鸡时代数鸡蛋
类别变量(categorical variable),顾名思义,用来表示类别(category)或标签(label)。例如,一个类别变量可以表示世界上的主要城市、一年中的四个季节,或者一家公司所属的行业(石油、旅行、科技)。在真实世界的数据集中,类别取值的数量总是有限的。这些取值可以用数字来表示。然而,与其他数值变量不同,类别变量的取值之间无法相互排序。(石油作为行业类型,既不大于也不小于旅行。)它们被称为非序数(nonordinal)。
一个简单的问题可以作为检验某物是否应该成为类别变量的试金石:“两个取值的差异程度重要吗,还是说它们不同这件事本身就够了?“500 美元的股价是 100 美元股价的五倍。因此,股价应该用连续数值变量来表示。而公司所属的行业(石油、旅行、科技等)则可能应该是类别变量。
大规模类别变量在交易记录中尤其常见。例如,许多网络服务用 ID 来跟踪用户,这是一个类别变量,根据服务的唯一用户数,其取值从几百到几亿不等。互联网交易的 IP 地址是另一个大规模类别变量的例子。它们之所以是类别变量,是因为尽管用户 ID 和 IP 地址都是数字,但它们的大小通常与手头的任务无关。例如,在对单笔交易做欺诈检测时,IP 地址可能是相关的——某些 IP 地址或子网可能比其他地址或子网产生更多欺诈交易。但 164.203.x.x 这个子网并不天生就比 164.202.x.x 更容易欺诈;子网的数值大小并不重要。
文档语料库的词汇表可以被解释为一个大规模类别变量,其类别就是唯一的词。表示如此众多的不同类别在计算上可能代价高昂。如果一个类别(例如某个词)在一个数据点(文档)中出现多次,那么我们可以把它表示为一个计数,并通过计数统计来表示所有类别。这被称为分箱计数(bin counting)。我们先从类别变量的常见表示讲起,然后慢慢过渡到大规模类别变量的分箱计数——这类变量在现代数据集中非常常见。
编码类别变量
类别变量的取值通常不是数字。1 例如,眼睛颜色可以是"黑色"“蓝色"“棕色"等。因此,需要一种编码(encoding)方法来把这些非数字类别转成数字。一个诱人的做法是直接给 \(k\) 个可能的类别各分配一个整数,比如从 1 到 \(k\)——但这样得到的取值彼此之间就是可排序的了,而类别之间是不允许排序的。所以,让我们看看一些替代方案。
独热编码
更好的方法是使用一组比特(bit)。每个比特代表一个可能的类别。如果变量不能同时属于多个类别,那么这一组比特中只能有一个比特是"开"的。这被称为独热编码(one-hot encoding),scikit-learn 中对应的实现是 sklearn.preprocessing.OneHotEncoder。每一个比特都是一个特征。因此,一个有 \(k\) 个可能类别的类别变量被编码成长度为 \(k\) 的特征向量。表 5-1 给出了一个例子。
| e₁ | e₂ | e₃ | |
|---|---|---|---|
| 旧金山 | 1 | 0 | 0 |
| 纽约 | 0 | 1 | 0 |
| 西雅图 | 0 | 0 | 1 |
独热编码非常容易理解,但它比严格需要的多用一个比特。如果我们看到 \(k-1\) 个比特都是 0,那么最后一个比特必然是 1,因为这个变量必须取 \(k\) 个值中的一个。从数学上,可以把这个约束写成"所有比特之和必须等于 1”:
\[ e_1 + e_2 + \cdots + e_k = 1 \]于是我们手上就有了一个线性相关(linear dependency)。正如我们在第 4 章中发现的,线性相关的特征有点烦人,因为它们意味着训练出的线性模型不是唯一的。特征的不同线性组合可以做出相同的预测,因此我们需要费更多周折才能理解某个特征对预测的影响。
哑变量编码
独热编码的问题在于它允许 \(k\) 个自由度,而变量本身只需要 \(k-1\) 个。哑变量编码(dummy coding)2通过在表示中只使用 \(k-1\) 个特征来去掉多余的那个自由度(见表 5-2)。一个特征被牺牲掉,用全零向量来表示。这被称为参考类别(reference category)。哑变量编码和独热编码在 Pandas 中都有实现,即 pandas.get_dummies。
| e₁ | e₂ | |
|---|---|---|
| 旧金山 | 1 | 0 |
| 纽约 | 0 | 1 |
| 西雅图 | 0 | 0 |
用哑变量编码建模的结果比独热编码更易解释。在一个简单的线性回归问题中很容易看到这一点。假设我们有三个城市(旧金山、纽约和西雅图)的公寓租金数据(见表 5-3)。
| City | Rent | |
|---|---|---|
| 0 | SF | 3999 |
| 1 | SF | 4000 |
| 2 | SF | 4001 |
| 3 | NYC | 3499 |
| 4 | NYC | 3500 |
| 5 | NYC | 3501 |
| 6 | Seattle | 2499 |
| 7 | Seattle | 2500 |
| 8 | Seattle | 2501 |
我们可以训练一个线性回归器,仅根据城市身份来预测租金(见示例 5-1)。
线性回归模型可以写成:
\[ y = w_1 x_1 + \cdots + w_n x_n \]按照惯例,还要拟合一个额外的常数项,称为截距(intercept),这样当所有 \(x\) 都为零时 \(y\) 仍可以取非零值:
\[ y = w_1 x_1 + \cdots + w_n x_n + b \]示例 5-1:对类别变量使用独热编码和哑变量编码进行线性回归
>>> import pandas
>>> from sklearn import linear_model
# Define a toy dataset of apartment rental prices in
# New York, San Francisco, and Seattle
>>> df = pd.DataFrame({
...     'City': ['SF', 'SF', 'SF', 'NYC', 'NYC', 'NYC',
...              'Seattle', 'Seattle', 'Seattle'],
...     'Rent': [3999, 4000, 4001, 3499, 3500, 3501,
...              2499, 2500, 2501]
... })
>>> df['Rent'].mean()
3333.3333333333335
# Convert the categorical variables in the DataFrame to one-hot encoding
# and fit a linear regression model
>>> one_hot_df = pd.get_dummies(df, prefix=['city'])
>>> one_hot_df
   Rent  city_NYC  city_SF  city_Seattle
0  3999       0.0      1.0           0.0
1  4000       0.0      1.0           0.0
2  4001       0.0      1.0           0.0
3  3499       1.0      0.0           0.0
4  3500       1.0      0.0           0.0
5  3501       1.0      0.0           0.0
6  2499       0.0      0.0           1.0
7  2500       0.0      0.0           1.0
8  2501       0.0      0.0           1.0
>>> model = linear_model.LinearRegression()
>>> model.fit(one_hot_df[['city_NYC', 'city_SF', 'city_Seattle']],
...           one_hot_df['Rent'])
>>> model.coef_
array([ 166.66666667,  666.66666667, -833.33333333])
>>> model.intercept_
3333.3333333333335
# Train a linear regression model on dummy code
# Specify the 'drop_first' flag to get dummy coding
>>> dummy_df = pd.get_dummies(df, prefix=['city'], drop_first=True)
>>> dummy_df
   Rent  city_SF  city_Seattle
0  3999      1.0           0.0
1  4000      1.0           0.0
2  4001      1.0           0.0
3  3499      0.0           0.0
4  3500      0.0           0.0
5  3501      0.0           0.0
6  2499      0.0           1.0
7  2500      0.0           1.0
8  2501      0.0           1.0
>>> model.fit(dummy_df[['city_SF', 'city_Seattle']], dummy_df['Rent'])
>>> model.coef_
array([   0.,  500., -1000.])
>>> model.intercept_
3500.0
使用独热编码时,截距项代表目标变量 Rent 的全局均值,每个线性系数代表该城市的平均租金与全局均值相差多少。
使用哑变量编码时,偏置系数代表参考类别(在这个例子中是城市 NYC)的响应变量 \(y\) 的均值。第 \(i\) 个特征的系数等于第 \(i\) 个类别的平均响应值与参考类别的平均响应值之差。
在表 5-4中可以看得很清楚,这些方法为线性模型产生了非常不同的系数。
| 编码方式 | x₁ | x₂ | x₃ | b |
|---|---|---|---|---|
| 独热编码 | 166.67 | 666.67 | -833.33 | 3333.33 |
| 哑变量编码 | 0 | 500 | -1000 | 3500 |
效应编码
类别变量编码的又一种变体是效应编码(effect coding)。效应编码与哑变量编码非常相似,区别在于参考类别现在用全 -1 的向量来表示。
| e₁ | e₂ | |
|---|---|---|
| 旧金山 | 1 | 0 |
| 纽约 | 0 | 1 |
| 西雅图 | -1 | -1 |
效应编码与哑变量编码非常相似,但得到的线性回归模型甚至更容易解释。示例 5-2演示了以效应编码作为输入时会发生什么。截距项代表目标变量的全局均值,各个系数表示各个类别的均值与全局均值的差异。(这被称为类别或水平的主效应(main effect),因此得名"效应编码”。)独热编码实际上也得到了相同的截距和系数,但在那种情况下,每个城市都有一个线性系数。在效应编码中,没有任何单个特征代表参考类别,因此参考类别的效应需要单独计算为所有其他类别系数的负和。(更多细节参见 UCLA IDRE 网站上的“FAQ: What is effect coding?”。)
示例 5-2:效应编码的线性回归
>>> effect_df = dummy_df.copy()
>>> effect_df.ix[3:5, ['city_SF', 'city_Seattle']] = -1.0
>>> effect_df
   Rent  city_SF  city_Seattle
0  3999      1.0           0.0
1  4000      1.0           0.0
2  4001      1.0           0.0
3  3499     -1.0          -1.0
4  3500     -1.0          -1.0
5  3501     -1.0          -1.0
6  2499      0.0           1.0
7  2500      0.0           1.0
8  2501      0.0           1.0
>>> model.fit(effect_df[['city_SF', 'city_Seattle']], effect_df['Rent'])
>>> model.coef_
array([ 666.66666667, -833.33333333])
>>> model.intercept_
3333.3333333333335
类别变量编码的优缺点
独热编码、哑变量编码和效应编码彼此非常相似。它们各有优缺点。独热编码是冗余的,这使得同一个问题可以有多个有效的模型。这种非唯一性有时会给解释带来麻烦,但好处是每个特征都清楚地对应一个类别。此外,缺失数据可以编码为全零向量,此时输出应该是目标变量的总体均值。
哑变量编码和效应编码不是冗余的。它们产生唯一且可解释的模型。哑变量编码的缺点是它不容易处理缺失数据,因为全零向量已经被映射到参考类别了。它还把每个类别的效应编码为相对于参考类别的效应,这看起来可能有点奇怪。
效应编码通过对参考类别使用不同的编码来避免这个问题,但全 -1 的向量是一个稠密向量,无论存储还是计算都很昂贵。因此,Pandas 和 scikit-learn 等流行的机器学习软件包选择了哑变量编码或独热编码,而不是效应编码。
当类别数量变得非常大时,这三种编码技术都会失效。处理极大规模类别变量需要不同的策略。
处理大规模类别变量
互联网上的自动数据收集会产生大规模的类别变量。这在定向广告(targeted advertising)和欺诈检测等应用中很常见。
在定向广告中,任务是把用户与一组广告匹配起来。特征包括用户 ID、广告所在的网站域名、搜索查询、当前页面,以及这些特征所有可能的成对合取。(查询是一个文本字符串,可以被切分并转成通常的文本特征。但查询通常很短,而且往往由短语构成,所以这种情况下最好的做法通常是保持它们完整,或者通过哈希函数处理以便于存储和比较。我们稍后会详细讨论哈希。)以上每一个都是非常大的类别变量。挑战在于找到一种内存高效、又能产生快速训练的准确模型的特征表示。
现有的解决方案可以(哈哈)这样分类:
- 编码上不做任何花哨处理。使用一个训练便宜的简单模型。把独热编码喂给线性模型(逻辑回归或线性支持向量机),跑在很多台机器上。
- 压缩特征。有两个选择:
- 特征哈希(feature hashing),在线性模型中很流行
- 分箱计数,在线性模型和树模型中都很流行
使用朴素的独热编码是一个可行的选项。Graepel 等人(2010)报告说,微软的搜索广告引擎使用了这种二值特征,放在一个贝叶斯概率回归(probit regression)模型中,可以通过简单的更新在线训练。与此同时,其他团队则主张压缩方法。Yahoo! 的研究人员对特征哈希推崇备至(Weinberger 等人,2009),不过 McMahan 等人(2013)在谷歌的广告引擎上试验了特征哈希,并没有发现显著的改进。而微软的另一些人则对分箱计数的想法情有独钟(Bilenko,2015)。
我们将会看到,所有这些想法都有各自的优缺点。我们先描述解决方案本身,然后再讨论它们的权衡。
特征哈希
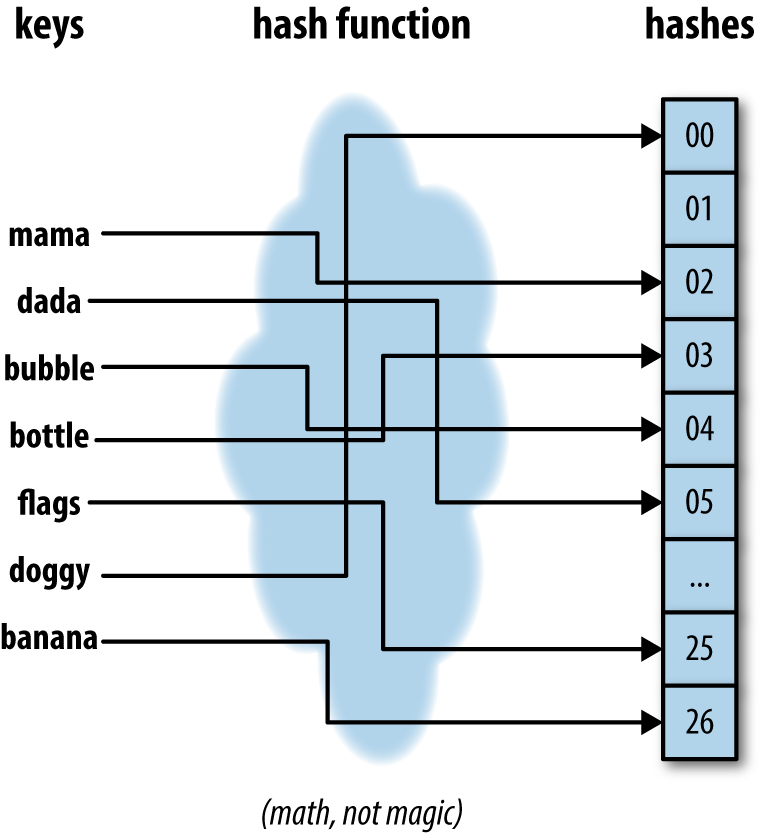
哈希函数(hash function)是一个确定性函数,把可能无界的整数映射到有限整数范围 [1, \(m\)]。由于输入域可能大于输出范围,多个数字可能被映射到同一个输出。这被称为碰撞(collision)。均匀哈希函数(uniform hash function)保证大致相同数量的数字被映射到 \(m\) 个箱子中的每一个。
直观上,可以把哈希函数想象成一台机器:它接收带编号的球(键),并把它们路由到 \(m\) 个箱子之一。编号相同的球总是会被路由到同一个箱子(见图 5-1)。这在保持特征空间的同时,减少了机器学习训练和评估周期中的存储和处理时间。
任何可以用数字表示的对象(任何能存储在计算机上的数据都是如此)都可以构造哈希函数:数字、字符串、复杂结构等。
当特征非常多时,存储特征向量可能会占用大量空间。特征哈希通过对特征 ID 应用哈希函数,把原始特征向量压缩成一个 \(m\) 维向量,如示例 5-3所示。例如,如果原始特征是文档中的词,那么哈希后的版本词汇量固定为 \(m\),无论输入中有多少个唯一词。
示例 5-3:词特征的特征哈希
>>> def hash_features(word_list, m):
...     output = [0] * m
...     for word in word_list:
...         index = hash_fcn(word) % m
...         output[index] += 1
...     return output
特征哈希的另一个变体添加了一个符号分量,使得计数要么加到哈希桶里,要么从哈希桶里减去(见示例 5-4)。从统计上说,这保证了哈希特征之间的内积在期望上等于原始特征之间的内积。
示例 5-4:带符号的特征哈希
>>> def hash_features(word_list, m):
...     output = [0] * m
...     for word in word_list:
...         index = hash_fcn(word) % m
...         sign_bit = sign_hash(word) % 2
...         if (sign_bit == 0):
...             output[index] -= 1
...         else:
...             output[index] += 1
...     return output
哈希后的内积值与原始内积的偏差在 \(O(1/\sqrt{m})\) 以内,因此可以根据可接受的误差来选择哈希表大小 \(m\)。在实践中,挑选合适的 \(m\) 可能需要一些试错。
特征哈希可以用于涉及特征向量与系数内积的模型,比如线性模型和核方法(kernel method)。它已被证明在垃圾邮件过滤任务中很成功(Weinberger 等人,2009)。在定向广告的场景中,McMahan 等人(2013)报告说,除非 \(m\) 达到数十亿的量级,否则无法把预测误差降到可接受的水平,这就不足以节省空间了。
特征哈希的一个缺点是,哈希后的特征是原始特征的聚合,不再可解释。
在示例 5-5中,我们使用 Yelp 评论数据集和 scikit-learn 的 FeatureHasher 来演示存储与可解释性之间的权衡。
示例 5-5:特征哈希(又称"哈希技巧”)
>>> import pandas as pd
>>> import json
# Load the first 10,000 reviews
>>> f = open('yelp_academic_dataset_review.json')
>>> js = []
>>> for i in range(10000):
...     js.append(json.loads(f.readline()))
>>> f.close()
>>> review_df = pd.DataFrame(js)
# Define m as equal to the unique number of business_ids
>>> m = len(review_df.business_id.unique())
>>> m
528
>>> from sklearn.feature_extraction import FeatureHasher
>>> h = FeatureHasher(n_features=m, input_type='string')
>>> f = h.transform(review_df['business_id'])
# How does this affect feature interpretability?
>>> review_df['business_id'].unique().tolist()[0:5]
['vcNAWiLM4dR7D2nwwJ7nCA',
 'UsFtqoBl7naz8AVUBZMjQQ',
 'cE27W9VPgO88Qxe4ol6y_g',
 'HZdLhv6COCleJMo7nPl-RA',
 'mVHrayjG3uZ_RLHkLj-AMg']
>>> f.toarray()
array([[ 0.,  0.,  0., ...,  0.,  0.,  0.],
       [ 0.,  0.,  0., ...,  0.,  0.,  0.],
       [ 0.,  0.,  0., ...,  0.,  0.,  0.],
       ...,
       [ 0.,  0.,  0., ...,  0.,  0.,  0.],
       [ 0.,  0.,  0., ...,  0.,  0.,  0.],
       [ 0.,  0.,  0., ...,  0.,  0.,  0.]])
# Not great. BUT, let's see the storage size of our features.
>>> from sys import getsizeof
>>> print('Our pandas Series, in bytes: ', getsizeof(review_df['business_id']))
>>> print('Our hashed numpy array, in bytes: ', getsizeof(f))
Our pandas Series, in bytes:  790104
Our hashed numpy array, in bytes:  56
我们可以清楚地看到,使用特征哈希如何在计算上让我们受益,代价是牺牲了用户的即时可解释性。当从数据探索和可视化进入大规模数据集的机器学习流水线时,这是一个很容易接受的权衡。
分箱计数
分箱计数是机器学习中反复被重新发现的经典技术之一。它被反复发明并用于各种应用,从广告点击率预测到硬件分支预测(Yeh 和 Patt,1991;Lee 等人,1998;Chen 等人,2009;Li 等人,2010)。然而,由于它是一项特征工程技术,而不是建模或优化方法,所以没有关于该主题的研究论文。关于这项技术最详细的描述可以在 Misha Bilenko(2015)的博客文章《Big Learning Made Easy—with Counts!》及配套幻灯片中找到。
分箱计数的想法狡猾地简单:不用类别变量的取值作为特征,而是用该取值下目标的条件概率(conditional probability)。换句话说,我们不编码类别取值的身份,而是计算该取值与我们要预测的目标之间的关联统计量。对于熟悉朴素贝叶斯(naive Bayes)分类器的人来说,这个统计量应该耳熟,因为它正是假设所有特征相互独立时类别的条件概率。用一个例子最能说明问题(见表 5-6)。
| 用户 | 点击次数 | 未点击次数 | 点击概率 | 查询哈希、广告域名 | 点击次数 | 未点击次数 | 点击概率 |
|---|---|---|---|---|---|---|---|
| Alice | 5 | 120 | 0.0400 | 0x598fd4fe, foo.com | 5,000 | 30,000 | 0.167 |
| Bob | 20 | 230 | 0.0800 | 0x50fa3cc0, bar.org | 100 | 900 | 0.100 |
| … | … | … | |||||
| Joe | 2 | 3 | 0.400 | 0x437a45e1, qux.net | 6 | 18 | 0.250 |
分箱计数假设有历史数据可用于计算统计量。表 5-6包含了类别变量每个可能取值的聚合历史计数。根据用户"Alice"点击过任何广告的次数以及她没有点击的次数,我们可以计算出她点击任何广告的概率。类似地,我们可以为任何查询-广告域名组合计算点击概率。在训练时,每次我们看到"Alice”,都可以用她的点击概率作为模型的输入特征。对"0x437a45e1, qux.net"这样的查询哈希-广告域名对也是如此。
假设有 10,000 个用户。独热编码会生成一个长度为 10,000 的稀疏向量,在与当前数据点取值对应的那一列有一个 1。分箱计数则会把全部 10,000 个二值列编码成单个特征,取值为 0 到 1 之间的实数。
除了历史点击概率,我们还可以加入其他特征:原始计数本身(点击次数和未点击次数)、对数比值比(log-odds ratio),或者概率的任何其他衍生量。我们这里的例子是预测广告点击率,但这项技术可以很容易地推广到一般的二分类问题。它也可以很容易地扩展到多分类,只需要用通常的方法把二分类器扩展成多分类器;例如通过一对多(one-against-many)比值比或其他多分类标签编码。
分箱计数的比值比与对数比值比
比值比(odds ratio)通常定义在两个二值变量之间。它通过问这样一个问题来衡量两者的关联强度:“当 \(X\) 为真时,\(Y\) 为真的可能性大多少?“例如,我们可能会问:“Alice 点击广告的可能性比一般人群大多少?“这里,\(X\) 是二值变量"Alice 是当前用户”,\(Y\) 是变量"是否点击广告”。计算使用所谓的双向列联表(two-way contingency table)(基本上就是四个数,对应 \(X\) 和 \(Y\) 的四种可能组合),如表 5-7 所示。
| 点击 | 未点击 | 总计 | |
|---|---|---|---|
| Alice | 5 | 120 | 125 |
| 非 Alice | 995 | 18,880 | 19,875 |
| 总计 | 1,000 | 19,000 | 20,000 |
给定输入变量 \(X\) 和目标变量 \(Y\),比值比定义为:
\[ \text{odds ratio} = \frac{P(Y=1 \mid X=1) / P(Y=0 \mid X=1)}{P(Y=1 \mid X=0) / P(Y=0 \mid X=0)} \]在我们的例子中,这转化为"Alice 点击广告而不是不点击的可能性,比其他用户点击而不是不点击的可能性大多少"这两个概率之比。这个数字是:
\[ \text{odds ratio (user, ad click)} = \frac{(5/125)/(120/125)}{(995/19{,}875)/(18{,}880/19{,}875)} = 0.7906 \]更简单地说,我们可以只看分子,它考察的是单个用户(Alice)点击广告与不点击相比的可能性大多少。这适合具有大量取值的类别变量,而不仅仅是两个:
\[ \text{odds ratio (Alice, ad click)} = \frac{5/125}{120/125} = 0.04166 \]概率比值很容易变得非常小或非常大。(例如,会有几乎从不点击广告的用户,也可能有点击广告远多于不点击的用户。)对数变换再次救了我们。对数还有一个有用的性质:它把除法变成减法:
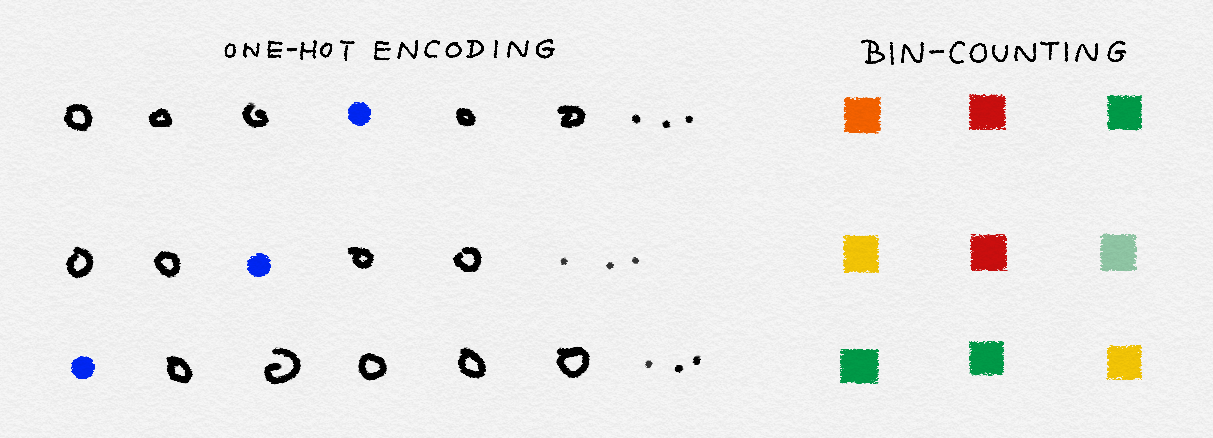
\[ \text{log-odds ratio (Alice, ad click)} = \log\frac{5}{125} - \log\frac{120}{125} = -3.178 \]简而言之,分箱计数把类别变量转换成关于取值的统计量。它把类别变量那种大规模的、稀疏的二值表示——比如独热编码产生的表示——变成一种非常小的、稠密的实值数值表示(图 5-2)。
在实现方面,分箱计数需要存储每个类别及其关联计数之间的映射。(其余统计量可以从原始计数中即时推导出来。)因此它需要 \(O(k)\) 的空间,其中 \(k\) 是类别变量的唯一取值个数。
为了演示分箱计数在实践中的用法,我们将使用Avazu 举办的 Kaggle 竞赛数据。以下是关于该数据集的一些相关统计:
- 共有 24 个变量,包括
click(二值的点击/未点击计数器)和device_id(跟踪广告展示在哪个设备上)。 - 完整数据集包含 40,428,967 条观测,有 2,686,408 个唯一设备。
Avazu 竞赛的目标是用广告数据预测点击率,但我们将用这个数据集来演示分箱计数如何大幅缩减大量流式数据的特征空间(见示例 5-6)。
示例 5-6:分箱计数示例
>>> import pandas as pd
# train_subset data is first 10K rows of 6+GB set
>>> df = pd.read_csv('data/train_subset.csv')
# How many unique features should we have after?
>>> len(df['device_id'].unique())
7201
# For each category, we want to calculate:
# Theta = [counts, p(click), p(no click), p(click)/p(no click)]
>>> def click_counting(x, bin_column):
...     clicks = pd.Series(x[x['click'] > 0][bin_column].value_counts(),
...                        name='clicks')
...     no_clicks = pd.Series(x[x['click'] < 1][bin_column].value_counts(),
...                           name='no_clicks')
...     counts = pd.DataFrame([clicks, no_clicks]).T.fillna('0')
...     counts['total_clicks'] = counts['clicks'].astype('int64') + \
...                              counts['no_clicks'].astype('int64')
...     return counts
>>> def bin_counting(counts):
...     counts['N+'] = counts['clicks']\
...         .astype('int64')\
...         .divide(counts['total_clicks'].astype('int64'))
...     counts['N-'] = counts['no_clicks']\
...         .astype('int64')\
...         .divide(counts['total_clicks'].astype('int64'))
...     counts['log_N+'] = counts['N+'].divide(counts['N-'])
...     # If we wanted to only return bin-counting properties,
...     # we would filter here
...     bin_counts = counts.filter(items=['N+', 'N-', 'log_N+'])
...     return counts, bin_counts
# Bin counts example: device_id
>>> bin_column = 'device_id'
>>> device_clicks = click_counting(df.filter(items=[bin_column, 'click']),
...                                bin_column)
>>> device_all, device_bin_counts = bin_counting(device_clicks)
# Check to make sure we have all the devices
>>> len(device_bin_counts)
7201
>>> device_all.sort_values(by='total_clicks', ascending=False).head(4)
        clicks  no_clicks  total  N+        N-        log_N+
a99f214...
稀有类别怎么办?
就像稀有词一样,稀有类别需要特殊处理。想想一个一年只登录一次的用户:可用于可靠估计该用户广告点击率的数据非常少。此外,稀有类别还会浪费计数表中的空间。
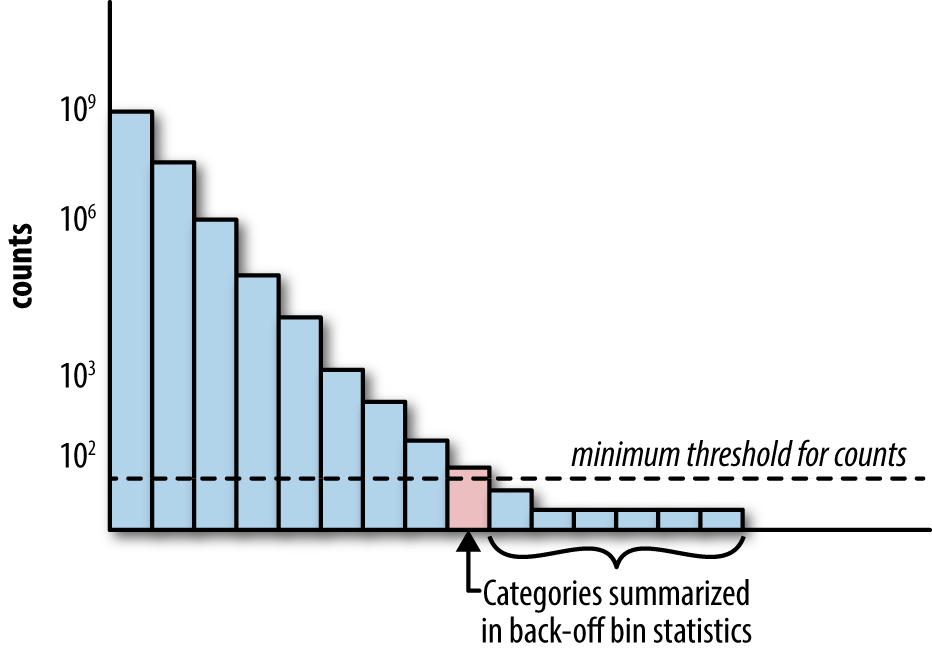
一种处理方法是回退(back-off),这是一种简单的技术,把所有稀有类别的计数累积到一个特殊的箱子中(见图 5-3)。如果计数大于某个阈值,该类别就拥有自己的计数统计量。否则,我们使用回退箱中的统计量。这本质上把单个稀有类别的统计量还原为在所有稀有类别上计算的统计量。使用回退方法时,最好再添加一个二值指示符,标明统计量是否来自回退箱。
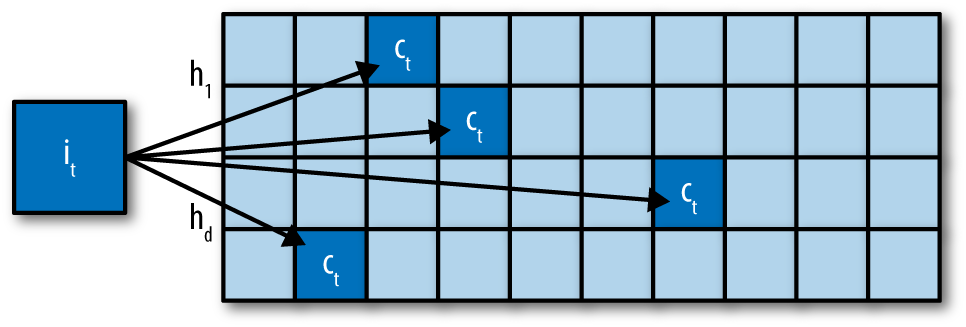
还有另一种处理这个问题的方法,称为计数最小草图(count-min sketch)(Cormode 和 Muthukrishnan,2005)。在这种方法中,所有类别——无论稀有还是常见——都通过多个输出范围为 \(m\) 的哈希函数映射,其中 \(m\) 远小于类别数量 \(k\)。检索统计量时,重新计算该类别的所有哈希值,并返回最小的统计量。使用多个哈希函数可以降低单个哈希函数内发生碰撞的概率。这个方案之所以有效,是因为哈希函数个数乘以哈希表大小 \(m\) 可以做得比类别数量 \(k\) 小,同时仍然保持很低的整体碰撞概率。
图 5-4 对此进行了说明。每个条目 \(i\) 被映射到计数数组每一行中的一个单元格。当对条目 \(i_t\) 进行 \(c_t\) 的更新时,\(c_t\) 被加到这些单元格中的每一个,使用函数 \(h_1 \dots h_d\) 进行哈希。
防范数据泄漏
由于分箱计数依赖历史数据来生成所需统计量,它需要等待一个数据收集周期,给学习流水线带来轻微延迟。此外,当数据分布发生变化时,计数需要更新。数据变化越快,计数需要重新计算的频率就越高。这对定向广告之类的应用尤其重要——用户偏好和热门查询变化非常快,不能适应当前分布可能给广告平台带来巨大损失。
有人可能会问,为什么不用同一份数据集既计算相关统计量又训练模型呢?这个想法看起来似乎人畜无害。这里的大问题是,统计量涉及目标变量,而目标变量正是模型试图预测的东西。用输出来计算输入特征会导致一个棘手的问题,称为泄漏(leakage)。简而言之,泄漏意味着有信息被泄露给模型,使它获得了不切实际的预测优势。当测试数据泄漏进训练集,或者未来数据泄漏到过去时,就会发生这种情况。任何时候,只要模型在生产的实时预测中被给予了本不该访问的信息,就存在泄漏。Kaggle 的 wiki 提供了更多关于泄漏的例子,以及为什么它对机器学习应用有害。
如果分箱计数过程使用当前数据点的标签来计算部分输入统计量,那就构成了直接泄漏。防止这种情况的一种方法是,在计数收集(用于计算分箱计数统计量)和训练之间建立严格的分离,如图 5-5所示——即用较早批次的数据点做计数,用当前数据点做训练(把类别变量映射到我们刚刚收集的历史统计量),用未来的数据点做测试。这解决了泄漏问题,但引入了前面提到的延迟(输入统计量乃至模型都会落后于当前数据)。
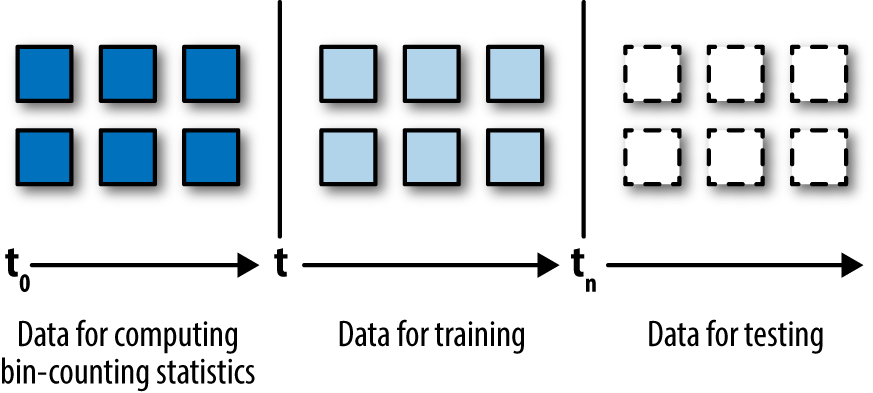
事实证明,还有另一种基于差分隐私(differential privacy)的解决方案。如果一个统计量的分布在任意一个数据点存在与否的情况下都大致保持不变,那么它就是近似防泄漏(approximately leakage-proof)的。在实践中,添加一个服从 Laplace(0,1) 分布的小随机噪声就足以掩盖来自单个数据点的任何潜在泄漏。这个想法可以与留一法(leaving-one-out)计数相结合,在当前数据上构造统计量(Zhang,2015)。
无界计数
如果统计量随着越来越多历史数据的到来而持续更新,原始计数将无界增长。这对模型来说可能是个问题。训练好的模型"知道"输入数据直到观测到的尺度。训练好的决策树可能会说:“当 \(x\) 大于 3 时,预测 1。“训练好的线性模型可能会说:“把 \(x\) 乘以 0.7,看看结果是否大于全局平均值。“当 \(x\) 在 0 到 5 之间时,这些可能是正确的决策。但超出这个范围会发生什么?没人知道。
当输入计数增大时,模型需要重新训练以适应当前的尺度。如果计数累积得比较慢,那么有效尺度不会变化太快,模型也不需要太频繁地重新训练。但当计数增长非常快时,频繁重新训练会很麻烦。
因此,通常最好使用归一化的计数,保证它们有界在已知区间内。例如,估计的点击概率有界于 [0, 1] 之间。另一种方法是取对数变换,它施加了严格界限,但当计数非常大时增长速度会非常慢。
两种方法都无法防范输入分布的变化(例如,去年的芭比娃娃已经过时,人们不再点击那些广告)。模型需要重新训练以适应输入数据分布中这些更根本的变化,或者整个流水线需要转向在线学习(online learning)环境,让模型持续适应输入。
小结
本章详细介绍的每种方法都各有利弊。以下是各种权衡的概览。
| 纯独热编码 | |
|---|---|
| 空间需求 | 使用稀疏向量格式时 \(O(n)\),其中 \(n\) 是数据点数量 |
| 计算需求 | 线性模型下 \(O(nk)\),其中 \(k\) 是类别数量 |
| 优点 | - 最容易实现 - 可能最准确 - 适合在线学习 |
| 缺点 | - 计算效率低下 - 不适应不断增长的类别 - 除线性模型外不可行 - 真正的大数据集需要大规模分布式优化 |
| 特征哈希 | |
|---|---|
| 空间需求 | 使用稀疏矩阵格式时 \(O(n)\),其中 \(n\) 是数据点数量 |
| 计算需求 | 线性或核模型下 \(O(nm)\),其中 \(m\) 是哈希桶数量 |
| 优点 | - 易于实现 - 使模型训练更便宜 - 容易适应新类别 - 容易处理稀有类别 - 适合在线学习 |
| 缺点 | - 只适合线性或核化模型 - 哈希后的特征不可解释 - 关于准确性的报告褒贬不一 |
| 分箱计数 | |
|---|---|
| 空间需求 | 每个数据点采用小而稠密的表示(\(O(n)\)),加上必须为每个类别保留的计数统计量(\(O(k)\)),合计 \(O(n+k)\) |
| 计算需求 | 线性模型 \(O(n)\);也可用于树等非线性模型 |
| 优点 | - 训练时的计算负担最小 - 支持基于树的模型 - 相对容易适应新类别 - 用回退或计数最小草图处理稀有类别 - 可解释 |
| 缺点 | - 需要历史数据 - 需要延迟更新,不完全适合在线学习 - 泄漏的可能性更高 |
正如我们所见,没有哪种方法是完美的。用哪一种取决于想要的模型。线性模型训练成本更低,因此可以处理独热编码这类未压缩的表示。另一方面,基于树的模型需要对所有特征反复搜索以找到正确的分裂点,因此只能使用分箱计数这类小表示。特征哈希介于这两个极端之间,但其准确性的评价褒贬不一。
参考文献
Agarwal, Alekh, Oliveier Chapelle, Miroslav Dudík, and John Langford. “A Reliable Effective Terascale Linear Learning System.” Journal of Machine Learning Research 15 (2015): 1111−1133.
Bilenko, Misha. “Big Learning Made Easy—with Counts!” Cortana Intelligence and Machine Learning Blog, February 17, 2015. https://blogs.technet.microsoft.com/machinelearning/2015/02/17/big-learning-made-easy-with-counts/ .
Chen, Ye, Dmitry Pavlov, and John F. Canny. “Large-Scale Behavioral Targeting.” Proceedings of the 15th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (2009): 209-218.
Cormode, Graham, and S. Muthukrishnan. “An Improved Data Stream Summary: The Count-Min Sketch and Its Applications.” Algorithms 55 (2005): 29-38.
Graepel, Thore, Joaquin Quiñonero Candela, Thomas Borchert, and Ralf Herbrich. “Web-Scale Bayesian Click-Through Rate Prediction for Sponsored Search Advertising in Microsoft’s Bing Search Engine.” Proceedings of the 27th International Conference on Machine Learning (2010): 13-20.
He, Xinran, Junfeng Pan, Ou Jin, Tianbing Xu, Bo Liu, Tao Xu, Yanxin Shi, Antoine Atallah, Ralf Herbrich, Stuart Bowers, and Joaquin Quiñonero Candela. “Practical Lessons from Predicting Clicks on Ads at Facebook.” Proceedings of the 8th International Workshop on Data Mining for Online Advertising (2014): 1-9.
Lee, Wenke, Salvatore J. Stolfo, and Kui W. Mok. 1998. “Mining Audit Data to Build Intrusion Detection Models.” Proceedings of the 4th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (1998): 66-72.
Li, Wei, Xuerui Wang, Ruofei Zhang, Ying Cui, Jianchang Mao, and Rong Jin. “Exploitation and Exploration in a Performance Based Contextual Advertising System.” Proceedings of the 16th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (2010): 27-36.
McMahan, H. Brendan, Gary Holt, D. Sculley, Michael Young, Dietmar Ebner, Julian Grady, Lan Nie, Todd Phillips, Eugene Davydov, Daniel Golovin, Sharat Chikkerur, Dan Liu, Martin Wattenberg, Arnar Mar Hrafnkelsson, Tom Boulos, and Jeremy Kubica. “Ad Click Prediction: A View from the Trenches.” Proceedings of the 19th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (2013): 1222-1230.
Weinberger, Kilian, Anirban Dasgupta, Josh Attenberg, John Langford, and Alex Smola. 2009. “Feature Hashing for Large Scale Multitask Learning.” Proceedings of the 26th International Conference on Machine Learning (2009): 1113-1120.
Yeh, Tse-Yu, and Yale N. Patt. “Two-Level Adaptive Training Branch Prediction.” Proceedings of the 24th Annual International Symposium on Microarchitecture (1991): 51-61.
Zhang, Owen. 2015. “Tips for data science competitions.” SlideShare presentation. Retrieved from http://bit.ly/2DjuhBD .
[1] 在标准的统计学文献中,类别的技术术语是水平(level)。具有两个不同类别的类别变量有两个水平。但统计学中还有其他一些东西也叫水平,所以我们这里不使用这个术语;我们用更口语化、更明确的术语"类别”。
[2] 好奇的读者可能会想,为什么一个叫 coding,另一个叫 encoding。这主要是惯例问题。我猜独热编码最早是在电气工程中流行起来的,在那里信息总是被编码和解码。而哑变量编码和效应编码则是在统计学界发明的。不知怎地,“en"这个前缀没能跨越学术分界线。