特征缩放的效果:从词袋到 Tf-Idf
词袋表示很容易生成,但远非完美。如果我们对所有词一视同仁地计数,那么有些词最终被强调的程度会超出我们的需要。回想第 3 章中 Emma 和乌鸦的例子。我们想要一种能突出两位主角的文档表示。“Emma” 和 “raven” 都出现了三次,但 “the” 出现了足足八次,“and” 出现了五次,“it” 和 “was” 各出现四次。仅靠简单的频率计数,主角并不突出。这是有问题的。
能挑出 “magnificently”、“gleamed”、“intimidated”、“tentatively”、“reigned” 这样的词也很好,因为它们有助于奠定整段的基调。它们指示着情绪(sentiment),这对数据科学家来说是非常有价值的信息。所以,理想情况下我们想要一种突出有意义词的表示。
Tf-Idf:词袋的一个简单变体
Tf-idf 是词袋方法的一个简单变体。它代表词频-逆文档频率(term frequency-inverse document frequency)。tf-idf 不看数据集中每个词在每个文档中的原始计数,而是看一种归一化的计数:每个词的计数除以该词出现的文档数。即:
\[ \text{bow}(w, d) = \# \text{词 } w \text{ 在文档 } d \text{ 中出现的次数} \]\[ \text{tf-idf}(w, d) = \text{bow}(w, d) \times \frac{N}{\# \text{词 } w \text{ 出现的文档数}} \]\(N\) 是数据集中的文档总数。分数 \(N / (\# \text{词 } w \text{ 出现的文档数})\) 就是所谓的逆文档频率(inverse document frequency)。如果一个词出现在很多文档中,它的逆文档频率接近 1。如果一个词只出现在少数文档中,逆文档频率就高得多。
或者,我们可以不用原始逆文档频率,而改用对数变换。对数把 1 变成 0,把大数(远大于 1 的数)变小。(后面会详述。)
如果我们把 tf-idf 定义为:
\[ \text{tf-idf}(w, d) = \text{bow}(w, d) \times \log \frac{N}{\# \text{词 } w \text{ 出现的文档数}} \]那么出现在每一篇文档中的词会被有效地清零,而只出现在极少数文档中的词会比之前得到更大的计数。
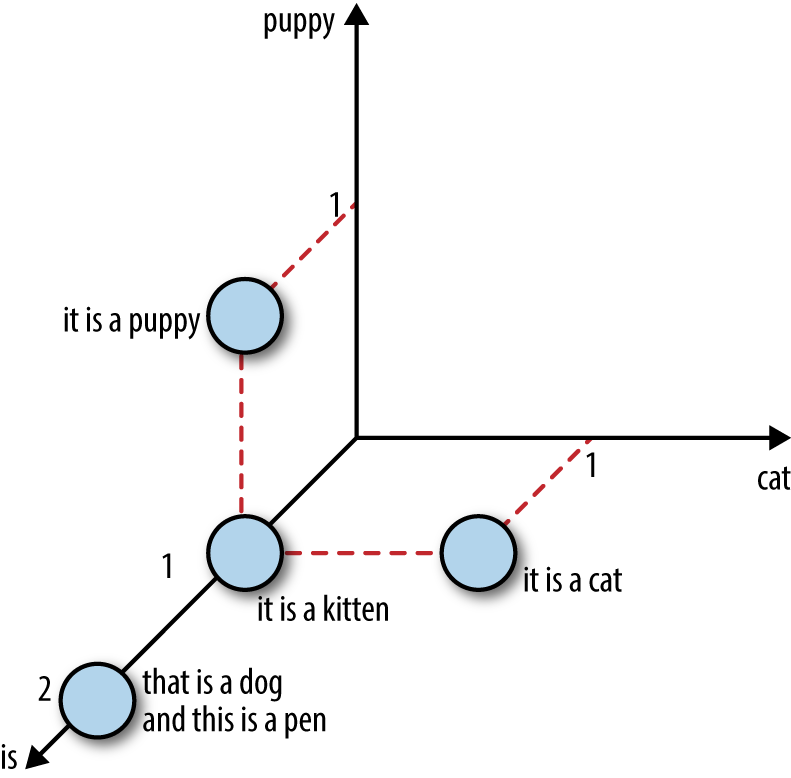
让我们看一些图来理解这一切。图 4-1 展示了一个包含四个句子的简单例子:“it is a puppy”、“it is a cat”、“it is a kitten” 和 “that is a dog and this is a pen”。我们把这四个句子绘制在 “puppy”、“cat” 和 “is” 三个词的特征空间中。
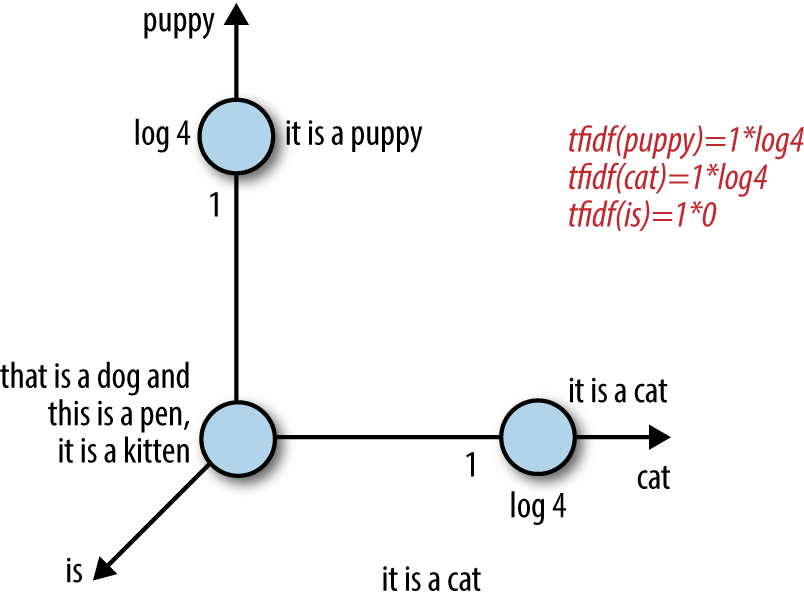
现在,我们用逆文档频率的对数变换,看看同样的四个句子在 tf-idf 表示下的样子。图 4-2 展示了特征空间中的文档。注意,“is” 这个特征被有效地消除了,因为它出现在该数据集的所有句子中。另外,由于 “puppy” 和 “cat” 各自只出现在四个句子中的一句里,它们的计数现在比之前更高(\(\log(4) = 1.38\ldots > 1\))。因此,tf-idf 让罕见词更突出,并有效地忽略常见词。它与第 3 章中基于频率的过滤方法密切相关,但在数学上比设置硬性截断阈值优雅得多。
Tf-Idf 背后的直觉
Tf-idf 让罕见词更突出,并有效地忽略常见词。
付诸实践检验
Tf-idf 通过乘以一个常数来变换词频特征。因此,它是特征缩放(feature scaling)的一个例子——这个概念在第 2 章中介绍过。特征缩放在实践中效果如何?让我们在一个简单的文本分类任务中比较缩放与未缩放特征的表现。是时候写点代码了!
在示例 4-1中,我们再次使用 Yelp 评论数据集。Yelp 数据集挑战赛第 6 轮包含美国六个城市近 160 万条商家评论。
示例 4-1:在 Python 中加载并清洗 Yelp 评论数据集
`>>> import json` >>> import pandas as pd `# Load Yelp business data` >>> biz_f = open ( 'yelp_academic_dataset_business.json' ) `>>> biz_df = pd . DataFrame ([ json . loads ( x ) for x in biz_f . readlines ()])` >>> biz_f . close () `# Load Yelp reviews data` >>> review_file = open ( 'yelp_academic_dataset_review.json' ) `>>> review_df = pd . DataFrame ([ json . loads ( x ) for x in review_file . readlines ()])` >>> review_file . close () `# Pull out only Nightlife and Restaurants businesses` >>> two_biz = biz_df [ biz_df . apply ( lambda x : 'Nightlife' in x [ 'categories' ] or `... 'Restaurants' in x [ 'categories' ], ... axis = 1 )]` # Join with the reviews to get all reviews on the two types of business `>>> twobiz_reviews = two_biz . merge ( review_df , on = 'business_id' , how = 'inner' )` # Trim away the features we won't use `>>> twobiz_reviews = twobiz_reviews [[ 'business_id' , ... 'name' , ... 'stars_y' , ... 'text' , ... 'categories' ]]` # Create the target column--True for Nightlife businesses, and False otherwise `>>> two_biz_reviews [ 'target' ] =` `\` `... twobiz_reviews . apply ( lambda x : 'Nightlife' in x [ 'categories' ],` ... axis = 1 ) ``
创建分类数据集
我们来看看能否用评论把商家分成餐厅或夜生活场所。为了节省训练时间,可以取评论的一个子集。在这个例子中,两个类别的评论数量差异很大,这被称为类别不平衡数据集(class-imbalanced dataset)。不平衡数据集对建模是个麻烦,因为模型会把大部分精力花在拟合较大的类别上。既然两个类别都有充足的数据,解决问题的一个好办法是对较大的类别(餐厅)下采样,使其与较小的类别(夜生活)规模大致相当。下面是一个示例工作流:
- 随机抽取 10% 的夜生活评论和 2.1% 的餐厅评论(百分比的选择使得每个类别中的样本数大致相等)。
- 对这个数据集做 70/30 的训练-测试划分。本例中,训练集最终有 29,264 条评论,测试集有 12,542 条评论。
- 训练数据包含 46,924 个不同的词;这就是词袋表示中的特征数量。
示例 4-2 展示了具体做法。
示例 4-2:创建平衡的分类数据集
`# Create a class-balanced subsample to play with` >>> nightlife = \ ... twobiz_reviews [ twobiz_reviews . apply ( lambda x : 'Nightlife' in x [ 'categories' ], `... axis = 1 )]` >>> restaurants = \ ... twobiz_reviews [ twobiz_reviews . apply ( lambda x : 'Restaurants' in x [ 'categories' ], `... axis = 1 )]` >>> nightlife_subset = nightlife . sample ( frac = 0.1 , random_state = 123 ) `>>> restaurant_subset = restaurants . sample ( frac = 0.021 , random_state = 123 )` >>> combined = pd . concat ([ nightlife_subset , restaurant_subset ]) `# Split into training and test datasets` >>> training_data , test_data = modsel . train_test_split ( combined , ... train_size = 0.7 , ... random_state = 123 ) `>>> training_data . shape` (29264, 5) `>>> test_data . shape` (12542, 5) ``
用 Tf-Idf 变换缩放词袋
本实验的目标是比较词袋、tf-idf 和 \(\ell_2\) 归一化(\(\ell_2\) normalization)在线性分类中的效果。注意,先做 tf-idf 再做 \(\ell_2\) 归一化,与单独做 \(\ell_2\) 归一化是一样的。所以,我们只需测试三组特征:词袋、tf-idf,以及在词袋之上逐词做 \(\ell_2\) 归一化。
在示例 4-3中,我们用 scikit-learn 的 CountVectorizer 把评论文本转换成词袋。所有文本特征化方法都隐式依赖分词器(tokenizer)——把文本字符串转换成词元(词)列表的模块。在本例中,scikit-learn 的默认分词模式寻找两个及以上字母数字字符的序列。标点符号被视为词元分隔符。
示例 4-3:变换特征
`# Represent the review text as a bag-of-words` >>> bow_transform = text . CountVectorizer () `>>> X_tr_bow = bow_transform . fit_transform ( training_data [ 'text' ])` >>> X_te_bow = bow_transform . transform ( test_data [ 'text' ]) `>>> len ( bow_transform . vocabulary_ )` 46924 `>>> y_tr = training_data [ 'target' ]` >>> y_te = test_data [ 'target' ] `# Create the tf-idf representation using the bag-of-words matrix` >>> tfidf_trfm = text . TfidfTransformer ( norm = None ) `>>> X_tr_tfidf = tfidf_trfm . fit_transform ( X_tr_bow )` >>> X_te_tfidf = tfidf_trfm . transform ( X_te_bow ) `# Just for kicks, l2-normalize the bag-of-words representation` >>> X_tr_l2 = preproc . normalize ( X_tr_bow , axis = 0 ) `>>> X_te_l2 = preproc . normalize ( X_te_bow , axis = 0 )`
测试集上的特征缩放
关于特征缩放有一个微妙之处:它需要知道特征的统计量——均值、方差、文档频率、\(\ell_2\) 范数等——而这些统计量在实践中我们多半并不知道。为了计算 tf-idf 表示,我们必须基于训练数据计算逆文档频率,并用这些统计量来缩放训练数据和测试数据。在 scikit-learn 中,在训练数据上拟合特征变换器就等于收集相关统计量。拟合好的变换器随后可以应用到测试数据上。
当我们用训练统计量来缩放测试数据时,结果会看起来有点模糊。测试集上的最小-最大缩放不再整齐地映射到 0 和 1。\(\ell_2\) 范数、均值和方差统计量看起来都会有点偏差。这比数据缺失的问题要小。例如,测试集可能包含训练数据中没有的词,我们就没有可用于新词的文档频率。常见的解决办法是直接丢弃测试集中的新词。这看起来可能不负责任,但模型——在训练集上训练的模型——反正也不知道怎么处理这些词。一个不那么取巧的选项是显式地学习一个"垃圾"词,把所有低频词都映射到它上面,即使在训练集内也如此——正如“罕见词”一节所讨论的。
用逻辑回归分类
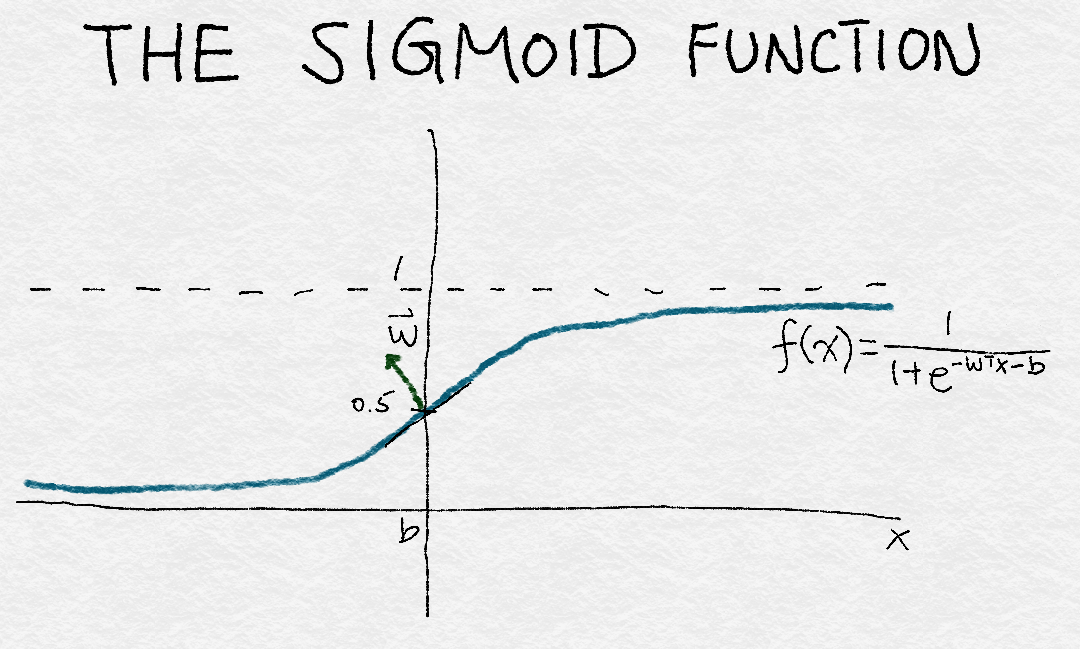
逻辑回归(logistic regression)是一种简单的线性分类器。正因为它简单,它常常是值得先试的分类器。它对输入特征做加权组合,然后送入 sigmoid 函数(sigmoid function)——该函数把任意实数平滑地映射到 0 和 1 之间的数。这个函数把实数输入 \(x\) 变换成 0 到 1 之间的数。它有一组参数 \(w\),表示在中点 0.5 附近上升的斜率。截距项 \(b\) 表示函数输出穿过中点时对应的输入值。如果 sigmoid 输出大于 0.5,逻辑分类器就预测正类,否则预测负类。通过改变 \(w\) 和 \(b\),可以控制决策转变发生的位置,以及决策在该点附近对输入变化的响应速度。
图 4-3 展示了 sigmoid 函数。
现在,让我们在各种特征集上构建几个简单的逻辑回归分类器,看看它们表现如何(示例 4-4)。
示例 4-4:用默认参数训练逻辑回归分类器
`>>> def simple_logistic_classify ( X_tr , y_tr , X_test , y_test , description ):` ... ### Helper function to train a logistic classifier and score on test data `... m = LogisticRegression () . fit ( X_tr , y_tr )` ... s = m . score ( X_test , y_test ) `... print ( 'Test score with' , description , 'features:' , s )` ... return m `>>> m1 = simple_logistic_classify ( X_tr_bow , y_tr , X_te_bow , y_te , 'bow' )` >>> m2 = simple_logistic_classify ( X_tr_l2 , y_tr , X_te_l2 , y_te , 'l2-normalized' ) `>>> m3 = simple_logistic_classify ( X_tr_tfidf , y_tr , X_te_tfidf , y_te , 'tf-idf' )` Test score with bow features: 0.775873066497 `Test score with l2-normalized features: 0.763514590974` Test score with tf-idf features: 0.743182905438
矛盾的是,结果显示最准确的分类器使用的是词袋特征。这出乎意料。事实证明,原因是这些分类器没有很好地"调优"——这是比较分类器时常见的陷阱。
用正则化调优逻辑回归
逻辑回归有一些附加功能。当特征数量大于数据点数量时,寻找最佳模型的问题被称为欠定(underdetermined)问题。解决这个问题的一种方式是对训练过程施加额外约束,这被称为正则化(regularization),其技术细节在此讨论。
大多数逻辑回归实现都支持正则化。要使用这个功能,必须指定一个正则化参数。正则化参数是超参数(hyperparameter)——在模型训练过程中不会自动学习,而必须针对手头的问题进行调优,再交给训练算法。这个过程称为超参数调优(hyperparameter tuning)。(关于如何评估机器学习模型的细节,参见 Zheng(2015)。)调优超参数的一种基本方法叫网格搜索(grid search):你指定一个超参数值网格,调优器在网格中程序化地搜索最佳超参数设置。找到最佳超参数设置后,用该设置在全部训练集上训练模型,并把它在测试集上的表现作为这类模型的最终评估。
重要提示:比较模型时务必调优超参数
比较模型或特征时,调优超参数至关重要。软件包的默认设置总会返回一个模型。但除非软件在底层做了自动调优,否则它很可能基于次优的超参数设置返回次优模型。分类器性能对超参数设置的敏感度取决于模型和训练数据的分布。逻辑回归对超参数设置相对稳健(或者说不太敏感)。即便如此,仍然有必要找到并使用正确的超参数范围。否则,一个模型相对于另一个模型的优势可能完全来自调参,并不能反映模型或特征的真实行为。
即使是最好的自动调优包,也仍然需要指定搜索的上下限,而确定这些界限往往要手动试上几次。
在下面的例子中,我们手动把逻辑回归正则化参数的搜索网格设为 {1e-5, 0.001, 0.1, 1, 10, 100}。上下界经过几次尝试才确定下来。每个特征集的最优超参数设置见表 4-1。
| 特征集 | \(\ell_2\) 正则化 |
|---|---|
| 词袋(BoW) | 0.1 |
| \(\ell_2\) 归一化 | 10 |
| Tf-idf | 0.001 |
我们还希望检验 tf-idf 与词袋之间的准确率差异是否只是噪声所致。为此,我们使用 k 折交叉验证(k-fold cross validation)来模拟拥有多个统计上独立的数据集。它把数据集分成 \(k\) 折(fold)。交叉验证过程遍历每一折,用除一折之外的所有折训练,在留出的那一折上验证结果。
通过重采样估计方差
现代统计方法假定底层数据来自某个随机分布。从数据推导出的模型的性能度量同样受随机噪声影响。在这种情况下,最好不只测量一次,而是基于统计量相当的数据集测量多次。这为我们提供了度量的置信区间。
k 折交叉验证就是这样一种策略。重采样(resampling)是另一种技术,它从同一个底层数据集中生成多个小样本。重采样的更多细节参见 Zheng(2015)。
scikit-learn 中的 GridSearchCV 函数运行带交叉验证的网格搜索(见示例 4-5)。图 4-4 展示了在每组特征集上训练的模型的准确率分布箱线图(box-and-whiskers plot)。箱中的中线标记中位准确率,箱体本身标记第一和第三四分位数之间的区域,须线延伸到分布的其余部分。
示例 4-5:用网格搜索调优逻辑回归超参数
`>>> import sklearn.model_selection as modsel` # Specify a search grid, then do a 5-fold grid search for each of the feature sets `>>> param_grid_ = { 'C' : [ 1e-5 , 1e-3 , 1e-1 , 1e0 , 1e1 , 1e2 ]}` # Tune classifier for bag-of-words representation `>>> bow_search = modsel . GridSearchCV ( LogisticRegression (), cv = 5 , ... param_grid = param_grid_ )` >>> bow_search . fit ( X_tr_bow , y_tr ) `# Tune classifier for L2-normalized word vector` >>> l2_search = modsel . GridSearchCV ( LogisticRegression (), cv = 5 , `... param_grid = param_grid_ )` >>> l2_search . fit ( X_tr_l2 , y_tr ) `# Tune classifier for tf-idf` >>> tfidf_search = modsel . GridSearchCV ( LogisticRegression (), cv = 5 , `... param_grid = param_grid_ )` >>> tfidf_search . fit ( X_tr_tfidf , y_tr ) `# Let's check out one of the grid search outputs to see how it went` >>> bow_search . cv_results_ `{'mean_fit_time': array([ 0.43648252, 0.94630651,` 5.64090128, 15.31248307, 31.47010217, 42.44257565]), `'mean_score_time': array([ 0.00080056, 0.00392466, 0.00864897, 0 .00784755,` 0.01192751, 0.0072515 ]), `'mean_test_score': array([ 0.57897075, 0.7518111 , 0.78283898, 0.77381766,` 0.75515992, 0.73937261]), `'mean_train_score': array([ 0.5792185 , 0.76731652, 0.87697341, 0.94629064,` 0.98357195, 0.99441294]), `'param_C': masked_array(data = [1e-05 0.001 0.1 1.0 10.0 100.0],` mask = [False False False False False False], `fill_value = ?),` 'params': ({'C': 1e-05}, `{'C': 0.001},` {'C': 0.1}, `{'C': 1.0},` {'C': 10.0}, `{'C': 100.0}),` 'rank_test_score': array([6, 4, 1, 2, 3, 5]), `'split0_test_score': array([ 0.58028698, 0.75025624, 0.7799795 , 0.7726341 ,` 0.75247694, 0.74086095]), `'split0_train_score': array([ 0.57923964, 0.76860316, 0.87560871, 0.94434003,` 0.9819308 , 0.99470312]), `'split1_test_score': array([ 0.5786776 , 0.74628396, 0.77669571, 0.76627371,` 0 .74867589, 0.73176149]), `'split1_train_score': array([ 0.57917218, 0.7684849 , 0.87945837, 0.94822946,` 0.98504976, 0.99538678]), `'split2_test_score': array([ 0.57816504, 0.75533914, 0.78472578, 0.76832394,` 0.74799248, 0.7356911 ]), `'split2_train_score': array([ 0.57977019, 0.76613558, 0.87689548, 0.94566657,` 0.98368288, 0.99397719]), `'split3_test_score': array([ 0.57894737, 0.75051265, 0.78332194, 0.77682843,` 0.75768968, 0.73855092]), `'split3_train_score': array([ 0.57914745, 0.76678626, 0.87634546, 0.94558346,` 0.98385443, 0.99474628]), `'split4_test_score': array([ 0.57877649, 0.75666439, 0.78947368, 0.78503076,` 0.76896787, 0.75 ]), `'split4_train_score': array([ 0.57876303, 0.7665727 , 0.87655903, 0.94763369,` 0.98334188, 0.99325132]), `'std_fit_time': array([ 0.03874582, 0.02297261, 1.18862097, 1.83901079,` 4.21516797, 2.93444269]), `'std_score_time': array([ 0.00160112, 0.00605009, 0.00623053, 0.00698687,` 0.00713112, 0.00570195]), `'std_test_score': array([ 0.00070799, 0.00375907, 0.00432957, 0.00668246,` 0.00612049]), `'std_train_score': array([ 0.00032232, 0.00102466, 0.00131222, 0.00143229,` 0.00100223, 0.00073252])} `# Plot the cross validation results in a box-and-whiskers plot to` # visualize and compare classifier performance `>>> search_results = pd . DataFrame . from_dict ({` ... 'bow' : bow_search . cv_results_ [ 'mean_test_score' ], `... 'tfidf' : tfidf_search . cv_results_ [ 'mean_test_score' ],` ... 'l2' : l2_search . cv_results_ [ 'mean_test_score' ] `... })` # Our usual matplotlib incantations. Seaborn is used here to make `# the plot pretty.` >>> import matplotlib.pyplot as plt `>>> import seaborn as sns` >>> sns . set_style ( "whitegrid" ) `>>> ax = sns . boxplot ( data = search_results , width = 0.4 )` >>> ax . set_ylabel ( 'Accuracy' , size = 14 ) `>>> ax . tick_params ( labelsize = 14 )`
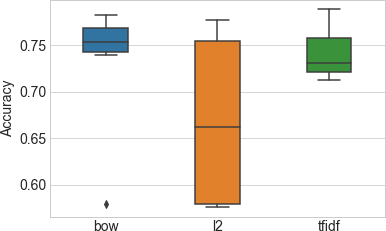
表 4-2 展示了每个超参数设置下的平均交叉验证分类准确率。每列中的星号表示该特征集达到的最高准确率。
| 正则化参数 | 词袋(BoW) | \(\ell_2\) 归一化 | Tf-idf |
|---|---|---|---|
| 0.00001 | 0.578971 | 0.575724 | 0.721638 |
| 0.001 | 0.751811 | 0.575724 | 0.788648 * |
| 0.1 | 0.782839 * | 0.589120 | 0.763566 |
| 1 | 0.773818 | 0.734247 | 0.741150 |
| 10 | 0.755160 | 0.776756 * | 0.721467 |
| 100 | 0.739373 | 0.761106 | 0.712309 |
图 4-4 中 \(\ell_2\) 归一化特征的结果看起来糟糕得吓人。但别被骗了。那些低准确率数值源于非常糟糕的正则化参数设置——这具体证明了次优的超参数会导致非常错误的结论。如果我们像示例 4-6那样,用每组特征集的最佳超参数设置来训练模型,不同特征集的准确率就非常接近了。
示例 4-6:比较不同特征集的最终训练与测试步骤
`# Train a final model on the entire training set, using the best hyperparameter` # settings found previously. Measure accuracy on the test set. `>>> m1 = simple_logistic_classify ( X_tr_bow , y_tr , X_te_bow , y_te , 'bow' , ... _C = bow_search . best_params_ [ 'C' ])` >>> m2 = simple_logistic_classify ( X_tr_l2 , y_tr , X_te_l2 , y_te , 'l2-normalized' , ... _C = l2_search . best_params_ [ 'C' ]) `>>> m3 = simple_logistic_classify ( X_tr_tfidf , y_tr , X_te_tfidf , y_te , 'tf-idf' , ... _C = tfidf_search . best_params_ [ 'C' ])` Test score with bow features: 0.78360708021 `Test score with l2-normalized features: 0.780178599904` Test score with tf-idf features: 0.788470738319 ``
恰当的调优提高了所有特征集的准确率,三个特征集在正则化逻辑回归下现在都产生相近的分类准确率。tf-idf 模型的准确率略高,但差异很可能在统计上不显著。这些结果完全令人费解。如果特征缩放并不比朴素词袋更好,那为什么还要做呢?如果 tf-idf 什么也没改变,为什么大家还这么大张旗鼓?我们将在下一节探讨这些问题的答案。
深入剖析:到底发生了什么?
要理解结果背后的"为什么",我们必须看看模型是如何使用这些特征的。对于逻辑回归这样的线性模型,这是通过一个叫做数据矩阵(data matrix)的中间对象发生的。
数据矩阵包含以定长扁平向量表示的数据点。对于词袋向量,数据矩阵也叫文档-词项矩阵(document-term matrix)。图 3-1 以向量形式展示了一个词袋向量,图 4-1 在特征空间中展示了四个词袋向量。要形成文档-词项矩阵,只需把文档向量展平,然后一个叠一个堆起来。列表示词汇表中所有可能的词(见图 4-5)。由于大多数文档只包含全部可能词的一小部分子集,矩阵中的大部分条目都是零;它是一个稀疏(sparse)矩阵。
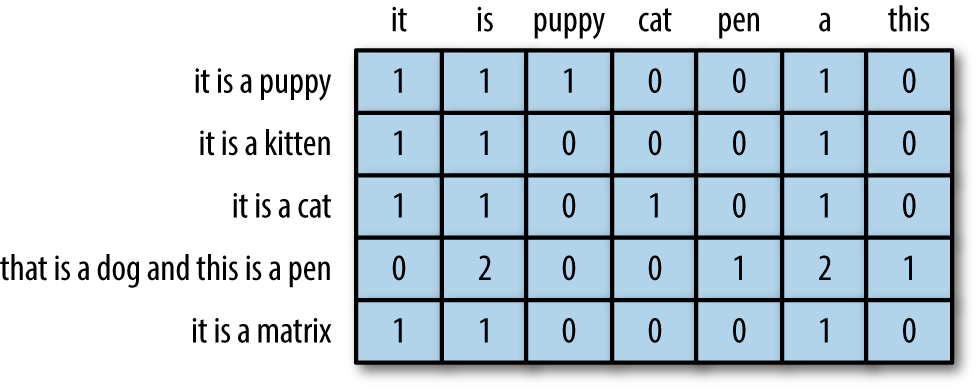
特征缩放方法本质上是对数据矩阵的列操作。具体来说,tf-idf 和 \(\ell_2\) 归一化都是把整列(例如一个 n 元语法特征)乘以一个常数。
Tf-Idf = 列缩放
Tf-idf 和 \(\ell_2\) 归一化都是对数据矩阵的列操作。
如附录 A所讨论的,训练线性分类器归根结底是寻找特征的最佳线性组合——特征就是数据矩阵的列向量。解空间由数据矩阵的列空间(column space)和零空间(null space)刻画。训练出的线性分类器的质量直接取决于数据矩阵的零空间和列空间。列空间大意味着特征之间的线性依赖少,这通常是好事。零空间包含那些无法表示为现有数据线性组合的"新颖"数据点;零空间太大可能是个问题。(想复习线性决策面、特征分解、矩阵基本子空间等概念的读者,强烈推荐翻阅附录 A。)
列缩放操作如何影响数据矩阵的列空间和零空间?答案是"影响不大"。但 tf-idf 和 \(\ell_2\) 归一化之间仍可能有一点差别。我们现在来看看为什么。
数据矩阵的零空间可能很大,原因有二。第一,许多数据集包含彼此非常相似的数据点,这意味着有效行空间相对于数据集中的数据点数量来说很小。第二,特征数量可能远大于数据点数量。词袋尤其擅长制造巨大的特征空间。在我们的 Yelp 例子中,训练集有 29K 条评论、47K 个特征。此外,不同词的数量通常随数据集中的文档数增长,所以增加更多文档不一定能降低特征与数据之比或缩小零空间。
对于词袋,列空间相对于特征数量来说比较小。可能存在一些词,在同一批文档中出现次数大致相同,这会导致对应的列向量近似线性相关,从而使列空间达不到它本应达到的满秩(full rank)。(满秩的定义见附录 A。)这被称为秩亏(rank deficiency)。(就像动物可能缺乏维生素和矿物质一样,矩阵也可能缺乏秩,输出空间就不会像应有的那样"丰满"。)
行空间和列空间的秩亏会导致模型对问题过度配置。线性模型为数据集中的每个特征配备一个权重参数。如果行空间和列空间是满秩的 [1],模型就能让我们生成输出空间中的任意目标向量。当它们秩亏时,模型拥有的自由度超出所需,这使解决方案更难确定。
特征缩放能解决数据矩阵的秩亏问题吗?让我们看一看。
列空间定义为所有列向量的线性组合(粗体表示向量):\(a_1 \mathbf{v}_1 + a_2 \mathbf{v}_2 + \dots + a_n \mathbf{v}_n\)。特征缩放把某个列向量替换为其常数倍,比如 \(\tilde{\mathbf{v}}_1 = c\mathbf{v}_1\)。但我们仍然可以通过把 \(a_1\) 换成 \(\tilde{a}_1 = a_1 / c\) 来生成原来的线性组合。看起来特征缩放并不改变列空间的秩。类似地,特征缩放也不影响零空间的秩,因为可以对权重向量中对应的条目做反向缩放来抵消被缩放的特性列。
然而,照例有一个陷阱。如果缩放因子是 0,就无从恢复原来的线性组合;\(\mathbf{v}_1\) 消失了。如果该向量与所有其他列线性无关,那么我们实际上缩小了列空间、扩大了零空间。
如果该向量与目标输出不相关,那么这实际上是在修剪掉噪声信号,这是好事。事实证明,这正是 tf-idf 与 \(\ell_2\) 归一化之间的关键区别。\(\ell_2\) 归一化永远不会算出零范数——除非向量全为零。如果向量接近零,它的范数也接近零。除以小范数会放大向量,使它变得更长。
另一方面,tf-idf 可以产生接近零的缩放因子,如图 4-2所示。当某个词出现在训练集中大量文档里时就会发生这种情况。这样的词很可能与目标向量没有强相关。把它修剪掉,求解器就能专注于列空间中的其他方向,找到更好的解(尽管准确率的提升可能不会很大,因为通常可以用这种方式修剪的噪声方向并不多)。
特征缩放——无论是 \(\ell_2\) 还是 tf-idf——真正有明显效果的地方是求解器的收敛速度。这是数据矩阵的条件数(condition number)现在小得多的标志(条件数是最大奇异值与最小奇异值之比——这些术语的完整讨论见附录 A)。事实上,\(\ell_2\) 归一化使条件数接近 1。但并不是条件数越好解就越好。在本实验中,\(\ell_2\) 归一化比词袋和 tf-idf 收敛都快得多,但它也更容易过拟合:它需要多得多的正则化,而且对优化过程中的迭代次数更敏感。
小结
在本章中,我们以 tf-idf 为切入点,详细分析了特征变换如何(或不如何)影响模型。Tf-idf 是特征缩放的一个例子,因此我们把它的表现与另一种特征缩放方法——\(\ell_2\) 归一化——做了对比。
结果并不像人们可能预期的那样。Tf-idf 和 \(\ell_2\) 归一化并没有把最终分类器的准确率提升到超过朴素词袋。掌握了统计建模和线性代数的功力之后,我们明白了原因:两者都没有改变数据矩阵的列空间。
两者之间有一个小差别:tf-idf 既能"拉伸"词频,也能"压缩"它。换句话说,它让一些计数变大,让另一些接近零。因此,tf-idf 可以彻底消除无信息量的词。
在这个过程中,我们还发现了特征缩放的另一个效果:它改善数据矩阵的条件数,使线性模型的训练快得多。\(\ell_2\) 归一化和 tf-idf 都有这个效果。
总而言之,教训是:正确的特征缩放对分类是有帮助的。正确的缩放突出有信息量的词、降低常见词的权重,还能改善数据矩阵的条件数。但正确的缩放未必是统一的列缩放。
这个故事绝妙地说明了在一般情况下分析特征工程效果的难度。改变特征会影响训练过程和随之而来的模型。线性模型是最容易理解的模型,然而要厘清理论和实践上的影响,仍然需要非常严谨的实验方法和大量深入的数学知识。对于更复杂的模型或特征变换,这基本上是不可能的。
参考文献
Zheng, Alice. Evaluating Machine Learning Models. Sebastopol, CA: O’Reilly Media, 2015.
[1] 严格来说,矩形矩阵的行空间和列空间不可能同时满秩。两个子空间的最大秩是 \(m\)(行数)和 \(n\)(列数)中较小者。