文本数据:展平、过滤与分块
如果你正在设计一个算法来分析下面这段文本,你会怎么做?
Emma knocked on the door. No answer. She knocked again and waited. There was a large maple tree next to the house. Emma looked up the tree and saw a giant raven perched at the treetop. Under the afternoon sun, the raven gleamed magnificently. Its beak was hard and pointed, its claws sharp and strong. It looked regal and imposing. It reigned the tree it stood on. The raven was looking straight at Emma with its beady black eyes. Emma felt slightly intimidated. She took a step back from the door and tentatively said, “Hello?”
(原文为英文数据样本,保留原文以便后续章节引用其中的词频统计。)
这段文字包含大量信息。我们知道它涉及一个名叫 Emma 的人和一只乌鸦(raven)。有一栋房子和一棵树,Emma 想进屋,却先看到了乌鸦。乌鸦气宇轩昂,也注意到了 Emma——她有点害怕,但仍在尝试沟通。
那么,这堆信息中哪些部分是我们应该提取的显著特征(salient feature)呢?首先,提取主角的名字——Emma 和乌鸦——似乎是个好主意。其次,记录下场景——房子、门和树——可能也不错。那对乌鸦的描述呢?Emma 的动作——敲门、后退一步、打招呼——又如何?
本章介绍文本特征工程的基础。我们从词袋(bag-of-words)开始,它是基于词频统计的最简单表示。一个与之密切相关的变换是 tf-idf(词频-逆文档频率,term frequency-inverse document frequency),它本质上是一种特征缩放(feature scaling)技术。本书为它单开一章(下一章)进行完整讨论。本章先讲文本抽取特征,再深入探讨如何过滤和清洗这些特征。
Bag-of-X:把自然文本变成扁平向量
无论是构建机器学习模型还是做特征工程,结果简单、可解释(interpretable)总是令人愉快的事。简单的东西容易尝试,可解释的特征和模型比复杂的更容易调试。简单可解释的特征并不总能带来最准确的模型,但先简单起步、只在绝对必要时才增加复杂度,是个好主意。
对于文本数据,我们可以从一组词频统计开始,这就是词袋。一组词频统计并不会特意去寻找有趣的实体,比如 Emma 或乌鸦。但这两个词在我们的示例段落中被反复提及,它们的计数高于像 “hello” 这样的随机词。对于文档分类这样的简单任务,词频统计往往就足够了。这种技术也可以用于信息检索(information retrieval)——目标是检索与输入文本查询相关的文档集合。这两类任务用词级特征都表现良好,因为某些词的出现与否是文档主题内容的重要指示器。
词袋(Bag-of-Words)
在词袋(BoW)特征化中,一个文本文档被转换成一个计数向量。(向量(vector)不过是一组 \(n\) 个数字。)向量中词汇表(vocabulary)里的每个可能的词都有一个对应项。如果某个词——比如 “aardvark”——在文档中出现了三次,那么特征向量中对应位置上的计数就是 3。如果词汇表中的某个词没有出现在文档中,那它得到计数 0。例如,文本 “it is a puppy and it is extremely cute” 的词袋表示如 图 3-1 所示。
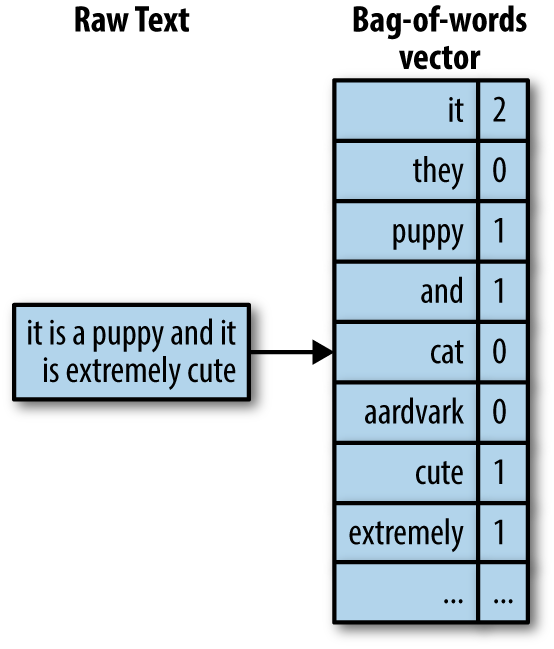
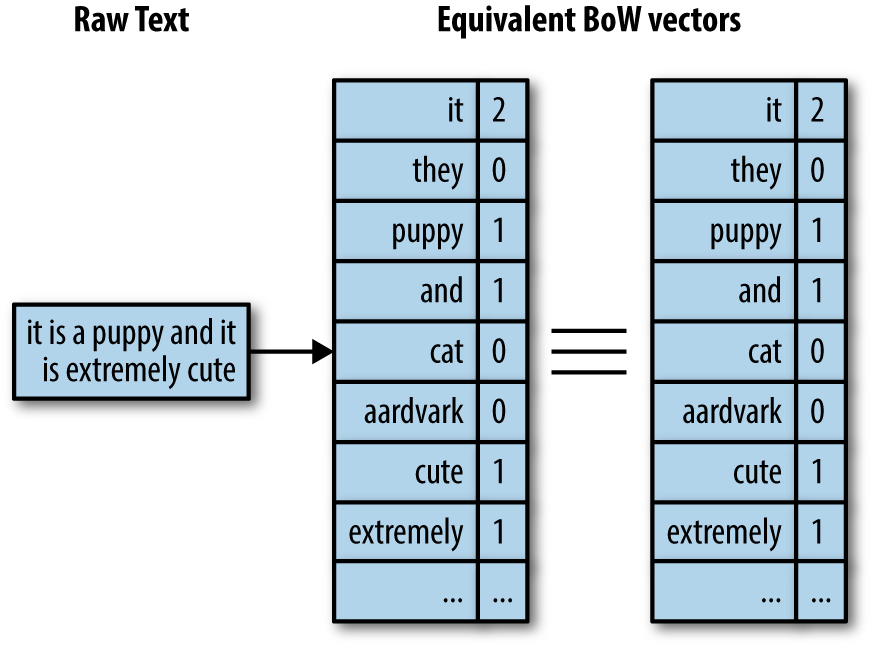
词袋把文本文档转换成一个扁平向量(flat vector)。说它"扁平",是因为它不含任何原始的文本结构。原始文本是词的序列。但词袋没有序列概念;它只记住每个词在文本中出现了多少次。因此,如 图 3-2 所示,只要对数据集中的所有文档保持一致,向量中词的顺序并不重要。词袋也不表达任何词层次的概念。例如,“animal” 这个概念包含 “dog”、“cat”、“raven” 等词。但在词袋表示中,这些词都是向量的平等元素。
这里重要的是数据在特征空间(feature space)中的几何形态。在词袋向量中,每个词成为向量的一个维度。如果词汇表有 \(n\) 个词,那么一个文档就成为 \(n\) 维空间中的一个点 [1]。我们很难想象两三维以上空间的几何形态,所以只能靠想象力。图 3-3 展示了示例句子在 “puppy” 和 “cute” 两个词对应的二维特征空间中的样子。
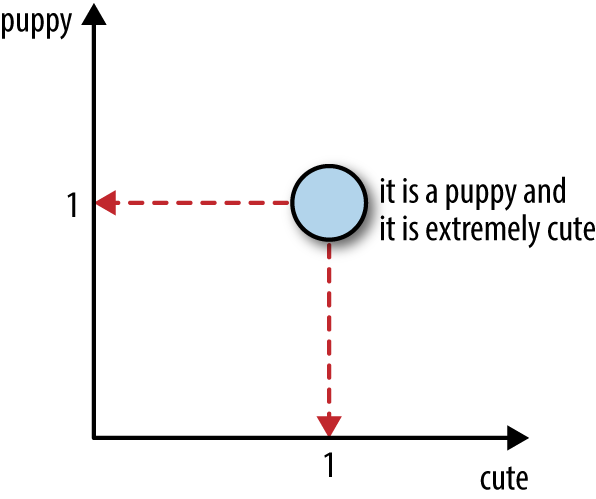
图 3-4 展示了三个句子在 “puppy”、“extremely” 和 “cute” 三个词对应的三维空间中的样子。
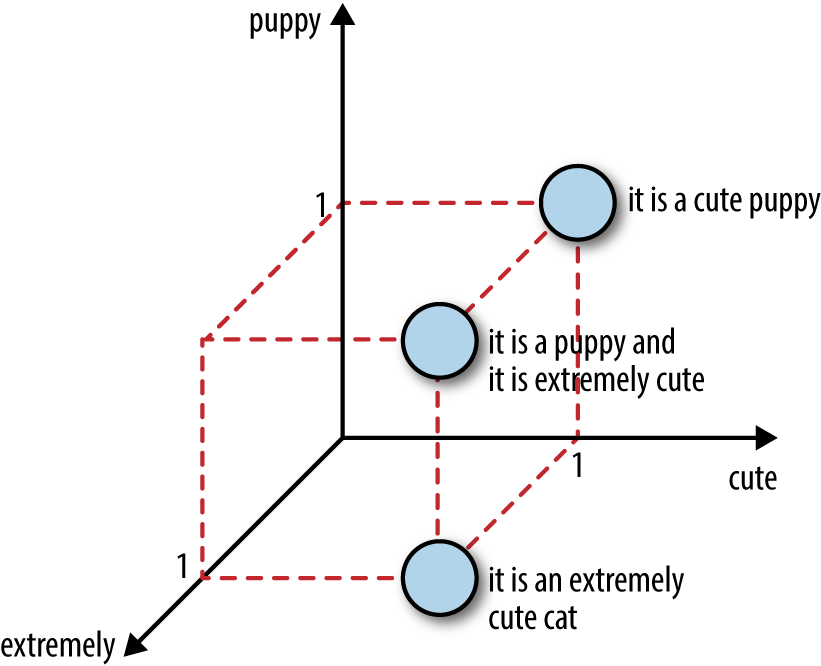
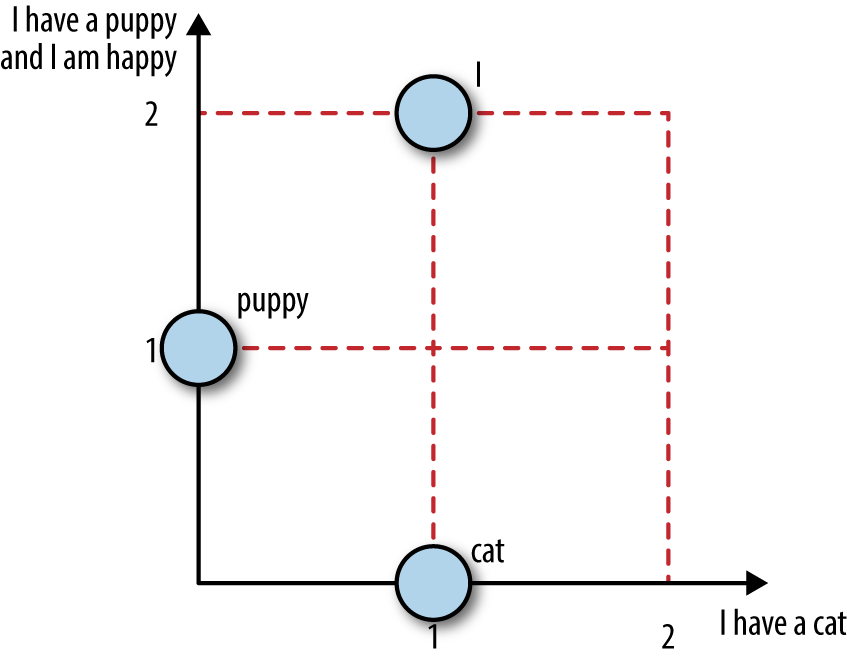
这两张图都描绘了特征空间中的数据向量。坐标轴表示单个的词——也就是词袋表示中的特征,空间中的点表示数据点(文本文档)。有时在数据空间中观察特征向量也很有信息量。特征向量包含该特征在每个数据点中的取值。此时坐标轴表示单个数据点,点表示特征向量。图 3-5 给出了一个例子。对于文本数据的词袋特征化,一个特征就是一个词,特征向量包含该词在每个文档中的计数。这样,一个词就被表示成"文档袋"。我们将在第 4 章看到,这些文档袋向量来自词袋向量的矩阵转置。
词袋并不完美。把句子拆成单个词可能破坏语义。例如,“not bad” 在语义上等于 “decent” 甚至 “good”(尤其对英国人而言)。但 “not” 和 “bad” 只是漂浮的否定加一个负面情绪词。“toy dog” 和 “dog toy” 可能是完全不同的东西(除非是玩具狗的狗玩具),而拆成孤零零的 “toy” 和 “dog” 后,含义就丢失了。这样的例子很容易举出一大堆。我们接下来要讲的 n 元语法词袋缓解了一部分问题,但并非根本性的修复。要记住,词袋是一种简单实用的启发式方法,但远非对文本的正确语义理解。
n 元语法词袋(Bag-of-n-Grams)
n 元语法词袋(Bag-of-n-Grams)是词袋的自然延伸。n 元语法(n-gram)是 \(n\) 个词元(token)组成的序列。一个词本质上就是 1-gram,也叫一元语法(unigram)。分词之后,计数机制既可以把单个词元汇总成词频,也可以把重叠的序列按 n 元语法计数。例如,句子 “Emma knocked on the door” 会生成 n 元语法 “Emma knocked”、“knocked on”、“on the” 和 “the door”。
n 元语法保留了更多原始文本的序列结构,因此 n 元语法词袋表示的信息量可能更大。然而,这是有代价的。理论上,若有 \(k\) 个不同的词,就可能有 \(k^2\) 个不同的 2-gram(也叫二元语法,bigram)。实际上远没有这么多,因为并非每个词都能跟在其他任意词后面。尽管如此,不同的 n 元语法(\(n > 1\))通常还是比词多得多。这意味着 n 元语法词袋是一个更大、更稀疏的特征空间,也意味着 n 元语法在计算、存储和建模上更昂贵。\(n\) 越大,信息越丰富,代价也越大。
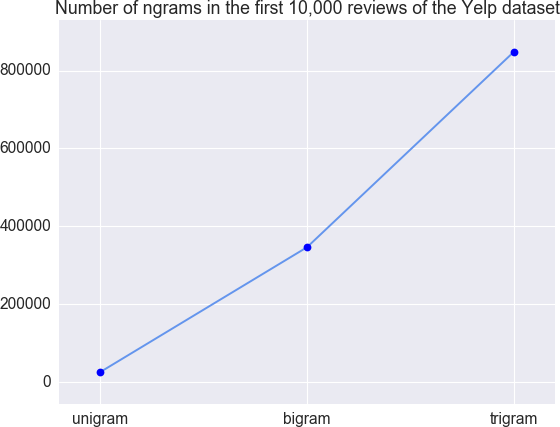
为了说明 n 元语法的数量如何随 \(n\) 增大而增长(见 图 3-6),我们在 Yelp 评论数据集 上计算 n 元语法。示例 3-1 中,我们用 Pandas 和 scikit-learn 中的 CountVectorizer 变换器计算前 10,000 条评论的 n 元语法。
示例 3-1:计算 n 元语法
`>>> import pandas` >>> import json `>>> from sklearn.feature_extraction.text import CountVectorizer` # Load the first 10,000 reviews `>>> f = open ( 'data/yelp/v6/yelp_academic_dataset_review.json' )` >>> js = [] `>>> for i in range ( 10000 ):` ... js . append ( json . loads ( f . readline ())) `>>> f . close ()` >>> review_df = pd . DataFrame ( js ) `# Create feature transformers for unigrams, bigrams, and trigrams.` # The default ignores single-character words, which is useful in practice because `# it trims uninformative words, but we explicitly include them in this example for` # illustration purposes. `>>> bow_converter = CountVectorizer ( token_pattern = '(?u) \\ b \\ w+ \\ b' )` >>> bigram_converter = CountVectorizer ( ngram_range = ( 2 , 2 ), ... token_pattern = '(?u) \\ b \\ w+ \\ b' ) `>>> trigram_converter = CountVectorizer ( ngram_range = ( 3 , 3 ), ... token_pattern = '(?u) \\ b \\ w+ \\ b' )` # Fit the transformers and look at vocabulary size `>>> bow_converter . fit ( review_df [ 'text' ])` >>> words = bow_converter . get_feature_names () `>>> bigram_converter . fit ( review_df [ 'text' ])` >>> bigrams = bigram_converter . get_feature_names () `>>> trigram_converter . fit ( review_df [ 'text' ])` >>> trigrams = trigram_converter . get_feature_names () `>>> print ( len ( words ), len ( bigrams ), len ( trigrams ))` 26047 346301 847545 `# Sneak a peek at the n-grams themselves` >>> words [: 10 ] `['0', '00', '000', '0002', '00am', '00ish', '00pm', '01', '01am', '02']` >>> bigrams [ - 10 :] `['zucchinis at',` 'zucchinis took', `'zucchinis we',` 'zuma over', `'zuppa di',` 'zuppa toscana', `'zuppe di',` 'zurich and', `'zz top',` 'à la'] `>>> trigrams [: 10 ]` ['0 10 definitely', `'0 2 also',` '0 25 per', `'0 3 miles',` '0 30 a', `'0 30 everything',` '0 30 lb', `'0 35 tip',` '0 5 curry', `'0 5 pork']`
过滤出更干净的特征
对于词,我们如何干净利落地把信号从噪声中分离出来?通过过滤(filtering),那些用原始分词和计数生成简单词表或 n 元语法表的技术变得更可用。我们接下来要讨论的短语检测,可以看作一种特殊的二元语法过滤。下面还有几种过滤方式。
停用词(Stopwords)
分类和检索通常不需要对文本的深入理解。例如,在句子 “Emma knocked on the door” 中,“on” 和 “the” 并不改变这句话是关于一个人和一扇门这一事实。对于分类这样的粗粒度任务,代词、冠词和介词可能价值不大。但在情感分析(sentiment analysis)中情况可能完全不同,它需要对语义的细粒度理解。
流行的 Python NLP 包 NLTK 包含语言学家为多种语言定义的停用词(stopword)表。(你需要安装 NLTK 并运行 nltk.download() 才能拿到全部好东西。)网上也能找到各种停用词表。例如,下面是英文停用词表中的一些示例词:
a, about, above, am, an, been, didn't, couldn't, i'd, i'll, itself, let's, myself,
our, they, through, when's, whom, ...
注意这张表包含撇号,而且词都没有大写。要原样使用它,分词过程不能吃掉撇号,词也需要转成小写。
基于频率的过滤
停用词表是剔除那些只会产生空洞特征的常见词的一种方式。还有其他更偏统计的方法来把握"常见词"这个概念。在搭配提取中,我们既能看到依赖人工定义的方法,也能看到使用统计的方法。同样的思路也适用于词过滤。我们在这里同样可以使用频率统计。
高频词
频率统计非常适合过滤掉语料库特有的常见词以及通用停用词。例如,短语 “New York Times” 及其中的每个词在纽约时报标注语料库数据集中都频繁出现。类似地,在加拿大议会辩论的 Hansard 语料库中,“house” 一词常出现在短语 “House of Commons” 里——这个数据集因包含所有文档的英文和法文版本,常用于统计机器翻译。这些词在一般情况下是有意义的,但在那些特定语料库中并非如此。典型的停用词表能抓住通用停用词,但抓不住语料库特有的词。
查看最高频的词可以暴露解析问题,并凸显那些碰巧在语料库中出现次数过多的、平时很有用的词。例如,表 3-1 列出了 Yelp 评论数据集中出现频率最高的 40 个词。这里频率基于它们出现的文档(评论)数量,而不是在单个文档中的计数。可以看到,表中包含很多停用词,也有一些意外。“s” 和 “t” 上榜是因为我们用了撇号作为分词分隔符(delimiter),像 “Mary’s” 或 “didn’t” 这样的词被解析成了 “Mary s” 和 “didn t”。此外,“good”、“food”、“great” 各出现在约三分之一的评论中,但我们可能想把它们留下,因为它们对情感分析或商家分类等任务非常有用。
| 排名 | 单词 | 文档频率 | 排名 | 单词 | 文档频率 |
|---|---|---|---|---|---|
| 1 | the | 1416058 | 21 | t | 684049 |
| 2 | and | 1381324 | 22 | not | 649824 |
| 3 | a | 1263126 | 23 | s | 626764 |
| 4 | i | 1230214 | 24 | had | 620284 |
| 5 | to | 1196238 | 25 | so | 608061 |
| 6 | it | 1027835 | 26 | place | 601918 |
| 7 | of | 1025638 | 27 | good | 598393 |
| 8 | for | 993430 | 28 | at | 596317 |
| 9 | is | 988547 | 29 | are | 585548 |
| 10 | in | 961518 | 30 | food | 562332 |
| 11 | was | 929703 | 31 | be | 543588 |
| 12 | this | 844824 | 32 | we | 537133 |
| 13 | but | 822313 | 33 | great | 520634 |
| 14 | my | 786595 | 34 | were | 516685 |
| 15 | that | 777045 | 35 | there | 510897 |
| 16 | with | 775044 | 36 | here | 481542 |
| 17 | on | 735419 | 37 | all | 478490 |
| 18 | they | 720994 | 38 | if | 475175 |
| 19 | you | 701015 | 39 | very | 460796 |
| 20 | have | 692749 | 40 | out | 460452 |
实践中,把基于频率的过滤与停用词表结合使用很有帮助。还有一个棘手的问题:截断点(cutoff)放在哪里。遗憾的是没有放之四海而皆准的答案。大多数时候截断点需要人工确定,而且数据集变化时可能需要重新审视。
罕见词
取决于具体任务,有时还需要过滤掉罕见词。这些词可能是真正生僻的词,也可能是常见词的拼写错误。对统计模型来说,只出现在一两篇文档中的词更像噪声而不是有用信息。例如,假设任务是依据 Yelp 评论对商家分类,而某条评论里出现了 “gobbledygook” 这个词。仅凭这一个词,怎么能判断这家商家是餐厅、美容院还是酒吧?即使我们知道这个例子里的商家恰好是酒吧,对其他包含 “gobbledygook” 的评论也这样分类,很可能是错误的。
罕见词不仅作为预测变量不可靠,还会带来计算开销。160 万条 Yelp 评论中共有 357,481 个不同的词(按空格和标点字符分词),其中 189,915 个只出现在一篇评论中,41,162 个出现在两篇评论中。超过 60% 的词汇是罕见词。这就是所谓的重尾分布(heavy-tailed distribution),在真实世界的数据中非常常见。许多统计机器学习模型的训练时间随特征数量线性增长,有些模型是二次方甚至更糟。罕见词付出了巨大的计算和存储成本,却没有多少额外收益。
基于词频统计可以轻松识别并修剪罕见词。或者,可以把它们的计数聚合到一个特殊的垃圾箱(garbage bin)里,作为额外的特征。图 3-7 在一个短文档上演示了这种表示:文档包含一堆常见词和两个罕见词 “gobbledygook” 和 “zylophant”。常见词保留各自的计数,可以进一步用停用词表或其他基于频率的方法过滤。罕见词则失去身份,被归并进一个垃圾箱特征。
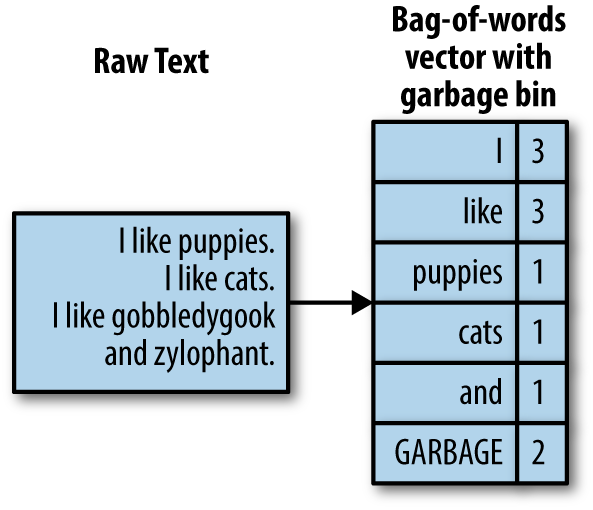
由于只有统计完整个语料库之后才能知道哪些词是罕见的,垃圾箱特征需要在后处理步骤中收集。
由于本书讲的是特征工程,我们的重点是特征。但罕见这个概念同样适用于数据点。如果一篇文本文档非常短,它很可能不含任何有用信息,训练模型时不应该使用。不过应用这条规则必须谨慎。Wikipedia 数据转储包含许多不完整的存根页面,过滤掉它们大概没问题。而推文(tweet)天生就短,需要其他特征化和建模技巧。
词干提取(Stemming)
简单解析的一个问题是:同一个词的不同变体会被计成不同的词。例如,“flower” 和 “flowers” 严格来说是不同的词元,“swimmer”、“swimming” 和 “swim” 也是如此,尽管它们的意思非常接近。如果所有这些不同变体都能映射到同一个词,那就好了。
词干提取(stemming)是一项 NLP 任务,它试图把每个词砍到最基本的语言学词干形式。有不同的方法,有些基于语言学规则,有些基于观察到的统计。其中一类算法把词性标注(part-of-speech tagging)和语言学规则结合到一个被称为词形还原(lemmatization)的过程中。
大多数词干提取工具专注于英语,不过其他语言也在持续努力中。波特词干算法(Porter stemmer)是英语中最广泛使用的免费词干提取工具。原始程序用 ANSI C 编写,但此后许多其他包对它做了封装,以便其他语言调用。
下面是通过 NLTK Python 包运行波特词干算法的例子。可以看到,它处理了大量情形,但并不完美。“goes” 被映射为 “goe”,而 “go” 映射为它自己:
`>>> import nltk` >>> stemmer = nltk . stem . porter . PorterStemmer () `>>> stemmer . stem ( 'flowers' )` u'flower' `>>> stemmer . stem ( 'zeroes' )` u'zero' `>>> stemmer . stem ( 'stemmer' )` u'stem' `>>> stemmer . stem ( 'sixties' )` u'sixti' `>>> stemmer . stem ( 'sixty' )` u'sixty' `>>> stemmer . stem ( 'goes' )` u'goe' `>>> stemmer . stem ( 'go' )` u'go'
词干提取确实有计算成本。最终收益是否超过成本取决于应用场景。还值得注意的是,词干提取可能弊大于利。“new” 和 “news” 意思差别很大,但两者都会被提取词干为 “new”。类似的例子比比皆是。因此,词干提取并非总被使用。
意义的原子:从词到 n 元语法再到短语
词袋的概念直截了当。但计算机怎么知道什么是词?文本文档在数字上表示为一个字符串(string),本质上就是字符序列。人们也可能遇到 JSON 块或 HTML 页面形式的半结构化文本。但即使加上标签和结构,基本单元仍然是字符串。如何把字符串变成词的序列?这涉及解析(parsing)和分词(tokenization)这两项任务,我们接下来讨论。
解析与分词
当字符串包含的不只是纯文本时,解析就是必要的。例如,如果原始数据是网页、电子邮件或某种日志,那么它包含额外的结构。需要决定如何处理标记、页眉页脚,或日志中无趣的部分。如果文档是网页,解析器需要处理 URL。如果是电子邮件,From、To 和 Subject 之类的字段可能需要特殊处理——否则这些头部最终会变成普通词进入最终计数,而这可能没什么用。
轻度解析之后,文档的纯文本部分可以进入分词环节。分词把字符串——字符序列——变成词元序列。每个词元随后可以按词计数。分词器需要知道哪些字符表示一个词元结束、另一个开始。空格字符通常是很好的分隔符,标点字符也是。如果文本包含推文,那么井号(#)不应作为分隔符(也叫定界符,delimiter)。
有时分析需要在句子层面而不是整个文档上进行。例如,n 元语法——词概念的推广——不应跨越句子边界。像 word2vec 这样更复杂的文本特征化方法也在句子或段落上工作。在这些情况下,需要先把文档解析成句子,再把每个句子进一步分词成词。
字符串对象:不止表面那么简单
字符串对象有各种编码,如 ASCII 或 Unicode。纯英文文本可以用 ASCII 编码。大多数其他语言需要 Unicode。如果文档包含非 ASCII 字符,要确保分词器能处理该特定编码,否则结果会不正确。
用于短语检测的搭配提取
词元序列直接产生词表和 n 元语法表。但从语义上讲,我们更习惯理解短语而不是 n 元语法。在计算自然语言处理(natural language processing,NLP)中,有用短语的概念被称为搭配(collocation)。用 Manning 和 Schütze(1999: 151)的话说:“搭配是由两个或更多词组成的表达式,对应某种约定俗成的说法。”
搭配比其组成部分之和更有意义。例如,“strong tea” 的含义超出了"强健的体力"和"茶";因此它被视为搭配。而 “cute puppy” 恰恰就是其组成部分之和:“cute” 加 “puppy”。因此它不算搭配。
搭配不一定是连续的序列。例如,句子 “Emma knocked on the door” 被认为包含搭配 “knock door”。因此,并非每个搭配都是 n 元语法。反过来,也并非每个 n 元语法都被视为有意义的搭配。
因为搭配大于其部分之和,单个词的计数无法充分捕捉它们的含义。词袋这种表示力有未逮。n 元语法词袋也有问题:它捕捉了太多无意义的序列(想想 n 元语法词袋例子里的 “this is”),而有意义的序列(如 “knock door”)又不够多。
搭配作为特征很有用。但如何从文本中发现并提取它们?一种方式是预先定义。如果我们非常努力,大概能找到各种语言的习语大全,然后在文本中逐一查找匹配。这会非常昂贵,但确实可行。如果语料库领域性很强、包含生僻行话,这可能就是首选方法。但这样的清单需要大量人工维护,而且要随语料库的演化不断更新。例如,用它来分析推文,或博客和文章,大概不太现实。
自过去二十年间统计 NLP 兴起以来,人们越来越倾向于用统计方法寻找短语。统计搭配提取方法不建立固定的短语和习语清单,而是依靠不断演化的数据来揭示当下的流行说法。
基于频率的方法
一个简单的取巧办法是看出现频率最高的 n 元语法。这种方法的问题在于:出现频率最高的未必是最有用的。表 3-2 展示了整个 Yelp 评论数据集中最流行的二元语法(\(n = 2\))。可以看到,按文档计数排前 10 的二元语法都是非常泛化的词,没什么含义。
| 二元语法 | 文档计数 |
|---|---|
| of the | 450,849 |
| and the | 426,346 |
| in the | 397,821 |
| it was | 396,713 |
| this place | 344,800 |
| it s | 341,090 |
| and i | 332,415 |
| on the | 325,044 |
| i was | 285,012 |
| for the | 276,946 |
搭配提取的假设检验
原始流行度计数这个度量太粗糙了。我们必须找到更巧妙的统计量,才能轻松挑出有意义的短语。关键思路是问:两个词一起出现的频率是否高于偶然水平?回答这个问题的统计工具叫做假设检验(hypothesis test)。
假设检验是一种把噪声数据蒸馏成"是"或"否"答案的方法。它把数据建模为从随机分布中抽取的样本。随机性意味着人们永远无法 100% 确定答案;总有可能出现离群值。所以,答案都附带着一个概率。
例如,假设检验的结果可能是"这两个数据集以 95% 的概率来自同一个分布"。想温和地入门假设检验,可以看可汗学院(Khan Academy)的教程假设检验与 p 值(Hypothesis Testing and p-Values)。
在搭配提取的语境下,多年来人们提出了许多假设检验方法。其中最成功的方法之一基于似然比检验(likelihood ratio test,Dunning,1993)。对于给定的一对词,该方法在观测数据集上检验两个假设。假设 1(零假设,null hypothesis)认为词 1 与词 2 独立出现。换句话说,看到词 1 与是否也会看到词 2 无关。假设 2(备择假设,alternate hypothesis)认为看到词 1 会改变看到词 2 的可能性。我们认为备择假设意味着两个词构成常见短语。因此,用于短语检测(即搭配提取)的似然比检验问的是这样一个问题:给定文本语料库中观测到的词出现情况,更可能是由一个两个词相互独立出现的模型生成的,还是一个两个词的概率相互纠缠的模型生成的?
这话说起来拗口。让我们稍微数学化一点。(数学非常擅长精确而简洁地表达事物,但它的确需要一套与自然语言完全不同的解析器。)
我们可以把零假设 \(H_{\text{null}}\)(独立)表示为 \(P(w_2 \mid w_1) = P(w_2 \mid \text{not } w_1)\),把备择假设 \(H_{\text{alternate}}\)(不独立)表示为 \(P(w_2 \mid w_1) \neq P(w_2 \mid \text{not } w_1)\)。
最终的统计量是两者之比的(自然)对数:
\[ \log \lambda = \log \frac{L(\text{Data}; H_{\text{null}})}{L(\text{Data}; H_{\text{alternate}})} \]似然函数 \(L(\text{Data}; H)\) 表示在词对的独立或不独立模型下,看到数据集中这些词频的概率。为了计算这个概率,我们必须对数据如何生成再做一次假设。最简单的数据生成模型是二项模型(binomial model):对数据集中的每个词,我们掷一次硬币,硬币正面朝上就插入我们的特殊词,否则插入其他词。在这个策略下,特殊词出现次数的计数服从二项分布(binomial distribution)。二项分布完全由词的总数、目标词的出现次数和正面概率决定。
通过似然比检验分析来检测常见短语的算法如下:
- 计算所有单词的出现概率:\(P(w)\)。
- 计算所有不同二元语法的条件成对出现概率:\(P(w_2 \mid w_1)\)。
- 计算所有不同二元语法的似然比 \(\log \lambda\)。
- 按似然比排序二元语法。
- 取似然比值最小的二元语法作为特征。
掌握似然比检验
关键在于:检验比较的并不是概率参数本身,而是在这些参数(以及假定的数据生成模型)下看到观测数据的概率。似然(likelihood)是统计学习的核心原则之一,但头几次接触时绝对让人绞尽脑汁。一旦想通其中的逻辑,它就变得直观了。
还有另一种基于逐点互信息(pointwise mutual information)的统计方法,但它对罕见词非常敏感,而真实世界的文本语料库中总少不了罕见词。因此它不太常用,我们这里也不做演示。
注意,所有搭配提取的统计方法——无论使用原始频率、假设检验还是逐点互信息——都是通过过滤候选短语列表来运作的。生成这种列表最简单、最廉价的方式是统计 n 元语法。生成非连续序列是可能的,但计算昂贵。在实践中,即使是连续的 n 元语法,人们也很少超出二元语法或三元语法,因为即便过滤之后它们也太多了。要生成更长的短语,还有其他方法,比如分块(chunking),或与词性(part-of-speech,PoS)标注结合。
分块与词性标注
分块比寻找 n 元语法更精细一些,它使用基于规则的模型,根据词性来形成词元序列。
例如,在一个实体(这里指文本的主题)对我们最重要的问题中,我们可能最想找出所有的名词短语(noun phrase)。为此,我们给每个词标注词性,然后检查词元的邻域,寻找词性分组,也就是"块(chunk)"。把词映射到词性的模型通常与语言相关。几个开源的 Python 库——如 NLTK、spaCy 和 TextBlob——都提供了多种语言模型。
为了说明 Python 的几个库如何让基于词性标注的分块变得相当简单,我们再次使用 Yelp 评论数据集。示例 3-2 中,我们用 spaCy 和 TextBlob 评估词性以找出名词短语。
示例 3-2:词性标注与分块
`>>> import pandas as pd` >>> import json `# Load the first 10 reviews` >>> f = open ( 'data/yelp/v6/yelp_academic_dataset_review.json' ) `>>> js = []` >>> for i in range ( 10 ): `... js . append ( json . loads ( f . readline ()))` >>> f . close () `>>> review_df = pd . DataFrame ( js )` # First we'll walk through spaCy's functions `>>> import spacy` # preload the language model `>>> nlp = spacy . load ( 'en' )` # We can create a Pandas Series of spaCy nlp variables `>>> doc_df = review_df [ 'text' ] . apply ( nlp )` # spaCy gives us fine-grained parts of speech using (.pos_) `# and coarse-grained parts of speech using (.tag_)` >>> for doc in doc_df [ 4 ]: `... print ([ doc . text , doc . pos_ , doc . tag_ ])` Got VERB VBP `a DET DT` letter NOUN NN `in ADP IN` the DET DT `mail NOUN NN` last ADJ JJ `week NOUN NN` that ADJ WDT `said VERB VBD` Dr. PROPN NNP `Goldberg PROPN NNP` is VERB VBZ `moving VERB VBG` to ADP IN `Arizona PROPN NNP` to PART TO `take VERB VB` a DET DT `new ADJ JJ` position NOUN NN `there ADV RB` in ADP IN `June PROPN NNP` . PUNCT . `SPACE SP` He PRON PRP `will VERB MD` be VERB VB `missed VERB VBN` very ADV RB `much ADV RB` . PUNCT . `SPACE SP` I PRON PRP `think VERB VBP` finding VERB VBG `a DET DT` new ADJ JJ `doctor NOUN NN` in ADP IN `NYC PROPN NNP` that ADP IN `you PRON PRP` actually ADV RB `like INTJ UH` might VERB MD `almost ADV RB` be VERB VB `as ADV RB` awful ADJ JJ `as ADP IN` trying VERB VBG `to PART TO` find VERB VB `a DET DT` date NOUN NN `! PUNCT .` # spaCy also does some basic noun chunking for us `>>> print ([ chunk for chunk in doc_df [ 4 ] . noun_chunks ])` [a letter, the mail, Dr. Goldberg, Arizona, a new position, June, He, I, `a new doctor, NYC, you, a date]` ##### `# We can do the same feature transformations using Textblob` from textblob import TextBlob `# The default tagger in TextBlob uses the PatternTagger, which is OK for our example.` # You can also specify the NLTK tagger, which works better for incomplete sentences. `>>> blob_df = review_df [ 'text' ] . apply ( TextBlob )` >>> blob_df [ 4 ] . tags `[('Got', 'NNP'),` ('a', 'DT'), `('letter', 'NN'),` ('in', 'IN'), `('the', 'DT'),` ('mail', 'NN'), `('last', 'JJ'),` ('week', 'NN'), `('that', 'WDT'),` ('said', 'VBD'), `('Dr.', 'NNP'),` ('Goldberg', 'NNP'), `('is', 'VBZ'),` ('moving', 'VBG'), `('to', 'TO'),` ('Arizona', 'NNP'), `('to', 'TO'),` ('take', 'VB'), `('a', 'DT'),` ('new', 'JJ'), `('position', 'NN'),` ('there', 'RB'), `('in', 'IN'),` ('June', 'NNP'), `('He', 'PRP'),` ('will', 'MD'), `('be', 'VB'),` ('missed', 'VBN'), `('very', 'RB'),` ('much', 'JJ'), `('I', 'PRP'),` ('think', 'VBP'), `('finding', 'VBG'),` ('a', 'DT'), `('new', 'JJ'),` ('doctor', 'NN'), `('in', 'IN'),` ('NYC', 'NNP'), `('that', 'IN'),` ('you', 'PRP'), `('actually', 'RB'),` ('like', 'IN'), `('might', 'MD'),` ('almost', 'RB'), `('be', 'VB'),` ('as', 'RB'), `('awful', 'JJ'),` ('as', 'IN'), `('trying', 'VBG'),` ('to', 'TO'), `('find', 'VB'),` ('a', 'DT'), `('date', 'NN')]` >>> print ([ np for np in blob_df [ 4 ] . noun_phrases ]) `['got', 'goldberg', 'arizona', 'new position', 'june', 'new doctor', 'nyc']`
可以看到,每个库找到的名词短语略有不同。spaCy 包含 “a”、“the” 这类英语常见词,而 TextBlob 会去掉它们。这反映了驱动各库判定名词短语的规则引擎之间的差异。你也可以自己编写词性关系来定义你要找的块。想从零开始深入钻研 Python 分块,可以参阅 Bird 等人(2009)。
小结
词袋表示易于理解、易于计算,对分类和搜索任务很有用。但有时单个词过于简单,无法封装文本中的某些信息。为了解决这个问题,人们求助于更长的序列。n 元语法词袋是词袋的自然推广。概念仍然容易理解,计算起来和词袋一样简单。
n 元语法词袋会产生多得多的不同 n 元语法。它增加了特征存储成本,以及模型训练和预测阶段的计算成本。数据点的数量不变,但特征空间的维度大得多,因此数据稀疏得多。\(n\) 越高,存储和计算成本越高,数据越稀疏。由于这些原因,更长的 n 元语法并不总能带来模型准确率(或其他任何性能指标)的提升。人们通常在 \(n = 2\) 或 3 处止步。更长的 n 元语法很少使用。
对抗稀疏性和成本增长的一种方式是过滤 n 元语法,只保留最有意义的短语。这正是搭配提取的目标。理论上,搭配(或短语)可以构成文本中不连续的词元序列。但在实践中,寻找非连续短语的计算成本高得多,收益却不大。因此,搭配提取通常从二元语法候选列表出发,用统计方法过滤它们。
所有这些方法都把文本词元序列变成一组互不关联的计数。集合比序列的结构少得多;它们带来扁平的特征向量。
本章我们小试牛刀,接触了简单的文本特征化技术。这些技术把一段充满丰富语义结构的自然语言文本变成简单的扁平向量。我们讨论了许多常见的过滤技术来清理向量条目,还介绍了 n 元语法和搭配提取,作为给扁平向量增加一点结构的方法。下一章将更详细地讨论另一个常见的文本特征化技巧——tf-idf。后续章节还会讨论更多把结构加回扁平向量的方法。
参考文献
Bird, Steven, Ewan Klein, and Edward Loper. Natural Language Processing with Python. Sebastopol, CA: O’Reilly Media, 2009.
Dunning, Ted. “Accurate Methods for the Statistics of Surprise and Coincidence.” ACM Journal of Computational Linguistics, special issue on using large corpora 19:1 (1993): 61-74.
Khan Academy. “Hypothesis Testing and p-Values.” Retrieved from https://www.khanacademy.org/math/probability/statistics-inferential/hypothesis-testing/v/hypothesis-testing-and-p-values.
Manning, Christopher D. and Hinrich Schütze. Foundations of Statistical Natural Language Processing. Cambridge, MA: MIT Press, 1999.
[1] 有时人们用"文档向量(document vector)“这个说法。向量从原点出发,终止于指定点。就我们的目的而言,“向量"和"点"是一回事。