数字的小把戏
在深入文本和图像这类复杂数据类型之前,让我们从最简单的数据类型——数值数据——开始。数值数据来源多种多样:某个地点或某个人的地理位置、一次购买的价格、传感器的测量值、交通流量统计等等。数值数据本身已经是数学模型易于消化的格式。但这并不意味着特征工程就不再必要。好的特征不仅应该刻画数据的重要方面,还应该符合模型的假设。因此,变换往往是必需的。数值特征工程技术是基础性的,凡是把原始数据转换成数值特征的地方,都可以用到它们。
对数值数据的第一个合理性检查是:量级(magnitude)重要吗?我们只需要知道它是正还是负吗?或者我们只需要在非常粗的粒度上知道量级?这个合理性检查对自动累积的数字尤其重要,例如计数——网站的每日访问次数、餐厅获得的评价条数等等。
接下来,考虑特征的尺度(scale)。最大值和最小值是多少?它们跨越了几个数量级?作为输入特征平滑函数的模型对输入的尺度很敏感。例如,\(3x + 1\) 是输入 \(x\) 的一个简单线性函数,其输出的尺度直接取决于输入的尺度。其他例子包括 k 均值(k-means)聚类、最近邻(nearest neighbors)方法、径向基函数(radial basis function,RBF)核,以及一切使用欧几里得距离(Euclidean distance)的方法。对于这些模型和建模组件,通常最好对特征做归一化(normalize),使输出保持在预期的尺度上。
另一方面,逻辑函数(logical function)对输入特征的尺度不敏感。无论输入是什么,它们的输出都是二值的。例如,逻辑与(AND)接受任意两个变量,当且仅当两个输入都为真时输出 1。逻辑函数的另一个例子是阶跃函数(step function)(例如,输入 \(x\) 是否大于 5?)。决策树模型由输入特征的阶跃函数构成。因此,基于空间划分树(space-partitioning tree)的模型(决策树、梯度提升机、随机森林)对尺度不敏感。唯一的例外是当输入的尺度随时间增长时——如果特征是某种累积计数,最终它会增长到超出树训练时的取值范围。如果可能出现这种情况,就可能需要定期重新缩放输入。另一个解决方案是第 5 章讨论的计数分箱(bin-counting)方法。
考虑数值特征的分布(distribution)也很重要。分布概括了取到某个特定值的概率。输入特征的分布对某些模型比对其他模型更重要。例如,线性回归模型的训练过程假设预测误差服从高斯分布。这通常没问题,除非预测目标跨越了几个数量级。在这种情况下,高斯误差假设很可能不再成立。一种处理方法是变换输出目标,以抑制量级的增长。(严格来说,这属于目标工程,而不是特征工程。)对数变换(log transform)是幂变换(power transform)的一种,它能使变量的分布更接近高斯分布。
除了让特征契合模型或训练过程的假设之外,还可以把多个特征组合成更复杂的特征。我们希望复杂的特征能够更简洁地捕捉原始数据中的重要信息。让输入特征更有"表现力",可以让模型本身更简单、更容易训练和评估,并做出更好的预测。走到极端,复杂特征本身可能就是统计模型的输出。这就是所谓的模型堆叠(model stacking),我们将在第 7 章和第 8 章中详细讨论。在本章中,我们给出复杂特征最简单的例子:交互特征(interaction feature)。
交互特征很容易构造,但特征的组合会导致输入模型的特征数量大大增加。为了降低计算开销,通常需要用自动的特征选择(feature selection)来剪除输入特征。
我们将从标量、向量和空间的基本概念开始,然后讨论尺度、分布、交互特征和特征选择。
标量、向量与空间
在继续之前,我们需要定义贯穿全书的一些基本概念。单个数值特征也称为标量(scalar)。标量的有序列表称为向量(vector)。向量位于向量空间(vector space)之中。在绝大多数机器学习应用中,模型的输入通常表示为一个数值向量。本书其余部分将讨论把原始数据转换成数值向量的最佳实践策略。
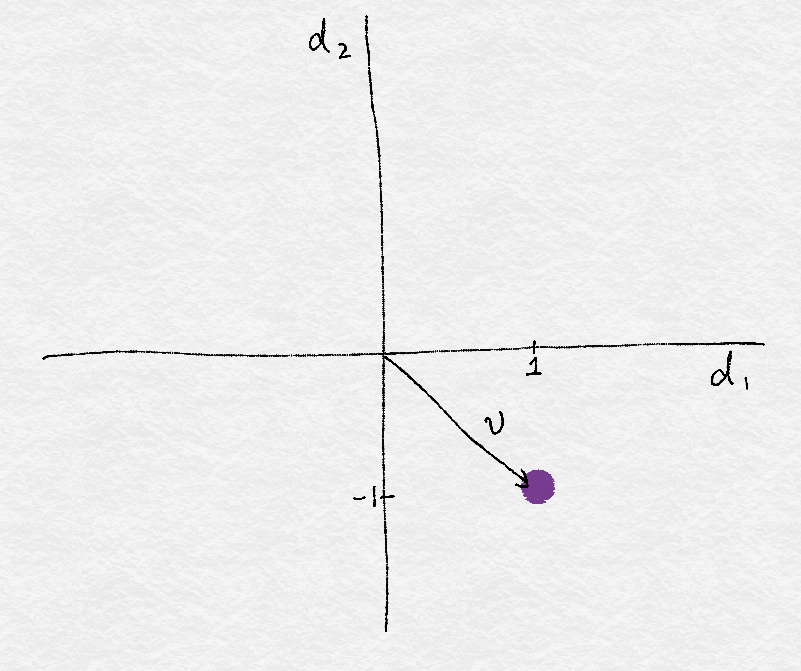
向量可以可视化为空间中的一个点。(有时人们会从原点画一条线或箭头指向这个点。在本书中,我们大多只使用点。)例如,假设我们有一个二维向量 v = [1, -1]。这个向量包含两个数:在第一个方向 \(d_1\) 上,向量的值为 1;在第二个方向 \(d_2\) 上,值为 -1。我们可以把 v 画在二维图中,如图 2-1所示。
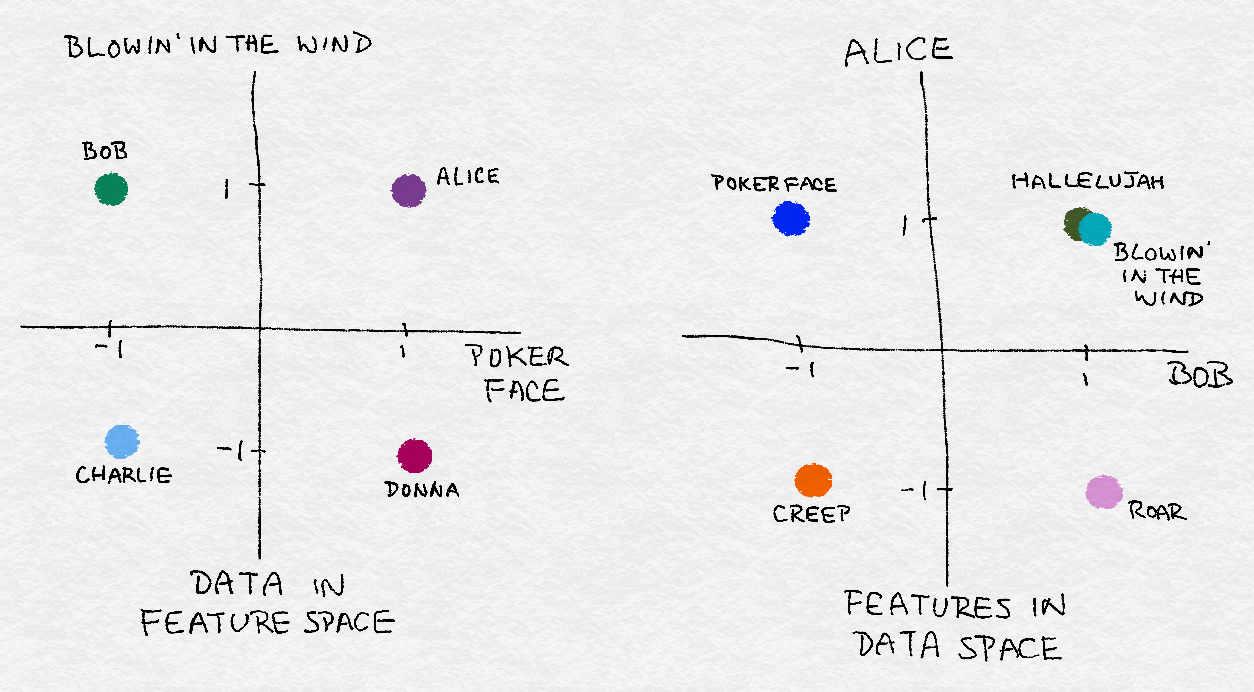
在数据的世界里,抽象向量及其特征维度具有实际含义。例如,一个向量可以表示一个人对歌曲的偏好。每首歌是一个特征,值 1 相当于点赞,-1 相当于点踩。假设向量 **v 表示听众 Bob 的偏好。Bob 喜欢鲍勃·迪伦(Bob Dylan)的《Blowin’ in the Wind》和 Lady Gaga 的《Poker Face》。其他人可能有不同的偏好。总体而言,一组数据可以在特征空间(feature space)中可视化为一个点云。
反过来,一首歌也可以用一群人的个体偏好来表示。假设只有两位听众:Alice 和 Bob。Alice 喜欢《Poker Face》、《Blowin’ in the Wind》和莱昂纳德·科恩(Leonard Cohen)的《Hallelujah》,但讨厌凯蒂·佩里(Katy Perry)的《Roar》和电台司令(Radiohead)的《Creep》。Bob 喜欢《Roar》、《Hallelujah》和《Blowin’ in the Wind》,但讨厌《Poker Face》和《Creep》。每首歌都是听众空间中的一个点。正如我们可以在特征空间中可视化数据一样,我们也可以在数据空间(data space)中可视化特征。图 2-2 展示了这个例子。
处理计数
在大数据时代,计数会迅速无界地累积。用户可能让一首歌或一部电影无限循环播放,或者用脚本反复检查热门演出的票是否可购,这会让播放次数或网站访问次数迅速攀升。当数据可以以高产量和高速度产生时,其中很可能包含一些极端值。最好检查一下尺度,决定是把数据保留为原始数字、转换成指示是否出现的二值值,还是分箱到更粗的粒度。为了说明这些想法,让我们看几个例子。
二值化
Echo Nest 品味档案子集是百万歌曲数据集(Million Song Dataset)的官方用户数据集合,包含一百万 Echo Nest 用户的完整音乐收听历史。以下是该数据集的一些相关统计信息:
Echo Nest 品味档案数据集统计
- 超过 4800 万个(用户 ID、歌曲 ID、收听次数)三元组。
- 完整数据集包含 1,019,318 个唯一用户和 384,546 首唯一歌曲。
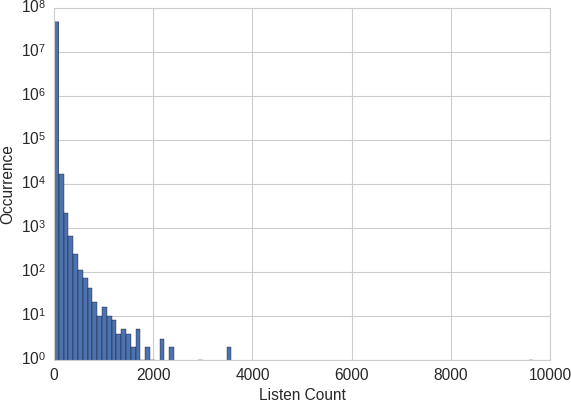
假设我们的任务是构建一个推荐系统来向用户推荐歌曲。推荐系统的一个组成部分可能是预测用户对某首特定歌曲的喜爱程度。由于数据包含实际的收听次数,是否应该把它作为预测目标?如果收听次数大意味着用户真的很喜欢这首歌,收听次数低意味着不感兴趣,那么这样做就是对的。然而,数据显示,虽然 99% 的收听次数在 24 次或以下,但也有一些收听次数达到数千次,最大值为 9,667。(如图 2-3所示,直方图在最接近 0 的区间达到峰值,但超过 10,000 个三元组有更大的计数,少数达到数千。)这些值异常地大;如果我们试图预测实际的收听次数,模型会被这些大值带偏。
在百万歌曲数据集中,原始收听次数不是衡量用户品味的稳健(robust)指标。(用统计学的说法,稳健性指的是方法能在各种各样的条件下工作。)用户的收听习惯各不相同。有些人可能让最喜欢的歌曲无限循环,而另一些人只在特殊场合细细品味。我们不能断言,一个把某首歌听了 20 次的人,对这首歌的喜爱程度一定是听了 10 次的人的两倍。
用户偏好更稳健的表示方式是把计数二值化,把所有大于 1 的计数裁剪为 1,如示例 2-1所示。换句话说,只要用户至少听过一次这首歌,我们就认为用户喜欢这首歌。这样,模型就不需要花精力去预测原始计数之间的细微差别。二值目标是对用户偏好简单而稳健的度量。
示例 2-1:对百万歌曲数据集中的收听次数进行二值化
>>> import pandas as pd
>>> listen_count = pd . read_csv ( 'millionsong/train_triplets.txt.zip' ,
... header = None , delimiter = ' \t ' )
# The table contains user-song-count triplets. Only nonzero counts are
# included. Hence, to binarize the count, we just need to set the entire
# count column to 1.
>>> listen_count [ 2 ] = 1
这是一个对模型目标变量进行工程的例子。严格来说,目标不是特征,因为它不是输入。但有时我们确实需要修改目标,以便解决正确的问题。
量化或分箱
在本练习中,我们取 Yelp 数据集挑战赛第 6 轮的数据,构造一个规模小得多的分类数据集。Yelp 数据集包含来自北美和欧洲 10 个城市的用户对商家的评价。每个商家被标注为零个或多个类别。
Yelp 评论数据集统计(第 6 轮)
- 共有 782 个商家类别。
- 完整数据集包含 1,569,264(约 160 万)条评论和 61,184(61K)个商家。
- 按评论数量计,“餐馆”(990,627 条评论)和"夜生活"(210,028 条评论)是最受欢迎的类别。
- 没有任何商家同时被归类为餐馆和夜生活场所。因此,两组评论之间没有重叠。
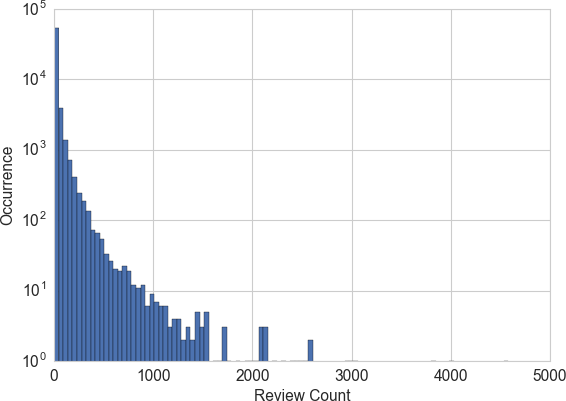
每个商家都有一个评论数。假设我们的任务是使用协同过滤(collaborative filtering)预测用户可能给商家的评分。评论数可能是一个有用的输入特征,因为受欢迎程度和好评之间通常存在强相关。现在的问题是:我们应该使用原始评论数,还是进一步处理它?图 2-4(由示例 2-2生成)展示了所有商家评论数的直方图。我们看到与前一个例子中收听次数相同的模式:大多数计数很小,但有些商家的评论达到数千条。
示例 2-2:可视化 Yelp 数据集中的商家评论数
>>> import pandas as pd
>>> import json
# Load the data about businesses
>>> biz_file = open ( 'yelp_academic_dataset_business.json' )
>>> biz_df = pd . DataFrame ([ json . loads ( x ) for x in biz_file . readlines ()])
>>> biz_file . close ()
>>> import matplotlib.pyplot as plt
>>> import seaborn as sns
# Plot the histogram of the review counts
>>> sns . set_style ( 'whitegrid' )
>>> fig , ax = plt . subplots ()
>>> biz_df [ 'review_count' ] . hist ( ax = ax , bins = 100 )
>>> ax . set_yscale ( 'log' )
>>> ax . tick_params ( labelsize = 14 )
>>> ax . set_xlabel ( 'Review Count' , fontsize = 14 )
>>> ax . set_ylabel ( 'Occurrence' , fontsize = 14 )
跨越几个数量级的原始计数对许多模型来说都是个问题。在线性模型中,同一个线性系数必须适用于计数的所有可能取值。大计数还会对无监督学习方法造成严重破坏,例如使用欧几里得距离作为相似度函数来衡量数据点之间相似性的 k 均值聚类。数据向量中某个元素的大计数会压过所有其他元素的相似性,从而搞乱整个相似性度量。
一种解决方案是通过量化(quantize)计数来约束尺度。换句话说,我们把计数分组到区间(bin)中,去掉实际的计数值。量化把连续数映射为离散数。我们可以把离散化后的数看作一个有序的区间序列,表示强度的度量。
为了量化数据,我们必须决定每个区间应该有多宽。解决方案分为两类:定宽(fixed-width)或自适应(adaptive)。我们各举一个例子。
定宽分箱
使用定宽分箱(fixed-width binning)时,每个区间包含一个特定的数值范围。这些范围可以自定义设计,也可以自动分段,可以是线性缩放的,也可以是指数缩放的。例如,我们可以按十年把人分成年龄段:0-9 岁在第 1 箱,10-19 岁在第 2 箱,依此类推。要从计数映射到区间,我们只需除以区间的宽度并取整数部分。
也常见到自定义设计的、与人生阶段更对应的年龄段,例如:
- 0-12 岁
- 12-17 岁
- 18-24 岁
- 25-34 岁
- 35-44 岁
- 45-54 岁
- 55-64 岁
- 65-74 岁
- 75 岁及以上
当数字跨越多个数量级时,按 10 的幂(或任何常数的幂)分组可能更好:0-9、10-99、100-999、1000-9999,等等。区间宽度呈指数增长,从 \(O(10)\) 到 \(O(100)\)、\(O(1000)\) 及更远。要从计数映射到区间,我们对计数取对数。指数宽度分箱与对数变换密切相关,我们将在“对数变换”一节中讨论。示例 2-3 展示了其中几种分箱方法。
示例 2-3:用定宽区间量化计数
>>> import numpy as np
# Generate 20 random integers uniformly between 0 and 99
>>> small_counts = np . random . randint ( 0 , 100 , 20 )
>>> small_counts
array([30, 64, 49, 26, 69, 23, 56,  7, 69, 67, 87, 14, 67, 33, 88, 77, 75,
47, 44, 93])
# Map to evenly spaced bins 0-9 by division
>>> np . floor_divide ( small_counts , 10 )
array([3, 6, 4, 2, 6, 2, 5, 0, 6, 6, 8, 1, 6, 3, 8, 7, 7, 4, 4, 9], dtype=int32)
# An array of counts that span several magnitudes
>>> large_counts = [ 296 , 8286 , 64011 , 80 , 3 , 725 , 867 , 2215 , 7689 , 11495 , 91897 ,
... 44 , 28 , 7971 , 926 , 122 , 22222 ]
# Map to exponential-width bins via the log function
>>> np . floor ( np . log10 ( large_counts ))
array([ 2.,  3.,  4.,  1.,  0.,  2.,  2.,  3.,  3.,  4.,  4.,  1.,  1.,
3.,  2.,  2.,  4.])
分位数分箱
定宽分箱很容易计算。但如果计数之间存在很大的空隙,就会有很多没有数据的空箱。这个问题可以通过根据数据分布自适应地定位区间来解决。这可以利用分布的分位数(quantile)来完成。
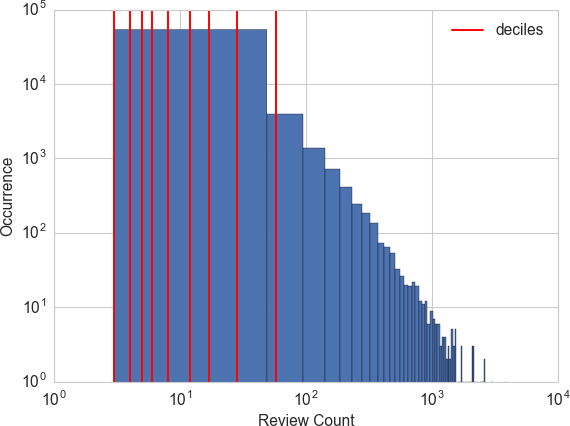
分位数是把数据分成相等部分的值。例如,中位数把数据分成两半:一半数据点小于中位数,一半大于中位数。四分位数把数据分成四份,十分位数分成十份,依此类推。示例 2-4 演示了如何计算 Yelp 商家评论数的十分位数,图 2-5 把十分位数叠加在直方图上。这让我们更清楚地看到数据向较小计数的偏斜。
示例 2-4:计算 Yelp 商家评论数的十分位数
>>> deciles = biz_df [ 'review_count' ] . quantile ([ . 1 , . 2 , . 3 , . 4 , . 5 , . 6 , . 7 , . 8 , . 9 ])
>>> deciles
0.1     3.0
0.2     4.0
0.3     5.0
0.4     6.0
0.5     8.0
0.6    12.0
0.7    17.0
0.8    28.0
0.9    58.0
Name: review_count, dtype: float64
# Visualize the deciles on the histogram
>>> sns . set_style ( 'whitegrid' )
>>> fig , ax = plt . subplots ()
>>> biz_df [ 'review_count' ] . hist ( ax = ax , bins = 100 )
>>> for pos in deciles :
... handle = plt . axvline ( pos , color = 'r' )
>>> ax . legend ([ handle ], [ 'deciles' ], fontsize = 14 )
>>> ax . set_yscale ( 'log' )
>>> ax . set_xscale ( 'log' )
>>> ax . tick_params ( labelsize = 14 )
>>> ax . set_xlabel ( 'Review Count' , fontsize = 14 )
>>> ax . set_ylabel ( 'Occurrence' , fontsize = 14 )
要计算分位数并把数据映射到分位数区间,我们可以使用 Pandas 库,如示例 2-5所示。pandas.DataFrame.quantile 和 pandas.Series.quantile 计算分位数。pandas.qcut 把数据映射到所需数量的分位数中。
示例 2-5:按分位数对计数分箱
# Continue example 2-3 with large_counts
>>> import pandas as pd
# Map the counts to quartiles
>>> pd . qcut ( large_counts , 4 , labels = False )
array([1, 2, 3, 0, 0, 1, 1, 2, 2, 3, 3, 0, 0, 2, 1, 0, 3], dtype=int64)
# Compute the quantiles themselves
>>> large_counts_series = pd . Series ( large_counts )
>>> large_counts_series . quantile ([ 0.25 , 0.5 , 0.75 ])
0.25     122.0
0.50     926.0
0.75    8286.0
dtype: float64
对数变换
在上一节中,我们简单介绍了对计数取对数以把数据映射到指数宽度区间的方法。现在让我们更仔细地看看它。
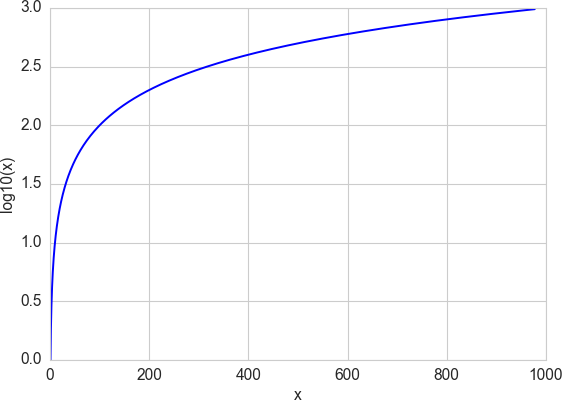
对数函数是指数函数的逆函数。它的定义是 \(\log_a(a^x) = x\),其中 \(a\) 是一个正常数,\(x\) 可以是任意正数。由于 \(a^0 = 1\),我们有 \(\log_a(1) = 0\)。这意味着对数函数把 (0, 1) 之间的很小范围的数映射到整个负数范围 \((-\infty, 0)\)。函数 \(\log_{10}(x)\) 把 [1, 10] 映射到 [0, 1],把 [10, 100] 映射到 [1, 2],依此类推。换句话说,对数函数压缩大数的范围,扩展小数的范围。\(x\) 越大,\(\log(x)\) 增长得越慢。
看一下对数函数的图像会更容易理解(见图 2-6)。注意水平方向上从 100 到 1,000 的 \(x\) 值如何被压缩到垂直方向上仅仅 2.0 到 3.0 的 \(y\) 范围,而水平方向上小于 100 的微小 \(x\) 部分则映射到其余垂直范围。
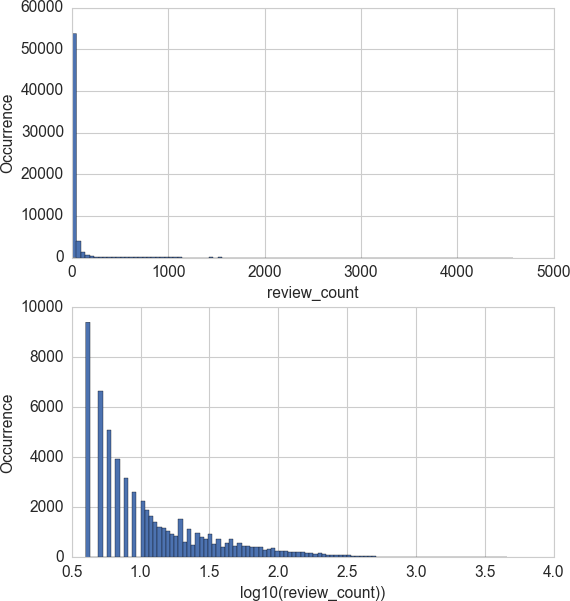
对数变换是处理具有重尾分布(heavy-tailed distribution)的正数的有力工具。(重尾分布比高斯分布把更多的概率质量放在尾部区域。)它把分布高端的的长尾压缩成较短的尾,把低端扩展成较长的头部。图 2-7 比较了 Yelp 商家评论数在对数变换前后的直方图(见示例 2-6)。两个 y 轴现在都是普通(线性)刻度。底部图中 (0.5, 1] 范围内区间间距变大,是因为 1 到 10 之间只有 10 个可能的整数计数。注意原始评论数非常集中在低计数区域,离群值延伸到 4,000 以上。对数变换后,直方图在低端的集中度降低,在 x 轴上分布得更开。
示例 2-6:可视化对数变换前后评论数的分布
>>> fig , ( ax1 , ax2 ) = plt . subplots ( 2 , 1 )
>>> biz_df [ 'review_count' ] . hist ( ax = ax1 , bins = 100 )
>>> ax1 . tick_params ( labelsize = 14 )
>>> ax1 . set_xlabel ( 'review_count' , fontsize = 14 )
>>> ax1 . set_ylabel ( 'Occurrence' , fontsize = 14 )
>>> biz_df [ 'log_review_count' ] . hist ( ax = ax2 , bins = 100 )
>>> ax2 . tick_params ( labelsize = 14 )
>>> ax2 . set_xlabel ( 'log10(review_count))' , fontsize = 14 )
>>> ax2 . set_ylabel ( 'Occurrence' , fontsize = 14 )
再举一个例子,我们考虑加州大学欧文分校机器学习知识库(UC Irvine Machine Learning Repository)的在线新闻流行度数据集(Fernandes 等,2015)。
在线新闻流行度数据集统计
- 该数据集包含 Mashable 在 2 年时间内发布的 39,797 篇新闻文章的 60 个特征。
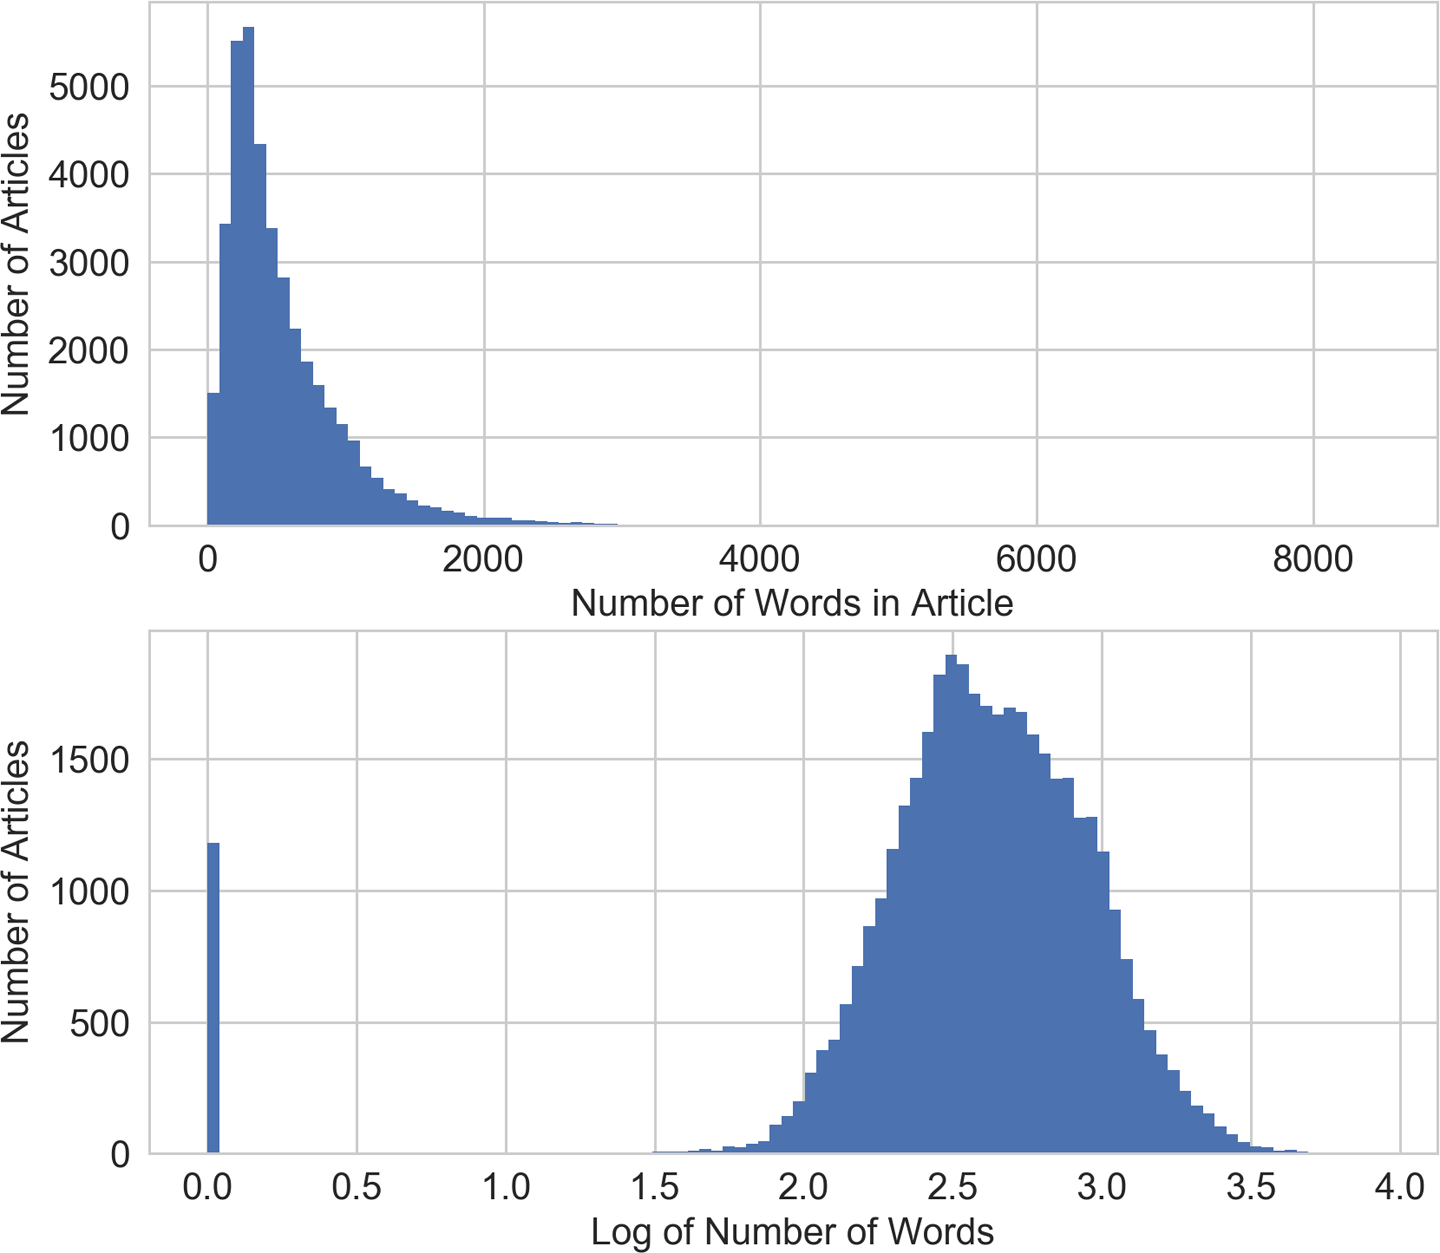
我们的目标是使用这些特征预测文章的流行度,即社交媒体上的分享次数。在这个例子中,我们只关注一个特征——文章中的词数。图 2-8 展示了对数变换前后该特征的直方图(见示例 2-7)。注意对数变换后分布看起来更接近高斯分布,除了长度为零(无内容)的文章数量出现的一阵爆发。
示例 2-7:可视化有无对数变换时新闻文章流行度的分布
>>> fig , ( ax1 , ax2 ) = plt . subplots ( 2 , 1 )
>>> df [ 'n_tokens_content' ] . hist ( ax = ax1 , bins = 100 )
>>> ax1 . tick_params ( labelsize = 14 )
>>> ax1 . set_xlabel ( 'Number of Words in Article' , fontsize = 14 )
>>> ax1 . set_ylabel ( 'Number of Articles' , fontsize = 14 )
>>> df [ 'log_n_tokens_content' ] . hist ( ax = ax2 , bins = 100 )
>>> ax2 . tick_params ( labelsize = 14 )
>>> ax2 . set_xlabel ( 'Log of Number of Words' , fontsize = 14 )
>>> ax2 . set_ylabel ( 'Number of Articles' , fontsize = 14 )
对数变换实战
让我们看看对数变换在监督学习中的表现。这里我们使用前面提到的两个数据集。对于 Yelp 评论数据集,我们用评论数来预测商家的平均评分(见示例 2-8)。对于 Mashable 新闻文章,我们用文章中的词数来预测其流行度。由于输出是连续数,我们使用简单的线性回归作为模型。我们使用 scikit-learn 对带和不带对数变换的特征进行线性回归的 10 折交叉验证。模型用 R 平方得分(R-squared score)评估,它衡量训练好的回归模型预测新数据的好坏。好的模型 R 平方得分高。完美模型得到最高分 1。得分可以是负数,差模型可以得到任意低的负分。通过交叉验证,我们不仅得到得分的估计值,还得到方差,这有助于我们判断两个模型之间的差异是否有意义。
示例 2-8:使用对数变换后的 Yelp 评论数预测商家平均评分
>>> import pandas as pd
>>> import numpy as np
>>> import json
>>> from sklearn import linear_model
>>> from sklearn.model_selection import cross_val_score
# Using the previously loaded Yelp reviews DataFrame,
# compute the log transform of the Yelp review count.
# Note that we add 1 to the raw count to prevent the logarithm from
# exploding into negative infinity in case the count is zero.
>>> biz_df [ 'log_review_count' ] = np . log10 ( biz_df [ 'review_count' ] + 1 )
# Train linear regression models to predict the average star rating of a business,
# using the review_count feature with and without log transformation.
# Compare the 10-fold cross validation score of the two models.
>>> m_orig = linear_model . LinearRegression ()
>>> scores_orig = cross_val_score ( m_orig , biz_df [[ 'review_count' ]],
... biz_df [ 'stars' ], cv = 10 )
>>> m_log = linear_model . LinearRegression ()
>>> scores_log = cross_val_score ( m_log , biz_df [[ 'log_review_count' ]],
... biz_df [ 'stars' ], cv = 10 )
>>> print ( "R-squared score without log transform: %0.5f (+/- %0.5f )"
... % ( scores_orig . mean (), scores_orig . std () * 2 ))
>>> print ( "R-squared score with log transform: %0.5f (+/- %0.5f )"
... % ( scores_log . mean (), scores_log . std () * 2 ))
R-squared score without log transform: -0.03683 (+/- 0.07280)
R-squared score with log transform: -0.03694 (+/- 0.07650)
从实验输出来看,两个简单模型(带和不带对数变换)在预测目标上同样糟糕,对数变换特征的表现略差一些。真令人失望!考虑到两者都只使用一个特征,它们都不是很好并不奇怪,但人们本来希望对数变换特征可能表现更好。
现在让我们看看对数变换在在线新闻流行度数据集上的表现(示例 2-9)。
示例 2-9:使用在线新闻流行度数据集中的对数变换词数预测文章流行度
# Download the Online News Popularity dataset from UCI, then use
# Pandas to load the file into a DataFrame.
>>> df = pd . read_csv ( 'OnlineNewsPopularity.csv' , delimiter = ', ' )
# Take the log transform of the 'n_tokens_content' feature, which
# represents the number of words (tokens) in a news article.
>>> df [ 'log_n_tokens_content' ] = np . log10 ( df [ 'n_tokens_content' ] + 1 )
# Train two linear regression models to predict the number of shares
# of an article, one using the original feature and the other the
# log transformed version.
>>> m_orig = linear_model . LinearRegression ()
>>> scores_orig = cross_val_score ( m_orig , df [[ 'n_tokens_content' ]],
... df [ 'shares' ], cv = 10 )
>>> m_log = linear_model . LinearRegression ()
>>> scores_log = cross_val_score ( m_log , df [[ 'log_n_tokens_content' ]],
... df [ 'shares' ], cv = 10 )
>>> print ( "R-squared score without log transform: %0.5f (+/- %0.5f )"
... % ( scores_orig . mean (), scores_orig . std () * 2 ))
>>> print ( "R-squared score with log transform: %0.5f (+/- %0.5f )"
... % ( scores_log . mean (), scores_log . std () * 2 ))
R-squared score without log transform: -0.00242 (+/- 0.00509)
R-squared score with log transform: -0.00114 (+/- 0.00418)
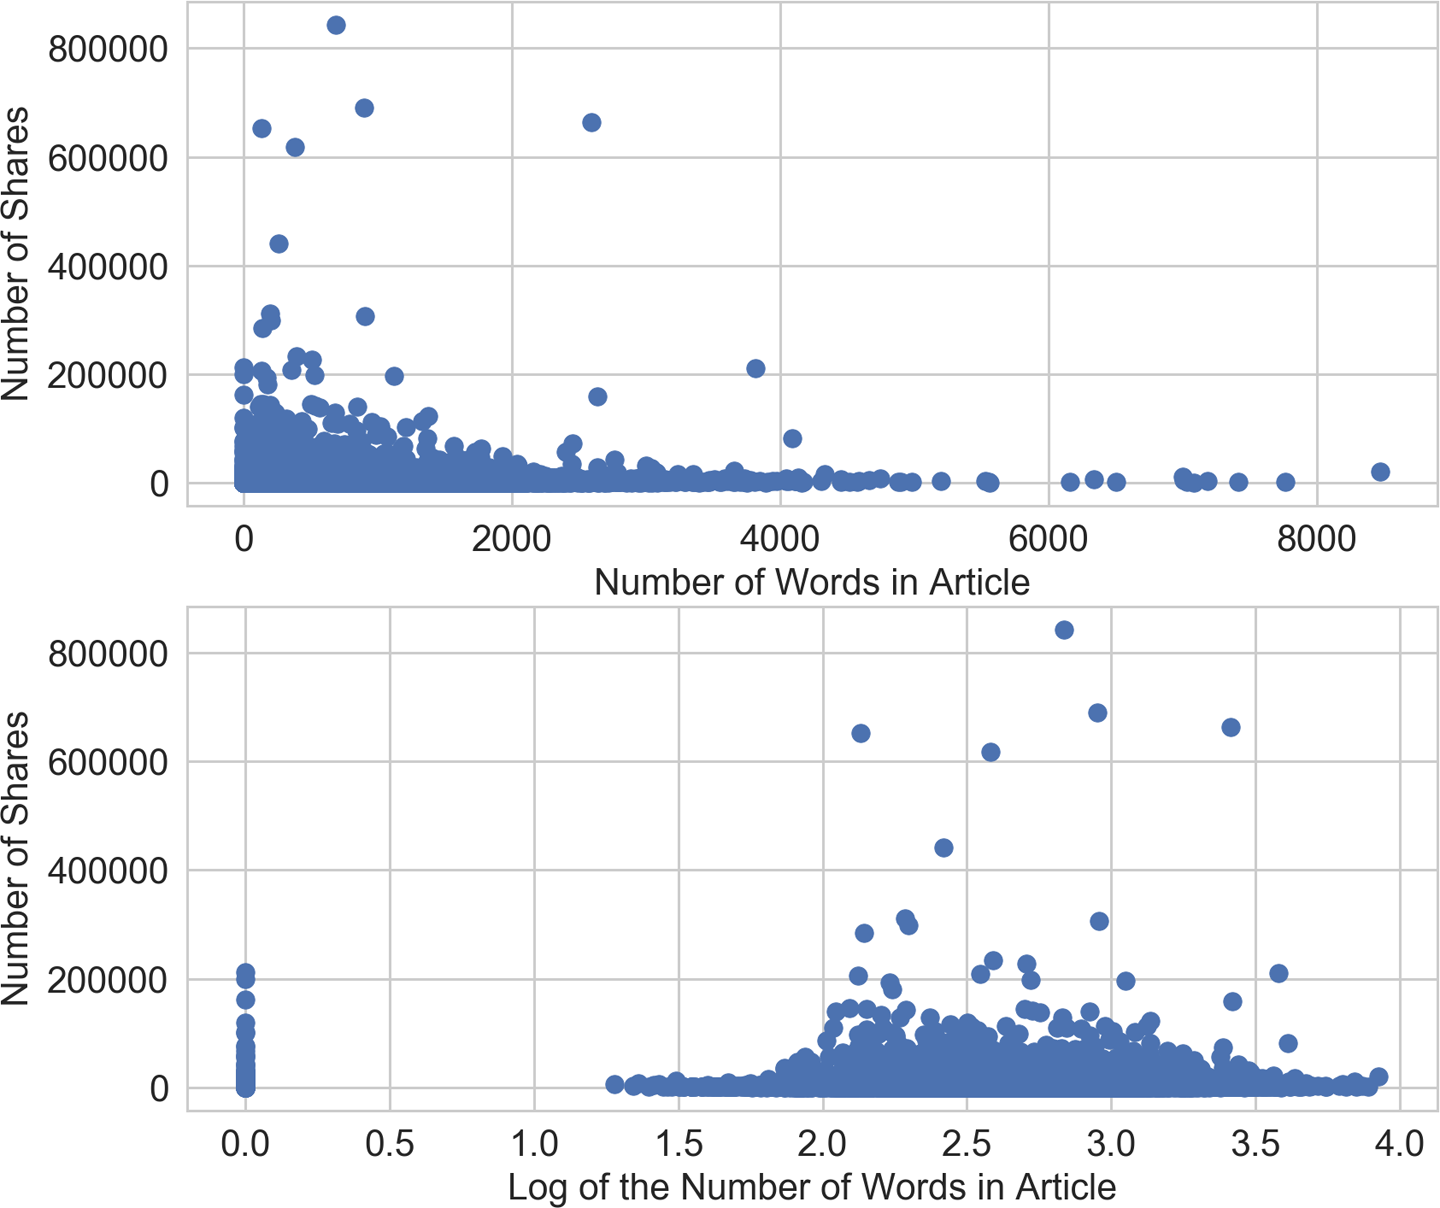
置信区间仍然重叠,但使用对数变换特征的模型比不使用的模型表现更好。为什么对数变换在这个数据集上成功得多?我们可以通过查看输入特征和目标值的散点图(示例 2-10)得到线索。如图 2-9 底部面板所示,对数变换重塑了 x 轴,把目标值具有大离群值(超过 200,000 次分享)的文章进一步拉到轴的右侧。这给线性模型在输入特征空间的低端留下了更多"呼吸空间"。没有对数变换(顶部面板),模型承受更大压力,要在输入变化很小的情况下拟合差异很大的目标值。
示例 2-10:可视化新闻流行度预测问题中输入与输出的相关性
>>> fig2 , ( ax1 , ax2 ) = plt . subplots ( 2 , 1 )
>>> ax1 . scatter ( df [ 'n_tokens_content' ], df [ 'shares' ])
>>> ax1 . tick_params ( labelsize = 14 )
>>> ax1 . set_xlabel ( 'Number of Words in Article' , fontsize = 14 )
>>> ax1 . set_ylabel ( 'Number of Shares' , fontsize = 14 )
>>> ax2 . scatter ( df [ 'log_n_tokens_content' ], df [ 'shares' ])
>>> ax2 . tick_params ( labelsize = 14 )
>>> ax2 . set_xlabel ( 'Log of the Number of Words in Article' , fontsize = 14 )
>>> ax2 . set_ylabel ( 'Number of Shares' , fontsize = 14 )
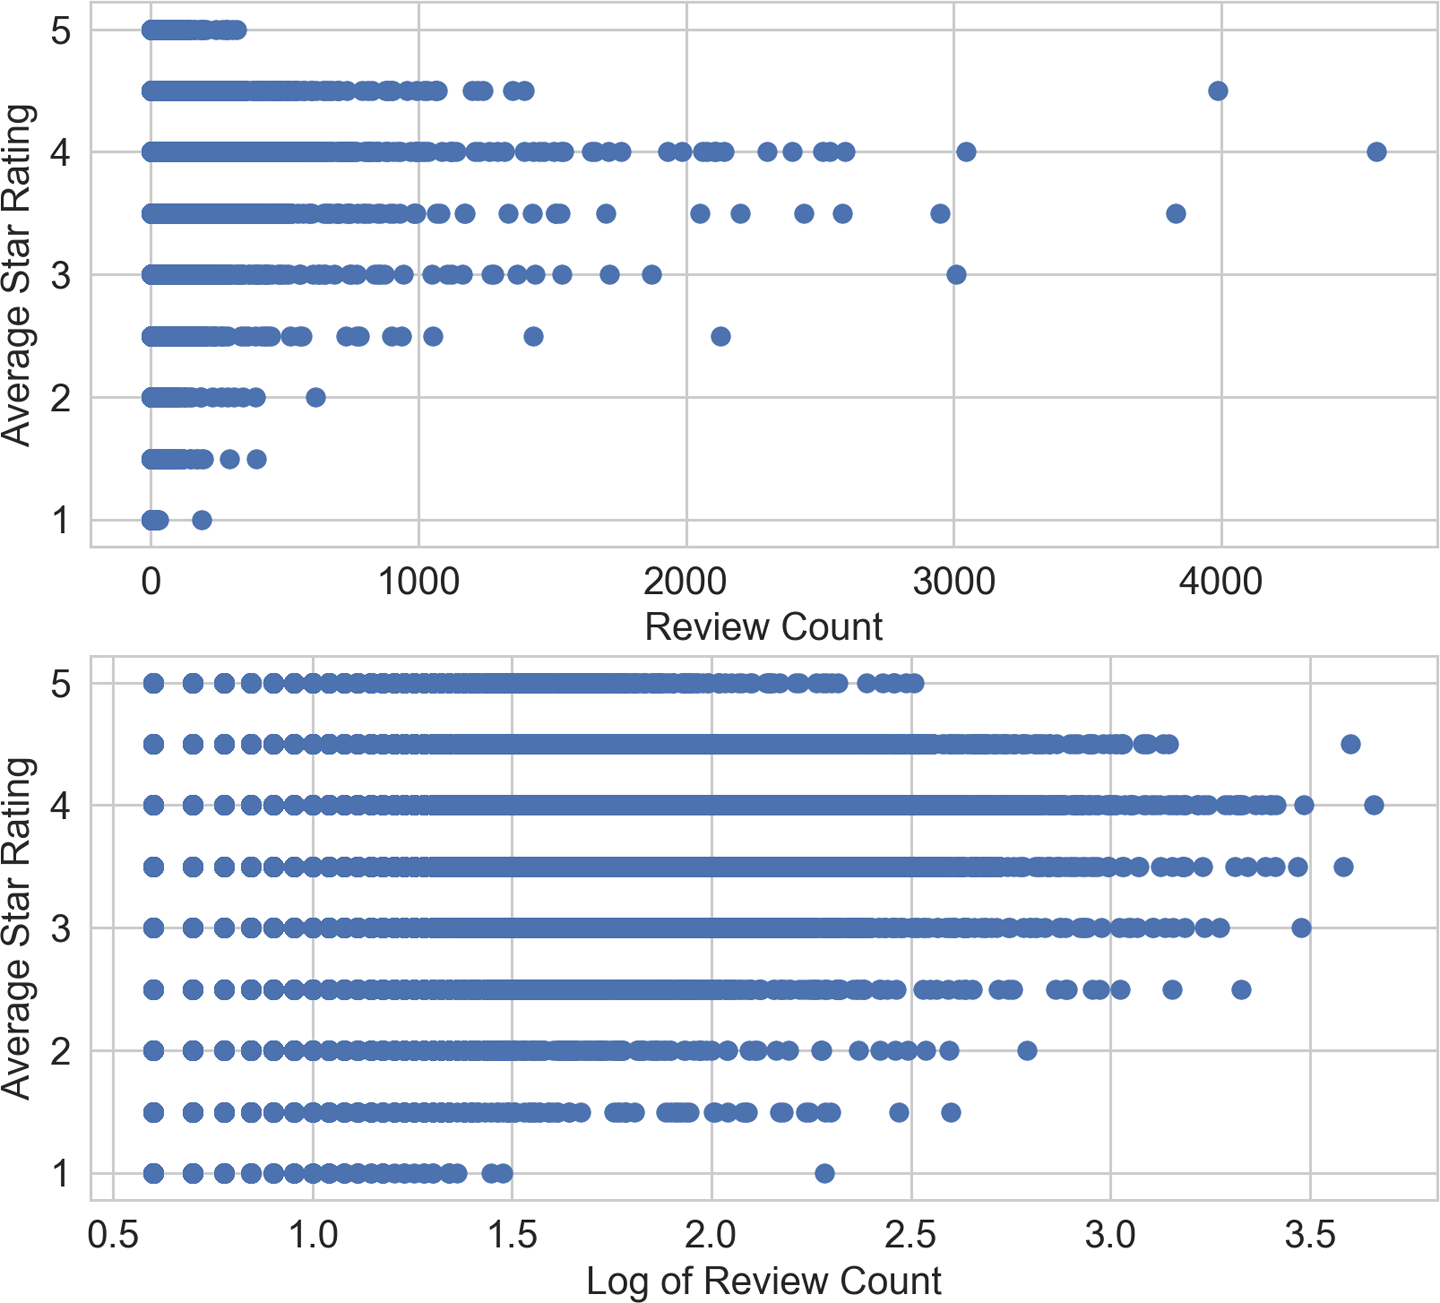
把这与应用于 Yelp 评论数据集的相同散点图(示例 2-11)进行比较。图 2-10 看起来与图 2-9 大不相同。平均星级评分以半星为增量离散化,范围从 1 到 5。高评论数(大约超过 2,500 条评论)确实与更高的平均星级评分相关,但这种关系远非线性。没有清晰的方法画一条线来根据任一输入预测平均星级评分。本质上,图显示评论数及其对数都不是平均星级评分的好的线性预测因子。
示例 2-11:可视化 Yelp 商家评分预测中输入与输出的相关性
>>> fig , ( ax1 , ax2 ) = plt . subplots ( 2 , 1 )
>>> ax1 . scatter ( biz_df [ 'review_count' ], biz_df [ 'stars' ])
>>> ax1 . tick_params ( labelsize = 14 )
>>> ax1 . set_xlabel ( 'Review Count' , fontsize = 14 )
>>> ax1 . set_ylabel ( 'Average Star Rating' , fontsize = 14 )
>>> ax2 . scatter ( biz_df [ 'log_review_count' ], biz_df [ 'stars' ])
>>> ax2 . tick_params ( labelsize = 14 )
>>> ax2 . set_xlabel ( 'Log of Review Count' , fontsize = 14 )
>>> ax2 . set_ylabel ( 'Average Star Rating' , fontsize = 14 )
数据可视化的重要性
对数变换在两个不同数据集上效果的比较说明了可视化数据的重要性。在这里,我们有意保持输入和目标变量简单,以便轻松可视化它们之间的关系。像图 2-10 这样的图立即揭示出所选的模型(线性)不可能表示所选输入与目标之间的关系。另一方面,我们完全可以对给定平均星级评分时评论数的分布进行建模。在构建模型时,最好直观地检查输入与输出之间、以及不同输入特征之间的关系。
幂变换:对数变换的推广
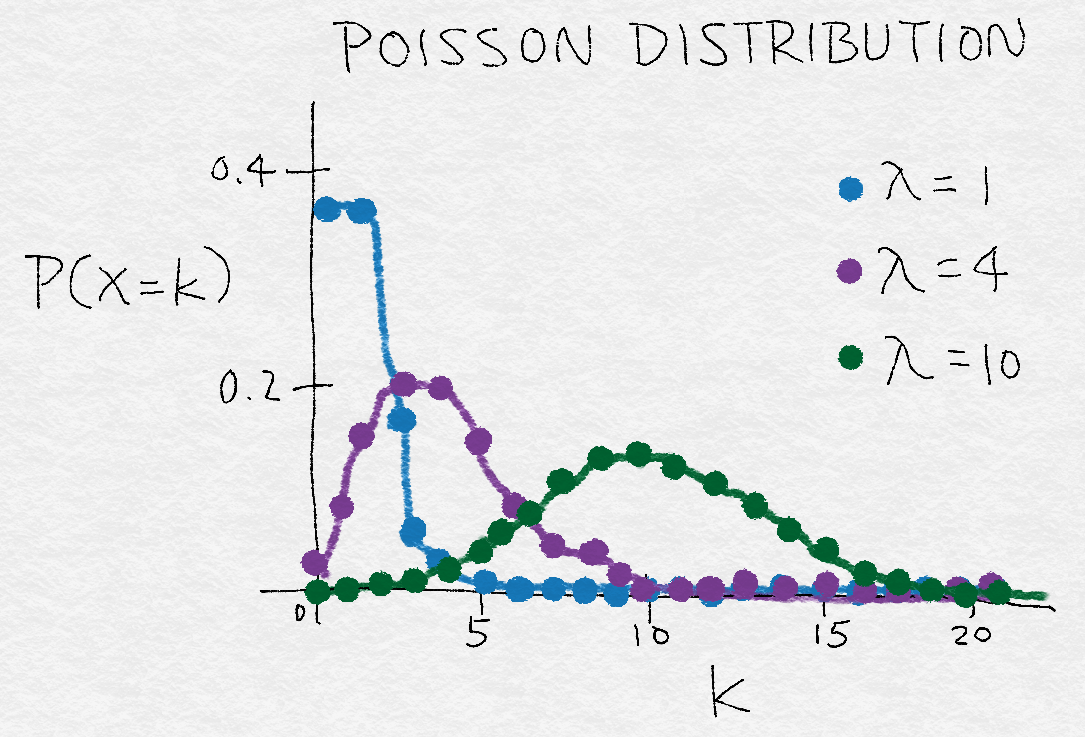
对数变换是被称为幂变换(power transform)的一族变换的具体例子。用统计学的术语说,它们是方差稳定变换(variance-stabilizing transformation)。为了理解为什么方差稳定是好的,考虑泊松分布(Poisson distribution)。这是一个重尾分布,其方差等于均值:因此,它的质量中心越大,方差越大,尾部越重。幂变换改变变量的分布,使方差不再依赖于均值。例如,假设随机变量 \(X\) 服从泊松分布。如果我们对 \(X\) 取平方根进行变换,那么 \(\tilde{X} = \sqrt{X}\) 的方差大致恒定,而不是等于均值。
图 2-11 展示了 λ,它表示分布的均值。随着 λ 增大,不仅分布的众数向右移动,质量也散开,方差变大。
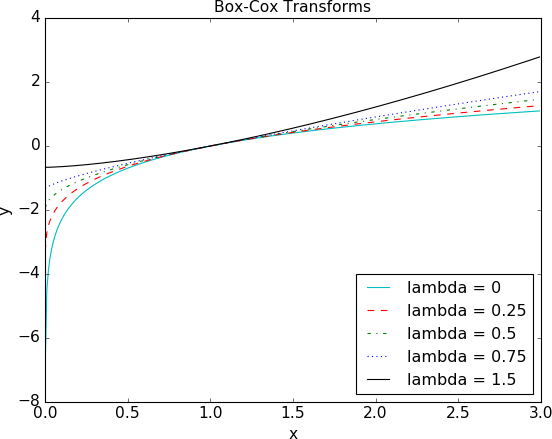
平方根变换和对数变换的一个简单推广称为 Box-Cox 变换:
\[ \tilde{x} = \begin{cases} \frac{x^\lambda - 1}{\lambda} & \text{if } \lambda eq 0, \\ \ln x & \text{if } \lambda = 0. \end{cases} \]图 2-12 展示了 λ = 0(对数变换)、λ = 0.25、λ = 0.5(平方根变换的缩放和平移版本)、λ = 0.75 和 λ = 1.5 时的 Box-Cox 变换。把 λ 设为小于 1 会压缩较大的值,把 λ 设为大于 1 则产生相反的效果。
Box-Cox 公式只对正数数据有效。对于非正数据,可以通过加上一个固定常数来平移数值。应用 Box-Cox 变换或更一般的幂变换时,我们必须确定参数 λ 的值。这可以通过最大似然(maximum likelihood,找到使变换后信号的高斯似然最大化的 λ)或贝叶斯方法来完成。对 Box-Cox 和一般幂变换用法的完整论述超出了本书的范围。感兴趣的读者可以在 Johnston 和 DiNardo(1997)的《计量经济学方法》(Econometric Methods)中找到关于幂变换的更多信息。幸运的是,SciPy 的 stats 包包含 Box-Cox 变换的实现,其中包括寻找最优变换参数。示例 2-12 演示了它在 Yelp 评论数据集上的使用。
示例 2-12:对 Yelp 商家评论数进行 Box-Cox 变换
>>> from scipy import stats
# Continuing from the previous example, assume biz_df contains
# the Yelp business reviews data.
# The Box-Cox transform assumes that input data is positive.
# Check the min to make sure.
>>> biz_df [ 'review_count' ] . min ()
3
# Setting input parameter lmbda to 0 gives us the log transform (without
# constant offset)
>>> rc_log = stats . boxcox ( biz_df [ 'review_count' ], lmbda = 0 )
# By default, the scipy implementation of Box-Cox transform finds the lambda
# parameter that will make the output the closest to a normal distribution
>>> rc_bc , bc_params = stats . boxcox ( biz_df [ 'review_count' ])
>>> bc_params
-0.4106510862321085
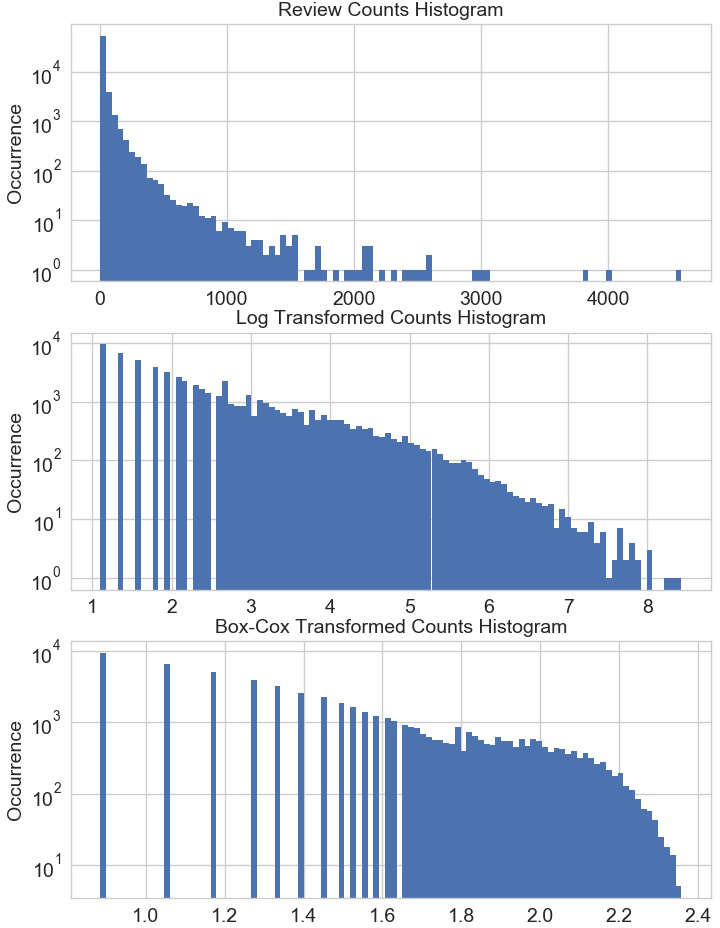
图 2-13 提供了原始计数和变换后计数分布的直观对比(见示例 2-13)。
示例 2-13:可视化原始、对数变换和 Box-Cox 变换后计数的直方图
>>> fig , ( ax1 , ax2 , ax3 ) = plt . subplots ( 3 , 1 )
# original review count histogram
>>> biz_df [ 'review_count' ] . hist ( ax = ax1 , bins = 100 )
>>> ax1 . set_yscale ( 'log' )
>>> ax1 . tick_params ( labelsize = 14 )
>>> ax1 . set_title ( 'Review Counts Histogram' , fontsize = 14 )
>>> ax1 . set_xlabel ( '' )
>>> ax1 . set_ylabel ( 'Occurrence' , fontsize = 14 )
# review count after log transform
>>> biz_df [ 'rc_log' ] . hist ( ax = ax2 , bins = 100 )
>>> ax2 . set_yscale ( 'log' )
>>> ax2 . tick_params ( labelsize = 14 )
>>> ax2 . set_title ( 'Log Transformed Counts Histogram' , fontsize = 14 )
>>> ax2 . set_xlabel ( '' )
>>> ax2 . set_ylabel ( 'Occurrence' , fontsize = 14 )
# review count after optimal Box-Cox transform
>>> biz_df [ 'rc_bc' ] . hist ( ax = ax3 , bins = 100 )
>>> ax3 . set_yscale ( 'log' )
>>> ax3 . tick_params ( labelsize = 14 )
>>> ax3 . set_title ( 'Box-Cox Transformed Counts Histogram' , fontsize = 14 )
>>> ax3 . set_xlabel ( '' )
>>> ax3 . set_ylabel ( 'Occurrence' , fontsize = 14 )
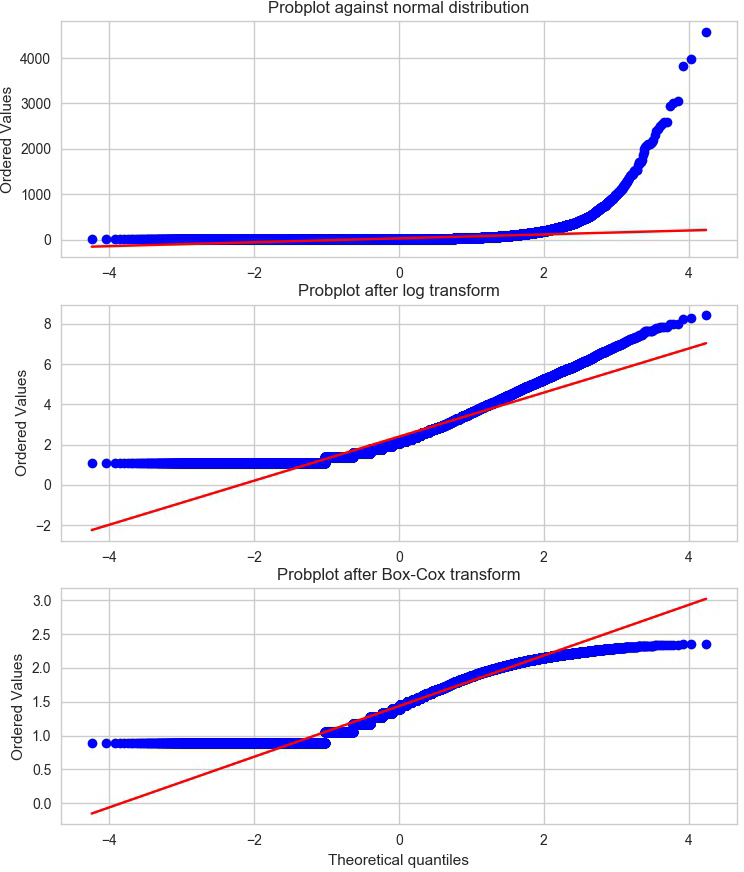
概率图(probability plot),或称 probplot,是一种直观比较数据经验分布与理论分布的简单方法。它本质上是以观测分位数为纵轴、理论分位数为横轴的散点图。图 2-14 展示了原始和变换后的 Yelp 评论计数数据相对于正态分布的概率图(见示例 2-14)。由于观测数据严格为正,而高斯分布可以为负,分位数在负端永远无法匹配。因此,我们的关注点在正侧。在这方面,原始计数明显比正态分布重尾得多。(有序值最高到 4,000,而理论分位数只延伸到 4。)无论是普通对数变换还是最优 Box-Cox 变换,都能把正尾拉近正态。最优 Box-Cox 变换比对数变换更大地压缩尾部,从尾部在红色对角等价线下方变平这一事实可以明显看出。
示例 2-14:原始和变换后计数相对于正态分布的概率图
>>> fig2 , ( ax1 , ax2 , ax3 ) = plt . subplots ( 3 , 1 )
>>> prob1 = stats . probplot ( biz_df [ 'review_count' ], dist = stats . norm , plot = ax1 )
>>> ax1 . set_xlabel ( '' )
>>> ax1 . set_title ( 'Probplot against normal distribution' )
>>> prob2 = stats . probplot ( biz_df [ 'rc_log' ], dist = stats . norm , plot = ax2 )
>>> ax2 . set_xlabel ( '' )
>>> ax2 . set_title ( 'Probplot after log transform' )
>>> prob3 = stats . probplot ( biz_df [ 'rc_bc' ], dist = stats . norm , plot = ax3 )
>>> ax3 . set_xlabel ( 'Theoretical quantiles' )
>>> ax3 . set_title ( 'Probplot after Box-Cox transform' )
特征缩放或归一化
有些特征(如纬度或经度)的值是有界的。其他数值特征(如计数)可能无界增长。作为输入平滑函数的模型,如线性回归、逻辑回归,或任何涉及矩阵的模型,都会受到输入尺度的影响。另一方面,基于树的模型则毫不在乎。如果你的模型对输入特征的尺度敏感,特征缩放(feature scaling)可能会有所帮助。顾名思义,特征缩放改变特征的尺度。有时人们也叫它特征归一化(feature normalization)。特征缩放通常对每个特征单独进行。接下来,我们将讨论几种常见的缩放操作,每种操作都会产生不同的特征值分布。
最小-最大缩放
设 \(x\) 是单个特征值(即某个数据点中该特征的值),\(\min(x)\) 和 \(\max(x)\) 分别是该特征在整个数据集上的最小值和最大值。最小-最大缩放(min-max scaling)把所有特征值压缩(或拉伸)到 [0, 1] 范围内。图 2-15 演示了这一概念。最小-最大缩放的公式是:
\[ \tilde{x} = \frac{x - \min(x)}{\max(x) - \min(x)} \]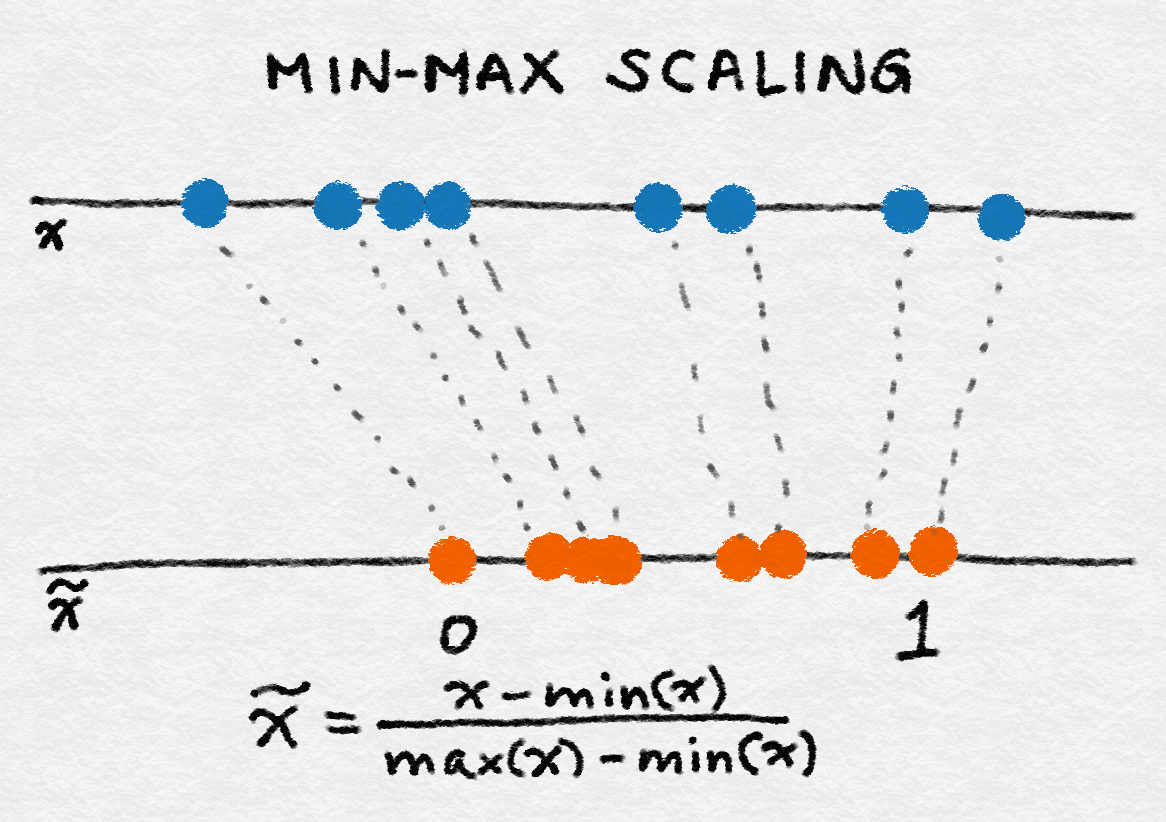
标准化(方差缩放)
特征标准化(standardization)的定义是:
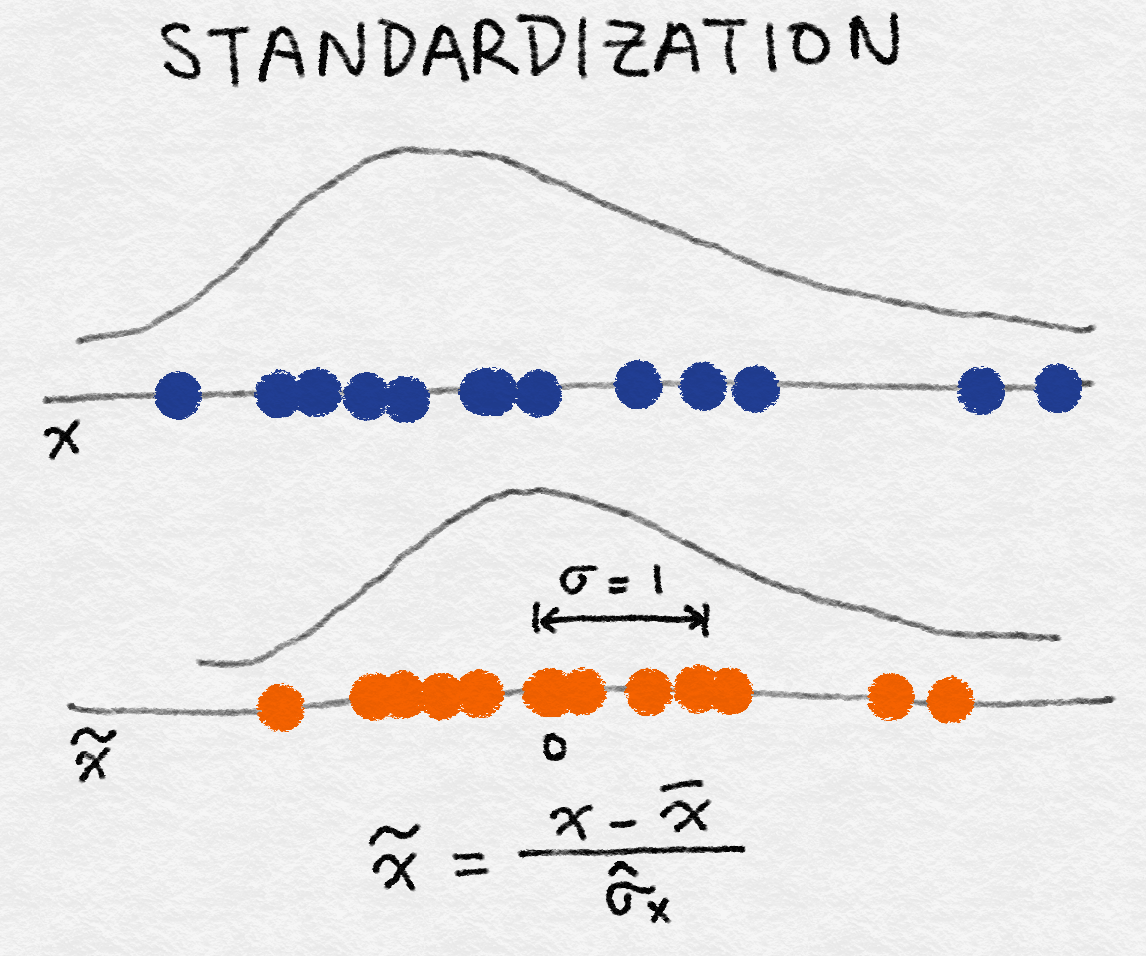
\[ \tilde{x} = \frac{x - \operatorname{mean}(x)}{\sqrt{\operatorname{var}(x)}} \]它减去特征(在所有数据点上)的均值,再除以方差。因此,它也可以称为方差缩放(variance scaling)。缩放后的特征均值为 0,方差为 1。如果原始特征服从高斯分布,那么缩放后的特征也服从高斯分布。图 2-16 是标准化的示意图。
不要"中心化"稀疏数据!
对稀疏特征执行最小-最大缩放和标准化时要小心。两者都会从原始特征值中减去一个量。对于最小-最大缩放,减去的量是当前特征所有值的最小值;对于标准化,是均值。如果减去的量不为零,那么这两种变换可能把大多数值为零的稀疏特征向量变成稠密向量。这反过来可能给分类器带来巨大的计算负担,具体取决于它的实现方式(更不用说如果表示现在包含文档中每个未出现的词,那将是多么可怕!)。词袋(bag-of-words)是一种稀疏表示,大多数分类库都针对稀疏输入进行了优化。
ℓ2 归一化
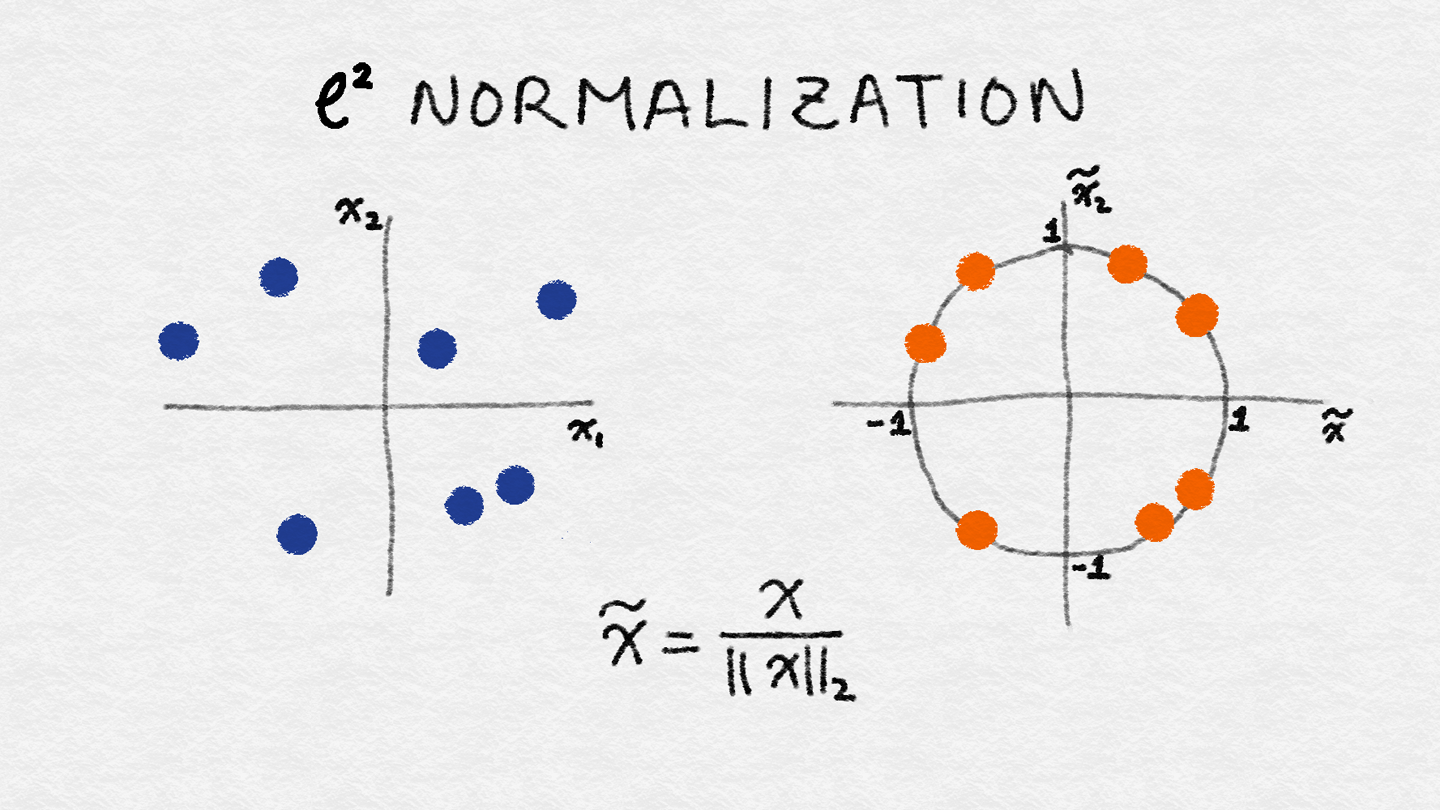
这种技术把原始特征值归一化(除以)所谓的 ℓ2 范数(ℓ2 norm),也称为欧几里得范数(Euclidean norm)。它的定义如下:
\[ \tilde{x} = \frac{x}{\lVert x \rVert_2} \]*ℓ2 范数度量向量在坐标空间中的长度。这个定义可以从著名的毕达哥拉斯定理推导出来,该定理在给定直角三角形两条边的长度时给出斜边的长度:
\[ \lVert x \rVert_2 = \sqrt{x_1^2 + x_2^2 + \cdots + x_m^2} \]ℓ2 范数先对数据点上特征值的平方求和,然后取平方根。经过 ℓ2 归一化后,特征列的范数为 1。这有时也称为 ℓ2 缩放(ℓ2 scaling)。(粗略地说,缩放意味着乘以一个常数,而归一化*可能涉及多种操作。)图 2-17 展示了 ℓ2 归一化。
数据空间与特征空间
注意图 2-17 中的图示是在数据空间中,而不是特征空间。我们也可以对数据点而不是特征做 ℓ2 归一化,这将得到单位范数(范数为 1)的数据向量。关于数据向量与特征向量互补性的讨论,参见“词袋”一节。
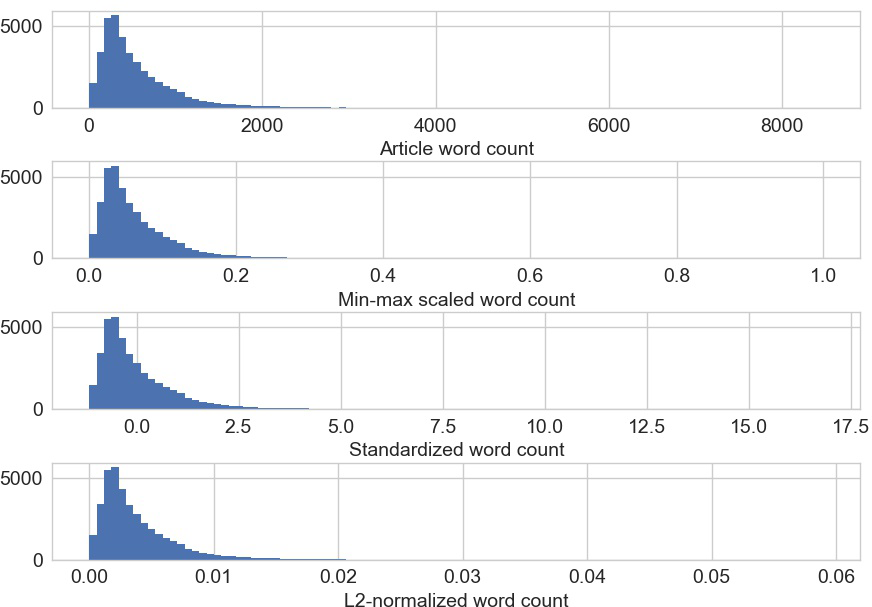
无论采用哪种缩放方法,特征缩放总是把特征除以一个常数(称为归一化常数(normalization constant))。因此,它不会改变单特征分布的形状。我们将用在线新闻文章的词数来说明这一点(见示例 2-15)。
示例 2-15:特征缩放示例
>>> import pandas as pd
>>> import sklearn.preprocessing as preproc
# Load the Online News Popularity dataset
>>> df = pd . read_csv ( 'OnlineNewsPopularity.csv' , delimiter = ', ' )
# Look at the original data - the number of words in an article
>>> df [ 'n_tokens_content' ] . as_matrix ()
array([ 219.,  255.,  211., ...,  442.,  682.,  157.])
# Min-max scaling
>>> df [ 'minmax' ] = preproc . minmax_scale ( df [[ 'n_tokens_content' ]])
>>> df [ 'minmax' ] . as_matrix ()
array([ 0.02584376,  0.03009205,  0.02489969, ...,  0.05215955,
0.08048147,  0.01852726])
# Standardization - note that by definition, some outputs will be negative
>>> df [ 'standardized' ] = preproc . StandardScaler () . fit_transform ( df [[ 'n_tokens_content' ]])
>>> df [ 'standardized' ] . as_matrix ()
array([-0.69521045, -0.61879381, -0.71219192, ..., -0.2218518 ,
0.28759248, -0.82681689])
# L2-normalization
>>> df [ 'l2_normalized' ] = preproc . normalize ( df [[ 'n_tokens_content' ]], axis = 0 )
>>> df [ 'l2_normalized' ] . as_matrix ()
array([ 0.00152439,  0.00177498,  0.00146871, ...,  0.00307663,
0.0047472 ,  0.00109283])
我们还可以可视化不同特征缩放方法下数据的分布(图 2-18)。如示例 2-16所示,与对数变换不同,特征缩放不改变分布的形状;只有数据的尺度发生变化。
示例 2-16:绘制原始和缩放后数据的直方图
>>> fig , ( ax1 , ax2 , ax3 , ax4 ) = plt . subplots ( 4 , 1 )
>>> fig . tight_layout ()
>>> df [ 'n_tokens_content' ] . hist ( ax = ax1 , bins = 100 )
>>> ax1 . tick_params ( labelsize = 14 )
>>> ax1 . set_xlabel ( 'Article word count' , fontsize = 14 )
>>> ax1 . set_ylabel ( 'Number of articles' , fontsize = 14 )
>>> df [ 'minmax' ] . hist ( ax = ax2 , bins = 100 )
>>> ax2 . tick_params ( labelsize = 14 )
>>> ax2 . set_xlabel ( 'Min-max scaled word count' , fontsize = 14 )
>>> ax2 . set_ylabel ( 'Number of articles' , fontsize = 14 )
>>> df [ 'standardized' ] . hist ( ax = ax3 , bins = 100 )
>>> ax3 . tick_params ( labelsize = 14 )
>>> ax3 . set_xlabel ( 'Standardized word count' , fontsize = 14 )
>>> ax3 . set_ylabel ( 'Number of articles' , fontsize = 14 )
>>> df [ 'l2_normalized' ] . hist ( ax = ax4 , bins = 100 )
>>> ax4 . tick_params ( labelsize = 14 )
>>> ax4 . set_xlabel ( 'L2-normalized word count' , fontsize = 14 )
>>> ax4 . set_ylabel ( 'Number of articles' , fontsize = 14 )
特征缩放在一组输入特征的尺度差异悬殊的情况下很有用。例如,热门电商网站的每日访客数可能是十万,而实际销售额可能是数千。如果这两个特征都被投入模型,模型在决定怎么做时需要平衡它们的尺度。输入特征尺度的剧烈变化可能导致模型训练算法的数值稳定性问题。在这些情况下,最好对特征进行标准化。第 4 章 在自然文本处理的语境下详细讨论了特征缩放,包括使用示例。
交互特征
一个简单的两两交互特征(interaction feature)是两个特征的乘积。类比是逻辑与。它用条件对来表达结果:“购买来自邮政编码 98121"且"用户年龄在 18 到 35 岁之间”。基于决策树的模型天然具备这种能力,但广义线性模型通常发现交互特征非常有用。
简单线性模型使用各个输入特征 \(x_1, x_2, \ldots, x_n\) 的线性组合来预测输出 \(y\):
\[ y = w_1 x_1 + w_2 x_2 + \cdots + w_n x_n \]扩展线性模型的一个简单方法是加入成对输入特征的组合,如下所示:
\[ y = w_1 x_1 + w_2 x_2 + \cdots + w_n x_n + w_{1,1} x_1 x_1 + w_{1,2} x_1 x_2 + w_{1,3} x_1 x_3 + \cdots \]这让我们能够捕捉特征之间的交互,因此这些对被称为交互特征。如果 \(x_1\) 和 \(x_2\) 是二值的,那么它们的乘积 \(x_1 x_2\) 就是逻辑函数 \(x_1\) 与 \(x_2\)(AND)。假设问题是根据客户的画像信息预测其偏好。在我们的例子中,交互特征允许模型基于"用户处于某个年龄"且"位于某个地点"来做预测,而不是仅仅基于用户的年龄或地点。
在示例 2-17 中,我们使用 UCI 在线新闻流行度数据集的两两交互特征来预测每篇新闻文章的分享次数。如结果所示,交互特征在准确性上比单一特征带来了一些提升。两者的表现都优于示例 2-9,后者使用文章正文的词数(带或不带对数变换)作为单一预测因子。
示例 2-17:预测中的交互特征示例
>>> from sklearn import linear_model
>>> from sklearn.model_selection import train_test_split
>>> import sklearn.preprocessing as preproc
# Assume df is a Pandas DataFrame containing the UCI Online News Popularity dataset
>>> df . columns
Index(['url', 'timedelta', 'n_tokens_title', 'n_tokens_content',
'n_unique_tokens', 'n_non_stop_words', 'n_non_stop_unique_tokens',
'num_hrefs', 'num_self_hrefs', 'num_imgs', 'num_videos',
'average_token_length', 'num_keywords', 'data_channel_is_lifestyle',
'data_channel_is_entertainment', 'data_channel_is_bus',
'data_channel_is_socmed', 'data_channel_is_tech',
'data_channel_is_world', 'kw_min_min', 'kw_max_min', 'kw_avg_min',
'kw_min_max', 'kw_max_max', 'kw_avg_max', 'kw_min_avg', 'kw_max_avg',
'kw_avg_avg', 'self_reference_min_shares', 'self_reference_max_shares',
'self_reference_avg_sharess', 'weekday_is_monday', 'weekday_is_tuesday',
'weekday_is_wednesday', 'weekday_is_thursday', 'weekday_is_friday',
'weekday_is_saturday', 'weekday_is_sunday', 'is_weekend', 'LDA_00',
'LDA_01', 'LDA_02', 'LDA_03', 'LDA_04', 'global_subjectivity',
'global_sentiment_polarity', 'global_rate_positive_words',
'global_rate_negative_words', 'rate_positive_words',
'rate_negative_words', 'avg_positive_polarity', 'min_positive_polarity',
'max_positive_polarity', 'avg_negative_polarity',
'min_negative_polarity', 'max_negative_polarity', 'title_subjectivity',
'title_sentiment_polarity', 'abs_title_subjectivity',
'abs_title_sentiment_polarity', 'shares'],
dtype='object')
# Select the content-based features as singleton features in the model,
# skipping over the derived features
>>> features = [ 'n_tokens_title' , 'n_tokens_content' ,
... 'n_unique_tokens' , 'n_non_stop_words' , 'n_non_stop_unique_tokens' ,
... 'num_hrefs' , 'num_self_hrefs' , 'num_imgs' , 'num_videos' ,
... 'average_token_length' , 'num_keywords' , 'data_channel_is_lifestyle' ,
... 'data_channel_is_entertainment' , 'data_channel_is_bus' ,
... 'data_channel_is_socmed' , 'data_channel_is_tech' ,
... 'data_channel_is_world' ]
>>> X = df [ features ]
>>> y = df [[ 'shares' ]]
# Create pairwise interaction features, skipping the constant bias term
>>> X2 = preproc . PolynomialFeatures ( include_bias = False ) . fit_transform ( X )
>>> X2 . shape
(39644, 170)
# Create train/test sets for both feature sets
>>> X1_train , X1_test , X2_train , X2_test , y_train , y_test = \
... train_test_split ( X , X2 , y , test_size = 0.3 , random_state = 123 )
>>> def evaluate_feature ( X_train , X_test , y_train , y_test ):
... """Fit a linear regression model on the training set and
... score on the test set"""
... model = linear_model . LinearRegression () . fit ( X_train , y_train )
... r_score = model . score ( X_test , y_test )
... return ( model , r_score )
# Train models and compare score on the two feature sets
>>> ( m1 , r1 ) = evaluate_feature ( X1_train , X1_test , y_train , y_test )
>>> ( m2 , r2 ) = evaluate_feature ( X2_train , X2_test , y_train , y_test )
>>> print ( "R-squared score with singleton features: %0.5f " % r1 )
>>> print ( "R-squared score with pairwise features: %0.10f " % r2 )
R-squared score with singleton features: 0.00924
R-squared score with pairwise features: 0.0113276523
交互特征非常容易构造,但使用起来很昂贵。带两两交互特征的线性模型的训练和评分时间会从 \(O(n)\) 变成 \(O(n^2)\),其中 \(n\) 是单一特征的数量。
有一些方法可以绕开高阶交互特征的计算开销。一种方法是在所有交互特征之上做特征选择。另一种方法是更精心地构造少量复杂特征。
两种策略各有优缺点。特征选择用计算手段为问题挑选最佳特征。(这种技术不限于交互特征。)然而,一些特征选择技术仍然需要用大量特征训练多个模型。
手工构造的复杂特征可以表达力足够强,只需要少量几个,从而减少模型的训练时间——但特征本身的计算可能很昂贵,这增加了模型评分阶段的计算成本。手工构造(或机器学到的)复杂特征的好例子可以在第 8 章中找到。现在让我们看一些特征选择技术。
特征选择
特征选择技术剪除无用的特征,以降低最终模型的复杂度。最终目标是一个简约(parsimonious)的模型,计算更快,预测精度几乎不下降。为了得到这样的模型,一些特征选择技术需要训练不止一个候选模型。换句话说,特征选择不是为了减少训练时间——事实上,有些技术增加了整体训练时间——而是为了减少模型评分时间。
粗略地说,特征选择技术分为三类:
- 过滤法(Filtering)
- 过滤技术预处理特征,去除对模型不太可能有用的特征。例如,可以计算每个特征与响应变量之间的相关性或互信息(mutual information),过滤掉低于阈值的特征。第 3 章 讨论了文本特征这类技术的例子。过滤技术比下面描述的包装法便宜得多,但它们没有考虑所使用的模型。因此,它们可能无法为模型选出正确的特征。最好保守地进行预过滤,以免在有用的特征进入模型训练步骤之前就不小心把它们淘汰掉。
- 包装法(Wrapper methods)
- 这些技术很昂贵,但它们允许你尝试特征的子集,这意味着你不会意外剪除那些单独看没有信息量、但组合起来很有用的特征。包装法把模型当作一个黑盒,为提出的特征子集提供质量分数。另有一个单独的方法迭代地细化子集。
- 嵌入法(Embedded methods)
- 这些方法把特征选择作为模型训练过程的一部分来执行。例如,决策树本质上就在做特征选择,因为它在每个训练步骤选择用一个特征来分裂树。另一个例子是 ℓ1 正则化(ℓ1 regularizer),它可以加到任何线性模型的训练目标中。ℓ1 正则化鼓励使用少量特征而不是大量特征的模型,所以它也被称为对模型的稀疏性约束(sparsity constraint)。嵌入法把特征选择纳入模型训练过程。它们不如包装法强大,但远没有那么昂贵。与过滤法相比,嵌入法选择的是特定于模型的特征。从这个意义上说,嵌入法在计算开销和结果质量之间取得了平衡。
对特征选择的完整论述超出了本书的范围。感兴趣的读者可以参考 Guyon 和 Elisseeff(2003)的综述论文。
小结
本章讨论了许多常见的数值特征工程技术,如量化、缩放(又称归一化)、对数变换(幂变换的一种)和交互特征,并简要总结了特征选择技术——处理大量交互特征所必需的。在统计机器学习中,所有数据最终都会归结为数值特征。因此,条条大路最终都通向某种数值特征工程技术。把这些工具留在手边,为特征工程的终局之战做好准备吧!
参考文献
Bertin-Mahieux, Thierry, Daniel P.W. Ellis, Brian Whitman, and Paul Lamere. “The Million Song Dataset.” Proceedings of the 12th International Society for Music Information Retrieval Conference (2011): 591-596.
Fernandes, K., P. Vinagre, and P. Cortez. “A Proactive Intelligent Decision Support System for Predicting the Popularity of Online News.” Proceedings of the 17th Portuguese Conference on Artificial Intelligence (2015): 535-546.
Guyon, Isabell, and André Elisseeff. “An Introduction to Variable and Feature Selection.” Journal of Machine Learning Research Special Issue on Variable and Feature Selection 3 (2003): 1157-1182.
Johnston, Jack, and John DiNardo. Econometric Methods. 4th ed. New York: McGraw Hill, 1997.