机器学习流水线
在深入特征工程之前,让我们先花点时间看一看机器学习的整体流水线(pipeline)。这将帮助我们在大图景中找准自己的位置。为此,我们首先对数据(data)和模型(model)这类基本概念做一些思考。
数据
我们所说的数据,是对现实世界现象的观测。例如,股票市场数据可能包含对每日股价的观测、各家公司发布的盈利公告,甚至还有权威人士的观点文章。个人生物特征数据可以包括对我们逐分钟心率、血糖水平、血压等的测量。客户情报数据包括诸如"爱丽丝在周日买了两本书"“鲍勃浏览了网站上的这些页面"“查理点击了上周特惠活动里的链接"之类的观测。我们可以举出无数跨领域的数据例子。
每一条数据都为我们提供了观察现实某个有限侧面的小窗口。所有这些观测的集合,让我们得以窥见整体图景。但这个图景是凌乱的,因为它由成千上万个小碎片拼成,而且总有测量噪声(measurement noise)和缺失的碎片(missing pieces)。
任务
我们为什么收集数据?因为有些问题可以借助数据来回答——比如"我该投资哪些股票?““我怎样才能活得更健康?“或者"我怎样才能理解顾客不断变化的口味,好让我的业务更好地服务他们?”
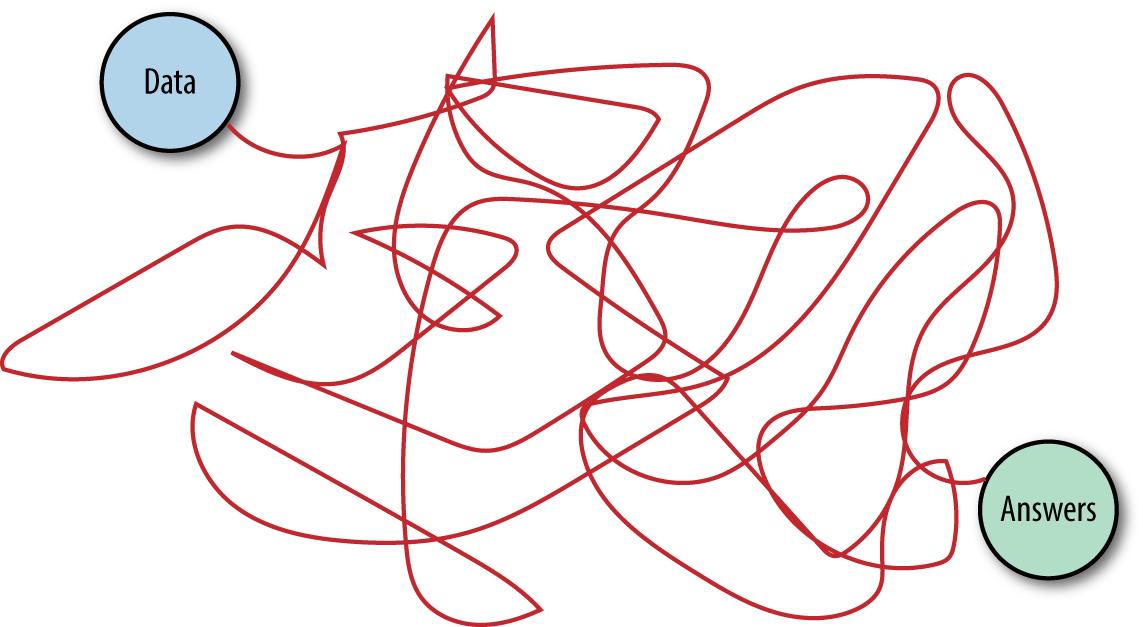
从数据到答案的路径充满了假起点和死胡同(见 图 1-1)。起初看起来很有前景的方法可能行不通;原本只是一个直觉的猜测,最终却可能通向最佳方案。与数据打交道的工作流常常是多阶段、迭代式的过程。例如,股价在交易所被观测到,由汤森路透(Thomson Reuters)这样的中间商聚合,存入数据库,被一家公司买下,转换成 Hadoop 集群上的 Hive 存储,由脚本从存储中取出,经过二次采样、加工和清洗,转储到文件里,再转换成你可以在 R、Python 或 Scala 中最喜欢的建模库中尝试的格式。然后,预测结果被转储回 CSV 文件,由评估器解析;模型经过多次迭代,由你的生产团队用 C++ 或 Java 重写,并在全部数据上运行,最后预测结果被灌入另一个数据库。
然而,如果我们暂且忽略工具和系统的杂乱,或许会发现这个过程涉及机器学习的两大支柱数学实体:模型和特征(feature)。
模型
试图通过数据理解世界,就像用一堆多余碎片去拼一幅充满噪声、残缺不全的拼图。这正是数学建模——尤其是统计建模——登场的时刻。统计学的语言包含了许多刻画数据常见特征的术语,比如错误(wrong)、冗余(redundant)或缺失(missing)。错误数据是测量失误的结果。冗余数据包含多个传达了完全相同信息的侧面。例如,星期几既可以作为取值为"星期一"“星期二”……“星期日"的分类变量出现,又可以再次作为 0 到 6 之间的整数值出现。如果某些数据点缺少星期几的信息,那你就遇到了缺失数据。
数据的数学模型(mathematical model)描述了数据不同侧面之间的关系。例如,一个预测股价的模型可能是一个把公司的盈利历史、历史股价和所属行业映射到预测股价的公式。一个推荐音乐的模型可能度量用户之间的相似度(基于他们的收听习惯),并向收听了很多相同歌曲的用户推荐相同的艺人。
数学公式(mathematical formula)把数值量相互关联起来。但原始数据往往不是数值。(“爱丽丝在星期三买了《指环王》三部曲"这个行为不是数值,她随后写的书评也不是数值。)必须有一个部件把两者连接起来。这就是特征登场的地方。
特征
特征是原始数据的数值表示。把原始数据变成数值度量的方法有很多,因此特征最终可以长成各种各样的形态。自然,特征必须源于可用的数据类型。不那么显而易见的是,特征也与模型绑定在一起:某些模型更适合某些类型的特征,反之亦然。合适的特征与手头的任务相关,并且应该易于模型消化。特征工程(feature engineering)就是在给定数据、模型和任务的情况下,制定最合适特征的过程。
特征的数量也很重要。如果有信息量的特征不够,模型将无法完成最终任务。如果特征太多,或者大部分特征不相关,模型训练将更昂贵、更棘手。训练过程中可能出岔子,影响模型的性能。
模型评估
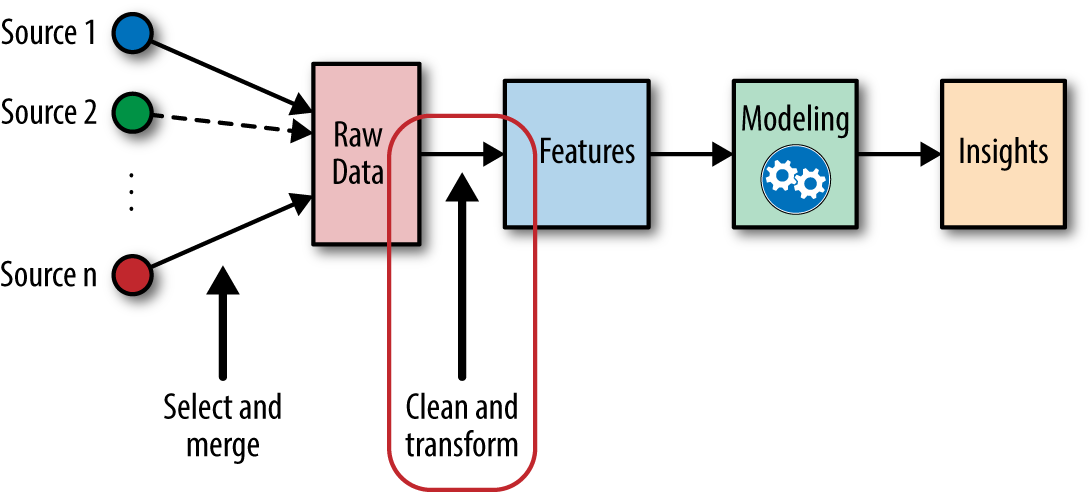
特征和模型位于原始数据与期望洞察之间(见 图 1-2)。在机器学习工作流中,我们不仅要挑选模型,还要挑选特征。这是一个双关节杠杆(double-jointed lever),一方的选择会影响另一方。好的特征使后续建模步骤变得容易,并使最终模型更能胜任目标任务。糟糕的特征可能需要复杂得多的模型才能达到同样的性能水平。在本书其余部分,我们将介绍不同类型的特征,并讨论它们对不同类型数据和模型的优缺点。闲话少说,让我们开始吧!