组织机器学习项目
终于,我们到了可以开始构建第一个机器学习(machine learning)模型的阶段了。
那么,我们准备好了吗?
在开始之前,我们必须先处理好几件事。请记住,我们将在 IDE(集成开发环境)/文本编辑器中工作,而不是在 Jupyter 笔记本(Jupyter Notebook)中。你也可以在 Jupyter 笔记本中工作,这完全取决于你自己。不过,我只会把 Jupyter 用于数据探索以及绘制图表之类的任务。我们将以这样的方式来构建分类框架:让大多数问题都能即插即用(plug n’ play)。你将能够在不对代码做太多修改的情况下训练模型,而且当你改进模型时,你还可以用 git 来跟踪它们。
首先,让我们看一下文件的结构。对于你正在做的任何一个项目,都要创建一个新文件夹。在这个例子中,我把项目命名为 project。
project 文件夹的内部看起来应该像下面这样。
.
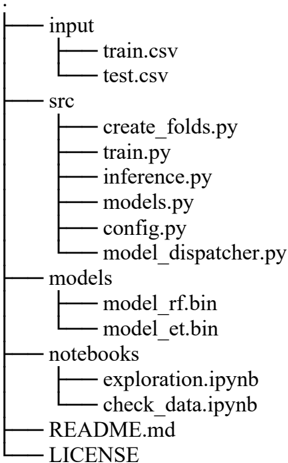
让我们来看看这些文件夹和文件分别是干什么的。
input/:这个文件夹存放你机器学习项目的所有输入文件和数据集。如果你在做自然语言处理(NLP)项目,可以把嵌入(embedding)文件放在这里。如果你在做图像项目,所有图片都放在这个文件夹下的子文件夹中。
src/:我们会把与项目相关的所有 Python 脚本都放在这里。如果我说到一个 Python 脚本,即任何 *.py 文件,它都存放在 src 文件夹中。
models/:这个文件夹存放所有训练好的模型。
notebooks/:所有 Jupyter 笔记本(即任何 *.ipynb 文件)都存放在 notebooks 文件夹中。
README.md:这是一个 Markdown 文件,你可以在里面描述你的项目,并写出如何训练模型、或者如何在生产环境中部署(serve)模型的说明。
LICENSE:这是一个简单的文本文件,包含项目的许可证,例如 MIT、Apache 等。深入讨论各种许可证已经超出了本书的范围。
假设你正在构建一个对 MNIST 数据集进行分类的模型(这个数据集几乎出现在每一本机器学习书中)。如果你还记得,我们在交叉验证(cross-validation)那一章也提到过 MNIST 数据集。所以我就不解释这个数据集长什么样了。网上有很多不同格式的 MNIST 数据集,但我们将使用该数据集的 CSV 格式。
在这种数据格式中,CSV 的每一行都包含图像的标签(label)以及 784 个像素值,取值范围从 0 到 255。该数据集以这种格式包含 60000 张图像。
我们可以用 pandas 轻松地读取这种数据格式。
请注意,虽然图 1 中显示的像素值全部是 0,但实际情况并非如此。
图 1:CSV 格式的 MNIST 数据集
| 标签 | 1x1 | 1x2 | 1x3 | 1x4 | 1x5 | 1x6 | 1x7 | 1x8 | 1x9 | 28x19 | 28x20 | 28x21 | 28x22 | 28x23 | 28x24 | 28x25 | 28x26 | 28x27 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 5 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 2 | 4 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 3 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 4 | 9 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
让我们看一下这个数据集中标签列的计数。
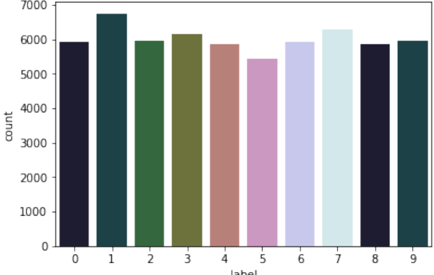
图 2:MNIST 数据集中标签的计数
对这个数据集,我们不需要做更多的探索。我们已经知道我们拥有什么,也没有必要对不同像素值绘制图表。从图 2 可以很清楚地看出,标签的分布相当不错,而且很均衡。因此我们可以使用准确率(accuracy)/F1 分数(F1 score)作为评估指标(metric)。这正是处理机器学习问题时的第一步:确定评估指标!
现在,我们可以写一点代码了。我们需要创建 src/ 文件夹和一些 Python 脚本。
请注意,训练用的 CSV 文件位于 input/ 文件夹中,名为 mnist_train.csv。
对于这样一个项目,这些文件应该长什么样呢?
应该创建的第一个脚本是 create_folds.py。
它会在 input/ 文件夹中创建一个名为 mnist_train_folds.csv 的新文件,它与 mnist_train.csv 内容相同。唯一的不同之处在于:这个 CSV 被打乱了顺序,并且新增了一个名为 kfold 的列。
一旦我们决定了要使用哪种评估指标,并且创建好了折(fold),我们就可以开始创建基础模型了。这一步在 train.py 中完成。
# src/train.py
import joblib
import pandas as pd
from sklearn import metrics
from sklearn import tree

def run(fold):
    # read the training data with folds
    df = pd.read_csv("../input/mnist_train_folds.csv")

    # training data is where kfold is not equal to provided fold
    # also, note that we reset the index
    df_train = df[df.kfold != fold].reset_index(drop=True)

    # validation data is where kfold is equal to provided fold
    df_valid = df[df.kfold == fold].reset_index(drop=True)

    # drop the label column from dataframe and convert it to
    # a numpy array by using .values.
    # target is label column in the dataframe
    x_train = df_train.drop("label", axis=1).values
    y_train = df_train.label.values

    # similarly, for validation, we have
    x_valid = df_valid.drop("label", axis=1).values
    y_valid = df_valid.label.values

    # initialize simple decision tree classifier from sklearn
    clf = tree.DecisionTreeClassifier()

    # fit the model on training data
    clf.fit(x_train, y_train)

    # create predictions for validation samples
    preds = clf.predict(x_valid)

    # calculate & print accuracy
    accuracy = metrics.accuracy_score(y_valid, preds)
    print(f"Fold={fold}, Accuracy={accuracy}")

    # save the model
    joblib.dump(clf, f"../models/dt_{fold}.bin")

if __name__ == "__main__":
    run(fold=0)
    run(fold=1)
    run(fold=2)
    run(fold=3)
    run(fold=4)
你可以通过在控制台运行 python train.py 来执行这个脚本。
❯ python train.py
Fold=0, Accuracy=0.8680833333333333
Fold=1, Accuracy=0.8685
Fold=2, Accuracy=0.8674166666666666
Fold=3, Accuracy=0.8703333333333333
Fold=4, Accuracy=0.8699166666666667
当你仔细看这个训练脚本时,会发现仍然有一些东西是硬编码(hardcoded)的,例如折号、训练文件和输出文件夹。
因此,我们可以创建一个包含所有这些信息的配置文件:config.py。
# config.py
TRAINING_FILE = "../input/mnist_train_folds.csv"
MODEL_OUTPUT = "../models/"
我们也要对训练脚本做一些修改。现在训练脚本会使用配置文件了,这样就更容易更换数据或模型输出位置。
# train.py
import os
import config
import joblib
import pandas as pd
from sklearn import metrics
from sklearn import tree

def run(fold):
    # read the training data with folds
    df = pd.read_csv(config.TRAINING_FILE)

    # training data is where kfold is not equal to provided fold
    # also, note that we reset the index
    df_train = df[df.kfold != fold].reset_index(drop=True)

    # validation data is where kfold is equal to provided fold
    df_valid = df[df.kfold == fold].reset_index(drop=True)

    # drop the label column from dataframe and convert it to
    # a numpy array by using .values.
    # target is label column in the dataframe
    x_train = df_train.drop("label", axis=1).values
    y_train = df_train.label.values

    # similarly, for validation, we have
    x_valid = df_valid.drop("label", axis=1).values
    y_valid = df_valid.label.values

    # initialize simple decision tree classifier from sklearn
    clf = tree.DecisionTreeClassifier()

    # fir the model on training data
    clf.fit(x_train, y_train)

    # create predictions for validation samples
    preds = clf.predict(x_valid)

    # calculate & print accuracy
    accuracy = metrics.accuracy_score(y_valid, preds)
    print(f"Fold={fold}, Accuracy={accuracy}")

    # save the model
    joblib.dump(
        clf,
        os.path.join(config.MODEL_OUTPUT, f"dt_{fold}.bin")
    )

if __name__ == "__main__":
    run(fold=0)
    run(fold=1)
    run(fold=2)
    run(fold=3)
    run(fold=4)
请注意,我没有指出这个训练脚本和之前那个脚本之间的差异。请仔细对比两者,自己找出不同之处。差异并不多。
关于训练脚本,还有一件可以改进的事。如你所见,我们对每一个折都多次调用 run 函数。有时候,在同一个脚本里运行多个折并不是个好主意,因为内存消耗可能会不断增长,程序可能会崩溃。为了解决这个问题,我们可以给训练脚本传递命令行参数。我喜欢用 argparse 来做这件事。
# train.py
import argparse
. . .
if __name__ == "__main__":
    # initialize ArgumentParser class of argparse
    parser = argparse.ArgumentParser()

    # add the different arguments you need and their type
    # currently, we only need fold
    parser.add_argument(
        "--fold",
        type=int
    )

    # read the arguments from the command line
    args = parser.parse_args()

    # run the fold specified by command line arguments
    run(fold=args.fold)
现在,我们可以再次运行这个 Python 脚本了,但只针对给定的折。
❯ python train.py --fold 0
Fold=0, Accuracy=0.8656666666666667
如果你仔细看,会发现我们折 0 的分数和之前略有不同。这是因为模型中的随机性(randomness)。我们会在后面的章节中讨论如何处理随机性。
现在,如果你愿意,可以创建一个 shell 脚本,为不同的折放入不同的命令,然后把它们一起运行,如下所示。
#!/bin/sh
python train.py --fold 0
python train.py --fold 1
python train.py --fold 2
python train.py --fold 3
python train.py --fold 4
你可以用下面的命令来运行它。
❯ sh run.sh
Fold=0, Accuracy=0.8675
Fold=1, Accuracy=0.8693333333333333
Fold=2, Accuracy=0.8683333333333333
Fold=3, Accuracy=0.8704166666666666
Fold=4, Accuracy=0.8685
到目前为止我们已经取得了不小的进展,但如果再看一眼我们的训练脚本,仍然有一些东西在限制我们,例如模型。模型被硬编码在训练脚本里,要更换模型的唯一方式就是修改脚本。因此,我们将创建一个名为 model_dispatcher.py 的新 Python 脚本。正如它的名字所示,model_dispatcher.py 会把我们的模型分发(dispatch)给训练脚本。
# model_dispatcher.py
from sklearn import tree

models = {
    "decision_tree_gini": tree.DecisionTreeClassifier(
        criterion="gini"
    ),
    "decision_tree_entropy": tree.DecisionTreeClassifier(
        criterion="entropy"
    ),
}
model_dispatcher.py 从 scikit-learn 中导入 tree,并定义了一个字典,键是模型的名字,值是模型本身。这里我们定义了两棵不同的决策树(decision tree):一棵使用 gini 准则(criterion),另一棵使用 entropy。要使用 model_dispatcher.py,我们需要对训练脚本做一些修改。
# train.py
import argparse
import os
import joblib
import pandas as pd
from sklearn import metrics
import config
import model_dispatcher

def run(fold, model):
    # read the training data with folds
    df = pd.read_csv(config.TRAINING_FILE)

    # training data is where kfold is not equal to provided fold
    # also, note that we reset the index
    df_train = df[df.kfold != fold].reset_index(drop=True)

    # validation data is where kfold is equal to provided fold
    df_valid = df[df.kfold == fold].reset_index(drop=True)

    # drop the label column from dataframe and convert it to
    # a numpy array by using .values.
    # target is label column in the dataframe
    x_train = df_train.drop("label", axis=1).values
    y_train = df_train.label.values

    # similarly, for validation, we have
    x_valid = df_valid.drop("label", axis=1).values
    y_valid = df_valid.label.values

    # fetch the model from model_dispatcher
    clf = model_dispatcher.models[model]

    # fir the model on training data
    clf.fit(x_train, y_train)

    # create predictions for validation samples
    preds = clf.predict(x_valid)

    # calculate & print accuracy
    accuracy = metrics.accuracy_score(y_valid, preds)
    print(f"Fold={fold}, Accuracy={accuracy}")

    # save the model
    joblib.dump(
        clf,
        os.path.join(config.MODEL_OUTPUT, f"dt_{fold}.bin")
    )

if __name__ == "__main__":
    parser = argparse.ArgumentParser()

    parser.add_argument(
        "--fold",
        type=int
    )

    parser.add_argument(
        "--model",
        type=str
    )

    args = parser.parse_args()

    run(
        fold=args.fold,
        model=args.model
    )
train.py 有几个主要的变化:
- 导入 model_dispatcher
- 给 ArgumentParser 添加 –model 参数
- 给 run() 函数添加 model 参数
- 使用分发器根据名称获取模型
现在,我们可以用下面的命令运行脚本:
❯ python train.py --fold 0 --model decision_tree_gini
Fold=0, Accuracy=0.8665833333333334
或者用下面的命令:
❯ python train.py --fold 0 --model decision_tree_entropy
Fold=0, Accuracy=0.8705833333333334
现在,如果你要添加一个新模型,你只需要修改 model_dispatcher.py。让我们试试添加随机森林(Random Forest),看看我们的准确率会有什么变化。
# model_dispatcher.py
from sklearn import ensemble
from sklearn import tree

models = {
    "decision_tree_gini": tree.DecisionTreeClassifier(
        criterion="gini"
    ),
    "decision_tree_entropy": tree.DecisionTreeClassifier(
        criterion="entropy"
    ),
    "rf": ensemble.RandomForestClassifier(),
}
让我们运行这段代码。
❯ python train.py --fold 0 --model rf
Fold=0, Accuracy=0.9670833333333333
哇,一个简单的改动就给分数带来了如此巨大的提升!现在让我们用 run.sh 脚本跑全部 5 个折吧!
#!/bin/sh
python train.py --fold 0 --model rf
python train.py --fold 1 --model rf
python train.py --fold 2 --model rf
python train.py --fold 3 --model rf
python train.py --fold 4 --model rf
分数如下所示。
❯ sh run.sh
Fold=0, Accuracy=0.9674166666666667
Fold=1, Accuracy=0.9698333333333333
Fold=2, Accuracy=0.96575
Fold=3, Accuracy=0.9684166666666667
Fold=4, Accuracy=0.9666666666666667
MNIST 是一个几乎在每本书、每个博客里都会被讨论的问题。但我试图把这个问题的趣味性发挥出来,并向你展示如何为几乎所有你现在正在做、或者打算在不久的将来做的机器学习项目编写一个基础框架。改进这个 MNIST 模型以及这个框架的方法有很多种,我们会在后面的章节中看到。
我在训练脚本中用到了一些脚本,比如 model_dispatcher.py 和 config.py,并把它们导入进来。请注意,我没有使用 import *,你也不应该使用。如果我用了 import *,你就永远不会知道 models 字典是从哪里来的。写出优质、易懂的代码是一个人能拥有的重要品质,而很多数据科学家都忽略了这一点。如果你做的项目别人不用咨询你就能看懂和使用,你就节省了他们的时间,也节省了你自己的时间,你可以把这些时间投入到改进项目或开展新项目上。