监督学习与无监督学习
在处理机器学习问题时,通常有两类数据(以及两类机器学习模型):
- 监督数据(supervised data):总是有一个或多个与之关联的目标(target)。
- 无监督数据(unsupervised data):没有任何目标变量(target variable)。
监督问题(supervised problem)比无监督问题更容易处理。要求我们预测某个值的问题被称为监督问题。例如,如果问题是根据历史房价来预测房价,特征包括是否有医院、学校或超市,到最近公共交通的距离等,这就是一个监督问题。类似地,当我们获得猫和狗的图像,并且事先知道哪些是猫、哪些是狗,如果任务是创建一个模型来预测给定图像是猫还是狗,这个问题就被视为监督问题。
图 1:一个监督数据集。
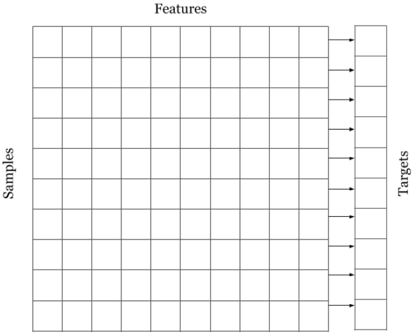
如图 1 所示,数据中的每一行都与一个目标或标签(label)相关联。列是不同的特征(features),行代表不同的数据点,通常称为样本(samples)。这个例子展示了十个样本,每个样本有十个特征和一个目标变量,目标变量既可以是数字也可以是类别。如果目标是类别,问题就变成了分类问题(classification problem);如果目标是实数,问题就被定义为回归问题(regression problem)。因此,监督问题可以分为两个子类:
- 分类(Classification):预测一个类别,例如狗或猫。
- 回归(Regression):预测一个值,例如房价。
必须指出的是,有时根据评估所用的指标,我们可能会在分类场景中使用回归。这一点我们稍后会讲到。
另一类机器学习问题是无监督类型。无监督数据集没有与之关联的目标,一般来说,与监督问题相比处理起来更具挑战性。
假设你在一个处理信用卡交易的金融公司工作。每秒钟都会涌入大量数据。唯一的问题是,很难找到人来把每一笔交易标记为有效或真实交易,或标记为欺诈。当我们没有任何关于某笔交易是欺诈还是真实的信息时,问题就变成了无监督问题。要解决这类问题,我们必须考虑数据可以分成多少个簇(cluster)。聚类(clustering)是可以用于此类问题的方法之一,但必须指出,还有其他几种方法可以应用于无监督问题。对于欺诈检测问题,我们可以说数据可以分为两类(欺诈或真实)。
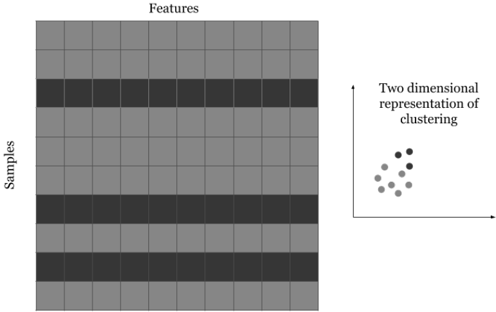
当我们知道簇的数量时,就可以对无监督问题使用聚类算法。在图 2 中,数据被假定有两类,深色代表欺诈,浅色代表真实交易。然而,在聚类方法应用之前,这些类别对我们来说是未知的。应用聚类算法之后,我们应该能够区分这两个假定的目标。为了理解无监督问题,我们还可以使用许多分解技术,例如主成分分析(Principal Component Analysis, PCA)、t-分布随机邻域嵌入(t-distributed Stochastic Neighbour Embedding, t-SNE)等。
监督问题更容易处理,因为它们的评估很容易。我们将在后面的章节中了解更多关于评估技术的内容。然而,评估无监督算法的结果具有挑战性,需要大量的人工干预或启发式方法。在本书中,我们将主要关注监督数据和模型,但这并不意味着我们会忽略无监督数据问题。
图 2:一个无监督数据集。
大多数时候,当人们开始接触数据科学或机器学习时,他们从非常著名的数据集开始,例如泰坦尼克号数据集或鸢尾花数据集,这些都是监督问题。在泰坦尼克号数据集中,你必须根据船票等级、性别、年龄等因素预测泰坦尼克号上乘客的存活情况。类似地,在鸢尾花数据集中,你必须根据花萼宽度、花瓣长度、花萼长度和花瓣宽度等因素预测花的种类。
无监督数据集可能包括用于客户细分的数据集。例如,你有访问你的电子商务网站的客户数据,或者访问商店或商场的客户数据,你想把他们划分或聚类成不同的类别。无监督数据集的另一个例子可能包括信用卡欺诈检测,或者只是对若干图像进行聚类。
大多数时候,也可以把监督数据集转换成无监督数据集,看看它们绘制出来是什么样子。
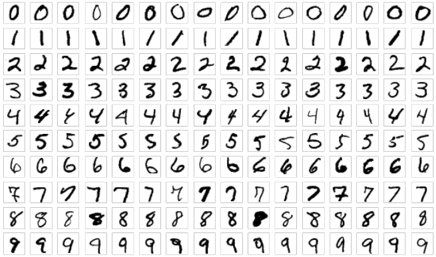
例如,让我们看看图 3 中的数据集。图 3 展示的是 MNIST 数据集,这是一个非常流行的手写数字数据集,它是一个监督问题:给你数字的图像以及与它们相关联的正确标签。你必须构建一个模型,在只提供图像时能够识别出它是哪个数字。
这个数据集很容易被转换成无监督设置来做基础的可视化。
图 3:MNIST 数据集 [1]
如果我们对这个数据集做 t-分布随机邻域嵌入(t-SNE)分解,可以看到,仅用图像像素的两个分量,我们就能在一定程度上把图像分离开来。如图 4 所示。
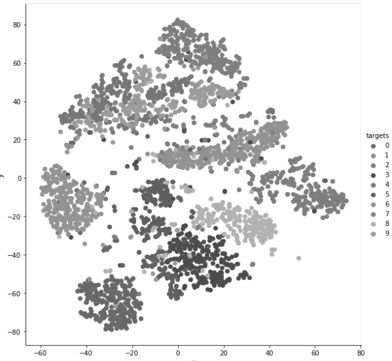
图 4:MNIST 数据集的 t-SNE 可视化。使用了 3000 张图像。
让我们看看这是怎么做到的。首先也是最重要的是导入所有必需的库。
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import seaborn as sns
from sklearn import datasets
from sklearn import manifold

%matplotlib inline
我们使用 matplotlib 和 seaborn 来绘图,numpy 来处理数值数组,pandas 来从数值数组创建数据框(dataframe),scikit-learn(sklearn)来获取数据和执行 t-SNE。
导入之后,我们需要下载数据并单独读取,或者使用 sklearn 内置的提供 MNIST 数据集的函数。
data = datasets.fetch_openml(
    'mnist_784', version=1, return_X_y=True
)
pixel_values, targets = data
targets = targets.astype(int)
在这部分代码中,我们使用 sklearn datasets 获取了数据,得到了一个像素值数组和另一个目标数组。由于目标是字符串类型,我们把它们转换成整数。
pixel_values 是一个形状为 70000x784 的二维数组。共有 70000 张不同的图像,每张大小为 28x28 像素。把 28x28 展平就得到 784 个数据点。
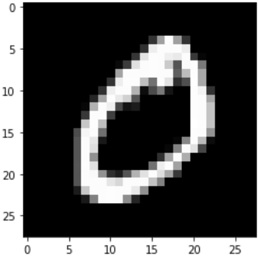
我们可以把数据集中的样本重塑回原始形状,然后用 matplotlib 绘制出来,从而对它们进行可视化。
single_image = pixel_values[1, :].reshape(28, 28)
plt.imshow(single_image, cmap='gray')
这段代码将绘制出类似下图所示的图像:
图 5:绘制 MNIST 数据集中的单张图像。
最重要的步骤在我们获取数据之后。
tsne = manifold.TSNE(n_components=2, random_state=42)
transformed_data = tsne.fit_transform(pixel_values[:3000, :])
这一步创建了数据的 t-SNE 变换。我们只使用两个分量,因为这样可以在二维空间中很好地可视化。这里的 transformed_data 是一个形状为 3000x2 的数组(3000 行 2 列)。这样的数据可以通过对数组调用 pd.DataFrame 转换成 pandas 数据框。
tsne_df = pd.DataFrame(
    np.column_stack((transformed_data, targets[:3000])),
    columns=["x", "y", "targets"]
)
tsne_df.loc[:, "targets"] = tsne_df.targets.astype(int)
这里我们从 numpy 数组创建了一个 pandas 数据框。有三列:x、y 和 targets。x 和 y 是 t-SNE 分解得到的两个分量,targets 是实际的数字。这样我们就得到了一个如图 6 所示的数据框。
图 6:包含 t-SNE 分量和目标的 pandas 数据框前 10 行。
| x | y | targets |
|---|---|---|
| -5.281551 | -28.952768 | 5 |
| -26.105896 | -68.069321 | 0 |
| -42.503582 | 35.580391 | 4 |
| 38.893967 | 26.663395 | 1 |
| -14.770573 | 35.433247 | 9 |
| 63.997231 | -1.102326 | 2 |
| -6.551701 | 9.943600 | 1 |
| 20.086042 | -44.003902 | 3 |
| -0.806248 | 12.682267 | 1 |
| -1.481194 | 45.506077 | 4 |
最后,我们可以用 seaborn 和 matplotlib 来绘制它。
grid = sns.FacetGrid(tsne_df, hue="targets", size=8)
grid.map(plt.scatter, "x", "y").add_legend()
这是可视化无监督数据集的一种方式。我们还可以对同一数据集做 k-means 聚类(k-means clustering),看看它在无监督设置下的表现。有一个问题总是被问到:如何在 k-means 聚类中找到最优的簇数量。其实,没有正确的答案。你必须通过交叉验证(cross-validation)来找到这个数量。交叉验证将在本书后面讨论。请注意,上述代码是在 jupyter notebook 中运行的。
在本书中,对于像上面示例这样的简单事情和绘图,我们将使用 jupyter。对于本书中的大部分内容,我们将使用 python 脚本。你可以选择使用哪种方式,因为结果是一样的。
MNIST 是一个监督分类问题,我们把它转换成无监督问题只是为了检查它是否能得到某种好的结果,而显然,用 t-SNE 分解我们确实得到了不错的结果。如果我们使用分类算法,结果会更好。什么是分类算法,如何使用它们?让我们在接下来的章节中看看。
[1] 图片来源:By Josef Steppan - Own work, CC BY-SA 4.0, https://commons.wikimedia.org/w/index.php?curid=64810040