全局搜索方法(Global Search Methods)
如第 10 章所述,全局搜索方法(global search method)会研究一组多样的潜在解。本章将在选择合适特征子集的背景下讨论两种方法:遗传算法(genetic algorithm)和模拟退火(simulated annealing)。还有其他多种全局搜索方法也可以使用,例如粒子群优化(particle swarm optimization)和同步扰动随机逼近(simultaneous perturbation stochastic approximation)。Spall (2005) 和 Weise (2011) 是这类优化技术的综合性参考资料。
在继续之前,将讨论朴素贝叶斯(naive Bayes)分类模型。本章将全程使用该分类器来演示全局搜索方法。
12.1 朴素贝叶斯模型
为了说明本章使用的方法,我们将 OkCupid 数据与朴素贝叶斯分类模型结合使用。朴素贝叶斯模型计算效率高,是演示全局搜索方法的有效模型。该模型使用贝叶斯公式(Bayes’ formula)来预测分类概率。
\[ P(C_k \mid \mathbf{x}) = \frac{P(\mathbf{x} \mid C_k) \times P(C_k)}{P(\mathbf{x})} \]用通俗的话说:给定我们的预测子数据,每个类别的概率是多少?
这个方程有三个要素。先验(prior)是每个类别的总体概率(例如 STEM 档案的比例),既可以从训练数据中估计,也可以根据专家知识确定。似然(likelihood)衡量的是在给定每个类别的情况下,观测到预测子数据的相对概率。证据(evidence)是一个归一化因子,可以由先验和似然计算得出。大部分计算发生在确定似然的过程中。例如,如果有多个数值预测子,可以使用多元概率分布来进行计算。然而,除了低维正态分布之外,这很难计算,或者可能需要大量的训练集数据。当特征是数值和连续值(numeric and continuous values)的组合时,似然的确定变得更加复杂。该模型的「朴素」(naive)之处源于一个非常严格的假设:预测子被假定为相互独立。这使得联合似然可以计算为每个预测子单独统计量的乘积。
图 12.1:OkCupid 数据中一个连续预测子和一个离散预测子的条件分布可视化。
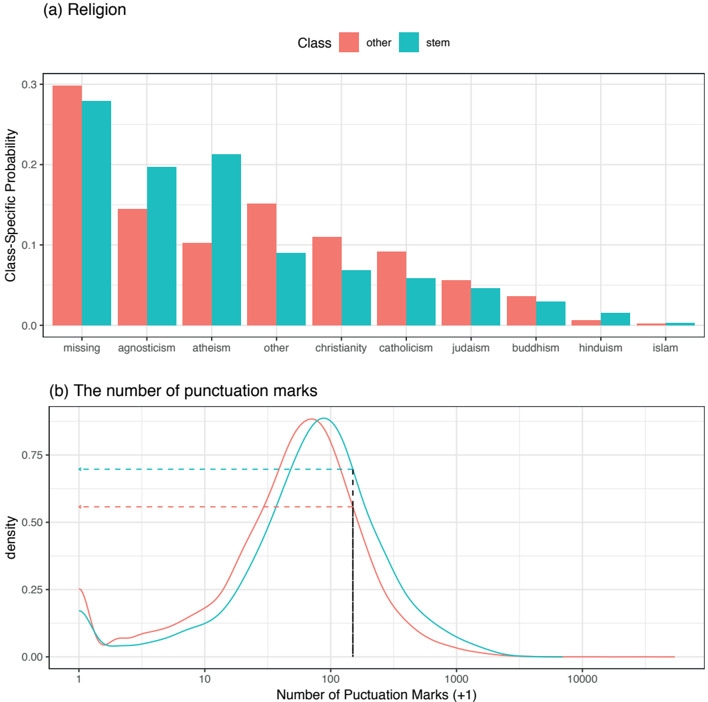
例如,假设一个朴素贝叶斯模型有两个预测子:文章中的标点符号数量以及所声明的宗教。首先考虑宗教预测子(它有 10 个可能取值)。对于该预测子,将各取值与结果之间建立交叉制表(crosstabulation),并计算每个类别内各宗教取值的概率。图 12.1(a) 展示了各类别特定的概率。假设一个人将宗教声明为无神论者(Atheist)。计算得出,STEM 档案中是无神论者的概率为 0.213,其他档案中为 0.103。
对于连续预测子——标点符号数量——预测子的分布按类别分别计算。实现方法之一是对预测子分箱(binning),并利用直方图频率来估计概率。更好的方法是在这些数据上计算非参数密度函数(nonparametric density function)(Wand and Jones, 1994)。图 12.1(b) 展示了两个类别各自的密度曲线(预测子数据经过了 log 10 变换)。可以看出一个轻微的趋势:非 STEM 档案倾向于使用更少的标点符号。假设一个人在文章中使用约 150 个标点符号(用黑色水平线标出)。为了计算每个类别的相对密度,使用两个类别密度线对应的高度。这里,STEM 档案的密度为 0.697,非 STEM 为 0.558。
现在,既然已经针对每个预测子和类别值计算了统计量,就可以做出总体预测了。首先,将两个预测子的值相乘,构成每个类别的似然统计量。表 12.1 展示了计算的细节。宗教和标点符号数据都更符合 STEM 档案的特征;各类别的似然值之比为 0.148 ÷ 0.057 = 2.59,表明该档案更可能对应 STEM 职业(基于训练数据)。然而,贝叶斯法则还包含先验信息(prior information)项,即在目标总体中发现 STEM 档案的总体比例。90 在这些数据中,STEM 比例约为 18.5%,很可能高于美国其他地区。为了得到最终预测,将先验与似然相乘,并将其值归一化使其总和为 1,从而得到后验概率(posterior probability)(即类别概率预测)。最终,这个特定档案与 STEM 工作相关的概率只有 37%;我们对结果的先验信息足够极端,以至于与观测数据所指示的情况相矛盾。
90 回顾第 3.2.2 节,在部分计算中使用患病率(prevalence)时也曾讨论过先验概率。
表 12.1:朴素贝叶斯模型计算中使用的值。
| 预测子值 | 预测子值 | ||||
|---|---|---|---|---|---|
| 类别 | 宗教 | 标点符号 | 似然 | 先验 | 后验 |
| STEM | 0.213 | 0.697 | 0.148 | 0.185 | 0.37 |
| 其他 | 0.103 | 0.558 | 0.057 | 0.815 | 0.63 |
分别考虑每个预测子使计算快得多,而且由于计算似然所需的信息可以存储在高效的查找表(look-up table)中,这些模型很容易部署。然而,预测子相互独立的假设对许多数据集来说并不成立。例如,标点符号数量与单词数量(相关系数:0.847)、逗号数量(0.694)等存在很强的秩相关。但在许多情况下,即使忽略预测子之间的相关性,该模型也能产生良好的预测。
该模型另一个相关的方面是定性预测子的处理方式。例如,本次分析中没有把宗教分解为指示变量(indicator variable)。或者,该预测子可以被分解为全部 10 种宗教回答,并在模型中直接使用这些变量。但必须小心,确保新的二元变量仍被视为定性变量;否则,一个只有两个可能取值的预测子会使用连续密度函数(类似于图 12.1(b) 中的分析)来表示。当朴素贝叶斯模型使用第 5.6 节描述的全部特征集(约 110 个变量)时,交叉验证的 ROC 曲线下面积计算为 0.798。当定性变量转换为单独的指示变量时,AUC 值为 0.799。性能差异可以忽略不计,不过使用单独指示变量的模型由于预测子数量从 110 增加到 298,计算时间长了 1.9 倍。
减少预测子数量可以为该模型带来一定的性能收益,因为注入概率计算的噪声更少。使用更少的特征还有一个附带好处:随着预测子数量接近训练集样本数量,独立性假设往往会产生高度病态的类别概率分布。在这些情况下,类别概率的分布变得有些两极分化;很少有预测点落在范围的中间(比如说大于 20% 且小于 80%)。这些 U 形分布可能难以向模型使用者解释,因为大多数被错误预测的样本都有很高的「正确」置信度(尽管事实恰恰相反)。减少预测子数量可以缓解这个问题。
该模型将用于演示在 OkCupid 数据上的全局搜索方法。朴素贝叶斯模型有一些优点:它们可以非常快速地训练,并且预测函数可以很容易地在一组包含似然和先验概率的查找表中实现。如果模型将使用数据库系统进行评分,后一点会很有帮助。
12.2 模拟退火
退火(annealing)是加热金属或玻璃以去除瑕疵、提高材料强度的过程。金属受热时,粒子在材料内部快速随机重排。这种随机重排有助于加强薄弱的分子连接。随着材料冷却,粒子的随机重排仍在继续,但速度会减慢。整个过程由时间和材料在特定时间的能量决定。
材料内部粒子发生的退火过程可以被抽象出来,应用于全局优化的目的。在这种情况下,目标是找到预测响应最强(或最具预测性)的一组特征。在特征选择的背景下,预测子就是粒子,预测子的集合就是材料,而当前粒子排列中选定的特征集就是排列方式。为了完成这个类比,时间由迭代次数表示,材料能量的变化则是当前迭代与上一次迭代之间预测性能的变化。这个过程被称为模拟退火(simulated annealing, SA)(Kirkpatrick et al., 1983; Van Laarhoven and Aarts, 1987)。
算法 12.1:用于特征选择的模拟退火。
- 1 创建一个初始的随机特征子集,并指定迭代次数;
- 2 对模拟退火的每一次迭代执行:
- 3 扰动当前特征子集;
- 4 拟合模型并估计性能;
- 5 如果性能优于之前的子集,则:
- 6 接受新的子集;
- 7 否则:
- 8 计算接受概率;
- 9 如果随机均匀变量大于该概率,则:
- 10 拒绝新的子集;
- 11 否则:
- 12 接受新的子集;
- 13 结束
- 14 结束
- 15 结束
为了初始化模拟退火过程,随机选择一个特征子集,同时选定迭代次数。然后构建模型并计算预测性能。接着,随机把当前特征集中一小部分(1%–5%)特征纳入或排除,并为新集合计算预测性能。如果新特征集的性能有所提高,则保留新特征集。但是,如果新特征集性能变差,则用下面的公式计算接受概率(acceptance probability):
\[ P(\text{accept}) = \exp\left(-\frac{\Delta \cdot t}{c}\right) \]此处性能越好对应数值越大。该概率是时间和性能变化的函数,也是一个常数 \(c\) 的函数,\(c\) 可用于控制特征扰动的速率。默认情况下,\(c\) 设为 1。计算出接受概率后,生成一个随机均匀数。如果随机数大于接受概率,则拒绝新特征集,继续使用之前的特征集。否则,保留新特征集。这一过程带来的随机性使模拟退火能够在搜索全局最优的过程中逃离局部最优。
为了理解接受概率公式,考虑一个以优化预测准确率为目标的例子。假设前一个解的准确率为 0.85,当前解的准确率为 0.80。当前解相对于前一个解的成比例下降为 5.9%。如果这种情况发生在第一次迭代,那么接受概率将是 0.94。在第 5 次迭代时,接受这个较劣子集的概率为 0.75。在第 50 次迭代时,接受概率下降到 0.05。因此,随着算法迭代次数的增加,接受更差解的概率会降低。算法 12.1 总结了用于特征选择的基本模拟退火算法。
虽然搜索的随机性和接受概率标准有助于算法避免局部最优,但一种称为重启(restart)的修改提供了额外的保护层,防止算法滞留在不利的区域。如果在 \(R\) 次迭代内没有找到新的最优解,则搜索重置到最后一次已知的最优解并重新开始,\(R\) 为自重启以来的迭代次数。
作为示例,下表展示了以 ROC 曲线下面积为结果的模拟退火前 15 次迭代:
| 迭代次数 | 子集大小 | ROC | 接受概率 | 随机均匀数 | 状态 |
|---|---|---|---|---|---|
| 1 | 122 | 0.776 | - | - | 改进 |
| 2 | 120 | 0.781 | - | - | 改进 |
| 3 | 122 | 0.770 | 0.958 | 0.767 | 接受 |
| 4 | 120 | 0.804 | - | - | 改进 |
| 5 | 120 | 0.793 | 0.931 | 0.291 | 接受 |
| 6 | 118 | 0.779 | 0.826 | 0.879 | 丢弃 |
| 7 | 122 | 0.779 | 0.799 | 0.659 | 接受 |
| 8 | 124 | 0.776 | 0.756 | 0.475 | 接受 |
| 9 | 124 | 0.798 | 0.929 | 0.879 | 接受 |
| 10 | 124 | 0.774 | 0.685 | 0.846 | 丢弃 |
| 11 | 126 | 0.788 | 0.800 | 0.512 | 接受 |
| 12 | 124 | 0.783 | 0.732 | 0.191 | 接受 |
| 13 | 124 | 0.790 | 0.787 | 0.060 | 接受 |
| 14 | 124 | 0.778 | - | - | 重启 |
| 15 | 120 | 0.790 | 0.982 | 0.049 | 接受 |
重启阈值设为 10 次迭代。前两次迭代对应性能改进。在第 3 次迭代,ROC 曲线下面积没有改进,但损失足够小,对应的接受概率为 95.8%。相关的随机数更小,因此该解被接受。这是值得的,因为下一次迭代带来了很大的性能提升,但随后是一系列损失。注意,在第 6 次迭代,损失大到接受概率为 82.6%,但由于抽到的随机均匀数,该解被拒绝。这意味着配置 7 基于配置 5。这些损失持续到第 14 次迭代,此时发生重启;配置 15 基于最后的最佳解(第 4 次迭代)。
12.2.1 不过拟合地选择特征
这种搜索方法应该如何使用数据?根据第 10.4 节的讨论,选择、建模和评估不应使用相同的数据。应该使用外部重抽样过程来确定多少轮搜索迭代是合适的。这将对所有重抽样的评估集预测取平均,以确定当搜索直接应用于整个训练集时应该进行多久。基本上,迭代次数是一个调优参数(tuning parameter)。
例如,如果使用 10 折交叉验证作为外部重抽样方案,则在 90% 的数据上执行 10 次模拟退火。每个对应的评估集用于估计选择过程在每一轮迭代中的表现。
在每个外部重抽样内,分析集(analysis set)可用于模型拟合和评估。但很可能不适合同时用于这两个目的。嵌套重抽样过程(nested resampling procedure)更为合适。应该对数据进行内部重抽样,将其分成用于模型拟合的子集和用于评估的另一子集。同样,这可以是完整的迭代重抽样方案,也可以是简单的验证集(validation set)。和之前一样,外部重抽样使用 10 折交叉验证。如果外部分析集(占训练集的 90%)足够大,我们可以随机使用其中 80% 的数据进行建模,20% 用于评估(即单个验证集)。它们分别是内部分析集和内部评估集。后者用于引导选择过程走向最优子集。外部和内部交叉验证方法的示意图见图 12.2。
图 12.2:全局搜索中外部与内部交叉验证示意图。
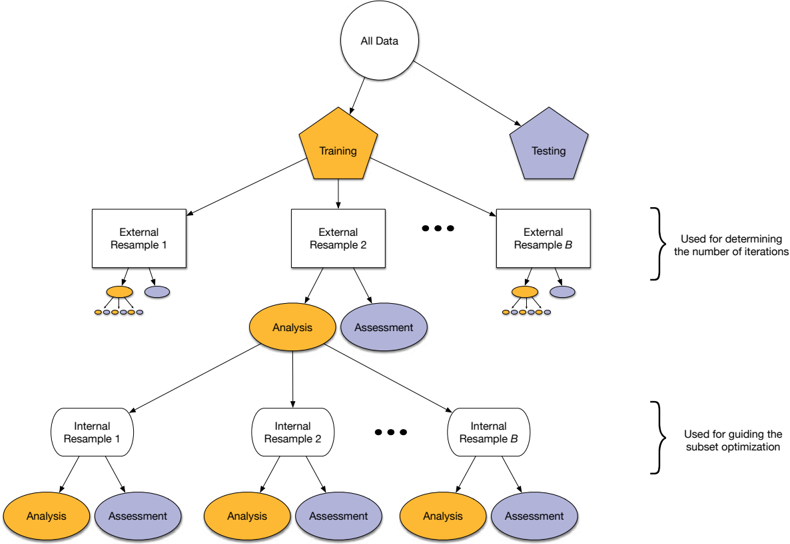
外部重抽样完成后,模拟退火的每一轮迭代都有对应的性能估计,且各自服务于不同目的:
- 内部重抽样引导子集选择过程
- 外部重抽样帮助调优要使用的搜索迭代次数
对于训练集样本较多的数据集,内部和外部性能度量可能会同步变化。在较小的数据集中,内部性能估计持续显示改进而外部估计持平或变差的情况并不少见。虽然使用两级数据划分不太直接、计算成本也更高,但这是了解选择过程是否过拟合的唯一方法。
一旦确定了最优的搜索迭代次数,就在整个训练集上执行最终的模拟退火搜索。和之前一样,不应该用同一数据集既创建模型又估计性能。仍然需要内部划分。
在最后一次搜索中,确定最优预测子集,并使用最佳预测子集在整个训练集上拟合最终模型。这种重抽样选择过程总结在算法 12.2 中。需要注意的是,第 2–20 行可以并行运行(跨外部重抽样),以减少所需的计算时间。
算法 12.2:模拟退火特征选择的重抽样方案。
- 1 创建外部重抽样;
- 2 对每个外部重抽样执行:
- 3 创建一个初始的随机特征子集;
- 4 对模拟退火的每一次迭代执行:
- 5 创建内部重抽样;
- 6 扰动当前子集;
- 7 在内部评估集上拟合模型;
- 8 预测内部评估集并估计性能;
- 9 如果性能优于之前的子集,则:
- 10 接受新的子集;
- 11 否则:
- 12 计算接受概率;
- 13 如果随机均匀变量大于该概率,则:
- 14 拒绝新的子集;
- 15 否则:
- 16 接受新的子集;
- 17 结束
- 18 结束
- 19 结束
- 20 结束
- 21 确定最优迭代次数;
- 22 创建一个初始的随机特征子集;
- 23 对最优次数的 SA 迭代执行:
- 24 基于训练集创建内部重抽样;
- 25 扰动当前子集;
- 26 在内部分析集上拟合模型;
- 27 预测内部评估集并估计性能;
- 28 如果性能优于之前的子集,则:
- 29 接受新的子集;
- 30 否则:
- 31 计算接受概率;
- 32 如果随机均匀变量大于该概率,则:
- 33 拒绝新的子集;
- 34 否则:
- 35 接受新的子集;
- 36 结束
- 37 结束
- 38 结束
- 39 确定最优特征集;
- 40 使用训练集在最佳特征上拟合最终模型;
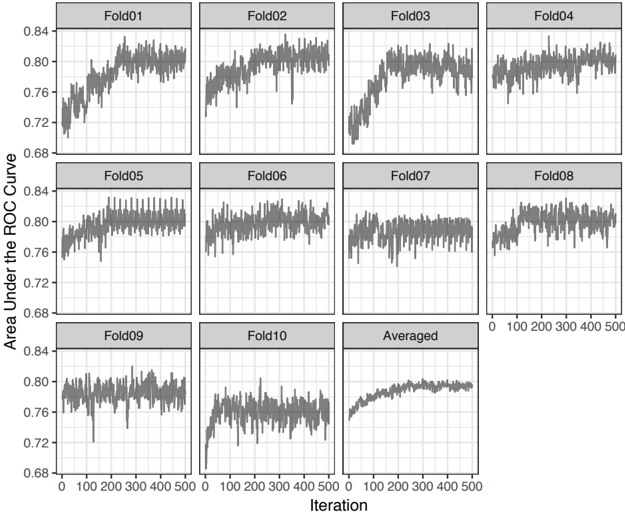
图 12.3:各外部重抽样中通过模拟退火选择的朴素贝叶斯模型的内部性能曲线。
12.2.2 应用于 OkCupid 数据建模
为了说明这一过程,使用 OkCupid 数据。回顾一下,训练集包含 38,809 个档案,其中 7,167 个档案据报道属于 STEM 领域。和之前一样,我们将使用 10 折交叉验证作为外部重抽样过程。这得到 6,451 个 STEM 档案和 28,478 个其他档案可用于建模和评估。假设我们使用单个验证集。我们应该分配多少数据?如果使用这些数据的 10% 作为验证集,将有 646 个 STEM 档案和 2,848 个其他档案可用于估计 ROC 曲线下面积和其他指标。由于 STEM 档案较少,在这些数据上计算的敏感性(sensitivity)将反映最高的不确定性。假设模型能达到 80% 的敏感性,该指标的 90% 置信区间宽度将为 6.3%。虽然这是主观判断,但这个精度似乎足以可靠地引导模拟退火搜索。
朴素贝叶斯模型将用于说明这种搜索方法的潜在用途。将使用 500 次模拟退火迭代,在连续 10 个次优特征集之后发生重启。使用 ROC 曲线下面积来优化模型并确定最优的 SA 迭代次数。首先,我们通过随机选择一半可能的预测子来初始化第一个子集(不过下面会更详细地研究这一点)。
首先看一下每次交叉验证迭代内部搜索的表现。图 12.3 展示了 10 个外部重抽样中内部 ROC 估计的变化。趋势各不相同;有些在迭代过程中性能呈上升趋势,而另一些在迭代过程中似乎变化很小。如果初始子集表现良好,趋势在迭代过程中往往保持平稳。这反映出即使每个重抽样中使用了近 35,000 个数据点,选择过程也可能存在相当大的变异。最后一个面板展示了这些值在所有重抽样中的平均值。
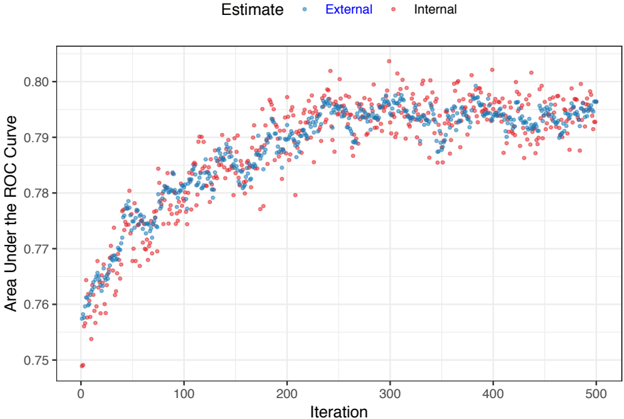
外部重抽样对每轮迭代也有性能估计。它们与内部验证集一致吗?两组 ROC 统计量之间的平均秩相关(rank correlation)为 0.622,范围为 (0.43, 0.85)。这表明一致性相当好。图 12.4 叠加了跨搜索迭代平均后的内部和外部迭代性能指标。这些数据中看到的周期性模式反映了算法的重启特性。最佳性能对应 383 次迭代,但很明显,其他选择也可以在对性能不造成损害的情况下做出。观察各个重抽样,最优迭代次数从 69 到 404 不等,平均为 258 次迭代。虽然这些值存在相当大的变异性,但在这些时间点上选出的变量数量更为精确;平均为 56 个预测子,范围为 (49, 64)。如下面的图 12.7 所示,不同重抽样的子集大小趋势各不相同,有些重抽样增加了预测子数量,而另一些则减少了。
图 12.4:初始子集中随机播种 50% 特征时,通过模拟退火选择的朴素贝叶斯模型的性能曲线。
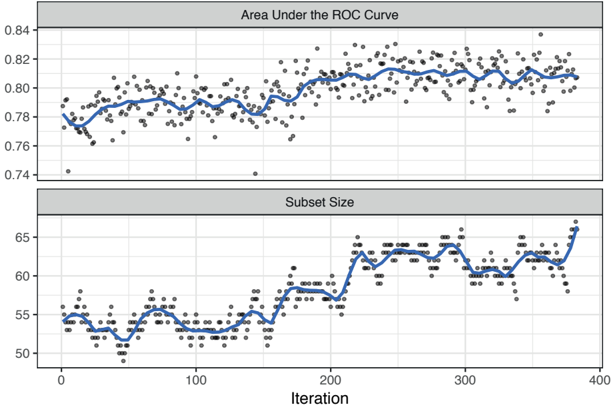
既然我们知道了多少轮搜索迭代是合适的,让我们看看最终的搜索。对于这次 SA 的应用,我们模仿外部重抽样内部的做法:从训练集中分配 10% 的验证集,其余部分用于建模。图 12.5 展示了 ROC 统计量和子集大小在最多 383 次迭代中的趋势。随着迭代次数的增加,子集大小呈上升趋势,ROC 曲线下面积也是如此。
最终,66 个预测子 91(在可能的 110 个中)被选中并用于最终模型:
91 关键词预测子以打字机字体显示。
图 12.5:使用整个训练集和 10% 内部验证集的最终 SA 搜索趋势。
饮食(diet)、教育水平(education level)、身高(height)、收入(income)、距上次上线的时间(time since last on-line)、子女(offspring)、宠物(pets)、宗教(religion)、吸烟(smokes)、城镇(town)、‘speaks’ C++ fluently、‘speaks’ C++ okay、‘speaks’ C++ poorly、lisp、‘speaks’ lisp poorly、黑人(black)、西班牙裔/拉丁裔(hispanic/latin)、印第安人(indian)、中东裔(middle eastern)、美洲原住民(native american)、其他(other)、太平洋岛民(pacific islander)、文章总长度(total essay length)、software、engineer、startup、tech、computers、engineering、computer、internet、science、technical、web、programmer、scientist、code、lol、biotech、matrix、geeky、solving、teacher、student、silicon、law、electronic、mobile、systems、electronics、futurama、alot、firefly、valley、lawyer、感叹号数量(the number of exclamation points)、多余空格数量(the number of extra spaces)、小写字符百分比(the percentage of lower-case characters)、句号数量(the number of periods)、单词数量(the number of words)、情感得分 afinn(sentiment score (afinn))、第一人称单词数量(number of first-person words)、第一人称(所有格)单词数量(number of first-person (possessive) words)、第二人称(所有格)单词数量(the number of second-person (possessive) words)、’to be’ 出现次数(the number of ’to be’ occurrences)以及介词数量(the number of prepositions)
基于外部重抽样,我们对该模型性能的估计是 ROC AUC 为 0.799。这略优于第 12.1 节中估计的完整模型。这个过程的主要好处是减少了预测子的数量。虽然在这种情况下保持了性能,但在其他情况下性能可能会得到改善。
使用随机化方法研究了这 52 个所选特征是否包含良好的预测信息。对于这些数据,生成了 100 个大小为 66 的随机子集,并将其用作朴素贝叶斯模型的输入。SA 模型的性能优于 95% 的随机子集。这一结果表明,SA 选择过程方法可以用来找到良好的预测子集。
12.2.3 检验性能变化
模拟退火是一种受控的随机搜索;新的候选特征子集完全基于当前状态随机选择。经过足够多的迭代后,可以创建一个数据集来量化有无每个预测子时的性能差异。例如,对于持续 500 次迭代的 SA 搜索,大约应该有 250 个包含和不包含每个预测子的子集,每个子集都有一个从外部留出集计算的关联 ROC 曲线下面积。可以对这些值进行各种不同的分析,但最简单的是用于检验相等性的基本 \(t\) 检验(\(t\)-test)。使用以一半变量初始化的 SA,绝对值最大的 10 个 \(t\) 统计量的预测子依次是:教育水平、software 关键词、engineer 关键词、收入、单词数量、startup 关键词、solving 关键词、每词字符数、身高和小写字符数量。显然,其中许多预测子相互关联,测量的是与文章长度相关的特征。作为识别预测性特征子集的额外好处,这种事后分析可以用来清晰地了解预测子的重要性。
12.2.4 分组定性预测子与指示变量
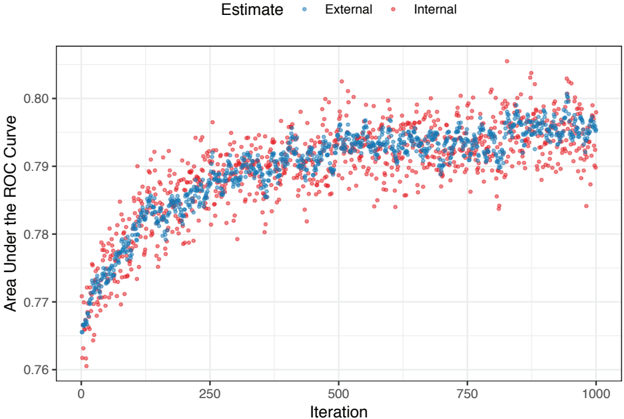
如果类别变量转换为虚拟变量(dummy variable),结果会不同吗?在初始模型播种一半预测子集的情况下进行了相同的分析。与第 5.7 节中进行的类似分析一样,所有其他因素保持不变。然而,由于预测子数量从 110 增加到 298,搜索迭代次数从 500 增加到 1,000,以确保所有预测子都有足够的曝光机会参与选择算法。结果如图 12.6 所示。显然需要额外的迭代来帮助达到预测性能的稳定状态。然而,模型性能(AUC:0.801)与将类别保留在单个预测子中的方法(AUC:0.799)大致相同。
图 12.6:定性变量分解为独立预测子时的结果。
12.2.5 初始子集的影响
还有一个值得考虑的方面:外部重抽样内的子集大小如何变化?如果初始子集播种更多(或更少)预测子,这些趋势会不同吗?为了回答这个问题,用初始子集为总特征集的 10% 或 90% 重复了搜索。图 12.7 展示了每个外部重抽样的平滑子集大小,按不同的初始百分比着色。在许多情况下,两个较稀疏的配置收敛到约为总可能预测子数量一半的子集大小(不过也有少数整体变化很小)。少数较大的初始子集没有大幅减少。三种配置之间存在一定的一致性,但这确实引发了一个潜在问题:模拟退火会在多大程度上强制减少模型中的预测子数量。鉴于这些结果,在许多实际应用中,从较小的子集大小开始并评估性能可能是有意义的。
图 12.7:不同初始特征子集大小下跨迭代的重抽样趋势。这些结果是通过对 OkCupid 数据应用模拟退火得到的。
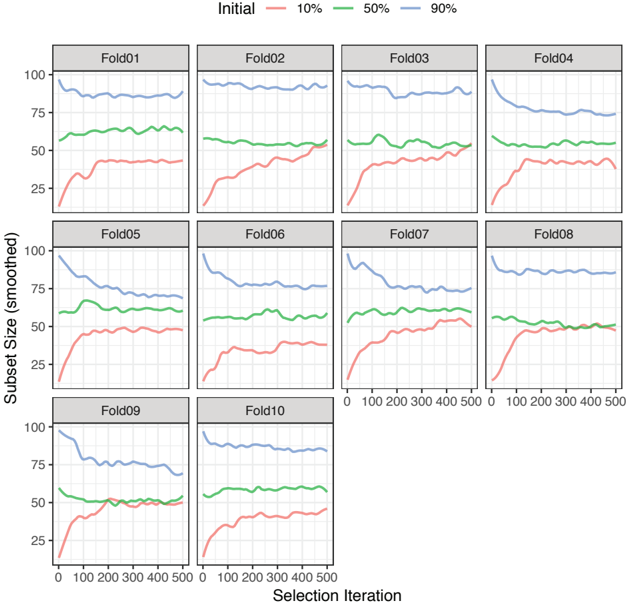
在性能方面,三组结果的 ROC 曲线下面积分别为 0.805(10%)、0.799(50%)和 0.804(90%)。鉴于这些结果的变异性,不同设置之间的性能没有明显差异。
12.3 遗传算法
遗传算法(genetic algorithm, GA)是一种基于种群生物学进化概念的优化工具(Mitchell, 1998; Haupt et al., 1998)。这些算法已被证明能够定位复杂函数的最优或近最优解(Mandal et al., 2006)。为了有效找到最优解,该算法模拟种群的进化过程:为优化问题生成候选解集,让解进行繁殖并产生新解(reproduction,繁殖),并促进竞争,使进化上最适的解(即最优解)有最大机会存活并填充下一代(自然选择,natural selection)。这一过程使 GA 能够随时间利用好的解来产生更好的解,并且已被证明会收敛到一个优化平台(Holland, 1992)。
识别最优特征子集的问题也是一个复杂的优化问题,如第 10.2 节所讨论。因此,如果特征选择问题可以用进化生物学的概念来表述,那么就可以应用 GA 引擎来搜索最优特征子集。在生物学中,种群中的每个个体由染色体(chromosome)表示,染色体由一串基因(gene)序列构成。每个染色体都根据适应度标准(fitness criterion)进行评估。适应度越好,染色体就越有可能被选中用于繁殖,以产生下一代染色体。繁殖阶段涉及交叉(crossover)和变异(mutation)过程,两个染色体交换一部分基因。随后,一小部分后代的基因会因变异过程而改变。
出于特征选择的目的,种群由特定数据集的所有可能特征组合构成。种群中的染色体是特征的特定组合(即基因),该组合用一个长度等于特征总数的字符串表示。适应度标准是所选特征组合的预测能力。与模拟退火不同,GA 特征子集按世代(generation)分组,而不是一次只考虑一个子集。但 GA 中的一个世代类似于模拟退火中的一次迭代。
在实践中,特征子集的初始种群需要足够大,以在特征子集空间中包含足够的多样性。通常选择 50 个或更多随机选择的特征子集来播种初始世代。
我们的方法是创建包含总特征数 10% 到 90% 的随机特征子集。
创建初始世代后,估计每个特征子集的适应度(即预测能力)。作为一个小例子,考虑一组 9 个预测子(A 到 I)和 12 个特征子集的初始种群:
| ID | A | B | C | D | E | F | G | H | I | 适应度 | 概率(%) |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | C | F | 0.64 | 6.4 | |||||||
| 2 | A | D | E | F | H | 0.65 | 6.5 | ||||
| 3 | D | 0.60 | 6.0 | ||||||||
| 4 | E | 0.62 | 6.2 | ||||||||
| 5 | D | G | H | I | 0.88 | 8.8 | |||||
| 6 | B | E | G | I | 0.75 | 7.5 | |||||
| 7 | B | C | F | I | 0.77 | 7.7 | |||||
| 8 | A | C | E | G | H | I | 1.12 | 11.2 | |||
| 9 | A | C | D | F | G | H | I | 0.96 | 9.6 | ||
| 10 | C | D | E | I | 0.93 | 9.3 | |||||
| 11 | A | B | D | E | G | H | 1.00 | 10.0 | |||
| 12 | A | B | C | D | E | F | G | I | 1.07 | 10.7 |
每个子集都有一个关联的性能值,在这种情况下,值越大越好。接下来,将选择这些特征集中的一部分作为父代(parent)进行繁殖,形成下一代。选择父代的一个合乎逻辑的方法是选择排名最高的特征子集作为父代。然而,这种贪婪方法往往会导致滞留在局部最优解中。为了避免局部最优,父代的选择应该是适应度标准的函数。选择父代最常用的方法是使用加权随机抽样,选择概率是预测性能的函数。计算选择概率的一个简单方法是将单个特征子集的性能值除以所有性能值之和。上表最右边的列展示了这一世代的结果。
假设子集 6 和 12 被选为下一代的父代。为了让这些父代繁殖,它们的基因将经历交叉和变异过程,产生两个新的特征子集。在单点交叉(single-point crossover)中,在两个预测子之间选择一个随机位置。92 然后父代交换交叉点一侧的特征。93 假设交叉点在预测子 D 和 E 之间,如下所示:
92 也存在多点交叉(multi-point crossover)方法,它会创建两个以上的特征交换区域。
93 通常还会生成一个随机概率来决定是否进行交叉。
| ID | A | B | C | D | E | F | G | H | I |
|---|---|---|---|---|---|---|---|---|---|
| 6 | B | E | G | I | |||||
| 12 | A | B | C | D | E | F | G | I |
这些父代产生的子代将是:
| ID | A | B | C | D | E | F | G | H | I |
|---|---|---|---|---|---|---|---|---|---|
| 13 | B | E | F | G | I | ||||
| 14 | A | B | C | D | E | G | I |
新创建的特征子集可能发生的最后一个修改是变异(mutation)。为每个可能的特征生成一个小的随机概率(1%–2%)。如果一个特征在变异过程中被选中,则其在当前特征子集中的状态被翻转。这一步为滞留在局部最优解中增加了额外的保护。继续使用上面生成的子代,假设特征子集 13 中的特征 I 被选中进行变异。由于该特征已经存在于子集 13 中,因为它被确定为变异对象,所以它将被移除。接下来要评估的下一代子代将是:
| ID | A | B | C | D | E | F | G | H | I |
|---|---|---|---|---|---|---|---|---|---|
| 13 | B | E | F | G | |||||
| 14 | A | B | C | D | E | G | I |
选择两个父代以产生两个更多后代的过程将继续,直到新世代被填满。
繁殖过程并不能保证当前世代中最适的染色体一定会出现在后续世代中。这意味着后续世代有可能拥有适应度较低的染色体。为了确保后续世代保持相同的适应度水平,最好的染色体可以原样带入后续世代。这个过程被称为精英策略(elitism)。当 GA 中使用精英策略时,观测到的各世代中最适的解将始终出现在最终世代中。然而,这个过程可能会导致 GA 在局部最优中滞留更久,因为最好的染色体总是具有最高的繁殖概率。
12.3.1 外部验证
应该使用外部重抽样过程来确定多少轮搜索迭代是合适的。这将对所有重抽样的评估集预测取平均,以确定当搜索直接应用于整个训练集时应该进行多久。基本上,迭代次数再次成为一个调优参数。
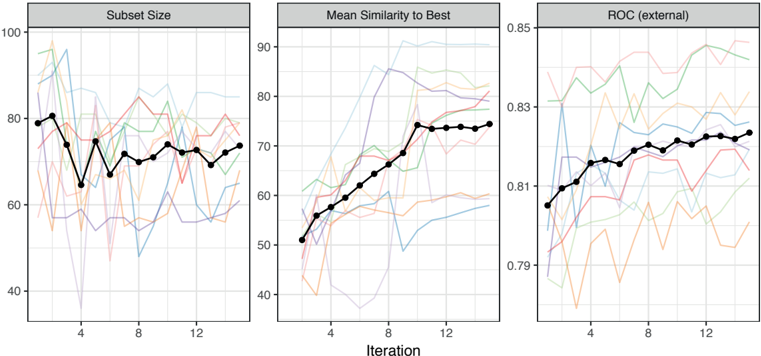
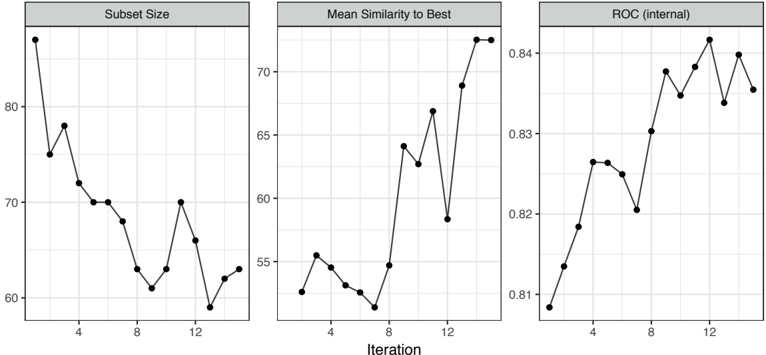
图 12.8:遗传算法各外部重抽样中子集大小、相似度和性能随时间的变化。
遗传算法通过随时间改变特征子集来逐步提高预测性能。与模拟退火类似,应该使用外部重抽样过程来选择最优的世代数。具体来说,GA 在每个外部重抽样循环内执行。然后使用内部重抽样来衡量适应度,以便使用不同的数据进行建模和评估。这一过程有助于防止遗传算法找到对现有数据过拟合的特征子集,而这种优化工具确实存在这种风险。
一旦确定了世代数,就在训练集上执行最终的选择过程,并用最佳子集为最终模型筛选预测子。
为了评估 GA 在特征选择中的性能,我们将再次使用 OkCupid 数据和朴素贝叶斯模型。此外,使用了与模拟退火相同的数据划分方案;外部重抽样使用 10 折交叉验证,外加 10% 的内部验证集。搜索参数大多保持为建议的默认值:
- 世代大小:50
- 交叉概率:80%
- 变异概率:1%
- 精英策略:否
- 世代数:14 94
94 对遗传算法来说这是一个较低的值。在其他应用中,世代数通常在数百或数千。然而,由于内部和外部验证方案的存在,如此大的值会使特征选择过程在计算上颇具挑战。
对于这个遗传算法,检查每一代成员(即特征子集)如何跨世代(即搜索迭代)变化是很有帮助的。正如我们在模拟退火中看到的那样,了解算法跨世代特征的简单指标是特征子集大小和预测性能估计。了解一代内成员的特征也很有用。例如,子集内部和世代之间的多样性可以使用诸如雅卡尔相似度(Jaccard similarity)之类的度量来量化(Tan et al., 2006)。该指标是两个子集共有的预测子数量除以两个集合中唯一预测子的总数。例如,如果有 5 个可能的预测子,子集 ABC 和 ABE 之间的雅卡尔相似度为 2/4,即 50%。这个值有助于了解遗传算法收敛到共同解或潜在过拟合的效率。
图 12.8 展示了监控每个重抽样每一代当前最佳子集的子集大小和预测性能的曲线。此外,该图还展示了每个外部重抽样中一代内子集与当前最佳子集的平均相似度。从这个图中可以注意到几个特征。首先,尽管各重抽样第一代的规模存在相当大的差异,但它们都收敛到包含 61 到 85 个预测子的子集大小。相似度图表明,一代内的子集正变得越来越接近最佳解。与此同时,ROC 曲线下面积在最后一代增加到 0.843。
由于平均 ROC 曲线下面积总体呈上升趋势,AUC 值最大的世代是第 15 代。由于总体趋势仍在继续,额外的世代可能会在后续世代中产生更优的特征子集。
最终搜索在整个训练集上进行,图 12.9 展示了结果。这些与之前展示的内部趋势相似。
第 15 代的最终预测子集包含的变量比之前的 SA 搜索更多,包含以下预测子:
年龄(age)、教育水平(education level)、身高(height)、收入(income)、距上次上线的时间(time since last on-line)、宠物(pets)、星座(astrological sign)、吸烟(smokes)、城镇(town)、宗教(修饰符)(religion (modifer))、星座(修饰符)(astrological sign (modifer))、‘speaks’ C++、‘speaks’ C++ fluently、‘speaks’ C++ poorly、lisp、‘speaks’ lisp fluently、‘speaks’ lisp poorly、亚裔(asian)、黑人(black)、印第安人(indian)、中东裔(middle eastern)、美洲原住民(native american)、其他(other)、太平洋岛民(pacific islander)、白人(white)、文章总长度(total essay length)、software、engineer、startup、tech、computers、engineering、computer、internet、technology、technical、developer、programmer、scientist、code、geek、lol、biotech、matrix、geeky、solving、problems、data、fixing、teacher、student、silicon、law、mechanical、electronic、mobile、math、apps、数字数量(the number of digits)、情感得分 bing(sentiment score (bing))、第一人称单词数量(number of first-person words)、第二人称单词数量(the number of second-person words)以及 ’to be’ 出现次数(the number of ’to be’ occurrences)。为了衡量搜索的有效性,选择了 100 个大小为 63 的随机子集,并为每个子集开发了一个朴素贝叶斯模型。GA 选择的子集表现优于 100% 的随机选择子集。这表明 GA 确实为预测响应找到了有用的子集。
图 12.9:使用整个训练集的最终搜索的遗传算法结果。
12.3.2 施加稀疏性
遗传算法往往比其他方法选择更大的特征子集。这可能是由于算法的构造方式:如果一个特征对预测有用,它就会被包含在特征子集中。然而,保留一个对预测性能没有影响的特征的代价较小。当 GA 与不会因包含不相关预测子而产生实质性代价的建模技术(第 10.3 节)结合时尤其如此。在这些情况下,添加非信息性预测子并不会强制选择过程强烈追求稀疏解。
稀疏解有几个好处。首先,模型通常更简单,这可能使其更容易理解。更少的预测子也需要的计算资源更少。那么,有没有办法迫使搜索过程走向更稀疏的预测子子集解呢?
减少预测子数量的一种简单方法是使用基于特征数量具有显式惩罚的代理性能度量。第 11.4 节介绍了赤池信息准则(Akaike information criterion, AIC),它以训练集大小和模型项数量的函数形式向目标函数添加惩罚。该指标专门适用于以似然为目标函数的模型(即线性或逻辑回归),但不能应用于以优化 ROC 曲线下面积或 \(R^2\) 等其他指标为目标的模型。此外,AIC 通常涉及模型参数的数量,而不是预测子的数量。对于简单的参数回归模型,这两个量非常相似。但许多模型没有参数数量的概念(例如树、\(K\) 近邻等),而另一些模型的参数可能比训练集中的样本多得多(例如神经网络)。然而,基于特征数量惩罚目标的原理可以扩展到其他模型。
对性能度量施加惩罚使问题可以被表述为多参数优化(multi-parameter optimization, MPO)或多目标优化(multi-objective optimization)。有各种方法可以解决这个问题,包括将多个目标值组合成最终单一值的函数。出于特征选择的目的,一个目标是优化预测性能,另一个目标是尽可能少地包含特征。有许多不同的选项(例如 Bentley and Wakefield (1998)、Xue et al. (2013) 等),但一种简单直接的方法是使用合意度函数(desirability function)(Harrington, 1965; Del Castillo et al., 1996; Mandal et al., 2007)。使用这种方法时,每个目标都被转换到一个新的 [0, 1] 尺度上,值越大越合意。例如,不合意的 ROC 曲线下面积是 0.50,合意的 ROC 曲线下面积是 1.0。一个简单的合意度函数可以是一条线,当 AUC 小于或等于 0.50 时合意度为零,当 AUC 为 1.0 时合意度为 1.0。相反,模型中预测子数量的合意度函数,当所有预测子都在模型中时为 0.0,当模型中只有一个预测子时为 1.0。还可以加入额外的合意度函数,引导建模过程走向其他重要特征。
一旦定义了所有单独的合意度函数,就通过取所有单独函数的几何平均值(geometric mean)来创建总体合意度统计量。如果有 \(q\) 个合意度函数 \(d_i\)(\(i = 1 \ldots q\)),几何平均值定义为:
\[ D = \left( \prod_{i=1}^{q} d_i \right)^{1/q} \]基于这个函数,如果任何一个合意度函数不可接受(即 \(d_i = 0\)),总体度量也不可接受。95 对于特征选择应用,内部性能度量——即遗传算法用来接受或拒绝子集的指标——可以使用总体合意度来鼓励选择过程偏向更小的子集,同时仍然考虑性能。
95 如果我们不希望仅仅因为一个不理想的特性就把合意度分数强制归零,那么可以对各个合意度函数加以约束,使其最小值大于零。
最大化某个量时最常用的合意度函数使用 Derringer 和 Suich (1980) 提出的分段线性或多项式函数:
\[ d_i = \begin{cases} 0, & x \le A \\ \left( \dfrac{x - A}{B - A} \right)^s, & A < x < B \\ 1, & x \ge B \end{cases} \]图 12.10:(a) 两类合意度函数示例,(b) 两者组合后的总体合意度曲面。(b) 中的等高线使用 0.2 的最大化函数和 1 的最小化函数创建。
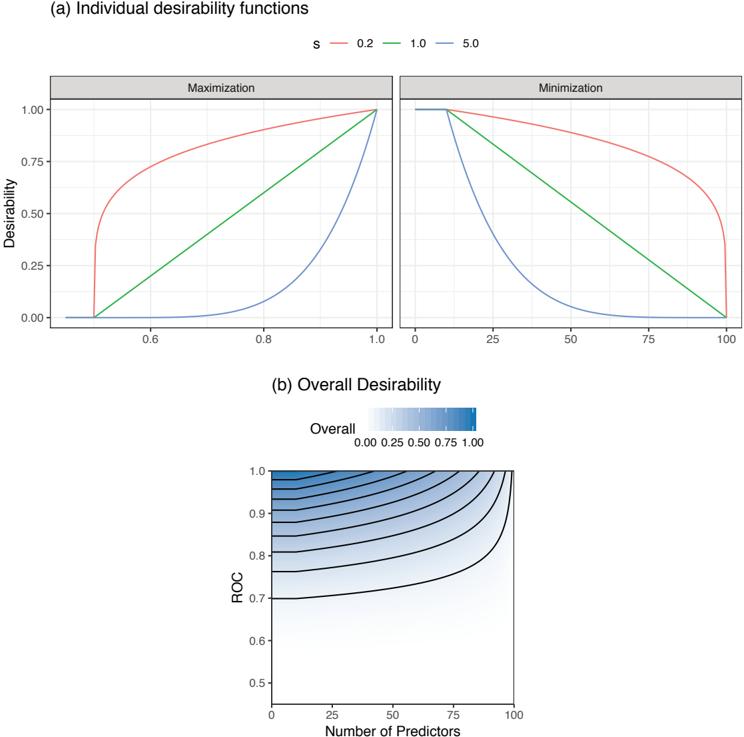
图 12.10(a) 展示了一个最大化函数的例子,其中 \(A = 0.50\),\(B = 1.00\),缩放因子 \(s\) 有三个不同的值。注意,\(s\) 小于 1.0 会削弱合意度函数的影响,而 \(s > 1.0\) 的值会增强对合意度函数的影响。
最小化某个量时,使用类似的函数:
\[ d_i = \begin{cases} 1, & x \le A \\ \left( \dfrac{B - x}{B - A} \right)^s, & A < x < B \\ 0, & x \ge B \end{cases} \]图 12.10(a) 还展示了一个最小化示例,对子集中的预测子数量进行评分,其中 \(A = 10\),\(B = 100\)。
当 \(s = 1/5\) 的最大化函数与 \(s = 1\) 的最小化函数通过几何平均值组合时,结果如图 12.10(b) 所示。在这种情况下,等高线不对称,因为根据 \(s\) 的值,我们给了 ROC 曲线下面积更多的影响。
对于目标值最佳(即最小值和最大值之间的值)的情况、施加盒约束(box constraint)的情况或使用定性输入的情况,也存在类似的合意度函数。也可以使用更平滑的函数来代替分段方程。
对于 OkCupid 数据,使用具有以下目标的合意度函数来引导 GA:
- 在 \(A = 0.50\) 和 \(B = 1.00\) 之间最大化 ROC 曲线下面积,缩放因子 \(s = 2.0\)。
- 在 \(A = 10\) 和 \(B = 100\) 之间最小化子集大小,\(s = 1.0\)。
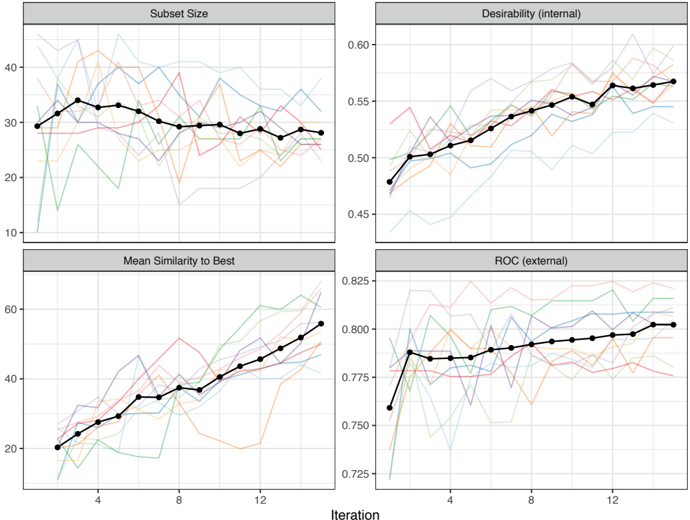
总体合意度用于内部性能,而外部 ROC 曲线下面积仍作为主要的外部指标。图 12.11 展示了类似于图 12.8 的内部结果图。总体合意度持续增加,并且随着额外世代的增加可能还会继续增加。到最后一个世代,平均子集大小下降到约 28。基于内部重抽样的平均值,第 14 代与最大的合意度值相关联,对应的 ROC 曲线下面积外部估计为 0.802。这小于无约束的 GA,但性能的降低被模型中预测子数量的大幅减少所抵消。
图 12.11:结合合意度函数使用遗传算法时朴素贝叶斯模型的内部性能曲线。
在遗传算法的最终运行中,第 15 代选择了 32 个预测子。它们是:
教育水平(education level)、身高(height)、宗教(religion)、吸烟(smokes)、城镇(town)、‘speaks’ C++ okay、lisp、‘speaks’ lisp poorly、亚裔(asian)、美洲原住民(native american)、白人(white)、software、engineer、computers、science、programming、technical、code、lol、matrix、geeky、fixing、teacher、student、electronic、pratchett、math、systems、alot、valley、lawyer 以及标点符号数量(the number of punctuation marks)
根据具体情境,可以提出一个强有力的论点:即使结果稍差(但优于完整模型),更小的预测子集也可能是更好的选择。如果朴素贝叶斯比其他模型更好的选择,那么值得在测试集上评估普通 GA 和稀疏 GA,以做出选择。
12.4 测试集结果
使用无约束和受约束 GA 的最优参数设置构建模型,并将其应用于测试集。无约束 GA 的 ROC 曲线下面积为 0.831,而受约束 GA 的对应值为 0.804。这两个值都大于它们对应的重抽样估计值,但两个模型的性能排名顺序相同。
图 12.12:两个遗传算法模型的测试集结果。
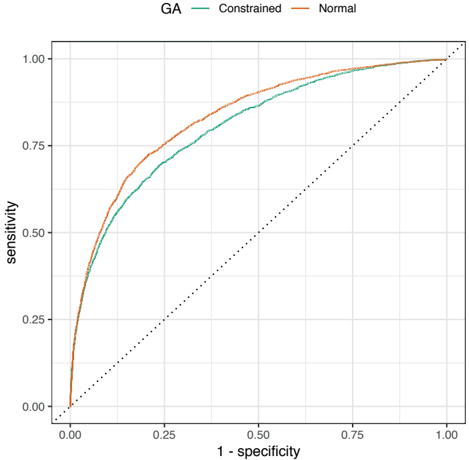
图 12.12 显示,无约束模型在测试集的所有截断点(cutoff)上都具有一致的更好的敏感性和特异性,不过很难判断这些结果彼此之间是否具有实际差异。
12.5 小结
全局搜索方法可以成为研究预测子空间、识别与响应最优相关的预测子子集的有效工具。尽管这些方法有一些可调参数(例如迭代次数、初始子集大小、变异率等),但默认值通常是合理的,并且往往效果良好。
虽然全局搜索方法通常能有效找到好的特征集,但它们在计算上代价高昂。例如,进行每次模拟退火分析的完整过程总共需要拟合 5,501 个单独的模型,而遗传算法分析需要 8,251 个模型。外部交叉验证中各折的独立性允许这些方法并行运行,从而减少总体计算时间。即便如此,上述 GA 在每个外部交叉验证折使用单独核心并行处理的情况下,仍耗时超过 9 小时。
此外,必须指出,用于比较方法的朴素贝叶斯模型不需要优化任何调优参数。96 如果全局搜索方法与径向基支持向量机(2 个调优参数)或 C5.0 模型(3 个调优参数)一起使用,那么计算需求将显著上升。
96 核密度估计的平滑度本来也可以进行调优,但这通常不会产生显著影响。
将全局搜索方法与具有调优参数的模型结合使用时,我们建议尽可能首先利用关于问题的专家知识对特征集进行筛选。接下来,重要的是确定合理的调优参数值范围。如果有足够数量的样本,可以从中分出一定比例,使用所有特征来寻找潜在的良好参数值范围。调优参数值可能不是特征子集的最佳选择,但应该足以有效地找到最优子集。
一般的特征选择策略是使用能够在模型拟合过程中内在地消除特征的模型。如前所述,这些模型可能比包装器方法(wrapper method)快得多地产生良好结果。当没有这种属性的模型最具吸引力时,包装器方法最有用。例如,如果我们有特定的理由偏爱朴素贝叶斯模型,我们就会优先考虑本章展示的方法,而不是那些会自动过滤预测子的更快捷技术(例如 glmnet、MARS 等)。
12.6 计算
网站 http://bit.ly/fes-global 包含用于重现这些分析的 R 程序。