特征选择概述
第 5 章到第 9 章提供了工程化特征(feature)(或预测子(predictor))的工具,以使它们能够处于让模型更好地找到与结果(outcome)相关的预测信号的形式。其中一些技术,如一一变换(1-1 transformation)或降维方法,会产生与原始数据相比数量相同或更少的预测子集合。其他变换,如基展开(basis expansion),会生成比原始数据更多的特征。人们希望一些新工程化的预测子能够捕捉到与结果之间的预测关系。但有些可能与结果无关。此外,许多原始预测子也可能不包含预测信息。对于许多模型而言,随着无关信息预测子数量的增加,预测性能会下降。因此,确实需要适当地选择用于建模的预测子。
接下来的章节将聚焦于有监督的特征选择(supervised feature selection),即根据预测子对结果的影响来决定保留哪些预测子。本章将介绍特征选择、这些方法的一般术语以及一些值得注意的陷阱(pitfall)。
10.1 特征选择的目标
在实践中,我们经常发现合作者希望拥有一个既具有最佳预测能力又可解释(interpretable)的模型。但预测性能与可解释性之间往往存在权衡(trade-off),通常不可能同时最大化两者(Shmueli, 2010)。对这种权衡的误解导致人们认为,简单地过滤掉无信息的预测子将有助于阐明哪些因素在影响结果。然后就可以构建解释,说明为什么剩余的预测子与结果相关。这种推理在几个方面是有问题的。首先,考虑预测子数量远大于样本数量的情况。在这种情况下,很可能存在许多互斥的预测子子集,它们产生的模型具有几乎相当的预测性能(例如,局部最优(local optimum))。要找到最佳全局解,即性能最好的预测子子集,需要评估所有可能的预测子子集,这可能计算上不可行(computationally infeasible)。但即使有可能用现有数据找到全局最优解,由于可用预测子和结果中固有的噪声,识别出的子集也可能不是真正的全局最优解(如果存在的话)。
许多模型在将预测子与结果相关联的方式上很复杂。对于此类模型,几乎不可能解读任何单个预测子与结果之间的关系。一种试图在复杂模型中洞察单个预测子的方法是,将所有其他选定的预测子固定为单一值,然后通过改变感兴趣的预测子来观察对结果的影响。这种方法称为部分依赖图(partial dependence plot),它过于简单,只能提供关于预测子真实影响的一小部分洞见。
在这里,我们想重新聚焦从模型中移除预测子的动机。主要动机应该是要么缓解预测子与模型之间相互作用中的特定问题,要么降低模型复杂度。例如:
- 一些模型,特别是支持向量机(support vector machine, SVM)和神经网络(neural network),对无关预测子很敏感。如下所示,多余的预测子在某些情况下会导致预测性能下降。
- 其他模型如线性回归或逻辑回归容易受到相关预测子的影响(见第 6 章)。移除相关预测子将减少多重共线性(multicollinearity),从而使这些类型的模型能够被拟合。
- 即使预测模型对额外预测子不敏感,纳入能够提供可接受结果的最小可能集合也是合理的科学做法。在某些情况下,移除预测子可以降低获取数据的成本或提高用于预测的软件的处理能力(throughput)。
这里的工作前提是,模型中预测子越少通常越好。对于接下来的章节,特征选择的目标将被重新定义为:
在不损害预测性能的前提下,尽可能减少预测子的数量。
有多种方法可以减少预测子集合。下一节概述特征选择技术的一般类别。
10.2 特征选择方法的类别
特征选择方法分为三大类:内在方法(intrinsic method)(或隐式方法(implicit method))、过滤法(filter method)和包装法(wrapper method)。内在方法将特征选择自然地融入建模过程,而过滤法和包装法则致力于将特征选择方法与建模技术结合起来。在减少特征方面,三类方法中最为无缝和重要的是内在方法。一些例子包括:
基于树和基于规则的模型(tree- and rule-based model)。这些模型搜索最佳预测子和分裂点,使得每个新划分(partition)内的结果更加同质(回顾第 5.7 节)。因此,如果某个预测子没有用于任何分裂,它在功能上就独立于预测方程,从而被排除在模型之外。树的集成(ensemble)也具有同样的性质,尽管某些算法,如随机森林(random forest),在构建树时会刻意在无关预测子上强制分裂。这导致预测子的过度选择(over-selection)(如下所示)。
多元自适应回归样条(multivariate adaptive regression spline, MARS)模型。这些模型创建涉及一次一个或两个预测子的数据新特征(第 6.2.1 节)。然后预测子按顺序添加到线性模型中。与树一样,如果某个预测子没有参与至少一个 MARS 特征,它就会被排除在模型之外。
正则化(regularization)模型。正则化方法惩罚或收缩预测子系数以改善模型拟合。套索(lasso)(第 7.3 节)使用一种将系数收缩到绝对零的惩罚。这迫使预测子被排除在最终模型之外。
隐式特征选择方法的优点是它们相对较快,因为选择过程嵌入在模型拟合过程中;不需要外部特征选择工具。此外,隐式方法在选择特征与目标函数(objective function)之间提供了直接联系。目标函数是模型试图优化的统计量(例如,广义线性模型中的似然(likelihood)或基于树的模型中的不纯度(impurity))。选择与建模目标之间的直接联系使得在特征稀疏性和预测性能之间做出明智的选择更加容易。
内在特征选择的主要缺点是它依赖于模型。如果数据更适合使用非内在特征选择类型的模型,那么当使用所有特征时,预测性能可能是次优的。此外,一些内在模型(如单棵树模型)使用贪心(greedy)方法进行特征选择。贪心方法通常会识别出预测性能次优的狭窄特征集。本章后面将更详细地讨论这个问题。
如果模型没有内在特征选择,则需要某种搜索程序来识别能够提高预测性能的特征子集。为此目的有两类通用技术:过滤法和包装法。
过滤法对预测子进行初始的有监督分析,以确定哪些是重要的,然后只将这些预测子提供给模型。在这里,搜索只执行一次。过滤法通常单独考虑每个预测子,尽管这并不是必需的。第 5.6 节出现了一个过滤的例子,我们考虑了一组从 OkCupid 文本字段中导出的关键词。关键词出现与结果之间的关系使用比值比(odds-ratio)进行评估。保留或排除某个词的依据(即过滤规则)基于统计显著性和比值比的大小。通过过滤的词随后被添加到逻辑回归模型中。由于每个关键词都是单独考虑的,它们不太可能捕捉到数据中的独立趋势。例如,programming 和 programmer 这两个词都通过过滤标准被选中,并且相对于结果而言代表几乎相同的含义。[78] 过滤器简单且往往很快。此外,它们能有效捕捉数据中的大趋势(即单个预测子与结果之间的关系)。然而,如上所述,它们容易过度选择预测子。在许多情况下,某种统计显著性度量被用来判断“重要性”,如原始或多重性调整后的 p 值(p-value)。在这些情况下,过滤法的目标函数(例如,显著性)与模型所需的目标函数(预测性能)之间可能存在脱节。换句话说,满足过滤标准(如统计显著性)的预测子选择可能不是一组能提高预测性能的选择。过滤器将在第 11 章中更详细地讨论。
包装法使用迭代搜索程序,反复向模型提供预测子子集,然后使用由此产生的模型性能估计来指导下一个要评估的子集的选择。如果成功,包装法将迭代到更小的预测子集合,其预测性能优于原始预测子集合。包装法可以采取贪心或非贪心(non-greedy)的方法进行特征选择。贪心搜索是一种根据当时看起来最好的方向来选择搜索路径以获得最佳即时收益的方法。虽然这可能是一种有效的策略,但它可能在预测性能上显示出即时收益,却停滞在局部最优设定上。非贪心搜索方法会重新评估先前的特征组合,并且如果某个方向在当前步骤之后看起来有潜在收益,则能够朝着最初不利的方向移动。这使非贪心方法能够避免被困在局部最优中。
贪心包装法的一个例子是向后选择(backwards selection)(也称为递归特征消除(recursive feature elimination, RFE))。在这里,预测子最初按某种重要性度量排序。使用完整的预测子集合创建初始模型。下一个模型基于较小的预测子集合,其中已移除最不重要的预测子。这个过程沿着规定的路径(基于重要性生成的排序)继续,直到模型中只剩下很少的预测子。使用性能估计来确定何时移除过多特征;希望更小的预测子子集能够带来改进。请注意,RFE 过程是贪心的,因为它将变量排序视为搜索方向。它不会在任何时候重新评估搜索路径,也不会考虑混合重要性水平的子集。如果预测子之间存在重要的交互,其中只有某个预测子在存在其他预测子时才显著,这种特征选择方法很可能会失败。RFE 将在第 11 章和下面的第 10.4 节中更详细地讨论。
非贪心包装法的例子有遗传算法(genetic algorithm, GA)和模拟退火(simulated annealing, SA)。SA 方法是非贪心的,因为它将随机性纳入特征选择过程。该过程的随机成分帮助 SA 找到新的搜索空间,这些空间往往带来更优的结果。这两种技术将在第 12 章中详细讨论。
与简单的过滤器或具有内置特征选择的模型相比,包装法有可能搜索更广泛的预测子子集。它们最有可能找到全局最优的预测子子集(如果存在的话)。主要缺点是这些方法找到最优或接近最优子集所需的计算时间。额外的时间可能过多,以至于适得其反。计算时间问题可能因与之耦合的模型类型而进一步恶化。例如,最需要特征选择的模型(如 SVM 和神经网络)本身可能就非常耗费计算资源。包装法的另一个缺点是它们最有可能使预测子过拟合训练数据,并且需要外部验证(如下所述)。
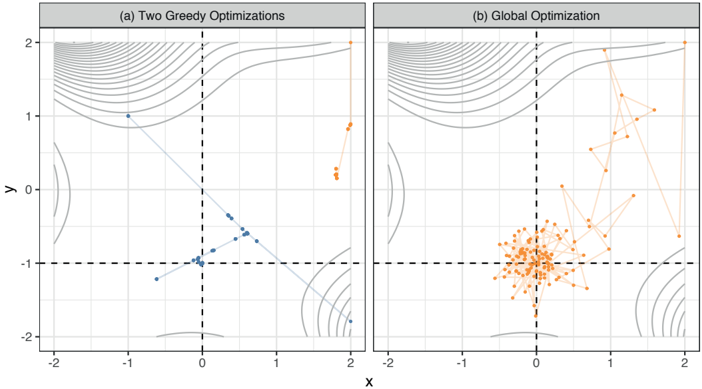
图 10.1 使用 Goldstein-Price 方程直观对比了贪心搜索和非贪心搜索方法:
\[ f(x, y) = \left[1 + (x + y + 1)^2 (19 - 14x + 3x^2 - 14y + 6xy + 3y^2)\right] \times \left[30 + (2x - 3y)^2 (18 - 32x + 12x^2 + 48y - 36xy + 27y^2)\right] \]
这个函数的最小值位于 \(x = 0\) 和 \(y = -1\),其中 x 和 y 都在 -2 和 2 之间。函数的结果在中间相对平坦,沿顶部和右下边缘有较大值。面板 (a) 显示了两种使用梯度下降(gradient descent)寻找最小值的贪心方法的结果。第一个起始值(橙色,右上)沿着梯度定义的路径移动,并停滞在局部最小值。它无法重新评估搜索。第二次尝试,从 \(x = -1\) 和 \(y = 1\) 开始,也遵循不同的贪心路径,经过一些路线修正后,在第 131 次迭代时找到了接近最佳值的解。路径的每次改变都转向立即受益的新方向。面板 (b) 显示了一种称为模拟退火的全局搜索方法。这是一种受控但随机的方法,将在后面更详细地讨论。它使用当前点的随机偏差生成新的候选点。如果新点更好,过程继续。如果它是更差的解,它可能会以一定的概率接受它。通过这种方式,全局搜索并不总是沿着当前最佳方向进行,而是倾向于探索更广泛的候选值范围。在这次特定搜索中,更早(在第 64 次迭代时)就找到了接近最优值的值。
图 10.1:求解具有连续输入的函数时,贪心搜索和全局搜索方法的示例。
鉴于不同类型特征选择方法的优点和缺点,应该如何利用这些技术?我们在实践中使用的一个好策略是,用一个或多个内在方法开始特征选择过程,看看它们能产生什么结果。请注意,期望使用内在特征选择的模型选择相同的预测子子集是不现实的,尤其是在比较线性和非线性方法时。如果非线性内在方法具有良好的预测性能,那么我们可以继续使用与非线性模型结合的包装法。类似地,如果线性内在方法具有良好的预测性能,那么我们可以继续使用与线性模型结合的包装法。如果多种方法都选择了较大的预测子集合,那么这可能意味着减少特征数量可能不可行。
在继续之前,让我们考察无关预测子对不同类型模型的影响,以及这种影响在不同场景下如何变化。
10.3 无关特征的影响
多余的预测子对模型的伤害有多大?可以预见,这取决于模型的类型、预测子的性质以及训练集大小与预测子数量的比率(即 p : n 比率(p : n ratio))。为了研究这一点,使用模拟来生成具有不同数量无关预测子的数据并监测性能。模拟系统取自 Sapp 等(2014),由 20 个相关预测子的非线性函数组成:
每个预测子都是使用独立的标准正态随机变量生成的,误差被模拟为均值为零、标准差为 3 的随机正态分布。为了评估额外变量的影响,添加了不同数量的随机标准正态预测子(与结果无关)。在原始特征集上追加了 10 到 200 个额外列。训练集大小为 \(n = 500\) 或 \(n = 1{,}000\)。使用均方根误差(root mean squared error, RMSE)在大型模拟测试集上衡量模型的质量,因为 RMSE 是不可约误差(irreducible error)的良好估计。
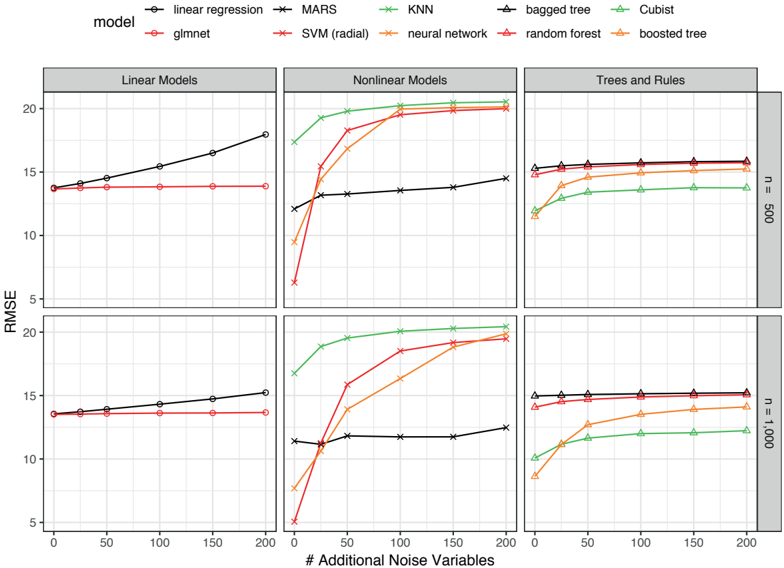
图 10.2:不同模型和模拟配置下的 RMSE 趋势。
针对每个模拟数据集,对许多模型进行了调优和训练,包括线性、非线性和基于树/规则的模型。[79] 每个模型的细节和代码可以在 GitHub 仓库 [80] 中找到,结果总结如下。
图 10.2 显示了结果。线性模型(普通线性回归和 glmnet)整体表现平庸。额外预测子削弱了线性回归的性能,而 glmnet 使用的套索惩罚使得性能在无关预测子数量增加时保持稳定。当训练集大小从 500 增加到 1,000 时,对线性回归的影响变小。这印证了 p : n 比率可能是根本问题的观点。
非线性模型有不同的趋势。K 近邻(K-nearest neighbors)整体表现不佳,受 p 增加的影响中等。MARS 表现良好,并且由于该模型使用的内在特征选择,对噪声特征表现出良好的抵抗能力。同样,额外预测子的影响在较大的训练集下更小。单层神经网络和支持向量机在没有添加额外预测子时显示出整体最佳性能(最接近可能的最佳 RMSE 3.0)。然而,两种方法都因包含噪声预测子而受到严重影响,以至于在模拟中表现出最差的性能之一。
对于树来说,随机森林和装袋(bagging)表现出相似但平庸的性能,不受 p 增加的影响。基于规则的集成模型 Cubist 和提升树(boosted tree)表现更好。然而,随着无关预测子的添加,两种模型都表现出中等程度的性能下降;提升比 Cubist 更容易受到这个问题的影响。
这些结果清楚地表明,有许多模型可能需要减少预测子以避免性能下降。此外,对于随机森林或 glmnet 等模型,特征选择似乎可能有助于找到更小的预测子子集,而不影响模型的有效性。
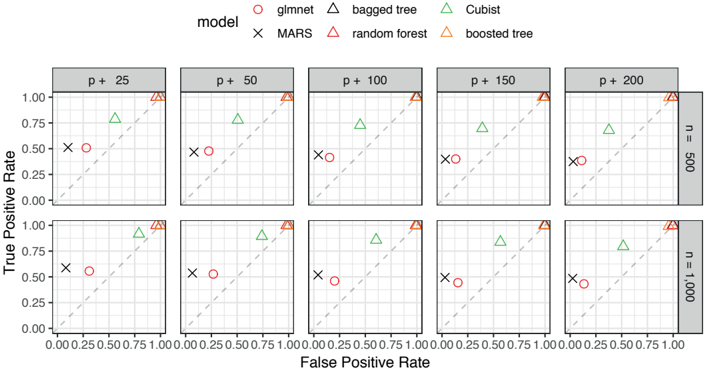
由于这是一个模拟,我们还可以评估具有内置特征选择的模型在找到正确预测子子集方面的表现。数据中有 20 个相关预测子。根据选择了哪些预测子,可以计算一个类似灵敏度(sensitivity)的比例,描述真实预测子被保留在模型中的比率。类似地,被选择的无关预测子的数量可以让人了解选择程序的假阳性率(false positive rate)(即 1 减去特异度(specificity))。图 10.3 使用与 ROC 曲线可视化方式类似的图显示了这些结果。
三个树集成(装袋、随机森林和提升)具有极好的真阳性率;真正相关的预测子几乎总是被保留。然而,它们在无关预测子上也表现出较差的结果,选择了许多噪声变量。这在一定程度上与模拟的性质有关,即大多数预测子以平滑、连续函数的形式进入系统。这可能导致基于树的模型过于努力地通过训练深层树或更大的集成来实现性能。
Cubist 的结果更平衡,真阳性率大于 70%。对于较小的训练集大小,假阳性率约为 50%,而当训练集更大且额外预测子小于或等于 100 时,假阳性率增加。Cubist 与树集成结果之间的整体差异可以解释为:Cubist 使用在训练集的小子集(由规则定义)上拟合的线性回归模型集成。这种类型的模型可能更适合模拟系统的性质。
图 10.3:模拟数据集中特征选择结果的类 ROC 图。p 值表示相关预测子的数量,附加数字表示无关预测子的数量。
回想一下,随机森林的主要调优参数 \(m_{\text{try}}\) 是每次分裂时应评估的随机选择的变量数量。虽然这鼓励了多样的树(以提高性能),但它可能需要分裂无关预测子。随机森林经常在大多数预测子上分裂(无论其重要性如何),并且会大大过度选择预测子。因此,可能需要额外的分析,基于该模型的变量重要性得分来确定哪些预测子真正必要。此外,树总体上对高度相关预测子的重要性估计不佳。例如,添加一个与另一个预测子完全相同的重复列,会在数值上稀释这些模型生成的重要性得分。因此,使用这些模型时,重要预测子的排名可能很低。
MARS 和 glmnet 在这些模拟中也在灵敏度和特异度之间做出权衡,且倾向于特异度。这些模型的假阳性率低于 25%,真阳性率通常在 40% 到 60% 之间。
10.4 对预测子过拟合与外部验证
第 3.5 节介绍了在模型调优参数选择期间对可用数据过拟合问题的一个简单例子。该示例说明了找到过度学习训练集中预测子与结果之间关系的调优参数值的风险。当模型过度解读训练集中的模式时,新数据的预测性能会受到影响。解决这个问题的方法是在不用于估计模型参数的数据集(通过验证集或评估集)上评估调优参数。
执行特征选择时也会出现类似的问题。对于许多数据集,有可能找到一个预测子子集,它在训练集上具有良好的预测性能,但在测试集或其他新数据集上使用时表现不佳。解决这个问题的方法类似于解决过拟合问题的方法:特征选择需要成为重采样(resampling)过程的一部分。
不幸的是,尽管有这种需要,实践者经常不适当地组合特征选择和重采样。最常见的错误是只在特征选择程序内部进行重采样。例如,假设模型中有五个预测子(标记为 A 到 E),每个预测子都有一个从训练集得出的相关重要性度量(A 最重要,E 最不重要)。应用向后选择,第一个模型将包含所有五个预测子,第二个将移除最不重要的(在此示例中为 E),依此类推。一种方法的大致框架是:
Algorithm 10.1: An inappropriate resampling scheme for recursive feature elimination.
1 Rank the predictors using the training set;
2 for a feature subset of size 5 to 1 do
3   for each resample do
4     Fit model with the feature subset on the analysis set;
5     Predict the assessment set;
6   end
7 Determine the best feature subset using resampled performance;
8 Fit the best feature subset using the entire training set;
9 end
这个程序有两个关键问题:
- 由于特征选择在重采样之外进行,重采样无法有效衡量选择过程的影响(无论好坏)。在这里,重采样没有接触到选择过程中的变异,因此无法衡量其影响。
- 相同的数据被用来衡量性能并指导选择程序的走向。这类似于将模型拟合到训练集,然后重新预测同一集合来衡量性能。如果模型能够紧密拟合训练数据,就可能出现明显的偏差。需要某种样本外(out-of-sample)数据来准确判断模型的表现。如果选择过程导致过拟合,就没有剩余的数据可能告知我们这个问题。
作为这个问题的一个真实例子,Ambroise 和 McLachlan (2002) 重新分析了 Guyon 等 (2002) 的结果,其中来自 RNA 表达微阵列(RNA expression microarray)的高维分类数据被建模。在这些分析中,样本数量很少(即少于 100),而预测子数量很多(2K 到 7K)。使用线性支持向量机拟合数据,并使用向后消除(即 RFE)进行特征选择。原始分析使用留一法(leave-one-out, LOO)交叉验证和上述方案。在这些分析中,LOO 重采样报告的误差率非常接近零。然而,当保留一组样本仅用于衡量性能时,测得的误差率高出 15%-20%。在一个 p : n 比率最差的情况下,Ambroise 和 McLachlan (2002) 表明,即使类别标签被打乱,仍然可以达到零 LOO 误差率。
将特征选择与重采样结合的更好方法是使特征选择成为建模过程的一个组成部分。特征选择应该以与预处理和其他工程任务相同的方式纳入。我们的意思是,执行特征选择的适当方式是在重采样过程内部进行。[81] 使用前面五个预测子的例子,重采样内的特征选择算法修改为:
Algorithm 10.2: Appropriate resampling for recursive feature elimination.
1 Split data into analysis and assessment sets;
2 for each resample do
3   Rank the predictors using the analysis set;
4   for a feature subset of size 5 to 1 do
5     Fit model with the feature subset on the analysis set;
6     Predict the assessment set;
7   end
8   Average the resampled performance for each model and feature subset size;
9   Choose the model and feature subset with the best performance;
10  Fit a model with the best feature subset using the entire training set;
11 end
在这个程序中,相同的数据集不会既用于确定最佳子集大小又用于确定子集内的预测子。相反,不同版本的数据用于每个目的。外部重采样循环用于决定选择过程应该沿着移除路径走多远。然后,这被用来决定应该在完整训练集上的最终模型中使用的子集大小。基本上,子集大小被视为调优参数。此外,使用独立的数据来确定选择路径应该采取的方向。方向由在分析集上(重采样内部)或完整训练集上(对于最终模型)计算的变量排序决定。
在重采样过程内部执行特征选择有两个显著的影响。第一个影响是,该过程提供了更现实的预测性能估计。可能很难理解在重采样期间可能选择不同特征集的想法。回想一下,重采样迫使建模过程使用不同的数据集,以便可以准确衡量性能的变异。结果反映了整个建模过程的不同实现。如果特征选择过程不稳定,了解结果可能有多嘈杂是有帮助的。最终,重采样被用来衡量整个建模过程的整体性能,并试图估计当最终模型使用最佳预测子在训练集上拟合时的性能。第二个影响是计算负担的增加。[82] 对于对调优参数选择敏感的模型,可能需要在评估每个子集时重新调优模型。在这种情况下,需要单独的嵌套重采样(nested resampling)过程来调优模型。在许多情况下,计算成本可能使搜索工具实际上不可行。
在选择过程不稳定的情况下,使用多个重采样是一种昂贵但值得的方法。如果数据集很小,和/或特征数量很大,或者存在极端的类别不平衡(class imbalance),就可能发生这种情况。当数据稍微改变时,这些因素可能产生不同的特征集。在另一个极端,大型数据集往往大大降低特征选择期间对预测子过拟合的风险。在这种情况下,使用单独的数据划分分别进行特征排序/过滤、建模和评估,既高效又有效。
10.5 案例研究
我们最近的一次合作凸显了不正确组合特征选择和重采样的危险。在这个问题中,一位研究人员从两个类别中各收集了 75 个样本。每个数据点大约有 10,000 个预测子。最终目标是尝试识别一个预测子子集,该子集能够以至少 80% 的准确率将样本分类到正确的响应中。
研究人员选择使用 70% 的数据作为训练集,10 折交叉验证(10-fold cross-validation)用于模型训练,以及 glmnet 和随机森林的隐式特征选择方法。在广泛搜索每个模型的调优参数空间后,找到的最佳交叉验证准确率略低于 60%,远非期望的性能。降低问题的维度可能会有帮助,因此接下来尝试了主成分分析(principal component analysis, PCA)后跟线性判别分析(linear discriminant analysis, LDA)和偏最小二乘判别分析(partial least squares discriminant analysis, PLS-DA)。不幸的是,这些方法的交叉验证准确率甚至更差。
研究人员推测,找到预测变量子集的部分挑战在于数据中大量无关预测子。逻辑是先识别并选择与响应具有单变量(univariate)信号的预测子。
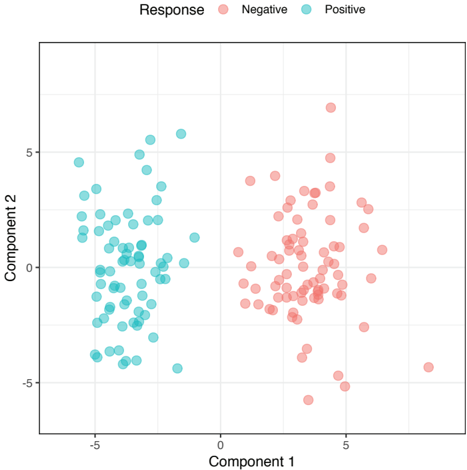
图 10.4:对在重采样之外使用特征选择程序识别出的顶部特征应用前两个主成分。执行该程序的预测子和响应是随机生成的,表明在重采样之外进行特征选择会导致虚假(spurious)结果。
对每个预测子执行 t 检验(t-test),预测子按分离类别的显著性排序。选择前 300 个预测子进行建模。
为了证明这种选择方法能够识别出捕捉分类响应最佳预测子的预测子,研究人员对 300 个预测子执行了主成分分析,并将样本投影到前两个成分上,按响应类别着色。该图显示组间几乎完美的分类,研究人员得出结论,有很好的证据表明存在可以对样本进行分类的预测子。
遗憾的是,由于特征选择是在重采样之外执行的,发现的明显信号仅仅是由于随机机会。事实上,可以证明研究人员使用的单变量特征选择过程在完全随机的数据中也能在两组之间产生完美分离。为了说明这一点,我们生成了一个 150×10,000 的随机标准正态数矩阵(\(\mu = 0\) 和 \(\sigma = 1\))。响应也是随机选择的,每个类别中有 75 个样本。对每个预测子执行 t 检验,并选择前 300 个预测子。按响应状态着色的样本在前两个主成分上的投影图显示在图 10.4 中。
显然,使用此程序具有良好的分离度并不意味着所选特征具有预测响应的能力。相反,明显的分离同样可能是由于随机机会和不正确的特征选择程序造成的。
10.6 后续步骤
在接下来的章节中,将结合示例重新审视这里介绍的主题。在下一章中,将描述贪心选择方法(如简单过滤器和向后选择)。随后的一章将描述更复杂(且计算成本更高)的非贪心方法,这些方法更有可能找到更好的局部最优解。
10.7 计算
网站 http://bit.ly/fes-selection 包含用于重现这些分析的 R 程序。
[78] 第 7.3 节在简单筛选(simple screening)的背景下讨论了一个这样的例子。
[79] 显然,该数据集需要非线性模型。然而,该模拟用于考察无关预测子的相对影响(而非绝对性能)。对于线性模型,我们假设交互项 \(x_5 x_6\) 和 \(x_{19} x_{20}\) 会被识别出来并纳入线性模型。
[80] https://github.com/topepo/FES_Selection_Simulation
[81] 即使是单一的(希望是较大的)验证集也是如此。
[82] 第 12 章描述的全局搜索方法也会加剧这一问题。