处理档案数据(Working with Profile Data)
让我们回顾一下前面几个数据集都预测了什么:
- 爱荷华州(Iowa)一所房子的价格
- 克拉克站和莱克站(Clark and Lake)的每日火车客运量
- 在步道上采集的粪便样本的物种
- 患者发生中风(stroke)的概率
从这些例子来看,预测单元(unit of prediction)相当容易确定,因为数据结构很简单。对于住房数据,我们知道位置、结构特征、最近一次销售价格等等。数据结构一目了然:行是房子,列是描述房子的字段。每行对应一所房子,而且在大多数情况下,我们可以假定这些房子在统计上是相互独立的。用统计学的术语来说,房子就是数据的独立实验单元(experimental unit)。由于我们是针对房产(而非邮政编码或其他聚合层级)进行预测,因此房产就是预测单元。
但情况并不总是如此。稍微换个例子,来看看芝加哥的火车数据。该数据集的行对应具体的日期,列是这些日期的特征:节假日指示变量、一周前其他车站的客运量,等等。预测是按天进行的;天就是预测单元。不过,请回忆一下,数据中还有天气测量值。天气数据每天获取多次,通常每小时一次。例如,2001 年 1 月 5 日的前 15 个测量值如表 9.1 所示。这些小时级数据与预测单元(按天)并不一致。我们可以预期,在一天之内,小时级测量值之间的相关性,要高于它们与从整个数据集中随机抽取的其他任意天气测量值之间的相关性。因此,这些测量值在统计上是相互依赖的。76
由于目标是进行逐日预测,日内天气测量值的档案(profile)应当以保留潜在预测信息的方式在日层面进行汇总。就这个例子而言,日级特征可以包括数值数据的均值或中位数,或许还有一天内取值的极差(range)。此外,还可以用斜率来汇总特征的变化速率。对于定性的天气状况,可以计算一天中被记录为「晴朗」(Clear)、「阴天」(Overcast)等的时长百分比,从而将特定日期的天气状况纳入用于分析的数据集。
76 然而,公平地说,逐日测量值彼此之间也有一定程度的相关性。
表 9.1:芝加哥小时级天气数据的一个示例。
| 时间 | 温度 | 湿度 | 风速 | 天气状况 |
|---|---|---|---|---|
| 00:53 | 27.0 | 92 | 21.9 | Overcast |
| 01:53 | 28.0 | 85 | 20.7 | Overcast |
| 02:53 | 27.0 | 85 | 18.4 | Overcast |
| 03:53 | 28.0 | 85 | 15.0 | Mostly Cloudy |
| 04:53 | 28.9 | 82 | 13.8 | Overcast |
| 05:53 | 32.0 | 79 | 15.0 | Overcast |
| 06:53 | 33.1 | 78 | 17.3 | Overcast |
| 07:53 | 34.0 | 79 | 15.0 | Overcast |
| 08:53 | 34.0 | 61 | 13.8 | Scattered Clouds |
| 09:53 | 33.1 | 82 | 16.1 | Clear |
| 10:53 | 34.0 | 75 | 12.7 | Clear |
| 11:53 | 33.1 | 78 | 11.5 | Clear |
| 12:53 | 33.1 | 78 | 11.5 | Clear |
| 13:53 | 32.0 | 79 | 11.5 | Clear |
| 14:53 | 32.0 | 79 | 12.7 | Clear |
再举一个例子:假设中风数据是在患者住院期间收集的。如果研究包含随时间变化的纵向测量值,我们可能就有兴趣预测随时间推移发生中风的概率。在这种情况下,预测单元是某一天的患者,但独立的实验单元只是患者本身。
在某些情况下,可能存在多重层级结构。以在线教育为例,我们会有兴趣预测某位学生能成功完成哪些课程。例如,假设有 10,000 名学生选修了在线课程「数据科学 101」(标记为 DS101)。其中有些人成功完成,另一些人则没有。这些数据可以用来在学生的层面上建立合适的模型。要为模型工程化特征,就应该考虑数据结构。对于学生来说,可能的预测子包括人口统计学信息(例如年龄等),而另一些预测子则与他们先前其他课程的经历有关。如果他们成功完成了其他 10 门课程,那么与没有完成 10 门课程的学生相比,我们有理由认为他们更有可能学得好。对于选修 DS101 的学生,更详细的数据集可能如下所示:
| 学生 | 课程 | 分节 | 作业 | 开始时间 | 结束时间 |
|---|---|---|---|---|---|
| Marci | STAT203 | 1 | A | 07:36 | 08:13 |
| : | : | : | : | : | : |
| Marci | CS501 | 4 | Z | 10:40 | 10:59 |
| David | STAT203 | 1 | A | 18:26 | 19:05 |
| : | : | : | : | : | : |
层级结构是:作业嵌套在分节内,分节嵌套在课程内,课程嵌套在学生内(assignment-within-section-within-course-within-student)。如果 STAT203 和 CS501 都是 DS101 的先修课程,那么可以稳妥地假设会存在一个相对完整的数据集。如果是这样,就可以创建非常具体的特征,例如「在 STAT203 中完成计算 t 检验作业的时间,是否能预测他们通过或完成数据科学课程的能力?」有些特征可以在课程层面汇总(例如完成 CS501 课程的总时间),也可以在分节层面汇总。这种层级结构的丰富性使得模型能够使用一些有趣的特征,但它也提出了一个问题:「汇总档案数据(profile data)是否有好坏之分?」
遗憾的是,这个问题的答案取决于问题本身和档案数据的性质。不过,关于数据中变异和相关性的性质,还是有一些方面值得考虑。
生物科学中的高内涵筛选(high content screening, HCS)数据是另一个例子(Giuliano et al., 1997; Bickle, 2010; Zanella et al., 2010)。为了获得这类数据,科学家用药物处理细胞,然后测量细胞的各种特征,例如细胞的整体形状、细胞核的大小,以及特定蛋白质在细胞核外的含量。
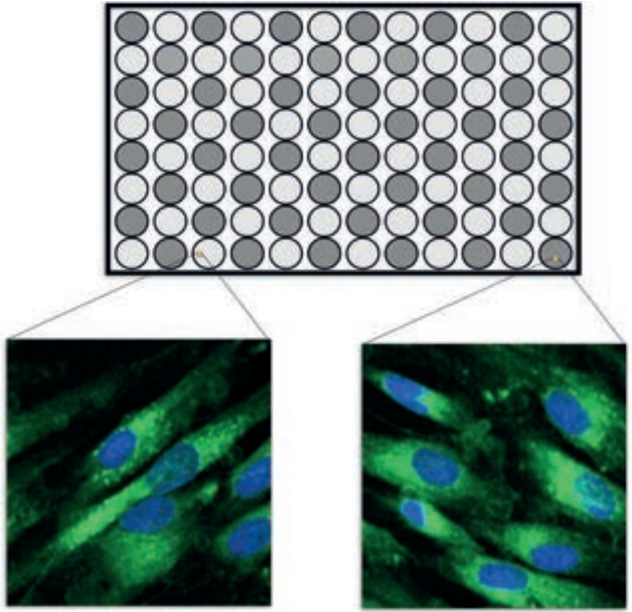
HCS 实验通常在微量滴定板(microtiter plate)上进行。例如,最小的板有 96 个孔(well),可以容纳不同的液体样本(通常是 8 行 12 列的排列,如图 9.1 所示)。每个孔中会加入一份细胞样本,同时加入某种处理(例如候选药物)。处理后,用显微镜对细胞成像,每个孔内通常会在特定位置拍摄一组图像(Holmes and Huber, 2019)。假设平均每个图像中有 200 个细胞,每个孔拍摄 5 张图像。通常可以安全地把孔内的图像合并起来,这样数据结构就变成:细胞嵌套在孔内,孔嵌套在板内(cell within well within plate)。每个细胞都通过图像分析进行量化,因此底层特征处于细胞层面。
然而,要对药物进行预测,数据需要在孔的层面上进行汇总。一种做法是对细胞属性取简单的平均值和标准差,例如平均细胞核大小、平均蛋白质丰度等。这种方法的问题在于它会破坏细胞数据的相关结构(correlation structure)。细胞层面的特征高度相关是很常见的。一个明显的例子是,细胞中某种蛋白质的丰度与细胞的总体大小相关。假设细胞特征 \(X\) 和 \(Y\) 是相关的。如果这两个值的一个重要特征是它们的差值,那么有两种计算方法。可以先在孔内计算出平均值 \(\bar{X}\) 和 \(\bar{Y}\),然后再计算两个平均值之差;或者,可以先对每个细胞计算差值(\(D_i = X_i - Y_i\)),再对这些差值取平均(即 \(\bar{D}\))。这有区别吗?如果 \(X\) 和 \(Y\) 高度相关,区别就非常大。根据概率论我们知道,差值的方差是:
图 9.1:高内涵筛选中微量滴定板的示意图。深色孔可能是经处理的细胞,而浅色孔则是对照组。每个孔内拍摄多张图像,每张图像中的细胞以不同方式被分离和量化。绿色代表细胞边界,蓝色描述细胞核。
如果两个细胞特征相关,协方差(covariance)可能很大。如果在孔的层面上先对特征求差分再取平均,方差就会大幅降低。正如 Wickham 和 Grolemund (2016) 所指出的:
「如果你把变异(variation)视为一种制造不确定性的现象,那么共变异(covariation)就是一种减少它的现象。」
先取平均值再求差值会忽略协方差项,从而产生噪声更大的特征。
复杂的数据结构在医学研究中非常普遍。现代测量设备,如活动记录仪(actigraphy)监测器和磁共振成像(magnetic resonance imaging, MRI)扫描仪,可以在极短的时间内为每个受试者生成数百个测量值。同样,脑电图(electroencephalogram, EEG)或心电图(electrocardiogram, ECG)等医疗设备可以提供与患者大脑或心脏活动相关的密集、连续的测量流。这些测量设备正越来越多地被纳入医学研究,以识别与结果相关的重要信号。例如,Sathyanarayana 等人 (2016) 使用活动记录仪数据预测睡眠质量,Chato 和 Latifi (2017) 研究了脑癌患者 MRI 图像与生存期之间的关系。
在医学研究越来越频繁地使用能够获取密集、连续测量值的设备的同时,许多其他研究领域也在收集类似类型的数据。在设备维护领域,卡特彼勒公司(Caterpillar Inc.)收集已部署机器的连续实时数据,以推荐能够更好地优化性能的调整方案(Marr, 2017)。
总而言之,一些复杂的数据集可能具有多层数据层级结构,这些层级可能需要被压缩,以使建模数据集与预测单元保持一致。汇总数据有好的做法也有坏的做法,但具体策略通常因学科而异。
本章的其余部分是一个扩展的案例研究,其中预测单元包含多层数据。这是一个科学数据集,其中有大量高度相关的预测子、独立的时间效应以及其他因素。与图 1.7 类似,这个例子表明,良好的预处理和特征工程对结果的影响可能比所用模型的类型更大。
9.1 示例数据:药品生产监测
制药公司使用光谱测量(spectroscopy)来评估生物药(biological drug)生产过程中的关键工艺参数(Berry et al., 2015)。基于该工艺建立的模型可以与实时数据一起使用,推荐能够提高产品产率(yield)的调整方案。在下面的例子中,数据是通过拉曼光谱(Raman spectroscopy)生成的(Hammes, 2005)77。要制造本例所用的药物,需要一种特定类型的蛋白质,而这种蛋白质可以由一种特定的细胞产生。一批细胞被接种到生物反应器(bioreactor)中,生物反应器是一种旨在帮助细胞生长和维持的装置。在生产中,大型生物反应器约为 2000 升,用于在大约两周内生产大量的蛋白质。
77 本示例使用的数据由真实数据生成,但已被明显修改,以保护机密性并达到示例目的。
许多因素都会影响产品产率。例如,由于细胞是活的、在工作中的生物体,它们需要合适的温度和充足的食物(葡萄糖)来生成药物产品。在工作过程中,细胞还会产生废物(氨)。过多的废物会杀死细胞并降低整体产品产率。通常,葡萄糖和氨等关键属性每天都会被监测,以确保细胞处于最佳生产状态。样本被采集后,会对这些关键属性进行离线测量。如果测量结果表明存在潜在问题,监督工艺的制药科学家就可以调整生物反应器的内容物,以优化细胞所处的条件。
一个问题是,测量葡萄糖和氨的传统方法非常耗时,结果可能无法及时得出以应对任何问题。如果能用有效的模型将光谱检测的结果转化为对目标物质(即葡萄糖和氨)的预测,光谱法就是一种可能更快的获取这些结果的方法。
然而,使用许多大型生物反应器进行实验是不可行的。为此使用了两个并行的实验系统:
- 15 个小型(5 升)生物反应器接种了细胞,并连续 14 天每日监测。
- 3 个大型生物反应器也接种了来自同一批次的细胞,并连续 14 天每日监测。
每天从所有生物反应器中采集样本,并同时使用光谱法和传统方法测量葡萄糖。图 9.2 展示了该实验的设计。目标是利用数量更多的小型生物反应器的数据建立模型,然后评估这些结果能否准确预测大型生物反应器中发生的情况。
图 9.2:制药生产实验设计的示意图。
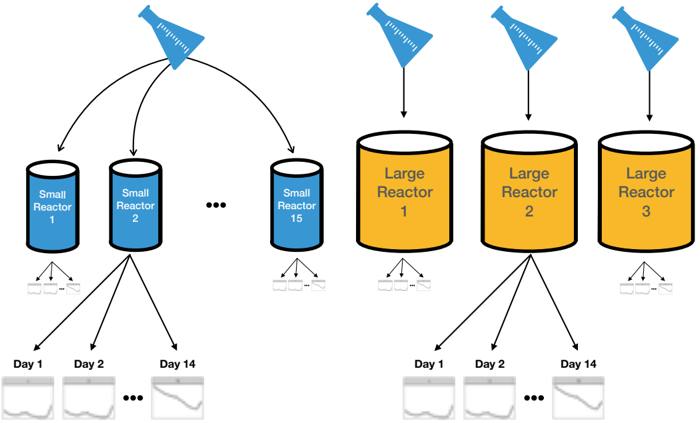
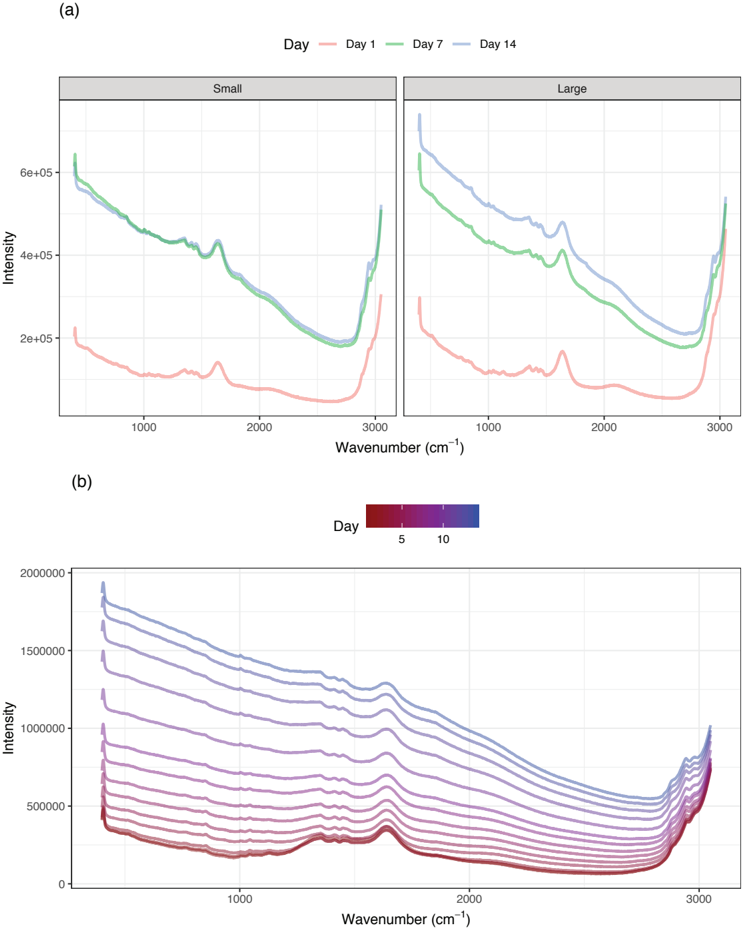
图 9.3(a) 展示了一个小型和一个大型生物反应器内若干天的光谱。这些光谱的谱线呈现出相似的模式,显著峰出现在跨天相似的波长区域。然而,强度的高度在小型生物反应器内部以及小型与大型生物反应器之间都有所变化。为了了解光谱在两周内的变化情况,请看图 9.3(b)。大多数谱线在波数(wavenumber)范围内具有相似的整体模式,强度随时间递增。其他生物反应器也呈现同样的模式,只是各自带有独特的强度偏移。
图 9.3:(a) 第 1、7 和 14 天小型与大型生物反应器的光谱。(b) 单个反应器在 14 天内的光谱。
9.2 实验单元和预测单元是什么?
在两周的时间里,15 个小型生物反应器中的每一个都每天测量近 2600 个波长(wavelength)。这类数据形成一种层级结构:波长在每个日内测量,而每个日又位于每个生物反应器内。换句话说,波长测量值嵌套(nested)在日内,而日又进一步嵌套在生物反应器内。嵌套数据结构的一个特征是,同一嵌套内的测量值之间的关联程度,高于不同嵌套之间的测量值。在这里,一天内的波长彼此之间的关联或相关性,高于不同天之间的波长;而不同天之间的波长彼此之间的相关性,又高于不同生物反应器之间的波长。
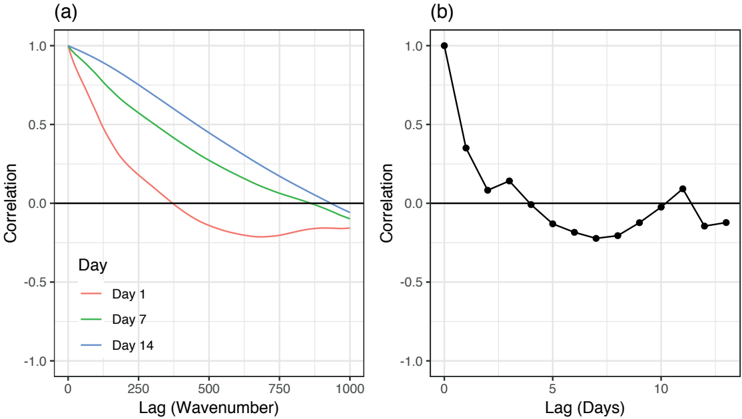
一天内以及生物反应器内波长之间这些错综复杂的关系,可以通过自相关(autocorrelation)图来观察。自相关是原始序列与该序列每个依次滞后的版本之间的相关性。一般来说,自相关随着滞后(lag)值的增大而减小,并且在存在季节性趋势时,较后的滞后处自相关可能会增大。第一个生物反应器若干天的波长自相关图如图 9.4(a) 所示(它代表了其他生物反应器与日期组合中波长关系的典型情况)。该图表明,不同日期之间波长间的相关性是不同的。较晚的日期往往具有更高的波长间相关性,但在所有情况下,都需要数百个滞后才能使相关性降到零以下。
层级结构的再上一层是生物反应器内部跨天的情况。这里也可以使用自相关来理解该层级的相关结构。为了计算自相关,先在一个生物反应器和一天内对跨波长的强度取平均。然后让平均强度在日期之间滞后,并计算各滞后之间的相关性。这里同样以小型生物反应器 1 作为代表性示例。图 9.4(b) 显示了前 13 个滞后日的自相关。第一个滞后的相关性大于 0.95,之后相关性衰减得相当快。
图 9.4:(a) 小型生物反应器 1 第一天波长的选定滞后自相关。(b) 小型生物反应器 1 平均波长强度的日滞后自相关。
层级结构的最顶层是生物反应器。由于一个生物反应器内发生的反应不会影响另一个反应器内发生的情况,因此这一层的数据彼此独立。如上所述,生物反应器内部的数据彼此之间可能是相关的。那么预测单元是什么呢?由于光谱都是同时测量的,我们可以认为这一层级位于预测单元之下;我们不会在某个特定的波长上做预测。该模型的使用场景是:针对细胞已经生长了特定天数的生物反应器进行预测。因此,预测单元是生物反应器内的天(day within bioreactor)。
理解实验单元将指导交叉验证(cross-validation)方法的选择(第 3.4 节),并且对于诚实地评估模型在新日期上的预测能力至关重要。例如,考虑把(每个生物反应器内的)每一天都当作独立的实验单元,并使用 V 折交叉验证(V-fold cross-validation)作为重抽样(resampling)技术。在这种情况下,同一生物反应器内的日期很可能同时出现在分析集和评估集中(图 3.5)。考虑到一天内存在大量相关数据,这是一个糟糕的想法,因为它会导致对模型的人工乐观评价。
更合适的重抽样技术是整体留出一个或多个生物反应器的全部数据。模型中会使用日期效应,因此当每个生物反应器被分配到分析集或评估集时,其对应不同日期的数据集合也应随之移动。在最后一节中,我们将比较这两种重抽样方法。
接下来的几节描述了应用于这类数据的一系列预处理方法。虽然这些方法对光谱数据最为有用,但它们说明了如何将预处理和特征工程应用于不同的数据层。
9.3 减少背景
图 9.3 中可以看到的一个特征是,小型和大型生物反应器的每日数据在强度轴上发生了偏移,并且在高波长处往往呈下降趋势。对于光谱数据,强度偏离零的现象称为基线漂移(baseline drift),通常由测量系统中的噪声、干扰或荧光(fluorescence)引起(Rinnan et al., 2009),而不是由样本中的实际化学物质引起。基线漂移是测量变异的主要来源;对于图 9.3 中的小型生物反应器,纵向变异远大于光谱中可能与葡萄糖含量相关的峰所导致的变异。由造成背景的虚假来源带来的多余变异,会对主成分回归和偏最小二乘等由预测子变异驱动的模型产生不利影响。
对于这类数据,如果背景被完全消除,那么对样本中存在的分子没有响应的波数,其强度将为零。虽然在测量过程中可以采取具体措施来减少噪声、干扰和荧光,但要通过实验去除所有背景几乎是不可能的。因此,必须对背景模式进行近似,并从观测到的强度中去除这个近似值。
一种简单而巧妙的背景近似方法是:用多项式对整条光谱中强度最低的值进行拟合。该过程的算法如下:
算法 9.1:使用多项式函数进行背景校正。
- 1 选择多项式次数 \(d\) 和最大迭代次数 \(m\);
- 2 当所选点的数量大于 \(d\) 且迭代次数小于 \(m\) 时,执行:
- 3 对数据拟合一个次数为 \(d\) 的多项式;
- 4 计算残差(观测值减去拟合值);
- 5 将数据子集化为残差为负的点;
- 6 结束
- 7 从原始谱线中减去估计的基线;
对大多数数据而言,用 3 到 5 次的多项式来近似基线通常就足够了。
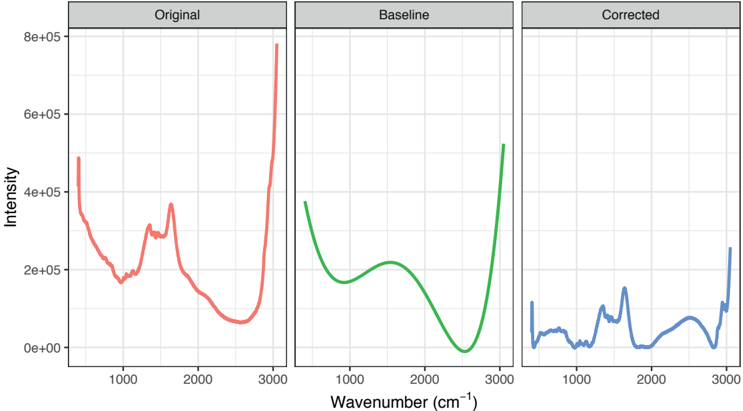
图 9.5 展示了原始光谱、次数 \(d = 5\) 的最终多项式拟合,以及跨波长的校正后强度。虽然光谱中仍有高于零的区域,但光谱已被变形,使得低强度区域接近零。
图 9.5:小型生物反应器 1 第 1 天强度的多项式基线校正。
9.4 减少其他噪声
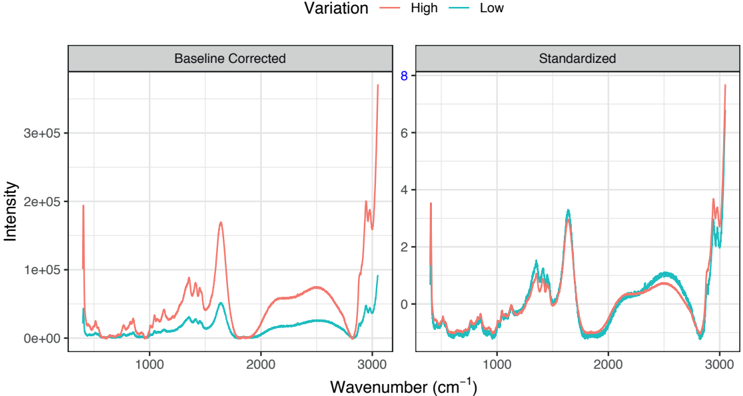
处理档案数据的下一步是减少无关的噪声。这些数据中的噪声以两种形式出现。首先,不同生物反应器之间,各光谱的振幅差异很大,这很可能是由测量系统的变异造成的,而不是由样本中分子的类型和数量造成的变异。更能反映样本含量的是光谱之间的相对峰振幅。为了将光谱置于相似的尺度上,基线校正后的强度值会在每条光谱内部进行标准化,使一条光谱的整体均值为零、标准差为 1。光谱学文献将这种变换称为标准正态变量(standard normal variate, SNV)。这种方法可以确保不同样本的样本含量可以直接比较。不过,在使用均值和标准差对数据进行标准化时必须小心,因为这两个汇总统计量都可能受到一个(或少数几个)极端而有影响力的值的影响。为了防止少数点影响均值和标准差,可以在计算这些统计量时排除最极端的值。这种方法称为修剪(trimming),它能对数据的中心和离散程度提供更稳健的估计,从而反映绝大多数数据的典型情况。
图 9.6 比较了变异最小和变异最大的光谱谱线,其中 (a) 是所有日期和所有小型生物反应器的基线校正后数据。该图表明,谱线的振幅可能差异很大。在标准化之后 (b),谱线变得更具直接可比性,这将使光谱中由样本含量引起的更细微变化能够被识别为与响应相关的信号。
图 9.6:(a) 变异最大和最小的光谱的基线校正后强度。(b) 每条光谱标准化为均值 0、标准差 1 之后的光谱。
第二个噪声来源在光谱内每个波长的强度测量值中也很明显。这可以从图 9.5 的「原始」(Original)或「校正后」(Corrected)面板所示谱线的锯齿状特征中看出。减少这类噪声可以通过几种不同的方法实现,例如平滑样条(smoothing spline)和移动平均(moving average)。要在点 \(p\) 处计算大小为 \(k\) 的移动平均,需要将关于 \(p\) 对称的 \(k\) 个值取平均,然后用该平均值替换当前值。计算移动平均时考虑的点越多,曲线就越平滑。
为了更清晰地看到应用移动平均的影响,我们将考察一个较小的波长区域。图 9.7 聚焦于第一个小型生物反应器第一天波长 950 到 1200 的区域,展示了标准化后的光谱,以及长度为 5、10 和 50 的移动平均。标准化光谱在该区域相当锯齿状。随着移动平均中包含的波长数增加,谱线变得更加平滑。但计算时选择多少个波长才是最佳的呢?诀窍在于找到一个既能代表谱线峰谷总体结构、又不会抹掉这些峰谷的值。在这里,长度为 5 的移动平均消除了标准化谱线的大部分锯齿状特征,但仍能紧密地追踪原始谱线。另一方面,长度为 50 的值不再能代表原始谱线的主要峰谷。对于这些数据,15 这个值似乎是既能保留整体结构的合理选择。
图 9.7:长度为 5、15 和 50 的移动平均应用于第一个小型生物反应器第一天波长 950 到 1200 的数据。
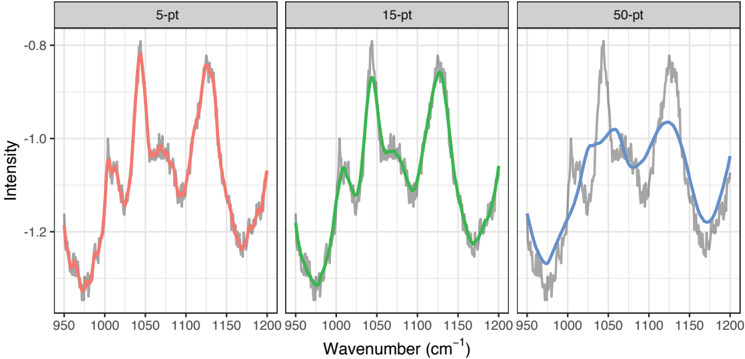
需要指出的是,移动平均计算中应考虑的合适点数会因数据类型和应用而异。像图 9.7 所示那样,目视检查计算中不同点数的影响,是为所关心的问题确定合适数量的好方法。
9.5 利用相关性
前面估计和调整基线、减少噪声的步骤有助于细化谱线,并增强谱线内与响应相关的真实信号。然而,这些步骤并不会减少每个样本内波长间的相关性,而这对于许多预测模型来说仍然是一个问题特征。
减少波长间相关性可以使用第 6.3 节中描述过的几种方法,例如主成分分析(principal component analysis, PCA)、核 PCA 或独立成分分析(independent component analysis)。这些技术对所有样本的预测子进行降维(dimension reduction)。请注意,这与前面描述的步骤是不同层面的做法;具体来说,基线校正和降噪步骤是在每个样本内部进行的。在传统 PCA 的情况下,预测子被压缩,使得跨样本的变异相对于所有预测子测量值被最大化。如前所述,PCA 不关注响应,可能无法产生具有预测性的特征。虽然这种技术可能解决预测子间相关性的问题,但它并不能保证产生有效的模型。
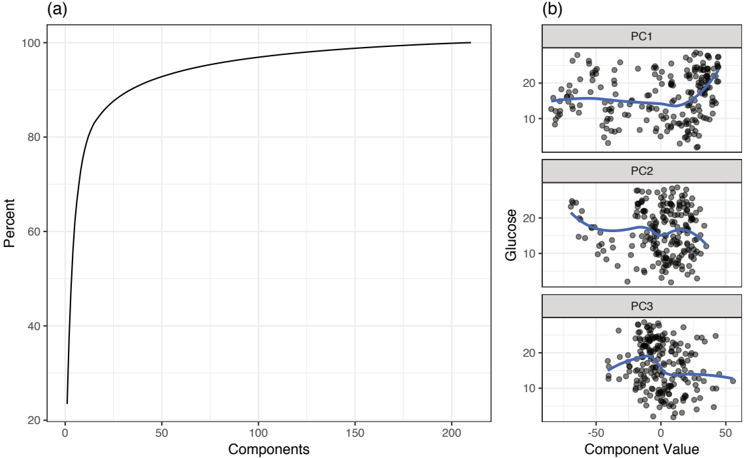
当 PCA 应用于小型数据时,跨波长强度值的变异量可以通过碎石图(scree plot)来概括(图 9.8(a))。对于这些数据,11 个成分解释了约 80% 的预测子变异,而 33 个成分解释了近 90% 的变异。响应与前三个新成分中每一个的关系如图 9.8(b) 所示。新成分互不相关,现在是任何预测模型的理想输入。然而,前三个成分中没有一个与响应有强关系。当面对高度相关的预测子,且目标是找到预测子与响应之间的最优关系时,更有效的替代技术是偏最小二乘(第 6.3.1.5 节中描述)。
图 9.8:应用于所有小型生物反应器数据的 PCA 降维。(a) 各成分累计解释变异的碎石图。(b) 葡萄糖与前三个主成分的散点图。
减少相关性的第二种方法是对每条谱线进行一阶差分(first-order differentiation)。计算一阶差分时,用谱线中第 \(p\) 个值处的响应减去谱线中第 \(p-1\) 个值处的响应。这个差值表示谱线中相邻测量值之间响应的变化速率。变化越大对应移动越大,并可能与响应中的信号有关。此外,计算一阶差分会使新值相对于前一个值,并减少与距当前值 2 步或更远的值之间的关系。这意味着跨谱线的自相关应该大幅降低。这与本章引言中展示的方程直接相关;大的正协方差(例如波长之间所见的那种)可以大幅降低差分中的噪声和变异。
图 9.9 显示了第一个生物反应器第一天谱线内前 200 个滞后的自相关值,包括计算差分之前和之后的情况。自相关急剧下降,只有前 3 个滞后的相关性大于 0.95。
图 9.9:对光谱求差分前后的自相关。
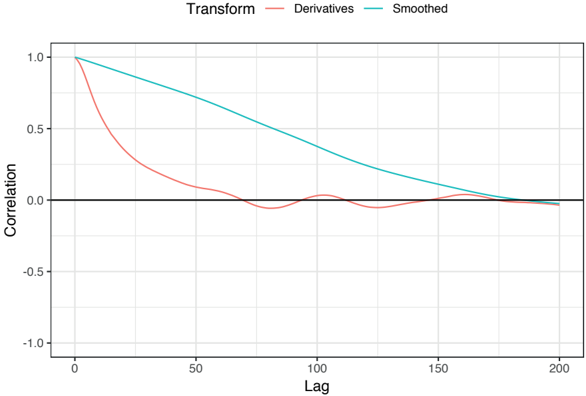
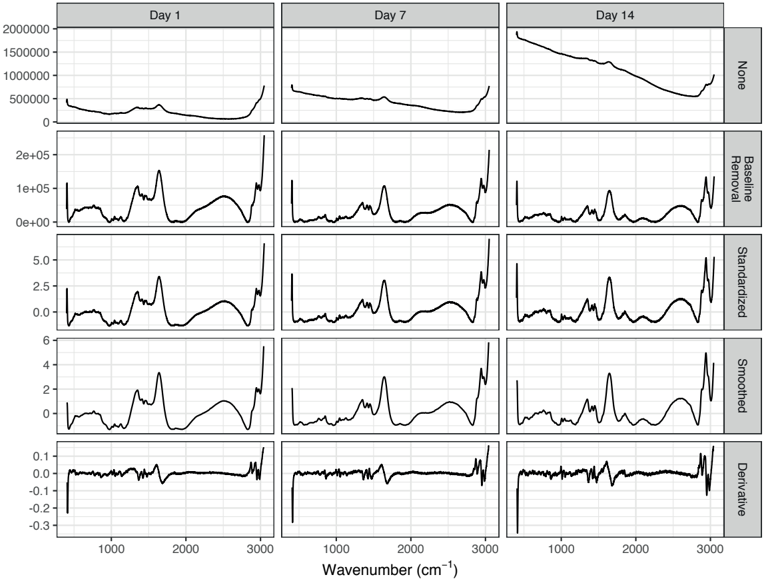
图 9.10 比较了第一个小型生物反应器第一天的原始谱线,以及同一生物反应器经过基线校正、标准化和一阶差分后的谱线。这些步骤展示了谱内漂移如何被去除,以及与峰无关的大部分趋势如何被最小化。
图 9.10:第一个小型生物反应器第一天的光谱,其中预处理步骤被依次应用。
虽然高度相关的滞后差分数量很少,但它们仍然会给预测模型带来问题。一种解决方案是每隔 \(m\) 条谱线选取一条,其中 \(m\) 的选择应使该滞后处的自相关低于某个阈值,例如 0.9 或 0.95。另一种解决方案是使用相关性过滤器(第 2 节)在所有谱线中滤除高度相关的差分。
9.6 数据处理对建模的影响
预处理的量可以被视为一个调优参数(tuning parameter)。如果是这样,目标就是选择最好的模型和适当的信号处理量。这里的策略是使用小型生物反应器数据及其相应的重抽样性能估计,来选择分析方法的最佳组合。一旦我们得出一两个候选的预处理与建模组合,就用小型生物反应器光谱建立的模型来预测大型生物反应器的类似数据。换句话说,小型生物反应器是训练数据,而大型生物反应器是测试数据。希望在一个数据集上建立的模型能够适用于生产规模反应器的数据。
训练数据包含 15 个小型生物反应器,每个有 14 个日测量值。虽然实验单元的数量很少,但交叉验证仍有几种合理的选择。在这种情况下可以考虑的第一个选项是留一生物反应器交叉验证(leave-one-bioreactor-out cross-validation)。这种方法会将 14 个小型生物反应器的数据放入分析集,并用 1 个小型生物反应器的数据进行评估。另一种方法是使用分组 V 折交叉验证(grouped V-fold cross-validation),但以生物反应器作为实验单元。在这种情况下,\(V\) 的自然选择是 5;每一折会将 12 个生物反应器放入分析集,3 个放入评估集。作为示例,表 9.2 展示了这些数据的一种这样的分配。
表 9.2:生物反应器数据的分组 V 折交叉验证示例。
| 重抽样 | 留出生物反应器 |
|---|---|
| 1 | 5、9 和 13 |
| 2 | 4、6 和 11 |
| 3 | 3、7 和 15 |
| 4 | 1、8 和 10 |
| 5 | 2、12 和 14 |
在留一生物反应器和分组 V 折交叉验证的情况下,每个样本都被精确预测一次。当实验单元数量很少时,一个单元对模型调优和交叉验证性能的影响就会增大。仅仅一个异常的单元就可能改变最优调优参数的选择,以及模型预测性能的估计。在更多的交叉验证重复(或重复交叉验证(repeated cross-validation))中平均性能,是抑制异常单元影响的有效方法。但需要重复多少次呢?一般来说,分组 V 折交叉验证重复 5 次就足够了,但重复次数可能取决于问题带来的计算负担以及样本量。对于较小的数据集,增加重复次数会产生更准确的性能指标。相反,对于较大的数据集,为了在计算上可行,重复次数可能需要少于 5 次。对于这些数据,执行了 5 次重复的分组 5 折交叉验证。
当档案数据处于原始形式时,建模技术的选择是有限的。通常会选择同时进行降维和预测的建模技术,例如主成分回归(principal component regression, PCR)和偏最小二乘(partial least squares, PLS)。尤其是偏最小二乘,它是这类数据非常流行的建模技术。这是因为它将预测子信息压缩到与响应关系最优的预测子空间中的较小区域。然而,只有当预测子与响应之间的关系呈直线或平面时,PLS 和 PCR 才是有效的。当预测子与响应之间的潜在关系是非线性时,这些方法就不是最优的。
神经网络和支持向量机(support vector machine, SVM)不能直接处理档案数据。但它们发现预测子与响应之间非线性关系的能力,使它们成为非常理想的建模技术。本章前面介绍的预处理技术将使这些技术能够应用于档案数据。
基于树的方法也能容忍档案数据的高度相关性。使用这些技术的主要缺点是,由于预测子之间的高度相关性,变量重要性(variable importance)的计算可能会被误导。此外,如果数据中的趋势确实是线性的,这些模型将不得不更费力地近似线性模式。
在本节中,将训练线性、非线性和基于树的模型。具体来说,我们将探索 PLS、Cubist、径向基函数(radial basis function)SVM 和前馈神经网络(feed-forward neural network)的性能。每个模型都将在小型生物反应器分析集上训练。然后,每个模型都将在基线校正、标准化、平滑和一阶差分这一预处理序列上训练。在每一组谱线预处理序列中,还会应用特定于模型的预处理步骤。例如,对每个预测子进行中心化和缩放对 PLS 是有益的。虽然谱线预处理步骤显著降低了预测子之间的相关性,但仍有一些高度相关残留。因此,移除高度相关的预测子将是 SVM 和神经网络模型的一个额外步骤。
图 9.11:不同预处理步骤下多个模型对档案数据的交叉验证性能。
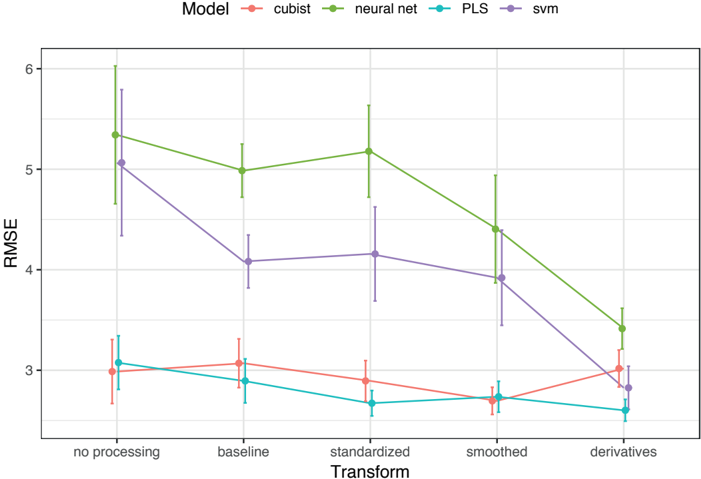
跨模型和谱线预处理步骤的重复交叉验证结果如图 9.11 所示。该图突出了几个重要结果。首先,对于 SVM 和神经网络模型,谱线预处理使评估集的总体平均模型性能大幅提升。以神经网络为例,原始数据的交叉验证 RMSE 为 5.34;经过谱线预处理后,交叉验证 RMSE 下降到 3.41。谱线预处理为 PLS 和 Cubist 模型提供了预测能力上的总体改善。但对这些模型来说更值得注意的是 RMSE 变异的减少。没有谱线预处理时,PLS 评估集性能的标准差为 3.08,谱线预处理后降至 2.6。
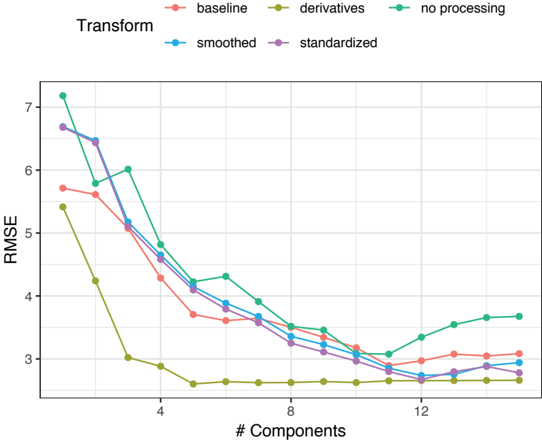
基于这些结果,使用差分特征的 PLS 似乎是最佳组合。带差分的支持向量机也看起来很有前景,尽管 Cubist 模型在计算差分之前就表现良好。为了进入大型生物反应器测试集,将评估基于差分的 PLS 模型和带平滑的 Cubist 模型。图 9.12 更详细地展示了 PLS 的结果,其中针对每种预处理方法,展示了重抽样 RMSE 估计与保留成分数量的关系。许多预处理方法的性能相当,但使用差分显然对结果产生了积极影响。不仅 RMSE 值更小,而且只需少量成分即可优化性能。这同样很可能是由于差分后波长特征之间相关性的降低。
图 9.12:偏最小二乘在谱线预处理步骤下的调优参数曲线。
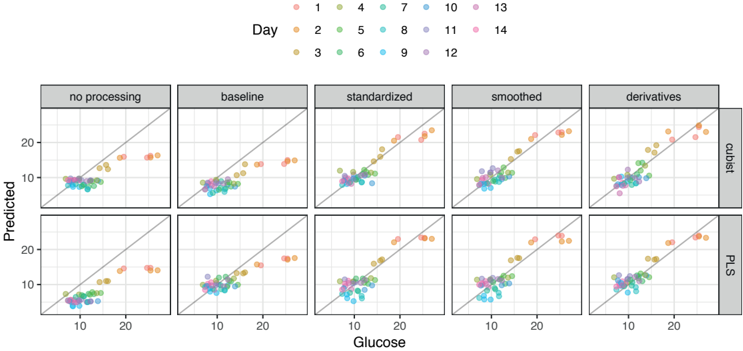
将两个候选模型用于大型生物反应器测试集,图 9.13 展示了每种预处理方法下观测值与预测值的对比图,并按日期着色。很明显,在标准化之前,模型明显低估了葡萄糖值(尤其是在最初几天)。即使模型拟合最佳时,反应的最初几天在预测中似乎也有最多的噪声。从数值上看,Cubist 模型的 RMSE 略小(Cubist 为 2.07,PLS 为 2.14)。然而,考虑到 PLS 模型的简单性,这种方法可能更可取。
图 9.13:大型生物反应器数据观测值与预测葡萄糖值的比较。
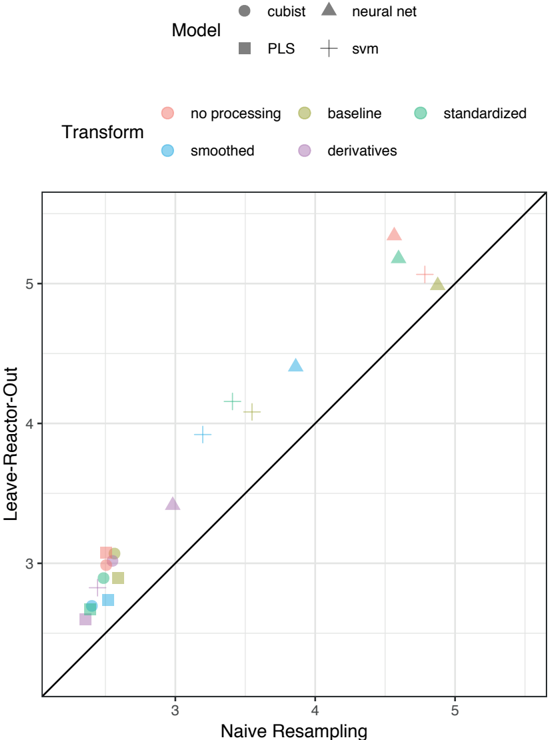
这个建模示例基于以下认识:实验单元是生物反应器,而不是生物反应器内的单个日期。如前所述,要采用合适的交叉验证方案,必须对单元有扎实的理解。对于这些数据,我们已经看到生物反应器内部的日测量值之间的相关性,高于生物反应器之间的测量值。基于日测量值的交叉验证很可能带来更好的留出(hold-out)性能。但这种性能具有误导性,因为在这种情况下,新数据将来自全新的生物反应器。此外,对小型数据执行的重复交叉验证中,日期被不恰当地视为实验单元。留出性能的比较如图 9.14 所示。在所有模型和所有谱线预处理步骤中,与以生物反应器为单元相比,以日为实验单元时的留出 RMSE 值被人为地降低了。忽视或不知道生物反应器才是实验单元,很可能会让人对模型的预测性能过度乐观。
图 9.14:使用生物反应器(实验单元)或朴素的行重抽样的交叉验证性能比较。
9.7 小结
档案数据是一种特殊类型的数据,可能源自多种不同的结构。如果样本随时间被重复测量、样本具有许多高度相关/关联的预测子,或者样本测量发生在层级结构中,就会出现这类数据。无论哪种情况,分析者都需要敏锐地意识到实验单元是什么。理解单元有助于做出以下决策:谱线应如何预处理、样本应如何分配到训练集和测试集,以及重抽样时样本应如何分配。
档案数据的基本预处理步骤可以包括:估计并调整基线效应、减少谱线中的噪声,以及利用预测子之间相关性中所包含的信息。这些步骤的一个基本目标是:去除阻碍这类数据被大多数预测模型使用的特征,同时保留谱线与结果之间的预测信号。没有任何一种特定的步骤组合适用于所有数据。然而,把正确的步骤组合在一起可以产生非常有效的模型。
9.8 计算
网站 http://bit.ly/fes-profile 包含用于重现这些分析的 R 程序。