处理缺失数据(Handling Missing Data)
缺失数据(missing data)在真实数据集中并不罕见。事实上,至少有一个数据点缺失的概率会随着数据集规模的增大而增加。缺失数据可能以多种方式出现,其中包括以下几种。
- 源数据集的合并(merging of source data sets):一个常见的简单例子是两个数据集按样本标识符(ID)合并时。如果某个 ID 只出现在第一个数据集中,那么对于第二个数据集中的所有预测子(predictor),合并后的数据都将为该 ID 包含缺失值。
- 随机事件(random events):任何测量过程都容易受到妨碍数据收集的随机事件的影响。设想在医学诊断实验室中收集数据的情形。生物样本(如血液或血清)的意外错放或损坏会使样本无法进行测量,从而产生缺失值。收集活动记录(actigraphy)数据的设备也可能受到随机事件的影响。例如,如果电池耗尽或采集设备损坏,则无法收集测量值,最终数据中将出现缺失。
- 测量失败(failures of measurement):基于图像的测量要求图像对焦。未对焦或损坏的图像会产生缺失值。测量失败的另一个例子是临床研究中的患者错过了预定的医生访视。该患者在该访视中本应进行的测量在最终数据中将缺失。
特征工程(feature engineering)的目标是使预测子处于模型能够更好地利用的形式,以建立预测子与响应(response)之间的关系。例如,对连续预测子使用投影方法(第 6.3 节)或自编码器变换(第 6.3.2 节)可以显著提升预测性能。同样,对分类预测子进行似然编码(likelihood encoding,第 5.4 节)这一特征工程手段也可能带来预测上的益处。这些特征工程技术以及本书中讨论的许多其他技术都要求数据没有缺失值。此外,无论是否进行特征工程,原始预测子中的缺失值在多种预测模型中都是不可容忍的。因此,要利用预测子或特征工程技术,我们必须首先处理数据中的缺失性(missingness)。而且,缺失性本身可能就是一个重要的响应预测因子。
除了预测子内部的测量值缺失外,响应中也可能存在测量值缺失。大多数建模技术无法利用训练数据中响应值缺失的样本。然而,一种被称为半监督学习(semi-supervised learning)的新方法能够在训练集中利用响应值未知的样本。半监督学习方法超出了本章的讨论范围;进一步参考请见 Zhu 和 Goldberg(2009)。相反,本章将重点介绍解决预测子内部缺失值的方法。
缺失数据的类型
遇到缺失数据时,第一个也是最重要的问题是:“这些值为什么缺失?“有时答案可能已知,或者可以通过研究数据轻松推断出来。如果数据来自科学实验或临床研究,实验室记录本或临床研究日志中的信息可能直接关联到所收集的样本或所研究的患者,从而揭示测量值缺失的原因。但对于许多其他数据集,缺失数据的原因可能无法确定。在这种情况下,我们需要一个理解缺失数据的框架。这个框架反过来将引导我们采用合适的技术来处理缺失信息。
一个理解缺失值的框架是从缺失数据的机制(mechanism)角度来审视。三种常见的机制是:
- 数据的结构性缺陷(structural deficiencies in the data),
- 随机事件(random occurrences),或
- 特定原因(specific causes)。
结构性缺陷可以定义为预测子中一个被省略于数据之外的缺失组成部分。一旦识别出必要的组成部分,这类缺失通常是最容易解决的。Ames 住房数据(Ames housing data)中的 Alley 预测子就是这类缺失的一个例子。该预测子的取值为"砾石(gravel)“或"铺砌(paved)",或者缺失。在这里,93.2% 的房屋的 alley 值为缺失。因为大部分值都缺失,直接删除该预测子可能很诱人。然而,这样做会丢弃对房价具有预测价值的信息,因为在这种情况下,缺失意味着该房产没有小巷(alley)。对于 Alley 预测子,更好的记录方式可能是将缺失值替换为"无小巷通道(No Alley Access)"。
缺失值的第二个原因是随机事件。Little 和 Rubin(2014)将这类随机性细分为两类:
完全随机缺失(missing completely at random,MCAR):缺失结果的似然(likelihood)对所有数据点(已观测或未观测)都是相等的。换句话说,缺失值与数据无关。这是最好的情形。
随机缺失(missing at random,MAR):缺失结果的似然并非对所有数据点(已观测或未观测)都相等。在这种情形下,结果缺失的概率取决于已观测数据,但不取决于未观测数据。
在实践中,要区分缺失值对所有数据具有相同的发生似然,还是对已观测或未观测数据具有不同的似然,可能非常困难甚至不可能。就本书而言,这里描述的方法可以适用于任何一种情况。关于这些微妙情形的更深入理解,我们请读者参考 Little 和 Rubin(2014)。
缺失数据的第三种机制是由于特定原因导致的缺失(即非随机缺失(not missing at random,NMAR),Little 和 Rubin, 2014)。这类缺失通常发生在对患者进行周期性测量的临床研究中。例如,患者可能因治疗的不良副作用或死亡而退出研究。对于该患者,退出后将不再记录任何测量值。非随机缺失的数据是最难处理的。这里介绍的技术可能适用也可能不适用于这类缺失。因此,在实施下文描述的任何技术之前,我们必须努力理解缺失数据的性质。
本章将说明评估数据中缺失值的性质和严重程度的方法,介绍在存在缺失值时可使用的模型,并回顾删除或插补(impute)缺失数据的技术。
为了说明,我们将使用芝加哥火车客运量数据(Chicago train ridership data,第 4 章)和 Reid(2015)的粪便(scat)数据(先前见第 6.3.3 节)。后一个数据集包含在野外收集的动物粪便信息。对每个样本进行了多种测量,包括形态学观察(即形状)、位置/时间信息和实验室检测。对每个样本中的 DNA 进行了基因分型(genotyped)以确定样本的物种(灰狐(gray fox)、郊狼(coyote)或短尾猫(bobcat))。这些数据的目标是建立粪便测量值与物种之间的预测关系。在收集到新的粪便样本后,该模型将用于预测产生该样本的物种。在收集的 110 个粪便样本中,有 19 个样本有一个或多个预测子值缺失。
8.1 理解缺失信息的性质与严重程度
正如本书通篇所示,数据可视化是引导我们实施合适特征工程技术的重要工具。同样的原则也适用于理解整个数据中缺失信息的性质和严重程度。可视化和数值汇总(numeric summary)是掌握数据集中缺失信息挑战的第一步。对于中小型数据(数百个样本和数百个预测子),有几种技术可以同时可视化所有样本和预测子,以理解缺失预测子值的程度和位置。当样本数或预测子数变得很大时,缺失信息必须首先进行适当的浓缩,然后再进行可视化。除了可视化汇总之外,数值汇总也是诊断缺失性的性质和程度的宝贵工具。
可视化缺失信息
当训练集的样本数和预测子数适中时,一种简单的可视化缺失信息的方法是使用热图(heatmap)。在这种可视化中,图形用两种颜色分别表示存在值和缺失值。图 8.1 的上半部分展示了动物粪便数据缺失信息的热图。可以对热图可视化进行重新组织,通过对预测子和样本分别进行层次聚类分析(hierarchical cluster analysis,Dillon 和 Goldstein, 1984)来突出缺失预测子和缺失样本之间的共性。这种可视化表明,大多数预测子和样本具有完整或近乎完整的信息。三个形态学预测子(直径(diameter)、锥度(taper)和锥度指数(taper index))更常缺失。此外,有两个样本缺失了全部三项实验室测量值(d13N、d15N 和 CN)。
共现图(co-occurrence plot)可以进一步加深对缺失信息的理解。这种图展示了缺失预测子组合的频率(图 8.1)。顾名思义,共现图展示最常见的缺失预测子组合的频率。该图可以清楚地看出,TI、Taper 和 Diameter 的缺失值最多,Taper 和 TI 最常同时缺失,并且有六个样本缺失了全部三个形态学预测子。图 8.1 的下半部分展示了粪便数据的共现图。
除了探索缺失信息的全局性质外,明智的做法是探索数据内部可能与缺失性相关的关系。在探索预测子之间的两两关系时,一个预测子的缺失值可以在另一个轴(axis)的边缘处标示出来。例如,图 8.2 显示了粪便直径与质量(mass)之间的关系。任一轴上的刻度标记(hash mark)代表这样的样本:该样本在该预测子上有观测值,但在对应预测子上有缺失值。这些点根据样本是否为"缺乏其他形态学特征的扁平状(flat puddle)“而着色。由于缺失的直径测量值具有这种不令人满意的特性,某些形状属性无法确定也就说得通了。这可以被认为是结构性缺失(structurally missing),但缺失性中可能仍存在随机或信息性成分。
然而,就结果而言,这六个扁平样本分布在灰狐(\( n = 5 \))和郊狼(\( n = 1 \))数据中。鉴于样本量很小,尚不清楚这种缺失是否与结果相关(如果相关将是有问题的)。需要咨询领域专家(subject-matter expert)才能理解是否如此。
当数据有大量样本或预测子时,使用热图或共现图来理解缺失性模式和特征的效果要差得多。在这种情况下,缺失信息必须首先在可视化之前进行浓缩。主成分分析(principal component analysis,PCA)在第 6.3 节中首次被介绍为一种降维技术。事实证明,PCA 也可以用于可视化和理解具有问题性缺失信息水平的样本和预测子。要在这种情况下使用 PCA,需将预测子矩阵转换为二元矩阵(binary matrix),其中 0 代表非缺失值,1 代表缺失值。由于 PCA 寻找能概括最大变异的维度方向,最初的几个维度捕捉由缺失值的存在引起的变异。没有任何缺失值的样本将被投影到靠近原点的同一位置。相反,有缺失值的样本将被投影到远离原点的位置。因此,只需绘制前两个维度的得分(score),我们就可以开始识别大型数据集中缺失性的性质和程度。
图 8.1:检查整个数据集(上图)或跨变量的缺失数据共现(下图)的缺失数据模式可视化。
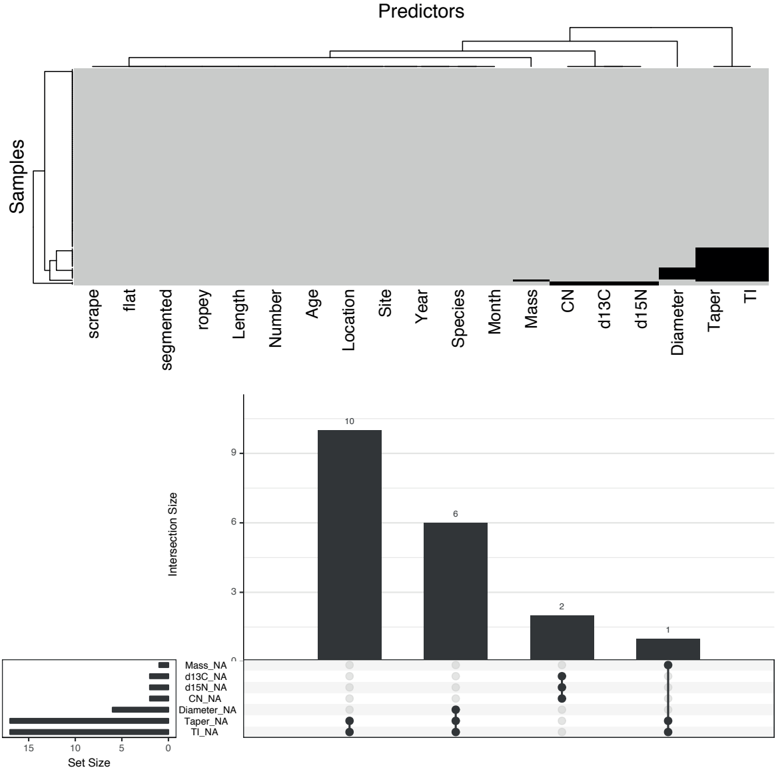
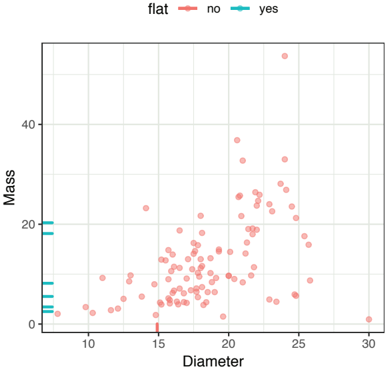
图 8.2:两个预测子的散点图,按第三个预测子的值着色。两个轴上的地毯图(rug)显示当另一轴的预测子缺失时该变量的值出现的位置。
同样的方法可以应用于理解预测子之间的缺失程度。为此,先对表示缺失值的二元矩阵进行转置(transpose),使预测子现在位于行中,样本位于列中。然后对该矩阵应用 PCA,得到的维度现在捕捉由预测子之间缺失值的存在引起的变异。
为了说明这种方法,我们将回到芝加哥火车客运量数据,该数据包含 5,733 天和 146 个车站的客运量值。缺失数据矩阵可以用日期和车站来表示。对该矩阵应用 PCA 生成图 8.3 所示的前两个成分。图中的点按缺失车站的数量确定大小。在这种情况下,每天至少有一个车站存在缺失值,并且有 8 种不同的缺失数据模式。
进一步探索发现,许多缺失值发生在 2013 年 9 月。应进一步调查这些缺失值的原因。
为了进一步理解缺失值的程度和位置,可以对数据矩阵进行变换并再次应用 PCA。图 8.4 展示了车站的得分。这里的点按各车站缺失信息量进行标注。在这种情况下,有 5 个车站有大量缺失数据。应调查这些车站缺失值的根本原因,以更好地确定处理这些车站的合适方式。
缺失过多的车站及其随时间变化的缺失数据模式如图 8.5 所示。车站顺序使用聚类算法设定,而 x 轴按日期排序。有九个车站的数据几乎完整,只是缺了一个月。这些车站都在红线(Red Line)上,并且发生在红线重建工程(Red Line Reconstruction Project)期间,该工程影响了从 Cermak-Chinatown 以北到 95th Street 车站的车站。Homan 车站只有一个月完整数据,并被 2001 年开通的 Conservatory 车站取代,这解释了为什么 Conservatory 车站在 2001 年之前有缺失数据。Washington-State 车站出现了另一个异常。由于该车站在 2000 年代中期关闭,数据收集在数据集的中间停止了。对缺失数据的进一步调查表明,这些模式与客运量无关,主要源于结构性原因。
图 8.3:芝加哥客运量数据缺失值二元表示的前两个行得分的散点图,用于识别日期上的缺失性模式。符号大小表示缺失数据量。
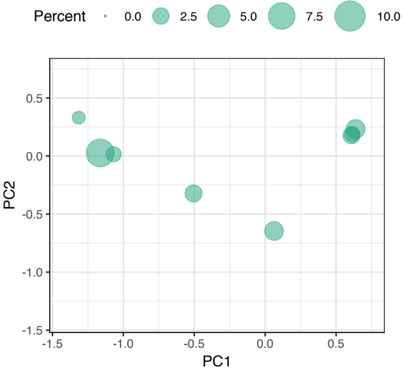
图 8.4:芝加哥客运量数据缺失值二元表示的前两个列得分的散点图,用于识别车站的模式。符号大小表示缺失数据量。
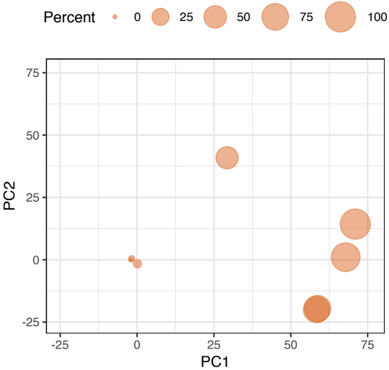
图 8.5:芝加哥客运量数据中原始车站的缺失数据模式。
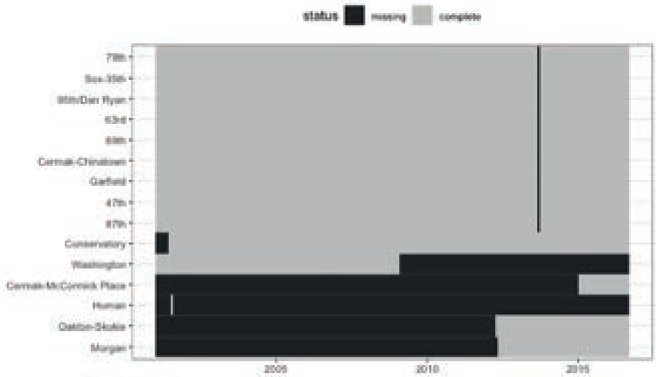
表 8.1:动物粪便预测子按缺失量排序。
| 缺失百分比(%) | 预测子 |
|---|---|
| 0.909 | Mass |
| 1.818 | d13C、d15N 和 CN |
| 5.455 | Diameter |
| 15.455 | Taper 和 TI |
汇总缺失信息
当数据大到无法直观检查时,简单的数值汇总能有效识别有问题的预测子和样本。第一步可以轻松计算预测子和样本的缺失值总数或百分比。回到动物粪便数据,表 8.1 按缺失值数量展示了预测子。类似地,表 8.2 包含按缺失值数量排列的样本。这些汇总可用于调查值缺失的根本原因,或作为剔除缺失值数量严重的预测子或样本的筛选机制。
表 8.2:动物粪便样本按缺失量排序。
| 缺失百分比(%) | 样本编号 |
|---|---|
| 10.5 | 51、68、69、70、71、72、73、75、76 和 86 |
| 15.8 | 11、13、14、15、29、60、67、80 和 95 |
8.2 能够容忍缺失值的模型
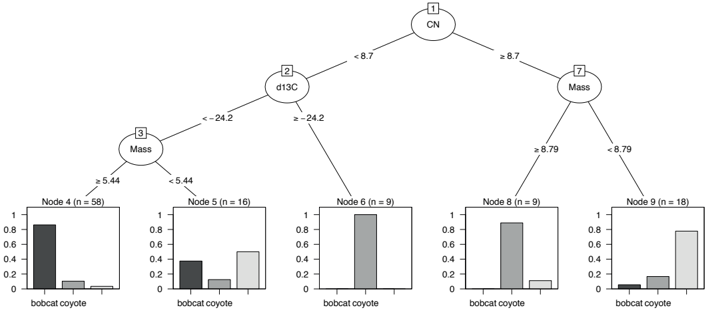
许多流行的预测模型,如支持向量机(support vector machine)、glmnet 和神经网络(neural network),无法容忍任何数量的缺失值。然而,有少数预测模型可以在内部处理不完整的数据。[71] 某些树模型(tree-based model)的实现具有巧妙的程序来适应不完整数据。CART 方法(Breiman 等, 1984)使用代理分裂(surrogate splits)的思想。在创建树时,会记录一组单独的分裂(使用与当前被分裂预测子不同的备选预测子),当该预测子值缺失时可以近似原始的分裂逻辑。图 8.6 展示了动物粪便数据的递归划分(recursive partitioning)模型。树选出的所有三个预测子都包含缺失值,如图 8.1 所示。初始分裂基于碳氮比(carbon/nitrogen ratio,\( \mathrm{CN} < 8.7 \))。当样本的 CN 值缺失时,CART 模型会使用基于粪便是否为扁平状的指示(indicator)的替代分裂。这两个分裂对 80.6% 的数据产生相同的划分,并且可以在碳氮比缺失时使用。继续沿树向下,d13C 和 Mass 的代理预测子分别是 Mass 和 d13C。这是可能的,因为这些预测子不会同时缺失。
图 8.6:动物粪便数据的递归划分树。这棵树中的所有三个预测子都包含缺失值,但由于代理预测子而可以使用。
[71] 前提是导致缺失数据的机制不是病理性的。
C5.0(Quinlan, 1993;Kuhn 和 Johnson, 2013)采取了不同的方法。基于具有缺失数据的预测子的分布,在后续分裂中使用分数计数(fractional count)。例如,该模型对粪便数据的第一次分裂是 \( \mathrm{d13C} > 24.55 \)。当该语句为真时,训练集中全部 13 个样本都是郊狼。然而,该预测子有一个缺失值。由于对分裂变量的缺失值数量进行了调整,后续节点中每个物种的计数变为分数。这使得模型能够持续追踪缺失值在划分中可能落入的位置。
另一种可以容忍缺失数据的方法是朴素贝叶斯(Naive Bayes)。该方法分别对每个预测子建模类特定的分布(class-specific distribution)。同样,如果缺失数据机制不是病理性的,这些分布汇总可以使用每个预测子的完整观测,从而避免逐案删除(case-wise deletion)。
8.3 删除数据
当希望使用不容忍缺失数据的模型时,就必须将缺失值从数据中剔除。处理缺失值最简单的方法是删除包含缺失值的整个预测子和/或样本。然而,在采取这种方法之前,必须仔细考虑数据的多个方面。例如,可以通过删除所有包含至少一个缺失值的预测子来消除缺失值。类似地,可以通过删除所有含任何缺失值的样本消除缺失值。正如从"没有免费午餐(No Free Lunch)“定理可以推断出的那样,这两种方法都不可能适用于所有数据。对于某些数据集,可能确实某些预测子比其他预测子问题大得多;通过删除这些预测子,缺失数据问题就解决了。对于其他数据集,可能特定样本在多个预测子上持续缺失;通过删除这些样本,缺失数据问题同样得以解决。然而在实践中,特定的预测子和特定的样本集中了大部分缺失信息。
另一个重要的考虑因素是样本相对于预测子的内在价值。当样本难以获取或数据包含的样本(即行)数量很少时,则不宜从数据中删除样本。一般来说,样本比预测子更关键,应优先尽可能多地保留样本。鉴于通常优先考虑样本,一个初始策略是先识别并删除缺失数据量足够高的预测子。当然,已知有价值且/或对结果具有预测性的预测子不应删除。一旦删除了有问题的预测子,就可以将注意力转向超过缺失性阈值的样本。
以芝加哥火车客运量数据为例。本章前面对这些数据的调查显示,有几个车站存在大量连续的缺失数据(图 8.5)。每个日期(样本)至少有一个车站(预测子)缺失,但预测子之间的缺失程度很小。然而,少数车站存在过度缺失。对这些车站来说,连续缺失数据太多,无法将其保留在分析集中。在这种情况下,删除这几个车站更有意义。对于红线上的车站,是否将其保留在分析集中则不太明确。鉴于车站之间的高度相关性,本书决定从所有分析中排除所有有缺失数据的车站,这不会损害构建预测 Clark-Lake 车站客运量的有效模型。这个例子说明,在确定处理缺失值的方法时,有几个重要方面需要考虑。
除了丢弃数据之外,删除训练集的样本(行)的主要担忧是它可能会使将预测子与结果联系起来的模型产生偏差(bias)。一个经典的例子来自医学研究。在这些研究中,一部分患者被随机分配到当前的常规护理(standard of care)治疗组,另一部分患者被分配到新治疗组。新治疗可能对某些患者产生不良影响,导致他们退出研究,从而在未来的临床访视中产生缺失数据。这类缺失数据显然不是随机缺失的,从分析中删除这些数据会虚假地使结果显得比包含其不利结果时更好。话虽如此,Allison(2001)指出,如果数据是完全随机缺失的,这可能是一种可行的方法。
8.4 编码缺失
当预测子在本质上是离散的时,缺失性可以直接编码到预测子中,就好像它是一个自然出现的类别一样。这对于结构性缺失值是有意义的,例如 Ames 住房数据中小巷的例子。在这里,将缺失值改为"无小巷(no alley)“类别是合理的。在其他情况下,缺失值可以简单地编码为"缺失(missing)“或"未知(unknown)"。例如,Kuhn 和 Johnson(2013)使用了一个目标是预测拨款提案被接受或拒绝的数据集。其中一个分类预测子是拨款资助方(grant sponsor),其取值包括’Australian competitive grants’、‘cooperative research centre’、‘industry’等。该预测子总共有超过 245 个可能值,大约 10% 的拨款申请具有空的资助方值。为了使具有空资助方的申请能够用于建模,空资助方值被编码为’unknown’。在所研究的许多模型中,未知资助方的指示符是拨款成功最重要的预测子之一。事实上,对比已知与未知资助方的比值比(odds-ratio)大于 6。这意味着当资助方预测子未知时,拨款成功获得资助的可能性要大得多。事实上,在训练集中,与未知资助方相关的拨款成功率为 82.2%,而已知资助方的成功率为 42.1%。
将缺失值编码是否是一个成功的策略?显然,导致缺失资助方标签被识别为与拨款接受强相关的机制确实很重要。不幸的是,无法知道为什么这种关联如此重要。这里确实有些情况正在发生,这一事实很重要,而编码帮助识别了它的发生。然而,将此分析视为最终结论并暗示某种因果关系会是有问题的。[72] 一个可用于判断编码缺失是否是一个好主意的指导原则是:思考如果该信息对模型变得重要,结果将如何被解释。
[72] 一个可能更困难的情况是向模型的使用者解释:“我们知道这很重要,但我们不知道为什么!”
8.5 插补方法
处理缺失值的另一种方法是插补(impute)或估计它们。缺失值插补在统计学中有着悠久的历史,并已被深入研究。不错的起点是 Little 和 Rubin(2014)、Van Buuren(2012)和 Allison(2001)。本质上,插补利用非缺失预测子之间的信息和关系来提供一个估计值以填补缺失值。
从历史上看,处理缺失数据的统计方法关注的是对推理模型(inferential model)的影响。在这种情况下,插补策略的特征和质量侧重于模型产生的检验统计量(test statistic)。这些技术的目标是确保统计分布是可处理的(tractable),并且质量足以支持随后的假设检验。这种情况下的主要方法是使用多重插补(multiple imputation);即创建数据集的几个变体,对缺失值使用不同的估计。然后,数据集的变体被用作模型的输入,并为每个插补后的数据集计算检验统计量的重复值(replicate)。从这些重复统计量中,可以构造合适的假设检验并用于决策。
推理模型和预测模型(predictive model)之间有几个差异会影响这一过程:
- 在许多预测模型中,不存在分布假设的概念(或者它们往往是不可处理的)。例如,在构建大多数基于树的模型时,算法不需要为预测子指定任何概率分布。因此,许多预测模型即使以推断为首要目标,也无法产生推断结果。[73] 鉴于此,传统的多重插补方法可能不适用于这些模型。
- 许多预测模型的计算成本很高。重复插补会大大加剧计算时间和开销。然而,我们确实有兴趣捕捉插补过程带来的益处(或损害)。为了确保插补引入的变异在训练过程中被捕捉到,我们建议在重采样(resampling)过程中进行插补。
- 由于预测模型是以准确预测尚未见过的样本(包括测试集和新的未知样本)的能力来评判的,而不是以统计适当性来评判,因此插补值必须尽可能接近其真实(未观测)值,这一点至关重要。
- 推理模型的一般焦点是彻底理解可用数据中预测子与响应之间的关系。相反,预测模型的焦点是理解预测子与响应之间可推广到尚未见过样本的关系。多重插补方法在缺失数据被估计后不会保留插补生成器(imputation generator),这给将这些技术应用于新样本带来了挑战。
[73] 显然,存在例外,如线性回归和逻辑回归、朴素贝叶斯模型等。
最后一点强调了机器学习模型中插补的主要目标:对缺失数据点产生最准确的预测。预测性插补方法应具备的其他一些重要特征包括:
- 在一个样本数据点内部,其他变量也可能缺失。因此,插补方法应该能够容忍其他缺失数据。
- 插补会在另一个模型内部创建一个模型。训练集中每个可能有缺失数据的预测子都对应一个预测方程。理想情况下,插补方法应该快速且具有紧凑的预测方程。
- 许多数据集通常同时包含数值型和分类型预测子。与其为分类型预测子生成虚拟变量(dummy variable),一个有用的插补方法应该能够使用各种类型的预测子作为输入。
- 预测缺失值的模型应该(数值上)相对稳定,并且不应受到离群数据点(outlying data point)的过度影响。
实际上任何预测模型都可以用来插补数据。这里将重点介绍几个值得考虑的候选模型。
插补确实引出了一个问题:多少缺失数据算是太多而不宜插补?虽然无论如何都不是通用规则,但列内 20% 的缺失数据可能是值得遵守的一条"尊严线(line of dignity)"。当然,这取决于具体情况和训练集中缺失值的模式。
同样重要的是要考虑插补可能是任何预处理序列中的第一步。在创建指示变量之前插补分类型预测子是一个好主意,这样可以保留所得插补的二元性质。此外,插补通常应该先于涉及参数估计的其他步骤。例如,如果在插补之前对数据执行中心化(centering)和缩放(scaling),所得的均值和标准差将继承数据删除带来的潜在偏差和问题。
K 近邻
当训练集规模较小或适中时,K 近邻(K-nearest neighbors)可以是一种快速有效的缺失值插补方法(Eskelson 等, 2009;Tutz 和 Ramzan, 2015)。该过程首先识别具有一个或多个缺失值的样本。然后,它识别训练数据中完整的(即某些列中没有缺失值的)K 个最相似样本。该方法中样本的相似性由距离度量(distance metric)定义。当所有预测子都是数值型时,标准欧氏距离(Euclidean distance)通常被用作相似性度量。计算距离后,识别出距离具有缺失值的样本最近的 K 个样本,并计算所关注预测子的平均值。该值随后被用来替换样本的缺失值。
然而,数据集通常同时包含数值型和分类型预测子。如果是这种情况,欧氏距离就不是合适的度量。相反,Gower 距离(Gower’s distance)是一个很好的替代方案(Gower, 1971)。该度量对分类型和数值型预测子分别使用专门的特定距离度量。对于分类型预测子,如果两个样本取值相同,则它们之间的距离为 1,否则为 0。对于数值型预测子 \( x \),样本 \( i \) 和 \( j \) 之间的距离定义为
\[ d_{ij} = \frac{|x_i - x_j|}{R_x} \]其中 \( R_x \) 是预测子的取值范围(range)。对每个预测子计算距离度量,并使用平均距离作为总体距离。一旦找到 K 个邻居,就用它们的值来插补缺失数据。分类型预测子用众数(mode)插补,数值型预测子用平均值或中位数(median)插补。K 可以是一个可调参数,但 5-10 左右的值是合理的默认值。
对于动物粪便数据,图 8.7 显示了与图 8.2 相同的数据,但缺失值是使用基于 Gower 距离的 5 个邻居填补的。新值大多落在这两个维度的外围,但在具有完整数据的样本范围内。
树
基于树的模型是插补技术的合理选择,因为树可以在存在其他缺失数据的情况下构建[74]。此外,树通常具有良好的准确性,并且不会将值外推到训练数据的边界之外。虽然单棵树可以用作插补技术,但众所周知它会产生低偏差但高方差(variance)的结果。然而,树的集成(ensemble)提供了低方差的替代方案。随机森林(random forest)就是这样一种技术,并且已为此目的被研究(Stekhoven 和 Buhlmann, 2011)。然而,在预测建模环境中使用这种技术有几个明显的缺点。首先也是最重要的,在每次分裂时随机选择预测子需要大量树木(500 到 2000 棵)才能实现稳定、可靠的模型。这些树中的每一棵都不修剪(unpruned),所得模型通常具有较大的计算足迹(computational footprint)。随着具有缺失数据的预测子数量增加,这会带来挑战,因为必须为每个预测子构建并保留单独的模型。一个计算足迹较小的好替代方案是袋装树(bagged tree)。袋装树的构建方式与随机森林类似。主要区别在于,在袋装模型中,每棵树每次分裂时都会评估所有预测子。使用 25-50 棵树的袋装树的性能通常与随机森林模型的性能大致相当。当目标是找到合理的缺失数据插补值时,较少的树数量是一个明显的优势。
[74] 然而,许多实现并不具备这一特性。
图 8.7:动物粪便数据的 K 近邻与袋装树插补技术比较。两个轴上的地毯图显示当另一轴的预测子缺失时该变量的值出现的位置。
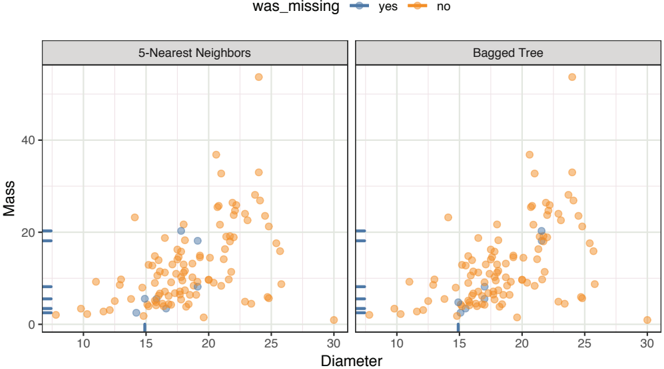
图 8.7 展示了使用 50 棵树的袋装集成对粪便数据插补后的值。当以插补直径预测子为目标时,模型的估计 RMSE 为 4.16(或 \( R^2 \) 为 13.6%)。类似地,当以插补质量预测子为目标时,估计的 RMSE 为 8.56(或 \( R^2 \) 为 28.5%)。RMSE 和 \( R^2 \) 指标并不十分令人印象深刻。然而,这些来自袋装模型的插补产生的结果是合理的,在训练数据的范围内,并允许预测子保留用于建模(而不是逐案删除)。
线性方法
当一个完整的预测子与需要插补的预测子显示出强线性关系时,一个直接的线性模型可能是最好的方法。线性模型计算非常快,并且保留的开销非常少。虽然线性模型确实要求插补模型的预测子是完整的,但这不是致命缺陷,因为模型系数(即斜率)使用所有数据进行估计。
线性回归(linear regression)可用于需要插补的数值型预测子。类似地,逻辑回归(logistic regression)适用于需要插补的分类预测子。
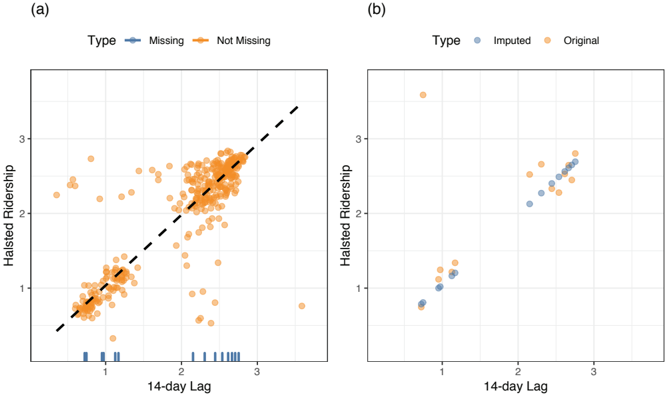
芝加哥火车客运量数据将用于说明线性回归等简单技术在插补中的有用性。可以设想,一个或多个未来的客运量值可能以随机方式从完整数据集中缺失。为了模拟潜在的缺失数据,我们在 Halsted 站的客运量中人为制造了缺失值。如前面图 4.8 所示,站点内客运量的 14 天滞后与当天客运量高度相关。图 8.8(a) 显示了 2010 年 Halsted 站这些预测子之间的关系,当前日的缺失值在 x 轴上被突出显示。大多数数据显示这些预测子之间存在线性关系,少数天的值偏离整体趋势。对这些数据拟合的鲁棒线性模型(robust linear model)用虚线表示。图 8.8(b) 将插补值与原始真实客运量值进行了比较。鲁棒线性模型在插补缺失值方面表现良好,除了一天之外。这一天因为是一个假日而客运量异常。将假日作为预测子纳入鲁棒模型将有助于改进插补。
图 8.8:Halsted 站客运量线性插补的示例。(a) 14 天滞后客运量与当天客运量。(b) 基于鲁棒线性模型的插补值与原始值的比较。
线性插补的概念可以扩展到高维数据。例如,Audigier 等(2016)开发了基于相似性度量和主成分分析的缺失数据插补方法。
8.6 特殊情况
有些情况下,一个数据点并非缺失,但也不完整。例如,在测量事件发生前的持续时间时,可能已知持续时间至少为某个时间 \( T \)(因为事件尚未发生)。这类值被称为删失(censored)值。[75] 已经开发了各种统计方法来分析这类数据。
[75] 在数据在上下界之外未定义的情况下,数据将被视为截断(truncated)。
持续时间通常是右删失(right censored)的,因为终止值未知。在其他情况下,可能发生左删失(left censoring)。例如,实验室测量可能有检测下限(lower limit of detection),这意味着测量仪器无法可靠地量化低于阈值 \( X \) 的值。该阈值通常是在开发测量系统的过程中通过实验确定的。当预测子有低于检测下限的值时,这些值通常被报告为”< \( X \)"。当这些数据要被纳入预测模型时,通常存在如何处理删失值的问题。一个被广泛接受的做法是使用下限值 \( X \) 作为结果。虽然这不会对某些划分模型(如树或规则)产生不利影响,但可能对其他模型产生有害影响,因为它假设这些是真实值。删失值会影响衡量变异性的指标。具体来说,变异性会被低估。这种效应与第 6.2.2 节中分箱(binning)的方式类似,模型可能过拟合(overfit)到具有相同值的数据点簇上。
为了缓解变异性问题,左删失值可以使用介于零和 \( X \) 之间的随机均匀值进行插补。在低于 \( X \) 的分布有良好信息的情况下,可以使用其他能更好地代表分布的随机值分配方案。例如,可能存在某些科学或生理学原因使最小可能值大于零(但小于 \( X \))。虽然以这种方式插补会给数据增加随机噪声,但它很可能优于为数据赋予 \( X \) 值可能导致的过拟合问题。
另一种非典型情况是数据具有很强的时间成分。在这种情况下,为了保留数据的这些特征,可以使用简单移动平均平滑器(simple moving average smoother)来插补数据,以免破坏任何时间效应。如第 6.1 节先前所述,必须注意两端,以免使用测试(或其他)数据来插补训练集值。
8.7 小结
缺失值是数据中的常见现象。不幸的是,大多数预测建模技术无法处理任何缺失值。因此,必须在建模之前解决这个问题。缺失数据可能由于随机机会或系统性原因而发生。理解缺失值的性质有助于指导如何最好地删除或插补数据的决策过程。
理解缺失值数量和性质的最佳方法之一是通过适当的可视化。对于较小的数据集,热图或共现图很有帮助。较大的数据集可以通过绘制缺失数据指示矩阵的 PCA 模型的前两个得分来可视化。
一旦知道了缺失值的严重程度,就需要决定如何处理这些值。当预测子或样本中存在严重的缺失数据时,删除有问题的预测子或样本可能是明智的。或者,如果预测子是分类型的,缺失值可以编码为"缺失(missing)“类别。
对于小到中等程度的缺失,可以对值进行插补。插补技术有很多种。当最终目标是构建预测模型时,特别有用的几种是 K 近邻、袋装树和线性模型。这些方法中的每一种都具有相对较小的计算足迹,并且可以快速计算,这使得它们能够被纳入预测建模的重采样过程中。
8.8 计算
网站 http://bit.ly/fes-missing 包含用于重现这些分析的 R 程序。
脚注
[71] 前提是导致缺失数据的机制不是病理性的。
[72] 一个可能更困难的情况是向模型的使用者解释:“我们知道这很重要,但我们不知道为什么!”
[73] 显然,存在例外,如线性回归和逻辑回归、朴素贝叶斯模型等。
[74] 然而,许多实现并不具备这一特性。
[75] 在数据在上下界之外未定义的情况下,数据将被视为截断。