检测交互效应(Detecting Interaction Effects)
在以预测为主要目标的问题中,响应(response)的大部分变异可以由重要单个预测子的累积效应来解释。到目前为止,本书的重点一直放在开发工程化类别型或数值型预测子的方法上,使工程化后的预测子版本具有更好的表示形式,从而发现和/或改善与响应的预测关系。对许多问题而言,响应中额外的变异可以通过两个或多个预测子协同工作的效应来解释。作为预测子协同工作的一个简单概念性例子,考虑水和肥料对田间玉米作物产量的影响。没有水但有一定肥料时,田间玉米不会有任何收成,因为水是植物生长的必要条件。相反,水量充足但没有肥料时,田间玉米会有一定收成。然而,只有在水量充足且肥料充足的情况下,产量才能达到最优。因此,水和肥料以适当的量组合时,产生的产量大于两者各自单独作用所能产生的产量。更正式地说,当两个或多个预测子的组合效应不同于(小于或大于)我们将其各自单独作用的效应相加时所预期的效应时,就称这些预测子之间存在交互(interact)。请注意,根据定义,交互总是以预测子与结果(outcome)之间的关系为背景。例如,预测子之间的相关性并不直接与是否存在交互效应有关。另外,从记号的角度来看,单个变量(如肥料和水)在交互之外被称为主效应项(main effect term)。
交互的预测重要性最早在第 2 章讨论过,当时问题的重点是使用基于个体颈动脉(carotid artery)图像的预测子来预测其缺血性中风(ischemic stroke)风险。在该例中,动脉壁重塑程度与动脉壁最大厚度之间的交互被认为是一个有前景的候选。图 2.7(a) 展示了这些预测子之间关系的可视化,其中等高线代表预测子之间的等效乘性效应。同一幅图的 (b) 部分展示了这些预测子的组合如何在发生中风与未发生中风的患者之间产生更好的区分。
图 7.1:Ames 住房数据中预测子存在交互 (a) 与不存在交互 (b) 的图。
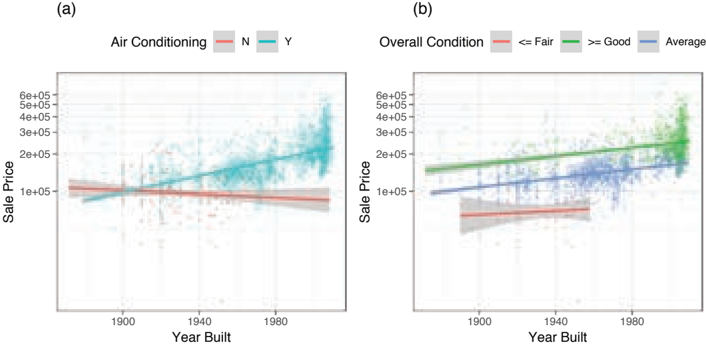
在前面的例子中,重要的交互发生在两个连续预测子之间。但重要的交互也可能发生在两个类别型预测子之间,或一个连续预测子与一个类别型预测子之间,这些都可以在 Ames 住房数据中找到。图 7.1(a) 展示了房屋年龄(x 轴)与房屋销售价格(y 轴)之间的关系,并按房屋是否有空调进行了分类。在这个例子中,对于有空调的房屋,房屋年龄与销售价格之间的关系是递增的;另一方面,对于没有空调的房屋,这些预测子之间没有关系。相比之下,该图的 (b) 部分展示了两个不交互的预测子:房屋年龄和整体状况。这里房屋的状况不影响房龄与销售价格之间的关系。每种状况类型的曲线几乎平行,揭示了两者之间缺乏交互。
为了更好地理解交互,考虑一个只有两个预测子的简单例子。两个预测子之间的交互可以用数学表示为:
\[ y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \beta_3 x_1 x_2 + \varepsilon \]在这个方程中,\( \beta_0 \) 表示响应的总体平均值,\( \beta_1 \) 和 \( \beta_2 \) 分别表示由 \( x_1 \) 和 \( x_2 \) 引起的平均变化率,\( \beta_3 \) 表示由 \( x_1 \) 和 \( x_2 \) 的组合效应引起的、超出 \( x_1 \) 和 \( x_2 \) 单独所能解释部分的增量变化率。误差项(error term)表示真实数据中无法由方程确定性部分解释的随机变异。根据数据,可以使用线性回归(linear regression)等方法(用于连续响应)或逻辑回归(logistic regression)(用于类别型响应)来估计 \( \beta \) 参数。参数估计完成后,就可以确定交互在解释响应变异方面的有用性。有四种可能的情形:
- 如果 \( \beta_3 \) 与零没有显著差异,那么 \( x_1 \) 和 \( x_2 \) 之间的交互对于解释响应的变异没有用处。在这种情况下,\( x_1 \) 和 \( x_2 \) 之间的关系称为可加(additive)的。
- 如果系数显著为负,同时 \( x_1 \) 和 \( x_2 \) 单独也会影响响应,那么这种交互称为拮抗(antagonistic)。
- 在另一个极端,如果系数为正,同时 \( x_1 \) 和 \( x_2 \) 单独也会影响响应,那么这种交互称为协同(synergistic)。
- 最后一种情形发生在交互系数显著不同于零,但 \( x_1 \) 或 \( x_2 \) 中有一个或两个都不影响响应时。在这种情况下,\( x_1 \) 在 \( x_2 \) 各取值上的平均响应(反之亦然)的变化率基本为零。然而,\( x_1 \) 在 \( x_2 \) 每个取值处的平均值(即以 \( x_2 \) 为条件)却不同于零。这种情况在真实数据中很少发生,我们需要理解识别这一特定情形的视觉线索。这种类型的交互称为非典型(atypical)。
图 7.2:两个预测子之间具有协同交互、无交互(可加)和拮抗交互的模型的预测响应等高线图。
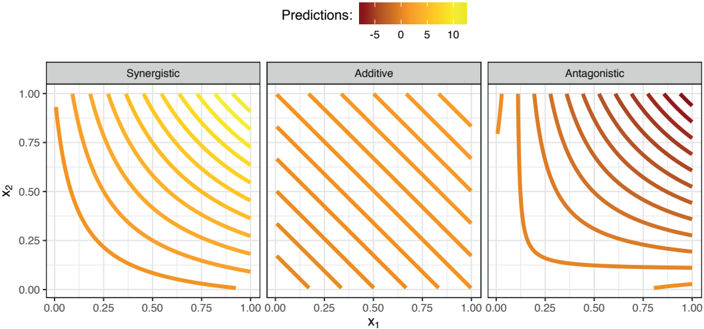
为了说明前三种类型的交互,将使用上述公式生成模拟数据,系数如下:\( \beta_0 = 0 \),\( \beta_1 = \beta_2 = 1 \),\( \beta_3 = -10 \)、0 或 10,分别用于说明拮抗、无交互或协同。为 \( x_1 \) 和 \( x_2 \) 在 0 到 1 之间随机均匀生成 200 个样本,每个样本的误差从正态分布(normal distribution)中抽取。使用线性回归模型估计系数,并生成每个模型的预测值等高线图(图 7.2)。在该图中,可加情形具有平行等高线,响应从左下角向右上角递增。协同情形下响应也从左下角向右上角递增,但等高线是弯曲的,表明需要每个预测子的较低值才能引出相同的响应值。拮抗情形也显示出弯曲的等高线;这里响应从左下角向右上角递减。该图揭示了当预测子之间存在真实交互时,响应轮廓会发生变化。
图 7.3:两个类别型因子之间非典型交互的一个例子。在该例中,每个因子单独来看都不显著,但因子之间的交互是显著的,其特征是组内平均值出现标志性的交叉模式。
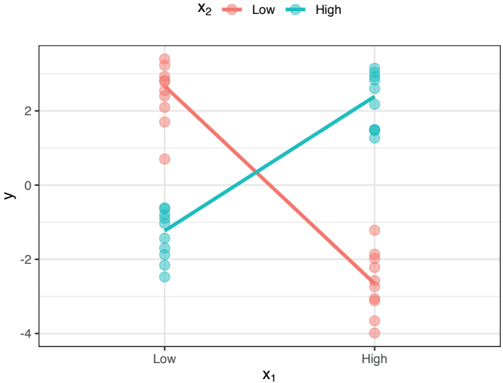
当 \( x_1 \) 和 \( x_2 \) 是类别型预测子时,非典型情形可以更清楚地说明。为了模拟非典型情形,两个预测子将取"低"和"高"两个值,响应由 \( y = 2 x_1 x_2 + \varepsilon \) 生成,其中 \( x_1 \) 和 \( x_2 \) 的低值和高值分别用 \( \pm 1 \) 数值表示。图 7.3 展示了因子的低水平和高水平之间的关系。请注意,\( x_1 \) 在低水平和高水平上的平均响应大约为零。然而,当平均值以 \( x_2 \) 为条件(由两种不同颜色表示)时,在 \( x_1 \) 的两个水平上响应是相反的。这里每个预测子的单独效应都不显著,但条件效应非常显著。
当我们知道哪些预测子交互时,可以将它们纳入模型。然而,关于哪些预测子交互的知识可能并不可用。最近的一些实证研究表明,更复杂的建模技术可以发现交互。正如 Elith 等人(2008)所指出的,基于树的模型通过树中连续的递归划分(recursive split)天然地对预测子之间的交互进行建模。García-Magariños 等人(2009)表明,随机森林(random forest)能有效识别单核苷酸多态性(single nucleotide polymorphism, SNP)之间未知的交互;Lampa 等人(2014)发现,提升树模型(boosted tree model)能够在流行病学问题中发现重要的交互;Chen 等人(2008)发现,搜索技术与支持向量机(support vector machine)相结合能有效识别与人类疾病相关的基因-基因交互。这些发现引出了一个问题:如果复杂精密的预测建模技术确实能够从交互中提取预测信息,那么为什么我们还要花时间和精力去精确定位哪些交互是重要的?重要性回到了特征工程的根本目标,即创建包含预测相关信息、能提高模型有效性的特征。通过识别和创建相关的交互项,可以提高可解释性更好的模型的预测能力。因此,一旦我们努力改进了单个预测子的形式,注意力就应该转向搜索预测子之间可能有助于解释响应中额外变异并提高模型预测能力的交互。
本章的重点将是探索如何搜索和识别预测子之间能够提高模型预测性能的交互。本章将重点关注 Ames 住房数据。所用的基础模型(base model)包含许多变量,包括以下连续预测子:一般居住面积、地块面积和临街宽度、建造年份和销售年份、泳池面积、经度、纬度以及全套卫浴数量。基础模型还包含以下定性预测子:社区、建筑类型(例如,联排别墅、独户住宅等)、中央空调、MS 子类(例如,1 层、1945 年及更早等)、地基类型、屋顶样式、小巷类型、车库类型和地块轮廓。基础模型由主效应组成,本章将重点放在发现这些预测子的有用交互上。
7.1 搜索交互的指导原则
首先,对所研究系统的专家知识(expert knowledge)对于指导选择交互项的过程至关重要。Neter 等人(1996)认识到专家知识的重要性并建议:
“因此,只要有可能,最好事先识别出那些最可能以重要方式影响响应变量的交互。”
因此,专家选定的交互应该最先被探索。但在许多情况下,专家指导可能无法获得,或者研究领域太新,没有先验知识来引导交互项的选择。当处于这种情况下时,需要合理的指导原则来引导对交互的合理选择。
一个已经解决这个问题的领域是统计实验设计(experimental design)。实验设计运用控制(control)、随机化(randomization)和重复(replication)的原则来构建收集证据的框架,以建立自变量(即预测子)与因变量响应之间的因果关系。该过程首先确定感兴趣的总体(或单元)、将被系统性改变的因子以及要研究的因子的具体范围。特定类型的实验设计称为筛选设计(screening design),它以结构化的方式生成信息,以便收集足够的数据来识别重要的因子以及两个或多个因子之间的交互。图 7.4 概念性地展示了一个包含三个因子的实验。
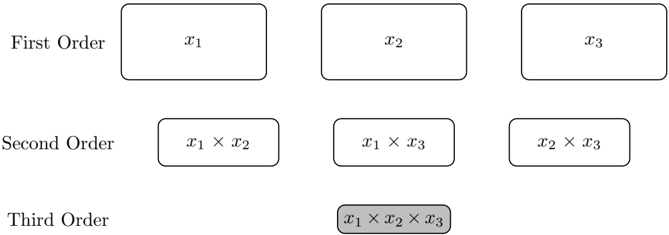
图 7.4:来自全因子(full factorial)实验的一组一阶、二阶和三阶项的示意图。项的大小根据交互层级原则确定。由于效应稀疏性原则,三向交互项被置灰。
虽然实验数据能够估计因子之间所有可能的交互,但每个交互都不可能解释所测响应变异的显著部分。也就是说,这些项中有许多对响应没有预测性。更可能的情况是,只有少数交互(如果有的话)是合理的或捕获了显著的响应变异。在这种情况下,挑战在于弄清楚众多可能的交互中哪些是真正重要的。Wu 和 Hamada(2011)为解决识别显著交互这一挑战提供了一个框架。该框架建立在交互层级(interaction hierarchy)、效应稀疏性(effect sparsity)和效应遗传性(effect heredity)等概念之上。这些概念已被证明能有效识别实验设计生成数据中最重要的效应。此外,该框架可以扩展到预测建模框架中。
交互层级原则指出,交互的阶数越高,交互解释响应变异的可能性就越小。因此,两两交互应该是搜索与响应关系的第一组交互,然后是三向交互,再是四向交互,依此类推。对于具有三个因子的数据,图 7.4 中可以直观看到效应层级的图示,其中节点的大小代表项对响应具有预测性的可能性。Neter 等人(1996)建议对三向及更高阶的交互保持谨慎,因为这些高阶项很少(如果有的话)能捕获显著的响应变异,而且几乎不可能解释。
图 7.5:一个包含三个因子的示例数据集的效应遗传性原则示意图。
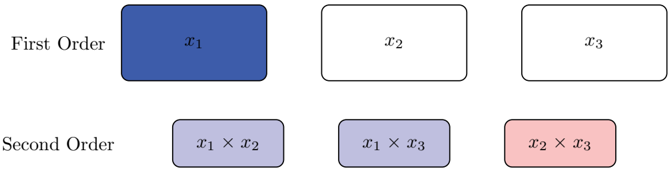
第二个原则,效应稀疏性,认为只有一小部分可能的效应真正解释了显著的响应变异(图 7.4)。因此,在搜索能够优化模型预测能力的项时,该方法可以大幅削减可能的主效应和交互项。
效应遗传性原则基于遗传学的原理,断言只有当交互之前的低阶项在解释响应变异方面有效时,才可考虑交互项。这一原则至少有两种可能的实现方式:强遗传(strong heredity)和弱遗传(weak heredity)。强遗传实现要求,要在模型中考虑某个交互,所有低阶的前置项都必须解释显著的响应变异。也就是说,只有当 \( x_1 \) 的主效应和 \( x_2 \) 的主效应各自都解释显著的响应变异时,才会考虑 \( x_1 \times x_2 \) 交互。[66] 但如果只有一个因子显著,则不会考虑该交互。弱遗传放宽了这一要求,会考虑与显著因子之间的任何可能交互。图 7.5 展示了三因子实验中强遗传与弱遗传之间的区别。对于这个例子,发现 \( x_1 \) 主效应对响应具有预测性。弱遗传原则会探索 \( x_1 x_2 \) 和 \( x_1 x_3 \) 交互项。然而,\( x_2 x_3 \) 交互项将被排除在调查之外。强遗传原则在这个例子中不会考虑任何二阶项,因为只有一个主效应被发现显著。
虽然这些原则已被证明在搜索要纳入模型的相关且具有预测性的项时是有效的,但它们并不总是适用。例如,自然界中已证明存在复杂的高阶交互。Bairey 等人(2016)表明,物种之间的高阶交互会影响生态系统的多样性。人体也是复杂化学和生物交互的温床,多个系统同时协同工作以对抗病原体并维持生命。这些例子强化了我们的观点,即识别重要交互项的最佳方法将来自对所建模系统的专家知识与基于合理统计原则的精心设计的搜索程序的结合。
7.2 实际考量
在寻找预测性交互的过程中,需要解决几个实际考量,特别是当几乎没有或没有专家知识来建议应该首先筛选哪些项时。在讨论搜索方法之前需要思考的几个问题是:利用现有数据,是否有可能枚举并评估所有可能的预测性交互?如果可能,那么是否应该评估所有交互?交互项应该在预处理原始预测子之前还是之后创建?
让我们从是否应该完全枚举所有交互项的问题开始。为了回答这个问题,将使用交互层级和效应稀疏性原则来影响方法。虽然高阶交互(三向及以上)在某些问题上可能存在(如前所述),但它们可能很少发生(效应稀疏性),并且可能只对模型的预测能力提供很小的改进(交互层级)。因此,只有在专家知识建议调查特定交互项时,才应该筛选高阶交互。更可能发生的情况是,一小部分可能的两两交互项包含预测相关信息。尽管这里的建议是专注于搜索两两交互,但要评估这些项的完全枚举仍然可能实际上是不可行的。更具体地说,如果有 \( p \) 个预测子,那么就有 \( p(p-1)/2 \) 个两两交互项。随着预测子数量的增加,交互项的数量呈指数增长。仅 100 个原始预测子,完全枚举就需要搜索 4,950 个项。适度增加到 500 个预测子,就需要我们评估近 125,000 个两两交互项!对于即使只包含中等数量预测子的数据,也肯定需要更具战略性的搜索方法,这将在后续章节中讨论。
另一个实际考量是交互项应该相对于预处理步骤何时创建。回顾第 6 章,单个数值预测子的预处理步骤可以包括中心化(centering)、缩放(scaling)、维度扩展或维度缩减。如前几章所示,这些步骤有助于模型更好地发现预测子与响应之间的预测关系。现在必须理解的是,预处理和交互项创建的先后顺序是否会影响发现具有预测重要性的交互的能力。为了说明这些步骤的顺序如何影响交互与响应的关系,考虑中风数据(第 2 章)中最大重塑比与最大面积狭窄度之间的交互。对于这些数据,预处理步骤是中心化、缩放和单独变换。图 7.6 比较了在预处理步骤之前创建交互项 (a) 和之后创建交互项 (b) 时中风组的分布。
图 7.6:说明基于中风数据预处理预测子和创建交互项的操作顺序的影响。(a) 先创建交互项,然后对所有项进行预处理。(b) 先对预测子进行预处理,然后基于预处理后的预测子创建交互项。
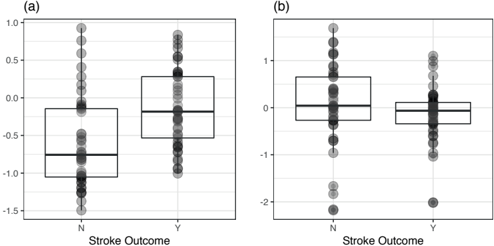
中风组之间的箱线图清楚地表明,当先创建交互项、随后进行预处理步骤时,交互的信号(由组分布之间的偏移捕获)得以保留。然而,当原始预测子在创建交互项之前被预处理时,交互的预测信号几乎完全丢失。这个案例表明,我们应该非常仔细地考虑在哪个步骤创建交互项。一般来说,交互在原始测量尺度上最合理且最易于实际解释。因此,交互项可能应该在任何预处理步骤之前创建。检查这些步骤顺序的影响也可能是明智的。
7.3 识别预测性交互的暴力枚举方法
对于具有少量到中等数量预测子的数据集,可以评估所有可能与响应相关的两两交互。然而,能评估的交互项越多,由于随机机会而与响应相关的交互被发现的可能性就越高。更具体地说,评估的与响应真正无关的项越多,其中至少有一个与响应相关的机会就越大。仅仅由于随机机会而不是由于真实关系而具有统计显著信号的项称为假阳性发现(false positive finding)。统计学的一个完整子领域致力于开发控制假阳性发现概率的方法论(Dickhaus, 2014)。假阳性发现会显著降低模型的预测性能,我们需要防止选择这类发现。
7.3.1 简单筛选
筛选重要交互项的传统方法是使用嵌套统计模型(nested statistical model)。对于具有两个预测子 \( x_1 \) 和 \( x_2 \) 的线性回归模型,主效应模型为:
\[ y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \varepsilon \]带主效应加交互的第二个模型为:
\[ y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \beta_3 x_1 x_2 + \varepsilon \]这两个模型被称为"嵌套"的,因为第一个模型是第二个模型的子集。当模型嵌套时,可以对交互项捕获的额外信息量进行统计比较。对于线性回归,比较这两个模型之间的残差误差(residual error),假设检验评估误差的改善(按自由度调整后)是否足以被认为是真实的。统计检验得出一个 p 值,它反映了该项捕获的额外信息是由于随机机会的概率。较小的 p 值,例如小于 0.05,表明捕获的额外信息是由于随机性的概率小于 5%。应当指出,5% 是假阳性发现率,是一个历史经验法则。然而,如果人们愿意为特定问题承担更多的假阳性发现风险,那么可以将临界值设置为更高的值。
对于线性回归,用于比较模型的目标函数是统计似然(statistical likelihood)(本例中为残差误差)。对于其他模型,例如逻辑回归,用于比较嵌套模型的目标函数将是二项似然(binomial likelihood)。
第 2.3 节提出了另一种防止假阳性发现的方法。该方法采用与上述相同的嵌套模型方法,但有两个重要区别:
- 使用重抽样(resampling)为不同版本的训练集创建多对嵌套模型。对于每个重样本,使用评估集来评估目标函数。在传统方法中,用于创建模型的数据被重新预测并用于评估模型(对某些模型来说这显然是有问题的)。如果模型过拟合(overfit),那么从独立数据集计算目标函数可以提供潜在的不同意见,从而反映过拟合。
- 重抽样方法与传统方法之间的另一个区别是,任何性能度量都可以用来比较嵌套模型;它不必是统计上易于处理的指标。在第 2.3 节中,ROC 曲线下面积(area under the ROC curve)是比较的目标函数。我们也可以选择识别优化灵敏度(sensitivity)、特异度(specificity)、准确度(accuracy)或任何其他适当指标的交互。这提供了极大的通用性,使我们能够将筛选与适当的建模技术和性能指标相匹配。
由于这两个原因,尤其是第二个原因,评估嵌套模型的两种方法不能保证产生一致的结果。这本身并不是问题;不同的目标函数回答不同的问题,在没有一些背景的情况下不能说一个客观上比另一个更好。Friedman(2001)说明了指标之间潜在的不一致。在他的案例中,不同的指标(二项似然和错误率)被用来选择提升树的最佳迭代次数。使用似然作为目标函数时,与使用误分类率(misclassification rate)相比,选择的迭代次数显著更少。在他看来:
“……在逻辑似然达到其最优值之后很久,误分类错误率仍在继续下降。这种通过过拟合使似然变差的做法实际上改善了误分类错误率。虽然可能违反直觉,但这并不矛盾;似然和错误率衡量的是拟合质量的不同方面。”
传统方法和第 2.3 节的重抽样方法都会生成 p 值。[67] 比较的次数越多,发现假阳性交互的机会就越高。有一系列方法可以控制假阳性发现。一个极端是不控制假阳性发现。在探索潜在交互的早期,我们可以选择这样做,同时记住很有可能找到一个或多个假阳性。另一个极端是 Bonferroni 校正(Bonferroni correction)(Shaffer, 1995),它使用非常严格的指数惩罚来尽量减少任何假阳性发现。由于这种惩罚的严重性,当我们需要执行许多统计检验时,它并不好。错误发现率(false discovery rate, FDR)程序(前面在第 5.6 节提到过)属于这个校正谱系,它是在有许多检验时为了尽量减少假阳性发现而开发的(Benjamini 和 Hochberg, 1995)。由于完全枚举可能导致探索许多可能的两两交互,FDR 可以成为无调整和 Bonferroni 校正之间的务实折衷。
这种交互检测方法(以前在第 2.3 节中使用过)的一个缺点是它过于简化。这些候选模型只包含交互中涉及的项。当发现的交互被纳入包含其他(可能相关的)预测子的更广泛模型时,它们对模型的重要性可能会减弱。由于本章使用这种方法,交互被添加到包含所有潜在相关预测子的模型中。这可能会减少被认为重要的预测子的数量(因为残差自由度更小),但发现的交互对更大的模型来说可能更可靠地重要。
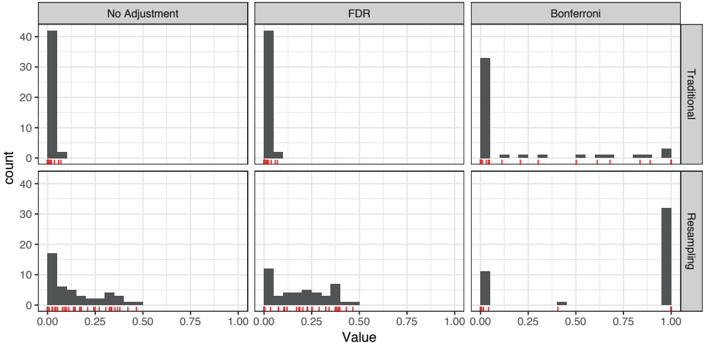
图 7.7:在产生 RMSE 降低的预测子交互中,传统估计与交叉验证估计之间的 p 值分布和 p 值调整方法的比较。
让我们回到 Ames 数据示例来说明评估交互项。这里将使用传统方法与通过重抽样得出的 p 值来比较嵌套模型。回想一下,基础模型中有许多预测子是定性的。在这个分析中,这些预测子的主效应和交互是在组级别(group level)进行的。这意味着像车库类型(有四个可能值)这样的预测子在模型中有三个主效应。当这个因子与定量预测子(如居住面积)交叉时,会增加三个额外的项。或者,可以查看更具体的交互效应(例如"已完成"的车库类型与另一个变量交互)。这与第 5.7 节中关于基于树的模型的因子与虚拟变量(dummy variable)的讨论非常相似。
在每种 p 值计算方法中,原始 p 值将与 FDR 和 Bonferroni 调整后的 p 值进行比较。图 7.7 展示了每种计算方法和调整类型下 p 值的分布。对于这些数据,传统方法几乎将所有交互效应都识别为显著(即使在 FDR 校正或 Bonferroni 调整之后)。然而,交叉验证方法的显著率较低,并且受两种校正的影响更大。同样,这可能是由于使用了不同的估计方法。由于传统方法只是重新预测原始训练集,许多这些显著发现很可能是将交互过拟合到数据的结果。
使用重抽样方法,如果我们接受 10% 的假阳性率,将宣布 15 个交互对是重要的。该方法识别出的前五对及其相关的 FDR 值为:纬度 × 经度(2e-10)、纬度 × 居住面积(4e-08)、经度 × 社区(3e-07)、建筑类型 × 居住面积(1e-06)和纬度 × 社区(1e-05)。请注意,由于方差分析(ANOVA)方法可以同时检验两个变量之间的整组交互项,这些交互是在组级别表述的(即 neighborhood 整体,而不是特定的 neighborhood)。出于说明目的,后续章节中的几乎所有分析都将定性预测子分解为虚拟变量,以便在更细粒度的级别上检测交互。对于如何评估交互没有规则;这通常由分析人员和问题的背景决定。
正如后面将看到的,显著交互列表可以用作使用探索性数据分析(exploratory data analysis, EDA)进行调查的起点。例如,使用重抽样,p 值最小的潜在交互是经度与纬度之间的交互。由此,应该使用可视化来理解该效应是否具有实际意义和潜在意义。在这些活动之后,建模者可以决定编码交互的最佳方法等。
7.3.2 惩罚回归
第 7.3.1 节提出了一种在完全枚举实际可行时搜索潜在交互项的方法。这涉及评估仅包含主效应的模型与包含主效应和交互的模型之间的模型性能变化。这种方法实现简单,可以有效地识别需要进一步评估的交互项。然而,以一次一个的方式评估交互项,使得简单模型无法在存在全套主效应和两两交互项的情况下评估交互项的重要性。
如果完全枚举实际可行,那么识别重要交互的另一种方法是创建所有交互项并将其添加到数据中。通过这样做,数据可能包含比样本更多的预测子(原始预测子加交互项)。当数据包含的预测子多于样本时,某些模型(如树(或树的集成)、神经网络、支持向量机和 K 近邻(K-nearest neighbors))是可行的。然而,其他技术如线性回归和逻辑回归不能直接在这些条件下使用。但这些模型可解释性更强,如果能够使用,可能提供良好的预测性能。特征工程的一个目标是识别既能提高模型性能又能提高可解释性的特征。因此,在预测子多于样本的情况下能够使用线性回归和逻辑回归的方法将是有用的。
一系列称为惩罚模型(penalized model)的建模技术已经被开发出来,用于处理预测子多于样本但仍希望获得可解释模型的情况。为了理解这些工具的基本前提,我们需要简要回顾线性回归的目标。假设数据由 \( p \) 个预测子组成,记为 \( x_1, x_2, \ldots, x_p \)。线性回归寻求找到使样本的估计预测值与样本观测值之间的平方距离(或误差)之和最小的系数 \( \beta_1, \beta_2, \ldots, \beta_p \)。平方误差和可以写成:
\[ \text{SSE} = \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 \]\[ \hat{y}_i = \hat{\beta}_0 + \hat{\beta}_1 x_{i1} + \hat{\beta}_2 x_{i2} + \cdots + \hat{\beta}_p x_{ip} \]并且 \( \hat{\beta}_j \) 是根据可用数据估计的、使 SSE 最小的回归系数。可以用微积分来求解这个最小化问题。但事实证明,求解需要求预测子协方差矩阵(covariance matrix)的逆。如果预测子多于样本,或者一个预测子可以写成其他一个或多个预测子的组合,那么就无法求逆。随着预测子之间的相关性越来越强,估计的回归系数会变大(膨胀)并变得不稳定。在这些条件下,需要另一种解决方案。Hoerl(1970)认识到了这一挑战,并提出将优化问题改为:
\[ \min \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 + \lambda_r \sum_{j=1}^{p} \beta_j^2 \]由于方程的目标是最小化整个量,\( \lambda_r \) 项称为惩罚(penalty),该技术称为岭回归(ridge regression)。随着回归系数变大,惩罚也必须增加以强制实现最小化。本质上,惩罚使最终的回归系数变小并向零收缩。此外,通过添加这个简单的惩罚,我们可以获得合理的参数估计。然而,许多参数估计可能并不真正为零,从而使最终模型的解释困难得多。Tibshirani(1996)对岭回归优化准则做了一个简单而显著的修改,提出最小化以下方程:
\[ \min \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 + \lambda_\ell \sum_{j=1}^{p} |\beta_j| \]这种方法被称为最小绝对收缩和选择算子(least absolute shrinkage and selection operator, lasso)。通过修改惩罚项 \( \lambda_\ell \),lasso 方法迫使回归系数变为零。这样做时,lasso 实际上将模型项选择到预测子的最优子集,因此,该方法可以用于整个预测子和交互数据集,以选择产生最佳模型性能的那些项。Friedman 等人(2010)扩展了这项技术,使其可以应用于分类场景。
传统上,这两种不同类型的惩罚与不同的任务相关联;岭惩罚主要与对抗预测子之间的共线性(collinearity)相关,而 lasso 惩罚用于消除预测子。在某些数据集中,可能需要两种效应才能创建有效的模型。Zou 和 Hastie(2005)以及 Friedman 等人(2010)设计了将两种惩罚混合在一起的方法。glmnet 模型对总惩罚 \( \lambda = \lambda_r + \lambda_\ell \) 以及与 lasso 惩罚相关的 \( \lambda \) 的比例(通常记为 \( \alpha \))有调优参数。选择 \( \alpha = 1 \) 将是完全 lasso 惩罚模型,而 \( \alpha = 0.5 \) 将是均匀混合。对于回归模型,这种方法优化
\[ \min \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 + \lambda_r \sum_{j=1}^{p} \beta_j^2 + \lambda_\ell \sum_{j=1}^{p} |\beta_j| \]图 7.8:(a) 应用于 Ames 数据的 glmnet 方法的调优参数曲线。(b) 排名靠前的选定交互项(建造年份 × 居住面积)与结果数据的关系。
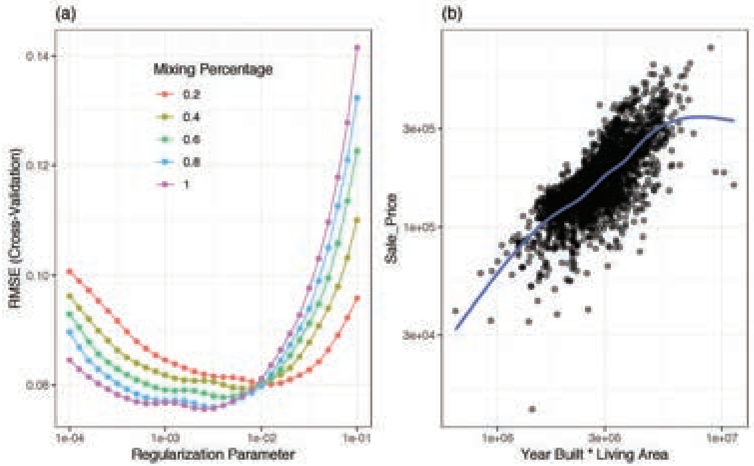
图 7.8(a) 显示了使用重抽样在 Ames 数据上(使用基础模型加上所有可能的交互)调整模型的结果。每条线是给定 \( \alpha \) 值下估计 RMSE 与 \( \lambda \) 之间的关系。随着模型变得更像 lasso,RMSE 降低。最终,使用 \( \lambda = 0.003 \) 的纯 lasso 模型是最好的。该模型的估计 RMSE 为 0.076 对数单位。在 1,033 个预测子中,模型选择了 115 个项的子集(其中只有 3 个是主效应)。对于这些数据,lasso 似乎主要偏好模型中的交互项;该技术不强制层级原则,尽管 Bien 等人(2013)为此模型开发了一种强制该原则的方法。
系数最大的交互效应交叉了建造年份和居住面积。该预测子如图 7.8(b) 所示,其中存在很大的对数线性效应。
表 7.1:glmnet 程序选择的前几项(预测子和两两交互)。
| 预测子 1 | 预测子 2 | 系数 |
|---|---|---|
| Living Area | Year Built | 0.10143 |
| Latitude | Year Built | 0.02363 |
| Central Air: Y | Lot Area | 0.02281 |
| Lot Frontage | Neighborhood: Northridge Heights | 0.01144 |
| Central Air: Y | Neighborhood: Gilbert | -0.01117 |
| Lot Area | Year Built | 0.00984 |
| Foundation: PConc | Roof Style: Hip | 0.00984 |
| Lot Frontage | Neighborhood: Edwards | -0.00944 |
| Foundation: PConc | Lot Area | 0.00893 |
| Alley: No Alley Access | MS SubClass: Two Story PUD 1946 and Newer | -0.00874 |
| Alley: No Alley Access | MS SubClass: Two Story 1946 and Newer | -0.00624 |
| Building Type Duplex | Central Air: Y | -0.00477 |
| Foundation: Slab | Living Area | -0.00454 |
| Land Contour: HLS | Roof Style: Hip | 0.00414 |
| Lot Frontage | Pool Area | -0.00409 |
表 7.1 显示了前 15 个交互项。在这组中,几个模型项多次出现(即 neighborhood、living area 等)。
7.4 完全枚举实际不可行时的方法
随着预测子数量的增加,需要探索的交互项数量呈指数增长。仅几百个预测子的中等数量(对当今的数据来说可能算少)就会产生比实际或统计角度所能考虑的更多的交互。在实际方面,计算负担也同样呈指数增长。只要有足够的计算资源,仍然可以评估大量的交互。即使这些计算是可能的,由于发现假阳性结果的机会,这在统计上也不是明智的方法。因为重要交互的数量通常很少,筛选的无关紧要交互越多,评估这些交互所付出的惩罚就越大。因此,如果计算所有可能的交互并做出适当的调整,真正显著的交互可能会被遗漏。
当有大量交互项需要评估时,需要其他方法来使搜索更高效,同时在发现重要交互方面仍然有效。本节的其余部分将综述几种已开发的用于发现预测子之间交互的方法。
7.4.1 指导原则与两阶段建模
在两阶段建模(two-stage modeling)方法中,使用不直接考虑交互效应的模型来评估预测子解释响应变异的能力。这种模型的例子是线性或逻辑回归。一旦识别出重要的预测子,就计算该模型的残差(residual)。这些残差包含单个预测子本身无法解释的信息。无法解释的变异是由于随机测量误差,也可能由于不可用或未测量的预测子,或者模型中不存在的观测预测子之间的交互。更具体地说,假设观测数据由以下方程生成
\[ y = \beta_0 + \beta_1 x_1 + \beta_2 x_2 + \beta_3 x_1 x_2 + \varepsilon \]还假设当收集该系统的数据时,只观测到了响应和 \( x_1 \)。我们能估计的最佳模型将限于
\[ y = \beta_0 + \beta_1 x_1 + \varepsilon^{*} \]由于真实响应取决于 \( x_2 \) 以及 \( x_1 \) 和 \( x_2 \) 之间的交互,不完美模型的误差(\( \varepsilon^{*} \))包含这些重要项(模型中缺失的项)的信息。如果能够访问 \( x_2 \) 并创建 \( x_1 \times x_2 \) 交互项,那么就有可能通过第二个模型分离出它们的贡献
\[ \varepsilon^{*} = \beta_2 x_2 + \beta_3 x_1 x_2 + \varepsilon \]我们无法做任何事情来解释随机测量误差;它在某种程度上总是数据固有的。而确定其他预测子是否与解释响应相关并应纳入模型,需要专家知识。然而,仍然可以搜索有助于解释响应变异的交互项。但本节的焦点是搜索所有可能的交互项实际上不可行的场景。
当有许多预测子时,可以使用第 7.1 节概述的原则来缩小搜索范围。层级原则建议首先查看两两交互以帮助解释残差变异。接下来,稀疏性原则表明,如果存在活跃的交互,那么只有相对较少的一部分是重要的。最后,遗传性原则将在第一阶段识别出的预测子中搜索这些交互。此时选择的遗传类型(弱或强)将决定要评估的交互项数量。
为了遵循这个过程逻辑,考虑对 Ames 数据建模。在第一阶段,仅使用基础预测子集(即仅主效应)的 glmnet 模型选择了 12 个预测子。
由于选择了 12 个单独的预测子,这些预测子之间有 66 个两两组合。然而,一旦创建了适当的虚拟变量,第二阶段的 glmnet 模型包含 719 个预测子列作为输入,其中 660 个是交互。遵循相同的调优过程,结果模式与图 7.8(a) 中看到的非常相似。这个两阶段模型也是纯 lasso,估计的最佳惩罚为 0.002,RMSE 为 0.081 对数单位。在整个预测子集中,这个 glmnet 模型选择了 7 个主效应和 128 个交互项。
重要的是要注意,处理连续结果与类别型结果时,计算误差的过程是不同的。如上面所示,当响应是数值时,两阶段建模方法的误差很容易计算。在分类结果的情况下,如中风数据,必须以不同的方式计算残差。应该使用 Pearson 残差(Pearson residual),定义为
\[ r_i = \frac{y_i - p_i}{\sqrt{p_i (1 - p_i)}} \]对于类别型响应数据,\( y_i \) 是第 \( i \) 个样本响应类别的二元指示符,\( p_i \) 是第 \( i \) 个样本的预测概率。
7.4.2 基于树的方法
到目前为止讨论的方法可以有效地揭示具有中等数量预测子的数据中的交互。然而,随着预测子数量的增长,这些方法的实际有效性会下降。基于树的方法,如递归划分(recursive partitioning)或递归划分模型的集成,可以有效地对具有大量预测子的数据进行建模。此外,基于树的方法已被证明可以发现变量之间的潜在交互(Breiman 等人, 1984)。事实上,使用基于树的方法识别预测子之间的重要交互一直是理论和实证研究的热门领域,我们将会看到。
让我们回顾递归划分的基本概念,以理解为什么这种技术能够发现预测子之间的交互。递归划分的目标是找到一个预测子的最优分割点,将样本分成相对于响应更同质的组。一旦进行了分割,就对后续每个节点处的样本子集应用相同的过程。这个过程然后递归地继续,直到节点中的样本数达到最小值或过程满足优化准则。当数据被递归划分时,每个后续节点可以被认为代表前一个节点与当前节点之间的局部交互(localized interaction)。此外,同一对预测子的后续节点出现得越频繁,预测子之间的交互就越可能是跨越预测子观测范围的全局交互(global interaction)。
图 7.9:两个预测子之间协同交互的递归划分树。该交互由树后续层级中两个预测子之间的几次交替分割捕获。
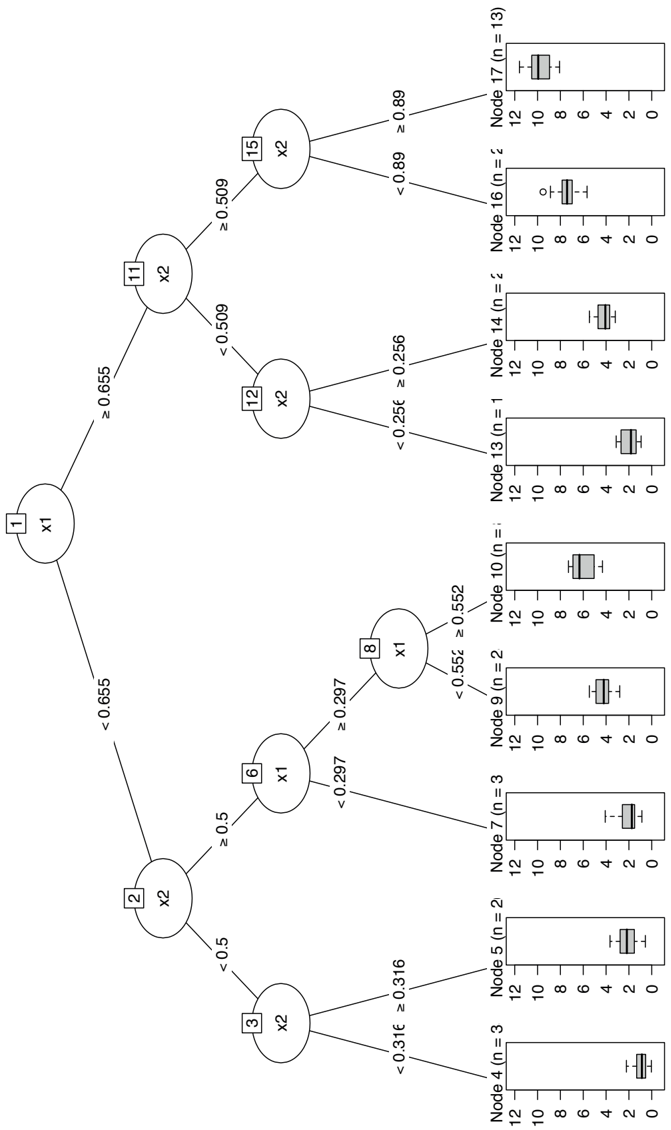
引言中提出的简单两预测子协同关系示例将用于演示如何通过递归划分检测交互。这些数据的最优树如图 7.9 所示。基于树的模型通常被认为是纯交互的,因为它们的预测方程可以写成一组乘法语句。例如,到达终端节点 4 的路径经过三次分割,可以写成单一规则:
node_4 <-I (x1 < 0.655) * I (x2 < 0.5) * I (x2 < 0.316) * 0.939
其中 0.939 是落入该节点的训练集数据的均值(\( I \) 是一个根据函数内部逻辑取值 0 或 1 的函数)。最终的预测方程将通过添加来自其他八个终端节点的类似项来计算(预测时除单个规则外,其他项都将为零)。请注意,在图 7.9 中,终端节点具有同质的小组数据,在第一次分割的每一侧,从较小的响应值(左侧)到较大的响应值(右侧)排列。实现同质终端节点需要整个树中两个预测子的信息。
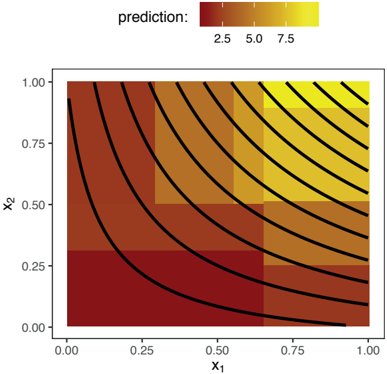
但为什么树需要如此复杂来对 \( x_1 \) 和 \( x_2 \) 之间这种相对简单的协同关系建模呢?回想图 7.2,协同关系使响应产生弯曲的等高线。因为递归划分模型将空间分成矩形区域,模型需要更多区域来充分解释响应。本质上,划分特性阻碍了树表示平滑、全局交互的能力。
为了看到这一点,让我们看看图 7.10。在该图中,每个终端节点的预测由矩形区域表示,其中颜色表示该区域的预测响应值。叠加在该图上的是来自线性模型的等高线,其中交互项已被估计。基于树的模型在逼近协同响应方面做得很好。但是,由于模型将空间分成矩形区域,它需要许多区域来解释这种关系。
图 7.10 说明树将预测子与响应之间的关系像素化。众所周知,树预测的粗糙特性通常使该模型的准确性低于其他模型。此外,树还有一些众所周知的潜在缺点。例如,单个树可能高度可变(即,模型可能随着数据的微小变化而显著改变)。树的集成,如袋装(bagging)(Breiman, 2001)和提升(boosting)(Friedman, 2001),已被证明可以缓解这些问题并提高响应的预测性。
这里提供这些技术的简要说明,以帮助理解这些技术。这些技术的深入说明可以在 Kuhn 和 Johnson(2013)中找到。为了构建袋装树模型,独立地从原始数据中有放回地生成许多样本。对每个样本构建一棵树。为了预测一个新样本,模型对所有树的预测响应取平均。提升也利用一系列树,但以根本不同的方式创建它们。提升模型不是构建最大深度的树,而是限制树的深度。此外,提升树模型利用前一棵树在样本上的预测性能来重新加权预测不佳的样本。第三,提升模型中每棵树的贡献使用与单个模型拟合相关的统计量进行加权。对新样本的预测是整个树集合的加权组合。
图 7.10:具有协同关系的两个预测子的递归划分模型预测响应示意图。这些区域能够以像素化的方式逼近与响应的关系。
最近的研究表明,这些集成方法能够识别预测子之间的重要交互。García-Magariños 等人(2009)和 Qi(2012)说明了随机森林(它是袋装的进一步修改)如何用于在生物数据中发现交互,而 Basu 等人(2018)使用随机森林算法的变体来识别高阶交互。对于提升,Lampa 等人(2014)和 Elith 等人(2008)发现这种方法也可以用来发现重要的交互。从理论的角度,Friedman 和 Popescu(2008)提出了一种新的统计量来评估基于树的模型中交互的重要性。
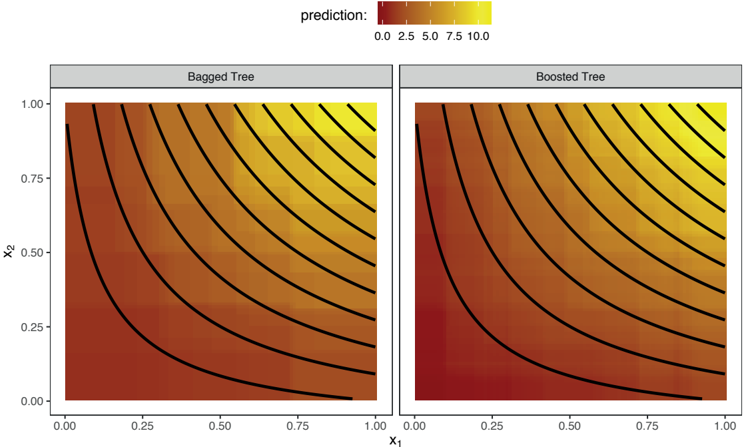
树集成能有效识别预测子-响应关系的原因在于,它们聚合了来自原始数据略有不同版本的许多树。这种聚合允许更多可能的响应值,并更好地逼近预测子-响应关系。为了看到这一点,将在两预测子协同示例上构建一个随机森林模型和一个梯度提升机(gradient boosting machine)模型。
图 7.11 显示,树集成比单棵树更能逼近协同关系。事实上,提升的交叉验证均方根误差(root mean squared error, RMSE)为 0.27,袋装树为 0.6。最优单树模型更差,交叉验证 RMSE 为 0.9。在这个例子中,更平滑的模型胜出;线性回归交互模型的 RMSE 为 0.05。
图 7.11:当预测子具有协同关系时,提升和袋装树模型的预测响应示意图。与单棵树相比,这些集成模型可以更好地逼近预测子与响应之间的关系。
请注意,单棵树或树的集成在发现对所有样本全局成立的预测性交互方面效果较差,而且是复杂得多的模型。这个简单的例子突出了特征工程的主要前提。如果可以识别有意义的预测子关系并将其置于更有效的形式中,那么就可以使用更简单、或许更合适的模型来估计预测子与响应之间的关系。然而,有一种情况下基于树的方法可能具有更好的预测能力。当重要交互发生在一个或多个样本子集内(即局部)时,基于树的方法具有正确的架构来对交互建模。为局部交互创建特征以纳入更简单的模型要繁琐得多。这个过程需要创建一个项,它是局部空间的标识符(即虚拟预测子)与该空间内交互的预测子的乘积,这本质上是一个三项交互。
既然树和树的集成可以逼近预测子之间的交互,我们能否利用结果模型中的信息来指出应该纳入更简单线性模型的项?Basu 等人(2018)提出的方法使用一种随机森林模型形式(称为特征加权随机森林(feature weighted random forest)),它根据由特征重要性决定的权重随机选择特征。创建集成后,为每个共现特征集计算一个指标,该指标可用于识别最重要的交互特征。
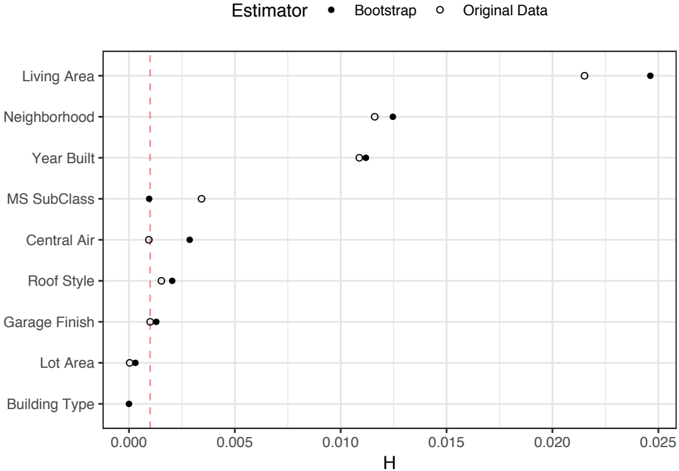
Friedman 和 Popescu(2008)提出了一种基于偏依赖(partial dependence)(Friedman, 2001)理论概念的方法,用于使用集成识别交互。简而言之,该方法比较模型中两个(或多个)预测子的联合效应与每个预测子的单独效应。如果单个预测子不与任何其他预测子交互,联合效应与单独效应之间的差异将接近零。然而,如果单个预测子与至少一个预测子之间存在交互,差异将大于零。这种比较在他们所称的 H 统计量(H statistic)中进行了数值总结。对于 Ames 数据中的 18 个预测子(包括随机预测子),在整个训练集上计算了 H 统计量。一个问题是,H 统计量在各预测子之间可能具有相当双峰的分布,因为许多值为零(当预测子不参与任何交互时)。这个数据集相当小,因此出于这些原因,计算了 20 个自助法(bootstrap)估计值,并使用中位数 H 统计量进行总结。两个估计都显示在图 7.12 中。原始统计量与其重抽样对应物相当吻合。一些 H 值非常接近零,因此在自助法估计值上使用了 H ≥ 0.001 的截断值来选择变量。这将使我们相信有 6 个预测子参与了至少一个交互。遵循之前的两阶段方法,将这些预测子的所有对应两两交互添加到 glmnet 模型中的主效应中(模拟之前的分析)。使用重抽样,选择了另一个纯 lasso 模型,这次最优调优参数值为 \( \lambda = 10^{-4} \)。从这个模型中,选择了 48 个主效应和 68 个交互。
第三种实用的交互识别方法使用预测子重要性信息以及层级、稀疏性和遗传性原则。简而言之,如果预测子之间的交互很重要,那么基于树的方法会在多棵树的多个位置使用这些预测子来发现与响应的关系。这些预测子将具有非零且可能很高的重要性值。然后可以创建最重要预测子之间的两两交互,并评估它们在预测响应方面的相关性。这与两阶段建模方法非常相似,只是基础学习器是基于树的模型。
每种基于树的方法都有自己特定的预测子重要性计算算法。最流行的方法之一是由随机森林生成的。随机森林使用自助法样本创建许多模型用于集成。由于使用了自助法,每棵树都有一个相关的评估集(历史上称为袋外(out-of-bag, OOB)样本),这些样本不用于拟合模型。可以对每棵树预测这些样本,以了解模型的质量。假设一个随机森林模型包含 1,000 棵树。如果对每棵树的袋外样本计算分类准确度,这些准确度统计量的平均值就是 OOB 估计。为了测量特定预测子的重要性,将该预测子的值打乱,并重新计算 OOB 估计。如果预测子不重要,原始 OOB 统计量与使预测子变得无关的统计量之间不会有太大差异。然而,如果预测子至关重要,置换后的 OOB 统计量应该显著变差。随机森林对模型中的每个预测子进行这种分析,并为每个预测子创建一个单一分数,较大的值与较高的重要性相关。[68]
图 7.12:Ames 数据的 H 统计量估计可视化。
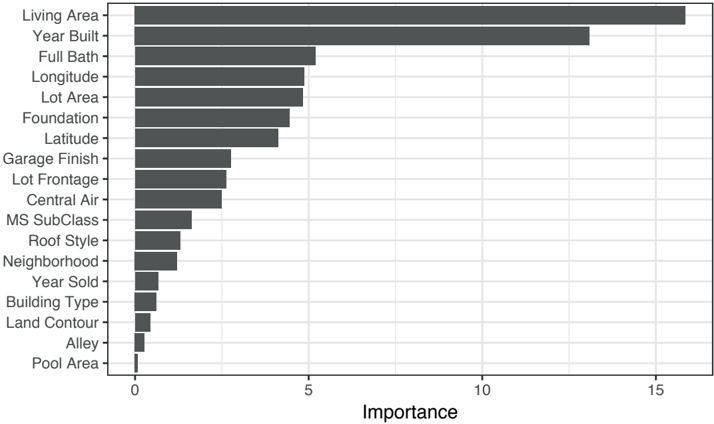
对于 Ames 数据,拟合了随机森林模型(使用默认的 mtry 值)并估计了重要性分数。图 7.13 显示了按重要性排列的前 10 个预测子,其中大多数已被其他方法识别为多个两两交互的一部分。特别重要的是居住面积和建造年份,它们是最重要的预测子,并组合成一个科学上有意义的交互。这种方法在精神上与上面讨论的两阶段方法相似。主要区别在于,随机森林模型仅用于识别有可能成为重要交互一部分的预测子。这里识别出的最重要预测子之间的交互随后可以纳入更简单的模型(如逻辑回归)中,以评估它们的重要性。
图 7.13:应用于 Ames 数据的随机森林模型的前 10 个变量重要性分数。
7.4.3 可行解算法
如上所述,识别重要交互的问题可以被认为是识别包含主效应和交互的最优模型。即使对于中等数量的预测子,对所有可能模型进行完全枚举和评估实际上也是不可能的,因为模型的数量是 \( p! \)。当使用线性或逻辑回归等线性模型时,前向(forward)、后向(backward)和逐步选择(stepwise selection)等方法通常用于找到最优预测子集(Neter 等人, 1996)。这些技术正如其名称所示一样易于理解。前向选择技术从没有预测子开始,识别与响应关系最优的预测子。在下一步中,选择下一个预测子,使其与第一个预测子组合后与响应的关系最优。这个过程持续到剩余的预测子中没有一个能根据优化准则改善模型。后向选择技术从所有预测子开始,顺序移除对优化准则贡献最小的预测子。这个过程持续到移除一个预测子会显著降低模型性能为止。逐步过程根据优化准则在每一步一次添加或移除一个预测子,直到任何预测子的添加或移除都不能显著改善模型。[69]
Miller(1984)为线性模型问题提供了一种替代逐步法的搜索技术。他不建议移除预测子,而是建议一种替换(substitution)方法,其中系统地选择每个已选预测子进行替换。例如,假设有 10 个预测子 \( x_1 \) 到 \( x_{10} \),我们想找到包含三个预测子的最佳模型。Miller 的过程首先从十个预测子中随机选择三个,比如 \( x_2 \)、\( x_5 \) 和 \( x_9 \)。计算这三个预测子的模型性能。然后固定前两个预测子,并计算这两个预测子与其余七个预测子中每一个组合的模型性能。如果其他七个预测子中没有一个比 \( x_9 \) 给出更好的性能,则保留这个预测子。如果 \( x_9 \) 不是最优的,则将其与最佳预测子交换。然后过程固定第一个和第三个预测子,使用相同的步骤选择最优的第二个预测子。然后,固定第二个和第三个预测子,开始搜索最优的第一个预测子。这个过程持续迭代,直到收敛到最优解。因为该算法不能保证找到全局最优解,所以应该选择不同的随机起始预测子集。对于每个不同的起始集,确定收敛解和每个解的出现频率。Hawkins(1994)将此算法扩展为一种稳健的建模方法,并将该过程称为可行解算法(Feasible Solution Algorithm, FSA)。
这种技术的一个主要优点是算法的搜索空间,其数量级为 \( q \times m \times p \),其中 \( q \) 是随机起始次数,\( m \) 是子集中的项数,\( p \) 是预测子数量,远小于整个搜索空间(\( p^m \))。FSA 已被证明收敛到最优解,尽管不能保证是全局最优。
FSA 专注于找到主效应的最优子集。然而,FSA 的原始实现不考虑搜索预测子之间的交互。这可能是在使用该算法时的一个相当大的缺点,因为许多问题中预测子之间确实存在重要的交互。Lambert 等人(2018)认识到了这一缺陷,并对该算法进行了推广以搜索交互。Lambert 的方法从一个基础模型开始,该模型通常包含被认为对预测响应重要的预测子。选择所需交互的阶数(即两因子、三因子等)。识别潜在相关交互的过程遵循与原始 FSA 相同类型的逻辑。为了说明这个过程,让我们回到上面的例子。假设基础模型包含三个预测子(\( x_1 \)、\( x_5 \) 和 \( x_9 \)),目标是识别重要的两两交互。Lambert 的算法随机选择两个预测子,比如 \( x_1 \) 和 \( x_9 \),并计算包含基础项和该交互项的模型的性能。然后算法固定第一个预测子,系统地用其余八个(如果我们想研究二次效应,则为九个)预测子替换第二个预测子,并计算相应的模型性能。如果其他预测子都没有给出更好的预测性能,则保留 \( x_9 \)。但如果 \( x_9 \) 不是最优的,则将其与最佳预测子交换。然后过程固定第二个预测子,并用其他八个(或九个)预测子交换第一个预测子。这个过程持续迭代直到收敛。然后选择不同的随机预测子对并应用该过程。在随机起始之间汇总收敛的交互,以识别潜在的可行解。该算法可以很容易地推广到任何阶数的交互。
表 7.2:可行解算法为 Ames 数据选择的前几对交互。
| 预测子 1 | 预测子 2 | p 值 | RMSE |
|---|---|---|---|
| Foundation: CBlock | Living Area | 0.00539 | 0.0513 |
| Foundation: PConc | Living Area | 0.00828 | 0.0515 |
| Building Type Duplex | Living Area | 0.00178 | 0.0516 |
| Living Area | MS SubClass: Duplex All Styles and Ages | 0.00102 | 0.0516 |
| Roof Style: Hip | Year Built | 0.04945 | 0.0518 |
| Roof Style: Gable | Year Built | 0.00032 | 0.0518 |
| Longitude (spline) | Neighborhood: Northridge Heights | 0.00789 | 0.0518 |
| Living Area | Neighborhood: Northridge Heights | 0.09640 | 0.0519 |
| Full Bath | Land Contour: HLS | 0.07669 | 0.0519 |
| Foundation: CBlock | Lot Area | 0.01698 | 0.0519 |
| MS SubClass: One Story PUD 1946 and Newer | Year Built | 0.02508 | 0.0519 |
| Latitude (spline) | Neighborhood: other | 0.03926 | 0.0520 |
| Latitude (spline) | Neighborhood: College Creek | 0.00986 | 0.0520 |
| Foundation: CBlock | MS SubClass: One Story PUD 1946 and Newer | 0.04577 | 0.0520 |
| Longitude (spline) | Neighborhood: other | 0.03762 | 0.0520 |
FSA 被用于 Ames 数据。与之前的分析不同,我们选择使用单独的虚拟变量来查看特定的交互项,以便与之前的结果进行对比。例如,随机生成的交互可能涉及来自不同预测子的两个虚拟变量。我们限制了选择,使来自同一预测子的虚拟变量永远不会配对。使用了 50 次随机起始,每次随机起始期间,有 60 次将预测子交换到随机生成的交互中的潜在交换。使用重抽样[70] 来确定每个候选交互项集是否与较小的 RMSE 值相关联。该确定使用基础模型和候选交互进行。在 FSA 的迭代过程中,识别出 31 个不同的交互对。表 7.2 显示了前 15 个交互的结果(按其产生的 RMSE 排序)。许多相同的变量出现在这些列表中(例如,居住面积、社区等),以及一些非线性项(例如,地理编码的样条)。下一步将是在更多探索性工作之后,将其中一些项添加到基础模型中。
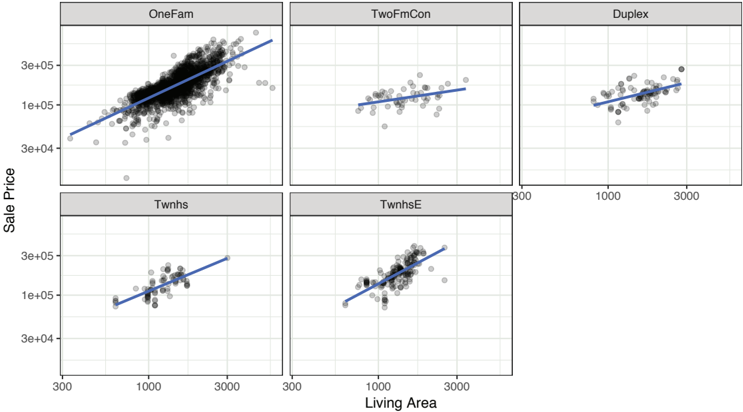
例如,建筑类型和居住面积之间似乎存在潜在的交互。它们与结果的关系性质是什么?图 7.14 显示了一个按建筑类型分隔的散点图,每个子组中叠加了线性回归线。该图显示了几种建筑类型的斜率非常不同。最大的对比出现在联排别墅端单元(Townhouse End Units,TwnhsE)与两户改建(two-family conversions,TwoFmCon,最初建造为独户住宅)之间。将全部五个交互项编码,或将一些斜率相似的项分组以实现更简单的编码,可能是有意义的。
图 7.14:使用 FSA 程序发现的建筑类型异质斜率示例。
7.5 其他可能有用的工具
还有一些其他模型能够发现预测性交互,值得一提。多元自适应回归样条(multivariate adaptive regression splines, MARS)是一种用于连续响应的非线性建模技术,它搜索单个预测子和每个预测子的单个值,以找到用于创建描述预测子与响应之间关系的铰链函数(hinge function)的预测子和样本值(Friedman, 1991)。铰链函数之前在第 6.2.1 节中描述过,它使模型能够搜索非线性关系。除了能够搜索单个预测子之外,MARS 还可以用于搜索预测子的乘积,以创建隔离预测子空间部分的非线性交互。MARS 技术还具有内置的特征选择。这种方法的主要缺点是计算量大。MARS 也已扩展到分类结果,这种方法称为灵活判别分析(flexible discriminant analysis, FDA)。
Cubist(Kuhn 和 Johnson, 2013)是一种基于规则的回归模型,它构建一棵初始树并将其分解为规则集,这些规则被剪枝并可能被消除。对于每条规则,定义一个单独的线性模型。Ames 住房数据的一个规则示例可能是:
if Year_Built <= 1952 Central_Air = No Longitude <= -93.6255 then log10 Sale Price = 261.38176 + 0.355 Gr_Liv_Area + 2.88 Longitude + 0.26 Latitude
这种结构创建了一组不相交的交互;规则集可能无法覆盖规则中使用的预测子的每个值组合。被预测的新数据点可能属于多个规则,在这种情况下,相关的线性模型预测被平均。这种模型结构非常灵活,很有可能在整个预测子空间内发现局部交互。例如,当一个房产的总居住面积较小但卧室数量较多时,回归模型中通常与卧室数量相关的斜率为负。这当然不是普遍正确的,但当仅应用于几乎"全是卧室"的房产时可能如此。
7.6 小结
在构建预测模型时,预测子之间的交互往往被忽视。这可能是由于现代建模技术能够隐式识别交互。或者交互可能被忽视,是因为这些交互会给模型增加大量额外的项。如果分析人员不知道哪些交互项可能有助于解释结果,这一点尤其如此。
当开始搜索交互时,关于系统的专家知识总是最有益的,可以帮助缩小搜索范围。算法方法也可以用于搜索。对于预测子数量相对较少的数据,可以完全枚举每个两两交互。然后可以使用重抽样方法或惩罚模型来定位可能有用地改善模型的交互。
随着预测子数量的增长,完全枚举变得实际上不可行。相反,应该使用能够在不搜索整个空间的情况下轻松识别潜在重要交互的方法。这些方法包括两阶段建模、基于树的方法和可行解算法。
当搜索完成时,最有可能改善模型性能的交互项可以添加到更简单的模型(如线性或逻辑回归)中。然后可以通过交叉验证估计预测性能,并与没有这些项的模型进行比较,以确定整体的预测改进。
7.7 计算
网站 http://bit.ly/fes-interact 包含用于重现这些分析的 R 程序。
脚注
[66] 因此,图 7.3 中显示的交互被标记为"非典型"。
[67] 尽管如第 3.7 节所述,有一些贝叶斯方法可以在不生成 p 值的情况下比较模型。
[68] 这些重要性分数将在第 11.3 节中进一步讨论。
[69] 这是一种特征选择算法,与第 10 章中讨论的类似。
[70] 使用之前采用的相同的 10 折交叉验证重复。