数值预测子的工程化(Engineering Numeric Predictors)
上一章提供了巧妙修改定性预测子的方法。通常,其他预测子具有连续的实数取值。本章的目标是开发一些工具,将这些类型的预测子转换为模型能够更好地利用的形式。
处于连续尺度上的预测子会面临一系列我们可能不得不应对的潜在问题。连续预测子中普遍存在的某些问题可以通过我们所选择的模型类型来缓解。例如,基于预测子值的秩(rank)而非实际值来构建预测子与响应之间关系的模型(如树(tree)模型),不受偏态分布或具有异常值(outlier)的个别样本的影响。其他模型(如 K 近邻(K-nearest neighbors)和支持向量机(support vector machine))对具有偏态分布或异常值的预测子则要敏感得多。相互高度相关的连续预测子也是经常出现的情形,它对某些模型构成问题,但对另一些模型则不然。例如,偏最小二乘(partial least squares)就是专门为直接处理高度相关的预测子而构建的。但多元线性回归(multiple linear regression)或神经网络(neural network)等模型在这种情况下会受到不利影响。
如果我们希望利用和探索更多类型模型的预测能力,就需要通过以有用的方式对预测子进行工程化来应对这些预测子带来的问题。
在本章中,我们将提供此类方法,并说明如何处理具有常见问题的连续预测子。预测子可能:
- 处于截然不同的尺度(scale)上。
- 遵循偏态分布(skewed distribution),其中一小部分样本比大多数数据大几个数量级(即偏度(skewness))。
- 包含少量极端值。
- 在范围的低端和/或高端被截尾(censored)。
- 与响应存在复杂的关系,确实具有预测性,但无法用简单函数充分表示,也无法被复杂的模型提取出来。
- 包含相关且过度冗余的信息。也就是说,所收集的信息可以用更少、更整合的新预测子来更有效、更高效地表示,同时保留或增强新预测子与响应之间的关系。
本章中的技术被组织为三大类。第一类工程化技术处理单个预测子的有问题的特征(第 6.1 节)。第 6.2 节阐述将单个预测子扩展为多个预测子的方法,以便更好地表示更复杂的预测子-响应关系,并能够提取预测信息。最后,第 6.3 节提供了一种整合多个预测子间冗余信息的方法。归根结底,所有这些方法的目标都是将现有的连续预测子转换为任何模型都能利用的形式,并向模型呈现最有用的信息。
与本书讨论的许多技术一样,对这些技术的需求可能高度依赖于数据和模型。例如,解决偏度或异常值的变换对某些模型来说并不需要,但对其他模型来说却是良好性能的关键。本章将提供一份指南,说明哪些模型会受益于特定的预处理方法。
6.1 一对一变换
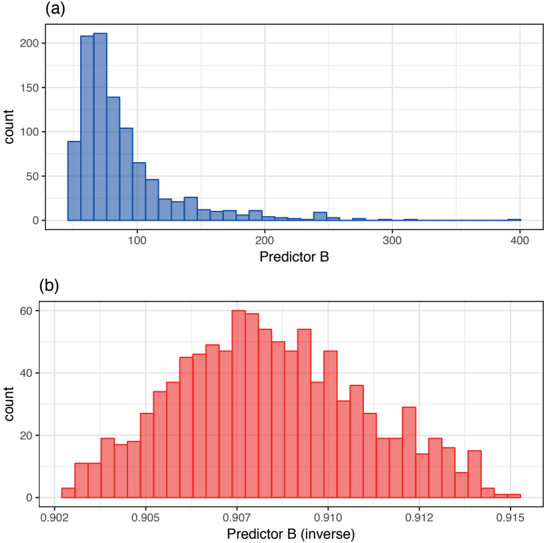
可以对单个预测子进行各种修改,以提高其在模型中的效用。这里讨论的第一类对单个预测子的变换是改变数据尺度的变换。一个很好的例子是第一章图 1.3 中描述的变换。在那种情况下,两个预测子具有非常偏态的分布,并且表明使用值的倒数(inverse)可以改善模型性能。图 6.1(a) 显示了图 1.3 中一个预测子的测试集分布。
Box-Cox 变换(Box 和 Cox, 1964)被用来估计这种变换。Box-Cox 过程最初是作为模型结果(outcome)的变换而提出的,它使用最大似然估计来估计方程中的变换参数 λ:
\[ x^{(\lambda)} = \begin{cases} \dfrac{x^\lambda - 1}{\lambda \tilde{x}^{\lambda - 1}} & \lambda \neq 0 \\[6pt] \tilde{x} \ln x & \lambda = 0 \end{cases} \]其中 \tilde{x} 是预测子数据的几何平均数(geometric mean)。在该过程中,λ 由数据估计。由于感兴趣的参数位于指数中,这类变换被称为幂变换(power transformation)。某些 λ 值对应常见的变换,如 λ = 1(不变换)、λ = 0(对数)、λ = 0.5(平方根)和 λ = -1(倒数)。如你所见,Box-Cox 变换在应对许多不同的数据分布方面非常灵活。对于图 6.1 中的数据,从训练集数据估计出的参数为 \( \hat{\lambda} = -1.09 \)。这实际上就是倒数变换。图 6.1(b) 显示了将变换应用于测试集后的结果,得到近似对称的变换后分布。需要注意的是,Box-Cox 过程只能应用于严格为正的数据。为解决这个问题,Yeo 和 Johnson(2000)设计了一个类似的过程,可用于任何数值数据。
图 6.1:应用 Box-Cox 变换前 (a) 和变换后 (b) 的偏态预测子的分布。
此外,请注意这两种变换都是无监督的(unsupervised),因为在此应用中,计算中没有使用结果。虽然变换可能会改善预测子的分布,但它不能保证改善模型。然而,有各种各样的参数模型会在预测子数据上使用多项式计算,例如大多数线性模型、神经网络和支持向量机。在这些情况下,偏态的预测子分布可能对这些模型产生有害影响,因为分布的尾部会主导底层计算。
应当指出,Box-Cox 变换最初是作为结果的有监督变换(supervised transformation)使用的。先对数据拟合一个简单线性模型,然后从模型残差(residual)中估计变换。使用 Box-Cox 方法的结果对结果变量进行变换。在这里,该方法被移用来独立地应用于每个预测子,并使用它们的数据(而不是残差)来确定合适的变换。
另一个对单个变量的重要变换是针对取值介于零和一之间的变量,例如比例(proportion)。对这类结果进行建模的问题在于,模型的预测可能无法保证落在相同的边界内。对于介于零和一之间的数据,可以使用 logit 变换。如果 π 是变量,logit 变换为
\[ \text{logit}(\pi) = \ln\left(\frac{\pi}{1 - \pi}\right) \]该变换将尺度从介于零和一之间的值改变为介于负无穷和正无穷之间的值。在极端情况下,当数据恰好为零或一时,可以加上或减去一个小的常数以避免除以零。一旦生成模型预测,就可以使用逆 logit 变换将值放回原始尺度。logit 变换的替代方案是反正弦变换(arcsine transformation)。它主要用于比例的平方根(例如,\( y^* = \arcsin(\sqrt{\pi}) \))。
修改预测子尺度的另一种常用技术是标准化(standardize)其值,以获得特定性质。对预测子进行中心化(centering)是一种常用技术。将预测子的训练集平均值从预测子的各个值中减去。当这分别应用于每个变量时,变量集合将具有共同的均值(即零)。类似地,缩放(scaling)是将变量除以相应训练集的标准差的过程。这确保变量的标准差为一。或者,范围缩放(range scaling)使用训练集的最小值和最大值将数据转换到任意范围内(通常为零到一)。再次强调,变换所需的统计量(例如均值)是从训练集估计的,并应用于所有数据集(例如测试集或新样本)。
这些变换大多是无害的,通常在模型要求预测子具有共同单位时需要。例如,当使用预测子之间的距离或点积(如 K 近邻或支持向量机)时,或者当变量需要处于共同尺度以应用惩罚项(例如第 7.3 节中描述的 lasso 或岭回归(ridge regression))时,标准化过程是必不可少的。
另一种可用于包含时间或序列效应的数据的预处理方法是简单数据平滑(smoothing)。例如,可以使用运行均值(running mean)在建模前减少预测子或结果数据中的过多噪声。例如,运行 5 点均值将用每个数据点自身及其前后两个数据点的平均值来替换它。[53] 正如人们所料,移动窗口的大小很重要;如果过大,平滑效果可能会消除重要的趋势,例如非线性模式。
[53] 对于数据的开头和结尾有各种处理方法,例如保持数据原样。
图 6.2:一段时间内的结果值序列。原始数据在第 10 天和第 45 天包含异常值。平滑值是 3 点运行中位数(running median)的结果。
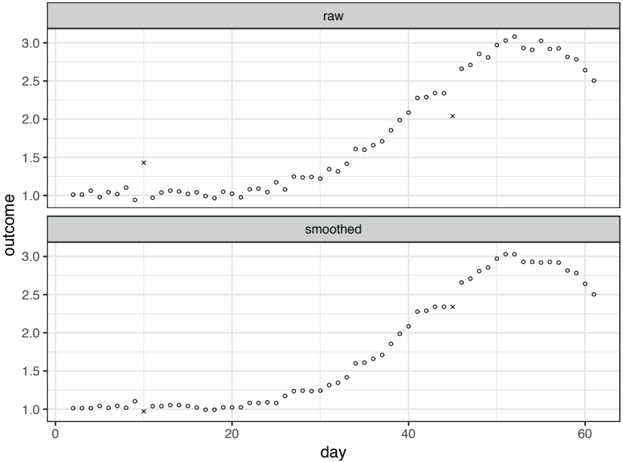
短运行中位数也很有帮助,尤其是在存在显著异常值时。当异常值落入移动窗口时,均值会被拉向异常值。中位数对异常值非常不敏感,是更好的选择。它还具有改变较少原始数据点的效果。
例如,图 6.2 显示了 61 天的数据序列。原始数据位于上图,第 10 天和第 45 天有两个异常数据值。下图显示了 3 点运行中位数平滑器的结果。它似乎并没有钝化数据最后 15 天中可见的非线性趋势,但确实缓解了异常值。此外,大约 40% 的平滑数据与原始序列具有相同的值。
也可以使用其他平滑器,例如平滑样条(smoothing spline,本章也会介绍)。然而,短运行中位数的简单性和稳健性使其成为这类数据颇具吸引力的方法。这种平滑操作可以应用于结果数据(如图 6.2 所示)和/或任何序列预测子。后一种情况在第 3.4.7 节中有关信息泄露(information leakage)的讨论中被提及。务必确保测试集预测子数据被单独平滑,以避免训练集影响测试集(或新的未知样本)中的值。为减少噪声而对预测子数据进行平滑在第 9.4 节中有更多探讨。
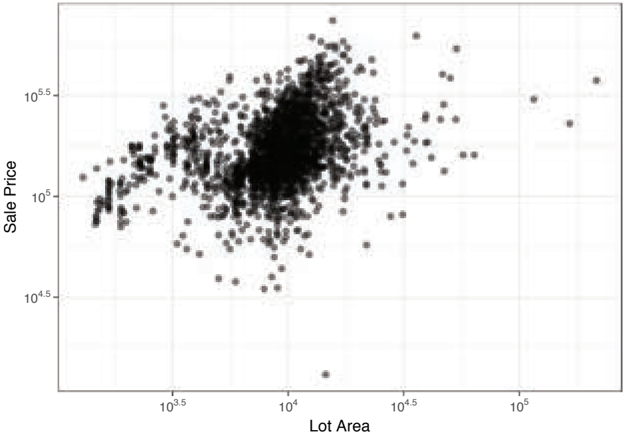
图 6.3:训练集的销售价格和地块面积(lot area)数据。
6.2 一对多变换
上一章说明了从单个定性预测子创建多个数值指示列的过程。类似地,可以对单个数值预测子进行变换,将其扩展为多个预测子。数据的一对多变换可用于改善模型性能。
6.2.1 通过基展开和样条实现非线性特征
预测子 x 的基展开(basis expansion)可以通过推导一组可以使用线性组合(linear combination)组合的函数 \( f_i(x) \) 来实现。例如,在上一章中,多项式对比函数(polynomial contrast function)被用于编码有序类别。对于连续预测子 x,三次基展开(cubic basis expansion)为
\[ f(x) = \beta_0 + \beta_1 x + \beta_2 x^2 + \beta_3 x^3 \]要在模型中使用此基展开,需要在原始列的基础上增加两个新特征,即原始值的平方和立方版本。β 值可以使用基本线性回归来估计。如果真实趋势是线性的,那么后两个回归参数应该接近于零(至少相对于它们的标准误而言)。此外,用于确定基展开系数的线性回归可以在存在其他回归量的情况下估计。
这种将模式全局应用于预测子的基展开往往是不够的。例如,以 Ames 住房数据中的地块大小变量为例。当与销售价格[54] 作图时,在数据的主体范围内(介于 \( 10^{3.75} \) 和 \( 10^{4.25} \) 之间)存在线性递增趋势,但在数据主体两侧,模式可以忽略不计。
创建可用于回归模型的全局基函数的另一种方法是多项式样条(polynomial spline)(Wood, 2006; Eilers 和 Marx, 2010)。在这里,基展开在预测子空间中创建不同的区域,其边界称为结点(knot)。多项式样条在每个区域内使用多项式函数(通常是三次)来表示数据。我们希望三次函数在结点处相连,因此可以创建专门的函数来确保整体函数是连续的。[55] 在这里,结点的数量控制区域的数量以及函数的潜在复杂性。如果结点数量很少(也许三个或更少),基函数可以表示相对简单的趋势。结点更多的函数适应性更强,但也更可能过拟合(overfit)数据。
结点通常使用数据的百分位数(percentile)来选择,以便每个区域内包含相对等量的数据。例如,具有三个区域的样条通常将结点放置在 33.3% 和 66.7% 分位数处。一旦确定了结点,就可以创建基函数并在回归模型中使用。多项式样条有许多类型,这里描述的方法通常被称为自然三次样条(natural cubic spline)。
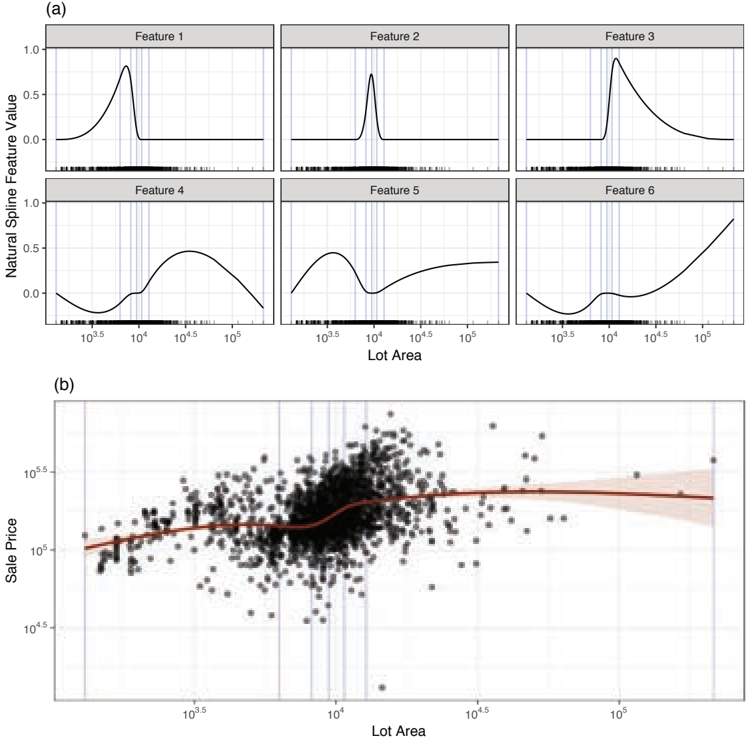
对于 Ames 地块面积数据,考虑一个具有 6 个区域的样条。该过程将结点放置在以下百分位数:16.7%、33.3%、50%、66.7%、83.3%。在创建自然样条基函数时,第一个函数通常作为截距。该过程生成的其他 x 的函数如图 6.4(a) 所示。这里蓝线表示结点。请注意,前三个特征包含基函数值为零的区域。这意味着这些特征不影响预测子空间的该部分。其他三个特征似乎将最大的权重放在数据主体之外的区域。该图的 (b) 面板显示了最终的回归形式。在数据点云的中间存在强烈的线性趋势,而在主体之外存在弱关系。左侧的拟合似乎不是特别好。这可能意味着需要更多结点。
应该使用多少个结点?这是一个调参(tuning)参数,可以通过网格搜索(grid search)或目视检查平滑结果(例如图 6.4(b))来确定。在一维情况下,如果模型过拟合,会有视觉证据。此外,一些样条函数使用一种称为广义交叉验证(generalized cross-validation,GCV)的方法,利用线性回归的计算捷径来估计适当的样条复杂度(Golub 等, 1979)。
请注意,基函数是在接触结果数据之前创建的。
[54] 两个变量都高度右偏,因此对两个轴都应用了对数变换。
[55] 这些方法还确保函数在一定阶数内的导数也是连续的。这是通常使用三次函数的原因之一。
图 6.4:(a) 使用地块面积预测子的自然样条基函数创建的特征。蓝线对应结点。(b) 回归模型为每个特征估计模型系数后的拟合结果。
情况不必如此。确定曲线最优复杂度的一种方法是首先将每个训练集点都指定为潜在结点,并使用正则化回归模型(类似于权重衰减(weight decay)或岭回归)来确定哪些实例应被视为结点。平滑样条方法(Yandell, 1993)采用了这种方法。此外,还有一大类称为广义可加模型(generalized additive model,GAM)的模型。它们扩展了广义线性模型(包括线性和逻辑回归),使其可以为单个预测子提供非线性项(并且不能对交互作用建模)。GAM 模型可以自适应地为不同变量建模单独的基函数,并估计每个函数的复杂度。换言之,不同的预测子可以用不同水平的复杂度来建模。此外,还有许多其他类型的有监督非线性平滑器可以使用。例如,loess 模型在预测子上拟合加权移动回归线,以估计数据中的非线性模式。关于 GAM 模型的更多技术信息,请参阅 Wood(2006)。
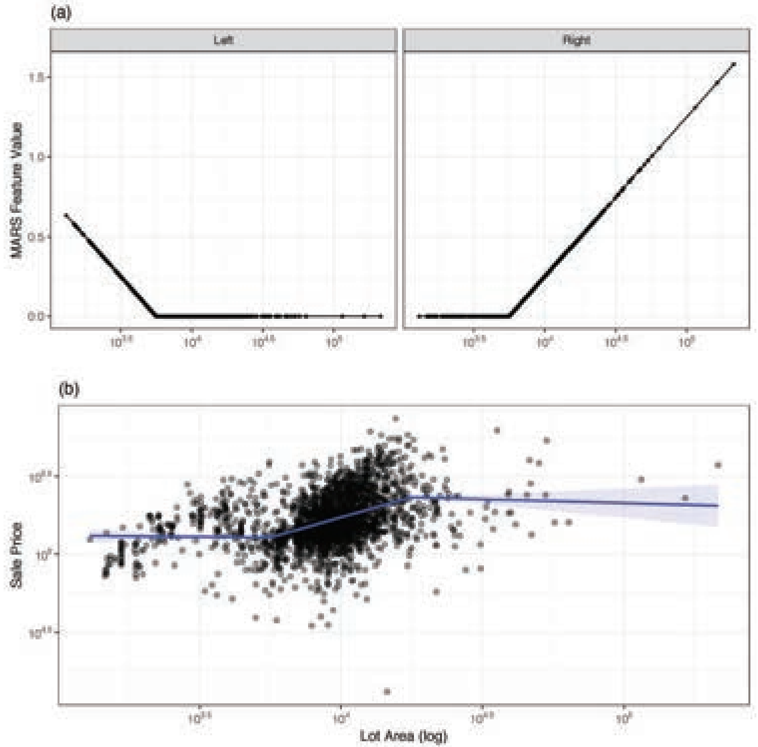
与样条和多元自适应回归样条(multivariate adaptive regression spline,MARS)模型(Friedman, 1991)相关的另一种特征构造方法是单一固定结点样条。该方法使用的铰链函数(hinge function)变换为
\[ h(x - c) = (x - c) \cdot I(x > c) \]其中 I 是一个指示函数(indicator function),当 x 大于 c 时取值为 1,否则为零。(译者注:原书该公式在 docling 提取中未解码,此处按文中描述重建,即当 x 大于结点值 c 时取 x − c,否则取零。)例如,如果地块面积的对数用 x 表示,\( h(x - 3.75) \) 会生成一个新特征,当对数地块面积小于 3.75 时为零,否则等于 \( x - 3.75 \)。相反的特征 \( h(3.75 - x) \) 在值高于 3.75 时为零。变换的效果如图 6.5(a) 所示,它展示了成对的铰链函数如何隔离预测子空间的某些区域。
这些特征可以被添加到模型中,以创建具有不同趋势的不同区段的分段回归模型(segmented regression model)。如前所述,图 6.4 中的地块面积数据在数据的中部区域呈现线性趋势,而在两个极端呈平坦趋势。假设将两组铰链函数添加到结点位于 3.75 和 4.25 的线性模型中。这将在低于 \( 10^{3.75} \) 的区域、介于 \( 10^{3.75} \) 和 \( 10^{4.25} \) 之间的区域以及高于 \( 10^{4.25} \) 的区域分别生成单独的线性趋势。当添加到线性回归时,最左侧区域的斜率将由两个结点的"左向"铰链函数驱动。中间区域将涉及与结点 \( 10^{3.75} \) 相关的两个项的斜率,以及与结点 \( 10^{4.25} \) 相关的左向铰链函数,依此类推。[56] 与该策略相关的模型拟合如图 6.5(b) 所示。
这种特征生成函数在神经网络和深度学习领域被称为修正线性单元(rectified linear unit,ReLU)激活函数(activation function)。Nair 和 Hinton(2010)总结了它们在这些领域的应用。
虽然基函数通过表示特征的非线性模式有助于构建更好的模型,但它们对于探索性数据分析(exploratory data analysis)也非常有效。诸如图 6.4(b) 和图 6.5 之类的可视化可用于告知建模者预测的可能函数形式(例如,对数线性、二次、分段等)。
6.2.2 作为最后手段的预测子离散化
分箱(binning),也称为分类化(categorization)或离散化(discretization),是将定量变量转换为两个或更多定性桶(即类别)的过程。例如,变量可以被转换为分位数(quantile);桶将表示数字是否落入数据的前 25%、介于 25% 和中位数之间,等等。在这种情况下,数据的分箱版本将有四个不同的值。
[56] 请注意,MARS 模型会自适应地顺序生成一组结点,并确定哪些结点应保留在模型中。
图 6.5:(a) 使用地块面积预测子的自然样条基函数创建的特征。蓝线对应结点。(b) 回归模型为每个特征估计模型系数后的拟合结果。
对数据施加这种变换有几个显而易见的原因:
- 有些人认为它简化了分析和/或结果的解释。假设一个人的年龄是一个预测子,并按某人是否超过 40 岁进行分箱。人们或许可以这样说:年轻人和老年人之间事件概率增加了 25%。这里不会讨论响应的每单位增加。
- 分箱可以避免必须指定预测子与结果之间关系的问题。一组箱可以被认为能够在不必可视化或思考底层模式的情况下建模更多模式。
- 使用预测子的定性版本可能会让人觉得它减少了数据中的变异。这一点将在下面详细讨论。
分箱数据的方法有很多。有些是无监督的,基于用户驱动的切点(cutoff)或估计的百分位数(例如中位数)。在其他情况下,切点的位置(和数量)被优化以提高性能。例如,如果需要单次分割,可以使用 ROC 曲线(第 3.2.2 节)来找到敏感度(sensitivity)和特异度(specificity)的适当权衡。
将连续数据变为分类数据存在许多问题。首先,底层趋势极不可能与新模型一致。其次,当存在真实趋势时,离散化数据很可能会使模型更难有效地工作,因为数据中的所有细微差别都被移除了。第三,对于特定的切点可能没有客观依据。第四,当结果与预测子之间没有关系时,“发现"错误趋势的概率会大幅增加。这一点已被广泛研究和验证。参见 Altman(1991)、Altman 等(1994)及其中的参考文献。
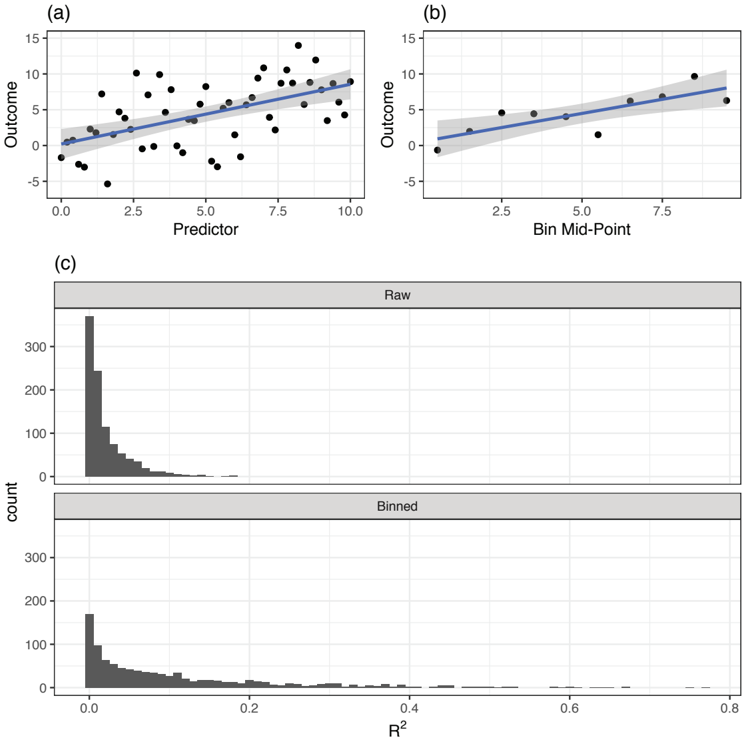
Kenny 和 Montanari(2013)出色地说明了这种情况是如何发生的,我们的示例遵循他们的研究。假设正在筛选一组变量,以找出哪些变量与数值结果有关系。图 6.6(a) 显示了一个模拟数据集的示例,其线性趋势系数为 1.0,误差服从标准差为 4.0 的正态分布。对这些数据(如图所示)进行线性回归会找到递增趋势,估计的 R² 为 30.3%。数据被切成 10 个等距的箱,并估计每个箱的平均结果。这些数据显示在 (b) 面板中,连同回归线。由于使用的是平均值,估计的 R² 要大得多(64.2%),因为模型认为数据更精确(而实际上并非如此)。
不幸的是,这种人为的变异减少会在预测子与结果无关时导致很高的假阳性率(false positive rate)。为了说明这一点,我们使用了相同的数据,但斜率为零(即预测子不携带信息)。这个模拟在有和没有分箱数据的情况下运行了很多次,图 6.6(c) 显示了各次模拟中估计的 R² 值的分布。对于原始数据,在 1000 个数据集中看到的最大 R² 值为 18.3%,尽管大多数数据小于 20%。当数据被离散化时,R² 值往往大得多(最大为 76.9%)。事实上,19% 的模拟有 \( R^2 \geq 20\% \)。
离散化过程有可能改善模型;“没有免费午餐"定理(No Free Lunch Theorem)否定了某种方法论永远不会起作用的想法。如果要使用分类策略,尤其是有监督的分类策略,我们建议:
图 6.6:原始数据 (a) 和分箱 (b) 的模拟数据。此外,预测子无信息的模拟结果 (c)。
- 该策略不应成为正常操作流程的一部分。对预测子进行分类应该是最后的手段。
- 箱的确定必须包含在重采样(resampling)过程之内。这将有助于诊断过程中是否引入了不存在的关系,并在使用有信息量的预测子时减轻性能的高估。此外,由于必须定义某种过程才能将其包含在重采样中,这将防止通常的"目测"数据来挑选切点的方法。我们发现,仅基于目视检查数据的分箱策略更容易过拟合。
6.3 多对多变换
当从多个预测子创建新特征时,有可能纠正各种问题,例如异常值或共线性(collinearity)。它还可以帮助降低预测子空间的维数,从而可能提高性能并减少模型的计算时间。
6.3.1 线性投影方法
当今的观测或可用数据集包含许多预测子,而且往往超过可用样本的数量。预测子通常是任何可能与响应有微弱关联的测量值。一种传统的思维是:包含的预测子越多,模型找到信号的机会就越大。但事实并非如此;包含无关的预测子可能对最终模型产生不利影响(见第 10 章)。负面影响包括:增加训练模型所需的计算时间、降低预测性能以及使预测子重要性(predictor importance)的计算复杂化。通过包含任何潜在的预测子,我们最终会得到一个次优模型。这将在第 10.3 节中说明。
处理现代数据的张力在于,我们往往并不完全知道哪些预测子与响应相关。事实上可能的情况是,一些可用的预测子(或它们的组合)与响应存在有意义的关联。在这些条件下,任务是尝试识别与响应相关的简单或复杂组合。
本节将介绍已被证明能有效识别原始预测子有意义的投影的投影方法(projection method)。这里讨论的具体技术是主成分分析(principal component analysis,PCA)、核 PCA(kernel PCA)、独立成分分析(independent component analysis,ICA)、非负矩阵分解(non-negative matrix factorization,NNMF)和偏最小二乘(partial least squares,PLS)。这个列表中的前四种技术是不了解响应的无监督技术。最后一种技术使用响应来指导降维过程,从而使降维后的预测子空间与响应最优关联。
这些方法在如下意义上是线性的:它们取数值预测子值的矩阵(X),并创建原始数据线性组合的新成分。这些成分通常被称为得分(score)。如果有 n 个训练集点和 p 个预测子,得分可以表示为 \( n \times p \) 矩阵 \( X^* \),并使用下式创建:
\[ X^* = X A \]其中 \( p \times p \) 矩阵 A 通常被称为投影矩阵(projection matrix)。因此,数据点 i 的第一个得分的值为:
\[ x_{i1}^* = a_{11} x_{i1} + a_{21} x_{i2} + \cdots + a_{p1} x_{ip} = \sum_{j=1}^{p} a_{j1} x_{ij} \]一种可能是只使用 A 的一部分,将得分的数量减少到 \( k < p \)。例如,A 的最后几列可能对描述预测子集没有好处。这种降维(dimension reduction)的概念不应与特征选择(feature selection)混淆。如果预测子空间可以用 k 个得分变量来描述,那么提供给模型的数据中的特征就更少,但这些列中的每一列都是所有原始预测子的函数。
上面提到的投影方法之间的差异[57] 在于投影值的确定方式。
如下文所示,每种无监督技术都有自己的目标:仅使用 A 的前 k 列,将原始预测子汇总或投影到大小为 k 的低维子空间中。通过压缩预测子信息,可以减少预测子的冗余,并可以在子空间内提取潜在信号(相对于噪声)。将信息压缩到预测子子空间的一个直接好处是减少训练模型所需的计算时间。但采用无监督技术并不能保证预测性能的改善。使用无监督投影方法时的主要潜在假设是,识别出的子空间能够预测响应。这可能是也可能不是真的,因为无监督技术的目标与响应完全无关。在模型训练结束时,我们可能会发现无监督技术是压缩原始预测子的便捷工具,但无助于有效提高预测性能。[58]
有监督技术 PLS 通过专注于寻找与响应直接相关的原始预测子子空间的目标,改进了无监督技术。通常,这种方法会找到更小、更有效的原始预测子子空间。使用有监督方法的缺点是,需要更大的数据集来预留用于测试和验证的样本,以避免过拟合。
6.3.1.1 主成分分析
主成分分析在第 4.2.7 节中作为探索性可视化技术被介绍过。我们现在将更详细地探讨 PCA,并研究如何以及何时可以有效地使用它来创建新特征。主成分分析最初是由 Karl Pearson 在一个多世纪前开发的,尽管年代久远,它仍然是使用最广泛的降维工具之一。关于这种方法的一个很好的参考文献是 Abdi 和 Williams(2010)。它在现代数据中的相关性源于该技术的基本目标。具体来说,PCA 的目标是找到原始预测子的线性组合,使得这些组合汇总原始预测子空间中的最大变异量。从统计学的角度来看,变异与信息同义。因此,通过找到捕获变异的原始预测子组合,我们找到了包含与预测子相关的信息的数据子空间。同时,新的 PCA 得分被要求彼此正交(即不相关)。正交性使得预测子空间的变异性能够以不重叠的方式整齐地划分。事实证明,所有主成分汇总的变异性恰好等于原始预测子之间的变异性。在实践中,计算出足够多的新得分变量,以解释原始预测子中预先指定的变异量(例如 95%)。
[57] 核 PCA 除外。
[58] 这种情况与上面描述的 Box-Cox 变换类似。
该技术的一个重要附带好处是,得到的 PCA 得分是不相关的。这个性质对需要预测子相对不相关的建模技术(例如多元线性回归、神经网络、支持向量机等)非常有用。这将在下面 ICA 的背景下再次讨论。
当可用数据由一个或多个包含冗余信息的预测子簇组成(例如彼此高度相关的预测子)时,PCA 是一个特别有用的工具。高度相关的预测子可以被认为存在于比原始数据更低维的空间中。举一个简单的例子,考虑图 6.7(a) 中的散点图,其中两个预测子线性相关。虽然这些数据是在二维中测量的,但只需要一个维度(一条线)就可以充分汇总样本的位置。也就是说,这些数据几乎可以等效地用这两个变量的组合来表示,如图 (b) 部分所示。图中的红点是原始数据在第一个主成分得分上的正交投影(想象对角线被旋转到水平位置)。新特征用一个数值表示原始数据,即从原点到投影值的距离。创建第一个 PCA 得分后,“剩余"信息由 (b) 面板中蓝线的长度表示。这些距离将是最终的得分(即第二个成分)。
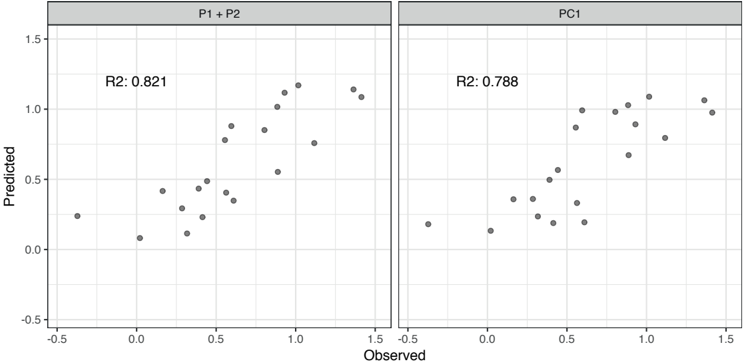
对于这个简单的例子,使用两个相关的预测子构建了一个线性回归模型。还在第一个主成分得分与响应之间构建了一个线性回归模型。图 6.8 提供了每个模型的观测值与预测值之间的关系。对于这个例子,这些模型之间的性能几乎没有差异。
主成分回归(principal component regression)描述了首先降维然后将新的成分得分回归到响应上的过程,是一个分步过程(Massy, 1965)。这个过程的两步是分离的,这意味着降维步骤与响应没有直接联系。因此,与数据变异性相关的主成分得分可能与响应相关,也可能不相关。
为了提供一个 PCA 的实际示例,让我们回到在第 4 章中首次探索的芝加哥客流量(ridership)数据。回想一下,许多车站之间的客流量高度相关(图 4.9)。在 125 个车站中,有 94 个车站与另一个车站的成对相关系数大于 0.9。这意味着,如果知道一个车站的客流量,就可以高精度地估计许多其他车站的客流量。换言之,关于客流量的信息更简单地包含在这些数据的低得多的维度中。
图 6.7:两个高度相关预测子的主成分分析。(a) 两个高度相关预测子的散点图,第一个主方向用虚线表示。(b) 原始数据在第一个主方向上的正交投影。新特征用红点表示。
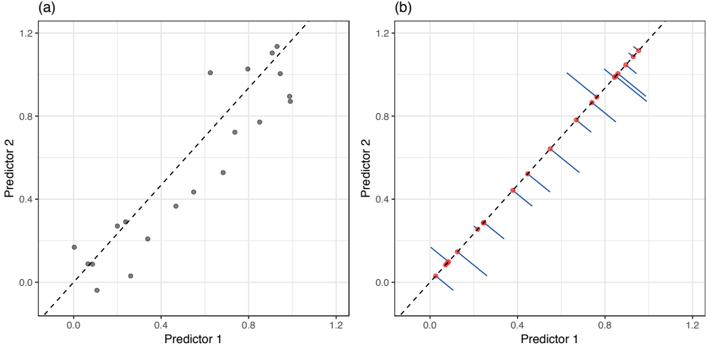
图 6.8:为汇总最大变异而选择的两个预测子的线性组合,本质上包含与两个原始预测子相同的信息。
芝加哥数据可以用来演示投影方法的工作原理。回想一下,数据的主要驱动力是周末与工作日客流量的差异。这两组数据之间的鸿沟完全主导了主成分分析,因为它解释了数据中的大部分变化。这里没有展示这一分析,而是分析了周末数据。[59] 训练数据中有 1628 天是周六或周日。仅使用 14 天滞后预测子,在列被中心化和缩放后对周末数据进行了 PCA。
图 6.9:Clark and Lake 车站周末客流量的几种线性投影方法的得分值。x 轴值是每种方法的得分,y 轴是客流量(以千计)。
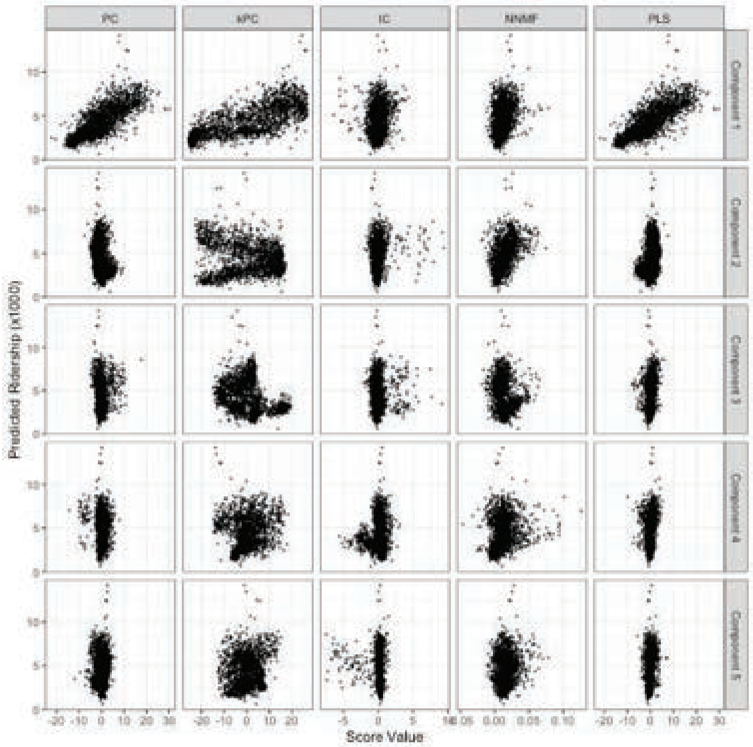
图 6.9 最左边的列显示了前五个成分及其与结果的关系。第一个成分解释了滞后预测子中 60.4% 的变异,与客流量呈强烈的线性关系。对于这个成分,投影矩阵 A 中对应此线性组合的所有系数都是正的,五个最有影响力的车站是 35th/Archer、Ashland、Austin、Oak Park 和 Western。[60] 对第一个成分而言五个最不重要的车站是 Central、O’Hare、Garfield、Linden 和 Washington/Wells。
[59] 我们不建议将其作为这些数据的现实分析策略,只是为了让说明更有效。
第二个成分只解释 5% 的变异性,与结果的相关系数较小。事实上,其余成分在滞后预测子中捕获的信息量越来越少。要覆盖原始信息的 95%,总共需要 36 个主成分。
PCA 可能有助于回答的一个重要问题是:“周末是否存在线路效应?“为了帮助回答这个问题,前五个成分使用热图(heatmap)在图 6.10 中可视化。在热图中,点的颜色代表 A 元素的符号和大小。行已根据使用五个成分的聚类程序重新排序。行标签显示对应车站的线路(或线路)。
第一列显示,每个车站对第一个成分的相对权重稳定为正且较小(与其他成分相比);在主要的底层信息源中不存在线路效应。其他成分似乎隔离了特定的线路(或线路内的子集)。例如,第二个成分主要由 Pink 线沿线的车站(深红色部分)、向西北方向延伸的 Blue 线的一段以及城市北部运行的 Green 线的一部分驱动。相反,第四个成分对相同的 Green 线车站有一个强烈的负聚类。总的来说,y 轴上的标签显示线路相当好地聚集在一起,这表明在去除第一个成分的影响后存在线路效应。
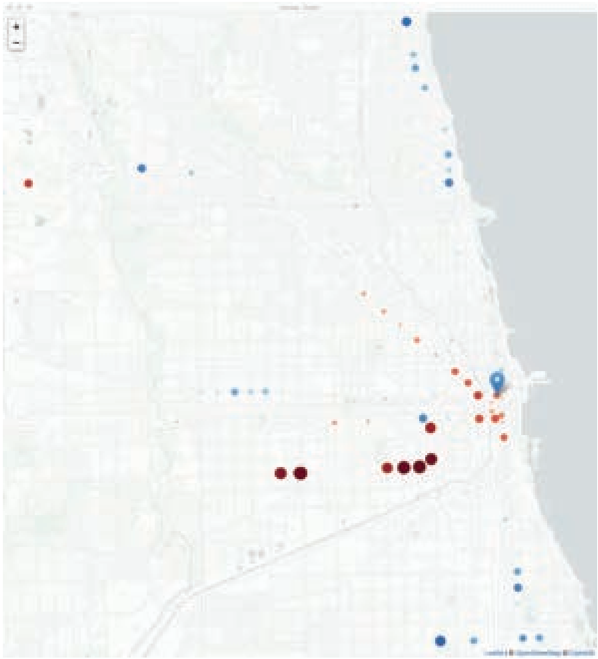
尽管第二个成分捕获的变异量很小,但我们将使用 A 中的这些系数来突出周末数据中的地理趋势。第二个 PCA 成分的旋转值既有正值也有负值。它们的符号和大小可以帮助我们了解哪些车站在驱动这个成分。如图 6.11 所示,沿 Red 和 Purple 线[61] 沿海岸正北方向行驶的车站对第二个成分有实质性的正效应。Pink 线沿线的西南车站有较大的负效应(如较大的红色标记所示),O’Hare 车站(最西北端)也是如此。此外,许多聚集在 Clark and Lake 附近的车站对第二个成分有较小或适度的负效应。有趣的是,两个彼此非常接近的车站,Illinois Medical District 和 Polk,对这个成分有显著的影响,但符号相反。这两个车站在不同的线路上(分别是 Blue 和 Pink),这可能再次表明,一旦数据中的主要信息(即第一个成分)被移除,数据中就存在线路效应。
[60] 在这些情况下,“有影响力"意味着系数最大。
[61] 车站线路请回顾图 4.1。

图 6.10:前五个主成分系数的热图。行使用所有五个成分进行聚类。
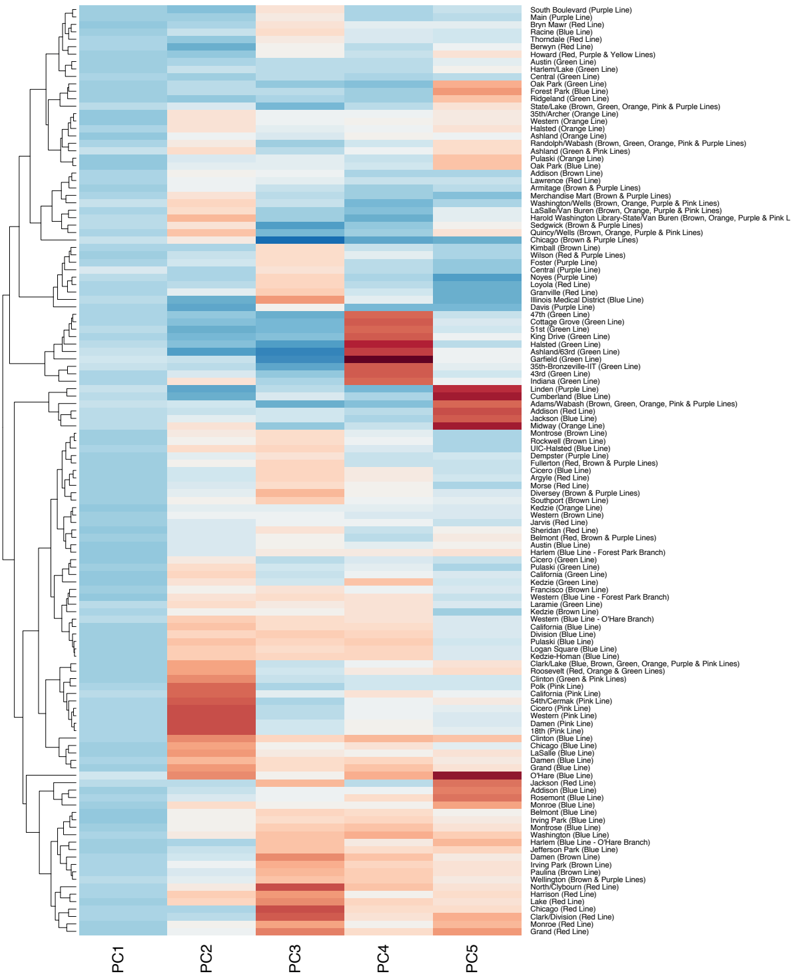
图 6.11:第二个主成分的系数。大小是系数的相对大小,红色表示负值,蓝色表示正值,白色表示接近零的值。
可视化 PCA 结果的方法有很多。通常将前几个得分相互作图,以寻找类别之间的分离、异常值或其他有趣的模式。另一种可视化是双标图(biplot)(Greenacre, 2010),这是一种信息丰富的图形,将得分与 A 的系数叠加在一起。在我们的数据中,PCA 分析涉及 126 个高度相关的车站,在这种情况下,双标图并不是特别有效。
最后,重要的是要注意,由于每个 PCA 成分捕获的变异性越来越少,得分的尺度通常会变得越来越小。因此,重要的是在考虑得分中所有数据的共同轴尺度(即尽可能大的范围)上绘制成分得分。这样,捕获数据中很小百分比信息的成分中的小模式就不会被过度解读。
6.3.1.2 核主成分分析
当预测子线性相关且所得得分与响应相关时,主成分分析是一种有效的降维技术。然而,预测子空间的正交划分可能无法提供与响应的良好预测关系,尤其是在预测子与响应之间真实的底层关系是非线性的情况下。例如,考虑响应(y)与两个预测子(\( x_1 \) 和 \( x_2 \))之间的假设关系如下:
\[ y = \beta_0 + \beta_1 x_1^2 + \beta_2 x_2^2 + \epsilon \](译者注:原书该公式在 docling 提取中未解码,此处按文中描述——响应依赖于预测子的二次关系——重建。)
在这个方程中,ε 表示随机噪声。还假设 \( x_1 \) 和 \( x_2 \) 之间的相关性很强,如图 6.7 所示。将传统 PCA 应用于这个示例会将 \( x_1 \) 和 \( x_2 \) 之间的关系汇总为一个主成分。然而,这种方法会忽略对预测响应至关重要的重要二次关系。在这个双预测子示例中,对预测子以及预测子与响应之间关系的简单可视化探索会让我们理解,预测与响应的关系需要预测子的二次版本。但随着数据维度的增加,可视化探索重要高阶项的能力会下降。因此,当数据应该增加额外特征时,传统 PCA 将是一种效果差得多的降维技术。
如果我们知道需要一个或多个二次项来解释响应,那么可以将这些项添加到预测子中,以便在建模过程中进行评估。另一种方法是使用本章前面描述的非线性基展开。第三种可能的方法是核 PCA(kernel PCA)(Schölkopf 等, 1998; Shawe-Taylor 和 Cristianini, 2004)。核 PCA 方法将 PCA 的一种特定数学观点与核函数(kernel function)和核"技巧”(kernel trick)相结合,使 PCA 能够扩展执行降维的预测子空间的维度(这与基展开不无相似之处)。为了更好地理解核 PCA 在做什么,我们首先需要认识到,PCA 提出的方差汇总问题可以通过找到预测子协方差矩阵(covariance matrix)的特征值和特征向量来解决。事实证明,协方差矩阵的特征分解形式可以等价地用样本的内积(inner product)来书写。这被称为问题的"对偶”(dual)表示。内积被称为线性核(linear kernel);\( x_1 \) 和 \( x_2 \) 之间的线性核表示为:
\[ K(x_1, x_2) = \langle x_1, x_2 \rangle = x_1^T x_2 \]对于一组 \( i = 1 \ldots n \) 个样本和两个预测子,这对应于
\[ K_{ij} = \langle x_i, x_j \rangle = x_i^T x_j, \quad i, j = 1, \ldots, n \]然后,核 PCA 使用核替换技巧将线性核替换为任何其他有效的核。关于构造有效核的核属性的简明列表,请参阅 Bishop(2011)。除了线性核,基本多项式核有一个参数 d,定义如下:
\[ K(x_1, x_2) = (\langle x_1, x_2 \rangle + 1)^d \]同样,对于两个预测子和 d = 2:
\[ K(x_1, x_2) = (\langle x_1, x_2 \rangle + 1)^2 \]使用多项式核,我们可以直接将线性组合展开为 d 次多项式(类似于第 6.2.1 节中对基函数所做的操作)。
径向基函数(radial basis function,RBF)核有一个参数 σ,定义如下:
\[ K(x_1, x_2) = \exp\left(-\frac{\|x_1 - x_2\|^2}{2\sigma^2}\right) \]由于数学形式及其与正态分布的关系,RBF 核也被称为高斯核(Gaussian kernel)。径向基核和多项式核是核 PCA 的流行起点。
利用这种观点,核方法可以将数据的原始维度扩展到高维,这些高维包含原始预测子的潜在有益表示。更棒的是,核技巧绕过了在 X 矩阵中创建这些项(就像基展开那样)的麻烦。只需使用核函数并直接求解优化问题,就可以探索更高维空间。
为了说明核 PCA 的效用,我们将基于本节前面的模型模拟数据。对于这个模拟,生成了 200 个样本,其中 150 个被选入训练集。PCA 和核 PCA 将分别用作降维技术,随后进行线性回归,以比较这些方法的表现。图 6.12(a) 显示了训练数据中 \( x_1 \) 和 \( x_2 \) 之间的关系。散点图显示了这两个预测子之间的线性关系。(b) 面板揭示了 \( x_1 \) 与 y 之间的二次关系,如果预测子数量很少,这种关系很容易被发现并纳入模型。PCA 找到了一个维度来汇总 \( x_1 \) 和 \( x_2 \),主成分与响应之间的关系如图 6.12(c) 所示。在实践中,我们通常使用汇总达到阈值变异量的成分数量作为预测子。如果我们盲目地运行主成分回归,PC₁ 和 y 之间的拟合会很差,因为这些数据更适合用二次拟合来描述。使用 2 次多项式核的响应与第一个成分之间的关系如 (d) 面板所示。使用该核展开残差空间使 PCA 能够更好地找到预测子之间的底层结构。显然,这种结构与响应的预测关系比线性方法更强。(e) 面板显示了测试集上的模型性能,其中核 PCA 模型的残差分布明显小于 PCA 模型的残差分布。
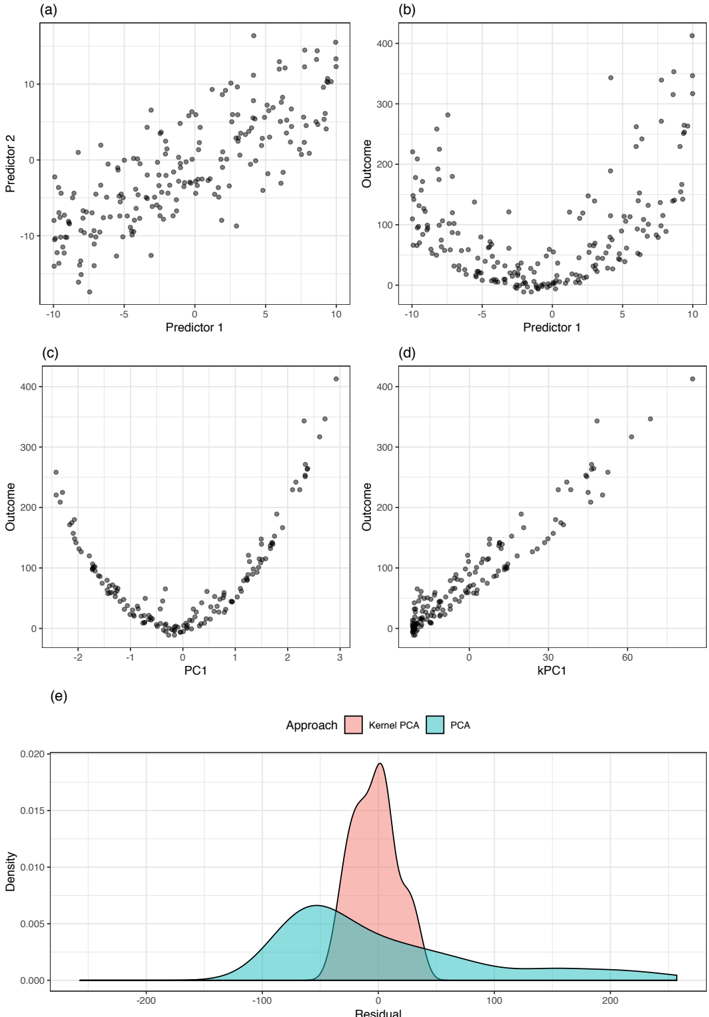
图 6.12:PCA 和核 PCA 的比较。(a) 训练集数据。(b) \( x_1 \) 与结果之间的模拟关系。(c) PCA 结果。(d) 使用多项式核的 kPCA 显示出更好的结果。(e) 两种降维方法的残差分布。
对于芝加哥数据,使用径向基函数核来获得新的 PCA 成分。核的唯一参数(σ)使用 Caputo 等(2002)的方法解析估计;0.002 到 0.022 之间的值似乎合理,使用接近该范围中间的值(0.006)来计算成分。进行了敏感性分析,以评估该范围内的其他选择是否会导致明显不同的结果——结果并非如此。图 6.9 中左起第二列显示了结果。与普通 PCA 类似,第一个 kPCA 成分与客流量有很强的关联。然而,基于核的成分在 x 轴上具有更大的动态范围。图中显示的其他成分与常规 PCA 有些不同。虽然这些得分(单独地)与结果的关联较小,但非常有可能的是,当得分同时输入回归模型时,它们具有预测效用。
6.3.1.3 独立成分分析
PCA 寻求解释数据中的变异,并产生彼此数学上正交的成分。因此,这些成分是不相关的。然而,由于相关性是衡量两个变量之间线性独立性的指标,它们可能彼此并非统计独立(即协方差为零)。有许多玩具示例展示不相关变量的散点图,其中变量之间存在清晰的关系。一个例外是当底层值遵循高斯分布时。在这种情况下,不相关的数据在统计上也是独立的。[62]
独立成分分析(ICA)在许多方面与 PCA 相似(Lee, 1998)。它创建原始变量线性组合的新成分,但方式上是使成分彼此尽可能统计独立。这使 ICA 能够比 PCA 建模更广泛的趋势,PCA 侧重于正交性和线性关系。ICA 有多种满足统计独立性约束的方法,其目标通常是最大化所得成分的"非高斯性”(non-Gaussianity)。衡量非高斯性有不同的方法,fastICA 方法使用一种称为负熵(negentropy)的信息论方法来做到这一点(Hyvarinen 和 Oja, 2000)。在实践中,除非预测子表现出显著的多元正态性或严格的线性趋势,否则 ICA 应该创建与 PCA 不同的成分。此外,与 PCA 不同,成分没有唯一的排序。
[62] 这并不意味着 PCA 产生的成分服从高斯分布。
在运行 ICA 计算之前,通常对数据进行归一化和白化(whitening)。在这种情况下,白化意味着将原始值转换为完整的 PCA 成分集。这看起来可能违反直觉,但这种预处理不会对 ICA 的目标产生负面影响,并大幅降低计算复杂度(Roberts 和 Everson, 2001)。此外,ICA 计算通常使用随机参数值初始化,最终结果可能对这些值敏感。为了获得可重现的结果,手动初始化这些值会很有帮助,这样可以在以后的某个时间重新生成相同的结果。
ICA 被应用于芝加哥数据。在估计成分之前,对预测子进行了缩放,以便 ICA 之前的白化步骤使用中心化后的数据来计算初始 PCA 数据。当不应用缩放时,ICA 成分被不同的单个车站强烈驱动。ICA 成分显示在图 6.9 的第三列,看起来与其他方法非常不同。第一个成分与结果的关系很小,包含一组离群值。在这个成分中,大多数车站对得分的贡献很小或没有贡献。许多有影响的车站靠近 Clark and Lake。虽然有 42 个车站对该成分产生负面影响(最强的是 Chicago、State/Lake 和 Grand),但大多数具有正系数(如 Clark/Division、Irving Park 和 Western)。对于这个成分,其他重要的车站沿 Brown 线(向北)以及 Rosemont 车站(就在 O’Hare 机场之前)。图 6.9 中显示的其他 ICA 成分与结果的关系非常弱。对于这些数据,寻找数据合适旋转的 PCA 方法在定位预测关系方面更好。
6.3.1.4 非负矩阵分解
非负矩阵分解(Gillis, 2017; Fogel 等, 2013)是另一种线性投影方法,专门针对大于或等于零的特征。在这种情况下,算法找到 A 的系数,使它们的值也为非负(从而确保新特征具有相同的性质)。这种方法在文本数据(其中预测子是词频)、图像和生物测量(例如特定基因表达的 RNA 量)中很流行。这种技术也可以用于芝加哥数据。[63]
确定系数的方法在概念上很简单:在非负性的约束下,找到使得分尽可能"接近"原始数据的最佳系数集。接近度可以使用均方误差(mean squared error,跨预测子聚合)或其他度量(如 Kullback-Leibler 散度(Kullback-Leibler divergence))(Cover 和 Thomas, 2012)来衡量。后者是一种衡量两个概率分布之间距离的信息论方法。与 ICA 一样,数值求解器使用随机数初始化,最终解可能对这些值敏感,并且成分的顺序是任意的。
[63] NNMF 可以应用于对数变换后的客流量值,因为这些值都大于或等于零。
图 6.13:NNMF 成分 11 的系数。大小和颜色反映系数的相对大小。
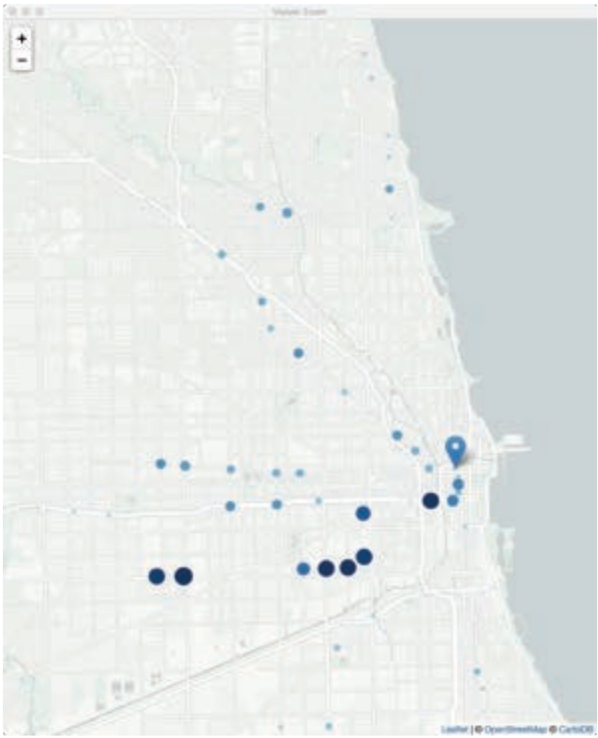
图 6.9 中显示的前五个非负矩阵分解成分与 Clark and Lake 车站的客流量有适度的关系。在估计的 20 个 NNMF 成分中,第 11 号成分与客流量的关联最大。该成分的系数如图 6.13 所示。该成分受到 Pink 线(例如 54th/Cermak、Damen)、Blue 线和 Green 线沿线车站的强烈影响。O’Hare 机场的系数也做出了很大贡献。
6.3.1.5 偏最小二乘
到目前为止讨论的技术都是无监督的,这意味着降维的目标完全基于预测子。相比之下,有监督降维技术使用响应来指导预测子的降维,从而使新预测子与响应最优相关。偏最小二乘(PLS)是 PCA 的有监督版本,它以与响应最优相关的方式降维(Stone 和 Brooks, 1990)。具体来说,PLS 的目标是找到与响应具有最优协方差的预测子的线性函数(称为潜变量(latent variable))。这意味着响应指导降维,使得分在训练数据中与响应具有尽可能高的相关性。优化问题的典型实现要求每个新维度中的数据不相关,这与 PCA 优化问题中施加的约束类似。由于 PLS 是一种有监督技术,我们发现需要更多的 PCA 成分才能达到 PLS 模型产生的相同性能水平(Kuhn 和 Johnson, 2013)。因此,PLS 可以更有效地降维,从而在模型构建过程中节省内存和计算时间。然而,由于 PLS 使用响应来确定潜变量的最佳数量,必须使用严格的验证方法来确保该方法不过拟合数据。
图 6.9 中显示了芝加哥周末数据的 PLS 成分。第一个成分与第一个 PCA 成分基本相同。回想一下,PLS 试图在预测子的降维与最大化成分和结果之间的相关性之间取得平衡。在这种特定情况下,如图所示,PCA 成分与客流量有很强的线性关系。实际上,PLS 的两个目标由无监督成分完成了。对于图 6.9 中显示的其他成分,第二个成分也非常类似于相应的 PCA 版本(符号除外),但其他两个成分不同,并且与客流量的关联略好。
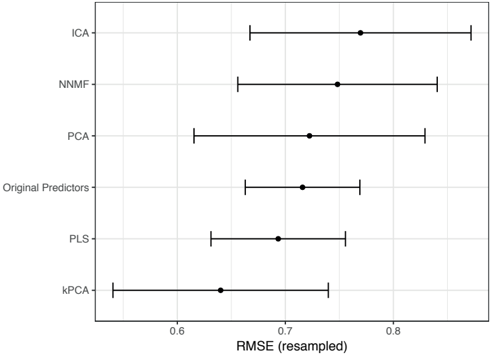
为了量化每种方法在估计结果与滞后预测子之间关系方面的表现,使用每种方法拟合了线性模型。在每种情况下,计算了 20 个成分并输入到简单线性回归模型中。为了重采样,使用了类似的基于时间的方案:800 个周末作为初始分析集,两组周末用作评估集(在下一轮迭代中会添加到分析集中)。这样得到了 25 次重采样。在每个重采样中,投影方法每次都重新计算,这种重复应该捕获这些计算可能产生的不确定性。如果我们预先计算整个训练周末集的成分,然后重采样,结果很可能是虚假乐观的。图 6.14 显示了每种方法在重采样上的 RMSE 值的置信区间。虽然置信区间重叠,但有一些迹象表明 PLS 和核 PCA 有可能优于原始值。对于其他对预测子间相关性非常敏感的模型(例如神经网络),当这些变换方法产生不相关的特征时,它们可以提供实质性的性能提升。
图 6.14:使用不同降维方法(每种 20 个成分)的芝加哥周末数据的模型结果。
6.3.2 自编码器
自编码器(autoencoder)是计算上复杂的多元方法,用于寻找预测子数据的表示,通常用于深度学习(deep learning)模型(Goodfellow 等, 2016)。其思想是创建原始预测子数据与一组人工特征(通常大小相同)之间的非线性映射。这些新特征(可能没有任何合理的解释)然后被用作模型预测子。虽然这听起来与之前的投影方法非常相似,但自编码器在新特征的推导方式以及潜在收益方面非常不同。
使用自编码器的一种情况是当有大量未标记数据(即结果尚不知道)时。例如,制药公司可以访问数百万种化合物,但这些数据中只有很小一部分具有新药发现项目所需的相关结果数据。化学中一项常见的任务是创建模型,利用化合物的化学结构来预测它可能成为多好的药物。可以为化学数据库的绝大多数数据计算预测子,这些数据尽管缺乏实验室结果,仍可用于改进模型。
例如,假设建模者打算拟合一个简单的线性回归模型。众所周知的 least squares 模型将预测子数据放在矩阵 X 中,结果放在向量 y 中。为了估计回归系数,公式是
\[ \hat{\beta} = (X^T X)^{-1} X^T y \]请注意,结果数据只用于该方程的右侧部分(例如 \( X^T y \))。未标记的数据可以用来产生左侧逆项的非常好的估计,并将其保存。当结果数据可用时,可以用相对少量的标记数据计算 \( X^T y \)。当 \( (X^T X)^{-1} \) 是在大数据集上创建时,上述方程仍然可以用来产生更好的参数估计。
同样的理念可以用于自编码器。所有可用的预测子数据都可以用来创建一个估计(并可能平滑)预测子之间关系的方程。基于这些模式,较小的预测子数据集可以通过使用其"预测"特征值来更有效地表示。
创建自编码器的方法有很多。最(相对)直接的方法是使用神经网络结构:
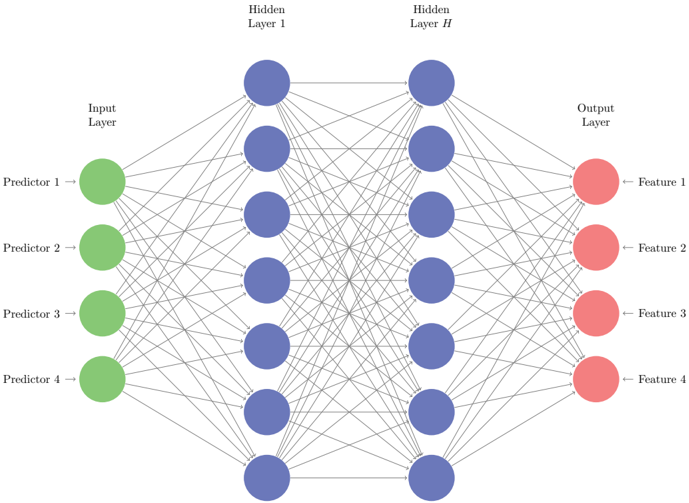
在这个架构中,从输入到隐藏单元以及隐藏单元之间的函数是非线性函数。常用的函数是简单的 sigmoid 函数以及 ReLU 函数。[64] 到输出特征的连接通常是线性的。一种策略是在隐藏单元中使用相对较少的节点,以迫使自编码器学习预测子中的关键模式。也可能多层且每层多个节点最能代表预测子值。
网络图中的每条线代表一个要估计的参数,这个数量可能变得过大。然而,有一些成功的方法,如正则化(regularization)和 dropout 方法,来控制过拟合,以及许多相当高效的深度学习库可以减轻计算负担。因此,这种方法的好处出现在有大量数据的时候。
[64] 这有助于防止模型从数据中学习简单的恒等函数(那样不会提供任何真正的价值)。
拟合神经网络和深度学习模型的细节超出了本书的范围。技术细节的优秀参考是 Bishop(2011)和 Goodfellow 等(2016),而 Chollet 和 Allaire(2018)是拟合这类模型的优秀指南。[65] 创建有效的自编码器需要模型调参和预测模型中常用的许多其他任务。为了衡量性能,通常使用观测值与预测(预测子)值之间的均方根误差(root mean squared error,RMSE),跨变量聚合。
如何将自编码器纳入建模过程?通常将自编码器模型估计的关系视为"已知"值,在重采样期间不再重新估计。事实上,在图像和文本数据的深度学习中,在新项目中使用预训练网络相当常见。这些预训练的区段或网络块可以用作网络的前端。如果有非常大量的数据进入这个模型,并且模型拟合过程收敛,这种方法可能具有一定的统计有效性。
例如,我们使用了 Karthikeyan 等(2005)的数据,他们利用化学描述符(chemical descriptor)对化合物的熔点(即从固态到液态的转变)进行建模。他们汇集了 4401 种化合物和 202 个数值预测子。为了模拟一个刚刚启动的药物发现项目,随机选择 50 个数据点作为训练集,另外随机选择 25 个分配给测试集。其余 4327 个数据点被视为没有熔点数据的未标记数据。
对未标记的预测子进行了处理:首先消除 126 个预测子,使得不存在高于 0.75 的成对相关性。此外,使用 Yeo-Johnson 变换来改变其余 76 个预测子的尺度(使它们不那么偏态)。最后,所有预测子都被中心化和缩放。相同的预处理应用于训练集和测试集。
使用具有两个隐藏层(每层 512 个单元)的自编码器对预测子进行建模。使用双曲正切(hyperbolic tangent)激活函数在原始单元和第一组隐藏单元之间以及两个隐藏层之间进行转换,线性函数连接第二组隐藏单元和 76 个输出特征。模型参数总数为 341,068。在训练模型时,使用未标记数据的随机 20% 验证集上的 RMSE 来衡量性能。模型训练了 500 次迭代,图 6.15(a) 显示 RMSE 在前 50 次迭代中急剧下降,在 100 次迭代左右最小化,然后在剩余迭代中缓慢增加。基于第 100 次迭代系数的自编码器模型被应用于训练集和测试集。
[65] 下面示例的代码可以在本书的 GitHub 仓库中找到。
图 6.15:对药物发现数据集拟合自编码器的结果。(a) 面板是用于衡量拟合过程 MSE 的留出数据,(b) 是应用(黑色)和未应用(灰色)自编码器的 K 近邻的重采样曲线。
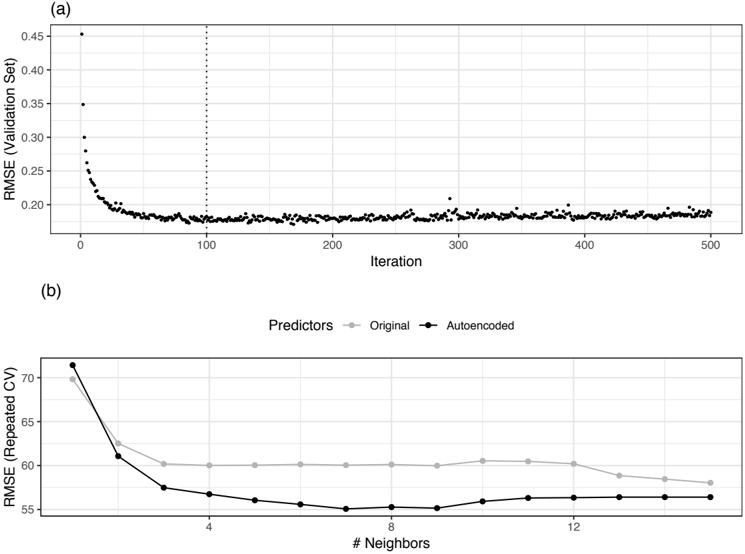
对原始和编码版本的训练集拟合了一个 K 近邻模型。测试了 1 到 20 之间的邻居数量,并使用五次重复的 10 折交叉验证(cross-validation)测量的 RMSE 结果选择了最佳模型。重采样曲线如图 6.15(b) 所示。编码数据的最佳设置(7 个邻居,估计 RMSE 为 55.1)与原始数据的最佳设置(15 个邻居,RMSE = 58)相差 3 度,95% 置信区间为(0.7, 5.3)度。虽然这是一个适度的改进,但对于药物发现项目来说,如果模型能够更好地预测新化合物的有效性,这样的改进可能会产生实质性的影响。
测试集由两个 KNN 模型进行预测。与原始训练集预测子相关的模型表现非常差,产生的 RMSE 为 60.4 度。这可能是由于训练集和测试集化合物的选择或其他原因。使用编码值的 KNN 模型产生的结果与重采样结果一致,RMSE 值为 51。使用不同的随机数种子重复整个过程,以验证结果不是严格偶然产生的。
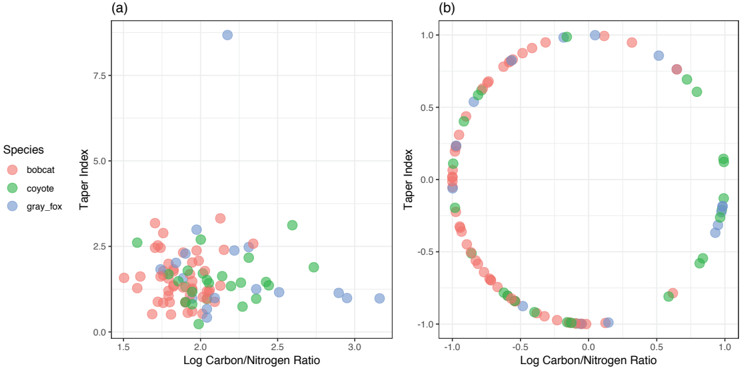
图 6.16:空间符号(spatial sign)变换前 (a) 和后 (b) 的分类数据集的散点图。
6.3.3 空间符号
空间符号变换取一组预测子变量,并以使新值到分布中心的距离相同的方式对它们进行变换(Serneels 等, 2006)。本质上,数据使用以下公式投影到多维球面上:
\[ \text{sgn}(\mathbf{x}_i) = \frac{\mathbf{x}_i}{\|\mathbf{x}_i\|} \]这种方法也被称为全局对比度归一化(global contrast normalization),通常与图像分析一起使用。
该变换需要计算数据的范数,因此,预测子应该在空间符号之前进行中心化和缩放。此外,如果任何预测子具有高度偏态的分布,它们可能受益于诱导对称性的变换,例如 Yeo-Johnson 技术。
例如,图 6.16(a) 显示了 Reid(2015)的数据,其中动物粪便(scat,即排泄物)的特征被用来预测提供样本的动物的真实物种。该图在两个轴上显示两个预测子,样本按真实物种着色。锥度指数(taper index)在 y 轴上显示一个显著的异常值。当变换应用于这两个预测子时,6.16(b) 中的新值显示所有数据到中心(零)的距离相等。虽然变换后的数据可能看起来不便于在新模型中使用,但这种变换在减轻极端异常值的损害方面非常有效。
6.3.4 距离与深度特征
在分类中,从数据中构造半监督特征可能是有益的。在这个上下文中,这意味着结果类别被用于创建新预测子,但不是在特征针对预测准确性进行优化的意义上。例如,从训练集中,可以为每个类别计算预测子的均值(通常称为类别质心(class centroid))。对于新数据,可以计算到每个类别的类别质心的距离,这些距离可以用作特征。这基本上将准最近邻技术嵌入到使用这些特征的模型中。例如,图 6.17(a) 使用对数碳氮比(carbon-nitrogen ratio)和 \( \delta^{13}C \) 特征显示了粪便数据的类别质心。基于这些多维平均值,可以很容易地计算新样本到每个类别中心的距离。如果新样本更接近某个特定类别,其距离应该很小。图 6.17(a) 显示了这种方法的一个示例,其中新样本(用 * 表示)相对靠近山猫(bobcat)和郊狼(coyote)中心。可以在适当的地方使用不同的距离度量。要在模型中使用这种方法,将为每个类别创建新特征,衡量每个样本到相应质心的距离。
图 6.17:类别到质心的距离 (a) 和深度计算 (b) 的示例。星号表示正在被预测的新样本,方块对应类别质心。
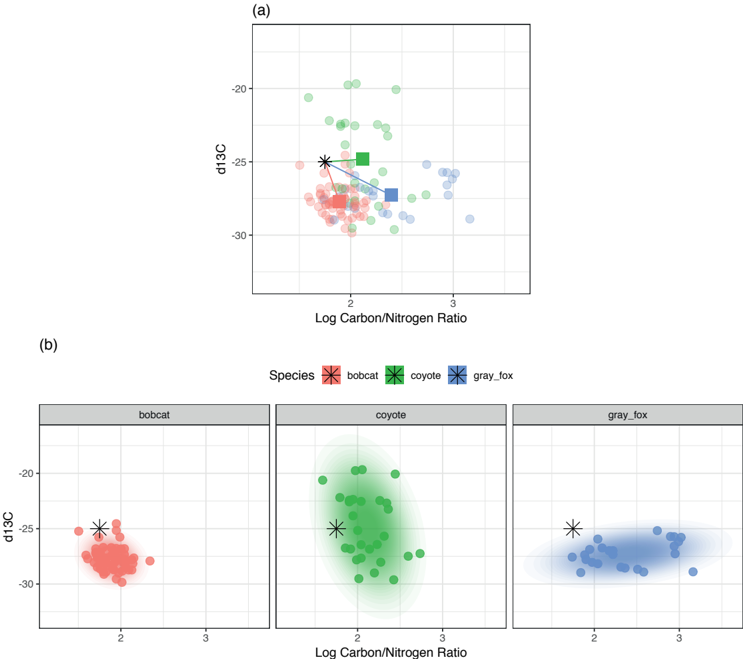
或者,可以使用数据深度(data depth)的思想(Ghosh 和 Chaudhuri, 2005; Mozharovskyi 等, 2015)。数据深度衡量一个数据点距离其分布中心有多近。计算深度的方法有很多,类别距离和数据深度之间通常存在反比关系(例如,大的深度值更表明接近类别质心)。如果我们假设前面展示的数据服从二元正态分布(bivariate normal),就可以在每个类别内计算概率分布。估计的高斯概率如图 6.17(b) 中的阴影所示。
在这种情况下,使用概率分布测量深度比 (a) 面板中显示的简单欧氏距离提供略高的灵敏度。在这种情况下,被预测的新样本比任何其他物种都更多地位于郊狼的概率区域内。
可以使用的深度度量有很多,许多不需要对预测子的分布做出特定假设,并且可能对异常值稳健。与距离特征类似,可以计算类别特定的深度并添加到模型中。
这类特征可以增强某些模型预测结果的能力。例如,如果真实的类别边界是一条对角线,大多数分类树将难以模拟这种模式。在这些情况下,用距离或深度特征补充预测子集可以使这类模型发挥作用。
6.4 小结
数值特征以其原始形式可能存在也可能不存在有效形式,让模型能够找到与响应的良好关系。例如,预测子可能被测量了,但与响应真正相关的是它的平方版本。直接的变换,如中心化、缩放或将分布变换为对称,是某些模型识别预测信号所必需的步骤。其他变换,如基展开和样条,可以将预测子从原始尺度转换到可能有信息量的非线性尺度。
但扩展预测子空间是有计算成本的。探索预测子与响应之间非线性关系的另一种方式是通过核函数与 PCA 的组合。这种方法计算效率非常高,可以探索更大的维度空间。
与其扩展预测子空间,可能有必要降低预测子的维度。这可以使用无监督技术(如 PCA、ICA、NNMF)或有监督方法(如 PLS)来完成。
最后,自编码器、空间符号变换或距离和深度度量提供了新颖的工程化方法,可以利用未标记数据中的信息或削弱极端样本的影响。
6.5 计算
网站 http://bit.ly/fes-num 包含用于重现这些分析的 R 程序。
脚注
[53] 对于数据的开头和结尾有各种处理方法,例如保持数据原样。
[54] 两个变量都高度右偏,因此对两个轴都应用了对数变换。
[55] 这些方法还确保函数在一定阶数内的导数也是连续的。这是通常使用三次函数的原因之一。
[56] 请注意,MARS 模型自适应地顺序生成一组结点,并确定哪些结点应保留在模型中。
[57] 核 PCA 除外。
[58] 这种情况与上面描述的 Box-Cox 变换类似。
[59] 我们不建议将其作为这些数据的现实分析策略,只是为了让说明更有效。
[60] 在这些情况下,“有影响力"意味着系数最大。
[61] 车站线路请回顾图 4.1。
[62] 这并不意味着 PCA 产生的成分服从高斯分布。
[63] NNMF 可以应用于对数变换后的客流量值,因为这些值都大于或等于零。
[64] 这有助于防止模型从数据中学习简单的恒等函数(那样不会提供任何真正的价值)。
[65] 下面示例的代码可以在本书的 GitHub 仓库中找到。