类别预测子的编码
类别预测子(categorical predictor)或名义预测子(nominal predictor)是指包含定性数据(qualitative data)的预测子。对于 OkCupid 数据,示例包括教育程度(如高中、两年制大学、大学等)和饮食习惯(如不忌口、纯素、素食等)。在 Ames 数据中,房屋类型和社区都是没有数值尺度的预测子。然而,尽管邮编(ZIP Code)是数值型的,它同样符合定性预测子的条件,因为这些数值没有连续的意义。简而言之,没有任何理由认为邮编 21212 比邮编 06385 “多” 14,827。
类别预测子也可以从非结构化(unstructured)或开放式文本中派生。OkCupid 数据包含一组可选的短文,描述了个人的兴趣爱好和其他个人信息。依赖数值输入的预测模型无法直接处理开放式文本字段。相反,这些信息丰富的数据需要在呈现给模型之前进行预处理。文本信息可以通过不同方式处理。例如,如果从文本中提取关键词用作预测子,应该包含单个单词还是单词串?是否应该对单词进行词干提取(stemming)以使用词根(例如,用 ‘comput’ 作为 ‘computer’、‘computers’、‘computing’、‘computed’ 等的缩写),还是应该使用正则表达式模式匹配方法(例如,^comput)?
简单的类别变量还可以分为有序(ordered)和无序(unordered)两类。取值 ‘Bad’、‘Good’ 和 ‘Better’ 的变量显示出明显的取值递进。虽然这些类别之间的差异可能无法精确地用数值量化,但存在有意义的排序。相比之下,考虑另一个取值为 ‘French’、‘Indian’ 或 ‘Peruvian’ 的变量。这些类别没有有意义的排序。有序和无序因子(factor)可能需要不同的方法来将其中蕴含的信息纳入模型。
与其他预处理步骤一样,纳入预测子的方法取决于模型类型。绝大多数模型要求所有预测子都是数值型的。但也有例外。基于树的模型(tree-based model)算法可以自然地处理数值或类别预测子的分裂。这些算法采用一系列 if/then 语句,将数据依次分割成组。例如,在芝加哥数据中,星期几是一个很强的预测子,基于树的模型可能会包含这样的模型组件:
if day in {Sun, Sat} then ridership = 4.4K else ridership = 17.3K
再举一个例子,朴素贝叶斯(naive Bayes)模型(第 12.1 节)可以创建类别预测子与结果类别之间的交叉制表,该频率分布被纳入模型的概率计算中。在这种情况下,类别可以以其自然格式进行处理。本章最后一节将研究类别预测子如何与基于树的模型相互作用。
基于树的模型和朴素贝叶斯模型是例外;大多数模型要求预测子采用数值形式。本章主要关注将类别数据编码为数值的方法。
本章中的许多分析使用第 3.1 节介绍并在上一章讨论过的 OkCupid 数据。在本章中,我们将更详细地探讨特定变量。这样做的一个问题是与过拟合(overfitting)有关。与本书讨论的其他数据集相比,OkCupid 数据集包含大量潜在的类别预测子,其中许多发生率较低。如果取整个训练集,检查特定趋势和变量,然后基于这些分析向模型添加特征,那将是有问题的。尽管我们会对这些数据上的模型进行交叉验证,但仍可能过拟合,找到无法推广到其他数据的预测关系。该数据集并不小;训练集包含 38,809 个数据点。然而,对于这里的分析,从训练集中选择了 5,000 个 STEM 个人资料和 5,000 个非 STEM 个人资料的子样本,目的是为模型发现新的预测子(与第 3.8 节一致)。
5.1 为无序类别创建虚拟变量
将类别值表示为数值数据的最基本方法是创建虚拟变量(dummy variable)或指示变量(indicator variable)。这些是人工构造的数值变量,捕捉一个(或多个)类别值的某些方面。实现方法有很多,为便于说明,考虑星期几的简单示例。如果我们取七个可能的值并将它们转换为二值虚拟变量,完成这种转换所需的数学函数通常被称为对比函数(contrast function)或参数化函数(parameterization function)。对比函数的一个示例被称为“参照单元”(reference cell)或“处理”(treatment)对比,其中预测子的一个值在生成的虚拟变量中不被表示。以星期日作为参照单元,对比函数将创建六个虚拟变量(如表 5.1 所示)。这六个数值预测子将取代原始的类别变量。
为什么只有六个?有两个相关的原因。首先,如果六个虚拟变量的值已知,那么第七个就可以直接推断出来。第二个原因更偏技术性。在拟合线性模型时,会创建设计矩阵(design matrix)\(\mathbf{X}\)。当模型有截距时,会为所有行额外包含一列初始的 1。估计线性模型(以及其他类似模型)的参数涉及对矩阵 \(\mathbf{X}'\mathbf{X}\) 求逆。如果模型包含截距并且包含所有七天的虚拟变量,那么这七个天的列将(按行)加起来等于截距,这种线性组合将阻止矩阵求逆(因为它是奇异的)。发生这种情况时,称设计矩阵小于满秩(less than full rank)或超定(overdetermined)。当预测子有 \(C\) 个可能值且只使用 \(C-1\) 个虚拟变量时,矩阵求逆可以计算,这种对比方法被称为满秩参数化(full rank parameterization)(Timm 和 Carlson, 1975; Haase, 2011)。小于满秩的编码有时被称为“独热编码”(one-hot encoding)。生成完整的指示变量集可能对某些对线性依赖不敏感的模型有利(例如第 7.3.2 节描述的 glmnet 模型)。此外,当使用所有虚拟变量时,树和基于规则的模型产生的分裂可能更易于解释。
表 5.1:一组虚拟变量。
| 原始值 | 虚拟变量 | 虚拟变量 | 虚拟变量 | 虚拟变量 | 虚拟变量 | 虚拟变量 |
|---|---|---|---|---|---|---|
| Mon | Tues | Wed | Thurs | Fri | Sat | |
| Sun | 0 | 0 | 0 | 0 | 0 | 0 |
| Mon | 1 | 0 | 0 | 0 | 0 | 0 |
| Tues | 0 | 1 | 0 | 0 | 0 | 0 |
| Wed | 0 | 0 | 1 | 0 | 0 | 0 |
| Thurs | 0 | 0 | 0 | 1 | 0 | 0 |
| Fri | 0 | 0 | 0 | 0 | 1 | 0 |
| Sat | 0 | 0 | 0 | 0 | 0 | 1 |
虚拟变量的解释是什么?这取决于所使用的模型类型。考虑一个仅使用星期几作为预测子的芝加哥交通数据线性模型,采用上述参照单元参数化。使用训练集拟合模型,截距值估计参照单元的均值,即训练集中星期日乘客的平均人数,估计为 3.84K 人。第二个模型参数(对应星期一)估计为 12.61K。在参照单元模型中,虚拟变量表示超出参照单元均值的均值。在本例中,该估计值表明星期一比星期日多 12.61K 名乘客。星期一乘客量的总体估计将截距和虚拟变量的估计值相加(16.45K 人次)。
当有多个类别预测子时,参照单元变为多维的。假设有一个取值很少的天气预测子:‘clear’、‘cloudy’、‘rain’ 和 ‘snow’。我们以 ‘clear’ 作为参照单元。如果这个变量被纳入模型,截距将对应于晴朗天气的星期日的均值。但是,每组虚拟变量的解释不会改变。多云星期一的平均乘客量将等于晴朗星期日的平均乘客量加上多云的增量效应和星期一的增量效应。
还有其他用于虚拟变量的对比函数。“单元均值”(cell means)参数化(Timm 和 Carlson, 1975)会为一周中的每一天创建一个虚拟变量,并且不包含截距,以避免设计矩阵奇异的问题。在这种情况下,每个虚拟变量的估计值将对应于该类别的平均值。对于芝加哥数据,星期一虚拟变量的参数估计值就是 16.45K。
还有几种用于构造虚拟变量的其他对比方法。另一种基于多项式函数的方法将在下面针对有序数据讨论。
5.2 编码类别数量众多的预测子
如果有 \(C\) 个类别,当 \(C\) 变得非常大时会发生什么?例如,美国的邮编可能是受地理因素影响的结果的重要预测子。可能的邮编超过 40K 个,并且根据数据的收集方式,这可能会产生过多的虚拟变量(相对于数据点的数量)。如上一节所述,这可能导致数据矩阵超定,并限制某些模型的使用。此外,人口密集地区的邮编在数据中可能具有更高的出现频率,导致出现发生率较低的“长尾”(long tail)地点。
一个潜在的问题是,重采样(resampling)可能会将一些较罕见的类别排除在分析集之外。这将导致数据中出现全为零的虚拟变量列,对许多模型来说,这将成为一个数值问题并引发错误。此外,模型将无法为包含该预测子的新样本提供相关预测。当预测子只包含一个值时,我们称之为零方差预测子(zero-variance predictor),因为该预测子确实没有显示出任何变异。
处理这个问题的第一种方法是创建完整的虚拟变量集,然后简单地移除零方差预测子。这是一种简单有效的方法,但可能很难事先知道模型中会出现哪些项。换句话说,在重采样期间,不同重样本之间的模型参数数量可能不同。这可能是一个好的副作用,因为它捕捉了因省略罕见值而产生的方差,并将这种噪声传播到重采样的性能估计中。
在生成虚拟变量之前,可以考虑确定这些变量中哪些(如果有的话)是近零方差预测子(near-zero variance predictor),或者在重采样过程中可能具有近零方差。这些预测子具有很少的唯一值(例如二值虚拟变量只有两个值),并且在数据中出现频率很低(Kuhn 和 Johnson, 2013)。对于训练集,我们会考虑最常出现的值的频率与次常出现的值的频率之比。对于虚拟变量,这其实就是 1 的个数与 0 的个数之比。假设某个虚拟变量有 990 个 0 值和 10 个 1 值。这两个频率之比为 99,表明它在重采样过程中很容易变成全零。我们建议以 19 作为粗略的截止值来判定这样的变量“过于罕见”,不过针对不同问题,具体情境可能会提高或降低这个门槛。
表 5.2:对 OkC 数据中七个地点的特征哈希(feature hashing)演示。
| 哈希特征编号 | 哈希特征编号 | ||
|---|---|---|---|
| 哈希整数值 | 16 列 | 256 列 | |
| belvedere tiburon | 582753783 | 8 | 248 |
| berkeley | 1166288024 | 9 | 153 |
| martinez | -157684639 | 2 | 98 |
| mountain view | -1267876914 | 15 | 207 |
| san leandro | 1219729949 | 14 | 30 |
| san mateo | 986716290 | 3 | 131 |
| south san francisco | -373608504 | 9 | 201 |
尽管近零方差预测子可能包含很少有价值的预测信息,但我们可能不想将其过滤掉。避免过滤这些预测子的一种方法是在创建虚拟变量之前重新定义预测子的类别。取而代之,可以创建一个“其他”(other)类别来汇集不常出现的类别,前提是这种汇总是合理的。可以指定基于训练集频率的截止值,以指明应合并哪些类别。同样,这应该在重采样过程中进行,以便最终估计反映“其他”组中包含哪些预测值的变化。
合并类别的另一种方法是使用哈希函数(hash function)(或哈希(hash))。哈希用于将一组值映射到另一组值,通常用于数据库和密码学(Preneel, 2010)。原始值称为键(key),通常被映射到一个更小的人工哈希值(hash value)集合。在我们的情境中,可能数量庞大的预测子类别是键,我们希望用更少数量的类别(即哈希)来表示它们。可能的哈希数量由用户设定,出于数值处理的原因,它是 2 的幂。哈希函数一些计算上有趣的方面如下:
- 唯一需要的数据是被哈希的值和最终的哈希数量。这与之前描述的参照单元对比函数不同。
- 转换过程是完全确定性的(deterministic)。
- 在传统应用中,映射到哈希的键的数量保持相对均匀(uniform)是很重要的。如果
- 哈希用于密码学,这一点很重要,因为它增加了猜测结果的难度。如下所述,对于数据分析来说,这可能不是一个好的特性。
- 哈希函数是单向的;一旦创建了哈希值,就无法知道原始值。如果有一组已知且有限的原始值,可以创建一张表来进行转换,但否则,当只知道哈希值时,键是无法确定的。
- 使用此过程没有免费的午餐;一些原始类别将被映射到相同的哈希值(称为“冲突”(collision))。冲突的数量在很大程度上取决于生成的特征数量。
当使用哈希创建虚拟变量时,该过程被称为“特征哈希”(feature hashing)或“哈希技巧”(hash trick)(Weinberger 等, 2009)。由于哈希函数有很多种,因此生成将原始集合映射到缩减后哈希集合的表格也有不同的方法。
作为一个简单的例子,对 OkCupid 数据中的地点进行了哈希。[43] 表 5.2 显示了其中 7 个城市以说明细节。哈希值是一个完全由每个城市的文本值派生的整数值。为了将其转换为数据集中的新特征,使用了模运算。假设需要 16 个特征。为了创建从该整数到 16 个特征列之一的映射,使用公式 \(\text{column} = (\text{integer} \bmod 16) + 1\) 对该哈希值进行取模。例如,对于字符串 ‘mountain view’,我们有 \((-1267876914 \bmod 16) + 1 = 15\),因此这个城市被映射到第十五个虚拟变量特征。上表最后一列显示了当需要 256 个特征时各城市的分配情况;mod 256 比 mod 16 有更多可能的余数,因此可以有更多特征。使用 16 个特征时,数据中一些地点的虚拟变量分配如表 5.3 所示。
表 5.3:编码类别预测子的二值哈希特征。
| 1 | 2 | 3 | 4 | 5 | 6 | 9 | 12 | 13 | 14 | 15 | 16 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| alameda | 1 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| belmont | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| benicia | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| berkeley | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 |
| castro valley | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 |
| daly city | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| emeryville | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 |
| fairfax | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| martinez | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| menlo park | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 |
| mountain view | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| oakland | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 |
| other | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 |
| palo alto | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| san francisco | 1 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 |
| san leandro | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 |
| san mateo | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| san rafael | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 |
| south san francisco | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 |
| walnut creek | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
这张表有几个特点值得注意。首先,有 4 个哈希(列)没有显示在表中,因为它们全为零。这是因为没有任何哈希整数值具有那些特定的 mod 16 余数。对于那些可能取到不同于训练数据字符串值的预测子来说,这可能是个问题,因为这些新值会被放入这些列之一。在这种情况下,明智的做法是创建一个“其他”类别,以确保新字符串具有哈希表示。其次,注意有 6 个哈希没有冲突(即其列中只有一个 1)。但有多个列表现出冲突。冲突的一个例子是哈希编号 14,它同时编码了 Menlo Park 和 San Leandro。用统计学的术语来说,这两个类别被称为别名化(aliased)或混杂(confounded),意味着从这个哈希估计的参数无法分离任一城市的影响。别名结构(alias structure)在统计实验设计领域已经被研究了很长时间,尽管通常是在变量之间的别名化而非变量内部的别名化的背景下(Box 等, 2005)。无论如何,从统计的角度来看,最小化别名化的数量和程度是对比方案的一个重要方面。
某些哈希函数也可以是有符号(signed)的,这意味着新特征不是产生二值指示,而是可能取 -1、0 或 +1。零表示该类别与该特定特征无关,±1 值可以表示原始数据的不同取值。假设两个类别映射到相同的哈希值。二值哈希会导致冲突,但有符号哈希可以通过将一个类别编码为 +1、另一个编码为 -1 来避免这种情况。表 5.4 显示了与表 5.3 相同的数据,但使用相同大小的有符号哈希。
注意哈希 14 中的冲突现在消失了,因为值 1 对应于 Menlo Park,而 San Leandro 被编码为 -1。对于线性回归模型,第 14 个哈希的系数现在分别表示由 Menlo Park 或 San Leandro 引起的响应的正向或负向偏移。
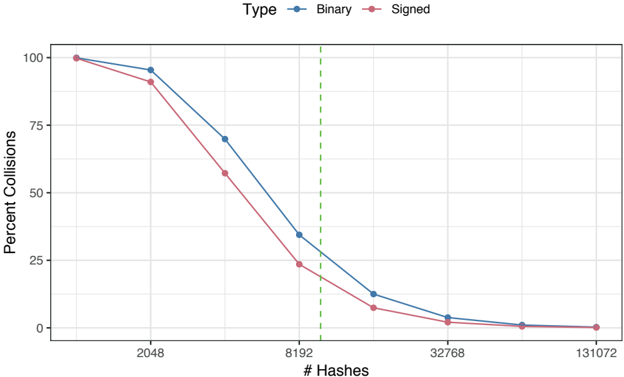
我们应该期望什么程度的别名化?为了研究这一点,模拟了数据,使得有 \(10^4\) 个预测子类别,每个类别由 20 个唯一的、随机生成的字符值组成。生成了各种大小的二值和有符号哈希,并确定了冲突率。该模拟重复进行了 10
表 5.4:编码类别预测子的有符号整数哈希特征。
| 1 | 2 | 3 | 4 | 5 | 6 | 9 | 12 | 13 | 14 | 15 | 16 | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| alameda | 1 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| belmont | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| benicia | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| berkeley | 1 | 0 | 0 | 0 | 0 | 0 | -1 | 0 | 0 | 0 | 0 | 0 |
| castro valley | 1 | 0 | 0 | 0 | 0 | 0 | 0 | -1 | 0 | 0 | 0 | 0 |
| daly city | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| emeryville | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 |
| fairfax | 1 | -1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| martinez | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| menlo park | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 |
| mountain view | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | -1 | 0 |
| oakland | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 |
| other | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 |
| palo alto | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| san francisco | 1 | 0 | 0 | 0 | 0 | -1 | 0 | 0 | 0 | 0 | 0 | 0 |
| san leandro | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | -1 | 0 | 0 |
| san mateo | 1 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| san rafael | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | -1 |
| south san francisco | 1 | 0 | 0 | 0 | 0 | 0 | -1 | 0 | 0 | 0 | 0 | 0 |
| walnut creek | 1 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
次,并计算了平均冲突百分比。图 5.1 显示了结果,其中 y 轴是特征中任何程度冲突的比率。正如预期的那样,有符号值与二值编码相比冲突更少。绿线对应于完整的虚拟变量集(不使用哈希)。对于这些数据,使用有符号特征将给出最佳的别名化结果,但冲突百分比相当高。
由于新特征的创建方式,特征哈希对预测子别名化的概念是无感的。当哈希用于其典型应用时,哈希函数的均匀性是一个重要特性。然而,在数据分析中,它可能是一个缺点。减少别名化是统计学中的一个重要概念;我们希望在尽可能多的情况下拥有最具体的类别表示,原因如下:
- 更少的别名化允许更好地解释结果。如果某个预测子对模型有显著影响,最好理解其中的原因。当多个类别因冲突而被别名化时,解开真实效应可能非常困难,尽管这可能有助于缩小
图 5.1:对一个具有 10K 个类别的预测子的模拟研究中冲突的平均比率。
影响响应的类别范围。
- 参与冲突的类别之间没有任何有意义的关联。例如,San Leandro 和 Menlo Park 并不是因为具有某种相似性或地理邻近性而被别名化的。由于冲突的任意性,可能出现不同类别其真实潜在效应相互抵消的情况。这可能会产生抵消哈希特征影响的效果。
- 哈希函数不知道每个键出现的概率。因此,可以想象一个出现频率很高的类别与一个罕见的类别被别名化。在这种情况下,出现更频繁的值将对那个哈希特征的影响产生大得多的作用。
尽管我们不知道有任何在统计意识上优于特征哈希的竞争者,但当对比函数与包含大量类别的预测子一起使用时,它应该具备一些特性。[44] 例如,如果能够使某些类别不与任何其他类别别名化,那么应该选择出现频率最高的值来承担这些角色。提出这一建议的原因是,它将为最可能暴露于对比函数的类别生成高度的特异性。这种策略的一个副作用是让出现频率较低的类别彼此别名化。这可能是有益的,因为它减少了那些虚拟变量的稀疏性(sparsity)。例如,如果两个各占训练集值 5% 的类别被合并,虚拟变量中 1 的数量将增加一倍。这将减少在重采样期间被过滤掉的机会,也可能减轻这种近零方差预测子对分析可能产生的潜在影响。
5.3 处理新类别的方法
假设构建了一个模型来预测个人从事 STEM 职业的概率,并且该模型依赖于地理位置(如城市)。如果新个体居住在 20 个城市之一,模型将能够预测 STEM 职业的概率。但是,当新个体居住在一个未出现在原始数据中的城市时,模型预测会发生什么?如果模型完全基于虚拟变量,那么模型将没有见过这条信息,无法生成预测。
如果未来有可能遇到新类别,一种策略是使用前面提到的“其他”类别来捕捉新值。虽然这种方法在针对该特定类别提取与响应相关的预测信息方面可能不是最有效的,但它确实使原始模型能够应用于新数据,而无需完全重新拟合。这种方法也可以与特征哈希一起使用,因为新类别被转换为一个独特的“其他”类别,并以与其他预测子值相同的方式被哈希;但是,我们确实需要确保“其他”类别存在于训练/测试数据中。或者,我们可以确保“其他”类别与另一个哈希类别发生冲突,以便模型可用于预测新样本。下一节将给出更多处理新类别的方法。
请注意,具有新类别的预测子的概念在模型的训练/测试阶段不是问题。在此阶段,建模时现有数据中所有预测子的类别都是已知的。如果某个特定预测子类别只出现在训练集中(反之亦然),仍然可以为两个数据集创建虚拟变量,尽管它将在其中一个数据集中是零方差预测子。
5.4 有监督编码方法
有几种以结果数据为指导(因此它们是有监督方法(supervised method))将类别预测子编码为数值列的方法。这些技术非常适合预测子可能有许多可能取值或模型训练后出现新水平的情况。
第一种方法是简单的转换,有时称为效应编码(effect encoding)或似然编码(likelihood encoding)(Micci-Barreca, 2001; Zumel 和 Mount, 2016)。本质上,测量因子水平对结果的影响,并将该影响用作数值编码。例如,对于 Ames 房屋数据,我们可以从训练数据中计算每个社区房屋销售价格的均值或中位数,并使用该统计量在模型中表示因子水平。估计效应的方法有很多,将在下面讨论。
对于分类问题,可以使用简单的逻辑回归模型来测量类别结果与类别预测子之间的效应。如果结果事件以比率 \(p\) 发生,则该事件的几率(odds)定义为 \(p/(1-p)\)。例如,在 OkC 数据中,加利福尼亚州 Mountain View 的 STEM 个人资料比率为 0.53,因此几率将为 1.125。逻辑回归将结果的对数几率(log-odds)建模为预测子的函数。如果模型中只包含一个类别预测子,则可以为每个预测子值计算对数几率,并将其用作编码。使用之前表 5.2 中显示的地点,OkC 数据的简单效应编码如表 5.5 中“原始”列所示。
表 5.5:OkC 数据中几个城镇的有监督编码示例。
| 数据 | 数据 | 对数几率 | 对数几率 | 词嵌入 | 词嵌入 | 词嵌入 | |
|---|---|---|---|---|---|---|---|
| 地点 | 比率 | n | 原始 | 收缩 | 特征 1 | 特征 2 | 特征 3 |
| belvedere tiburon | 0.086 | 35 | -2.367 | -2.033 | 0.050 | -0.003 | 0.003 |
| berkeley | 0.163 | 2676 | -1.637 | -1.635 | 0.059 | 0.077 | 0.033 |
| martinez | 0.091 | 197 | -2.297 | -2.210 | 0.008 | 0.047 | 0.041 |
| mountain view | 0.529 | 255 | 0.118 | 0.011 | 0.029 | -0.232 | -0.353 |
| san leandro | 0.128 | 431 | -1.922 | -1.911 | -0.050 | 0.040 | 0.083 |
| san mateo | 0.277 | 880 | -0.958 | -0.974 | 0.030 | -0.195 | -0.150 |
| south san francisco | 0.178 | 258 | -1.528 | -1.554 | 0.026 | -0.014 | -0.007 |
| -1.787 | 0.008 | 0.007 | -0.004 |
如前所述,估计效应有不同的方法。可以使用单一的广义线性模型(generalized linear model,如线性或逻辑回归)。虽然非常快,但它有缺点。例如,当因子水平只有一个值时会发生什么?理论上,对数几率应在相应的方向上趋于无穷大,但在数值上,它通常被限制在一个很大的(且不准确的)值上。
绕过这个问题的一种方法是使用某种收缩(shrinkage)方法。例如,可以确定总体对数几率,如果因子水平内数据的质量较差,则该水平的效应估计可以偏向于忽略预测子水平的总体估计。“质量差”可能是由于样本量小,或者对于数值结果,是该水平内数据的方差大。收缩方法还可以将极端估计值移向分布的中心。例如,一个重复次数很多的因子水平可能具有极端的均值或对数几率(如下面 Mountain View 数据所示)。
收缩参数估计的一种常见方法是贝叶斯分析(Bayesian analysis)(McElreath, 2015)。在这种情况下,可以在查看数据之前使用专家判断为估计值(如均值或对数几率)指定先验分布(prior distribution)。先验将是一个理论分布,代表效应的总体分布。几乎任何分布都可以使用。如果对分布应该是什么没有很强的信念,那么关注分布的形状可能就足够了。如果钟形分布是合理的,那么可以使用非常弥散或宽的先验,使其不过分有主见。贝叶斯方法获取观测数据并将其与先验分布混合,得出结合两者的后验分布(posterior distribution)。对于数据质量差的类别预测子值,后验估计值会向先验分布的中心收缩。当它们的原始估计值相对极端时也会发生这种情况。[45]
图 5.2:左:OkC 数据效应的原始与收缩估计。右:相同数据以对数几率幅度(x 轴)的函数形式显示。
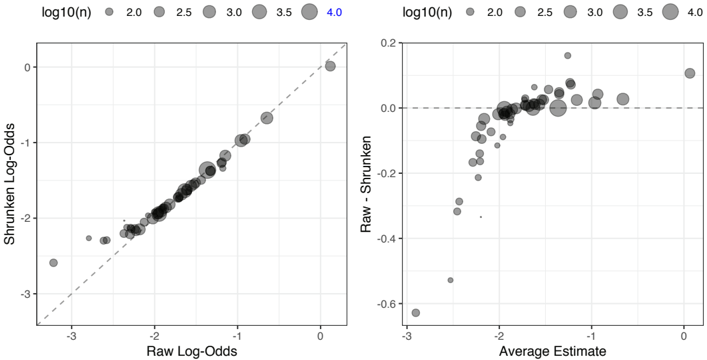
对于 OkC 数据,对数几率使用了具有大标准差(\(\sigma = 10\))的正态先验分布。表 5.5 显示了结果。对于大多数地点,原始和收缩估计非常相似。对于 Belvedere/Tiburon,样本量相对较小(STEM 比率也相对较小),估计值向先验中心收缩。注意有一行是 ‘
也可以使用经验贝叶斯(Empirical Bayes)方法,以线性(和广义线性)混合模型(mixed model)的形式(West 和 Galecki, 2014)。这些是非贝叶斯估计方法,也在其估计过程中纳入收缩。虽然它们往往比这里使用的贝叶斯模型类型更快,但它们的灵活性不如完全的贝叶斯方法。
效应编码的一个问题(与估计方法无关)是它增加了过拟合的可能性。这是因为估计的效应取自一个模型并放入另一个模型(作为变量)。如果这两个模型基于相同的数据,这多少有些自我实现。如果这些编码与未来数据不一致,这将导致模型无法检测到的过拟合,因为模型没有接触到任何可能反驳这些发现的其它数据。此外,使用汇总统计量作为预测子可能会大幅低估数据中的变异,并可能对新的编码列的效用给出虚假乐观的看法。[46] 因此,强烈建议使用不同的数据集来估计编码和预测模型,或者在其推导过程中在重采样内部进行,以便评估集能够衡量过拟合(如果存在的话)。
另一种有监督方法来自文本数据分析的深度学习文献。在这种情况下,大量文本可以被切分为单个单词。与其将每个单词都变成自己的指示变量,不如开发词嵌入(word embedding)或实体嵌入(entity embedding)方法。与下一章描述的降维方法类似,其思想是估计一组更小的数值特征,以充分表示类别预测子。Guo 和 Berkhahn (2016) 以及 Chollet 和 Allaire (2018) 更详细地描述了这种技术。除了降维之外,这些方法还有可能估计单词之间的语义关系,从而使主题相似的单词(如 ‘dog’、‘pet’ 等)在新编码中具有相似的值。这种技术不限于文本数据,可用于编码任何类型的定性变量。
一旦指定了新特征的数量,模型就会获取传统的指示变量并将它们随机分配给一个新特征。然后,模型尝试同时优化指示变量到特征的分配以及特征本身的参数系数。模型中的结果可以与预测模型相同(如销售价格或 STEM 个人资料的概率)。可以优化任何类型的损失函数(loss function),但通常对数值结果使用均方根误差(root mean squared error),对类别结果使用交叉熵(cross-entropy)(它们分别是线性和逻辑回归的损失函数)。模型拟合后,保存定量因子每个观测值的嵌入特征值。这些值充当用于预测的查找表。此外,可以为原始预测子分配一个额外的水平,作为模型训练后遇到的任何预测子新值的占位符。
可以使用更典型的神经网络结构,在预测子和结果之间放置一组或多组非线性变量(即隐藏层(hidden layer))。这允许模型对底层模式进行更复杂的表示。虽然对神经网络模型的完整描述超出了本书的范围,但 Chollet 和 Allaire (2018) 提供了拟合这些模型的非常易懂的指南,并且存在专门的软件来创建编码。
对于 OkCupid 数据,训练集中有 52 个地点。我们可以尝试使用一组嵌入特征来表示这些地点,再加上一个用于潜在新地点的插槽。模型的示意图为:
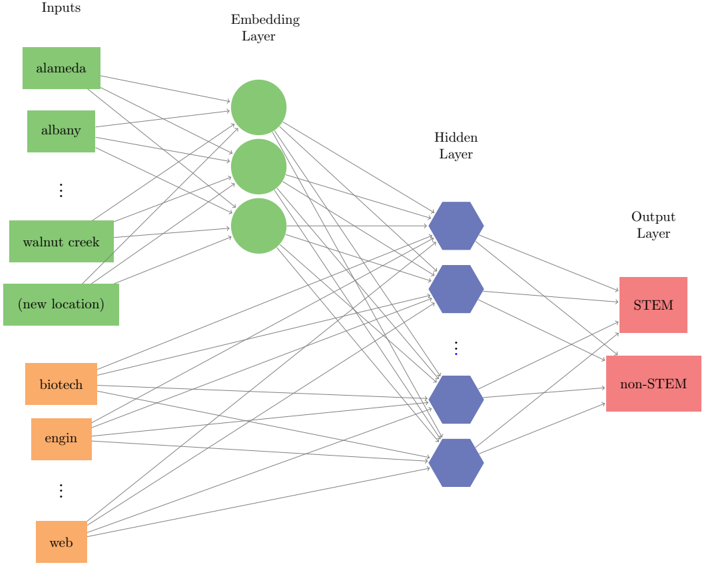
这里,每个绿色节点代表网络中专用于将地点数据降维到更小集合的部分。在此图中,使用了三个嵌入特征。模型还可以包含一组与嵌入组件无关的其他预测子。在此图中,一组额外的指示变量(将在第 5.6 节中派生)以橙色显示。这允许在其他潜在重要预测子存在的情况下估计嵌入,以便可以相应调整。每条线代表模型的斜率系数。左侧指示变量层与由绿色圆形节点表示的嵌入层之间的连接值,将用于表示原始地点。连接嵌入和其他预测子到隐藏层的激活函数(activation function)使用了修正线性单元(rectified linear unit,ReLU)连接(在第 6.2.1 节中介绍)。这允许模型通过非线性关系获得额外的复杂度。这里在模型估计期间使用了十个隐藏节点。总的来说,网络模型在推导嵌入特征的过程中估计了 678 个参数。使用交叉熵来拟合模型,并训练了 30 次迭代,发现其收敛。这些数据并不是特别复杂,因为唯一值很少,且往往几乎没有文本信息,因为每个数据点只属于一个地点(与文本被切分为单个单词的情况不同)。
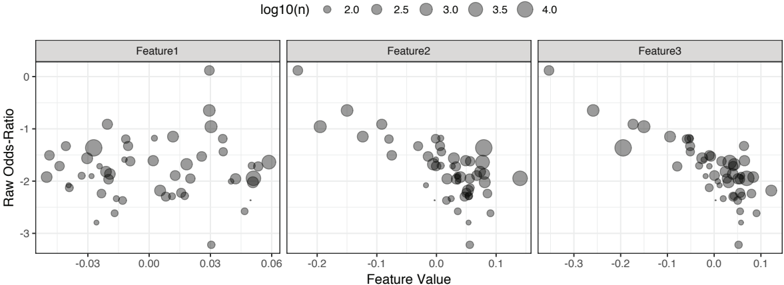
表 5.5 显示了几个地点的结果,图 5.3 包含了每个最终编码(即特征)与原始对数几率之间的关系。每个特征都与原始对数几率有关系,秩相关(rank correlation)分别为 -0.01、-0.58 和 -0.69。一些新特征与其他特征相关;绝对相关值介于 0.01 和 0.69 之间。这提出了一个可能性:对于这些数据,可能只需要更少的特征。最后,提醒一下,虽然这里使用了完整的有监督神经网络,但嵌入特征可以在其他模型中用于预处理地点值。
5.5 有序数据的编码
在前面的章节中,具有 \(C\) 个类别的无序预测子由 \(C-1\) 个二值虚拟变量或二值虚拟变量的哈希版本表示。这些方法有效地将类别信息呈现给模型。但现在假设 \(C\) 个类别具有相对顺序。例如,考虑一个具有 ’low’、‘medium’ 和 ‘high’ 类别的预测子。这条信息可以转换为 2 个二值预测子:\(X_{\text{low}} = 1\) 表示被分类为 ’low’ 的样本,否则 = 0;\(X_{\text{medium}} = 1\) 表示被分类为 ‘medium’ 的样本,否则 = 0。这些新预测子将准确识别低、中、高样本,但这两个新预测子会丢失相对顺序中包含的信息,而这些信息相对于响应可能非常重要。
有序类别预测子需要以不同的方式呈现给模型,以揭示顺序与响应之间的关系。有序类别可能与响应具有线性关系。例如,从 low 到 medium 响应可能增加约 5 个单位,从 medium 到 high 响应再增加约 5 个单位。为了让模型发现这种关系,必须向模型呈现表示线性顺序的有序类别的数值编码。在统计学领域,这种编码被称为多项式对比(polynomial contrast)。对比的特征是它是单一比较(即一个自由度(degree of freedom)),并且其系数之和为零。对于上面的 ’low’、‘medium’、‘high’ 示例,揭示线性趋势的对比将是 -0.71、0、0.71,其中 low 样本编码为 -0.71,medium 样本为 0,high 样本为 0.71。多项式对比也可以扩展到非线性形状。如果预测子与响应之间的关系最好用二次趋势描述,那么对比将是 0.41、-0.82 和 0.41(表 5.6)。方便的是,这类对比可以为任何数量的有序因子的预测子生成,但对比的复杂度被限制为原始预测子类别数减一。例如,我们不能用只有 3 个类别的预测子来探索预测子与响应之间的三次关系。
图 5.3:OkC 数据中每个唯一地点的三个词嵌入特征及其与原始比值比的关系。
通过采用多项式对比,我们可以将这些对比包含在同一模型中,同时研究多种关系(线性、二次等)。当我们这样做时,数值表示的形式很重要。具体来说,新预测子应包含独特的信息。要做到这一点,数值表示需要是正交(orthogonal)的。这意味着对比向量的点积为 0。
表 5.6:具有三个水平的有序类别预测子的线性和二次多项式对比示例。
| 原始值 | 线性虚拟变量 | 二次虚拟变量 |
|---|---|---|
| low | -0.71 | 0.41 |
| medium | 0.00 | -0.82 |
| high | 0.71 | 0.41 |
重要的是要认识到,多项式对比描述的模式可能无法有效地将预测子与响应联系起来。例如,在某些情况下,可能预期一种趋势,其中 ’low’ 和 ‘medium’ 样本的响应大致相同,但 ‘high’ 样本的响应非常不同。在这种情况下,多项式对比不太可能有效地建模这种趋势。有序类别的多项式对比的另一个缺点是当类别数量为中等到较多时。如果有序预测子有 \(C\) 个水平,则编码为虚拟变量时使用的多项式最高到 \(C-1\) 次。这些高阶多项式极不可能在建模重要趋势(如八次模式),因此限制多项式次数可能是合理的。在实践中,我们很少探索超过二次多项式的有效性。
作为多项式对比的替代方案,可以:
- 将预测子视为无序因子。这将允许多项式特征集未覆盖的模式。当然,如果真实的底层模式是线性或二次的,无序虚拟变量可能无法有效揭示这种趋势。
- 根据情境特定信息将有序类别转换为单一组数值评分。例如,在讨论计算机硬件的故障模式时,专家可以在整数尺度上对故障类型的严重程度进行排序。轻微故障可能被评为 ‘1’,而灾难性故障模式可能得到 ‘10’ 的评分,依此类推。
简单的可视化和情境特定的专业知识可以用来理解这两种方法中哪一种是个好主意。
5.6 从文本数据创建特征
通常,数据包含从问卷、文章、评论、推文和其他来源收集的文本字段。例如,OkCupid 数据包含九个开放式文本问题的回答,如 ‘my self-summary’ 和 ‘six things I could never do without’。开放式回答可能包含与结果相关的重要信息。STEM 领域的个人可能与人文学科的人使用不同的词汇。因此,这些开放式文本字段中使用的单词或短语对于预测结果可能非常重要。这类数据是定性的,需要付出更多努力才能转化为模型可以消费的形式。那么,如何探索这些数据并为模型表示它们呢?
例如,一些个人资料的文本回答包含外部网站的链接。一个合理的假设是,超链接的存在可能与人的职业有关。表 5.7 显示了随机个人资料子集的结果。STEM 个人资料中超链接的比率为 21%,而非 STEM 个人资料中该比率为 12.4%。评估两个比例之间差异的一种方法称为比值比(odds-ratio)(Agresti, 2012)。首先,以比率 \(p\) 发生的事件的几率定义为 \(p/(1-p)\)。对于 STEM 个人资料,包含超链接的几率相对较小,值为 \(0.21/0.79 = 0.27\)。对于非 STEM 个人资料,它更小(0.142)。然而,这两个量的比率可以用来理解拥有超链接对两个职业之间的效应。在这种情况下,这表明当个人资料包含链接时,STEM 个人资料的几率几乎高出 1.9 倍。可以使用基础统计量为此量指定 95% 置信区间的下限。对于这些数据,下限为 1.7,这表明几率的增加不太可能是随机噪声造成的,因为它不包含 1.0 的值。鉴于这些结果,超链接的指示很可能有益于模型,应该被包括在内。
表 5.7:OkCupid 短文文本中至少存在一个超链接与职业之间的交叉制表。
| stem | other | |
|---|---|---|
| 有链接(Link) | 1063 | 620 |
| 无链接(No Link) | 3937 | 4380 |
是否有能够很好预测结果的单词或短语?要确定这一点,必须首先处理和清理文本数据。此时,10,000 个个人资料的子样本中有 63,440 个不同的单词。在数据上计算了各种特征,如逗号、话题标签(hashtag)、提及(mention)、感叹号等的数量。这产生了一组 13 个新的“文本相关”特征。在这些数据中,文本中有大量 HTML 标记标签,如
和 。这些以及标点符号、换行符和其他符号都被从数据中移除。此外,还有一些无意义的重复字符词,如 *** 或 aaaaaaaaaa,也被移除。下面描述其他类型的文本预处理,有关更多信息,Christopher 等 (2008) 是文本数据分析的一个很好的入门,而 Silge 和 Robinson (2017) 是分析此类数据的计算方面的优秀参考资料。
给定这组 63,440 个单词及其相关的结果类别,可以计算比值比。首先,再次过滤单词,使得在 10,000 个个人资料中至少出现 50 次的词才会被分析。确定此截止值是为了保证足够的建模频率。在此约束下,潜在关键词的数量减少到 4,918 个词。对每个词计算比值比和相关的 p 值。p 值检验的关键词在两个职业组中出现的几率相等(即 1.0)这一假设。然而,p 值很容易因两个原因提供误导性结果:
- 孤立地看,p 值只回答“两组之间的几率是否有差异?”的问题。更恰当的问题是“两组之间的差异有多大?”。p 值不衡量差异的大小。
- 在检验单个(预定义的)假设时,使用 \(\alpha = 0.05\) 的假设检验的假阳性率为 5%。然而,对同一数据集进行 4,918 次检验会将假阳性率呈指数级提高。错误发现率(false discovery rate,FDR)p 值校正(Efron 和 Hastie, 2016)正是针对这种情况开发的。该过程使用整个 p 值分布并衰减假阳性率。如果某个特定关键词的 FDR 值为 0.30,这意味着 FDR 值
Odds-Ratio
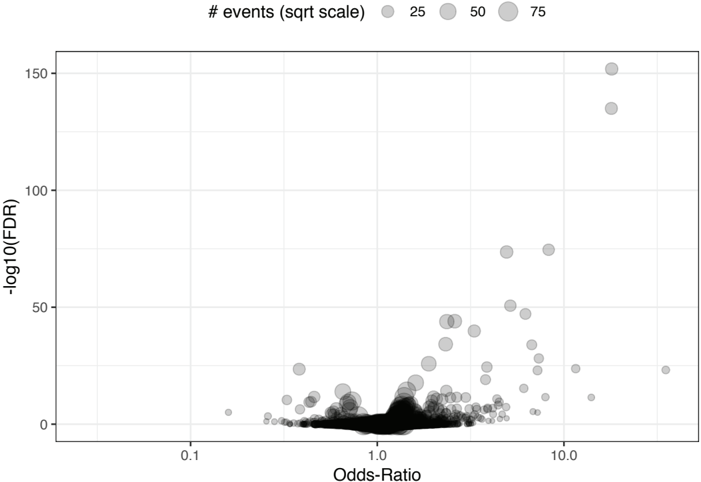
图 5.4:关键词分析的火山图(volcano plot)。每个点代表 OkCupid 短文中的一个单词,点的大小代表出现的频率。右上角的单词与 STEM 个人资料强相关。
小于 0.30 的关键词集合具有 30% 的集体错误发现率。因此,这里的重点将放在使用 Benjamini-Hochberg 校正(Benjamini 和 Hochberg, 1995)生成的 FDR 值上。
为了表征这些结果,图 5.4 显示了火山图,其中估计的比值比显示在 x 轴上,FDR 值的负对数显示在 y 轴上(较大的值表示较高的统计显著性)。点的大小与采样数据集中发现的事件数量相关。落在左上和右上侧的关键词表明类别之间存在强烈差异,不太可能是随机结果。该图显示,比非 STEM 职业更可能在 STEM 个人资料中找到的关键词要多得多,因为更多点落在 x 轴上 1 的右上侧。其中一些具有极高的统计显著性,FDR 值小到几乎消失。
作为“重要性”的粗略标准,比值比至少为 2(任一方向)且 FDR 值小于 \(10^{-5}\) 的关键词将被考虑用于建模。这产生了 52 个关键词:
alot, apps, biotech, code, coding, computer, computers, data, developer, electronic, electronics, engineer, engineering, firefly, fixing, futurama, geek, geeky, im, internet, lab, law, lawyer, lol, math, matrix, mechanical, mobile, neal, nerd, pratchett, problems, programmer, programming, science, scientist, silicon, software, solve, solving, startup, stephenson, student, systems, teacher, tech, technical, technology, valley, web, websites, wikipedia
在这些关键词中,只有 7 个在非 STEM 个人资料中富集:im、lol、teacher、student、law、alot、lawyer。在 STEM 富集的关键词中,许多是合理的(并且符合刻板印象)。大多数与职业有关(如 engin、startup 和 scienc),而其他则明显与流行的极客文化有关,如 firefli、[47] neal 和 stephenson、[48] 以及 scifi。
最后计算了一组与短文的情感和语言相关的 9 个特征。有一些精心整理的带有指定情感值的单词集合。例如,‘horrible’ 具有相当负面的含义,而 ‘wonderful’ 与积极性相关。单词可以被赋予定性评估(如 ‘positive’、’neutral’ 等)或数值评分,其中中性被赋予零值。在某些问题中,情感可能是结果的一个很好的预测子。该特征集包括情感相关度量,以及视角(即第一、第二或第三人称文本)和其他语言元素的度量。
这些特征对模型有影响吗?使用不同的特征集计算了一系列逻辑回归模型:
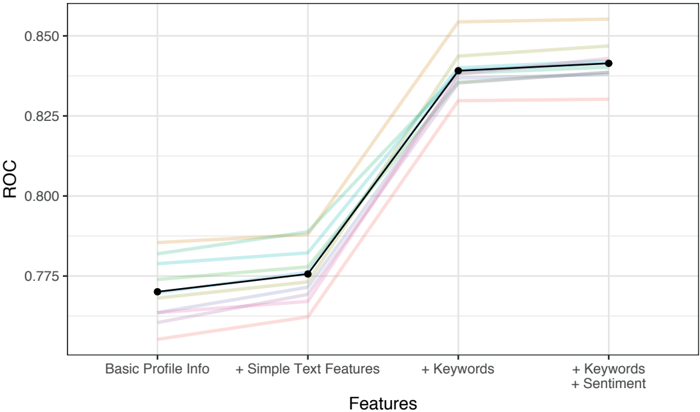
- 一组与短文无关的基本个人资料特征(如年龄、宗教等),由 160 个预测子组成(在生成虚拟变量之后)。这产生了 0.77 的基线 ROC 曲线下面积(area under the ROC curve)。该模型的各个重样本如图 5.5 所示。
- 添加简单文本特征将预测子数量增加到 173。性能没有明显改善,AUC 值为 0.776。这些特征被放弃进一步使用。
- 将关键词添加到基本个人资料特征中。在这种情况下,性能跃升至 0.839。回想一下,这些是从这些数据的较小子集派生的,这个估计可能稍微乐观。然而,整个训练集都经过交叉验证,如果过拟合很严重,重采样的性能估计就不会很好。
- 将情感和语言特征添加到该模型中,产生了 0.841 的 AUC。这表明短文的这些方面没有提供
图 5.5:使用不同特征集计算的一系列逻辑回归模型的重采样结果。
超出先前特征已捕获信息的任何预测价值。
总的来说,关键词加基本特征的模型是这里发现的最佳版本。[49]
这里展示的从文本计算和评估特征的策略相当简单,不是唯一可以采用的方法。文本数据预处理的其他方法包括:
- 移除常用停用词(stop word),如 ‘is’、’the’、‘and’ 等。
- 对单词进行词干提取,使相似的单词(如单数和复数版本)表示为单个实体。
SMART 停用词词典(Lewis 等, 2004)被从当前单词集中过滤掉,留下 62,928 个唯一结果。然后使用 Porter 算法(Willett, 2006)对单词进行“词干提取”,将相似的单词转换为共同的词根。例如,这 7 个单词相当相似:teach、teacher、teachers、teaches、teachable、teaching、teachings。词干提取会将它们减少为 3 个唯一值:teach、teacher、teachabl。一旦这些值被词干化,就剩下 45,486 个唯一单词。虽然这确实减少了需要分析的潜在词项数量,但也存在与文本特异性降低相关的潜在缺点。Schofield 和 Mimno (2016) 以及 Schofield 等 (2017) 表明,使用这些预处理器可能会造成损害。
确定相关特征的另一种方法使用词频-逆文档频率(term frequency-inverse document frequency,tf-idf)统计量(Amati 和 Van R, 2002)。这里的目标是找到对当前文档集合中的单个文档很重要的单词或词项。例如,如果处理本书中的单词,有些词会具有高频率(如 predictor、encode 或 resample),但在大多数其他情境中却不常见。
对于文档 \(D\) 中的单词 \(W\),词频(term frequency)\(tf\) 是 \(W\) 在 \(D\) 中出现的次数(通常根据 \(D\) 的长度进行调整)。逆文档频率(inverse document frequency)\(idf\) 是一个权重,将按单词在当前文档集合中出现的频率进行归一化。例如,假设单词 feynman 在特定个人资料中的词频为 2。在用于派生特征的个人资料样本中,该单词在 10,000 个中出现了 55 次。逆文档频率通常表示为比率的对数,即 \(\log_2(10000/55)\),即 7.5。feynman 在该个人资料中的 tf-idf 值将是 \(2 \times \log_2(10000/55)\),即 15。然而,假设在同一个人资料中,单词 internet 也出现了两次。这个单词在个人资料中更为普遍,至少出现过一次的有 1529 次。这里的 tf-idf 值是 5.4;这样,相同的原始计数根据其在整体数据集中的丰富程度被降低权重。在这个假设的个人资料中,feynman 出现的次数与 internet 相同,但 feynman 更独特或更重要(按 tf-idf 衡量),因为它在整体上更罕见,因此作为预测特征可能更有效。
tf-idf 在预测模型中的一个潜在问题是“当前文档集合”的概念。可以为训练集计算它,但当预测单个新样本时(即没有集合)该怎么办?一种方法是使用训练集的整体 idf 值来加权新样本中发现的词频。
此外,之前的所有方法都一次考虑一个单词。也可以考虑连续单词序列,它们可能提供额外信息。n 元组(n-gram)是 \(n\) 个连续单词的序列的词项。可以想象,在预测个人资料是否对应 STEM 职业时,序列 ‘I hate computers’ 的评分会与简单词项 ‘computer’ 不同。
5.7 基于树的模型中的因子与虚拟变量
如前所述,某些类型的模型能够以自然形式使用类别数据(即无需转换为虚拟变量)。使用芝加哥数据的星期几预测子的简单回归树(regression tree)(Breiman 等, 1984)产生了这个简单的预测分裂:
if day in {Sun, Sat} then ridership = 4.4K else ridership = 17.3K
假设星期几已被转换为虚拟变量。会发生什么?在这种情况下,模型稍微复杂一些,因为它一次只能基于单个虚拟变量创建规则:
表 5.8:用于评估树和规则模型中类别预测子编码的数据集摘要。
| Attrition | Cars | Churn | German Credit | HPC | |
|---|---|---|---|---|---|
| n | 1470 | 1728 | 5000 | 1000 | 4331 |
| p | 30 | 6 | 19 | 20 | 7 |
| 类别数(Classes) | 2 | 4 | 2 | 2 | 4 |
| 数值预测子(Numeric Predictors) | 16 | 0 | 15 | 7 | 5 |
| 因子预测子(Factor Predictors) | 14 | 6 | 4 | 13 | 2 |
| 有序因子(Ordered Factors) | 7 | 0 | 0 | 1 | 0 |
| 3 个及以上水平的因子(Factor with 3+ Levels) | 12 | 7 | 2 | 11 | 3 |
| 5 个及以上水平的因子(Factor with 5+ Levels) | 3 | 0 | 1 | 5 | 2 |
if day = Sun then ridership = 3.84K else if day = Sat then ridership = 4.96K else ridership = 17.30K
非虚拟变量模型如果发现周六和周日的差异足够大,值得额外分裂,也可以产生相同的结构。这就引出了在基于树的模型中使用类别预测子的相关问题:预测的编码方式重要吗?
为了回答这个问题,进行了一系列实验。[50] 使用几个公开的分类数据集来比较不同的编码。这些在表 5.8 中总结。两个数据集同时包含有序和无序因子。如下所述,有序因子以不同的方式处理。
对于模拟的每次迭代,75% 的数据用于训练集,并使用 10 折交叉验证来调优模型。当结果变量有两个水平时,最大化 ROC 曲线下面积。对于其他数据集,优化多项式对数似然(multinomial log-likelihood)。评估了相同数量的调优参数值,尽管在某些情况下,由于虚拟变量生成前后数据中预测子的数量,这些参数的值不同。对有无虚拟变量的模型使用了相同的重样本和随机数。当数据包含显著的类别不平衡时,对数据进行下采样(downsampling)以补偿。
对于每个数据集,使用原始形式的数据以及(无序)虚拟变量拟合模型。对于两个具有有序数据的数据集,还使用有序虚拟变量(即多项式对比)创建了额外的模型。
对数据集拟合了多个模型。除非另有说明,每个模型都使用默认的软件参数。
- 单个 CART 树(Breiman 等, 1984)。使用递归划分算法内部的“一个标准误规则”(one-standard error rule)选择复杂度参数。
- 装袋 CART 树(bagged CART tree)(Breiman, 1996)。每个模型包含 50 棵组成树。
- 单个 C5.0 树和单个 C5.0 规则集(ruleset)(Quinlan, 1993; Kuhn 和 Johnson, 2013)
- 单个条件推断树(conditional inference tree)(Hothorn 等, 2006)。评估了 10 个值的分裂 p 值阈值网格。
- 提升 CART 树(又称随机梯度提升(stochastic gradient boosting),Friedman (2002))。模型在树的数量、学习率、树的深度和进行额外分裂所需的样本数上进行优化。使用随机搜索评估了 25 个参数组合。
- 提升 C5.0 树。针对迭代次数进行调优。
- 提升 C5.0 规则。也针对迭代次数进行调优。
- 使用 CART 树的随机森林(random forest)(Breiman, 2001)。每个森林包含 1,500 棵树,并针对 10 个值的网格调优每次分裂选择的变量数量。
- 使用条件(无偏)推断树的随机森林(Strobl 等, 2007)。每个森林包含 100 棵树,并针对 10 个值的网格调优每次分裂选择的变量数量。
对于每个模型,使用重采样估计了各种不同的性能指标,以及训练和调优模型的总时间。[51]
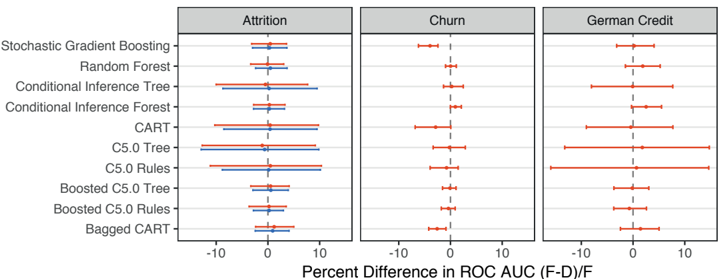
对于三个具有两个类别的数据集,图 5.6 显示了 ROC 曲线下面积结果的摘要。在图中,性能的百分比差异使用以下公式计算:
以这种方式,正值表示因子编码具有更好的性能。图像显示了分布的中位数以及较低和较高的 5% 百分位数。灰色虚线表示编码之间没有差异。
这些模拟的结果表明,对于这些数据集,不同编码方法之间的 ROC 曲线下面积没有真正的差异。当将简单因子编码与从有序预测子的多项式对比生成的虚拟变量进行比较时,情况似乎也是如此。[52] 在十个模型中(对比项:因子 vs 有序虚拟变量、因子 vs 无序虚拟变量),40 种场景中只有两种情况下分布的主流没有覆盖零。随机梯度提升和装袋 CART 树都是集成方法(ensemble method),在单个数据集中使用因子而非虚拟变量时,ROC 曲线下降了 2%-4%。
图 5.6:ROC 曲线下面积编码的比较。
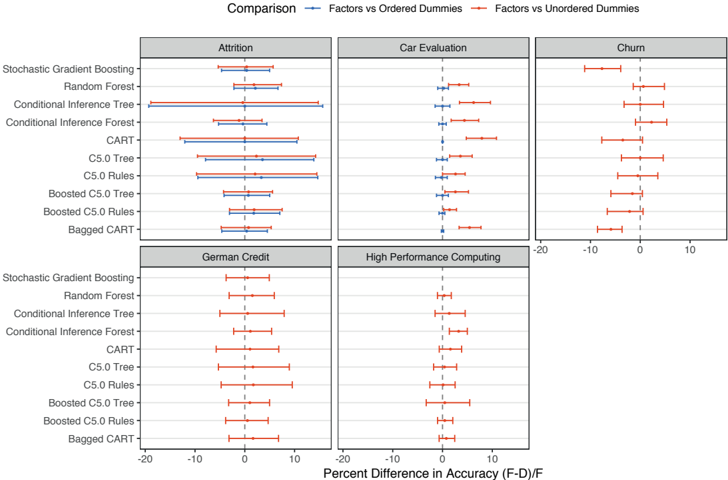
另一个指标,总体准确率(accuracy),也可以评估。这些结果显示在图 5.7 中,所有模型都可以纳入考虑。在这种情况下,结果是混合的。当将因子与无序虚拟变量比较时,有两个模型显示编码差异。churn 数据显示的结果与 ROC 曲线指标相似。car evaluation 数据表现出近乎一致的效应,因子编码优于虚拟变量。回想一下,在具有四个类别的 car 数据中,所有预测子都是类别型的。因此,它可能显示出所有数据集中最大的效应。
在使用多项式对比生成的虚拟变量的情况下,两个数据集都没有显示两种编码之间的差异。然而,car evaluation 数据显示了一种模式:因子编码与多项式对比相比没有差异,但与无序虚拟变量相比,因子编码更优。这表明数据中的底层趋势遵循多项式模式。
在性能方面,两种编码之间的差异似乎很少见(但可能发生)。人们可能会推断,由于 car 数据包含所有类别变量,这种情况将是何时使用因子而不是虚拟变量的良好指标。然而,两个数据集(Attrition 和 German Credit)具有高比例的类别预测子,但没有显示出差异。在某些数据集中,编码的影响取决于类别预测子对结果是否重要以及以何种方式重要。
总而言之,虽然看到的差异很少,但很难预测差异何时会发生。
图 5.7:准确率编码的比较。
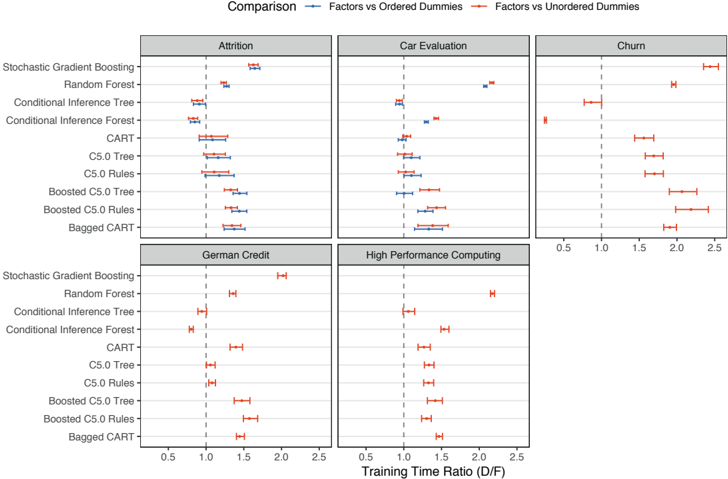
然而,为每个模拟计算了另一个统计量:训练模型的时间。图 5.8 显示了使用因子相对于虚拟变量的加速比(即值为 2.5 表示虚拟变量模型比因子编码模型慢两倍半)。这里有一个非常强的趋势:基于因子的模型比对应的虚拟变量模型训练得更高效。其原因很可能是扩展的预测子数量(由生成虚拟变量引起)比确定因子水平最优分裂的方法需要更多的计算时间。这一趋势的例外是使用条件推断树的模型。
定性预测子编码方式的另一个影响与汇总度量有关。许多这些技术,尤其是基于树的模型,计算变量重要性(variable importance)得分,这是衡量预测子对结果影响程度的相对度量。例如,树衡量特定分裂对模型性能改善(如不纯度(impurity)、残差误差等)的影响。随着预测子被用于分裂,这些改善被聚合;这些可以用作重要性得分。如果分裂涉及预测子的所有值(例如周六与其他六天),整个变量的重要性得分很可能远大于单个水平(如周六或非周六)的类似重要性得分。在后一种情况下,每个水平的这些碎片化得分可能不如反映所有水平的类似得分排名高。在特征选择(第 10 至 7 章)和交互检测(第 12 章)中也会出现类似的问题。预测子编码方法的选择将在那里进一步讨论。
图 5.8:训练模型时间编码的比较。较大的值表示因子编码比虚拟变量模型花费更少的训练时间。
作为指南,我们建议使用不转换为虚拟变量的预测子,如果模型看起来有前景,也尝试使用虚拟变量重新拟合。
5.8 总结
类别预测子在被建模的数据中可以采取多种形式。除了基于树的模型之外,类别预测子必须首先转换为数值表示,才能让其他模型使用这些信息。类别预测子最简单的特征工程技术是将每个类别转换为一个独立的二值虚拟预测子。但即使是这种基本转换也有一个主要的注意事项:某些模型需要的虚拟预测子比类别数少一个。创建虚拟预测子可能不是从类别预测子中提取预测信息的最有效方式。例如,如果预测子具有有序类别,那么线性或多项式对比等其他技术可能更好地与结果相关。
文本字段也可以被视为类别预测子的集合体,必须转换为数值。最近出现了大量将文本转换为数值的方法。通常这些方法必须包含一个过滤步骤,以移除高频、无描述性的单词。
如果做得好,类别预测子的特征工程可以解锁与结果相关的重要预测信息。下一章将重点介绍使用特征工程技术在连续预测子中发现额外的预测信息。
5.9 计算
网站 http://bit.ly/fes-cat 包含用于重现这些分析的 R 程序。
脚注
[43] 这些计算使用了位于 https://github.com/aappleby/smhasher 的 ‘MurmurHash3’ 哈希函数,并由 FeatureHashing R 包实现。
[44] 对别名结构的传统分析可以应用于这个问题。然而,还需要更多的研究,因为这些方法通常应用于平衡设计(balanced design),即预测子的值具有相同的出现频率。此外,如前所述,它们往往侧重于多个变量之间的别名化。无论如何,这方面还有很大的改进空间。
[45] 在这种情况下,值向均值的收缩被称为估计的部分汇集(partial pooling)。
[46] 这将在第 6.2.2 节中结合示例进一步讨论。
[47] https://en.wikipedia.org/wiki/Firefly_(TV_series)
[48] https://en.wikipedia.org/wiki/Neal_Stephenson
[49] 这是在第三章讨论重采样和模型比较(表 3.4)时使用的特征集。
[50] 在第 12 章中,使用朴素贝叶斯模型进行了类似但规模较小的分析。
[51] 模拟中使用的程序包含在 GitHub 仓库 https://github.com/topepo/dummies-vs-factors 中。
[52] 请注意,许多非集成方法,如 C5.0 树/规则、CART 和条件推断树,显示出大量的变异。这是因为它们是不稳定的模型,具有高方差。