探索性可视化
我们在建模过程中所做的一切工作的核心目标,是找到可复现的方法来解释响应(response)中的变异(variation)。正如前一章所讨论的,发现与响应相关的预测变量模式,涉及选择重采样(resampling)方案以防止过拟合(overfitting)、选择性能度量、调优并训练多个模型,以及比较模型性能以确定哪些模型表现最佳。面对一个新数据集时,人们很容易直接跳入预测建模流程,看看能否快速开发出一个满足性能预期的模型。或者,在预测变量很多的情况下,初始目标可能是利用建模结果来识别与响应相关的最重要预测变量。但正如第 1 章图 1.4 所示,应当花足够的时间来探索数据。本章的重点是介绍可视化探索数据的方法,并演示如何利用这种方法来指导特征工程(feature engineering)。
当最终目的是预测响应时,探索性数据分析(exploratory data analysis)过程的第一步,是创建有助于阐明响应相关知识、进而揭示预测变量与响应之间关系的可视化。因此,我们的可视化应该从响应入手,理解其分布的特征,然后以预测变量提供的额外信息为基础向外扩展。可以通过创建直方图(histogram)或箱线图(box plot)来获得关于响应的知识。这种简单的可视化会揭示响应的变异量,以及响应是否由具有需要进一步调查的异常特征的机制生成。接下来,我们可以继续探索预测变量之间的关系以及预测变量与响应之间的关系。通过检查以下内容可以识别重要特征:
- 单个预测变量与响应的散点图(scatter plot),
- 预测变量之间的两两相关图,
- 将高维预测变量投影到低维空间,
- 基于时间的预测变量的折线图(line plot),
- 回归树或分类树的前几层,
- 跨样本和预测变量的热图(heatmap),或
- 用于检查分类变量之间关联的马赛克图(mosaic plot)。
这些可视化提供了洞见,应当用于为初始模型提供信息。值得注意的是,一些最有用的数据探索可视化并不一定复杂或难以创建。事实上,一个简单的散点图就能引出模型可能无法发现的洞见,并能促成新预测变量的创建,或对预测变量或响应进行改进模型性能的变换。这里的挑战在于培养直觉,知道如何通过可视化探索数据以提取改进所需的信息。如图 1.4 所示,探索性数据分析不应止步于此,而应在初始模型构建之后继续进行。模型构建之后,可视化工具可用于评估模型的失拟(lack-of-fit),并评估原始模型中未包含的新预测变量的潜在有效性。
在本章中,我们将深入探讨多种有用的可视化工具,用于在构建初始模型之前探索数据。其中一些工具还可以在模型构建之后使用,以识别能够改进模型性能的特征。按照图 1.4 的流程,我们将先考察建模之前的可视化,然后考察建模过程中的可视化。我们还建议读者参考 Tufte (1990)、Cleveland (1993) 和 Healy (2018),它们是数据可视化的优秀资源。
为了说明这些工具,数值可视化将使用芝加哥轨道交通客流量(Chicago Train Ridership)数据,分类可视化将使用 OkCupid 数据。
4.1 芝加哥轨道交通客流量数据简介
为了说明探索性可视化如何成为理解数据集的关键部分,以及可视化如何用于识别和揭示有助于提高模型预测能力的预测变量表示,我们将使用芝加哥交通管理局(Chicago Transit Authority,CTA)‘L’ 铁路系统收集的客流量数据[36](图 4.1)。在短期内,了解未来一两周的客流量将使 CTA 能够确保有最佳数量的车厢来服务芝加哥大都市区(Chicagoland)的人口。作为需求波动的一个简单例子,我们可以预期大都市区的客流量在工作日更强、周末较弱。对需求的误解可能犯两种常见错误。一种极端情况是,一条线路上车厢太少而无法满足工作日需求,这会延误乘客到达目的地,并导致过度拥挤和紧张。另一种极端情况是,周末车厢太多会降低效率,导致运营成本上升、盈利能力下降。良好的需求预测将帮助 CTA 更接近最优地满足需求。
从长期来看,预测可用于预判何时可能需要新增线路服务、调整停靠频率以最优地服务客流量,或随着人口迁移和需求强弱变化而增加或取消停靠站。
图 4.1:芝加哥交通管理局 ‘L’ 线路图。在本示例中,我们感兴趣的是预测芝加哥环路(Chicago Loop)Clark/Lake 车站的客流量。(来源:Wikimedia Commons,知识共享许可)
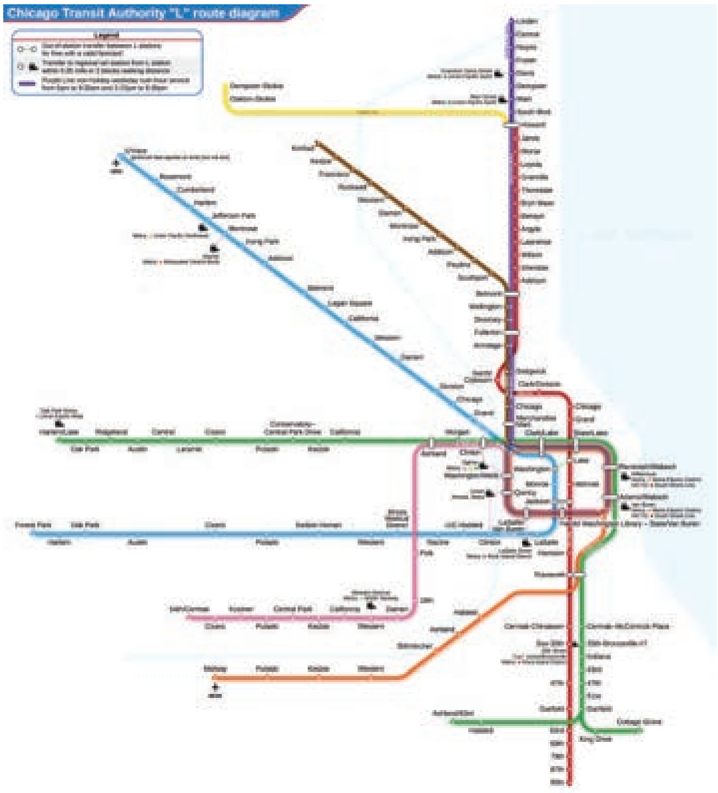
为了说明探索性可视化的重要性,我们将专注于日客流量的短期预测。我们获取了 2001 年 1 月 22 日至 2016 年 9 月 11 日期间 126 个车站[37]的日客流量数据。客流量以通过所有闸机的进站人数来衡量,该时段内各车站的每日乘客数差异很大,介于每天 0 到 36,323 人之间。为便于展示,客流量将以千名乘客为单位显示和分析。
我们的示例将缩小范围,专注于预测 Clark/Lake 车站的日客流量。
这个车站是一个值得理解的重要站点;它位于市中心环路,是整个铁路系统中客流量最高的车站之一,并服务覆盖芝加哥北部、西部和南部的四条不同线路。
对于这些数据,其他车站的客流量数字可能对模型很重要。然而,由于目标是预测未来的客流量,在预测时点只能获得历史数据。对于时间序列数据,预测变量通常通过对数据进行滞后(lag)来构造。在本应用中,当预测第 \(D\) 天时,使用每个车站的 14 天滞后(lag-14)数据创建预测变量(例如,第 \(D-14\) 天的客流量)。如有必要,也可以向模型添加其他滞后。
其他可能影响公共交通客流量的潜在区域因素包括天气、汽油价格和就业率。例如,可以合理地预期,随着个人交通成本(即汽油价格)长期上涨,会有更多人使用公共交通。同样,随着失业率下降,公共交通的使用量可能会增加。我们获取了与客流量数据同时段的天气数据。天气信息按小时记录,包含多种状况,如阴天(overcast)、冻雨(freezing rain)、雪(snow)等。我们创建了一组预测变量,反映与雨、雪/冰、云、暴风雨和晴空相关的状况。每个类别都是通过汇集更细粒度的记录状况来确定的。例如,降雨预测变量反映的记录状况包括’rain’(雨)、‘drizzle’(毛毛雨)和’mist’(薄雾)。新预测变量的编码方式是:汇总一天内的小时数据,计算一天中观测到该状况的观测值百分比。作为示例,2012 年 12 月 20 日,记录的状况为雪(占全天的 12.8%)、多云(15.4%)、暴风雨(12.8%)和降雨(71.8%)。显然,构成这些类别的状况存在一些重叠,例如多云和暴风雨。
还有其他与温度、露点(dew point)、湿度、气压、降水和风速相关的小时级天气数据可用。温度通过每日最小值、中位数和最大值以及每日变化来汇总。气压变化也以类似方式计算。在大多数其他情况下,使用每日中位数值来汇总小时记录。与客流量数据一样,未来天气数据不可用,因此模型中使用这些数据的滞后版本。[38] 总共有 18 个与天气相关的预测变量可用。此类数据的汇总方式将在第 9 章进一步讨论。
除了每日天气数据外,我们还获取了 2001 年至 2016 年芝加哥地区的周平均汽油价格(美国能源信息署(U.S. Energy Information Administration),2017a)。同一时期,我们从美国人口普查局(United States Census Bureau,2017)获取了月度失业率。这些预测变量的潜在用途将在下文讨论。
4.2 数值数据的可视化:探索轨道交通客流量数据
4.2.1 箱线图、小提琴图和直方图
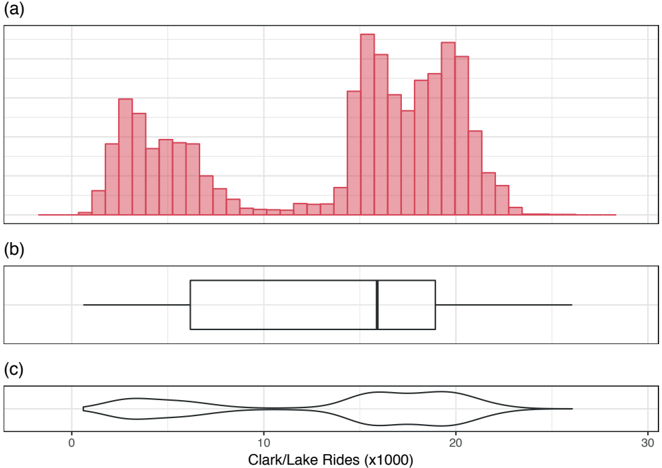
单变量可视化(univariate visualization)用于理解单个变量的分布。几种常见的单变量可视化包括箱线图(box-and-whisker plot,即 box plot)、小提琴图(violin plot)或直方图。虽然这些是简单的图形工具,但它们在理解所关注数量的特征方面具有巨大价值。
由于建模的首要目标是理解响应中的变异,第一步应该是理解响应的分布。对于像 Clark/Lake 车站客流量这样的连续响应,重要的是理解响应是否具有对称分布、分布是否具有较大观测值频率递减的特征(即分布是偏斜的(skewed))、分布是否看起来由两个或多个单独的分布组成(即分布具有多个峰或众数),或者是否出现异常低或异常高的观测值(即异常值(outlier))。
理解响应的分布及其变异,为模型性能的预期提供了一个下限。也就是说,如果模型包含有意义的预测变量,那么包含这些预测变量的模型的残差(residual)变异应小于响应本身的变异。此外,响应的分布可能表明响应应在分析之前进行变换。例如,如果响应的分布表现出频率随数值增大而按比例递减的特征,则可能表明响应服从对数正态分布(log-normal distribution)。在这种情况下,对响应取对数变换将产生正态(钟形、对称)分布,并且通常能使模型具有更好的预测性能。我们应该努力理解响应的第三个原因是,分布可能为包含或创建有助于解释响应的特征提供线索。
作为理解响应分布重要性的一个简单例子,请考虑图 4.2,它展示了 Clark/Lake 车站客流量的响应箱线图。箱线图最初由 John Tukey 开发,作为评估变量分布的快速方法(Tukey, 1977),由数据的最小值、下四分位数、中位数、上四分位数和最大值组成。箱线图的替代版本将须线延伸到某个值之外,超过该值的样本将被视为异常高(或低)(Frigge 等人, 1989)。具有对称分布的变量在各四分位数之间间距相等,使得箱体和须线看起来也是对称的。相反,在更宽的值域内取值较少的变量看起来则不对称。
图 4.2:2001 年至 2016 年 Clark/Lake 车站日客流量的箱线图。蓝色区域是箱体,代表数据的中间 50%。须线从箱体延伸出来,表示数据下 25% 和上 25% 的区域。
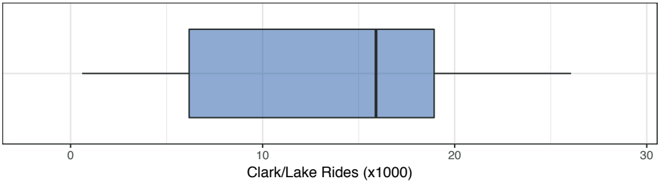
这些数据将在多个章节中进行分析。考虑到日客流量数值的范围,曾有人质疑结果应该以自然单位建模还是在对数尺度上建模。一方面,自然单位使结果的解释更容易,因为 RMSE 将以乘客人次为单位。然而,如果在建模之前对结果进行变换,则可以确保不会预测出负的客流量。这些数据的双峰性质,以及每年客流量分布右侧有更长尾部的事实,使这一决定变得困难。最终,我们以两种方式拟合了少量模型来做决定。以自然单位计算的模型似乎性能略好一些,因此所有模型都以自然单位进行分析。
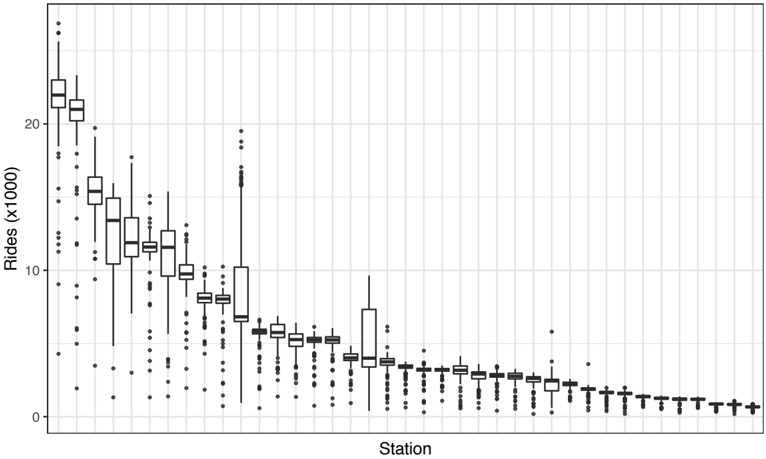
检查每个预测变量的分布有助于指导我们决定是否需要在分析之前通过变换来工程化特征。当我们有中等数量的预测变量(约少于 100 个)且预测变量处于同一数量级时,可以使用并排的箱线图或小提琴图同时可视化这些分布。再次考虑以两周滞后客流量作为预测变量的客流量数据。图 4.4 给出了 2016 年选定车站工作日客流量的分布。在这里,我们关注的是各车站客流量的变异性和范围。尽管之前有警告,但箱线图在刻画数据的这些方面表现良好。为了更清楚地看到模式,客流量按中位数从最大(左侧)到最小(右侧)排序。有几个特征很突出:客流量的变异性随中位数客流量增加而增大,每个车站都有一些异常低和异常高的值,少数车站的变异明显较大。有一个车站特别突出,大约位于从左起四分之一处。这个车站恰好是 Addison 车站,是距离瑞格利球场(Wrigley Field)最近的站点。其更宽的分布是由于芝加哥小熊队(Chicago Cubs)工作日主场比赛带来的客流量,其高峰期的客流量接近客流量最大的车站。如果目标是预测 Addison 车站的客流量,那么小熊队的主场比赛日程将是任何模型的重要信息。接下来将讨论大多数车站的异常低值。
图 4.3:2001 年至 2016 年 Clark/Lake 车站日客流量的分布。直方图 (a) 让我们看到客流量分布有两个峰或众数,表明可能有两种机制影响客流量。箱线图 (b) 无法看到数据中的多个峰。然而,小提琴图 (c) 提供了一种紧凑的可视化,能够识别出分布上的细微差别。
随着预测变量数量的增加,可视化单个分布的能力会减弱,甚至可能实际上无法实现。在这种情况下,可以使用这些技术来检查被认为重要的预测变量子集。
图 4.4:2016 年选定车站工作日客流量的分布。
4.2.2 通过分面、颜色和形状增强可视化
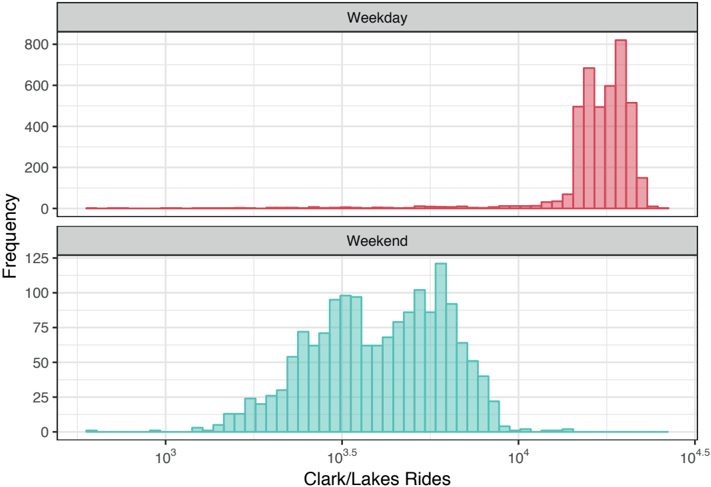
通过使用分面(faceting)、颜色和形状,几乎任何图形都可以添加额外的维度。分面是指创建相同类型的图(例如散点图),并根据某个变量将图分割成不同的面板。[39] 图 3.2 就是一个很好的例子。虽然这是一种简单的方法,但这类增强可以是发现重要模式的强大工具,这些模式可用于指导新特征的工程化。Clark/Lake 车站的客流量分布是添加另一个维度的绝佳候选。如上所示,图 4.3 有两个明显的峰。对此一个合理的解释是,工作日的客流量与周末不同。图 4.5 通过颜色和分面(为了便于可视化)按一周中的部分(part of the week)对客流量分布进行分区。一周中的部分并不是原始数据集中的预测变量;通过运用直觉并仔细检查分布,我们发现了一个对解释客流量重要且必要的特征,应该将其纳入模型。
图 4.5 促使我们进一步理解这些数据。仔细观察工作日客流量分布,我们的目光会被左侧的长尾吸引,这是一些客流量较低的日子(与周末客流量范围相近)造成的。什么会导致工作日客流量偏低?如果能够找出原因,就可以工程化一个特征。能够解释这些较低值的模型将比不能解释的模型具有更好的预测性能。
图 4.5:2001 年至 2016 年 Clark/Lake 车站日客流量的分布,按工作日和周末着色并分面。注意每个面板的 y 轴计数刻度不同,以及工作日数据中左侧的长尾。

在接下来的几个小节中,我们将演示如何使用颜色和形状来阐明预测信息。
4.2.3 散点图
通过分面、颜色或形状增强可视化是在图形中融入额外维度的一种方式。另一种方法是在图中直接添加一个维度。当处理两个数值变量时,这种图称为散点图。散点图将一个变量放在 x 轴上,另一个变量放在 y 轴上,然后将每个样本绘制在这个坐标空间中。我们可以使用这种图来评估预测变量与响应之间的关系、揭示预测变量对之间的关系,并理解新预测变量纳入模型是否有用。这些简单的关系是最先提供线索的,有助于工程化数据中可能无法直接获得的特征。
如果目标是预测 Clark/Lake 车站的客流量,那么我们可以预期,最近的过去客流量信息应该与当前客流量相关。也就是说,另一个值得考虑的潜在预测变量是前一天或前一周的客流量信息。因为我们知道工作日和周末的分布不同,一天的滞后对预测周一或周六的客流量用处较小。一周的滞后则没有这个困难(尽管在时间上相隔更远),因为信息发生在同一周的日子。由于我们的主要兴趣是提前两周预测客流量,我们将为 Clark/Lake 车站创建 14 天的客流量滞后。
图 4.6:Clark/Lake 车站 14 天滞后客流量与同一车站当日客流量之间的散点图。
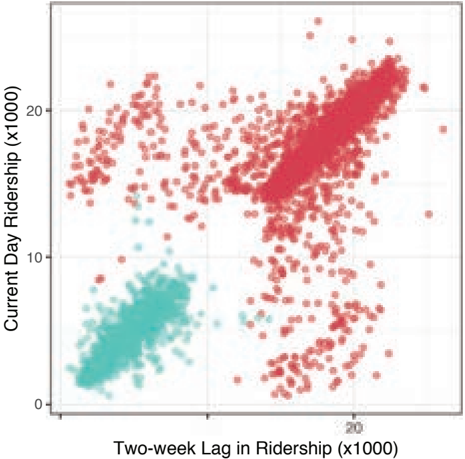
在这种情况下,可以通过创建散点图(图 4.6)直接理解这些变量之间的关系。该图突出了我们需要知道的几个特征:14 天滞后与当日客流量之间存在很强的线性关系;有两组截然不同的点(由于一周中的部分不同);还有许多 14 天滞后/当日配对的天数远远偏离点的整体散布。这些结果表明,14 天滞后将是解释当日客流量的关键预测变量。此外,找出偏离此处可视化整体模式的样本的解释,将催生一个对模型有用的新特征。
4.2.4 热图
如图 4.5 所示的工作日低客流量可能是由年度性事件造成的;为了调查这一假设,需要扩充数据。第一步是为客流量小于 10,000 或大于等于 10,000 的工作日创建一个指示变量(indicator variable)。然后我们需要一种可视化,让我们能够看到这些异常值何时出现。在这种情境下,能够阐明年度模式的可视化是热图。热图是一种用途广泛的图,几乎可以利用任何类型的预测变量来创建,它将一个预测变量显示在 x 轴上,另一个预测变量显示在 y 轴上。在该图中,x 轴和 y 轴的预测变量必须是可分类的。分类后的预测变量形成一个网格,网格由另一个变量填充。填充变量可以是连续的,也可以是分类的。如果是连续的,则网格中的方块在从填充预测变量最低值到最高值的连续尺度上着色。如果填充变量是分类的,则每个类别的方块都有不同的颜色。
对于客流量数据,我们将创建一个月日(month and day)预测变量、一个年份预测变量,以及一个工作日客流量小于 10,000 人次乘车的指示变量。
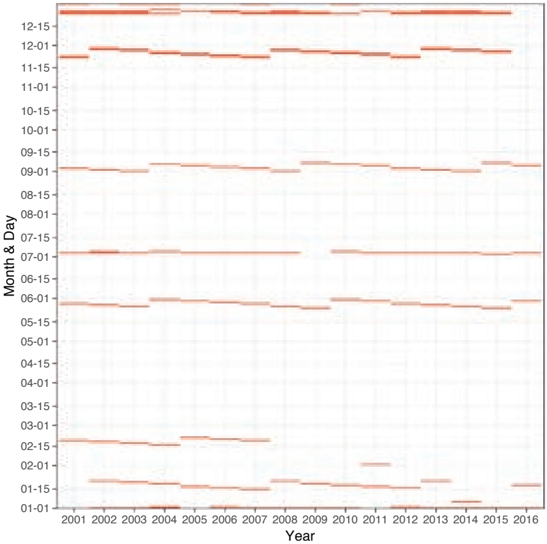
这些新特征是热图的输入(图 4.7)。在该图中,x 轴代表年份,y 轴代表月日。红色方块表示 Clark/Lake 车站客流量小于 10,000 的工作日。以这种形式呈现的数据热图带出了一些清晰的趋势。低客流量出现在年初前后、1 月中旬、2 月中旬(截至 2007 年)、5 月下旬、7 月上旬、9 月上旬、11 月下旬和 12 月下旬。美国读者会认出这些模式是经常观察到的假日。由于假日是事先已知的,为常见的工作日假日添加一个特征将有利于模型解释客流量。
仔细观察热图会发现两天不符合年度模式的日子:2011 年 2 月 2 日和 2014 年 1 月 6 日。这些异常是由极端天气造成的。2011 年 2 月 2 日,芝加哥创下了 −16°F 的低温纪录。随后在 2014 年 1 月 6 日,一场暴风雪给该地区带来了 21.2 英寸的降雪。极端天气事件并不频繁,因此在模型中加入这个预测变量的用处有限。如果未来极端天气的频率增加,那么使用预报数据可能成为解释客流量的宝贵预测变量。
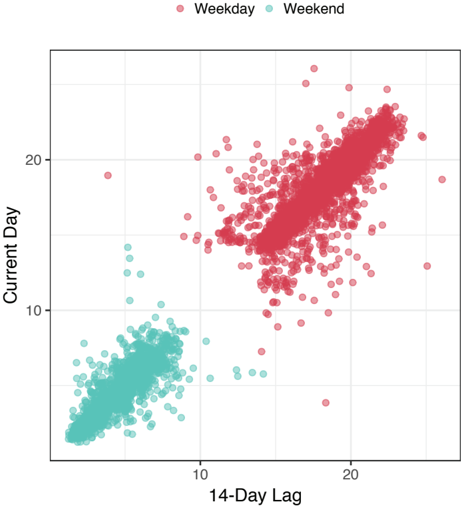
既然我们已经理解了美国主要假日的影响,这些值将从 14 天滞后与当日客流量的散点图(图 4.8)中排除。图 4.6 中大部分偏离对角线的点现在都消失了。然而,还有几个点保留下来。与这些点相关的日子是 2010 年 6 月 11 日,那是全市庆祝芝加哥黑鹰队(Chicago Blackhawks)赢得斯坦利杯(Stanley Cup)的日子。虽然这类庆祝活动并不频繁,但工程化一个特征来预判这些不寻常的事件,将有助于减少模型的预测误差。[40]
图 4.7:2001 年至 2016 年 Clark/Lake 车站工作日客流量小于 10,000 人次的乘车日的热图。该可视化表明,工作日低客流量的明显模式出现在美国主要假日当天及其前后。
4.2.5 相关矩阵图
散点图的一种扩展是相关矩阵图(correlation matrix plot)。在这种图中,每对变量之间的相关性以矩阵的形式绘制。每个变量都表示在矩阵的外侧 x 轴和外侧 y 轴上,相关性的强度由矩阵中相应位置的颜色表示。这种可视化最早出现在图 2.3 中。在这里,我们将为芝加哥数据构建一个类似的图:2016 年非假日工作日各车站 14 天滞后客流量的相关性。这些 14 天滞后预测变量的相关结构与原始(未滞后)预测变量几乎相同;使用滞后版本可以确保使用正确的行数。
图 4.9 中的相关矩阵带来了进一步的理解。首先,几乎所有车站对之间的客流量都呈正相关(红色);这意味着一个车站的低客流量对应另一个车站相对较低的客流量,一个车站的高客流量对应另一个车站相对较高的客流量。其次,大多数车站对之间的相关性极高。事实上,超过 18.7% 的预测变量对的相关性大于 0.90,3.1% 的相关性大于 0.95。高度的相关性清楚地表明,各车站之间存在的信息是冗余的,可以被消除或减少。可以使用第 3 章讨论的过滤(filtering)技术来消除预测变量。此外,通过降维(dimension reduction,第 6 章)进行特征工程,在类似情境下可能是数据的一种有效替代表示。我们将在第 4.2.7 节中将降维作为一种探索性可视化技术来讨论。
图 4.8:Clark/Lake 车站两周滞后日客流量与日客流量的对比图,已排除常见的美国假日,并按一周中的部分着色。
这个版本的相关图包含基于层次聚类分析(hierarchical cluster analysis)(Dillon 和 Goldstein, 1984)的行和列组织结构。聚类分析的总体目标是排列样本,使在测量空间中’接近’的样本在轴上的位置也彼此靠近。对于这些数据,任意两个车站之间的距离基于车站的相关值向量。因此,具有相似相关向量的车站在每个轴上的排列会彼此靠近,而具有不同相关向量的车站则会相距较远。x 轴和 y 轴上的树状结构称为树状图(dendrogram),它根据样本相关向量的接近程度将它们连接起来。这种组织结构有助于阐明一些视觉上截然不同的车站分组。这些分组反过来可能指向对解释客流量而言值得纳入模型的重要特征。
图 4.9:2016 年非假日工作日 14 天滞后客流量车站预测变量的相关矩阵可视化。车站使用层次聚类分析进行组织,组织结构使用树状图(顶部和右侧)可视化。
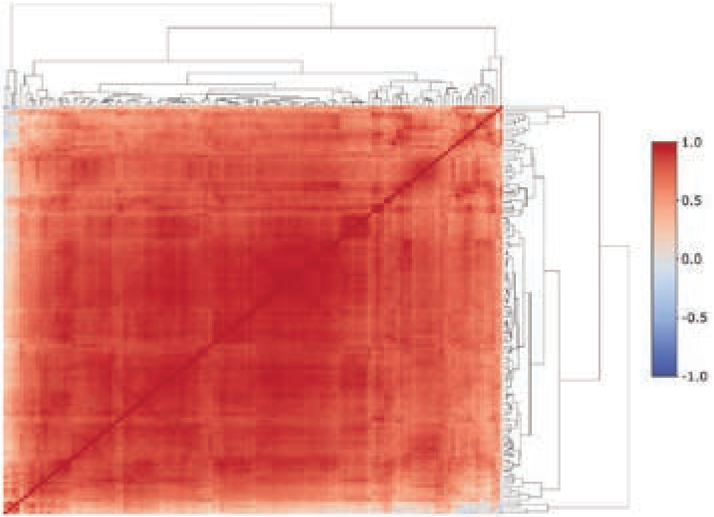
作为示例,请考虑 x 轴最左侧显示的车站,那里有一些低相关性和/或负相关性。该组中有一个车站与其他车站的中位相关性为 0.23。这个车站服务奥黑尔机场(O’Hare airport),是该地区两个主要机场之一。可以想象,这个车站的客流量驱动因素与其他车站不同。这里的客流量很可能受进出港航班时刻表的影响,而其他车站则不然。例如,该车站与同一线路上的 UIC-Halsted 车站呈负相关(−0.46)。第二不相似的车站是前面提到的 Addison 车站,因为它是由比赛观众驱动的。
4.2.6 折线图
随时间收集的变量在建模过程中带来了独特的挑战。这类变量很可能具有与时间渐增相关的趋势或模式。这意味着变量的当前值与近期值的关系比与时间上更远的值的关系更密切。因此,知道变量今天的值,对明天值的预测力将强于上周、上个月或去年的值。我们可以通过创建折线图来评估时间与变量值之间的关系,折线图是散点图的扩展。在折线图中,时间在 x 轴上,变量值在 y 轴上,相邻时间点的变量值用线连接。识别时间趋势可以带来其他特征,或工程化与响应相关的其他特征。芝加哥数据为折线图提供了一个很好的示例。
图 4.10:按年份划分的每月平均客流量,分为工作日(不含假日)和周末。

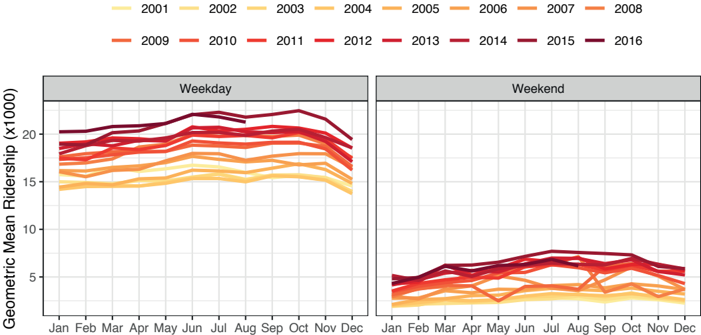
芝加哥数据是随时间收集的,因此我们还应该寻找由时间带来的潜在趋势。为了寻找这些趋势,我们计算了工作日和周末(分别)每月平均客流量(图 4.10)。在这里我们可以看到,自 2001 年以来,工作日和周末的客流量都稳步增长。这是合理的,因为芝加哥大都市区的人口在此期间有所增加(美国人口普查局, 2017)。折线图还揭示,在每一年内,客流量通常从 1 月到 10 月增加,然后到 12 月下降。这些发现意味着客流量信息的时间邻近性对模型应该是有用的。也就是说,了解最近一周或一个月内的客流量信息,对预测未来客流量更有用。
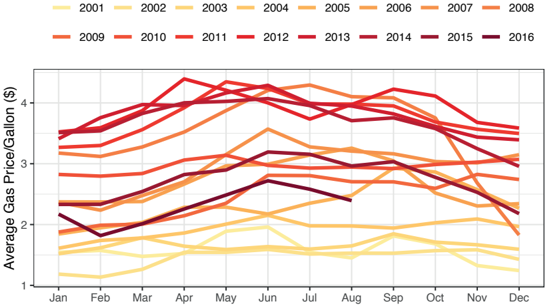
周末客流量也显示出年度趋势,但在某些年份的趋势内表现出更多的变异。揭示与这种增加的变异相关的预测变量,可能有助于减少预测误差。具体来说,周末折线图在 2008 年变异最大,夏季客流量明显更高。公共交通客流量增加的一个潜在驱动因素是汽油价格。我们从美国能源信息署收集了芝加哥地区的周度汽油价格,图 4.11 的折线图显示了按年份划分的月平均价格。
图 4.11:按年份划分的每月平均汽油价格(美元/加仑)。价格在 2008 年夏季飙升,这与周末客流量飙升的时间一致。
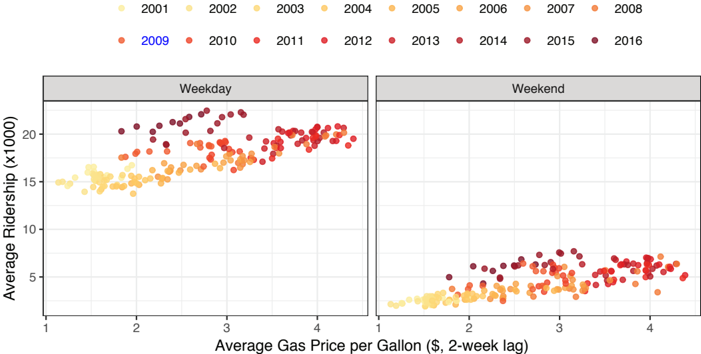
接下来,让我们看看能否在汽油价格和客流量之间建立关系。为此,我们将计算汽油价格的月平均两周滞后,以及 Clark/Lake 车站客流量的几何平均值。图 4.12 展示了这种关系;汽油价格的两周滞后与客流量的几何平均值之间存在正相关。从 2001 年到 2014 年,汽油价格越高,客流量越高,2008 年的数据出现在工作日和周末散点图的最右侧。2015 年和 2016 年的趋势略有不同,当时由于供应量显著增加,油价下跌(美国能源信息署, 2017b)。在这里我们可以看到,通过深入挖掘原始折线图的特征,可以发现另一个有助于解释客流量部分变异的特征。
4.2.7 主成分分析
通过使用颜色、形状和分面,可以在二维图中可视化数据的五六个维度。但如今几乎任何数据集包含的变量都远不止几个。能够在我们可以实际看到的物理空间中可视化许多维度,对于理解数据以及理解数据中是否存在指向特征工程需求的特性至关重要。将许多维度压缩为两三个维度的一种方法是使用投影技术,例如主成分分析(principal components analysis,PCA)、偏最小二乘(partial least squares,PLS)或多维缩放(multidimensional scaling,MDS)。以特征工程为目的的降维技术将在第 6.3 节中更全面地讨论。这里我们将重点介绍 PCA,以及如何使用该方法来工程化有效压缩原始预测变量信息的特征。
高度相关的预测变量(如图 4.9 所示的车站客流量)可以被认为存在于比原始数据更低维的空间中。也就是说,这里表示的数据可以近似地由相似车站的组合来表示。主成分分析寻找最能概括原始数据变异性的变量组合(Dillon 和 Goldstein, 1984)。这些组合是数据的更简单表示,通常能识别数据中潜在的特征,有助于指导特征工程过程。
图 4.12:每月平均两周滞后汽油价格(美元/加仑)与平均月度客流量的对比。汽油价格与客流量之间存在正相关关系,表明汽油价格可能有助于解释部分客流量变异。
现在将 PCA 应用于 14 天滞后的车站客流量数据。由于 PCA 的目标是最优地概括数据中的变异性,因此通过前几个主成分来汇总累积变异百分比。对于这些数据,第一个主成分捕获了总体变异性的 76.7%,而前两个主成分捕获了 83.1%。考虑到总共有 125 个车站,这是一个很大的变异百分比,表明车站客流量信息是冗余的,很可能可以用更紧凑的方式汇总。
图 4.13 提供了分析的总结。面板 (a) 显示了前 50 个主成分汇总的累积变异量。这种图用于直观地确定需要多少个主成分才能汇总数据中足够的变异。检查前两个主成分的散点图 (b) 可以发现,PCA 关注的是由一周中的部分引起的变异:工作日样本的主成分 1 得分较低,而周末样本的主成分 1 得分较高。第二个主成分关注的是随时间变化引起的变异:较早样本的主成分 2 得分较低,较晚样本的主成分 2 得分较高。这些模式在面板 (c) 和 (d) 中更清楚地显现出来,其中第一和第二主成分分别与似乎对它们影响最大的底层变量作图。
图 4.13:14 天车站滞后客流量的主成分分析。(a) 前 10 个主成分汇总的累积变异性。(b) 前两个主成分的散点图。第一个主成分关注由一周中的部分引起的变异,而第二个主成分关注由时间(年份)引起的变异。(c) 第一个主成分与 Clark/Lake 车站一周中每一天客流量的关系。(d) 第二个主成分与 Clark/Lake 车站每一年客流量的关系。
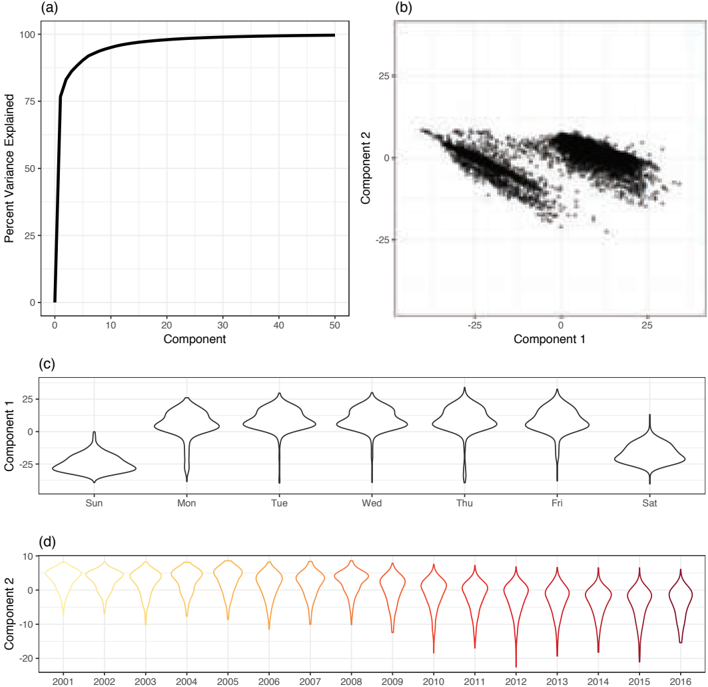
本章前面其他的可视化已经提醒我们一周中的部分和年份相对于响应的重要性。PCA 现在帮助确认了这些发现,并将促成新特征的创建,从而在保留关键预测信息的同时简化我们的数据。我们将在后面的第 6.3 节深入讨论这项技术和其他类似技术。
4.3 分类数据的可视化:探索 OkCupid 数据
为了说明定性数据的不同可视化技术,我们使用 OkCupid 数据。这些数据首次在第 3.1 节中介绍。回顾一下,训练集包含 38,809 份个人资料,目标是预测资料作者是否在 STEM 领域工作。事件率(event rate)为 18.5%,大多数预测变量本质上是分类的。这些数据将在下一章进一步讨论。
4.3.1 可视化结果与预测变量之间的关系
传统上,条形图(bar chart)用于表示分类值的计数。例如,图 4.14(a) 显示了所声明宗教的频率,并按结果类别分区和着色。这种图的优点是很容易看到频率最高和最低的类别。然而,除此之外,它还存在几个问题:
- 要理解是否有任何宗教与结果相关,读者需要目测判断所有宗教中每个深蓝色条形与对应浅蓝色条形的比率,然后确定是否有任何比率不同于随机偶然。该图按比率从最大(左侧)到最小(右侧)排序,这种形式可能让读者难以看清。
- 该图间接地展示了我们感兴趣的数据特征,即 STEM 与非 STEM 资料之间的频率比率。我们并不关心有多少印度教徒从事 STEM 领域;相反,印度教内部各领域的比率才是重点。换句话说,该图掩盖了我们感兴趣的统计假设:印度教 STEM 资料的比例是否与偶然预期的不同?
- 如果重点是宗教内部 STEM 资料的比例,条形图无法给出该数量的不确定性感。在这种情况下,不确定性来自两个来源。首先,每个宗教的资料数量显然会影响 STEM 资料比例的变异。这一点可以通过条形的高度来说明,但这并不是说明噪声的精确方式。其次,由于所关注的统计量是一个比例,当 STEM 资料的比例接近 50% 时(在其他条件相同的情况下),统计量的变异性会变大。
为了解决前两个问题,我们可以显示宗教内部 STEM 资料的百分比。图 4.14(b) 显示了条形图的这种替代版本,这是一个改进,因为现在重点是 STEM 资料的比例。宗教的排序方式更明显,我们也能看到每个宗教与 18.4% 基线率的偏差程度。然而,我们仍然没有说明不确定性。因此,我们无法评估未声明宗教的资料的比例是否真的与不可知论者不同。此外,虽然图 4.14(b) 直接比较了各宗教之间的比例,但它没有给出每个宗教频率的任何感觉。对于这些数据,伊斯兰教资料非常少;这一重要信息在这种显示中无法看到。
图 4.14:宗教与结果之间关系的三种不同可视化。
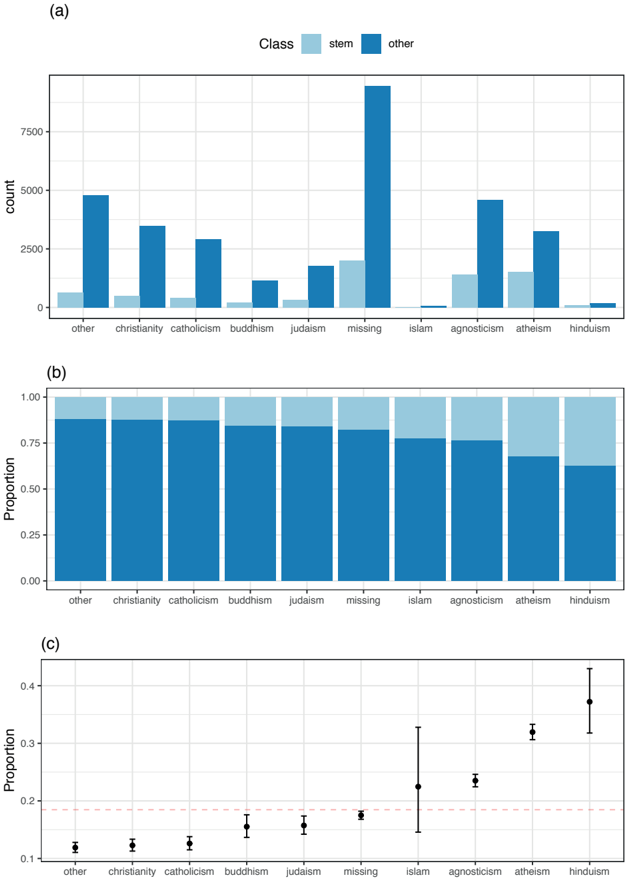
图 4.14(c) 解决了上面列出的所有三个问题。对于每个宗教,计算 STEM 资料的比例,并显示 95% 置信区间,以帮助理解该值周围的噪声。我们可以清楚地看到哪些宗教偏离了随机性,误差条(error bar)的宽度帮助读者理解每个数字在多大程度上值得信任。这张图是三张中最好的,因为它直接显示了差异的大小以及不确定性。在 x 轴类别数量较多的情况下,可以使用火山图(volcano plot)来显示结果(参见图 2.6 和图 5.4)。
这次讨论的重点不是带置信区间的汇总统计量总是可视化问题的解决方案。要点是每张图都应该有一个明确定义的假设,并且这个假设要以简洁的方式展示出来,使读者能够基于数据做出快速而有信息量的判断。
最后,宗教看起来与结果相关吗?由于各组之间 STEM 职业的比例存在梯度变化,看起来确实如此。如果没有关系,所有比例将大致相同。
如何可视化分类结果与数值预测变量之间的关系?作为示例,我们将使用所有个人资料短文的总长度来说明一种可能的解决方案。训练集中有 1,181 份资料没有填写任何开放式文本字段。在这个分析中,所有九个回答被拼接成一个文本字符串。文本长度的分布非常左偏,中位数为 1,862 个字符。最大长度约为 59K 字符,不过 10% 的资料包含的字符少于 444 个。为了调查这一点,图 4.15(a) 显示了短文字符总数的分布。x 轴是字符数的对数,没有短文文本的资料在此显示为零。两个类别之间的分布看起来极为相似,因此这个预测变量(单独来看)本身不太可能重要。然而,如上所述,最好还是尝试直接回答这个问题。
为此,使用另一种平滑器(smoother)来建模数据。在这种情况下,使用回归样条平滑器(regression spline smoother)(Wood, 2006)来建模 STEM 资料的概率与(对数)短文长度的函数关系。这涉及使用基展开(basis expansion)拟合逻辑回归(logistic regression)模型。这意味着我们原始的因子——对数短文长度——被用来创建一组进入逻辑回归模型的人工特征。这些预测变量的性质将允许类别概率在短文长度各取值上得到灵活、局部的表示,更多讨论见第 6.2.1 节。[41]
结果如图 4.15(b) 所示。黑色线代表逻辑回归模型的类别概率,带状区域表示拟合周围的 95% 置信区间。水平红线表示训练集中 STEM 资料的基线概率。在长度约 \(10^{1.5}\) 之前,资料成为 STEM 的概率略低于偶然水平。较大的资料显示概率增加。这可能看起来是一个值得纳入的预测变量,但请考虑 y 轴的尺度。如果放在完整的概率尺度 \([0, 1]\) 上,这个趋势看起来几乎是平坦的。最多,成为 STEM 资料的可能性增加几乎只有 3.5%。
图 4.15:短文长度对结果的影响。
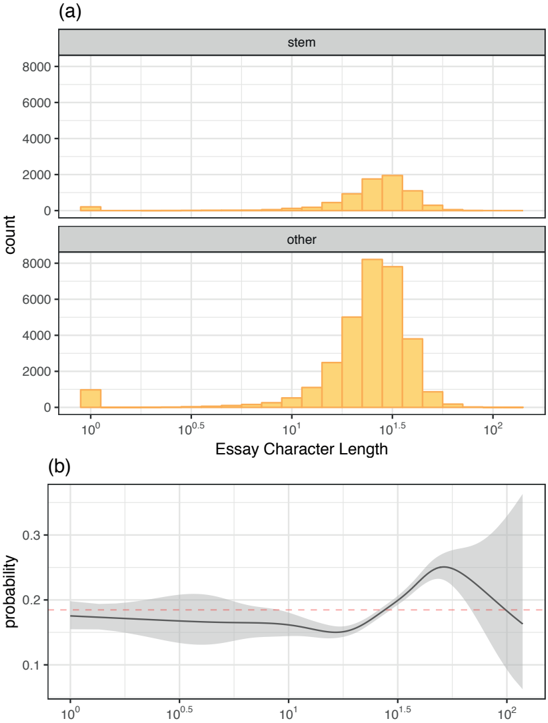
另外,请注意置信带在 \(10^{1.75}\) 附近迅速变宽,这主要是因为该范围内数据点数量减少,因此概率的潜在增加具有很高的不确定性。这个预测变量可能值得纳入模型,但不太可能单独表现出很强的效果。
4.3.2 探索分类预测变量之间的关系
在决定如何使用包含非数值数据的预测变量之前,理解它们的特征以及它们与其他预测变量的关系至关重要。一种常见的遗憾做法是依赖大量基于二维表(two-way table)的基础统计分析,将关系归结为数值汇总,例如关联的卡方检验(Chi-squared test,\(\chi^2\))。通常最好的方法是可视化数据。在考虑分类数据之间的关系时,有几种选择。一旦创建了变量之间的交叉制表(cross-tabulation),可以再次使用马赛克图来理解变量之间的关系。对于 OkCupid 数据,可以想象毒品和酒精使用的问卷可能是相关的,图 4.16 显示了这些变量的马赛克图。对于酒精,大多数数据表明是社交饮酒,而绝大多数毒品回答是’从不’(never)或缺失。这些变量之间有关系吗?是否有任何回答与其他回答’聚簇’?
图 4.16:OkCupid 数据中毒品与酒精数据的马赛克图。
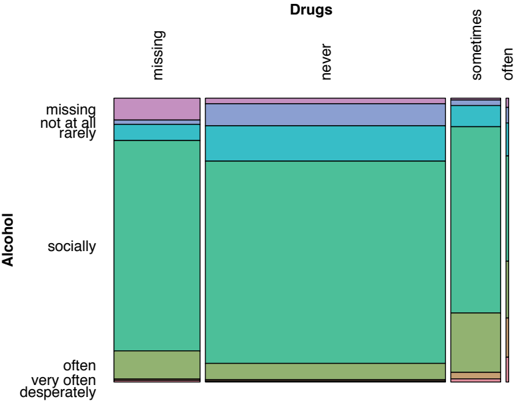
这些问题可以使用对应分析(correspondence analysis)(Greenacre, 2017)来回答,它分析交叉制表。在列联表(contingency table)中,变量的频率分布可用于确定期望单元格计数(expected cell count),它们模拟两个变量没有关系时会出现的情况。传统的 \(\chi^2\) 检验利用与这些期望值的偏差来评估变量之间的关联,方法是累加这类单元格残差的函数。如果表中的两个变量强关联,则总体 \(\chi^2\) 统计量会很大。对应分析不是累加这些残差函数,而是分析它们以确定占这些统计量最大比例的新变量。[42] 这些新变量称为主坐标(principal coordinates),可以为表中的两个变量计算,并显示在同一张图中。这些图可以包含几个特征:
- 每个轴上的数据将根据主坐标占原始表格信息量的多少来评估。如果某个坐标只捕获了总体 \(\chi^2\) 统计量的一小部分,则不应过度解读该方向显示的模式。
- 落在原点附近的类别代表数据的’平均’值
从马赛克图可以清楚地看到,每个变量都有一些单元格频率最大的类别(例如,毒品’从不’和酒精’社交’饮用)。更不寻常的类别位于主坐标散点图的边缘。
- 单个变量的主坐标彼此接近的类别表明存在冗余,意味着可能可以合并这些组。
- 在主坐标空间中彼此靠近的不同变量的类别表明这些类别之间存在关联。
在酒精使用与毒品使用的交叉制表中,\(\chi^2\) 统计量(4114.2)相对其自由度(18)非常大,并且与非常小的 p 值(0)相关。这表明这两个变量之间存在强关联。
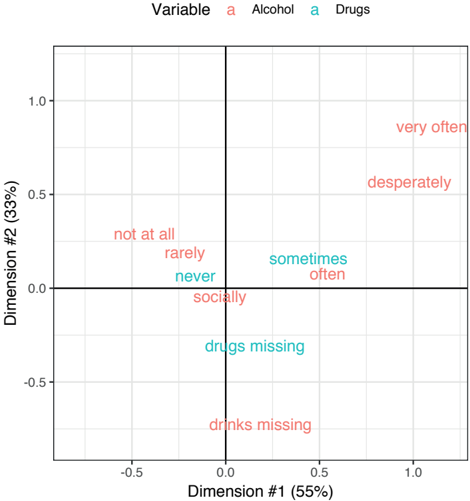
图 4.17 显示了对应分析的主坐标。x 轴上的成分占 \(\chi^2\) 统计量的一半以上。该维度上接近零的值往往表示没有做出选择或物质使用是零星的。向右远离零的是较少出现的值。一个小聚簇表明偶尔使用毒品和频繁饮酒在数据中往往具有特定的关联。另一个更极端的聚簇显示,非常频繁地使用酒精与使用毒品之间存在关联。图的 y 轴主要由缺失数据驱动(这可以理解,因为表中 25.8% 的单元格至少有一个缺失回答),并占 \(\chi^2\) 统计量的另外三分之一。这些结果表明,这两个变量的结果相似,可能测量的是同一个潜在特征。
图 4.17:OkCupid 数据中毒品与酒精数据的对应分析主坐标。
4.4 建模后的探索性可视化
如第 3.2.2 节所述,重采样期间产生的评估(assessment)数据上的预测可用于理解模型的性能。它还可以指导建模者通过可视化和分析理解接下来可以做出的一系列改进。这里使用轨道交通客流量数据来说明这一过程。
多元线性回归(multiple linear regression)有丰富的基于模型残差的诊断方法,有助于理解模型拟合,并识别可能值得纳入模型的关系。虽然多元线性回归在预测性能上落后于其他建模技术,但其可用的诊断方法是了不起的工具,在揭示预测变量和预测变量关系方面不应被低估,这些发现可以使更复杂的建模技术受益。
回归诊断中一个有助于识别有用预测变量的工具是偏回归图(partial regression plot)(Neter 等人, 1996)。这种图利用两个不同线性回归模型的残差来挖掘预测变量在模型中的潜在有用性。开始这一过程时,我们首先拟合以下模型并计算残差(\(\epsilon_i\)):
\[ y_i = \beta_0 + \beta_1 \text{week}_i + \beta_2 \text{month}_i + \beta_3 \text{year}_i + \epsilon_i \](译者注:原书该公式在 docling 提取中未解码,此处按后文描述——基模型包含周(week)、月(month)和年(year)预测变量——重建。)
接下来,我们选择一个不在模型中的预测变量,但它可能包含与响应相关的额外预测信息。对于这个潜在预测变量,我们然后拟合:
\[ x_i = \beta_0 + \beta_1 \text{week}_i + \beta_2 \text{month}_i + \beta_3 \text{year}_i + \eta_i \](译者注:原书该公式在 docling 提取中未解码,此处按偏回归图的标准做法——将潜在预测变量对基模型的预测变量回归——重建。)
然后,来自两个模型的残差(\(\epsilon_i\) 和 \(\eta_i\))在简单的散点图中相互绘制。这两组残差之间的线性或曲线模式表明,将新预测变量作为线性或二次(或其他非线性变体)项加入模型将是有用的补充。
如前所述,当残差值只是通过对训练集数据进行简单预测而得到时,通过残差检查模型拟合是有问题的。更好的策略是使用重采样期间创建的各种评估集的残差。
对于芝加哥数据,使用滚动预测起点(rolling forecast origin)方案(第 3.4.4 节)进行重采样。训练集中有 5,698 个数据点,每个代表一天。这里使用的重采样包含 2014 年 9 月 1 日之前的基础样本集,分析/评估划分从该日期开始。这样做时,分析集会累积增长;一旦某个评估集被评估,它会在下一轮重采样中放入分析集。每个评估集包含分析集中最后一个值之后紧接的 14 天。因此,共有 52 个重采样,每个评估集都是最新日期的互斥集合。该方案旨在模拟数据将被重复分析的方式;一旦捕获一组新数据,就用之前的数据训练模型,新数据作为测试集。图 4.18 展示了前几个重采样的示意图。左侧的箭头表示完整的分析集从 2001 年 1 月 22 日开始。
图 4.18:芝加哥 L 数据使用的重采样方案示意图。左侧的箭头表示分析集始于 2001 年 1 月 22 日。右侧的红色条形表示滚动的两周评估集。
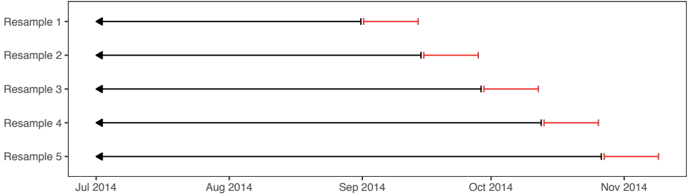
对于使用这种方案拟合这些数据的任何模型,14 组残差的集合可用于理解模型的优缺点,且过拟合风险最小。此外,由于评估集随时间块移动,它还可以让分析师了解模型在一年中的哪些特定时段表现不佳。
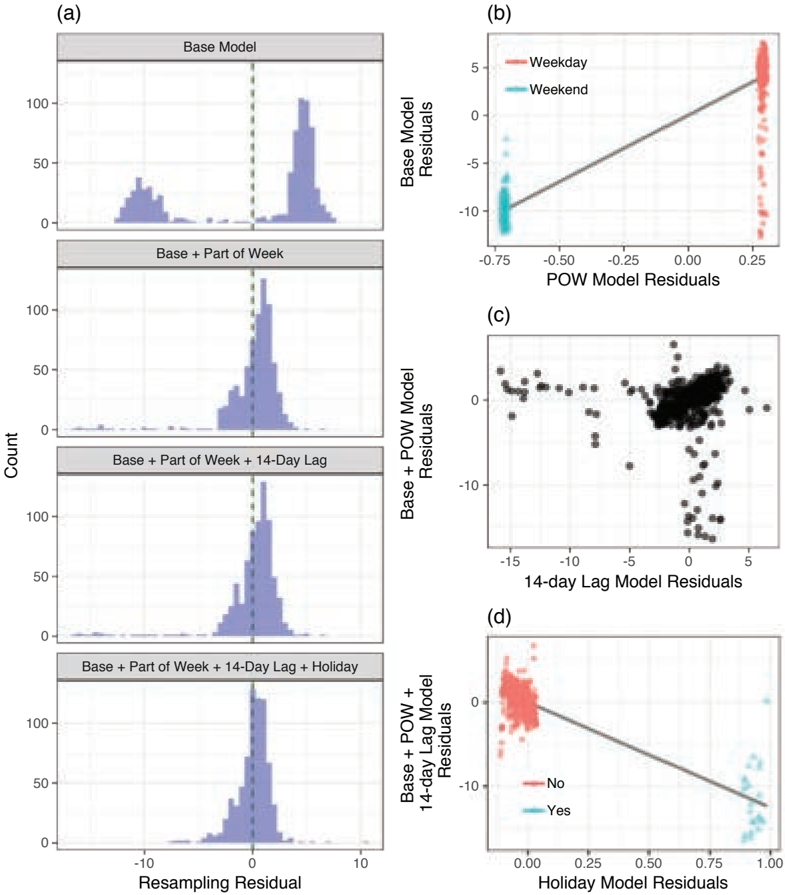
回归模型的响应是 Clark/Lake 车站的客流量,我们的初始模型将包含周(week)、月(month)和年(year)预测变量。该模型的留出(hold-out)残差分布见图 4.19(a)。正如我们在本章前面看到的,分布有两个峰,我们发现这是由于一周中的部分(工作日与周末)造成的。为了调查一周中的部分的重要性,我们将基础预测变量对一周中的部分进行回归,并计算该模型的留出残差。两组留出残差之间的关系见 (b),它展示了非随机关系,表明一周中的部分包含对 Clark/Lake 车站客流量的额外预测信息。我们可以看到,在模型中包含一周中的部分会进一步减小残差分布,如标记为’Base + Part of Week’(基础 + 一周中的部分)的直方图所示。
接下来,让我们探索 Clark/Lake 车站 14 天客流滞后量的重要性。图的 (c) 部分展示了在 Clark/Lake 车站客流模型中包含 14 天滞后量的重要性。在这部分图中,我们看到数据主流中模型残差之间存在很强的线性关系,只有少数几天落在整体模式之外。这些天恰好是这一时期内的假日。假日的潜在预测重要性反映在 (d) 部分。在这张图中,读者的目光可能会被一个远离其他假日样本的假日吸引。事实证明,这个样本是 2015 年 7 月 4 日,是训练数据中唯一既是假日又是周末的日子。由于模型已经解释了一周中的部分,这一天是假日这一额外信息对该样本的预测值几乎没有影响。
图 4.19:(a) 模型重采样过程中基础模型以及基础模型加上其他潜在有用预测变量(用于解释 Clark/Lake 车站客流量)的残差分布。(b) 一周中的部分效应的偏回归图。(c) Clark/Lake 车站 14 天滞后预测变量的偏回归图。(d) 假日分类的偏回归图。
4.5 总结
先进的预测建模和机器学习技术具有诱人的吸引力:分析师几乎不费力气就能提取预测变量与响应之间的复杂关系。这种不干预的建模方式只会让分析师处于不利地位。花时间可视化响应、预测变量、预测变量之间的关系以及预测变量与响应之间的关系,只会带来对数据更好的理解。此外,这些知识可能提供关键洞见,帮助了解数据中可能缺失哪些特征,以及可能需要纳入哪些特征来提高模型的预测性能。
数据可视化是特征工程的基础工具。下一章将以此为基础,开始分类预测变量的特征工程开发。
4.6 计算
网站 http://bit.ly/fes-eda 包含用于重现这些分析的 R 程序。
脚注
[36] http://bit.ly/FES-Chicago
[37] 所选择的站点不含缺失值。更多细节参见第 8.5 节。
[38] 另一种替代方案是直接从整个训练集计算这些条件的每日平均值。
[39] 这种可视化方法在不同的软件中也称为"分面"(trellising)或"条件化"(conditioning)。
[40] 这确实给本分析带来了一个有趣的困境:是否应该允许这样一个异常样本潜在地影响模型?我们保留了该值不动,但完全可以论证应该用先前数据的推算值替代,并在分析中使用该值。
[41] 还有其他类型的平滑器可用于发现数据中潜在的非线性模式。其中一种称为 loess(局部加权回归),非常有效,它使用一系列跨预测变量值的移动回归线在特定点进行预测(Cleveland, 1979)。
[42] 其机制与第 6 章讨论的主成分分析(PCA)非常相似。例如,两者都使用奇异值分解(singular value decomposition)来计算新变量。