预测建模过程回顾
在深入具体的建模方法和技术之前,有一些必要的话题应该先讨论和定义。这些话题对于经验建模来说相当通用,包括:测量回归和分类问题性能的指标、最优数据使用的方法(包括数据划分和重采样)、模型调优的最佳实践,以及比较模型性能的建议。
本章使用两个数据集来说明这些技术。第一个是第 1 章中首次介绍的艾姆斯住房价格数据。第二个数据集专注于根据在线约会网站的信息对一个人的职业进行分类。这些数据将在下一节讨论。
3.1 示例:OkCupid 个人资料数据
OkCupid 是一个服务国际用户的在线约会网站。Kim 和 Escobedo-Land (2015) 描述了一个数据集,其中旧金山地区超过 50,000 份个人资料被公开,[15] 数据可以在 GitHub 仓库中找到。[16] 数据包含几种类型的变量:
- 与个人兴趣和个人描述相关的开放式文本短文,
- 单选类型字段,如职业、饮食和教育,
- 多选字段,如所讲语言和编程语言的熟练程度。
在原始形式下,几乎所有的原始数据字段本质上都是离散的;只有年龄和距离上次登录的时间是数值型的。分类预测变量在拟合模型之前被转换为哑变量(第 5 章)。在本章对这些数据的分析中,开放式文本数据将被忽略,但将在后面(第 5.6 节)进行探讨。在使用的 212 个预测变量中,有地理位置(即城镇,p = 3)、宗教派别(p = 13)、星座(p = 15)、子女情况(p = 15)、宠物(p = 15)、收入(p = 12)、教育(p = 32)、饮食(p = 17)等变量簇,以及 50 多个与所讲语言相关的变量。关于这个数据集及其处理方式的更多信息,请参见本书的 GitHub 仓库。
对于这个演示,目标将是预测一个人的职业是否属于 STEM 领域(科学、技术、工程和数学)。这些数据存在中等程度的类别不平衡(class imbalance);只有 18.5% 的资料显示从事这些领域的工作。虽然不平衡对分析有显著影响,但这里的演示将在很大程度上回避这个问题,通过对实例进行下采样(down-sampling),使每个类别中的资料数量相等。关于处理稀有类别的技术的详细描述,请参见 Kuhn 和 Johnson (2013) 的第 16 章。
3.2 测量性能
虽然经常被忽视,但用于评估模型预测结果有效性的指标非常重要,会影响结论。我们选择用来评估模型性能的指标取决于结果,下面的小节描述了使用的主要统计量。
3.2.1 回归指标
当结果是一个数值时,最常用的指标是均方根误差(root mean squared error,RMSE)。要计算这个值,需要构建一个模型,然后用它来预测结果。残差(residual)是观测结果与预测结果值之间的差。要得到模型的 RMSE,先计算平方残差的平均值,再取这个值的平方根。取平方根使指标回到原始的测量单位。我们可以把 RMSE 看作样本从观测值到预测值的平均距离。简而言之,RMSE 越低,模型预测样本结果的能力越好。
另一个流行的指标是决定系数(coefficient of determination),通常称为 R²。计算这个值有几种公式(Kvalseth, 1985),但概念上最简单的一种是找到观测值与预测值之间的标准相关(即 R),然后取其平方。这个统计量的好处是,对于线性模型,它有直接的解释:R² 是结果中能被模型解释的总变异(total variability)的比例。接近 1.0 的值表示几乎完美的拟合,而接近零的值则来自预测与结果没有线性关联的模型。这个数字的另一个优点是它无单位,便于对不同结果进行比较。
不幸的是,R² 可能是一个具有欺骗性的指标。主要问题是它是相关性的度量,而不是准确性的度量。在评估模型的预测能力时,我们需要知道观测值和预测值的一致性(agree)如何。模型产生的预测值与观测值有很强的线性关系,但预测值不符合 45 度一致性直线(观测值与预测值相等的位置),这是可能的,也并不罕见。这种现象的一个例子是,模型在结果的一个极端处欠预测,而在结果的另一个极端处过预测。基于树的集成方法(如随机森林、提升树等)以这类预测而闻名。使用 R² 作为性能指标的第二个问题是,当结果方差很大时,它会显示出非常乐观的结果。最后,如果有一小部分结果值远离观测值和预测值的整体散点,R² 也可能产生误导。在这种情况下,这一小部分点会人为地提高 R²。
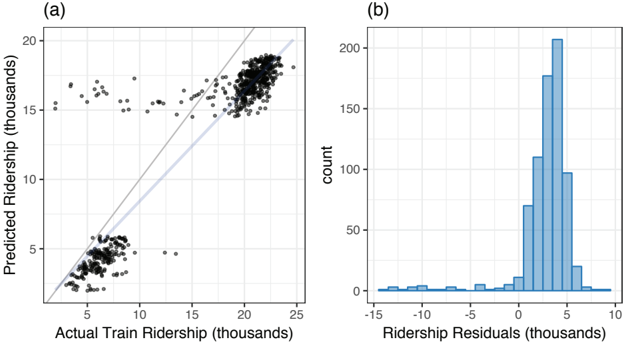
为了说明 R² 的问题,让我们看看芝加哥轨道交通客流量数据的一个特定模型的结果。对于这个模型,R² 估计为 0.9;从表面上看,我们可能会认为这是一个非常好的模型。然而,这个高值主要归因于客流量的固有性质:工作周期间客流量高,周末相应较低。结果的双峰性质夸大了结果方差,进而夸大了 R²。我们可以在图 3.1(a) 中看到双峰结果的影响。图 (b) 部分显示了残差的直方图,其中一些大于 10K 次乘车。该模型的 RMSE 为 3,853 次乘车,相对于观测到的客流量值来说有些偏大。
使用 R² 的问题的第二个说明可以通过检查图 3.1(a) 中的蓝色和黑色线看到。蓝线是观测值与预测值之间的线性回归拟合,而黑线代表一致性直线。在这里我们可以看到,模型对较小的观测值(左侧)欠预测,对较大的观测值(右侧)过预测。在这种情况下,偏移并不大,但它确实说明了 RMSE 和 R² 指标如何产生不一致的结果。由于这些原因,我们建议使用 RMSE 而不是 R²。
为了解决相关系数在数据表现出相关性而非一致性时过于乐观的问题,Lawrence 和 Lin (1989) 开发了一致性相关系数(concordance correlation coefficient,CCC)。这个指标提供了相对于一致性直线的相关性度量,定义为通常的相关系数与来自一致性直线的偏差度量之积。偏差系数范围从 0 到 1,其中值为 1 表示数据落在一致性直线上。数据偏离一致性直线越远,偏差系数越小。因此,CCC 可以被认为是相关系数的惩罚版本。如果数据在观测值和预测值之间表现出较差的相关性,或者观测值与预测值之间的关系远离一致性直线,惩罚就会生效。
图 3.1:芝加哥轨道交通客流量的观测值与预测值(单位:千,面板 (a)),以及相应模型残差(观测值减预测值)的直方图(面板 (b))。在面板 (a) 中,蓝线对应观测值与预测值之间的线性回归线,而黑线代表一致性直线。
RMSE 和 R² 都对极端值非常敏感,因为两者都基于单个样本残差的平方值。因此,一个残差很大的样本会对最终汇总度量产生异常大的影响。一般来说,这类情况会使模型性能指标看起来比没有该样本时更差。取决于手头的问题,这种脆弱性不一定是缺点,也可能是优点。例如,如果建模问题的目标是对新数据点进行排序(如消费最高的客户),那么只要最极端的值被预测为最极端的,残差的大小就不是问题。然而,更多的情况是,我们感兴趣的是预测实际的响应值,而不仅仅是排名。在这种情况下,我们需要不被一个或一小撮极端值扭曲的指标。稳健性(robustness)领域就是为研究极端值(即异常值(outlier))对常用统计指标的影响而发展起来的,并推导出达到同样目的但对异常值影响不敏感的替代指标(Hampel 等人, 1972)。作为宽泛的描述,稳健技术寻求为大多数数据找到数值汇总。为了减轻极端值的影响,稳健方法会降低极端样本的权重,或者以某种方式变换原始值,使极端样本更接近大多数数据。对样本进行排序就是一种减少极端值影响的变换。在预测客户消费的假设案例中,秩相关(rank correlation)可能是更好的模型指标选择,因为它衡量预测与其真实值的排序一致程度。这个统计量计算数据的秩(如 1、2 等),并从这些值计算标准相关统计量。回归的其他稳健度量包括中位数绝对偏差(median absolute deviation,MAD)(Rousseeuw 和 Croux, 1993)和绝对误差(absolute error)。
3.2.2 分类指标
当结果是一组离散值(即定性数据)时,可以使用两种不同类型的性能指标。下面描述的第一种类型基于定性的类别预测(如 stem 或 other),而第二种类型使用预测的类别概率来衡量模型有效性(如 Pr[stem] = 0.254)。
给定一组预测类别,理解模型工作效果的第一步是创建混淆矩阵(confusion matrix),它是观测类别和预测类别的简单交叉制表。对于 OkCupid 数据,使用上述预测变量集构建了一个简单的逻辑回归模型,表 3.1 显示了由此产生的混淆矩阵。[17]
表 3.1:一个 OkCupid 模型的混淆矩阵。列是真类别,行对应预测。
| stem | other | |
|---|---|---|
| stem | 5134 | 6385 |
| other | 2033 | 25257 |
被正确预测的样本位于表格的对角线上。被错误预测为非 STEM 的 STEM 资料显示在表格的左下角(n = 2033),而被错误预测的 non-STEM 资料位于右上角单元格(n = 6385)。使用最广泛的指标是分类准确率(classification accuracy),它只是被正确预测的结果比例。在这个例子中,准确率为 0.78 = (5134 + 25257)/(5134 + 6385 + 2033 + 25257)。有一种隐含的倾向是,通过将观测到的准确率值与 1/C(C 是类别数)进行比较来评估模型性能。在这种情况下,0.78 远大于 0.5。然而,这种比较只应在每个类别中的样本数量几乎相同的时候进行。当类别之间存在不平衡时(就像这些数据一样),准确率可能是一个相当具有欺骗性的模型性能度量,因为将所有资料都预测为 non-STEM 就可以达到 0.82 的值。
作为准确率的替代方案,另一个称为科恩卡帕系数(Cohen’s Kappa)(Agresti, 2012)的统计量可用于考虑类别不平衡。这个指标将错误率按偶然预期的水平进行归一化。Kappa 取值介于 -1 和 1 之间,其中值为 1 表示观测值和预测值完全一致(因此准确率完美)。值为 -1 表示完全不一致,很少见到。[18] 接近零的值表示模型预测与真实结果之间没有关系。Kappa 统计量也可以推广到多于两个组的问题。
可以用于混淆矩阵的可视化技术是马赛克图(mosaic plot)(见图 3.3)。在这些图中,表格的每个单元格表示为一个矩形,其面积与单元格中的数值数量成正比。这些图可以用多种不同的方式渲染,适用于各种尺寸的表格。更多示例参见 Friendly 和 Meyer (2015)。
当结果有两个类别时,还有一组专门的分类指标。要使用它们,必须将其中一个类别值指定为关注事件(event of interest)。这有点主观。在某些情况下,这个值可能是最坏情况(即死亡),但指定的事件应该是你最感兴趣预测的值。
第一类分类指标范式聚焦于假阳性和假阴性,在有兴趣比较两类错误时最有用。敏感性(sensitivity)指标就是被正确预测的事件比例,即数据中的真阳性率(true positive rate)。对于我们的例子:
\[ \text{敏感性} = \frac{TP}{TP + FN} = \frac{5134}{5134 + 2033} = 0.72 \]假阳性率(false positive rate)与特异性(specificity)相关,即:
\[ \text{特异性} = \frac{TN}{TN + FP} = \frac{25257}{25257 + 6385} = 0.798 \](译者注:原书上述公式在 docling 提取中未解码,此处按表 3.1 数值与后文"假阳性率为 0.202"等描述重建。)
假阳性率为 1 − 特异性(本例中为 0.202)。
两类系统的另一个范式植根于信息检索(information retrieval)领域,其目标是找到事件。在这种情况下,常用的指标是精确率(precision)和召回率(recall)。召回率等同于敏感性,关注模型找到的真事件数量。精确率是预测正确的事件占预测事件总数的比例,即:
\[ \text{精确率} = \frac{TP}{TP + FP} = \frac{5134}{5134 + 6385} = 0.446 \]敏感性、特异性和精确率有一个值得理解的方面:它们都是条件统计量(conditional statistic)。例如,敏感性反映的是,在样本确实是事件的前提下,事件被正确预测的概率。这句话的后半部分显示了该指标的条件性质。当然,真实类别通常是未知的,如果已知,就不需要模型了。无论如何,如果 Y 表示真实类别,P 表示预测,我们可以把敏感性写成 Pr[P = STEM | Y = STEM]。
人们真正想知道的问题是:“如果我的值被预测为事件,它真正是事件的可能性有多大?“即 Pr[Y = STEM | P = STEM]。幸运的是,贝叶斯分析(Bayesian analysis)(McElreath, 2015)领域对这个问题有答案。在这种背景下,贝叶斯法则(Bayes’ Rule)指出:
\[ \Pr[Y = \text{STEM} \mid P = \text{STEM}] = \frac{\Pr[P = \text{STEM} \mid Y = \text{STEM}] \cdot \Pr[Y = \text{STEM}]}{\Pr[P = \text{STEM}]} \]敏感性(或特异性,取决于视角)是这个方程的"似然"部分。先验概率(prior probability),或患病率(prevalence),是我们在现实世界中看到事件的总体比率(可能与我们在训练集中观测到的不同)。通常,人们会在收集数据之前指定总体事件率,并在计算中使用它来确定无条件统计量。对于敏感性,其无条件的对应物称为阳性预测值(positive predictive value,PPV):
\[ PPV = \frac{\text{敏感性} \times \text{患病率}}{\text{敏感性} \times \text{患病率} + (1 - \text{特异性}) \times (1 - \text{患病率})} \]阴性预测值(negative predictive value,NPV)是特异性的对应物,可以计算为:
\[ NPV = \frac{\text{特异性} \times (1 - \text{患病率})}{(1 - \text{敏感性}) \times \text{患病率} + \text{特异性} \times (1 - \text{患病率})} \]关于这些度量的清晰简洁的讨论,参见 Altman 和 Bland (1994b)。此外,这些统计量经常显示假定患病率为 0.50 的简化版本公式。这些公式在患病率为 0.50 时是正确的,但如果患病率不同于这个数字,就会产生非常误导性的结果。
对于 OkCupid 数据,敏感性和 PPV 之间的区别是:
- 敏感性:如果资料确实是 STEM,它被正确预测的概率是多少?
- PPV:如果资料被预测为 STEM,它是 STEM 的概率是多少?
阳性和阴性预测值并不经常用来衡量性能。这部分是由于患病率的性质。如果对结果没有很好的理解,很难提供一个值(即使询问专家)。当有足够的数据时,患病率通常由结果数据中对应于关注事件的比例来估计。此外,在其他情况下,患病率可能取决于某些因素。例如,旧金山地区 STEM 资料的比例可以从训练集中估计为 0.18。使用这个值作为患病率,我们的估计是 PPV = 0.45 和 NPV = 0.93。PPV 明显小于敏感性,因为模型漏掉了近 28% 的真正 STEM 资料,而且属于 STEM 领域的总体可能性已经相当低。
表 3.2:用于分类模型的典型基于概率的度量比较。这里的计算假设类别 1 是真实类别。
| 类别 1 | 类别 2 | 对数似然 | Gini | 熵 | |
|---|---|---|---|---|---|
| 模棱两可的模型 | 0.5 | 0.5 | -0.693 | 0.25 | 1.000 |
| 好模型 | 0.8 | 0.2 | -0.223 | 0.16 | 0.722 |
| 差模型 | 0.2 | 0.8 | -1.609 | 0.16 | 0.722 |
旧金山 STEM 职业人群的患病率很可能高于美国其他地区。如果我们认为美国整体的 STEM 患病率约为 5%,那么我们的估计将变为 PPV = 0.16 和 NPV = 0.98。这些计算仅因患病率估计而异,并展示了较小的患病率如何影响结果的无条件概率。
到目前为止讨论的指标依赖于有硬性预测(如 STEM 或 other)。大多数分类模型可以产生类别概率作为软预测,通过选择概率最大的类别可以转换为确定的类别。可以使用这些概率创建许多指标。
对于两类问题,一个示例指标是二项对数似然统计量(binomial log-likelihood statistic)。为了说明这个统计量,让 i 表示样本的索引,其中 i = 1, 2, …, n,让 j 表示结果类别数量的数值,其中 j = 1, 2。接下来,我们用 y_ij 表示第 i 个样本真实类别的指示变量。也就是说,如果第 i 个样本在第 j 类中,y_ij = 1,否则为 0。最后,让 p_ij 表示第 i 个样本在第 j 类中的预测概率。然后对数似然(log-likelihood)计算为:
\[ \log L = \sum_{i=1}^{n} \sum_{j=1}^{C} y_{ij} \log(p_{ij}) \]其中对于两类问题 C = 2。一般来说,我们希望最大化对数似然。如果所有样本都以高概率被预测到正确类别,这个值将被最大化。
在类别概率上常用的另外两个指标是基尼准则(Gini criterion)(Breiman 等人, 1984):
\[ \text{Gini} = \sum_{j=1}^{C} y_{ij} p_{ij} (1 - p_{ij}) \]和熵(entropy,H)(MacKay, 2003):
\[ H = -\sum_{j=1}^{C} p_{ij} \log_2(p_{ij}) \]与对数似然统计量不同,这两个指标都是类别概率中方差或不纯度(impurity)的度量,[19] 应该被最小化。
在这三个指标中,重要的是要注意,似然统计量是唯一使用真实类别信息的指标。正因为如此,它以一种有监督的方式惩罚差的模型。Gini 和熵统计量只会惩罚模棱两可的模型(即产生大致相等的类别概率的模型)。例如,表 3.2 显示了一个两类示例。如果真实结果是第一类,第二行显示的模型结果是最好的。似然统计量只考虑"类别 1"这一列,因为这是 y_ij = 1 的唯一一列。就似然统计量而言,模棱两可的模型比自信地预测错误类别的模型表现更好。在考虑 Gini 和熵时,模棱两可的模型表现最差,而好模型和差模型是等价的。[20]
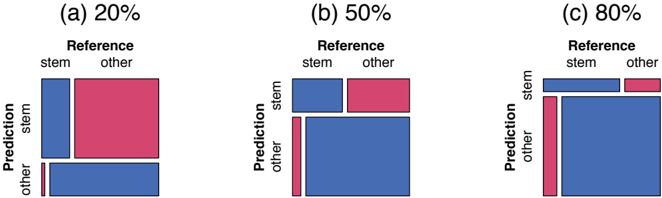
当有两个类别时,对数似然相对于基于硬性预测的指标的一个优势是,它回避了概率截断值是否合适的问题。例如,在讨论准确率、敏感性、特异性和其他度量时,有一个隐含的假设:用于从软预测过渡到硬预测的概率截断值是有效的。这往往不成立,尤其是当数据存在严重的类别不平衡时。[21] 考虑 OkCupid 数据和前面讨论的逻辑回归模型。用于做出表 3.1 中确定预测的类别概率估计如图 3.2 所示,其中顶部面板包含真正为 STEM 的资料,底部面板显示其他资料的类别概率分布。[22] 创建原始的观测类别对预测类别表时使用了常见的 50% 截断值。表 3.1 也可以用马赛克图可视化,例如图 3.3(b) 中所示,其中块的大小与每个单元格中的数据量成正比。如果我们对判定资料为 STEM 所需的证据水平更宽松,这张表会发生什么变化?不使用 50% 截断值,我们可能会将事件阈值降低到 20%。在这种情况下,更多的资料将被判定为 STEM。这可能会提高敏感性,因为真正的 STEM 资料更有可能被正确预测,但代价是增加假阳性的数量。这个混淆矩阵的马赛克图如图 3.3(a) 所示,左上角的蓝色块变大。但右上角的红色块也在增加。这样一来,敏感性从 0.72 提高到 0.96,但特异性从 0.8 下降到 0.35。将预测 STEM 资料所需的证据水平提高到 80%,则产生相反的效果,如图 3.3(c) 所示。在这里,特异性得到改善,但敏感性受到损害。
图 3.2:OkCupid 数据的类别概率分布。顶部面板对应真正的 STEM 资料,而底部显示 non-STEM 测试集样本的概率。
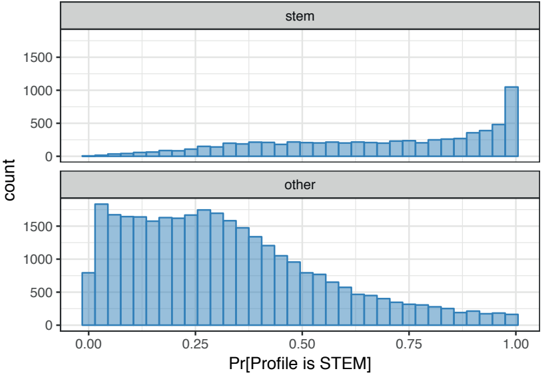
图 3.3:不同截断值下混淆矩阵的马赛克图。
接下来的问题变成"应该使用什么概率截断值?“这取决于很多事情,包括哪种错误(假阳性还是假阴性)伤害最大。然而,如果两类错误同样糟糕,可能存在比默认更好的截断值。
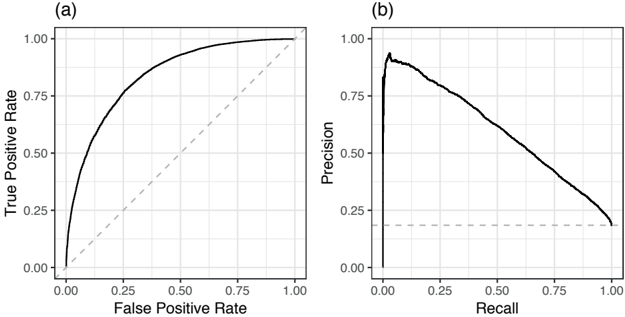
受试者工作特征(receiver operating characteristic,ROC)曲线(Altman 和 Bland, 1994a)可以用来缓解这个问题。它考虑所有可能的截断值,并跟踪敏感性和特异性的变化。曲线通过绘制假阳性率(1 − 特异性)对真阳性率来构成。OkCupid 数据的 ROC 曲线如图 3.4(a) 所示。最好的模型是紧贴 y 轴并直接通向左上角(两种错误都不犯)的模型,而完全无效的模型曲线将沿着以灰色显示的对角线。这条曲线允许用户做两件重要的事情。第一,可以根据自己对敏感性或特异性重要性的期望来确定合适的截断值。然后可以用这个截断值做出定性预测。第二,也许更重要的是,它允许在不识别最佳截断值的情况下评估模型。通常,ROC 曲线下面积(area under the ROC curve,AUC)用于评估模型。如果最好的模型立即通向左上角,这条曲线下的面积将为一,而差的模型产生的 AUC 将在 0.50 附近。不过,应该谨慎,因为两个不同模型的曲线可能交叉;这表明在某些区域一个模型比另一个做得更好。作为汇总度量使用,AUC 抹杀了曲线中可以看到的任何细微差别。对于图 3.4(a) 中的曲线,AUC 为 0.839,表明拟合度中等偏上。
从信息检索的角度来看,精确率-召回率曲线(precision-recall curve)更合适(Christopher 等人, 2008)。这与 ROC 曲线类似,两个统计量在数据中的每个可能截断值上计算。对于 OkCupid 数据,曲线如图 3.4(b) 所示。差的模型会导致精确率-召回率曲线位于观测患病率(此处为 0.18)值的水平灰线附近。曲线下面积用于汇总模型性能。最好的可能值是 1.0,而最差的是患病率。这条曲线下的面积为 0.603。
在模型构建的初始阶段,对于两类数据集,一个好的策略是关注这些曲线的 AUC 统计量,而不是基于硬性类别预测的指标。一旦找到合理的模型,可以仔细检查 ROC 或精确率-召回率曲线,为数据找到合理的截断值,然后可以使用定性预测指标。
3.2.3 特定情境的指标
虽然前面讨论的指标可以用于开发有效的模型,但它们可能无法回答潜在的关注问题。例如,考虑一个场景:我们收集了关于客户特征以及客户是否点击广告的数据。我们的目标可能是将客户特征与客户点击广告的概率联系起来。如果这是目标,上面描述的几个指标将使我们能够评估模型性能。或者,我们可能更感兴趣回答"如果这个模型被用来预测谁将点击广告,我的公司会赚多少钱?“在另一种情境下,我们可能感兴趣构建一个模型来回答"当模型被用来确定这个客户是否会偿还贷款时,我的预期利润是多少?“这些问题非常特定于情境,并不直接符合前面描述的指标。
图 3.4:ROC 曲线 (a) 和精确率-召回率曲线 (b) 的示例。
以贷款为例。如果一笔贷款被要求 $M,我们能计算预期利润(或损失)吗?让我们假设我们的模型是在适当的数据集上创建的,可以产生贷款将按时偿还的类别概率 Pr。给定这些数量、利率、费用和其他已知因素,可以为每个数据点计算贷款的总回报,然后可以用平均值来优化模型。
因此,我们应该让关注的问题引导我们找到合适的指标,来评估模型回答问题的能力。也许可以使用常见的、现成的指标来解决问题。或者问题可能需要针对情境开发定制指标。更多讨论参见 Kuhn 和 Johnson (2013) 的第 16 章。
3.3 数据划分
开始建模项目时要做的第一个决定之一是如何利用现有数据。一种常见的技术是将数据分成两组,通常称为训练集(training set)和测试集(test set)。[23] 训练集用于开发模型和特征集;它是估计参数、比较模型以及达成最终模型所需的所有其他活动的基础。测试集只在这些活动结束时使用,用于估计模型性能的最终无偏评估。至关重要的是,在此之前不能使用测试集。查看测试集结果会使结果产生偏差,因为测试数据将成为模型开发过程的一部分。
应该留出多少数据用于测试?要制定统一的准则极其困难。数据的比例可以由许多因素驱动,包括原始样本池的大小和预测变量的总数。对于大的样本池,一旦训练集中包含"足够"的样本,这个决定的关键性就会降低。此外,在这种情况下,替代简单的初始数据划分的想法可能是好的;更多细节见下面的第 3.4.7 节。样本数量(n)与预测变量数量(p)的比率也需要考虑。当 n 远大于 p 时,我们在划分数据方面会有更多的灵活性。然而,当 n 小于 p 时,即使 n 看起来很大,我们也可能遇到建模困难。
划分训练集和测试集的方法有很多。最常见的方法是使用某种随机抽样(random sampling)。完全随机抽样是一种直接的实现策略,通常保护过程不偏向数据的任何特征。然而,当响应在结果中分布不均匀时,这种方法可能有问题。风险较小的划分策略是基于结果的分层随机样本(stratified random sample)。对于分类模型,这通过在每种类别内随机选择样本来实现。这种方法确保结果的频率分布在训练集和测试集内大致相等。当结果是数值型时,可以根据数据的四分位数(quartile)构建人工分层。例如,在艾姆斯住房价格数据中,结果分布的四分位数会将数据分成四个包含大约 230 栋房屋的人工组。训练/测试划分将在这四个组内进行,四个不同的训练集部分合并在一起(测试集也是如此)。
当有充分理由时,也可以使用非随机抽样。一种情况是数据有重要的时间方面。在这里,使用最近的数据作为测试集可能是明智的。这是第 4.1 节中讨论的芝加哥交通数据使用的方法。
3.4 重采样
如前所述,有时需要在不求助于测试集的情况下理解模型的有效性。简单地重新预测训练集是有问题的,因此需要一种使用训练集获得评估的方法。重采样(resampling)方法将用于此目的。
重采样方法可以生成训练集的不同版本,用于模拟模型在新数据上的表现。这些技术的区别在于重采样数据版本的创建方式以及模拟过程的迭代次数。在每种情况下,重采样方案都会生成一个用于建模的数据子集和另一个用于测量性能的数据子集。这里,我们将前者称为"分析集”(analysis set),后者称为"评估集”(assessment set)。它们大致类似于本章开头描述的训练集和测试集。[24] 图 3.5 显示了具有任意数量重采样的示例数据层级图。
图 3.5:对训练数据进行 B 次重采样的典型数据使用示意图。
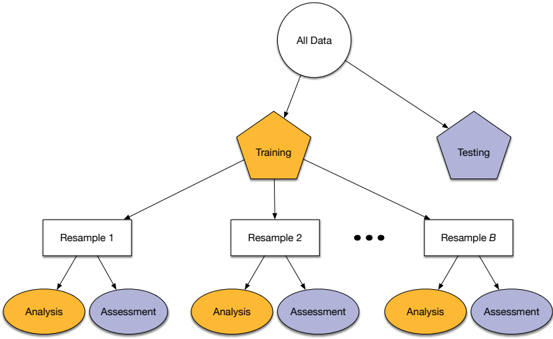
在继续之前,我们应该注意被重采样的是什么。独立实验单元(independent experimental unit)是尽可能与其他数据统计独立的数据单元。例如,对于艾姆斯数据,合理地认为每栋房屋都独立于其他房屋。由于房屋包含在数据的行中,每一行被分配到分析集或评估集。然而,考虑这样一种情况:公司的客户是独立单元,但数据集每个客户包含多行。在这种情况下,每个客户将被分配到分析集或评估集,他们所有对应的行都随之移动。这类非标准安排将在第 9 章中进一步讨论。
接下来四个小节将描述几种不同风格的重采样。
3.4.1 V 折交叉验证及其变体
简单的 V 折交叉验证(V-fold cross-validation)创建原始训练集的 V 个不同版本,它们的大小大致相同。每个 V 评估集包含训练集的 1/V,并且每个都排除不同的数据点。分析集包含其余部分(通常称为"折”(fold))。假设 V = 10,那么有 10 个不同的 90% 数据版本,以及每个相应重采样剩余 10% 的 10 个版本。
要使用 V 折交叉验证,在第一个折(分析集)上创建模型,并由模型预测相应的评估集。使用选定的性能度量(如 RMSE、ROC 曲线下面积等)汇总评估集,并保存这些统计量。这个过程以循环方式进行,最终得到模型的 V 个性能估计,每个都在不同的评估集上计算。交叉验证的性能估计通过平均 V 个个体指标来计算。
图 3.6 显示了假设的 20 个训练集样本数据集的 10 折交叉验证图。对于每个重采样,两个不同的训练集数据点被留出用于评估集。注意,评估集是互斥的,包含不同的实例。
当结果是分类变量时,这里也可以应用分层划分技术,以确保分析集和评估集产生相同的结果频率分布。同样,当连续结果偏斜或分类结果不平衡时,这是一个好主意,但其他情况下不太可能有问题。
例如,对于 OkCupid 数据,使用了分层 10 折交叉验证。训练集包含 38,809 份资料,10 个评估集各包含 3,880 份不同的资料。ROC 曲线下面积被用来衡量前面提到的逻辑回归模型的性能。10 个曲线下面积从 0.83 到 0.854 不等,平均值是 0.839。不使用测试集,我们就可以用这个统计量来预测这个模型在新数据上的表现。
正如将在第 3.4.6 节讨论的,重采样方法有不同的特征。基本 V 折交叉验证的一个缺点是它相对更嘈杂(即变异性更大)比其他重采样方案。弥补这一点的一种方法是进行重复 V 折交叉验证(repeated V-fold cross-validation)。如果使用 R 次重复,V 个重采样被创建 R 次,最终平均 RV 个重采样来估计性能。由于平均了更多的数据,最终平均值的方差会减少 \( \sqrt{R} \) 倍(使用高斯近似 [25])。同样,这个过程的嘈杂程度是相对的,正如人们所料,它由评估集中的数据量驱动。对于 OkCupid 数据,ROC 曲线下面积是根据 3,880 份资料计算的,可能足以产生足够精确的估计(即使我们预计其中只有大约 716 份是 STEM 资料)。
评估集可以用于模型验证和诊断。表 3.1 和图 3.2 使用这些留出预测来可视化模型性能。此外,第 4.4 节更详细地描述了如何使用评估数据集来推动模型的改进。
另一个变体是留一交叉验证(leave-one-out cross-validation),其 V 等于训练集的大小。这是一种有些过时的技术,可能只在训练集大小极小时有用(Shao, 1993)。
在前面与独立实验单元相关的讨论中,给出了一个示例:客户应该被重采样,与每个客户关联的所有行都会进入分析集或评估集。要做到这一点,V 折交叉验证将与客户标识符一起使用。一般来说,这被称为"分组 V 折交叉验证”(grouped V-fold cross-validation)或"留组交叉验证”(leave-group-out cross-validation),取决于 V 的值。
3.4.2 蒙特卡洛交叉验证
V 折交叉验证产生 V 组评估集互斥的划分。蒙特卡洛重采样(Monte Carlo resampling)产生的划分很可能包含重叠。对于每个重采样,随机抽取一个样本,训练集的 π 比例进入分析集,其余样本分配到评估集。与前一个过程一样,在分析集上创建模型,评估集用于评估模型。这个划分过程执行 B 次,B 次结果的平均值用于估计未来性能。B 被选择得足够大,使 B 个值的平均值具有可接受的精度。
图 3.6 还显示了 π = 0.90 的 10 次重采样的蒙特卡洛交叉验证。注意,与 10 折交叉验证不同,一些相同的数据点被用于不同的评估集。
图 3.6:包含 20 个样本的训练集的两种交叉验证示意图。
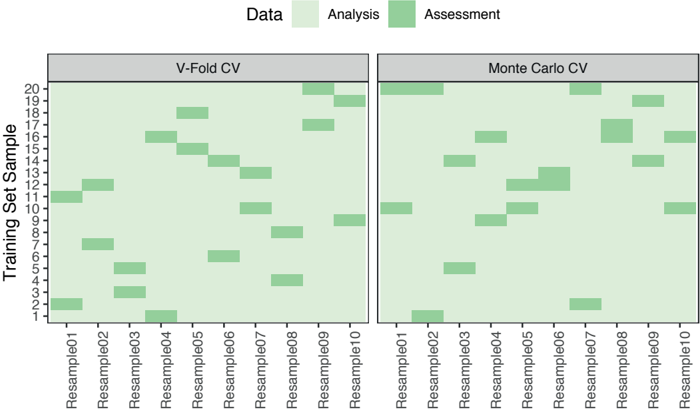
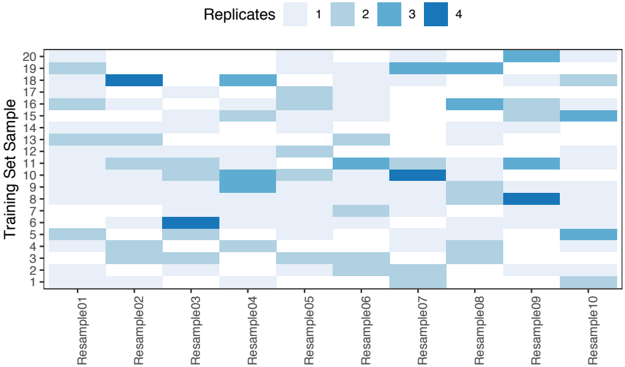
图 3.7:包含 20 个样本的训练集的自助法重采样示意图。颜色表示一个数据点在分析集中被复制的次数。
3.4.3 自助法
数据的自助法重采样(bootstrap resample)被定义为与训练集大小相同的简单随机样本,其中数据有放回地抽样(Davison 和 Hinkley, 1997)。这意味着当创建自助法重采样时,任何训练集成员被包含在自助样本中至少一次的概率为 63.2%。自助法重采样被用作分析集,而评估集(有时称为袋外样本(out-of-bag sample))由训练集中未被包含在自助样本中的成员组成。和以前一样,自助法抽样进行 B 次,遵循相同的建模/评估程序,产生作为 B 个结果均值的自助法性能估计。
图 3.7 显示了从 20 个样本数据集创建的十个自助样本的图示。颜色显示几个训练集点被多次选择进入分析集。评估集将由没有颜色的行组成。
3.4.4 滚动起点预测
这个过程专门针对时间序列(time-series)数据或任何具有强烈时间成分的数据集(Hyndman 和 Athanasopoulos, 2013)。如果数据中存在季节性或其他长期趋势,在分析和评估集之间随机划分数据可能会破坏模型估计这些模式的能力。
在这种方案中,假设训练集按时间或其他时间成分排序,第一个分析集由前 M 个训练集点组成。评估集将由接下来的 N 个训练集样本组成。第二个重采样保持数据集大小相同,但分析集递增为使用样本 2 到 M + 1,而评估集包含样本 M + 2 到 M + N + 1。划分方案继续进行,直到没有更多数据来产生相同的数据集大小。假设这产生数据的 B 个划分,同样的过程用于建模和评估,最终从每个评估集生成 B 个性能估计。估计性能的一个简单方法是再次对这些数据使用简单平均。然而,应该理解,由于滚动评估集之间有显著重叠,B 个样本本身构成一个时间序列,也可能显示季节性或其他时间效应。
图 3.8:M = 10 和 N = 2 的滚动起点预测重采样示意图。
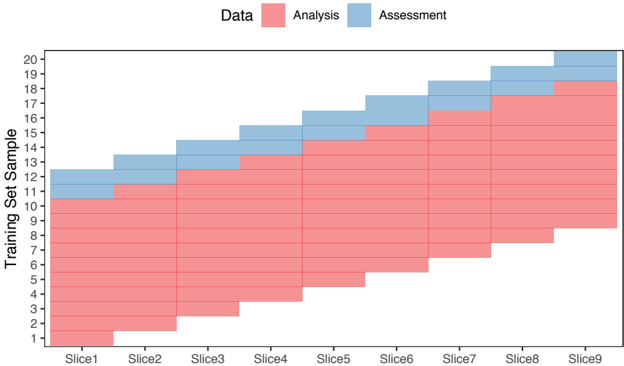
图 3.8 显示了这种类型的重采样,其中 10 个数据点用于分析,随后的两个训练集样本用于评估。
这个过程有许多变体:
- 分析集不必大小相同。随着移动窗口沿训练集推进,它们可以累积增长。换句话说,第一个分析集包含 M 个数据点,第二个包含 M + 1 个,依此类推。这是芝加哥列车数据建模采用的方法,在第 4 章中描述。
- 划分过程可以跳过迭代以产生更少的重采样。例如,在芝加哥数据中,有 2001 年到 2016 年的每日测量值。按天递增会产生过大的 B 值。对于这些数据,跳过了 13 个样本,使划分窗口以两周为块移动,而不是按单日移动。
- 如果训练数据采样不均匀,可以使用相同的过程,但在时间增量上移动,而不是在数据行增量上移动。例如,窗口可以在 12 小时周期上移动用于分析集,在 2 小时周期上移动用于评估集。
这种重采样方法至少有两个方面不同于以前的方法。划分不是随机的,评估数据集不是移除分析集后训练集数据的剩余部分。
3.4.5 验证集
验证集(validation set)是介于训练集和测试集之间的东西。历史上,在神经网络文献中,人们认识到使用相同的数据来估计参数和测量性能是有问题的。通常,分配一小部分数据来确定神经网络每次训练迭代(在该术语体系中也被称为训练轮次(training epoch))的错误率。这个验证集将在模型训练时用于估计性能,以确定它何时开始过拟合。通常,验证集是训练集的随机子集,因此它随着数值优化器的每次迭代而变化。在对这种类型的模型进行重采样时,使用分析集的一小部分随机部分作为重采样内的验证集是合理的。
这会取代测试集(或类似地,评估集)吗?不会。由于验证数据指导训练过程,它们不能用于公平评估建模过程的效果。
3.4.6 重采样中的方差与偏差
在第 1.2.5 节中,讨论了模型的方差和偏差特性。重采样方法具有相同的特性,但其影响以不同的方式显现。方差更容易概念化。如果你在相同的数据集上多次进行 10 折交叉验证,重采样方案的变异性可以通过确定所得平均值的离散程度来测量。这种变异性可以与重复相同次数(以此类推)的不同方案进行比较,以获得每种方案中噪声量的相对比较。
偏差是特定重采样方案命中真实底层性能参数(我们永远不会真正知道)的能力。一般来说,随着分析集中数据量的减少,重采样估计的偏差会增加。换句话说,10 折交叉验证的偏差小于 5 折交叉验证。对于蒙特卡洛重采样,这显然取决于 π 的值。然而,通过模拟可以看到,当使用 π = 0.10 和 B = 10 时,10 折交叉验证的偏差小于蒙特卡洛交叉验证。留一交叉验证的偏差会非常低,因为它的分析集与训练集只差一个样本。
图 3.9 包含重采样方案中方差和偏差的图形表示,其中曲线代表如果在相同数据集上多次执行相同过程时重采样统计量的分布。图中表示四种可能的方差/偏差情况。我们假设这里测量的模型指标值越大越好(如 R² 或敏感性),真实值由绿色垂直线表示。右上方面板展示了悲观偏差,因为值往往小于真实值,而右下方的面板显示了一种方差相对较低、分布中心对准真实值的重采样方案(因此几乎无偏)。
图 3.9:重采样方案中方差-偏差差异的说明。
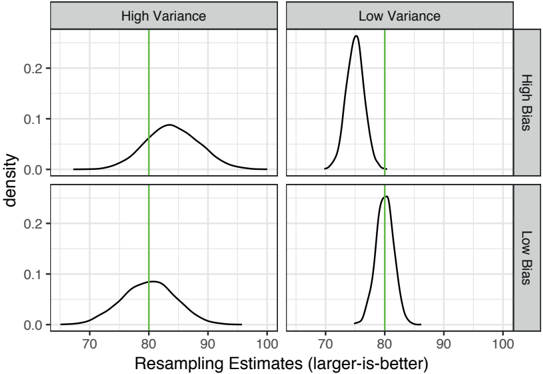
一般来说,对于固定的训练集大小和重采样次数,简单的 V 折交叉验证通常被认为是这里讨论的方法中最嘈杂的,而自助法变异性最小。[26] 自助法被认为偏差最大(因为大约 36.8% 的训练集被选入评估集),其偏差通常是悲观的(即可能显示比真实底层值更差的模型性能)。有一些尝试纠正自助法的偏差,如 Efron (1983) 和 Efron 和 Tibshirani (1997)。
虽然 V 折交叉验证确实有膨胀的方差,但当 V 为 10 或更多时,其偏差相当低。当训练集不大时,我们建议根据所需精度、训练集大小和其他因素,使用大约五次重复的 10 折交叉验证。
3.4.7 重采样中应包含哪些内容?
在前面对重采样方案的描述中,我们说评估集用于"构建模型"。这在某种程度上是一种简化。为了使任何重采样方案产生能推广到新数据的性能估计,它必须包含建模过程中所有可能显著影响模型有效性的步骤。例如,在第 1.1 节中,使用了一种变换来修改预测变量,这带来了性能的改进。在重采样期间,这个步骤应该包含在重采样循环中。其他预处理或过滤步骤(如 PCA 信号提取、预测变量相关性过滤器、特征选择方法)必须是重采样过程的一部分,以便理解模型表现如何,并测量建模过程何时开始过拟合。
有些操作可以豁免。例如,在第 2 章中,只有少数患者有缺失值,这些值用中位数插补。对于如此小的修改,我们没有在重采样中包含这些步骤。但一般来说,插补会对性能产生实质性影响,其变异性应该传播到重采样结果中。在其他条件相同的情况下,中心化和缩放也可以从重采样中豁免。
作为另一个例子,OkCupid 训练数据被下采样,使类别比例相等。这是一个重要的数据处理步骤,将这个过程的效应传播到重采样结果中很重要。因此,下采样过程在每次重采样的分析集上执行,然后在创建最终模型时在整个训练集上再次执行。
重采样的另一个方面与信息泄漏(information leakage)的概念有关,即测试集数据在训练过程中被(直接或间接)使用。这可能导致过度乐观的结果,这些结果无法在未来的数据点上复现,并且可能以微妙的方式发生。
例如,假设一个 120 个样本的数据集有一个单一的预测变量,并且本质上是顺序性的,如时间序列。如果预测变量有噪声,预处理数据的一种方法是对预测变量数据应用移动平均,并用平滑值替换原始数据。假设使用三点平均,第一个和最后一个数据点保留其原始值。我们的倾向是用移动平均平滑整个 120 个数据点的序列,然后将数据分成训练集和测试集(比如前 100 行在训练中)。这里的微妙问题是,第 100 个数据点(训练集中的最后一个)使用测试集中的第一个点来计算其三点平均。通常,最近的数据与时间序列中的下一个值最相关。因此,包含最近的点可能会(以小的方式)使模型性能产生偏差。
为了提供可靠的方法论,我们应该约束自己:制定预处理技术列表,只在训练数据点存在的情况下估计它们,然后将技术应用于未来的数据(包括测试集)。可以说,上面提到的移动平均问题在后果上很可能很小,但它说明了测试数据多么容易渗入建模过程。应用这种预处理技术的方法是先划分数据,然后分别对训练集和测试集应用移动平均平滑器。
另一种更明显的通往信息泄漏的路径,有时可以在机器学习竞赛中看到,即训练集和测试集数据同时给出。虽然测试集数据的结果常常被隐藏,但有可能通过只使用与测试集数据最相似的训练集样本来"向测试训练"(train to the test)。这可能非常有助于提高该特定测试集的模型性能分数,但可能会破坏模型在更广泛数据集上的预测能力。
最后,对于大量数据,替代的数据使用方案可能是个好主意。不是简单的训练/测试划分,而是可以为特定目的创建多个划分。例如,可以在使用训练集建模之前,用数据的特定划分来确定模型的相关预测变量。这将减少在重采样中包含昂贵的特征选择步骤的需要。同样的方法可以用于后处理活动,例如从受试者工作特征曲线确定适当的概率截断值。
3.5 调优参数与过拟合
许多模型包含一些参数,虽然重要,但不能直接从数据中估计。调优参数(tuning parameter,有时称为超参数 hyperparameter [27])很重要,因为它们通常控制模型的复杂性,从而也影响可以做出的任何方差-偏差权衡。
例如,K 近邻(K-nearest neighbor)模型存储训练集数据,当预测新样本时,定位与新样本最接近的 K 个训练集点。使用邻居的训练集结果进行预测。邻居的数量控制复杂性,并且以与第 1.2.5 节中移动平均讨论非常相似的方式,控制模型的方差和偏差。当 K 很小时,过拟合的可能性最大,因为只有很少的值用于预测,并且最容易受数据变化的影响。然而,如果 K 太大,太多可能不相关的数据点被用于预测,导致模型欠拟合。
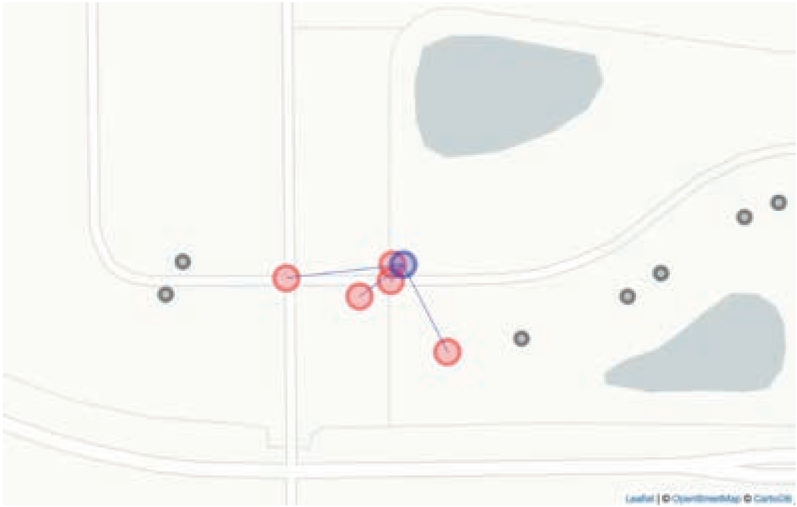
为了说明这一点,考虑图 3.10,其中单个测试集样本显示为蓝色圆圈,其在训练集中五个最近的(地理)邻居显示为红色。测试集样本的销售价格为 28.2 万美元,邻居的价格从最近到最远依次为:$320K、$248K、$286K、$274K、$320K。使用 K = 1,模型会错过真实房价 3.75 万美元。这说明了第 1.2.1 节中引入的过拟合概念;模型过于激进地使用训练集中的模式对新数据点进行预测。对于这个模型,增加邻居的数量可能有助于缓解这个问题。对所有 K = 5 个点取平均来预测,将误差大幅削减到 7.3K 美元。
这个例子说明了调优参数对模型质量的影响。在某些模型中,可能有一个以上的参数。再次以最近邻模型为例,可以使用不同的距离度量,以及不同的邻居加权方案,使更远的点对预测的影响更小。
图 3.10:测试集中艾姆斯的一栋房子(蓝色)及其来自训练集的五个最近邻居(红色)。
为了确保使用适当的调优参数值,需要某种搜索过程,以及获得良好、可推广的性能度量的方法。对于后者,反复使用测试集来解决这些问题是有问题的,因为它会失去公正性。相反,通常使用重采样。下一节将描述一些确定这类参数最优值的方法。
3.6 模型优化与调优
寻找最佳调优参数值的方法有很多,但大多数分为两大类:预先定义要评估的值的,和增量确定值的。在第一种情况下,最著名的方法是网格搜索(grid search)。这里,指定一组候选调优参数值,然后进行评估。在某些情况下,模型会有多个调优参数,在这种情况下,候选参数组合是多维的。我们建议使用重采样来评估每个不同的参数值组合,以获得每个候选表现如何的良好估计。一旦计算出结果,就选择"最佳"调优参数组合,并用这个值将最终模型拟合到整个训练集。最佳组合可以通过多种方式确定,但最常见的方法是选择经验结果最好的候选。
例如,一个简单的 K 近邻模型需要邻居的数量。对于 OkCupid 数据,这个模型将用于预测资料所属的职业。在这种情况下,预测变量包含许多不同类型的资料特征,因此"最近邻"实际上是一个基于许多特征的相似资料。
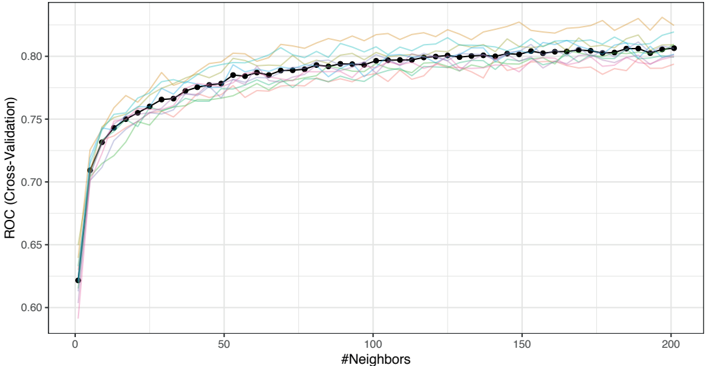
我们将候选集预定义为 K = 1, 3, …, 201。[28] 当与相同的 10 折交叉验证过程结合时,总共将使用 380 个临时模型来确定一个良好的 K 值。一旦选择了最佳的 K 值,就使用最优邻居数创建一个最终模型。重采样曲线如图 3.11 所示。图中显示的每个黑点是用训练集不同的 90% 估计的十个不同模型的性能平均值。ROC 曲线下面积最大的配置使用了 201 个邻居,对应的 AUC 为 0.806。图 3.11 显示了十个重采样中每一个的个体重采样曲线。这些数据中减少的变异量主要归因于训练集的大小。[29]
当模型关联许多调优参数时,有几种方法可以继续。第一,可以进行多维网格搜索,评估候选参数组合和组合网格。在某些情况下,这可能非常低效。另一种方法是为每个参数定义一个可能值的范围,并随机采样多维空间足够多次,以覆盖合理的量(Bergstra 和 Bengio, 2012)。这个随机搜索网格(random search)可以像更传统的网格一样被重采样。当有大量调优参数且对应该使用哪些值没有先验概念时,这个过程可能非常有益。大网格可能搜索效率低下,特别是如果曲线在参数的某个范围内有相当稳定的模式、变化很小。神经网络、梯度提升机(gradient boosting machine)和其他模型可以有效地使用这种方法调优。[30]
为了说明这个过程,再次使用 OkCupid 数据。使用与前面两个模型相同的预测变量,用单层前馈神经网络(feed-forward neural network)对属于 STEM 领域的概率进行建模。这是一个极其灵活的非线性分类系统,有许多调优参数。参见 Goodfellow 等人 (2016),了解神经网络和深度学习模型的优秀入门。
图 3.11:对 OkC 数据 K-NN 分类模型中的邻居数进行简单网格搜索生成的重采样曲线。黑线代表 10 次重采样的平均性能,而其他线代表每个个体重采样的性能。
模型的主要调优参数是:
- 隐单元(hidden unit)的数量。这个参数控制神经网络的复杂性。较大的值能实现更高的性能,但也增加过拟合的风险。对于这些数据,隐藏层中的单元数被随机选择在 2 到 20 之间。
- 激活函数(activation function)。由这个参数设置的非线性函数连接网络的不同部分。使用了三种不同的函数:传统的 S 形(sigmoidal)曲线、tanh 或修正线性单元函数(rectified linear unit function,ReLU)。
- 丢弃率(dropout rate)。这是在训练迭代期间系数被随机设为零的比率,可以减弱过拟合(Nitish 等人, 2014)。考虑了 0 到 80% 之间的比率。
神经网络系数的拟合过程在数值上可能非常具有挑战性。通常有大量系数需要估计,并且有找到局部最优的显著风险。这里,我们使用一种称为 RMSProp 的基于梯度的优化方法 [31] 来拟合模型。这是一种寻找系数值的现代算法,这个过程有几个模型调优参数:[32]
- 批大小(batch size)控制每个轮次(即优化迭代)随机暴露给优化过程的训练集数据点的数量。这具有通过为优化过程提供一些随机性来减少潜在过拟合的效果。考虑了 10 到 40K 之间的批大小。
- 学习率(learning rate)参数控制参数估计迭代期间的下降速率,这些值被对比在零和一之间。
- 随时间降低学习率的衰减率(decay rate)(范围在零和一之间)。
- 均方根梯度缩放因子(ρ)控制梯度被最近的平方梯度值归一化的程度。这个参数较小的值更强调最近的梯度。这个参数的范围被设定为 [0.0, 1.0]。
对于这个模型,使用均匀分布在上面的范围内随机采样,创建了 20 个不同的七维调优参数组合。每个设置都使用之前使用的相同 10 折交叉验证划分进行评估。
表 3.3:神经网络参数空间随机搜索的设置和结果。
| 隐单元 | 丢弃率 | 批大小 | 学习率 | 梯度 | 缩放衰减 | 激活函数 | ROC |
|---|---|---|---|---|---|---|---|
| 9 | 0.592 | 26231 | 0.004 | 0.457 | 0.04458 | relu | 0.837 |
| 16 | 0.572 | 25342 | 0.631 | 0.298 | 0.51018 | relu | 0.836 |
| 13 | 0.600 | 10196 | 0.333 | 0.007 | 0.17589 | relu | 0.835 |
| 10 | 0.286 | 19893 | 0.947 | 0.495 | 0.46124 | relu | 0.832 |
| 8 | 0.534 | 36267 | 0.387 | 0.505 | 0.14937 | relu | 0.832 |
| 14 | 0.617 | 21154 | 0.252 | 0.297 | 0.00654 | sigmoid | 0.829 |
| 17 | 0.250 | 11638 | 0.227 | 0.721 | 0.01380 | tanh | 0.825 |
| 20 | 0.392 | 17235 | 0.017 | 0.363 | 0.00029 | relu | 0.821 |
| 16 | 0.194 | 8477 | 0.204 | 0.155 | 0.01819 | tanh | 0.820 |
| 10 | 0.282 | 18989 | 0.878 | 0.260 | 0.06387 | tanh | 0.820 |
| 2 | 0.586 | 19404 | 0.721 | 0.159 | 0.18514 | sigmoid | 0.818 |
| 18 | 0.305 | 5563 | 0.836 | 0.457 | 0.01051 | sigmoid | 0.805 |
| 10 | 0.513 | 17877 | 0.496 | 0.770 | 0.00004 | tanh | 0.796 |
| 4 | 0.536 | 32689 | 0.719 | 0.483 | 0.00011 | sigmoid | 0.755 |
| 12 | 0.150 | 4015 | 0.558 | 0.213 | 0.00001 | relu | 0.732 |
| 14 | 0.368 | 7582 | 0.938 | 0.126 | 0.00001 | relu | 0.718 |
| 3 | 0.688 | 12905 | 0.633 | 0.698 | 0.00001 | relu | 0.598 |
| 3 | 0.645 | 5327 | 0.952 | 0.717 | 0.00001 | sigmoid | 0.560 |
| 2 | 0.688 | 14660 | 0.686 | 0.445 | 0.00003 | relu | 0.546 |
| 15 | 0.697 | 4800 | 0.806 | 0.139 | 0.00003 | sigmoid | 0.538 |
候选参数值之间的重采样 ROC 值显著不同。最佳设置在表 3.3 中以斜体显示,其对应的 ROC 曲线下面积为 0.837。
如前所述,网格搜索和随机搜索方法预先指定了调优参数,搜索不会适应寻找新的值。还有其他方法可以做到这一点。例如,有许多非线性搜索方法可以使用,如内尔德-米德单纯形搜索(Nelder-Mead simplex search)、模拟退火(simulated annealing)和遗传算法(Chong 和 Zak, 2008)。这些方法对网格空间进行非常彻底的搜索,但往往计算成本高昂。原因之一是,每次评估新参数都需要一个良好的性能估计来指导搜索。重采样是做到这一点的最佳方法之一。另一种搜索空间的方法称为贝叶斯优化(Bayesian optimization)(Mockus, 1994)。这里,使用网格或随机搜索评估初始样本池。优化过程创建一个单独的模型来预测作为调优参数函数的性能,然后可以推荐下一个要评估的候选集。一旦评估了这个新点,模型被更新,过程持续设定的迭代次数(Jones 等人, 1998)。[33]
关于重采样结果解释的最后一点是,通过根据结果选择最佳设置并用这些值表示模型性能,存在优化偏差(optimization bias)的风险。取决于问题,这种偏差可能高估模型的真实性能。可以使用嵌套重采样(nested resampling)过程来减轻这些偏差。更多信息参见 Boulesteix 和 Strobl (2009)。
3.7 使用训练集比较模型
当多个模型在竞争时,通常需要在它们之间进行正式评估,以了解性能的任何差异是否超出了随机预期。在我们提出的工作流中,重采样被大力依赖来估计模型性能。好的做法是在任何被评估的模型之间使用相同的重采样。这使得模型之间可以进行同类比较。它也允许在测试集介入之前对模型进行正式比较。考虑为 OkCupid 数据创建的逻辑回归和神经网络模型。它们如何比较?由于两个模型使用相同的重采样来拟合和评估,这产生了一组 10 个配对比较。表 3.4 显示了每个重采样的具体 ROC 结果及其配对差异。这两组值之间的相关性为 0.96,表明结果中可能存在重采样间效应。
给定这组配对差异,可以进行正式的统计推断来比较模型。一个简单的方法是考虑两个模型之间的配对 t 检验(paired t-test),或对差异进行普通的单样本 t 检验。ROC 值的估计差异为 -0.003,95% 置信区间为 (-0.004, -0.001)。确实有证据表明这些模型之间存在真实(但可忽略不计的)性能差异。这种方法曾在第 2.3 节中使用,当时预测卒中结果的潜在变量按其相对于零模型 ROC 曲线下面积的改进进行排序。这种方法可以用来比较模型,或比较同一模型的不同方法(如预处理差异或特征集)。
表 3.4:预测 OkCupid 数据的两个模型的配对重采样结果。ROC 指标被用来调优每个模型。由于每个模型使用相同的重采样集,我们可以正式比较模型之间的性能。
| 逻辑回归 | 神经网络 | 差值 | |
|---|---|---|---|
| 折 1 | 0.830 | 0.827 | -0.003 |
| 折 2 | 0.854 | 0.853 | -0.002 |
| 折 3 | 0.844 | 0.843 | -0.001 |
| 折 4 | 0.836 | 0.834 | -0.001 |
| 折 5 | 0.838 | 0.834 | -0.004 |
| 折 6 | 0.840 | 0.833 | -0.007 |
| 折 7 | 0.839 | 0.838 | -0.001 |
| 折 8 | 0.837 | 0.837 | 0.000 |
| 折 9 | 0.835 | 0.832 | -0.003 |
| 折 10 | 0.838 | 0.835 | -0.003 |
这种技术的价值有两方面:
- 它防止测试集在模型开发过程中被使用,并且
- 使用许多评估(通过评估集)来衡量差异。
第二点更重要。通过使用多个差异,可以测量性能统计量的变异性。虽然单个静态测试集有其优势,但它只是模型性能的一次实现,我们不知道这个值的精度。
也可以比较两个以上的模型,尽管分析必须使用贝叶斯分层模型(Bayesian hierarchical model)(McElreath, 2015)或重复测量模型(repeated measures model)(West 和 Galecki, 2014)来解释重采样内相关性。这个方法论的想法起源于 Hothorn 等人 (2005)。Benavoli 等人 (2016) 也提供了一种对模型和数据集之间重采样结果进行分析的贝叶斯方法。
3.8 无过拟合的特征工程
第 3.5 节讨论了使用重采样调优模型的方法。这种方法的关键是在未用于构建模型的数据上评估参数值。这不是一个有争议的概念。在某种程度上,评估集数据被用作对特定调优值有效性的潜在反对意见。相当清楚的是,简单地重新预测训练集不包括这样的机会。
正如在后面的章节中将多次指出的,同样的想法应该应用于任何其他与特征相关的活动,如工程新特征/编码,或决定是否在模型中包含新项。应该总是有机会让独立的数据来评估设计选择的适当性。
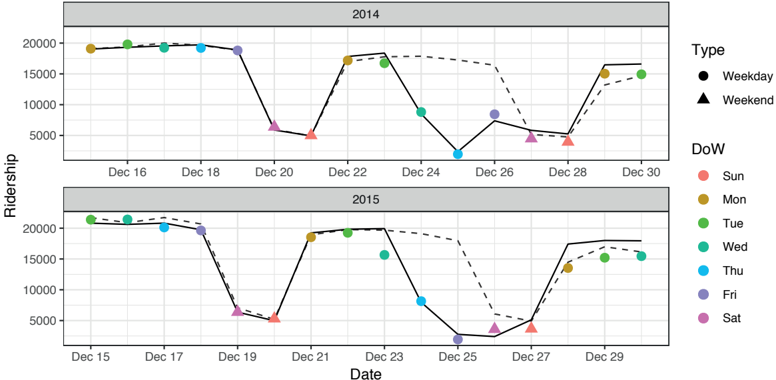
例如,对于芝加哥列车数据,有些天的客流量数字被严重过度预测。过度预测的原因可以通过研究训练数据来确定。问题的根源在于假日和辅助趋势,需要在预测变量中处理(如"圣诞节在周五"等)。[34] 对于支持向量机,这些新特征的影响如图 3.12 所示。面板显示了被重采样的两年的评估集预测。虚线显示添加假日预测变量之前的预测,实线对应添加这些特征之后的模型。显然,这些预测变量在这些时间片段内帮助提高了性能。这有明显的常识性理由,但评估集被评估以确认结果。
然而,假设探索性数据分析清楚地显示,当芝加哥公牛队(Bulls)和熊队(Bears)有客场比赛时,客流量下降。即使这种假设的模式在训练集中有非常清晰的信号,重采样也将是确定当一些训练数据被留出作为无偏对照时它是否成立的最佳方法。
作为另一个例子,在第 5.6 节中,OkCupid 数据被用来从文本短文数据中推导关键词特征。那里采用的方法是使用一小部分训练集(随机选择)来发现关键词特征。这个小子集保留在训练集中,并在模型拟合时正常重采样。一些发现数据集在训练集中,因此我们预计重采样估计会略有乐观偏差。尽管如此,仍有相当大量的数据没有参与这些特征的发现,用于确定它们的有效性。[35]
无论如何,最好用重采样对探索性数据分析期间发现的趋势进行"压力测试",以获得趋势或模式是否可能是真实的更客观的感觉。
图 3.12:向为芝加哥列车数据创建的 SVM 模型添加假日预测变量的效果。虚线对应原始预测变量的模型。实线对应将假日指标作为预测变量包含在内的模型。
3.9 总结
在深入特征工程和特征选择的方法之前,我们必须首先对预测建模过程有扎实的理解。对这个过程的透彻理解有助于分析人员做出许多关键选择,其中大多数发生在构建任何模型之前。此外,分析人员对数据、生成数据的机制以及要回答的问题了解得越多,分析人员就能做出更好的初始选择。初始选择包括模型性能指标、重采样方法、模型及相应的调优参数。如果没有好的选择,整个建模过程往往需要更多时间,并导致次优的模型选择。
建模前过程的下一步是开始了解可用数据的特征。最好的方法之一是可视化数据,这是下一章的重点。
3.10 计算
网站 http://bit.ly/fes-review 包含用于重现这些分析的 R 程序。
脚注
[15] 虽然曾有未经授权获取在线约会信息的情况,但这些数据是在 OkCupid 总裁兼联合创始人 Christian Rudder 的许可下提供的。更多信息请参见原始出版物。在这些数据中,没有提供用户名或图像。
[16] github.com/rudeboybert/JSE_OkCupid
[17] 注意,这些值并不是简单地对数据集进行重新预测获得的。表中的值是第 3.4.1 节中定义的交叉验证过程期间生成的"评估"集。
[18] 接近 -1 的值在预测建模中很少见到,因为模型寻求找到与观测值相似的预测值。我们发现,难以在预测变量与响应之间找到关系的预测模型,其 Kappa 值略低于或接近 0。
[19] 事实上,当有两个类别时,Gini 统计量等价于二项方差。
[20] 虽然对比较模型没有帮助,但这两个统计量在创建决策树的过程中被广泛使用。参见 Breiman 等人 (1984) 和 Quinlan (1993) 的示例。在这种情况下,这些指标使基于树的算法能够创建有效的模型。
[21] 参见 Kuhn 和 Johnson (2013) 的第 16 章。
[22] 与表 3.1 中的混淆矩阵一样,这些数据是在 10 折交叉验证期间创建的。
[23] 还有其他类型的子集,例如验证集。这将在第 3.4.5 节讨论。
[24] 事实上,许多人使用"训练"和"测试"来描述重采样期间产生的数据划分。我们在这里避免这样做,因为 1) 重采样只对训练集样本进行,2) 术语可能令人困惑,因为同一个术语被用于原始数据的不同版本。
[25] 这是基于均值标准误的分母中有 \( \sqrt{R} \) 的想法。
[26] 这是一个总体趋势;有许多因素影响这些比较。
[27] 不要与贝叶斯分析中先验分布的超参数混淆。
[28] 与其他数据集相比,这个邻居数异常大。这个模型倾向于偏好最多几十个(或更少)的 K 值。
[29] 其他数据集通常不是这样;可视化个体曲线通常可以显示重采样之间过多的噪声,这些噪声在最终会被平均掉。
[30] 然而,规则的网格可能更高效。对于某些模型,存在一些优化方法,可以在不重新拟合模型的情况下计算候选参数集的结果。随机搜索的性质取消了这种好处。
[31] RMSProp 是一种使用梯度的通用优化方法。细节超出了本书的范围,但更多信息可以在 Goodfellow 等人 (2016) 以及 https://en.wikipedia.org/wiki/Stochastic_gradient_descent#RMSProp 找到。
[32] 对于不熟悉现代基于导数优化的人来说,这些参数中的许多相当晦涩。Goodfellow 等人 (2016) 的第 8 章对这些方法有大量的讨论。
[33] GitHub 仓库 http://bit.ly/2yjzB5V 有非线性搜索方法和调优参数贝叶斯优化的示例代码。
[34] 这些与假日相关的指标构成图 1.7 中的集合 5。
[35] 如第 3.4.7 节最后一段所指出的,更好的方法是从训练集和测试集中分配一个单独的数据集,并将其用于发现。当数据充足时,这最有用。