示例:预测缺血性卒中风险
作为特征工程的入门,这里给出一个简化的示例,其建模过程与图 1.4 所示的类似。为了便于说明,这个例子将通过单一模型(逻辑回归)的视角,聚焦于探索、分析拟合和特征工程。
为了说明特征工程在提高模型性能方面的价值,考虑这样一个应用:试图更好地预测患者罹患缺血性卒中(ischemic stroke)的风险(Schoepf 等人, 即将发表)。历史上,动脉狭窄(arterial stenosis,即堵塞)程度一直被用来识别有卒中风险的患者(Lian 等人, 2012)。为降低卒中风险,堵塞程度足够(> 70%)的患者通常被建议进行手术干预以移除堵塞(Levinson 和 Rodriguez, 1998)。然而,历史证据表明,仅凭堵塞程度实际上并不能很好地预测未来卒中(Meier 等人, 2010)。这可能是因为如下理论:虽然堵塞的大小可能相同,但斑块(plaque)堵塞的组成成分也与卒中结果的风险相关。大而稳定、不太可能破裂的斑块,可能比更小但不太稳定的斑块带来的卒中风险更低。
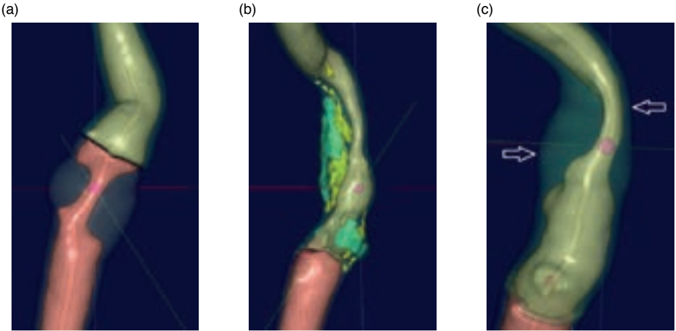
为了研究这一假设,选取了一组历史上患有不同程度颈动脉(carotid artery)堵塞的患者。数据包括 126 名患者,其中 44 名堵塞程度大于 70%。所有患者都接受了计算机断层血管造影(Computed Tomography Angiography,CTA),以生成堵塞的详细三维可视化和表征。然后由 Elucid Bioimaging 公司的 vascuCAP™ 软件对这些图像进行分析,该软件可生成解剖结构估计值,如狭窄百分比(percent stenosis)、动脉壁厚度,以及组织特征如富脂坏死核心(lipid-rich necrotic core)和钙化(calcification)。举例来说,考虑图 2.1(a),它表示一个严重狭窄的颈动脉,表现为贯穿动脉中部的细小管状开口。利用图像,软件可以计算最大横截面狭窄面积(MaxStenosisByArea)和最大横截面狭窄直径(MaxStenosisByDiameter)。此外,图中的灰色区域代表为动脉壁提供结构支撑的大分子(如胶原蛋白、弹性蛋白、糖蛋白和蛋白聚糖)。这个结构区域可以用其面积(MATXArea)来量化。图 2.1(b) 展示了一条严重狭窄的动脉,带有钙化斑块(绿色)和富脂坏死核心(黄色)。斑块和富脂坏死核心都被认为与卒中风险有关,这些区域可以用其体积(CALCVol 和 LRNCVol)和最大横截面积(MaxCALCArea 和 MaxLRNCArea)来量化。图 2.1(c) 中呈现的动脉显示了严重狭窄和向外的动脉壁生长。顶部箭头描绘了狭窄最大的横截面(MaxStenosisByDiameter),底部箭头描绘了正向壁重塑最大的横截面(MaxRemodelingRatio)。重塑比(remodeling ratio)是动脉壁的一种度量,比值小于 1 表示壁收缩,比值大于 1 表示壁生长。这个指标可能很重要,因为像这里显示的大重塑比的冠状动脉与破裂有关(Cilla 等人, 2013;Abdeldayem 等人, 2015)。MaxRemodelingRatio 指标捕捉三维动脉图像中(两个白色箭头之间的)最大比值区域。基于对动脉的生理学上有意义的表征,还生成了许多其他影像预测变量。
图 2.1:vascuCAP 软件应用于不同颈动脉的三幅插图,以及软件生成的影像预测变量示例。(a) 严重狭窄的颈动脉,以穿过中间的细小开口表示。(b) 带有钙化斑块(绿色)和富脂坏死核心(黄色)的颈动脉。(c) 严重狭窄并伴有正向重塑斑块的颈动脉。
该研究中的患者组还有随访信息,记录了在随后某个时间点是否发生卒中。堵塞分类与卒中结果之间的关联见表 2.1。对这些患者而言,基于关联的卡方检验(chi-squared test),该关联在统计上不显著(p = 0.42),表明仅凭堵塞分类可能不是卒中结果的良好预测指标。
表 2.1:堵塞分类与卒中结果之间的关联。
| 卒中 = 否 | 卒中 = 是 | |
|---|---|---|
| 堵塞 < 70% | 43 | 39 |
| 堵塞 > 70% | 19 | 25 |
如果斑块特征对评估卒中风险确实很重要,那么影像软件提供的斑块特征测量值可能有助于改善卒中预测。通过提高预测卒中的能力,医生可能会有更多可操作的数据来做出更好的患者管理或临床干预决策。具体来说,堵塞大(> 70%)但斑块稳定的患者可能不需要手术干预,从而免于侵入性手术,同时继续接受药物治疗。或者,斑块较小但不稳定的患者可能确实需要手术干预或更积极的药物治疗来降低卒中风险。
每位患者的数据还包括通常收集的卒中风险临床特征,如患者是否患有心房颤动(atrial fibrillation)、冠状动脉疾病(coronary artery disease),以及是否有吸烟史。性别和年龄的人口统计学信息也包括在内。这些现成的风险因素可以被认为是另一组可能有用的预测变量集,可以进行评估。事实上,应该首先评估这组预测变量的卒中预测能力,因为这些预测变量易于收集、在患者就诊时即可获得,并且不需要昂贵的影像技术。
为了评估每个集合的预测能力,我们将使用风险预测变量、影像预测变量以及两者的组合来训练模型。我们还将探索这些特征的其他表示,以提取有益的预测信息。
2.1 划分
在构建这些模型之前,我们将数据划分为一个用于开发模型、预处理预测变量以及探索预测变量与响应之间关系的集合(训练集(training set)),以及另一个作为预测变量集/模型组合性能最终裁决者的集合(测试集(test set))。为了划分数据,将对原始数据集进行分层(stratified)划分,即在每个结果类别内进行随机划分。这将使卒中患者的比例大致保持不变(表 2.2)。在划分中,70% 的数据被分配到训练集。
2.2 预处理
建模过程的第一步之一是了解重要的预测变量特征,如各自的分布、每个预测变量内的缺失程度、预测变量中可能异常的值、预测变量之间的关系,以及每个预测变量与响应之间的关系等等。毫无疑问,随着预测变量数量的增加,我们仔细管理每个预测变量的能力迅速下降。但有一些自动化工具和可视化可以实现初始探索过程的良好实践,如 Kuhn (2008) 和 Wickham 和 Grolemund (2016)。
表 2.2:训练集与测试集划分的卒中结果分布。
| 数据集 | 卒中 = 是 | 卒中 = 否 |
|---|---|---|
| 训练集(Train) | 51% (45) | 49% (44) |
| 测试集(Test) | 51% (19) | 49% (18) |
对于这些数据,所有受试者和预测变量中只有 4 个缺失值。许多模型无法容忍任何缺失值。因此,我们必须采取措施消除缺失,以便构建各种模型。插补(imputation)技术用合理的值替换缺失值,这些技术将在第 8 章讨论。这里我们将每个缺失值替换为该预测变量的中位数(median),这是一种简单、无偏的方法,对于相对少量的缺失是足够的(但远非最优)。
这个数据集足够小,可以手动探索,对影像预测变量的单变量探索揭示了许多有趣的特征。首先,影像预测变量被均值中心化并缩放到单位方差,以便进行直接的视觉比较。第二,许多影像预测变量具有长尾分布,也称为正偏态(positively skewed)分布。例如,考虑富脂坏死核心的最大横截面积(mm²)(MaxLRNCArea,显示在图 2.2a 中)。MaxLRNCArea 是对狭窄横截面上脂质池和坏死细胞碎片混合物的测量。最初,我们可能认为偏态和几个异常高的测量值是由一小部分患者造成的。我们可能很想移除这些异常值,担心它们会对模型识别预测信号的能力产生负面影响。虽然我们的直觉对许多模型来说是正确的,但这里显示的偏态通常是由数据的底层分布造成的。相反,分布才是我们应该关注的焦点。简单的对数变换(log transformation),或更复杂的 Box-Cox 或 Yeo-Johnson 变换(第 6.1 节),可以用来将数据置于近似对称的尺度上,从而消除数据中异常值的外观(图 2.2b)。这种变换对于呈指数增长的测量是有意义的。在这里,脂质面积按面积计算的定义自然呈乘法增长。
接下来,我们将移除与其他预测变量高度相关(R² > 0.9)的预测变量。影像预测变量之间的相关性可以在图 2.3 的热图(heatmap)中看到,其中列和行的顺序由一种聚类算法确定。
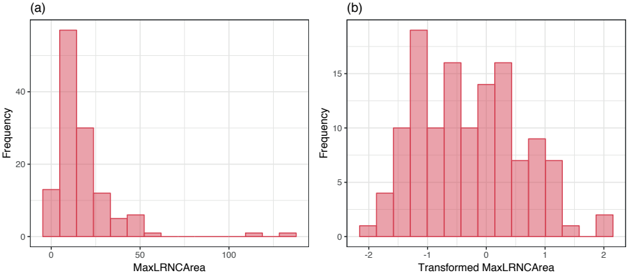
图 2.2:(a) 富脂坏死核心最大横截面积的分布。(b) Yeo-Johnson 变换后的富脂坏死核心最大横截面积的分布。
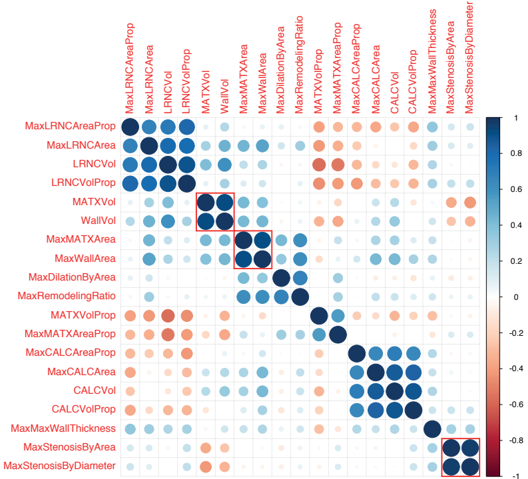
图 2.3:影像预测变量相关矩阵的可视化。
在这里,有三对预测变量显示出不可接受的高相关性:
- 血管壁体积(mm³,WallVol)与基质体积(MATXVol),
- 最大横截面壁面积(mm²,MaxWallArea)与最大基质面积(MaxMATXArea),
- 基于面积的最大横截面狭窄(MaxStenosisByArea)与基于直径的最大横截面狭窄(MaxStenosisByDiameter)。
这三对在图 2.3 相关矩阵对角线上的红色框中突出显示。很容易理解为什么第三对有高相关性,因为面积的计算是直径的函数。因此,我们只需要这些表示中的一种用于建模。虽然只有 3 个预测变量超过了高相关阈值,但还有几个预测变量区域接近该阈值。例如,钙化体积(CALCVol)和最大横截面钙化面积(mm²,MaxCALCArea)(r = 0.87),以及富脂坏死核心的最大横截面积(MaxLRNCArea)与富脂坏死核心体积(LRNCVol)(r = 0.8)具有中等强度的正相关,但没有超过阈值。这些可以在沿对角线的一大块蓝色点中看到。相关性阈值是任意的,可能需要根据问题和要使用的模型而提高或降低。第 3 章包含关于这种方法的更多细节。
2.3 探索
下一步是探索单个预测变量与响应之间以及成对预测变量与响应之间的潜在预测关系。
然而,在继续检查数据之前,需要一种机制来确保在这个小数据集中看到的任何趋势不会被过度解读。为此,将使用一种重采样(resampling)技术。使用第 3.4 节中描述的称为重复 10 折交叉验证(repeated 10-fold cross-validation)的重采样方案。这里,创建了训练集的 50 个变体,每当对训练集数据进行分析时,都会在每个重采样上对其进行评估。虽然不是万无一失的,但它确实提供了针对过拟合的某种保护。
例如,一个初步的问题是:哪些预测变量与结果有简单的关联?传统上,会对整个数据集进行统计假设检验(hypothesis test),然后显示统计显著性的预测变量将被列入模型。这种方法的问题在于,它使用所有数据来做这个决定,而这些相同的数据点将被用于最终的模型。由于将整个数据集完全重复用于两个目的,过拟合的可能性很大。此外,如果预测性能是重点,正式假设检验的结果可能与预测性不一致。
作为替代方案,当我们想比较两个模型(M₁ 和 M₂)时,将使用以下过程(在第 3.7 节中详细讨论):
算法 2.1:使用基于重采样的性能指标进行模型比较
- 对每个重采样执行:
- 使用该重采样 90% 的数据拟合模型 M₁ 和 M₂
- 用两个模型预测剩余的 10% 数据
- 计算 M₁ 和 M₂ 的 ROC 曲线下面积
- 计算两个 AUC 值之间的差
- 结束
- 对差值使用单侧 t 检验,检验 M₂ 是否优于 M₁
90% 和 10% 这两个数字并不总是被使用,它们是使用 10 折交叉验证(第 3.4.1 节)的结果。
使用该算法,在训练集的许多版本上评估第二个模型的潜在改进,并用相关指标量化改进。[13]
为了说明该算法,考虑了两种逻辑回归模型。简单模型类似于统计上的"零模型"(null model),只包含截距(intercept)项,而更复杂的模型对风险集中的每个预测变量都有一个单独的项。这些结果在表 2.3 中给出,按 ROC 改进程度从最显著到最不显著对风险预测变量排序。对于训练数据,几个预测变量在预测卒中结果方面提供了边际但显著的改进(以 ROC 的改进衡量)。基于这些结果,我们的直觉会让我们相信,显著的风险集预测变量很可能是最终预测模型不可或缺的一部分。
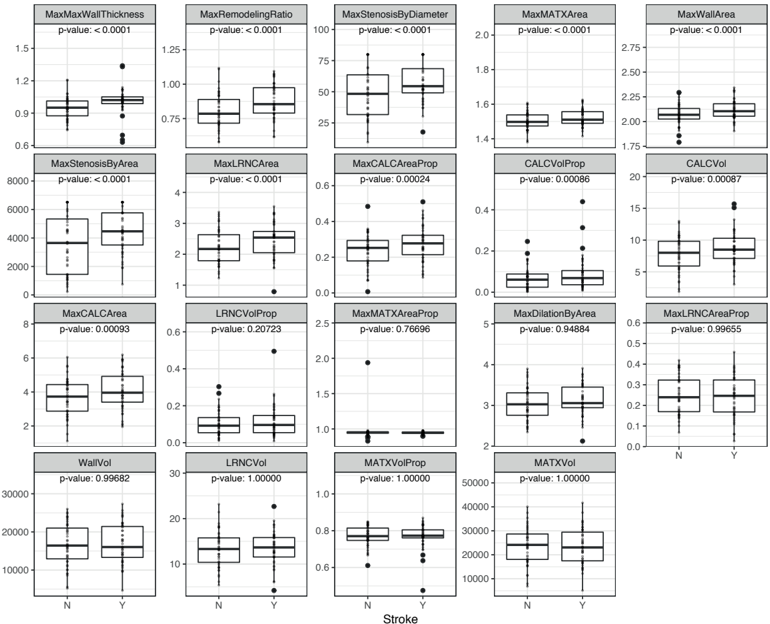
同样,可以探索连续的影像预测变量与卒中结果之间的关系。与风险预测变量一样,将仅含截距的逻辑回归模型的预测性能与包含每个影像预测变量的模型进行比较。图 2.4 展示了每个预测变量按卒中结果着色的散点图,并带有比较零模型与含各预测变量模型 ROC 改进的检验 p 值(顶部中央)。对于这些数据,目标所有横截面中最厚的壁(MaxMaxWallThickness)和最大横截面壁重塑比(MaxRemodelingRatio)与卒中结果的关联最强。让我们考虑 MaxRemodelingRatio 的结果,它表明卒中类别之间的平均值存在显著偏移。该预测变量在卒中类别之间的分布散点图仍有相当大的重叠。为了了解 MaxRemodelingRatio 在多大程度上能按卒中类别区分患者,为训练集数据创建了该预测变量的 ROC 曲线(图 2.5)。曲线表明该预测变量有一些信号,但该信号可能不足以用作预后工具。
表 2.3:风险集预测卒中结果相对于零模型的 ROC 改进。零模型的 AUC 值约为 0.50。
| 预测变量 | 改进 | p 值 | ROC |
|---|---|---|---|
| CoronaryArteryDisease | 0.079 | 0.0003 | 0.579 |
| DiabetesHistory | 0.066 | 0.0003 | 0.566 |
| HypertensionHistory | 0.065 | 0.0004 | 0.565 |
| Age | 0.083 | 0.0011 | 0.583 |
| AtrialFibrillation | 0.044 | 0.0013 | 0.544 |
| SmokingHistory | -0.010 | 0.6521 | 0.490 |
| Sex | -0.034 | 0.9288 | 0.466 |
| HypercholesterolemiaHistory | -0.102 | 1.0000 | 0.398 |
在这一点上,人们可以直接进入在预处理和过滤后的风险和/或影像预测变量上调优预测模型,看看这些预测变量如何共同识别卒中结果。这通常是实践者采取的下一步,以理解和量化模型性能。然而,还可以采取更多的探索步骤来识别其他相关且有用的预测变量构造,以改进模型的预测能力。在这种情况下,原始形式的卒中数据不包含预测变量之间交互(interaction)的直接表示(第 7 章)。预测变量之间的两两交互是探索的首要候选对象,可能包含与响应有价值的预测关系。
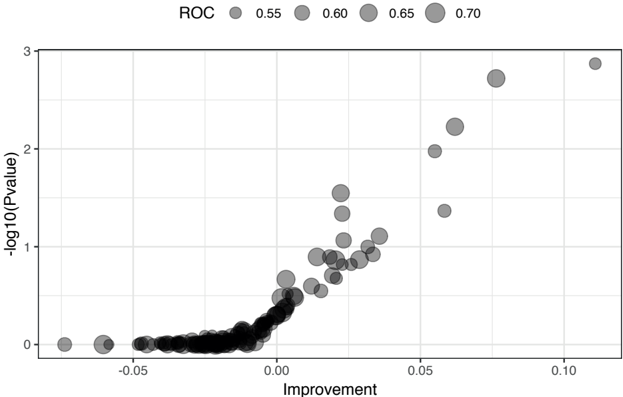
对于预测变量数量较少的数据,可以创建所有两两交互。对于数值预测变量,交互只需通过将每个预测变量的值相乘即可生成。这些新项可以添加到数据中,并作为预测变量传入模型。随着预测变量数量的增加,这种方法在实际操作上可能具有挑战性,可能需要其他方法来筛选大量可能的两两交互(详见第 7 章)。对于这个例子,为原始影像预测变量的每个可能配对创建了一个交互项(171 个潜在新项)。对于每个交互项,使用相同的重采样算法来量化仅含两个主效应(main effect)的模型与含主效应和交互项的模型的交叉验证 ROC。计算了 ROC 的改进以及交互模型对主效应模型的 p 值。图 2.6 显示了交互项带来的 ROC 改进(x 轴)与改进的负 log10 p 值(y 轴,越大越显著)之间的关系。点的大小象征主效应模型的基线 ROC 曲线下面积。符号相对较小的点表示改进是针对已经表现出良好性能的模型的。
图 2.4:影像预测变量与卒中结果之间的单变量关联。每个预测变量相对于仅含截距的逻辑回归模型的 ROC 改进 p 值列于每个小面板(facet)的顶部中央。
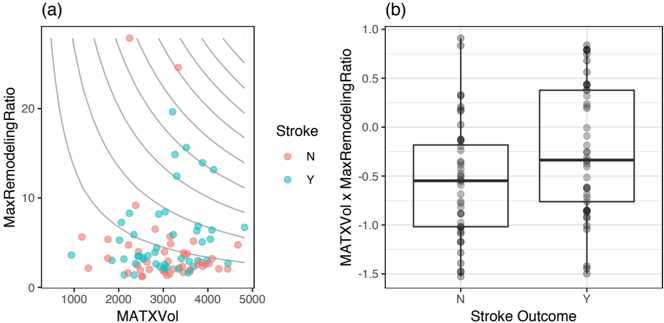
在 171 个交互项中,过滤过程表明,当以 p 值小于 0.2 过滤时,有 18 个提供了优于仅主效应的改进。图 2.7 说明了其中一个交互项的关系。面板 (a) 是两个预测变量的散点图,训练集数据按卒中结果着色。等高线表示两个预测变量之间等价的乘积值,这有助于突出这样的特征:没有卒中结果的患者这两个预测变量的乘积值通常较低。相反,有卒中结果的患者通常具有较高的乘积值。实际上,这意味着显著的堵塞与血管向外壁生长相结合会增加卒中风险。该交互在 (b) 中的箱线图表明,卒中结果类别之间的分离比任一预测变量单独使用时更强。
图 2.5:基于训练数据,最大横截面壁重塑比(MaxRemodelingRatio)作为卒中结果独立预测变量的 ROC 曲线。
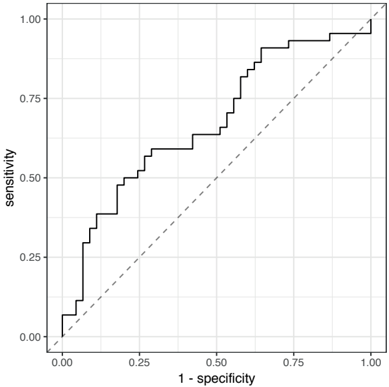
图 2.6:ROC 曲线下面积改进与影像预测变量交互项重要性 p 值的比较。
2.4 跨集合的预测建模
在这一点上,至少有五组渐进的预测变量组合可以探索其预测能力:单独的风险集、单独的影像预测变量、风险与影像预测变量组合、影像预测变量与影像预测变量交互、以及风险、影像预测变量与影像预测变量交互。我们将依次考虑对其中几组数据进行建模。
图 2.7:(a) 两个预测变量(MATXVol 和 MaxRemodelingRatio)在原始测量尺度上的二元散点图。(b) 预处理后,乘法交互在卒中结果类别之间的分布。
医生强烈倾向于使用逻辑回归,因为它具有固有的可解释性。然而,众所周知,逻辑回归是一种高偏差、低方差模型,其预测性往往低于其他低偏差、高方差模型。逻辑回归的预测性能也会因包含相关、无信息的预测变量而降低。为了找到最具预测性的逻辑回归模型,应该识别最相关的预测变量,以找到预测卒中风险的最佳子集。
针对这些数据的具体问题,使用递归特征消除(recursive feature elimination,RFE)例程(第 10 章和第 11 章)来确定更少的预测变量是否有优势。RFE 是一个简单的向后选择过程:最初使用最大的模型,然后从这个模型中按重要性对每个预测变量进行排序。对于逻辑回归,有几种确定重要性的方法,我们将使用每个模型项回归系数的简单绝对值(在预测变量被中心化和缩放之后)。RFE 过程开始移除最不重要的预测变量,重新拟合模型,并评估性能。在每次模型拟合时,预测变量都会经过初始 Yeo-Johnson 变换以及中心化和缩放预处理。
正如后面章节将讨论的,预测变量之间的相关性会导致逻辑回归系数不稳定。虽然有更复杂的方法,但对数据使用额外的变量过滤器,以移除最少数量的预测变量,使预测变量之间没有成对相关性大于 0.75。数据处理将分别在有和没有这一步的情况下进行,以显示对特征选择过程的潜在影响。
我们之前的重采样方案与 RFE 过程结合使用。这意味着向后选择在训练集的 90% 上执行了 50 次,剩余 10% 用于评估移除预测变量的效果。使用这些结果确定最优子集大小,最终一次 RFE 执行在整个训练集上进行,并在最优大小处停止。同样,这种重采样过程的目标是降低这个小数据集中过拟合的风险。此外,所有预处理步骤都在这些重采样步骤内进行,因此相关性过滤器可能会为每个重采样选择不同的变量。这是有意为之,也是衡量预处理步骤对建模过程影响和变异性的唯一方法。
RFE 过程应用于:
- 包含 8 个预测变量的小型风险集。由于这不是一个大集合,生成了全部 28 个两两交互。当应用相关性过滤器时,模型项的数量可能会大幅减少。
- 包含 19 个影像预测变量的集合。本章前面推导出的交互效应也考虑了这些数据。
- 全部预测变量集。影像交互也与这些变量结合。
图 2.8 显示了结果。当只考虑风险集的主效应时,全部 8 个预测变量的集合受到青睐。当添加全部 28 个两两交互时,额外的交互损害了模型性能。基于重采样,13 个预测变量的集合是最优的(其中 11 个是交互)。当应用相关性过滤器时,主效应模型不受影响,而交互模型最多有 18 个预测变量。总的来说,过滤器对这个预测变量集没有帮助。
对于影像预测变量集,数据更偏好一个不包含之前发现的任何交互但包含相关性过滤器的模型。这看起来可能违反直觉,但要理解,这些交互是在没有其他预测变量或交互的情况下发现的。非交互项似乎补偿或取代了最重要交互项提供的信息。关于为什么相关性过滤器改善了这些预测变量的一个合理假设是,它们彼此之间的相关性往往更高(与风险预测变量相比)。到目前为止最好的模型基于过滤后的 7 个影像主效应集。
当组合两个预测变量集时,没有相关性过滤器的模型性能处于中等水平,交互模型和主效应模型之间没有真正差异。一旦应用过滤器,数据强烈倾向于主效应模型(包含通过相关性过滤器的全部 10 个预测变量)。
使用这个训练集,我们估计过滤后的 7 个影像预测变量集是我们最好的选择。最终的预测变量集是 MaxLRNCArea、MaxLRNCAreaProp、MaxMaxWallThickness、MaxRemodelingRatio、MaxCALCAreaProp、MaxStenosisByArea 和 MaxMATXArea。为了理解选择过程中的变异性,表 2.4 显示了在所有 50 个重采样中,7 变量模型中被选中的预测变量的频率。选择结果相当一致,尤其是对于这么小的训练集。
图 2.8:各种条件下的递归特征消除结果。
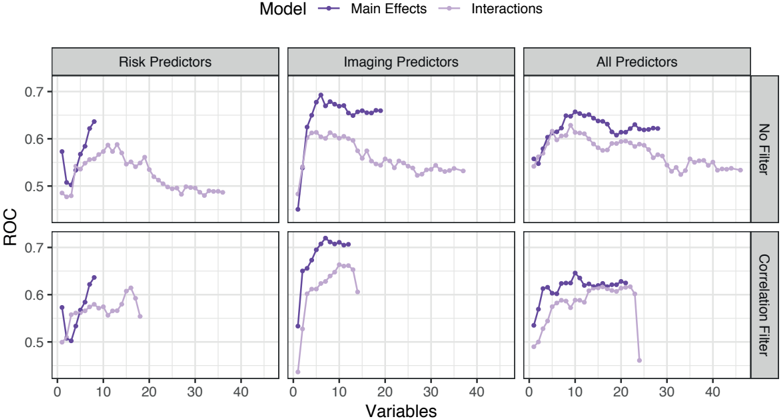
表 2.4:RFE 选择在重采样间的一致性。
| 预测变量 | 被选中次数 | 是否进入最终模型? |
|---|---|---|
| MaxLRNCAreaProp | 49 | 是 |
| MaxMaxWallThickness | 49 | 是 |
| MaxCALCAreaProp | 47 | 是 |
| MaxRemodelingRatio | 45 | 是 |
| MaxStenosisByArea | 41 | 是 |
| MaxLRNCArea | 37 | 是 |
| MaxMATXArea | 24 | 是 |
| MATXVolProp | 18 | 否 |
| CALCVolProp | 12 | 否 |
| MaxCALCArea | 7 | 否 |
| MaxMATXAreaProp | 7 | 否 |
| MaxDilationByArea | 6 | 否 |
| MATXVol | 4 | 否 |
| CALCVol | 2 | 否 |
| LRNCVol | 2 | 否 |
这个预测变量集在测试集上表现如何?测试集的 ROC 曲线下面积估计为 0.69。这小于重采样估计值 0.72,但大于该数字估计的 90% 下界(0.674)。
2.5 其他考虑
这里介绍的方法并不是可以用这些数据采取的唯一方法。例如,如果正在评估的模型是逻辑回归,那么 glmnet 模型(Hastie 等人, 2015)是一种将特征选择纳入逻辑回归拟合过程的模型。[14] 此外,你可能想知道为什么我们选择只预处理影像预测变量,为什么不探索风险预测变量之间或风险预测变量与影像预测变量之间的交互,为什么在原始预测变量上而不是预处理后的预测变量上构造交互项,或者为什么不采用不同的建模技术或特征选择例程。你问这些问题是对的。事实上,可能有一种不同的预处理方法、不同的预测变量组合或不同的建模技术可以带来更好的预测性。我们在这段简短旅程中的主要观点是说明,多花一点时间(有时是很多时间)研究预测变量以及预测变量之间的关系,有助于提高模型的预测性。当预测性能的边际收益能带来显著好处时尤其如此。
2.6 计算
网站 http://bit.ly/fes-stroke 包含用于重现这些分析的 R 程序。
脚注
[13] 正如本章末尾以及第 7.3 节所指出的,这种方法的应用存在缺陷。
[14] 该模型将在第 7.3 节和第 10 章中进一步讨论。