引言(Introduction)
统计模型在现代社会中无处不在,其重要性日益凸显。它们使我们能够在日常生活中生成各种类型的预测。例如,医生依靠由模型推导出的通用规则,这些规则告诉他们哪些特定患者群体罹患某种疾病或发生某种事件的风险更高。对航班到达时间的数值预测可以帮助我们了解飞机是否可能晚点。在其他情况下,模型能有效地告诉我们什么是重要的或具体的。例如,律师可能会利用统计模型来量化潜在招聘偏见(hiring bias)是偶然发生的可能性,还是可能属于系统性问题。
在以上每种情况下,模型都是通过获取现有数据并找到一种对数据具有可接受保真度的数学表示来创建的。从这样的模型中,可以估计出重要的统计量。就航班延误而言,对结果(到达时间)的预测就是关注的数量,而对潜在招聘偏见的估计则可能通过某个特定的模型参数揭示出来。在后一种情况下,招聘偏见的估计值通常要与数据中估计的不确定性(即噪声)进行比较,并根据这样的结果相对于噪声而言有多罕见来做出判断——这一概念通常被称为"统计显著性(statistical significance)"。这类模型通常被认为是推断性的(inferential):得出结论是为了理解自然的状态。相比之下,对特定值(如到达时间)的预测反映的是一个估计问题,我们的目标不一定是理解某个趋势或事实是否真实,而是专注于最准确地确定该值。预测中的不确定性是另一个重要的量,尤其是用于衡量模型产生的值的可信度。
无论模型将用于推断还是估计(或者极少数情况下两者兼用),都有一些重要的特征需要考虑。简约性(parsimony,即简单性)是一个关键的考量。简单的模型通常比复杂的模型更受欢迎,尤其是在以推断为目标时。例如,在参数较少的模型中更容易设定现实的分布假设。简约性还能提高模型的可解释性(interpretability)。例如,经济学家可能对量化研究生教育对薪酬的益处感兴趣。一个简单的模型可以用线性关系来表示受教育年限与工作薪酬之间的关系。这种参数化将便于对这类教育的潜在益处进行统计推断。但假设这种关系在不同职业之间存在显著差异,和/或不是线性的。那么更复杂的模型在捕捉数据模式方面会做得更好,但可解释性会差得多。
然而,问题在于,准确性不应为了简单而严重牺牲。简单的模型可能易于解释,但如果它不能保持对数据可接受的忠实度,就不会成功;如果模型的准确率只有 50%,它应该被用来做推断或预测吗?复杂性通常是解决准确性不佳的办法。通过使用额外的参数或使用本质上非线性的模型,我们或许能提高准确性,但可解释性很可能会大大受损。这种权衡是构建模型时的一个关键考量。
到目前为止,讨论都集中在模型的各个方面。然而,进入模型的变量(以及它们的表示方式)对成功同样关键。不谈模型就无法谈论建模,但本书的目标之一是加强对模型中预测变量的重视。
在术语方面,被建模或被预测的量被称为:结果(outcome)、响应(response)或因变量(dependent variable)。用于对结果建模的变量被称为预测变量(predictors)、特征(features)或自变量(independent variables)(取决于上下文)。例如,在为房屋的销售价格(结果)建模时,房产的特征(如面积、卧室数量和浴室数量)可以用作预测变量(特征这一术语也同样适用)。然而,考虑由两个或多个变量复合而成的人为模型项,例如每间浴室的卧室数量。这类变量或许更恰当地被称为特征(feature,或派生特征 derived feature)。无论如何,特征和预测变量在模型中都是用来解释结果的。[4]
正如人们所料,将预测变量引入模型有好的方式和坏的方式。在许多情况下,一条底层信息可以有多种表示或编码方式。考虑一个房产销售价格的模型。位置很可能至关重要,而且可以有多种表示方式。图 1.1 显示了 2006 年至 2010 年间在艾奥瓦州艾姆斯(Ames, Iowa)市内及周边售出房产的位置。在这张图中,颜色代表报告的居住社区(neighborhood)。这里展示了 28 个社区,每个社区的房产数量从 Landmark 的 1 套到 North Ames 的 443 套不等。数据中位置的第二种表示是经度和纬度。房地产经纪人可能会建议使用邮政编码(ZIP Code™)作为模型中的预测变量,作为学区的代理,因为这对于有孩子的买家来说可能是一个重要的考量因素。但从信息论的角度来看,经度和纬度在测量物理位置方面提供了最大的特异性,人们可能会论证这种表示具有更高的信息含量(假设这一特定信息具有预测性)。
图 1.1:艾奥瓦州艾姆斯市在售房屋,按社区着色。Leaflet | © OpenStreetMap © CartoDB
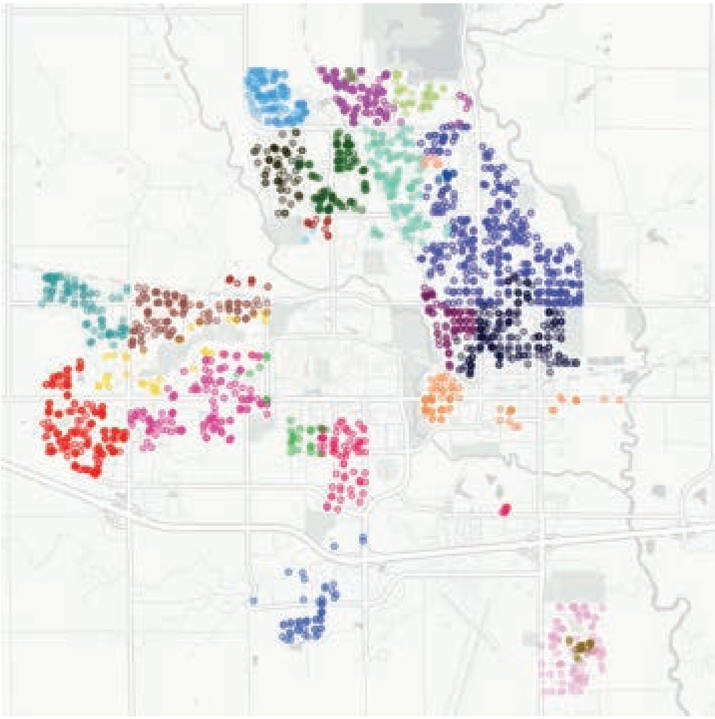
不同预测变量在模型中的表示方式各有优劣,这种想法引出了特征工程(feature engineering)的概念——即创建能够提高模型有效性的数据表示的过程。
请注意,模型的有效性受许多因素的影响。显然,如果预测变量与结果没有关系,那么它的表示就无关紧要。然而,非常重要的是要认识到,模型的种类繁多,每种模型都有其自身的敏感性和需求。例如:
- 有些模型无法容忍测量同一底层量的预测变量(即预测变量之间的多重共线性(multicollinearity)或相关性)。
- 许多模型不能使用含有任何缺失值(missing value)的样本。
- 当数据中存在不相关的预测变量时,某些模型的性能会受到严重损害。
特征工程和变量选择(variable selection)有助于缓解其中的许多问题。本书的目标是帮助实践者通过关注预测变量来构建更好的模型。“更好"取决于问题的具体背景,但很可能涉及以下因素:准确性、简单性和稳健性(robustness)。要实现这些特性,或在它们之间做出良好的权衡,关键在于理解模型中使用的预测变量与模型类型之间的相互作用。有时,通过以模型更容易消化的方式表示数据,或减少使用的变量数量,可以提高准确性和/或简单性。为了说明这一点,下一节将展示一个包含两个预测变量的简单示例。此外,第 1.3 节将讨论一个更实质性的示例,它更接近实践中的建模过程。
1.1 简单示例
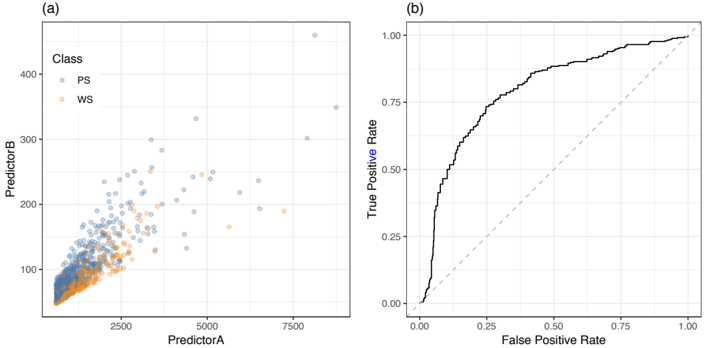
作为特征工程如何影响模型的一个简单示例,请考虑图 1.2a,它显示了两个相关预测变量(标记为 A 和 B)的散点图。数据点按其结果着色,结果是一个具有两个可能值(“PS"和"WS”)的离散变量。这些数据来自 Hill 等人(2007)的一项实验,该实验包含更大的预测变量集。对于他们的任务,模型需要高准确度,但不需要用于推断。为了便于说明,这里只考虑这两个预测变量。在这张图中,两个类别之间显然存在对角线分离。这里将使用一个简单的逻辑回归(logistic regression)模型(Hosmer 和 Lemeshow, 2000),用这两个变量来建立预测方程。该模型使用以下方程:
\[ p = \frac{1}{1 + \exp[-( \beta_0 + \beta_1 A + \beta_2 B)]} \]其中 p 是样本属于"PS"类别的概率,β 值是需要从数据中估计的模型参数。
使用标准过程(最大似然估计(maximum likelihood estimation))从数据中估计这三个回归参数。作者用 1009 个数据点来估计参数(即训练集(training set)),并保留了 1010 个样本专门用于估计性能(测试集(test set))。[5] 使用训练集,估计出的参数为 \( \hat{\beta}_0 = 1.73 \)、\( \hat{\beta}_1 = 0.003 \) 和 \( \hat{\beta}_2 = -0.064 \)。
为了评估模型,在测试集上进行预测。逻辑回归天然产生类别概率,给出每个类别的似然指示。虽然通常使用 50% 的截断值来做硬性类别预测,但由这种默认设置得出的性能可能具有误导性。为了避免应用概率截断值,这里使用一种称为受试者工作特征(receiver operating characteristic,ROC)曲线的技术。[6] ROC 曲线在所有可能的截断值上评估结果,并绘制真阳性率(true positive rate)对假阳性率(false positive rate)的曲线。此示例的曲线如图 1.2b 所示。最好的曲线是尽可能向左上角移动的曲线,而无效的模型将沿着虚线对角线。该技术常用的汇总值是 ROC 曲线下面积(area under the ROC curve),其中 1.0 对应于完美模型,而接近 0.5 的值表明模型没有预测能力。对于当前的逻辑回归模型,ROC 曲线下面积为 0.794,表明对响应进行分类的准确度中等。
图 1.2:(a) 一个示例数据集;(b) 简单逻辑回归模型的 ROC 曲线。
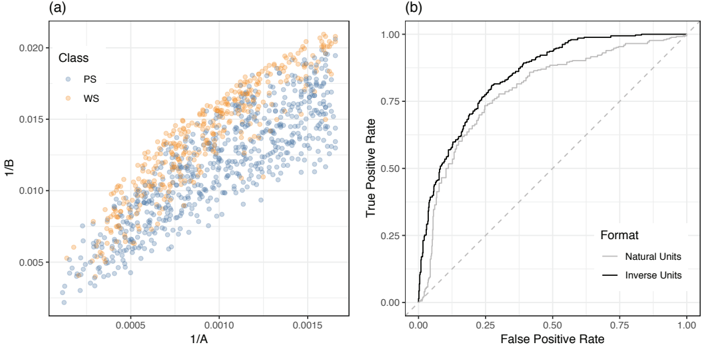
鉴于这两个预测变量,尝试对这些数据进行不同的变换和编码以增加 ROC 曲线下面积是有意义的。由于两个预测变量都大于零,且分布看起来呈右偏(right-skewed),人们可能会倾向于取比率 A/B,并只将该比率项放入模型。或者,我们也可以评估对每个预测变量的简单变换是否有帮助。一种方法是 Box-Cox 变换,[7] 它在逻辑回归模型之前使用一个单独的估计过程,可以将预测变量置于新的尺度上。使用这种方法,Box-Cox 估计过程建议两个预测变量都应使用倒数尺度(即用 1/A 代替 A)。这种数据表示如图 1.3a 所示。当这些变换后的值替代原始值进入逻辑回归模型时,ROC 曲线下面积从 0.794 变为 0.848,这是一个显著的提升。图 1.3b 显示了两条曲线。在这种情况下,对应变换后预测变量的 ROC 曲线一致地优于原始结果。
这个例子说明了如何通过改变预测变量(这里是简单的变换)来提高模型的有效性。比较图 1.2a 和图 1.3a 中的数据,可以更容易地通过视觉区分两组数据。通过对数据进行单独变换,我们使逻辑回归模型能够更好地分离类别。取决于预测变量的性质,使用原始数据的倒数可能会使推断分析更加困难。
图 1.3:(a) 变换后的预测变量;(b) 两个逻辑回归模型的 ROC 曲线。
然而,不同的模型对数据有不同的要求。如果原始预测变量的偏态(skewness)是影响逻辑回归模型的问题,那么存在其他模型对这一特征没有同样的敏感性。例如,神经网络(neural network)也可以在不使用预测变量倒数变换的情况下拟合这些数据。[8] 该模型实现的 ROC 曲线下面积为 0.848,与改进后的逻辑回归结果大致相当。人们可能会得出结论:神经网络模型本质上总是优于逻辑回归,因为神经网络不受预测变量分布特性的影响。但鉴于"没有免费的午餐”(No Free Lunch)定理(见第 1.2.3 节),我们不应草率地得出这样的笼统结论。此外,神经网络模型也有其自身的缺点:它完全不可解释,并且需要大量的参数调优才能获得良好的结果。取决于模型将如何使用,对于这些数据,这两种模型中的某一种可能比另一种更受欢迎。
关于不同特征如何以不同方式影响模型的更全面总结,将在第 1.3 节中给出。在这个例子之前,下一节将讨论贯穿全书使用的几个关键概念。
1.2 重要概念
在进入具体的策略和方法之前,有一些关键概念需要讨论。这些概念涉及建模的理论方面以及创建模型的实践。这里讨论其中一些方面,更详细的内容将在后面的章节中提供,并在全书中给出参考文献。
1.2.1 过拟合
过拟合(overfitting)是指模型对当前数据拟合得很好,但在预测新样本时失败的情况。它通常发生在模型过度依赖当前数据集中不会在其他地方出现的模式和趋势时。由于模型只能访问当前数据集,它无法理解这些模式是异常的。例如,在图 1.1 所示的住房数据中,人们可以确定,建筑面积在 1267.5 到 1277 平方英尺之间且含三间卧室的房产,其销售价格可以在真实值的 1207 美元范围内被预测出来。然而,对于(不在该数据集中的)满足这些条件的其他房屋,准确度会差得多。这是一个无法推广到新数据的趋势的例子。
通常,非常灵活的模型(在第 1.2.5 节中称为"低偏差模型")过拟合数据的可能性更高。这些模型很容易在用于创建模型的数据集上表现得非常好,而如果没有一些预防机制,就很容易无法泛化到新数据。正如在接下来的章节中将看到的,尤其是第 3.5 节,过拟合是建模的主要风险之一,实践者应予以关注。
虽然模型可能对数据点过拟合,如上面显示的住房数据,但特征选择技术可能对预测变量过拟合。当一个变量在当前数据集中看起来相关,但一旦收集到新数据就与结果没有真正的关系时,就会发生这种情况。当数据点数量(记为 n)很小而潜在预测变量数量(p)非常大时,这种过拟合的风险尤其危险。与对数据点过拟合一样,这个问题可以通过一种在发生时发出警告的方法来缓解。
1.2.2 有监督与无监督方法
有监督数据分析(supervised data analysis)涉及识别预测变量与被建模或预测的既定结果之间的模式,而无监督技术(unsupervised technique)则只关注识别预测变量之间的模式。
两类分析通常都会涉及一定量的探索。探索性数据分析(exploratory data analysis,EDA)(Tukey, 1977)用于理解预测变量和结果的主要特征,以便在建模之前发现与数据相关的任何特定挑战。这可以包括调查变量间的相关结构、缺失数据的模式,和/或数据中可能挑战建模者初始预期的异常模式。
显然,预测模型是严格有监督的,因为其直接关注点在于找到预测变量与结果之间的关系。无监督分析包括聚类分析(cluster analysis)、主成分分析(principal component analysis)等方法,以及类似的用于发现数据模式的工具。
有监督和无监督分析都容易过拟合,但有监督分析尤其容易在数据中发现用于预测结果的错误模式。简而言之,我们可以利用这些技术制造一种自我实现的预测预言(self-fulfilling predictive prophecy)。例如,分析人员经常对有监督分析来检测哪些预测变量与结果显著相关。然后,这些显著的预测变量在相同数据上用于可视化(如热图或聚类分析)。毫不奇怪,该可视化可靠地展示了结果与预测变量之间的清晰模式,似乎为它们的重要性提供了证据。然而,由于展示的是相同的数据,这种可视化本质上是挑选那些只对这些数据成立、且不太可能推广到新数据的结果。这个问题在本书的不同地方都有讨论,但最直接的是在第 3.8 节。
1.2.3 天下没有免费的午餐
“没有免费的午餐"定理(Wolpert, 1996)认为,在没有对当前问题或数据的任何具体了解的情况下,没有任何一个预测模型可以被说是最好的。有许多模型针对某些数据特征(如缺失值或共线预测变量)进行了优化。在这些情况下,假设它们(在其他条件相同的情况下)比其他模型做得更好是合理的。但在实践中,事情并没有那么简单。一个针对共线预测变量优化的模型可能被限制为只能对数据中的线性趋势建模,并且对数据的缺失敏感。要预测最好的模型是非常困难的,尤其是在数据到手之前。
有一些实验旨在判断哪些模型平均而言往往比其他模型更好,特别是 Demsar(2006)和 Fernandez-Delgado 等人(2014)。这些分析表明,有些模型有产生最准确模型的倾向,但"获胜"的比率不足以实施"总是使用模型 X"的策略。
在实践中,明智的做法是尝试多种不同类型的模型,以探明哪些模型能很好地适用于你的特定数据集。
1.2.4 模型与建模过程
开发有效模型的过程既是迭代的,也是启发式的。在与数据集打交道之前很难知道它的需求,而且在模型最终确定之前,通常要对许多方法进行评估和修改。许多书籍和资源只关注建模技术,但这项活动往往只是整个过程中的一小部分。图 1.4 展示了为典型问题创建模型的整体过程的示意图。
图 1.4:典型建模过程的示意图。
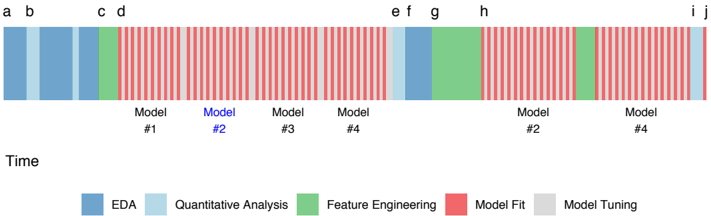
最初的活动从标记 (a) 开始,其中使用探索性数据分析来研究数据。[9] 在初步探索之后,标记 (b) 表示可能进行早期数据分析的位置。这可能包括评估简单的汇总度量,或识别与结果强相关的预测变量。过程可能会在可视化和分析之间迭代,直到建模者确信数据已被充分理解。在里程碑 (c) 处,根据之前的分析,创建预测变量在模型中将如何表示的第一版草稿。
此时,可能会用初始特征集评估几种不同的建模方法。然而,许多模型可能包含需要调优的超参数(hyperparameter)。[10] 这在标记 (d) 处表示,其中显示了四组模型,用细红色标记表示。这代表正在评估的四个不同模型,但每个模型都要在一组候选超参数值上评估多次。这种模型调优过程在第 3.6 节中讨论,并在后面的章节中多次说明。一旦四个模型完成调优,就在数据上对它们进行数值评估,以了解其性能特征 (e)。使用每个模型的汇总度量(如模型准确度)来了解问题的难度,并确定哪些模型似乎最适合数据。基于这些结果,可以对模型结果进行更多的 EDA (f),例如残差分析(residual analysis)。对于前面预测房屋销售价格的例子,可以检查预测不佳的房产,以了解模型是否存在任何系统性问题。例如,可能有些特定的邮政编码难以准确评估。因此,可以再进行一轮特征工程 (g) 来弥补这些障碍。到这时,可能已经清楚哪些模型往往最适合当前的问题,可以对更少的模型进行另一轮更广泛的模型调优 (h)。在对预测变量表示进行更多调优和修改后,两个候选模型(#2 和 #4)被最终确定。这些模型可以在外部测试集上评估,作为模型之间的最终"决选”(bake off)(i)。然后选择最终模型 (j),这个拟合好的模型将被用于预测新样本或进行推断。
这张示意图的意义在于说明,过程中的活动远不止拟合一个单一的数学模型。对大多数问题来说,常见的做法是有反馈回路,反复评估和再评估任何模型/特征集组合的表现如何。
1.2.5 模型的偏差与方差
方差(variance)是一个被充分理解的概念。当用于数据时,它描述的是数值波动的程度。如果同一个物体被测量多次,观测到的测量值会在一定程度上有所不同。在统计学中,偏差(bias)通常被认为是一个事物偏离其真实底层值的程度。例如,在试图估计公众对某个话题的意见时,如果受访者在人口统计学上过度代表某一特定群体,那么民调可能会有系统性偏差。这种偏差是民调错误估计期望目标的结果。
模型也可以用方差和偏差来评估(Geman 等人, 1992)。如果用于估计参数的底层数据发生微小变化,就会引起参数(或模型结构)的显著变化,那么这个模型就具有高方差。例如,一组数据点的样本均值比样本中位数具有更高的方差。后者只使用数据分布中心的值,因此对数值的适度变化不敏感。低方差模型的一些例子有线性回归(linear regression)、逻辑回归和偏最小二乘(partial least squares)。高方差模型包括那些强烈依赖单个数据点来定义其参数的模型,如分类树或回归树(classification or regression trees)、最近邻模型(nearest neighbor model)和神经网络。为了对比低方差模型和高方差模型,请考虑线性回归和最近邻模型。线性回归使用所有数据来估计斜率参数,虽然它对异常值可能敏感,但远比最近邻模型不敏感。
模型偏差反映的是模型符合数据底层理论结构的能力。低偏差模型是高度灵活的,有能力拟合各种不同的形状和模式。高偏差模型则无法估计接近其真实理论对应值的数值。线性方法通常具有高偏差,因为如果不加修改,它们无法描述预测变量中的非线性模式。基于树的模型、支持向量机(support vector machines)、神经网络等对数据有很强的适应性,偏差较低。
正如人们所料,模型偏差和方差常常相互对立;为了获得低偏差,模型往往表现出高方差(反之亦然)。方差-偏差权衡(variance-bias trade-off)是统计学中一个常见的主题。在许多情况下,模型具有控制模型灵活性的参数,从而影响结果的方差和偏差特性。考虑一个简单的数据点序列,如每日股价。移动平均(moving average)模型将通过某一天前后一定窗口内数据点的平均值来估计当天的股价。窗口的大小可以调节这里的方差和偏差。对于小窗口,平均值对数据的响应要灵敏得多,并且有很大潜力匹配底层趋势。然而,它也继承了窗口内数据的高度敏感性,这增加了方差。加宽窗口将对更多点取平均,并减少模型中的方差,但也会通过冒过度平滑数据的风险来降低模型拟合的潜力(从而增加偏差)。
图 1.5:一个模拟数据集,以及三点移动平均(绿色)和二次回归(紫色)的模型拟合。
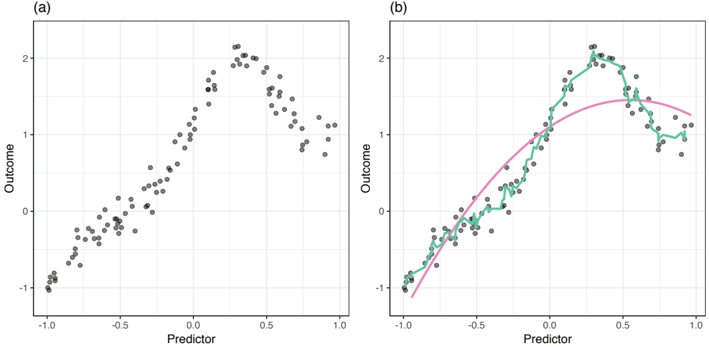
考虑图 1.5a 中的例子,它包含单个预测变量和结果,两者之间的关系是非线性的。右侧面板 (b) 显示了两条模型拟合线。首先使用简单的三点移动平均(绿色)。这条趋势线有些起伏,但很好地跟踪了数据中的非线性趋势。紫色线显示的是标准线性回归模型的结果,该模型包含预测变量项和预测变量平方项。线性回归在模型参数上是线性的,向模型添加多项式项可以是一种有效的方式,让模型识别非线性模式。由于数据点从 y 轴较低处开始,在预测变量值约 0.3 处达到顶点,然后下降,二次回归(quadratic regression)模型是对这些数据建模的合理首选。这个模型非常平滑(表现出低方差),但对数据中看到的非线性趋势拟合得不是很好(即高偏差)。
图 1.6:数据的二十个抖动版本的模型拟合。
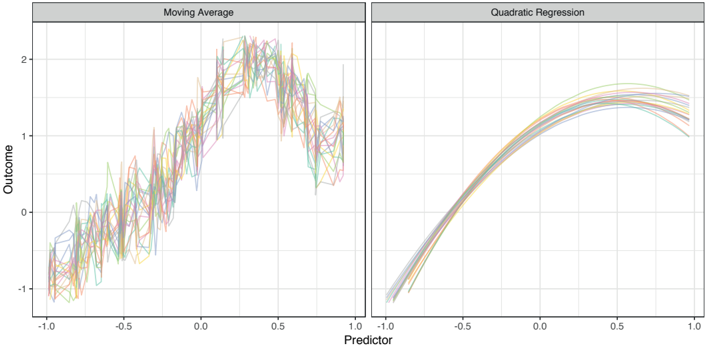
为了进一步强调这一点,原始数据被多次"抖动"(jittered),即向数值中添加少量随机噪声。这进行了二十次,对每个版本的数据,都向抖动后的数据拟合相同的两个模型。拟合曲线如图 1.6 所示。移动平均在回归预测中表现出显著的噪声,但平均而言,能够很好地跟踪数据模式。二次模型没有被额外的噪声迷惑,生成了非常相似(尽管不准确)的模型拟合。
模型偏差和方差的概念是本书思想的核心。如前所述,简单性是模型的一个重要特征。创建低方差、低偏差模型的一种方法是用适当的数据表示来增强低方差模型,以降低偏差。第 1.1 节中的前一个例子就是这个过程的简单示例;通过修改预测变量,逻辑回归(高偏差、低方差)得到了改进,并能够展示出与神经网络模型(低偏差)相当的结果。作为另一个例子,图 1.5(a) 中的数据是用以下方程生成的:
\[ y = \sin(2\pi x) + \epsilon \](译者注:原书该公式在 docling 提取中未解码,此处按文中描述——数据从低处起始、在预测变量值约 0.3 处达到顶点后下降——重建为 \(y = \sin(2\pi x) + \epsilon\)。)
理论上,如果这种函数形式能从数据中确定,那么最好的可能模型将是一个非线性回归模型(低方差、低偏差)。我们将在第 3.4.6 节以使用重采样测量性能为背景,重新讨论方差-偏差关系。
类似地,由于不相关的预测变量导致模型产生多余的变动,模型的性能可能会下降。特征选择技术通过减少多余变量的不必要噪声来改进模型。
1.2.6 经验驱动建模与实证驱动建模
有些项目的数据此前从未应用过建模。例如,假设一个新的客户数据库可用,该数据库包含大量可能成为预测变量的字段。领域专家(subject matter expert)可能根据以往的经验,对模型中应包含哪些特征有很好的判断。这种知识使专家能够确切地规定使用哪些变量以及如何表示它们。鉴于他们的专业知识,他们的推理应被认真考虑。然而,由于模型从数据中估计参数,人们可能会有强烈的愿望采用数据驱动(data-driven)而非经验驱动(experience-driven)的方式。
许多类型的模型都有能力凭经验辨别哪些预测变量应进入模型,并能推导出(基于可用数据)最大化性能的预测变量表示。这种方法的(感知到的且往往真实的)危险有两方面。第一,如前所述,数据驱动的方法有对数据中的虚假模式过拟合的风险。第二,它们可能产生高度复杂、且可能没有任何明显理性解释的模型。在后一种情况下,可能会出现循环论证:实践者只接受那些量化了他们已知内容的模型,却期望结果优于人工手动评估所能提供的。例如,如果发现一个意想不到的新预测变量与结果有很强的关系,这可能会挑战当前的传统观念,并受到怀疑。
经验驱动建模与实证驱动建模之间经常存在一些冲突。每种方法都有其优缺点。在实践中,我们发现只要双方都能看到对方方法的价值,两种方法的结合效果最好。如果领域专家觉得用于发现特征的方法足够严谨,能够避免虚假结果,他们可能对一个新颖的模型特征更有信心。另外,实证建模者可能会从专家的建议中获益,用这些建议初步缩减大量预测变量,或至少帮助在建模过程中对它们进行优先级排序。此外,特征工程的过程需要一定程度的与所建模对象相关的专业知识。在真空中或不了解项目背景的情况下,很难就预测变量应如何表示提出建议。例如,在第 1.1 节的简单示例中,对预测变量进行倒数变换对经验丰富的实践者来说可能显而易见。
1.2.7 大数据
大数据(Big Data)的定义有些模糊。通常,这个术语意味着大量的数据点(相对于变量而言),值得注意的是,有效样本量(effective sample size)可能小于实际数据量。例如,如果存在严重的类别不平衡(class imbalance)或稀有事件发生率,数据中的事件数量可能相当少。在线广告的点击率(click-through rate)就是一个很好的例子。
另一个例子是当预测变量空间的某个特定区域被大量采样时。假设一个数据集有数十亿条记录,但大多数对应某个年龄范围内的白人男性。不同样本的数量可能很少,导致数据集缺乏多样性。
大数据的规模帮不上忙的一种情况是,当样本在数据的主流范围内增加时。这只会增加变量分布的粒度,超过某一点后,可能对数据分析没有帮助。当人口的新领域被纳入时,更多的数据行会有帮助。换句话说,大数据并不一定意味着更好的数据。
虽然大数据的好处被广泛宣扬,但它也有一些潜在的缺点。首先,它可能根本无法解决分析中遇到的问题。当预测变量与结果之间不存在关系时,大数据无法自动引出这种关系。第二,拥有大量数据通常会产生计算上的影响。许多高方差/低偏差模型往往非常复杂且计算量大,拟合这些模型的时间会随着数据量的增加而增加,在某些情况下,增加可能是非线性的。添加更多数据使这些模型能够更准确地反映数据的复杂性,但需要专门的解决方案才能可行。这本身并不是问题,除非这些解决方案产生了限制可用模型类型的效果。最好是让问题来决定需要哪种类型的模型。
此外,并非所有模型都能利用大数据量。对于高偏差、低方差模型,大数据往往只是降低了参数估计的标准误。例如,在基于一百万条数据记录创建的线性回归中,将训练数据量翻倍或三倍不太可能在实际意义上改善参数估计(在其他条件相同的情况下)。
然而,有些模型可以有效地利用大型数据集。在某些领域,可能存在大量未标记的数据(unlabeled data),其中结果未知,但预测变量已被测量或计算。经典的例子是图像和文本,但未标记的数据也可能出现在其他情况中。例如,制药公司拥有大量已设计出的化合物数据库,但其重要特性尚未被测量(这可能很昂贵)。其他例子包括公共政府数据库,其中有大量数据尚未与特定结果相关联。
未标记数据可以用来解决一些特定的建模问题。对于需要正式概率设定的模型,确定多元分布可能极其困难。大量的预测变量数据可以帮助估计或设定这些分布。自编码器(autoencoders,在第 6.3.2 节中讨论)是可以对预测变量值去噪或平滑的模型。创建自编码器不需要结果,因此未标记数据有可能改善这种情况。
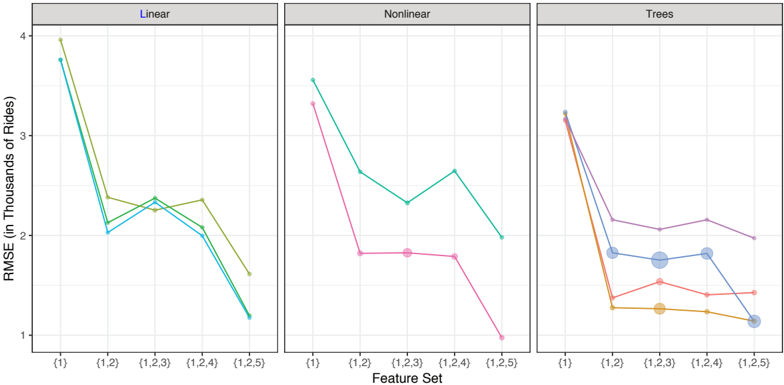
图 1.7:对芝加哥轨道交通客流量建模的一系列模型与特征集组合。点的大小与调优和训练模型所需的时间成正比。
总的来说,当遇到(或被提供)大量数据时,人们可能会想到问:
- 你要用它做什么?它是否解决了一些未满足的需求?
- 它会碍事吗?
1.3 一个更复杂的示例
为了说明模型与特征之间的相互作用,我们展示一个更现实的示例。[11] 这里讨论的案例研究涉及预测芝加哥 “L” 线列车(即每天进入某个特定车站的人数)的客流量。如果能建立足够有预测力的模型,芝加哥交通管理局(Chicago Transit Authority)就可以利用该模型适当地安排列车工作人员和每条线路所需的车厢数量。这个数据集将在第 4.1 节中更详细地讨论,但本节描述的是最初分析数据时评估的一系列模型。
首先,考虑了一个包含四个预测变量的简单集合。这些初始预测变量被标记为"集合 1",因为它们易于计算,而且可视化显示它们与客流量(结果)有很强的关系。评估了各种不同的模型,并使用重采样方法估计了均方根误差(root mean squared error,RMSE)。图 1.7 显示了若干不同类型模型(如基于树的模型、线性模型等)的结果。初始特征集的 RMSE 值介于每天 3151 到 3960 次乘车之间。[12] 在相同的特征集下,基于树的模型性能最好,而线性模型结果最差。此外,同一模型类型内的 RMSE 结果变化很小(即线性模型的结果往往彼此相似)。
为了提高模型性能,花了一些时间推导第二组预测变量,用于补充最初的四个变量。由此确定了 128 个数值预测变量,它们是不同车站客流量的滞后(lag)版本。例如,要预测一周后的客流量,今天的客流量将用作预测变量(即七天滞后)。这第二组预测变量总体上产生了有益的效果,但对线性模型尤其有帮助(见图 1.7 中 x 轴上的 {1, 2} 值)。然而,这种益处因模型和模型类型而异。
由于滞后变量对预测结果很重要,因此创建了更多滞后变量,使用 8 到 14 天的滞后。其中许多变量与其他预测变量高度相关。然而,使用预测变量集合 1、2 和 3 的模型相比之前的一组模型并没有显示出太多有意义的改进,有些模型的结果甚至更差。一个特定的线性模型受到了影响,因为扩展后的集合具有高度的变量间相关性。这种情况通常被称为多重共线性,对某些模型来说可能特别麻烦。由于这组扩展的滞后变量整体上不再显示出多少益处,因此不再考虑。
当头脑风暴接下来可以添加哪些预测变量时,认为天气状况可能影响客流量似乎是合理的。为了评估这一猜想,计算了第四组 18 个预测变量,并与前两组一起用于模型(标记为 {1, 2, 4})。与第三组一样,天气没有显示出与预测列车客流量的任何相关性。
在对与集合 1 和 2 相关的模型进行残差图的探索性数据分析后,开发了第五组 49 个二值预测变量,用于处理当前最佳模型表现不佳的日子。这些预测变量使模型误差大幅下降,并被保留下来(见图 3.12 和 4.19)。请注意,这种改进对不同模型的影响不同,而且使用特征集 1、2 和 5 时,简单的线性模型产生了与更复杂的建模技术相当的结果。
从这个演示中应该理解的总体要点是:
- 在对数据建模时,几乎从来不存在一个单一的模型拟合或特征集能立即解决问题。这个过程更可能是一场为了获得最佳结果的试错战役。
- 特征集的影响可能远大于不同模型之间的影响。
- 模型与特征之间的相互作用是复杂的,在某种程度上是不可预测的。
- 有了正确的预测变量集,许多不同类型的模型通常可以达到相同的性能水平。最初,线性模型的性能最差,但最终表现出了一些最好的性能。
发现、表示、添加和删除预测变量的技术将在后面的章节中讨论。
1.4 特征选择
在前面的例子中,新的特征集是按顺序推导出来以提高模型性能的。这些集合被开发出来、添加到模型中,然后用重采样来评估它们的效用。在将新预测变量添加到模型之前,并没有前瞻性地对它们进行统计显著性过滤。这将是一个有监督的过程,必须小心确保不会发生过拟合。
在那个例子中,一些预测变量具有足够的基础信息来充分预测结果(如集合 1、2 和 5)。然而,这组预测变量很可能包含无信息变量,这可能在一定程度上影响性能。为了将预测变量集合缩减到只包含有信息预测变量的更小集合,可以使用有监督的特征选择技术。此外,集合 3 和 4 中可能有一小部分重要的预测变量,其效用因为集合中的大量无信息变量而未被发现。
在其他情况下,所有的原始预测变量在建模过程开始时都是已知和可用的。在这种情况下,可以采用不那么顺序化的方法,简单地使用特征选择例程来尝试区分最好和最差的预测变量。
有监督特征选择有许多不同的策略可以应用,这些将在第 10 章到第 12 章中讨论。搜索方法的一个区别在于子集是如何推导出来的:
- 包装法(wrapper methods)使用外部搜索过程来选择整个预测变量集的不同子集,以便在模型中进行评估。这种方法将特征搜索过程与模型拟合过程分开。这种方法的一个例子是向后选择(backward selection)或逐步选择(stepwise selection),以及遗传算法(genetic algorithms)。
- 嵌入法(embedded methods)是在模型拟合过程中自然发生特征选择过程的模型。这里的一个例子是简单的决策树(decision tree),当模型在分裂中使用变量时,变量就被选中。如果一个预测变量从未被用于分裂,预测方程在功能上就与该变量无关,它就被选择出去了。
与模型拟合一样,特征选择期间的主要担忧是过拟合。当使用包装方法和/或训练集中的数据点数量相对于预测变量数量较少时,尤其如此。
最后,无监督的选择方法可以对模型性能产生非常积极的影响。回想一下艾姆斯住房数据。一个房产所在的社区可能是一个有用的预测变量。由于大多数模型要求预测变量以数字表示,通常的做法是将这类数据编码为哑变量(dummy variable)或指示变量(indicator variable)。在这种情况下,这个单一的社区预测变量有 28 个可能值,被转换为一组 27 个二值变量,当房产位于该社区时值为一,否则为零。虽然这是一种众所周知且常见的方法,但在这里它导致 2 个社区在这些数据中只有一两套房产,不到整个集合的 1%。由于频率如此之低,这样的预测变量可能对某些模型(如线性回归)产生不利影响,在构建模型之前移除它们可能是明智的。
在进行变量子集搜索时,重要的是要认识到,可能不存在一组唯一的预测变量能产生最佳性能。通常存在一种补偿效应:当某个看似重要的变量被移除时,模型会利用剩余变量进行调整。当解释变量之间存在一定程度的相关性或使用低偏差模型时,尤其如此。因此,特征选择不应被用作确定特征显著性(feature significance)的正式方法。更传统的推断统计方法更适合评估预测变量对底层模型或数据集的贡献。
1.5 本书概要
本书的目标是提供有效的工具,以发现相关且具有预测用途的预测变量表示。这些工具将是预测建模过程的两个端点。在过程的开始,我们将探索扩充预测变量集的技术。然后在过程的最后,我们将提供过滤增强后预测变量集的方法,以最终产生更好的模型。这些概念将在第 2-12 章中详细阐述,具体如下。
我们首先简要说明建模与特征工程过程之间的相互作用(第 2 章)。在这个例子中,我们使用特征工程和特征选择方法来提高模型预测缺血性卒中风险的能力。
在第 3 章中,我们回顾了开发预测模型的过程,其中包括数据划分、验证方法选择、模型调优和未来预测性能估计等步骤的说明。本章还将指导如何在多个模型的建模过程中循环使用反馈回路。
数据的探索性可视化对于理解预测变量之间以及预测变量与响应之间的关系至关重要,尤其是对于高维数据。此外,可视化可用于帮助理解单个预测变量的性质,包括预测变量的偏态和缺失数据模式。第 4 章将介绍有用的可视化技术,以探索预测变量内部和之间的关系。还将介绍评估模型缺乏拟合(lack-of-fit)的图形方法。
第 5 章将重点介绍对离散(discrete)或分类(categorical)预测变量进行编码的方法。在这里,我们将总结表示分类预测变量的标准技术。针对分类预测变量的特征工程方法,如特征哈希(feature hashing),被引入作为一种利用现有信息创建新预测变量的方法,以更好地揭示有意义的关系。本章还将就实际问题提供指导,例如如何处理分类预测变量中的稀有水平(rare level),以及为树模型和基于规则的模型创建哑变量的影响。基于日期的预测变量存在于许多数据集中,可以视为分类预测变量。
数值预测变量的工程将在第 6 章中讨论。如上所述,原始数据中收集的数值预测变量可能不是预测响应的最优形式。单变量和多变量变换是寻找更优数值预测变量形式的第一步。更高级的方法是使用基展开(basis expansion,即样条 spline)来创建原始预测变量的更好表示。在某些情况下,将连续预测变量转换为分类或有序的分箱(bin)可以减少变化,并有助于提高预测模型的性能。还将提供对数值预测变量分箱(binning)的注意事项。
到目前为止,本书中的特征一直被认为是数据中观测到的预测变量之一。在第 7 章中,我们将说明预测模型的重要特征也可能是两个或多个原始预测变量之间的交互(interaction)。我们将探讨确定哪些预测变量相互交互的定量工具,以及评估这类效应重要性的图形方法。本章还将讨论交互作用的可估计性(estimability)概念。
每个处理真实世界数据的实践者都会在某个时候遇到缺失数据。虽然一些预测模型(如树)有处理缺失数据的新颖方法,但其他模型则不能,需要完整的数据。第 8 章探讨了导致缺失数据的机制,并提供了调查缺失数据模式的可视化工具。还提供了删除或插补(imputing)缺失数据的传统和现代工具。此外,还针对连续和分类预测变量评估了插补方法。
处理轮廓数据(profile data),如时间序列(纵向)、蜂窝(cellular)和图像数据,将在第 9 章中讨论。这类数据通常在金融、制药、情报、交通和天气预报领域收集,这种特殊的数据结构给许多模型带来了独特的挑战。一些现代预测建模工具,如偏最小二乘,可以自然地处理这种格式的数据。但许多其他强大的建模技术没有直接处理这类数据的方法。这些模型要求在建模之前对轮廓数据进行汇总或折叠。本章将说明处理轮廓数据的技术,这些技术力求在创建可跨预测模型使用的格式的同时保留预测信息。
第 5-9 章中描述的特征工程过程可能导致比原始数据中包含的多得多的预测变量。虽然一些额外的预测变量可能会提高模型性能,但并非所有原始和新预测变量都可能对预测有用。最后的章节将讨论特征选择作为提高模型预测性能的整体策略。重要的方面包括:特征选择的目标、不相关预测变量的后果、与通过正则化(regularization)进行选择的比较,以及如何避免(特征选择过程中的)过拟合。
1.6 计算
网站 http://bit.ly/fes-intro 包含用于重现这些分析的 R 程序。
脚注
[4] 此外,在某种程度上,这些术语的选择取决于一个人更偏向计算机科学还是统计学。
[5] 这类数据集将在第 3.3 节中进一步讨论。
[6] 该技术将在第 3.2 节中更详细地讨论。
[7] 在第 6.1 节中讨论。
[8] 预测变量值被归一化为均值为零、标准差为一,这是该模型所需要的。然而,这并不影响数据的偏态。
[9] 这假设数据已被充分清洗,不存在错误值。根据数据来源的不同,数据清洗很容易花费大量时间。
[10] 在第 3.6 节中更详细地讨论。
[11] 这个例子将在后面的章节中详细分析。
[12] 在这些数据中,RMSE 值 3000 大约对应 R² 值在 0.80 到 0.90 之间。然而,正如第 3.2.1 节所讨论的,由于这些数据的性质,R² 在这里可能具有误导性。